00-数学基础 · 高数与微积分¶
秋招算法岗 / 机器学习岗数学地基 · 第 1 篇 读完这篇,你能用大白话解释:导数是什么、梯度为什么反着走、链式法则怎么"传误差"、泰勒展开和积分在 ML 里用在哪。 全程中文、公式配 LaTeX、代码用 numpy 从零实现,可放心跟着跑。
本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 训练神经网络时,参数动一点点,损失函数会变多少?用什么工具衡量? | 导数:瞬时变化率 |
| 误差要从输出层一层层传回输入层,靠什么规则? | 常见导数表 + 链式法则 |
| 损失函数有成百上千万个参数,该往哪个方向调最优? | 偏导数、梯度与梯度下降 |
| 为什么可以用简单多项式近似复杂的损失函数?优化理论怎么用它? | 泰勒展开 |
| "曲线下的面积"在概率、AUC、期望里到处都是,到底怎么算? | 定积分与微积分基本定理 |
| 上面这些最终都用在哪? | 反向传播与优化 |
故事引入:开车、爬山与"看仪表盘"¶
想象你周末开车去郊外兜风。仪表盘上一直亮着两个数字:一个是当前瞬时速度,一个是已行驶里程。速度告诉你"这一刻开得多快"——它是位置随时间变化的快慢,这正是导数;里程表告诉你"总共走了多远"——它其实是在把每一瞬间的速度一点点累加起来,这正是积分。微积分最核心的一句话,就藏在这两个数字的关系里:速度的积分等于路程,路程的导数等于速度。
再换一个场景:你在浓雾中爬山,想找到山谷的最低点(这相当于找到损失函数的最小值)。你看不见整座山的全貌,只能靠脚下感受坡度:哪边更陡、哪边是下坡,就朝那个方向迈一小步。每迈一步,脚下的坡度都会变,于是你重新感受、再迈一步……这个"凭坡度找方向、一步一步往下走"的过程,就是梯度下降:用"坡度"(导数 / 梯度)指方向,用"步长"(学习率)定步子大小。而"这座山在某一点附近长什么样",可以用一个多项式近似出来——那就是泰勒展开。
机器学习的训练,本质上是把两个故事拼在一起:前向传播算损失(像记里程),反向传播用链式法则逐层算梯度(像看速度表),再用梯度下降更新参数(像雾天爬山)。把这几件事想明白,你就拿到了理解深度学习训练的全部数学骨架。
核心概念¶
(a) 🗂️ 高数与微积分 · 知识结构树¶
微积分就两件事:微分研究"变化有多快",积分研究"累加有多少",而微积分基本定理把两者连成一家。下面这张图是本章的地图,方框里是概念,箭头表示"谁支撑谁"。
flowchart TB
    A["🧠 极限与连续性<br/>变化的趋近直觉"] --> B["🧠 导数<br/>瞬时变化率"]
    B --> C["🧠 常见导数与链式法则<br/>求导工具箱"]
    C --> D["🧠 偏导数与梯度<br/>多元函数的导数"]
    D --> E["🧠 梯度下降优化<br/>沿最陡下坡走"]
    B -.-> F["🧠 泰勒展开<br/>用多项式逼近函数"]
    E -.-> F
    A --> G["🧠 定积分<br/>把变化累加起来"]
    G --> H["🧠 微积分基本定理<br/>微分与积分互逆"]
    F --> I["🧠 在 ML 中:反向传播<br/>误差逐层传回"]
    E --> I
    H --> I
- 极限与连续性:极限说的是"一个量越来越逼近某个值"的严谨语言,连续性则表示曲线没有"断口"。它是一切微积分的地基,直觉上理解即可,面试很少深挖。
- 导数:衡量"自变量变一点点,函数值变多少",也就是曲线在某一点的瞬时斜率。神经网络里"损失对权重的一阶变化"就是导数。
- 常见导数与链式法则:记住一张小小的导数表,再配上链式法则,就能对任何"套娃"式复合函数求导——反向传播整条链路就是靠它走完的。
- 偏导数与梯度:函数有多个自变量时,对其中一个求导就是偏导数;把所有偏导数排成一个向量就是梯度,它指向函数增长最快的方向。
- 梯度下降优化:沿着负梯度方向反复迈小步,就能逼近极小值点。SGD、Adam 这些深度学习优化器,都是它的变体。
- 泰勒展开:任何一个"光滑"的函数,都可以在某一点附近用多项式逼近。优化里的收敛性分析、二阶方法(牛顿法)全都建立在它之上。
- 定积分:把曲线下的面积切成无数小窄条再累加,得到总面积。概率密度下的面积、AUC 这些概念本质上都是积分。
- 微积分基本定理:积分和导数互为逆运算:先求导再积分,等于回到原点。它让"算面积"变得极其简单——只要找到原函数。
- 在 ML 中:反向传播:把损失函数看成所有参数的复合函数,用链式法则从输出层把梯度一层层传回输入层,得到每个参数的"坡度"。
深入原理¶
下面 6 个小节,每个都按同一套路讲:先给大白话直觉 → 再给严格公式 → 再走一遍关键推导 → 最后一句"面试怎么问"。看完你会发现,微积分并没有想象中那么可怕。
1. 导数:瞬时变化率¶
大白话直觉:开车时仪表盘上的"瞬时速度"就是导数的化身。平均速度 = 路程 ÷ 时间,但"瞬时"指的是时间间隔 $\Delta x$ 无限趋近于 0 时的极限。几何上,导数是曲线上某一点处切线的斜率:割线越来越短、越来越贴近曲线,最后"锁死"在切线的位置。
定义公式:
$$ f'(x) = \lim_{\Delta x \to 0} \frac{f(x+\Delta x) - f(x)}{\Delta x} $$
关键推导步骤(以 $f(x)=x^2$ 为例):
- 写出差商:$\dfrac{f(x+\Delta x)-f(x)}{\Delta x} = \dfrac{(x+\Delta x)^2 - x^2}{\Delta x}$;
- 展开平方并约分:$\dfrac{x^2 + 2x\Delta x + (\Delta x)^2 - x^2}{\Delta x} = 2x + \Delta x$;
- 令 $\Delta x \to 0$,得到 $f'(x)=2x$。所以在 $x=3$ 处斜率为 6:意思就是"$x$ 每增大一点点,$y$ 大约增大 6 倍那么多"。
面试怎么问:"$f(x)=x^2$ 的导数是多少?从定义推一遍。"——背结论人人都会,能手推极限过程才是加分项。
2. 常见导数表与链式法则¶
大白话直觉:求导就像"拆零件"。常见函数(幂函数、指数、对数、三角)的导数是一张"乘法口诀表";而链式法则专门处理"套娃"函数——外一层、里一层,就像剥洋葱,从外到里一层层求导再相乘。反向传播就是一条超长的链式法则:损失函数是几百层"套娃"的复合函数。
常见导数表:
$$ (x^n)' = n\,x^{n-1}, \quad (\sin x)' = \cos x, \quad (e^x)' = e^x, \quad (\ln x)' = \frac{1}{x} $$
链式法则:
$$ \frac{d}{dx} f\big(g(x)\big) = f'\big(g(x)\big) \cdot g'(x) $$
关键推导步骤(以 $y = (x^2+1)^3$ 为例):
- 设里层 $u = g(x) = x^2+1$,外层 $f(u) = u^3$;
- 外层对 $u$ 求导:$f'(u) = 3u^2$;里层对 $x$ 求导:$g'(x) = 2x$;
- 相乘并代回:$y' = 3(x^2+1)^2 \cdot 2x = 6x(x^2+1)^2$。
直觉解释:$x$ 动一点,先带动 $u$,$u$ 再带动 $y$,两个"传动比"相乘就是总传动比。深度网络里,损失对第 $l$ 层权重的梯度,就是一路把传动比连乘到那一层。
面试怎么问:"softmax 交叉熵损失对 logits 的梯度是多少?"——答案是 $\hat{y} - y$,本质就是链式法则的产物,能现场推出来非常加分。
3. 偏导数与梯度:多变量函数的"坡度"¶
大白话直觉:损失函数通常有上亿个参数,是"高维空间里的一座山"。偏导数是"只动 $x$、其他变量全部冻结"时的坡度;把所有偏导数收集成一个向量,就得到梯度——它指向这座山"上升最快"的方向。所以想下山,就走负梯度方向。
定义公式:
$$ \frac{\partial f}{\partial x} = \lim_{h \to 0} \frac{f(x+h, y) - f(x, y)}{h}, \qquad \nabla f = \left( \frac{\partial f}{\partial x_1}, \frac{\partial f}{\partial x_2}, \ldots, \frac{\partial f}{\partial x_n} \right) $$
关键推导步骤(以 $f(x, y) = x^2 y + \sin y$ 为例):
- 对 $x$ 求偏导,把 $y$ 当常数:$\dfrac{\partial f}{\partial x} = 2xy$;
- 对 $y$ 求偏导,把 $x$ 当常数:$\dfrac{\partial f}{\partial y} = x^2 + \cos y$;
- 梯度就是 $\nabla f = (2xy,\ x^2 + \cos y)$。在点 $(1,0)$ 处 $\nabla f = (0,2)$:朝 $y$ 正方向走,函数上升最快。
为什么梯度是最陡方向(一句话推导):对任意单位方向 $\boldsymbol{u}$,方向导数等于 $\nabla f \cdot \boldsymbol{u} = \|\nabla f\|\cos\theta$,当 $\boldsymbol{u}$ 与 $\nabla f$ 同向时取最大——所以梯度就是最陡上升方向,负梯度即最陡下降方向。
面试怎么问:"为什么梯度下降沿负梯度方向走?"——能背出上面"方向导数 = 内积 = 模长 × cosθ"的推导即可。
✍️ §4.1 手算泰勒展开:e^0.5 用多项式一级一级逼近¶
泰勒公式 $f(x)=\sum_{k=0}^{\infty}\frac{f^{(k)}(0)}{k!}x^k$——手算 $e^x$ 的前几项,看误差怎么随项数缩小。
设定:$f(x)=e^x$ 在 $x=0.5$ 处展开($e^x$ 的 $k$ 阶导数还是 $e^x$,在 0 处都等于 1)。
第 1 步:写出泰勒级数
$$e^x=1+x+\frac{x^2}{2}+\frac{x^3}{6}+\frac{x^4}{24}+\cdots$$
第 2 步:逐项代入 $x=0.5$
| 项 | 数值 |
|---|---|
| 1 | 1.000 |
| $x$ | 0.500 |
| $x^2/2$ | 0.1250 |
| $x^3/6$ | 0.0208 |
| $x^4/24$ | 0.0026 |
第 3 步:累加对比真值
$$1+0.5+0.125=1.625\quad(+0.125)\quad 2\text{ 阶截断}$$ $$1.625+0.0208=1.6458\quad(\text{距 } 1.6487\text{ 仅差 }0.0029)\quad 3\text{ 阶}$$
手算收获:
- $e^{0.5}=1.6487$,前 3 项 1.625、前 4 项 1.6458——每加一项都更接近,第 4 项贡献只 0.0026
- 误差 = 余项 $R_n=f^{(n+1)}(\xi)x^{n+1}/(n+1)!$:项数越多误差越小($0.5^{n+1}$ 快速衰减)——这就是"用多项式逼近任何光滑函数"
- 机器学习里到处是泰勒的影子:牛顿法/二阶优化用 $f''$ 展开,验证器用有限差分逼近导数(中心差分 $\approx f'+O(h^2)$)
- 面试速答:$e^x$ 展开、$\ln(1+x)\approx x-x^2/2$ 都是手撕高频项
下面 numpy 复算。
# ---- §4.1 验证:numpy 复算泰勒展开 ----
import numpy as np

x = 0.5
terms = [1.0, x, x**2/2, x**3/6, x**4/24]
s3 = sum(terms[:3])
s4 = sum(terms[:4])
truth = np.exp(x)
print(f'前3项 = {s3:.4f},前4项 = {s4:.4f},真值 = {truth:.4f},误差 = {truth - s4:.4f}')
assert abs(s3 - 1.625) < 1e-9 and abs(s4 - 1.6458) < 1e-3
print('\n✓ 与手算一致:级数项越多越逼近真值')
4. 泰勒展开:用多项式逼近任何光滑函数¶
大白话直觉:任何一条"顺滑"的曲线,在某个点附近看,它像一条直线(一阶);再凑近一点,像一条抛物线(二阶);更近一点,像三次曲线……泰勒展开就是把"局部形状"一层层还原成多项式。学习率分析、牛顿法、以及很多优化理论,都建立在这只"局部放大镜"上。
公式(在 $a$ 点展开):
$$ f(x) = f(a) + f'(a)(x-a) + \frac{f''(a)}{2!}(x-a)^2 + \frac{f'''(a)}{3!}(x-a)^3 + \cdots $$
关键推导思路(为什么系数是 $\frac{f^{(k)}(a)}{k!}$):
- 假设 $f(x) \approx c_0 + c_1(x-a) + c_2(x-a)^2 + \cdots$;
- 令 $x=a$,得 $c_0 = f(a)$;
- 两边对 $x$ 求导后再令 $x=a$,得 $c_1 = f'(a)$;再求二阶导,得 $2!\,c_2 = f''(a)$,即 $c_2 = \frac{f''(a)}{2!}$;
- 依此类推:第 $k$ 项系数恰好是 $\frac{f^{(k)}(a)}{k!}$——这就是"系数由各阶导数决定"的原因。
在优化中的应用:把损失函数在 $\theta_t$ 处做一阶展开:$L(\theta_t - \eta \nabla L) \approx L(\theta_t) - \eta\|\nabla L\|^2$,只要学习率 $\eta$ 足够小,损失必然下降——这就是梯度下降能收敛的理论依据。若再保留二阶项,就得到牛顿法:$\theta_{t+1} = \theta_t - H^{-1}\nabla L$($H$ 为 Hessian 矩阵)。
面试怎么问:"梯度下降为什么能保证损失下降?"——用一阶泰勒展开回答"小步长下沿负梯度方向损失近似线性下降",比背结论高级得多。
5. 定积分与微积分基本定理¶
大白话直觉:定积分就是"算曲线下的面积":把区间切成无数根小窄条,每根窄条近似成矩形,再全部加起来。而微积分基本定理说了一件很妙的事:求面积和求斜率是互逆的。想算 $\int_a^b f(x)\,dx$,根本不用真去切窄条——只要找到 $f$ 的原函数 $F$(即 $F' = f$),答案就是 $F(b) - F(a)$。
公式:
$$ \int_a^b f(x)\,dx = \Big[\,F(x)\,\Big]_a^b = F(b) - F(a), \qquad F'(x) = f(x) $$
关键推导直觉(考察面积函数 $S(x) = \int_a^x f(t)\,dt$):
- 让上限 $x$ 动一点 $\Delta x$,面积的增量约等于"右边那根小窄条":$S(x+\Delta x) - S(x) \approx f(x)\,\Delta x$;
- 两边除以 $\Delta x$ 并令其趋于 0,得到 $S'(x) = f(x)$——面积函数恰好是 $f$ 的原函数;
- 于是 $\int_a^b f(x)\,dx = S(b) - S(a)$,而任意两个原函数只差一个常数,所以通常写成 $F(b) - F(a)$。
在 ML 中哪用:连续概率密度下的面积就是概率:$P(a \le X \le b) = \int_a^b p(x)\,dx$;期望 $\mathbb{E}[X] = \int x\,p(x)\,dx$;连续熵、KL 散度、AUC(ROC 曲线下面积)也都是积分。
面试怎么问:"KL 散度为什么非负?"——从凸性和 Jensen 不等式出发证明,积分只是载体。
6. 反向传播:把链式法则用到极致¶
大白话直觉:前向传播时,输入 $x$ 依次穿过每一层得到预测 $\hat{y}$ 和损失 $L$;反向传播则反过来,把"损失对输出的敏感度"从输出层一路传回输入层,每经过一层就用链式法则乘上这一层的"局部导数"。整个网络就是一个巨型复合函数,反向传播就是高效地计算它的梯度——只求一次、处处复用,本质是动态规划。
核心公式(以单隐藏层网络为例):设 $h = \sigma(W_1 x)$,$z = W_2 h$,$a = \sigma(z)$,损失 $L(a)$:
$$ \frac{\partial L}{\partial W_2} = \underbrace{\frac{\partial L}{\partial a}}_{\text{从后层传来}} \cdot \underbrace{\frac{\partial a}{\partial z}}_{\text{激活函数导数}} \cdot \underbrace{\frac{\partial z}{\partial W_2}}_{\text{本层局部导数}} $$
关键推导步骤:
- 记 $\delta = \frac{\partial L}{\partial z}$ 为"本层收到的误差信号";
- 对权重 $W_{2,ij}$:$\dfrac{\partial L}{\partial W_{2,ij}} = \delta_i \cdot h_j$——"误差信号 × 上游激活值",这就是为什么训练代码里到处都是"激活 × 误差";
- 把误差继续传回上一层:$\dfrac{\partial L}{\partial h} = W_2^\top \delta$——用权重矩阵的转置把误差传回去;
- 整个过程只有矩阵乘法和逐元素乘法,GPU 一次就能并行算完。
面试怎么问:"为什么反向传播比数值求导快?"——数值求导对每个参数都要重跑一次前向($O(n)$ 次),反向传播只跑一次前向 + 一次反向,所有梯度一次到手。
代码实战¶
下面用 numpy 从零验证本章的核心结论,一共 4 个代码 cell:
- 数值导数 vs 解析导数:用中心差分逼近导数,和手推公式对比,再复现一次梯度下降;
- 链式法则与偏导数:复合函数求导 + 多元函数梯度,逐项数值验证;
- 泰勒展开:多取几项,逼近误差下降多少(出图);
- 黎曼和 vs 微积分基本定理:把积分"切窄条"硬算,和 $F(b)-F(a)$ 对比(出图)。
所有代码只依赖 numpy / matplotlib,无随机(或固定 seed),可直接运行复现。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
import sys, io
# 中文输出前确保 UTF-8 编码(Jupyter 内核的 OutStream 已支持 UTF-8,此处自动降级为 no-op)
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except (AttributeError, TypeError):
    pass

import numpy as np

def numerical_derivative(f, x, h=1e-6):
    """中心差分求导:f'(x) ≈ [f(x+h) - f(x-h)] / (2h),误差 O(h^2)"""
    return (f(x + h) - f(x - h)) / (2 * h)

# 1) f(x) = x^2,解析导数 2x
f1 = lambda x: x ** 2
x = 2.0
an1 = 2 * x
nu1 = numerical_derivative(f1, x)
print(f"f(x)=x^2 在 x=2:解析={an1:.10f},数值={nu1:.10f},误差={abs(an1-nu1):.2e}")

# 2) f(x) = sin(x),解析导数 cos(x)
x = 1.0
an2 = np.cos(x)
nu2 = numerical_derivative(np.sin, x)
print(f"f(x)=sin(x) 在 x=1:解析={an2:.10f},数值={nu2:.10f},误差={abs(an2-nu2):.2e}")

# 3) f(x) = e^x,解析导数 e^x
x = 0.5
an3 = np.exp(x)
nu3 = numerical_derivative(np.exp, x)
print(f"f(x)=e^x 在 x=0.5:解析={an3:.10f},数值={nu3:.10f},误差={abs(an3-nu3):.2e}")

# 4) 梯度下降复现:f(x) = (x-3)^2 在 x=3 处最小,从 x=0 出发沿负梯度走
f = lambda t: (t - 3) ** 2
df = lambda t: 2 * (t - 3)
x = 0.0
lr = 0.1
for _ in range(60):
    x = x - lr * df(x)
print(f"梯度下降 60 步后 x={x:.6f}(理论最优 x=3,误差={abs(x-3):.2e})")

# 核对
assert abs(an1 - nu1) < 1e-6 and abs(an2 - nu2) < 1e-6 and abs(an3 - nu3) < 1e-6
assert abs(x - 3) < 1e-3
print("核对通过:数值导数 ≈ 解析导数,梯度下降收敛到最优解 ✔")
f(x)=x^2 在 x=2:解析=4.0000000000,数值=4.0000000001,误差=1.15e-10
f(x)=sin(x) 在 x=1:解析=0.5403023059,数值=0.5403023059,误差=2.77e-11
f(x)=e^x 在 x=0.5:解析=1.6487212707,数值=1.6487212707,误差=3.04e-11
梯度下降 60 步后 x=2.999995(理论最优 x=3,误差=4.60e-06)
核对通过:数值导数 ≈ 解析导数,梯度下降收敛到最优解 ✔
import numpy as np

def numerical_derivative(f, x, h=1e-6):
    """中心差分求导"""
    return (f(x + h) - f(x - h)) / (2 * h)

# 1) 链式法则验证:y = (x^2 + 1)^3,解析 y' = 6x(x^2+1)^2
x = 1.3
analytic = 6 * x * (x**2 + 1) ** 2
numeric = numerical_derivative(lambda t: (t**2 + 1) ** 3, x)
print(f"y=(x^2+1)^3 在 x=1.3:链式法则={analytic:.10f},数值={numeric:.10f},误差={abs(analytic-numeric):.2e}")

# 2) 三层"套娃"(模拟多层网络):y = sin(exp(x^2))
#    链式:dy/dx = cos(exp(x^2)) * exp(x^2) * 2x
x = 0.7
analytic = np.cos(np.exp(x**2)) * np.exp(x**2) * 2 * x
numeric = numerical_derivative(lambda t: np.sin(np.exp(t**2)), x)
print(f"y=sin(exp(x^2)) 在 x=0.7:链式法则={analytic:.10f},数值={numeric:.10f},误差={abs(analytic-numeric):.2e}")

# 3) 偏导数与梯度验证:f(x, y) = x^2 y + sin(y),在 (1, 0)
def f(x, y):
    return x**2 * y + np.sin(y)

x, y = 1.0, 0.0
df_dx_an = 2 * x * y                    # 解析:∂f/∂x
df_dy_an = x**2 + np.cos(y)             # 解析:∂f/∂y
h = 1e-6
df_dx_nu = (f(x + h, y) - f(x - h, y)) / (2 * h)
df_dy_nu = (f(x, y + h) - f(x, y - h)) / (2 * h)
print(f"∂f/∂x(1,0):解析={df_dx_an:.8f},数值={df_dx_nu:.8f},误差={abs(df_dx_an-df_dx_nu):.2e}")
print(f"∂f/∂y(1,0):解析={df_dy_an:.8f},数值={df_dy_nu:.8f},误差={abs(df_dy_an-df_dy_nu):.2e}")
print(f"梯度 ∇f(1,0) = ({df_dx_an:.1f}, {df_dy_an:.1f}),沿 (0, 2) 方向函数增长最快")

assert abs(analytic - numeric) < 1e-6 and abs(df_dx_an - df_dx_nu) < 1e-6 and abs(df_dy_an - df_dy_nu) < 1e-6
print("核对通过:链式法则与偏导数均与数值结果一致 ✔")
y=(x^2+1)^3 在 x=1.3:链式法则=56.4415800000,数值=56.4415799946,误差=5.37e-09
y=sin(exp(x^2)) 在 x=0.7:链式法则=-0.1404992236,数值=-0.1404992236,误差=2.52e-12
∂f/∂x(1,0):解析=0.00000000,数值=0.00000000,误差=0.00e+00
∂f/∂y(1,0):解析=2.00000000,数值=2.00000000,误差=1.67e-13
梯度 ∇f(1,0) = (0.0, 2.0),沿 (0, 2) 方向函数增长最快
核对通过:链式法则与偏导数均与数值结果一致 ✔
import numpy as np
import matplotlib.pyplot as plt
from math import factorial
import os

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 1) 在 x=0 处展开 e^x:1 + x + x^2/2! + x^3/3! + ...
def taylor_exp(x, n):
    s = 0.0
    for k in range(n + 1):
        s += x ** k / factorial(k)
    return s

x = 1.0
print(f"e^1 真值 = {np.exp(1):.10f}")
for n in range(0, 8):
    approx = taylor_exp(x, n)
    print(f"  取前 {n+1} 项:{approx:.8f},误差 = {abs(np.exp(1) - approx):.2e}")

# 2) 画图:用 1/3/5/7 阶泰勒多项式逼近 sin(x)
xx = np.linspace(-np.pi, np.pi, 400)
plt.figure(figsize=(8, 5))
plt.plot(xx, np.sin(xx), 'k-', linewidth=2.5, label='sin(x)(真值)')
for order, style in [(1, '--'), (3, '-.'), (5, ':'), (7, '-')]:
    taylor = np.zeros_like(xx)
    for k in range((order + 1) // 2):
        taylor += ((-1) ** k) * (xx ** (2 * k + 1)) / factorial(2 * k + 1)
    plt.plot(xx, taylor, style, linewidth=1.5, label=f'{order} 阶泰勒')
plt.axhline(0, color='gray', linewidth=0.6)
plt.axvline(0, color='gray', linewidth=0.6)
plt.ylim(-2.2, 2.2)
plt.xlabel('x'); plt.ylabel('y')
plt.title('泰勒展开:用多项式逼近 sin(x)')
plt.legend()
plt.tight_layout()
os.makedirs('images', exist_ok=True)
plt.savefig('images/math00_taylor.png', dpi=120)
plt.show()
print("已保存 images/math00_taylor.png")

assert abs(taylor_exp(x, 7) - np.exp(1)) < 1e-4
print("核对通过:7 阶泰勒逼近 e^1,误差 < 1e-4 ✔")
e^1 真值 = 2.7182818285
  取前 1 项:1.00000000,误差 = 1.72e+00
  取前 2 项:2.00000000,误差 = 7.18e-01
  取前 3 项:2.50000000,误差 = 2.18e-01
  取前 4 项:2.66666667,误差 = 5.16e-02
  取前 5 项:2.70833333,误差 = 9.95e-03
  取前 6 项:2.71666667,误差 = 1.62e-03
  取前 7 项:2.71805556,误差 = 2.26e-04
  取前 8 项:2.71825397,误差 = 2.79e-05
已保存 images/math00_taylor.png
核对通过:7 阶泰勒逼近 e^1,误差 < 1e-4 ✔
C:\Users\24260\AppData\Local\Temp\ipykernel_41008\3574860626.py:40: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
import numpy as np
import matplotlib.pyplot as plt
import os

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

def riemann_sum(f, a, b, n, rule='left'):
    """把 [a,b] 切成 n 等份,按 rule(left/right/midpoint)取矩形高度累加面积(黎曼和)"""
    xs = np.linspace(a, b, n + 1)
    h = (b - a) / n
    if rule == 'left':
        pts = xs[:-1]
    elif rule == 'right':
        pts = xs[1:]
    else:
        pts = (xs[:-1] + xs[1:]) / 2
    return h * np.sum(f(pts))

# 1) ∫₀^π sin(x) dx = 2:矩形切得越细越接近真值
for n in [10, 100, 10000]:
    s = riemann_sum(np.sin, 0, np.pi, n)
    print(f"∫₀^π sin(x) dx({n} 份矩形)≈ {s:.8f},真值 2,误差 {abs(s - 2):.2e}")

# 2) ∫₀^1 x² dx = 1/3:原函数 F(x) = x³/3,用微积分基本定理
F = lambda t: t**3 / 3
true_val = F(1) - F(0)
for rule in ['left', 'right', 'midpoint']:
    s_rule = riemann_sum(lambda t: t**2, 0, 1, 10000, rule)
    print(f"∫₀^1 x² dx(10000 份,{rule} 矩形)≈ {s_rule:.8f},误差 {abs(s_rule - true_val):.2e}")
s_mid = riemann_sum(lambda t: t**2, 0, 1, 10000, 'midpoint')
print(f"微积分基本定理:F(1)-F(0) = {true_val:.8f}")

# 3) 画图:黎曼和可视化
f = lambda t: t ** 2
a, b, n = 0.0, 1.0, 10
xx = np.linspace(a, b, 400)
plt.figure(figsize=(8, 5))
plt.plot(xx, f(xx), 'k-', linewidth=2.5, label='f(x)=x²')
xs = np.linspace(a, b, n + 1)
w = (b - a) / n
for i in range(n):
    plt.bar(xs[i], f(xs[i]), width=w, align='edge', color='steelblue', alpha=0.45,
            edgecolor='steelblue', linewidth=0.5)
plt.title('黎曼和:把曲线下的面积切成小矩形再累加')
plt.xlabel('x'); plt.ylabel('y')
plt.legend()
plt.tight_layout()
os.makedirs('images', exist_ok=True)
plt.savefig('images/math00_integral.png', dpi=120)
plt.show()
print("已保存 images/math00_integral.png")

assert abs(s_mid - true_val) < 1e-6
print("核对通过:中点规则矩形和 ≈ F(b)-F(a),微积分基本定理成立 ✔")
∫₀^π sin(x) dx(10 份矩形)≈ 1.98352354,真值 2,误差 1.65e-02
∫₀^π sin(x) dx(100 份矩形)≈ 1.99983550,真值 2,误差 1.64e-04
∫₀^π sin(x) dx(10000 份矩形)≈ 1.99999998,真值 2,误差 1.64e-08
∫₀^1 x² dx(10000 份,left 矩形)≈ 0.33328334,误差 5.00e-05
∫₀^1 x² dx(10000 份,right 矩形)≈ 0.33338334,误差 5.00e-05
∫₀^1 x² dx(10000 份,midpoint 矩形)≈ 0.33333333,误差 8.33e-10
微积分基本定理:F(1)-F(0) = 0.33333333
已保存 images/math00_integral.png
核对通过:中点规则矩形和 ≈ F(b)-F(a),微积分基本定理成立 ✔
C:\Users\24260\AppData\Local\Temp\ipykernel_41008\393265324.py:51: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
代码实战 · 结果图¶
上面两张图分别直观验证了"泰勒展开"和"积分"两个核心概念。
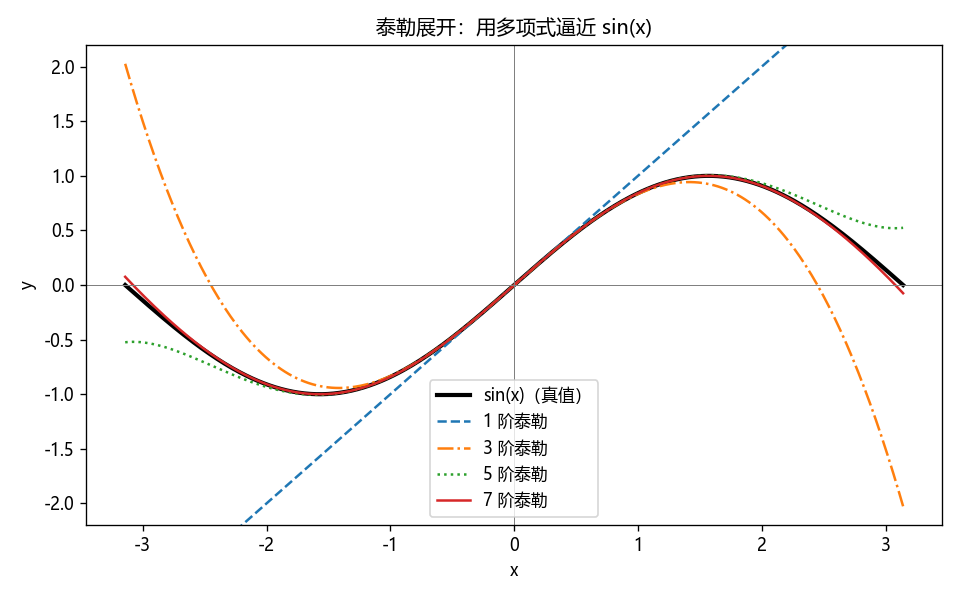
高阶泰勒多项式在展开点附近几乎完美贴合原函数——这就是"局部用多项式代替复杂函数"的直观画面。
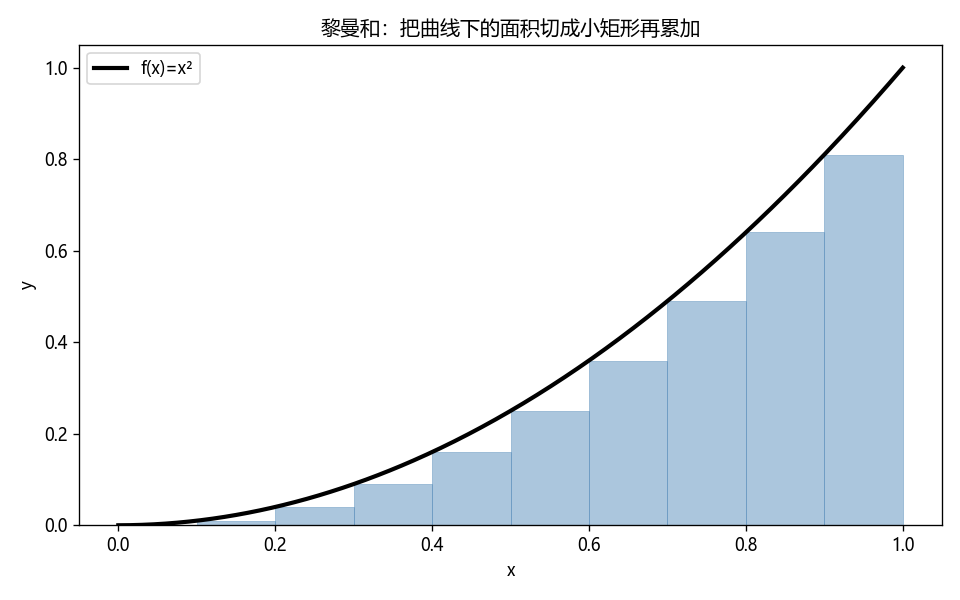
把曲线下的面积切成小矩形再求和,切得越细越接近真值——这就是积分的本质;而微积分基本定理让我们根本不用真的去切矩形。
小技巧:上面代码用"数值导数验证解析公式"来自检,面试手撕反向传播之前,先用这一招检查自己的实现。
面试考点¶
Q1:导数是什么?请从定义出发给 f(x)=x² 求导。¶
参考回答:导数是瞬时变化率 / 切线斜率,定义是 $f'(x)=\lim_{\Delta x\to 0}\frac{f(x+\Delta x)-f(x)}{\Delta x}$。对 $x^2$:差商展开约分后得 $2x+\Delta x$,取极限得 $2x$。 追问:为什么中心差分 $[f(x+h)-f(x-h)]/(2h)$ 比前向差分 $[f(x+h)-f(x)]/h$ 精度高? 30 秒速答:把 $f(x\pm h)$ 做泰勒展开,前向差分误差 $O(h)$,中心差分里 $h$ 的一次项正好相消,误差 $O(h^2)$。
Q2:链式法则和反向传播是什么关系?¶
参考回答:反向传播就是链式法则在多层复合函数上的应用:把网络看成复合函数,从输出层到输入层逐层乘"局部导数",一次前向 + 一次反向拿到全部参数的梯度。 追问:为什么叫"反向"? 30 秒速答:误差信号从输出往输入传,方向与数据流动相反;正向只算数值,反向才算梯度。
Q3:为什么梯度下降要沿负梯度方向走?¶
参考回答:对任意单位方向 u,方向导数 = ∇f·u = ‖∇f‖cosθ,θ=0(与梯度同向)时最大,所以梯度是上升最快方向,负梯度即下降最快方向;结合一阶泰勒展开,小步长下损失必然下降。 追问:学习率太大会怎样? 30 秒速答:一步跨过谷底,损失震荡甚至发散——泰勒展开只在局部成立,步子太大近似就失效了。
Q4:泰勒展开在机器学习里有什么用?¶
参考回答:① 梯度下降收敛性证明(一阶展开);② 牛顿法 / 拟牛顿法(二阶展开,用到 Hessian);③ 分析损失函数局部性质;④ 各种推导近似。 追问:牛顿法为什么可能比梯度下降快? 30 秒速答:梯度下降只看坡度(一阶),牛顿法还利用曲率(二阶 Hessian),能自适应调整方向和步长,收敛更快,但 Hessian 计算昂贵。
Q5:积分在 ML 里哪些地方会出现?¶
参考回答:期望 E[X]=∫x p(x)dx;概率 P(a≤X≤b)=∫ₐᵇ p(x)dx;连续熵、KL 散度;AUC = ROC 曲线下面积;GAN 的积分形式目标函数。 追问:既然积分这么重要,为什么深度学习代码里几乎看不到积分? 30 秒速答:因为都离散化了——期望用样本均值近似(蒙特卡洛),概率用频次估计,AUC 用排序计算,积分被"求和"取代。
Q6:数值梯度 ∂L/∂W ≈ [L(W+ε)-L(W-ε)]/(2ε) 可行吗?实际训练为什么不用?¶
参考回答:可行,这就是中心差分定义导数的直接应用。实际不用是因为每个参数都要重跑一次前向(O(n) 次),而反向传播一次搞定;而且数值误差大、不稳定。 追问:数值梯度什么时候仍然有用? 30 秒速答:写单元测试——用数值梯度校验反向传播实现(gradient check),这是工程常规做法。
Q7:ReLU 在 0 处不可微,为什么还能训练?¶
参考回答:可微要求导数存在且连续;ReLU 除 0 外处处可导,在 0 处取次梯度(0 或 1 均可),且参数几乎不可能恰好等于 0,所以训练没问题。 追问:GELU 相比 ReLU 有什么好处? 30 秒速答:GELU 处处光滑可导,梯度更平滑、优化更稳,实践中通常表现更好。
小结与下一章预告¶
小结¶
- 一个直觉:微分管"变化有多快",积分管"累加有多少",微积分基本定理把两者接上。
- 一张表:幂 / 指数 / 对数 / 三角的导数表 + 链式法则,足以应付深度学习里 99% 的求导。
- 一个向量:梯度 = 所有偏导数组成的向量,指向最陡上升方向;负梯度 = 下山方向。
- 一个近似:泰勒展开 = 局部的"多项式放大镜",是优化理论的地基。
- 一个工程:反向传播 = 链式法则 + 动态规划,一次前向 + 一次反向拿到全部梯度。
下一章预告¶
下一节进入 01-线性代数:向量、矩阵、特征值分解、SVD。你会看到 Transformer 的注意力、PCA 降维、权重初始化全都建立在这套语言上。微积分给了我们"怎么走",线性代数给了我们"在哪里走、往哪个方向走"。