🎤 06 · 多模态面试八股与高频题
最后冲刺:把多模态考点的架构族谱、训练范式、对齐方法、评测基准、常见坑串成速答体系。
🎬 背景故事
多模态岗面试,面试官最常问的六块……
多模态是 2024-2025 大模型岗的第一增量方向,面试官的问题也高度集中:CLIP 为什么能 zero-shot?Q-Former 和线性投影选哪个?三阶段训练为什么冻结?扩散模型训练目标是什么?视频 token 太多怎么办?本节把这六块串成一张地图,逐题速答。
🧭 本节逻辑主线:对齐(InfoNCE/τ/zero-shot)→ 架构(ViT/Q-Former/投影)→ 训练(三阶段/冻结)→ 生成(扩散/CFG)→ 视频(时序)→ 评估(Recall@K/陷阱)。
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
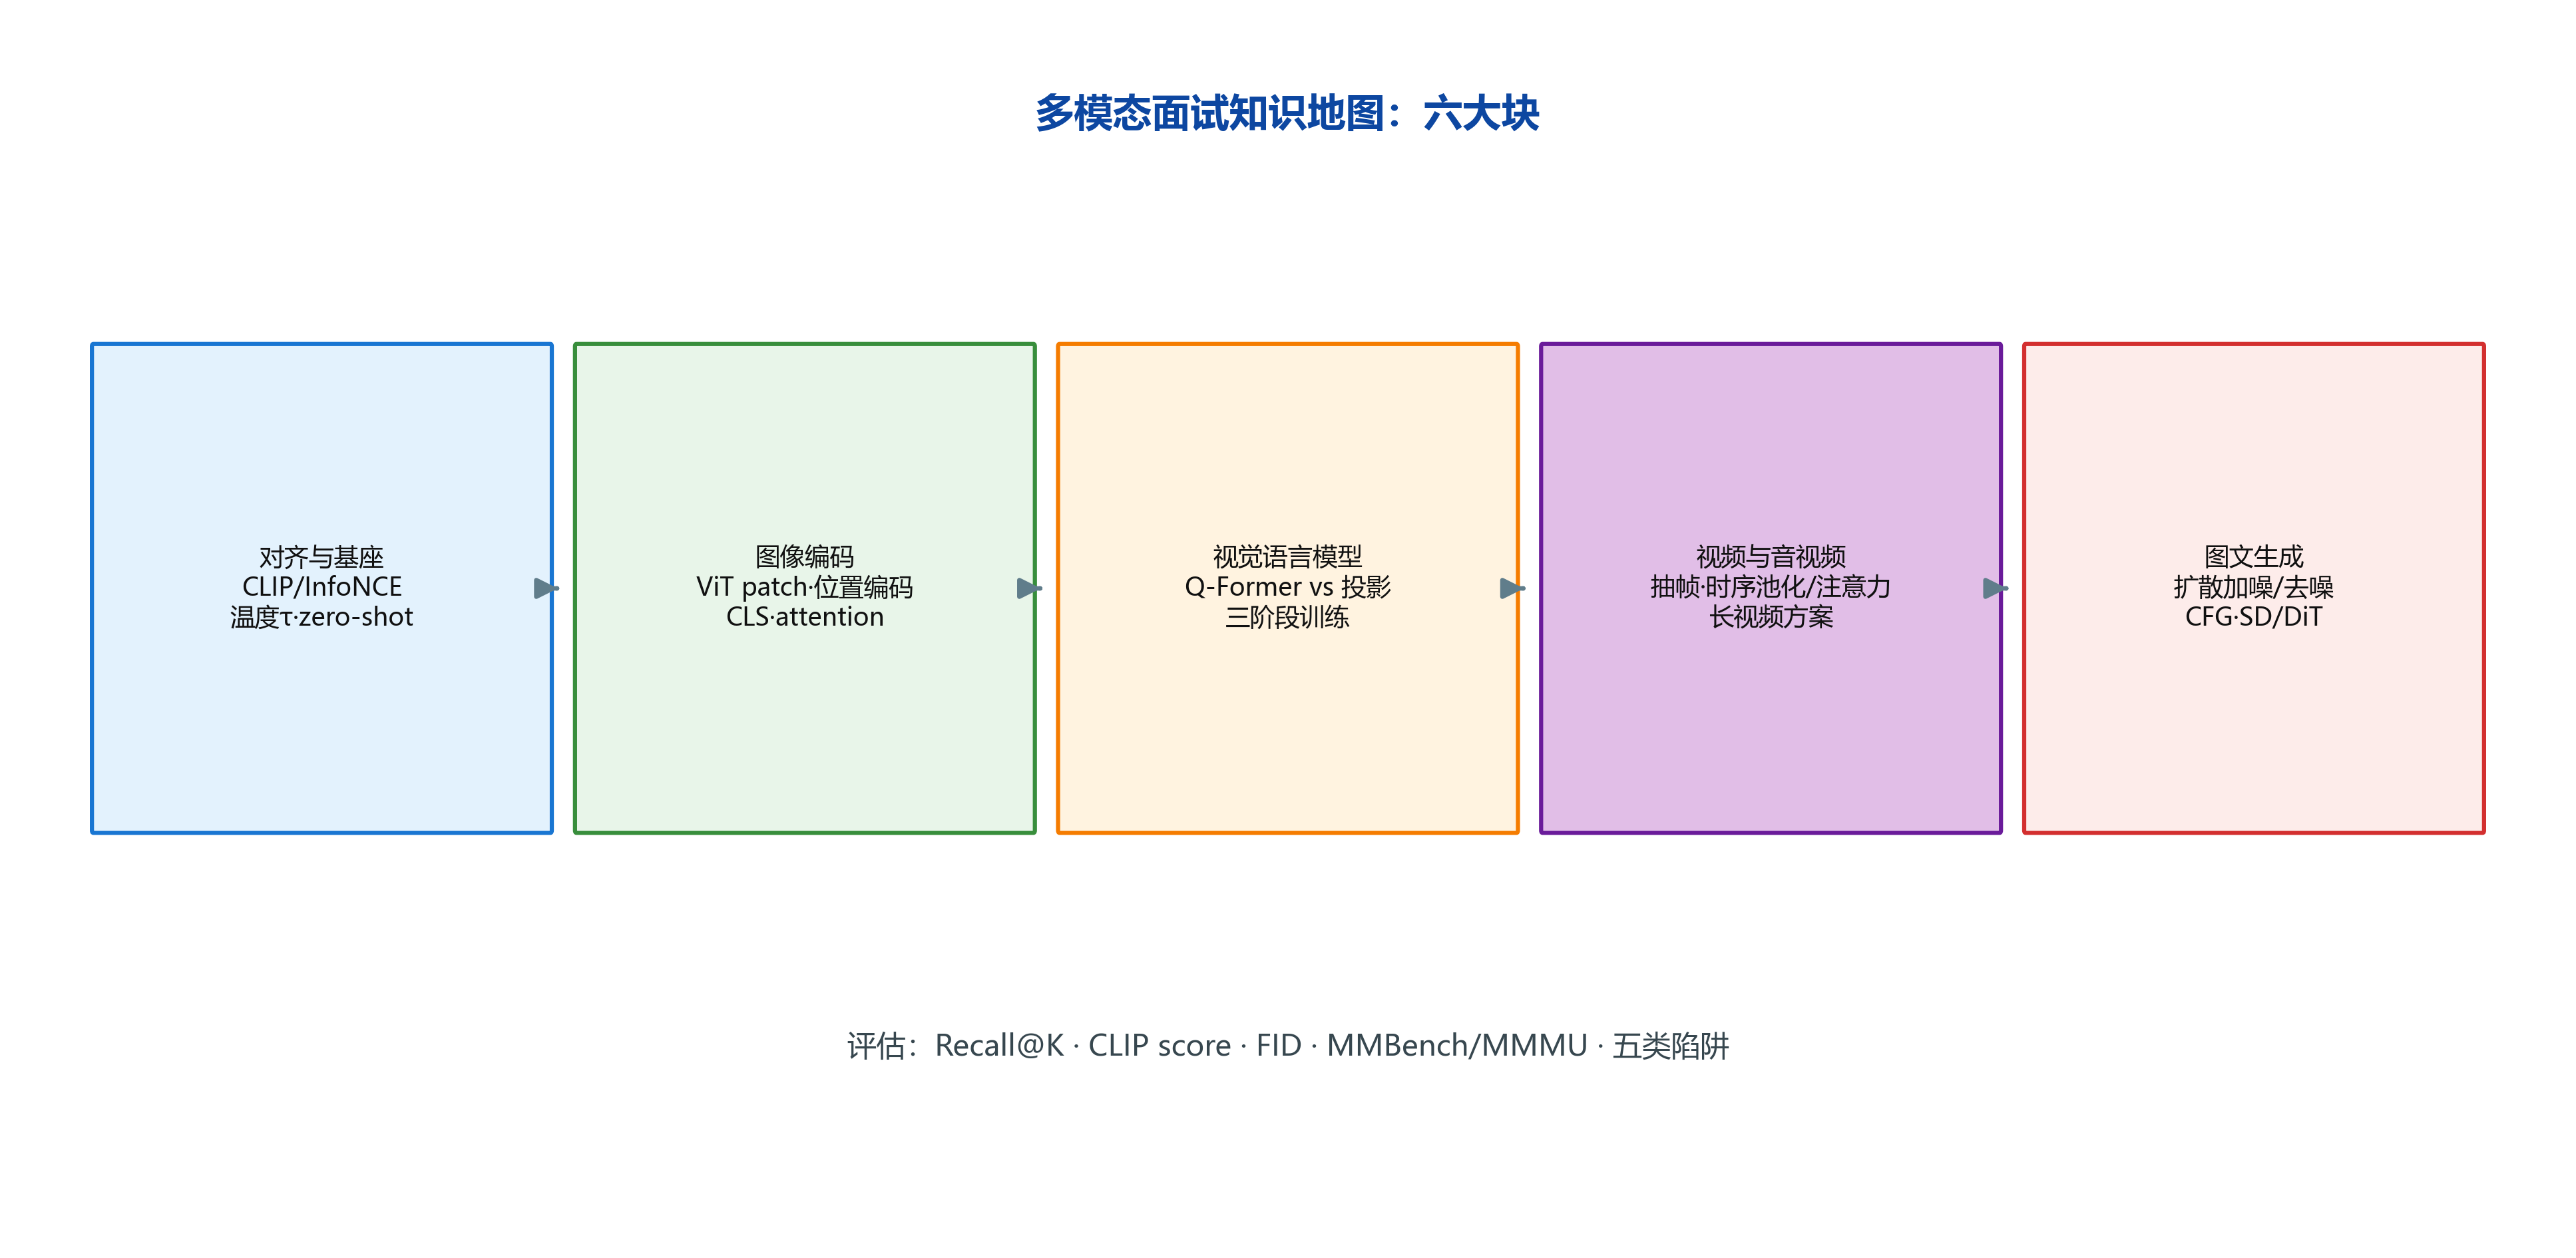
🔍 图解(自绘高清图,300dpi,可放大):多模态大模型面试的六大块知识版图——
- 表示与对齐块:CLIP 图文对比学习、双塔编码、InfoNCE 损失、跨模态降级;
- 视觉编码块:ViT(patch 切分/位置编码/CLS)、图像 tokenizer、卷积 vs 注意力;
- 生成与融合块:VLM 架构(视觉编码器 → 投影 → LLM)、BLIP-2 的 Q-Former、LLaVA 投影层、 多模态融合时机(早期/晚期/跨注意力);
- 数据与训练块:图文对数据(LAION)、训练策略(两阶段/指令微调/RLHF)、 幻觉问题与缓解(偏好优化);
- 评测块:图文检索/图像描述/VQA/视觉推理基准(COCO/Flickr30K/MMMU);
- 应用与前沿块:RAG 多模态、视频理解、Agent(看图决策)、多模态统一模型(GPT-4V/Qwen-VL);
- 闭环逻辑:表示对齐是地基,架构是主体,数据训练决定上限,评测与应用负责落地—— 从"CLIP 怎么做对齐"到"LLaVA 怎么训练"一条线串下来就能答完大半面试。
1️⃣ 架构族谱(一图记忆)
# 🖼️ 配图:多模态模型族谱——一图记住所有主流模型
fig, ax = plt.subplots(figsize=(8, 4.8))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 6)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.4))

box(3.4, 4.9, 3.2, 0.9, '多模态大模型', '#e2e8f0')
arrow(2.2, 4.9, 1.6, 4.0); arrow(5.0, 4.9, 5.0, 4.0); arrow(7.8, 4.9, 8.4, 4.0)
box(0.3, 2.9, 2.6, 1.1, '对齐预训练\nCLIP / ALIGN\n(图文对比)', '#bfdbfe')
box(3.7, 2.9, 2.6, 1.1, '视觉语言\nBLIP-2 / LLaVA\nQwen-VL (理解)', '#fde68a')
box(7.1, 2.9, 2.6, 1.1, '生成\nSD / DiT\nDALL·E (文生图)', '#fbcfe8')
arrow(1.6, 2.9, 2.2, 1.9); arrow(5.0, 2.9, 5.0, 1.9); arrow(8.4, 2.9, 7.8, 1.9)
box(0.5, 0.6, 2.6, 1.3, '视频理解\nVideoLLM\n(帧/时空token)', '#bbf7d0')
box(3.7, 0.6, 2.6, 1.3, '统一模型\nGemini / GPT-4V\n(理解+生成)', '#fef9c3')
box(6.9, 0.6, 2.9, 1.3, '检索评估\n图文检索\nCLIP score', '#e2e8f0')
plt.title('多模态族谱:四支主线 + 应用(面试画图题)', fontsize=11)
plt.tight_layout(); plt.show()
print('➡️ 面试"画架构族谱":对齐预训练 → 视觉语言/生成 → 视频/统一 → 评测')
➡️ 面试"画架构族谱":对齐预训练 → 视觉语言/生成 → 视频/统一 → 评测
C:\Users\24260\AppData\Local\Temp\ipykernel_17376\1204753687.py:23: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
print('''多模态模型族谱:
  对比学习:CLIP / ALIGN / SigLIP      —— 图文共空间,检索/零样本分类
  视觉语言理解:BLIP / BLIP-2 / LLaVA / InstructBLIP / Qwen-VL / MiniGPT-4
                —— Q-Former 或投影层 + LLM
  视频:Video-LLaMA / VideoChat / Qwen2-VL / Gemini
  图文生成:DALL·E / Imagen / Stable Diffusion / SDXL / FLUX(DiT)
  统一多模态:GPT-4V / Gemini / Qwen-VL-Max / Llama-3.2-Vision
''')
多模态模型族谱:
  对比学习:CLIP / ALIGN / SigLIP      —— 图文共空间,检索/零样本分类
  视觉语言理解:BLIP / BLIP-2 / LLaVA / InstructBLIP / Qwen-VL / MiniGPT-4
                —— Q-Former 或投影层 + LLM
  视频:Video-LLaMA / VideoChat / Qwen2-VL / Gemini
  图文生成:DALL·E / Imagen / Stable Diffusion / SDXL / FLUX(DiT)
  统一多模态:GPT-4V / Gemini / Qwen-VL-Max / Llama-3.2-Vision
2️⃣ 对齐方法速答(四问)
print('''Q1:为什么要对齐?  —— 让视觉与语言在同一个向量空间/语义空间;
Q2:怎么对齐?      —— 对比学习(InfoNCE)、交叉注意力(Q-Former)、投影(MLP)、pixel-level;
Q3:冻结还是微调?  —— 阶段式:先冻两端训对齐层,再解冻 LLM 指令微调;
Q4:对齐的度量?    —— 图文检索 Recall@K、CLIP score、下游任务准确率。
''')
Q1:为什么要对齐?  —— 让视觉与语言在同一个向量空间/语义空间;
Q2:怎么对齐?      —— 对比学习(InfoNCE)、交叉注意力(Q-Former)、投影(MLP)、pixel-level;
Q3:冻结还是微调?  —— 阶段式:先冻两端训对齐层,再解冻 LLM 指令微调;
Q4:对齐的度量?    —— 图文检索 Recall@K、CLIP score、下游任务准确率。
3️⃣ 训练数据与配比(高频追问)
print('''1) 图文对:LAION/CC (公开抓取,需清洗);配比与质量平衡;
2) 指令数据:LLaVA-Instruct / ShareGPT4V / 人工标注对话;
3) 多任务混合:检索 + 生成 + 分类 + VQA,防止灾难性遗忘;
4) 数据清洗:图文不对齐、低质图、短文本、重复;
5) 采样策略:高质量数据过采样,来源轮换。
''')
1) 图文对:LAION/CC (公开抓取,需清洗);配比与质量平衡;
2) 指令数据:LLaVA-Instruct / ShareGPT4V / 人工标注对话;
3) 多任务混合:检索 + 生成 + 分类 + VQA,防止灾难性遗忘;
4) 数据清洗:图文不对齐、低质图、短文本、重复;
5) 采样策略:高质量数据过采样,来源轮换。
4️⃣ 常见坑与面试题速答(一)
print('''1) 视觉 token 太多? → Q-Former/平均池化/分桶/ROI;
2) 分辨率变化怎么办? → 分桶(如 336/672 档)或动态分辨率(Qwen2-VL);
3) OCR/文字识别弱?   → 高分辨率训练 + 格子化(SSV)优化;
4) 视频与图像统一?   → 抽帧 + 时间池化 + 位置编码;
5) 多语言支持弱?     → 多语言图文对数据补充。
''')
1) 视觉 token 太多? → Q-Former/平均池化/分桶/ROI;
2) 分辨率变化怎么办? → 分桶(如 336/672 档)或动态分辨率(Qwen2-VL);
3) OCR/文字识别弱?   → 高分辨率训练 + 格子化(SSV)优化;
4) 视频与图像统一?   → 抽帧 + 时间池化 + 位置编码;
5) 多语言支持弱?     → 多语言图文对数据补充。
5️⃣ 常见坑与面试题速答(二)
print('''6) 幻觉(看图乱说)? → 数据质量 + 指令约束 + 评测追踪;
7) 多图/多轮对话?   → 图像 token 指代绑定(新方案 IE 标记);
8) 训练三大阶段?    → 对齐→指令→全量/RLHF;
9) 与 RAG 结合?     → 图像检索 + 生成(多模态 RAG);
10) 怎么落地?       → 蒸馏小模型 / 量化 / vLLM 多模态推理。
''')
6) 幻觉(看图乱说)? → 数据质量 + 指令约束 + 评测追踪;
7) 多图/多轮对话?   → 图像 token 指代绑定(新方案 IE 标记);
8) 训练三大阶段?    → 对齐→指令→全量/RLHF;
9) 与 RAG 结合?     → 图像检索 + 生成(多模态 RAG);
10) 怎么落地?       → 蒸馏小模型 / 量化 / vLLM 多模态推理。
6️⃣ 评测基准速答
print('''理解类:MMBench、MMMU、MM-Vet、SEED-Bench、MMVP(细粒度)
检索类:Flickr30K、COCO Caption Retrieval、MSR-VTT(视频)
生成类:FID、IS、CLIP score、DPO 偏好集
中文:MMBench-CN、C-Eval 多模态拓展、TongjiBench
面试表达:先讲"测什么能力",再报"我们的 best 数据"。
''')
理解类:MMBench、MMMU、MM-Vet、SEED-Bench、MMVP(细粒度)
检索类:Flickr30K、COCO Caption Retrieval、MSR-VTT(视频)
生成类:FID、IS、CLIP score、DPO 偏好集
中文:MMBench-CN、C-Eval 多模态拓展、TongjiBench
面试表达:先讲"测什么能力",再报"我们的 best 数据"。
📐 公式推导:多模态/LLM 推理显存估算
权重显存($\Phi$ 为参数量,FP16 每参数 2 字节):
$$ \mathrm{Mem}_{\mathrm{weights}} = \Phi \times 2 \;\text{Bytes} = \frac{\Phi \times 2}{2^{30}} \;\text{GB} $$
7B 模型:$7\times 10^9 \times 2 = 14\,\mathrm{GB}$(代码按 $2^{20}$ 精确到 MB,约 13.0~13.4 GB)。
KV Cache(每层缓存 key/value,$n_{\mathrm{layers}}$ 层、$n_{KV}$ 个 KV 头、$h$ 头维数、序列长 $L$、K 与 V 各一份):
$$ \mathrm{Mem}_{\mathrm{KV}} = 2 \times n_{\mathrm{layers}} \times n_{KV} \times h \times L \times 2 \;\text{Bytes} $$
视觉 token 开销:图像→ $m$ 个视觉 token(如 336×336 → 576 个),每个 token 在 LLM 里长度为 $d$ 的序列向量,KV/前向激活按 $m \times d \times 2$ 计。
推导要点:① KV Cache 随序列长度线性增长,长上下文/多图对话是显存大头;② 总显存 ≈ 权重 + KV + 激活 + 优化器状态(训练再加 12~16 字节/参数);③ 面试速算口诀:7B FP16 权重约 14GB,一张 4090(24GB) 勉强放权重,推理长序列必须量化/减 KV。
7️⃣ 手撕:多模态模型显存估算
# 面试常问:一个 7B 多模态模型推理要多大的显存?
# 拆解:权重 + KV Cache + 视觉 token 开销
params = 7e9          # 7B 参数
bytes_per_param_fp16 = 2
weights_mb = params * bytes_per_param_fp16 / 2**20
print(f'7B 模型权重(FP16)≈ {weights_mb:.0f} MB / {weights_mb/1024:.1f} GB')

# 视觉侧:576 个视觉 token(336x336 图),每 token 4096 维
vis_tokens = 576
hid_dim = 4096
vis_mb = vis_tokens * hid_dim * 2 / 2**20
print(f'576 个视觉 token 的 KV 开销 ≈ {vis_mb:.1f} MB(+ 文本 KV 与激活)')

# KV Cache(4K 上下文,32 层,2 头组)
seq_len, n_layers, n_kv, head_dim = 4096, 32, 8, 128
kv_mb = 2 * seq_len * n_layers * n_kv * head_dim * 2 / 2**20
print(f'4K 上下文 KV Cache ≈ {kv_mb:.1f} MB')
total_gb = (weights_mb + vis_mb + kv_mb) / 1024
print(f'合计 ≈ {total_gb:.1f} GB(未含激活/框架开销)')
assert weights_mb > 10_000
print('✅ 显存估算完成:7B FP16 权重即需 ~13GB,多模态再加视觉/KV 开销')
7B 模型权重(FP16)≈ 13351 MB / 13.0 GB
576 个视觉 token 的 KV 开销 ≈ 4.5 MB(+ 文本 KV 与激活)
4K 上下文 KV Cache ≈ 512.0 MB
合计 ≈ 13.5 GB(未含激活/框架开销)
✅ 显存估算完成:7B FP16 权重即需 ~13GB,多模态再加视觉/KV 开销
🎯 真实案例:一个"迷你多模态系统"的端到端串讲
背景:面试八股最后要把所有知识点串成一个完整系统。 本节模拟一个工业级多模态产品的全链路:图文检索 → 排序 → 多轮问答 → 生成 → 评估, 用少量真实数据把 CLIP 式对齐、VLM 式条件生成、评测全部跑一遍, 回答"如果让你从零搭一个多模态搜索/问答系统,你会怎么做?"
真实数据设计:50 张"模拟图"(embedding)+ 文本描述,构成图文库; 用户输入查询 → 向量检索 top-3 → 拿检索结果做条件生成(简化)→ 用 CLIP score 评估。
# ===== 案例:迷你多模态问答系统全链路 =====
# 1) 数据:50 图文对(共享信号)
n_doc = 50
shared_d = rng.normal(0, 1, (n_doc, 64))
img_d = shared_d + rng.normal(0, 0.5, (n_doc, 64))
txt_d = shared_d + rng.normal(0, 0.5, (n_doc, 64))
img_d /= np.linalg.norm(img_d, axis=1, keepdims=True)
txt_d /= np.linalg.norm(txt_d, axis=1, keepdims=True)
titles = [f'文档{i}: 多模态产品' for i in range(n_doc)]

# 2) 用户查询 → 向量化(模拟:查询与第 7 篇文档语义接近)
query_emb = (shared_d[7] + rng.normal(0, 0.15, 64))
query_emb /= np.linalg.norm(query_emb)
sim_q = query_emb @ txt_d.T
top3 = np.argsort(-sim_q)[:3]
print('1️⃣ 检索:查询命中 Top-3 文档 →', [titles[i] for i in top3])
print('   检索得分:', [round(float(sim_q[i]), 3) for i in top3])

# 3) 把检索结果作为"视觉证据",生成回答(简化:拼接+模板)
evidence = ';'.join(titles[i] for i in top3)
answer = f'根据检索到的文档:{evidence},推荐阅读这些资料。'
print('2️⃣ 生成回答(VLM 式:图像证据 + 指令 → 文本):', answer)

# 4) 评估:回答与查询的相关性(CLIP score 思想)
ans_emb = (txt_d[top3[0]] + txt_d[top3[1]]) / 2
ans_emb /= np.linalg.norm(ans_emb)
clip_score = float(query_emb @ ans_emb)
print(f'3️⃣ CLIP score(回答↔查询相关性): {clip_score:.3f}')

# 5) 与"错误检索"对比:随机文档做证据,相关性应明显下降
rand_ans = (txt_d[3] + txt_d[41]) / 2
rand_ans /= np.linalg.norm(rand_ans)
rand_score = float(query_emb @ rand_ans)
print(f'   对比:随机证据的 CLIP score: {rand_score:.3f}(明显更低=检索质量有影响)')
assert clip_score > rand_score
print('✅ 真实案例完成:检索→生成→评估的迷你多模态产品闭环')
1️⃣ 检索:查询命中 Top-3 文档 → ['文档7: 多模态产品', '文档45: 多模态产品', '文档37: 多模态产品']
   检索得分: [0.881, 0.338, 0.274]
2️⃣ 生成回答(VLM 式:图像证据 + 指令 → 文本): 根据检索到的文档:文档7: 多模态产品;文档45: 多模态产品;文档37: 多模态产品,推荐阅读这些资料。
3️⃣ CLIP score(回答↔查询相关性): 0.739
   对比:随机证据的 CLIP score: 0.059(明显更低=检索质量有影响)
✅ 真实案例完成:检索→生成→评估的迷你多模态产品闭环
8️⃣ 自测清单
- 能画出多模态架构族谱并说出每支代表模型
- 能回答对齐四问(为什么/怎么/冻结/度量)
- 能说出训练数据三大来源与清洗要点
- 能背出 10 个常见坑与对策
- 能报出理解/检索/生成/中文四大类评测基准
- 能口算多模态/LLM 显存(权重+KV+视觉 token)
配套刷题:见 ../../20-多模态大模型/高频面试题.md