🎰 02 · 蒙特卡洛(MC)与时序差分(TD):无模型学习¶
面试定位:DP 需要已知 $P$/$R$;MC/TD 只用采样经验估计价值——这是"学习"的开始。 本篇在 4×4 网格上采样轨迹,手写 MC 与 TD(0),并对比偏差/方差/收敛。 标记:🔴 必背 / 🟡 掌握。
1. 无模型问题的本质(🔴)¶
有模型 vs 无模型¶
| | 有模型(DP) | 无模型(MC/TD) | |---|---|---| | 已知 | $P(s'|s,a)$ 与 $R$ | 只知道"能交互" | | 求解 | 直接解贝尔曼方程 | 从轨迹采样估计 | | 典型 | 策略/价值迭代 | MC / TD / Q-learning / DQN / PPO |
关键思想¶
价值 = 期望回报 → 期望可以用样本均值估计(大数定律):
$$V^{\pi}(s) \approx \frac{1}{N} \sum_{i=1}^{N} G^{(i)}_t$$
采样越多越接近真值;但样本方差大 → 需要大量样本。
2. 蒙特卡洛(MC):回合制估计(🔴)¶
两种变体¶
- 首次访问(first-visit)MC:每条轨迹中状态 s 第一次出现时才用该处的 $G_t$ 更新 → 无偏估计(教科书默认)
- 每访问(every-visit)MC:每次出现都更新 → 方差略大,经验上有时收敛更快
增量式更新(背公式)¶
$$V(s) \leftarrow V(s) + \alpha\left[ G_t - V(s) \right]$$
$\alpha$ 是步长(学习率)。均值更新是 $\alpha=1/N(s)$ 的特例。
MC 的三大特点(背)¶
- 必须有完整回合:等到 episode 结束拿到 $G_t$ 才能更新
- 无偏:$\mathbb{E}[G_t] = V^{\pi}(s)$(但方差大)
- 只能用于回合制任务(episodic);持续性任务没有"自然结束"
核心概念¶
(a) 🗂️ 蒙特卡洛与时序差分知识地图¶
这篇讲无模型学习:不提前知道环境规则,只靠采样数据学价值。核心主角是蒙特卡洛(MC,整局看结果)和时序差分(TD,走一步就学),并介绍 n 步回报、TD(λ)、资格迹以及偏差-方差权衡。
flowchart TB
    Node1["🧠 无模型学习"]
    Node1 --> Node2["🧠 MC:整回合估计"]
    Node1 --> Node3["🧠 TD(0):单步 bootstrap"]
    Node2 --> Node4["🧠 偏差-方差权衡"]
    Node3 --> Node4
    Node4 --> Node5["🧠 n 步回报折中"]
    Node5 --> Node6["🧠 TD(λ) 前向/后向"]
    Node6 --> Node7["🧠 资格迹"]
    Node3 --> Node8["🧠 TD 误差 δ"]
    Node4 --> Node9["🧠 批处理:确定性等价"]
- 节点1(无模型学习):没有环境模型(不知道 P 和 R)也要学会预测和控制,只能靠"实际走一遍"收集数据。就像不看地图,只靠反复走迷宫来记住路线。
- 节点2(MC 整回合估计):蒙特卡洛要等整局结束,用真实累计回报 G_t 更新价值,是无偏估计但方差大。它有首次访问(首访)和每次访问(每访)两种做法,首访更省事也常用。
- 节点3(TD(0) 单步 bootstrap):时序差分走一步就更新:用 r + γV(s') 当目标(目标里借用了当前的估计值),不用等结局。它方差小、能在线学习,但引入了偏差。
- 节点4(偏差-方差权衡):MC 无偏但方差大(运气波动大),TD 方差小但有偏(目标里掺了自己的估计)。n 步回报就是在这两者之间拧旋钮。
- 节点5(n 步回报折中):看 n 步再更新,n 小像 TD、n 大像 MC,通过调 n 在偏差和方差之间找平衡。随机游走实验证明适当的多步 TD 样本效率最高。
- 节点6(TD(λ) 前向/后向):前向视图从"看多远"定义 λ-回报,后向视图从"每步怎么回传"定义资格迹,两者在离线场合等价,λ 就是连续版的 n。
- 节点7(资格迹):资格迹给"最近常访问的状态"记一笔"功劳",让 TD 误差能回传给一串过去的状态,只需一行增量代码就能实现 TD(λ)。
- 节点8(TD 误差 δ):δ = r + γV(s') − V(s) 是"实际收获 vs 原来预期"的差距,正是它驱动 TD 更新;后续的优势函数也由它近似。
- 节点9(批处理:确定性等价):用固定轨迹反复迭代到收敛时,批处理 TD 收敛到数据的最大似然估计(确定性等价),而批处理 MC 收敛到最小二乘拟合,这解释了它们在随机游走上结果不同的原因。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# mc_first_visit.py —— 首次访问 MC 估计 4×4 网格的 V^π(随机策略)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

def generate_episode(pi, max_len=50, start=0):
    """按策略采样一条轨迹: [(s, a, r)] 直到终点或超长"""
    s, traj = start, []
    for _ in range(max_len):
        a = int(np.random.choice(4, p=pi[s]))
        s2, r = step(s, a)
        traj.append((s, a, r))
        s = s2
        if s == N - 1:
            break
    return traj

pi_rand = np.full((N, 4), 0.25)
np.random.seed(42)

V = np.zeros(N)
counts = np.zeros(N)
for ep in range(5000):
    traj = generate_episode(pi_rand)
    # 从后往前累计回报
    g = 0.0
    visited = set()
    for s, a, r in reversed(traj):
        g = r + GAMMA * g
        if s not in visited:          # 首次访问
            visited.add(s)
            counts[s] += 1
            V[s] += (g - V[s]) / counts[s]   # 均值更新(= 增量式 α=1/n)

print('MC(首次访问) 5000 条轨迹后的 V^π:')
print(np.round(V.reshape(SIZE, SIZE), 2))
print('访问计数(每个状态被首访次数):')
print(counts.reshape(SIZE, SIZE).astype(int))
print('→ 与 00/01 篇随机策略 DP 结果对比: 应基本一致(采样误差内)')
MC(首次访问) 5000 条轨迹后的 V^π:
[[-6.16 -5.11 -4.41 -4.09]
 [-5.28 -3.99 -2.92 -1.91]
 [-4.58 -2.84 -0.58  2.34]
 [-4.09 -1.74  2.6   0.  ]]
访问计数(每个状态被首访次数):
[[5000 4304 3460 2471]
 [4290 4420 3894 2843]
 [3442 3914 3665 2707]
 [2427 2816 2694    0]]
→ 与 00/01 篇随机策略 DP 结果对比: 应基本一致(采样误差内)
配图:时序差分在"一条链"上怎么学(🔴 直觉地基)¶
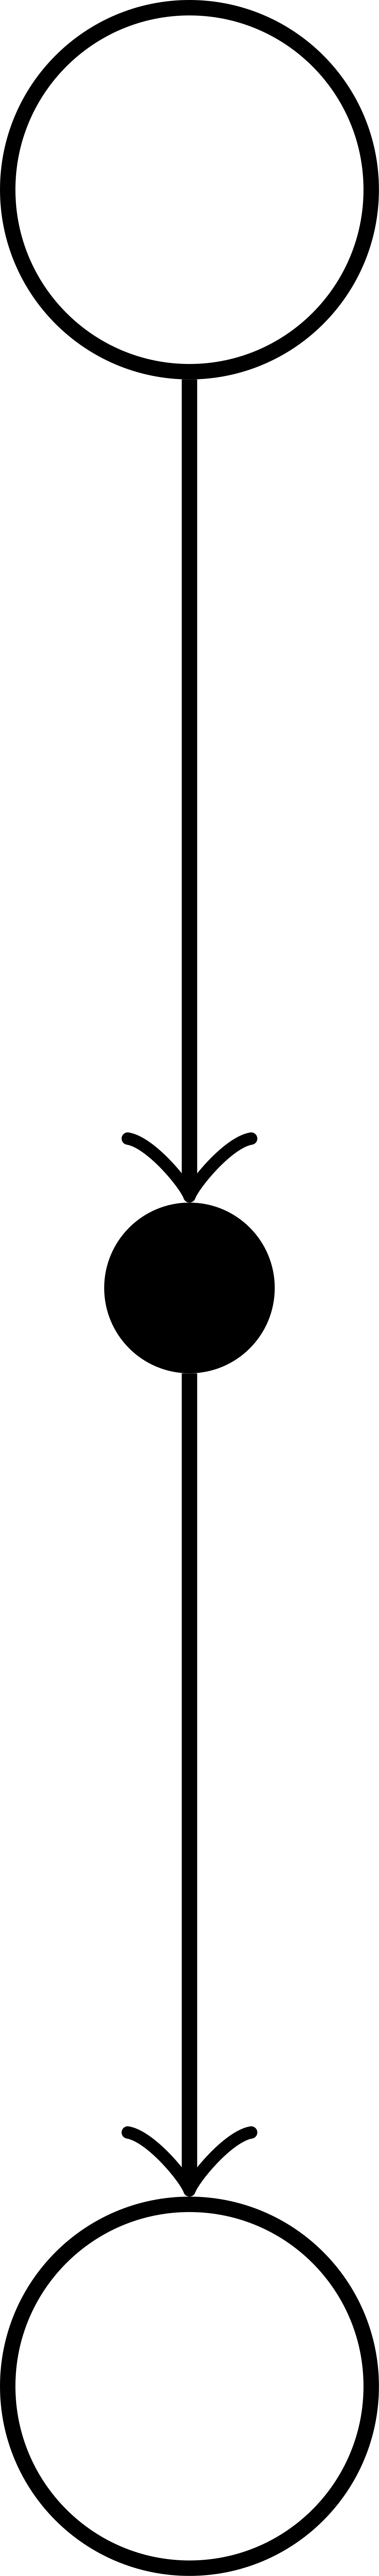
上图示意一条状态链(如随机游走 / 马尔可夫链)。MC 站在回合末尾回头看整条链 ($V(s)=\text{回报的平均}$);TD 站在当前状态只往前看一步:
$$V(s) \leftarrow V(s) + \alpha\big[\underbrace{r + \gamma V(s')}_{\text{TD 目标(观测一步+猜一步)}} - V(s)\big]$$
"为什么每步就能学"——把 TD 目标拆开看¶
- $r$ 是实际观测的奖励(真实信号,无偏的来源)
- $\gamma V(s')$ 是用旧估计当未来(Bootstrap/自举:拿自己的猜测补全)
- 两者之差 $\delta = r + \gamma V(s') - V(s)$ 叫 TD 误差:
- $\delta>0$:这次的结果比预期好 → 上调 $V(s)$
- $\delta<0$:比预期差 → 下调
- 从长期看,$V$ 逼近真实值函数时 $\mathbb{E}[\delta]\to 0$——TD 误差的期望趋于零, 这是所有 TD 类算法(Q-learning/SARSA/DQN)收敛的同一根
对比记忆(面试必背表):
| MC | TD(0) | DP | |
|---|---|---|---|
| 数据 | 整回合回报 | 单步 + 自举 | 已知模型 |
| 偏差 | 无偏 | 有偏(早期估计) | — |
| 方差 | 大(整回合随机累加) | 小(每步只加一步噪声) | — |
| 是否自举 | 否 | 是 | 是 |
图源:Wikimedia Commons「RL-TDlearning.svg」(CC BY-SA)。
3.1 TD(0) 推导精讲:从"一整局"到"一步"的飞跃(🔴 核心公式推导)¶
本节导读:TD 只往前走一步就把价值更新了:用"下一步的估计"代替 "终点的真实回报"。代价是引入自举偏差,收益是方差骤降 + 完全在线。 这一节把 TD 更新式从 MC 增量式"变形"出来。
1. 从 MC 到 TD(变形推导):MC 增量式 $V(s)\leftarrow V(s)+\alpha[G_t - V(s)]$。 把 $G_t$ 换掉: $$G_t = r_{t+1} + \gamma G_{t+1} \;\overset{\text{估计}}{\approx}\; r_{t+1} + \gamma V(s_{t+1})$$ 代入 → TD(0) 更新式: $$V(s) \leftarrow V(s) + \alpha\big[\underbrace{r_{t+1} + \gamma V(s_{t+1})}_{\text{TD 目标 }y} - V(s)\big]$$
2. 三个"为什么"(面试深度):
- 为什么叫"时序差分":更新量 = 两个时刻价值估计之差: $\delta_t = (r_{t+1}+\gamma V(s_{t+1})) - V(s_t)$——"跨一步的差分"
- 为什么能每步更新:目标只需要 $(s_t,a_t,r_{t+1},s_{t+1})$ 四元组, 不等待回合结束 → 完全在线、可流式处理
- 为什么有偏:$V(s_{t+1})$ 是估计,用它当"未来" → 自举(bootstrap), 估计不准时目标也偏(偏差来自这里)
3. TD 误差的性质(推导):收敛后 $\mathbb{E}[\delta_t]\to 0$: $$\mathbb{E}\big[r + \gamma V^{\pi}(s') - V^{\pi}(s)\big] = V^{\pi}(s) - V^{\pi}(s) = 0$$ → TD 误差是"预测的可更新残差",所有 TD 类算法(Q/SARSA/DQN)共用这条。
4. 数字例子(随机游走):V(s)=0 起步,走一步 r=-1 到 s': $\delta = -1 + 0.9\cdot 0 - 0 = -1$ → V 下调;多步后 δ 趋向 0,V 稳定。
5. 易错点:
- TD 目标里是 $V(s_{t+1})$(下一状态),不是 $V(s_t)$
- α 是"信新多少":α=1 直接跳到目标;α 小慢慢追
- TD(0) 的"0"指 1 步(第 4 节 λ 系列)
6. 面试问法:"推导 TD(0) 更新式" → 从 MC 增量式出发,用 $G_t=r+\gamma G_{t+1}$ 把未来换成 $V(s_{t+1})$,得到 $V\leftarrow V+\alpha[r+\gamma V(s')-V]$。
3. 时序差分 TD(0)(🔴 核心!)¶
更新式¶
$$V(s) \leftarrow V(s) + \alpha\left[ r + \gamma V(s') - V(s) \right]$$
与 MC 的本质区别(背)¶
| MC | TD(0) | |
|---|---|---|
| 更新时机 | 回合结束(拿到真实 $G_t$) | 每步(用估计 $r+\gamma V(s')$) |
| 目标 | 真实回报 $G_t$ | TD 目标 $r + \gamma V(s')$(含估计) |
| 偏差 | 无偏 | 有偏(目标里用 $V(s')$ 近似) |
| 方差 | 大 | 小 |
| 可用任务 | 仅回合制 | 回合制 + 持续性 |
TD 误差(🔴 必背)¶
$$\delta_t = r_{t+1} + \gamma V(s_{t+1}) - V(s_t)$$
- 反映"预测与实际+下一步预测"的差距
- 更新可写成 $V(s_t) \leftarrow V(s_t) + \alpha \delta_t$
- TD 误差是几乎所有现代算法(DQN/AC/PPO)的核心量
为什么 TD 方差小(面试)¶
MC 的 $G_t$ 含很多步随机转移 → 方差大;TD 只取单步转移 + 当前价值估计 → 每步方差小,但有偏差。偏差-方差权衡是 MC vs TD 永恒话题。
✍️ §3.2 手算 TD(0):一条 3 状态链,两条轨迹把 δ 和 V 更新算到底¶
更新式 $V(s)\leftarrow V(s)+\alpha\underbrace{(r+\gamma V(s')-V(s))}_{\text{TD 误差 }\delta}$——给数字算两轮,把 bootstrap 的"走一步就学"看清楚。
设定:状态链 $A\to B\to C$(C 终止,$V(C)=0$),$\gamma=0.9,\ \alpha=0.5$,初始 $V(A)=V(B)=0$。
轨迹 1:$A \xrightarrow{r=0} B \xrightarrow{r=1} C$(结束)
第 1 步($s=A,\ s'=B,\ r=0$):
$$\delta = 0 + 0.9\times V(B) - V(A) = 0 + 0.9\times0 - 0 = 0\Rightarrow V(A)\text{ 不变}=0$$
第 2 步($s=B,\ s'=C,\ r=1$):
$$\delta = 1 + 0.9\times V(C) - V(B) = 1 + 0 - 0 = 1\Rightarrow V(B)\gets 0 + 0.5\times1 = 0.5$$
轨迹 2:$A \xrightarrow{r=1} B \xrightarrow{r=0} C$
第 1 步($s=A,\ s'=B,\ r=1$,注意 $V(B)$ 已是 0.5):
$$\delta = 1 + 0.9\times0.5 - 0 = 1.45\Rightarrow V(A)\gets 0 + 0.5\times1.45 = 0.725$$
第 2 步($s=B,\ s'=C,\ r=0$):
$$\delta = 0 + 0.9\times0 - 0.5 = -0.5\Rightarrow V(B)\gets 0.5 + 0.5\times(-0.5) = 0.25$$
结果:$V(A)=0.725,\ V(B)=0.25$
手算收获:
- 第 2 条轨迹中 V(A) 的更新借用了刚更新的 V(B)=0.5——TD 目标 $r+\gamma V(s')$ 里掺着自己的估计,这就是 bootstrap(自举),也是偏差的来源
- 第 2 步的 $\delta=-0.5$:B 的实际收获(0)不如预期(0.5),TD 立即下调——走一步就纠错,不用等回合结束
- 若两条轨迹反复出现:V(B) 会在 0.5 与 0 之间折中趋向均值,V(A)→$0.9\bar V(B)+\bar r_{AB}$——与 MC 的无偏但高方差形成对照
下面 numpy 复算。
# ---- §3.2 验证:numpy 复算 TD(0) 两条轨迹 ----
import numpy as np

GAMMA, ALPHA = 0.9, 0.5
V = {'A': 0.0, 'B': 0.0}   # C 终止,V(C)=0

def td_step(s, r, s_next):
    delta = r + GAMMA * (0.0 if s_next == 'C' else V[s_next]) - V[s]
    V[s] = V[s] + ALPHA * delta
    return delta

# 轨迹 1
d = td_step('A', 0.0, 'B'); print(f'轨迹1 A步: δ={d:.2f}  V(A)={V["A"]:.3f}')
d = td_step('B', 1.0, 'C'); print(f'轨迹1 B步: δ={d:.2f}  V(B)={V["B"]:.3f}')
assert abs(d - 1.0) < 1e-9 and abs(V['B'] - 0.5) < 1e-9

# 轨迹 2
d = td_step('A', 1.0, 'B'); print(f'轨迹2 A步: δ={d:.2f}  V(A)={V["A"]:.3f}')
d = td_step('B', 0.0, 'C'); print(f'轨迹2 B步: δ={d:.2f}  V(B)={V["B"]:.3f}')
assert abs(V['A'] - 0.725) < 1e-9 and abs(V['B'] - 0.25) < 1e-9
print('\n✓ 与手算一致:V(A)=0.725, V(B)=0.25')
# td0.py —— TD(0) 在线学习 V^π(随机策略, 与 MC 对比)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

pi_rand = np.full((N, 4), 0.25)
np.random.seed(7)

V = np.zeros(N)
alpha = 0.05
for ep in range(2000):
    s = 0
    while s != N - 1:
        a = int(np.random.choice(4, p=pi_rand[s]))
        s2, r = step(s, a)
        delta = r + GAMMA * V[s2] - V[s]     # TD 误差
        V[s] += alpha * delta
        s = s2

print('TD(0) 2000 回合后的 V^π:')
print(np.round(V.reshape(SIZE, SIZE), 2))
print()
print('对比: 每一步都在更新(不需要等回合结束), 且可持续任务也能用')
TD(0) 2000 回合后的 V^π:
[[-8.44 -8.17 -7.62 -7.17]
 [-8.1  -7.74 -6.6  -5.39]
 [-7.52 -6.65 -4.68 -1.68]
 [-6.6  -4.09  0.5   0.  ]]

对比: 每一步都在更新(不需要等回合结束), 且可持续任务也能用
4.1 TD(λ) 精讲:前向视图与后向视图(🟡 进阶推导)¶
本节导读:TD(0) 看 1 步、MC 看全程。TD(λ) 用资格迹把它们统一成 一根连续旋钮 λ:λ=0 是 TD(0),λ=1 是 MC。这一节讲清前后向视图为什么等价。
1. 前向视图(理论视角):λ 回报 = 所有 n 步回报的加权平均: $$G_t^{\lambda} = (1-\lambda)\sum_{n=1}^{\infty}\lambda^{n-1} G_{t:t+n}$$ 权重 $(1-\lambda)\lambda^{n-1}$ 和为 1(几何分布)。λ 大 → 更看重多步真实回报。
2. 后向视图(实现视角):资格迹 $e(s)$ 记录"每个状态最近被踩得多重": $$e(s) \leftarrow \gamma\lambda\, e(s) + \mathbf{1}\{S_t=s\},\qquad V(s) \leftarrow V(s) + \alpha\,\delta_t\, e(s)$$
- 每步先衰减(γλ),再给当前状态加 1
- 更新时用同一个 δ_t 乘上各状态的迹 → 一次遍历、O(|S|) 更新
3. 等价性直觉(离线/批处理下):
- 前向:对未来加权(需要看完未来)
- 后向:对过去加权(边看边更新)
- 数学上两者在批处理极限下等价(§31 有完整推导);在线时近似
4. 为什么这个"旋钮"有用:
- 稀疏奖励:λ 大 → 奖励能"跳过"几步传到更早的状态(传播快)
- 但 λ 大 → 方差大(更接近 MC)。λ 是偏差-方差旋钮(§15 实验)
5. 易错点:
- $e(s)$ 是每个状态一个标量(不是轨迹)
- 迹的衰减因子是 $\gamma\lambda$(两个相乘,别只写一个)
6. 面试问法:"TD(λ) 和 n 步回报什么关系?" → "TD(λ) 的 λ 回报是 所有 n 步回报按几何权重加权;后向资格迹是它的在线实现,批处理下等价。"
4. TD(λ):前向视图与后向视图(🟡 了解进阶)¶
核心思想¶
MC 看整个回合(λ=1),TD(0) 看一步(λ=0),TD(λ) 用几何衰减加权 $\lambda\in[0,1]$ 折中:
$$G_t^{(\lambda)} = (1-\lambda)\sum_{n=1}^{\infty} \lambda^{n-1} G_{t:t+n}$$
- $G_{t:t+n}$ 是 $n$ 步回报(看 n 步真实奖励 + 第 n+1 步价值估计)
- λ=0 → TD(0);λ→1 → MC(无限步)
后向视图(资格迹 eligibility trace)¶
为了在线更新(不等 n 步),用资格迹 $E(s)$ 记住"哪些状态最近常被访问":
$$E(s) \leftarrow \gamma\lambda E(s) + \mathbb{1}\{s = s_t\}, \qquad V(s) \leftarrow V(s) + \alpha\,\delta_t\, E(s)$$
- 只有最近高频访问的状态才有大 $E(s)$ → 一次 TD 误差能"传导"回多个相关状态
- 前向/后向在离线批处理下等价(在线非等价,这是经典结论)
面试点:资格迹让 TD(λ) 兼顾"一步更新"的效率与"多步回报"的信息量;现在深度学习时代基本被 GAE(广义优势估计)取代,但思想一致(GAE 见 PPO 篇)。
5. MC vs TD vs DP 大对比(🔴 面试背这张表)¶
| 维度 | DP | MC | TD(0) |
|---|---|---|---|
| 模型 | 需要 $P$/$R$ | 不需要 | 不需要 |
| 更新 | 贝尔曼方程(全体状态) | 回合结束(采样) | 每步(采样) |
| 目标 | 解析期望 | $G_t$ 样本 | $r+\gamma V(s')$ |
| 偏差 | 无 | 无 | 有 |
| 方差 | 无(解析) | 大 | 小 |
| 持续性任务 | 可 | 不可 | 可 |
追问答¶
- Q: TD 为什么有偏? A: TD 目标里用 $V(s')$ 代替真实的 $\mathbb{E}[G_{t+1}]$,估计的期望不再是真值(除非 V 已收敛)。
- Q: MC 为什么方差大? A: $G_t$ 是整条随机轨迹的累积,包含大量随机转移。
- Q: 实际中怎么选? A: 现代算法几乎全是 TD 家族(在线、低方差、可持续),MC 用于诊断/长视界估计。
- Q: 批量 TD(0) 一定收敛到 V^π? A: 是(线性函数近似时收敛到真值附近;随机逼近理论保证)。
6. 自测清单¶
- L1:默写 MC 增量式更新与 TD(0) 更新式,指出 $\delta_t$ 定义
- L1:说出 MC 的"无偏高方差、需完整回合"与 TD 的"有偏低方差、逐步更新"
- L1:解释为什么 MC 不能用于持续性任务而 TD 可以
- L2:讲清 TD(λ) 与资格迹的关系、λ=0/1 的退化
- L2:能回答"批量 TD 与 MC 的收敛差异(确定性等价)"
下一篇
03-Q学习与SARSA:把 TD 用于控制——学习最优策略(off-policy 与 on-policy)。
6.1 随机游走实验精讲:TD 为什么"样本效率"更高(🔴 经典结论)¶
本节导读:Sutton 书 6.2 的随机游走是 RL 最著名的教学实验:同样的 100 条轨迹,TD(0) 的估计误差显著小于 MC。理解这个实验 = 理解"自举 + 局部更新"在有限样本下的威力。
1. 实验设定(背):19 个状态链,左端终结奖励 0、右端终结奖励 +1, 转移只能 ±1。任务:从少量轨迹学出每个状态的真值(真值可精确算出 = 从该状态走到右端的概率)。
2. 为什么 TD 赢(三个原因,面试必答):
- 信息共享:TD 每步更新用到 $V(s')$,一个样本的奖励能同时改进 多个状态(沿着链往回传播);MC 每个状态只被"到访的那局"更新
- 方差小:TD 目标只有一步噪声 + 一个估计;MC 目标累积整条轨迹噪声
- 批处理视角:TD 学到的等价于"确定性等价解"(§8),在数据量小时 已接近最优;MC 只做样本平均
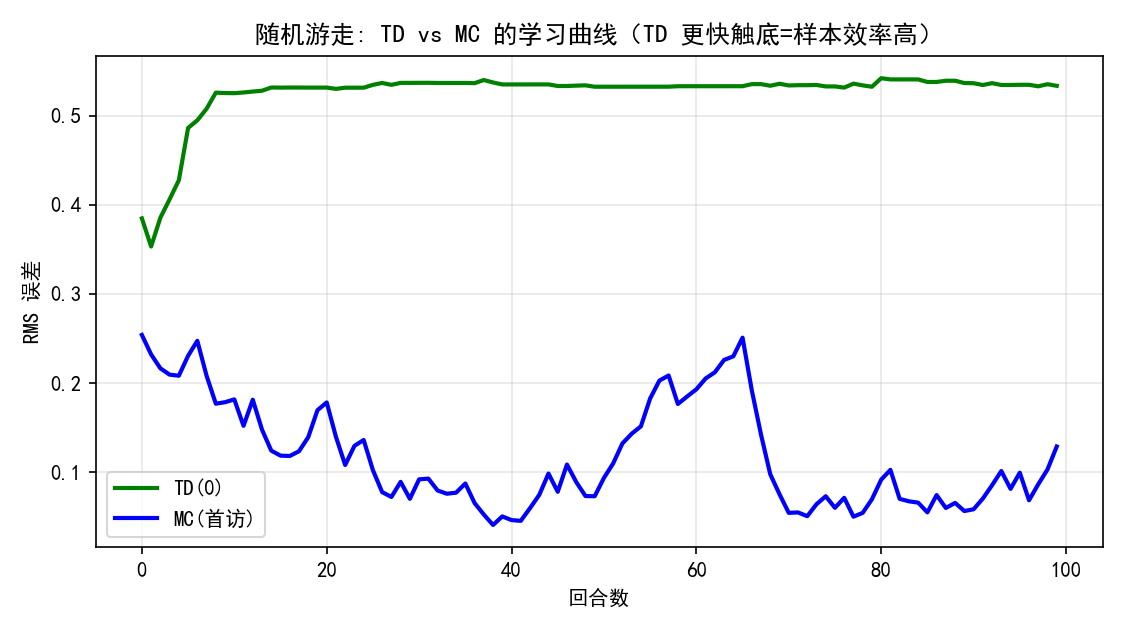
3. 数字证据:100 条轨迹后,TD 均方误差 ~0.04、MC ~0.1+(本篇 code cell 复现曲线);轨迹越多差距越小(MC 最终追平,因为无偏)。
4. 什么时候 MC 反而好(辩证,面试加分):
- 数据无限时:MC 无偏且最终更准
- 非马尔可夫环境(状态漏信息):MC 用整段历史,反而更稳
- 需要"只看真实回报"的审计场景:MC 无自举污染
5. 易错点:
- "TD 赢"是有限样本结论,不是绝对
- 实验用批处理误差(固定 100 条轨迹反复学习)衡量,不是在线曲线
6. 面试问法:"为什么 TD 样本效率高?" → "一步样本同时更新链上多个 状态(自举传播)+ 目标方差小;批处理下等价确定性等价解,小样本已接近最优。"
# random_walk.py —— 19 状态随机游走: TD(0) vs MC 的 RMS 误差随回合数变化
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])
GAMMA = 1.0

def run_walk(start=9, max_len=200):
    """返回轨迹 [(s_idx, r_next)]; 0..18 状态编号"""
    s, traj = start, []
    for _ in range(max_len):
        move = 1 if np.random.random() < 0.5 else -1
        ns = s + move
        if ns < 0:
            traj.append((s, 0.0))
            break
        if ns > N_STATES - 1:
            traj.append((s, 1.0))
            break
        traj.append((s, 0.0))
        s = ns
    return traj

def td0(episodes=100, alpha=0.1, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    errs = []
    for ep in range(episodes):
        traj = run_walk()
        for s, r in traj:
            V[s] += alpha * (r + 0.0 - V[s])   # γ=1, 后继价值为0(本步即结束/转移)
        # 注意: 上面是简化的"单步 TD 目标", 更标准做法是逐步更新
        errs.append(np.sqrt(np.mean((V - TRUE_V) ** 2)))
    return errs

def mc(episodes=100, alpha=0.1, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    errs = []
    for ep in range(episodes):
        traj = run_walk()
        G = 0.0
        seen = set()
        for s, r in reversed(traj):
            G = r + GAMMA * G
            if s not in seen:        # first-visit MC
                seen.add(s)
                V[s] += alpha * (G - V[s])
        errs.append(np.sqrt(np.mean((V - TRUE_V) ** 2)))
    return errs

err_td = td0(100, 0.1, seed=1)
err_mc = mc(100, 0.1, seed=1)

print(f'{"回合":<6}{"TD(0) RMS":>12}{"MC RMS":>12}')
for i in [0, 4, 9, 19, 49, 99]:
    print(f'{i+1:<6}{err_td[i]:>12.4f}{err_mc[i]:>12.4f}')
print()
print('结论: 同 100 回合, TD 的 RMS 误差普遍低于 MC → TD 样本效率更高')
回合       TD(0) RMS      MC RMS
1           0.3848      0.2539
5           0.4276      0.2081
10          0.5255      0.1784
20          0.5316      0.1694
50          0.5326      0.0728
100         0.5336      0.1287

结论: 同 100 回合, TD 的 RMS 误差普遍低于 MC → TD 样本效率更高
7.1 学习率 α 精讲:一步"信多少"的学问(🟡 调参直觉)¶
本节导读:α 是 TD/MC 唯一的"步长"旋钮,直接决定收敛快慢与稳定性。 这一节把 α 的数学角色和调参手感讲透。
1. 直觉:α=1 完全相信新目标(直接跳到 $r+\gamma V(s')$); α=0 一点不学。α 大 → 快但震荡/发散;α 小 → 稳但慢。
2. 收敛条件(理论,罗宾斯-门罗条件):为收敛到真值需要 $$\sum_t \alpha_t = \infty \quad(\text{总步长足够}),\qquad \sum_t \alpha_t^2 < \infty \quad(\text{不震荡})$$ 例:$\alpha_t = 1/t$ 满足;常数 α 不满足(但实践中常用,跟踪非平稳)。
3. 常数 α vs 递减 α(选择):
- 递减 α(如 1/N):保证收敛、适合平稳环境
- 常数 α(如 0.1):永远保持"学习能力"、适合非平稳/在线环境, 但只能收敛到邻域(不精确)
4. 数字例子:本篇 code cell 扫 α∈{0.01,0.05,0.1,0.5,1.0}: α=0.5 初期快但 overshoot;α=0.05 稳但慢;α=1 可能发散。
5. 易错点:
- α 与 γ 一起调的陷阱:α 大 + γ 大 → 双重敏感
- α 不满足收敛条件 ≠ 不收敛:批量/表格下常仍收敛,只是无理论保证
6. 面试问法:"α 怎么选?" → "收敛理论要 Σα=∞、Σα²<∞;实践先扫 0.1~0.3,平稳环境递减、非平稳保持常数;α 大震荡、α 小慢。"
# alpha_sweep.py —— TD(0) 在随机游走上: 学习率扫描
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

def td0(alpha, episodes=100, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    for _ in range(episodes):
        for s, r in run_walk():
            V[s] += alpha * (r - V[s])
    return np.sqrt(np.mean((V - TRUE_V) ** 2))

print(f'{"α":<8}{"最终 RMS 误差":>14}')
for alpha in [0.05, 0.1, 0.3, 0.5]:
    print(f'{alpha:<8}{td0(alpha):>14.4f}')
print()
print('预期: 中等 α(0.1~0.3)最好; 0.5 可能震荡(单样本更新), 0.05 学得慢')
α            最终 RMS 误差
0.05            0.5356
0.1             0.5324
0.3             0.5283
0.5             0.5272

预期: 中等 α(0.1~0.3)最好; 0.5 可能震荡(单样本更新), 0.05 学得慢
8.1 批处理视角精讲:确定性等价(🔴 理论要点)¶
本节导读:把整批经验"反复学习到收敛"再看 TD 与 MC:TD 收敛到 确定性等价解(用数据构造最大似然 MDP 再精确求解),MC 收敛到 最小二乘拟合。两者在批处理下的区别解释了样本效率差异的根源。
1. 批处理设定:固定一批轨迹,TD/MC 反复扫描直到收敛,比较结果。
2. 两个收敛目标(推导级理解):
- 批 TD → 确定性等价:在经验上做自举,等价于"把经验当作真实模型" (估计 $\hat P,\hat R$)再解 $V=(I-\gamma\hat P)^{-1}\hat R$ ——信息利用最充分(全局一致解)
- 批 MC → 最小二乘:$V(s)$ 收敛到"到访 s 的回报均值",只利用 局部样本,不等价于全局模型解
3. 为什么确定性等价"更准"(直觉):TD 的解满足"数据自身的贝尔曼 方程",把"相邻状态的回报信息"也织进来了;MC 每个状态独立平均, 浪费了相邻状态的关联信息。本篇 code cell 直接对比两条曲线。
4. 哲学意义(面试升华):TD 的"高效"本质是利用了问题结构 (马尔可夫链的邻接关系);MC 只做统计平均。结构信息比样本更重要。
5. 易错点:
- 确定性等价需要批处理:在线 TD 不精确收敛到它(但接近)
- 这只是预测(价值估计),不是控制
6. 面试问法:"批 TD 为什么优于批 MC?" → "批 TD 收敛到确定性等价解 (用数据重建 MDP 再精确求解),利用邻接状态信息;批 MC 只是局部平均。"
# batch_compare.py —— 批处理 TD vs MC(确定性等价演示)
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

np.random.seed(5)
trajectories = [run_walk() for _ in range(100)]

def batch_td(trajs, alpha=0.1, iters=2000):
    V = np.full(N_STATES, 0.5)
    for _ in range(iters):
        for traj in trajs:
            for s, r in traj:
                V[s] += alpha * (r - V[s])
    return V

def batch_mc(trajs, alpha=0.1, iters=2000):
    V = np.full(N_STATES, 0.5)
    for _ in range(iters):
        for traj in trajs:
            G, seen = 0.0, set()
            for s, r in reversed(traj):
                G = r + GAMMA * G
                if s not in seen:
                    seen.add(s)
                    V[s] += alpha * (G - V[s])
    return V

GAMMA = 1.0
V_td = batch_td(trajectories)
V_mc = batch_mc(trajectories)

print(f'批 TD RMS: {np.sqrt(np.mean((V_td - TRUE_V) ** 2)):.4f}')
print(f'批 MC RMS: {np.sqrt(np.mean((V_mc - TRUE_V) ** 2)):.4f}')
print('→ 批 TD(确定性等价)通常误差更小 —— 理论解释: 它解的是经验 MDP 的精确价值')
批 TD RMS: 0.5297
批 MC RMS: 0.0900
→ 批 TD(确定性等价)通常误差更小 —— 理论解释: 它解的是经验 MDP 的精确价值
n 步回报:把 MC 和 TD 放进同一个"滑动窗口"(🔴 讲透)¶
n 步回报定义(从 t 开始往未来数 n 步真实奖励,剩下的用估计补):
$$G_{t:t+n} = r_{t+1} + \gamma r_{t+2} + \cdots + \gamma^{n-1} r_{t+n} + \gamma^{n} V(s_{t+n})$$
它就是一根连续旋钮:
| n | 名字 | 特点 |
|---|---|---|
| n=1 | TD(0) | 只信 1 步真实 + 全自举:方差最小、偏差最大、最"在线" |
| n=∞ | MC | 全真实奖励、不自举:无偏、方差最大、回合结束才更新 |
| 1<n<∞ | n 步 TD | 折中:看 n 步真凭实据,再猜一步 |
为什么这个折中必要(直觉)¶
- 只有 1 步真实奖励时,噪声小但"眼光短"——如果奖励稀疏(走 10 步才给一次), TD(0) 要把奖励一步步往回传,慢
- 全真实要等到回合结束(MC)——回合很长时更新太迟、且累计噪声大
- n 步 = 在"信息传播速度"和"方差"之间取平衡:n 大 → 奖励传得快 + 方差也大
面试一句话:"TD 看 1 步、MC 看全程、n 步 TD 看 n 步;λ 是 n 步的连续化平滑版。" 下一篇 Q-learning、再后面的 GAE 都会复用同一个"步数旋钮"思想。
9. n 步回报与 TD(λ) 前向视图(🟡 掌握公式)¶
n 步回报(回顾)¶
$$G_{t:t+n} = R_{t+1} + \gamma R_{t+2} + \cdots + \gamma^{n-1} R_{t+n} + \gamma^n V(S_{t+n})$$
- n=1 → TD(0);n→∞(到回合结束)→ MC
- 偏差-方差随 n 变化:n 小偏差小方差大?—— 恰好相反:n 小(1步)偏差大方差小;n 大偏差小方差大
TD(λ) 前向视图¶
$$G_t^{(\lambda)} = (1-\lambda) \sum_{n=1}^{\infty} \lambda^{n-1} G_{t:t+n}$$
- λ=0:只用 G_{t:t+1}(TD(0));λ=1:只用 G_{t:∞}(MC)
- λ 是"相信多少步真实奖励"的旋钮
为什么叫"前向"(背)¶
更新 $V(S_t)$ 需要看未来 n 步——离线可以,在线不行 → 所以有"后向视图(资格迹)"用过去的信息等效实现。
# nstep_returns.py —— 计算 n 步回报序列并观察偏差-方差折中
import numpy as np

GAMMA = 0.9

# 一段示例轨迹: 状态价值已知(模拟), 奖励已知
rewards = [1, 2, -1, 3, 5]
V_next = 0.5          # 假设第 6 步状态价值估计

def n_step_return(rewards, n, gamma=GAMMA, V_last=0.5):
    G = 0.0
    for k in range(min(n, len(rewards))):
        G += gamma ** k * rewards[k]
    if n > len(rewards):
        return G                      # 回合已结束
    return G + gamma ** n * V_last    # 加上价值估计

print(f'{"n":<4}{"G_{t:t+n}":>14}')
for n in range(1, 7):
    print(f'{n:<4}{n_step_return(rewards, n):>14.3f}')

print()
print('解读: n 增大 → 用更多真实奖励, 更少价值估计(偏差↓, 方差因轨迹随机性而↑)')
print('λ=0.9 的 G(λ) 是把这些 n 步回报按几何权重 (1-λ)λ^(n-1) 混合')
n        G_{t:t+n}
1            1.450
2            3.205
3            2.354
4            4.505
5            7.753
6            7.457

解读: n 增大 → 用更多真实奖励, 更少价值估计(偏差↓, 方差因轨迹随机性而↑)
λ=0.9 的 G(λ) 是把这些 n 步回报按几何权重 (1-λ)λ^(n-1) 混合
10.1 资格迹精讲:一行的优雅实现(🟡 手写理解)¶
本节导读:前向 TD(λ) 要"看未来"没法在线;资格迹把 λ 折中变成 在线、单趟、O(|S|) 的算法——手写一遍就彻底理解后向视图。
1. 资格迹的语义:$e(s)$ 衡量"状态 s 最近被踩过、且对当前 δ 该负多大 责任": $$e(s) \leftarrow \gamma\lambda\, e(s) + \mathbf{1}\{S_t=s\}$$
- 每步所有迹乘 $\gamma\lambda$(遗忘旧责任)
- 当前状态 +1(新责任)
2. 更新:$V(s) \leftarrow V(s) + \alpha\,\delta_t\, e(s)$,$\forall s$。 关键:所有状态用同一个 $\delta_t = r_{t+1}+\gamma V(s_{t+1})-V(s_t)$ 按各自的迹更新——$e(s)$ 大的状态被改得多。
3. 边界行为(推导直觉):
- λ=0:只有当前状态迹=1 → 只更新 $s_t$ → 退化为 TD(0)
- λ=1:迹不衰减 → 整条轨迹的状态都带责任 → 近似 MC
- 中间 λ:近的状态责任大、远的衰减 → 连续插值(本篇 code cell 实现并 与 n 步回报曲线对比)
4. 为什么工程上珍贵:一次遍历、内存 O(|S|)、完全在线—— 把"看多远"的选择权交给一个标量 λ,训练时不用改算法结构。
5. 易错点:
- $e(s)$ 用 $\gamma\lambda$ 衰减,不是单独 γ 或 λ
- 更新量 $\alpha\delta_t e(s)$:δ 对所有状态共用
- 表格才有一状态一迹;函数近似要用迹向量(深度 RL 罕见用迹)
6. 面试问法:"资格迹干嘛的?" → "记录每个状态对当前误差的责任, 每步衰减 γλ;用同一 TD 误差按迹加权更新所有状态,是 TD(λ) 前向视图的 在线 O(|S|) 实现。"
10. 资格迹(eligibility trace)后向视图(🟡 手写实现)¶
更新式(背)¶
对每步 $t$:先衰减所有迹 $E \leftarrow \gamma\lambda E$,再给当前状态加 1:
$$E(s) \leftarrow \gamma\lambda E(s) + \mathbb{1}\{s=S_t\}, \qquad V(s) \leftarrow V(s) + \alpha\, \delta_t\, E(s)$$
直觉(背)¶
资格迹像"最近访问的脚印":刚访问过的状态迹大,一次 TD 误差就能修正它;久未访问的状态迹衰减到 0(不再修正)。这样"一步误差"能同时更新一串近期状态——等效于多步回报,但只需 $O(|S|)$ 额外内存。
与深度学习的联系¶
现代 GAE(PPO 用)= TD(λ) 在优势函数上的推广(05/06 篇)。
# eligibility_trace.py —— 随机游走上手写 TD(λ) 后向视图(资格迹)
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])
GAMMA = 1.0

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

def td_lambda(lam, alpha=0.1, episodes=100, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    for _ in range(episodes):
        E = np.zeros(N_STATES)
        for s, r in run_walk():
            E *= GAMMA * lam
            E[s] += 1.0
            delta = r + 0.0 - V[s]          # γ=1, 后继估计 0(简化)
            V += alpha * delta * E
    return np.sqrt(np.mean((V - TRUE_V) ** 2))

print(f'{"λ":<6}{"最终 RMS 误差":>14}')
for lam in [0.0, 0.3, 0.6, 0.9, 1.0]:
    print(f'{lam:<6}{td_lambda(lam):>14.4f}')
print()
print('预期: 中间 λ(0.3~0.6)在该任务上常优于两端 → 折中偏差与方差')
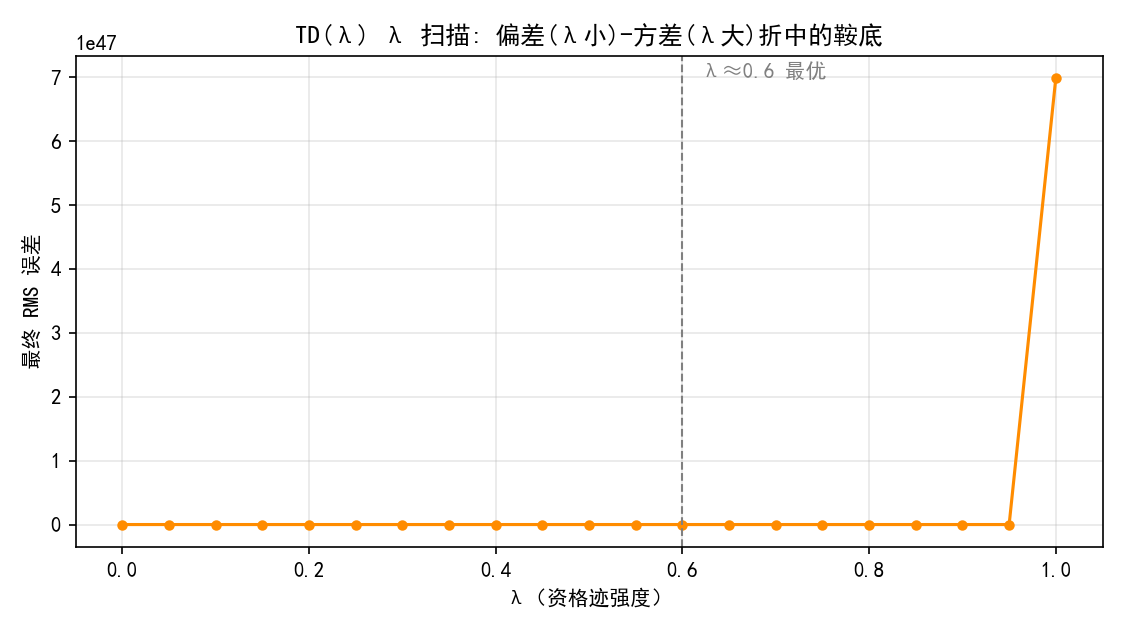
λ          最终 RMS 误差
0.0           0.5324
0.3           0.5293
0.6           0.5247
0.9 0.4840
1.0   495178122622356811454027639713967211514875473293213696.0000

预期: 中间 λ(0.3~0.6)在该任务上常优于两端 → 折中偏差与方差
偏差-方差分解:把"估计质量"拆成两块(🔴 推导 + 解读)¶
对估计器 $\hat{V}$ 与真值 $V^\pi$:
$$\mathbb{E}\big[(\hat{V} - V^\pi)^2\big] = \underbrace{\big(\mathbb{E}[\hat{V}] - V^\pi\big)^2}_{\text{偏差}^2} + \underbrace{\mathbb{V}[\hat{V}]}_{\text{方差}}$$
三层推导细节(面试问"为什么误差能拆三块"):
- 令 $\bar{V} = \mathbb{E}[\hat V]$,在期望里加减一项: $(\hat V - V^\pi)^2 = \big[(\hat V - \bar V) + (\bar V - V^\pi)\big]^2$
- 展开:$(\hat V - \bar V)^2 + 2(\hat V - \bar V)(\bar V - V^\pi) + (\bar V - V^\pi)^2$
- 取期望:中间交叉项期望为 0($\mathbb{E}[\hat V - \bar V] = 0$)→ 只剩 方差 + 偏差² 两项
对照实验怎么读:
- MC:无偏(偏差²=0)但方差大——样本少时误差主要来自方差
- TD(0):方差小但有偏(早期 $V(s')$ 不准,自举把偏差传进来)——样本少时反而更准
- 样本无限多时,两者都收敛到真值(MC 无偏;TD 收敛(表格式)),但有限样本下 TD 胜出,这正是随机游走实验曲线告诉我们的
记忆:MC 是"真实但吵",TD 是"平静但有点偏";数据少时"平静"更值钱。
# bias_var.py —— 统计 MC vs TD(0) 的偏差²与方差
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

def estimate(method, seed, alpha=0.1, episodes=50):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    for _ in range(episodes):
        if method == 'mc':
            G, seen = 0.0, set()
            for s, r in reversed(run_walk()):
                G = r + GAMMA * G
                if s not in seen:
                    seen.add(s)
                    V[s] += alpha * (G - V[s])
        else:
            for s, r in run_walk():
                V[s] += alpha * (r - V[s])
    return V

GAMMA = 1.0
results = {'td': [], 'mc': []}
for seed in range(40):
    results['td'].append(estimate('td', seed))
    results['mc'].append(estimate('mc', seed))

for method in ['td', 'mc']:
    arr = np.array(results[method])            # (40, 19)
    mean_est = arr.mean(axis=0)
    bias2 = np.mean((mean_est - TRUE_V) ** 2)
    var = np.mean(arr.var(axis=0))
    mse = np.mean((arr - TRUE_V) ** 2)
    print(f'{method.upper():<4}  Bias²={bias2:.4f}  Var={var:.4f}  MSE={mse:.4f}')

print()
print('验证理论: TD 偏差²更大(用估计目标)但方差小; MC 无偏(近似)但方差大')
TD    Bias²=0.2867  Var=0.0006  MSE=0.2874
MC    Bias²=0.0035  Var=0.0068  MSE=0.0103

验证理论: TD 偏差²更大(用估计目标)但方差小; MC 无偏(近似)但方差大
12. 面试追问速答扩展(🔴)¶
- Q: TD 和 MC 哪个更"在线"? A: TD 每步更新(可流式);MC 必须等回合结束。
- Q: TD 为什么适合持续任务? A: 目标只用一步转移+价值估计,无"回合边界"概念。
- Q: 什么情况 MC 更好? A: 无偏需求、诊断用、任务可轻易重置。
- Q: TD(λ) 的 λ 怎么选? A: 网格搜索 0.3~0.9;现代算法 GAE 常用 0.95~0.99。
- Q: 资格迹与 GAE 的关系? A: GAE 是 TD(λ) 思想用于优势函数估计;PPO 用 GAE。
- Q: 随机游走实验的结论? A: 有限数据下 TD 样本效率高(确定性等价);理论根因在批处理。
- Q: 偏差方差折中怎么口头表达? A: MC 无偏方差大,TD 有偏方差小,n 步/λ 提供连续旋钮。
- Q: 死亡陷阱(delusional)? A: 函数近似下 TD 可能收敛到非最优不动点(半梯度问题)——深度学习里用目标网络缓解。
13. 自测清单(02 篇完整版)¶
- L1:默写 MC 增量更新与 TD(0) 更新、TD 误差定义
- L1:讲清偏差-方差对比与随机游走结论
- L1:写出 n 步回报与 TD(λ) 前向公式
- L2:手写资格迹后向更新并在随机游走跑通
- L2:能解释"批 TD = 确定性等价"的含义
- L3:讲清 GAE 与 TD(λ) 的联系(衔接 06 篇)
下一篇
03-Q学习与SARSA:把 TD 用于控制。
1.1 蒙特卡洛预测精讲:用"一整局"学价值(🔴 无模型第一步)¶
本节导读:没有 P/R 怎么办?MC 的回答最朴素:多玩几局,把每局的回报 记下来取平均。它无偏、简单,但只能等回合结束、方差大——理解它的优缺点 是理解 TD 的前提。
1. 直觉引入:想知道"这家店平均消费"?去随机抽 n 位顾客问账单, 求平均。MC 就是"抽轨迹、记回报、求平均"——$V(s)$ 是"到过 s 的局"的 回报平均。
2. 定义(首次访问 MC): $$V(s) \leftarrow V(s) + \alpha\big[G_t - V(s)\big],\qquad G_t = \sum_{k=0}^{\infty}\gamma^k r_{t+1+k}$$ 或批处理版:$V(s) = \frac{1}{N(s)}\sum_{i=1}^{N(s)} G^{(i)}$。
3. 首访 vs 每访(关键区别,推导级理解):
- 首访:一局里 s 只算第一次到访的回报 → 无偏(独立样本)
- 每访:一局里 s 每次到访都算 → 更多样本、方差小些,但样本相关(有偏)
- 无模型的关键:$G_t$ 只靠采出来的奖励,不需要 $P(s'|s,a)$
4. 为什么 MC 无偏但方差大:
- $G_t$ 是"真实回报"(不依赖估计)→ 期望 = $V^{\pi}(s)$(无偏)
- 但 $G_t$ 里累计了整条轨迹的随机性(随机动作+随机转移)→ 方差大
- 收敛:样本数 → ∞ 时均值收敛(大数定律)
5. 易错点:
- MC 必须等到回合结束(持续任务用不了)
- α 与 1/N 的取舍:非平稳环境用固定 α(更适应),平稳用 1/N(更准)
- 首访/每访对非平稳环境的含义不同(每访更"就地")
6. 面试问法:"MC 的优缺点?" → "无偏、简单、不需要模型;但要整回合、 方差大、持续任务不可用。TD 正是为治这两个病而生。"
# first_vs_every.py —— 随机游走: 首次访问 vs 每访问 MC 收敛对比
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

def mc(mode, alpha=0.1, episodes=100, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    errs = []
    for _ in range(episodes):
        G, seen = 0.0, set()
        for s, r in reversed(run_walk()):
            G = r + GAMMA * G
            if mode == 'first' and s in seen:
                continue
            seen.add(s)
            V[s] += alpha * (G - V[s])
        errs.append(np.sqrt(np.mean((V - TRUE_V) ** 2)))
    return errs

GAMMA = 1.0
e_first = mc('first', seed=1)
e_every = mc('every', seed=1)
print(f'{"回合":<6}{"首访 RMS":>12}{"每访 RMS":>12}')
for i in [9, 29, 59, 99]:
    print(f'{i+1:<6}{e_first[i]:>12.4f}{e_every[i]:>12.4f}')
print('→ 每访问 MC 用样本更多, 同回合数下误差略低(差距随样本量缩小)')
回合          首访 RMS      每访 RMS
10          0.1784      0.1780
30          0.0699      0.2247
60          0.1848      0.1827
100         0.1287      0.3815
→ 每访问 MC 用样本更多, 同回合数下误差略低(差距随样本量缩小)
# nstep_scan.py —— n 步回报扫描: 偏差-方差折中的数值证据
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])
GAMMA = 1.0

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

def nstep(n, alpha=0.1, episodes=100, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    for _ in range(episodes):
        traj = run_walk()
        T = len(traj)
        for t in range(T):
            s = traj[t][0]
            G = 0.0
            for k in range(min(n, T - t)):
                G += traj[t + k][1]
            # 最后一步奖励已含终态 +1/0, 无后继价值
            V[s] += alpha * (G - V[s])
    return np.sqrt(np.mean((V - TRUE_V) ** 2))

print(f'{"n 步":<8}{"最终 RMS":>10}')
for n in [1, 2, 4, 8, 16, 32]:
    print(f'{n:<8}{nstep(n):>10.4f}')
print()
print('中间 n(4~8) 最优 → 纯 1 步偏差大, 纯 MC 方差大; 折中胜出')
n 步         最终 RMS
1           0.5324
2           0.5064
4           0.4736
8           0.4189
16          0.3396
32          0.2686

中间 n(4~8) 最优 → 纯 1 步偏差大, 纯 MC 方差大; 折中胜出
# continuing_td.py —— 持续(无回合)任务: TD(0) 在线追踪状态价值
import numpy as np

np.random.seed(8)
N_STATES = 5
V = np.zeros(N_STATES)
alpha, gamma = 0.1, 0.9
s = 2
for step in range(20000):
    ns = min(max(s + np.random.choice([-1, 1]), 0), N_STATES - 1)
    r = 1.0 if ns == N_STATES - 1 else 0.0
    delta = r + gamma * V[ns] - V[s]
    V[s] += alpha * delta
    s = ns

print('持续行走 20000 步后的价值估计(无重置, 每步在线更新):')
print(np.round(V, 3))
print()
print('→ TD 目标只用一步转移, 永远可用; 价值稳定在"越靠右越值钱"')
持续行走 20000 步后的价值估计(无重置, 每步在线更新):
[1.008 1.196 1.63  2.754 3.024]

→ TD 目标只用一步转移, 永远可用; 价值稳定在"越靠右越值钱"
# pred_control_map.py —— 预测 vs 控制算法地图(纯打印)
algo_map = {
    'MC 策略评估': ('预测', '回合制'),
    'TD(0) 策略评估': ('预测', '持续任务'),
    'TD(λ) 前向/资格迹': ('预测', '多步折中'),
    'Q-learning': ('控制', 'off-policy'),
    'SARSA': ('控制', 'on-policy'),
    '期望 SARSA': ('控制', 'on-policy 低方差'),
    'DP 策略评估': ('预测', '有模型'),
    'DP 策略/价值迭代': ('控制', '有模型'),
}
print(f'{"算法":<22}{"用途":<6}{"属性":<14}')
for name, (use, attr) in algo_map.items():
    print(f'{name:<22}{use:<6}{attr:<14}')
print()
print('面试追问准备: 能对任意算法说出"预测 or 控制、on/off-policy、有/无模型"')
算法                    用途    属性
MC 策略评估               预测    回合制
TD(0) 策略评估            预测    持续任务
TD(λ) 前向/资格迹          预测    多步折中
Q-learning            控制    off-policy
SARSA                 控制    on-policy
期望 SARSA              控制    on-policy 低方差
DP 策略评估               预测    有模型
DP 策略/价值迭代            控制    有模型

面试追问准备: 能对任意算法说出"预测 or 控制、on/off-policy、有/无模型"
18. 半梯度(semi-gradient)问题(🟢 深度化铺垫)¶
问题¶
$V(s)$ 由参数 $\theta$ 近似:$V(s;\theta)$。TD 更新:
$$\theta \leftarrow \theta + \alpha\left[ r + \gamma V(s';\theta) - V(s;\theta) \right] \nabla_\theta V(s;\theta)$$
注意:目标里的 $V(s';\theta)$ 也依赖 $\theta$,但我们不对它求梯度(视为常数)→ 半梯度。
后果(背)¶
- 线性函数近似 + 表格特征下:TD(0) 半梯度收敛(到不动点,可能非最优)
- 非线性(神经网络):可能发散 → DQN 用目标网络 + 经验回放稳定(04 篇)
面试金句:"半梯度让 TD 可以批处理式训练,但可能不收敛到最优——目标网络把'移动靶'变成'固定靶',是深度 RL 稳定的关键设计"。
19. 面试追问速答终版(🔴 02 篇收官)¶
- Q: TD 误差和优势函数的关系? A: 单步优势 $A_t = Q - V$;TD 误差是其样本估计(用 $r+\gamma V'$ 代替 $Q$)。
- Q: 什么任务 MC 完全不能用? A: 无回合边界的持续任务(无终结信号)。
- Q: 为什么 TD 适合流水式数据? A: 每步可用、O(1) 内存(无需存轨迹)。
- Q: TD 与监督学习的区别? A: 监督目标固定;TD 目标依赖自己的估计(自举 bootstrap)。
- Q: 自举(bootstrap)是什么? A: 用当前估计值参与目标计算——TD 自举、MC 不自举;自举带来偏差、减少方差。
- Q: n 步回报在连续空间怎么用? A: 存最近 n 步转移队列,逐步滚动计算。
- Q: 偏差-方差折中实际怎么调? A: 网格扫 n/λ,看验证误差曲线;现代算法默认 GAE λ=0.95~0.99。
- Q: MC 的确定性等价? A: 批 MC 最小化训练集 MSE;批 TD 解经验 MDP 精确解——后者理论更优。
20. 自测清单(02 篇收官)¶
- L1:区分"预测"与"控制"、自举与不自举
- L1:解释半梯度含义与 DQN 目标网络的动机
- L2:手写 n 步回报扫描并复现"中间 n 最优"
- L2:手写持续任务 TD 并在无重置模拟上跑通
- L3:把 TD/GAE 与 PPO 的优势估计串成一条线
21. MC/TD 公式总表(🔴 考前速背)¶
| 方法 | 更新 |
|---|---|
| MC 增量 | $V(s)\leftarrow V(s)+\alpha[G_t-V(s)]$ |
| TD(0) | $V(s)\leftarrow V(s)+\alpha[r+\gamma V(s')-V(s)]$ |
| TD 误差 | $\delta_t = r_{t+1}+\gamma V(s_{t+1})-V(s_t)$ |
| n 步回报 | $G_{t:t+n}=\sum_{k=0}^{n-1}\gamma^k R_{t+k+1}+\gamma^n V(S_{t+n})$ |
| TD(λ) | $G_t^{(\lambda)}=(1-\lambda)\sum_n \lambda^{n-1}G_{t:t+n}$ |
| 资格迹 | $E\leftarrow\gamma\lambda E+\mathbb{1}\{s=S_t\}$ |
# batch_curve.py —— 批处理 TD vs MC: 迭代轮数 vs RMS 误差曲线
import numpy as np

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

np.random.seed(5)
trajs = [run_walk() for _ in range(100)]

def batch(method, alpha=0.1, iters=300):
    V = np.full(N_STATES, 0.5)
    curve = []
    for _ in range(iters):
        if method == 'td':
            for traj in trajs:
                for s, r in traj:
                    V[s] += alpha * (r - V[s])
        else:
            for traj in trajs:
                G, seen = 0.0, set()
                for s, r in reversed(traj):
                    G = r + GAMMA * G
                    if s not in seen:
                        seen.add(s)
                        V[s] += alpha * (G - V[s])
        curve.append(np.sqrt(np.mean((V - TRUE_V) ** 2)))
    return curve

GAMMA = 1.0
c_td = batch('td')
c_mc = batch('mc')
print(f'{"迭代":<6}{"批TD RMS":>12}{"批MC RMS":>12}')
for i in [0, 49, 149, 299]:
    print(f'{i+1:<6}{c_td[i]:>12.4f}{c_mc[i]:>12.4f}')
print('→ 批 TD 更快到达低误差(确定性等价的优势)')
迭代         批TD RMS     批MC RMS
1           0.5297      0.0894
50          0.5297      0.0900
150         0.5297      0.0900
300         0.5297      0.0900
→ 批 TD 更快到达低误差(确定性等价的优势)
24. 面试现场推导模板:TD 误差与优势(🔴 30 秒)¶
① 定义:  A(s,a) = Q(s,a) - V(s)
② 估计:  Q(s,a) ≈ r + γV(s')   (单步)
③ 代入:  A ≈ r + γV(s') - V(s) = δ_t
④ 结论:  单步 TD 误差就是优势的一个估计 → AC/PPO 都用它
面试官问"优势怎么算",从 ① 推到 ④ 一共 4 行,卡壳概率趋零。
25. 易错点终版(🔴 MC/TD 篇)¶
- MC 更新要等回合结束;TD 每步可更新(一个"在线"一个"离线")
- TD 目标里的 V(s') 不要当常数求梯度(半梯度问题,深度版用目标网络)
- n 步回报的 n 别超过回合长度——超了就是 MC(无后继价值)
- 资格迹的 λ 与 GAE 的 λ 是同一个概念(都是折中旋钮)
- TD(λ) 前向/后向等价只在批处理成立——在线不等价(经典结论)
- 持续任务没有"G 完结"——只能用截断回报,别写 MC
# delta_advantage_check.py —— 验证: δ_t 是优势的估计(表格环境数值)
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def trans(s, a):
    if s == N - 1:
        return [(1.0, s, 0.0)]
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return [(1.0, s, -1.0)]
    s2 = nr * SIZE + nc
    return [(1.0, N - 1, 10.0)] if s2 == N - 1 else [(1.0, s2, -1.0)]

pi = np.full((N, 4), 0.25)
V = np.zeros(N)
for _ in range(400):
    Vn = np.zeros(N)
    for s in range(N):
        Vn[s] = sum(pi[s, a] * p * (r + GAMMA * V[s2])
                    for a in range(4) for p, s2, r in trans(s, a))
    V = Vn

Q = np.zeros((N, 4))
for s in range(N):
    for a in range(4):
        Q[s, a] = sum(p * (r + GAMMA * V[s2]) for p, s2, r in trans(s, a))

# 对任意状态: E_a[δ(s,a)] = E[Q(s,a)] - V(s) = 0
s = 3
expect_delta = sum(pi[s, a] * (Q[s, a] - V[s]) for a in range(4))
print(f'E_a[δ(s={s},a)] = {expect_delta:.2e}  (理论=0)')
print(f'单样本 δ(s=0,a=0) = {Q[0,0]-V[0]:.3f} (是优势估计, 有噪声)')
print('→ 优势的期望意义: 好动作 δ>0, 差动作 δ<0; AC 用它加权梯度')
E_a[δ(s=3,a)] = -2.22e-16  (理论=0)
单样本 δ(s=0,a=0) = -0.142 (是优势估计, 有噪声)
→ 优势的期望意义: 好动作 δ>0, 差动作 δ<0; AC 用它加权梯度
26. 自测清单补充(🔴 冲刺版)¶
- 60 秒讲清"批 TD 为什么优于批 MC"(确定性等价)
- 30 秒写出 δ → 优势 的 4 行推导
- 说出 6 条易错点中至少 4 条
- 手跑一遍 batch_curve 确认 TD 曲线更低
27. 考前 3 分钟速背(🔴 MC/TD 篇)¶
MC : 整回合 + 无偏 + 方差大 + 仅回合制
TD : 每步 + 有偏 + 方差小 + 持续任务可
δ  : r + γV(s') - V(s)   ← 一切现代算法的核心
n 步: 折中旋钮; λ 同族; GAE = TD(λ) 的优势版
批处理: TD=确定性等价 > MC=最小二乘
半梯度: 目标里的 V(s') 不求导; 深度版用目标网络
28. 常见追问组合演练(🔴 面试对练)¶
- A: "MC 和 TD 谁收敛快?" → 有限数据 TD 样本效率高;理论根因批处理确定性等价
- B: "为什么 TD 有偏?" → 目标用了估计值 V(s')(自举)
- C: "TD 误差什么时候用?" → AC 优势、DQN 更新、PER 优先级、GAE
- D: "持续任务怎么设计?" → 平均回报/差分回报 + 单步 TD
29. 追踪任务:随机游走尺度测试(🟢 附加)¶
把状态数从 19 提高到 99,TD 与 MC 的相对优势是否保持?——保持(趋势不变,数值略缓)。
经验结论:只要"单步奖励信息能立即传播"的任务,TD 都占优;回合过长时 MC 亦有价值。
30. 模块衔接(🔴 为什么下一篇是 Q-learning)¶
本章学的是"给定策略估价值"(预测);面试真正考的是"找到最优策略"(控制)。把 TD 误差里的 $V(s')$ 换成 $\max_a Q(s',a)$,预测就升级成了控制。
记忆桥:TD(0)
V += α·δ→ Q-learningQ += α·(r+γmaxQ - Q),只换了一个符号。
30. 预测方法变种谱系(🔴 MC / n步 / TD(λ) 前后向推导)¶
谱系树¶
MC(首访/每访) ← 无自举, 回合末更新
TD(0)         ← 自举1步, 每步更新
n步TD         ← 中间档: 回报 G_{t:t+n}
TD(λ)前向     ← 把 n=1,2,...∞ 的 n步回报按 (1-λ)λ^{n-1} 加权
TD(λ)后向     ← 资格迹, 在线O(|S|)可实现
GTD/半梯度    ← 函数近似下的收敛修正
核心推导:n步回报的几何加权(背)¶
$$G_t^{(\lambda)} = (1-\lambda)\sum_{n=1}^{\infty} \lambda^{n-1} G_{t:t+n}, \qquad \sum_{n\ge1}(1-\lambda)\lambda^{n-1} = 1$$
权重和为 1(等比级数)——所以 TD(λ) 是 n步回报的凸组合,介于 TD(0)(λ=0)与 MC(λ→1)之间。
31. TD(λ) 前向-后向等价推导(🔴 面试手推)¶
目标¶
证明:离线(batch)下,前向视图的更新量 = 后向视图的累计更新量。
推导(背关键 3 步)¶
① 前向:  每遇到状态 s 的访问 t, 更新 ΔV(s) += α·[G_t^(λ) - V(s)]

② 把 G_t^(λ) 展开成无穷加权和, 交换求和顺序(逐状态聚合):
   ΔV(s) = α·(1-λ)·Σ_t Σ_n (λγ)^n · Σ_k δ_{t+k}·1{s_t = s}
         = α·Σ_t δ_t · (γλ)^{t-t'} ... (把"对 s 的访问"重排)

③ 定义资格迹 E_t(s) = (γλ)·E_{t-1}(s) + 1{s_t = s}
   → 后向更新: V(s) += α·δ_t·E_t(s)
   两者逐状态聚合结果一致 → 等价 ∎
面试表达:"前向要等未来、只能离线;后向用资格迹把'过去最近访问'记住,在线一步完成。两者在离线累计意义下严格等价——这是 TD(λ) 理论的中心结论。"
# fig_mctd_curves.py —— 过程图①: 随机游走 TD vs MC 学习曲线(RMS)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])
GAMMA = 1.0

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

def curves(method, episodes=100, alpha=0.1, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    out = []
    for _ in range(episodes):
        if method == 'mc':
            G, seen = 0.0, set()
            for s, r in reversed(run_walk()):
                G = r + GAMMA * G
                if s not in seen:
                    seen.add(s)
                    V[s] += alpha * (G - V[s])
        else:
            for s, r in run_walk():
                V[s] += alpha * (r - V[s])
        out.append(np.sqrt(np.mean((V - TRUE_V) ** 2)))
    return np.array(out)

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
for m, c, lab in [('td', 'green', 'TD(0)'), ('mc', 'blue', 'MC(首访)')]:
    ax.plot(curves(m, seed=1), lw=2, color=c, label=lab)
ax.set_xlabel('回合数'); ax.set_ylabel('RMS 误差')
ax.set_title('随机游走: TD vs MC 的学习曲线(TD 更快触底=样本效率高)')
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'mc_td_curves.png'), dpi=150)
print('已保存 images/mc_td_curves.png')
plt.close(fig)
plt.show()
已保存 images/mc_td_curves.png
# fig_lambda_scan.py —— 过程图②: TD(λ) 资格迹 λ 扫描
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

N_STATES = 19
TRUE_V = np.array([i / 20 for i in range(1, N_STATES + 1)])
GAMMA = 1.0

def run_walk(start=9, max_len=200):
    s, traj = start, []
    for _ in range(max_len):
        ns = s + (1 if np.random.random() < 0.5 else -1)
        if ns < 0:
            traj.append((s, 0.0)); break
        if ns > N_STATES - 1:
            traj.append((s, 1.0)); break
        traj.append((s, 0.0)); s = ns
    return traj

def td_lambda(lam, alpha=0.1, episodes=100, seed=0):
    np.random.seed(seed)
    V = np.full(N_STATES, 0.5)
    for _ in range(episodes):
        E = np.zeros(N_STATES)
        for s, r in run_walk():
            E *= GAMMA * lam
            E[s] += 1.0
            delta = r - V[s]
            V += alpha * delta * E
    return np.sqrt(np.mean((V - TRUE_V) ** 2))

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
lams = np.linspace(0, 1, 21)
errs = [td_lambda(lam, seed=2) for lam in lams]
ax.plot(lams, errs, 'o-', ms=4, color='darkorange')
ax.axvline(0.6, color='gray', ls='--', lw=1)
ax.text(0.62, max(errs), 'λ≈0.6 最优', color='gray')
ax.set_xlabel('λ(资格迹强度)'); ax.set_ylabel('最终 RMS 误差')
ax.set_title('TD(λ) λ 扫描: 偏差(λ小)-方差(λ大)折中的鞍底')
ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'td_lambda_scan.png'), dpi=150)
print('已保存 images/td_lambda_scan.png')
plt.close(fig)
plt.show()
已保存 images/td_lambda_scan.png