🏗️ 00 · 大数据体系与 HDFS
大数据面试第一题常是"数据湖/数仓/Hadoop 体系"。本节搭大数据技术全景框架, 再用模拟实现讲清 HDFS 的块/副本/读写流程——不依赖集群,numpy 就能跑。
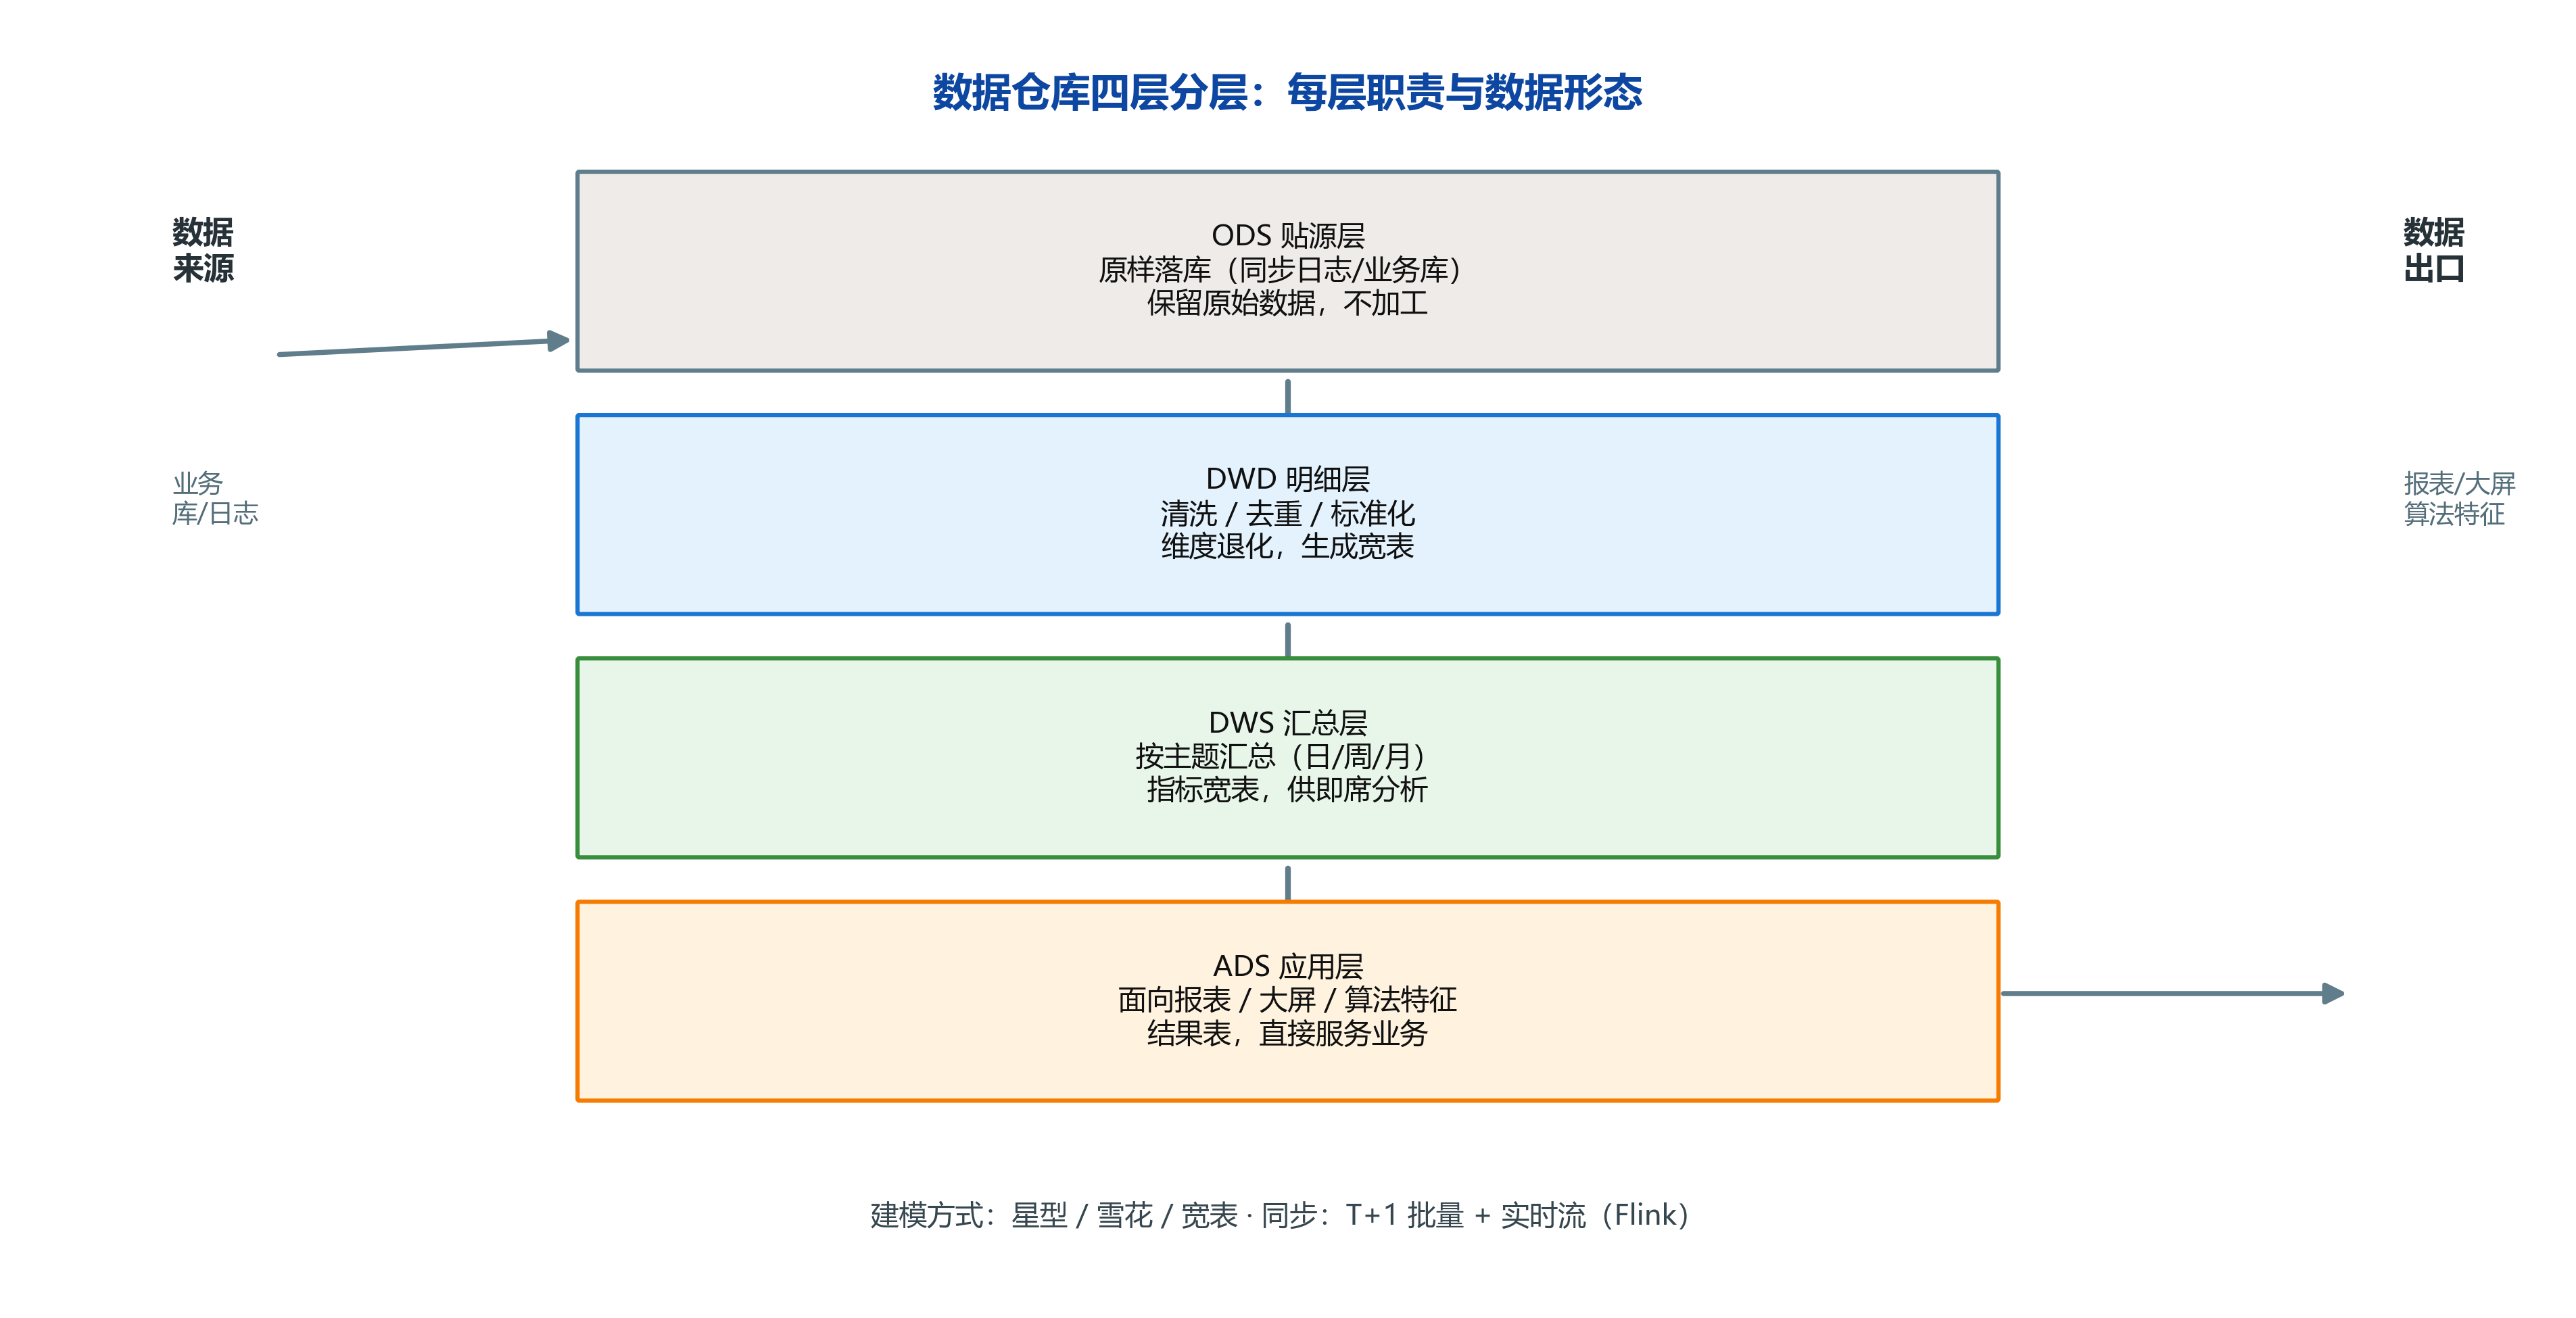
🔍 图解(自绘高清图,300dpi,可放大):数据仓库经典的四层分层架构,自底向上——
- ODS(贴源层):原始数据原样落地(业务库同步/日志/埋点),不做加工只做存储, 与源系统保持一一对应,用于追溯;
- DWD(明细层):对 ODS 做清洗与标准化(去重、格式统一、空值处理、维表补全), 保持"最细粒度"的事实数据——所有分析都在这一层取明细;
- DWS(汇总层):按业务维度聚合(按天/按月、按商品/按类目)成宽表与指标表, 供 BI 报表直接查询——大部分查询命中这一层,查得快;
- ADS(应用层):面向具体应用场景的定制表(推荐特征表、风控评分表、C 端页面指标), 去服务化输出;
- 核心思想:下层保真、上层专用,每上一层数据量变小、查询变快;谁都不跨层取数。 底部是 HDFS 存储底座(Hive/Spark 读写),顶部对接 BI 与线上应用。
论文出处:Inmon, "Building the Data Warehouse", 1992——数仓分层架构(ODS/DWD/DWS/ADS 分层思想源头)。
🎬 背景故事
单块硬盘装不下全网数据,单台服务器也扛不住计算——怎么办?……
十年前,一台服务器能存 1TB,但全网每天新增的数据早已是它的千倍万倍。数据太多、一台机器装不下,于是有了"分布式"这个答案:把数据切开,分散到成千上万台机器。而这一切的起点,是 Hadoop 的存储层 HDFS。本节讲透分块、副本、读写流程这些面试必问。
🧭 本节逻辑主线:数据爆炸的现实 → 分布式存储的思路(分块+副本)→ HDFS 架构(NameNode/DataNode)→ 读写流程 → 5 个高频点。
📋 本节要解决的问题
| # | 问题 | 方法 |
|---|---|---|
| 1 | 大数据技术栈有哪些层? | 采集/存储/计算/调度/OLAP |
| 2 | HDFS 怎么存大文件? | 分块 + 副本 |
| 3 | 读写怎么走? | NameNode 元数据 + DataNode 数据 |
| 4 | 副本策略为什么重要? | 容错 3 副本 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ 大数据技术栈全景(必背框架)
stack = [
    ('采集', 'Flume / Kafka / Logstash / DataX / Sqoop'),
    ('存储', 'HDFS / HBase / Kudu / Delta / Iceberg / Hudi'),
    ('计算', 'MapReduce / Spark / Flink / Hive / Presto / StarRocks'),
    ('调度', 'Airflow / DolphinScheduler / YARN / K8s'),
    ('查询', 'Presto / Trino / Impala / Doris / ClickHouse'),
    ('治理', '数仓分层 / 元数据 / 数据质量 / 数据安全'),
]
for layer, tools in stack:
    print(f'  {layer:<4} | {tools}')
print('\n➡️ 面试串讲:先说全貌,再说"我负责的模块",最后讲联动')
  采集   | Flume / Kafka / Logstash / DataX / Sqoop
  存储   | HDFS / HBase / Kudu / Delta / Iceberg / Hudi
  计算   | MapReduce / Spark / Flink / Hive / Presto / StarRocks
  调度   | Airflow / DolphinScheduler / YARN / K8s
  查询   | Presto / Trino / Impala / Doris / ClickHouse
  治理   | 数仓分层 / 元数据 / 数据质量 / 数据安全

➡️ 面试串讲:先说全貌,再说"我负责的模块",最后讲联动
2️⃣ 存储 vs 计算分离思想
print('''存算分离(存储计算分离):
  HDFS = 存储(DataNode 只存数据)
  Spark/Flink = 计算(用完即释放,不持有数据)
  好处:弹性扩缩容、成本低、统一存储(湖仓一体基础);
  代价:网络 IO 变大 → 数据本地性优化(把任务调度到数据所在节点)。
''')
存算分离(存储计算分离):
  HDFS = 存储(DataNode 只存数据)
  Spark/Flink = 计算(用完即释放,不持有数据)
  好处:弹性扩缩容、成本低、统一存储(湖仓一体基础);
  代价:网络 IO 变大 → 数据本地性优化(把任务调度到数据所在节点)。
📐 公式推导:HDFS 分块与副本占用
分块数(文件大小 $S$、块大小 $B$=128MB,向上取整;不足一块也占一块):
$$ N_{\mathrm{block}} = \left\lceil \frac{S}{B} \right\rceil, \qquad \text{例:} S=300\text{MB} \Rightarrow \lceil 300/128 \rceil = 3 $$
副本占用(副本因子 $R$=3):存储逻辑大小 $S$ 的文件,实际占物理空间:
$$ \mathrm{Usage}_{\mathrm{physical}} = N_{\mathrm{block}} \times B \times R \;\approx\; S \times R \quad\text{(块对齐后略大于)} $$
推导要点:① 块大(128MB)→ 元数据条数少(每个块一条元数据进 NameNode 内存)、顺序读写减少寻道;② 副本数 $R$ 与容错概率的关系:一个数据节点同时坏掉 $k$ 台的概率为 $p^k$($p$ 为单机故障率),$R=3$ 通常允许同机架坏 2 台不丢数据;③ 机架感知:副本跨机架分布,防"整机架断电"。
3️⃣ HDFS 分块:把大文件切成块
# 🖼️ 配图:HDFS 架构——NameNode 管元数据、DataNode 存数据块(3 副本)
fig, ax = plt.subplots(figsize=(8, 4.6))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 5)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.6))

box(0.5, 3.7, 2.2, 1.0, '客户端\n(读写请求)', '#e2e8f0')
box(4.0, 3.7, 2.2, 1.0, 'NameNode\n(元数据: 块位置)', '#bfdbfe')
box(7.3, 3.7, 2.2, 1.0, '文件 → 块\n(128MB/块)', '#fef9c3')
arrow(2.8, 4.2, 3.9, 4.2); arrow(6.3, 4.2, 7.2, 4.2)
arrow(5.1, 3.7, 5.1, 3.1)
# DataNode 集群
for i, (x, y) in enumerate([(0.8, 0.8), (3.5, 0.8), (6.2, 0.8), (8.6, 0.8)]):
    box(x, y, 1.6, 1.4, f'DataNode\n块{3*i}-{3*i+2}\n(3副本)', '#bbf7d0')
arrow(3.6, 3.0, 1.6, 2.2); arrow(4.4, 3.0, 4.3, 2.2); arrow(5.2, 3.0, 7.0, 2.2)
plt.title('HDFS:元数据集中(NameNode) + 数据分散(DataNode×N,每块3副本)', fontsize=10.5)
plt.show()
print('➡️ 块 3 副本分布在不同节点 → 单节点/单机架故障不丢数据')
➡️ 块 3 副本分布在不同节点 → 单节点/单机架故障不丢数据
C:\Users\24260\AppData\Local\Temp\ipykernel_22648\457609098.py:23: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 模拟一个大文件,按 128MB 块大小分块(这里用字符数模拟)
file_size_mb = 500
block_size_mb = 128
n_blocks = (file_size_mb + block_size_mb - 1) // block_size_mb
sizes = [block_size_mb] * (n_blocks - 1) + [file_size_mb - block_size_mb * (n_blocks - 1)]
print(f'文件 {file_size_mb}MB:块大小 {block_size_mb}MB -> 分成 {n_blocks} 个块,末块 {sizes[-1]}MB')
assert sum(sizes) == file_size_mb
# 模拟块数据(字节数组)
block_data = [np.random.default_rng(i).integers(0, 256, 64, dtype=np.uint8) for i in range(n_blocks)]
print(f'每个块 64 字节样例:块0 = {block_data[0][:8]}...')
print('➡️ 真实 HDFS 默认块 128MB/256MB,块是分布式存储与容错的基本单位')
文件 500MB:块大小 128MB -> 分成 4 个块,末块 116MB
每个块 64 字节样例:块0 = [ 95 130 194 217 207 235  15 163]...
➡️ 真实 HDFS 默认块 128MB/256MB,块是分布式存储与容错的基本单位
4️⃣ 副本机制:3 副本容错
# 模拟副本:每块存 3 份在不同"节点"
n_nodes = 5
replication = 3
assign = {}
for b in range(n_blocks):
    nodes = list(rng.choice(n_nodes, size=replication, replace=False))
    assign[b] = nodes
    print(f'块{b}: 副本 -> 节点{nodes}')

# 容错演示:挂掉 1-2 个节点数据是否仍完整
for fail in [[0], [0, 1], [0, 1, 2]]:
    ok = True
    for b in range(n_blocks):
        if not set(assign[b]) & set(range(n_nodes)) - set(fail):
            ok = False
    print(f'节点 {fail} 宕机 -> 数据可读: {ok}')
print('\n➡️ 3 副本=块丢失率极低;面试点:副本放置策略(同机架/跨机架)')
块0: 副本 -> 节点[np.int64(4), np.int64(0), np.int64(3)]
块1: 副本 -> 节点[np.int64(0), np.int64(3), np.int64(2)]
块2: 副本 -> 节点[np.int64(1), np.int64(3), np.int64(4)]
块3: 副本 -> 节点[np.int64(3), np.int64(2), np.int64(0)]
节点 [0] 宕机 -> 数据可读: True
节点 [0, 1] 宕机 -> 数据可读: True
节点 [0, 1, 2] 宕机 -> 数据可读: True

➡️ 3 副本=块丢失率极低;面试点:副本放置策略(同机架/跨机架)
5️⃣ 读写流程(NameNode/DataNode 分工)
print('''读流程:
  1. Client 问 NameNode:文件在哪些块、各块在哪些 DataNode(元数据)
  2. Client 就近(机架感知)从 DataNode 拉块
  3. 拼装成完整文件

写流程:
  1. Client 问 NameNode 申请创建文件
  2. 按块依次写:写块 -> 流式复制到副本节点(pipeline)
  3. 全部写完 -> 告知 NameNode 提交

关键:NameNode 只管元数据(内存),数据流不过 NameNode(否则瓶颈)。
NameNode 单点 -> HA(Active/Standby + JournalNode)。
''')
读流程:
  1. Client 问 NameNode:文件在哪些块、各块在哪些 DataNode(元数据)
  2. Client 就近(机架感知)从 DataNode 拉块
  3. 拼装成完整文件

写流程:
  1. Client 问 NameNode 申请创建文件
  2. 按块依次写:写块 -> 流式复制到副本节点(pipeline)
  3. 全部写完 -> 告知 NameNode 提交

关键:NameNode 只管元数据(内存),数据流不过 NameNode(否则瓶颈)。
NameNode 单点 -> HA(Active/Standby + JournalNode)。
6️⃣ 面试高频:HDFS 相关速答
print('''1) 为什么块大(128MB)?  -> 减少元数据量、减少寻道开销;
2) 小文件问题?           -> 每个文件有元数据,海量小文件压垮 NameNode;
3) 解决小文件?           -> 合并(SequenceFile/Har)、分区归档、Iceberg 等湖格式;
4) HDFS 适合什么?        -> 大文件批量读写;不适合秒级随机访问/低延迟;
5) 与对象存储对比?       -> HDFS 块语义 vs OSS 桶/对象语义。
''')
print('✅ 五个高频点已覆盖')
1) 为什么块大(128MB)?  -> 减少元数据量、减少寻道开销;
2) 小文件问题?           -> 每个文件有元数据,海量小文件压垮 NameNode;
3) 解决小文件?           -> 合并(SequenceFile/Har)、分区归档、Iceberg 等湖格式;
4) HDFS 适合什么?        -> 大文件批量读写;不适合秒级随机访问/低延迟;
5) 与对象存储对比?       -> HDFS 块语义 vs OSS 桶/对象语义。

✅ 五个高频点已覆盖
📝 自测清单
- 能画出大数据技术栈全景图(六层)
- 能解释存储计算分离的好处
- 能手算文件分块数与副本分配
- 能画出 HDFS 读写流程图
- 能答 5 个 HDFS 高频问题