⚙️ 15-AI-Infra:AI 基础设施(推理 / 训练 / 性能优化)
AI Infra(AI 基础设施)岗位 = 让大模型"训得快、跑得省"的系统工程师: 训练侧(分布式并行、混合精度、显存优化)+ 推理侧(KV Cache、量化、批处理、推理引擎)+ 算子层(CUDA/GEMM 优化、算子融合)+ 性能分析(profiler、roofline、吞吐/延迟调优)。
面向秋招画像:AI Infra / 大模型推理优化 / 训练平台 / 高性能计算(HPC)/ 异构计算 / CUDA 工程师 岗位。 与 04-LLM大模型(模型结构)、08-优化算法(训练优化器/FP16-ZeRO)、13-编程语言(C++/Linux)、05-八股与工程(OS/网络/分布式)直接衔接。
🖼️ 配图与深化:11 篇教学 notebook 均含手写实现 + 数值对照(numpy/torch,无需 GPU 可执行); 模块目录会随产出持续扩充,内容以当前目录和下方索引为准。
知识地图(面试考察的九大块)
AI Infra 考点
├── 1. 系统基础        CPU/GPU 架构差异 · 内存层次 · 带宽 vs 算力 · roofline 模型
├── 2. 算子层          GEMM 优化(tiling/register blocking)· 算子融合 · CUDA 线程模型
├── 3. 训练框架        计算图 · 自动微分(反向传播实现)· PyTorch 内核 · torch.compile(图模式)
├── 4. 混合精度        FP16/BF16/FP32 · loss scaling · 显存账本(参数/梯度/优化器状态/激活)
├── 5. 分布式训练      数据并行 DP/FSDP · 张量并行 TP · 流水线并行 PP · ZeRO · 梯度同步
├── 6. 通信            NCCL · 集合通信(allreduce/broadcast)· Ring AllReduce 通信量 · 拓扑
├── 7. 推理优化        KV Cache · 连续批处理(vLLM/PagedAttention)· 投机解码 · 并行采样
├── 8. 量化压缩        PTQ/QAT · INT8/INT4 · GPTQ/AWQ/SmoothQuant · 误差分析与校准
└── 9. 部署与监控      QPS/TTOT/TPOT 指标 · 推理服务架构 · profiler 定位瓶颈 · 成本估算
学习路线(推荐顺序)
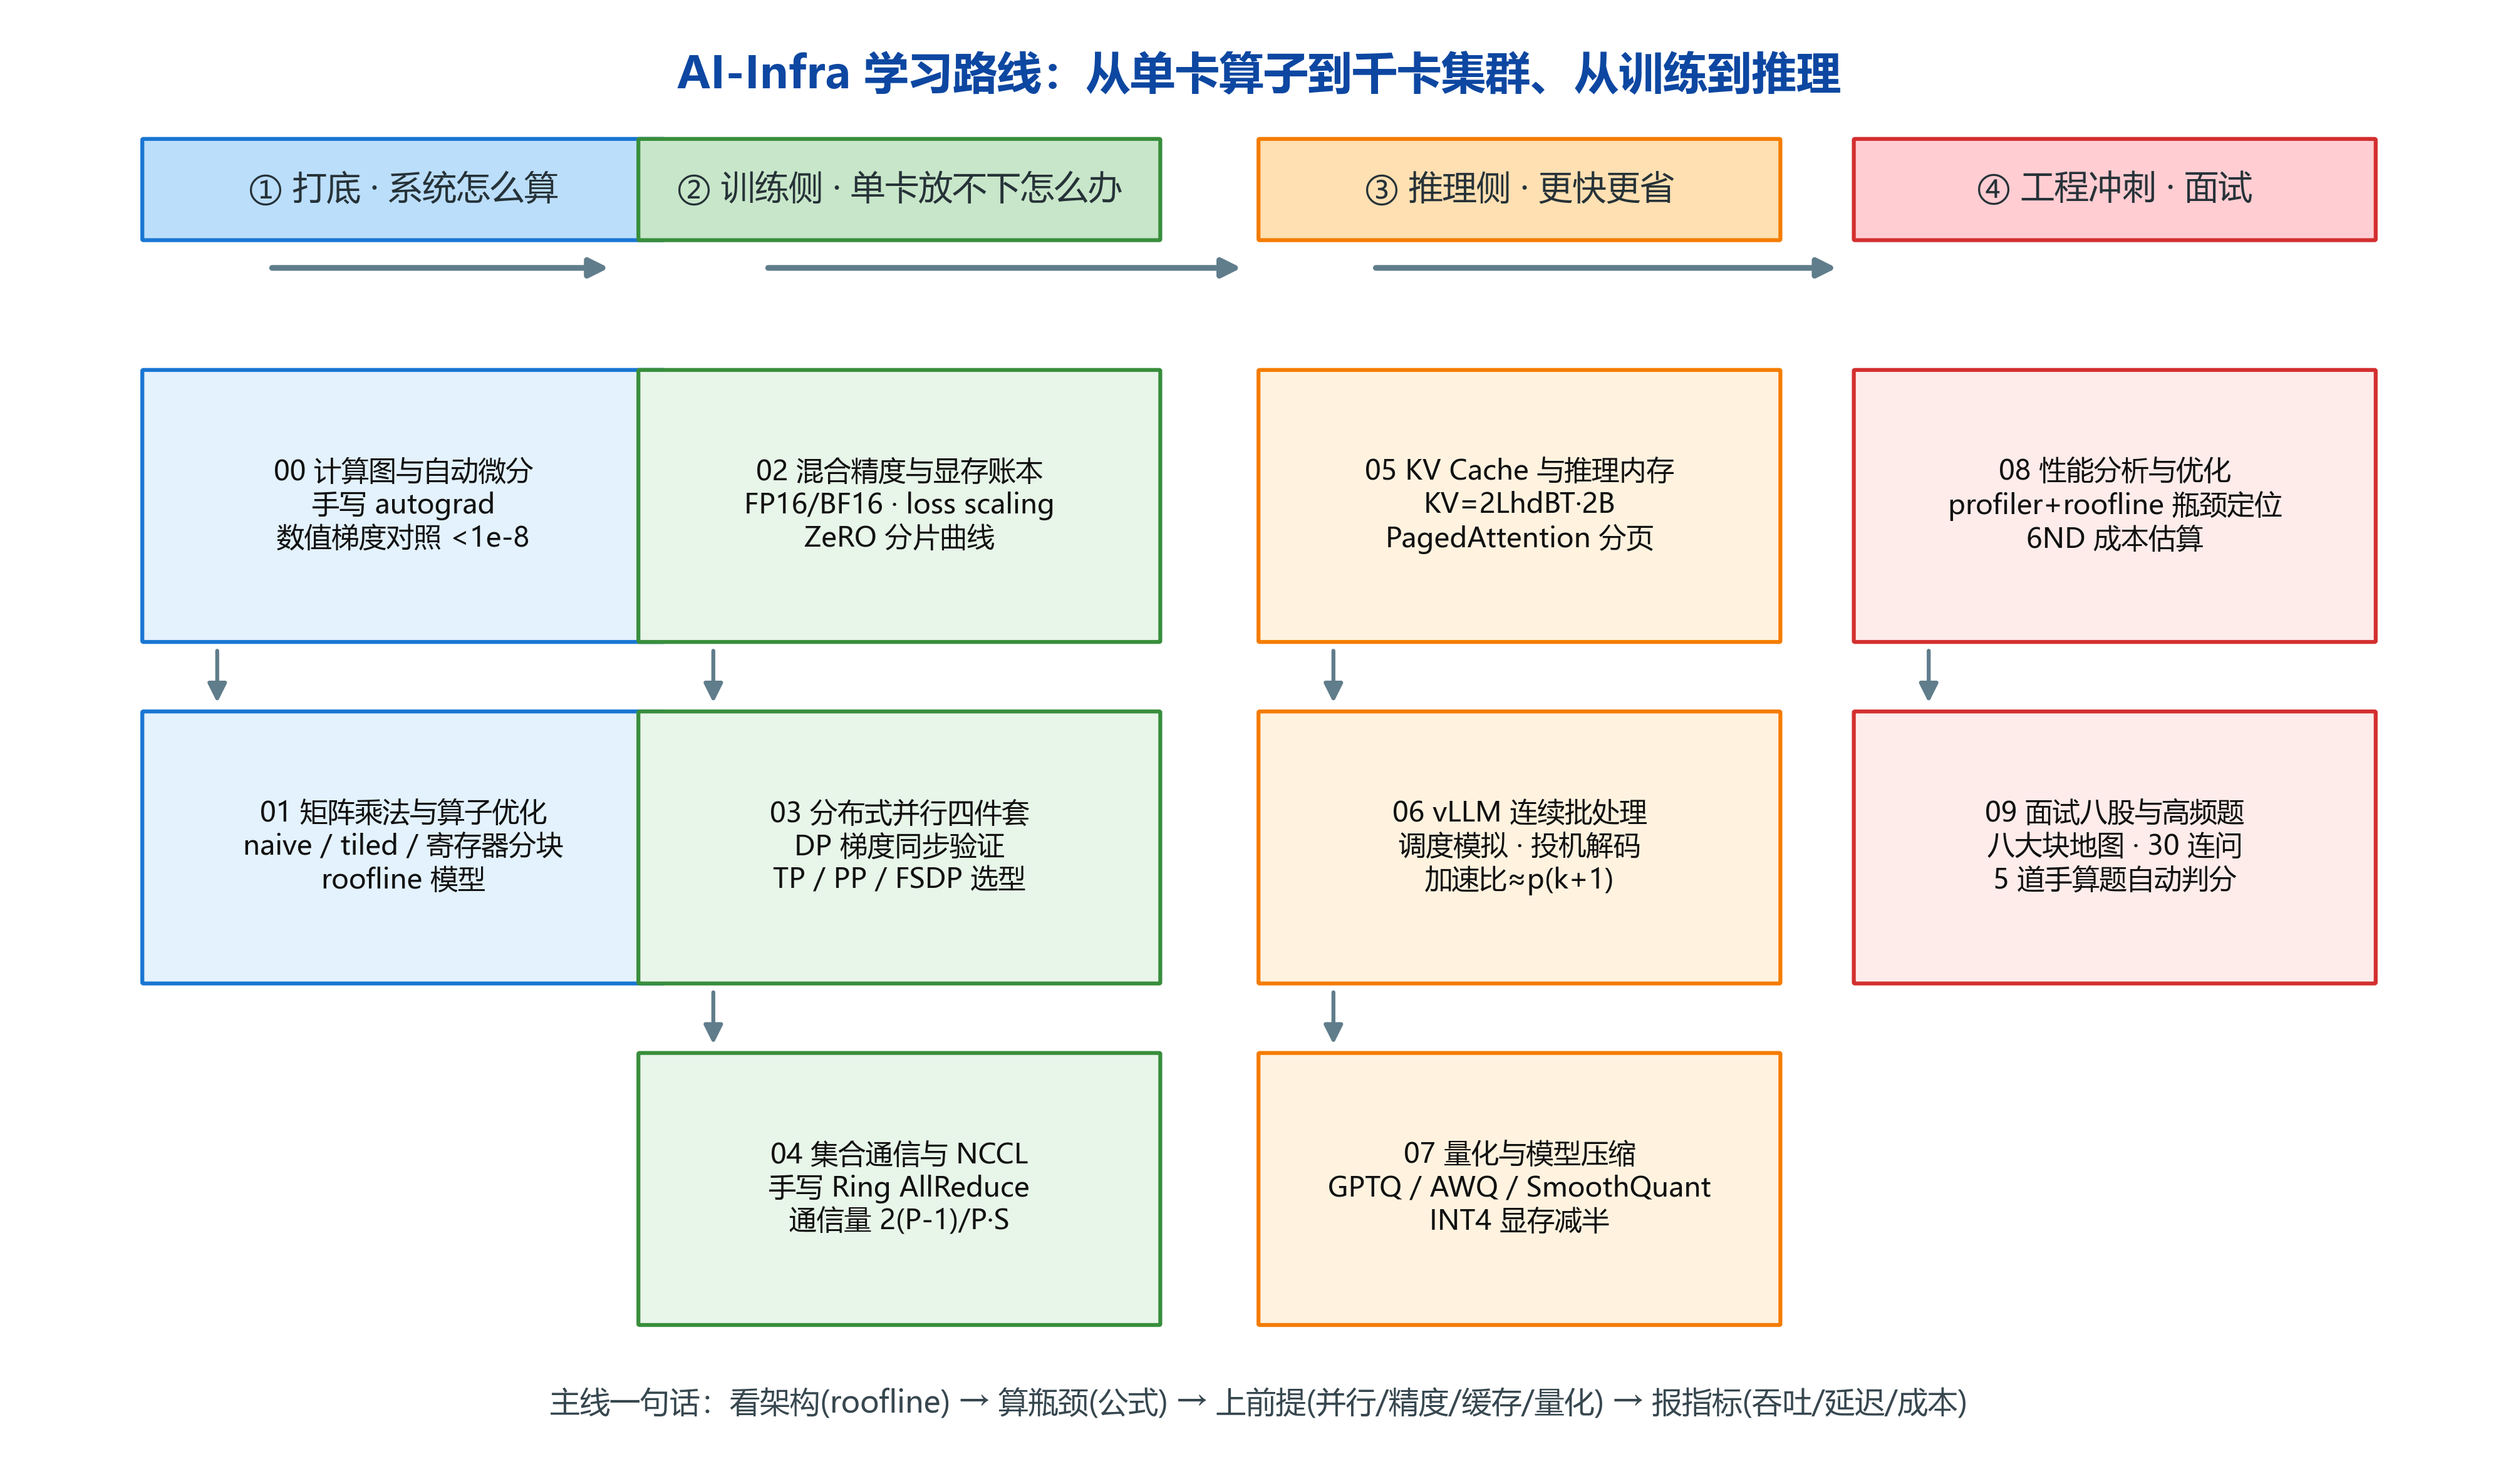
- 打底(00-01):先懂"系统怎么算"——计算图与自动微分引擎(手写 autograd),GEMM 与算子优化(手写分块乘法 + roofline)✅
- 训练侧(02-04):混合精度与显存账本 → 分布式并行四件套(DP/FSDP/TP/PP + ZeRO)→ 集合通信与 NCCL(手写 Ring AllReduce)✅
- 推理侧(05-07):KV Cache 与内存计算 → 推理引擎 vLLM 连续批处理/投机解码 → 量化与压缩(PTQ/GPTQ/AWQ/SmoothQuant)✅
- 工程与冲刺(08-09):性能分析与优化(profiler/算子融合/成本估算)→ AI-Infra 面试八股速查(30 连问 + 手算题)✅
教学 Notebook 索引
| # | 主题 | 核心手写/演示 | 状态 |
|---|---|---|---|
| 00 | 深度学习推理引擎:从计算图到自动微分 | 手写 mini autograd(Value 类 + 拓扑序反向)数值梯度对照 <1e-8 / 引擎训练 XOR 100% / 7B 激活显存估算 / 算子融合实测 | ✅ |
| 01 | 矩阵乘法与算子级优化:GEMM 工程解剖 | naive vs 分块(tiled) vs 寄存器分块实测 / FLOPs·算力·带宽 roofline / 块大小甜点区扫描 | ✅ |
| 02 | 混合精度与显存账本 | FP16 上溢/下溢演示 / BF16 模拟截断 / loss scaling 救回梯度曲线 / 7B 显存四件套 + ZeRO-1/2/3 分片堆叠图 | ✅ |
| 03 | 分布式并行训练:DP/FSDP/TP/PP/ZeRO | 4 卡数据并行梯度 allreduce = 串行验证 / 张量并行行切·列切等价 + 通信量 / PP bubble 曲线 / 70B 显存-通信权衡双轴图 | ✅ |
| 04 | 集合通信与 NCCL:手写 Ring AllReduce | 原语全家桶速验 / 手写 Ring AllReduce 两阶段(P=4/8 数值验证)/ ring vs tree 通信量曲线 / 梯度桶化演示 | ✅ |
| 05 | KV Cache 与推理内存 | 缓存 vs 无缓存工作量曲线 / KV 内存公式手算与增长曲线 / 手写带缓存解码一致验证 / PagedAttention 分页 vs 连续预分配 | ✅ |
| 06 | 推理引擎:vLLM 连续批处理与投机解码 | 静态 vs 连续批处理调度模拟(活跃度曲线)/ 投机解码加速比公式+模拟 / decode 吞吐-延迟权衡曲线 | ✅ |
| 07 | 量化与模型压缩 PTQ/GPTQ/AWQ/SmoothQuant | per-tensor vs per-channel 误差实测 / 输出域误差补偿机制(最小二乘投影验证)/ SmoothQuant 激活迁移数学等价验证 / 位宽-精度-显存权衡 | ✅ |
| 08 | 性能分析与优化 | 手写简易 profiler 时间拆解 / roofline 实测判定算力-带宽受限 / 算子融合收益实测 / 6ND 训练成本与推理成本估算 | ✅ |
| 09 | AI-Infra 面试八股与高频题 | 八大块知识地图 + 30 连问(30 秒答案)+ 5 道手算题自动判分 + 一句话串联全章 | ✅ |
| 10 | FlashAttention 与 CUDA 线程模型 | 显存层级与 roofline 回顾 / 标准注意力 IO 瓶颈定量 / 手写分块 softmax(online softmax)数值对照 / flash attn 前向模拟(tiling 循环)/ CUDA 线程模型(grid-block-thread)与 block reduce 演示 / 面试考点 | ✅ |
🖼️ 图库:自绘高清流程图 + 官方高清配图
自绘高清流程图(11 张 · 300dpi · 教学/images/,原创可放大打印)
| 图 | 说明 | 用于 Notebook |
|---|---|---|
ai_infra_roadmap.png |
AI-Infra 四大阶段知识地图(打底→训练侧→推理侧→工程冲刺) | 09 |
ring_allreduce.png |
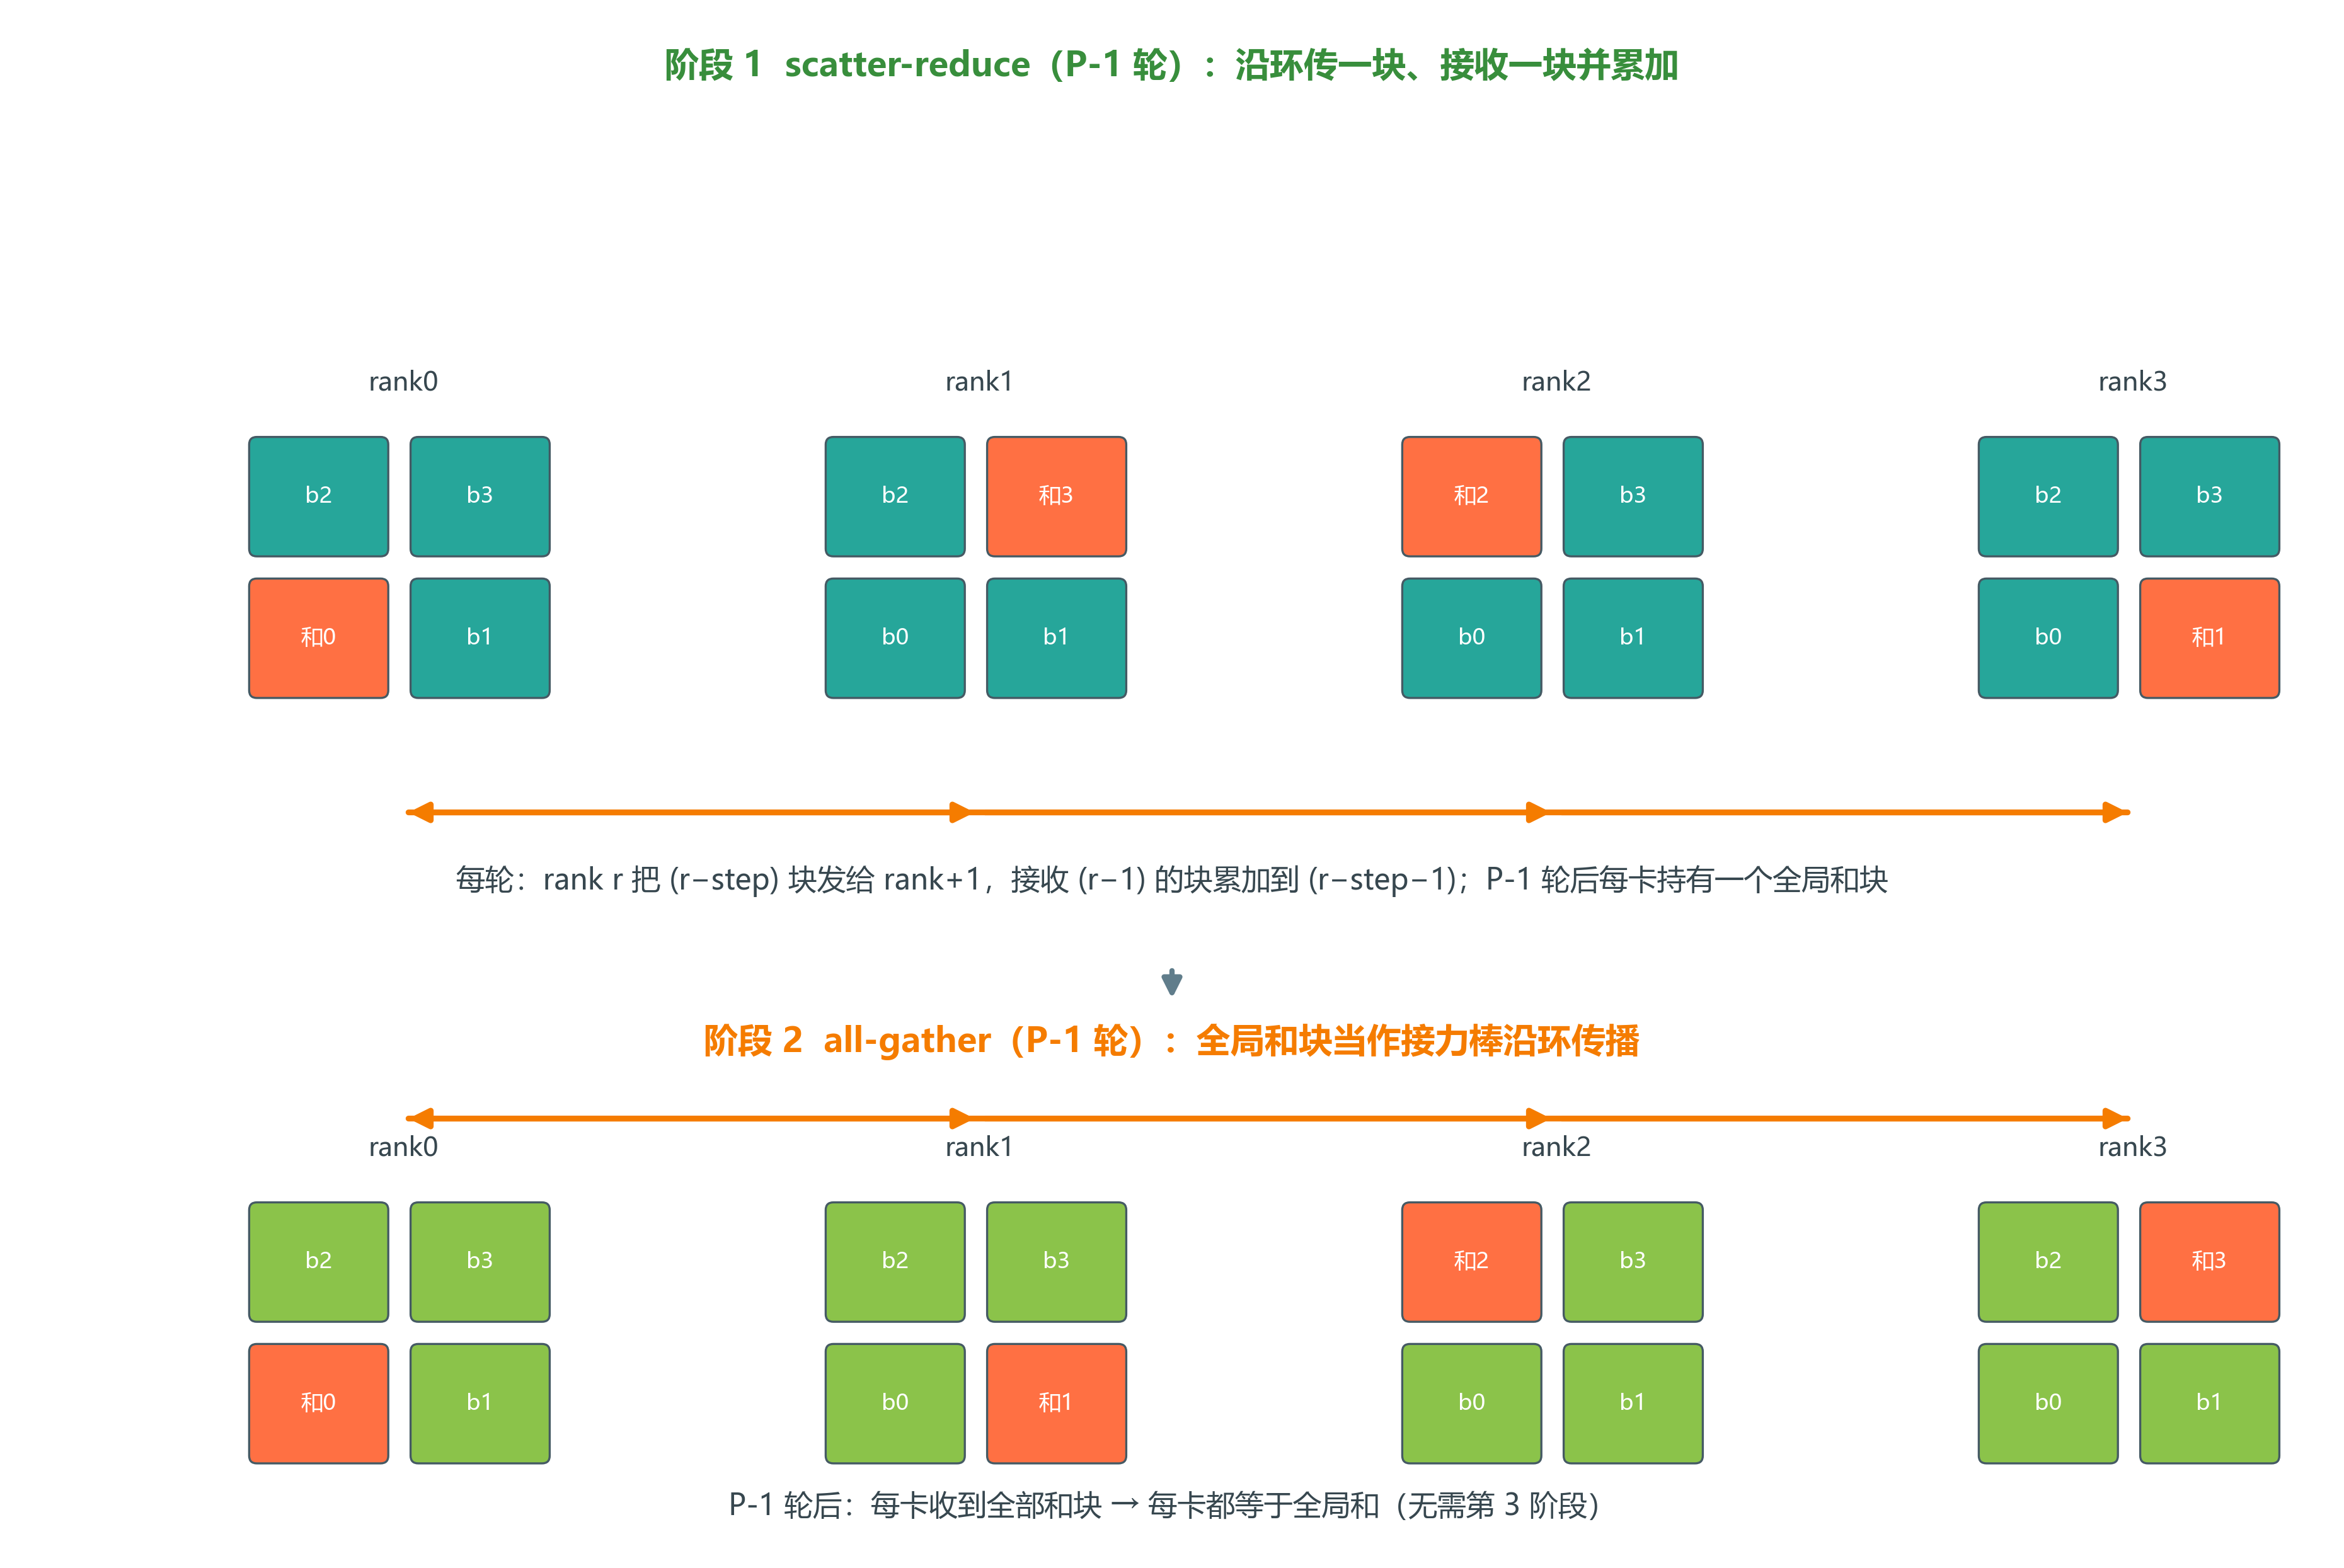
Ring AllReduce 两阶段(scatter-reduce + all-gather)4 卡示意 | 04 |
batch_scheduling.png |
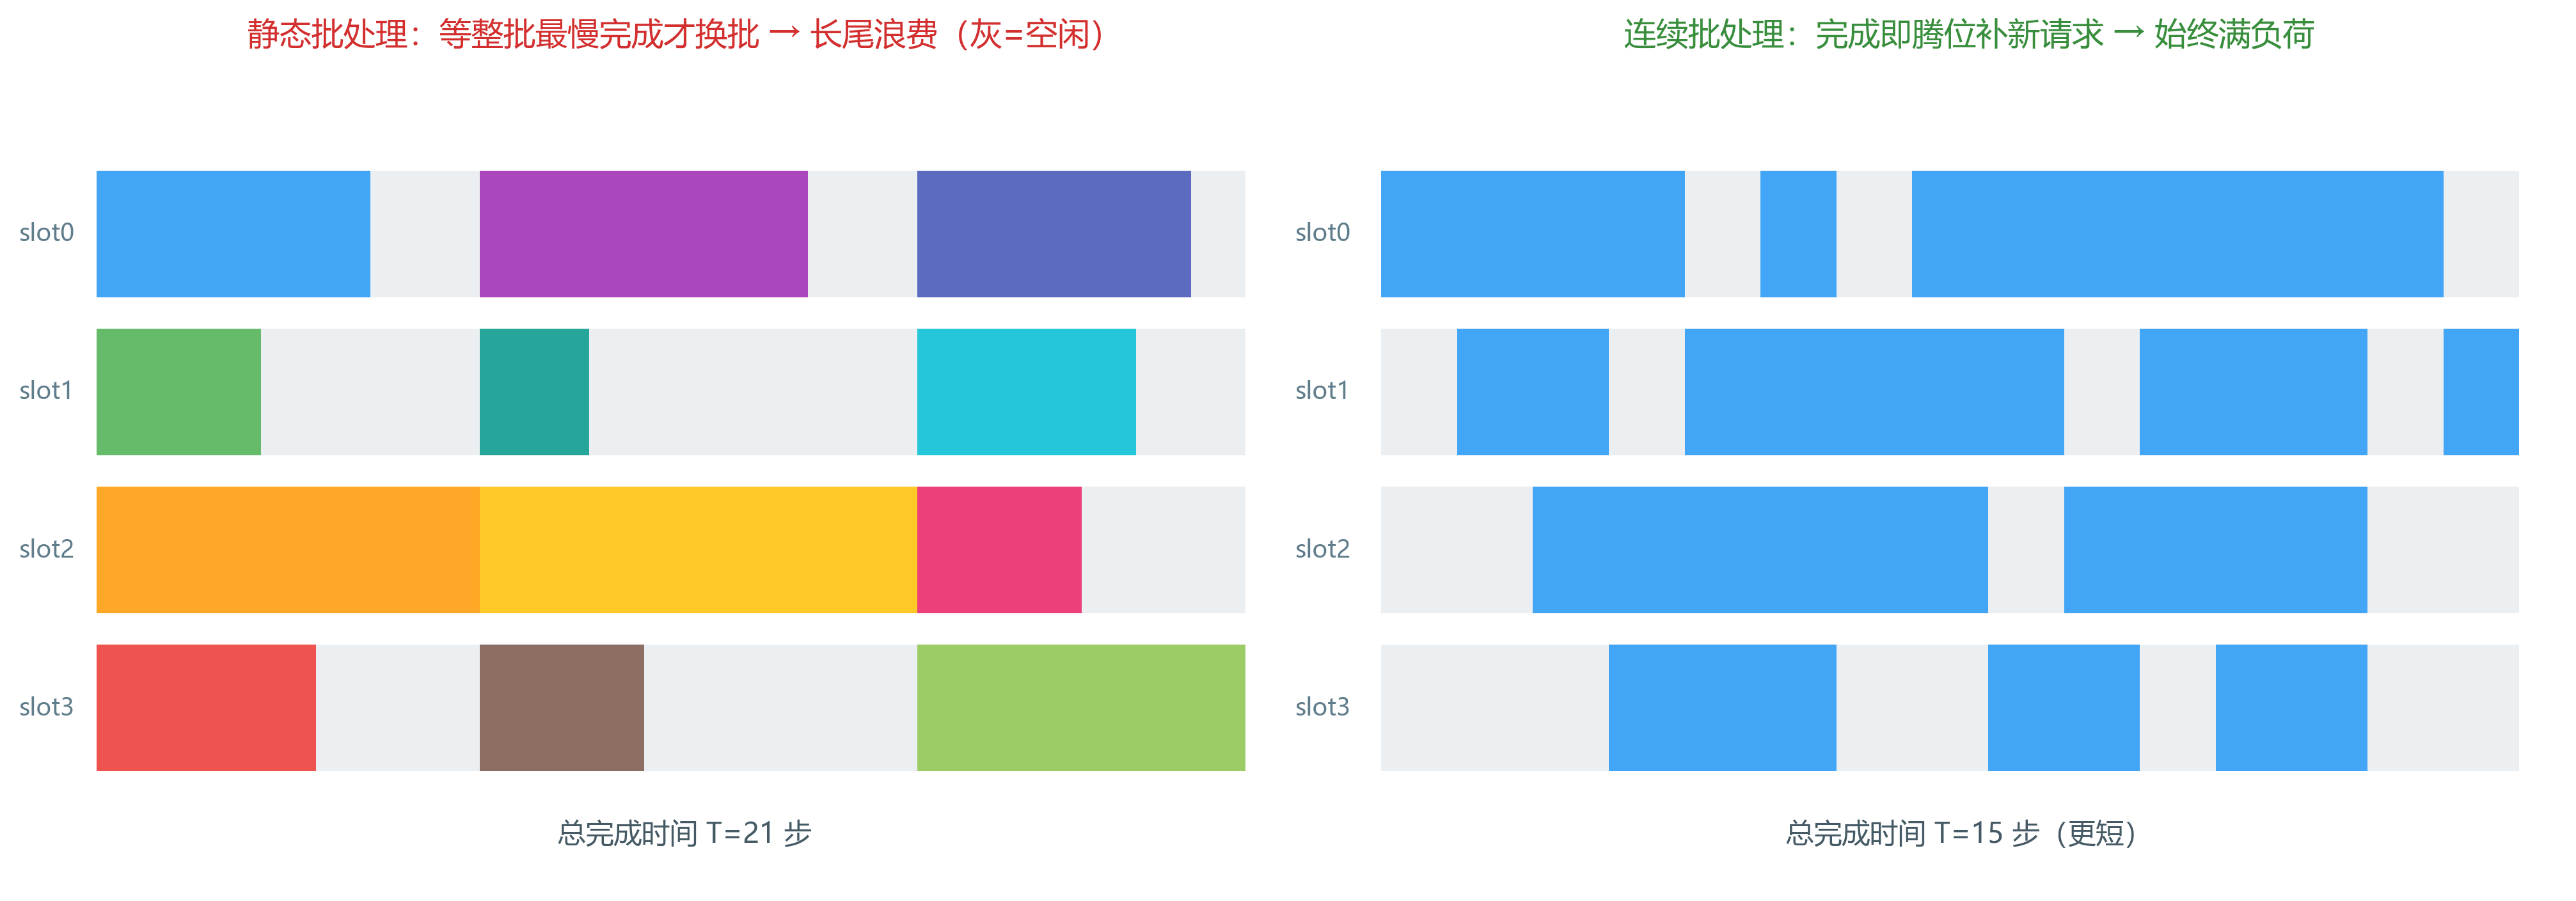
静态 vs 连续批处理甘特图(长尾浪费 vs 完成即补位) | 06 |
parallel_3d.png |
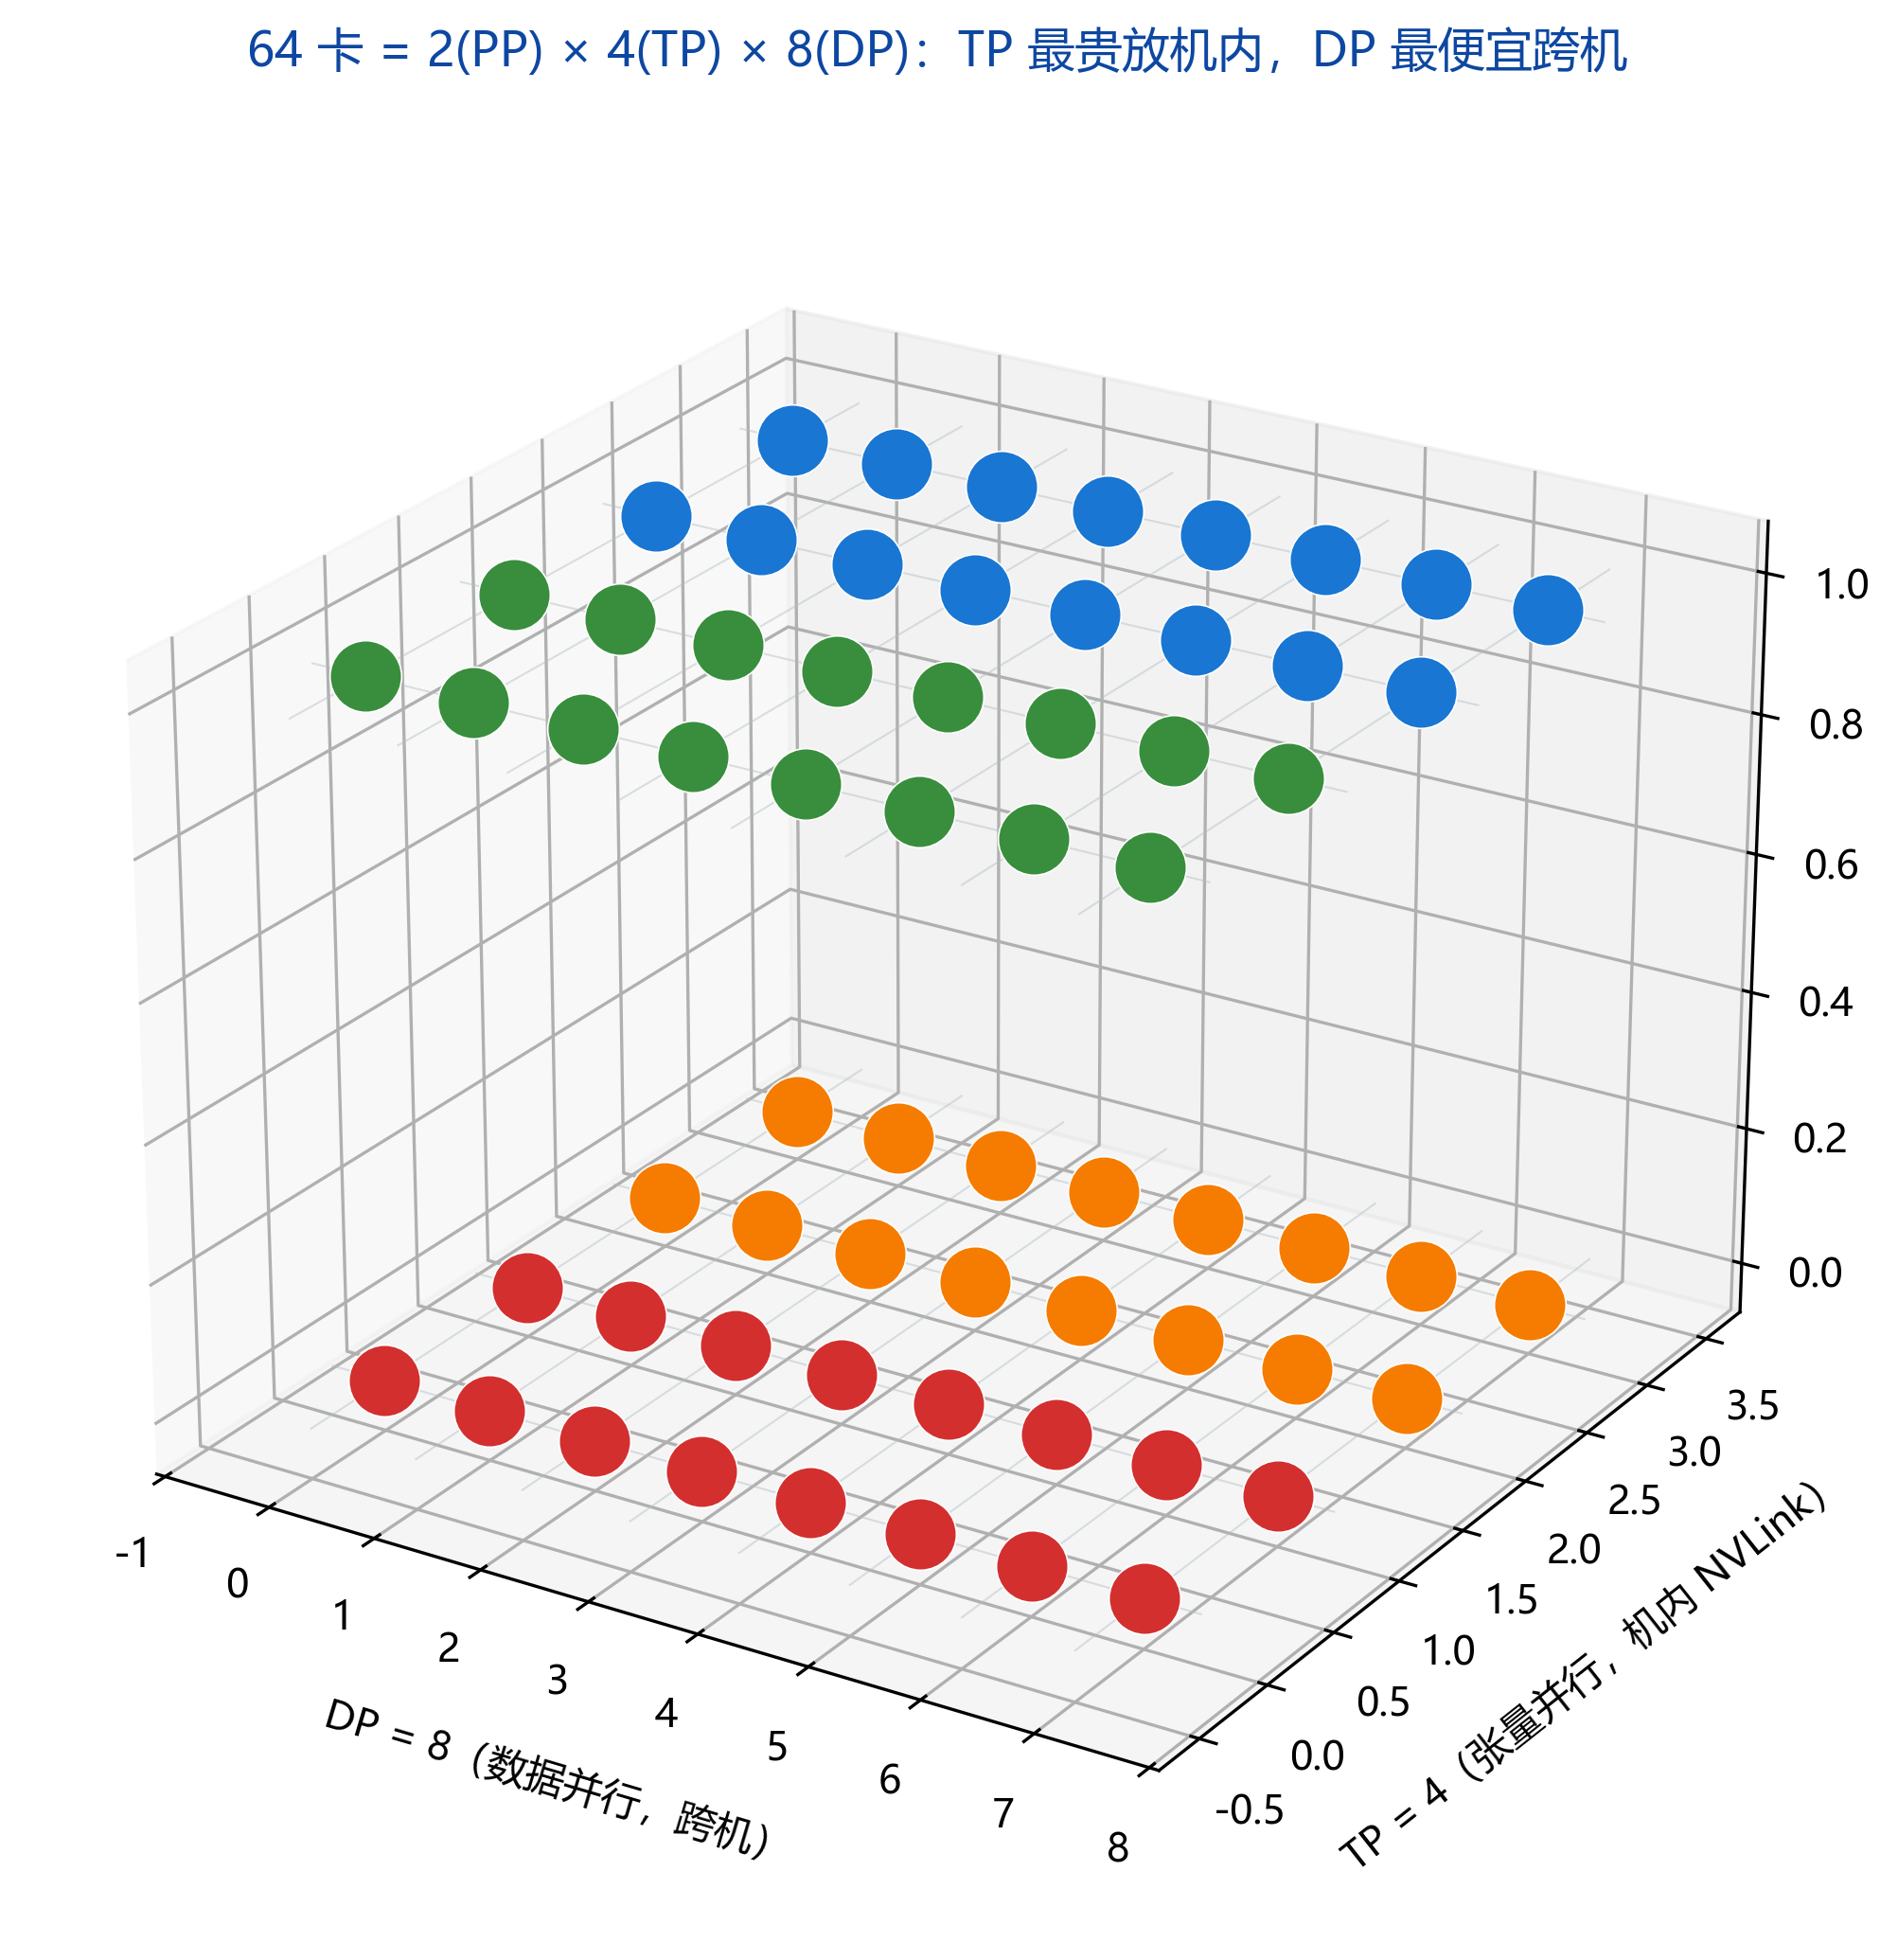
DP×TP×PP 三维并行网格(64 卡 = 2×4×8) | 03 |
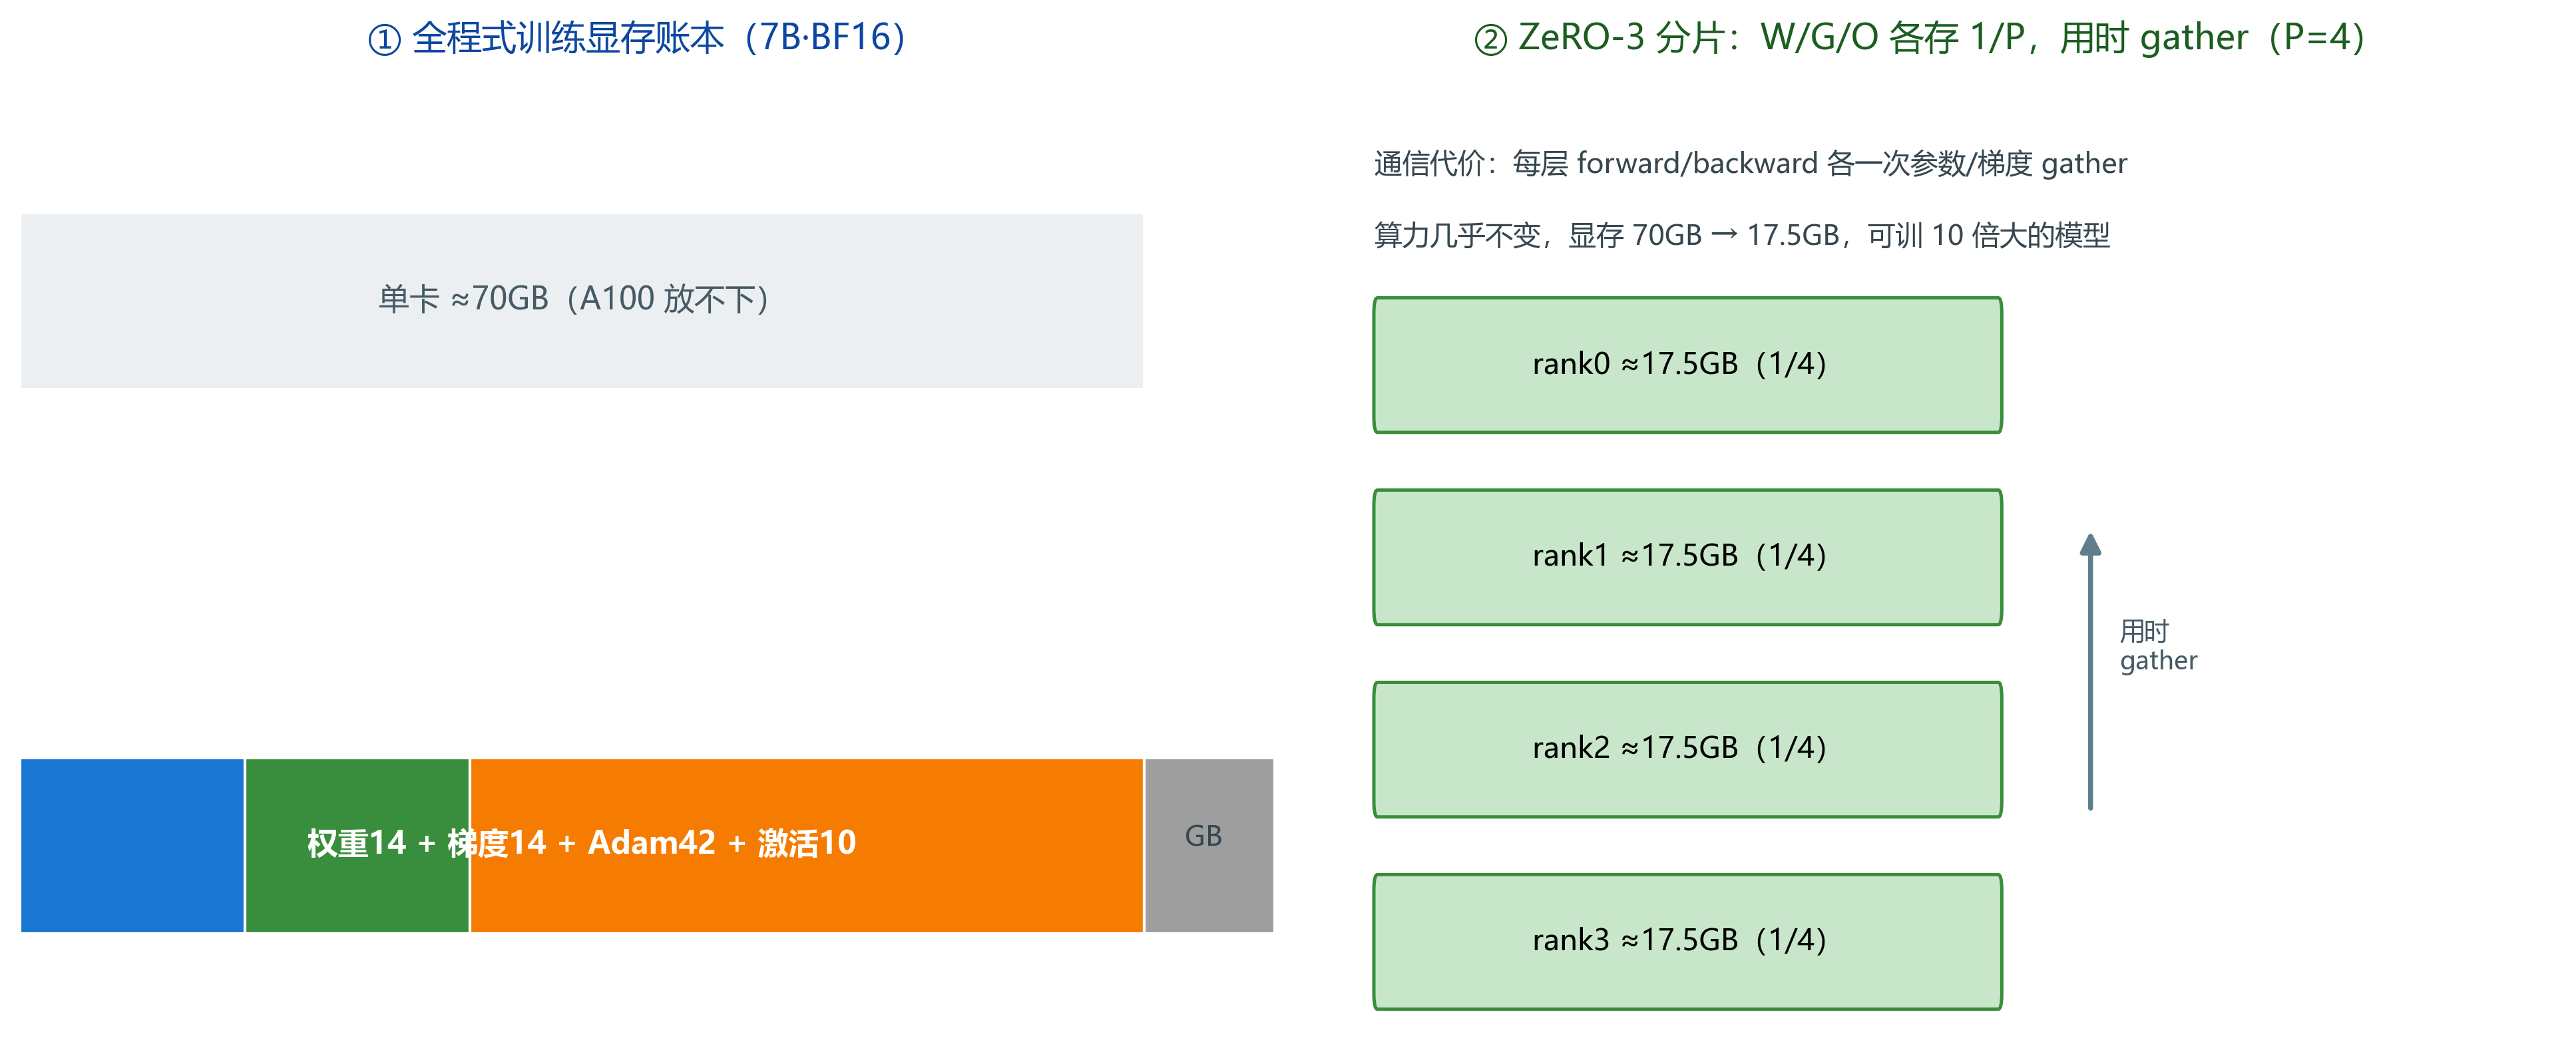
memory_zeRO.png |
训练显存四件套(BF16 7B:权重14+梯度14+Adam84≈112GB)→ ZeRO-3 分片(P=8 每卡≈14GB) | 02 |
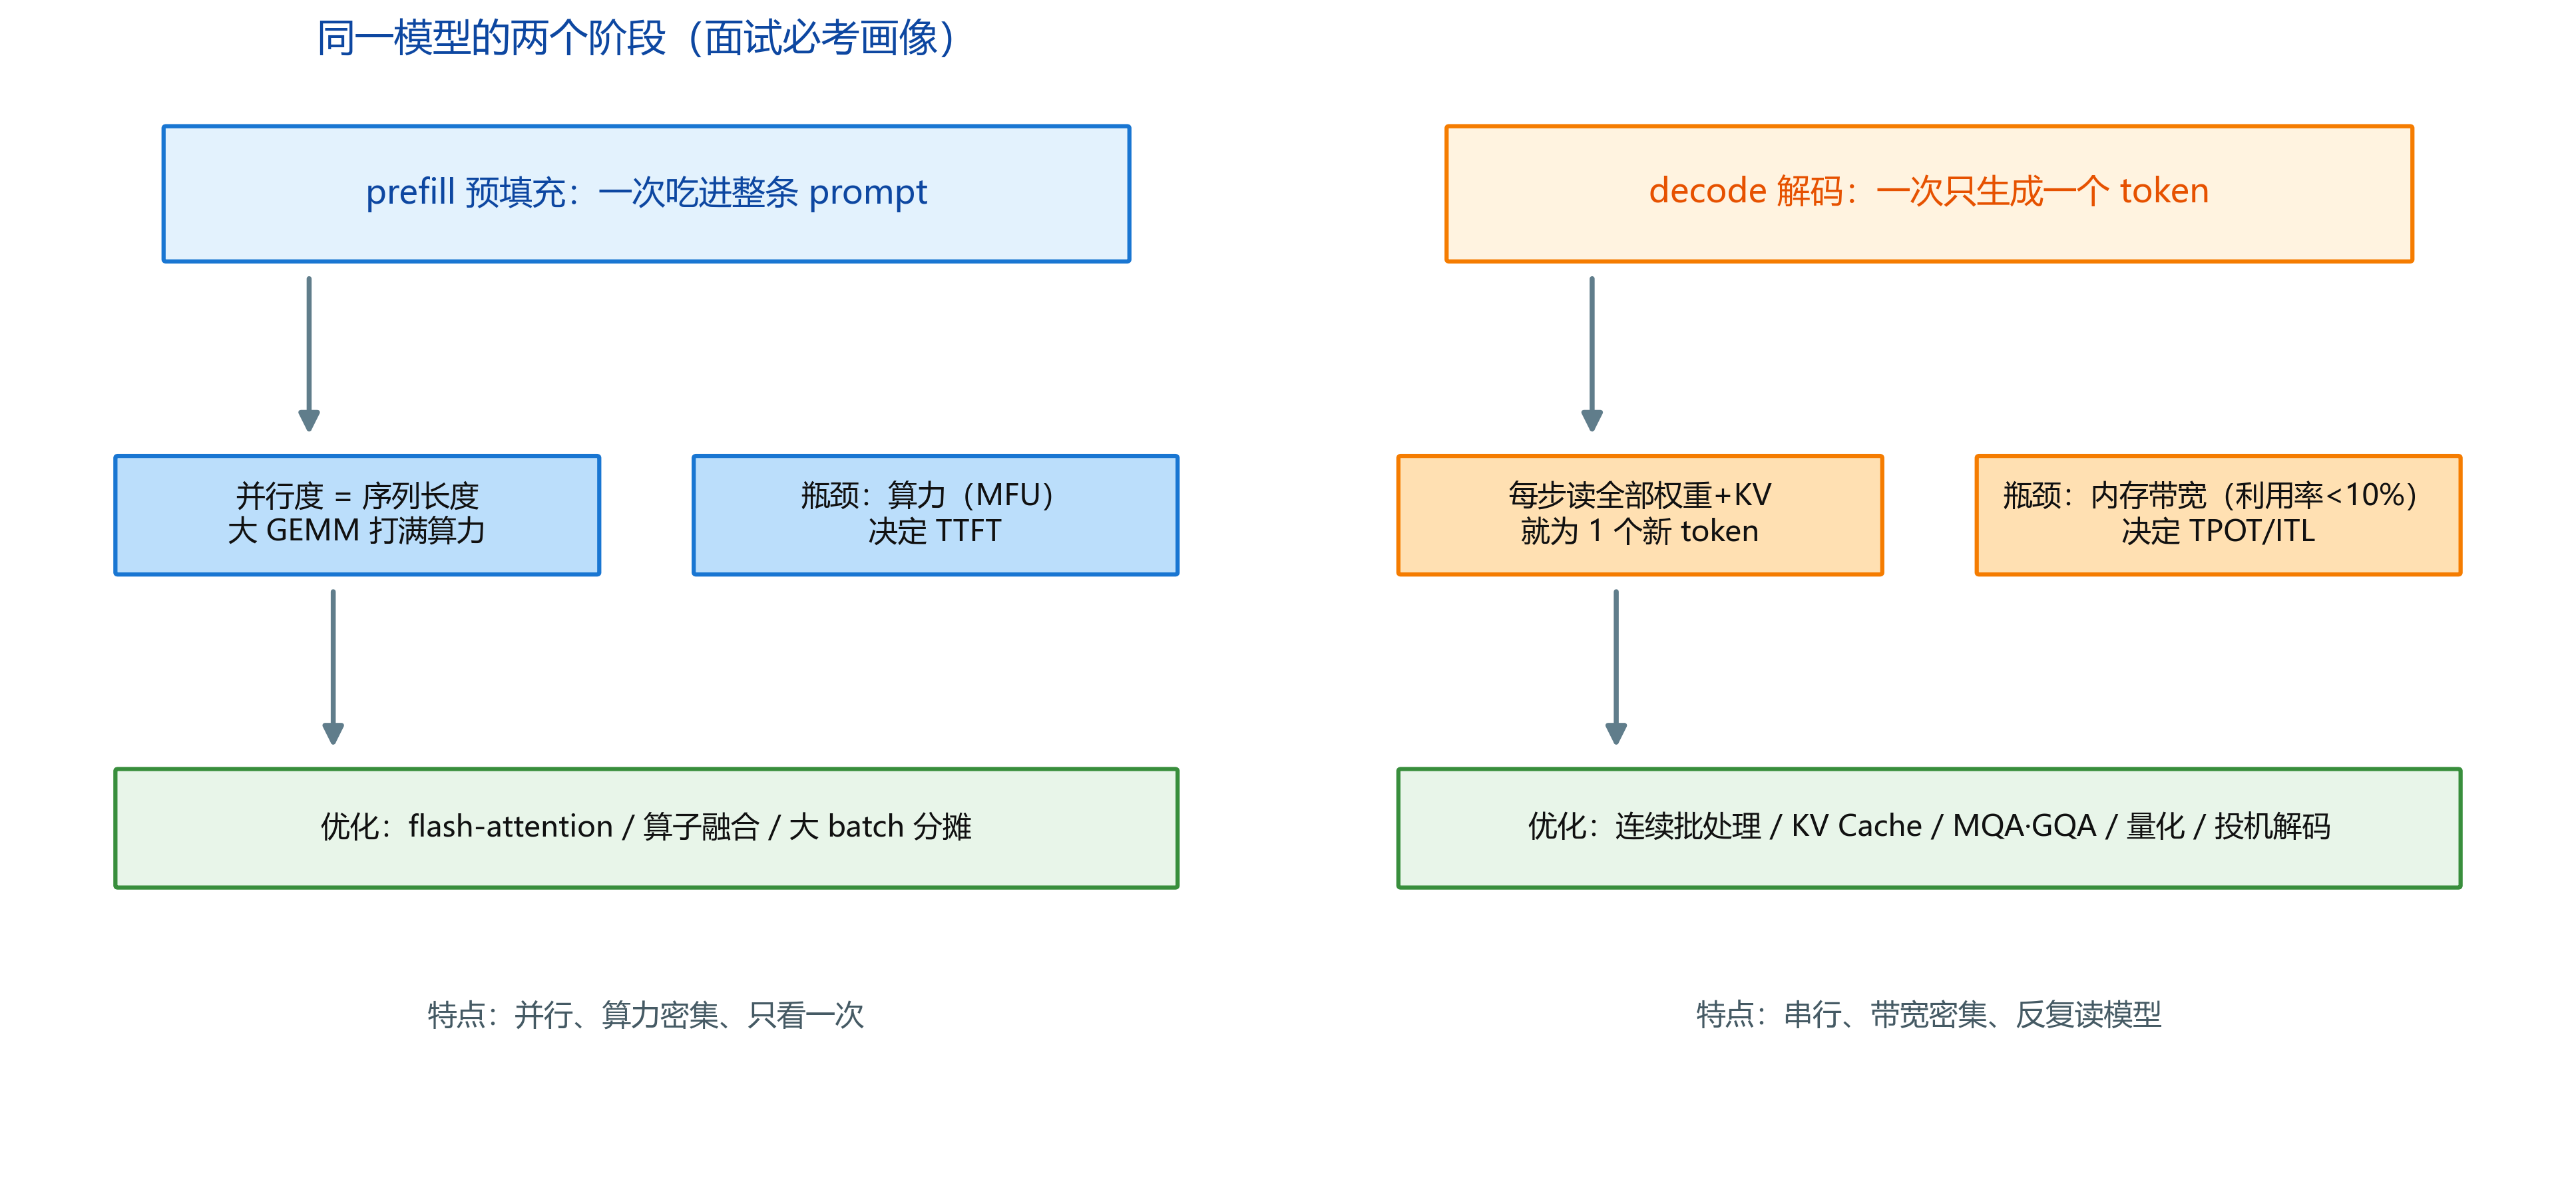
prefill_decode.png |
prefill(算力受限)vs decode(带宽受限)两阶段画像 | 06 |
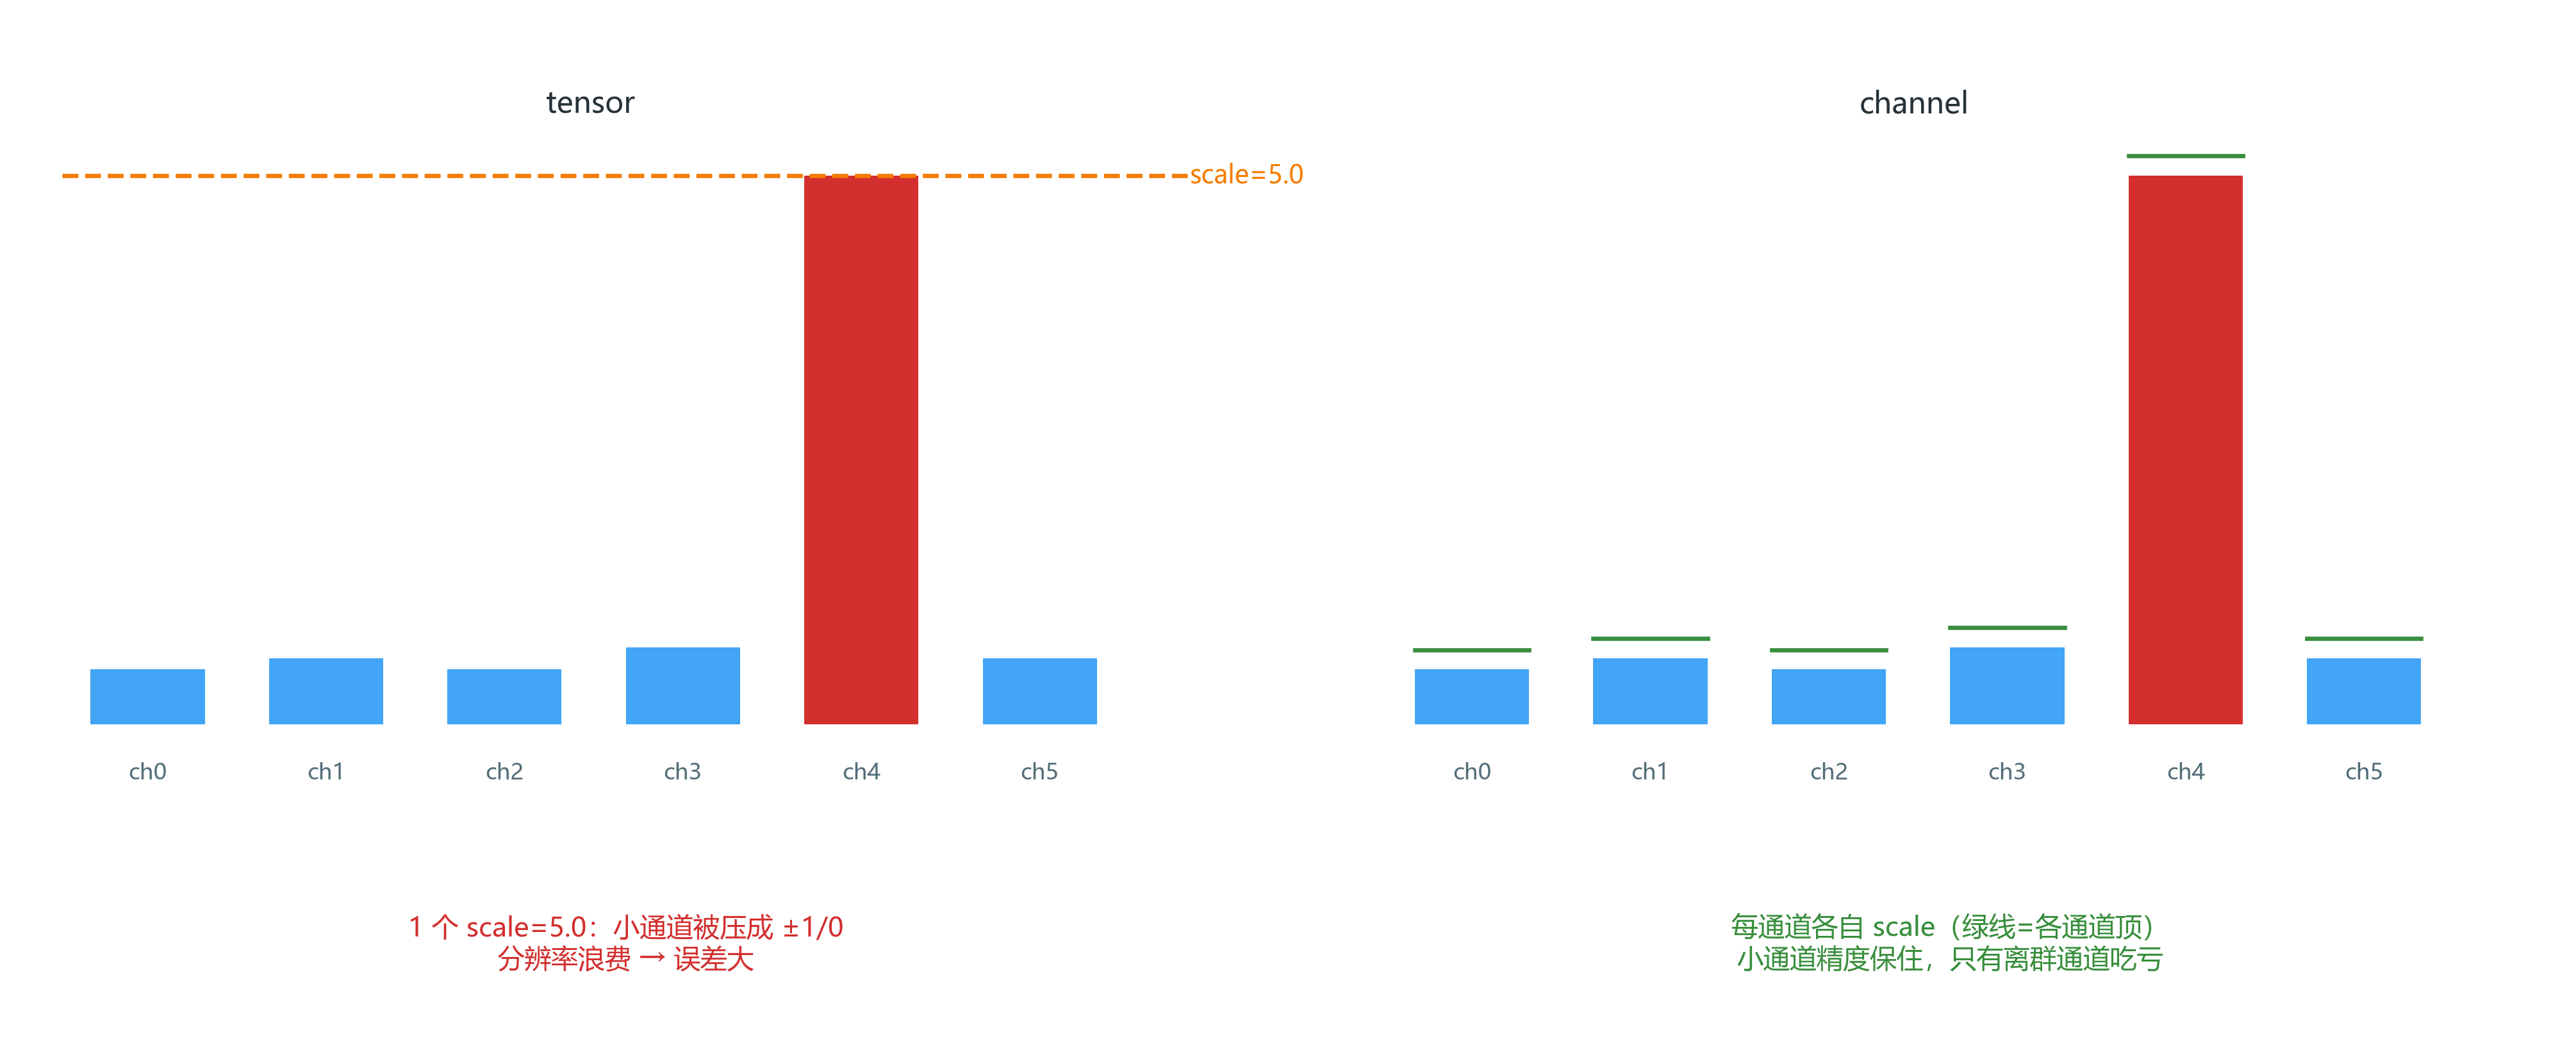
quantization_scales.png |
per-tensor vs per-channel 量化 scale(离群通道效应) | 07 |
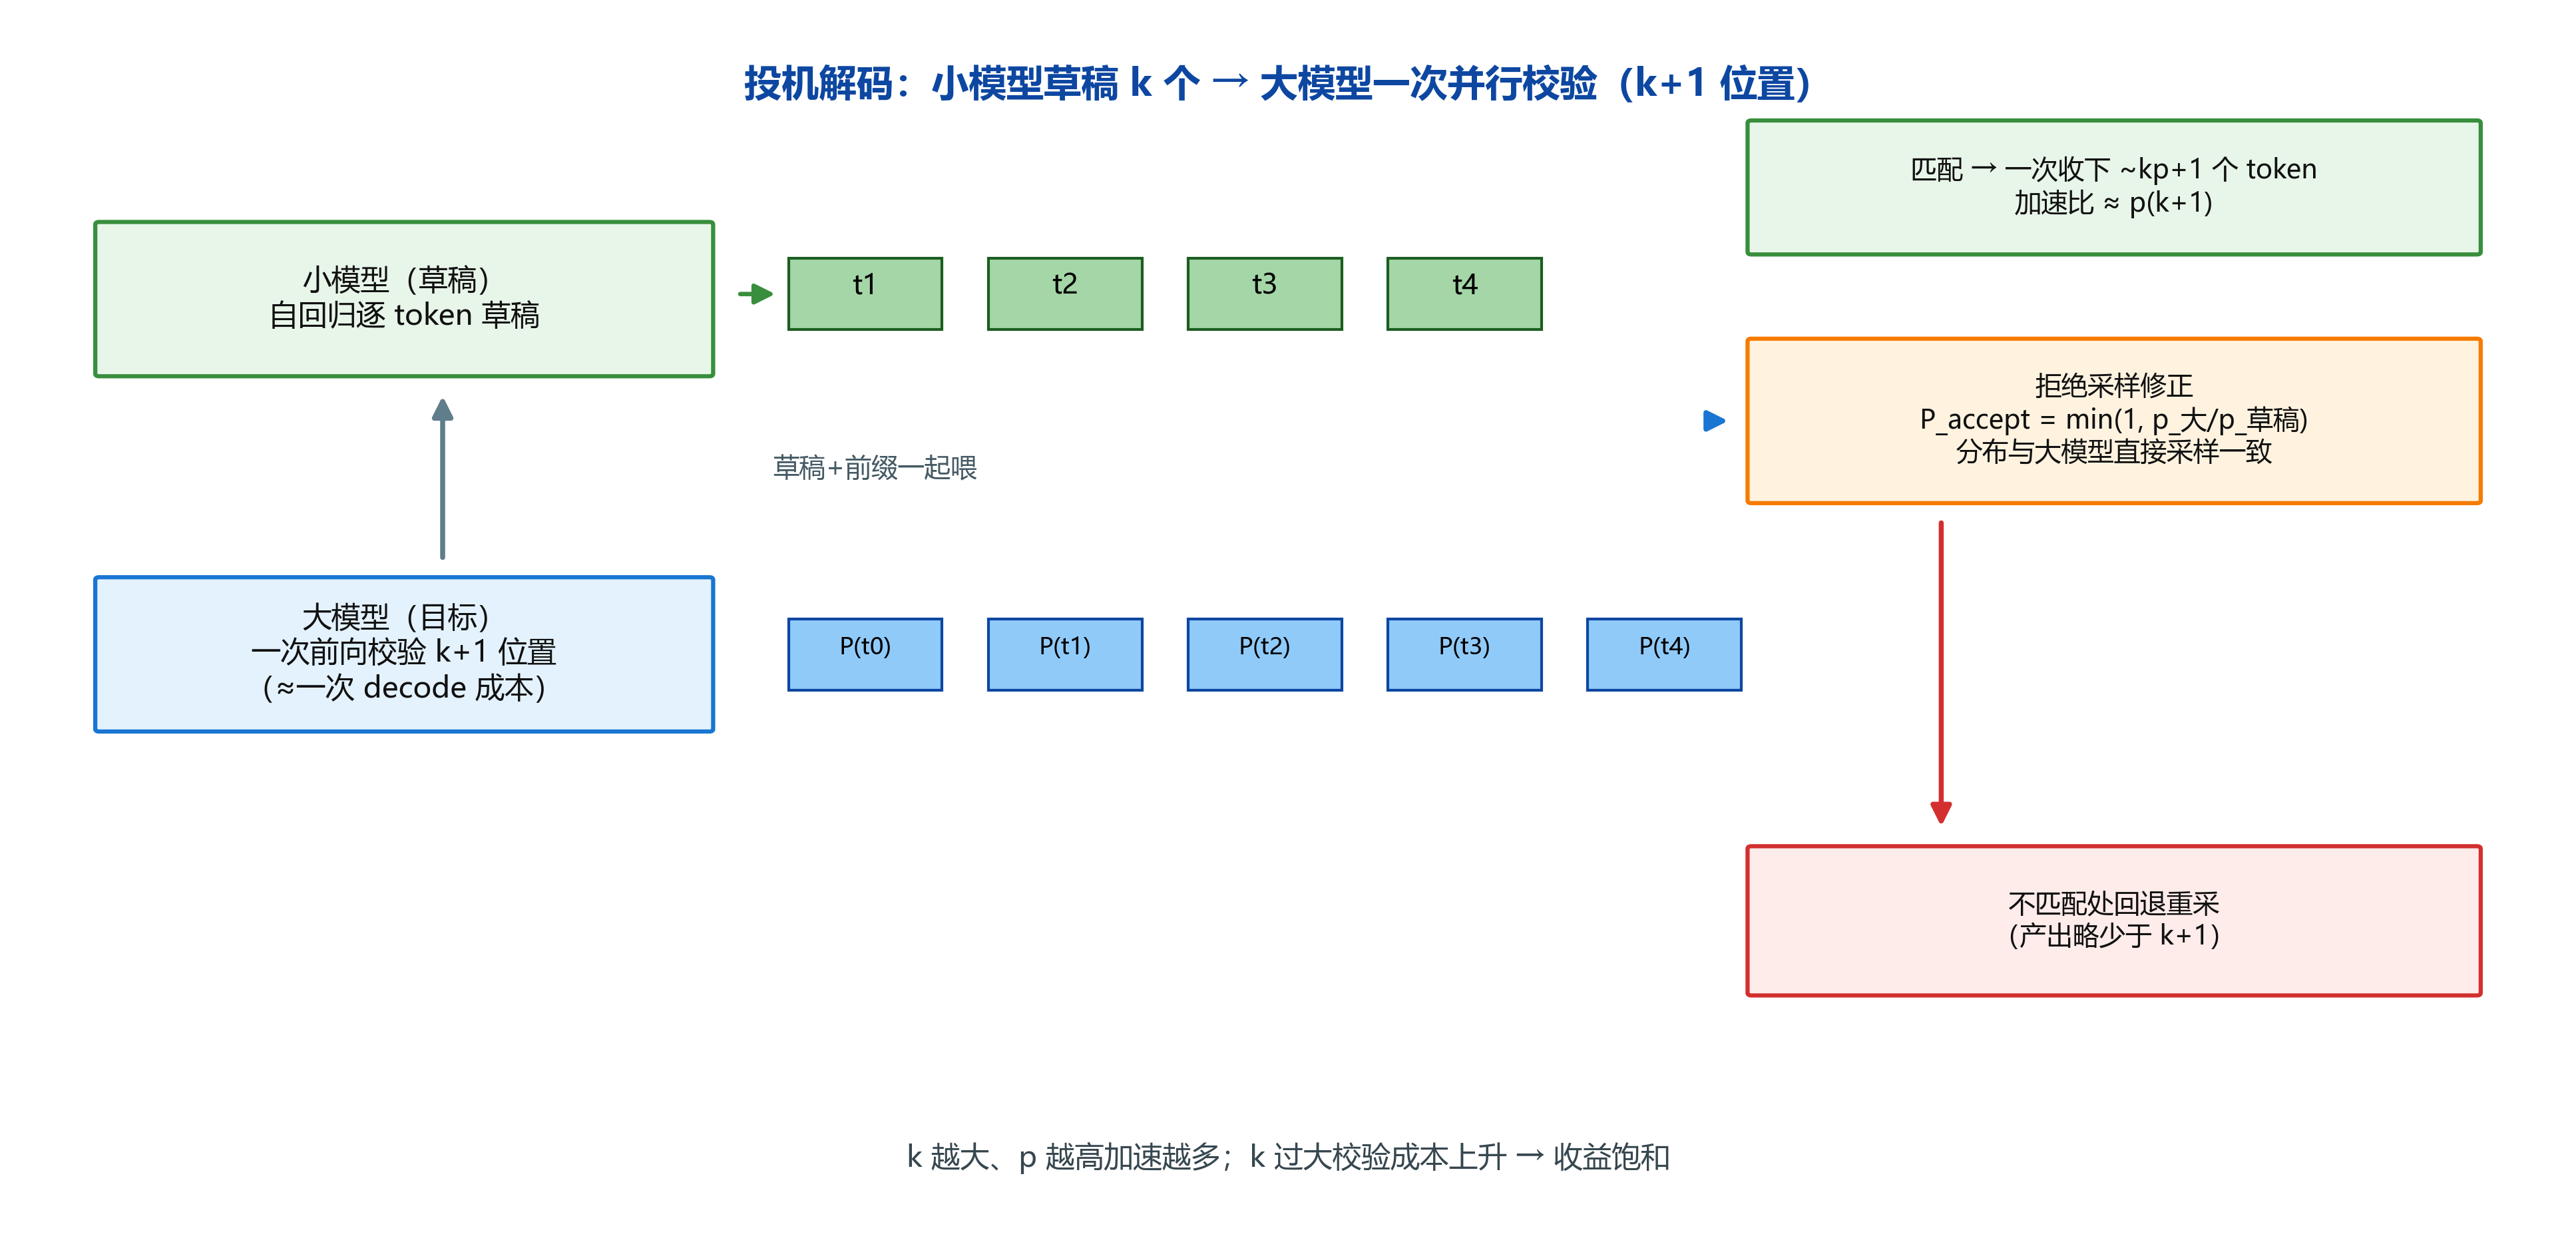
speculative_decoding.png |
投机解码流程(草稿→并行校验→拒绝采样) | 06 |
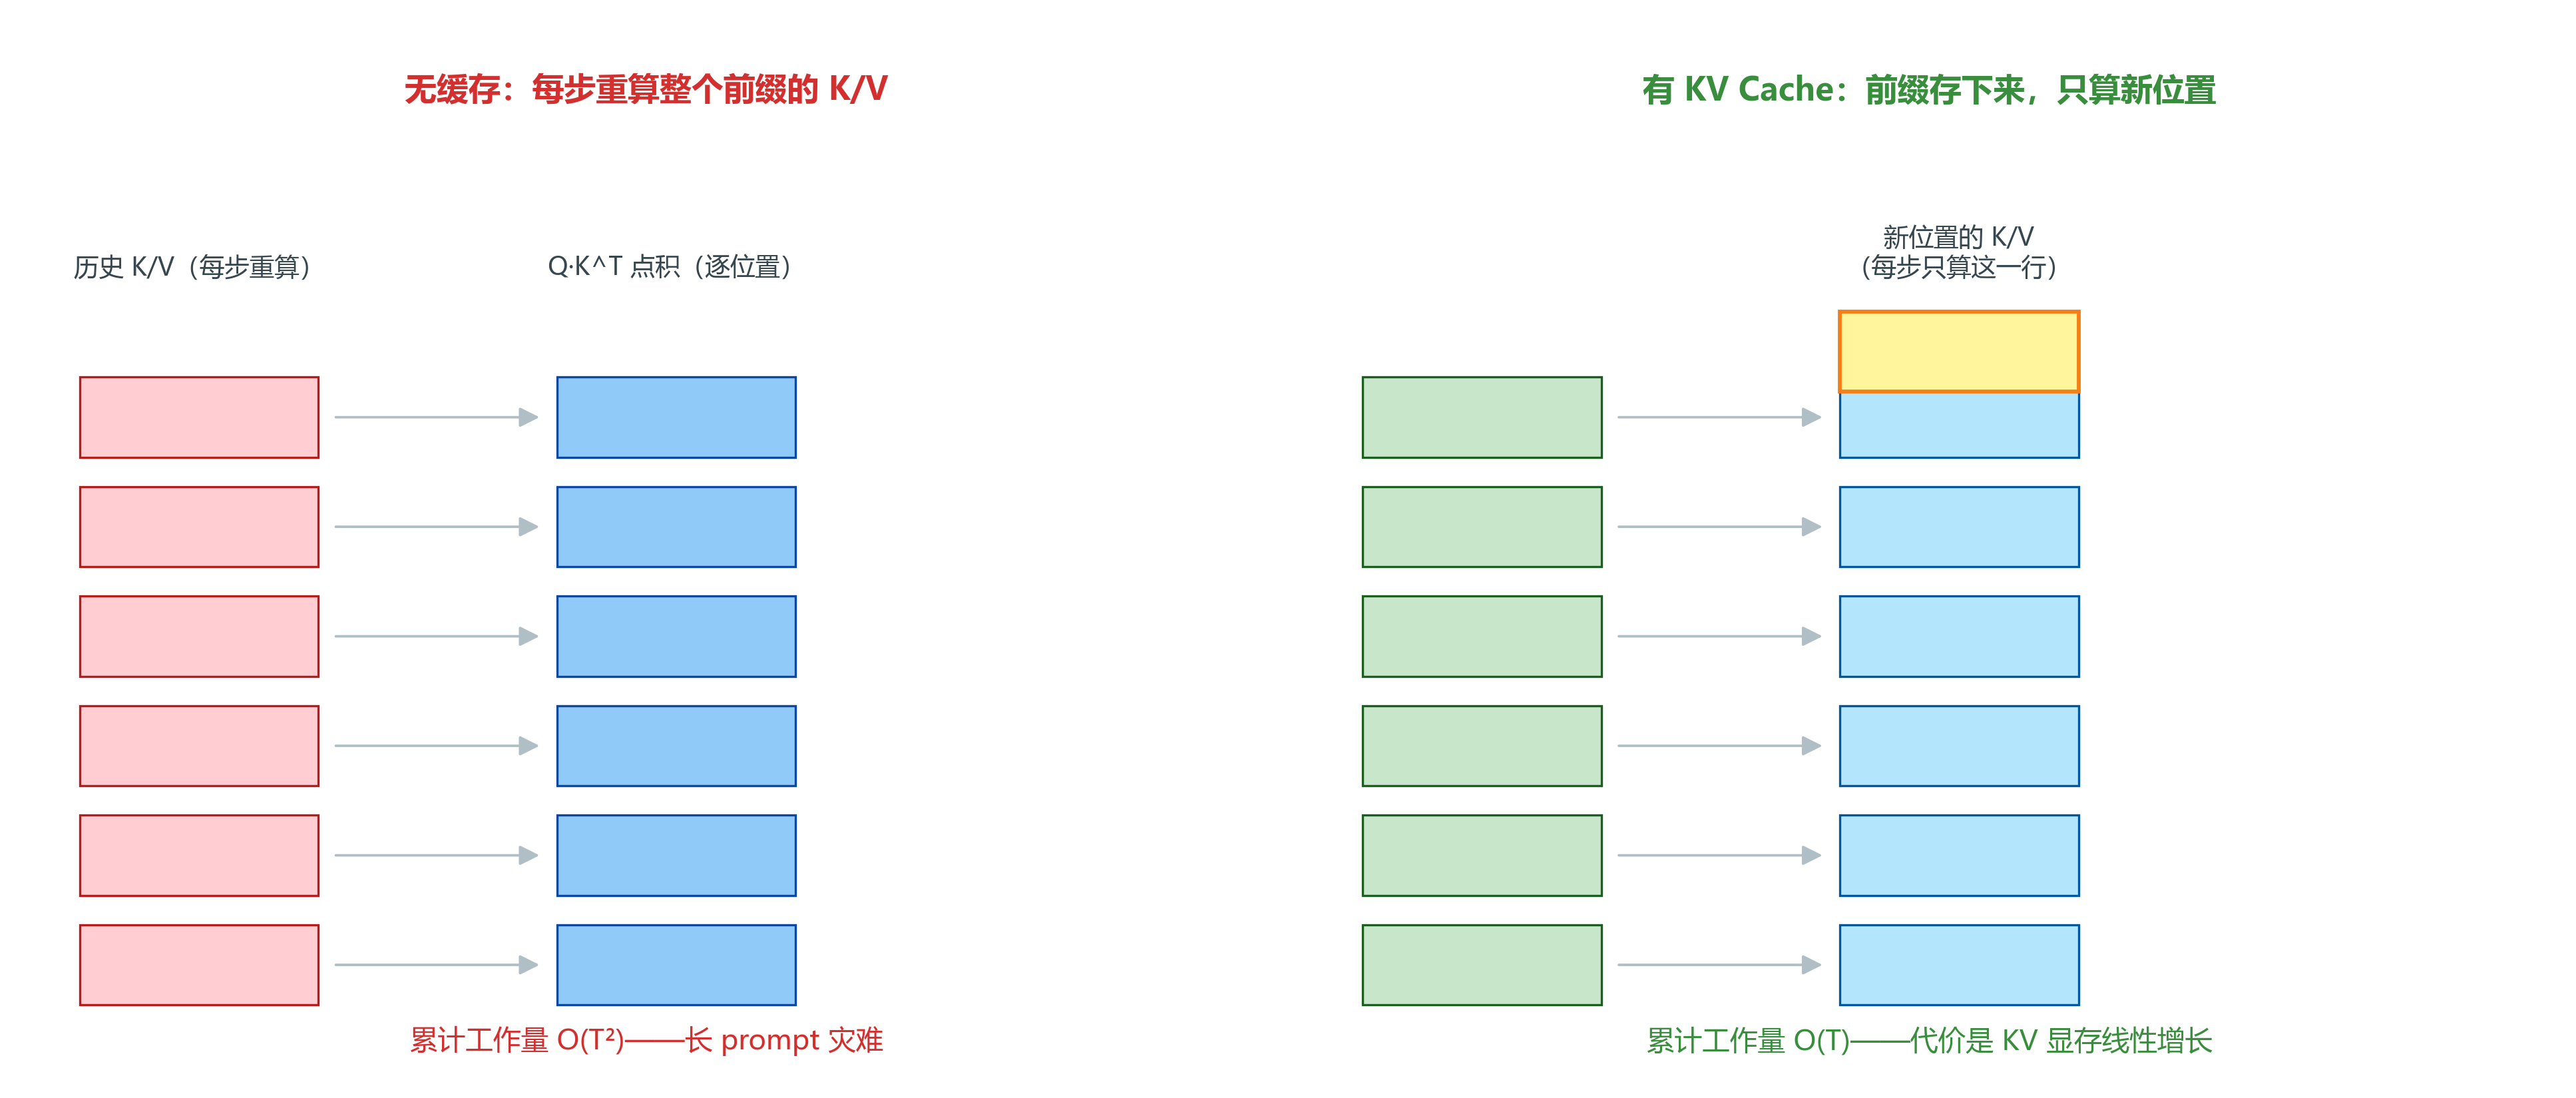
kv_cache_mem.png |
有/无 KV Cache 的注意力机制(O(T²)→O(T)) | 05 |
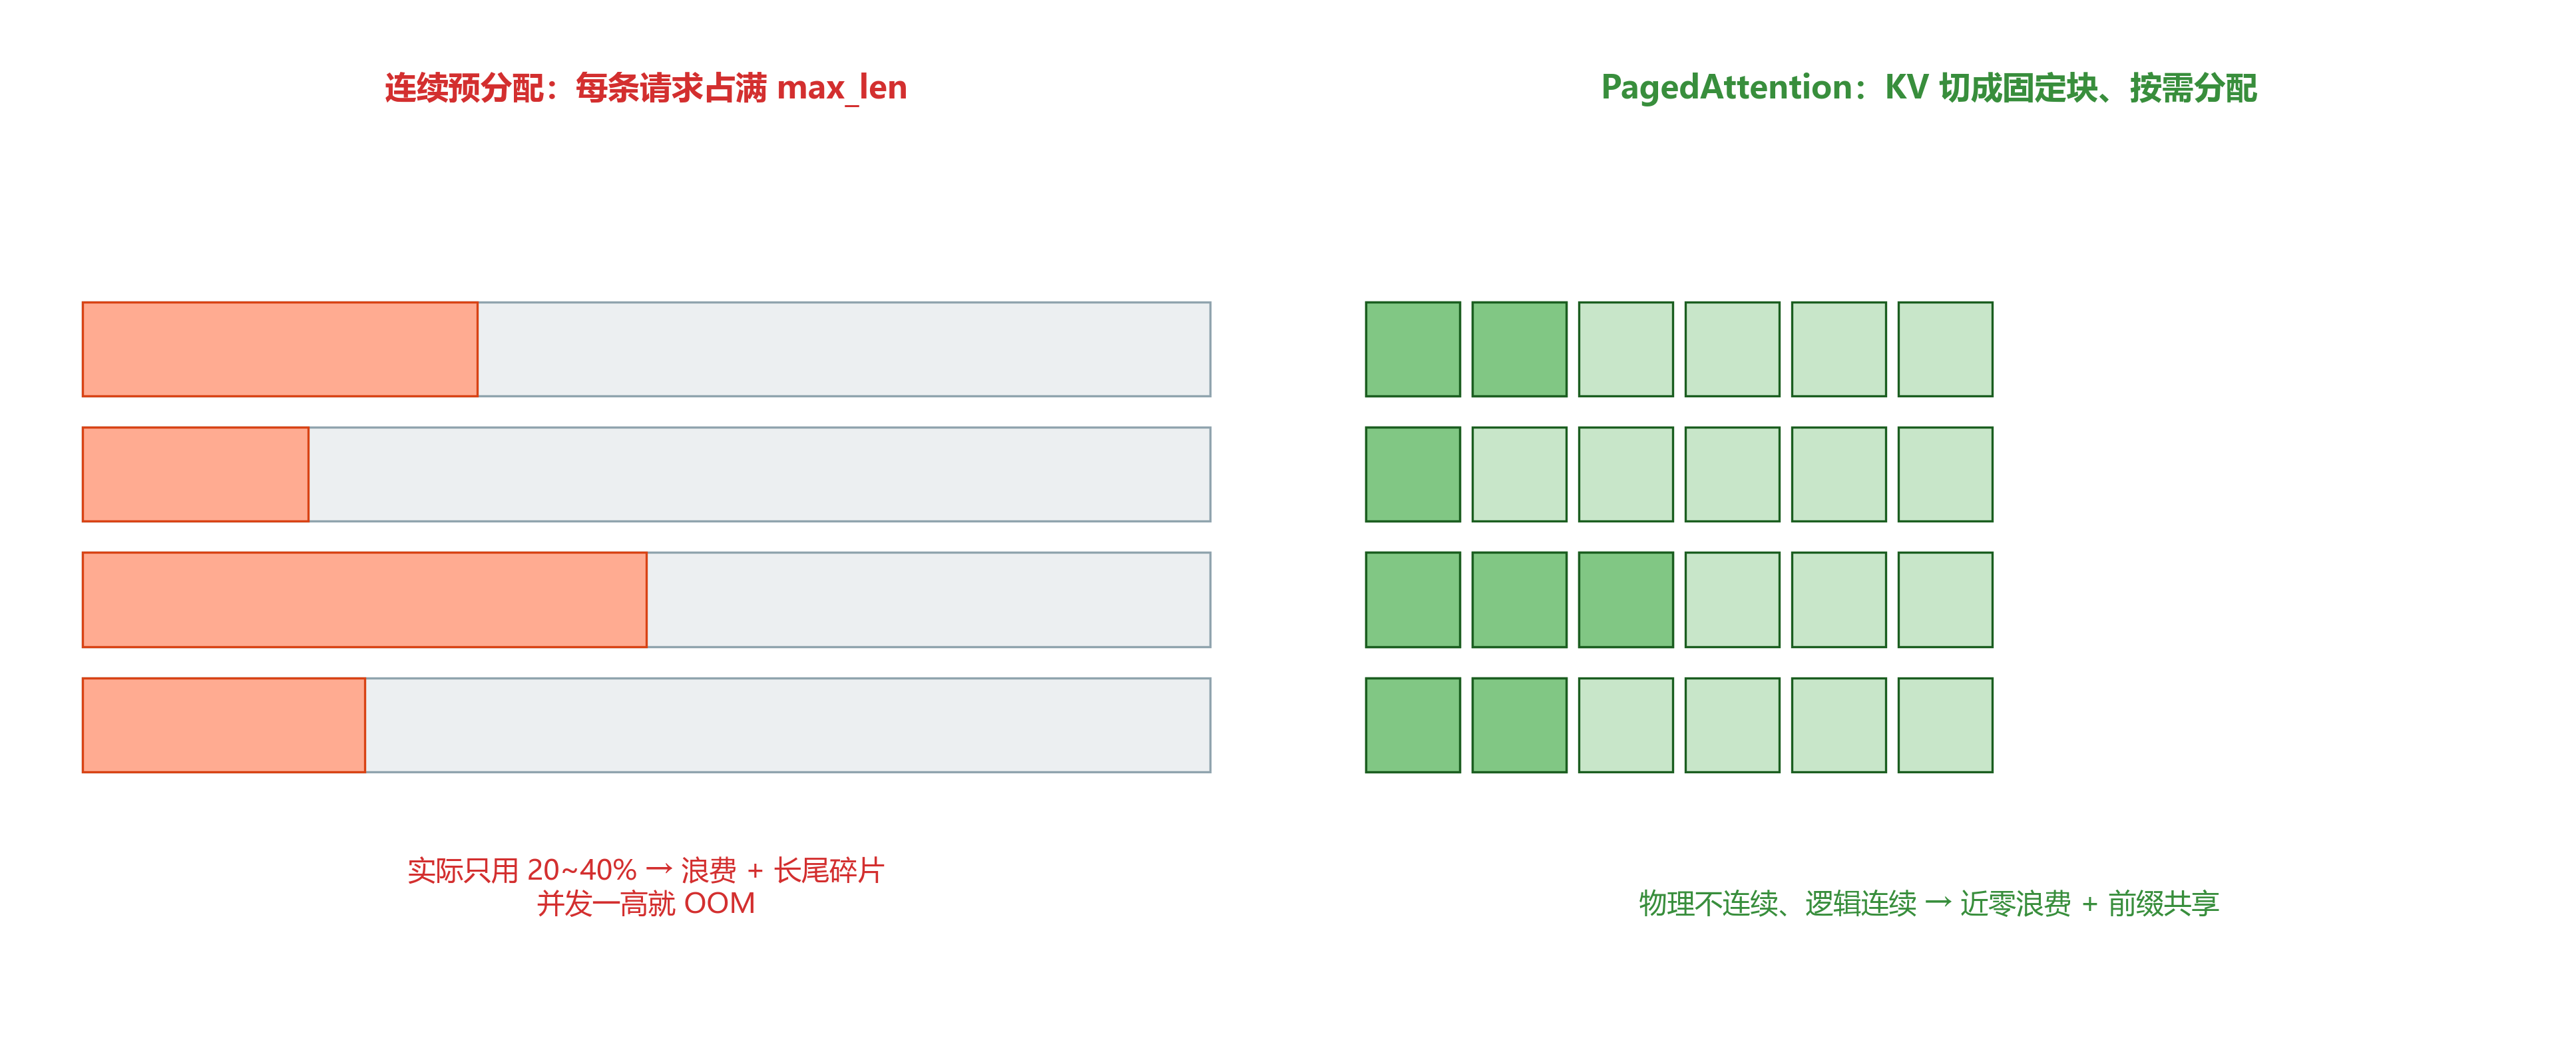
paged_vs_contig.png |
连续预分配(20-40% 利用率)vs PagedAttention 分页 | 05 |
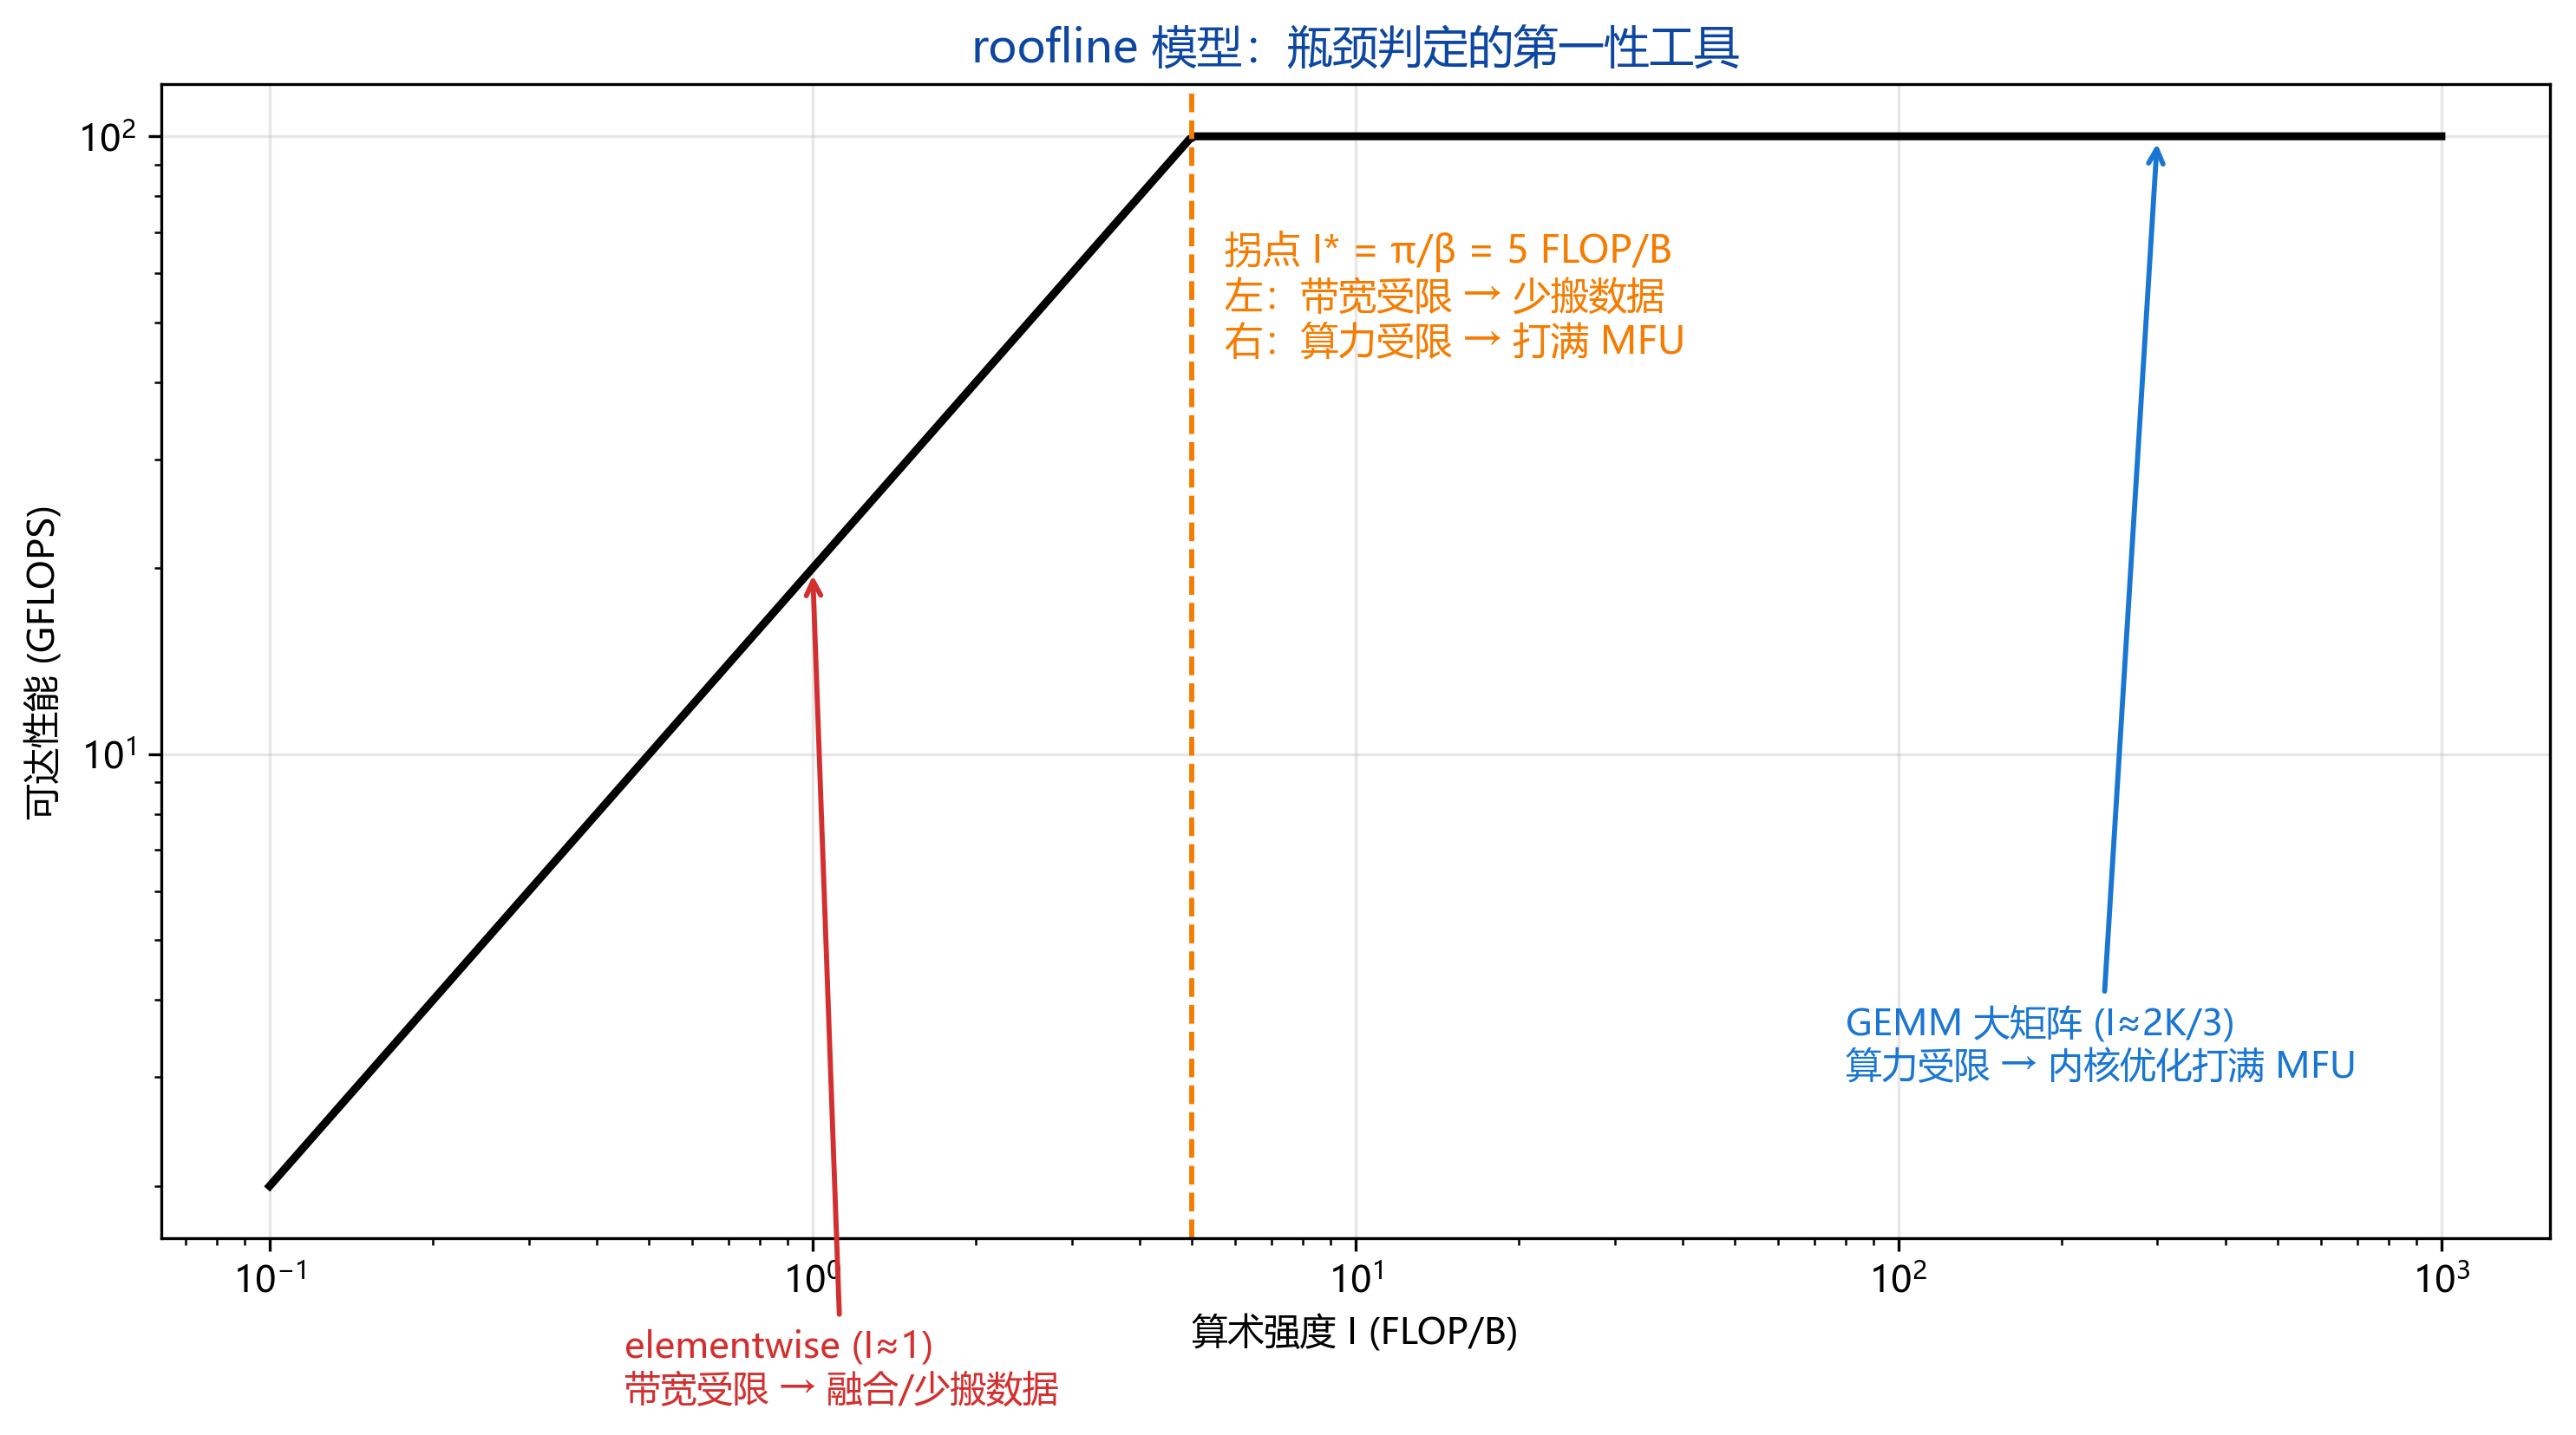
roofline_annotated.png |
roofline 拐点标注(带宽受限 vs 算力受限) | 01 / 08 |
自绘机制图(SVG · 矢量 · 公式可缩放)
面向"过程可视化"教学:把推导中间步骤、调度时间线、内存/通信/量化迁移画成矢量图,放大不糊、公式清晰,随 Notebook 内嵌使用。
| 图 | 说明 | 用于 Notebook |
|---|---|---|
00_autograd_backward.svg |
前向计算图 → 反向梯度流(链式法则逐边传播) | 00 |
02_precision_memory_tradeoff.svg |
FP32/BF16/FP16/INT4 位宽-精度-显存权衡 | 02 |
03_pipeline_1f1b_schedule.svg |
流水线并行 1F1B 调度时间线与气泡公式 | 03 |
04_ring_tree_topology.svg |
Ring/Tree 拓扑连边与 α-β 时间模型交叉 | 04 |
07_smoothquant_migration.svg |
SmoothQuant 激活-权重离群迁移(X′=X·diag(s)⁻¹) | 07 |
08_profiler_fusion_timeline.svg |
融合 vs 未融合 kernel 时间线与 HBM 流量 | 08 |
10_flashattention_tiling_hbm_sram.svg |
标准 vs tiled FlashAttention(HBM/SRAM/在线 softmax) | 10 |
10_cuda_grid_block_thread.svg |
Grid→Block→Warp→Thread 层级与 GEMM 索引 | 10 |
官方高清配图(论文/官方文档原图,点击直达)
| 主题 | 官方来源 | 图 | 对照阅读 |
|---|---|---|---|
| 3D 并行(DP×TP×PP 组合与 trade-off) | Megatron-LM | 图 1:并行配置示意 | 03 |
| PagedAttention 分页管理 KV | vLLM / PagedAttention | 图 2/3:KV 块与页表 | 05 |
| FlashAttention IO 感知分块 | FlashAttention | 图 1:HBM/SRAM 分块 | 00/08 |
| SmoothQuant 激活-权重迁移 | SmoothQuant | 图 2:离群迁移示意 | 07 |
| GPTQ 量化重建与误差补偿 | GPTQ | 图 1/2:逐列重建 | 07 |
| ZeRO 的 P/G/O 三级分片 | DeepSpeed ZeRO | 图 1:显存分片 | 02/03 |
| Ring AllReduce 两阶段流水 | Bringing HPC Techniques to DL | 图 2:ring 收发轮转 | 04 |
| Transformer 架构总览 | Attention Is All You Need | 图 1 | 00 |
| KV Cache 机制图解 | HuggingFace KV Cache 指南 | 官方图示 | 05 |
| NCCL 集合通信原语/拓扑 | NCCL 用户指南 | 原语与拓扑说明 | 04 |
说明:自绘图包含两类——11 张门面流程图(PNG 300dpi,可放大打印)与 8 张机制图(SVG 矢量,公式可缩放),均已内嵌到对应 Notebook 的「深入原理」处;官方链接来自论文与官方文档(稳定可达),可作为高清原图对照学习,不建议直接嵌入 Notebook(保持离线自包含)。
与其他章节衔接
本 README 位于
15-AI-Infra/,跨模块链接统一使用../模块名/路径,方便从 GitHub 页面直接跳转。
| 本模块主题 | 前置章节 | 衔接说明 |
|---|---|---|
| 计算图 / 自动微分 | 03-深度学习 01-BP | 从"手推梯度"到"引擎自动反向" |
| 混合精度 / 显存 / ZeRO | 08-优化算法 07-大模型训练优化实践 | 那边讲数值与内存,这边补系统实现 |
| 量化 | 04-LLM大模型 14/22 | 04 讲算法,本模块补工程部署视角 |
| KV Cache / 推理 | 04-LLM大模型 19-KV缓存 | 04 讲原理与内存账本,本模块补引擎调度 |
| C++ / Linux / 分布式 | 13-编程语言 · 05-八股与工程 | 工程表达与 OS/网络基础 |
面试高频题型(详见 高频面试题.md)
- 公式计算类:FLOPs/参数量/显存/通信量的手算(RoPE 时 FLOPs、7B 训练显存、Ring AllReduce 通信量)
- 对比选型类:DP vs TP vs PP vs FSDP;PTQ vs QAT;连续批处理 vs 静态批处理;TF32 vs FP16 vs BF16
- 手撕代码类:autograd 反向、分块 GEMM、Ring AllReduce、softmax 数值稳定改写
- 排查调优类:显存 OOM 定位、吞吐瓶颈(算力受限 vs 带宽受限)、量化掉点排查
验收标准
- [x] 全模块 11 篇 notebook 设计为可执行:00 计算图与自动微分 / 01 GEMM 算子优化 / 02 混合精度与显存 / 03 分布式并行 / 04 集合通信与 NCCL / 05 KV Cache 与推理内存 / 06 推理引擎 vLLM / 07 量化与压缩 / 08 性能分析 / 09 面试八股 / 10 FlashAttention 与 CUDA 线程模型(全部 numpy/torch 自包含,无需 GPU、无需联网;当前环境无法跑 nbclient 全量回归,已在本地按单元手工核对数值与公式一致性,建议在 Jupyter 环境跑一遍验证)
- [x] 每篇含:问题表 → 直觉 → 公式/原理 → 手写实现 → 数值对照 → 面试考点 → 自测清单
- [x] 全部代码 numpy/torch 自包含,随机种子固定,可复现
- [ ] 可进一步扩充:训练/推理端到端案例(如从零训一个 1B 的显存与耗时预算表)、框架源码导读(vLLM/FSDP 关键类)