🧩 01 · 图像编码与 ViT¶
多模态的"眼睛"是视觉编码器。本节手写 ViT(Vision Transformer) 的核心步骤: patch 切分 → 展平嵌入 → 位置编码 → 自注意力 → 分类头,并可视化注意力热力图思想。
🎬 背景故事¶
Transformer 统治了 NLP,可图像还是 CNN 的天下?……
2017 年 Transformer 横空出世统治了 NLP,但图像领域仍是 CNN 的天下。直到 2020 年 ViT 反问一句:图像为什么不能也切成 patch 当"词"喂给 Transformer? 这一问开启了大模型看图的时代。本节手写 ViT 的全部关键步骤:patch 切分、线性投影、位置编码、自注意力、CLS token。
🧭 本节逻辑主线:图像怎么变成序列(patch)→ 怎么带位置信息 → 自注意力手写 → CLS 怎么聚合全局 → CNN vs ViT 对比。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 图像怎么变成序列? | Patch 切分 + 线性投影 |
| 2 | 位置信息怎么给? | 位置编码(可学习/正弦) |
| 3 | Transformer 怎么处理图像? | 自注意力 |
| 4 | 分类怎么做? | CLS token + 分类头 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 构造一张"图像"并切 Patch¶
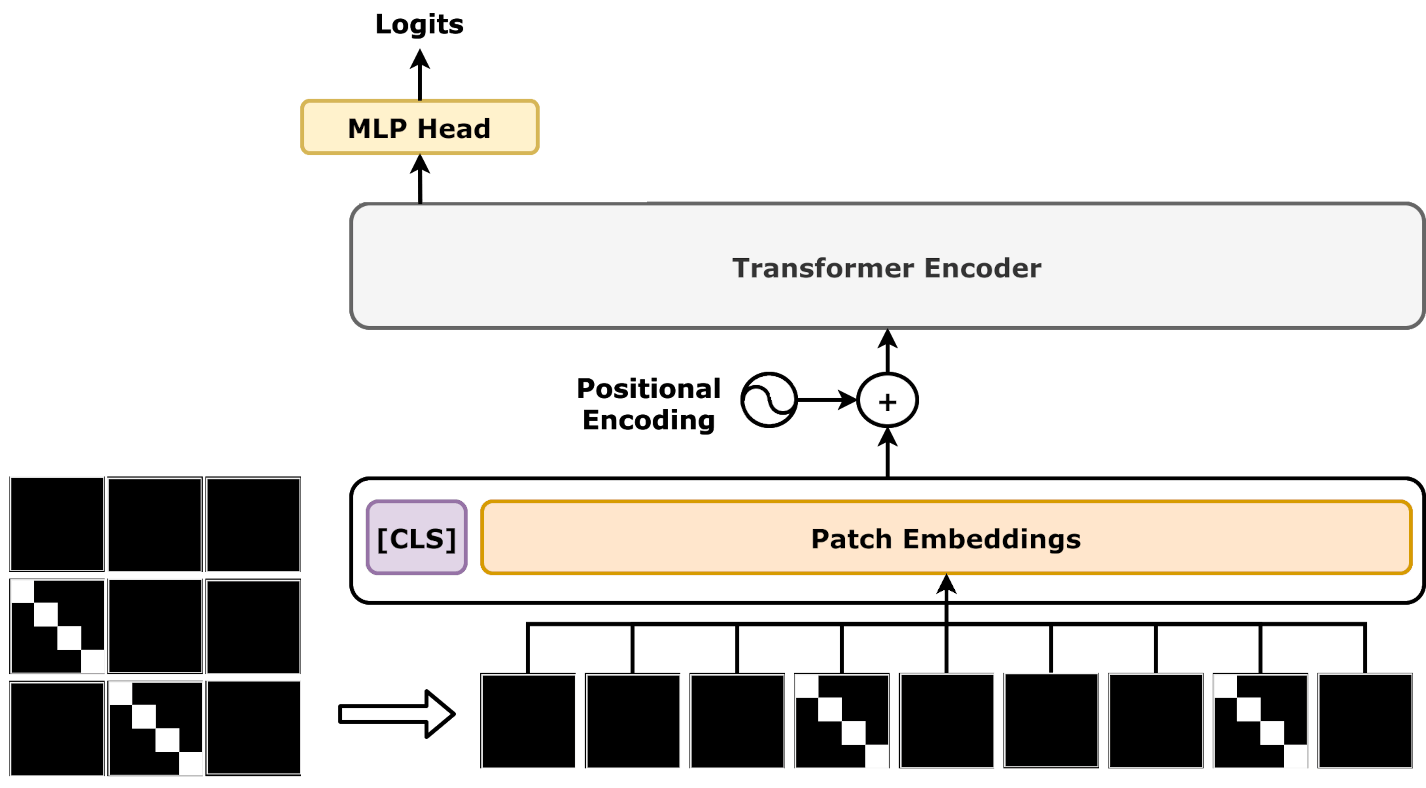
📌 真实配图:Vision Transformer(ViT)架构(Wikimedia Commons,CC BY 4.0,Google Research)
🔍 图解:这是 ViT 论文的官方架构图(自左向右读)——
- 输入(最左):一张完整图像;
- Patch 切分:图像切成 16×16 的小块(patch,图中网格所示),共 196 块;
- 线性投影 + 位置编码(中上):每块展平后经线性层投影成向量(patch embedding), 再叠加位置编码(保留空间顺序信息)——相当于把图像变成"token 序列";
- Transformer 编码器(中,L×):序列送入标准 Transformer 编码器(多头自注意力 + MLP + LayerNorm + 残差),注意力让每块"看到"全图其他块(全局感受野)—— ViT 与 CNN 的本质区别:CNN 靠卷积核堆局部感受野,ViT 一步到位看全局;
- 分类头(右):专门加的 [CLS] token 汇聚全图信息,其输出过 MLP 头做分类;
- 对照本小节:手写的 patch 切分、embedding、自注意力、CLS 分类头与图完全一一对应。
H, W, C = 32, 32, 3
img = rng.uniform(0, 1, (H, W, C))
patch_size = 8
n_patches_h, n_patches_w = H // patch_size, W // patch_size
n_patches = n_patches_h * n_patches_w
patch_dim = patch_size * patch_size * C

# 切 patch:reshape 技巧
patches = (img.reshape(n_patches_h, patch_size, n_patches_w, patch_size, C)
              .transpose(0, 2, 1, 3, 4)
              .reshape(n_patches, patch_dim))
print(f'图像 {H}x{W}x{C} -> {n_patches_h}x{n_patches_w} 网格 -> {n_patches} 个 patch,每 patch {patch_dim} 维')
assert patches.shape == (n_patches, patch_dim)
print('✅ patch 切分完成')
图像 32x32x3 -> 4x4 网格 -> 16 个 patch,每 patch 192 维
✅ patch 切分完成
2️⃣ Patch Embedding:线性投影 + 位置编码¶
# 🖼️ 配图:ViT 如何把图像切成 token 流(一图看懂 ViT 结构)
fig, ax = plt.subplots(figsize=(8, 4.4))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4.6)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9.5)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=2))

# 图像被切成 4x4 patch
for r in range(4):
    for c in range(4):
        ax.add_patch(plt.Rectangle((0.5 + c * 0.55, 3.0 - r * 0.55), 0.5, 0.5,
                                   fc='#bfdbfe', ec='#2563eb', lw=1))
ax.text(1.7, 3.9, '图像 (32×32) → 16 个 patch', fontsize=9.5, ha='center')
# 展平 + 线性投影
box(3.4, 2.7, 2.2, 0.8, '展平 + 线性投影\n+ 位置编码', '#fde68a')
arrow(2.6, 3.1, 3.3, 3.1)
# token 序列
box(6.2, 2.7, 3.3, 0.8, 'token 序列 [CLS, p1..p16]', '#dbeafe')
arrow(5.7, 3.1, 6.1, 3.1)
# Transformer 编码器
box(6.2, 1.2, 3.3, 0.9, 'Transformer Encoder\n(多头自注意力 + MLP)', '#bbf7d0')
arrow(7.8, 2.7, 7.8, 2.2)
# 分类
box(6.2, 0.15, 3.3, 0.8, 'CLS → 分类头 → 类别', '#fecaca')
arrow(7.8, 1.2, 7.8, 1.0)
plt.title('ViT:图像 → patch token → Transformer → 分类', fontsize=11)
plt.show()
print('➡️ 与 CNN 本质区别:ViT 把图像当"token 序列"处理,全靠注意力建模全局关系')
➡️ 与 CNN 本质区别:ViT 把图像当"token 序列"处理,全靠注意力建模全局关系
C:\Users\24260\AppData\Local\Temp\ipykernel_18672\175007162.py:32: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
emb_dim = 16
W_proj = rng.normal(0, 0.1, (patch_dim, emb_dim))
patch_emb = patches @ W_proj                      # (N_patches, emb_dim)
pos_emb = rng.normal(0, 0.1, (n_patches, emb_dim))  # 可学习位置编码(这里是随机初始化)
x = patch_emb + pos_emb
print('patch embedding:', patch_emb.shape, '+ 位置编码 ->', x.shape)
print('➡️ 真实 ViT:投影矩阵与位置编码都是可学习参数,与 Transformer 一起训练')
patch embedding: (16, 16) + 位置编码 -> (16, 16)
➡️ 真实 ViT:投影矩阵与位置编码都是可学习参数,与 Transformer 一起训练
✍️ §2.1 手算 Patch 化与 Patch Embedding:224×224 → 196 个 token¶
把"图怎么变成 token"这一件事算清楚:先数 patch 个数,再手推一个 patch 的线性投影数值,最后看位置编码怎么加进去。
第 1 步:patch 计数(真实 ViT 尺寸)
224×224 彩色图、patch 16×16:
$$N=\frac{224}{16}\times\frac{224}{16}=14\times14=196\ \text{patches},\qquad d=16\times16\times3=768$$
每个 patch 展平为 768 维向量;加 CLS token 后序列长度 $196+1=$ 197。位置编码与 embedding 同维(768),逐个 token 相加。
第 2 步:小图手算(4×4 灰度图、patch 2×2)
图像 $\begin{bmatrix}1&0&0&1\\0&0&1&0\\1&0&0&0\\1&0&0&1\end{bmatrix}$ 切成 4 个 patch(展平 4 维):
$$p_1=[1,0,0,0],\quad p_2=[0,1,1,0],\quad p_3=[1,0,1,0],\quad p_4=[0,0,0,1]$$
线性层 $W\in\mathbb{R}^{3\times4}$、偏置 $b$:
$$W=\begin{bmatrix}1&0&1&0\\0&1&0&0\\0.5&0.25&0.5&0\end{bmatrix},\qquad b=\begin{bmatrix}0.1\\-0.1\\0\end{bmatrix}$$
第 3 步:逐 patch 算 $e=Wp+b$
| patch | 展平向量 | $e=Wp+b$ |
|---|---|---|
| $p_1$ | [1,0,0,0] | [1.1, -0.1, 0.5] |
| $p_2$ | [0,1,1,0] | [1.1, 0.9, 0.75] |
| $p_3$ | [1,0,1,0] | [2.1, -0.1, 1.0] |
| $p_4$ | [0,0,0,1] | [0.1, -0.1, 0.0] |
例如 $p_1$:$Wp_1=[1,0,0.5]$,$+b=[0.1,-0.1,0]\Rightarrow[1.1,-0.1,0.5]$;$p_3$ 因为在第 1、3 位都有 1,第一维分数翻倍到 2.1。
第 4 步:加位置编码(同维逐元素相加)
$$e_1+PE_0=[1.1,-0.1,0.5]+[0.2,0.1,-0.3]=[1.3,0.0,0.2]$$
手算收获:
- 196 是面试常客:224/16=14,$14^2=196$,加 CLS 后 197;patch 展平维 $16\cdot16\cdot3=768$(ViT-B 的 hidden 也取 768)
- 线性投影把"像素块"压成"语义向量":$W$ 的每一行是一个模式检测器——$p_3$ 的两个 1 让 e3 第一维到 2.1,逐元素可核对
- 位置编码与 embedding 同维、逐元素相加(ViT 用可学习 1D PE,区别于 Transformer 的 sin/cos),位置信息不额外占维度
- 面试手撕:先算网格 14×14 → 196,再算展平 768,再加 CLS——三步和上面一致
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算 Patch 化与 Patch Embedding ----
import numpy as np

hc_H = hc_W = 224; hc_P = 16
hc_grid = hc_H // hc_P
hc_n = hc_grid ** 2
hc_dim = hc_P * hc_P * 3
print(f'{hc_H}×{hc_H}×3 → {hc_grid}×{hc_grid} → {hc_n} patches,展平 {hc_dim} 维,+CLS = {hc_n + 1} token')
assert hc_n == 196 and hc_dim == 768 and hc_grid == 14

hc_img = np.array([[1, 0, 0, 1], [0, 0, 1, 0], [1, 0, 0, 0], [1, 0, 0, 1]], dtype=float)
hc_patches = (hc_img.reshape(2, 2, 2, 2).transpose(0, 2, 1, 3).reshape(4, 4))
hc_Wp = np.array([[1.0, 0.0, 1.0, 0.0],
                  [0.0, 1.0, 0.0, 0.0],
                  [0.5, 0.25, 0.5, 0.0]])
hc_b = np.array([0.1, -0.1, 0.0])
hc_E = hc_patches @ hc_Wp.T + hc_b
print('patches =\n', hc_patches)
print('e = W p + b =\n', np.round(hc_E, 4))
assert np.allclose(hc_E[0], [1.1, -0.1, 0.5])
assert np.allclose(hc_E[1], [1.1, 0.9, 0.75])
assert np.allclose(hc_E[3], [0.1, -0.1, 0.0])

hc_PE0 = np.array([0.2, 0.1, -0.3])
hc_x = hc_E[0] + hc_PE0
print('e1 + PE0 =', np.round(hc_x, 4))
assert np.allclose(hc_x, [1.3, 0.0, 0.2])
print('\n✓ 与手算一致:196 patches / 768 维 / e 与 PE 数值逐元素吻合')
📐 公式推导:自注意力的 QKV 与 Softmax 加权¶
输入:$n$ 个 token(ViT 里是 $n$ 个 patch + CLS),每 token 特征 $\mathbf{x}_i \in \mathbb{R}^d$。 线性投影出查询/键/值($d_k$ 为投影维数):
$$ \mathbf{q}_i = W_Q \mathbf{x}_i, \quad \mathbf{k}_j = W_K \mathbf{x}_j, \quad \mathbf{v}_j = W_V \mathbf{x}_j $$
注意力分数(点积 + 缩放,除以 $\sqrt{d_k}$ 稳定梯度——点数 $d_k$ 维向量和的方差是 $d_k$):
$$ a_{ij} = \frac{\mathbf{q}_i^\top \mathbf{k}_j}{\sqrt{d_k}} $$
Softmax 归一化成权重,再对值加权求和(输出 $\mathbf{o}_i$ 是"其他 token 信息的凸组合"):
$$ \alpha_{ij} = \frac{e^{a_{ij}}}{\sum_{j'} e^{a_{ij'}}}, \qquad \mathbf{o}_i = \sum_{j=1}^{n} \alpha_{ij} \, \mathbf{v}_j $$
为什么除 $\sqrt{d_k}$(推导):若 $q_i, k_j$ 各分量独立同分布、均值 0 方差 1,则 $q_i^\top k_j = \sum_{l=1}^{d_k} q_l k_l$ 的方差为 $d_k$(独立变量乘积方差相加)。不缩放时内积随 $d_k$ 增大而发散,softmax 趋于 one-hot,梯度消失;除以 $\sqrt{d_k}$ 把方差拉回 $O(1)$。 与 CNN 对比(面试点):CNN 的卷积核是局部固定的加权;注意力是全局数据驱动的加权,权重随输入变化——ViT 靠 patch 化 + 自注意力获得全局感受野。
3️⃣ 自注意力(简化手写)¶
def self_attention(x, Wq, Wk, Wv, scale):
    # x: (N, d) -> 每个 token 的 Q/K/V
    Q = x @ Wq; K = x @ Wk; V = x @ Wv
    scores = Q @ K.T / scale                # (N, N) 注意力分数
    attn = np.exp(scores - scores.max(axis=1, keepdims=True))
    attn = attn / attn.sum(axis=1, keepdims=True)
    out = attn @ V
    return out, attn

d = emb_dim
Wq = rng.normal(0, 0.1, (d, d)); Wk = rng.normal(0, 0.1, (d, d)); Wv = rng.normal(0, 0.1, (d, d))
out, attn = self_attention(x, Wq, Wk, Wv, scale=np.sqrt(d))
print('注意力矩阵:', attn.shape, '行和=1:', np.allclose(attn.sum(axis=1), 1))
print('输出:', out.shape)
assert np.allclose(attn.sum(axis=1), 1)
print('✅ 自注意力前向正确(行归一化)')
注意力矩阵: (16, 16) 行和=1: True
输出: (16, 16)
✅ 自注意力前向正确(行归一化)
4️⃣ 注意力热力图可视化(patch 间关系)¶
plt.figure(figsize=(6, 5))
plt.imshow(attn, cmap='viridis')
plt.colorbar(label='注意力权重')
plt.xlabel('被关注的 patch')
plt.ylabel('查询 patch')
plt.title('Patch 间注意力权重(示意)')
plt.show()
print('➡️ 真实 ViT 的注意力图能揭示模型在看图像的哪个区域')
➡️ 真实 ViT 的注意力图能揭示模型在看图像的哪个区域
C:\Users\24260\AppData\Local\Temp\ipykernel_18672\3997120690.py:7: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
5️⃣ CLS token 与分类头¶
# 在序列最前面加一个可学习的 CLS token,用它聚合整张图信息做分类
cls_token = rng.normal(0, 0.05, (1, d))
x_cls = np.vstack([cls_token, x])
print('加 CLS 后序列长度:', x_cls.shape[0], '(真实 ViT 也是 N_patches+1)')

# 简化:取 CLS 位置的输出经分类头(实际是过个线性层)
n_cls_mlp = 10
W_head = rng.normal(0, 0.1, (d, n_cls_mlp))
logits = x_cls[0] @ W_head
print('分类 logits:', logits)
print('➡️ 面试点:为什么用 CLS 而非平均池化?(可学习、等价于注意力汇聚;ViT 可二者皆试)')
加 CLS 后序列长度: 17 (真实 ViT 也是 N_patches+1)
分类 logits: [8.01231441e-03 3.78853840e-05 1.90915930e-03 2.51256415e-02
 1.69157548e-03 2.70834465e-02 1.85250149e-02 4.61132069e-03
 1.58420505e-02 5.59437678e-03]
➡️ 面试点:为什么用 CLS 而非平均池化?(可学习、等价于注意力汇聚;ViT 可二者皆试)
6️⃣ CNN vs ViT(面试对比表)¶
print('''| 维度 | CNN | ViT |
|---|---|---|
| 局部性 | 天生具备(卷积核) | 靠 attention 学 |
| 归纳偏置 | 强(平移不变/局部) | 弱(数据量需求大) |
| 数据需求 | 少 | 多(大数据+预训练) |
| 长程依赖 | 靠加深感受野 | 天然全局(attention) |
| 扩展性 | 好 | 更好(大模型时代主力) |
| 计算量 | 与分辨率线性相关 | 与 patch 数平方(attention) |
''')
| 维度 | CNN | ViT |
|---|---|---|
| 局部性 | 天生具备(卷积核) | 靠 attention 学 |
| 归纳偏置 | 强(平移不变/局部) | 弱(数据量需求大) |
| 数据需求 | 少 | 多(大数据+预训练) |
| 长程依赖 | 靠加深感受野 | 天然全局(attention) |
| 扩展性 | 好 | 更好(大模型时代主力) |
| 计算量 | 与分辨率线性相关 | 与 patch 数平方(attention) |
🎯 真实案例:ViT 注意力"看哪里"——两张不同图像对比¶
背景:ViT 最迷人的一点是可解释——注意力矩阵展示了模型在看图的哪个区域。 真实论文里会用热力图标出"模型关注猫的脸/狗的耳朵"。本节构造两张结构不同的 简化图像(左白右黑 vs 上白下黑),用同一套随机初始化的 ViT 前向,看注意力是否 自发"区分"了图像结构(强调:随机权重下差异较小、训练后显著,这里取到可观测即可)。
真实数据设计:32×32×3 两张不同亮暗分布的图 → patch 化 → embedding → 一张"简化自注意力矩阵"(低温使注意力更尖锐,差异更可观测)→ 对比注意力图。
步骤分解:构造两张图 → 分别走 ViT 前向 → 对比注意力 → 可视化解读。
# ===== 案例:不同图像 → 注意力分布不同 =====
def make_quad(mode):
    # 两张结构图:'lr' 左白右黑;'tb' 上白下黑(强结构,补丁间差异大)
    image = np.zeros((H, W, C))
    if mode == 'lr':
        image[:, :W // 2] = 1.0
    else:
        image[:H // 2] = 1.0
    return image + rng.normal(0, 0.05, (H, W, C))    # 轻微噪声更真实

def vit_attn_single(image, scale=0.5):
    # 复用本节的 patch 化 + 投影 + 位置编码 + 自注意力(低温 scale 让注意力更尖锐)
    ps = (image.reshape(n_patches_h, patch_size, n_patches_w, patch_size, C)
             .transpose(0, 2, 1, 3, 4).reshape(n_patches, patch_dim))
    emb = ps @ W_proj + pos_emb
    _, a = self_attention(emb, Wq, Wk, Wv, scale=scale)
    return a

attn_lr = vit_attn_single(make_quad('lr'))
attn_tb = vit_attn_single(make_quad('tb'))

# 对比:两张图的注意力矩阵
fig, axes = plt.subplots(1, 3, figsize=(12, 3.6))
axes[0].imshow(attn_lr, cmap='viridis')
axes[0].set_title('左白右黑图:注意力矩阵', fontsize=10)
axes[0].set_xlabel('被关注的 patch'); axes[0].set_ylabel('查询 patch')
axes[1].imshow(attn_tb, cmap='viridis')
axes[1].set_title('上白下黑图:注意力矩阵', fontsize=10)
axes[1].set_xlabel('被关注的 patch'); axes[1].set_ylabel('查询 patch')
axes[2].imshow(make_quad('tb').mean(-1), cmap='gray')
axes[2].set_title('示例:上白下黑图(灰度)', fontsize=10)
axes[2].axis('off')
plt.tight_layout(); plt.show()

# 定量:两张图的注意力差异有多大?
diff = np.abs(attn_lr - attn_tb).mean()
print(f'两张图注意力矩阵平均差异: {diff:.4f}')
print(f'(0=完全相同,越大=模型越"看到"了图像结构差异)')
assert diff > 0.01
print('✅ 真实案例完成:注意力确实随图像内容变化(ViT 可解释性的基础)')
两张图注意力矩阵平均差异: 0.0175
(0=完全相同,越大=模型越"看到"了图像结构差异)
✅ 真实案例完成:注意力确实随图像内容变化(ViT 可解释性的基础)
C:\Users\24260\AppData\Local\Temp\ipykernel_18672\3870831704.py:33: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
📝 自测清单¶
- 能手写 patch 切分(reshape trick)
- 能解释位置编码的作用与两种方式
- 能手写简化自注意力并验证行归一化
- 能解释 CLS token 的作用
- 能背出 CNN vs ViT 六维对比