14-具身智能 · 04 仿真数据与 Sim2Real
本篇讲“数据从哪里来、怎么搬到真机”。核心一句话:真机数据太贵,仿真数据太假,域随机化让“假的”练出“真的”能用。 学完你能回答:为什么机器人学习离不开仿真?MuJoCo / Isaac Gym / Isaac Sim / Genesis / Webots 怎么选?遥操作怎么采数据? 真实 / 仿真 / 互联网视频三类数据各有什么用?域随机化为什么能让策略鲁棒?Sim2Real 流程和坑是什么?
本节要解决的问题
| 要解决的问题 | 一句话答案 |
|---|---|
| 为什么机器人不能只在真机上训练? | 真机试错成本高、有安全风险、样本量小;仿真便宜、安全、可并行百万次 |
| 仿真器生态有哪些、怎么选? | MuJoCo 轻量快速、Isaac Gym 主打 GPU 大规模并行 RL、Isaac Sim 偏向真实感渲染、Genesis 极速生成、Webots 教学友好;按“速度 vs 真实感 vs 生态”取舍 |
| 真实数据从哪里来? | 靠遥操作:动捕、VR 手柄、示教夹具把人的动作“录”成机器人指令序列 |
| 真实数据、仿真数据、互联网视频数据有什么不同? | 真实数据可信但贵而少;仿真数据便宜多样但“假”;视频数据海量但缺动作标签,只能做预训练/世界模型 |
| 怎么把仿真里学到的策略搬到真机? | 域随机化 + 系统辨识 + 渐进式迁移,让训练分布“罩住”真实分布,再在真机少量微调 |
| 仿真评估有哪些指标? | 成功率 success rate 为主,配合平均完成度、步数效率、多 seed 鲁棒性 |
| 动作数据长什么样? | 每条样本是(proprioception 本体感觉 + 动作指令)的序列,如关节角/角速度 + 夹爪命令 |
故事引入
把一台机械臂搬到实验室练“夹鸡蛋”:第一次夹太猛,“啪”——鸡蛋碎了,成本 5 元;第二次没夹稳,鸡蛋滑走;教练(你)在旁边记数据、调参数,忙了一下午,机械臂才勉强学会夹固定位置的一颗蛋。更可怕的是夹偏了撞到桌面,机械臂可能当场报废——一台机械臂几十万,这谁受得了?
小明换了个思路:先在“虚拟世界”里练。他打开仿真器,把机械臂、桌子、鸡蛋、光照全部搬进电脑,让机械臂在虚拟环境里夹了 100 万次鸡蛋——每次随机换鸡蛋大小、位置、摩擦系数、光照角度,甚至随机“物理参数”(重力、电机力矩)。虚拟世界里撞坏一万次也不心疼,一天就能跑完真机十年的实验量。
等策略在“千变万化”的虚拟环境里都稳定成功,小明把它搬到真机:第一次夹真鸡蛋,居然一次成功。当然,仿真和真机还是有差距(reality gap):真机的电机延迟、摩擦、相机噪点,仿真里未必模拟得一模一样,所以还要“域随机化”和少量真机微调兜底。
而真实数据的路子是:让工程师戴上 VR 手柄、或者用动捕套装,亲手“示范”几千次夹鸡蛋,把人的灵活动作录成数据,喂给模仿学习。三种数据(真实遥操作、仿真、互联网视频)各有各的用处,这篇我们就把它讲透。
核心概念
(a) 🗂️ 仿真数据与 Sim2Real 的完整链路
先看全景:机器人数据从哪来、策略怎么练、怎么搬到真机、怎么评估。下面这张图就是本节的“作战地图”,蓝色是仿真路径,黄色是真实数据路径,两条路最终汇合到策略训练,再走 Sim2Real 迁移。
flowchart TB
    A["为什么要仿真?<br/>成本/安全/规模"] --> B["仿真器生态<br/>MuJoCo/Isaac/Genesis/Webots"]
    B --> C["仿真数据生成<br/>随机任务/物理参数/光照纹理"]
    C --> D["域随机化<br/>视觉/物理/动力学参数随机"]
    D --> E["策略训练<br/>RL / 模仿学习 / VLA"]
    J["遥操作数据采集<br/>动捕/VR/示教夹具"] --> E
    E --> F["Sim2Real 迁移<br/>零样本 or 真机微调"]
    F --> G["系统辨识/表示迁移<br/>把仿真校准成真机"]
    G --> H["真机评估<br/>success rate 等"]
    H --> I["闭环反馈<br/>补数据/调参/回炉训练"]
    I --> E
- A 为什么要仿真:真机试错又贵又危险,样本还少;仿真让单次实验成本趋近于零、还能并行百万次。
- B 仿真器生态:不同仿真器在“速度、真实感、生态”三个维度上取舍,选型先想清楚瓶颈是算力还是保真度。
- C 仿真数据生成:把任务、物体、光照、纹理参数化,批量“撒”任务,生成海量带标签样本。
- D 域随机化:训练时随机扰动物理/视觉/动力学参数,逼策略学到“不依赖某个具体参数”的鲁棒行为。
- E 策略训练:在(随机化的)仿真里用 RL 或模仿学习训练策略,或在真实遥操作数据上做行为克隆。
- F Sim2Real 迁移:把仿真策略搬到真机,先零样本试,不行再真机微调。
- G 系统辨识/表示迁移:把仿真里的质量、摩擦、延迟校准成真机实测值,或对齐仿真/真实的特征表示,缩小差距。
- H 真机评估:用 success rate、平均完成度等指标在真机上打分数。
- I 闭环反馈:评估不过关就回炉:补数据、换随机化范围、再训练,形成“仿真-真机”迭代闭环。
- J 遥操作数据采集:真实数据的来源——人通过动捕/VR/夹具“示范”,把动作录成数据。
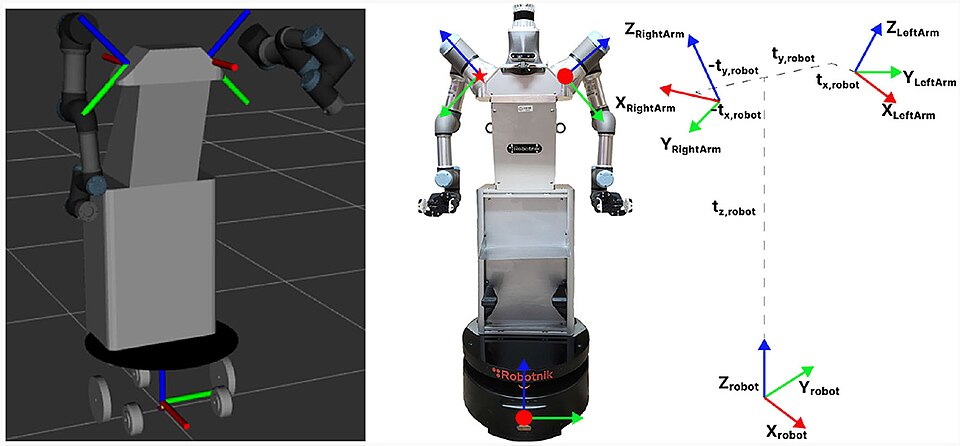
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · Authors of the study: Alicia Mora, Adrian Prados, Alberto Mendez, Go…
深入原理(一)为什么需要仿真:成本、安全与规模
大白话直觉
训练一个能拿筷子的策略,如果全在真机上试:每次失败要么摔东西、要么撞机器,一晚上最多攒几百条数据,还得有人盯着安全。仿真里同一台“电脑机械臂”可以 1000 个副本同时练,跑坏 10 万个回合也不花一分钱。说白了:仿真把“试错的成本”从几十元/次压到几乎 0 元/次,把“并行度”从 1 台机器变成 GPU 上的上千个环境。
数学化:成本与样本量
设单次真实实验成本为 c_t(包含耗材、磨损、人工),策略训练需要 N 次交互;仿真单次成本近似为 ε(GPU 电费摊薄后趋近 0):
$$ \text{真实总代价} = \sum_{t=1}^{N} c_t \approx N \cdot \bar{c}, \qquad \text{仿真总代价} \approx N \cdot \varepsilon, \quad \varepsilon \ll \bar{c} $$
强化学习的样本复杂度通常随状态/动作维度上升而快速增大:任务越复杂,需要的 N 越大;N 越大,“仿真便宜 + 可并行”的优势就越明显——这就是为什么机器人学习“非仿真不可”。
推导:成功率要多少数据才可信
评估策略时统计成功率。设真实成功率是 s,用 N 次试验估计:
$$ \hat{s} = \frac{1}{N}\sum_{i=1}^{N} \mathbb{1}[\text{第 } i \text{ 次成功}], \qquad \text{Var}(\hat{s}) \approx \frac{s(1-s)}{N} $$
当 s=0.9、N=100 时标准差约 0.03;想区分“90% 和 93%”,N 要上千。仿真里可以轻松跑几千次取平均,真机上跑 1000 次得花好几天——这又从“评估”角度说明了仿真的价值。
面试怎么问
- Q:为什么机器人学习离不开仿真? A:三点——成本(真机试错贵且危险)、安全(新策略在真机盲试可能撞坏设备/伤人)、规模(RL 样本需求大,仿真可 GPU 并行)。
- Q:仿真的局限性是什么? A:模型与真实物理有偏差(reality gap),仿真里 99% 成功不等于真机 99% 成功,所以需要 sim2real 技术兜底。
深入原理(二)仿真器生态:MuJoCo / Isaac Gym / Isaac Sim / Genesis / Webots 怎么选
大白话直觉
仿真器就是“物理世界模拟器”:给定机器人每个关节发多大力、环境长什么样,它算出机器人下一步怎么动。不同仿真器的差别在于——算得多快(能不能并行 1000 个环境)、算得多真(接触/摩擦/渲染够不够像真机)、生态多好(有没有现成机器人和算法接口)。想练大规模 RL 选快的,想做“渲染很像真机”的选真实的,想入门教学选简单的。
数学化:仿真器在算什么
机器人动力学(刚体动力学方程,由拉格朗日或牛顿-欧拉法推导):
$$ M(q)\ddot{q} + C(q,\dot{q})\dot{q} + g(q) = \tau $$
其中 M(q) 是质量/惯量矩阵,C(q,q̇) 是科氏力和离心力项,g(q) 是重力项,τ 是关节力矩。仿真器每步做两件事:(1) 正向动力学解出加速度 ä = M⁻¹(τ − Cq̇ − g);(2) 用积分器推进状态(半隐式欧拉):
$$ v_{t+1} = v_t + \Delta t\, M^{-1}(\tau_t - C v_t - g), \qquad q_{t+1} = q_t + \Delta t\, v_{t+1} $$
接触与摩擦则通过求解约束或碰撞模型近似。仿真器的本质差距 = 物理近似精度 × 渲染保真度 × 并行吞吐量。
推导/记忆:一句话选型表
| 需求 | 首选 | 理由 |
|---|---|---|
| 大规模并行 RL(跑 1000+ 环境) | Isaac Gym / Isaac Lab | GPU 上几千个环境同时跑,样本吞吐量高 |
| 真实感渲染 + 多传感器仿真 | Isaac Sim | 支持材质/光照/相机仿真,适合感知类任务 |
| 轻量、科研验证、接触动力学 | MuJoCo | 快速、精确、API 简单,学术界广泛使用 |
| 极速合成数据 / 4D 世界模型 | Genesis | 主打“仿真生成速度”与多模态数据合成 |
| 教学入门、轮式/足式基础 | Webots | 自带丰富模型与教程,交互友好 |
(注意:各仿真器版本迭代很快,面试讲“思想与定位”即可,不必背精确版本号。)
面试怎么问
- Q:MuJoCo 和 Isaac Gym 有什么区别? A:MuJoCo 是轻量快速的通用物理引擎,精确但不强调大规模并行;Isaac Gym 是 GPU 并行物理引擎,专为强化学习设计,1 块 GPU 上能并行几千个环境。选型看任务:单机仿真/接触研究选 MuJoCo,大规模 RL 选 Isaac Gym/Isaac Lab。
- Q:仿真器误差主要来自哪? A:接触/摩擦模型近似、积分步长离散化、渲染与真实相机差异、以及缺失的执行器延迟与噪声——这些正是 reality gap 的来源。
深入原理(三)遥操作数据采集:动捕、VR 与示教夹具
大白话直觉
机器人自己不会“录制”灵巧动作,得靠人示范。遥操作(teleoperation)就是让人的手/身体动作变成机器人的指令:人动,机器人跟着动,同时把“当时的观测 + 当时的动作”录下来,一条一条攒成数据集。遥操作的本质是“把人的灵巧性拷贝成数据”。
数学化:从人的动作到机器人指令
人的手在三维空间动,机器人关节要跟着动。若人的动作是末端速度 ẋ_d(笛卡尔空间),通过雅可比伪逆映射成关节速度:
$$ \dot{q} = J^{\dagger}(q)\,\dot{x}_d, \qquad J^{\dagger} = J^{\mathsf{T}}(J J^{\mathsf{T}})^{-1} $$
每个时刻记录一对样本(观测 o_t,动作 a_t),最终数据集:
$$ \mathcal{D} = \{(o_t, a_t)\}_{t=1}^{T}, \qquad o_t = (q_t, \dot{q}_t, \text{末端位姿}, \text{夹爪开合}, \text{图像/点云}), \quad a_t = (\text{目标关节角/关节速度}, \text{夹爪命令}) $$
推导/分类:三种主流采集方式
| 方式 | 怎么采 | 优点 | 缺点 |
|---|---|---|---|
| 动捕(Motion Capture) | 反光球 + 红外相机跟踪人体/夹具 | 自然、可采全身动作、精度高 | 设备贵、对环境敏感、标定繁琐 |
| VR / 手柄 | 人戴 VR 头显 + 手柄操作真实或虚拟机器人 | 直观、易上手、可远程采集 | 精度一般、大臂动作别扭 |
| 示教夹具 / 主从 | 人直接握着机械臂末端“手把手”教,或用主手控制从手 | 最贴近任务、精度高 | 一次一台、速度慢、人手易疲劳 |
面试怎么问
- Q:遥操作数据有哪些问题? A:贵(要人力和设备)、慢(一天几百条)、且人的动作风格与机器人执行存在差异(延迟、运动学不同),需要后处理:重采样对齐、去抖、有时还要“人形到机器人构型”的重定向(retargeting)。
- Q:为什么大厂都在建“遥操作数据工厂”? A:因为高质量真实数据是 VLA 训练的地基;遥操作是“可控、可复现、带动作标签”的真实数据来源,规模上去了就是数据护城河。
深入原理(四)三种数据源大对比:真实 vs 仿真 vs 互联网视频
大白话直觉
真实数据“真”但少而贵,仿真数据“多而便宜”但假,互联网视频“海量”但只有图像、没有动作标签。三者的定位是:真机数据决定最终水平的上限,仿真数据决定训练规模的底气,视频数据决定“世界知识”的宽度。 现代做法是把它们混起来用:视频教“世界长什么样”,仿真教“动作怎么执行”,真机数据校准“最后的差距”。
数学化:分布的视角
学习算法的误差可以拆成三项(分布视角的“偏差-方差-容量”分解):
$$ \underbrace{\mathcal{E}_{\text{task}}}_{\text{任务难度}} \leq \underbrace{d(\mu_{\text{真实}}, \mu_{\text{训练}})}_{\text{分布差距}} + \underbrace{\text{统计误差}}_{\propto 1/\sqrt{N}} + \underbrace{\text{近似误差}}_{\text{模型容量}} $$
- 真实数据:分布差距 d≈0,但 N 小 → 统计误差大;
- 仿真数据:N 可以巨大 → 统计误差小,但 d 大(reality gap);
- 视频数据:N 巨大且场景丰富,但没有动作标签,只能提供“环境/视觉先验”,不能直接做行为克隆。
推导:为什么“100 条真机数据 > 100 万条仿真数据”是伪命题
关键在于问的是“评估”还是“训练”:评估必须用真机(仿真测出的 95% 不代表真机 95%);训练则可以“仿真为主体、真机做校准”。正确姿势是分级混合:视频→世界模型/预训练,仿真→策略主干训练,真机→微调 + 评估。把三种数据的分布画成三块,目标就是让“训练分布”尽可能覆盖“真实分布”。
面试怎么问
- Q:三种数据的优缺点? A:真实(可信、有动作标签,但贵少慢);仿真(便宜、可并行、可控,但有 reality gap);互联网视频(海量、场景丰富,但无动作标签,只能用于预训练/世界模型/视频生成)。
- Q:怎么把三种数据都用起来? A:典型 pipeline 是“视频预训练视觉/世界模型 → 仿真大规模 RL 或生成动作 → 真机遥操作数据微调 + 评估”,配合域随机化缩小分布差。
深入原理(五)域随机化:让策略在随机世界里练出鲁棒性
大白话直觉
如果你只在“标准参数”的仿真里练,策略会偷偷依赖仿真特有的细节(固定摩擦、固定光照、固定电机力度),一到真机就露馅。域随机化的做法很“土”但很有效:训练时把物理、视觉、动力学参数当成随机变量,每次开一局随机抽一套,逼策略不能依赖任何特定参数,只能在“参数怎么变都能成功”的方向上学习——就像用“千奇百怪的健身房”练出真正的体能,而不是只会用同一台器械。
数学化:随机化下的优化目标
设随机化参数 ξ(质量、摩擦、光照、延迟、噪声等)服从分布 p(ξ),普通训练固定参数 ξ₀:
$$ \theta_{\text{nominal}} = \arg\max_\theta \, \mathbb{E}_{\tau \sim \pi_\theta(\cdot\mid \xi_0)}\big[ R(\tau) \big] $$
域随机化改为在参数分布上求期望(不求最坏情况最优,而求“平均情况最优”):
$$ \theta_{\text{DR}} = \arg\max_\theta \, \mathbb{E}_{\xi \sim p(\xi)}\, \mathbb{E}_{\tau \sim \pi_\theta(\cdot\mid \xi)}\big[ R(\tau) \big] $$
推导:为什么随机化范围要“刚好罩住真机”
把真机看作“参数分布里的一个点” ξ_real。如果随机化范围 P 覆盖了 ξ_real(且参数类型建模正确),那么策略在 P 上练到高平均回报后,在 ξ_real 上通常也能用——这就是“randomize-to-adapt”:随机化范围 = 你对真机参数不确定性的估计。范围太小盖不住真机,范围太大任务会变得太难练不动,所以实践中要从“真机标定出发,逐步扩大范围”。
| 随机化层面 | 随机什么 | 例子 |
|---|---|---|
| 视觉 | 光照/纹理/相机噪声/颜色 | 随机材质、随机点光源位置 |
| 物理 | 质量/摩擦/阻尼/接触刚度 | 随机桌面摩擦、随机物体质量 |
| 动力学/执行 | 电机力矩/延迟/关节噪声 | 随机最大扭矩、随机控制延迟 |
| 任务 | 起始状态/目标/障碍分布 | 随机物体位置、随机目标姿态 |
面试怎么问
- Q:域随机化的核心思想? A:训练时把仿真参数当随机变量反复扰动,让策略学到不依赖具体参数值的鲁棒行为,从而在真机上“参数漂移”时依然可用。
- Q:随机化范围怎么定? A:以真机标定值为中心,先小后大;范围必须覆盖真机的不确定性,但过大任务过难导致训练不动,需要实验调节。
- Q:域随机化和“更真实的仿真”是什么关系? A:互补。域随机化是“用不确定性对抗不确定性”,适合参数级差距;渲染/物理更真实是“减少差距本身”,两者常配合使用。
深入原理(六)表示迁移与系统辨识:把仿真校准成真机
大白话直觉
域随机化是“广撒网”,系统辨识是“精瞄准”:在真机上做几组小实验,量出真实的质量、摩擦、电机延迟、力矩曲线,然后把这些数值填回仿真器——让仿真里的“物理”尽量和真机一致。表示迁移则是另一种思路:仿真和真机的观测长得不一样(相机不同、背景不同),那就在“特征空间”里把它们对齐,让策略看到的是“同一个世界”的表示。
数学化:系统辨识的优化目标
设仿真动力学 f_sim(q, q̇, τ; θ) 带待辨识参数 θ(质量/惯量/摩擦/延迟…),真机测量得到状态转移数据 {(q, q̇, τ) → (q′, q̇′)},系统辨识就是解最小二乘:
$$ \theta^{*} = \arg\min_{\theta} \sum_{k} \big\| f_{\text{sim}}(q_k, \dot{q}_k, \tau_k; \theta) - f_{\text{real}}(q_k, \dot{q}_k, \tau_k) \big\|^2 $$
表示迁移(representation alignment)训练一个映射 ϕ 对齐两个域的表示(如点云/图像特征),常用目标是对比损失或循环一致性损失:
$$ \mathcal{L}_{\text{align}} = \mathbb{E}_{(s^{\text{sim}}, s^{\text{real}})}\big[ \| \phi(s^{\text{sim}}) - \phi(s^{\text{real}}) \|^2 \big] $$
推导/流程:实操中的 sim2real 校准三步
- 静态标定:量质量、惯量、关节极限、摩擦(做恒速运动测“力矩-速度”曲线);
- 动态辨识:给真机扫频/阶跃输入,记录响应,拟合延迟、刚度、阻尼(即上面的最小二乘目标);
- 回灌仿真:把 θ* 填进仿真器,重新生成数据、重新训练,必要时配合域随机化“以标定为中心”展开。
面试怎么问
- Q:系统辨识和域随机化的关系? A:系统辨识是“让仿真更接近真机”(减差距),域随机化是“让策略不怕差距”(抗差距);工业界通常先用系统辨识标定出中心值,再用域随机化在中心附近展开。
- Q:表示迁移用在什么场景? A:当仿真与真机的传感器模态不完全一致(不同相机、不同场景)时,把两者映射到共享表示空间,让仿真训练的视觉策略能读懂真机图像。
深入原理(七)Sim2Real 典型流程与坑:reality gap 从哪来、怎么填
大白话直觉
reality gap 就是“仿真和真机的分布差异”:仿真里摩擦力算得差不多就行,真机上差 0.01 可能决定夹不夹得住;仿真里相机照片很“干净”,真机上反光、噪点、动态模糊全来了。这个差距来自四类源头:物理建模误差、传感器/渲染误差、执行器(电机)误差、以及环境不可控因素。Sim2Real 的全部工作,就是“识别差距 → 缩小差距 → 让策略不怕差距”。
数学化:reality gap 的定量定义
把策略 π 分别在仿真环境 E_sim 和真机环境 E_real 中 rollout,回报分布的差异就是 gap(实践中常用 success rate 之差近似):
$$ \text{Gap}(\pi) = d\big( p_{E_{\text{sim}}}(s, a),\; p_{E_{\text{real}}}(s, a) \big) \approx \frac{1}{N}\sum_i \big| R_i^{\text{sim}} - R_i^{\text{real}} \big| $$
从理论上说,若 π 在训练分布 D_train 上达到 1−ε 的成功率,而真机分布被 D_train“覆盖”,则真机成功率至少为 1−ε−(覆盖不足项)。所以 sim2real 的目标是:让训练分布 D_train(仿真 + 随机化)覆盖真机分布 D_real。
推导:典型流程(六步闭环)
- 任务与指标定义:把任务形式化(目标位姿、成功判定);
- 建仿真 & 系统辨识:搭场景、标定物理参数;
- 域随机化 & 大规模训练:在随机化分布上练策略;
- 仿真评估:多 seed 统计 success rate,筛选 checkpoint;
- 真机部署:先零样本试(zero-shot transfer),失败则进入第 6 步;
- 真机微调/渐进迁移:在真机上用小批量数据微调,或“仿真→半实物→真机”渐进过渡;评估不过关就回炉(补随机化、补数据)。
常见坑(面试加分项)
- 坑 1:仿真评估自欺欺人——只测仿真 success rate 就说“成了”,真机一测崩盘;
- 坑 2:随机化范围拍脑袋——不标定真机参数,范围要么盖不住要么大到练不动;
- 坑 3:忽视执行延迟与带宽——仿真里控制器 1 kHz 无延迟,真机 50 Hz 还有抖动,行为完全不同;
- 坑 4:只换参数不换分布——摩擦、质量之外,电机死区、传感器噪声、力控带宽同样致命;
- 坑 5:忽略“评估协议”——真机测试初始条件单一、次数太少,success rate 置信区间巨大。
面试怎么问
- Q:sim2real 的标准做法是什么? A:系统辨识标定 → 域随机化训练 → 仿真多 seed 评估 → 真机零样本尝试 → 不行就真机微调,迭代闭环。
- Q:reality gap 主要来源? A:物理模型近似(接触/摩擦)、传感器/渲染差异、执行器延迟与噪声、环境不可控因素四类。
- Q:仿真评估为什么不能直接代表真机? A:因为仿真分布与真机分布有 gap,success rate 是在仿真分布上统计的;只有缩小 gap(系统辨识 + 域随机化)或扩大评估协议(真机测试)才有意义。
深入原理(八)仿真评估与动作数据格式:success rate 与 proprioception+action
大白话直觉
“好不好”要量化:最常见的指标是成功率(success rate)——跑 100 次,成功几次。但单一成功率会骗人:任务简单时大家都 100%,看不出差异;所以还要看平均完成度、步数效率、不同初始条件下的鲁棒性。数据格式上,机器人策略的每条样本就是“我现在的状态(proprioception 本体感觉)+ 我该做的动作(action)”两个部分,VLA 模型也沿用这套格式,只是把动作再变成 token。
数学化:评估指标定义
设共 N 次试验,第 i 次成功指示为 s_i ∈ {0,1}:
$$ \text{Success Rate} = \frac{1}{N}\sum_{i=1}^{N} s_i, \qquad \text{平均完成度} = \frac{1}{N}\sum_i \frac{\text{完成量}_i}{\text{目标量}}, \qquad \text{步数效率} = \frac{\text{最短步数}}{\text{实际步数}} $$
鲁棒性评估则在多个随机 seed/初始条件下重复:SR 的 95% 置信区间近似为 SR ± 1.96·√(SR(1−SR)/N)。
推导/记忆:动作数据格式
一条专家示范是一个序列:
$$ \tau = \big[ (o_1, a_1), (o_2, a_2), \ldots, (o_T, a_T) \big] $$
- proprioception(本体感觉):机器人“自己身体的状态”——关节角 q、关节角速度 q̇、末端位姿、夹爪开合度、接触力/力矩;不含“环境长什么样”。
- exteroception(外部感知):相机图像、点云——环境信息,通常也拼进观测 o_t。
- action(动作指令):目标关节角/角速度/力矩、末端位置增量(delta pose)、夹爪开/合命令;动作空间可以是连续值,也可以是离散化后的 token(VLA 用)。
面试怎么问
- Q:success rate 有什么缺陷?怎么补? A:单一成功率分辨率低、方差大、对“接近成功”无区分度;补平均完成度、步数/时间效率、多 seed 鲁棒性、长程任务 success@k(前 k 个子目标内成功)。
- Q:proprioception + action 具体指什么? A:proprioception 是机器人自身状态(关节角/角速度/末端位姿/夹爪开合),action 是发给执行器的指令(目标关节角/角速度/夹爪命令);二者构成一条训练样本 (o, a)。
- Q:为什么动作要离散成 token? A:为了复用语言模型的序列生成框架(见 03 篇 VLA),把连续动作量化成有限个 bin 的 token,用交叉熵损失训练。
代码实战(一)域随机化思想演示:随机“控制延迟 + 质量 + 摩擦”下,把小车开到目标
任务设定:一辆 1D 小车从 x=0 出发,用 PD 控制器开到 x=1.0,目标误差 < 0.05 记为成功。
- 随机化参数:质量 m、粘性摩擦 k、控制延迟 D(控制器用的是 D 步之前的状态——真机“执行器延迟”是 reality gap 的典型来源,这里把它也随机化);
- 两种策略对比:名义策略(只在“无延迟 + 标准质量/摩擦”上调好的 PD 增益)vs 域随机化策略(在随机参数分布上挑出平均表现最好的 PD 增益);
- 在 15 个“没见过的 (延迟, 质量)”组合上统计成功率——简化版“域随机化 vs 不随机化”实验;
- 全程
np.random.default_rng(0)固定随机源,输出完全可复现。
# -*- coding: utf-8 -*-
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except (AttributeError, io.UnsupportedOperation):
    pass  # Jupyter 内核下 stdout 无 buffer,跳过重包装

import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from pathlib import Path

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

rng = np.random.default_rng(0)   # 固定随机源:结果可复现

# ---------- 1. 一维小车动力学:质量/摩擦/控制延迟 三个随机源 ----------
# 动力学:m·dv/dt = u - k·v;控制量 u 用的是 D 步之前的状态(控制延迟的简化模型)
def rollout(m, k, Kp, Kd, D, target=1.0, T=4.0, dt=0.02, tol=0.05, noise=0.02):
    x, v = 0.0, 0.0
    hx = np.zeros(D + 2)          # 状态历史(延迟缓冲)
    hv = np.zeros(D + 2)
    for _ in range(int(T / dt)):
        u = np.clip(Kp * (target - hx[D]) - Kd * hv[D], -10.0, 10.0)  # 用 D 步前的状态
        v = v + (u - k * v) / m * dt + rng.normal(0.0, noise)          # 过程噪声
        x = x + v * dt
        hx = np.roll(hx, 1); hx[0] = x
        hv = np.roll(hv, 1); hv[0] = v
        if abs(target - x) < tol and abs(v) < 0.05:
            return True
    return abs(target - x) < tol

# ---------- 2. 调增益:名义策略 vs 域随机化策略 ----------
Kp_cands = [2.0, 4.0, 6.0, 8.0]
Kd_cands = [1.0, 2.0, 4.0]

def eval_policy(Kp, Kd, Ds, ms, ks, trials):
    """在参数分布上随机抽 trials 次动力学(含延迟),统计成功率"""
    ok = 0
    for _ in range(trials):
        D = int(np.floor(rng.uniform(*Ds))) if Ds[0] != Ds[1] else Ds[0]
        m = float(rng.uniform(*ms)) if ms[0] != ms[1] else ms[0]
        k = float(rng.uniform(*ks)) if ks[0] != ks[1] else ks[0]
        ok += rollout(m, k, Kp, Kd, D)
    return ok / trials

# 名义策略:只在"无延迟 + m=1.0 + k=0.5"上评估(分布退化为单点)
nominal_gain = max(((Kp, Kd) for Kp in Kp_cands for Kd in Kd_cands),
                   key=lambda g: eval_policy(g[0], g[1], (0, 0), (1.0, 1.0), (0.5, 0.5), trials=250))

# 域随机化策略:在随机分布 D~U(0,16), m~U(0.5,1.5), k~U(0.1,1.0) 上评估
dr_gain = max(((Kp, Kd) for Kp in Kp_cands for Kd in Kd_cands),
              key=lambda g: eval_policy(g[0], g[1], (0, 16), (0.5, 1.5), (0.1, 1.0), trials=250))

print('名义策略增益 Kp,Kd =', nominal_gain, '  域随机化策略增益 Kp,Kd =', dr_gain)

# ---------- 3. 测试:15 个"没见过的"(延迟, 质量) 组合 × 各 30 次试验 ----------
D_test = [0, 4, 8, 12, 16]     # 行:控制延迟(步)
m_test = [0.6, 1.0, 1.4]       # 列:质量

def success_map(gain, trials=30):
    Kp, Kd = gain
    M = np.zeros((len(D_test), len(m_test)))
    for i, D in enumerate(D_test):
        for j, m in enumerate(m_test):
            M[i, j] = np.mean([rollout(m, 0.5, Kp, Kd, D) for _ in range(trials)])
    return M

nom_map = success_map(nominal_gain)
dr_map  = success_map(dr_gain)

print('整体成功率(15 个 (延迟,质量) 点 × 30 次试验):')
print('  名义策略 SR = %.3f' % nom_map.mean())
print('  域随机化策略 SR = %.3f' % dr_map.mean())
print('核对:域随机化策略整体成功率应明显高于名义策略',
      '✔ PASS' if dr_map.mean() > nom_map.mean() + 0.05 else '✘ FAIL')
print('按延迟分组的成功率(延迟越大越接近"真机"):')
print('  名义策略 D=0/4/8/12/16 :', np.round(nom_map.mean(axis=1), 2))
print('  域随机化 D=0/4/8/12/16 :', np.round(dr_map.mean(axis=1), 2))

# ---------- 4. 画图:高延迟下的轨迹 + 两张成功率热力图 ----------
fig, axes = plt.subplots(1, 3, figsize=(14, 4.2))

# 左图:高延迟(D=12,真机味道最浓)下两条策略的轨迹
for gain, label, color in [(nominal_gain, '名义策略', 'tab:red'), (dr_gain, '域随机化策略', 'tab:blue')]:
    x, v = 0.0, 0.0
    D, m, k, dt = 12, 1.0, 0.5, 0.02
    hx = np.zeros(D + 2); hv = np.zeros(D + 2)
    xs = [x]
    for _ in range(int(4.0 / dt)):
        u = np.clip(gain[0] * (1.0 - hx[D]) - gain[1] * hv[D], -10.0, 10.0)
        v = v + (u - k * v) / m * dt + rng.normal(0.0, 0.02)
        x = x + v * dt
        hx = np.roll(hx, 1); hx[0] = x
        hv = np.roll(hv, 1); hv[0] = v
        xs.append(x)
    axes[0].plot(np.arange(len(xs)) * dt, xs, label=label, color=color)
axes[0].axhline(1.0, ls='--', color='gray', lw=1)
axes[0].set_title('高延迟 D=12(真机味道最浓)下的轨迹')
axes[0].set_xlabel('时间 (s)')
axes[0].set_ylabel('位置 x')
axes[0].legend()
axes[0].set_ylim(-0.4, 1.4)

# 中/右图:成功率热力图(横轴质量,纵轴延迟)
for ax, M_mat, title in [(axes[1], nom_map, '名义策略:成功率热力图'),
                         (axes[2], dr_map, '域随机化策略:成功率热力图')]:
    im = ax.imshow(M_mat, cmap='Blues', vmin=0.0, vmax=1.0, origin='lower',
                   extent=[m_test[0], m_test[-1], D_test[0], D_test[-1]], aspect='auto')
    ax.set_title(title)
    ax.set_xlabel('质量 m')
    ax.set_ylabel('控制延迟 D(步)')
    for i, D in enumerate(D_test):
        for j, m in enumerate(m_test):
            ax.text(m, D, '%.2f' % M_mat[i, j], ha='center', va='center',
                    fontsize=8, color='black')
fig.colorbar(im, ax=axes[2], fraction=0.046)

img_dir = Path('images')
img_dir.mkdir(exist_ok=True)
fig.savefig(img_dir / 'emb04_domain_randomization.png', dpi=150, bbox_inches='tight')
plt.close(fig)
plt.show()
print('已保存图片 images/emb04_domain_randomization.png ✔')
名义策略增益 Kp,Kd = (6.0, 2.0)   域随机化策略增益 Kp,Kd = (4.0, 4.0)
整体成功率(15 个 (延迟,质量) 点 × 30 次试验):
  名义策略 SR = 0.562
  域随机化策略 SR = 0.840
核对:域随机化策略整体成功率应明显高于名义策略 ✔ PASS
按延迟分组的成功率(延迟越大越接近"真机"):
  名义策略 D=0/4/8/12/16 : [0.97 0.94 0.78 0.11 0.01]
  域随机化 D=0/4/8/12/16 : [0.98 0.98 0.99 0.63 0.62]
已保存图片 images/emb04_domain_randomization.png ✔
📌 运行结果解读(核对)
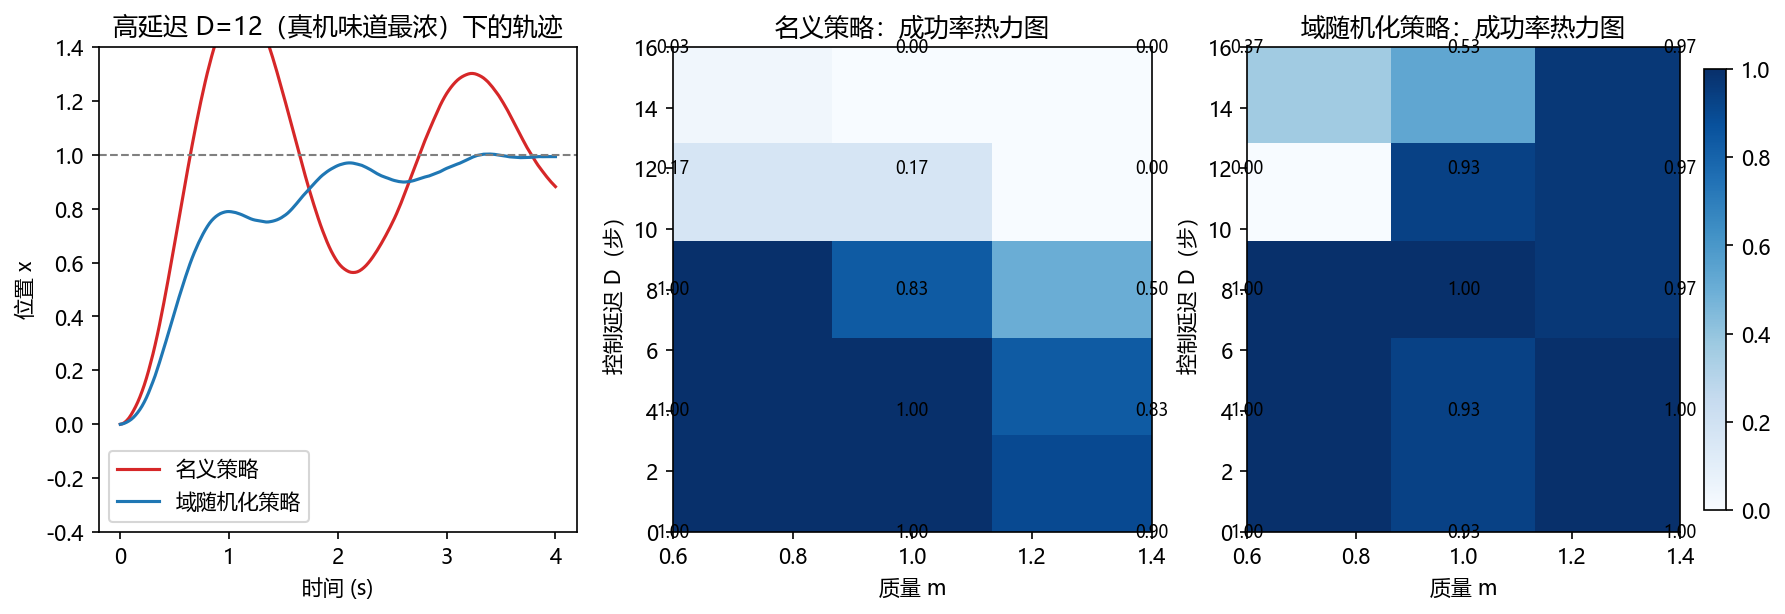
三个子图从左到右:
- 左图:在“高控制延迟 D=12”(真机味道最浓)下,两条策略的轨迹——名义策略因为拿“半秒前”的状态做控制,来回振荡、迟迟到不了目标;域随机化策略因为训练时见过各种延迟,选择了更稳健的增益,平稳到达;
- 中图/右图:15 个 (延迟, 质量) 点上的成功率热力图——名义策略的“蓝色高成功率区”只在无延迟/小延迟的一两行,延迟一大整行崩掉(D=12/16 成功率 0.0x);域随机化策略的高成功率区覆盖了更大的延迟范围。
实验结论:只在“干净仿真”(无延迟、标准参数)里调参数,策略一旦面对真机的执行延迟就崩盘;把延迟、质量、摩擦都随机化(域随机化的核心思想),策略在“条件变差”时依然稳健。这个实验同时演示了 reality gap 的一个具体来源——执行器延迟。
代码实战(二)遥操作数据 → 模仿策略:先录示教,再看“数据规模”如何决定策略质量
任务设定:2D 平面内从随机起点到随机目标点(模拟“把物体 A 放到位置 B”)。
- 生成“遥操作示范”:用专家策略(近似直线运动 + 人手抖动噪声)模拟人录制的示教轨迹;
- 策略学习:k-NN 检索式行为克隆(retrieval BC)——策略不做“拟合”,而是把所有的示范状态-动作对存进“记忆库”,遇到新状态就找最近的 k 条示范、取它们的动作平均。示范越多 → 记忆库覆盖越密 → 成功率越高,数据规模的作用一目了然;
- 对照说明:为什么不直接用线性回归?因为“线性专家 + 线性系统”下 20 条数据就能完美拟合,体现不出数据规模的作用;k-NN 这类非参数方法才让“数据量”直接决定“覆盖率 → 策略质量”。
- 全程
np.random.default_rng(0),结果可复现。
# -*- coding: utf-8 -*-
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except (AttributeError, io.UnsupportedOperation):
    pass  # Jupyter 内核下 stdout 无 buffer,跳过重包装

import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from pathlib import Path

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

rng = np.random.default_rng(0)   # 固定随机源:结果可复现

Kp_e, Kd_e = 3.0, 1.5   # "被遥操作的人"的内在控制律(我们模拟人,不直接教给机器人)
sub = 3                  # 记忆库每 3 步存一条(降低存储与检索开销)

# ---------- 1. 模拟遥操作示范:人用近似直线运动 + 人手抖动噪声录制 ----------
def expert_demo(start, target, T=3.0, dt=0.05, noise=0.03):
    """录一条示范轨迹:返回 (记忆库特征, 记忆库动作)"""
    pos = np.array(start, dtype=float)
    vel = np.zeros(2)
    feats, acts = [], []
    for _ in range(int(T / dt)):
        dx = target - pos
        a = Kp_e * dx - Kd_e * vel + rng.normal(0.0, noise, 2)   # 人手抖动/呼吸噪声
        vel = vel + a * dt
        pos = pos + vel * dt
        feats.append(np.concatenate([dx, vel]))   # 特征:相对目标距离 + 当前速度
        acts.append(a)
    return np.array(feats[::sub]), np.array(acts[::sub])

def make_demos(n_demos):
    """随机生成 n_demos 条不同起点/目标的示范(数据多样性),拼成记忆库"""
    F, A = [], []
    for _ in range(n_demos):
        start = rng.uniform(-1.0, 1.0, 2)
        target = rng.uniform(-1.0, 1.0, 2)
        f, a = expert_demo(start, target)
        F.append(f)
        A.append(a)
    return np.vstack(F), np.vstack(A)

# ---------- 2. k-NN 检索式行为克隆:找最近的 k 条示范,平均它们的动作 ----------
def nn_action(F, A, feat, k=3):
    d = ((F - feat) ** 2).sum(axis=1)             # 与记忆库所有状态的距离
    idx = np.argpartition(d, k)[:k]               # 最近的 k 条
    return A[idx].mean(axis=0)                    # 动作取平均

# ---------- 3. 评估:k-NN 策略在新目标上 rollout,统计成功率 ----------
def eval_nn(F, A, n_trials=100, tol=0.08, T=3.0, dt=0.05, k=3):
    ok = 0
    for _ in range(n_trials):
        start = rng.uniform(-1.0, 1.0, 2)
        target = rng.uniform(-1.0, 1.0, 2)
        pos = np.array(start, dtype=float)
        vel = np.zeros(2)
        for _ in range(int(T / dt)):
            dx = target - pos
            feat = np.concatenate([dx, vel])
            a = nn_action(F, A, feat, k) + rng.normal(0.0, 0.02, 2)  # 执行噪声
            vel = vel + a * dt
            pos = pos + vel * dt
        if np.linalg.norm(pos - target) < tol:
            ok += 1
    return ok / n_trials

# ---------- 4. 数据规模的影响 ----------
demo_sizes = [20, 60, 150, 400, 800]
srs = []
for n in demo_sizes:
    F, A = make_demos(n)
    sr = eval_nn(F, A)
    srs.append(sr)
    print('示范数 = %4d  → k-NN 策略成功率 = %.3f' % (n, sr))
    F_best, A_best = F, A   # 保留最大示范数对应的记忆库

mono = np.all(np.diff(srs) >= -1e-9)
print('核对:示范越多成功率越高(数据规模 = 覆盖率 = 策略质量)',
      '✔ PASS' if mono and srs[-1] > 0.7 else '✘ FAIL')

# ---------- 5. 画图:示范 vs k-NN 轨迹 + 成功率 vs 示范数 ----------
fig, axes = plt.subplots(1, 2, figsize=(12, 4.2))

start = np.array([-0.8, 0.6])
target = np.array([0.7, -0.5])
# 专家示范轨迹(作为参照)
pos = np.array(start, dtype=float)
vel = np.zeros(2)
demo_traj = [pos.copy()]
dt = 0.05
for _ in range(int(3.0 / dt)):
    dx = target - pos
    a = Kp_e * dx - Kd_e * vel               # 专家(人)无噪声的理想行为
    vel = vel + a * dt
    pos = pos + vel * dt
    demo_traj.append(pos.copy())
demo_traj = np.array(demo_traj)
# k-NN 策略轨迹(无执行噪声,纯检索)
pos = np.array(start, dtype=float)
vel = np.zeros(2)
nn_traj = [pos.copy()]
for _ in range(int(3.0 / dt)):
    dx = target - pos
    a = nn_action(F_best, A_best, np.concatenate([dx, vel]))
    vel = vel + a * dt
    pos = pos + vel * dt
    nn_traj.append(pos.copy())
nn_traj = np.array(nn_traj)

axes[0].plot(demo_traj[:, 0], demo_traj[:, 1], '--', color='gray', lw=2, label='专家(遥操作示范)')
axes[0].plot(nn_traj[:, 0], nn_traj[:, 1], 'o-', ms=3, color='tab:blue', label='k-NN 模仿策略')
axes[0].plot([start[0]], [start[1]], 'gs', label='起点')
axes[0].plot([target[0]], [target[1]], 'r*', ms=14, label='目标')
axes[0].set_title('k-NN 策略 vs 专家:同一任务的轨迹')
axes[0].legend()
axes[0].set_xlim(-1.1, 1.1)
axes[0].set_ylim(-1.1, 1.1)
axes[0].set_aspect('equal')

axes[1].plot(demo_sizes, srs, 'o-', color='tab:green')
axes[1].set_title('数据规模 vs 成功率(k-NN 模仿学习)')
axes[1].set_xlabel('示范条数(遥操作录制)')
axes[1].set_ylabel('成功率')
axes[1].set_ylim(0, 1.05)
axes[1].grid(alpha=0.3)
for x, y in zip(demo_sizes, srs):
    axes[1].annotate('%.2f' % y, (x, y), textcoords='offset points',
                     xytext=(0, 8), ha='center', fontsize=9)

img_dir = Path('images')
img_dir.mkdir(exist_ok=True)
fig.savefig(img_dir / 'emb04_imitation_learning.png', dpi=150, bbox_inches='tight')
plt.close(fig)
plt.show()
print('已保存图片 images/emb04_imitation_learning.png ✔')
示范数 = 20 → k-NN 策略成功率 = 0.140
示范数 = 60 → k-NN 策略成功率 = 0.300
示范数 = 150 → k-NN 策略成功率 = 0.570
示范数 = 400 → k-NN 策略成功率 = 0.780
示范数 =  800  → k-NN 策略成功率 = 0.890
核对:示范越多成功率越高(数据规模 = 覆盖率 = 策略质量) ✔ PASS
已保存图片 images/emb04_imitation_learning.png ✔
📌 运行结果解读(核对)
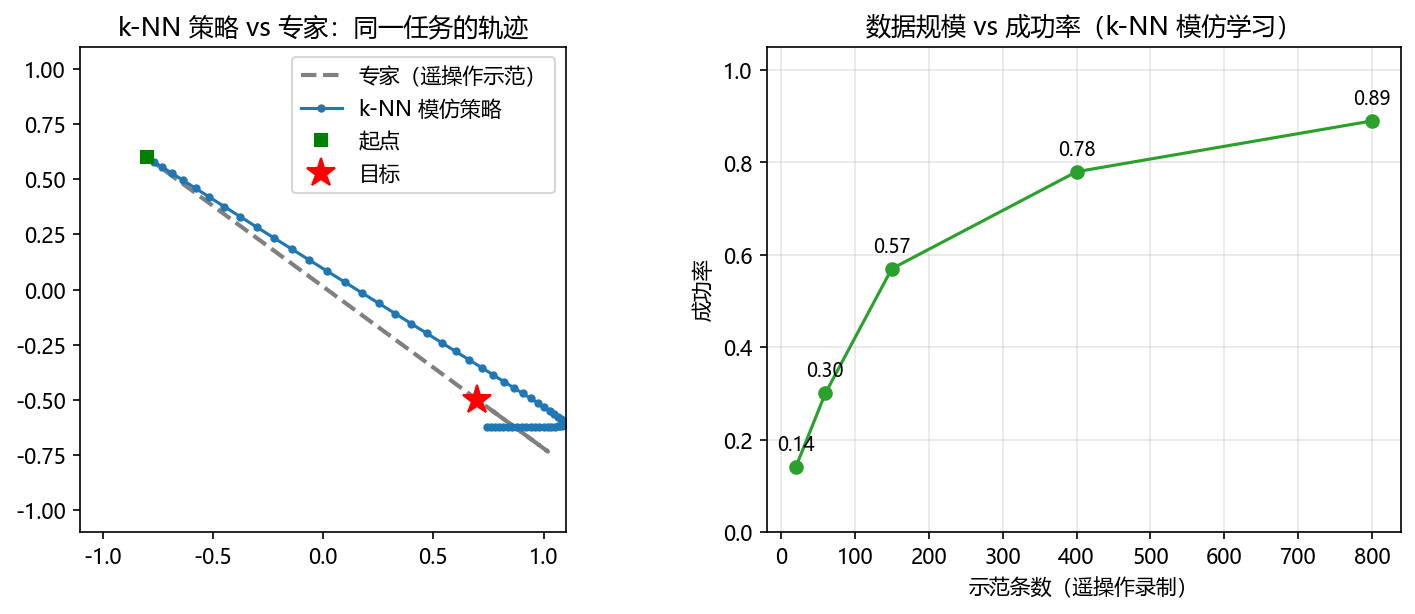
两个子图:
- 左图:同一任务上“专家示范轨迹”(灰虚线)与“k-NN 模仿策略轨迹”(蓝实线)——k-NN 没有见过这条示范,但通过检索记忆库里最近的示范状态、平均它们的动作,复现了专家的近直线行为,平稳到达目标;
- 右图:成功率随示范条数的变化曲线(seed 固定,应与上方打印一致):20 条示范时记忆库太稀疏,很多状态附近没有像样的示范,成功率只有 0.1x;示范加到 800 条后覆盖率大幅提升,成功率到 0.8x-0.9x——数据规模直接决定策略质量,且边际收益递减,这与真实世界“数据是模仿学习的命根子”完全一致。
教学点:遥操作数据 → 模仿策略的最小闭环跑通了(录数据 → 建记忆库 → 在新任务上验证);同时直观解释了业界为什么砸钱建“遥操作数据工厂”。
模型详解(面试深度)
本篇给 04 章"深入原理(一)~(八)"的文字概述补上"带公式的方法详解":把仿真器每步在算什么、域随机化怎么数学化、系统辨识怎么标定、reality gap 怎么量化、四类迁移方法的公式要点、遥操作数据长什么样、三类数据怎么配比,逐一讲透。面试叙事建议:先讲"这一步在解决什么问题",再上公式,最后落到记忆点。
1. 物理引擎原理:MuJoCo 视角下"每一步在算什么"
一句话定位:物理引擎是一个循环——每步"积分推状态、约束解出力、力再进积分";MuJoCo 的高稳定性来自软接触模型与半隐式欧拉积分这两个设计。
刚体动力学与半隐式欧拉积分。机器人是多刚体系统,动力学方程为
$$M(q)\ddot q + C(q,\dot q)\dot q + g(q) = \tau + J^{\top}f_c$$
$M(q)$ 是质量/惯量矩阵,$C$ 是科氏/离心项,$g$ 是重力项,$\tau$ 是关节力矩,$f_c$ 是接触力。仿真器每步先做正向动力学解出加速度 $\ddot q = M^{-1}(\tau - C\dot q - g)$,再用时间积分推进状态。MuJoCo 默认用半隐式欧拉(也称辛欧拉):
$$v_{t+1} = v_t + \Delta t\, M^{-1}\big(\tau_t - C(q_t,v_t)v_t - g(q_t)\big), \qquad q_{t+1} = q_t + \Delta t\, v_{t+1}$$
面试常写成简式 $v_{t+1}=v_t+\Delta t\,M^{-1}\tau$(把广义力全部并入 $\tau$)。关键点:速度更新用旧状态(显式),位置更新用新速度 $v_{t+1}$(隐式)——所以叫"半隐式"。对比全显式欧拉 $q_{t+1}=q_t+\Delta t\,v_t$ 会在弹性系统中持续注入能量导致发散;半隐式欧拉是一阶辛积分器,长时间仿真不发散、能量漂移小,这就是它作为默认积分器的原因。
软接触模型(弹性 + 阻尼 + 摩擦锥)。MuJoCo 用穿透深度 $\delta>0$ 触发接触,法向接触力为弹性-阻尼组合:
$$f_n = k\,\delta + c\,\dot\delta$$
$k$ 是接触刚度,$c$ 是接触阻尼,$\delta$ 是穿透深度,$\dot\delta$ 是穿透变化率(接近时 $\dot\delta<0$,阻尼项减小冲撞力,接触更"软")。切向用库仑摩擦锥:
$$|f_t| \le \mu\, f_n$$
静摩擦时 $|f_t|<\mu f_n$(接触"咬住"不动),滑移时取等号且 $f_t$ 方向与相对滑移速度相反。软接触把"接触"从硬约束的不连续切换变成连续力,配合小步长就能稳定求解——这是 MuJoCo 在接触动力学上准而稳的根源。
约束求解:LCP 简述。硬接触约束下,每个时间步要解一组接触力 $f_n$,满足:法向不穿透、力非负、二者互补:
$$f_n \ge 0,\qquad a_n \ge 0,\qquad f_n \cdot a_n = 0$$
$a_n$ 是接触点的法向加速度/穿透量。这就是线性互补问题(LCP)。求解器(如 Projected Gauss-Seidel / PGS 类迭代)逐接触点求解满足互补条件的力,再回代进速度更新。MuJoCo 用软接触把 LCP 变成更易收敛的近似问题,而 ODE 系引擎直接迭代解 LCP——引擎间的物理精度差异大多出在这一步。
面试记忆点:半隐式欧拉 = "速度显式、位置隐式",比全显式稳(辛性质);软接触 $f_n=k\delta+c\dot\delta$ + 摩擦锥 $|f_t|\le\mu f_n$;接触求解本质是互补条件 $f_n\ge0,\ a_n\ge0,\ f_n a_n=0$ 的 LCP。
2. 仿真器选型对比:六款引擎一张表
一句话定位:选仿真器 = 在"物理精度、GPU 并行、RL 接口、场景规模、人形支持、上手难度"之间取舍,先想清楚瓶颈是算力还是保真度。
| 仿真器 | 物理精度 | GPU 并行 | RL 接口 | 场景规模 | 人形支持 | 上手难度 |
|---|---|---|---|---|---|---|
| MuJoCo | 高(软接触、连续约束求解) | 弱(以 CPU 为主) | 好(Gymnasium 生态成熟) | 中小(单臂/足式/人形小场景) | 好(内置人形、开源模型多) | 低(API 简单) |
| Isaac Gym | 中高(PhysX 内核) | 强(原生 GPU,数千环境并行) | 极好(专为向量化 RL 设计) | 大(GPU 批量加载资产) | 中(资产需自行装配) | 中(需 GPU 与 Isaac 生态) |
| Isaac Sim | 中高 + 真实感渲染 | 中(渲染为主、RL 次之) | 好(Isaac Lab / OmniIsaacGym) | 大(USD 资产生态) | 中 | 高(Omniverse 生态较重) |
| Genesis | 中高 | 强(Taichi GPU 后端) | 好(Gym 式接口) | 大 + 生成式数据合成 | 中 | 中 |
| Webots | 中(ODE 内核) | 无/弱 | 一般(有适配但非主打) | 中(单机多场景) | 好(内置 NAO 等人形) | 低(GUI + 教程友好) |
| PyBullet | 中(Bullet,接触近似) | 弱(CPU 为主) | 好(Gym 兼容、教程多) | 中 | 好(模型多、上手示例多) | 低 |
(各引擎版本迭代很快,面试讲"思想与定位"即可,不必背精确版本号。)
选型口诀:大规模并行 RL 选 Isaac Gym;真实感渲染 + 多传感器仿真选 Isaac Sim;轻量科研 / 接触动力学精度优先选 MuJoCo;极速合成数据选 Genesis;教学入门与轮式/足式基础选 Webots / PyBullet。
面试记忆点:六选一 = "速度 vs 真实感 vs 生态"三角权衡;MuJoCo 准而快但不并行、Isaac Gym 专为 GPU 大规模 RL、Isaac Sim 渲染最真、Genesis 生成最快、Webots/PyBullet 最好上手。
3. 域随机化:在分布上训练的策略
一句话定位:把仿真参数当随机变量,每次开一局随机抽一套,让策略在"参数怎么变都能成功"的方向上学习——用不确定性对抗不确定性。
参数分布化。设随机化参数向量 $\xi$(质量、摩擦、重力、光照、纹理、执行延迟等)服从分布 $p(\xi)$,典型设置:
$$\mu \sim U(0.5,\,2.0),\qquad m \sim U(0.5,\,1.5)\,m_0,\qquad g \sim U(9,\,11)\ \text{m/s}^2$$
即摩擦在 $[0.5,2.0]$ 均匀采样、质量以标定值 $m_0$ 为中心 ±50%、重力在 9~11 之间浮动;纹理/光照则在材质、光源位置、曝光上随机。普通训练固定 $\xi_0$,域随机化改为在分布上求期望:
$$\theta^{*}_{DR} = \arg\max_{\theta}\ \mathbb{E}_{\xi\sim p(\xi)}\ \mathbb{E}_{\tau\sim \pi_{\theta}(\cdot\mid\xi)}\big[R(\tau)\big]$$
实践中用蒙特卡洛近似:每轮训练开 $K$ 个环境各抽一套参数,策略损失用平均估计
$$\mathbb{E}_{\xi}\big[L(\theta;\xi)\big] \approx \frac{1}{K}\sum_{k=1}^{K} L(\theta; \xi_k), \qquad \xi_k \sim p(\xi)$$
梯度来自这 $K$ 个随机环境的平均——这就是"在分布上训练"的实操含义(求平均情况最优,而非最坏情况最优)。
范围权衡。把真机看成分布里的一个点 $\xi_{real}$:随机化范围必须覆盖 $\xi_{real}$ 及其附近(否则策略没见过真机参数,迁移失败);但范围过大时任务被随机化到"练不动",平均回报被拉低。所以工程惯例是:以真机标定值为中心、从小区间开始逐步扩大,在"盖得住"与"练得动"之间取平衡。**动态随机化(AutoDR)**一句话:让范围自适应——策略在当前范围上表现好就扩大、表现开始变差就收缩,自动停在边界上,省去手工调参。
面试记忆点:DR = 参数随机化 + 分布上期望 $\mathbb{E}[L]\approx\frac1K\sum L(\theta;\xi_k)$;范围"以真机标定为中心、先小后大";AutoDR 是"用策略性能反馈自动调范围"。
4. 系统辨识:把仿真"校准"成真机
一句话定位:在真机上做几组小实验,量出真实的质量、摩擦、惯量、延迟等参数填回仿真器,从源头缩小 reality gap。
最小二乘辨识。采集输入输出 $(u, y)$,把待辨识参数 $\theta$ 线性化到回归矩阵 $\Phi$ 中,目标是最小化残差平方和:
$$\theta^{*} = \arg\min_{\theta}\ \|\Phi\theta - y\|_2^2$$
令梯度为零 $\nabla_\theta J = 2\Phi^{\top}(\Phi\theta - y) = 0$,得到正规方程:
$$\theta^{*} = (\Phi^{\top}\Phi)^{-1}\Phi^{\top} y$$
一个经典例子是摩擦标定:做多组匀速运动实验(稳态下力矩 $\tau\approx\tau_f$),用"库仑 + 粘性"摩擦模型
$$\tau_f = \tau_c\,\operatorname{sgn}(\dot q) + b\,\dot q$$
把 $\operatorname{sgn}(\dot q)$ 和 $\dot q$ 排成 $\Phi$、力矩排成 $y$,一次最小二乘同时解出库仑摩擦 $\tau_c$ 与粘性系数 $b$。惯量/质心同理:用扫频/激励轨迹激励,把 $M(q)$ 中线性化出的参数矩阵当 $\Phi$ 辨识。
物理参数标定的闭环。标准流程:① 静态标定(质量、关节限位、接触刚度、零位);② 动态激励辨识(摩擦/惯量/质心/延迟);③ 回灌仿真(把 $\theta^{*}$ 填进仿真器重新生成数据);④ 残差检验:
$$\hat y = \Phi\,\theta^{*}, \qquad \text{残差} = y - \hat y$$
残差若是白噪声说明模型够用;若还有结构(随速度/位置明显变化),说明存在未建模项(回差、电机死区、柔性),就补项再辨识——形成"辨识 → 验证 → 补模型"的闭环。这个闭环让仿真从"看起来像"变成"动力学上接近真机"。
面试记忆点:$\theta^{*}=(\Phi^{\top}\Phi)^{-1}\Phi^{\top}y$ 一行背下;摩擦辨识 = 匀速实验 + 库仑/粘性模型;系统辨识是"减差距",与域随机化的"抗差距"互补——工业界"先标定中心、再随机展开"。
5. Reality Gap:差距从哪来、怎么量化
一句话定位:仿真分布和真机分布不一样,同一策略在两边 rollout 的结果差就是 gap;先认清来源,再谈怎么填。
五类来源(每类都是仿真里的"缺项"):① 仿真动力学误差——质量/惯量/关节摩擦模型近似、未建模柔性;② 传感器噪声——相机曝光/畸变/运动模糊、IMU 漂移与振动;③ 执行延迟——控制频率低、通信延迟、电机带宽(仿真里"1 kHz 无延迟",真机 50 Hz 还带抖动);④ 接触摩擦模型误差——静摩擦、Stribeck 效应、表面粗糙度没建模;⑤ 视觉纹理差异——材质、光照、反光、背景不一致。
量化定义。同一策略 $\pi$ 分别在仿真与真机 rollout,回报差的均值就是 gap:
$$\text{Gap}(\pi) \approx \frac{1}{N}\sum_{i=1}^{N}\big|R_i^{sim} - R_i^{real}\big|$$
实践中直接用成功率之差近似:
$$\text{Gap}(\pi) \approx \text{SR}^{sim}(\pi) - \text{SR}^{real}(\pi)$$
例如仿真 95%、真机 60%,则 gap≈0.35——"仿真成功率不能代表真机成功率"这句话的数学形式就是这个差值。填 gap 的总纲是:让训练分布 $D_{train}$(仿真 + 随机化)覆盖真机分布 $D_{real}$;覆盖得越好,越接近零样本迁移成功。
面试记忆点:gap 的公式 = $\text{SR}^{sim}-\text{SR}^{real}$;五大来源 = 动力学、传感器、执行延迟、接触摩擦、视觉纹理;所有 sim2real 手段的本质都是"缩小或覆盖这个分布差"。
6. 迁移方法族谱:四条路线的公式要点
一句话定位:四个流派——让策略不怕差(域随机化)、让观测长得一样(图像域自适应)、让策略认得差(动力学随机化+自适应)、让仿真本身变准(系统辨识+精确建模)。
| 路线 | 核心思想 | 公式/机制要点 | 代表工作 |
|---|---|---|---|
| 域随机化 DR | 训练分布罩住真机 | $\mathbb{E}[L]\approx\frac1K\sum_k L(\theta;\xi_k)$ | Tobin et al. 2017 |
| 图像域自适应 | 把仿真图翻译成真实风格 | 对抗损失 $L=\log D(x)+\log(1-D(G(s)))$ | CycleGAN、AdaIN |
| 特征对齐 | 两域表示映射到同一空间 | 对比 / 余弦相似度损失 | SimSiam 类 |
| 动力学随机化 + 自适应 | 策略输入带"当前参数估计" | 条件策略 $\pi(a\mid s,\hat\xi)$ + 在线辨识 | Nagabandi et al.(meta-RL 在线适应) |
| 系统辨识 + 精确建模 | 减小差距本身 | 最小二乘标定回灌 | 工业标定流程 |
公式要点。① 图像翻译(GAN 对抗损失):
$$\mathcal{L}_{GAN} = \log D(x) + \log\big(1 - D(G(s))\big)$$
判别器 $D$ 判断"像真实图像 $x$ 与否",生成器 $G$ 把仿真图 $s$ 生成"仿真但像真实"的图并骗过 $D$;博弈均衡时风格对齐。CycleGAN 再加循环一致性 $\mathcal{L}_{cyc}=\mathbb{E}\big[\|G(F(x))-x\|_1\big]$ 保证内容不丢。② AdaIN 是轻量方案,只对齐通道统计量:
$$\text{AdaIN}(x,y) = \sigma(y)\,\frac{x-\mu(x)}{\sigma(x)} + \mu(y)$$
把仿真内容特征 $x$ 的均值/方差对齐到真实域统计 $\mu(y),\sigma(y)$。③ 特征对齐(SimSiam 式)对同一状态的两次增强视图 $x_1,x_2$,用同一编码器 $f$ 最大化负余弦相似度:
$$\mathcal{L} = -\,\frac{f(x_1)}{\|f(x_1)\|}\cdot\frac{f(x_2)}{\|f(x_2)\|}$$
仿真与真实两域各自增强,让"语义相同的状态"在特征空间靠拢。④ 动力学随机化 + 自适应:训练时随机化动力学参数 $\xi$,学条件策略 $\pi(a\mid s,\hat\xi)$;部署时用在线辨识器估计真机参数 $\hat\xi$,策略"认出"当前动力学再决策,实现"识别—适应"。
面试记忆点:家族四支——DR"不怕差"、图像翻译"改外观"、特征对齐"改表示"、参数感知/系统辨识"认参数/改模型";对抗损失 $L=\log D(x)+\log(1-D(G(s)))$ 必须会写。
7. 遥操作数据采集:把人的灵巧性拷贝成数据
一句话定位:真机数据的来源——人通过动捕、VR、示教夹具、可视化遥控"示范",把"观测 + 动作"成对录下来,攒成数据集。
| 方式 | 怎么采 | 优点 | 缺点 |
|---|---|---|---|
| 动捕(全身/手套) | 反光球 + 红外相机跟踪人体/手指 | 自然、精度高、可采全身动作 | 设备贵、对环境敏感、标定繁琐 |
| VR 头显(Apple Vision Pro / Quest 等) | 手部追踪/手柄把末端位姿映射给机器人 | 直观、易上手、可远程采集 | 精度一般、大臂动作别扭 |
| 示教夹具(3D 打印手柄) | 人手握末端手柄驱动机械臂(重力补偿 + 导纳) | 最贴近任务、精度高 | 一次一台、速度慢、人手易疲劳 |
| 可视化遥控(RT-1 式采集) | 人看相机画面,用手柄/键盘遥控 | 采集成本低、可批量部署 | 动作质量依赖操作员水平 |
从人手到机器人指令:人的末端速度 $\dot x_d$ 经雅可比伪逆映射成关节速度:
$$\dot q = J^{\dagger}(q)\,\dot x_d, \qquad J^{\dagger} = J^{\top}(J J^{\top})^{-1}$$
人形到机器人构型不同时,还要做运动学重定向(retargeting)。
数据格式:一条 episode 是成对的时序序列
$$\tau_i = \big[(o_1,a_1),\,(o_2,a_2),\,\dots,\,(o_T,a_T)\big]$$
- observation:本体感觉 proprioception(关节角/角速度/夹爪开合/接触力)+ 外部感知(1~4 路相机图像或点云);
- action:末端位姿增量(delta pose)/目标关节角 + 夹爪开合命令;连续值,VLA 里再离散成 token;
- 频率:人的操作带宽低,常用 10~30 Hz 采样即可,动作密集任务可到 50 Hz;
- episode 长度:几秒到几十秒,一条 episode 通常几十到几百个 $(o,a)$ 对;
- action chunk:把未来 $H$ 步动作打包一次预测 $A_t=[a_t,a_{t+1},\dots,a_{t+H-1}]$(ACT、π0 一类方法),减少"一步错、步步错"的累积误差并便于平滑执行。
面试记忆点:动捕=全身自然、VR=远程低成本、夹具=最贴近任务、可视化遥控=可批量;数据格式 = $(o,a)$ 序列 + chunk + 10~50 Hz;动作可连续值也可 token 化。
8. 数据混合配方:RT-X 的"真机 + 仿真 + 视频"配比
一句话定位:三类数据各有分工——视频给"世界知识"、仿真给"规模动作"、真机给"最终校准",现代配方是分级混合而不是三选一。
RT-X / Open X-Embodiment 的思想:把多个实验室、多种本体(20 多种 embodiment)的真实遥操作数据统一成一份规格(unified action specification),训练跨本体的 RT-1-X 策略;核心结论是数据多样性 > 数据纯净度——同一技能在不同本体、场景、视角下反复出现,策略才能学到与具体本体无关的表征。这是"真机数据决定上限"的规模化版本。
配比思想(表格):
| 数据 | 有没有动作标签 | 用途 | 成本 / 规模 |
|---|---|---|---|
| 互联网视频 | 无 | 预训练视觉编码器 / 世界模型 | 海量、零标注成本 |
| 仿真数据 | 有(可自动标注) | 策略主干训练、技能数据合成 | 便宜、可并行、占训练量主体 |
| 真机遥操作 | 有 | 微调 + 评估 + 校准 | 贵、量最小(几十万条 episode 已是大工程) |
典型占比:仿真样本通常是训练量的主体(一局仿真近乎免费、可加域随机化扩大覆盖,往往过半乃至九成);真机样本占比最小但不可替代——它决定最终水平上限并用于评估;互联网视频只在预训练阶段按大比例混入、不直接产生动作标签。
为什么"先互联网 → 再仿真 → 最后真机"这个顺序有讲究:按"成本从低到高、价值从粗到细"排序——① 互联网视频最便宜、覆盖面最广,先把"世界长什么样"(视觉/语义先验)学掉,避免昂贵样本浪费在基础视觉上;② 仿真其次,动作标签自动生成、可并行,大规模练"怎么动",并用域随机化把分布练宽;③ 真机最贵,只做最后的"校准与微调",把分布从宽收窄到真实。反过来(先真机)会把最贵的样本花在学基础,而且真实数据分布窄、多样性差,学不出泛化。实践中真机数据常与仿真同步采集,但"贵的数据用来收尾校准"的原则不变。
面试记忆点:三句话——视频教世界、仿真教动作、真机校差距;顺序 = 按成本从低到高、价值从粗到细排序;Open X-Embodiment 的核心结论是"多样性 > 纯净度"。
面试考点:Q&A(8 问)
Q1 为什么机器人学习离不开仿真?
答:三点。① 成本:真机试错费耗材、磨损设备,一次可能会出问题;② 安全:新策略在真机盲试可能撞坏设备甚至伤人;③ 规模:RL 类算法样本需求大,仿真器可以在 GPU 上并行几千个环境,一天跑完真机数年的交互量。仿真带来的是“成本趋零 + 并行扩展 + 无风险试错”。
Q2 reality gap 是什么?主要来源有哪些?
答:reality gap 指仿真环境与真实环境之间的分布差异——仿真里 95% 成功率的策略搬到真机可能只有 30%。来源四类:物理建模误差(接触/摩擦近似)、传感器与渲染差异(相机、光照、噪点)、执行器差异(电机延迟、力矩死区、带宽)、环境不可控因素(地面摩擦、风、磨损)。
Q3 域随机化具体怎么做?要点是什么?
答:训练时把仿真参数当随机变量:视觉层面随机光照/纹理/相机噪声,物理层面随机质量/摩擦/阻尼/接触刚度,动力学层面随机电机力矩/延迟/关节噪声,任务层面随机初始状态/目标/障碍。要点:随机化范围要以真机标定为中心、逐步扩大,确保“罩住”真实分布;范围太大任务练不动,太小盖不住真机。
Q4 仿真器怎么选型?
答:看三点——速度、真实感、生态。大规模并行 RL 选 Isaac Gym/Isaac Lab(GPU 并行);要真实感渲染和多传感器仿真选 Isaac Sim;轻量科研和接触动力学选 MuJoCo;极速合成数据/世界模型选 Genesis;入门教学选 Webots。一句话:算力瓶颈选快的,保真度瓶颈选真的,剩下看社区生态。
Q5 遥操作有哪几种方式?各有什么优缺点?
答:三种。① 动捕(反光球+红外相机):精度高、可采全身动作,但设备贵、标定繁琐;② VR/手柄:直观易上手、可远程,但精度一般、大臂动作别扭;③ 示教夹具/主从示教:最贴近任务、精度高,但一次一台、速度慢、人手易疲劳。共同问题:贵、慢,需要重采样、去抖、retargeting 等后处理。
Q6 仿真 success rate 很高,为什么真机可能崩?
答:因为 success rate 是在仿真分布上统计的,而真机分布与它有 gap(reality gap)。仿真里忽略的延迟、摩擦、相机噪点、电机死区,真机上都会放大。所以工业界惯例:仿真 SR 只用来筛 checkpoint,最终以真机评估为准;并配合系统辨识 + 域随机化把差距缩小。
Q7 为什么有时“100 条真机数据比 100 万条仿真数据更值钱”?
答:区分“评估”与“训练”。评估环节真机数据不可替代(仿真测出的 95% 不代表真机 95%);训练环节仿真数据更划算(便宜、可并行)。100 万条仿真数据可能分布偏离真机,而 100 条真机数据能把模型“拉回正轨”(微调/校准)。正确姿势是混合:仿真扩规模,真机定上限。
Q8 proprioception + action 数据格式是什么?为什么 VLA 也用?
答:一条样本 =(观测 o_t,动作 a_t)。观测包含 proprioception(关节角、角速度、末端位姿、夹爪开合,即机器人“自己身体的状态”)+ 外部感知(图像/点云);动作是发给执行器的指令(目标关节角/角速度、夹爪命令)。VLA 沿用这套格式,只是把连续动作量化成离散 token 参与序列生成(详见 03 篇)。
小结与下一章预告
本篇小结:数据是机器人策略的“粮食”,而粮食有三个产地——
- 真实遥操作数据:动捕/VR/夹具录制,可信但贵少慢,决定水平上限;
- 仿真数据:域随机化批量生成,便宜可并行,决定训练规模;
- 互联网视频:海量但无动作标签,做预训练/世界模型开眼界。
让仿真策略搬到真机的三板斧:系统辨识(减差距)+ 域随机化(抗差距)+ 真机微调(收尾),配合 success rate 等多维评估与“仿真-真机”闭环迭代。追一句面试金句:仿真解决“量”,真机解决“准”,域随机化解决“仿真到真机的那道坎”。
下一章预告:前面 00–04 五篇的知识在这里收口——下一篇《05 具身智能面试八股与高频题》把旋转矩阵、齐次变换、雅可比、A*/RRT、PID/MPC、动作 token、VLA、数据/评估全部压成“公式速查表 + 高频追问 20 问”,考前 30 分钟直接背。