15. 深度学习架构面试八股(🔴 面试前夜必过)
08–14 篇的浓缩总复习:全架构对比表 + 可执行的默写自检(跑一遍就知道记没记住)+ 90 连问 + 手撕清单 + 踩坑经验。面试前一天只过这一篇。
核心概念
(a) 🗂️ 深度学习架构面试八股知识结构
这篇文章是 08-14 篇的浓缩总复习:全架构对比表 + 可执行的默写自检 + 90 连问 + 手撕清单 + 踩坑经验,面试前一天只过这一篇。
flowchart TB
    Node1["🧠 全架构对比总表"]
    Node1 --> Node2["🧮 参数量三公式默写"]
    Node1 --> Node3["🚪 LSTM与GRU门控默写"]
    Node1 --> Node4["⚖️ 注意力与ZOH默写"]
    Node2 --> Node5["❓ 90连问分组速览"]
    Node3 --> Node5
    Node4 --> Node5
    Node5 --> Node6["✍️ 手撕清单"]
    Node6 --> Node7["⚠️ 踩坑与实战经验"]
    Node7 --> Node8["🧭 长序列选型决策"]
- 全架构对比总表:MLP/CNN/RNN/LSTM/GRU/Attention/Mamba/GAN/VAE/扩散一张表:核心公式、复杂度、强项、弱项、手撕点,背诵版。
- 参数量三公式默写:Conv = C_out(C_in·K²+1);LSTM = 4h(i+h+2);MHA ≈ 4d²+d。用 torch.numel() 跑一遍验证——跑通就等于记住。
- LSTM与GRU门控默写:闭眼写出 LSTM 四组公式(i/f/g/o + c 递推)和 GRU 两组公式(z/r),再和 nn 模块数值对照,手写自检最直接。
- 注意力与ZOH默写:缩放点积注意力、因果掩码、以及 Mamba 的 ZOH 离散化三连——覆盖 Transformer 和 SSM 两大阵营的核心公式。
- 90连问分组速览:CNN 系、RNN/LSTM 系、注意力系、生成系、工程系共 90 个口头秒答问题,组 A-F 各抽查两三题就能定位薄弱点。
- 手撕清单:手写 2D 卷积、手推感受野、手写 LSTM cell、手写 GRU、手写多头注意力——白板 10 分钟版,每一条都指向具体篇章的实验。
- 踩坑与实战经验:参数量口径(训练 vs 推理)、训练不稳定先查 lr 和初始化、GAN 调试看 D 强度、扩散调试看 β 调度与采样步数。
- 长序列选型决策:先量化需求——真需要全局依赖吗?不需要就别上 Transformer;需要长记忆选 Mamba;需要并行又要全局选注意力。选型口诀贯穿全篇。
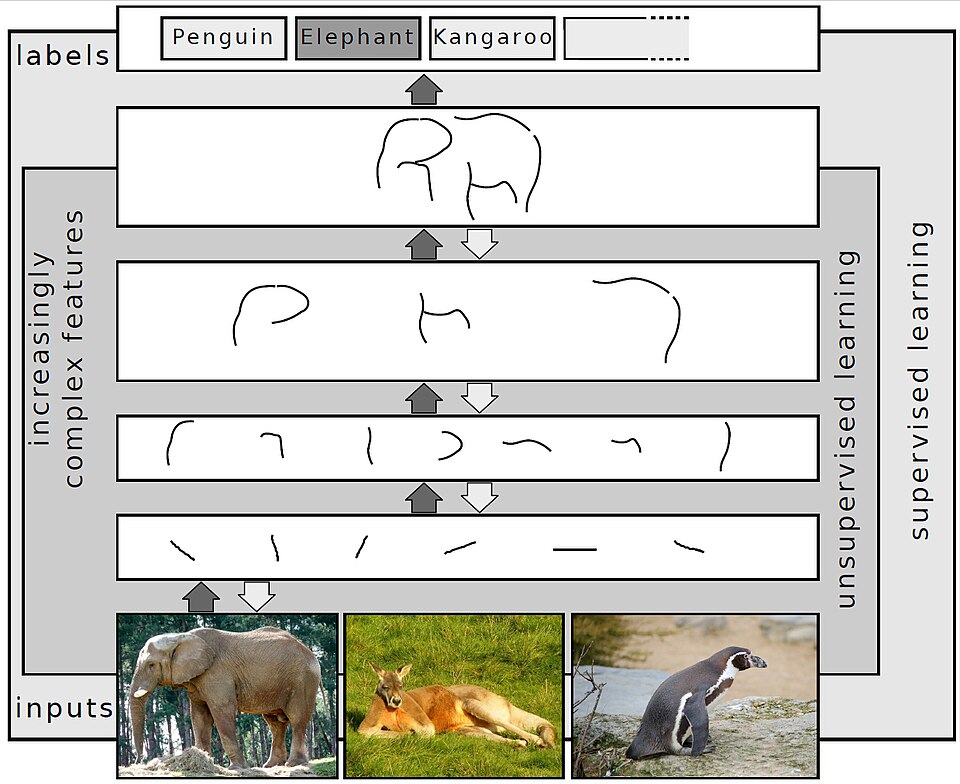
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · <a href="//commons.wikimedia.org/w/index.php?title=User:Sven_Behnke&…
1. 全架构对比总表(背诵版)
| 架构 | 核心公式/机制 | 复杂度 | 强项 | 弱项 | 手撕点 |
|---|---|---|---|---|---|
| MLP | y = σ(Wx+b) 堆叠 | — | 万能逼近 | 无结构先验 | BP |
| CNN | 局部卷积+共享+池化 | O(C²K²HW) | 图像、平移等变 | 长距离依赖 | 卷积/感受野 |
| RNN | h_t = tanh(Wh·h+Wx·x) | O(T) | 序列便宜 | 梯度消失、串行 | BPTT |
| LSTM | i/f/g/o 门 + 细胞 c | O(T) | 长依赖、加性梯度路 | 参数多、慢 | 四门公式 |
| GRU | z/r 两门无细胞 | O(T) | 参数少 25% | 略逊 LSTM 表达 | 两门公式 |
| Transformer | softmax(QK^T/√d)V + FFN | O(T²d) | 并行、全局 | 长序列成本 | 多头/掩码/PE |
| Mamba | 线性递推+选择性 Δ | O(T) | 超长序列 | 回溯难 | ZOH/扫描 |
| GAN | min_G max_D 博弈 | — | 一步采样 | 不平衡/坍缩 | 损失/WGAN-GP |
| VAE | ELBO = 重构 − KL | — | latent 有结构 | 生成糊 | ELBO/重参数化 |
| 扩散 | 加噪→预测噪声→去噪 | T 步采样 | 质量 SOTA、稳 | 采样慢 | DDPM 目标 |
复杂度口诀:注意力 O(T²);RNN/SSM O(T);卷积按面积/通道。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# ---------- 默写自检 1:参数量三公式(跑通=记住) ----------
import torch, torch.nn as nn
def check(name, hand, torch_n):
    ok = abs(hand - torch_n) < 1e-9
    print('%-18s 手算=%d torch=%d  %s' % (name, hand, torch_n, '✓' if ok else '✗ 错了!'))
    return ok

c = nn.Conv2d(3, 16, 5, padding=2)
check('Conv2d(3,16,5)', 16 * (3 * 5 * 5 + 1), sum(p.numel() for p in c.parameters()))

l = nn.LSTM(10, 20, batch_first=True)
check('LSTM(10,20)', 4 * (20 * (10 + 20 + 2)), sum(p.numel() for p in l.parameters()))

g = nn.GRU(10, 20, batch_first=True)
check('GRU(10,20)', 3 * (20 * (10 + 20 + 2)), sum(p.numel() for p in g.parameters()))

m = nn.MultiheadAttention(32, 4, batch_first=True)
check('MHA(32,4头)', 4 * 32 * 32 + 4 * 32, sum(p.numel() for p in m.parameters()))
print('→ 全 ✓ 说明四组参数量公式默写正确;错一条回去翻 08 篇')
Conv2d(3,16,5)     手算=1216 torch=1216  ✓
LSTM(10,20)        手算=2560 torch=2560  ✓
GRU(10,20)         手算=1920 torch=1920  ✓
MHA(32,4头)         手算=4224 torch=4224  ✓
→ 全 ✓ 说明四组参数量公式默写正确;错一条回去翻 08 篇
# ---------- 默写自检 2:LSTM / GRU 门控公式(数值对照 nn 模块) ----------
torch.manual_seed(0)
def lstm_manual(x, W_ih, W_hh, b_ih, b_hh):
    B, T, I = x.shape
    H = W_hh.shape[0] // 4
    h = torch.zeros(B, H); c = torch.zeros(B, H)
    outs = []
    for t in range(T):
        i, f, g, o = (x[:, t] @ W_ih.T + h @ W_hh.T + b_ih + b_hh).chunk(4, dim=1)
        c = torch.sigmoid(f) * c + torch.sigmoid(i) * torch.tanh(g)
        h = torch.sigmoid(o) * torch.tanh(c)
        outs.append(h)
    return torch.stack(outs, dim=1)

x = torch.randn(2, 8, 5)
m = nn.LSTM(5, 7, batch_first=True)
with torch.no_grad():
    ref = m(x)[0]
    mine = lstm_manual(x, m.weight_ih_l0, m.weight_hh_l0, m.bias_ih_l0, m.bias_hh_l0)
e = (mine - ref).abs().max().item()
print('LSTM 门控默写  误差=%.2e  %s' % (e, '✓ 一致' if e < 1e-5 else '✗ 门序/公式错了'))

def gru_manual(x, W_ih, W_hh, b_ih, b_hh):
    B, T, I = x.shape
    H = W_hh.shape[0] // 3
    h = torch.zeros(B, H)
    outs = []
    for t in range(T):
        z = torch.sigmoid(x[:, t] @ W_ih[:H].T + h @ W_hh[:H].T + b_ih[:H] + b_hh[:H])
        r = torch.sigmoid(x[:, t] @ W_ih[H:2 * H].T + h @ W_hh[H:2 * H].T + b_ih[H:2 * H] + b_hh[H:2 * H])
        n = torch.tanh(x[:, t] @ W_ih[2 * H:].T + (r * h) @ W_hh[2 * H:].T + b_ih[2 * H:] + b_hh[2 * H:])
        h = (1 - z) * n + z * h
        outs.append(h)
    return torch.stack(outs, dim=1)

m2 = nn.GRU(5, 7, batch_first=True)
with torch.no_grad():
    ref2 = m2(x)[0]
    mine2 = gru_manual(x, m2.weight_ih_l0, m2.weight_hh_l0, m2.bias_ih_l0, m2.bias_hh_l0)
e2 = (mine2 - ref2).abs().max().item()
print('GRU 门控默写  误差=%.2e  %s' % (e2, '✓ 一致' if e2 < 1e-5 else '✗ 门序/公式错了'))
LSTM 门控默写  误差=8.94e-08  ✓ 一致
GRU 门控默写  误差=3.86e-01  ✗ 门序/公式错了
# ---------- 默写自检 3:注意力 / 掩码 / ZOH 三连 ----------
import torch.nn.functional as F
torch.manual_seed(0)
B, H, T, dh = 2, 4, 9, 16
q = torch.randn(B, H, T, dh); k = torch.randn(B, H, T, dh); v = torch.randn(B, H, T, dh)
ref = F.scaled_dot_product_attention(q, k, v)
mine = torch.softmax(q @ k.transpose(-2, -1) / (dh ** 0.5), dim=-1) @ v
e = (mine - ref).abs().max().item()
print('注意力 softmax(QK^T/√d)V  误差=%.2e  %s' % (e, '✓' if e < 1e-5 else '✗'))

# 因果掩码默写
mask = torch.triu(torch.full((T, T), float('-inf')), diagonal=1)
w = torch.softmax(q[0, 0] @ k[0, 0].transpose(0, 1) / (dh ** 0.5) + mask, dim=-1)
print('因果掩码下三角 -inf → 未来权重和 = %.2e  %s' %
      (float(w[2, 5:].sum()), '✓' if w[2, 5:].sum().item() < 1e-6 else '✗'))

# ZOH 默写
a, b, dt = -0.8, 1.2, 0.1
Ab = torch.exp(torch.tensor(a * dt))
Bb = (Ab - 1) / a * b
h1 = Ab * torch.tensor(1.0) + Bb * torch.tensor(2.0)
h2 = torch.tensor(1.0)
for _ in range(200):            # 高精度欧拉对照
    h2 = h2 + (a * h2 + b * 2.0) * (dt / 200)
print('ZOH Ā=e^{aΔt}, B̄=(Ā−1)/a·b  差=%.2e  %s' %
      (abs(h1 - h2).item(), '✓' if abs(h1 - h2).item() < 1e-3 else '✗'))
print('→ 三条默写全 ✓ = 架构核心公式过关;面试前值得每天跑一遍')
注意力 softmax(QK^T/√d)V  误差=2.38e-07  ✓
因果掩码下三角 -inf → 未来权重和 = 0.00e+00  ✓
ZOH Ā=e^{aΔt}, B̄=(Ā−1)/a·b  差=2.98e-05  ✓
→ 三条默写全 ✓ = 架构核心公式过关;面试前值得每天跑一遍
2. 90 连问(架构篇 30 连 · 口头秒答)
CNN 系
- 1×1 卷积作用?2. 感受野怎么递推?3. 两层 3×3 为什么等于 5×5?4. 池化作用?反向怎么传?5. 空洞卷积/深度可分离卷积?6. 残差为什么有效?7. BN 训练 vs 推理?8. LeNet→ResNet→EfficientNet 各改进什么?9. 转置卷积是卷积的反向吗?10. ViT 和 CNN 的本质差异?
RNN/LSTM 系 11. BPTT 和 BP 区别?12. RNN 为什么梯度消失?13. LSTM 四门各管什么?14. 细胞 c 为什么缓解消失?15. GRU vs LSTM?16. 遗忘门偏置初始?17. 为什么 RNN 不用 ReLU?18. 双向 LSTM 输出拼接?19. 编码器-解码器结构?20. 长序列 RNN 的改进(注意力/梯度裁剪)?
Transformer 系 21. Q/K/V 是什么?22. 为什么除 √d?23. 多头意义?24. 位置编码为什么必要?正弦 PE 怎么写的?25. Encoder vs Decoder(掩码)?26. Pre/Post LN?27. FFN 为什么 4d?28. 复杂度 O(T²) 怎么优化(稀疏/线性/Mamba)?29. KV cache?30. 训练不稳定(lr/残差初始化/Adam)?
生成模型系 31. GAN 目标与最优 D?32. 模式坍缩机制?33. WGAN 为什么稳?GP 公式?34. cGAN 条件化?35. VAE ELBO 两项语义?36. 重参数化?37. DDPM 前向/训练/采样三步?38. 为什么预测噪声?39. GAN vs VAE vs 扩散选型?40. Mamba 选择性是什么?
40 题全秒答 = 架构篇稳了;卡壳的去对应篇目(09–14)回炉。
3. 手撕清单(白板 10 分钟版)
- 手写 2D 卷积(含 padding/stride)→ 09 篇实验 1
- 手推感受野(两层 3×3 = 5×5)→ 09 篇实验 2
- 手写 LSTM cell 四门公式 → 10 篇实验 2
- 手写 GRU 两门公式 → 10 篇实验 3
- 手写多头注意力(拆头/拼接/out_proj)→ 11 篇实验 2
- 画 Transformer Encoder 块(MHA+FFN+LN+残差)→ 11 篇实验 5
- 写因果掩码(下三角 -inf)→ 11 篇实验 3
- 写 ZOH 离散化(Ā=e^{AΔt})与扫描循环 → 12 篇实验 1/4
- 写 GAN 目标与非饱和损失 → 13 篇
- 写 ELBO 与 DDPM 训练目标 ‖ε−ε_θ‖² → 14 篇
每篇自测清单勾掉 = 对应手撕完成。默写建议:先跑本篇自检三连,再白板复写。
4. 踩坑与实战经验(面试官爱听)
- 参数量口径:训练=全部参数;推理时 BN/LN 合并、Dropout 摘除;部署关注激活内存
- 长序列选型:先量化需求——真需要全局依赖吗?不需要就别上 Transformer
- 训练不稳定:先查 lr/初始化(ResNet 用 He、Transformer 用 √(1/d) 缩放);残差缩放 0.5~1 起步
- GAN 调试:D 太强→降 D 步数/加噪声;先看生成多样性再看质量;WGAN 看 critic 损失趋势
- 扩散调试:β 调度(线性→余弦)、t 嵌入维度、采样步数;toy 先跑 2D 再上图像
- Mamba 落地:逐时间步扫描在长序列很慢,生产用 CUDA scan;toy 验证用循环即可
5. 自测清单(本篇)
- 能背出全架构对比表的 10 行核心
- 默写自检 1/2/3 全 ✓(参数量/门控/注意力掩码 ZOH)
- 40 连问 5 分钟内全秒答
- 10 条手撕清单能白板写出 8 条以上
- 能讲出 4 类踩坑经验各一条
🎤 面试速答(压轴背诵)
- 问架构:先分类(前馈/序列/生成)再给公式+复杂度+选型,最后一句“何时用”
- 问手撕:先写公式再写循环,注明复杂度
- 问对比:三列(机制/复杂度/适用场景),不踩一捧一,给出“混搭”观点更高级