🧬 07 · 进阶图结构:异构图、超图与动态图¶
真实世界的图很少是"单类型节点 + 单类型边"的简单图:电商里有用户/商品/店铺,论文引用里有作者/论文/会议, 一个课题组可以同时和多个方向"相关"。本节把 GNN 从同构图扩展到三大进阶结构: 异构图(多种节点/关系 + 元路径)、超图(一条超边圈住 ≥3 个节点)、动态图(随时间演化的边流), 并用 torch 手写 RGCN / HAN 简化版、HGNN 超图卷积、时间衰减编码。
前置:先学 00-01(图基础 + GCN 消息传递)。本节公式多、考点新,是秋招"图方向"的拉开差距题。
🎬 背景故事¶
你点开外卖 App:用户、商家、骑手、菜品——它们不是同一种东西,却连在同一张图上。
上一节我们学会的 GCN 假设所有节点是一种类型、所有边是一种关系。但真实业务图早就不这么单纯了: 电商里用户-商品-店铺是三种节点、"购买/收藏/属于"是三种关系;科研网络里作者-论文-会议三种节点、 "撰写/发表于"两种关系。强行把所有节点塞进同一套参数,等于让模型"用一把尺子量所有人"——这显然不对。
异构图的解法是:不同关系用不同矩阵建模(RGCN),或用元路径(Meta-Path)限定"从哪类节点、沿哪类边、走到哪类节点"的路径模板(HAN)。 更进一步的超图干脆打破"一条边只连两个点"的假设:一门课把 20 个学生圈在同一张"超边"里,一次聚合整组。 而动态图则回答最后一个问题:图不是静止的照片,是流动的河流——好友关系在变、交易在发生,时间信息怎么用进 GNN?
本节就是这三座"进阶关卡"的通关攻略。
🧭 本节逻辑主线:同构图的局限 → 异构图(类型感知:RGCN 关系矩阵 + 元路径)→ 超图(高阶交互:关联矩阵 + 超图卷积)→ 动态图(时间信息:快照 + 时间编码)→ 面试速答。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 同构图为什么不够用? | 真实图多类型节点/边 |
| 2 | 异构图怎么建模? | RGCN(每关系一个矩阵)+ 元路径 |
| 3 | 元路径是什么? | U-P-U / U-P-S-P-U 路径模板 |
| 4 | 超图和普通图差在哪? | 超边圈 ≥3 节点,关联矩阵 H |
| 5 | 超图怎么做消息传递? | HGNN:D⁻¹H W Hᵀ B⁻¹ X |
| 6 | 动态图怎么利用时间? | 快照序列 / 时间编码 ψ(Δt) |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import torch
import torch.nn as nn
import torch.nn.functional as F
rng = np.random.default_rng(42)
torch.manual_seed(42)
print('✅ 环境就绪:torch', torch.__version__)
1️⃣ 同构图的局限:一图开局(必背)¶
# 同构图 = 单类型节点 + 单类型边。看 GCN 的聚合:
#   H' = D̂⁻¹ᐟ² Â D̂⁻¹ᐟ² H W
# 问题 1:只用一个 W,无法区分"朋友"和"同事"这两种完全不同的关系;
# 问题 2:所有节点共享同一套特征空间,用户(id+年龄) 和 商品(价格+类目) 硬拼在一起不合理。
print('''同构 GCN 的两个假设(现实中经常不成立):
  1) 单一关系:所有边的含义相同 → 现实中朋友/同事/师生含义完全不同;
  2) 单一节点类型:所有节点特征同分布 → 现实中用户(离散id) 和商品(连续属性) 特征空间不同。
记忆点:信息在哪丢失?→ 不同类型节点/边被"平均"进同一套参数,等权混合丢失类型信息。
''')
2️⃣ 异构图:RGCN(关系感知消息传递)¶
📐 公式推导:RGCN 层¶
设关系集合 $\mathcal{R}$,节点 $i$ 在关系 $r$ 下的邻居为 $\mathcal{N}_i^r$,RGCN 每类关系一个矩阵:
$$ h_i^{(l+1)} = \sigma\Big( W_{\text{self}}^{(l)} h_i^{(l)} + \sum_{r \in \mathcal{R}} \sum_{j \in \mathcal{N}_i^r} \frac{1}{c_{i,r}} W_r^{(l)} h_j^{(l)} \Big) $$
- $W_r^{(l)}$:每个关系 $r$ 独立的变换矩阵(类型感知的核心);
- $c_{i,r} = |\mathcal{N}_i^r|$:归一化系数(也可以带度归一化);
- 参数量 $= |\mathcal{R}| \times d^2$:关系多时爆炸 → 基分解/对角分解降参。
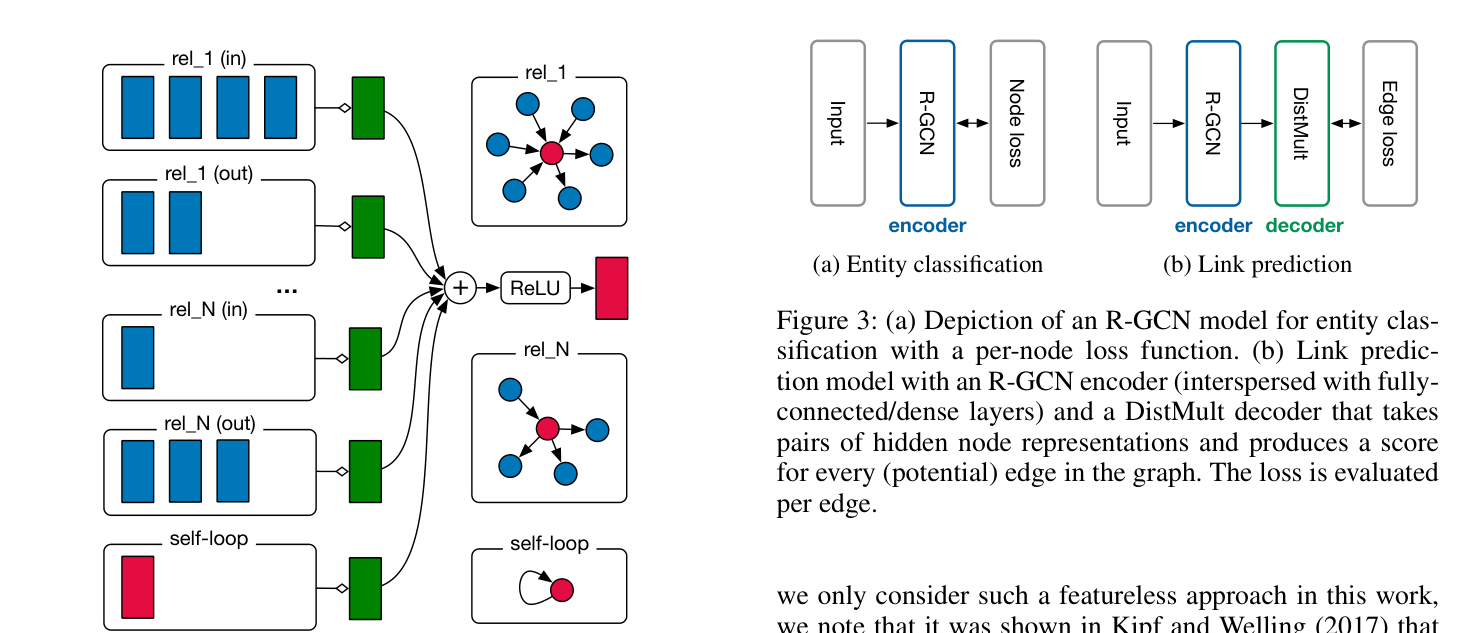
它与 GCN 的区别:GCN 把邻居"等权平均",RGCN 把邻居"按关系分成几路、各路独立变换再相加"。
📄 经典论文原图:R-GCN 关系感知节点更新
🔍 图解与逻辑衔接:图中不同颜色边代表不同关系类型。中心节点不会把所有邻居混成一团,而是先按关系分组,每类关系使用独立的变换矩阵 W_r 聚合,最后再加自环变换和求和。这张图正好回答“为什么同构 GCN 不够”:朋友、购买、属于等关系的语义不同,必须使用关系感知参数。下面的 RGCN 手写代码就是把图中的每种颜色边分别循环处理。
论文出处:Schlichtkrull et al., “Modeling Relational Data with Graph Convolutional Networks”, ESWC 2018(arXiv:1703.06103),Figure 2。
# 手写 RGCN 层:每关系一个 W_r,聚合时按关系分组
class RGCNLayer(nn.Module):
    def __init__(self, in_dim, out_dim, n_rel, self_loop=True):
        super().__init__()
        # 每类关系一个变换矩阵 + 可选自环
        self.W_rel = nn.ParameterList([nn.Parameter(torch.randn(in_dim, out_dim) * 0.15)
                                       for _ in range(n_rel)])
        self.has_self = self_loop
        if self_loop:
            self.W_self = nn.Parameter(torch.randn(in_dim, out_dim) * 0.15)
    def forward(self, H, adj_by_rel):
        # adj_by_rel: list of numpy 邻接矩阵(每关系一个,含方向)
        out = torch.zeros(H.shape[0], self.W_rel[0].shape[1])
        if self.has_self:
            out = out + H @ self.W_self
        for r, A in enumerate(adj_by_rel):
            deg = A.sum(axis=1, keepdims=True)
            deg[deg == 0] = 1                      # 防除零
            A_n = A / deg                           # 行归一化:平均该关系下的邻居
            At = torch.tensor(A_n, dtype=torch.float32)
            out = out + At @ H @ self.W_rel[r]      # 聚合 + 该关系变换
        return out

# 构造一个小异构图:2 类节点(用户u1,u2 / 商品p1,p2),2 种关系(r_buy 用户→商品, r_collect 用户→商品)
n_user, n_item, d = 2, 2, 3
X = torch.randn(n_user + n_item, d)
# 关系矩阵(只含跨类型的边方向)
A_buy = np.zeros((4, 4)); A_buy[0, 2] = 1; A_buy[1, 3] = 1      # u1→p1, u2→p2
A_col = np.zeros((4, 4)); A_col[0, 3] = 1; A_col[1, 2] = 1       # u1→p2, u2→p1
rgcn = RGCNLayer(d, 2, n_rel=2)
out = rgcn(X, [A_buy, A_col])
print('RGCN 输出形状:', tuple(out.shape))
assert out.shape == (4, 2)
print('✅ RGCN:不同关系用不同 W_r,类型信息不被平均稀释')
3️⃣ 元路径(Meta-Path):异构图里的"语义路径"¶
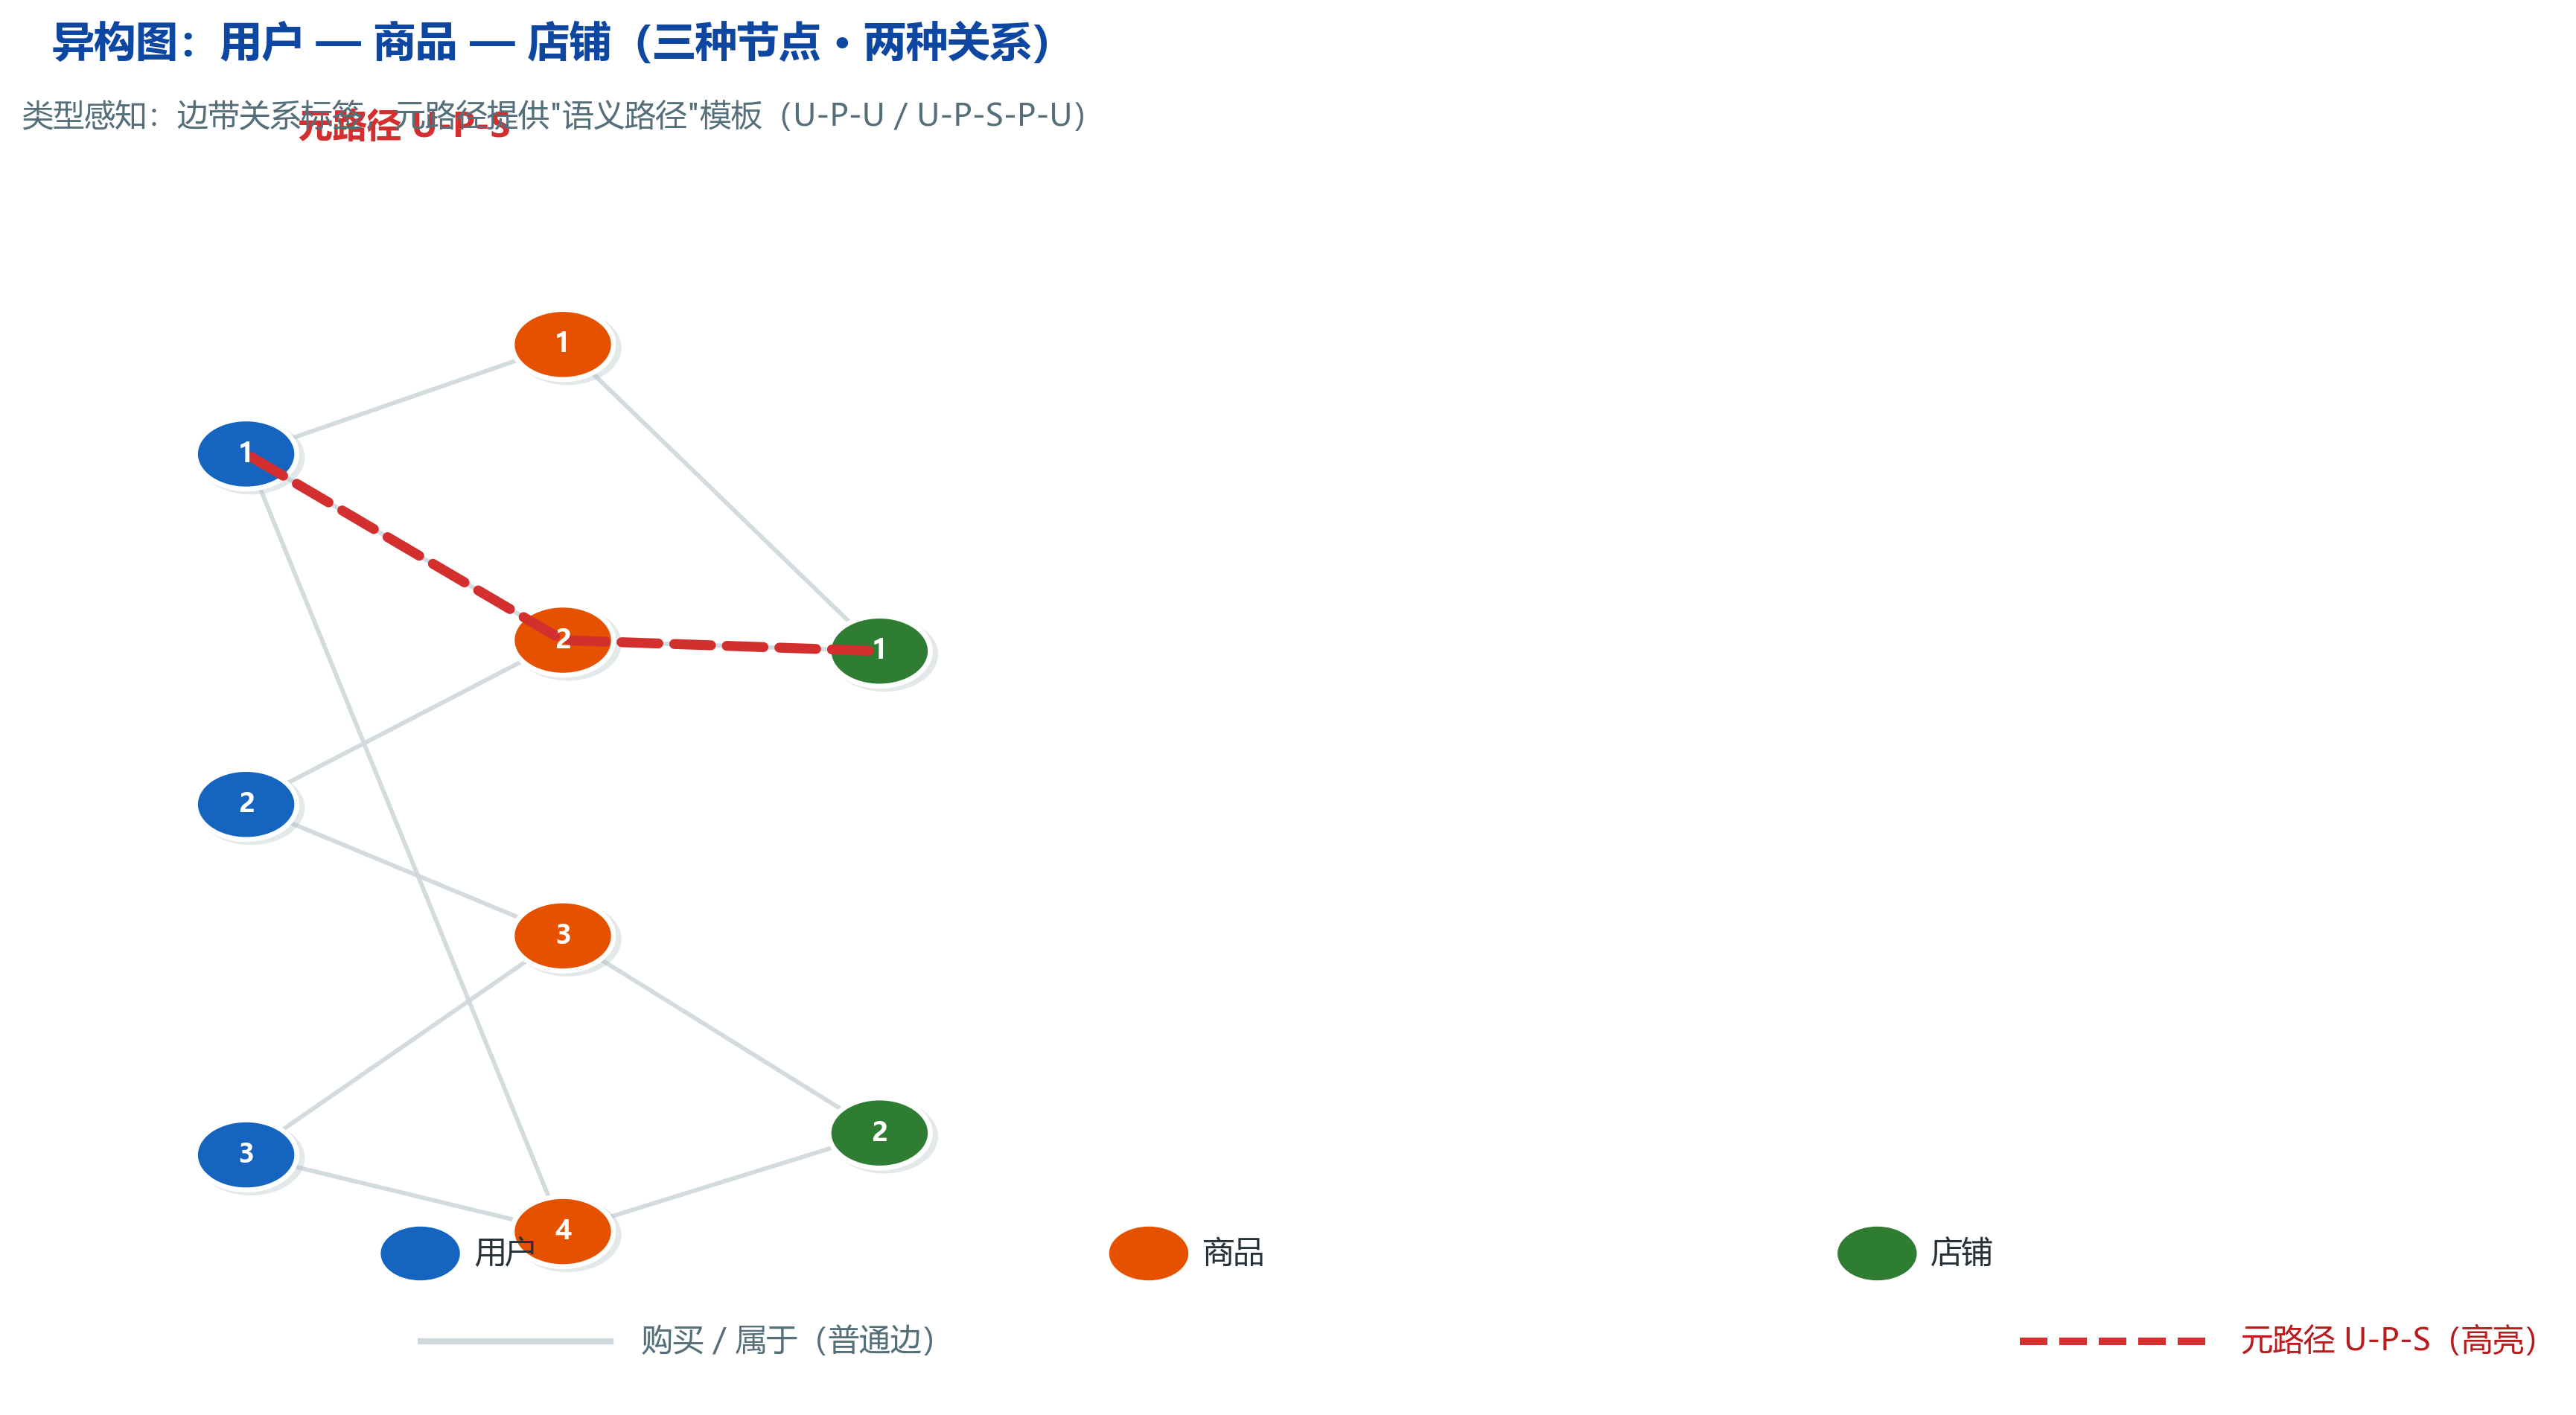
🔍 图解(自绘高清图,networkx 专业布局,300dpi):这张图画的是一个电商异构图——
- 三种节点(左→右三列):蓝色圆 = 用户 u1/u2/u3,橙色圆 = 商品 p1~p4,绿色圆 = 店铺 s1/s2;
- 两种关系(灰色边):用户→商品是"购买",商品→店铺是"属于"——每种边都带关系标签;
- 红色虚线 = 元路径 U-P-S:u1 →(购买) p2 →(属于) s1 是一条满足模板的具体路径实例;
- 关键理解:元路径不是"一条具体路径",而是路径模板——把所有"用户-商品-店铺"的 三段路径归为一类语义。同类元路径的路径实例可计数(U-P-U 共同购买的用户对)作为特征。
📐 公式推导:元路径与路径实例¶
元路径是连接两个节点的、交替"节点类型-关系类型-节点类型"的路径模板:
$$ \mathcal{P} = A_0 \xrightarrow{R_1} A_1 \xrightarrow{R_2} \cdots \xrightarrow{R_l} A_l $$
- 实例:满足模板的一条具体路径,如 $u_1 \xrightarrow{\text{buy}} p_2 \xrightarrow{\text{belong}} s_1$;
U-P-U(共同购买过同一商品的用户)、U-P-S-P-U(在同店铺消费过的用户)是电商推荐最常见的两条;- 用途一:游走模板——只在元路径上做随机游走,生成的序列语义同质(METAPATH2VEC);
- 用途二:语义邻居聚合——HAN 先按每条元路径算语义级注意力,再节点级注意力。
# 元路径实例计数:U-P-U 语义邻居
# 用 networkx 建一个小异构图(用户-商品-店铺),统计"共同购买过同一商品的用户"对
import networkx as nx
G = nx.Graph()
G.add_nodes_from(['u1', 'u2', 'u3'], type='user')
G.add_nodes_from(['p1', 'p2', 'p3'], type='item')
G.add_nodes_from(['s1', 's2'], type='shop')
G.add_edges_from([('u1', 'p1', {'rel': 'buy'}), ('u1', 'p2', {'rel': 'buy'}),
                  ('u2', 'p1', {'rel': 'buy'}), ('u2', 'p3', {'rel': 'buy'}),
                  ('u3', 'p2', {'rel': 'buy'}), ('u3', 'p3', {'rel': 'buy'}),
                  ('p1', 's1', {'rel': 'belong'}), ('p2', 's2', {'rel': 'belong'}), ('p3', 's2', {'rel': 'belong'})])

def meta_path_neighbors(G, start, path_rels):
    # path_rels: e.g. ['buy'] 表示 U --buy--> P --buy--> U
    # 找 start 经 buy 到商品、再经 buy 回到的其他用户
    items = [v for v in G[start] if G.nodes[v]['type'] == 'item']
    nbrs = set()
    for it in items:
        for v in G[it]:
            if v != start and G.nodes[v]['type'] == 'user':
                nbrs.add(v)
    return sorted(nbrs)

print('u1 的 U-P-U 语义邻居:', meta_path_neighbors(G, 'u1', ['buy']))
print('u3 的 U-P-U 语义邻居:', meta_path_neighbors(G, 'u3', ['buy']))
print('➡️ 元路径让"相似用户"有明确语义:共同买过同一商品,而不是笼统的图上距离')
4️⃣ 超图:一条边圈住一群人¶
📐 公式推导:关联矩阵与超图卷积(HGNN)¶
超图:超边 $e$ 可包含任意多个节点。用关联矩阵 $H \in \mathbb{R}^{|V| \times |E|}$ 表示: $H_{i,e} = 1$ 当且仅当节点 $i \in e$。定义超边度 $\delta(e)=\sum_i H_{i,e}$、节点度 $d(i)=\sum_e H_{i,e}$。
HGNN 超图卷积层(Feng et al., 2019):
$$ X^{(l+1)} = \sigma\big( D^{-1/2} H W_e B^{-1} H^{\top} D^{-1/2} X^{(l)} \Theta \big) $$
- $H^{\top} X$:把节点特征聚合到超边("这条超边里都有什么");
- $H(H^{\top} X)$:再广播回节点("这条超边传递回什么");
- $D$(节点度)、$B$(超边度)对角归一化 → 相当于"两跳"的组内平均。
直观对比:普通边的消息传递是"一对一邻居",超图是"先聚到组、再从组广播回每个成员"——一次捕获高阶集体交互(如一个班、一个课题组、一次团购)。
✍️ §4.1 手算超图卷积:一条超边圈住一群人,信息怎么聚起来¶
HGNN 层 $X'=\sigma(D_v^{-1}H D_e^{-1}H^\top X W)$——4 节点 2 超边手算($W=I$、无激活),把"节点→超边→节点"两级传播变成数字。
设定:超边 $e_1=\{v_1,v_2,v_3\}$、$e_2=\{v_3,v_4\}$,特征 $X=I$(one-hot)。
第 1 步:关联矩阵与度
$$H=\begin{bmatrix}1&0\\1&0\\1&1\\0&1\end{bmatrix},\quad D_v=\text{diag}(1,1,2,1),\quad D_e=\text{diag}(3,2)$$
第 2 步:节点 → 超边($D_e^{-1}H^\top X$)
$$e_1\text{ 聚合} =\frac{X_{v_1}+X_{v_2}+X_{v_3}}{3}=\left(\tfrac13,\tfrac13,\tfrac13,0\right),\quad e_2\text{ 聚合}=\frac{X_{v_3}+X_{v_4}}{2}=\left(0,0,\tfrac12,\tfrac12\right)$$
第 3 步:超边 → 节点($D_v^{-1}H(\cdot)$)
$$X_{v_1}'=\tfrac13 e_1\ 聚合=\left(\tfrac13,\tfrac13,\tfrac13,0\right),\qquad X_{v_4}'=e_2\ 聚合=\left(0,0,\tfrac12,\tfrac12\right)$$
$$X_{v_3}'=\tfrac12\left(e_1\ 聚合+e_2\ 聚合\right)=\left(\tfrac16,\tfrac16,\tfrac5{12},\tfrac14\right)$$
手算收获:
- 超边把"多个节点的组"当整体:$v_1,v_2$ 只属 $e_1$,特征完全变成 $e_1$ 组内平均;组内节点表示聚拢(本 notebook §4 可视化)
- $v_3$ 跨两个超边:两级传播后取两个组聚合的平均——跨组节点同时携带两组信息,这是普通图(只能两两连边)做不到的高阶交互
- 传播公式与 GCN 同构:$H D_e^{-1}H^\top$ 就是超图版的"归一化邻接"(对比 GCN 的 $\tilde{D}^{-1/2}\tilde{A}\tilde{D}^{-1/2}$),$D_v^{-1}$ 负责按节点度归一
- 超边 $e$ 的度在 $D_e$ 里体现:超边包含节点越多,每个贡献越"稀释"——所以 $v_3$ 在 $e_1$ 里的贡献只有 1/3
下面 numpy 复算。
# ---- §4.1 验证:numpy 复算超图卷积 ----
import numpy as np

H = np.array([[1, 0], [1, 0], [1, 1], [0, 1]], dtype=float)
dv = H.sum(axis=1)
de = H.sum(axis=0)
X = np.eye(4)
Dv_inv = np.diag(1 / dv)
De_inv = np.diag(1 / de)
Xp = Dv_inv @ H @ De_inv @ H.T @ X
print('X\' = Dv^-1 H De^-1 H^T X =')
print(np.round(Xp, 4))
assert np.allclose(Xp[0], [1/3, 1/3, 1/3, 0])
assert np.allclose(Xp[3], [0, 0, 1/2, 1/2])
assert np.allclose(Xp[2], [1/6, 1/6, 5/12, 1/4], atol=1e-9)
print('\n✓ 与手算一致:超边聚合 + 广播回节点')
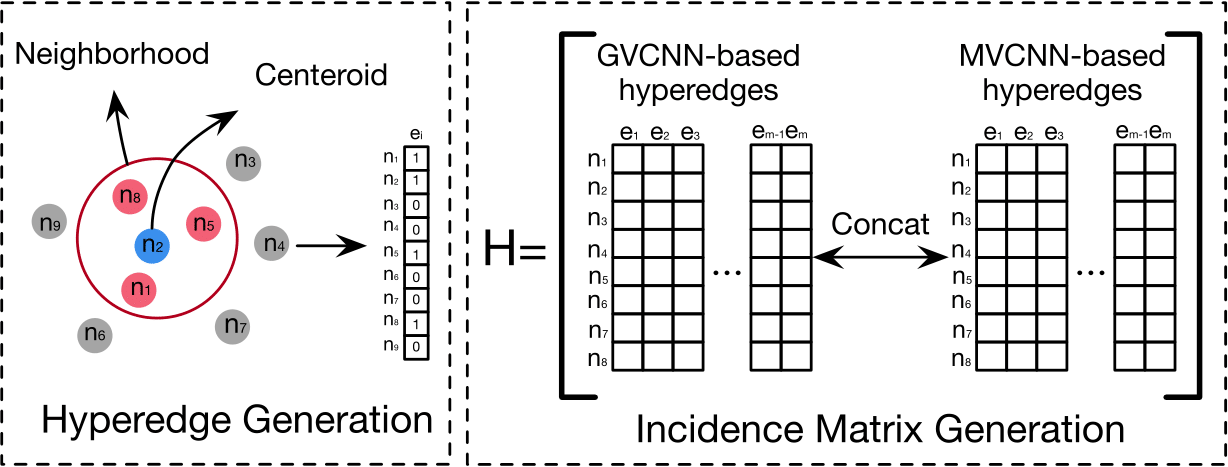
📄 经典论文原图:HGNN 超边构造
🔍 图解与逻辑衔接:图中从原始样本/特征出发,通过相似性或邻域规则把多个节点放进同一条超边。与普通边一次连接两个节点不同,超边直接表达一个局部群体或高阶事件。这一步解释了关联矩阵 H 的来源:节点属于某条超边就令 H(i,e)=1。理解“超边如何产生”,再看后面的 HᵀX 聚组和 H 广播回节点就会自然很多。
论文出处:Feng et al., “Hypergraph Neural Networks”, AAAI 2019(arXiv:1809.09401)。
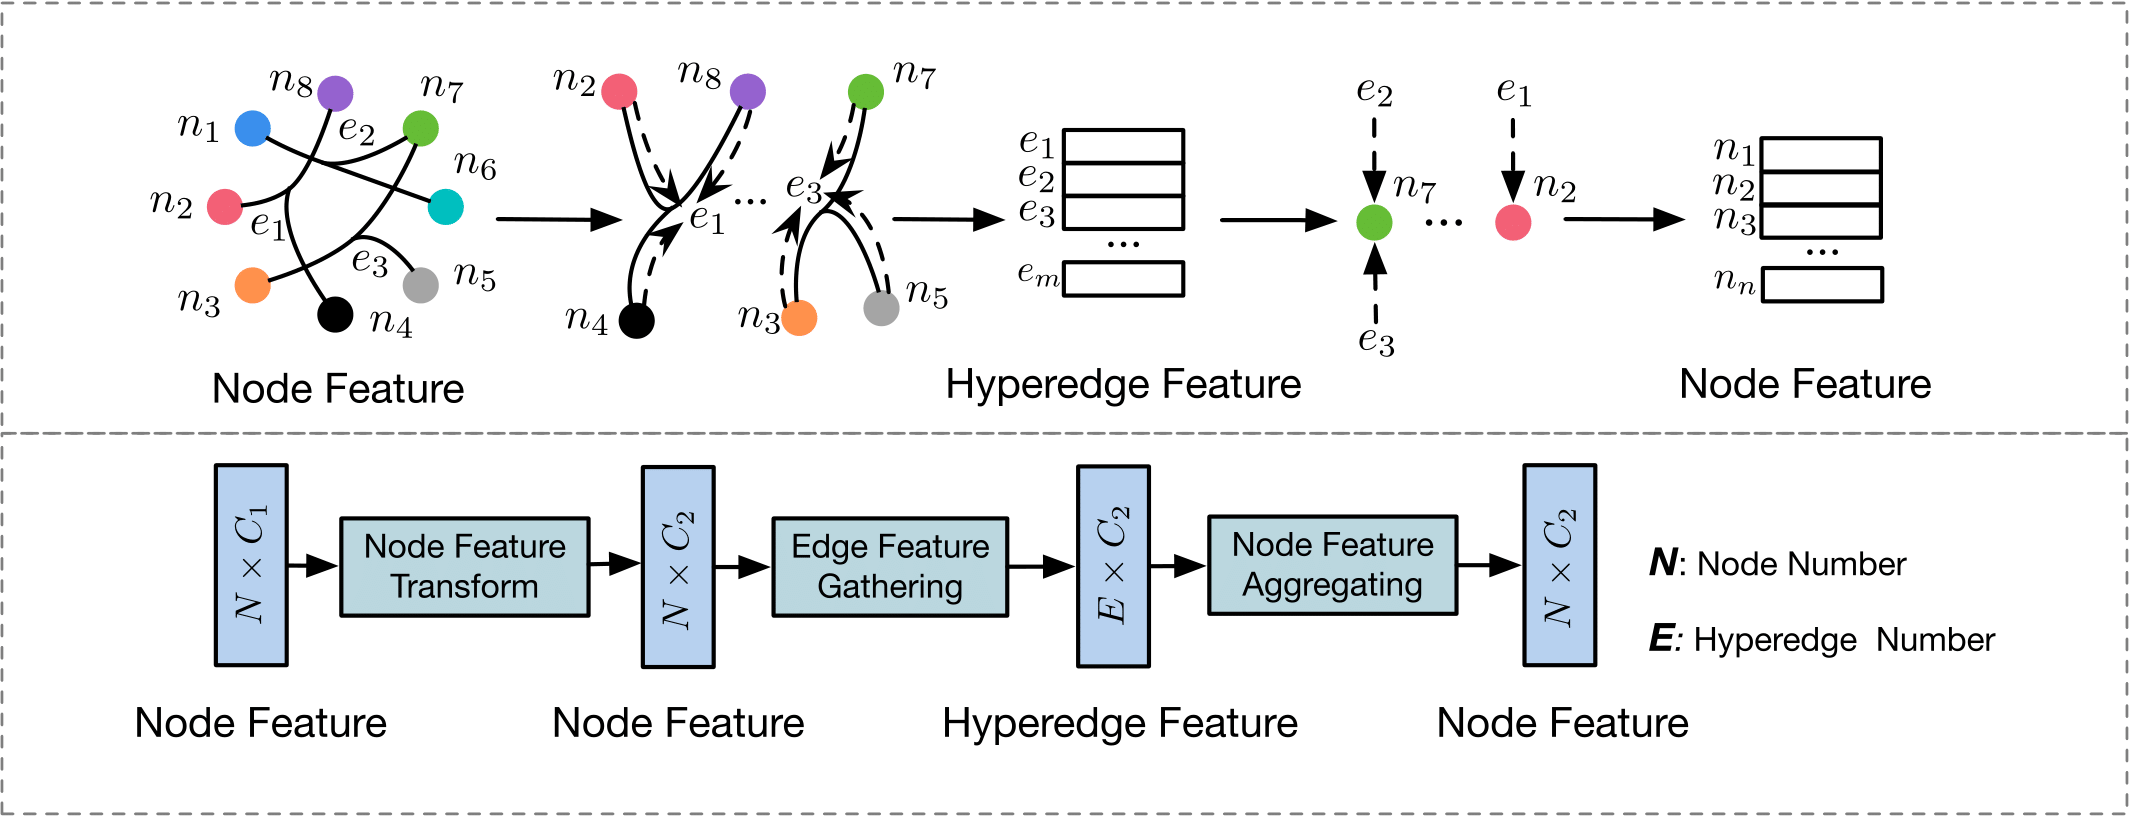
📄 经典论文原图:HGNN 超图卷积层
🔍 图解与逻辑衔接:图中节点特征先沿关联矩阵聚合到超边,再从超边广播回所有成员节点。中间的超边相当于一个“群体消息池”,把一次两两传播扩展成一次高阶集体交互。图中两步正对应公式中的 HᵀX 和 H(HᵀX);度归一化矩阵负责避免大超边因为成员多而天然占据过大权重。它与本节代码中的 Dv_inv_sqrt @ H @ De_inv @ H.T @ Dv_inv_sqrt 一一对应。
论文出处:Feng et al., HGNN, AAAI 2019(arXiv:1809.09401)。
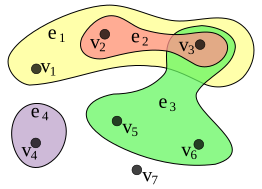
📌 权威配图:超图示意图(Wikimedia Commons,CC BY-SA 4.0)
图中每条超边(椭圆圈住的一组节点)可包含 3 个以上节点——这正是普通图办不到的"高阶交互"。 相比自绘示意图,这张权威图用标准超图记号(节点-超边二分视图)表达同一概念。
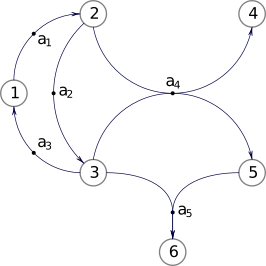
📌 权威配图②:有向超图示例(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:这张图标出了普通超图的有向版本——
- 入超边(in-hyperedge):多个尾节点汇聚指向一个头节点——表达"多对一"聚合 (多名作者 → 一篇论文、多个原料 → 一个产品);
- 出超边(out-hyperedge):一个头节点发散指向多个尾节点——表达"一对多"分发 (一篇论文 → 多名审稿人、一个事件 → 多个后果);
- 与无向超图的区别:无向超边只表示"一组人同属一个集体"(如 e1 圈住 v1,v2,v3), 有向超边额外带方向语义——谁指向谁,这在因果/流程建模里必不可少;
- 应用:生物通路(多个基因 → 一个产物)、供应链(多供应商 → 一个工厂)、事件因果链。
# 手写 HGNN 超图卷积:节点特征 → 超边 → 广播回节点
def hgnn_layer(X, H_inc, Theta, act=np.tanh):
    # X: (n, d) 节点特征;H_inc: (n, n_e) 关联矩阵
    # 论文公式:X' = D^-1/2 H W B^-1 H^T D^-1/2 X Θ
    n, n_e = H_inc.shape
    Dv = H_inc.sum(axis=1) + 1e-9          # 节点度 d(i)
    De = H_inc.sum(axis=0) + 1e-9          # 超边度 δ(e)
    Dv_inv_sqrt = np.diag(1.0 / np.sqrt(Dv))
    De_inv = np.diag(1.0 / De)
    # 超图拉普拉斯传播矩阵:D^-1/2 H B^-1 H^T D^-1/2
    Lh = Dv_inv_sqrt @ H_inc @ De_inv @ H_inc.T @ Dv_inv_sqrt
    Y = Lh @ X                              # (n, d) 组内平均后的特征
    return act(Y @ Theta)

# 构造超图:6 节点,2 条超边(e1={0,1,2}, e2={3,4,5}),节点特征 4 维
H_inc = np.zeros((6, 2))
H_inc[0:3, 0] = 1; H_inc[3:6, 1] = 1
X = rng.normal(0, 1, (6, 4))
Theta = rng.normal(0, 0.2, (4, 2))
out = hgnn_layer(X, H_inc, Theta)
print('HGNN 输出形状:', out.shape)
# 组内同质化验证:e1 组内节点输出应比跨组更接近
g1 = out[:3]; g2 = out[3:]
print('组内平均距离: %.3f  跨组平均距离: %.3f' % (np.mean(np.linalg.norm(g1 - g1.mean(0))), np.linalg.norm(g1.mean(0) - g2.mean(0))))
assert out.shape == (6, 2)
print('✅ 超图卷积:H^T 聚到组、H 广播回成员,高阶交互一次建模')
# ===== 可视化:超图关联矩阵 H 与"聚到组-广播回组"传播 =====
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse, Circle
H_inc_viz = np.zeros((6, 2))
H_inc_viz[0:3, 0] = 1; H_inc_viz[3:6, 1] = 1
fig, axes = plt.subplots(1, 2, figsize=(10.5, 4.2), dpi=200)
# 左:关联矩阵热力图
im = axes[0].imshow(H_inc_viz, cmap='Blues', aspect='auto')
axes[0].set_xticks([0, 1]); axes[0].set_xticklabels(['超边 e1', '超边 e2'])
axes[0].set_yticks(range(6)); axes[0].set_yticklabels(['v%d' % (i+1) for i in range(6)])
axes[0].set_title('关联矩阵 H (6×2)\nH[i,j]=1 ↔ 节点 i 在超边 j 中', fontsize=10)
for i in range(6):
    for j in range(2):
        axes[0].text(j, i, '1' if H_inc_viz[i, j] else '0', ha='center', va='center',
                     color='#B71C1C' if H_inc_viz[i, j] else '#888')
fig.colorbar(im, ax=axes[0], shrink=0.8)
# 右:传播路径图(节点→超边→节点)
axes[1].axis('off')
for i in range(6):
    axes[1].plot([1, 0], [i, 0.2 + (0.4 if i < 3 else 0)], '--', color='#90A4AE', lw=1)
    axes[1].add_patch(Circle((1, i), 0.22, fc='#BBDEFB', ec='#1565C0', lw=1.2))
    axes[1].text(1, i, 'v%d' % (i + 1), ha='center', va='center', fontsize=8, color='#0D47A1')
axes[1].add_patch(Ellipse((3.2, 0.9), 2.2, 1.8, fc='#C8E6C9', ec='#1B5E20', lw=1.4, alpha=0.4))
axes[1].add_patch(Ellipse((3.2, -0.4), 2.2, 1.8, fc='#FFE0B2', ec='#E65100', lw=1.4, alpha=0.4))
for j, (yy, lbl) in enumerate([(0.9, 'e1'), (-0.4, 'e2')]):
    axes[1].text(3.2, yy, lbl, ha='center', va='center', fontsize=10, color='#1B5E20' if j == 0 else '#E65100', fontweight='bold')
axes[1].plot([2.2, 2.7], [0.6, 0.9], color='#1565C0', lw=1.6, marker='o', ms=4)
axes[1].text(2.55, 1.15, 'HᵀX', fontsize=8, color='#1565C0', ha='center')
axes[1].plot([3.7, 4.2], [0.9, 0.6], color='#C62828', lw=1.6, marker='o', ms=4)
axes[1].text(4.0, 1.15, '广播', fontsize=8, color='#C62828', ha='center')
axes[1].text(1, 1.35, '节点', fontsize=9, color='#37474F', ha='center')
axes[1].text(3.2, 1.6, '超边(组)', fontsize=9, color='#37474F', ha='center')
axes[1].set_title('HGNN 传播:HᵀX 聚到组 → H 广播回节点', fontsize=10)
axes[1].set_xlim(-0.4, 5); axes[1].set_ylim(-1.6, 1.9)
plt.tight_layout(); plt.show()
# ===== 可视化:HGNN 一层后,组内节点表示聚拢(高阶交互捕获) =====
X2 = rng.normal(0, 1, (6, 4))
Theta2 = rng.normal(0, 0.2, (4, 2))
out2 = hgnn_layer(X2, H_inc, Theta2)
fig, ax = plt.subplots(figsize=(6.4, 5.4), dpi=200)
colors = ['#1565C0'] * 3 + ['#E65100'] * 3       # e1 组蓝 / e2 组橙
ax.scatter(out2[:, 0], out2[:, 1], c=colors, s=160, alpha=0.85, edgecolors='white', linewidths=1.4)
for i, (x, y) in enumerate(out2):
    ax.text(x + 0.06, y + 0.06, 'v%d' % (i + 1), fontsize=9, color='#333')
# 组中心
for ci, idxs in [('#1565C0', [0, 1, 2]), ('#E65100', [3, 4, 5])]:
    cx, cy = out2[idxs].mean(axis=0)
    ax.add_patch(Circle((cx, cy), 0.18, fc=ci, ec='none', alpha=0.35))
    ax.text(cx, cy - 0.32, '组中心', fontsize=8, ha='center', color=ci)
ax.set_title('HGNN 一层后:超边 e1/e2 内节点表示聚拢\n(组间距离 > 组内距离)', fontsize=10.5)
ax.set_xlabel('输出维度 1'); ax.set_ylabel('输出维度 2')
ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
print('✅ 超图卷积令同超边内的节点表示更接近(高阶集体信息被捕获)')
5️⃣ 超图 vs 普通图:可视化对比¶
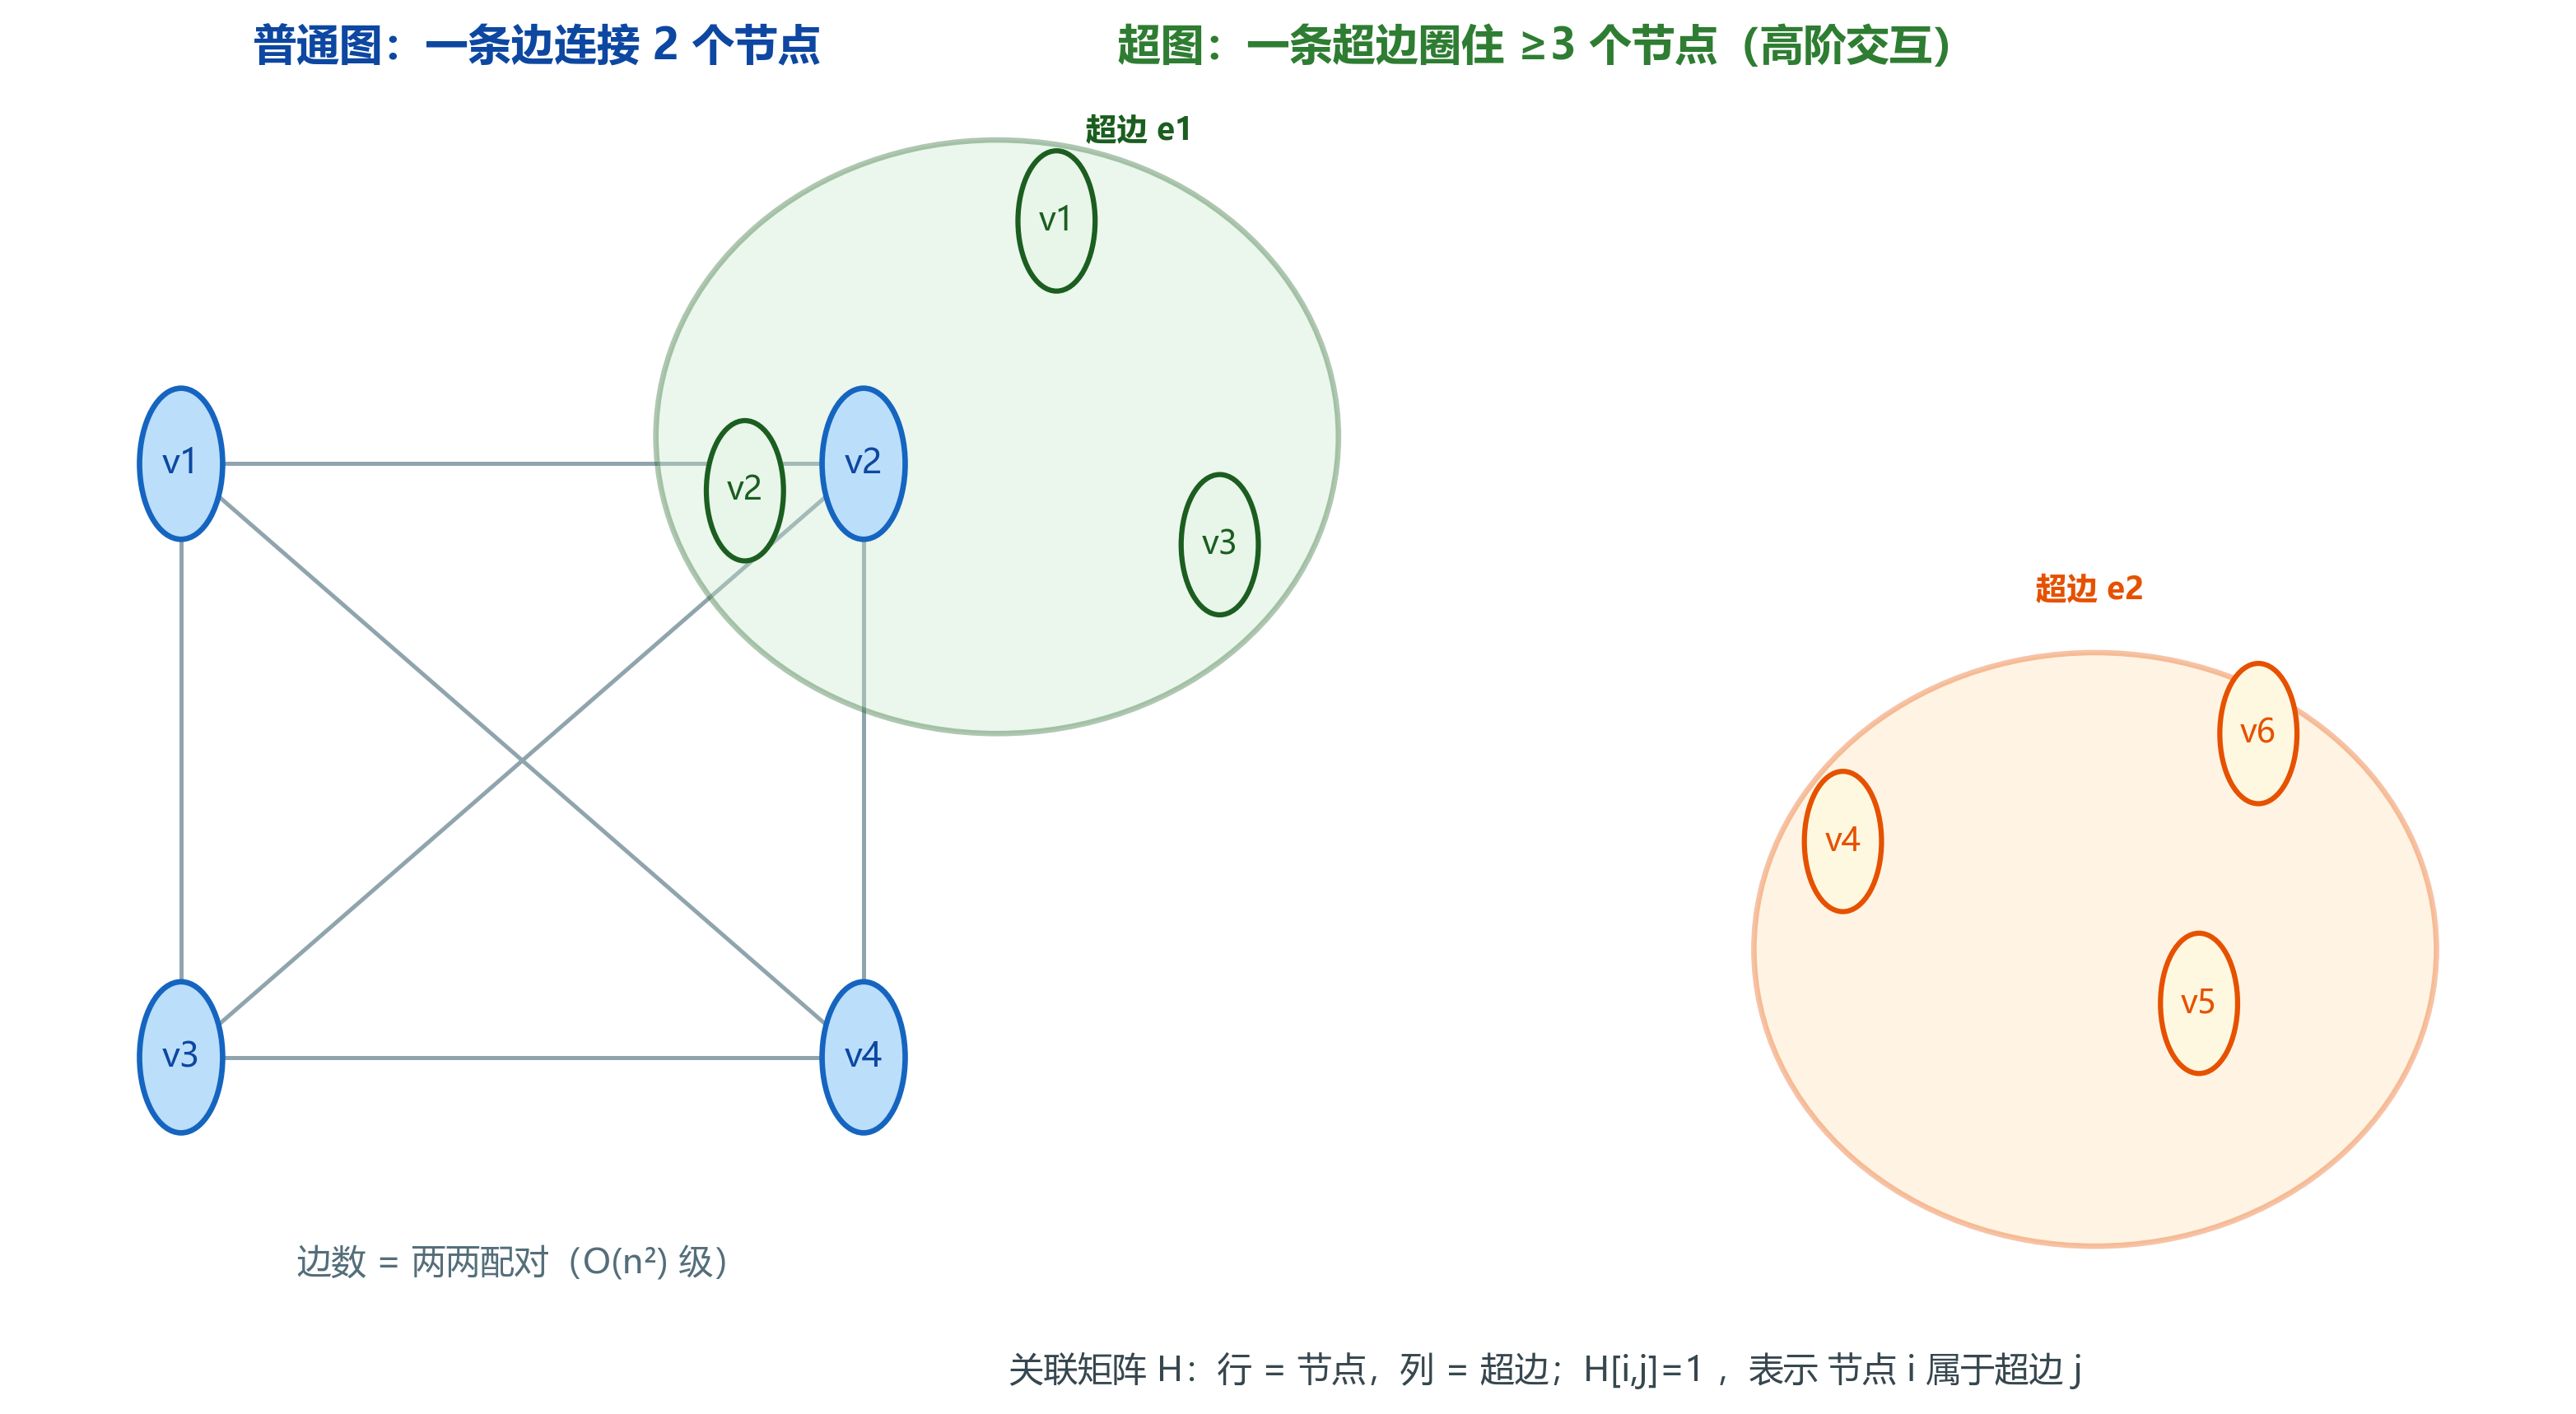
🔍 图解(自绘高清图,300dpi):左右对照是最直观的高阶交互对比——
- 左(普通图):4 个节点 v1~v4,每两个节点之间一条边(共 6 条边)——"一条边只连接 2 个点"; 边数随节点数平方增长(O(n²) 级),关系是一对一明确的;
- 右(超图):绿色椭圆 超边 e1 圈住 v1/v2/v3,橙色椭圆 超边 e2 圈住 v4/v5/v6—— 一条超边可以圈住 ≥3 个节点,表达"一组人同属一个集体"的高阶关系;
- 表示差异:普通图用邻接矩阵(n×n),超图用关联矩阵 H(n × 超边数), H[i,j]=1 表示节点 i 属于超边 j——这是代码里手写 HGNN 的输入格式。
什么时候用超图?节点天然分组的场景(课程-学生、论文-作者、共享 Session); 什么时候普通图够用?关系是两两明确的(好友、交易)。
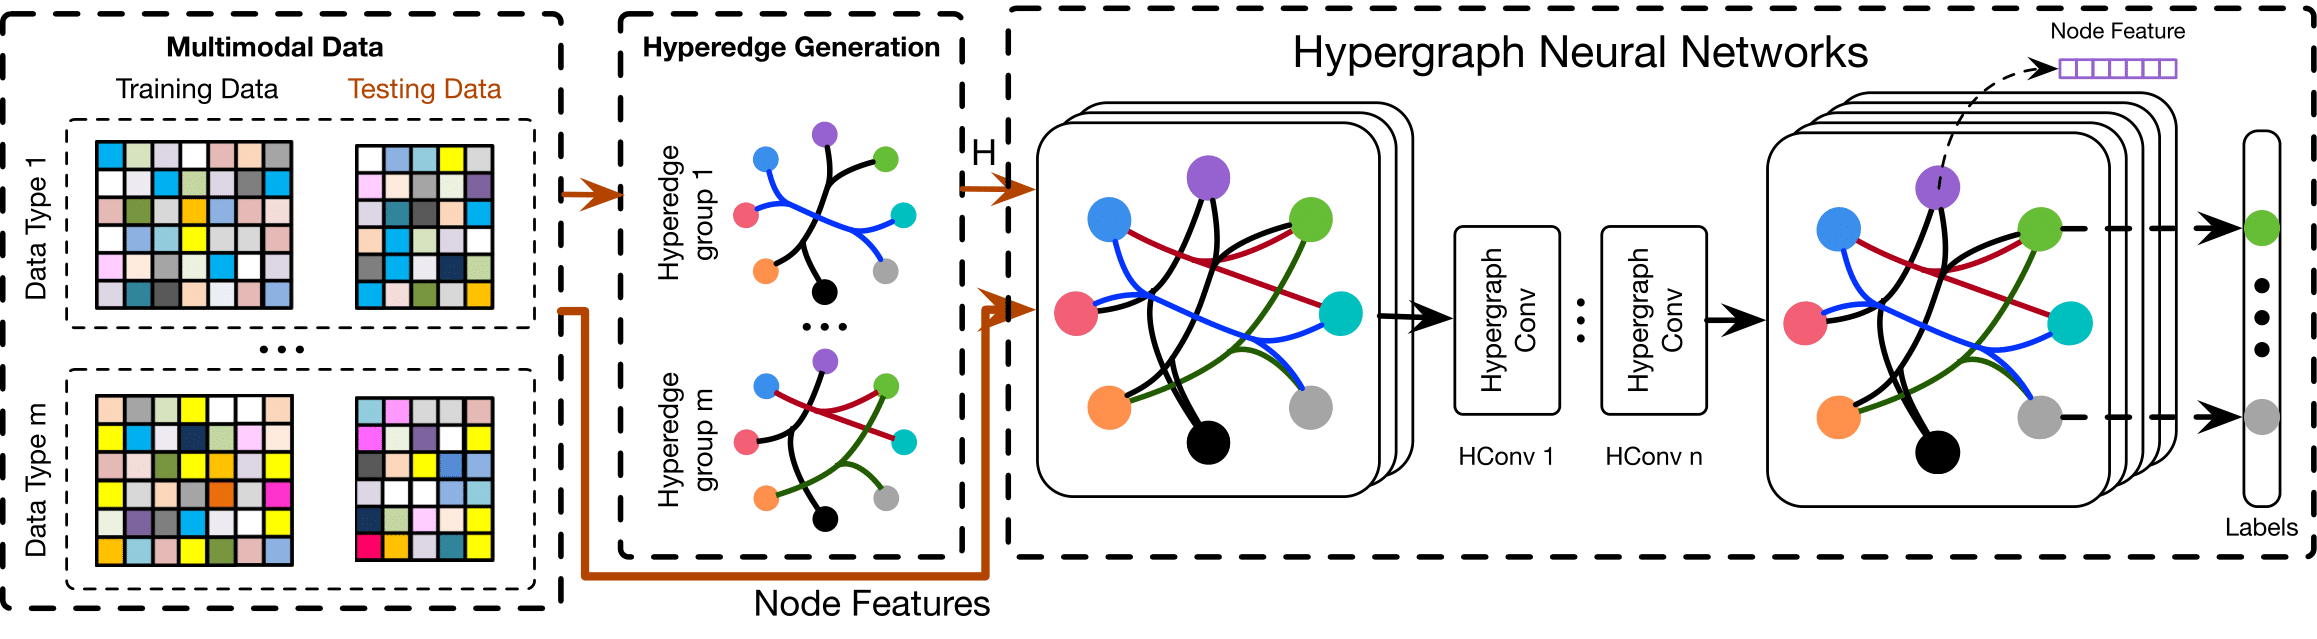
📄 经典论文原图:HGNN 整体流程
🔍 图解与逻辑衔接:图从输入特征开始,先构建超图,再堆叠超图卷积层,最后接分类/预测头。它把“数据如何变成超边”和“超边如何参与神经网络传播”放在同一条流水线上。这张总图适合在阅读公式和代码之后回看:前半段对应超边构造,网络主体对应 HGNN 层,末端对应下游任务。这样可以把局部公式放回完整模型,而不是只记住一个传播矩阵。
论文出处:Feng et al., HGNN, AAAI 2019(arXiv:1809.09401)。
# 用 networkx 实现一个"超图退化"实验:把超边展开成两两边(clique),看开销
import networkx as nx
n_nodes = 50
# 10 条超边,每条随机圈 8 个节点
rng2 = np.random.default_rng(1)
hyperedges = [rng2.choice(n_nodes, 8, replace=False) for _ in range(10)]
# 超图表示:1 次
print('超图表示:10 条超边(每边 8 节点)→ 关联矩阵 50×10')
# 展开成普通图:每条超边内的节点两两连边
edge_count = 0
for e in hyperedges:
    edge_count += len(e) * (len(e) - 1) // 2
print('展开成普通图:%d 条两两连边(信息冗余 %d/%d=%.1f%%)' % (
    edge_count, edge_count - len(hyperedges), edge_count, (edge_count - len(hyperedges)) / edge_count * 100))
print('➡️ 高阶关系强行拆成两两配对会带来大量冗余边+信息稀释 → 超图是更紧凑的表示')
6️⃣ 动态图:时间信息怎么用进 GNN¶
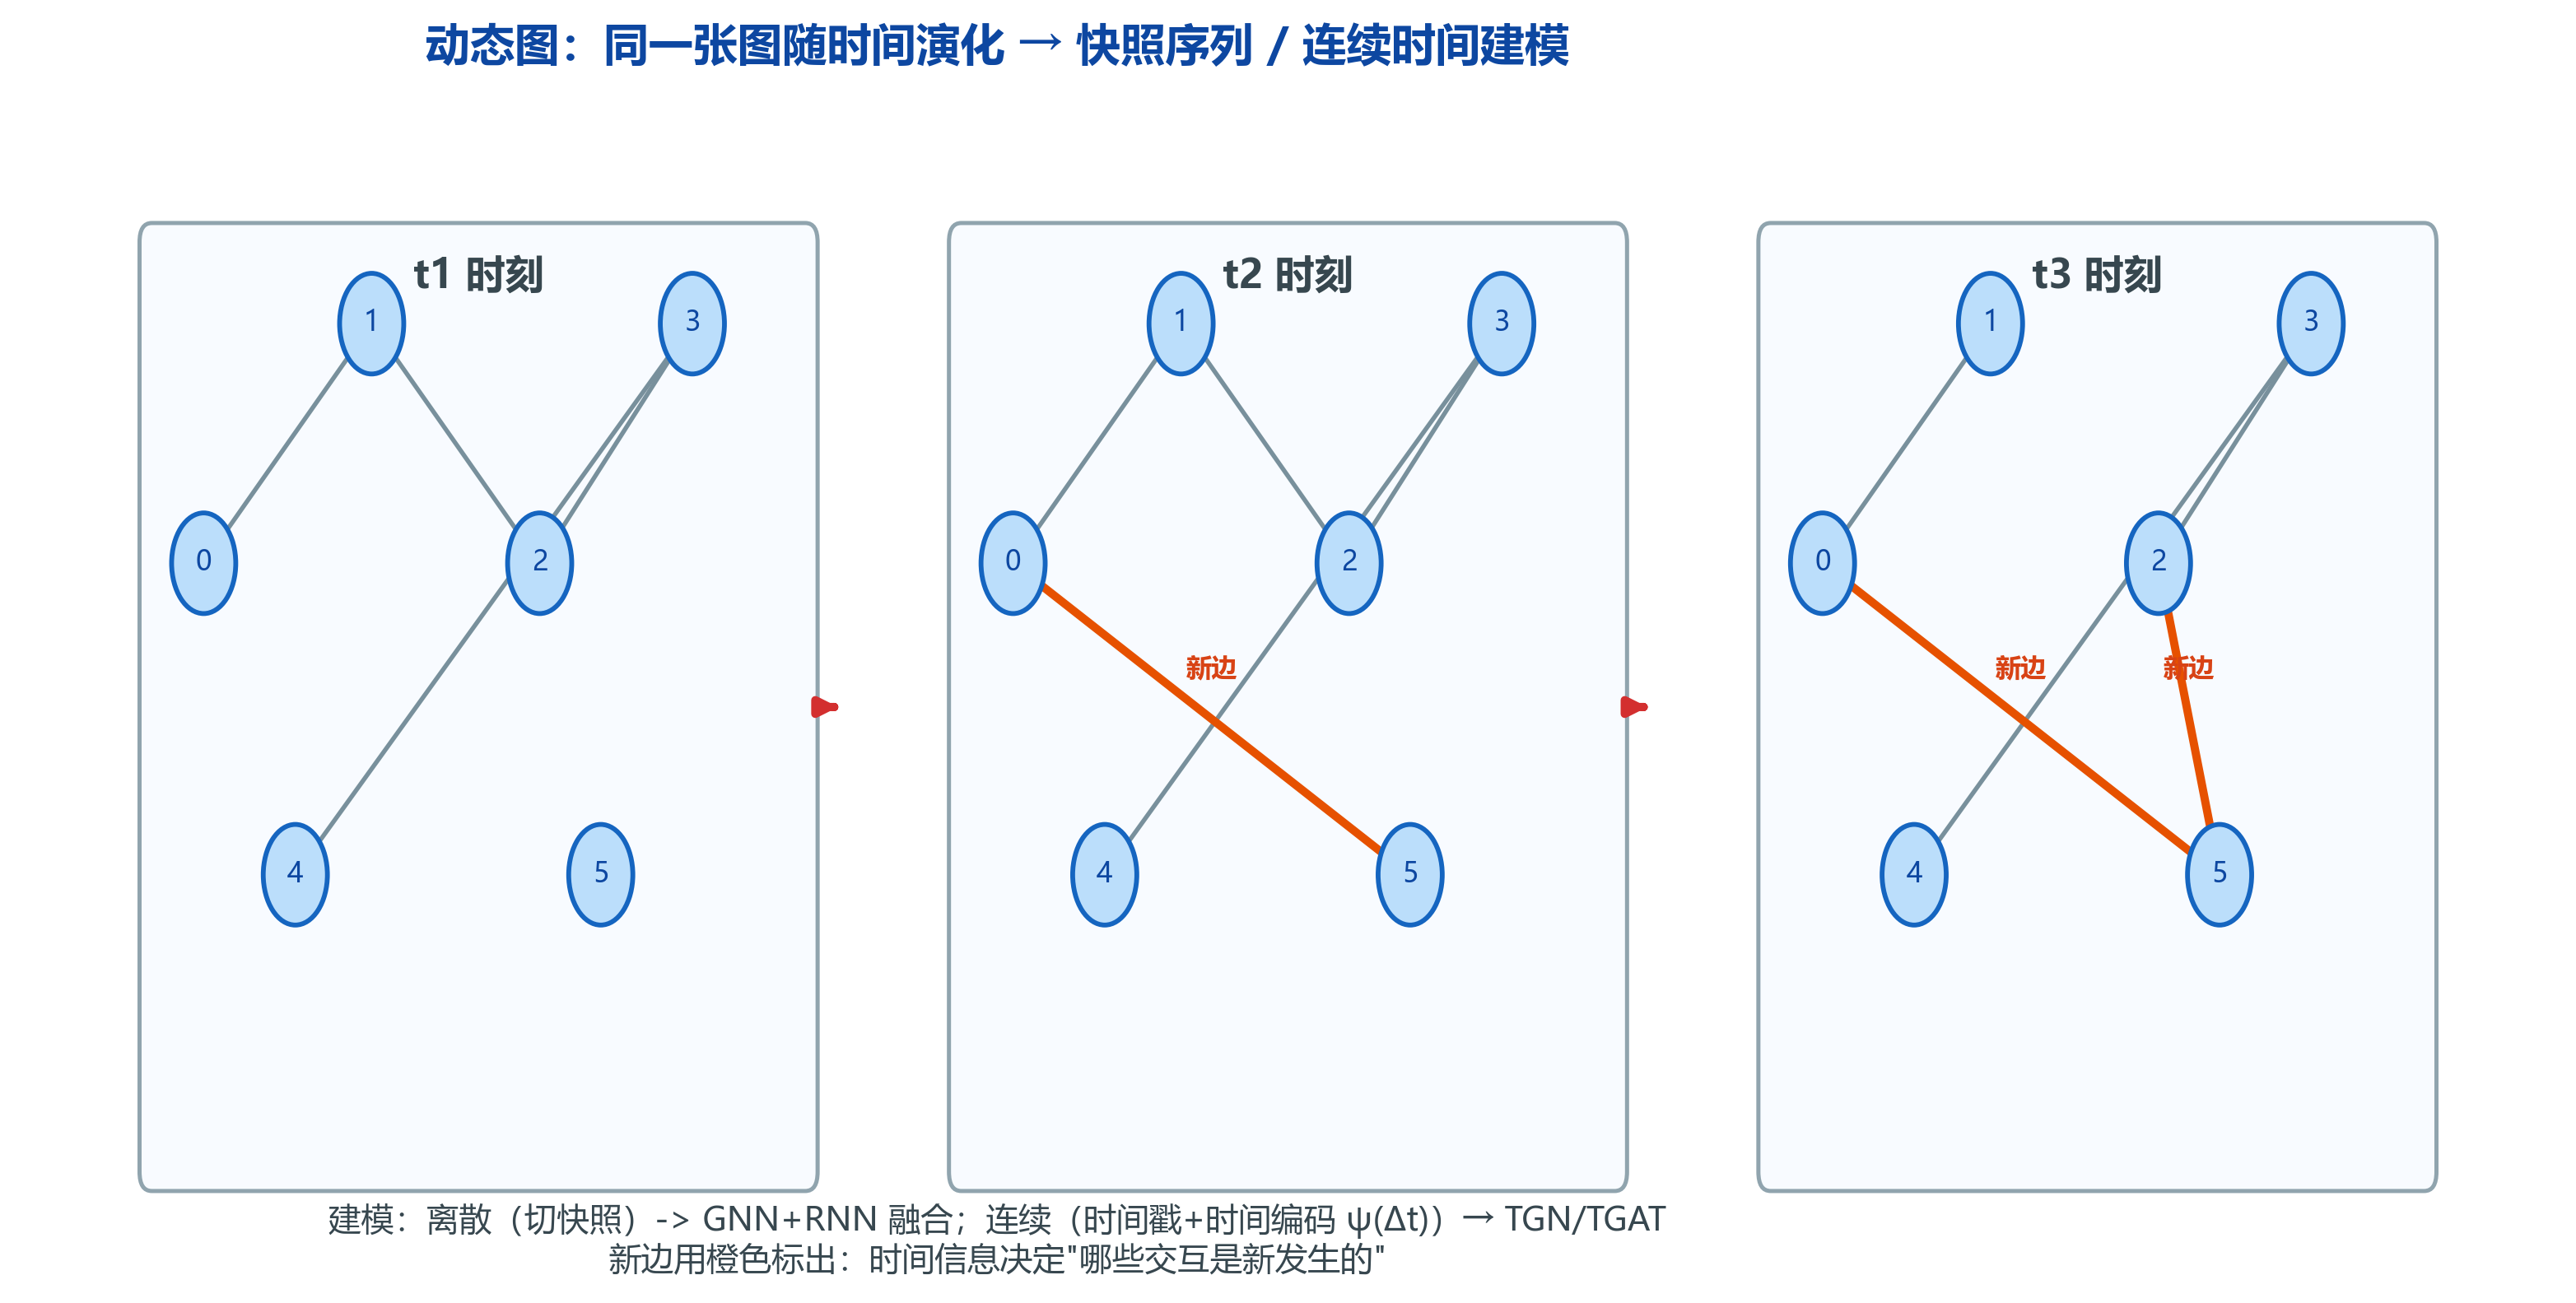
🔍 图解(自绘高清图,300dpi):三个快照 t1→t2→t3 展示同一张图如何随时间演化——
- 三帧快照(左→右):t1 有边 0-1、1-2、2-3、3-4(基础结构);t2 新增边 0-5(橙色); t3 再新增边 2-5——网络在持续生长;
- 橙色高亮 = 新边:这正是动态图与静态图的本质区别——边不是固定的,是按时间戳到达的事件流;
- 为什么时间重要:如果忽略时间,把 t1 和 t3 的图等权看待,模型会误以为"5 号节点从一开始就在社交圈里"; 显式建模时间(快照序列 / 时间编码 ψ(Δt) / TGN memory)才能回答"谁是新来的、谁的交互最近"。
📐 公式推导:时间编码与时间衰减¶
动态图的两种主流建模:
- 离散时间(快照):按时间窗口切成快照序列 $G_{t_1}, G_{t_2}, \dots$,对每个快照跑 GNN,再用 RNN/拼接融合;
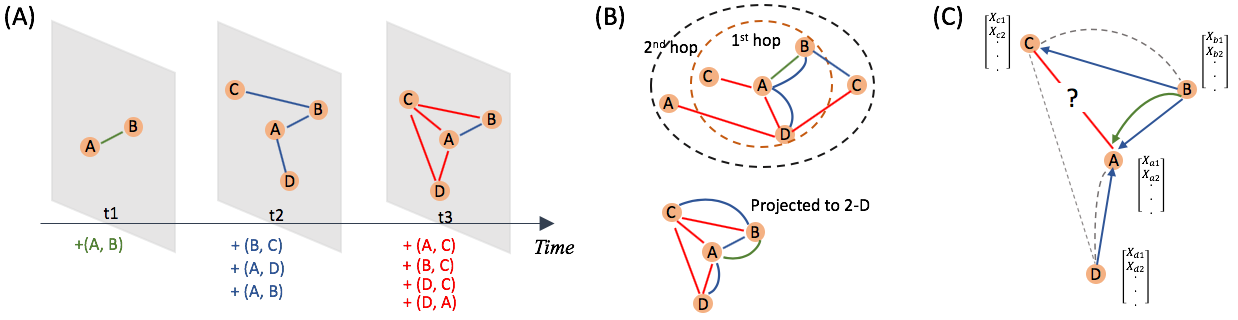
- 连续时间:每条边带时间戳 $(u,v,t)$,用时间编码把"距离现在多久"编码进特征:
$$ \psi(\Delta t) = \big[ \cos(\omega_1 \Delta t), \sin(\omega_1 \Delta t), \dots, \cos(\omega_d \Delta t), \sin(\omega_d \Delta t) \big] $$
时间衰减(可选):消息权重 $\propto \exp(-\beta \Delta t)$——越近的交互越重要。
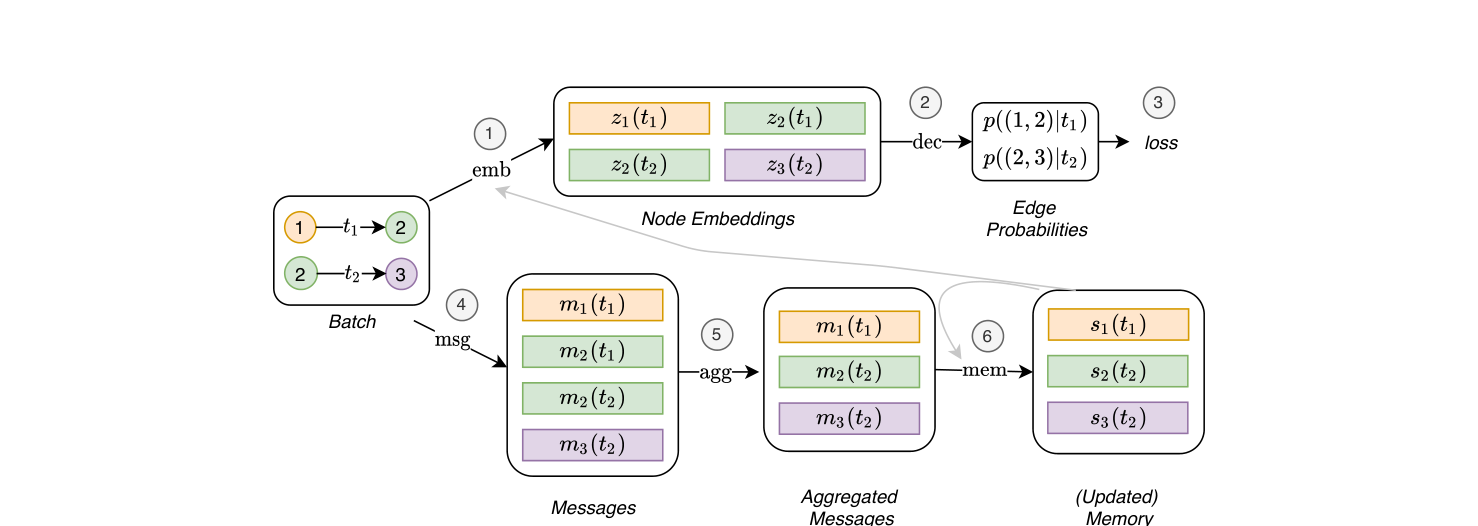
TGN / TGAT 是连续时间代表作:TGN 给每个节点维护一个 memory(内存状态),来一条边就更新一次;TGAT 用时间编码 + 注意力对"邻居在该时刻的表示"加权。
📄 经典论文原图:TGAT 时间编码
🔍 图解与逻辑衔接:图中用多组不同频率的余弦/正弦基函数表示时间间隔 Δt。低频分量变化慢,提供长期时间趋势;高频分量变化快,区分相近时间点。这解释了为什么 TGAT 不直接把时间戳当一个普通标量:周期基展开能同时表达粗粒度和细粒度时间差。下面的 time_encoding 函数就是这一思想的简化实现。
论文出处:Xu et al., “Inductive Representation Learning on Temporal Graphs”, ICLR 2020(arXiv:2002.07962),Figure 1。
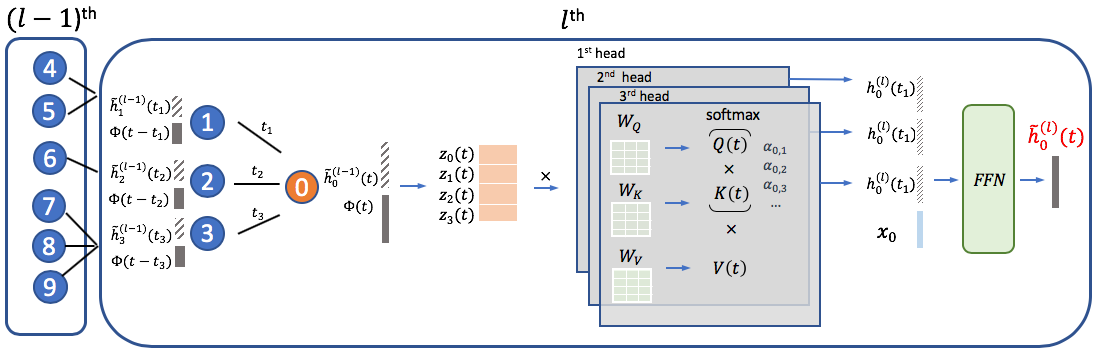
📄 经典论文原图:TGAT 架构
🔍 图解与逻辑衔接:图中查询节点在目标时间 t 聚合带时间戳的历史邻居。每条邻居消息都由节点特征与时间编码共同决定,再经过多头注意力得到该时刻的节点表示。与静态 GAT 的区别是:注意力不只看节点内容,还看“这条交互距离查询时刻多久”。因此 TGAT 能处理新节点和新时间点,属于归纳式动态图模型。
论文出处:Xu et al., TGAT, ICLR 2020(arXiv:2002.07962),Figure 2。
📄 经典论文原图:TGN 动态记忆计算流
🔍 图解与逻辑衔接:图中每条带时间戳的交互先写入消息存储,再由消息聚合器汇总,更新节点 memory,最后用更新后的 memory 计算节点 embedding 和预测损失。这张图补充了 TGAT 的注意力视角:TGAT 重点描述如何编码时间邻居,TGN 重点描述如何维护事件驱动的长期状态。两者都说明动态图不能只把所有历史边静态等权处理。
论文出处:Rossi et al., “Temporal Graph Networks for Deep Learning on Dynamic Graphs”, 2020(arXiv:2006.10637),Figure 1。
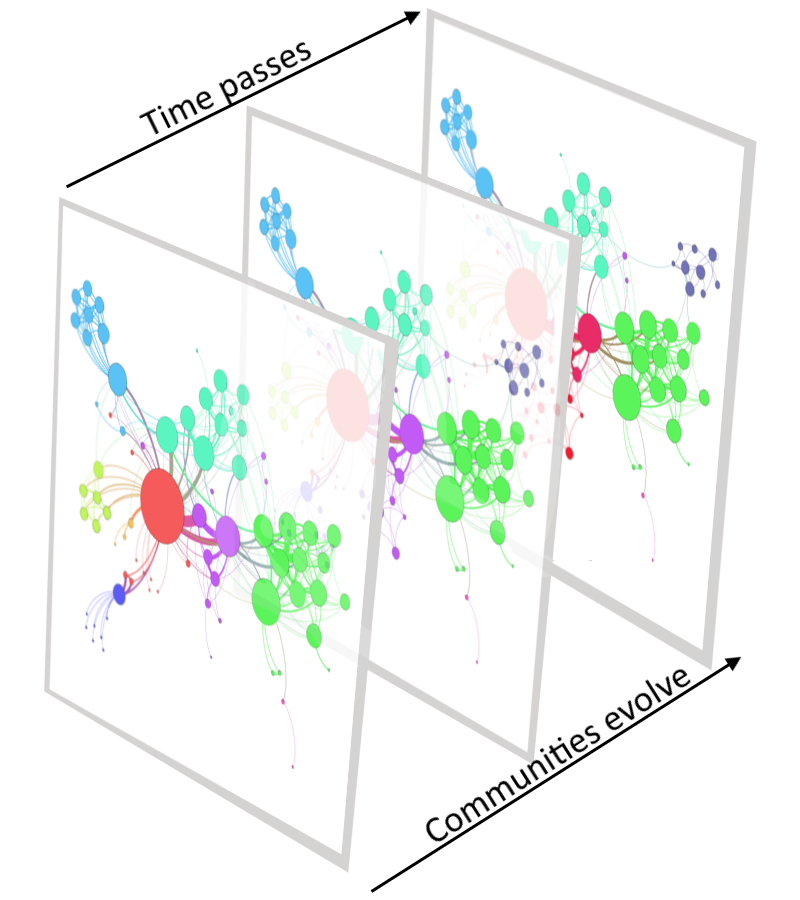
📌 权威配图:动态网络中社区演化(Wikimedia Commons,CC BY-SA 4.0)
图中同一社区随时间分裂/合并/转移——节点的连接关系在变,社区结构也在变。 这正是动态图建模要捕获的"时间演化"信息。
# 手写时间编码(余弦基)+ 简单时间衰减聚合
def time_encoding(dt, dim=8, base=30):
    # dt: 距现在的秒数;用不同频率的 cos/sin 混合编码
    freqs = 1.0 / (base ** (torch.arange(dim) / max(dim - 1, 1)))
    x = dt * freqs
    enc = torch.cat([torch.cos(x), torch.sin(x)])
    return enc

# 模拟:三条历史交互,距现在 10s / 600s / 7200s
dts = torch.tensor([10.0, 600.0, 7200.0])
encs = torch.stack([time_encoding(t) for t in dts])
print('时间编码形状:', tuple(encs.shape))
# 时间编码的可区分性:不同时间戳应得到不同的编码向量(不是单调,而是"各不相同")
d_short = torch.norm(encs[0] - encs[1]).item()   # 10s vs 600s
d_mid   = torch.norm(encs[1] - encs[2]).item()   # 600s vs 7200s
print('  编码差异 ||ψ(10)-ψ(600)||=%.2f  ||ψ(600)-ψ(7200)||=%.2f' % (d_short, d_mid))
assert d_short > 0.5 and d_mid > 0.5, '不同时间戳的编码应可区分'
print('✅ 时间编码:cos/sin 多频基函数让每个时间戳有专属向量(相对位置可学习)')
# ===== 可视化:时间编码 ψ(Δt) 的 cos/sin 分量与衰减权重 =====
fig, axes = plt.subplots(1, 2, figsize=(11.5, 4.0), dpi=200)
dt = torch.linspace(0, 7200, 300)
# 左:时间编码分量(选 3 个不同频率的 cos)
for dim_i, (freq_exp, col) in enumerate([(0, '#1565C0'), (4, '#2E7D32'), (7, '#E65100')]):
    f = 1.0 / (30 ** (dim_i / 7.0))
    axes[0].plot(dt.numpy(), torch.cos(dt * f).numpy(), label='cos(ω%d·Δt), ω=%d/30' % (dim_i + 1, dim_i + 1), color=col, lw=1.8)
axes[0].set_title('时间编码分量:不同频率的 cos 基函数', fontsize=10.5)
axes[0].set_xlabel('Δt(距现在秒数)'); axes[0].set_ylabel('cos 值')
axes[0].legend(fontsize=8); axes[0].grid(alpha=0.3)
# 右:时间衰减权重 exp(-β·Δt)
beta = 0.002
w = np.exp(-beta * dt.numpy())
axes[1].plot(dt.numpy(), w, color='#C62828', lw=2.2)
axes[1].fill_between(dt.numpy(), 0, w, alpha=0.15, color='#C62828')
axes[1].set_title('时间衰减权重 exp(−β·Δt),β=0.002\n(越近的交互权重越大)', fontsize=10.5)
axes[1].set_xlabel('Δt(距现在秒数)'); axes[1].set_ylabel('权重')
axes[1].grid(alpha=0.3)
plt.tight_layout(); plt.show()
print('✅ 左:cos/sin 基给出每个 Δt 专属编码;右:衰减保证近期交互主导消息聚合')
# 时间衰减聚合:消息权重随 Δt 指数衰减
def time_decay_aggregate(feats, dts, beta=0.002):
    # feats: (n,d),dts: (n,) 距现在时间
    w = torch.exp(-beta * dts)[:, None]          # 越近权重越大
    w = w / (w.sum() + 1e-9)
    return (feats * w).sum(dim=0)

hist = torch.randn(3, 4)
agg = time_decay_aggregate(hist, torch.tensor([10., 600., 7200.]))
agg_no_decay = hist.mean(0)
print('时间衰减聚合 vs 简单平均 的差异(范数差): %.4f' % torch.norm(agg - agg_no_decay).item())
print('➡️ 衰减聚合更强调近期行为 → 风控/推荐的时序敏感场景更合理')
7️⃣ 面试速答(进阶结构六连问)¶
print('''1) 同构图和异构图怎么选? -> 节点/边类型单一选同构图;电商/推荐/社交多类型就上异构图。
2) RGCN 怎么处理多关系? -> 每类关系一个 W_r,聚合按关系分组;关系多时用基分解/对角分解降参。
3) 元路径有什么用? -> 定义"语义路径"模板:限定游走(METAPATH2VEC)、限定聚合邻居(HAN)。
4) 超图和普通图的区别? -> 普通图边连 2 点;超图一条超边圈 ≥3 点,用关联矩阵 H 表示;
   超图卷积 = H^T 聚合到组 + H 广播回节点,一次建模高阶集体交互。
5) 动态图怎么建模? -> 离散(快照序列+GNN)或连续(时间戳+时间编码 ψ(Δt) / TGN memory)。
6) 为什么显式建模时间? -> 图在演化:好友会断、兴趣会变;忽略时间=把新老交互等权,预测失真。
''')
📝 自测清单¶
- 能说出同构 GCN 的两个隐藏假设(单关系/单节点类型)及为什么失效
- 默写 RGCN 层公式,解释每类关系一个 W_r 的意义
- 能举 2 条电商/科研元路径(U-P-U、A-P-C 等)并说出用途
- 会用关联矩阵 H 表示超图,能画出"聚到组-广播回组"的传播路径
- 默写时间编码 ψ(Δt),解释为什么近邻编码更接近"现在"
- 能对比 离散快照 vs 连续时间 两种动态图建模的取舍