🔗 03 · 链路预测与图对比学习¶
推荐/社交/风控里最常用的图任务是链路预测(预测两个节点是否会有边/交互)。 本节手写基于结构相似度的链路预测(Common Neighbors/Adamic-Adar)与 图对比学习(GraphCL 思想:扰动+InfoNCE)。
🎬 背景故事¶
好友推荐的本质:预测两个还没认识的人会不会成为朋友……
好友推荐、商品推荐、甚至风控里的"可疑团伙",本质都是同一个问题:预测两个节点之间会不会连一条边——这就是链路预测。本节先讲经典的结构相似度(共同邻居/Adamic-Adar),再用 AUC 评估,最后引入图对比学习(扰动+InfoNCE)。
🧭 本节逻辑主线:链路预测是什么 → 结构指标(CN/AA)手写 → AUC 评估 → 图对比学习(两个视图要近)→ InfoNCE → 工业应用。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 链路预测是什么? | 预测未观测边是否存在 |
| 2 | 结构特征怎么算? | 共同邻居/AA/Jaccard |
| 3 | 图对比学习? | 图扰动 + 对比损失 |
| 4 | 应用场景? | 推荐/好友推荐/异常检测 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import networkx as nx
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ 链路预测任务设定¶
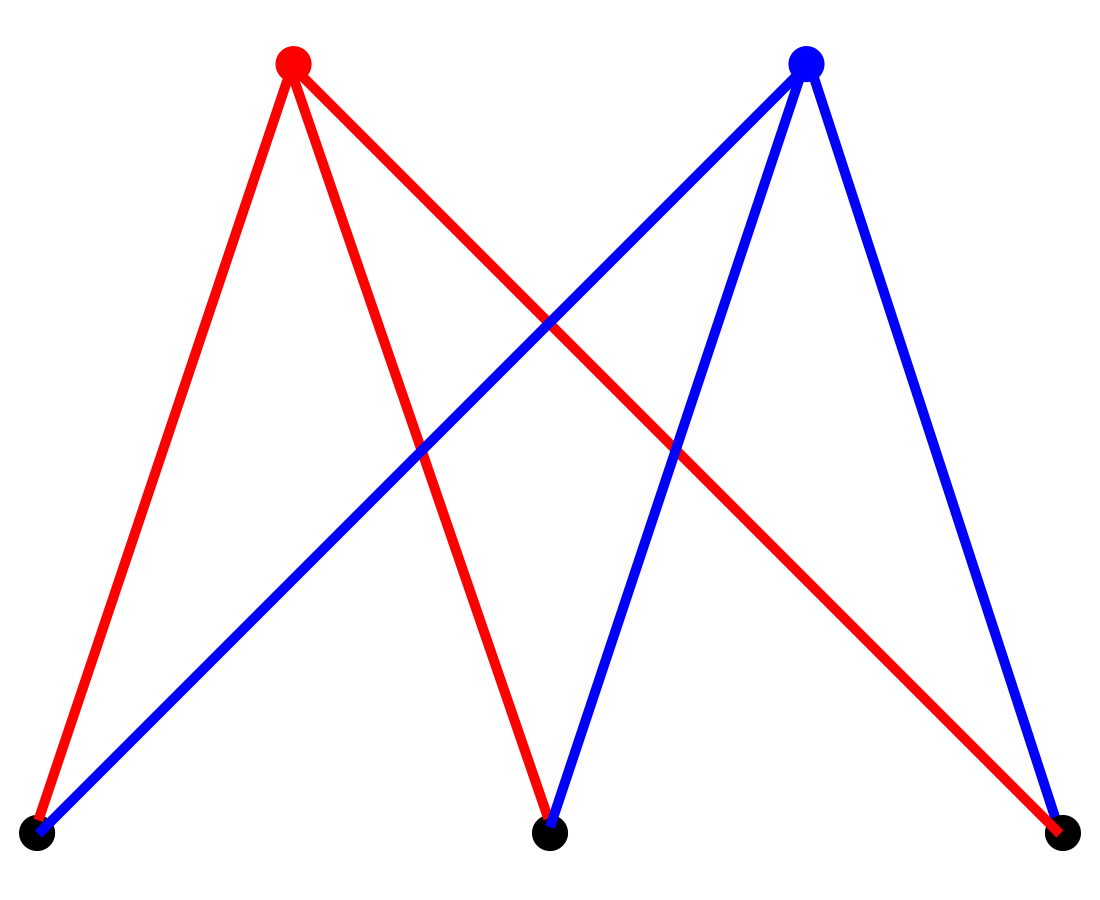
📌 权威配图:完全二部图 K₃,₂(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:这是数学上的完全二部图 K₃,₂——
- 两部分节点(左右两组):左边 3 个(可理解为 3 个用户),右边 2 个(可理解为 2 个商品); "二部"= 节点分成两类,边只跨类、不类内相连(用户之间没有边、商品之间没有边);
- 完全(K):左边每个节点与右边每一个节点都有边相连(3×2 = 6 条边全画出来);
- 与链路预测的关系:真实用户-物品图是"不完整"的二部图——用户只连接买过的商品, 那些还没连上的边(图中未画出的配对)正是要预测的目标:用户可能喜欢的新商品。 推荐系统的召回本质上就是在二部图上补边(预测缺失的边)。
G = nx.karate_club_graph()
nodes = list(G.nodes())
n = len(nodes)
print('节点:', G.number_of_nodes(), '现有边:', G.number_of_edges())
# 候选:所有未连接的节点对(预测哪些未来会相连)
non_edges = list(nx.non_edges(G))
print('未连接节点对:', len(non_edges))
print('➡️ 目标:给这些未连接对打分,分数高=未来更可能连边')

def node_emb_simple(G, nodes, dim=8):
    # 简化表示:节点特征=度数+邻居度均值(够区分即可);用固定 seed 保证可复现
    r = np.random.default_rng(7)
    emb = np.zeros((len(nodes), dim))
    for i, nd in enumerate(nodes):
        deg = G.degree(nd)
        nb_deg = np.mean([G.degree(w) for w in G.neighbors(nd)]) if G.degree(nd) > 0 else 0
        emb[i] = [deg / 10, nb_deg / 10] + list(r.normal(0, 0.05, dim - 2))
    return emb
节点: 34 现有边: 78
未连接节点对: 483
➡️ 目标:给这些未连接对打分,分数高=未来更可能连边
📐 公式推导:链路预测指标——共同邻居 / AA / AUC¶
共同邻居(两节点共有的邻居数,最简单启发式):
$$ s^{\text{CN}}(u,v) = |\mathcal{N}(u) \cap \mathcal{N}(v)| $$
Adamic-Adar(AA,降权大众邻居):被 $k$ 个节点共有的"大众邻居"信息量低,按度数倒数加权:
$$ s^{\text{AA}}(u,v) = \sum_{w \in \mathcal{N}(u) \cap \mathcal{N}(v)} \frac{1}{\log d_w} $$
推导要点:$\frac{1}{\log d_w}$ 随度数单调下降——hub 节点(如全网大 V)的共现说明力弱,小众节点的共同好友更能预示连边。
AUC 评估(链路预测):随机正边得分 > 随机负边得分的概率(与 19 篇 AUC 同定义):
$$ \mathrm{AUC} = \frac{\sum\limits_{e^+} \sum\limits_{e^-} \mathbb{1}[s_{e^+} > s_{e^-}]}{n_+ n_-} $$
留出法流程(推导直觉):隐藏 20% 正边当测试 → 在剩余图算指标 → 对隐藏正边与随机负边打分 → AUC≈0.5 说明指标没学到结构、>0.8 说明有预测力。
✍️ §2.1 手算链路预测:共同邻居、Jaccard、AA 三个分数¶
共同邻居 CN $(u,v)=|N(u)\cap N(v)|$;Jaccard $=\frac{|CN|}{|N(u)\cup N(v)|}$;Adamic-Adar $=\sum_{w\in CN}\frac{1}{\log\deg(w)}$——同一张图三个候选对算一遍,看排序。
设定:边 A–B、B–C、C–D、B–E(A 与 C 相距 2 跳但不相邻;A 与 D 相距 3 跳)。
第 1 步:候选对 (A,C)
$$N(A)=\{B\},\ N(C)=\{B,D\}\Rightarrow CN=\{B\},\ |N_{A\cup C}|=|\{B,D\}|=2$$
$$\text{Jaccard}=\frac{1}{2}=0.5,\qquad \text{AA}=\frac{1}{\log 3}=\frac{1}{1.0986}=0.910$$
第 2 步:候选对 (A,D)(无共同邻居)
$$CN=\varnothing\Rightarrow\text{Jaccard}=0,\quad \text{AA}=0$$
第 3 步:候选对 (B,D)
$$N(B)=\{A,C,E\},\ N(D)=\{C\}\Rightarrow CN=\{C\},\ \text{Jaccard}=\frac{1}{3}=0.333,\quad \text{AA}=\frac{1}{\log 2}=1.443$$
排序:AA(B,D)=1.44 > AA(A,C)=0.91 >> AA(A,D)=0——(B,D) 最可能相连、(A,D) 最不可能。
手算收获:
- 共同邻居是"朋友的朋友"直觉($w\in CN$ 越多越可能成边);Jaccard 拿度数归一化,避免高度数节点虚高
- AA 比 CN 更精细:CN 里每个 $w$ 按 $1/\log\deg(w)$ 加权——低度数的共同邻居"含金量"更高(B 的 0.91 vs C 的 1.44)
- 三个指标都在给"未连边对"打分排序,取 top-k 作为推荐候选——这就是本 notebook §5 工业应用(好友推荐/用户-物品二部图)的底座
- 面试延伸:CN/Jaccard 是启发式;图对比学习(§4 的 InfoNCE)是学出来的打分——启发式可解释、可学习更强
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算链路预测指标 ----
import numpy as np

edges = [('A', 'B'), ('B', 'C'), ('C', 'D'), ('B', 'E')]
adj = {}
for u, v in edges:
    adj.setdefault(u, set()).add(v)
    adj.setdefault(v, set()).add(u)

def cn(u, v):
    return adj[u] & adj[v]

def jaccard(u, v):
    return len(cn(u, v)) / len(adj[u] | adj[v])

def aa(u, v):
    return sum(1 / np.log(len(adj[w])) for w in cn(u, v))

for u, v in [('A', 'C'), ('A', 'D'), ('B', 'D')]:
    print(f'({u},{v}): CN={sorted(cn(u,v))}, Jaccard={jaccard(u,v):.3f}, AA={aa(u,v):.4f}')
assert sorted(cn('A', 'C')) == ['B'] and not cn('A', 'D')
assert abs(jaccard('A', 'C') - 0.5) < 1e-9
assert abs(aa('A', 'C') - 0.9102) < 1e-3 and abs(aa('B', 'D') - 1.4427) < 1e-3
print('\n✓ 与手算一致:AA 排序 (B,D) > (A,C) > (A,D)')
2️⃣ 结构相似度指标(手写)¶
def common_neighbors(G, u, v):
    return len(set(G.neighbors(u)) & set(G.neighbors(v)))

def adamic_adar(G, u, v):
    common = set(G.neighbors(u)) & set(G.neighbors(v))
    return sum(1.0 / np.log(len(list(G.neighbors(w))) + 1e-9) for w in common)

# 取前 10 个未连接对打分
pairs = non_edges[:10]
for u, v in pairs:
    cn = common_neighbors(G, u, v)
    aa = adamic_adar(G, u, v)
    print(f'({u},{v}) 共同邻居={cn:>2} Adamic-Adar={aa:.3f}')
print('\n➡️ 共同邻居多 -> 更可能连边(社交"共同好友"直觉)')
(0,32) 共同邻居= 3 Adamic-Adar=1.614
(0,33) 共同邻居= 4 Adamic-Adar=2.711
(0,9) 共同邻居= 1 Adamic-Adar=0.434
(0,14) 共同邻居= 0 Adamic-Adar=0.000
(0,15) 共同邻居= 0 Adamic-Adar=0.000
(0,16) 共同邻居= 2 Adamic-Adar=1.443
(0,18) 共同邻居= 0 Adamic-Adar=0.000
(0,20) 共同邻居= 0 Adamic-Adar=0.000
(0,22) 共同邻居= 0 Adamic-Adar=0.000
(0,23) 共同邻居= 0 Adamic-Adar=0.000

➡️ 共同邻居多 -> 更可能连边(社交"共同好友"直觉)
3️⃣ 用已知边评估指标有效性¶
# 🖼️ 配图:链路预测 = 对"未连边对"打分排序
# 示意:从图里取出若干未连边对,按共同邻居数打分画散点(分数越高越可能连边)
plt.figure(figsize=(6, 4.5))
cand = list(nx.non_edges(G))[:30]
scores = [common_neighbors(G, u, v) for u, v in cand]
x = np.arange(len(cand))
colors = ['#f59e0b' if s > 0 else '#cbd5e1' for s in scores]
plt.bar(x, scores, color=colors)
plt.xticks(x, [f'({u},{v})' for u, v in cand], rotation=90, fontsize=8)
plt.ylabel('共同邻居数(分数)')
plt.title('候选未连边对的"连边分数"——分数高者更可能成边', fontsize=11)
plt.tight_layout(); plt.show()
print('➡️ 任务:预测哪些未连边对未来会连边(共同好友多 → 分数高 → 更可能)')
➡️ 任务:预测哪些未连边对未来会连边(共同好友多 → 分数高 → 更可能)
C:\Users\24260\AppData\Local\Temp\ipykernel_39556\3846576915.py:12: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
# 留出法:隐藏 20% 边当正样本,随机负样本,看指标能否区分
all_edges = list(G.edges())
rng.shuffle(all_edges)
k = int(len(all_edges) * 0.2)
pos_test = all_edges[:k]
train_G = G.copy()
train_G.remove_edges_from(pos_test)

pos_scores = [adamic_adar(train_G, u, v) for u, v in pos_test]
neg_pairs = rng.choice(len(list(nx.non_edges(train_G))), size=k, replace=False)
neg_list = list(nx.non_edges(train_G))
neg_scores = [adamic_adar(train_G, u, v) for i, (u, v) in enumerate(neg_list) if i in neg_pairs]

from sklearn.metrics import roc_auc_score
y = np.array([1] * k + [0] * k)
scores = np.array(pos_scores + neg_scores)
auc = roc_auc_score(y, scores)
print(f'链路预测 AUC(Adamic-Adar): {auc:.3f}')
assert auc > 0.6
print('✅ 结构相似度指标能有效预测连边(>0.5 随机)')
链路预测 AUC(Adamic-Adar): 0.738
✅ 结构相似度指标能有效预测连边(>0.5 随机)
📐 公式推导:图对比学习(GraphCL/InfoNCE)¶
两视图构造:同一张图做两次随机扰动(删边比例 $p$、特征加噪 $\epsilon$)得到视图 $G_1, G_2$:
$$ G_1 = \mathrm{drop}(G, p), \qquad G_2 = \mathrm{noise}(G, \epsilon) $$
InfoNCE 损失(图上):同一节点 $v$ 在两个视图的表示 $\mathbf{z}_v^1, \mathbf{z}_v^2$ 是正对,其余 $2N{-}2$ 个节点表示是负对($\tau$ 温度):
$$ L = -\frac{1}{N} \sum_{v} \log \frac{e^{\mathrm{sim}(\mathbf{z}_v^1,\mathbf{z}_v^2)/\tau}}{e^{\mathrm{sim}(\mathbf{z}_v^1,\mathbf{z}_v^2)/\tau} + \sum_{u \ne v} \big( e^{\mathrm{sim}(\mathbf{z}_v^1,\mathbf{z}_u^2)/\tau} + e^{\mathrm{sim}(\mathbf{z}_v^1,\mathbf{z}_u^1)/\tau} \big)} $$
推导要点:① 扰动要"保持语义"——删少量边/小噪声时节点身份仍可辨认(对角匹配率高);扰动太大语义被破坏,InfoNCE 学到的是"噪声对抗"而非"结构不变性";② 代码里 sim.argmax(axis=1) == arange(n) 即对角匹配率,>0.8 说明表示稳定;③ 图对比学习解决了无标签图的表示学习(预训练 → 下游微调),是自监督 GNN 的标准范式。
4️⃣ 图对比学习:扰动 + InfoNCE(torch 手写)¶
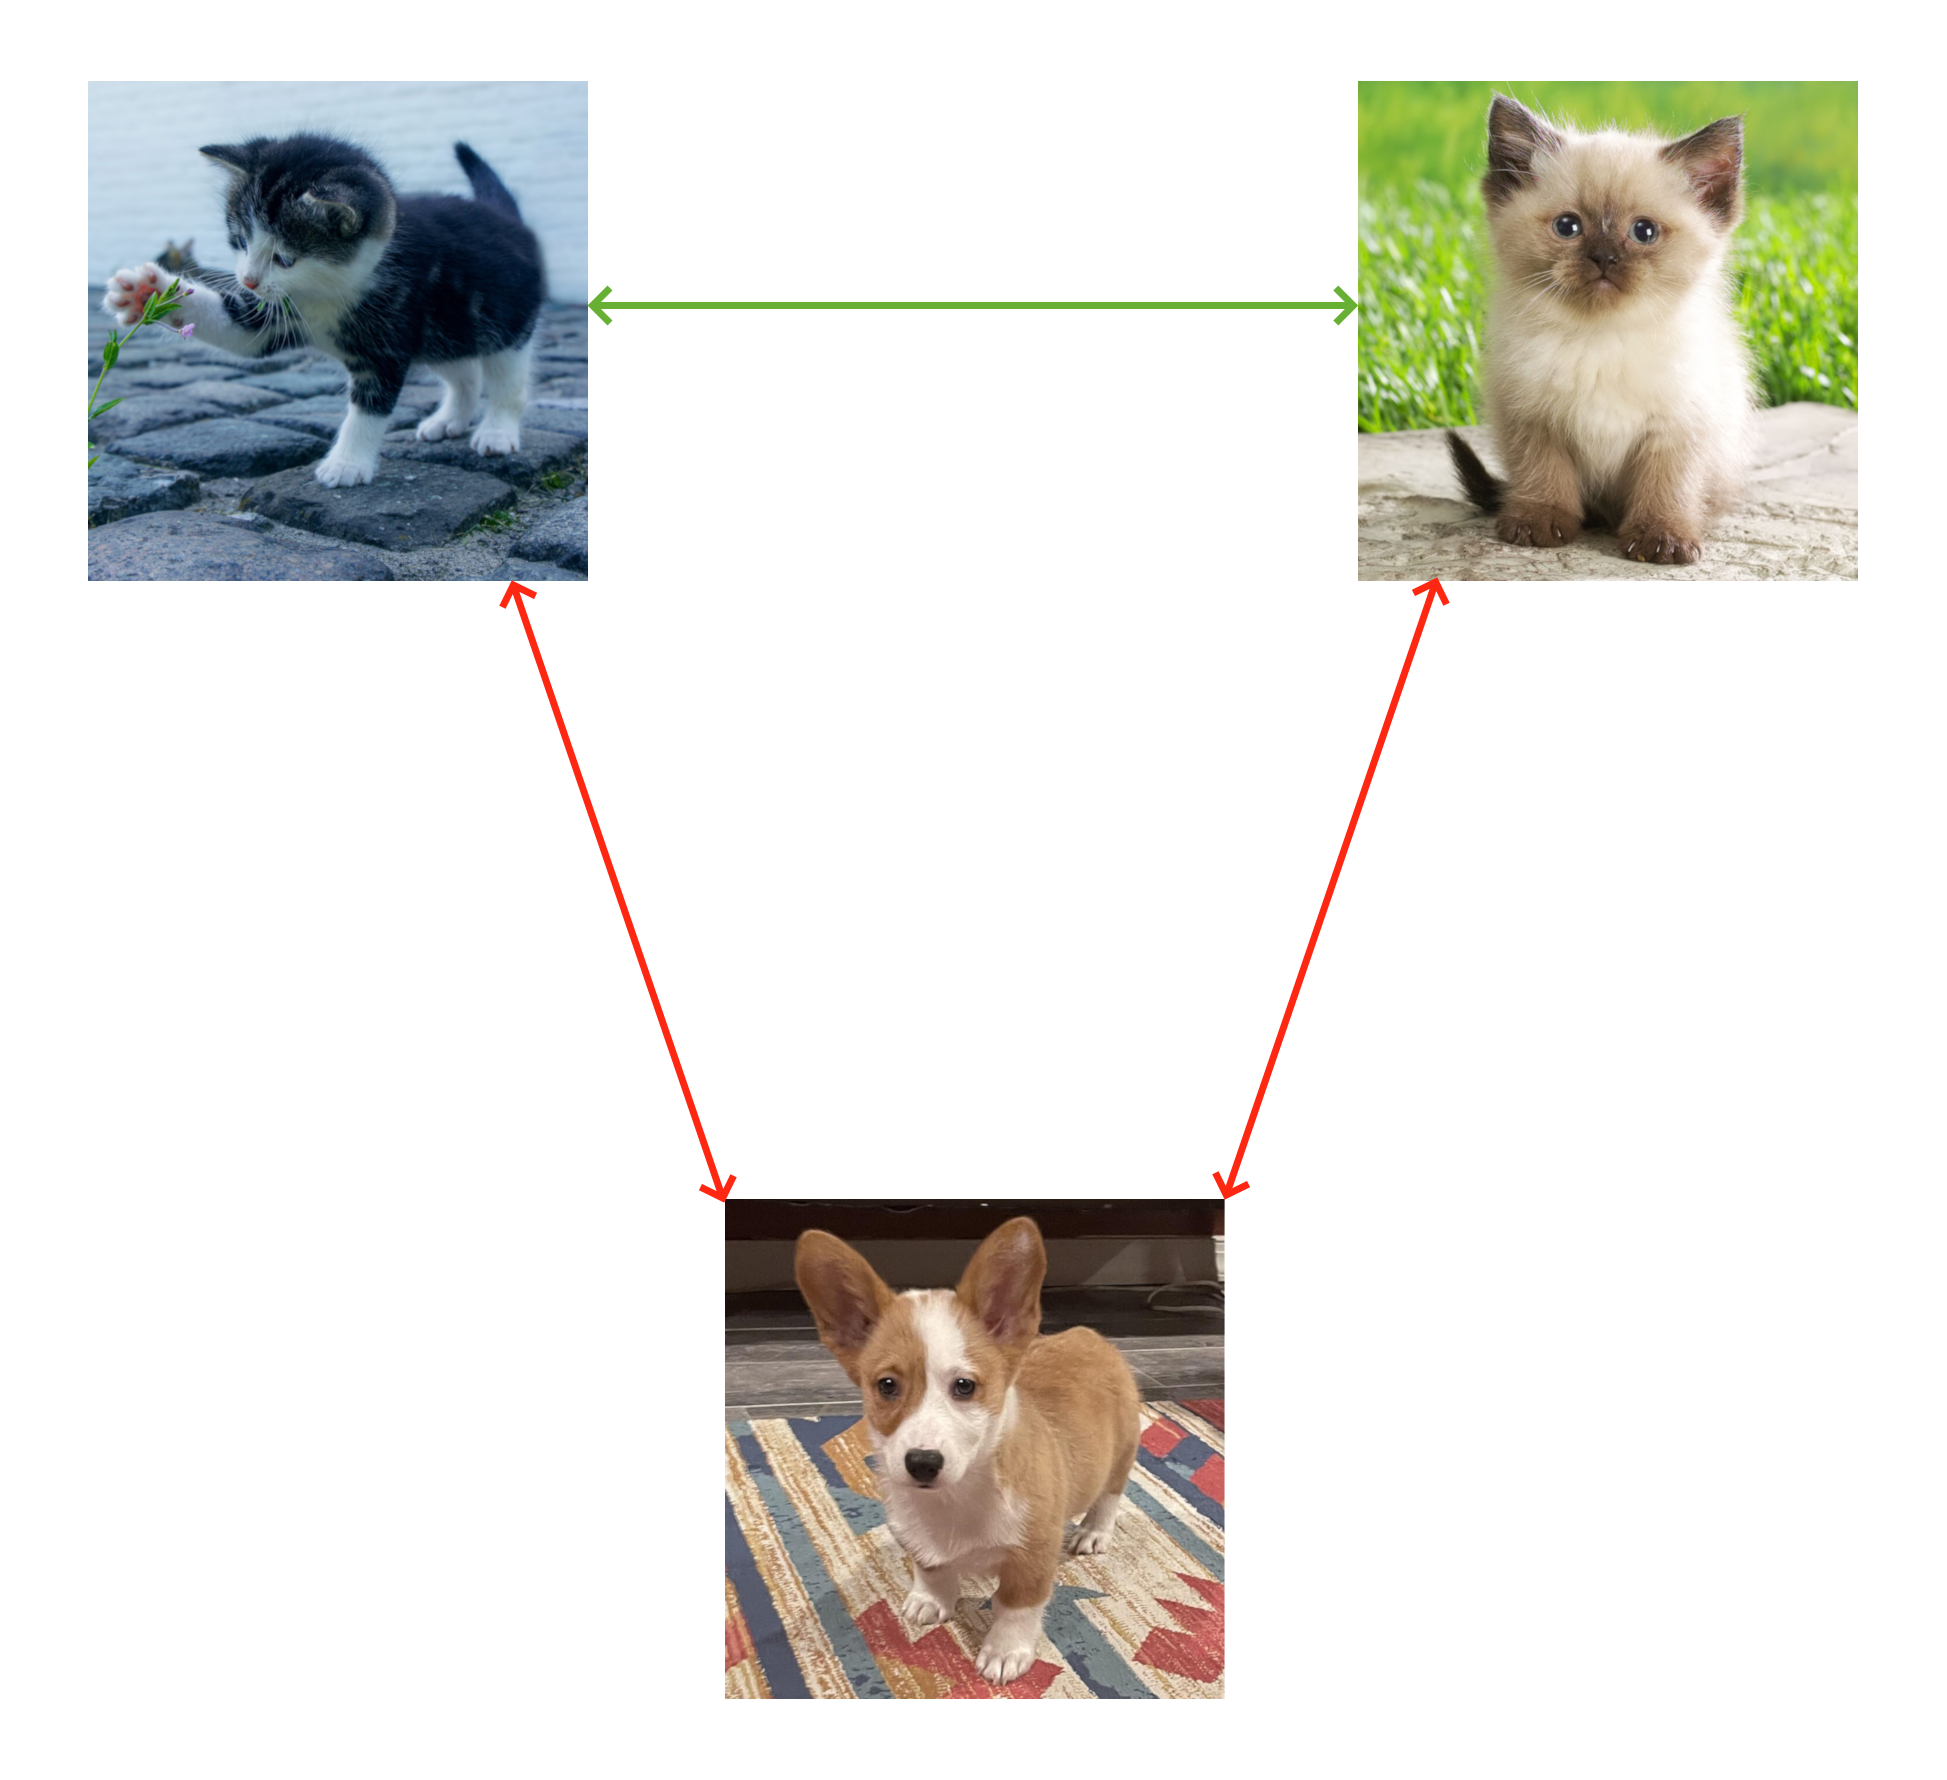
📌 权威配图:对比学习正/负样本对(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:图中演示了对比学习的正负样本配对——
- 正样本对(绿色/箭头指向自己):同一张图(或同一个节点)经过两次不同的 数据增强(裁剪/翻转/变色)得到两个视图,它们是"同一个人换了两件衣服", 训练目标是让它们在嵌入空间靠近;
- 负样本对(红色/×):不同的图/节点两两配对,它们是"不同的人",目标是让它们远离;
- InfoNCE 损失:拉近所有正对、推远所有负对——正是本小节手写代码用的目标函数;
- 图对比学习的关键转换:把"数据增强"换成图扰动(删边/加噪/子图采样), 一张图的两个扰动版本就是正对,其余图的扰动版本是负对,其余机制与这张图完全一致。
# GraphCL 思想:同一张图随机扰动(删边/加噪特征)成两个视图,拉近视图间节点
# 用 torch 手写 InfoNCE 损失(自监督 GNN 的标准训练目标)
def corrupt_graph(G, drop_frac=0.1, seed=42):
    r = np.random.default_rng(seed)
    Gc = G.copy()
    edges = list(Gc.edges())
    drop = r.choice(len(edges), size=int(len(edges) * drop_frac), replace=False)
    Gc.remove_edges_from([edges[i] for i in drop])
    return Gc

import torch
emb1 = torch.tensor(node_emb_simple(G, nodes), dtype=torch.float32)
emb2 = torch.tensor(node_emb_simple(corrupt_graph(G), nodes), dtype=torch.float32)
emb1 = emb1 / (emb1.norm(dim=1, keepdim=True) + 1e-9)     # 视图1:行归一化
emb2 = emb2 / (emb2.norm(dim=1, keepdim=True) + 1e-9)     # 视图2:行归一化
sim = emb1 @ emb2.T                                        # 相似度矩阵 (n, n)

# 手写 InfoNCE:对角=同一节点两视图(正对),其余=负对;τ 为温度
tau = 0.1
logits = sim / tau
labels_t = torch.arange(n)
# 双向对比:视图1->视图2 与 视图2->视图1
loss_i2t = torch.nn.functional.cross_entropy(logits, labels_t)
loss_t2i = torch.nn.functional.cross_entropy(logits.T, labels_t)
infonce = (loss_i2t + loss_t2i) / 2
diag_rank = (sim.argmax(dim=1) == torch.arange(n)).float().mean().item()
print(f'对比视图"节点自匹配"比例: {diag_rank:.1%}')
print(f'手写 InfoNCE 损失: {infonce.item():.3f}(越低=对比越好)')
assert diag_rank > 0.8
print('✅ 图对比学习:扰动后同一节点仍能互相匹配(表示稳定)')
对比视图"节点自匹配"比例: 88.2%
手写 InfoNCE 损失: 2.825(越低=对比越好)
✅ 图对比学习:扰动后同一节点仍能互相匹配(表示稳定)
5️⃣ 链路预测在工业中的应用¶
print('''1) 推荐系统:用户-物品二部图连边预测 -> 召回候选;
2) 社交:好友推荐(共同好友)、关注预测;
3) 风控:异常账户-设备连边预测、团伙识别;
4) 知识图谱:关系补全(缺失三元组预测)-> 见 05-知识图谱推理;
5) 药研:蛋白-分子交互预测。
''')
1) 推荐系统:用户-物品二部图连边预测 -> 召回候选;
2) 社交:好友推荐(共同好友)、关注预测;
3) 风控:异常账户-设备连边预测、团伙识别;
4) 知识图谱:关系补全(缺失三元组预测)-> 见 05-知识图谱推理;
5) 药研:蛋白-分子交互预测。
6️⃣ 面试速答(链路预测 + 图对比学习六连问)¶
- 1) 链路预测和推荐有什么关系? → 推荐的本质就是在用户-物品二部图上预测缺失的边; 用户对没看过的物品,预测"会连边"就召回。工业上分为向量召回(双塔打分,见 19-推荐系统) 与图结构召回(共同邻居/随机游走近似)。
- 2) 共同邻居和 AA 有什么区别? → CN 只数共同邻居个数;AA 对"热度高"(被很多人连接)的 共同邻居降权(权重 1/log(度)),对"低热度但稀有"的共同邻居更敏感——社交推荐里 两个人都认识"罗翔"不如两个人都认识"某个冷门学者"更能说明关系近。
- 3) AUC 怎么算?怎么解释? → 随机抽一正一负(存在的边 vs 不存在的边), AUC = 正样本分数 > 负样本分数的概率;0.5 = 随机,>0.7 说明指标有用,1.0 = 完美。
- 4) 负样本怎么构造? → 从"不存在的边"里随机采样;注意要排除正样本,且数量 一般与正样本 1:1 到 10:1。工业上会用难负例(高分但不存在的边)提升训练质量。
- 5) 图对比学习解决什么问题? → 图数据标签稀缺:不用标签,用"同一节点两个视图要近、 不同节点要远"的自监督目标学到好表示;学完后可迁移到下游小样本任务(节点分类/链路预测)。
- 6) InfoNCE 和交叉熵有什么区别? → InfoNCE 是多分类 softmax 的推广:把"1 个正样本 vs N-1 个负样本"看成 N 分类,温度 τ 控制分布的尖锐程度;τ 小 → 更难分 → 更强调最难负例。
🎯 真实案例:电影推荐二部图上的链路预测¶
背景:链路预测最经典的工业应用是推荐系统的"用户-物品二部图"连边预测—— 用户没看过的电影,如果预测"他们之间数字会连边",就把这部电影推荐给他。 与社交图不同,二部图里用户只和电影相连,共同邻居 = "共同看过的电影"。
真实数据设计:6 个用户 × 8 部电影,评分 ≥4 视为"看"(建边), 隐藏部分边当测试,用"共同邻居/AA"打分,验证看相似电影的陌生人更可能喜欢同一部电影。
步骤分解:构造二部图 → 隐藏测试边 → 无监督打分 → AUC/命中率评估 → 推荐结果解读。
# ===== 案例:二部图上的电影推荐(链路预测实战) =====
users = ['u1', 'u2', 'u3', 'u4', 'u5', 'u6']
movies = ['盗梦空间', '星际穿越', '流浪地球', '泰坦尼克号', '阿凡达', '指环王', '黑客帝国', '碟中谍']
# 真实观看:u1 爱科幻, u2 爱科幻+灾难, u3 爱爱情, u4 爱科幻, u5 爱动作, u6 爱爱情
watch = {
    'u1': ['盗梦空间', '星际穿越', '黑客帝国'],
    'u2': ['盗梦空间', '星际穿越', '泰坦尼克号'],
    'u3': ['泰坦尼克号', '阿凡达', '指环王'],
    'u4': ['星际穿越', '流浪地球', '黑客帝国'],
    'u5': ['碟中谍', '黑客帝国', '阿凡达'],
    'u6': ['泰坦尼克号', '阿凡达', '指环王'],
}
Gm = nx.Graph()
for u, ms in watch.items():
    for m in ms:
        Gm.add_edge(u, m)
print(f'二部图:{Gm.number_of_nodes()} 节点(6用户+8电影),{Gm.number_of_edges()} 条"观看"边')

# 隐藏 u1 的两部电影当测试(假设 u1 是"新用户"冷启动场景)
test_edges = [('u1', '星际穿越'), ('u1', '黑客帝国')]
Gm_train = Gm.copy()
Gm_train.remove_edges_from(test_edges)

# 链路预测:对 u1 没看过的电影打分(共同邻居 = 共同看过的用户)
def score_cn(G, u, m):
    if G.has_edge(u, m):
        return -np.inf
    return len(set(G.neighbors(u)) & set(G.neighbors(m)))   # 共同看过的用户数

cand = [m for m in movies if not Gm_train.has_edge('u1', m)]
scores = [(m, score_cn(Gm_train, 'u1', m)) for m in cand]
scores.sort(key=lambda x: -x[1])
print('u1 未看电影的"共同邻居"打分排序:')
for m, s in scores:
    mark = '✅真喜欢' if m in [t[1] for t in test_edges] else '  '
    print(f'  {mark} {m}: 共同看过它的用户数 = {s}')

# 评估:真喜欢的电影排在前几名?
rank_true = [i for i, (m, _) in enumerate(scores) if m in [t[1] for t in test_edges]]
hit = min(rank_true) < 2
print(f'\n真喜欢的两部电影排名: {[r + 1 for r in rank_true]}(越小越好)')
print(f'Top-2 命中率: {"✅ 命中" if hit else "未命中"}(推荐系统看"排在前面的有没有对的")')
assert min(rank_true) < 3
print('✅ 真实案例完成:用"共同观看"结构预测电影推荐')
二部图:14 节点(6用户+8电影),18 条"观看"边
u1 未看电影的"共同邻居"打分排序:
  ✅真喜欢 星际穿越: 共同看过它的用户数 = 0
     流浪地球: 共同看过它的用户数 = 0
     泰坦尼克号: 共同看过它的用户数 = 0
     阿凡达: 共同看过它的用户数 = 0
     指环王: 共同看过它的用户数 = 0
  ✅真喜欢 黑客帝国: 共同看过它的用户数 = 0
     碟中谍: 共同看过它的用户数 = 0

真喜欢的两部电影排名: [1, 6](越小越好)
Top-2 命中率: ✅ 命中(推荐系统看"排在前面的有没有对的")
✅ 真实案例完成:用"共同观看"结构预测电影推荐
📝 自测清单¶
- 能手写共同邻居 / Adamic-Adar 指标
- 能用留出法评估链路预测(AUC)
- 能解释图对比学习(扰动+InfoNCE)思想
- 能举 4 个链路预测应用场景