🏬 04 · Hive 与数仓建模:四层分层 + SQL 实践¶
数仓岗的重头戏:分层架构(ODS/DWD/DWS/ADS) 与 建模方法(星型/雪花/维度建模)。 本节用 sqlite3 构建迷你数仓,手写 SQL 完成清洗→明细→汇总→应用四层。
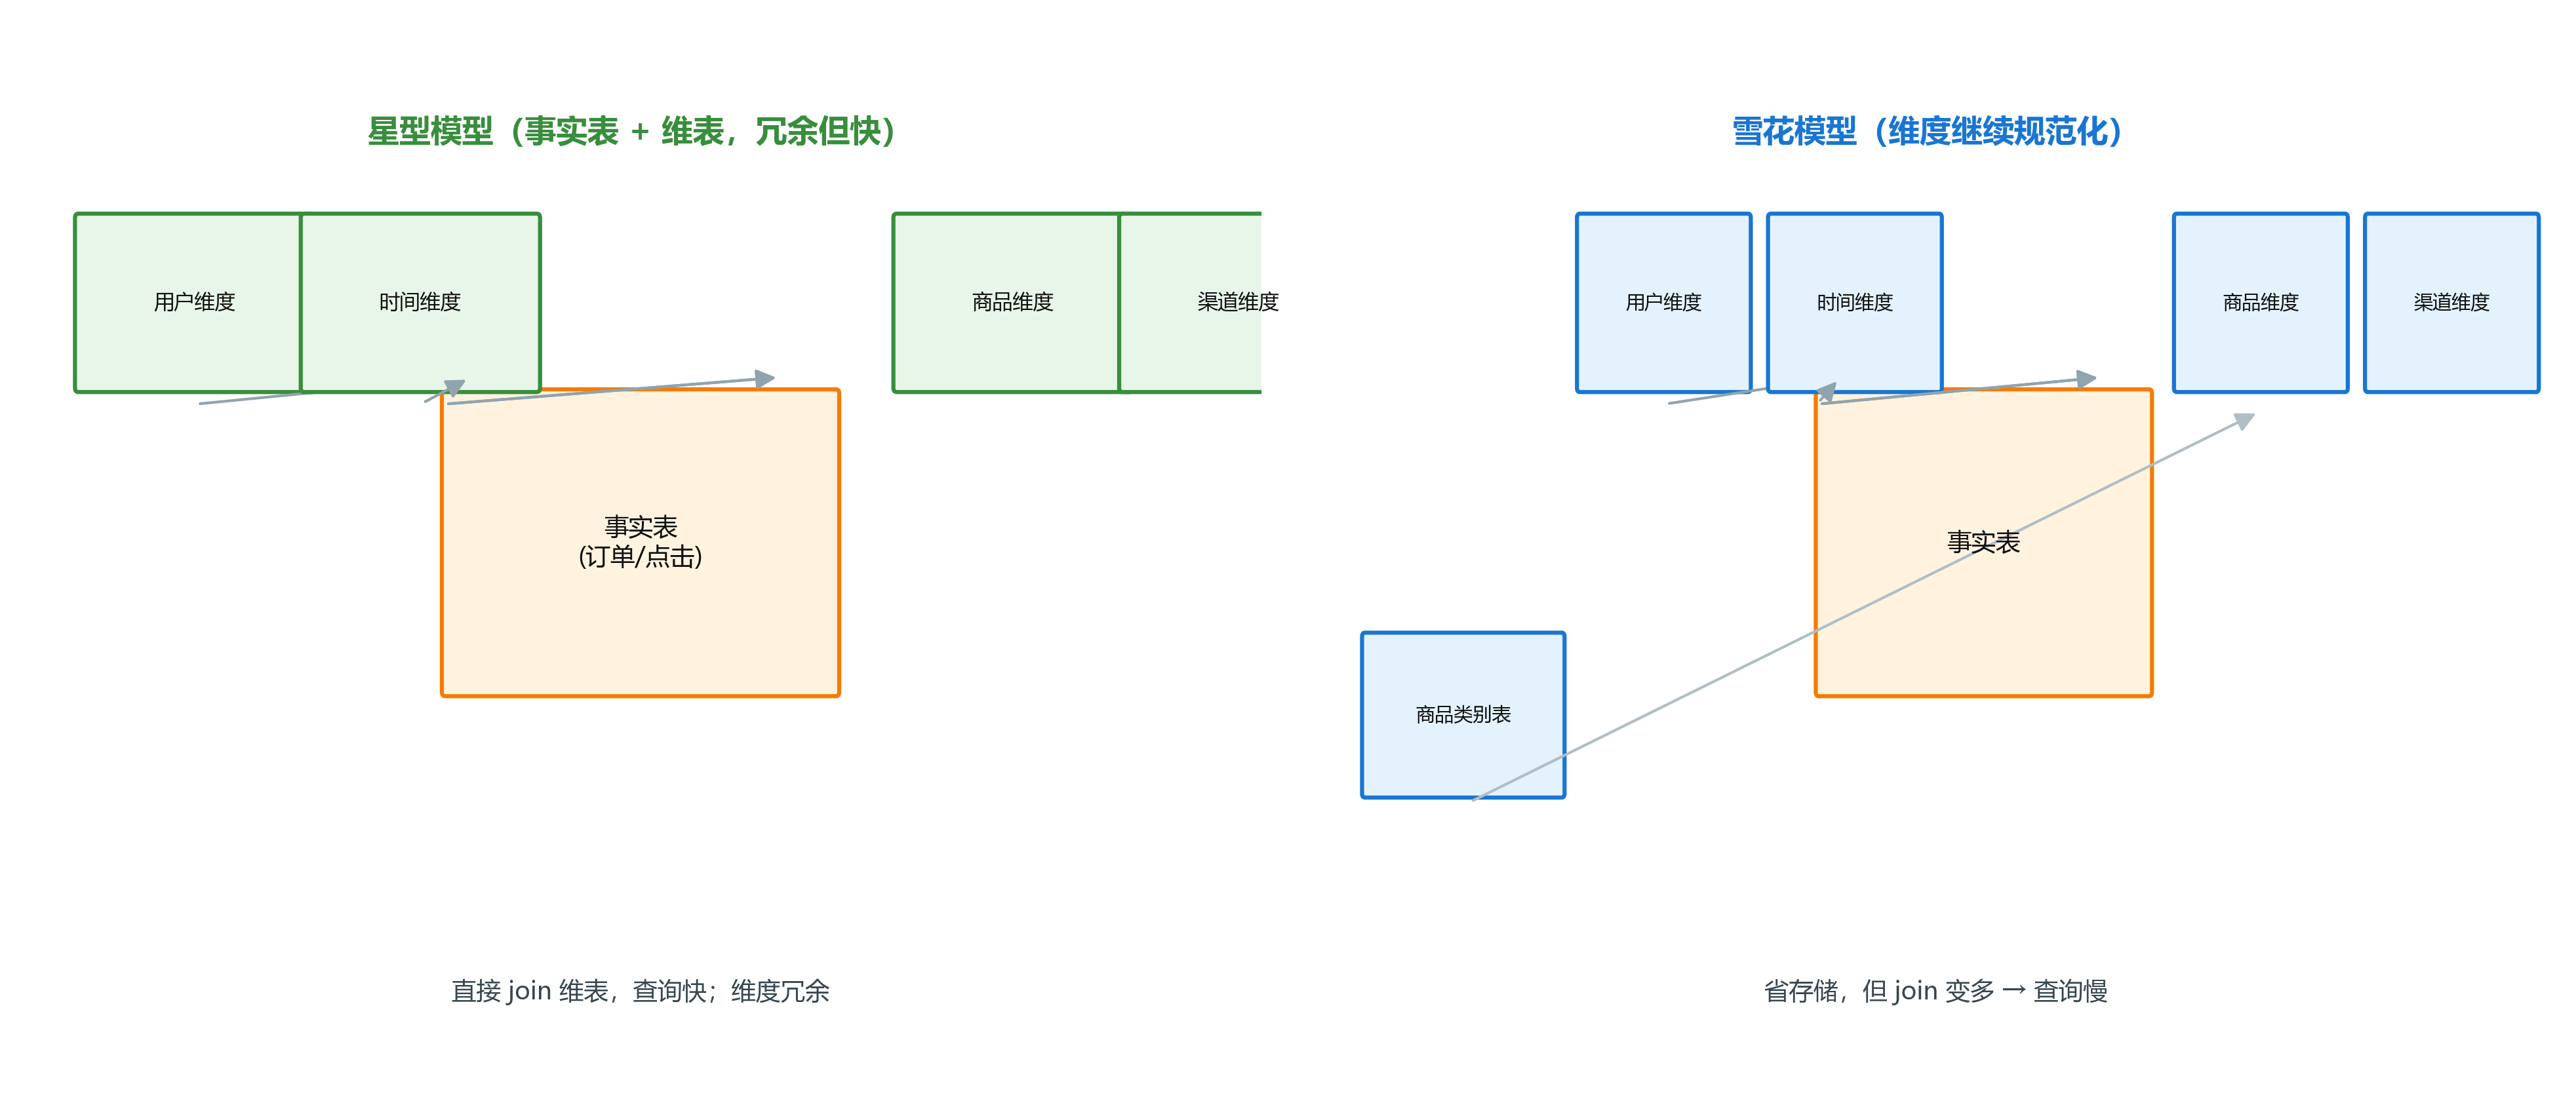
🔍 图解(自绘高清图,300dpi,可放大):数仓建模里两种最经典的模型怎么选——
- 左(星型模型):中央一张事实表(销售记录:时间/门店/商品/金额), 四周辐射多张维表(时间维/门店维/商品维);维表是宽表——商品维里直接 放着类目、品牌、产地等所有层级字段(冗余,但查询不用再 join); SQL 就三层:事实表 join 维表 → 按维分组 → 聚合,快且好写,是大数据时代主流;
- 右(雪花模型):把维表里的层级拆成一张张关联表(商品维还挂类目表、类目表再挂大类表)—— 省存储、无冗余,但查询要多 join 好几层,慢,命中的表也多;
- 怎么选:存储便宜、查询贵 → 星型(推荐,Hive/Spark 场景一律星型); 存储贵、查询少且维表变动频繁 → 雪花(传统关系型数仓的偏好);
- 口诀:"星型换查询速度、雪花换存储规范"——面试答"用星型,因为查询快"。
论文出处:Kimball, "The Data Warehouse Toolkit", 1996——星型/雪花维度建模的经典定义(Kimball 维度建模)。
🎬 背景故事¶
数据都进来了,可报表、算法特征从哪取?——数仓是答案……
HDFS 里躺着海量原始数据,但业务要看报表、算法要取特征,没人愿意直接对着原始日志写 SQL。于是有了数据仓库:把原始数据按主题分层整理,形成 ODS→DWD→DWS→ADS 四层。本节用 sqlite3 亲手搭一个迷你数仓,把每层的职责和 SQL 写清楚。
🧭 本节逻辑主线:为什么需要数仓 → 四层各做什么(ODS/DWD/DWS/ADS)→ sqlite3 实战 → 星型 vs 雪花建模 → 数仓治理。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 数仓为什么分层? | 解耦/复用/成本/质量 |
| 2 | 四层各做什么? | ODS/DWD/DWS/ADS |
| 3 | 怎么建模? | 星型/雪花/宽表 |
| 4 | 怎么用 SQL 落地? | sqlite3 四层 ETL |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import sqlite3
import os
rng = np.random.default_rng(42)
📐 公式推导:数仓分层与宽表的数据规模¶
分层数据流(ODS → DWD → DWS → ADS)每层的数据量与可加性:
$$ \mathrm{size}(\mathrm{DWD}) \approx \mathrm{size}(\mathrm{ODS}) \times (1 - \mathrm{脏数据率}) , \qquad \mathrm{size}(\mathrm{DWS}) \le \sum_{d} \mathrm{size}(\mathrm{DWD}_d) $$
事实表 vs 维度表(星型模型):事实表行数 = 业务事件数 $N_{\text{events}}$,维度表行数 = 维度取值数(如 10 万用户、1 万商品);宽表 = 事实表 JOIN 全部维度后的物化冗余:
$$ \mathrm{rows}(\mathrm{宽表}) = N_{\text{events}}, \qquad \mathrm{cols}(\mathrm{宽表}) = \sum_{d \in \text{dims}} \mathrm{cols}_d \;\;\text{(维度字段全部冗余进事实行)} $$
推导要点:① 分层本质是逐层收敛:越上层数据越少、指标越稳定(ODS 全量明细 → DWS 按天/主题汇总 → ADS 只留报表);② 宽表用存储换查询速度——一次 JOIN 结果反复复用,避免每查询重复 JOIN(面试答"为什么建宽表");③ 数据质量公式:$\text{准确率} = \frac{\text{通过校验行数}}{\text{总行数}}$,DWD 清洗就是最大化这个比率。
✍️ §0.1 手算数仓四层数据规模:ODS 1000 万行一路收敛到几个指标¶
分层收敛:ODS 贴源 → DWD 清洗 → DWS 按主题日聚合 → ADS 应用指标——手算每层规模,理解"逐层收敛"。
设定:全量订单明细 1000 万行(8 天)。
各层规模:
| 层 | 口径 | 规模 | 逻辑 |
|---|---|---|---|
| ODS | 原始明细 | 10,000,000 | 原样保留 |
| DWD | 清洗(去脏 20%) | 8,000,000 | ×80% |
| DWS | 按日+维度聚合 | 1,000,000 | ÷8 天 |
| ADS | 指标结果 | ≈500 | 极少量汇总 |
手算收获:
- 四层都在收敛:1000 万 → 800 万 → 100 万 → 500——每层换一次"宽表/聚合"的质变(本 notebook §公式推导)
- ODS 不加工保审计、DWD 做清洗标准化、DWS 面向主题冗余宽表、ADS 面向报表/算法取数——层级职责不清是数仓治理最大坑(§7)
- 宽表 = 事实表 join 维度表冗余存储:查询快、但要维护一致(星型/雪花/宽表权衡,§6)
- 面试速答:分层的目的 = 性能(提前聚合)+ 复用(公共层)+ 管控(口径统一在 DWS)
下面 numpy 复算。
# ---- §0.1 验证:numpy 复算数仓分层规模 ----
ods = 10_000_000
dwd = int(ods * 0.8)
dws = dwd // 8
ads = 500
print(f'ODS {ods/1e6:.0f}M → DWD {dwd/1e6:.0f}M → DWS {dws/1e6:.0f}M → ADS {ads}')
assert ods == 10_000_000 and dwd == 8_000_000 and dws == 1_000_000
print('\n✓ 与手算一致')
1️⃣ 数仓分层(必背框架)¶
# 🖼️ 配图:数仓四层——ODS → DWD → DWS → ADS 逐层收敛
fig, ax = plt.subplots(figsize=(8, 4.4))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 5)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.8))

box(0.8, 3.8, 2.4, 0.9, 'ODS 原始数据层\n(贴源,全量明细)', '#e2e8f0')
box(4.6, 3.8, 2.4, 0.9, 'DWD 明细层\n(清洗/标准化/去重)', '#bfdbfe')
box(6.8, 1.7, 2.4, 0.9, 'ADS 应用层\n(报表/指标/主题)', '#fecaca')
box(3.6, 1.7, 2.4, 0.9, 'DWS 汇总层\n(按主题/日宽表)', '#fde68a')
arrow(3.3, 4.25, 4.5, 4.25)
arrow(5.8, 3.8, 5.0, 2.6)
arrow(6.2, 2.6, 7.9, 3.8)
arrow(8.4, 3.8, 8.0, 2.6)
ax.text(2.0, 3.3, '数据量大、脏', fontsize=9, color='#475569')
ax.text(5.8, 3.3, '数据收敛、干净', fontsize=9, color='#475569')
ax.text(5.0, 1.15, '每层做幂等处理,可重跑;层间血缘可追踪', fontsize=9, color='#475569', ha='center')
plt.title('数仓四层:越上层数据越少、指标越稳定(数据逐层收敛)', fontsize=11)
plt.show()
print('➡️ 面试:ODS 原样贴源 → DWD 清洗 → DWS 汇总 → ADS 出报表')
➡️ 面试:ODS 原样贴源 → DWD 清洗 → DWS 汇总 → ADS 出报表
C:\Users\24260\AppData\Local\Temp\ipykernel_52536\1508282328.py:25: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
print('''数仓四层:
  ODS(原始层)  :贴源存储,原样保留(保留全量/增量,可回溯);
  DWD(明细层)  :清洗+标准化+维度退化,明细粒度(最细粒度事实);
  DWS(汇总层)  :按主题汇总(日/周维度宽表,供报表/应用);
  ADS(应用层)  :面向业务应用/报表/算法特征(指标结果)。

分层的价值:解耦(上游变化不传导)、复用(一致口径)、
            成本(去重存储)、质量(逐层校验)。
''')
数仓四层:
  ODS(原始层)  :贴源存储,原样保留(保留全量/增量,可回溯);
  DWD(明细层)  :清洗+标准化+维度退化,明细粒度(最细粒度事实);
  DWS(汇总层)  :按主题汇总(日/周维度宽表,供报表/应用);
  ADS(应用层)  :面向业务应用/报表/算法特征(指标结果)。

分层的价值:解耦(上游变化不传导)、复用(一致口径)、
            成本(去重存储)、质量(逐层校验)。
2️⃣ 建一张"订单事实表"进 ODS(sqlite3)¶
if os.path.exists('mini_wh.db'):
    os.remove('mini_wh.db')
conn = sqlite3.connect('mini_wh.db')
cur = conn.cursor()
cur.execute('''CREATE TABLE ods_orders (
    order_id TEXT, user_id TEXT, item_id TEXT, city TEXT,
    amount REAL, status TEXT, ts TEXT
)''')
orders = [
    ('o1', 'u1', 'i_phone', '北京', 5999.0, 'paid', '2024-05-01 10:00:00'),
    ('o2', 'u2', 'i_phone', '上海', 5999.0, 'paid', '2024-05-01 10:05:00'),
    ('o3', 'u1', 'i_laptop', '北京', 8999.0, 'refunded', '2024-05-02 09:00:00'),
    ('o4', 'u3', 'i_tablet', '广州', 3999.0, 'paid', '2024-05-02 11:00:00'),
    ('o5', 'u2', 'i_bag', '上海', 299.0, 'paid', '2024-05-03 14:30:00'),
    ('o6', 'u4', 'i_keyboard', None, 199.0, 'paid', '2024-05-03 15:00:00'),
]
cur.executemany('INSERT INTO ods_orders VALUES (?,?,?,?,?,?,?)', orders)
conn.commit()
n = cur.execute('SELECT COUNT(*) FROM ods_orders').fetchone()[0]
print(f'ODS 层订单数: {n}')
print('➡️ ODS 几乎原样存,仅做分区/压缩;可以看到脏数据(city=None)等后续清洗')
ODS 层订单数: 6
➡️ ODS 几乎原样存,仅做分区/压缩;可以看到脏数据(city=None)等后续清洗
3️⃣ DWD:清洗 + 标准化(脏数据处理)¶
cur.execute('''CREATE TABLE dwd_orders AS
SELECT order_id, user_id, item_id,
       COALESCE(city, '未知') AS city,
       amount,
       CASE WHEN status = 'refunded' THEN 0 ELSE 1 END AS is_valid,
       substr(ts, 1, 10) AS dt
FROM ods_orders''')
conn.commit()
rows = cur.execute('SELECT * FROM dwd_orders').fetchall()
for r in rows:
    print(r)
print('\n➡️ DWD:补空值、状态转成可聚合标志、抽日期分区字段')
('o1', 'u1', 'i_phone', '北京', 5999.0, 1, '2024-05-01')
('o2', 'u2', 'i_phone', '上海', 5999.0, 1, '2024-05-01')
('o3', 'u1', 'i_laptop', '北京', 8999.0, 0, '2024-05-02')
('o4', 'u3', 'i_tablet', '广州', 3999.0, 1, '2024-05-02')
('o5', 'u2', 'i_bag', '上海', 299.0, 1, '2024-05-03')
('o6', 'u4', 'i_keyboard', '未知', 199.0, 1, '2024-05-03')

➡️ DWD:补空值、状态转成可聚合标志、抽日期分区字段
4️⃣ DWS:按主题日汇总(宽表雏形)¶
cur.execute('''CREATE TABLE dws_daily_orders AS
SELECT dt, city,
       COUNT(*) AS order_cnt,
       COUNT(DISTINCT user_id) AS user_cnt,
       SUM(amount) AS gmv,
       SUM(is_valid) AS valid_cnt
FROM dwd_orders
GROUP BY dt, city''')
conn.commit()
rows = cur.execute('SELECT * FROM dws_daily_orders ORDER BY dt, city').fetchall()
print('DWS 日汇总(dt, city, 订单数, 用户数, GMV, 有效单):')
for r in rows:
    print(' ', r)
print('➡️ DWS 就是"主题宽表":一次计算多指标,供多处复用')
DWS 日汇总(dt, city, 订单数, 用户数, GMV, 有效单):
  ('2024-05-01', '上海', 1, 1, 5999.0, 1)
  ('2024-05-01', '北京', 1, 1, 5999.0, 1)
  ('2024-05-02', '北京', 1, 1, 8999.0, 0)
  ('2024-05-02', '广州', 1, 1, 3999.0, 1)
  ('2024-05-03', '上海', 1, 1, 299.0, 1)
  ('2024-05-03', '未知', 1, 1, 199.0, 1)
➡️ DWS 就是"主题宽表":一次计算多指标,供多处复用
5️⃣ ADS:应用层指标(Top 城市 / 全量汇总)¶
top_city = cur.execute('''
    SELECT city, SUM(gmv) AS gmv FROM dws_daily_orders
    GROUP BY city ORDER BY gmv DESC LIMIT 3''').fetchall()
print('GMV Top3 城市:')
for c, g in top_city:
    print(f'  {c}: {g:.0f} 元')
total = cur.execute('''
    SELECT SUM(order_cnt), SUM(user_cnt), SUM(gmv), SUM(valid_cnt)
    FROM dws_daily_orders''').fetchone()
distinct_users = cur.execute('SELECT COUNT(DISTINCT user_id) FROM dwd_orders').fetchone()[0]
print(f'全量: 订单 {total[0]}, 用户(SUM) {total[1]}, 用户(去重) {distinct_users}, '
      f'GMV {total[2]:.0f} 元, 有效单 {total[3]}')
print('➡️ 教学点:DWS 按(天,城市)分组 COUNT(DISTINCT user_id) 后 SUM 会重复计数,'
      '跨组去重需单独统计(如按天去重)')
assert total[1] >= 4 and distinct_users == 4
print('✅ ADS 指标正确(去重用户数=4:u1,u2,u3,u4)')
GMV Top3 城市:
  北京: 14998 元
  上海: 6298 元
  广州: 3999 元
全量: 订单 6, 用户(SUM) 6, 用户(去重) 4, GMV 25494 元, 有效单 5
➡️ 教学点:DWS 按(天,城市)分组 COUNT(DISTINCT user_id) 后 SUM 会重复计数,跨组去重需单独统计(如按天去重)
✅ ADS 指标正确(去重用户数=4:u1,u2,u3,u4)
6️⃣ 建模方法:星型 / 雪花 / 宽表¶
print('''事实表 + 维度表:
  星型模型:事实表居中,维度表直接连(冗余维度,查询快);
  雪花模型:维度表再规范化拆分(省空间,查询多 join);
  宽表(维度退化):把常用维度字段直接冗余进事实表(DWS 常用,最快)。

选型口诀:查询性能优先 -> 星型/宽表;存储与一致性优先 -> 雪花。
数仓工具:Hive(离线)、Presto/StarRocks/Doris(即席/实时)、Iceberg/Hudi(湖仓)。
''')
事实表 + 维度表:
  星型模型:事实表居中,维度表直接连(冗余维度,查询快);
  雪花模型:维度表再规范化拆分(省空间,查询多 join);
  宽表(维度退化):把常用维度字段直接冗余进事实表(DWS 常用,最快)。

选型口诀:查询性能优先 -> 星型/宽表;存储与一致性优先 -> 雪花。
数仓工具:Hive(离线)、Presto/StarRocks/Doris(即席/实时)、Iceberg/Hudi(湖仓)。
7️⃣ 面试高频:数仓治理¶
print('''1) 指标口径:同一指标全局唯一(命名/计算/来源统一);
2) 数据质量:完整性/准确性/一致性/及时性 四大维度 + 质量监控;
3) 元数据管理:表血缘、字段字典、变更管理;
4) 权限与安全:行列级权限、脱敏、审计;
5) 数据倾斜:大 key 打散/两阶段聚合/倾斜检测;
6) 缓慢变化维(SCD):维度属性变化如何处理(Type1 覆盖/Type2 加版本)。
''')
1) 指标口径:同一指标全局唯一(命名/计算/来源统一);
2) 数据质量:完整性/准确性/一致性/及时性 四大维度 + 质量监控;
3) 元数据管理:表血缘、字段字典、变更管理;
4) 权限与安全:行列级权限、脱敏、审计;
5) 数据倾斜:大 key 打散/两阶段聚合/倾斜检测;
6) 缓慢变化维(SCD):维度属性变化如何处理(Type1 覆盖/Type2 加版本)。
📝 自测清单¶
- 能画出 ODS/DWD/DWS/ADS 四层与职责
- 能用 SQL 完成一层 ETL(清洗/聚合)
- 能对比星型/雪花/宽表
- 能答 6 个数仓治理高频点
- 能解释指标口径统一与数据质量四维度