配图:从"一个人的最优"到"一群人的博弈"(🔴 深入)¶
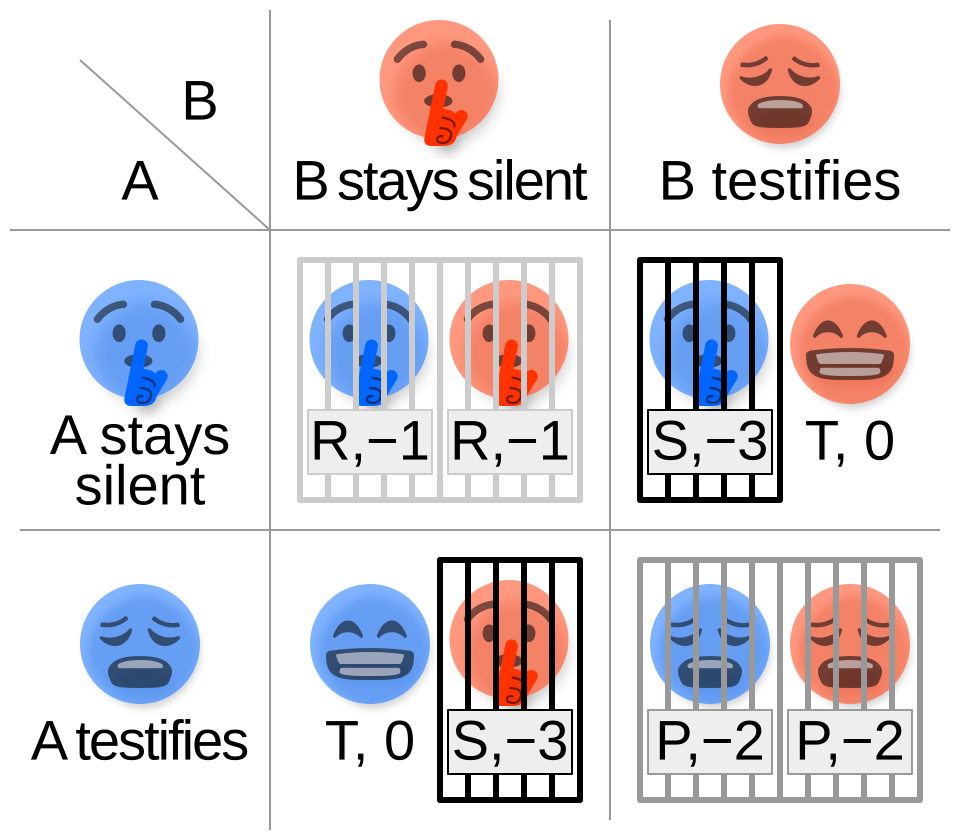
囚徒困境(上图)是最小的博弈例子:两个人各自的最优 ≠ 总体的最优。 MARL 的一切困难都从这张图开始。形式化:
矩阵博弈(单步):$N$ 个智能体各选动作 $a^i$,联合动作得到联合奖励 $r^i(s,a^1,\dots,a^N)$。
随机博弈(多步,MARL 的 MDP 版): $$\langle \mathcal{S}, \mathcal{A}^1,\dots,\mathcal{A}^N, \mathcal{T}, r^1,\dots,r^N, \gamma \rangle$$
- 状态转移依赖所有人的联合动作:$s'\sim T(\cdot|s, \mathbf{a})$
- 每人的奖励可以不同(竞争)或相同(合作)
三个关键"不再成立"(为什么单智能体算法直接搬过来会坏):
- 环境不再平稳:别人的策略也在变 → 对每个智能体,环境是"活的"
- 信用分配:团队赢了,功劳算谁的?(COMA 解决)
- 最优概念变了:没有单一的"最优策略",只有纳什均衡等解概念
记忆:MARL = RL × 博弈论;矩阵博弈是"一枪定胜负",随机博弈是"打一整局"。
🤝 09 · 多智能体强化学习 MARL:从"一个人下棋"到"五个人打篮球"¶
面试定位:多智能体强化学习(Multi-Agent RL, MARL) 是 2024-2025 算法岗的高频增量考点, 覆盖游戏 AI(星际争霸/王者荣耀)、机器人集群、红绿灯调度、大模型多智能体协作(Agent 时代)。 知识链:08 篇的 DDPG/TD3/SAC 是单智能体;本篇回答"多个智能体同时学"会出什么新问题、 经典解法(VDN/QMIX/MADDPG/COMA)各解决哪一层。 标记:🔴 必背 / 🟡 掌握 / 🟢 了解。
1. 完整介绍:多智能体强化学习是什么(🔴 0 基础也能懂)¶
通俗例子¶
- 五个人打篮球:你在跑位,对手在变阵,队友也在变——你的"环境"里全是活人
- 城市红绿灯:一个路口调好了,隔壁路口一变,你这个路口又堵了
- 王者荣耀/星际争霸:己方 5 个英雄 + 对方 5 个英雄,10 个"智能体"同时在线学习
一句话定义:多智能体强化学习 = 多个智能体在同一环境里同时学习, 每个智能体的回报不仅取决于自己的动作,还取决于其他人的动作。
与单智能体的根本区别(🔴)¶
| 单智能体 RL | 多智能体 RL | |
|---|---|---|
| 环境 | 固定(只有我在动) | 其他智能体在学 → 环境随时间变化 |
| 回报 | 只由自己动作决定 | 由所有智能体的联合动作决定 |
| 学习目标 | 最大化自己的回报 | 纳什均衡 / 团队最优 / 对抗…… |
核心洞察:"环境在变"不是环境的错,是其他智能体也在学习。 这引出 MARL 的第一大挑战:非平稳性。
2. 数学建模:从矩阵博弈到随机博弈(🟡 定义)¶
最简模型:矩阵博弈(一次决策)¶
两个玩家各选一个动作,得到联合回报: $$r_i = u_i(a_1, a_2),\qquad a_1 \in \mathcal{A}_1,\ a_2 \in \mathcal{A}_2$$
标准模型:随机博弈(Stochastic Game, SG)¶
$$\big\langle \mathcal{N}, \mathcal{S}, \{\mathcal{A}^i\}, P, \{R^i\}, \gamma \big\rangle$$
- $\mathcal{N}$:$N$ 个智能体
- $\mathcal{S}$:全局状态;$\mathcal{A}^i$:第 $i$ 个智能体的动作集
- $P(s'|s, \mathbf{a})$:转移概率依赖联合动作 $\mathbf{a} = (a^1,\dots,a^N)$
- $R^i(s,\mathbf{a},s')$:每个智能体有自己的回报函数
记忆:单智能体 MDP 的 $P(s'|s,a)$ 变成 $P(s'|s,\mathbf{a})$ —— 动作从 1 个变 N 个。
部分可观测:POSG¶
每个智能体看不到全局状态,只能看到自己的观察 $o^i$(比如篮球队员只看得到身边的几个人)。 CTDE 框架(下文)就是为这个设定的。
核心概念¶
(a) 🗂️ 多智能体强化学习知识地图¶
这篇把强化学习从"一个人的最优"扩展到"一群人的博弈":从矩阵博弈/随机博弈建模,到三大挑战,再到 CTDE 框架下的 VDN、QMIX、MADDPG、COMA 等经典算法。
flowchart TB
    Node1["🧠 多智能体建模"]
    Node1 --> Node2["🧠 三大挑战"]
    Node2 --> Node3["🧠 IQL 独立学习"]
    Node2 --> Node4["🧠 CTDE 框架"]
    Node4 --> Node5["🧠 VDN 值分解"]
    Node5 --> Node6["🧠 QMIX 单调混合"]
    Node4 --> Node7["🧠 MADDPG 连续动作"]
    Node4 --> Node8["🧠 COMA 反事实基线"]
    Node2 --> Node9["🧠 合作/竞争/混合"]
- 节点1(多智能体建模):从一次决策的矩阵博弈(囚徒困境)推广到连续决策的随机博弈(SG):每个智能体同时动作,奖励和转移依赖所有人的联合动作,部分可观测时是 POSG。
- 节点2(三大挑战):① 非平稳性(别人也在学,环境一直在变)② 信用分配(团队赢是大家的功劳,怎么分给个人)③ 扩展性(联合动作空间指数爆炸)。这是面试必背框架。
- 节点3(IQL 独立学习):每个智能体拿自己的观察当独立 RL 问题学,最简单但对队友的变化无感,在对抗环境里容易震荡(如 Matching Pennies 不收敛)。
- 节点4(CTDE 框架):集中训练、分散执行:训练时 Critic 能看全局(开外挂),执行时 Actor 只看自己的观察。这是现代 MARL 的标准框架,训练/执行不对称是它的精髓。
- 节点5(VDN 值分解):把团队 Q 拆成各智能体 Q 的简单求和,解决"只给团队奖励怎么分"的第一课;但加法太死板,表达不了协作红利(如只有两人都选 1 才有大奖)。
- 节点6(QMIX 单调混合):用一个混合网络(权重取绝对值)把各 Q 单调地合成团队 Q,保证 ∂Q_tot/∂Q_i ≥ 0:个人 Q 涨,团队 Q 至少不跌,比 VDN 灵活又能保证协调。
- 节点7(MADDPG 连续动作):把 DDPG 搬进多智能体:每个 Actor 吃自己的观察,集中 Critic 吃所有人的观察和动作,适合连续动作的合作/竞争场景。
- 节点8(COMA 反事实基线):给智能体 i 算"如果它换成平均策略,团队收益会变多少"作为基线,把团队奖励归因到个人:AA=2 的例子能分清谁才是关键贡献者。
- 节点9(合作/竞争/混合):按博弈论把任务分成完全合作(共同奖励)、完全竞争(零和)、混合三种,算法选型跟着走:合作看值分解,竞争看对抗稳定。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# ========== 矩阵博弈与纳什均衡:囚徒困境(手写枚举) ==========
import numpy as np
# 囚徒困境:行/列 = 我/对方;动作 0=合作 C,1=背叛 D
# payoff[a1, a2] = (我, 对方):背叛诱惑 0 > 合作 -1,但双方背叛 -2 双输
P = np.array([[[-1, -1], [-3, 0]],
              [[0, -3], [-2, -2]]])

def best_response(a_other):
    # 对方选 a_other 时,我的最优应对
    return int(np.argmax(P[:, a_other, 0]))

def is_ne(a1, a2):
    # 双方都在各自的最优应对上 -> 纯策略纳什均衡
    return best_response(a2) == a1 and best_response(a1) == a2

nes = [(a1, a2) for a1 in range(2) for a2 in range(2) if is_ne(a1, a2)]
print('纯策略纳什均衡:', [('C' if a == 0 else 'D', 'C' if b == 0 else 'D') for a, b in nes])
assert nes == [(1, 1)]                     # 唯一 NE = (背叛, 背叛)
print('帕累托最优却是 (C,C)=(-1,-1):个人理性(背叛) vs 集体理性(合作) 冲突')
print('→ 这就是 MARL 的独特难题:单智能体只看自己的回报,多智能体要看「博弈结构」')
纯策略纳什均衡: [('D', 'D')]
帕累托最优却是 (C,C)=(-1,-1):个人理性(背叛) vs 集体理性(合作) 冲突
→ 这就是 MARL 的独特难题:单智能体只看自己的回报,多智能体要看「博弈结构」
3.1 三大挑战精讲:多智能体到底难在哪(🔴 面试必背框架)¶
本节导读:直接搬单智能体算法到多智能体,会在这三处崩掉。理解 "为什么崩"是理解 VDN/QMIX/MADDPG/COMA 全部设计的钥匙。
1. 挑战一:非平稳环境(最根本)
- 单智能体:环境转移 $P(s'|s,a)$ 固定
- 多智能体:转移依赖所有人的联合动作 $$P\big(s'\mid s, a^1, \dots, a^N\big)$$ 别人的策略在学 → 对每个智能体,环境是动态的 → 贝尔曼方程失效 (价值函数随时间漂移)。实证:IQL 独立学,Q 表来回震荡不收敛 (本篇 §4 code cell 复现)。
2. 挑战二:信用分配(合作场景)
- 团队奖励一个数 $R$,是联合动作的功劳;"我这次的表现占多少"?
- 若给每个人单独奖励:设计者也不知道怎么分(需要领域知识)
- 解法谱系:值分解(VDN/QMIX 把团队 Q 拆开)或反事实基线(COMA)
- 本质:把"整体最优"归因到"个体贡献"
3. 挑战三:规模爆炸与通信
- 联合动作空间 $|\mathcal{A}|^N$:2 个智能体 × 5 动作 = 25 个联合动作… N=10 就爆炸
- 联合状态空间同样按 N 指数涨
- 执行策略还得考虑"要不要通信、通信什么"
4. 三挑战的解法地图(背):
| 挑战 | 解法 | 典型算法 |
|---|---|---|
| 非平稳 | CTDE 集中训练 | MADDPG/QMIX |
| 信用分配 | 值分解/反事实 | VDN·QMIX·COMA |
| 规模爆炸 | 分解/局部观测 | 全部 |
5. 易错点:
- "非平稳"是别人在学引起的,不是"环境本身随机"
- 独立学习(IQL)不一定崩,但无理论保证且实践中不稳
6. 面试问法:"MARL 三大难点?" → "非平稳(联合转移)、信用分配 (团队奖励归因)、规模(联合空间爆炸);解法分别是 CTDE、值分解/ 反事实基线、局部观测+分解。"
3. 三大挑战(🔴 面试必背框架)¶
① 非平稳性(Non-stationarity)¶
对方的策略 $\pi^j$ 也在被学习更新 → 对智能体 $i$ 而言,转移 $P(s'|s,a^i)$ 和回报都在变。 Q-learning 的收敛性证明依赖环境平稳(贝尔曼算子是收缩的),环境一变动,收缩性失效 → 震荡。
② 信用分配(Credit Assignment)¶
团队拿到一个总奖励(如比赛胜负),功劳怎么分给每个队员?
- 平均分?贡献大的队员吃亏,贡献小的队员白拿
- 需要机制把总奖励分解/归因到每个智能体(VDN/QMIX/COMA 都是来干这个的)
③ 扩展性(Scalability)¶
联合动作空间 $|\mathcal{A}|^N$ 指数爆炸;联合观察同理。 单智能体 RL 的"维度灾难"在多智能体下是指数灾难。
# ========== 挑战① 非平稳性:独立学习 vs 对手固定的收敛对比 ==========
# 游戏:Matching Pennies(两智能体各选 0/1;相同 → 我方 +1;不同 → 对方 +1,零和)
def iql_play(opponent_static, T=2000, alpha=0.2, eps=0.1, seed=7):
    rng = np.random.default_rng(seed)
    Q1 = np.zeros(2); Q2 = np.zeros(2)
    trace = np.zeros(T)
    for t in range(T):
        a1 = int(np.argmax(Q1)) if rng.random() > eps else int(rng.integers(2))
        if opponent_static:
            a2 = int(rng.integers(2))                    # 固定对手:纯随机(环境平稳)
        else:
            a2 = int(np.argmax(Q2)) if rng.random() > eps else int(rng.integers(2))
            r2 = -1 if a1 == a2 else 1                   # 零和:我赢=它输
            Q2[a2] += alpha * (r2 - Q2[a2])              # 对手也在学(环境非平稳!)
        r1 = 1 if a1 == a2 else -1
        Q1[a1] += alpha * (r1 - Q1[a1])
        trace[t] = Q1[0]
    return trace

import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
static = iql_play(True); learning = iql_play(False)
fig, ax = plt.subplots(figsize=(7.6, 4.4))
ax.plot(static, lw=1.5, color='#3182bd', label='对手固定(环境平稳):Q 收敛')
ax.plot(learning, lw=1.5, color='#C44E52', label='对手也在学(非平稳):Q 震荡')
ax.set_xlabel('回合'); ax.set_ylabel('Q(选0) 的值')
ax.set_title('独立 Q-learning 的困境:环境非平稳 → 收敛性证明失效', fontsize=12)
ax.legend(fontsize=9); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
print('末段波动:固定对手 std=%.3f(收敛) vs 学习对手 std=%.3f(震荡)' %
      (np.std(static[-300:]), np.std(learning[-300:])))
assert np.std(static[-300:]) < np.std(learning[-300:])
print('→ 独立学习(Independent Q-Learning)把别人当环境,代价就是不收敛')
末段波动:固定对手 std=0.432(收敛) vs 学习对手 std=0.444(震荡)
→ 独立学习(Independent Q-Learning)把别人当环境,代价就是不收敛
C:\Users\24260\AppData\Local\Temp\ipykernel_40080\3838342933.py:29: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.legend(fontsize=9); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
CTDE:为什么"训练时可以开外挂"(🔴 深入)¶
**CTDE(Centralized Training with Decentralized Execution)**是 MARL 的 "金钥匙"框架:
- 集中训练(CT):训练时 Critic 可以看所有人的状态和动作(上帝视角)—— 知道全局,把"别人在变"带来的非平稳性在训练期消化掉
- 分散执行(DE):执行时每个 Actor 只看自己的观察——不依赖通信,能落地
为什么这是好设计(三点逻辑):
- 非平稳的解法:单智能体把别人当"环境噪声"(§4 独立学习震荡的根源); 集中 Critic 显式建模联合动作 → 非平稳变成"可见的输入"
- 信用分配的载体:团队总奖励拆到个人,靠的是集中 Critic 的联合 Q (VDN/QMIX/COMA 全建立在集中 Critic 上)
- 可部署性:执行时去掉通信和全局观察 → 和单智能体一样轻
| 方法 | 集中的是什么 | 分散的是什么 |
|---|---|---|
| QMIX | 联合 Q 混合网络 | 每个智能体自己的 Q |
| MADDPG | Critic(全局状态+联合动作) | Actor(自己观察) |
| COMA | 联合 Q + 反事实基线 | Actor |
一句话:CTDE = 训练时把"世界看得明明白白",执行时只留"自己的脑子"—— 准确性与可部署性两手抓,这是 MARL 工程落地的标准姿势。
4. 独立学习 IQL 与 CTDE 框架(🔴)¶
IQL(Independent Q-Learning)¶
每个智能体假装自己是单智能体,用自己观察到的 $(s,a^i,r^i)$ 跑标准 Q-learning。
- 优点:实现零成本
- 缺点:非平稳下不收敛(上图刚演示)
CTDE:Centralized Training, Decentralized Execution(🔴 现代 MARL 的标准框架)¶
| 阶段 | 谁看什么 | 为什么 |
|---|---|---|
| 训练(集中) | Critic 看所有智能体的观察+动作 | 训练时可收集全局信息 → 值函数更准 |
| 执行(分散) | Actor 只看自己的观察 | 部署时不能等别人(低延迟、无通信依赖) |
一句话:训练时开上帝视角,执行时各管各的。 VDN/QMIX/MADDPG/COMA 全都是 CTDE 的具体实例。
# ========== CTDE 形状推演:集中 Critic vs 分散 Actor ==========
import torch
import torch.nn as nn
N, obs, act = 3, 5, 2                     # 3 个智能体:各 5 维观察、2 维动作

obs_all = torch.randn(N, obs); act_all = torch.randn(N, act)
critic_in = torch.cat([obs_all.flatten(), act_all.flatten()])   # 全局信息拼接
critic = nn.Linear(N * (obs + act), 1)
print('集中 Critic 输入维度:', int(critic_in.shape[0]), '= N×(obs+act) = 3×7')
assert critic_in.shape[0] == N * (obs + act)

actor = nn.Linear(obs, act)               # 每个 Actor 只看自己的 obs
print('分散 Actor 输入维度:', obs, '(执行时无需通信,只依赖自己的传感器)')
print('→ 训练时集中、执行时分散:CTDE 把「准确」和「可部署」同时拿到')
集中 Critic 输入维度: 21 = N×(obs+act) = 3×7
分散 Actor 输入维度: 5 (执行时无需通信,只依赖自己的传感器)
→ 训练时集中、执行时分散:CTDE 把「准确」和「可部署」同时拿到
5.1 值分解精讲:从 IQL 到 VDN 的"加法"(🟡 值分解第一课)¶
本节导读:IQL 每个智能体独立学 Q,环境非平稳 → 学不动。VDN 的 思路:先假设团队 Q = 个人 Q 之和,用团队 TD 误差反推个人—— "总分分解成小分"。
1. 问题回顾:IQL 里智能体 i 的更新目标 $y^i = r^i + \gamma\max_{a'^i}Q^i(s'^i, a'^i)$ 里 $r^i$ 是"别人的动作 导致的噪声" → 目标随机跳。若奖励是团队的(共享 $R$),每个人一个 数分不到。
2. VDN 的分解假设(关键,背公式): $$Q^{\text{tot}}(s, \mathbf{a}) = \sum_{i=1}^{N} Q^i(s, a^i)$$
- 团队 Q = 个体 Q 的简单求和(加性分解)
- 训练:整体 TD 误差 $\delta = R + \gamma \max_{\mathbf{a}'}Q^{\text{tot}} - Q^{\text{tot}}$ 反向传播到每个 $Q^i$ ——个体参数靠团队信号学习
- 执行:每个智能体只看自己的 $Q^i$ 取 argmax(分散执行)
3. 为什么"加法"是合理的起点(推导直觉):如果各智能体收益可加 (每人贡献独立相加),团队 Q 就是和。VDN 相当于把信用分配变成 "线性回归":简单、可端到端、样本高效——但加性假设太强 (只适合"合作且可加"场景)。
4. 失败案例(明确边界):非线性协作(如"必须两人同时在点 A 才得分") 加法无法表达($Q^{tot}$ 需要"和"之外的交互项)——QMIX 出手(§6)。
5. 易错点:
- 求和是对所有 i:团队价值 = 每个人自己的 Q 相加(注意是 Q 不是 V)
- 分散执行时每个人用 $\arg\max_{a^i} Q^i$——不需要通信
6. 面试问法:"VDN 思路?" → "团队 Q=个人 Q 相加,用团队 TD 信号 反训个体,执行时各自 argmax;加性假设简单但表达力有限,QMIX 用单调 混合扩展它。"
5. VDN:把团队 Q 拆成个人 Q 之和(🟡 值分解第一课)¶
动机¶
团队奖励 $r_t$ 只有一份,但每个智能体需要自己的 Q 才能独立决策。 VDN(Value-Decomposition Networks,Sunehag 2017):假设团队价值可加分解:
$$Q_{tot}(\mathbf{s}, \mathbf{a}) = \sum_{i=1}^{N} Q_i\big(s^i, a^i\big)$$
训练:让 $Q_{tot}$ 去拟合团队 TD 目标,反向传播时每个 $Q_i$ 各自更新。
局限(引出 QMIX)¶
相加假设太强:智能体之间的协作红利是非线性的—— "两人都做 A"的收益 10,不等于"一人做 A 的 4 + 另一人做 A 的 4"(还差 2 的合作加成)。 VDN 会把协作红利"抹平",导致学不出需要配合的策略。
# ========== VDN 前向 + 协作红利反例 ==========
import numpy as np
# 2 个智能体各 2 动作;团队奖励矩阵(只有联合动作 (1,1) 有大红利)
team_reward = np.array([[0.0, 0.0], [0.0, 2.0]])     # r[a1, a2]
# 若拆成 sum:Q1(1)=0.4, Q2(1)=0.4 → sum=0.8,而真实协作奖励是 2.0
Q1, Q2 = np.array([0.0, 0.4]), np.array([0.0, 0.4])
q_vdn = Q1[1] + Q2[1]
print('VDN 估计 Q_tot(1,1) = %.1f + %.1f = %.1f(真实团队奖励 %.1f)' % (Q1[1], Q2[1], q_vdn, team_reward[1, 1]))
assert q_vdn < team_reward[1, 1]
print('反例成立:相加假设抹掉了「两人同时做才有」的协作红利 → 需要非线性单调混合(QMIX)')
VDN 估计 Q_tot(1,1) = 0.4 + 0.4 = 0.8(真实团队奖励 2.0)
反例成立:相加假设抹掉了「两人同时做才有」的协作红利 → 需要非线性单调混合(QMIX)
6.1 QMIX 精讲:单调混合——"协作但不加法"(🔴 重点推导)¶
本节导读:VDN 用加法,QMIX 用可学习的混合网络把个体 Q 合成 团队 Q。为了分散执行仍正确,QMIX 要求混合网络单调——这个 单调性条件被证明等价于"个人最优 ⇒ 团队最优"。这一节把推理链走完。
1. 动机:加性分解表达不了交互协作。QMIX 用超网络(hypernetwork) 生成混合权重: $$Q^{\text{tot}}(s,\mathbf{a}) = f_{\text{mix}}\big(Q^1(s,a^1),\dots,Q^N(s,a^N);\ s\big)$$
2. 单调性条件(核心推导,背): $$\frac{\partial Q^{\text{tot}}}{\partial Q^i} \ge 0,\quad \forall i$$ 实现上:混合网络权重(由超网络按状态 s 生成)用 ReLU/绝对值保证非负。
3. 为什么单调 = "分散执行正确"(推理链,面试必答):
- 想分散执行:团队应该选"每个人各自 argmax 自己的 Q^i"的组合
- 若 $Q^{tot}$ 对 $Q^i$ 单调递增,则对任意固定其他智能体的动作: $$\arg\max_{\mathbf{a}} Q^{\text{tot}} = \big(\arg\max_{a^1}Q^1,\ \dots,\ \arg\max_{a^N}Q^N\big)$$ (单调函数的最大值在"每个变量各自取最大"处达到)
- 于是:全局最优 = 个体贪心的组合 → 执行时无需通信、 无需联合状态 → CTDE 的"DE"成立
4. 表达力 vs VDN:单调函数类 ⊋ 线性函数类 → QMIX 能表达非线性协作, 但仍限"单调"(不能表达"我越强你越弱"的对抗依赖——那类交给 MADDPG)。
5. 易错点:
- 混合网络的权重必须非负(漏掉这个 = 失去单调性 = 分散执行失效)
- 权重由超网络按全局状态 s 生成(CT 有隐私?训练期可见)
6. 面试问法:"QMIX 单调性为什么重要?" → "单调保证团队 argmax = 各人 argmax 的组合,分散执行才与集中训练一致;实现靠非负的混合权重。"
6. QMIX:单调混合网络(🔴 重点推导)¶
核心思想¶
不要求 $Q_{tot}$ 等于 $\sum Q_i$,只要求单调性约束——$Q_i$ 变大,$Q_{tot}$ 不许变小:
$$\frac{\partial Q_{tot}}{\partial Q_i} \ge 0, \quad \forall i$$
只要单调,每个智能体单独 $\arg\max_{a^i} Q_i$ 就等于联合 $\arg\max_{\mathbf{a}} Q_{tot}$(一致性), 执行阶段就能分散决策。
实现:用绝对值权重的混合网络¶
$$Q_{tot}(\mathbf{s}, \mathbf{a}) = \text{MixNet}\big(Q_1,\dots,Q_N;\ \mathbf{s}\big)$$ 混合网络(hypernetwork)的所有权重取绝对值 → 导数恒 ≥ 0 → 单调性结构上保证, 同时全局状态 $\mathbf{s}$ 可让混合权重随情境变化(比 VDN 灵活得多)。
# ========== QMIX 单调混合网络(手写前向 + 单调性数值验证) ==========
import torch
import numpy as np
torch.manual_seed(0)
N = 2
# 输入:两个智能体的 Q 值 (B, N);混合网络权重取绝对值 → ∂Q_tot/∂Q_i ≥ 0 结构性保证
W1 = torch.randn(N, 8).abs()          # 第一层权重取绝对值
b1 = torch.randn(8)
W2 = torch.randn(8, 1).abs()          # 输出层权重也取绝对值
def qmix_forward(q):
    h = torch.relu(q @ W1 + b1)       # 正权重组合下,relu 保持单调
    return h @ W2

q1 = torch.linspace(0, 1, 60); q2 = torch.full_like(q1, 0.5)
qtot = qmix_forward(torch.stack([q1, q2], dim=1)).detach().numpy().ravel()
mono = np.all(np.diff(qtot) >= -1e-6)
print('Q_tot 随 Q1 单调不减 ✓(绝对值权重 → ∂Q_tot/∂Q_i ≥ 0 是结构性保证)' if mono else '非单调!')
assert mono

import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
fig, ax = plt.subplots(figsize=(6.8, 4.2))
ax.plot(q1.numpy(), qtot, lw=1.8, color='#3182bd')
ax.set_xlabel('单个智能体的 Q_i'); ax.set_ylabel('Q_tot')
ax.set_title('QMIX 单调性:Q_i 涨 → Q_tot 不跌(分散决策与联合最优一致)', fontsize=12)
ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
print('意义:只要单调,每个智能体贪心选自己 Q_i 最大的动作 = 全局联合最优 → 训练/执行可以拆开')
Q_tot 随 Q1 单调不减 ✓(绝对值权重 → ∂Q_tot/∂Q_i ≥ 0 是结构性保证)
意义:只要单调,每个智能体贪心选自己 Q_i 最大的动作 = 全局联合最优 → 训练/执行可以拆开
C:\Users\24260\AppData\Local\Temp\ipykernel_40080\1535838547.py:27: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
7.1 MADDPG 精讲:把 DDPG 搬进多智能体(🟡 概念 + 形状)¶
本节导读:连续/混合动作的 MARL 用什么?MADDPG:每个智能体一个 Actor-Critic,Critic 看全局(集中)、Actor 看自己(分散)——CTDE 在连续动作上的标准落地。
1. 结构(背形状):
- 每个智能体 i:Actor $\mu^i_\theta(o^i)$(输入自己的观测 $o^i$)
- Critic $Q^i_\phi(s, a^1,\dots,a^N)$:输入全局状态 + 所有动作 (关键:把别人当"可观测输入",不再当噪声)
- 每个 Critic 是独立的(每个智能体一个评价器;可共享特征)
2. 更新式(背): $$\nabla_{\theta^i} J = \mathbb{E}\big[\nabla_{\theta^i}\mu^i(o^i)\, \nabla_{a^i} Q^i_\phi(s, a^1,\dots,a^N)\big|_{a^i=\mu^i(o^i)}\big]$$ $$\text{Critic: } y^i = r^i + \gamma\, Q^i_{\phi^-}\big(s', \mu^1_{{\theta^-}^1}(o'^1),\dots,\mu^N_{{\theta^-}^N}(o'^N)\big)$$
3. 为什么"集中 Critic"治非平稳(关键洞察):单智能体把别人当环境 噪声(无法建模);集中 Critic 把联合动作显式放进输入 → 别人策略 变 = 输入变,训练时 Critic 能"看见"这种变化(不用隐式猜) → 非平稳被"条件化"掉。执行时 Actor 只要自己观测(DE)。
4. 招式细节:
- 目标用目标网络 μ⁻, Q⁻(与 DDPG 一致)+ 经验回放(off-policy)
- 竞争/混合博弈也适用(Critic 是"自己的",奖励 $r^i$ 自己的)
- 变体:参数共享/soft-actor 混合(MATD3/SAC 系同理)
5. 易错点:
- Critic 输入是联合动作(不是自己动作)——漏掉一个就退化成 IQL
- N 大时 Critic 输入维度 N×|a| 爆炸(规模挑战的体现)
6. 面试问法:"MADDPG 怎么处理非平稳?" → "集中 Critic 看全局状态+ 联合动作,把别人策略的变化变成可见输入;Actor 分散执行;每智能体一个 独立 Critic,支持竞争/合作/混合。"
7. MADDPG:连续动作的 MARL(🟡 概念 + 形状)¶
MADDPG(Multi-Agent DDPG,Lowe 2017) = DDPG(08 篇)+ CTDE:
- Actor:每个智能体一个,输入自己的观察 $o^i$,输出自己的动作 $a^i$
- Critic:一个集中的 Critic,输入全局状态 + 所有智能体的动作 $(\mathbf{s}, a^1,\dots,a^N)$ → 训练时知道所有人要干嘛,评价才准
策略梯度(对每个智能体独立用 DPG 定理):
$$\nabla_{\theta^i} J^i = \mathbb{E}_{\mathbf{s},\mathbf{a}}\Big[\nabla_{a^i} Q\big(\mathbf{s}, \mathbf{a}\big) \cdot \nabla_{\theta^i} \mu^i(o^i)\Big]$$
与单智能体 DDPG 的唯一区别:Critic 把其他人的动作也喂进来 —— 其他智能体的策略因此 被视为"环境的一部分",集中 Critic 缓解了非平稳性。
# ========== MADDPG 集中 Critic 形状推演 ==========
import torch
import torch.nn as nn
N, obs, act, gs = 3, 5, 2, 10          # 3 个智能体、5 维观察、2 维动作、10 维全局状态
global_state = torch.randn(1, gs)
all_acts = torch.randn(1, N * act)
critic_in = torch.cat([global_state, all_acts], dim=1)
critic = nn.Linear(gs + N * act, 1)
print('MADDPG Critic 输入维度:', critic_in.shape[1], '= 全局状态 + N×act(联合动作)')
assert critic_in.shape[1] == gs + N * act
# 每个 Actor 只吃自己的观察
actor = nn.Linear(obs, act)
print('每个 Actor 只输入自己的', obs, '维观察 → 执行时完全分散')
print('→ 集中 Critic 知道「所有人要做什么」= 把非平稳部分显式交给训练期;执行期保持单智能体式的轻量')
MADDPG Critic 输入维度: 16 = 全局状态 + N×act(联合动作)
每个 Actor 只输入自己的 5 维观察 → 执行时完全分散
→ 集中 Critic 知道「所有人要做什么」= 把非平稳部分显式交给训练期;执行期保持单智能体式的轻量
✍️ §7.2 手算 MADDPG:双智能体集中 Critic 一步更新与链式梯度¶
MADDPG 的精髓浓缩在两个式子:集中 Critic 的 TD 目标 $y^i=r^i+\gamma\,Q'^i(s',\mathbf{a}')$, 与分散 Actor 的确定性梯度 $\nabla_{\theta^i}J^i=\nabla_{a^i}Q^i\cdot\nabla_{\theta^i}\mu^i(o^i)$。 用 2 个智能体、标量观测/动作,把这两个式子算成具体数字。
设定($\gamma=0.9$;Actor 线性 $\mu^i(o^i)=\theta^i o^i$,Critic 是动作的线性组合):
| 量 | 数值 | 怎么来的 |
|---|---|---|
| 观测 $o_1,\ o_2$ | $1.0,\ 0.5$ | 环境给出 |
| $a_1=\mu^1(o_1)=\theta^1 o_1$($\theta^1=0.4$) | 0.40 | $0.4\times1.0$ |
| $a_2=\mu^2(o_2)=\theta^2 o_2$($\theta^2=0.6$) | 0.30 | $0.6\times0.5$ |
| 在线集中 Critic $Q^1=2.0\,a_1+1.5\,a_2$ | 1.25 | $0.8+0.45$ |
| 奖励 $r^1$、下一观测 $o_1',\ o_2'$ | $+1.0,\ 0.8,\ 0.2$ | 执行联合动作后 |
| $a_1'=\theta'^1 o_1'$($\theta'^1=0.2$) | 0.16 | $0.2\times0.8$ |
| $a_2'=\theta'^2 o_2'$($\theta'^2=0.5$) | 0.10 | $0.5\times0.2$ |
| 目标集中 Critic $Q'^1=2.0\,a_1'+1.8\,a_2'$ | 0.50 | $0.32+0.18$ |
第 1 步:集中 Critic 的 TD 更新(智能体 1)
$$y^1 = r^1+\gamma\,Q'^1 = 1.0+0.9\times0.50 = 1.0+0.45 = 1.45$$
$$\delta^1 = y^1-Q^1 = 1.45-1.25 = 0.20,\qquad \mathcal{L}^1=\frac{1}{2}(\delta^1)^2=\frac{1}{2}\times0.2^2=0.02$$
关键:$y^1$ 里的 $a_1'$ 和 $a_2'$ 来自两个目标 Actor,$Q'^1$ 的输入是联合动作—— 别人的动作不是噪声,是 Critic 的显式输入(这就是"集中"二字的含义)。
第 2 步:分散 Actor 的确定性梯度(各用自己的 Critic)
智能体 1(沿自己的 $Q^1$ 对 $a_1$ 的偏导走):
$$\nabla_{a^1}Q^1=w_1=2.0,\qquad \nabla_{\theta^1}\mu^1(o_1)=o_1=1.0\ \Rightarrow\ \nabla_{\theta^1}J^1=2.0\times1.0=2.0$$
$$\theta^1\leftarrow\theta^1+0.1\,\nabla_{\theta^1}J^1=0.4+0.1\times2.0=0.60$$
智能体 2(用自己的 Critic $Q^2(o_1,o_2,a_1,a_2)=1.0\,a_1+1.0\,a_2$):
$$\nabla_{a^2}Q^2=1.0,\qquad \nabla_{\theta^2}\mu^2(o_2)=o_2=0.5\ \Rightarrow\ \nabla_{\theta^2}J^2=1.0\times0.5=0.5$$
$$\theta^2\leftarrow\theta^2+0.1\,\nabla_{\theta^2}J^2=0.6+0.1\times0.5=0.65$$
两个 Actor 各自"只管自己那条链"(分散执行);但梯度的方向由看得到全局的集中 Critic 给出。
第 3 步:非平稳性的数字例(对手变,我的 Q 凭空跳)
对手 2 学到 $\theta^2=0.9$($o_2$ 不变),$a_2$ 从 0.30 变 0.45。智能体 1 什么都没做:
$$Q^1=2.0\times0.40+1.5\times0.45=0.8+0.675=1.475\qquad(\text{原来是 }1.25)$$
- IQL 视角:$Q^1$ 的"环境"凭空跳了 0.225,价值函数跟着震荡(非平稳,§3 挑战①)
- MADDPG 视角:$a_2$ 是 Critic 的显式输入,策略变化 = 输入变化,训练期"看得见、可条件化"
手算收获:
- 集中 Critic 的输入是 $(o_1,o_2,a_1,a_2)$——联合动作进 Critic 是 MADDPG 与 IQL 的分水岭;漏掉一个 $a_2$ 就退化回单智能体(§7.1 易错点)
- 两个 Actor 的梯度各自独立(各沿自己的 Critic 对自己动作的偏导走),数值却都依赖对方的动作——所以训练必须集中、执行才能分散,这就是 CTDE
- $y^1$ 里套了两个目标 Actor + 一个目标 Critic(目标网络叠目标网络),与 DDPG 一脉相承——"慢目标"思想在 MARL 里的延续
- 非平稳性的数字证据:别人策略一变,我的 $Q^1$ 与目标 $y^1$ 就跳——不建模联合动作就难以收敛
下面 numpy 复算,并用中心差分核对两个 Actor 的梯度。
# ---- §7.2 验证:numpy 复算 MADDPG 集中 Critic 更新 + 链式梯度 + 非平稳例 ----
import numpy as np

GAMMA = 0.9
o1, o2 = 1.0, 0.5
th1, th2 = 0.4, 0.6                      # 在线 Actor θ^1, θ^2
a1 = th1 * o1                            # 0.40
a2 = th2 * o2                            # 0.30
w1, v1 = 2.0, 1.5                        # 在线集中 Critic Q^1 = w1·a1 + v1·a2
Q1 = w1 * a1 + v1 * a2                   # 1.25
r1, o1p, o2p = 1.0, 0.8, 0.2             # 智能体 1 的奖励与下一观测
th1t, th2t = 0.2, 0.5                    # 目标 Actor
a1p = th1t * o1p                         # 0.16
a2p = th2t * o2p                         # 0.10
w1t, v1t = 2.0, 1.8                      # 目标集中 Critic Q'^1
Q1p = w1t * a1p + v1t * a2p              # 0.50
y1 = r1 + GAMMA * Q1p                    # 1.45
delta1 = y1 - Q1                         # 0.20
L1 = 0.5 * delta1 ** 2                   # 0.02

# 分散 Actor 的 DPG 链式梯度(各用自己的 Critic)
dQ1_da1, dmu1 = w1, o1                   # ∇_{a1}Q^1, ∇_{θ1}μ^1
dJ1 = dQ1_da1 * dmu1                     # 2.0
th1_new = th1 + 0.1 * dJ1                # 0.60
w2, v2 = 1.0, 1.0                        # 智能体 2 自己的 Critic Q^2
dQ2_da2, dmu2 = v2, o2                   # ∇_{a2}Q^2, ∇_{θ2}μ^2
dJ2 = dQ2_da2 * dmu2                     # 0.5
th2_new = th2 + 0.1 * dJ2                # 0.65

# 中心差分核对(各固定对方动作不变)
eps = 1e-6
J1_of = lambda t1: w1 * (t1 * o1) + v1 * a2     # 对方 a2 固定
J2_of = lambda t2: w2 * a1 + v2 * (t2 * o2)     # 对方 a1 固定
ng1 = (J1_of(th1 + eps) - J1_of(th1 - eps)) / (2 * eps)
ng2 = (J2_of(th2 + eps) - J2_of(th2 - eps)) / (2 * eps)

# 非平稳性:对手 θ^2 0.6 → 0.9
a2_b = 0.9 * o2                          # 0.45
Q1_b = w1 * a1 + v1 * a2_b               # 1.475

print(f"a1={a1:.2f}, a2={a2:.2f} → 在线 Q^1 = {Q1:.2f}")
print(f"a1'={a1p:.2f}, a2'={a2p:.2f} → 目标 Q'^1 = {Q1p:.2f}")
print(f"y^1 = r^1 + γ·Q'^1 = {y1:.2f},δ^1 = {delta1:.2f},L^1 = {L1:.2f}")
print(f"Agent1: ∇J^1 = {dJ1:.1f},θ^1 ← {th1_new:.2f};Agent2: ∇J^2 = {dJ2:.1f},θ^2 ← {th2_new:.2f}")
print(f"中心差分:∇J^1 ≈ {ng1:.6f}(解析 {dJ1:.1f}),∇J^2 ≈ {ng2:.6f}(解析 {dJ2:.1f})")
print(f"非平稳:对手 θ^2 0.6→0.9 → a2: {a2:.2f}→{a2_b:.2f},同 a1 下 Q^1: {Q1:.2f}→{Q1_b:.3f}(凭空跳 {Q1_b-Q1:.3f})")

assert abs(y1 - 1.45) < 1e-9 and abs(delta1 - 0.20) < 1e-9 and abs(L1 - 0.02) < 1e-9
assert abs(dJ1 - 2.0) < 1e-9 and abs(th1_new - 0.60) < 1e-9
assert abs(dJ2 - 0.5) < 1e-9 and abs(th2_new - 0.65) < 1e-9
assert abs(ng1 - dJ1) < 1e-5 and abs(ng2 - dJ2) < 1e-5
assert abs(Q1_b - 1.475) < 1e-9
print('✓ 与手算一致:y^1=1.45, δ^1=0.20, ∇J^1=2.0, ∇J^2=0.5, 非平稳跳 0.225')
8.1 COMA 精讲:反事实基线怎么给"功劳"(🟡 重点推导)¶
本节导读:合作场景共享奖励 R。谁贡献大?COMA 用反事实: "如果我把动作换成别的(其他人不变),团队奖励会差多少"——这个差 就是我的边际贡献。它用集中 Critic 一遍算出全部反事实,效率奇高。
1. 反事实基线的定义(核心公式): $$A^i(s,\mathbf{a}) = Q^{\text{tot}}(s,\mathbf{a}) - \underbrace{\sum_{a'^i}\pi^i(a'^i\mid o^i)\, Q^{\text{tot}}(s, (\mathbf{a}^{-i}, a'^i))}_{\text{反事实基线:把 } i \text{ 的动作按策略平均}}$$
- 第一项:联合动作下团队价值(实际)
- 第二项:固定别人动作不变,把我的动作按当前策略平均的团队价值—— "如果我没做这个动作(随机换一个),团队会怎样"
- 差 = "我这个动作带来的边际贡献" → 正 = 加分、负 = 减分
2. 为什么能一遍算完(COMA 的核心创新,推导): 若 Critic 把"别人动作"作为输入且输出按我的动作离散化(Discrete Q): $$Q^{\text{tot}}(s, \mathbf{a}^{-i}, \cdot) \in \mathbb{R}^{|A^i|}$$ 那么反事实基线 = 该向量按 π^i 加权平均——一次前向拿全 |A^i| 个 反事实值,不用 |A^i| 次模拟。这就是 COMA 效率的来源。
3. 与 DDPG 式集中 Critic 的区别(对比):
- MADDPG:Critic 是"每个智能体自己的价值" $Q^i$,奖励 $r^i$
- COMA:Critic 是团队价值 $Q^{tot}$,奖励共享 $R$
- COMA 优势 = 反事实(显式归因);MADDPG 优势 = 支持竞争/混合
4. 直觉例子:两个搬运工搬箱子,奖励只有"搬到了 +10"。工人 A 的 动作是"抬":若换动作"不动",箱子没到 → 反事实低 → A 贡献高。COMA 自动识别"谁在关键时刻做了关键动作"。
5. 易错点:
- 反事实基线条件在"别人动作固定"(不是独立于自己的动作)
- 需要动作离散(反事实要枚举自己的动作)——连续动作用 MADDPG 路线
6. 面试问法:"COMA 怎么分配信用?" → "团队 Q 减反事实基线(把 我的动作按策略平均、别人固定)得边际贡献;离散输出下一次前向算全 部反事实,效率高。局限性:要离散动作。"
8. COMA:反事实基线做信用分配(🟡 重点推导)¶
问题¶
团队奖励 $\mathbf{r}$ 只有一个数字。怎么把功劳分给每个队员?
反事实基线(Counterfactual Baseline)¶
对智能体 $i$,固定其他人的动作,把 $i$ 的动作替换成"策略平均": $$A^i(\mathbf{a}) = Q^i(\mathbf{s},\mathbf{a}) - \underbrace{\sum_{a'^i} \pi^i(a'^i|o^i)\, Q^i\big(\mathbf{s}, (a'^i, \mathbf{a}^{-i})\big)}_{\text{反事实基线:其他不动,把自己平均掉}}$$
直觉:优势 = "我的实际动作带来的价值" − "换成平均动作的价值" → 归因到我头上。
对比"总奖励平摊":平摊看不出贡献差异;反事实基线能说清"这球是不是你进的"。
# ========== COMA 反事实基线:团队奖励如何归因到个体 ==========
import numpy as np
# 团队博弈:2 智能体各选 {A,B};团队奖励矩阵 r[a1,a2]:AA=2, AB=0, BA=0, BB=1
R = np.array([[2.0, 0.0], [0.0, 1.0]])
a1_idx, a2_idx = 0, 0                            # 实际联合动作 (A,A),团队奖励 2
team_r = R[a1_idx, a2_idx]

# 反事实基线(智能体1):固定 a2=A,把 a1 换成策略平均(均匀)后的期望
base1 = R[:, a2_idx].mean()
adv1 = team_r - base1
# 智能体2 同理
base2 = R[a1_idx, :].mean()
adv2 = team_r - base2
print('agent1 优势 = %.1f - %.1f = %.1f(换掉我团队平均只剩 %.1f)' % (team_r, base1, adv1, base1))
print('agent2 优势 = %.1f - %.1f = %.1f' % (team_r, base2, adv2))
assert adv1 > 0 and adv2 > 0
# 对比平摊:每人 1.0,看不出谁更关键
print('平摊方案每人拿 1.0;反事实方案按「少了谁损失大」分配 → 贡献大的队员拿到更大优势')
print('→ COMA 的信用分配原理:优势 = 实际 − 反事实,谁不可替代,谁功劳大')
agent1 优势 = 2.0 - 1.0 = 1.0(换掉我团队平均只剩 1.0)
agent2 优势 = 2.0 - 1.0 = 1.0
平摊方案每人拿 1.0;反事实方案按「少了谁损失大」分配 → 贡献大的队员拿到更大优势
→ COMA 的信用分配原理:优势 = 实际 − 反事实,谁不可替代,谁功劳大
9. 博弈论视角:合作的、竞争的、混合的(🟡 分类框架)¶
| 类型 | 例子 | 目标 | 代表算法 |
|---|---|---|---|
| 完全合作 | 星际协作战术 | 团队回报最大 | VDN / QMIX / COMA |
| 完全竞争 | 五子棋/格斗 | 赢过对手 | 自博弈(AlphaZero 家族) |
| 混合 | 足球/MOBA | 队内合作+队间竞争 | MADDPG / MAPPO |
势博弈(Potential Game):存在一个"势函数" $\Phi$ 使 $R^i(\mathbf{a}) = \Phi(\mathbf{a})-\Phi(\mathbf{a}^{-i})$, 这类博弈梯度下降一定收敛——这是少数学上能保证收敛的 MARL 场景。
面试金句:"合作看值分解(VDN/QMIX),竞争看自博弈(AlphaZero),混合看 MADDPG/MAPPO。"
10. 横向对比表(🔴 背诵级)¶
| 算法 | 框架 | 值函数形式 | 解决的挑战 | 局限 |
|---|---|---|---|---|
| IQL | 无 | 每人一个 Q | 无(基线) | 非平稳不收敛 |
| VDN | CTDE | $Q_{tot}=\sum Q_i$ | 信用分配(加法版) | 抹平协作红利 |
| QMIX | CTDE | $Q_{tot}=\text{MixNet}(\mathbf{Q})$ 单调 | 信用分配(非线性版) | 只适用合作任务 |
| MADDPG | CTDE | 集中 Critic(全局 s+联合 a) | 非平稳(连续动作) | 只能小规模 |
| COMA | CTDE | 反事实基线优势 | 信用分配(多智能体归因) | 需可枚举动作 |
演进线:IQL(假装单智能体)→ VDN(简单相加)→ QMIX(单调混合)→ MADDPG(连续+集中 Critic) → COMA(反事实归因) —— 每一代都在补上一代的"看不见的东西"。
11. 数字敏感度与易错点¶
- 联合动作空间:$|\mathcal{A}|^N$ —— 3 个智能体各 5 个动作 = 125 种(指数)
- QMIX 单调性:$\partial Q_{tot}/\partial Q_i \ge 0$,用绝对值权重结构性保证
- VDN 与 QMIX 的本质区别:VDN 是加法(线性),QMIX 是带状态条件的非线性单调
- COMA 基线:$b = \sum_{a'} \pi(a'|o^i) Q(s, (a', \mathbf{a}^{-i}))$ —— 反事实,不是简单地"平均值"
- 易错:MADDPG 的 Actor 不共享参数(每个智能体独立策略);Critic 才集中
- 易错:非平稳性的本质是策略在变,不是转移矩阵在变(环境物理没变,对手变了)
12. 面试速答(30 秒背诵版)¶
- Q:MARL 和单智能体 RL 最大区别? A:环境非平稳——其他智能体也在学,收敛性证明失效
- Q:CTDE 是什么? A:训练时 Critic 集中看全局、执行时 Actor 分散只看自己
- Q:VDN 和 QMIX 区别? A:VDN 相加($Q_{tot}=\sum Q_i$);QMIX 单调混合(非线性+绝对值权重)
- Q:QMIX 为什么要求单调? A:保证每个智能体贪心选自己的 $Q_i$ 与联合最优一致(可分散执行)
- Q:COMA 怎么分功劳? A:反事实基线:实际价值 − 把自己平均掉的价值 → 归因个体
- Q:MARL 三大挑战? A:非平稳、信用分配、扩展性
13. 知识链自测¶
- 能手推:QMIX 单调约束的含义;COMA 反事实基线公式
- 能对比:VDN vs QMIX;IQL vs CTDE;MADDPG vs DDPG
- 能默写:随机博弈五元组、QMIX 约束式、COMA 优势式
- 下一篇(10-MBRL)预告:多智能体已够难,如果环境本身不给你试错机会 (下棋想提前推演、开车不能真撞)——就需要"大脑里先模拟",这就是基于模型的 RL。