📚 10-03 · RNN 与 LSTM:让网络"记住上文"¶
目标:学完本篇你能——
- 说清为什么定长窗口 / 词袋不够用,RNN 如何用「参数共享 + 递推隐藏状态」建模任意长序列;
- 徒手推导 RNN 前向($h_t,\ y_t$)与 BPTT 三条梯度链($\partial L/\partial W_{hh},\ W_{xh},\ W_{hy}$);
- 用数值梯度证明手写 BPTT 正确(误差 <1e-6);
- 推导 LSTM 四门($f/i/g/o$)与细胞状态加性更新,解释「梯度高速公路」与遗忘门偏置≈1 的原因;
- 手写 LSTM / GRU 前向并和
torch.nn.LSTM / torch.nn.GRU对照(<1e-5);- 亲手训练一个字符级 RNN 学会"接话",并理解采样温度 $T$ 对生成质量的影响。
🧭 主线位置:01-n-gram(统计语言模型)→ 02-Word2Vec(静态词向量)→ 本篇 RNN / LSTM(序列建模) → 04-Attention 与 Transformer(并行注意力)。
🧩 生活化类比:RNN = 一个边读边记笔记的人——每读一个词就更新一次「笔记」(隐藏状态),下一个词的判断只依赖最新笔记。LSTM 是升级版:他有三支笔——遗忘笔(丢旧事)、写入笔(记新事)、输出笔(说话),外加一条几乎不被擦除的传送带(细胞状态)。
核心概念¶
(a) 🗂️ 让网络记住上文:RNN 与 LSTM¶
词袋丢语序、定长窗口丢长距离,RNN 用「参数共享 + 递推隐藏状态」按顺序读入序列。本篇从 RNN 前向与 BPTT 讲起,暴露梯度消失/爆炸这个病灶,再用 LSTM 细胞状态这座「梯度高速公路」和 GRU 做解药,最后用 CharRNN 实战收尾。
flowchart TB
    Node1["🤔 为什么需要 RNN"]
    Node2["📐 RNN 前向公式"]
    Node3["⏪ BPTT 反向传播"]
    Node4["💥 梯度消失/爆炸"]
    Node5["🏗️ LSTM 细胞状态"]
    Node6["🚪 GRU 两门简化"]
    Node7["✂️ 梯度裁剪 & 双向 RNN"]
    Node8["🎤 CharRNN 实战"]
    Node9["🚧 串行之痛 → Attention"]
    Node1 --> Node2
    Node2 --> Node3
    Node3 --> Node4
    Node4 --> Node5
    Node5 --> Node6
    Node4 --> Node7
    Node6 --> Node8
    Node7 --> Node8
    Node8 --> Node9
- 为什么需要 RNN:「我打了他」和「他打了我」词袋完全相同,模型分不清谁打了谁。语言是序列,RNN 按顺序一个词一个词地读,隐藏状态随身携带「到目前为止的笔记」,顺序信息不再丢失。
- RNN 前向公式:h_t = tanh(W_xh·x_t + W_hh·h_{t-1} + b_h)。同一个单元在所有时刻反复使用(参数共享),所以能处理任意长度序列;把网络按时间展开,就是一张 T 层共享权重的网。
- BPTT 反向传播:梯度要沿着时间轴从第 T 步一路传回第 1 步,叫 Backpropagation Through Time。跟普通 BP 的区别:沿时间展开、梯度按时刻累加、是共享权重网络。
- 梯度消失/爆炸:误差信号每回传一个时刻就要乘一次 W_hhᵀ 和 tanh 导数,连乘 T 次后,要么指数衰减到传不动(消失),要么指数爆炸成 NaN(爆炸)。生死由 W_hh 的谱半径决定。
- LSTM 细胞状态:RNN 的 h_t 每步被 tanh 整体重写,旧信息容易被覆盖。LSTM 单独开一条几乎不被擦除的「传送带」c_t,遗忘门、输入门、输出门在传送带上做加加减减而不是乘来乘去——加性结构就是梯度高速公路。
- GRU 两门简化:把 LSTM 的遗忘门 + 输入门合并成一个更新门 z_t,一个门同时决定「忘多少、记多少」,参数更省,效果常与 LSTM 相当。
- 梯度裁剪 & 双向 RNN:梯度爆炸的唯一治标手段——范数太大就按比例缩回来,只改大小不改方向;双向 RNN 让每个时刻同时看见左右两边,正向层反向层输出拼接。
- CharRNN 实战:字符级语言模型,读入前 10 个字符预测第 11 个,在 'hello world ' 上训练一个会「接话」的模型;温度 T 是生成多样性的旋钮,T 大更随机、T 小更保守。
- 串行之痛 → Attention:h_t 必须等 h_{t-1},T 个时刻没法并行,长序列训练极慢;而且 T 步后的信息只能压缩进一个固定向量(信息瓶颈)。这两条硬伤直接引出下一篇的 Attention。
0. 主线地图:本篇的 12 步¶
动机 → 公式 → 梯度 → 病灶 → 解药 → 简化 → 工程 → 实践 → 收尾
 │       │       │       │       │       │       │       │       │
 1 定长   2 前向   3 BPTT  4 梯度  5 LSTM  6 GRU   7 裁剪  8 字符  9 局限
 窗口局限 推导    三条链   消失/   四门+   两门     +技巧  生成+   →Attention
 词袋丢序         (含Why) 爆炸    细胞态           温度
| 步骤 | 内容 | 关键产出 |
|---|---|---|
| 1 | 为什么需要 RNN(定长窗口 / 词袋丢序) | 动机 |
| 2 | RNN 前向:$h_t,\ y_t$ 公式 + ASCII 结构图 | 公式 |
| 3 | BPTT:$W_{hy}/W_{xh}/W_{hh}$ 三条梯度链 | 梯度 |
| 4 | 梯度消失/爆炸:$W_{hh}^T$ 连乘、谱半径数值演示 | 病灶 |
| 5 | LSTM:四门 + 细胞状态加性更新(梯度高速公路) | 解药 |
| 6 | GRU:更新门/重置门 + 与 LSTM 参数对比表 | 简化 |
| 7 | 梯度裁剪:爆炸可剪、消失靠架构 | 工程 |
| 8 | CharRNN 字符生成 + 温度采样 | 实践 |
| 9 | 局限:串行慢 → 引出 Attention(04 篇) | 演进 |
| 10-12 | 数字敏感度 / 面试速答 / 自测清单 | 收尾 |
0.1 历史背景:循环网络是怎么"发明"出来的¶
在 RNN 之前,"序列建模"大体有三条路,各有硬伤:
| 路线 | 做法 | 硬伤 |
|---|---|---|
| 前馈网络 + 定长窗口 | 取最近 n 个词拼成一个输入 | 窗口外信息永久丢失,n 增大参数爆炸 |
| 词袋 / 平均 | 句内所有词向量求和/平均 | 语序被抹掉("我打了他"="他打了我") |
| HMM/CRF 等统计模型 | 显式状态转移 + 人工特征 | 状态离散、特征工程繁重、表达力受限 |
循环结构的思想源头是 Elman(1990)《Finding Structure in Time》提出的简单循环网络(SRN):隐藏层不仅接收当前输入,还接收"自己上一时刻的输出"——$h_t=f(W_{xh}x_t+W_{hh}h_{t-1}+b)$,这几乎就是今天 vanilla RNN 的全部。更早有 Jordan 网络(反馈来自上一时刻的输出层)与 Hopfield 网络(1982,循环吸引子)。"循环"的本质:把一个状态在时间轴上反复喂回自己,让网络拥有内部记忆。
值得注意,梯度消失几乎与 RNN 同年诞生:Hochreiter 1991 年的学位论文就严格证明了误差信号随步长指数衰减;1997 年他与 Schmidhuber 提出 LSTM,用"细胞状态 + 门控"把乘法传递换成加性直通。2014 年 seq2seq(Sutskever、Cho 同期工作)让 RNN 在机器翻译上爆发;2017 年 Transformer 以并行注意力取代其主流地位——但"递推"思想至今仍在流式/轻量场景延续(Mamba 等状态空间模型)。
# ---------- 全局设置:随机种子 / 中文字体 / 图片目录 ----------
%matplotlib inline
import os
import numpy as np
import torch
import matplotlib.pyplot as plt

np.random.seed(0)
torch.manual_seed(0)
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

IMG = os.path.join('10-自然语言处理', '教学', 'images')
os.makedirs(IMG, exist_ok=True)
print('随机种子已固定 (np/torch=0) | 图片目录:', IMG)

plt.show()
1. 为什么需要 RNN:序列是语言的第一性¶
1.1 直觉:一个"边读边记笔记"的人¶
词袋 / TF-IDF / Word2Vec 都是静态表示:整句读完才得到一个向量,词与词之间的顺序被抹掉了。 语言却是序列:『我打了他』和『他打了我』用的是同一批词,但主语宾语一换,语义完全相反。 如果模型把句子当成"一袋子词",这两句对它来说是同一个输入——预测"谁挨打"必然出错。
1.2 定长窗口的局限(n-gram 的瓶颈)¶
n-gram 语言模型用"最近 $n-1$ 个词"预测下一个词,有两个硬伤:
- 窗口定长:$n$ 一旦固定,超出窗口的距离信息永远看不到。比如『小明昨天在操场……(中间 50 个词)……摔倒了』,预测"摔倒"需要 50 步前的"小明",bigram/trigram 全部失效;
- 参数爆炸 + 数据稀疏:把窗口从 2 扩到 5,词表 $V=10^4$ 时 n-gram 组合数从 $10^8$ 涨到 $10^{20}$,绝大多数组合从未在语料中出现。
1.3 RNN 的答案:参数共享 + 递推状态¶
RNN 不给"每个位置"配一套权重,而是所有时刻共享同一套参数 $(W_{xh}, W_{hh}, b_h)$: $$h_t = \tanh(W_{xh} x_t + W_{hh} h_{t-1} + b_h)$$
- $h_t$ 是"读到第 $t$ 个词时的笔记",它递归地包含了前面所有词的信息;
- 序列多长都能处理——参数量与序列长度无关;
- 任意位置学到的模式(如"打"后面常接宾语)都能复用到所有位置(参数共享 = 平移不变性)。
⚠️ 本节局限:$h_t$ 是把全部历史"压缩进一个固定向量",且计算必须逐时刻串行。 这引出了 BPTT 的梯度问题(第 3、4 节)与并行瓶颈(第 9 节)。
1.4 手算:把"我打了他"和"他打了我"拆开看¶
实验 0 的三个输出值得逐条"翻译"一遍:
- 词袋完全相同:两句都含 {我, 打, 他} 各一次,词袋向量都是 $(1,1,1)$——对"只数词不看顺序"的模型(词袋、TF-IDF、平均词向量),这两句是同一个输入,必然无法回答"谁打了谁";
- 1 步上下文只有部分区分力:ctx₁=[我,打]、ctx₂=[他,打],主语位不同所以能区分——但这只是"恰好主语位置不同"。若句子拉长("小明在操场打了小刚" vs "小刚在操场打了小明"),主语与宾语被中间词隔开,固定 1 步/2 步窗口根本覆盖不到;
- RNN 末态距离 > 0:模型按序读入每个字,$h_t$ 是"前缀摘要",读完全句后"谁先出现"已被编码,两句末态自然不同。注意实验里的 RNN 权重是随机初始化、完全没训练过——"区分顺序"是递推结构自带的能力,不是学出来的。
由此可得第一条设计准则:序列模型必须"按序消费输入",并把顺序信息持续携带在某个状态里——RNN 的 $h_t$ 就是为这条准则而生的。
# ---------- 实验 0:词袋丢序 vs RNN 记住顺序 ----------
import numpy as np
np.random.seed(0)

s1 = ['我', '打', '他']      # "我打了他"
s2 = ['他', '打', '我']      # "他打了我"
vocab = sorted(set(s1 + s2))
w2i = {w: i for i, w in enumerate(vocab)}

def bow(seq):
    v = np.zeros(len(vocab), dtype=int)
    for w in seq:
        v[w2i[w]] += 1
    return v

b1, b2 = bow(s1), bow(s2)
print('词袋向量 s1:', b1, ' | s2:', b2, ' | 完全相同(顺序被抹掉):', np.array_equal(b1, b2))

ctx1 = [s1[k - 1] for k in range(1, len(s1))]   # 每个词的"上一个词"(1 步窗口)
ctx2 = [s2[k - 1] for k in range(1, len(s2))]
print('1 步上下文 s1:', ctx1, ' | s2:', ctx2, ' | 相同:', ctx1 == ctx2)

# RNN:按顺序读入,隐状态携带位置信息 → 两句可区分
rng = np.random.default_rng(0)
H, D = 4, len(vocab)
Wxh = rng.normal(0, 0.3, (H, D))
Whh = rng.normal(0, 0.3, (H, H))
bh = rng.normal(0, 0.1, H)

def read_rnn(seq):
    h = np.zeros(H)
    for w in seq:
        x = np.zeros(D); x[w2i[w]] = 1
        h = np.tanh(Wxh @ x + Whh @ h + bh)
    return h

h1, h2 = read_rnn(s1), read_rnn(s2)
dist = np.linalg.norm(h1 - h2)
print('RNN 末态 h 的距离: %.3f | 能区分两句(顺序被保留):' % dist, dist > 1e-6)
assert dist > 1e-6
print('结论:词袋/定长窗口抹掉顺序 → 需要"按序读取"的 RNN')
2. RNN 前向:一个公式 + 一张展开图¶
2.1 结构:从"折叠"到"展开"¶
RNN 本质是同一个单元在不同时刻反复使用。把它按时间展开,就变成一张 $T$ 层"共享权重"的网络:
        y_1         y_2         y_3          ...    y_T
        ▲           ▲           ▲                   ▲
   h_0 → h_1  Whh→  h_2  Whh→  h_3  Whh→ ... Whh→  h_T
        ▲           ▲           ▲                   ▲
        x_1         x_2         x_3                 x_T
- 横向箭头是 $W_{hh}$(时刻之间传递信息),纵向箭头是 $W_{xh}$(读入当前词)与 $W_{hy}$(输出预测);
- 同一个 $W_{hh}$ 被用了 $T$ 次——这正是参数共享,也正是后面梯度连乘的根源。
2.2 每个时刻只做两件事¶
- 更新笔记:把「当前词 $x_t$」和「上一时刻的笔记 $h_{t-1}$」融合,得到新笔记 $h_t$;
- 读出预测:从新笔记投影出 $y_t$(词表大小的 logits,分类时接 softmax + 交叉熵)。
2.1b 循环结构的标准示意图¶
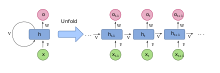
图 1:RNN 循环结构(左:折叠形式;右:按时间展开)(来源:公开网络资源)
这是理解 RNN 的"第一张图":左边一个带自环的单元(箭头从 $h$ 指回自己),右边把它按时间展开成一条链——展开后每个方块是"同一个单元在不同时刻的快照":横向连接是 $W_{hh}$(上一时刻状态 → 本时刻),竖向连接是 $W_{xh}$(读入输入)与 $W_{hy}$(输出预测)。
对照 §2.1 的 ASCII 图记两条要点:① 自环 = 时间共享——展开后所有位置用同一组权重,这正是"参数量与序列长度无关"的视觉证据;② 展开多深 = 网络多深——长度为 T 的序列等价于 T 层共享权重的网络,RNN 的"深度"来自时间方向,也预告了 §3 的 BPTT 要沿这条链反传。
2.3 前向公式逐步推导(记维度:$x_t\in\mathbb{R}^D,\\ h_t\in\mathbb{R}^H,\\ y_t\in\mathbb{R}^V$)¶
Step 1:线性融合。 当前词与旧笔记各乘一个权重矩阵后相加: $$a_t = W_{xh} x_t + W_{hh} h_{t-1} + b_h,\qquad a_t\in\mathbb{R}^H$$
Step 2:非线性压缩。 $\tanh$ 把 $a_t$ 压到 $(-1,1)$,让状态有界、可表达非线性: $$h_t = \tanh(a_t),\qquad h_t\in(-1,1)^H$$
Step 3:读出。 笔记投影到词表大小,得到预测 logits: $$y_t = W_{hy} h_t + b_y,\qquad y_t\in\mathbb{R}^V$$
为什么是 $\tanh$ 而不是 $\mathrm{ReLU}$? 反复迭代时 $\mathrm{ReLU}$ 无上界,状态可能越滚越大导致数值爆炸;$\tanh$ 有界(范数 ≤1),更稳定。
2.4 手算小例子($H=2,\\ D=3$)¶
设 $x_1=(1,0,0)^\top$,$h_0=(0,0)^\top$,$W_{xh}=\begin{bmatrix}1&-1&0\\\\0&1&1\end{bmatrix}$,$W_{hh}=\begin{bmatrix}0.5&0\\\\0&-0.5\end{bmatrix}$,$b_h=0$: $$a_1 = W_{xh}x_1 = (1,\\ 0)^\top,\qquad h_1 = \tanh(1,0) \approx (0.762,\\ 0)^\top$$ 读入 $x_2=(0,1,0)^\top$ 时,旧笔记经 $W_{hh}$ 参与: $$a_2 = (0,-1)^\top + (0.5\cdot0.762,\\ 0)^\top \approx (0.381,\\ -1)^\top,\qquad h_2\approx(0.363,-0.762)^\top$$ 可以看到 $h_1$ 的记忆确实传进了 $h_2$——这就是递推。
2.5 复杂度¶
单步计算 $O(H^2+HD)$(两个矩阵乘法),$T$ 步总计 $O\big(T(H^2+HD)\big)$。 参数量:$W_{xh}:HD,\\ W_{hh}:H^2,\\ W_{hy}:VH$,合计 $H(D+H+V)+H$——与 $T$ 无关(参数共享的收益)。
⚠️ 局限:前向必须逐时刻串行($t$ 步依赖 $t{-}1$),无法并行;反向更是雪上加霜(第 3 节)。
2.4b 往下再算一步:看见"记忆"在指数衰减¶
接着 §2.4 的算例,读入第三个词 $x_3=(0,0,1)^\top$。此时 $W_{xh}x_3=(0,\ 1)^\top$,而旧笔记经 $W_{hh}$ 的贡献是 $W_{hh}h_2=\big(0.5\times0.363,\ -0.5\times(-0.762)\big)^\top=(0.182,\ 0.381)^\top$,于是: $$a_3=(0.182,\ 1.381)^\top,\qquad h_3=\tanh(a_3)\approx(0.180,\ 0.882)^\top$$
把 $x_1$ 留下的痕迹在三个时刻的第一分量中列出来:
| 时刻 | 分量大小 | 说明 |
|---|---|---|
| $h_1$ | 0.762 | 刚读到,完整保留 |
| $h_2$ | 0.363 | 被 $W_{hh}$ 对角元 0.5 折半 |
| $h_3$ | 0.180 | 再折半(叠加 tanh 压缩) |
$x_1$ 的影响每一步 ×0.5:$0.762\to0.363\to0.180$——指数衰减的雏形。若衰减因子是 0.9,50 步后只剩 $0.9^{49}\approx0.006$;若是 1.1,就变成指数放大。"记忆随距离指数衰减"不是 bug,而是乘法递推的宿命:§4 的梯度消失,沿时间反传时遇到的乘法链路与此一模一样。
3. BPTT:把时间倒着推回去¶
3.1 为什么叫"通过时间反向传播"¶
普通 BP 在一层一层的静态网络里反传;RNN 把时间展开成 $T$ 层共享权重的网络,反传时梯度要沿着时间轴从 $T$ 流回 $1$,所以叫 Backpropagation Through Time(BPTT)。
与普通 BP 的三个区别(面试高频):
- 权重共享:$W_{hh}$ 在 $T$ 个时刻被用了 $T$ 次,反传时每个时刻的贡献要累加——$dW_{hh}$ 是 $T$ 项之和;
- 链长 = 序列长度:$t$ 时刻的梯度要穿过 $T-t$ 次 $\frac{\partial h_{k}}{\partial h_{k-1}}$,链长随序列变长;
- 不能并行:正向依赖顺序,反向依赖倒序,天然串行。
3.2 展开图上的反传路径¶
设总损失 $L=\sum_{t=1}^{T}\ell_t(y_t,\mathrm{target}_t)$。梯度从 $L$ 出发分两条路回流:
- 读出路径(短链):$L \to y_t \to h_t$,长度只有 1 步;
- 递推路径(长链):$L \to y_T \to h_T \to h_{T-1} \to \cdots \to h_1$,长度 $O(T)$——长链才是梯度消失/爆炸的来源。
3.3 三条梯度链完整推导($W_{hy}$ / $W_{xh}$ / $W_{hh}$)¶
记号:$a_t = W_{xh}x_t + W_{hh}h_{t-1}+b_h$($\tanh$ 的输入),$h_t=\tanh(a_t)$,$y_t = W_{hy}h_t+b_y$, 损失 $\ell_t = \tfrac12\|y_t - \mathrm{target}_t\|^2$,$L=\sum_t \ell_t$。
Step 1:$W_{hy}$(短链,与普通 BP 无异) $$\frac{\partial L}{\partial W_{hy}} = \sum_{t=1}^{T} (y_t - \mathrm{target}_t)\, h_t^\top,\qquad \frac{\partial L}{\partial b_y}=\sum_{t=1}^{T}(y_t-\mathrm{target}_t)$$
Step 2:递推误差信号 $\delta_t = \partial L/\partial a_t$ $h_t$ 同时影响本时刻输出 $y_t$ 与下一时刻状态 $h_{t+1}$,从 $t=T$ 倒推($\delta_{T+1}=0$): $$\delta_t = \mathrm{diag}(1-h_t^2)\,\Big(W_{hy}^\top (y_t-\mathrm{target}_t) + W_{hh}^\top \delta_{t+1}\Big)$$
Step 3:$W_{xh}$、$W_{hh}$、$b_h$(长链,逐时刻累加) $$\frac{\partial L}{\partial W_{xh}} = \sum_{t=1}^{T} \delta_t\, x_t^\top,\qquad \frac{\partial L}{\partial W_{hh}} = \sum_{t=1}^{T} \delta_t\, h_{t-1}^\top,\qquad \frac{\partial L}{\partial b_h} = \sum_{t=1}^{T} \delta_t$$
Step 4:展开看"连乘"本质 把 $\delta_t$ 递归展开,长链项是一串雅可比连乘: $$\delta_t\\ \ni\\ \Big(W_{hh}^\top\Big)^{T-t}\\ \prod_{k=t}^{T}\mathrm{diag}(1-h_k^2)\\ \cdot\\ \delta_T$$ 每个 $\|\mathrm{diag}(1-h_k^2)\|\le 1$($\tanh$ 导数上界为 1),所以长链的模主要由 $\|W_{hh}^\top\|^{T-t}\approx \rho(W_{hh})^{T-t}$ 决定——谱半径 <1 指数衰减(消失),>1 指数放大(爆炸),这就是第 4 节要解决的核心矛盾。
📌 实验 1 会把三条链全部手写出来,并用数值梯度逐条验证(误差 <1e-6)。
3.3b 用手算看清"连乘"与"累加"(T=3 微型算例)¶
设一个极端简化的 RNN:标量状态 $h_t=\tanh(\lambda h_{t-1})$(无输入),损失只在 $t=3$ 有监督。由 §3.3 的递推式,误差回传三步: $$\delta_3=(1-h_3^2)\,\delta_3^{\text{out}},\quad \delta_2=(1-h_2^2)\,\lambda\,\delta_3,\quad \delta_1=\underbrace{\lambda^2(1-h_1^2)(1-h_2^2)}_{\text{两步连乘}}\,\delta_3$$
代入两组数字看"传两步"的放大/衰减(假设 $\tanh$ 导数都在 0.9 附近):
| 权重 $\lambda$ | $\delta_1/\delta_3$(两步后) | 直觉 |
|---|---|---|
| 0.5 | $0.25\times0.81\approx0.20$ | 几步就衰减到 1% 以下 → 消失 |
| 0.9 | $0.81\times0.81\approx0.66$ | 慢速衰减,长序列仍不够用 |
| 1.5 | $2.25\times0.81\approx1.82$ | 两步放大近 2 倍 → 爆炸 |
同时看"累加":$dW_{hh}=\sum_{t=1}^{T}\delta_t h_{t-1}^\top$,T=3 时是三份外积相加——$dW_{hh}=\delta_1h_0^\top+\delta_2h_1^\top+\delta_3h_2^\top$。每个时刻的误差都回来"投票",越早的时刻票面越弱(链路最长)。漏累加任何一项 = 梯度算错,这是手写 BPTT 最常见的 bug(实验 1 的 dWhh += np.outer(dpre, hs[t]) 正是累加)。上面两张表就是 §4 谱半径定理的"数值版预告"。
# ---------- 实验 1:手写 RNN 前向 + 完整 BPTT + 数值梯度校验 ----------
import numpy as np
np.random.seed(0)

T, D, H, V = 6, 4, 5, 3
x = np.random.randn(T, D)
target = np.random.randn(T, V)          # 每个时刻都有监督(seq2seq 风格)
h0 = np.zeros(H)
Wxh = np.random.randn(H, D) * 0.2
Whh = np.random.randn(H, H) * 0.2
Why = np.random.randn(V, H) * 0.2
bh = np.random.randn(H) * 0.1
by = np.random.randn(V) * 0.1

def forward(x, h0, Wxh, Whh, Why, bh, by):
    hs, ys = [h0], []
    for t in range(T):
        h = np.tanh(Wxh @ x[t] + Whh @ hs[-1] + bh)   # h_t = tanh(Wxh x_t + Whh h_{t-1} + bh)
        hs.append(h)
        ys.append(Why @ h + by)                        # y_t = Why h_t + by
    return hs, ys                                       # hs[t] = h_t(含 h0)

def bptt(x, target, h0, Wxh, Whh, Why, bh, by):
    hs, ys = forward(x, h0, Wxh, Whh, Why, bh, by)
    dWxh = np.zeros_like(Wxh); dWhh = np.zeros_like(Whh)
    dWhy = np.zeros_like(Why); dbh = np.zeros_like(bh); dby = np.zeros_like(by)
    drec = np.zeros(H)                                   # 来自未来的误差信号(初始 0)
    for t in range(T - 1, -1, -1):
        dy = ys[t] - target[t]                           # ∂L/∂y_t(MSE: L = 0.5 Σ||y_t-target||²)
        dWhy += np.outer(dy, hs[t + 1])                  # 短链:W_hy 梯度
        dby += dy
        dh = Why.T @ dy + drec                           # h_t 总误差 = 输出路径 + 递推路径
        dpre = dh * (1 - hs[t + 1] ** 2)                 # tanh 导数 → δ_t
        dWxh += np.outer(dpre, x[t])                     # 长链:W_xh 梯度(累加)
        dWhh += np.outer(dpre, hs[t])                    # 长链:W_hh 梯度(累加)
        dbh += dpre
        drec = Whh.T @ dpre                              # 把误差传给 h_{t-1}:δ_t → δ_{t-1}
    return dWxh, dWhh, dWhy, dbh, dby

grads = bptt(x, target, h0, Wxh, Whh, Why, bh, by)
grad_map = dict(zip(['Wxh', 'Whh', 'Why', 'bh', 'by'], grads))

def compute_loss(Wxh, Whh, Why, bh, by):
    _, ys = forward(x, h0, Wxh, Whh, Why, bh, by)
    return 0.5 * sum(np.sum((y - t) ** 2) for y, t in zip(ys, target))

def num_grad(name, idx, eps=1e-6):
    P = {'Wxh': Wxh.copy(), 'Whh': Whh.copy(), 'Why': Why.copy(), 'bh': bh.copy(), 'by': by.copy()}
    N = {k: v.copy() for k, v in P.items()}
    P[name][idx] += eps
    N[name][idx] -= eps
    return (compute_loss(**P) - compute_loss(**N)) / (2 * eps)

checks = [('Wxh', (0, 0)), ('Wxh', (2, 3)), ('Whh', (1, 2)), ('Whh', (3, 4)),
          ('Why', (2, 0)), ('bh', (3,)), ('by', (1,))]
errs = [abs(num_grad(n, i) - grad_map[n][i]) for n, i in checks]
print('BPTT vs 数值梯度误差(Wxh/Whh/Why/bh/by 抽样): %s' % ['%.2e' % e for e in errs])
assert max(errs) < 1e-6
print('BPTT 正确 ✓ | 三条链:Why 短链(1 步) / Wxh、Whh 长链(T=%d 步逐时刻累加),反传链长=序列长度' % T)
4. 梯度消失 / 爆炸:$W_{hh}$ 的 $T$ 次幂¶
4.1 直觉:把梯度当"信号在传送带上的传递"¶
反传时误差信号每经过一个时刻,就要被乘一次 $W_{hh}^\top$ 和一次 $\tanh$ 导数。传送带传 $T$ 次,信号要么越传越弱(消失),要么越传越猛(爆炸)。什么时候传得动?看 $W_{hh}$ 的谱半径。
4.2 谱半径:判断消失/爆炸的标尺¶
矩阵范数 $\|W_{hh}^\top\|^{T-t}$ 的极限行为由谱半径(最大特征值模长)$\rho(W_{hh})$ 刻画: $$\|W_{hh}^\top\|^{T-t} \approx \rho(W_{hh})^{T-t}$$
- $\rho < 1$:$T$ 步后信号衰减为原来的 $\rho^T$(如 $\rho=0.9$ 时 $0.9^{50}\approx 0.005$)→ 梯度消失;
- $\rho > 1$:$T$ 步后放大为 $\rho^T$(如 $\rho=1.1$ 时 $1.1^{50}\approx 117$)→ 梯度爆炸;
- $\rho = 1$:临界点,信号不增不减(这也是正交初始化把谱半径设为 1 的原因)。
💡 一句话记忆:消失是"信息传不到",爆炸是"信息放太大";两者同源——都是 $W_{hh}$ 幂次连乘,只是谱半径在 1 的两侧。
4.3 数值演示(实验 2a)¶
代码里构造谱半径分别为 0.8 / 1.0 / 1.5 的三个 $W_{hh}$,画出 $\|W_{hh}^T v\|$ 随 $T$ 的变化曲线(对数坐标),你会看到三条曲线:一条坠向 $10^{-6}$,一条平直,一条冲上 $10^5$。
⚠️ 局限:光靠调初始化无法根治消失——信号传递链路本质上是"乘法"。要让信息加性直通,需要 LSTM(第 5 节)。
# ---------- 实验 2a:谱半径与梯度消失/爆炸的数值演示 ----------
import numpy as np
import matplotlib.pyplot as plt
np.random.seed(0)

H = 8
def make_Whh(spectral_radius):
    A = np.random.randn(H, H)
    rho = max(abs(np.linalg.eigvals(A)))
    return A / rho * spectral_radius          # 把谱半径缩放到目标值

Tmax = 60
Ts = np.arange(1, Tmax + 1)
for rho in [0.8, 1.0, 1.5]:
    W = make_Whh(rho)
    v = np.random.randn(H); v /= np.linalg.norm(v)
    norms = [np.linalg.norm(np.linalg.matrix_power(W, t) @ v) for t in Ts]
    plt.semilogy(Ts, norms, marker='o', ms=3, label='谱半径 ρ=%.1f' % rho)
    print('ρ=%.1f  T=%d 时 ||Whh^T v||=%.3e' % (rho, Tmax, norms[-1]))

plt.axhline(1.0, color='k', ls='--', lw=1, label='基准 1.0')
plt.xlabel('反传步数 T(时间步)')
plt.ylabel('梯度传播因子 ||Whh^T v||(对数坐标)')
plt.title('谱半径决定梯度消失/爆炸:Whh 的 T 次幂连乘')
plt.legend(); plt.grid(alpha=0.3); plt.tight_layout()
plt.savefig(os.path.join(IMG, 'nlp03_spectral.png'), dpi=110, bbox_inches='tight')
plt.show()

print('ρ<1 → 指数衰减(梯度消失); ρ>1 → 指数放大(梯度爆炸); ρ=1 → 临界(正交初始化目标)')
4.3b 读图:三条曲线就是三种命运¶
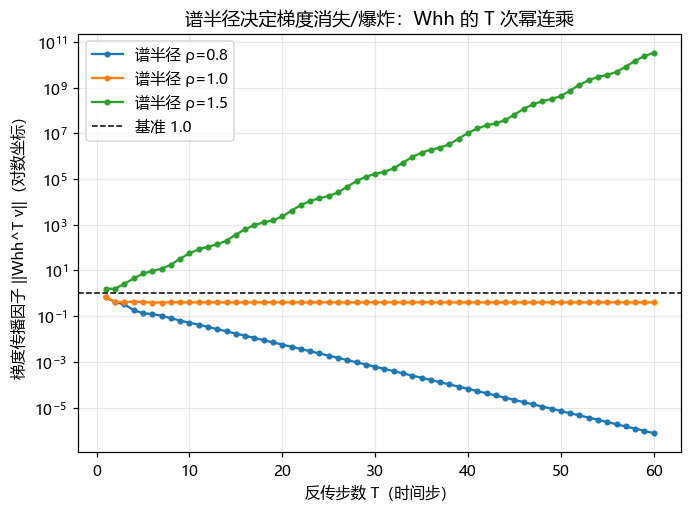
图 2:谱半径与梯度消失/爆炸的数值演示(本实验 2a 生成,自绘)
对数纵坐标下三条曲线的走向一目了然:
- ρ=0.8(蓝):$0.8^{60}\approx10^{-6}$——60 步反传后信号衰落到百万分之一,长依赖不可学;
- ρ=1.0(红):$1.0^{T}=1$ 恒为 1——临界点,这正是正交初始化把谱半径钉在 1 的原因;
- ρ=1.5(绿):$1.5^{60}\approx3\times10^{10}$——直接冲上 $10^{10}$,梯度爆炸、loss 变 NaN。
注意这张图只画了 $W_{hh}$ 的幂次;真实 BPTT 还要乘 $\tanh$ 导数(≤1),所以实际消失比图里更快、爆炸比图里更慢——方向不变、结论不变:谱半径是梯度命运的"第一决定因素"。
5. LSTM:细胞状态 = 梯度高速公路¶
5.1 直觉:从"笔记"到"传送带 + 三支笔"¶
RNN 的 $h_t$ 每步都被 $\tanh$ 整体重写,旧信息要么被覆盖、要么靠 $W_{hh}$ 的"乘法"勉强传递——这就是消失的根源。 LSTM 的思路:单独开一条几乎不被擦除的"传送带"(细胞状态 $c_t$),信息在传送带上做"加加减减",而不是乘来乘去。
- 遗忘笔 $f_t$:决定从传送带上丢掉多少旧记忆;
- 写入笔 $i_t$:决定把多少新候选内容 $\tilde c_t$ 写上传送带;
- 输出笔 $o_t$:决定从传送带上读出多少去更新对外可见的 $h_t$。
5.2 展开一个时刻的结构图¶
        c_{t-1} ──(× f_t)──( + i_t×c̃_t )──> c_t   ← 传送带(加性直通,几乎不衰减)
                    ▲               ▲
   x_t ──> [四个门控单元] ──> f_t, i_t, c̃_t, o_t
                    ▲               ▲
        h_{t-1} ──┘               └──> o_t × tanh(c_t) = h_t
5.2b 标准 LSTM 单元结构图¶
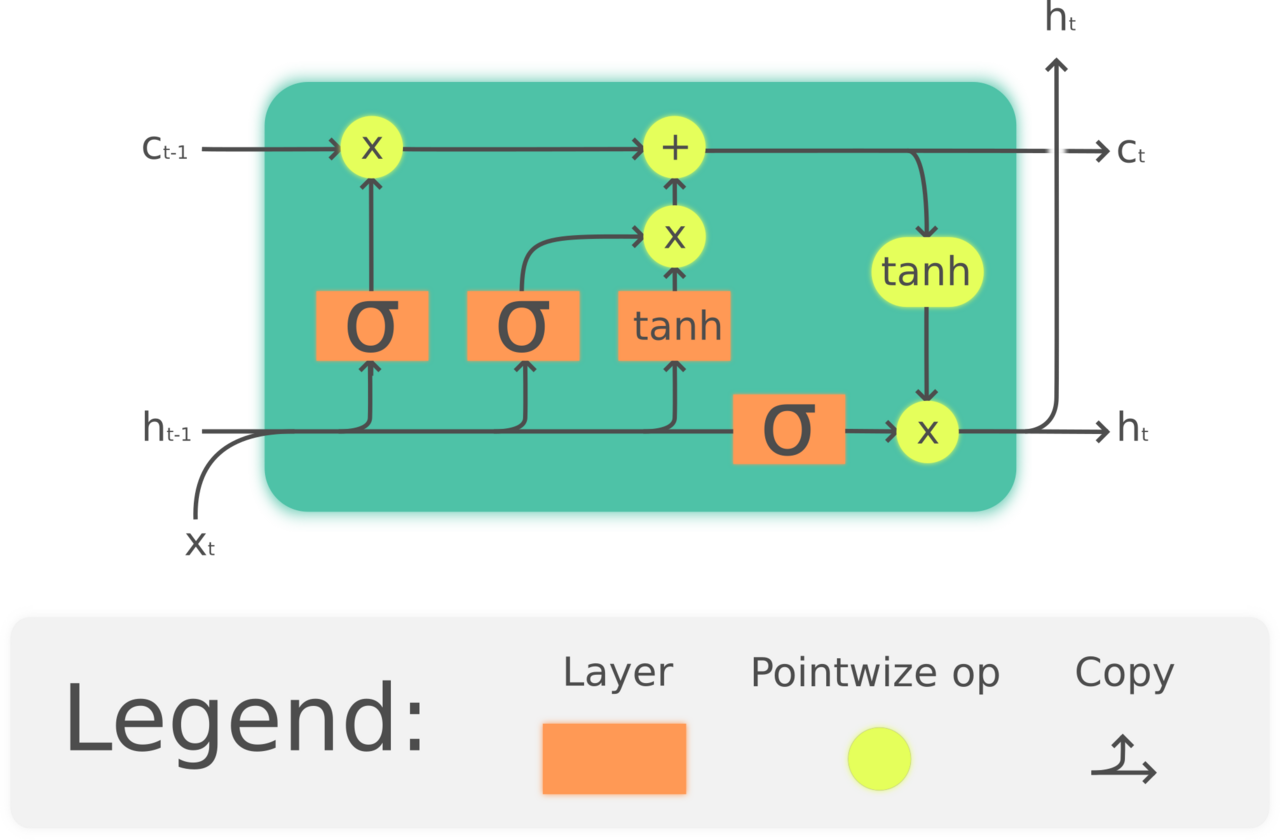
图 3:LSTM 单元内部结构(来源:公开网络资源)
这张经典结构图与 §5.2 的 ASCII 图一一对应,读图要点:
- 横向主线(细胞状态):$c_{t-1}$ 从左侧进入,先被"×"(遗忘门 $f_t$)逐元素缩放,再在"+"处叠加上 $i_t\otimes\tilde c_t$,从右侧流出 $c_t$——整条主线没有非线性激活、没有矩阵连乘,只有乘法和加法;
- 四条竖向支路:$x_t$ 与 $h_{t-1}$ 拼接后喂给四个并列单元,产出 $f_t/i_t/\tilde c_t/o_t$——标着 $\sigma$ 的是门(0~1),标着 $\tanh$ 的是候选内容(−1~1);
- 输出环节:$c_t$ 再过一次 $\tanh$,被输出门 $o_t$ 逐元素"过滤"后成为对外可见的 $h_t$——$h_t$ 永远是"被门控过的 $c_t$ 的压缩视图"。
把图上的"×"与"+"换成公式,就是 §5.3 的四道门:结构图比公式好记,公式比结构图精确——建议对着图默写公式。
5.3 四门逐个推导($x_t\in\mathbb{R}^D,\\ h_{t-1}\in\mathbb{R}^H$,拼接输入 $[x_t;h_{t-1}]\in\mathbb{R}^{D+H}$)¶
遗忘门 $f_t$(sigmoid → 0/1,决定"丢多少") $$f_t = \sigma(W_f [x_t; h_{t-1}] + b_f),\qquad f_t\in(0,1)^H$$ $f_t\approx 0$:清空旧记忆;$f_t\approx 1$:完整保留旧记忆。
输入门 $i_t$(sigmoid,决定"写多少") $$i_t = \sigma(W_i [x_t; h_{t-1}] + b_i)$$
候选记忆 $\tilde c_t$(tanh,决定"写什么",可正可负) $$\tilde c_t = \tanh(W_c [x_t; h_{t-1}] + b_c),\qquad \tilde c_t\in(-1,1)^H$$
输出门 $o_t$(sigmoid,决定"说多少") $$o_t = \sigma(W_o [x_t; h_{t-1}] + b_o)$$
5.4 为什么门用 sigmoid、内容用 tanh?¶
- 门是"比例",需要 0~1 连续可微的开关 → sigmoid(导数处处非零,可训练);
- 内容 $\tilde c_t$ 需要可正可负的增量 → tanh(对称、有界,加进传送带不产生偏置)。 二者分工一句话:门控"量"、tanh 控"方向"。
5.5 细胞状态更新:加性结构 = 梯度高速公路¶
$$c_t = f_t \odot c_{t-1} + i_t \odot \tilde c_t,\qquad h_t = o_t \odot \tanh(c_t)$$
- 忽略输入项时 $c_t = f_t \odot c_{t-1}$:旧记忆只被逐元素乘以 0~1 的数;当 $f_t\approx 1$ 时 $c_t\approx c_{t-1}$——误差信号沿传送带回传时 $\frac{\partial c_t}{\partial c_{t-1}} \approx 1$,不经过任何权重矩阵连乘;
- 对比 RNN 的 $\frac{\partial h_t}{\partial h_{t-1}} = W_{hh}^\top\,\mathrm{diag}(1-h_t^2)$:LSTM 把"乘法传递"换成"加法 + 逐元素缩放",梯度不再随 $T$ 指数衰减 → 长依赖成为可能。
5.6 遗忘门偏置初始化为 ≈1:从"默认记住"开始学¶
若 $b_f=0$,$f_t=\sigma(\cdot)$ 的均值在 0.5 附近——初始状态"半丢半留";
若初始 $b_f=1$(或 1~2),则 $f_t\approx\sigma(1)\approx 0.73$——初始偏向"多记住",给梯度高速路一个"默认畅通"的起点,模型再按需学习"何时遗忘"。
torch.nn.LSTM 中可用 bias_hh_l0 的对应分量单独初始化遗忘门偏置;实验 2b-2 用数字验证 $b_f=0$ vs $b_f=1$ 对 $f_t$ 均值的影响。
5.5b 手算:加性更新如何让梯度"不衰减"(标量版)¶
把维度压到 H=1(全是标量),用具体数字走两步。
正向更新:设 $c_0=1.0$、$f_1=0.9$、$i_1=0.1$、$\tilde c_1=2.0$: $$c_1=f_1\,c_0+i_1\,\tilde c_1=0.9\times1.0+0.1\times2.0=1.1$$
反向传播:$\dfrac{\partial c_1}{\partial c_0}=f_1=0.9$;两步链 $\dfrac{\partial c_2}{\partial c_0}=f_2\,f_1=0.81$;T 步链 $=\prod_{t}f_t$。当遗忘门都≈1 时整条链≈1——误差"无损返场"。
为什么这不是 RNN 那套老问题:RNN 的乘法因子是固定权重(谱半径 λ),改 λ 等于重写语义;LSTM 的 $f_t$ 是每个时刻独立学出来的门——想把第 k 步的信息留给未来,就把 $f_k$ 训到接近 1,高速路按需开合,而不是永远 0.9 连乘。实验 2b-2 的 $b_f=0$ vs $b_f=1$ 正是在给这条高速路选"默认开度"(平均 $f$:0.50 → 0.73)。
# ---------- 实验 2b:手写 LSTM 前向 vs torch.nn.LSTM 对照 ----------
import numpy as np
import torch
import torch.nn as nn
torch.manual_seed(0); np.random.seed(0)

D, H, T, B = 4, 5, 6, 2
lstm = nn.LSTM(D, H, batch_first=False)
# torch 权重拼接:(4H, D) 输入权重 + (4H, H) 隐权重 → (4H, D+H);gate 顺序 (i, f, g, o)
W = np.concatenate([lstm.weight_ih_l0.detach().numpy(),
                    lstm.weight_hh_l0.detach().numpy()], axis=1)
b = (lstm.bias_ih_l0 + lstm.bias_hh_l0).detach().numpy()

def sigmoid(z):
    return 1 / (1 + np.exp(-np.clip(z, -30, 30)))

def lstm_forward(x, W, b, H):
    # x: (T, B, D);gate 顺序 (i, f, g, o)
    T, B, D = x.shape
    h = np.zeros((B, H)); c = np.zeros((B, H))
    hs, cs = [], []
    for t in range(T):
        a = x[t] @ W[:, :D].T + h @ W[:, D:].T + b        # (B, 4H)
        i, f, g, o = np.split(a, 4, axis=1)
        i, f, o = sigmoid(i), sigmoid(f), sigmoid(o)
        g = np.tanh(g)
        c = f * c + i * g                                  # c_t = f⊙c_{t-1} + i⊙g̃
        h = o * np.tanh(c)                                 # h_t = o⊙tanh(c_t)
        hs.append(h); cs.append(c)
    return np.stack(hs), np.stack(cs)

x = torch.randn(T, B, D)
with torch.no_grad():
    out_t, (h_n, c_n) = lstm(x)
out_my, c_my = lstm_forward(x.numpy(), W, b, H)
err_h = np.abs(out_my - out_t.numpy()).max()
err_c = np.abs(c_my[-1] - c_n[0].numpy()).max()
print('手写 LSTM vs torch:h 最大误差 %.2e | c 最大误差 %.2e' % (err_h, err_c))
assert err_h < 1e-5 and err_c < 1e-5
print('一致 ✓ | gate 顺序 (i,f,g,o);若 f≡1, i≡0 则 c_t = c_{t-1} —— 梯度直通的高速公路')
# ---------- 实验 2b-2:遗忘门偏置 b_f=0 vs b_f=1 的数值效应 ----------
import numpy as np
np.random.seed(0)

H = 64
def sigmoid(z):
    return 1 / (1 + np.exp(-np.clip(z, -30, 30)))

z = np.random.randn(H)                       # 随机 pre-activation(只改偏置)
f0 = sigmoid(z + 0.0).mean()                 # b_f = 0
f1 = sigmoid(z + 1.0).mean()                 # b_f = 1
f2 = sigmoid(z + 2.0).mean()                 # b_f = 2
print('b_f=0 → 平均 f=%.3f(半丢半留)' % f0)
print('b_f=1 → 平均 f=%.3f(默认多记住)' % f1)
print('b_f=2 → 平均 f=%.3f(强烈默认记住)' % f2)

# sigmoid 导数:z=0 处最大 0.25,饱和区趋 0 → 门在 0/1 饱和是"不更新"的机制
zs = np.linspace(-6, 6, 101)
s = sigmoid(zs)
print('sigmoid 导数最大值 = %.3f(z=0 处),|z| 大时导数趋 0(门饱和)' % (s * (1 - s)).max())
6. GRU:把门减到两个¶
6.1 直觉:合并"遗忘 + 写入"¶
LSTM 用 $f$ 和 $i$ 两个门分别控制"丢旧 / 写新",配合起来容易冗余。GRU 把它们合成一个更新门 $z_t$:$z_t$ 大 → 多听新内容;$(1-z_t)$ 大 → 多留旧状态。一个门同时完成"忘多少"与"记多少",参数更省。
6.2 公式推导¶
更新门 $z_t$(sigmoid):决定新旧信息的混合比例 $$z_t = \sigma(W_z [x_t; h_{t-1}] + b_z)$$
重置门 $r_t$(sigmoid):决定"旧状态有多少参与新候选" $$r_t = \sigma(W_r [x_t; h_{t-1}] + b_r)$$
候选隐藏状态 $\tilde h_t$(tanh,旧状态先被 $r_t$ 缩放) $$\tilde h_t = \tanh(W_h [x_t; r_t \odot h_{t-1}] + b_h)$$ $r_t\approx 0$ 时候选几乎只看当前词(短时记忆);$r_t\approx 1$ 时完整利用旧状态。
最终更新(凸组合 / 线性插值) $$h_t = (1-z_t)\odot h_{t-1} + z_t \odot \tilde h_t$$ 没有独立细胞状态,但 $z_t\approx 0$ 时 $h_t\approx h_{t-1}$ 同样提供"近似恒等直通"。
6.3 对比表:RNN vs LSTM vs GRU¶
| 项目 | RNN | LSTM | GRU |
|---|---|---|---|
| 状态 | $h$ | $c, h$ | $h$ |
| 门数量 | 0 | 3($f,i,o$)+ 候选 | 2($z,r$)+ 候选 |
| 每步权重组数 | 1 | 4 | 3 |
| 每步参数量 | $H(D{+}H)$ | $4H(D{+}H)$ | $3H(D{+}H)$ |
| 长依赖能力 | 弱 | 强 | 强 |
| 训练速度 | 快 | 慢 | 中 |
| 典型场景 | 基线/简单序列 | 精度优先 | 速度与效果平衡(机器翻译、语音) |
⚠️ 局限:GRU 参数少约 25%,多数任务效果与 LSTM 相当,但门更少意味着表达"长期精确记忆"的能力略弱,复杂长依赖任务 LSTM 仍占优。
6.2b 手算:GRU 一步更新(H=1 标量版)¶
设 $h_{t-1}=0.5$,且此刻门与候选已算出:$z_t=0.7$、$r_t=0.8$、$\tilde h_t=0.6$,则 $$h_t=(1-z_t)\odot h_{t-1}+z_t\odot\tilde h_t=0.3\times0.5+0.7\times0.6=0.15+0.42=0.57$$
读结果:$z_t=0.7$ 表示"七成信新、三成留旧"——一个门同时完成了 LSTM 里遗忘($1-z$)与写入($z$)两件事。
再看两个极端(理解梯度直通的关键):
- $z_t\to0$:$h_t\approx h_{t-1}$,于是 $\dfrac{\partial h_t}{\partial h_{t-1}}\approx 1-z_t\approx1$——旧状态原样保留,误差无损回传(等价于 LSTM 遗忘门≈1);
- $r_t\to0$:候选 $\tilde h_t=\tanh(\cdot)$ 里的旧状态被清零,几乎只看当前输入——重置门负责"短时记忆",让网络能果断丢弃过时信息、重新开始。
把 $z$ 想成"新旧信息的混合旋钮"、$r$ 想成"旧状态的闸门",GRU 的两门语义就清楚了;实验 2c 的 (1 - z) * n + z * h 与上面公式逐字符对应。
# ---------- 实验 2c:手写 GRU 前向 vs torch.nn.GRU 对照 ----------
import numpy as np
import torch
import torch.nn as nn
torch.manual_seed(0); np.random.seed(0)

D, H, T, B = 4, 5, 6, 2
gru = nn.GRU(D, H, batch_first=False)
W_ih = gru.weight_ih_l0.detach().numpy()   # (3H, D),顺序 r, z, n
W_hh = gru.weight_hh_l0.detach().numpy()   # (3H, H)
b_ih = gru.bias_ih_l0.detach().numpy()
b_hh = gru.bias_hh_l0.detach().numpy()

def sigmoid(z):
    return 1 / (1 + np.exp(-np.clip(z, -30, 30)))

def gru_forward(x, W_ih, W_hh, b_ih, b_hh, H):
    # 注意:重置门作用在"变换后的隐状态"上:n_t = tanh(W_in x_t + b_in + r_t⊙(W_hn h_{t-1}+b_hn))
    T, B, D = x.shape
    h = np.zeros((B, H)); hs = []
    for t in range(T):
        gx = x[t] @ W_ih.T + b_ih            # (B, 3H) 输入贡献
        gh = h @ W_hh.T + b_hh               # (B, 3H) 隐状态贡献
        r = sigmoid(gx[:, :H] + gh[:, :H])                 # 重置门
        z = sigmoid(gx[:, H:2 * H] + gh[:, H:2 * H])       # 更新门
        n = np.tanh(gx[:, 2 * H:] + r * gh[:, 2 * H:])     # 候选(重置门缩放隐贡献)
        h = (1 - z) * n + z * h              # h_t = (1-z)⊙n + z⊙h_{t-1}
        hs.append(h)
    return np.stack(hs)

x = torch.randn(T, B, D)
with torch.no_grad():
    out_t, h_n = gru(x)
out_my = gru_forward(x.numpy(), W_ih, W_hh, b_ih, b_hh, H)
err = np.abs(out_my - out_t.numpy()).max()
print('手写 GRU vs torch:最大误差 %.2e' % err)
assert err < 1e-5
print('一致 ✓ | GRU 每步仅 3 组权重 (r, z, n),比 LSTM 少一组 → 参数省 25%')
7. 梯度裁剪与工程技巧¶
7.1 梯度裁剪:唯一能"治标"的爆炸手段¶
爆炸梯度会让参数一步跨出有效区域(loss 变成 NaN/Inf)。裁剪的思想很朴素:如果梯度范数太大,就把它按比例缩回来——只改方向、不放大步长: $$g \leftarrow g \cdot \min\left(1,\\ \frac{\mathrm{clip}}{\|g\|_2}\right)$$
- 范数 ≤ clip:不动;范数 > clip:整体等比缩小到范数 = clip;
torch.nn.utils.clip_grad_norm_(params, max_norm)就是干这个的,实验 3a 会手写一遍并和 torch 对照。
7.2 为什么"爆炸能剪、消失不能剪"?(面试高频)¶
- 爆炸是梯度太大,发生在靠近 $T$ 的浅层时刻,裁剪后立刻可训练 → 数值手段能治;
- 消失是梯度太小(信息根本没传到 $t$),裁剪只会把"本来就小的信号"再缩小,无济于事 → 架构手段才能治(LSTM/GRU 的加性直通、残差连接、Attention 的任意两位置直达)。
7.3 其他工程技巧¶
- 初始化:$W_{hh}$ 用正交初始化(谱半径≈1)或小随机值;LSTM 遗忘门偏置初始为正(1~2);
- 双向 RNN(BiRNN):正向 + 反向两个隐状态拼接,维度 ×2——序列标注标配(06 篇 BiLSTM+CRF 会用);
- 层数 / 正则:多层 RNN 每层有自己的隐状态;dropout 通常加在层间而非时刻间(variational dropout);
- 截断 BPTT:长序列只回传最近 $K$ 步,省显存(近似梯度)。
7.3b 双向 RNN:让每个时刻"看见"左右两边¶
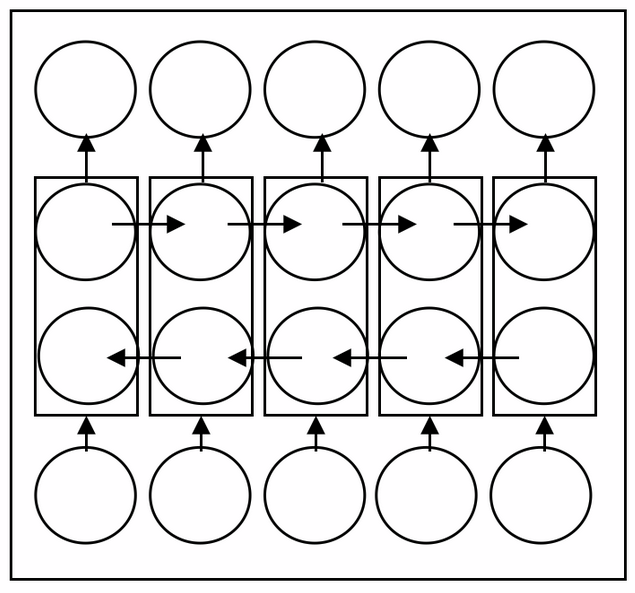
图 4:双向 RNN 结构(正向层 + 反向层,输出拼接)(来源:公开网络资源)
图中上方箭头向右的链是正向层 $\vec h_t$(按语序读),下方箭头向左的链是反向层 $\overleftarrow h_t$(按逆序读),两层在每个时刻拼接后共同喂给输出。注意两层是两套完全独立的参数(不存在共享),参数量约为两个 RNN。
为什么序列标注类任务(NER、词性标注)几乎标配双向?因为"当前词是什么标签"往往依赖左右两侧的证据:判断 bank 是机构还是河岸,要看它右边的 river;判断 我 是主语还是宾语,要看左边的动词。单向 RNN 只能看到"左边全部 + 右边 0",双向才能覆盖全句。
⚠️ 常见误解:双向 ≠ 解决梯度消失。BiLSTM 只是让每个位置拿到双向信息;梯度消失是"时间方向"的问题,依旧靠 LSTM/GRU 的加性直通解决,别把两者混为一谈。
# ---------- 实验 3a:梯度裁剪 —— 手写公式 vs torch.clip_grad_norm_ ----------
import numpy as np
import torch
torch.manual_seed(0); np.random.seed(0)

# 造一个大范数的"爆炸梯度"
p = torch.nn.Parameter(torch.randn(10))
g = torch.randn(10) * 50                    # 范数很大(≈50·√10)
p.grad = g.clone()
norm_before = p.grad.norm().item()
torch.nn.utils.clip_grad_norm_([p], max_norm=1.0)
norm_after = p.grad.norm().item()
print('裁剪前 ||g||=%.2f → 裁剪后 ||g||=%.6f' % (norm_before, norm_after))
assert abs(norm_after - 1.0) < 1e-6

# 手写等价公式:g ← g · min(1, clip/||g||)
clip = 1.0
g2 = g.clone()
norm = g2.norm()
g2 = g2 * min(1.0, clip / norm.item())
print('手写公式 ||g||=%.6f,与 torch 一致: %s' % (g2.norm().item(), torch.allclose(g2, p.grad)))
assert torch.allclose(g2, p.grad)
print('梯度裁剪只改方向、按比例缩小步长 —— 专治爆炸,不治消失')
8. CharRNN:训练一个会"接话"的模型¶
8.1 任务设定¶
字符级语言模型:语料是一个字符串 'hello world '(11 个字符),模型读入前 10 个字符,预测第 11 个(next-char prediction)。训练目标:给定前缀,最大化下一个字符的 log 概率。
为什么用字符不用词? 词表小(这里 $V=11$)、语料自包含、训练秒级完成——适合教学演示 RNN 的"记忆"能力:模型必须记住 hello 后面是空格、world 后面也是空格……靠的正是 $h_t$ 里的长期信息。
8.2 模型结构(三件套)¶
x_t(字符id) ──> Embedding(8维) ──> nn.RNN(隐层16) ──> Linear(词表V) ──> logits
每步输出一个 $V$ 维 logits,接交叉熵;训练 ≤400 步,$V=11$,参数量几千——单 cell <60s。
8.3 训练收敛后能干什么?¶
- argmax 贪心生成:永远选概率最大的字符 → 稳定但单调、易重复;
- 温度采样生成:$p(c) \propto \exp(\log z_c / T)$,$T$ 控制"随机程度"(8.4 节)。
8.4 采样温度 $T$:生成多样性的旋钮¶
温度采样把 logits 除以 $T$ 后再 softmax: $$p_i = \frac{\exp(z_i / T)}{\sum_j \exp(z_j / T)}$$
- $T\to 0$:退化为 argmax(确定性最高,风险是重复);
- $T=1$:原始分布;
- $T>1$:分布变平,低概率字符被"抬升"(更多样,风险是胡言乱语)。
实验 3c 的做法:用训练好的模型,分别以 $T=0.3 / 1.0 / 2.5$ 从相同前缀采样若干条,观察:$T$ 小 → 输出接近"标准答案" hello world;$T$ 大 → 出现偏离语料的随机字符。温度不是越高越好——"创造性"和"正确性"是一对 trade-off。
# ---------- 实验 3b:CharRNN 训练(torch)—— 学会 "hello world" 循环 ----------
import numpy as np
import torch
import torch.nn as nn
torch.manual_seed(0); np.random.seed(0)

text = 'hello world '
chars = sorted(set(text))
V3 = len(chars)
c2i = {c: i for i, c in enumerate(chars)}
i2c = {i: c for c, i in c2i.items()}
SEQ = 10                                  # 输入窗口:10 个字符预测下一个
rng = np.random.default_rng(0)

def make_batch(n=64, length=SEQ):
    xs, ys = [], []
    idx = rng.integers(0, len(text) - length, n)
    for s in idx:
        seq = [text[s + k] for k in range(length)]
        xs.append([c2i[c] for c in seq])
        ys.append([c2i[text[s + k + 1]] for k in range(length)])
    return torch.tensor(xs).long(), torch.tensor(ys).long()

class CharRNN(nn.Module):
    def __init__(self, vocab, hidden=16, emb=8):
        super().__init__()
        self.emb = nn.Embedding(vocab, emb)
        self.rnn = nn.RNN(emb, hidden, batch_first=True)
        self.fc = nn.Linear(hidden, vocab)
    def forward(self, x):
        h = self.rnn(self.emb(x))[0]
        return self.fc(h)

model = CharRNN(V3)
opt = torch.optim.Adam(model.parameters(), lr=1e-2)
ls = []
STEPS = 150                                 # torch 小规模训练 ≤400 步
for ep in range(STEPS):
    xb, yb = make_batch()
    logits = model(xb)
    loss = nn.functional.cross_entropy(logits.reshape(-1, V3), yb.reshape(-1))
    opt.zero_grad(); loss.backward(); opt.step()
    ls.append(loss.item())
    if ep % 30 == 0:
        print('ep %3d loss %.3f' % (ep, loss.item()))

with torch.no_grad():
    xb, yb = make_batch(200)
    pred = model(xb).argmax(-1)
acc = (pred == yb).float().mean().item()
print('训练集 next-char 准确率: %.3f' % acc)
assert acc > 0.9

# argmax 贪心生成:给 'h' 续写 20 个字符
with torch.no_grad():
    inp = torch.tensor([[c2i['h']]])
    out_chars = ['h']
    for _ in range(20):
        logits = model(inp)[0, -1]
        nxt = int(logits.argmax().item())
        out_chars.append(i2c[nxt])
        inp = torch.cat([inp, torch.tensor([[nxt]])], dim=1)[:, -SEQ:]
print('贪心生成:', ''.join(out_chars))

plt.figure(figsize=(7, 3.4))
plt.plot(ls)
plt.xlabel('step'); plt.ylabel('CE loss')
plt.title('字符级 RNN 训练收敛(hello world 循环)')
plt.grid(alpha=0.3); plt.tight_layout()
plt.savefig(os.path.join(IMG, 'nlp03_char.png'), dpi=110, bbox_inches='tight')
plt.show()
8.3b 读图:loss 曲线与"学会了什么"¶
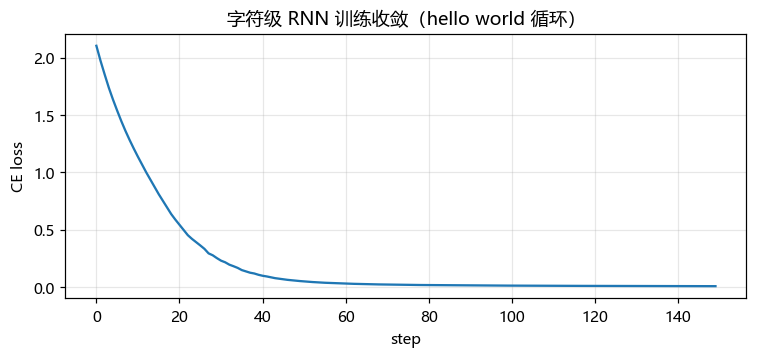
图 5:字符级 RNN 训练收敛曲线(本实验 3b 生成,自绘)
曲线在最初约 30 步从 ~2.4(均匀随机猜测 11 个字符的交叉熵 $-\ln\frac{1}{11}\approx2.40$)快速下降,之后进入平缓下降——前段是模型在学"字符分布",后段是精调 next-char 规则(hello 后必是空格、world 后必是空格……)。
和准确率对照着读:训练集 next-char 准确率 >0.9 说明模型真的记住了 11 字符语料的转移结构——这不是死记硬背(RNN 没有查表能力),而是 $h_t$ 把"当前前缀"压缩成可用状态、再据其预测下一个字符。贪心生成从 h 起步能续出标准答案,正说明"按序累积记忆"在小尺度上的可靠性;至于温度如何让同样的记忆"发挥",看 8.4 节与实验 3c。
# ---------- 实验 3c:采样温度 T 对生成多样性的影响 ----------
import numpy as np
import torch
torch.manual_seed(0); np.random.seed(0)

def sample_char(logits, T):
    logits = logits / T
    p = torch.softmax(logits, dim=-1)
    return int(torch.multinomial(p, 1).item())

def generate(seed_char, length, T):
    with torch.no_grad():
        inp = torch.tensor([[c2i[seed_char]]])
        out = [seed_char]
        for _ in range(length):
            logits = model(inp)[0, -1]
            nxt = sample_char(logits, T)
            out.append(i2c[nxt])
            inp = torch.cat([inp, torch.tensor([[nxt]])], dim=1)[:, -SEQ:]
    return ''.join(out)

print('===== 温度采样对比(语料: "hello world " 循环) =====')
for T in [0.3, 1.0, 2.5]:
    print('--- T = %.1f ---' % T)
    for _ in range(3):
        print('  ', generate('h', 12, T))

print('规律:T 小 → 接近贪心(稳定/易重复);T 大 → 多样(可能胡言乱语);T 是创造性与正确性的旋钮')
9. 局限:串行之痛 → 为什么需要 Attention¶
9.1 RNN 的三个天花板¶
- 串行计算:$h_t$ 必须等 $h_{t-1}$,$T$ 个时刻无法并行,长序列训练极慢;
- 长依赖容量有限:即便 LSTM/GRU 缓解了消失,$T$ 步后的信息也只能压缩在一个固定向量里,中距离信息会互相"挤占"(信息瓶颈);
- 难以"直达":第 1 个词到第 $T$ 个词要绕 $T$ 步;Attention 让任意两位置一步直达。
9.2 演进路线(一句话)¶
RNN/LSTM 的"递推记忆" → Transformer 的"并行注意力"(任意位置一步直达 + 全并行): $$h_t^{\mathrm{attn}} = \sum_j \alpha_{tj}\, v_j,\qquad \alpha_{tj} = \mathrm{softmax}_j\!\left(\frac{q_t^\top k_j}{\sqrt{d_k}}\right)$$ 下一篇(04-Attention 与 Transformer)会回答:Q/K/V 从哪来、为什么要除 $\sqrt{d_k}$、多头怎么做、位置编码为什么必须。
💡 但 RNN 没有退出历史舞台:轻量部署、流式/在线场景(逐词到达)、以及 Mamba 等"选择性状态空间模型"仍沿用递推思想。
9.3 RNN 家族谱系(记忆用)¶
Elman RNN(1990) → BPTT 训练 → LSTM(1997) / GRU(2014) → BiRNN(双向)→ seq2seq(2014) → Attention(2015) → Transformer(2017) → Mamba 等状态空间模型(2023)。RNN 家族靠"递推状态"换容量,Transformer 家族靠"两两直达"换并行——理解这条主线,后续 04/05 篇都在回答"递推还能不能更快、更准"。
10. 数字敏感度与易错点(背诵)¶
必记数字
- 参数量:RNN $H(D{+}H{+}1)$;LSTM $4H(D{+}H{+}1)$;GRU $3H(D{+}H{+}1)$;
- LSTM 每步 4 组权重 $(f,i,g,o)$;GRU 每步 3 组 $(z,r,\tilde h)$;
- 梯度裁剪常用
max_norm=1.0(或 5.0); - 遗忘门偏置初始值 ≈ 1(常见做法 $b_f=1$ 或 1~2);
- BiLSTM 隐状态维度 ×2;谱半径临界值 = 1;
- $\tanh$ 导数上界 = 1($h=0$ 处),饱和区 → 0;sigmoid 导数最大 0.25($z=0$ 处)。
易错点
- BPTT 不是"每步独立算梯度":$dW_{hh}$ 必须累加 $T$ 个时刻的贡献,漏累加是手写最常见的错;
- LSTM 遗忘门偏置初始化为正(≈1),不是 0——"默认记住"是设计意图;
- torch 中 LSTM gate 拼接顺序是
(i, f, g, o),GRU 是(r, z, n),手写对照时顺序错 = 全错; torch.nn.LSTM返回(output, (h_n, c_n)):output是所有时刻的 $h_t$(不是 $c_t$);batch_first别设错;- 梯度裁剪作用在所有参数的总范数上(拼成一个向量算范数),不是每个参数单独剪;
nn.RNN默认tanh激活(nonlinearity='tanh'),另一选项才是relu——别默认成 ReLU。
11. 面试速答(30 秒背诵版)¶
- RNN 核心公式:$h_t = \tanh(W_{xh}x_t + W_{hh}h_{t-1} + b_h)$;所有时刻共享参数,可处理任意长序列。
- 为什么需要 RNN:定长窗口丢长距离信息、n-gram 参数爆炸;词袋丢语序("我打了他" vs "他打了我")。
- BPTT vs BP:BPTT 把时间展开成 $T$ 层共享权重网络,梯度按时刻累加,链长 = 序列长度;BP 是静态深度网络。
- 梯度消失/爆炸根源:$\frac{\partial h_t}{\partial h_{t-1}}$ 连乘 ≈ $(W_{hh}^\top)^{T}$,谱半径 <1 消失、>1 爆炸。
- LSTM 为什么缓解消失:细胞状态 $c_t = f_t\odot c_{t-1} + i_t\odot\tilde c_t$ 是加性直通,$f_t\approx1$ 时 $\partial c_t/\partial c_{t-1}\approx1$,不经过权重连乘。
- 遗忘门偏置≈1:默认"多记住",给梯度高速路一个畅通起点,再按需学习遗忘。
- GRU vs LSTM:GRU 用更新门 $z$ 合并"忘+写",参数少 25%;效果相当,长期精确记忆略弱。
- 梯度裁剪治爆炸、不治消失:爆炸在浅层且数值大,可剪;消失是信息没传到,只能靠架构(LSTM/残差/Attention)。
- 为什么后来用 Transformer:RNN 串行不可并行、长依赖受固定隐状态容量限制;Attention 任意两位置一步直达 + 全并行。
11.1 面试连环问(追问版)¶
Q1:RNN 参数量为什么与序列长度无关? 所有时刻共享同一组 $(W_{xh}, W_{hh}, W_{hy})$,展开成 T 层只是"视觉上的深",实际参数只有一组;对应地,梯度要按 T 个时刻累加(BPTT 的本质)。
Q2:梯度消失为什么"调大学习率/换初始化"治标不治本? 消失是乘法链路问题——信号每传一步就乘一次 $\|W_{hh}^\top\|\cdot\|\mathrm{diag}(1-h^2)\|\le\rho(W_{hh})$;调参只能微调因子大小,改不了"指数连乘"的结构。只有改链路结构(LSTM/GRU 加性直通、残差连接、Attention 两两直达)才能根治。
Q3:LSTM 为什么需要 $c$ 和 $h$ 两个状态? $c$ 是"长期仓库"(低速通道,加性更新、靠遗忘门缓慢读写);$h$ 是"对外视图"(高速通道,每步都要被输出层读取)。若只有一个状态,它既要长期保存又要每步输出,旧信息会和新预测互相干扰——两个状态把"记忆"与"表达"解耦。
Q4:温度 $T$、top-k/top-p、beam search 各管哪一层? $T$ 与 top-k/top-p 都是采样层技巧(单条生成时控制"随机性":$T$ 调分布陡峭度、top-k 截断候选、top-p 按累积概率截断);beam search 是解码层搜索技巧(同时保留 K 条候选路径)。两者正交,工业级生成常叠加使用。
Q5:为什么 RNN 激活用 tanh、门控却用 sigmoid? tanh 输出关于 0 对称、有界,状态反复迭代不会单向漂移;sigmoid 输出天然落在 (0,1),语义就是"比例/开关"。另外门控的饱和是设计意图(全开/全关),而 tanh 饱和则意味着"记忆写不动"——两者饱和的后果完全不同。
12. 自测清单(写完代码后再看)¶
- 口算:$D=8, H=16, V=32$ 时 RNN / LSTM / GRU 各多少参数量(用 $H(D{+}H{+}1)$ 系列公式)
- 默写 RNN 前向公式,并解释为什么用 $\tanh$ 而不是无上界的 ReLU
- 默写 BPTT 三条梯度链($W_{hy}$ / $W_{xh}$ / $W_{hh}$),说明每条链的累加结构与链长
- 手写 RNN 前向 + BPTT,数值梯度验证 <1e-6(实验 1)
- 说清谱半径 <1 / >1 / =1 分别对应什么,以及正交初始化为什么把谱半径设为 1
- 默写 LSTM 四门公式与 $c_t, h_t$ 更新式;说出 torch 的 gate 顺序 (i,f,g,o)
- 手写 LSTM 前向与
torch.nn.LSTM对照 <1e-5(实验 2b) - 解释遗忘门偏置≈1 的原因,并说明 $b_f=0$ vs $b_f=1$ 的 $f_t$ 均值差异(实验 2b-2)
- 默写 GRU 两门公式,与 LSTM 参数对比(3H vs 4H),手写 GRU 与 torch 对照 <1e-5(实验 2c)
- 跑通梯度裁剪演示:手写 clip 与
clip_grad_norm_结果一致(实验 3a) - 跑通 CharRNN 训练(next-char acc > 0.9)并分别用 $T=0.3/1.0/2.5$ 采样生成(实验 3b/3c)
- 回答"为什么爆炸可剪、消失只能靠架构"
💡 下一篇预告:
04-Attention 与 Transformer——RNN 的"递推记忆"将被"并行注意力"取代: 任意两位置一步直达、$O(T^2)$ 全并行、Q/K/V 与 $\sqrt{d_k}$ 的数学动机。