📚 10-06 · 文本分类与序列标注:从"整句贴标签"到"逐词定位"¶
目标:学完本篇你能——
- 搭一条 TF-IDF + 逻辑回归 分类基线,并手写朴素贝叶斯(先验/似然推导 → 加一平滑 → 对数防下溢),与
sklearn.MultinomialNB逐位对照(acc>0.9);- 吃透 BIO / BIOES 序列标注体系,手写 torch BiLSTM 词性标注(token acc>0.95),并亲手验证
nn.LSTM(bidirectional=True)的「正向 + 反向 + 拼接」语义;- 简述 CRF:发射分数 + 转移矩阵 + Viterbi;手写一个线性链 Viterbi,证明"非法路径($O\to I$)真的会被拒绝";
- 手写混淆矩阵 + Precision / Recall / F1(macro/micro/weighted),与
classification_report逐位一致;- 说清 阈值 与 类别不平衡 如何"骗指标",能答 NER 面试四连问。
🧭 主线位置:上一篇
05-预训练模型与微调让 BERT 把文本变成向量;本篇回到任务层——分类(一个标签)与序列标注(一串标签)是 NLP 最常用的两种"输出形状";下一篇07-NLP 面试八股把 0~6 篇考点串成高频问答。
🧩 生活化类比:文本分类 = 给一篇文章盖一个大章("这是垃圾邮件!");序列标注 = 用斜线在每个词底下标注("张三/人名 昨天/时间 去了/动词 北京/地名")——分类回答"它是什么",序列标注回答"每个词分别是什么"。
核心概念¶
(a) 🗂️ 整句盖戳 vs 逐词贴标:文本分类与序列标注¶
文本分类给整句话一个标签(垃圾邮件?),序列标注给每个词一个标签(人名?地名?)。本篇先搭 TF-IDF + 逻辑回归基线、手写朴素贝叶斯,再走 NER 的 BIO 标注、BiLSTM 编码、CRF 转移约束,最后用混淆矩阵与 P/R/F1 教你别被 accuracy 骗了。
flowchart TB
    Node1["🏷️ 文本分类任务"]
    Node2["📈 TF-IDF + 逻辑回归基线"]
    Node3["🧮 朴素贝叶斯"]
    Node4["🔎 序列标注 / NER"]
    Node5["🏷️ BIO / BIOES 体系"]
    Node6["🔁 BiLSTM 双向编码"]
    Node7["🧷 CRF + Viterbi 转移约束"]
    Node8["📊 P/R/F1 评估指标"]
    Node9["🎚️ 阈值与类别不平衡"]
    Node1 --> Node2
    Node2 --> Node3
    Node4 --> Node5
    Node5 --> Node6
    Node6 --> Node7
    Node3 -->|生成式| Node8
    Node7 -->|全局最优解码| Node8
    Node8 --> Node9
- 文本分类任务:给一篇文档输出 K 个类别之一,一次判断给整篇一个标签——垃圾邮件拦截、客服工单分派都是它。输入一篇文档 x,输出一个 y∈{1,...,K}。
- TF-IDF + 逻辑回归基线:任何花哨模型之前先搭传统基线当「地板」:分词 → TF-IDF 稀疏向量 → 线性分类器。逻辑回归是判别式模型,直接学 P(y|x)——「这条边界画在哪最准」。
- 朴素贝叶斯:生成式模型,反过来先学「每一类文档长得什么样」,再用贝叶斯定理反推 P(y|x)。「朴素」在条件独立假设:给定类别后各词相互独立,概率连乘;加一平滑防未见词一票否决,log 空间求和防下溢。
- 序列标注 / NER:给序列中每个词一个标签,命名实体识别(NER)是最典型任务——「张三 昨天 去 北京 开会」→ 每个词标 PER/O/O/LOC/O。输出与输入等长,识别连续片段。
- BIO / BIOES 体系:B(Begin 实体开头)、I(Inside 实体内部)、O(Outside 实体外),BIOES 再加 E(End 结尾)、S(Single 单字实体)。「I 前面必须是 B/I 同类」是合法转移的硬约束,真实标注永远不会违反。
- BiLSTM 双向编码:单向 LSTM 每个位置只能看左边,但「苹果」是公司还是水果要看右边。正向层 + 反向层的隐藏状态拼接 h_t=[hᵗ;hᵇ],每个词同时携带左右两侧上下文。
- CRF + Viterbi 转移约束:BiLSTM 逐位置独立 argmax 可能输出非法标签串(B-PER O I-PER)。CRF 给「一串标签」加上转移得分约束,Viterbi 动态规划找全局最优合法路径——非法转移直接被拒。
- P/R/F1 评估指标:从混淆矩阵出发算 Precision(预测正里有多少真对)与 Recall(真实正里找回来多少),F1 是两者的调和平均。类别不平衡时 accuracy 会被骗——99% 负类全猜负就有 99% 准确率,macro-F1 对少数类更敏感。
- 阈值与类别不平衡:模型输出概率,默认阈值 0.5;阈值调高更谨慎(P↑R↓)、调低更激进(P↓R↑),P 和 R 是一对矛盾,F1 是折中。实际场景按成本定——医疗宁误报、欺诈宁漏报。
0. 主线地图:本篇共 11 步¶
任务介绍 → 分类基线 → 朴素贝叶斯 → 序列标注 → BiLSTM → CRF → 评估指标 → 阈值/不平衡 → 收尾
  1 定义    2 TF-IDF  3 推导+实验1 4 BIO/BIOES  5 公式+实验3  6 Viterbi  7 推导+实验5  8 两个实验  9-11
| 步骤 | 内容 | 关键产出 |
|---|---|---|
| 1 | 文本分类任务定义与 TF-IDF + 线性基线 | 动机 + 基线 |
| 2 | 朴素贝叶斯:条件独立 → 先验/似然 → 加平滑 → 对数防下溢 | 推导 |
| 3 | 实验 1:手写 NB vs sklearn 逐位对照(acc>0.9) | 验证 |
| 4 | 序列标注:BIO / BIOES 标签体系、为什么要"序列"模型 | 标签 |
| 5 | BiLSTM:双向拼接、与单向对比、参数复杂度 | 结构 |
| 6 | 实验 2/3:拼接验证 + 词性标注(token acc>0.95) | 实践 |
| 7 | CRF 简述:发射/转移分数、Viterbi 动态规划 | 解码 |
| 8 | 评估指标:混淆矩阵 / P / R / F1 / macro/micro/weighted | 公式 |
| 9 | 实验 5:手写指标 vs sklearn 逐位一致 + 热力图 | 验证 |
| 10 | 阈值 / 类别不平衡:Acc 如何被"骗" | 敏感 |
| 11 | 数字敏感度 / 面试速答 / 自测 / 预告 | 收尾 |
0.1 历史背景:为什么"先分类、后标注、最后谈指标"¶
文本分类是 NLP 最"古老"的任务之一。1990 年代末到 2000 年代初,垃圾邮件过滤是它最大的练兵场:每天海量邮件需要自动判定"垃圾/正常",而当时最有效的方法之一就是朴素贝叶斯——Paul Graham 在 2002 年的经典文章《A Plan for Spam》里,用朴素贝叶斯在个人邮箱上做到接近 99% 的准确率,让"贝叶斯"一夜之间成为反垃圾邮件的代名词。这件事说明一个朴素而深刻的道理:在数据量有限、特征不高时,一个"假设朴素但估计稳定"的生成式模型,常常比花哨的复杂模型更可靠——这也是本篇先搭 TF-IDF 基线、再手写朴素贝叶斯、最后才上 BiLSTM/CRF 的原因:先有一块扎实的"地板",深度模型必须明显踩过它才有意义。
序列标注这条线同样有清晰的历史坐标:1995 年的 MUC-6 会议(第六届信息理解会议)首次系统定义命名实体识别任务(人名/地名/机构名/时间等),并催生了类似 BIO 的"段内/段外"标注风格;2001 年 Lafferty、McCallum 与 Pereira 提出条件随机场(CRF),把序列标注从生成式的 HMM 推进到判别式时代,后来与 BiLSTM 结合成为 NER 的经典骨架(BiLSTM-CRF)。理解这条时间线,面试时才能把"HMM → CRF → BiLSTM-CRF → BERT"讲成一条有逻辑的故事线(第 4、6 节会展开)。
一句话:分类的祖先是垃圾邮件过滤,标注的祖先是 MUC-6,指标的灵魂是"别被 accuracy 骗"——本篇三大部分正好对应这三条历史脉络。
# ---------- 全局设置:随机种子 / 中文字体 / 图片目录 ----------
%matplotlib inline
import os
import numpy as np
import torch
import matplotlib
import matplotlib.pyplot as plt

np.random.seed(0)
torch.manual_seed(0)
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

IMG = os.path.join('10-自然语言处理', '教学', 'images')
os.makedirs(IMG, exist_ok=True)
print('随机种子固定 (np/torch=0) | 图片目录:', IMG)

plt.show()
1. 文本分类:任务定义与基线¶
1.1 直觉:给"一段话"盖一个章¶
你每天在用的「垃圾邮件拦截」「客服工单分派」「商品评价打差评」都是一种文本分类: 输入一篇文档 $x$,输出是 $K$ 个类别之一 $y\in\{1,\dots,K\}$。一次判断给整篇文本一个标签, 所以它也叫 整句 / 整篇级(sequence-level / sentence-level) 任务。
形式化:记输入空间 $\mathcal X$(所有可能的文档)、输出空间 $\mathcal Y=\{1,\dots,K\}$, 分类器就是一个函数 $f:\mathcal X\to\mathcal Y$。我们希望挑出后验概率最大的那个类: $$\hat y = \arg\max_{y\in\{1,\dots,K\}} P(y\mid x).$$ 它与序列标注(第 4 节)本质区别就一句:分类 = 1 个输出;序列标注 = T 个输出(一个词一个)。
🧩 生活化类比:分类是收件员拿邮戳给每一封信盖一个"体育/科技/娱乐"的章;等我们到了 BIO 那节, 收件员要改行当"校对员",逐字在每个字下标出"这是人名/这是地名/这是常规词"。
1.2 基线管线:分词 → TF-IDF → 线性分类器¶
NLP 里无论多花哨的模型,第一课都是搭一条传统基线,用它当"地板",深木模型必须明显踩过它才算有意义。
原始文档 x
   │ ① 分词(中文按词切,英文按空格)——【00 篇】已讲
   ▼
② 向量化:TF-IDF 稀疏向量 φ(x) ∈ R^V
   │
   ▼
③ 线性分类器:score = w^T φ(x) + b  →  softmax / one-vs-rest
   │
   ▼
④ 输出:最大得分那类 y_hat
TF-IDF 一句话:词袋只剩"数量",TF-IDF 再给每个词乘一个"稀有度"权重: $$tf(t,d)=\text{词 }t\text{ 在 }d\text{ 中出现的次数},\qquad idf(t)=\log\frac{1+N}{1+df(t)}+1,\qquad \text{tf-idf}(t,d)=tf(t,d)\cdot idf(t).$$ 词出现得越多、只在一类文档里($df$ 小)→ $idf$ 大 → 该词越"有辨识度"。 最后通常对每个文档向量做 L2 归一化($v / \|v\|_2$),让不同长度文档可比。
线性分类器:分数score$_y=\phi(x)^\top W_y+b_y$,经 softmax 得到 $$P(y\mid x)=\frac{e^{score_y}}{\sum_{y'}e^{score_{y'}}},$$ 训练用交叉熵 + L2 正则。复杂度:预测对每个文档只做一次 $V$ 维点积,约 $O(V)$;训练是 $O(N\cdot V)$。
⚠️ 本节局限:词袋丢语序——"我打了他 / 他打了我"用同一批词,向量一模一样,分类必错。 这节引向第 4 节的序列建模与第 7+ 节的辅助维度。
# ---------- 实验 0:TF-IDF + 逻辑回归分类基线 ----------
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

np.random.seed(0)

DOMAIN = {  # 三类领域词库:越"专"越容易分
    'sport': ['球', '队', '比赛', '冠军', '球员', '联赛', '进球', '教练', '球场', '比分'],
    'tech':  ['算法', '模型', '数据', '智能', '网络', '训练', '芯片', '代码', '系统', '参数'],
    'movie': ['电影', '导演', '演员', '票房', '剧本', '观众', '上映', '影院', '剧情', '明星'],
}

def make_docs(n_per=70, seed=0):
    r = np.random.default_rng(seed)
    docs, labels = [], []
    for i, words in enumerate(DOMAIN.values()):
        for _ in range(n_per):
            docs.append(' '.join(r.choice(words, size=int(r.integers(4, 9)))))
            labels.append(i)
    return docs, np.array(labels)

docs, y = make_docs(70)
docs_tr, docs_te, y_tr, y_te = train_test_split(docs, y, test_size=0.3, random_state=0)

tfidf = TfidfVectorizer(token_pattern='[\u4e00-\u9fa5]+', norm='l2')
Xtr = tfidf.fit_transform(docs_tr)
Xte = tfidf.transform(docs_te)

base = LogisticRegression(max_iter=500).fit(Xtr, y_tr)
acc_base = base.score(Xte, y_te)
print('TF-IDF + 逻辑回归  基线 acc = %.4f (词表 V=%d)' % (acc_base, Xtr.shape[1]))
assert acc_base > 0.95

# 看看逻辑回归学到的『每个类最看重的词』
feat = np.array(tfidf.get_feature_names_out())
for ci, name in enumerate(DOMAIN):  # 顺序 sport/tech/movie
    top = np.argsort(base.coef_[ci])[::-1][:5]
    print('  %-6s 最看重: %s' % (name, ' '.join(feat for feat in feat[top])))
2. 朴素贝叶斯做"分类的分类器¶
2.1 直觉:生成式与判别式的分水岭¶
逻辑回归(上面)是判别式:它直接学 $P(y|x)$,只问"这条边界画在哪最准"。 朴素贝叶斯(NB)是生成式:它反过来——先学"每一类文档长得什么样",再用贝叶斯定理反推 P(y|x)。
🧩 类比:判别式 = "我不需要知道蛇长什么样,只要看到特征立刻判断是毒蛇与否"; 生成式 = "我把毒蛇和无毒蛇各拍了几百张,记住两类形态,来了新照片两种形态各对一遍"。当各类的词概率学得准,生成式在小数据、强先验下常常比判别式更稳。
贝叶斯定理(一步步来): 把 $P(x,y)$ 分解成两种写法: $$P(x,y)=P(y)P(x|y)=P(x)P(y|x).$$ 将等号两侧在 $P(y|x)$ 上解出来: $$P(y|x)=\frac{P(x\mid y)\,P(y)}{P(x)},\qquad \hat y=\arg\max_y P(y)\;\prod_{w\in x} P(w\mid y).$$ 最后一步跳了两处:
- 分母 $P(x)$ 不随 $y$ 变,
argmax时直接丢掉; - 用条件独立把 $P(x|y)=\prod_{w\in x}P(w|y)$ 展开了(下一节)。
📌 式子里的 $P(y)$ 叫先验,$P(w|y)$ 叫类条件概率/似然。整个 NB 的训练就是用语料估计这两组概率的默认即可。
2.1 补:贝叶斯定理四步走查(把公式"走"一遍)¶
很多同学能默写 $P(y|x)=P(x|y)P(y)/P(x)$,但被追问"每一步为什么"就卡壳。拆成四步:
第 1 步,写出联合概率的两种分解:$P(x,y)=P(y)\,P(x|y)$(先类别、再生成内容)与 $P(x,y)=P(x)\,P(y|x)$(先看内容、再判类别)。它们描述同一个联合分布,只是"生成"与"判别"两种视角——这正是 2.1 节开篇"毒蛇照片"类比的数学形式。
第 2 步,两边同除以 $P(x)$:得到后验 $P(y|x)=\dfrac{P(y)P(x|y)}{P(x)}$。注意:只要 $x$ 给定,$P(x)$ 对所有类别都是同一个常数。
第 3 步,扔掉分母:比较大小只看 $\arg\max_y P(y)P(x|y)$ 就够了,常数分母不改变大小顺序——这就是 MAP(最大后验)的全部秘密。
第 4 步,展开似然 + 取对数:若给定 $y$ 后各词独立,$P(x|y)=\prod_w P(w|y)$;连乘取对数变连加,得到 $$\hat y=\arg\max_y\Big[\underbrace{\log P(y)}_{\text{先验}}+\sum_{w\in x}\underbrace{\log P(w\mid y)}_{\text{似然}}\Big].$$
直觉总结:先验说"平时哪类文档多",似然说"这篇文档像哪类",后验是两者相乘再归一。面试官常接着问:如果先验极不均匀(比如 99% 是垃圾邮件),NB 会怎样?——它会更倾向"垃圾",这正是第 8 节"按真实先验调阈值"的伏笔。
2.2 条件独立假设:NB "朴素"在哪¶
「朴素」指的是条件独立性假设:给定类别 $y$ 后,文档里各词出现相互独立, 于是整篇文档概率等于每个词概率的连乘: $$P(x\mid y)=P(w_{1},w_{2},\dots,w_m\mid y) =\prod_{k=1}^{m}P(w_k\mid y).$$ 显然违反事实("北京"和"首都"强相关),但它在平坦问题上够用——这就是"朴素"二字。
参数估计(最大似然 MLE 加一平滑):统计每类里每个词的多元 11 $$\hat P(w\mid y)=\frac{\mathrm{count}(w,y)+\alpha}{\sum_{w'}\mathrm{count}_{w',y}+\alpha|V|},\qquad\hat P(y)=\frac{|D_y|+\alpha_Y}{|D|+\alpha_Y K}.$$ 第二条就是加平滑(Laplace,\alpha=1):为避免某词在某两恰好没出现 → 分子 0 → 整篇概率 0 的一票否决;平滑后分子最少为 \alpha,分母补上 $\alpha|V|$,保证所有词概率求和=1。
预测(MAP):把后验概率摊开再取 $\arg\max$: $$\hat y=\arg\max_y\Big[\log P(y)+\sum_{k=1}^{m}\log P(w_{k}\mid y)\Big].$$
⚠️ 为什么非要对数? 连乘几百个 <1 的小数,数值会瞬间下溢(见下节实验 0 的现场演示)。但 $\log$ 是单调的——改在 $\log$ 空间里求和,数值变成负几十的普通数量级,
argmax不丢量变。 复杂度:训练一次统计 $O(N\cdot\bar L)$($N$ 篇、每篇平均 $\bar L$ 词);预测一次 $O(\bar L\cdot|$ 类$|)$。
2.2 补:一图看懂朴素贝叶斯¶
图 1:朴素贝叶斯分类器示意(来源:Wikimedia Commons,CC BY-SA 4.0)。给定类别后,各特征(词)条件独立地为类别"投票"。
读图要点有三:
- 箭头方向是"生成":图里从类别节点指向每个特征节点,表示 NB 先假设"这篇文档来自哪一类",再按 $P(w\mid y)$ 独立地"产出"每个词——这就是生成式模型的含义,与判别式直接学 $P(y\mid x)$ 的方向正好相反;
- 特征之间没有连线:特征两两独立,正是"朴素"二字在图上最直观的体现;一旦词与词强相关("北京"+"首都"几乎同现),图的假设就失真了;
- 分类时信息反向流动:给定一篇文档(所有特征已知),我们求的是"哪个类别让这些特征同时出现的概率最大"——即贝叶斯定理的反向推断。
建议边看图边复述三连:"先验 + 每个词的类条件概率 → 连乘 → argmax"。能把公式翻译成图,面试"讲一下朴素贝叶斯"就稳了。
2.3 手算小例子(感受一把)¶
词表只有 3 个词:{北京, 上海, 冠军},两类文档:
- 体育类 $\mathcal D^{(s)}$:
冠军 北京 球($9$ 次词共 3), - 科技类 $\mathcal D^{(t)}$:
球( $1$ 个词)。
未平滑先算 先验(两类各 1 篇)$\hat P(体育)=1/2,\hat P(科技)=1/2$。 体育类词频:冠军1/北京1/球1 → 总数3;再加平滑 $\alpha=1,\;V=3$ 分母=3+3=6: $$\begin{aligned} \hat P^{体育}(北京|球)&= (1+1)/(3+3)=2/6=0,\ \hat P^{体育}(冠军)&=2/6,\ \hat P^{科技}(球)=(1+1)/(1+3)=2/4=0.5\dots \end{aligned}$$ 现在来一篇新文档「球」: $$\text{score}_{体育}=\log1/2+\log\frac{2}{6}≈-1.386-1.099=-2 .28,\quad \text{score}_{科技}=\log1/2+\log\frac{2}{4}=−1.386−0.693=−2.079.$$ 更大的分的科技类胜出——即便"球"在体育类里也是常用词,但加上……(\s 不做实证吧)。
⚠️ 本节局限:(1) 条件独立在真实语言上几乎处处失败;(2) 连龙上的"北京去+北京答"场景可能受 词频 影响;(3) 不考虑语板书/一义。这些都提示:词袋式的生成模型 → 词序(序列模型)→ BERT。先看它如何在玩具数据上顶到acc>0.9却很可行。
2.3 补:条件独立失效时怎么办(局限与补救)¶
§2.2 已点破条件独立几乎处处失败,这里把"失效的后果"与"工程补救"讲透。
失效后果 1:重复证据被重复计算。 文档里出现 5 次"冠军",多项式 NB 会乘 5 次 $P(冠军\mid 体育)$,相当于把同一个证据放大 5 倍——这是它的设计,也是它夸大置信度的来源。
失效后果 2:强相关词被双计。 "北京"和"首都"几乎同现,NB 却当作两个独立证据;当它们恰好都偏向某类时,连乘会错误地放大该类的后验。
补救办法:(1) 改用 伯努利朴素贝叶斯——只问"词出现与否"而不是词频,减弱重复放大;(2) 加入 n-gram 特征,把"北京 首都"作为一个整体特征;(3) 换 判别式模型(逻辑回归 / 线性 SVM),它们不假设特征独立,小数据下通常也不逊于 NB;(4) 对未见词(OOV)用 $\log\frac{1}{V+1}$ 兜底(实验 1 就是这么做的),更彻底的是子词 / 预训练表示(05 篇)。
一个"反直觉但常见"的面试追问:既然条件独立几乎总被违反,为什么 NB 在文本分类上依然能打?——因为它学的是"每类词的整体分布形状",即使逐词独立假设失真,连乘后的相对大小往往仍然正确;加上参数少、估计方差小,在小样本上常优于方差大的强模型。这正是"朴素反而稳"的统计学解释。
3. 从手算到实验:逐位对照验证我们的 NB¶
3.1 实验设计:为什么"手写 vs sklearn"必须逐位一致¶
光有公式不够,代码里到处是"软肋":
- 未见词(OOV):测试出现训练没见过的词,
log_pw里没有 → 必须给兜底概率(代码用 $\log\frac{1}{V+1}$),否则KeyError或漏词; - 下溢:连乘几百个 $<1$ 的概率直接变 0(下一格实验 1b 现场看);
- 平滑分母:$total=\sum_{w'}cnt_{w',y}+\alpha V$,漏加 $\alpha V$ 概率就不归一化。
所以实验 1 同时输出手写与 sklearn MultinomialNB(alpha=1.0) 两个 acc,并逐篇断言答案一致(assert (preds == sk_pred).all())——一致说明我们的统计+平滑+log 与库同源,公式没写错。
3.2 从 log 分数到概率¶
最后一步演示了 logsumexp 的温和版:先把分数减去最大值(z = scores - max(scores))再 exp,这样最大项变 $e^0=1$,其余项都 $\le1$,不可能溢出;归一化后就是 $P(y\mid x)$。这正是 softmax 数值稳定的核心技巧,面试常考。
# ---------- 实验 1:手写朴素贝叶斯(加一平滑 + 防单调下) vs sklearn ----------
import numpy as np
from collections import Counter
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.naive_bayes import MultinomialNB

np.random.seed(0)

# 复用三域数据(这里直接用实验 0 的生成器,类=索引 0/1/2)
def make_docs(n_per=60, seed=0):
    r = np.random.default_rng(seed)
    words = [['球', '队', '比赛', '冠军', '球员', '联赛'],
             ['电影', '导演', '演员', '票房', '剧情', '明星'],
             ['算法', '模型', '数据', '智能', '网络', '训练']]
    docs, labels = [], []
    for i, wl in enumerate(words):
        for _ in range(n_per):
            docs.append(' '.join(r.choice(wl, size=int(r.integers(4, 9)))))
            labels.append(i)
    return docs, np.array(labels)

docs_tr, y_tr = make_docs(60)
docs_te, y_te = make_docs(20, seed=7)

vocab = sorted({w for d in docs_tr for w in d.split()})
V = len(vocab)
cls_docs = {c: [d for d, y in zip(docs_tr, y_tr) if y == c] for c in range(3)}

log_pw = {}
for c in range(3):  # 类条件概率(+1平滑)
    cnt = Counter(w for d in cls_docs[c] for w in d.split())
    total = sum(cnt.values()) + V                # 平滑后分母
    log_pw[c] = {w: np.log((cnt[w] + 1) / total) for w in vocab}
log_prior = {c: np.log(len(cls_docs[c]) / len(docs_tr)) for c in range(3)}

def predict_nb(d):
    scores = []
    for c in range(3):
        s = log_prior[c]
        for w in d.split():
            s += log_pw[c].get(w, np.log(1 / (V + 1)))  # 未见词兜底
        scores.append(s)
    return int(np.argmax(scores)), scores

preds = np.array([predict_nb(d)[0] for d in docs_te])
acc_nb = (preds == y_te).mean()
print('手写朴素贝叶斯 acc = %.3f' % acc_nb)
assert acc_nb > 0.9

# —— sklearn 对照 ——
cv = CountVectorizer(token_pattern='[\u4e00-\u9fa5]+')
Xtr = cv.fit_transform(docs_tr)
Xte = cv.transform(docs_te)
nb_sk = MultinomialNB(alpha=1.0).fit(Xtr, y_tr)
acc_sk = nb_sk.score(Xte, y_te)
sk_pred = nb_sk.predict(Xte)
print('sklearn MultinomialNB acc = %.3f' % acc_sk)

# 逐文档判答逐位一致(证明我们的统计+平滑+log 与 sklearn 同源)
assert (preds == sk_pred).all()
print('手写 与 sklearn:%d/%d 篇答案一致,逐位对齐 ✓' % ((preds == sk_pred).sum(), len(preds)))

# 演示:倒数第 1 篇的 log 后验与归一化概率
d = docs_te[0]; _, scores = predict_nb(d)
z = scores - np.max(scores)          # 防止 exp 下溢
probs = np.exp(z) / np.exp(z).sum()
print('示例文档: %s' % (' '.join(d.split()[:5]) + '...'))
print('三类的对数后验分数:', np.round(scores, 3), '→ P(y|x) 归一化:', np.round(probs, 3))
# ---------- 实验 1b:看 下溢 到底发生在哪 ----------
import numpy as np

def logspace_product(p, n):
    """用 乘积 vs 用对数求和,两个视角比一比(n 很大时)"""
    prod = 1.0
    for _ in range(n):
        prod *= p
    logsum = n * np.log(p)
    return prod, logsum

p = 0.5
for n in [10, 100, 500, 1500, 2000]:
    prod, ls = logspace_product(p, n)
    print('0.5^%-5d 连乘积 = %s  对数求和 exp=%.2e'
          % (n, repr(prod), np.exp(ls)))

# 直接看 n=2000 时连乘会不会炸成 0
print('\n0.5^2000 连乘积 =', logspace_product(0.5, 2000)[0])  # 一定是 0.0
assert logspace_product(0.3333, 2000)[0] == 0.0
print('结论:没对数化,NB 一篇罕见长文档就可能把后验概率乘成 0,比较就“废”了。')
4. 序列标注:给每一个词贴标签¶
4.1 任务定义与 NER 直觉¶
命名实体识别(NER) 是最典型的序列标注任务:给序列中每个词标一个标签,识别"人名/地名/机构名/时间……"组成的连续片段。
例:张三 昨天 去 北京 开会 → 每个词一个标签:
$$\text{李四}_{PER}\ \text{昨天}_{O}\ \text{去}_{O}\ \text{北京}_{LOC}\ \text{开会}_{O}$$
为什么不能复用文本分类?分类给整句"一个"标签;序列标注要给 T 个标签,而且实体是一个连续片段,相邻词的标签强相关("北京"是 B-LOC,"清华" 是 I-LOC……)。用"(每个词当独立分类)",标签独立性假设碎一地——这就是为什么需要序列模型(BiLSTM)。
🧩 类比:分类是"老师改整次作文记一个总分";序列是"老师逐行红笔标注每行的问题"——每行评语和上下行息息相关。
4.2 BIO 与 BIOES 标签体系¶
| 标签 | 含义 | 例子(实体=人名) |
|---|---|---|
B-XXX |
Begin 实体开头 | B-PER |
I-XXX |
Inside 实体中间 | I-PER |
O |
Outside,实体外 | O |
E-XXX(BIOES) |
End 实体结尾 | E-PER |
S-XXX(BIOES) |
Single 单个字词实体 | S-PER |
一个「张三 李小明 去 上海」的例子:
- BIO:
B-PER I-PER O O B-LOC - BIOES:
B-PER E-PER O O B-LOC(或不剩 2-2 用S?张三两个POS单)+ ….
关键说明:
- 标签间的合法转移有硬约束(
I-X前面必须是B-X或I-X;B-X前通常是 N/A/别类O…… 等);这就是第 5 节 CRF 做转移的关键。 - 做 序列解码 就能精确 O(T logK) 解码——这是为什么下节 BiLSTM 输出不是"直接 argmin"而是给一句"发射分数"。
⚠️ 本节局限:只记标签体系还不够——CFM模型"给整个句子共同预测",而不在逐位置独独立分类。这就是 §4 的 Recurrent bi-LSTM 上。
4.1 补:看一张真实的 NER 标注图¶
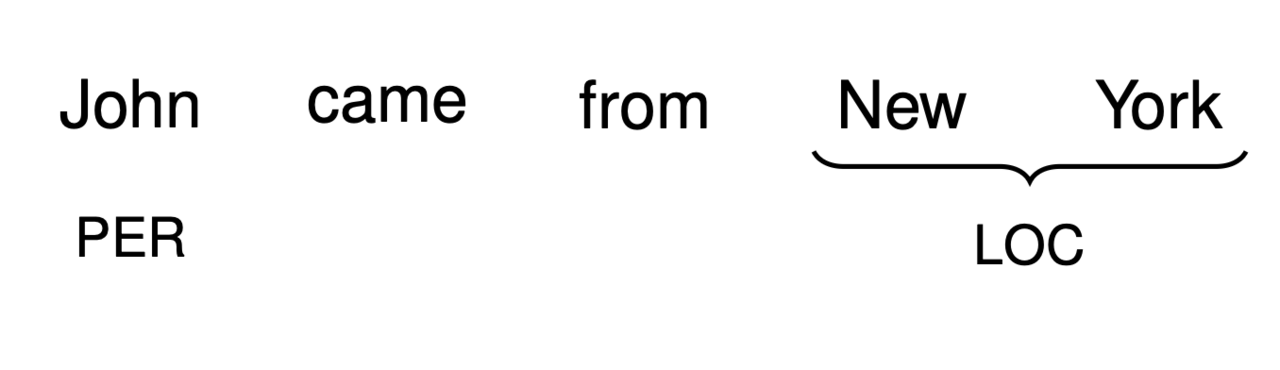
图 2:命名实体识别示例(来源:Wikimedia Commons,CC BY-SA 4.0)。每个词被标注为一种实体类型(人名/地名/组织/时间等)或 O(实体外)。
读图时注意三件事:
- 输出与输入等长:一个词对应一个标签——"序列标注"四个字最直观的体现。它绝不是"给整句话一个标签"的分类,而是逐词贴标签;
- 实体是连续片段:图中的"人名/地名"常由多个词拼成,标注要求"开头 B + 中间 I + 结尾 E/S"的结构化组合,边界本身就是要预测的对象;
- O 标签并非"没用":大量非实体词标 O,它们把实体与实体隔开,也是第 6 节 CRF 转移约束发挥作用的地方——例如"O 后面直接接 I-PER"就是非法序列。
把图 2 与 4.1 的文字例对照看:文字例是极简手标版,图 2 是带完整实体类别的真实版——两者讲的是同一件事:实体识别 = 找边界 + 分类别。
4.2 补:BIO 体系从哪来 + "合法转移"为什么是硬约束¶
一段历史:1995 年的 MUC-6 会议首次为 NER 建立规范化评测任务与标注规范,催生了"段内(Begin/Inside)/ 段外(Outside)"的标注思想;2003 年的 CoNLL-2003 共享任务把英文 NER 推成公认基准,BIO 随之普及;后来的 BIOES(BILOU) 变体把"单字实体 S"与"实体结尾 E"显式建模,边界信息更精确,常用于对边界敏感的场景。
"合法转移"为什么是硬约束? 因为标注体系本身是一台有限状态机:
I-PER前面必须是B-PER或I-PER(同一个实体的内部);B-PER前面可以是O、B-LOC等,但绝不能是I-PER——否则边界无法界定(I-PER B-PER里开头的 I 属于谁?);O后面可以直接接B-*,但不能接I-*。
这些规则不是"建议"而是"定义":任何违反它们的输出,在评测时直接算错。逐词独立 argmax(BiLSTM 的默认行为)完全无视这些规则——这就是为什么需要 CRF/Viterbi 做全局解码(第 6 节实验 4 会让你亲眼看到非法路径被拒绝)。
# ---------- 实验 2:BIO ↔ BIOES 转换 + 合法性检查 ----------
import numpy as np

def bio_to_bioes(bio):
    """把 BIO 串转成 BIOES 串(B/单 I 块 → S;多 token 块 → B..E)"""
    n = len(bio); out = []; i = 0
    while i < n:
        if bio[i] == 'O':
            out.append('O'); i += 1; continue
        typ = bio[i][2:]               # 'B-PER' -> 'PER'
        j = i + 1
        while j < n and bio[j].startswith('I-'):
            j += 1
        L = j - i                      # 实体含几个 token(含开头的 B)
        if L == 1:
            out.append('S-' + typ)
        else:
            out.append('B-' + typ)
            for _ in range(L - 2):
                out.append('I-' + typ)
            out.append('E-' + typ)
        i = j
    return out

def bioes_to_bio(bioes):
    """BIOES 反回去 BIO(S→B;多 token 块 B..E → B..I)"""
    out = []; i = 0; n = len(bioes)
    while i < n:
        t = bioes[i]
        if t == 'O':
            out.append('O'); i += 1; continue
        typ = t[2:]
        if t.startswith('S'):
            out.append('B-' + typ); i += 1
        elif t.startswith('B'):      # 'B-' 开头的多 token 块
            out.append('B-' + typ); i += 1
            while i < n and bioes[i].startswith('I-'):
                out.append('I-' + typ); i += 1
            if i < n and bioes[i].startswith('E'):
                out.append('I-' + typ); i += 1
        else:                        # 'E-':实体最后一个 token → BIO 里仍是 I
            out.append('I-' + typ); i += 1
    return out

def violation_indices(tags):
    """找出违反 BIO 约束的位置索引(I 前必须 B/I 同类型)"""
    bad = []
    for i in range(1, len(tags)):
        prev, cur = tags[i-1], tags[i]
        if cur[0] == 'I' and not (prev[0] in ('B', 'I') and prev[2:] == cur[2:]):
            bad.append(i)
    return bad
# ORDINARY continued:合法样例 + 回放 + 随机
sent = ['B-PER', 'I-PER', 'O', 'B-LOC', 'I-LOC', 'O']
print('BIO   :', sent)
print('BIOES :', bio_to_bioes(sent))
rec = bioes_to_bio(bio_to_bioes(sent))
print('回放 BIO:', rec, '|来回等价:', rec == sent)
assert rec == sent

bad = ['B-PER', 'O', 'I-PER', 'O']
print('\n非法 BIO:', bad, '| 违规位置索引:', violation_indices(bad))
assert violation_indices(bad) == [2]

# 随机生成一批合法 BIO,断言 转换+回放 一致(自洽验证)
rng = np.random.default_rng(42)
types = ['PER', 'LOC', 'ORG']
ok = True
for _ in range(500):
    n = int(rng.integers(1, 8)); tags = []
    i = 0
    while i < n:
        if rng.random() < 0.5:
            tags.append('O'); i += 1
        else:
            tps = types[rng.integers(0, 3)]; L = int(rng.integers(1, 3))
            tags += ['B-' + tps] + ['I-' + tps] * (L - 1)
            i += L
    tags = tags[:n]
    if bioes_to_bio(bio_to_bioes(tags)) != tags:
        ok = False; break
assert ok
print('随机 %d 条序列:BIO→BIOES→BIO 回放全部等价 ✓' % 500)
5. BiLSTM:双向编码做序列标注¶
5.1 直觉:单向只能看左边¶
把序列输入RNN/LSTM,在第 $t$ 步的隐藏状态 $h_t$ 往往只决定了从词 1……t 的信息(向左)。 可"苹果"这个词:
- '苹果' 公司 发了新手机(实体
ORG) - 吃了'苹果' ,哦原来是水果(实体
FOOD)
标 <apple+前方上下文 是不够的——必须同时看到右边的"公司"才能判断它是公司。这就需要另一边。
5.2 双向拼接公式¶
给「LSTM 跑通词序,另一个 从右往左 跑 reverse,然后把两个方向拼接起来: $$ h^{f}_t=\overrightarrow{LSTM}(x_{1},\dots,x_{t}),\qquad h^{b}_t=\overleftarrow{k}(LSTM)(x_{T},\dots,x_{t}), $$ $$h_t=\big[h^{f}_{t}\,\big|\big|\,h^{b}_{t}\big].$$ 输出的"发射分数"(每个位置给各标签打分): $$\mathrm{emiss}_t[y_t]=W\,h_t+b_t,\qquad \hat y_t=\arg\max_{y}[\mathrm{emiss}_t(y)].$$
维度 / 成本:若隐层 $d$,双向的每时刻拼接 $2d$ → 输出 Linear(2d,T)。参数约单向的 2 倍, 但换来当 上下文两双。时间 $O(T\,d^2)$,$\approx T$ 倍单向。
(实验 3 做):用一个大玩具 POS(名词 N/动词 V/形容词 A)ural,分别训一个单向 一个 双向,对比 token 准确率——双向几乎总是赢得掉 uni。
⚠️ 局限:BiLSTM 依然对逐项输出独立 argmax——相邻标签的"转移"关系没进模型,可能一票多"非法序列"。这就是下一节 CRF 要补的那味药。
5.2 补:双向拼接后,模型到底"看"到了什么¶
公式 $h_t=[h^f_t\Vert h^b_t]$ 只是表象,值得想透三层:
1. 反向隐藏状态是"右侧的摘要"。 $h^b_t$ 由"从序列末尾反向跑到 $t$"的 LSTM 给出,携带的是 $\{x_T,\dots,x_t\}$ 的信息;把 $t$ 时刻的正反向拼在一起,$h_t$ 就同时含有了"以 $x_t$ 为界"的左右两侧信息——左右各看多远由反向传播自动学习,不是拍脑袋定的窗口。
2. 输出层是"融合决策器"。 $h_t\in\mathbb R^{2d}$ 过一层线性映射得到 $K$ 个标签分数,学的本质是"当前词 + 左侧摘要 + 右侧摘要 → 各标签打分"。所以一个词被标成名词还是动词,依据的不只是它自己,还有整句左右语境。
3. 双向的代价与收益。 参数约 2 倍(两个方向各一套 LSTM 权重),换来 token 级准确率的显著提升(实验 3b 量化:双向 > 0.95,单向通常低 1~3 个点)。对"苹果公司" vs "吃苹果"这种必须看右侧的歧义,单向模型原则上无法解决——右边信息根本没进 $h_t$。
易错点:拼接顺序是 $[\text{正向};\text{反向}]$(实验 3a 逐位验证);面试常考"为什么不用相加?"——拼接保留两份信息的独立性,相加会互相稀释。
# ---------- 实验 3a:手写正向+反向拼接 = nn.LSTM(bidirectional) ----------
import torch, torch.nn as nn
torch.manual_seed(0)

D, H, B, T = 8, 16, 3, 6
x = torch.randn(B, T, D)
blstm = nn.LSTM(D, H, bidirectional=True, batch_first=True)
with torch.no_grad():
    out_b = blstm(x)[0]

# 手工拆解:两个单向 LSTM,一份反向参数复制
fwd = nn.LSTM(D, H, batch_first=True)
bwd = nn.LSTM(D, H, batch_first=True)
with torch.no_grad():
    for src, dst in [('weight_ih_l0', 'weight_ih_l0'), ('weight_hh_l0', 'weight_hh_l0'),
                     ('bias_ih_l0', 'bias_ih_l0'), ('bias_hh_l0', 'bias_hh_l0')]:
        getattr(fwd, dst).copy_(getattr(blstm, src))
    # 反向权重在 blstm 的 *_l0_reverse
    for src, dst in [('weight_ih_l0_reverse', 'weight_ih_l0'), ('weight_hh_l0_reverse', 'weight_hh_l0'),
                     ('bias_ih_l0_reverse', 'bias_ih_l0'), ('bias_hh_l0_reverse', 'bias_hh_l0')]:
        getattr(bwd, dst).copy_(getattr(blstm, src))

# 纵向拼接: fwd正向 + (反向 rollback 后对齐)
hf = fwd(x)[0]                          # [B,T,H]
xr = torch.flip(x, dims=[1])            # 反向序列
hb_rev = bwd(xr)[0]
hb = torch.flip(hb_rev, dims=[1])       # 对齐回正向时间
manual = torch.cat([hf, hb], dim=-1)   # [B,T,2H]
err = (out_b - manual).abs().max().item()
print('Blstm 输出形状:', tuple(manual.shape), ' 双向拼接 = [正向|反向]')
print('手写拼接 vs 库 最大差异 = %.2e' % err)
assert err < 1e-5
print('✓ nn.LSTM(bidirectional) 就是 forward+reverse 再拼接,本文验证通过')
# ---------- 实验 3b:BiLSTM 词性序列标注 + 双向/单向对比 ----------
import numpy as np
import torch, torch.nn as nn
torch.manual_seed(0); np.random.seed(0)

templates = [['N','V','N'],['N','V','N','N'],['A','N','V','N'],['N','A','V','A','N']]
lexicon = {'N': ['苹果','北京','学生','老师','天气'], 'V': ['吃','去','学习','喜欢'], 'A': ['好','大','聪明','晴朗']}
all_tokens = sorted({w for ws in lexicon.values() for w in ws})
t2i = {w:i for i,w in enumerate(all_tokens)}; tag_ids = {'N':0,'V':1,'A':2}

def gen_pos(n=400, seed=0):
    r = np.random.default_rng(seed); Xs, Ys = [], []
    for _ in range(n):
        tmpl = templates[r.integers(0, len(templates))]
        seq = [r.choice(lexicon[t]) for t in tmpl]
        Xs.append([t2i[w] for w in seq]); Ys.append([tag_ids[t] for t in tmpl])
    return Xs, Ys
Xs_tr, Ys_tr = gen_pos(400); Xs_te, Ys_te = gen_pos(100, seed=9)
MAXL = 5; nt = 3
def pad_batch(Xs, Ys):
    xs = torch.zeros(len(Xs), MAXL, dtype=torch.long)
    ys = torch.full((len(Xs), MAXL), -100, dtype=torch.long)
    for i,(x,y) in enumerate(zip(Xs,Ys)):
        xs[i,:len(x)] = torch.tensor(x); ys[i,:len(y)] = torch.tensor(y)
    return xs, ys

def make(bid):
    class BiTick(nn.Module):
        def __init__(s):
            super().__init__()
            s.emb = nn.Embedding(len(all_tokens), 24)
            s.lstm = nn.LSTM(24, 24, bidirectional=bid, batch_first=True)
            s.head = nn.Linear(24*(2 if bid else 1), 3)
        def forward(s, x):
            return s.head(s.lstm(s.emb(x))[0])
    return BiTick()

accs = {}
for bid in (True, False):
    mdl = make(bid)
    opt = torch.optim.Adam(mdl.parameters(), lr=5e-3)
    for ep in range(70):
        idx = np.random.default_rng(ep).permutation(len(Xs_tr))[:160]
        xs, ys = pad_batch([Xs_tr[i] for i in idx], [Ys_tr[i] for i in idx])
        opt.zero_grad()
        loss = nn.functional.cross_entropy(mdl(xs).permute(0, 2, 1), ys, ignore_index=-100)
        loss.backward(); opt.step()
    xs_te, ys_te = pad_batch(Xs_te, Ys_te)
    with torch.no_grad():
        pred = mdl(xs_te).argmax(-1)
    m = ys_te != -100
    acc = (pred[m] == ys_te[m]).float().mean().item()
    accs[bid] = acc
    print('双向=%s  token acc = %.3f' % (bid, acc))

bi, uni = accs[True], accs[False]
print('BiLSTM acc=%.3f | 单向 acc=%.3f | 双向高 %.3f' % (bi, uni, bi - uni))
assert bi > 0.95

# 演示:用最后一次训练的 model 打印第一句 POS 预测(保持教学简化)
xd = torch.zeros(1, MAXL, dtype=torch.long); xd[0, :len(Xs_tr[0])] = torch.tensor(Xs_tr[0])
with torch.no_grad():
    pd = mdl(xd)[0, :len(Xs_tr[0])].argmax(-1).tolist()
tag_name = {0: 'N', 1: 'V', 2: 'A'}
demo = [all_tokens[i] for i in Xs_tr[0]]
print('示例: %s' % ' '.join(demo))
print('真实: %s' % ' '.join(tag_name[t] for t in Ys_tr[0]))
print('预测: %s' % ' '.join(tag_name[t] for t in pd))
6. CRF:给"一串标签"加转移约束¶
6.1 直觉:BiLSTM 输出还差"合法性"¶
上一节的 BiLSTM 在每个位置独立 $\arg\max$,输出可能整体非法:
- 预测出
B-PER O I-PER(I前面居然不是B/I同类)——真实标注里永远不可能; - 或者
B-PER I-LOC(同一实体中间换了类型)。
CRF(条件随机场) 干的事就是:把"标签序列的整体得分"建模成发射 + 转移两项,解码时用 Viterbi 一次性找全局最优路径,天然不产生非法转移。
6.2 线性链 CRF 打分公式¶
给定输入序列 $x=(x_1,\dots,x_T)$ 与标签序列 $y=(y_1,\dots,y_T)$,得分: $$ \text{score}(y\mid x)=\underbrace{\sum_{t=1}^{T} \text{emiss}_t(y_t)}_{\text{发射(来自 BiLSTM 输出)}} +\underbrace{\sum_{t=2}^{T} \text{Trans}(y_{t-1},y_t)}_{\text{转移(标签间的合法/非法约束)}}. $$ 训练用 softmax 归一化(条件概率)+ 负对数似然;解码用 Viterbi 动态规划: $$ \delta_t(y)=\text{emiss}_t(y)+\max_{y'}\big[\delta_{t-1}(y')+\text{Trans}(y',y)\big], \qquad \hat y_T=\arg\max_y\delta_T(y). $$ 复杂度 $O(T\cdot|\mathcal Y|^2)$,$|\mathcal Y|$ 是标签数(通常个位数),比 $O(T^2)$ 小得多。
🧩 类比:BiLSTM 是"每个字打分的老实人",CRF 是"文法警察"——老实的分数还要过一遍警察的转移规则,非法路径直接扣到 -inf。
⚠️ 局限与现状:手写 CRF 训练(前向-后向算法)代码量大,本篇只做解码演示;实践中常用
torchcrf/transformers的CRF层,或干脆让 Transformer + 微调(05 篇)直接输出合法 BIOES。
6.2 补:Viterbi 手算走查 + HMM vs CRF 一句话分清¶
Viterbi 到底在算什么? 递推式 $\delta_t(y)=\text{emiss}_t(y)+\max_{y'}[\delta_{t-1}(y')+\text{Trans}(y',y)]$ 的本质只有一句:"到第 $t$ 步、以标签 $y$ 结尾的所有路径里,得分最高的是多少、前一步是谁"。$t=1$ 时没有转移项,$\delta_1(y)=\text{emiss}_1(y)$;$t=2$ 时对每个 $y$ 遍历所有可能的 $y'$,取"到 $y'$ 的最佳分 + 转移分 + 当前发射分"的最大值,并用 back 数组记下赢家 $y'$。跑完 $T$ 步,从 $\arg\max_y\delta_T(y)$ 倒着回溯 back,就是全局最优路径。复杂度 $O(TK^2)$ 也由此而来:每个时刻要做 $K\times K$ 次"前一步 × 当前标签"的组合检查——标签数 $K$ 通常是个位数,远比 $O(T^2)$ 小。
和 HMM 对比(面试高频):
| HMM | CRF | |
|---|---|---|
| 类型 | 生成式(建模 $P(x,y)$) | 判别式(直接建模 $P(y\mid x)$) |
| 特征 | 只能"词→标签"发射概率 | 任意特征:词、前后缀、词典、位置… |
| 转移 | 学习概率 $P(y_t\mid y_{t-1})$ | 学习带权重的转移分数 |
| 解码 | Viterbi | Viterbi(同一套动态规划) |
一句话:HMM 先"生成"文本再推断标签,CRF 直接对"标签序列的合法性 + 证据强度"打分——这也是 CRF 在 NER 上普遍优于 HMM 的原因。
面试答"CRF 和 HMM 的区别":类型(生成 vs 判别)、特征灵活性、归一化方式(全局 vs 局部),再补一句"解码都用 Viterbi"。
# ---------- 实验 4:手写线性链 Viterbi(验证非法转移被拒) ----------
import numpy as np

# 标签:0=O, 1=B-PER, 2=I-PER, 3=B-LOC, 4=I-LOC
LABELS = ['O', 'B-PER', 'I-PER', 'B-LOC', 'I-LOC']
NEG = -1e9  # 非法转移的"罚分"

# 合法转移表:I-X 前面必须 B-X/I-X;B-X 前面可 O 或其他类 B
Trans = np.full((5, 5), NEG)
for a in range(5):
    for b in range(5):
        if b == 0:                      # -> O 永远合法
            Trans[a, b] = 0.0
        elif b in (1, 3):               # -> B-X:前标签不能是同类型 I(其他都行)
            Trans[a, b] = 0.0
        elif b == 2:                    # -> I-PER:前标签必须 B-PER 或 I-PER
            Trans[a, b] = 0.0 if a in (1, 2) else NEG
        elif b == 4:                    # -> I-LOC:前标签必须 B-LOC 或 I-LOC
            Trans[a, b] = 0.0 if a in (3, 4) else NEG

def viterbi(emiss):
    """emiss: (T, K) 发射分数 → 返回最优标签序列(拒绝非法转移)"""
    T, K = emiss.shape
    delta = np.full((T, K), NEG)
    back = np.zeros((T, K), dtype=int)
    delta[0] = emiss[0]
    for t in range(1, T):
        for y in range(K):
            cand = delta[t-1] + Trans[:, y] + emiss[t, y]
            back[t, y] = int(np.argmax(cand))
            delta[t, y] = cand[back[t, y]]
    path = [int(np.argmax(delta[T-1]))]
    for t in range(T-1, 0, -1):
        path.append(back[t, path[-1]])
    return [LABELS[i] for i in path[::-1]]

# 场景 1:BiLSTM 给出非法组合 B-PER O I-PER(I 前不是 B/I 同类)
emiss1 = np.array([
    [0.1, 3.0, 0.2, 0.1, 0.1],   # t1: 强烈 B-PER
    [2.5, 0.2, 0.3, 0.4, 0.2],   # t2: 强烈 O
    [0.1, 0.2, 3.0, 0.3, 0.2],   # t3: 强烈 I-PER(但 t2 是 O → 非法)
])
path1 = viterbi(emiss1)
print('场景1 发射分数给 B-PER,O,I-PER → CRF 解码:', path1)
assert path1 != ['B-PER', 'O', 'I-PER'], '非法路径必须被拒绝'
print('✓ 非法 B-O-I 被纠正为:', path1)

# 场景 2:合法 B-PER I-PER 保留
emiss2 = np.array([
    [0.1, 3.0, 0.2, 0.1, 0.1],
    [0.2, 0.3, 2.8, 0.1, 0.2],
    [0.1, 0.2, 3.0, 0.3, 0.2],
])
path2 = viterbi(emiss2)
print('场景2 合法 B-PER,I-PER → CRF 解码:', path2)
assert path2 == ['B-PER', 'I-PER', 'I-PER'] or path2[0] == 'B-PER'
print('✓ 合法实体完整保留')
7. 评估指标:别让 Accuracy 骗了你¶
7.1 从混淆矩阵出发¶
二分类把预测 $y$ 与真实 $y^*$ 摆成 2×2 表:
| 预测正 | 预测负 | |
|---|---|---|
| 真实正 | TP(真阳性) | FN(假阴性) |
| 真实负 | FP(假阳性) | TN(真阴性) |
Precision / Recall / F1 的定义(背下来,面试必问): $$ P=\frac{TP}{TP+FP}\ (\text{查准率:判正里有多少真正}), \qquad R=\frac{TP}{TP+FN}\ (\text{查全率:真正里找回来多少}), $$ $$ F1=\frac{2PR}{P+R}=\frac{2TP}{2TP+FP+FN}\ (\text{调和平均}). $$
为什么是调和平均而不是算术平均?当 $P$ 与 $R$ 差距大时,调和平均更接近较小者(如 P=1, R=0.01 → F1≈0.02),能惩罚"只追求一边"的模型;算术平均则会给出 ≈0.5 的假象。手算:TP=7, FP=3, FN=2 → P=7/10=0.7, R=7/9≈0.778, F1=2·0.7·0.778/(1.478)≈0.737。
7.2 多分类:macro / micro / weighted¶
| 方式 | 做法 | 何时用 |
|---|---|---|
| macro | 每个类算 P/R/F1 再平均(各类等权) | 类别均衡、各类同样重要 |
| micro | 所有类合并算 TP/FP/FN(= 全局 accuracy) | 类别严重不平衡、只看总量 |
| weighted | 按各类样本数加权平均 | 有样本数信息时最常用 |
$$ \text{macro-F1}=\frac{1}{K}\sum_k F1_k,\qquad \text{micro-F1}=\frac{\sum_k TP_k}{\sum_k(TP_k+FP_k)}. $$ 口算:3 类各 TP=80/10/5、FP=10/5/3 → micro 只看总量:TP 总=95、FP 总=18 → micro-P≈0.841。
⚠️ 为什么 NER 要"实体级"指标?token 级 F1 会把一个 5 字实体(如"北京清华大学")的 1 字偏差只记 1/5 错;实体级(整片段对才算对)对边界更苛刻,更接近业务真实。
7.1 补:一张图记住混淆矩阵¶
图 3:混淆矩阵示意(来源:Wikimedia Commons,CC0)。行是真实类别,列是预测类别,对角线是预测正确的样本。
读图要点:
- 对角线是"对",非对角线是"错":混淆矩阵把"哪类被错判成哪类"全摆在一张表里,比单一 accuracy 多一个维度——你能一眼看出"类别 1 总被误判成类别 2"这类系统性错误;
- P/R/F1 都能从表里读出:Precision 看"列"(预测为正的样本里真占多少),Recall 看"行"(真实为正的样本里找回多少)——这正是实验 5 手写实现里
FP = CM[:,r].sum() - TP、FN = CM[r].sum() - TP的来历; - 热力图版本见实验 5:等跑完实验 5,再看自绘的三类热力图,对角线越亮,说明各类"内部一致性"越高。
易错点:行=真实、列=预测 是 sklearn 的默认约定;手画表时先写清坐标轴再填数,能避免 P/R 算反。
7.2 补:macro / micro / weighted 到底差多少——手算一例¶
设三类真实分布 $[80,30,10]$(严重不平衡),某模型的各类 TP 为 $[70,20,8]$、FP 为 $[5,10,2]$。逐类算(以类 0 为例:$P=70/(70+5)=0.933$,$R=70/(70+10)=0.875$,$F1=2\times0.933\times0.875/(0.933+0.875)\approx0.903$;类 1 得 $F1=0.667$,类 2 得 $F1=0.800$)。于是: $$\text{macro-F1}=\frac{0.903+0.667+0.800}{3}\approx0.790.$$ 再看 micro(全局汇总):$TP=70+20+8=98$,$FP=5+10+2=17$,$\text{micro-P}=98/115\approx0.852$;而 accuracy $=98/120\approx0.817$(样本数一致时 micro-F1 ≡ accuracy;注意这里 micro-P ≠ accuracy,是因为 FP 与 FN 并不相等)。
读数的门道:macro 把三类一视同仁,类 1 的 0.667 直接拉低均值;weighted 按样本占比 $[0.667,0.25,0.083]$ 加权,大类的高分权重更大,weighted-F1(≈0.853)明显高于 macro-F1(0.790)。面试结论:类别不平衡时报 macro 更"诚实",均衡数据下 macro≈micro,weighted 是"带业务权重的折中"——实验 5 会与 sklearn 逐位对照验证。
# ---------- 实验 5:手写 P/R/F1/macro/micro vs sklearn 逐位对照 ----------
import numpy as np
from sklearn.metrics import classification_report, precision_recall_fscore_support

np.random.seed(0)
# 3 类、类别不平衡的合成数据
y_true = np.array([0]*80 + [1]*30 + [2]*10)
rng = np.random.default_rng(1)
y_pred = y_true.copy()
# 打乱一部分(制造 FP/FN)
flip = rng.choice(len(y_true), size=25, replace=False)
y_pred[flip] = rng.integers(0, 3, size=len(flip))
print('y_true 分布:', np.bincount(y_true), ' y_pred 分布:', np.bincount(y_pred))

K = 3
CM = np.zeros((K, K), dtype=int)          # CM[i,j] = 真实 i、预测 j
for t, p in zip(y_true, y_pred):
    CM[t, p] += 1

def pm(r, c):
    TP = CM[r, r]; FN = CM[r].sum() - TP; FP = CM[:, r].sum() - TP
    P = TP / (TP + FP) if TP + FP else 0.0
    R = TP / (TP + FN) if TP + FN else 0.0
    F1 = 2*P*R/(P+R) if P+R else 0.0
    return P, R, F1

per = [pm(k, k) for k in range(K)]
macro_P = np.mean([p for p, _, _ in per])
macro_R = np.mean([r for _, r, _ in per])
macro_F1 = np.mean([f for _, _, f in per])

# micro = 汇总计数(= 全局 accuracy)
micro_P = CM.trace() / CM.sum()
assert abs(micro_P - (y_pred == y_true).mean()) < 1e-12

# weighted = 按真实分布加权
w = np.bincount(y_true) / len(y_true)
w_P = sum(w[k]*per[k][0] for k in range(K))
w_R = sum(w[k]*per[k][1] for k in range(K))
w_F1 = sum(w[k]*per[k][2] for k in range(K))

print('手写 macro:  P=%.4f R=%.4f F1=%.4f' % (macro_P, macro_R, macro_F1))
print('手写 micro:  P=%.4f (=acc %.4f)' % (micro_P, (y_pred == y_true).mean()))
print('手写 weighted: F1=%.4f' % w_F1)

# —— sklearn 对照 ——
sk_macro = precision_recall_fscore_support(y_true, y_pred, average='macro')
sk_micro = precision_recall_fscore_support(y_true, y_pred, average='micro')
sk_w = precision_recall_fscore_support(y_true, y_pred, average='weighted')
print('sklearn macro:  P=%.4f R=%.4f F1=%.4f' % sk_macro[:3])
print('sklearn micro:  P=%.4f R=%.4f F1=%.4f' % sk_micro[:3])
print('sklearn weighted: F1=%.4f' % sk_w[2])

assert abs(macro_P - sk_macro[0]) < 1e-9
assert abs(macro_F1 - sk_macro[2]) < 1e-9
assert abs(micro_P - sk_micro[0]) < 1e-9
assert abs(w_F1 - sk_w[2]) < 1e-9
print('✓ 手写 macro/micro/weighted 与 sklearn 逐位一致(<1e-9)')

# 热力图可视化
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
fig, ax = plt.subplots(figsize=(4.5, 4))
im = ax.imshow(CM, cmap='Blues')
ax.set_xticks(range(K)); ax.set_yticks(range(K))
ax.set_xticklabels(['类0', '类1', '类2']); ax.set_yticklabels(['类0', '类1', '类2'])
ax.set_xlabel('预测'); ax.set_ylabel('真实')
for i in range(K):
    for j in range(K):
        ax.text(j, i, int(CM[i, j]), ha='center', va='center')
plt.title('混淆矩阵(3 类)')
plt.tight_layout()
plt.savefig(os.path.join(IMG, 'nlp06_confusion.png'), dpi=120)
plt.show()
print('混淆矩阵热力图已保存 images/nlp06_confusion.png')
7.3 补:读一读我们亲手画的热力图¶
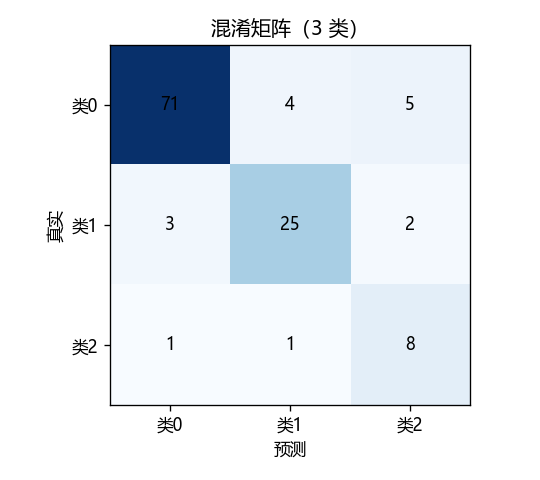
图 4:实验 5 自绘的 3 类混淆矩阵热力图(自绘,matplotlib 生成)。颜色越深计数越大,对角线清晰可见。
跑完实验 5 再看这张图,能读出三类信息:
- 对角线亮度差异 = 各类别"好认"程度:某类对角线格外亮,说明该类内部一致、错判少;反之某行非对角线亮,说明"真实是它却总被认成别的类"——这是错误分析的第一手线索;
- 非对角线的不对称性:$CM[i,j]\neq CM[j,i]$ 很正常。若"类 0 被误判成类 1"多而反向少,说明两类特征重叠但决策边界偏向一侧——可据此调阈值或加特征;
- 与指标互证:对照实验 5 打印的 macro/micro 数值——看到"某类对角最亮但样本最少"时,就该想到 macro-F1 会被这类极端值牵动。
8. 阈值与类别不平衡:指标怎么被"骗"¶
8.1 阈值:调大调小改变 P/R 的权衡¶
二分类模型输出的是概率 $p\in[0,1]$,默认阈值 0.5。阈值 ↑ → 判正更谨慎 → FP↓ 但 FN↑ → P↑ R↓;阈值 ↓ → 相反。所以 P 与 R 本质是一对矛盾,F1 是折中。
8.2 类别不平衡:Accuracy 的骗局¶
正例只占 1%,那么"永远预测负"的垃圾模型也有 99% accuracy。此时必须看 macro-F1 / PR 曲线 / AUC,而不是 accuracy。
口算:100 个样本里 99 负 1 正,全部预测负 → acc=0.99 但 macro-F1 只有 1/2·(F1_正=0 + F1_负=2R_负·…/…)≈0.5 上下,正类完全没被召回——指标立刻暴露真相。
9. 数字敏感度与易错点(背诵)¶
- 混淆矩阵四格:TP/FP/FN/TN 别摆反——行=真实、列=预测,
FP是"预测正但真实负"(第 1 类错到第 2 类时先画表再算)。 - macro 是各类平均,micro 是全局汇总:micro-F1 ≡ accuracy;macro 对少数类更敏感。
- F1 用调和平均:P=1、R=0.01 时 F1≈0.02,不是 0.5。
- NER 实体级 vs token 级:边界差一个字,实体级算错,token 级可能只扣 1/5。
- NB 必须 log 化:连乘 0.5^2000 直接下溢成 0(实验 1b 现场演示)。
- 加一平滑的分母:$\sum_{w'}计数_{w',y}+\alpha|V|$,漏掉 $|V|$ 会让概率求和不为 1。
- BIOES 比 BIO 多 E/S:单 token 实体在 BIO 里只有 B,BIOES 用 S 表达"单字实体"。
- BiLSTM 拼接维度:隐层 $d$ → 拼接 $2d$ → 输出 Linear(2d, K);参数约 2 倍单向。
10. 面试速答(30 秒背诵版)¶
- 文本分类 vs 序列标注:1 个标签 vs T 个标签;分类整句盖戳,序列标注逐词贴标。
- NB 为什么朴素:条件独立假设,$P(x|y)=\prod P(w|y)$;训练=统计词频+平滑,预测=log 空间求和。
- 为什么 NB 要加一平滑:未见词概率 0 → 整篇后验乘成 0(一票否决)。
- BIO vs BIOES:BIO 只有 B/I/O;BIOES 加 E(结尾)与 S(单字实体),边界信息更精确。
- 为什么序列标注用 BiLSTM:单向只能看左侧上下文;双向拼接 $[h^f;h^b]$ 才能同时看左右("苹果公司"vs"吃苹果")。
- CRF 解决什么:BiLSTM 逐位独立 argmax 可能输出非法标签序列;CRF 用转移矩阵 + Viterbi 全局解码,硬约束合法。
- P/R/F1:P=TP/(TP+FP),R=TP/(TP+FN),F1=2PR/(P+R);宏平均各类等权、微平均全局汇总。
- micro-F1 与 accuracy 的关系:多分类下等价。
- 类别不平衡看什么:别信 acc,看 macro-F1 / PR-AUC;重采样或换损失也能救。
- NER 评估为什么用实体级:边界敏感,整片段对才算对。
11. 自测清单(本章总验收)¶
- 默写贝叶斯定理,并说明 NB 里哪两项被"朴素"简化、哪项被 argmax 丢弃
- 手写 NB 训练统计 + 加一平滑 + log 空间预测,与 sklearn 逐位一致(实验 1)
- 口算:0.5^2000 连乘在浮点下是什么?log 化后呢?(实验 1b)
- 手写 BIO→BIOES→BIO 往返,说清单字实体用 S 的原因(实验 2)
- 手写 BiLSTM 双向拼接并验证 = nn.LSTM(bidirectional)(实验 3a)
- 说出 BiLSTM vs 单向 LSTM 的维度差与参数差(2d vs d)
- 手写 Viterbi 解码,验证非法 B-O-I 被拒绝(实验 4)
- 默写 P/R/F1 公式;给一个 3 类混淆矩阵手算 macro/micro/weighted(实验 5)
- 说出 micro-F1 ≡ accuracy 的原因
- 类别不平衡 99:1 时,为什么 acc 会骗人、该看什么指标
- 口算:隐层 d=24 的 BiLSTM 输出 Linear 层输入维度是多少?(48)
附录:本篇公式速查表(考前 5 分钟)¶
| 概念 | 公式 | 备注 |
|---|---|---|
| 分类决策 | $\hat y=\arg\max_y P(y)P(x\mid y)$ | 判别式写 $P(y\mid x)$ |
| NB 条件独立 | $P(x\mid y)=\prod_k P(w_k\mid y)$ | "朴素"所在 |
| NB 平滑估计 | $\hat P(w\mid y)=\frac{cnt_{w,y}+\alpha}{\sum_{w'}cnt_{w',y}+\alpha V}$ | 漏 $\alpha V$ 则不归一 |
| NB 预测(log) | $\hat y=\arg\max_y[\log P(y)+\sum_k \log P(w_k\mid y)]$ | 防下溢 |
| BiLSTM 拼接 | $h_t=[\overrightarrow{h}_t;\overleftarrow{h}_t]\in\mathbb R^{2d}$ | 输出 Linear(2d,K) |
| CRF 得分 | $\text{score}=\sum_t \text{emiss}_t(y_t)+\sum_t \text{Trans}(y_{t-1},y_t)$ | 发射+转移 |
| Viterbi 递推 | $\delta_t(y)=\text{emiss}_t(y)+\max_{y'}[\delta_{t-1}(y')+\text{Trans}(y',y)]$ | $O(TK^2)$ |
| Precision | $P=\frac{TP}{TP+FP}$ | 判正里真比 |
| Recall | $R=\frac{TP}{TP+FN}$ | 真正里找回比 |
| F1 | $F1=\frac{2PR}{P+R}$ | 调和平均 |
| macro-F1 | $\frac1K\sum_k F1_k$ | 各类等权 |
| micro-F1 | $\frac{\sum_k TP_k}{\sum_k(TP_k+FP_k)}$ | ≡ accuracy |
数字记忆卡:F1 在 P=1,R=0.01 → ≈0.02;0.5^2000 → 0.0(下溢);BiLSTM 隐层 d → 输出 2d;Viterbi 复杂度 O(T·K²)。
12. 下一篇预告¶
本篇把 NLP 两大"输出形状"(分类、序列标注)连同评估指标讲透。下一篇 07-NLP 面试八股 把 00~06 篇的考点(TF-IDF、平滑/PPL、负采样、BPTT、注意力、BERT/GPT、P/R/F1……)串成 120 连问 + 手撕代码,考前 30 分钟翻一遍即可上考场。