问题表
| 分类 | 核心问题 |
|---|---|
| 系统基础 | roofline 怎么判瓶颈?算力/带宽怎么手算? |
| 算子层 | GEMM 优化三板斧?为什么 elementwise 带宽受限? |
| 训练框架 | autograd 反向为什么逆拓扑序?激活为什么占显存? |
| 混合精度 | FP16 会怎样?loss scaling?BF16 vs FP16? |
| 分布式 | DP/TP/PP/FSDP 怎么选?ZeRO 代价是什么? |
| 通信 | Ring AllReduce 通信量?tree vs ring? |
| 推理 | 为什么 KV Cache?decode 为什么带宽受限?怎么提速? |
| 量化 | 误差从哪来?GPTQ/AWQ/SmoothQuant 分别干嘛? |
| 工程 | profiler 流程?6ND 成本?OOM 排查顺序? |
符号与单位约定(手算题通用)
| 符号 | 含义 | 常用值/单位 |
|---|---|---|
| $N$ | 模型参数量 | 7B = $7\times10^9$ 参数 |
| $D$ | 训练 token 数 | 1T = $10^{12}$ |
| $B$ | batch size | 个序列 |
| $T$ | 序列长度 | 个 token |
| $L$ | 层数 | LLaMA-7B 32 层 |
| $h, h_{kv}, d_h$ | Q 头数 / KV 头数 / 每头维度 | LLaMA-7B: h=32, d_h=128 |
| $P$ | GPU 卡数 / 流水线段数 | — |
| $S$ | 每卡通信数据量 | 字节 |
| $\pi$ | 峰值算力 | A100 FP16 312 TFLOPS |
| $\beta$ | 内存/链路带宽 | A100 约 2 TB/s |
| $\alpha$ | 通信启动延迟 | 约 1-5 µs |
| MFU | 模型利用率 | 30-50% |
| B | 字节(Byte);b = bit | 1 GB = $10^9$ B |
一句话口径:显存按字节(BF16 权重 $2N$ B、Adam $12N$ B、KV $2Lh_{kv}d_hBT\times2$B);训练成本 GPU-hours = $\frac{6ND}{\pi\cdot3600\cdot\text{MFU}}$;通信量 Ring $\frac{2(P-1)}{P}S$。
故事引入
面试 AI Infra 岗位,三轮面试官各问了一道"送命题":
- 一面:7B 模型训练显存怎么估算?(答:16N 字节 + 激活,ZeRO 分片……)
- 二面:为什么 decode 慢?(答:每步读全权重,带宽受限,连续批处理+投机解码……)
- 三面:给你 100 张卡,怎么把 70B 训起来?(答:3D 并行 + FSDP + 通信重叠……)
这 3 道题恰好覆盖了本模块 00-08 的全部主线。本讲把它们串成一张图、一套话术:"看架构(系统)→ 算瓶颈(公式)→ 上前提(并行/精度/缓存/量化)→ 报指标(吞吐/延迟/成本)"。
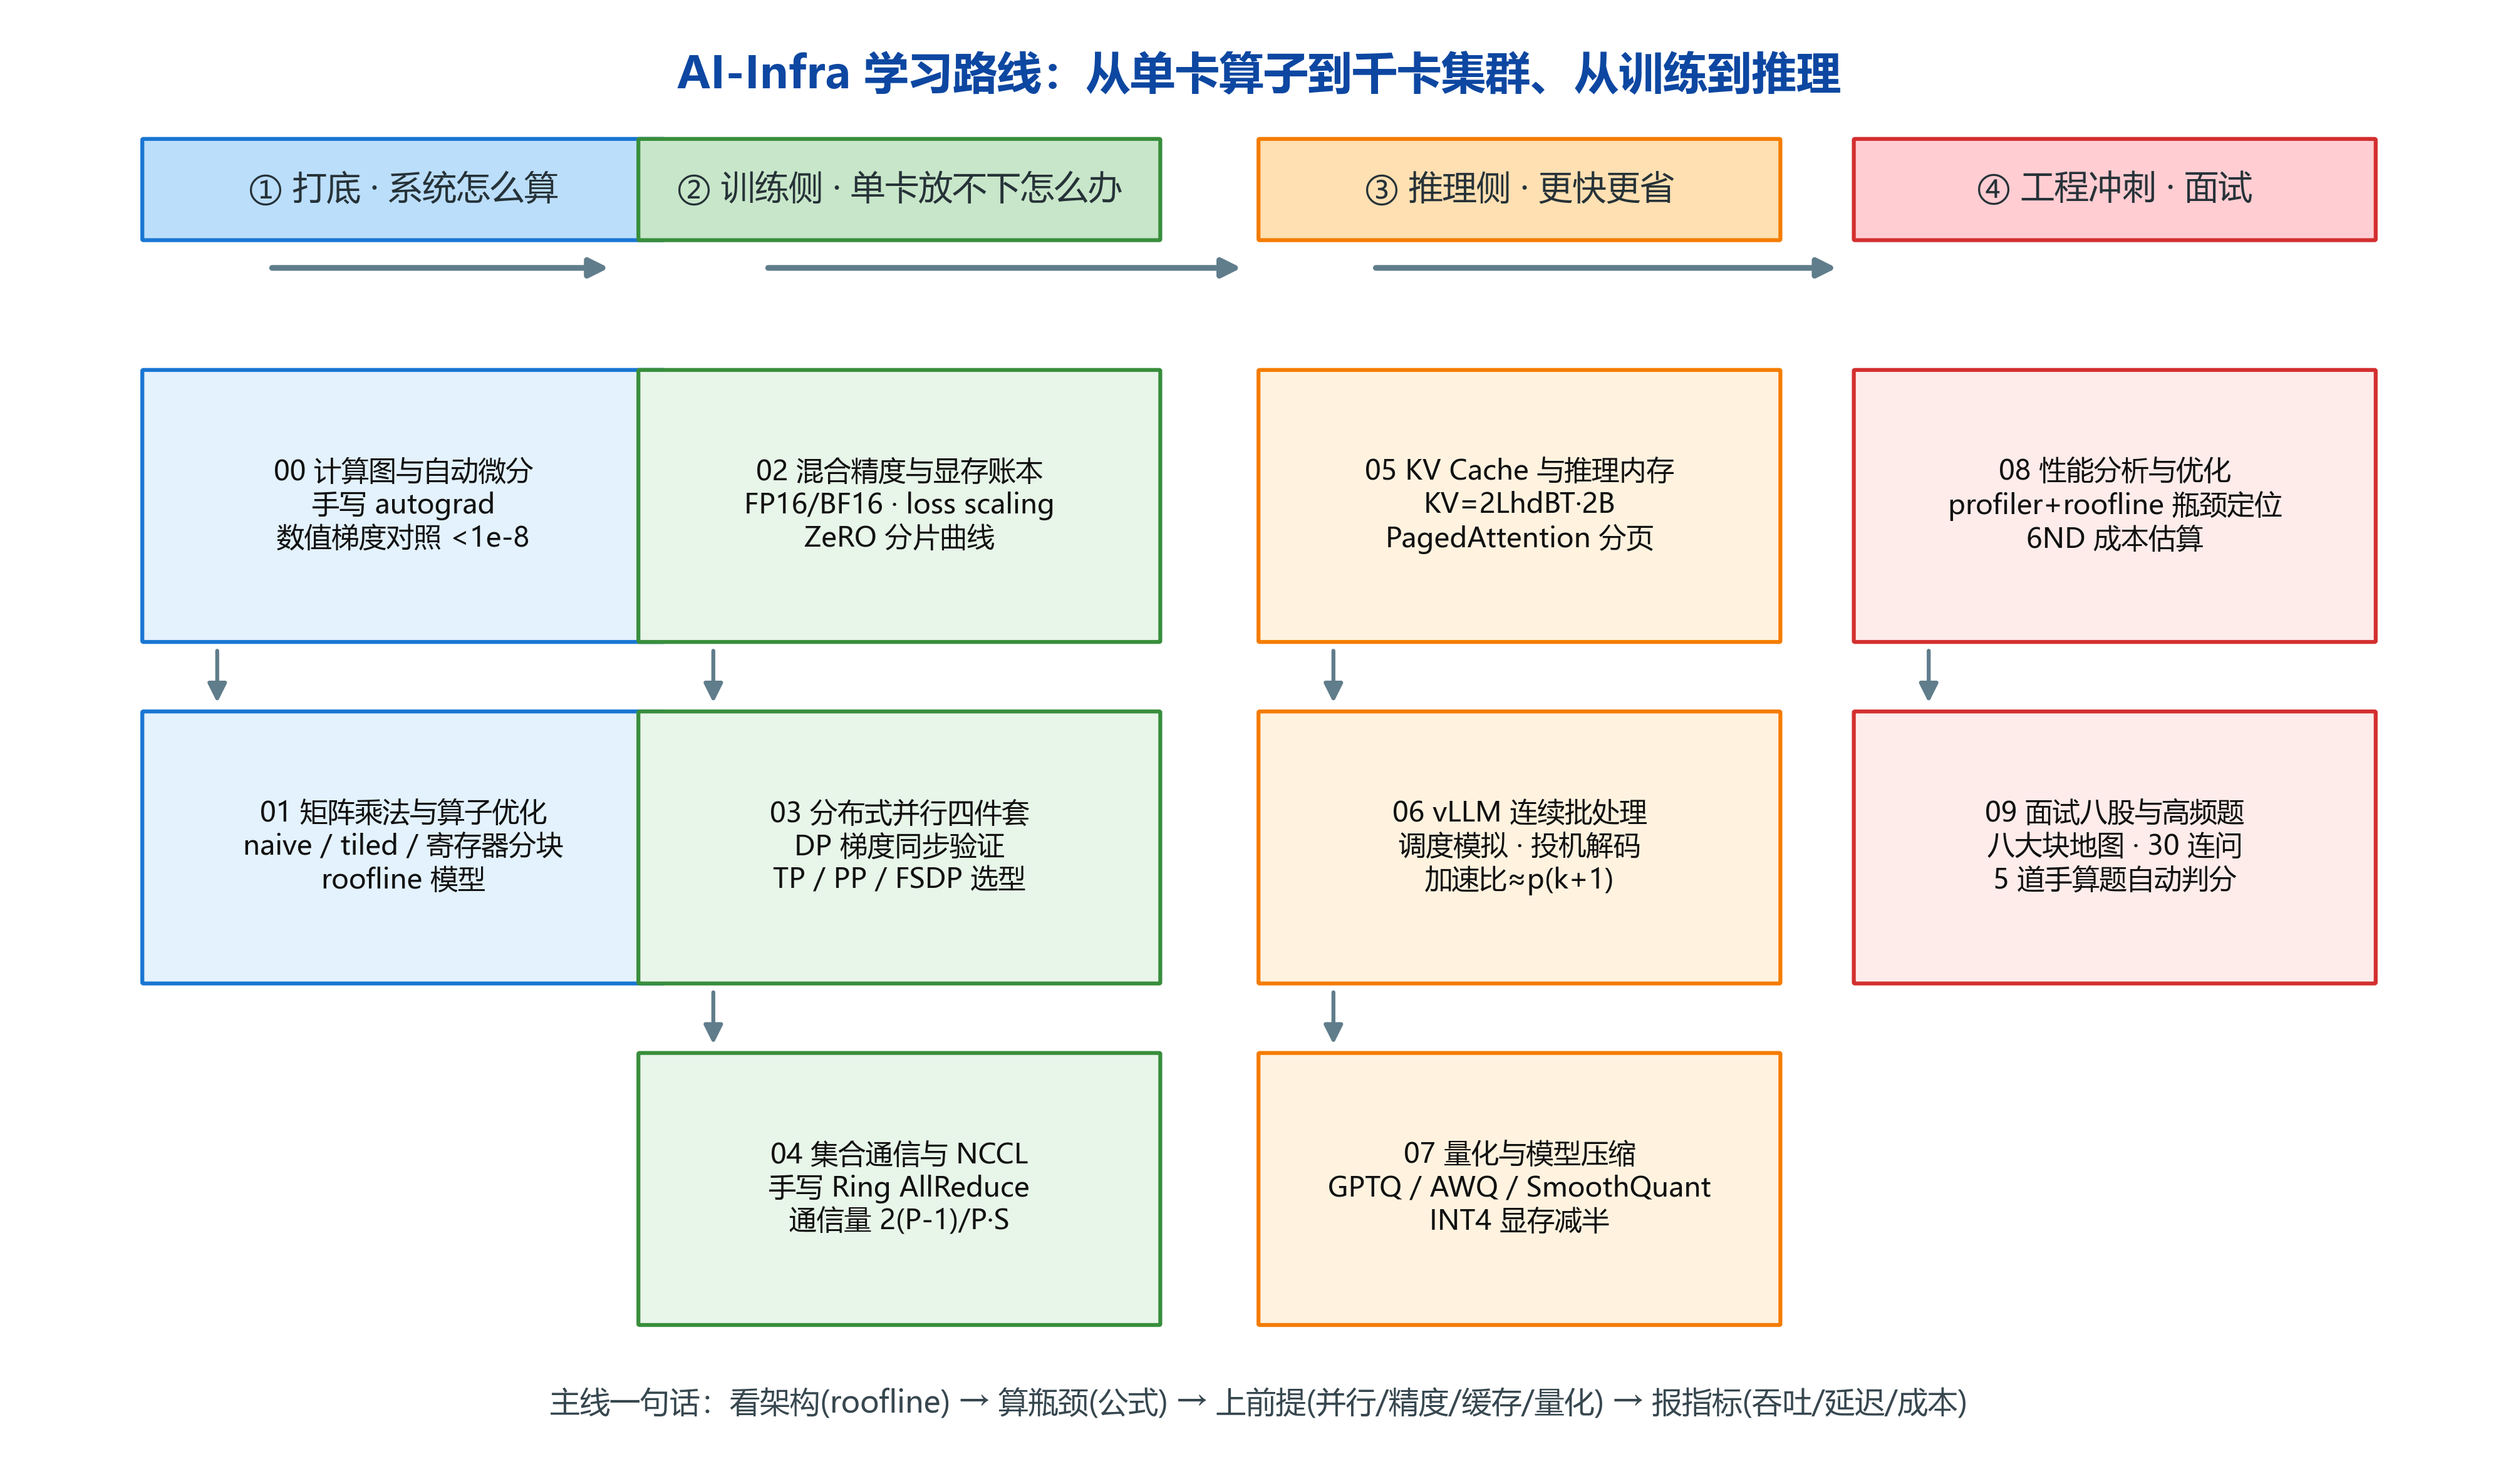
图示:四大阶段闭环——打底(00-01)→ 训练侧(02-04)→ 推理侧(05-07)→ 工程冲刺(08-09);主线一句话:看架构 → 算瓶颈 → 上前提 → 报指标。
核心概念:八大块知识地图(一页速览)
flowchart TB
    A[AI Infra] --> B[系统基础: CPU/GPU/内存/roofline]
    A --> C[算子: GEMM/CUDA/融合]
    A --> D[框架: 计算图/autograd]
    A --> E[混合精度: FP16/BF16/scaling]
    A --> F[分布式: DP/TP/PP/FSDP]
    A --> G[通信: Ring AllReduce/NCCL]
    A --> H[推理: KV Cache/vLLM/投机]
    A --> I[量化: PTQ/GPTQ/AWQ/Smooth]
    A --> J[工程: profiler/成本/OOM]
高频问答 30 题(30 秒标准答案)
🖥️ 系统基础 (1-4)
Q1 GPU 为什么比 CPU 快? CPU 大核大缓存适合串行复杂逻辑;GPU 几千小核高带宽适合海量并行简单运算——吞吐优先 vs 延迟优先。
Q2 roofline 模型? 性能上限 = min(峰值算力, 带宽×算术强度);低于拐点带宽受限(少搬数据),高于算力受限(优化计算)。
Q3 算力/带宽怎么手算? A100: FP16 312TFLOPS、带宽 2TB/s → 拐点 I≈153 FLOP/B。
Q4 为什么 GEMM 是好算子? 算术强度随维度线性增长(2MNK/(3N²)≈2K/3),大矩阵时为算力受限,可打满。
🔧 算子层 (5-8)
Q5 GEMM 优化三板斧? tiling(cache 复用得 b 倍)、寄存器分块(复用 r 倍)、向量化/SIMD;再加内存布局。
Q6 naive 为什么慢? 每步从主存读 A、B,每字节 0.125 FLOP,被带宽卡死(局部性差)。
Q7 算子融合? 把 k 个 elementwise 合成 1 个 kernel,读写从 2kn 降到 2n——带宽受限近 k 倍收益。
Q8 CUDA 线程模型? thread→block→grid,warp=32 线程 SIMT 同步;寄存器最快、共享内存次之、全局内存最慢。
🧠 训练框架 (9-12)
Q9 autograd 反向为什么逆拓扑序? 梯度依赖下游已算结果;逆拓扑序保证遍历时下游梯度齐备,可累加。
Q10 为什么必须存激活? 反向需要 dA·W 与 Aᵀ·dL;重计算(checkpoint)用 ~30% 算力换 O(√N) 显存。
Q11 torch.compile 干了什么? Dynamo 捕获动态图 → 静态图全局优化(融合/内核生成/内存规划/并行)。
Q12 动态图 vs 静态图? 动态灵活易调试;静态可全局优化——compile 是二者的桥梁。
🔢 混合精度 (13-17)
Q13 FP16 的问题? 范围 ±65504、10 位尾数;loss 大上溢 inf、梯度小下溢 0。
Q14 loss scaling? 前向 loss×s → 梯度放大免下溢;更新前除回,主权重 FP32;遇 inf/nan 减半并跳步。
Q15 BF16 vs FP16? BF16 指数 8 位范围同 FP32、精度略降、无需 scaling,预训练首选;FP16 尾数 10 位更精细但需 scaling。
Q16 7B 训练显存? BF16 全程:权重 14GB + 梯度 14GB + Adam(m/v 全 FP32 + master) 84GB ≈ 112GB(不加激活),远超 A100-80G;ZeRO-1 把优化器状态分片(P=8 → 权重14+梯度14+Adam10.5 ≈ 38.5GB)、ZeRO-3 全分片(P=8 → 14GB)+ 激活重计算解决。
Q17 TF32? FP32 尾数截到 10 位 ≈ 19bit 精度、算力翻 8 倍,A100 上 matmul 默认加速。
🚀 分布式与通信 (18-24)
Q18 DP 梯度同步为什么与串行等价? 梯度对样本线性:全 batch 梯度 = 各卡子 batch 梯度的平均(allreduce 平均后同步更新)。
Q19 TP 与 PP? TP 切单层矩阵(列切拼接/行切求和,机内);PP 切层(bubble=(P-1)/(P-1+m),跨机)。
Q20 FSDP/ZeRO 省什么? 优化器状态→梯度→参数逐级分片(÷P),用时 gather;代价通信上升。
Q21 怎么选并行? 放得下先 DP;单层大 TP;层多跨机 PP;超大规模 3D(TP×PP×DP)+ FSDP。
Q22 Ring AllReduce 通信量? 两阶段各 (P-1)/P·S,总 2(P-1)/P·S≈2S 与 P 无关——带宽最优。
Q23 tree vs ring? ring 带宽最优(大数据);tree O(logP) 延迟低(小消息)。
Q24 通信优化? 桶化(打包少同步)、通信-计算重叠、梯度压缩(有损)。
🚄 推理 (25-27)
Q25 为什么 KV Cache? 自回归每步注意力需要全部历史 K/V;缓存免重算前缀 O(T²)→O(T),以显存换算力。
Q26 decode 为什么慢? 每步读全部权重+KV 只产 1 token,带宽受限、GPU 利用率 <10%;对策 MQA/GQA、量化、连续批处理、投机解码。
Q27 投机解码? 小模型草稿 k 个 + 大模型一次校验(k+1 位置) + 拒绝采样保分布一致;加速 ≈ p(k+1)。
📉 量化与工程 (28-30)
Q28 量化误差来源? 步长分辨率 + 离群值拉大 scale;per-channel/保护大权重/GPTQ/AWQ/SmoothQuant 缓解。
Q29 GPTQ vs AWQ vs SmoothQuant? GPTQ 用 Hessian 做输出域最小二乘+误差补偿;AWQ 按激活幅度保护通道(缩放);SmoothQuant 把激活离群数学等价拆给权重。
Q30 OOM/慢推理排查? OOM:看四件套占比→减 batch→重计算→混合精度→ZeRO→换卡;慢:prefill 看 MFU、decode 看带宽、调度看连续批处理。
手算速练(自动判分)
先运行环境设置单元:
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# 环境设置:中文字符输出(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
print("环境就绪")
环境就绪
# 手算题 1:GEMM FLOPs(A: 4096×8192 @ B: 8192×4096)
# 修改下面的 u1 为你的答案(单位 GFLOPs),再运行判分
u1 = 274.9
M, K, N = 4096, 8192, 4096
ans = 2 * M * K * N / 1e9
print("答案: %.1f GFLOPs | 你的: %.1f" % (ans, u1))
print("✅ 正确" if abs(u1 - ans) < 0.5 else "❌ FLOPs = 2MNK = 2×4096×8192×4096")
答案: 274.9 GFLOPs | 你的: 274.9
✅ 正确
# 手算题 2:7B BF16 训练显存(不含激活,GB)
u2 = 112.0
N = 7e9
ans = N * (2 + 2 + 12) / 1e9
print("答案: %.0f GB(16N 字节) | 你的: %.0f" % (ans, u2))
print("✅ 正确" if abs(u2 - ans) < 5 else "❌ = (权重2B + 梯度2B + Adam12B) × N")
答案: 112 GB(16N 字节) | 你的: 112
✅ 正确
# 手算题 3:Ring AllReduce 通信量(8 卡,每卡 1GB 梯度,每卡总传多少 GB)
u3 = 1.75
P, S = 8, 1.0
ans = 2 * (P - 1) / P * S
print("答案: %.3f GB(2(P-1)/P·S) | 你的: %.3f" % (ans, u3))
print("✅ 正确" if abs(u3 - ans) < 0.05 else "❌ ≈2S,与卡数近似无关")
答案: 1.750 GB(2(P-1)/P·S) | 你的: 1.750
✅ 正确
# 手算题 4:KV Cache 内存(LLaMA-7B,B=16, T=4096, FP16)
u4 = 34.4
L, hd = 32, 4096
ans = 2 * L * hd * 16 * 4096 * 2 / 1e9
print("答案: %.1f GB(2×L×hd×B×T×2B) | 你的: %.1f" % (ans, u4))
print("✅ 正确" if abs(u4 - ans) < 2 else "❌ = 2×32×4096×16×4096×2B")
答案: 34.4 GB(2×L×hd×B×T×2B) | 你的: 34.4
✅ 正确
# 手算题 5:7B×1T 训练成本(A100 312TFLOPS, MFU 40%)
u5 = 93.5
N, D, pi, mfu = 7e9, 1e12, 312e12, 0.4
ans = 6 * N * D / pi / 3600 / mfu / 1e3   # 千 A100-hours
print("答案: %.1fK A100-hours | 你的: %.1f" % (ans, u5))
print("✅ 正确" if abs(u5 - ans) < ans * 0.1 else "❌ = 6ND/(π·MFU);7B×1T ≈ 93K A100-hours")
答案: 93.5K A100-hours | 你的: 93.5
✅ 正确
一句话串联全章(面试叙事模板)
"AI Infra 的本质是 系统视角的「算力-带宽-显存-成本」四本账: ① 先看硬件(roofline 判瓶颈)→ ② 算子层用小 GEMM 优化三板斧与算子融合把带宽受限变算力受限; ③ 单卡放不下就上并行(DP 同步梯度、TP 切矩阵、PP 切层、FSDP 分状态)+ 集合通信(Ring AllReduce 带宽最优); ④ 数值上混合精度(BF16+scaling)把显存减半; ⑤ 推理侧用 KV Cache 换算力、连续批处理塞满 GPU、投机解码降延迟、量化(GPTQ/AWQ/SmoothQuant)再省一半; ⑥ 最后一切用 profiler 与 6ND 成本模型量化,报出『负载×延迟×吞吐×成本』。"
按这个叙事,98% 的 AI Infra 面试题都能挂上钩。