🎼 24-信号处理 · 03 STFT 与语谱图¶
关键词:分帧、加窗、STFT、时频分辨率 语音是时变信号:不同时刻有不同频率。STFT = 加窗 DFT 的"滑动取景",把时间-频率画成一张语谱图。
本节要解决的问题¶
| # | 问题 | 对应内容 |
|---|---|---|
| 1 | 为什么直接 DFT 不够? | §1 核心概念 |
| 2 | STFT 的三个参数:帧长/帧移/窗函数 | §2 深入原理 |
| 3 | 25ms/10ms/40Hz 这些数字怎么来的? | §3 手算 ✍️ |
| 4 | 时间分辨率与频率分辨率怎么权衡? | §4 代码实战 |
故事引入¶
一段语音 0.1s 里先有"啊"(低频)后有"咿"(高频)。整体 DFT 只能告诉你"整段里有哪些频率",却分不清"哪个频率出现在哪一刻"。STFT 把时间切成小段(帧),每帧做一次 DFT——时间和频率都有了。
STFT 的产物——语谱图——在真实语音上是这样的。下图取自一段英文句子,截取辅音 /b/ 前后 0.5 秒:横轴时间、纵轴频率、颜色深浅代表该时该频的能量。可以看到语音的能量随时间剧烈变化:元音段有明亮的横条纹(共振峰),辅音段则是一团宽频的暗色爆发。
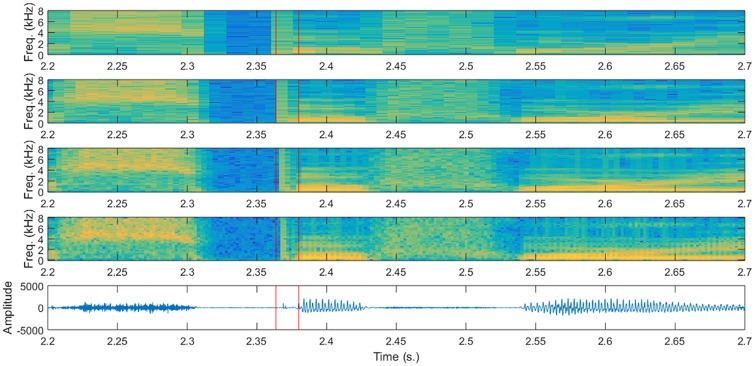
怎么读:语谱图的"条纹"就是共振峰(formant),是发音器官的形状在频域的印记;辅音爆发则横跨很宽频率。这正是"时频表示"比单一 DFT 多出的信息——时间轴上声音在变,语谱图把这种变化保留了下来。
📚 图源:Toledano DT et al. (2018) Multi-resolution speech analysis for ASR: Experiments on TIMIT, PLOS ONE 13(8):e0205355(开放获取,CC-BY 4.0)图 1。
核心概念¶
STFT(短时傅里叶变换):
$$X(m,k)=\sum_{n}x[n]\,w[n-mH]\,e^{-j\frac{2\pi}{N}kn}$$
- $m$:帧序号;$H$:帧移(hop);$w$:窗函数;$N$:帧长
- 三步走:分帧 → 加窗 → 逐帧 DFT
- 语谱图 = $|X(m,k)|^2$(或 dB)按"时间×频率"排成的二维图
- 语音标准:$f_s=16$kHz,帧长 $N=400$(25ms),帧移 $H=160$(10ms),窗用 Hamming
帧长、帧移、窗函数这些参数,最终都反映在语谱图的"颗粒感"上。下图是同一语音在不同情绪下(平静/愤怒/恐惧…)的 Mel 语谱图对比:情绪不同,能量在时频平面上的分布形态明显不同。也说明 Mel 刻度(人耳感知)下的语谱图比线性刻度更贴合听觉。
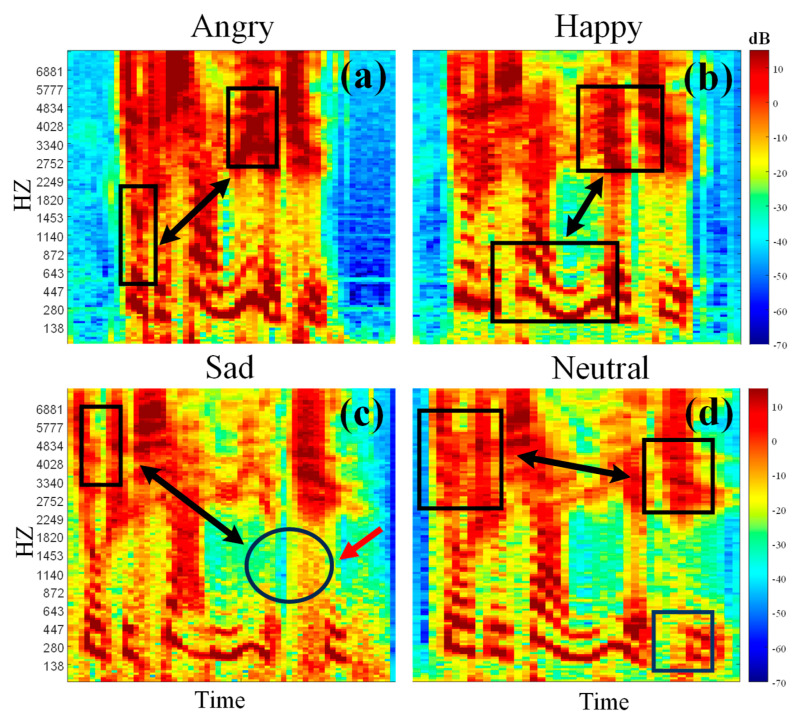
怎么读:每张小图是一句情绪语音的 Mel 语谱图,颜色越亮能量越强。愤怒语音在中高频段的能量更集中,平静语音的能量更平缓——这就是"时频分辨率选择会影响你能看到什么"的现实例证。
📚 图源:Li H et al. (2024) MelTrans: Mel-Spectrogram Relationship-Learning for Speech Emotion Recognition, Sensors 24(17):5506(开放获取,CC-BY 4.0)图 1。
深入原理:三个参数与两对分辨率¶
参数换算($f_s=16000$,$N=400$,$H=160$):
- 帧时长 $N/f_s=25$ms;帧移 $H/f_s=10$ms(相邻帧重叠 15ms,保持平滑)
- 频率分辨率 $\Delta f=f_s/N=40$Hz;时间分辨率 $\Delta t=H/f_s=10$ms
权衡:帧长 ↑ → 频率分辨率 ↑($\Delta f=f_s/N$↓)但时间分辨率 ↓(每帧覆盖更长);反之亦然。$\Delta t\cdot\Delta f=\frac{H}{f_s}\cdot\frac{f_s}{N}=\frac{H}{N}=\text{常数}$——时频不确定关系(语音版海森堡)。
Hamming 窗:$w[n]=0.54-0.46\cos(2\pi n/(N-1))$,压低旁瓣防频谱泄漏(§01)。
✍️ 手算 STFT 参数与分帧¶
设定 A:参数换算($f_s=16000$, $N=400$, $H=160$)
$$\text{帧长}=\frac{400}{16000}=25\text{ms},\quad \text{帧移}=\frac{160}{16000}=10\text{ms},\quad \Delta f=\frac{16000}{400}=\mathbf{40}\ \text{Hz}$$
设定 B:分帧——16 点信号,帧长 8、帧移 4:
$$\text{帧数}=\left\lfloor\frac{16-8}{4}\right\rfloor+1=\mathbf{3}\ \text{帧(帧 0:[0..7],帧 1:[4..11],帧 2:[8..15])}$$
设定 C:Hamming 窗($N=8$)
$$w[0]=0.54-0.46\cos0=\mathbf{0.08};\qquad w[3]=0.54-0.46\cos(6\pi/7)\approx\mathbf{0.9544}$$
窗两端低、中间高——"中间的数据更重要"。
手算收获:
- 帧长/帧移是工程约定(25/10ms):太短频率糊、太长语音突变被抹平;重叠 50%+ 是默认
- $\Delta f=40$Hz 意味着 8kHz 内共 200 个频点;两个差 40Hz 以内的频率在单帧内分不开
- $w[0]=0.08$ 极低 → 帧首尾数据几乎被窗压掉,能量靠重叠帧补回(OLA 合成)
- 面试速答:语谱图纵轴频率、横轴时间、颜色能量——读图先找"横条=稳态音、竖条=瞬态冲击"(打击乐/爆破音)
# ---- §3.1 验证:numpy 复算 STFT 参数 ----
import numpy as np
fs, N, H = 16000, 400, 160
print(f'帧长 = {N/fs*1000} ms, 帧移 = {H/fs*1000} ms, Δf = {fs/N} Hz')
assert N/fs*1000 == 25 and H/fs*1000 == 10 and fs/N == 40

sig = np.arange(16.0)
n_frames = (len(sig) - 8) // 4 + 1
print(f'16 点信号(帧长8,帧移4) → 帧数 = {n_frames}')
assert n_frames == 3

w = 0.54 - 0.46*np.cos(2*np.pi*np.arange(8)/(8-1))
print(f'Hamming(N=8): w[0] = {w[0]:.4f}, w[3] = {w[3]:.4f}')
assert abs(w[0] - 0.08) < 1e-3 and abs(w[3] - 0.9544) < 1e-3
print('\n✓ 与手算一致')
帧长 = 25.0 ms, 帧移 = 10.0 ms, Δf = 40.0 Hz
16 点信号(帧长8,帧移4) → 帧数 = 3
Hamming(N=8): w[0] = 0.0800, w[3] = 0.9544

✓ 与手算一致
代码实战:从零写 STFT(滑动窗 DFT)¶
手写分帧+DFT,得到语谱图矩阵,数字可直接核对。
# ---- 手写 STFT:分帧→加窗→逐帧 DFT ----
import numpy as np

def stft(x, N=400, H=160, fs=16000):
    w = 0.54 - 0.46*np.cos(2*np.pi*np.arange(N)/(N-1))   # Hamming
    n_frames = (len(x) - N) // H + 1
    spec = np.zeros((n_frames, N//2 + 1))
    for m in range(n_frames):
        seg = x[m*H : m*H + N] * w
        spec[m] = np.abs(np.fft.rfft(seg))**2
    return spec

# 合成: 0.5s 内 500Hz→2500Hz 线性扫频
fs = 16000
n = np.arange(int(0.5*fs))
f0, f1 = 500.0, 2500.0
phase = 2*np.pi*(f0*n/fs + (f1-f0)*(n/fs)**2/2)
x = np.cos(phase)
spec = stft(x, fs=fs)
print('语谱图形状 (帧数 × 频点数) =', spec.shape)
print('帧数 =', spec.shape[0], '(0.5s 信号, 25ms 帧, 10ms 移)')
assert spec.shape[0] == (len(x)-400)//160 + 1
assert spec.shape[1] == 201   # N//2+1
print('✓ 与手算参数一致')
语谱图形状 (帧数 × 频点数) = (48, 201)
帧数 = 48 (0.5s 信号, 25ms 帧, 10ms 移)
✓ 与手算参数一致
面试考点¶
Q1:STFT 和 DFT 的区别?
DFT 一次性把整段信号变频域,丢失时间信息;STFT 分帧滑动 DFT,输出时间×频率矩阵。
Q2:帧长怎么选?
权衡时频分辨率:语音 20–30ms 是"准平稳"经验区间;帧太长频率分辨率高但时间糊,帧太短反之。
Q3:为什么用 Hamming 窗而不是矩形窗?
矩形窗旁瓣高(−13dB)泄漏严重;Hamming 主瓣稍宽但旁瓣 −43dB,能量集中。
Q4:语谱图怎么用于 ASR/说话人?
MFCC = 语谱图(Mel 滤波+log+余弦)→ 特征输入;语谱图本身也可直接喂 CNN(§16-语音 00 衔接)。
小结与下一章预告¶
- STFT = 分帧 + 加窗 + 逐帧 DFT;25ms/10ms/40Hz 是 16kHz 语音的标准配置
- 时频分辨率此消彼长:$\Delta t\cdot\Delta f=H/N$ 常数
- 下一章:怎么"加工"信号?——FIR / IIR 滤波器设计
✅ 自测清单¶
- 能手算 STFT 参数换算(帧长/帧移/Δf)与分帧数
- 能说出 Hamming 窗公式与 w[0]、w[3] 的数值
- 能解释时频分辨率的权衡
- 知道语谱图坐标含义与读图方法