⚙️ 15-AI-Infra · 06 推理引擎:vLLM 连续批处理与投机解码¶
关键词:静态批处理 · 连续批处理(continuous batching)· 调度 · 投机解码(speculative decoding)· 并行采样 · TTFT/TPOT/吞吐
前置知识:[05-KV Cache与推理内存](05-KV Cache与推理内存.ipynb)(decode 带宽受限)、04-集合通信与NCCL(吞吐思维)。
🧩 本讲定位:有 KV Cache 之后,推理引擎的胜负手是调度:静态批处理为什么浪费?vLLM 的连续批处理怎么"塞满"GPU?投机解码为什么能提速还不改变分布?本讲用离散事件模拟把吞吐-延迟的权衡讲透。
本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 静态批处理为什么浪费算力? | 深入原理 1 + 实战 A |
| 连续批处理怎么"塞满" GPU? | 深入原理 2 + 实战 A |
| 投机解码为什么快?加速比多大? | 深入原理 3 + 实战 B |
| 吞吐和延迟指标怎么算? | 核心概念 (c) + 实战 C |
| 并行采样是什么?和投机解码啥关系? | 深入原理 4 + 面试考点 |
故事引入¶
小周把 7B 模型部署上线,QPS 只有可怜的 1.2。他看 GPU 利用率:30%。原因简单——静态批处理:4 条请求凑成一个 batch,必须等最慢的那条生成完,batch 才解散换下一批。请求长度参差时,后半程 batch 里只剩一两条还在跑,其他 GPU 全闲着。
他换上 vLLM 的连续批处理:每生成一步就检查有没有请求完成,完成了立刻腾出 slot 给新请求——GPU 利用率冲到 85%,QPS 翻了 3 倍。再叠一层投机解码(小模型草稿 + 大模型校验),TPOT 又降了 40%。本讲就把这三板斧的原理与收益算清楚。
核心概念¶
(a) 静态批处理 vs 连续批处理¶
| 维度 | 静态批处理 | 连续批处理(vLLM) |
|---|---|---|
| 批次切换时机 | 整批全部解码完 | 每步检查,完成即腾位 |
| 尾部浪费 | 长尾请求拖慢整批 | 无(按 step 粒度调度) |
| GPU 利用率 | 中低(长尾闲置) | 高(始终有活干) |
| 实现代价 | 简单 | 需要内存池/PagedAttention + 调度器 |
(b) 投机解码:小模型先写,大模型一次校验¶
- 小模型(草稿)自回归草稿 $k$ 个 token;
- 大模型并行校验 $k+1$ 个位置(一次性前向);
- 拒绝采样修正:接受与目标分布一致的 token,不一致处回退重采;
- 输出分布与大模型直接采样严格一致(数学保证),速度却接近 $k$ 倍。
(c) 关键指标¶
- TTFT(Time To First Token):prefill 主导,影响"首响应"体感;
- TPOT / ITL(每输出 token 间隔):decode 主导,影响"逐字速度";
- 吞吐:tokens/s,批处理容量与利用率主导。
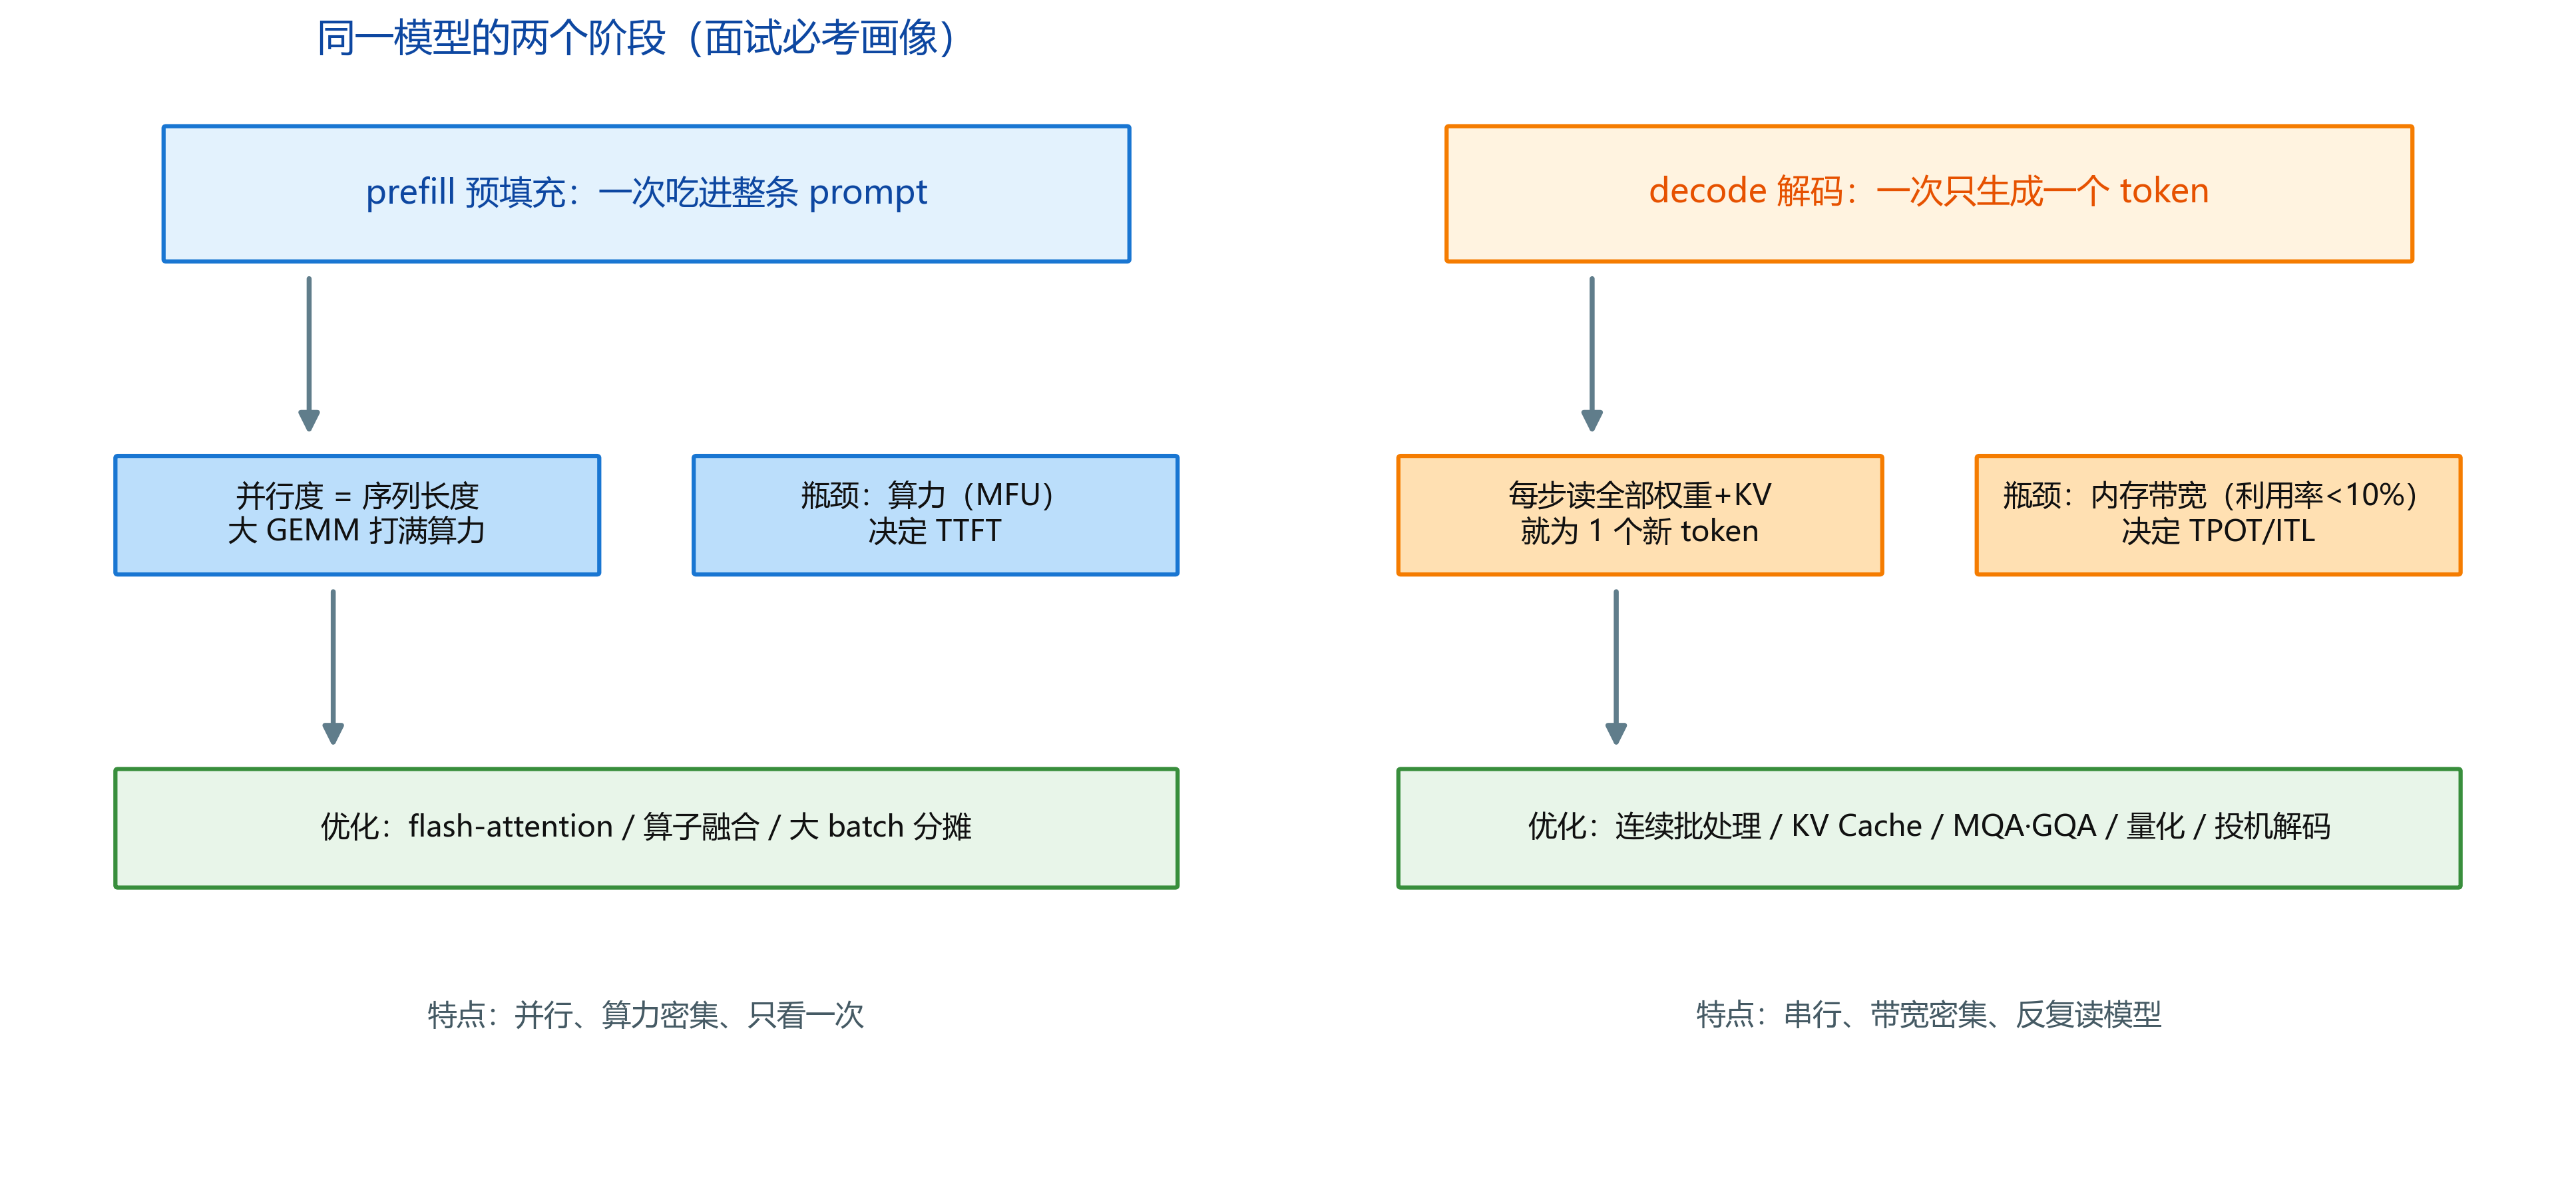
图示:prefill 并行度高、算力受限(决定 TTFT);decode 每步只产一个 token 却要读全部权重+KV,带宽受限(决定 TPOT),利用率常 <10%。
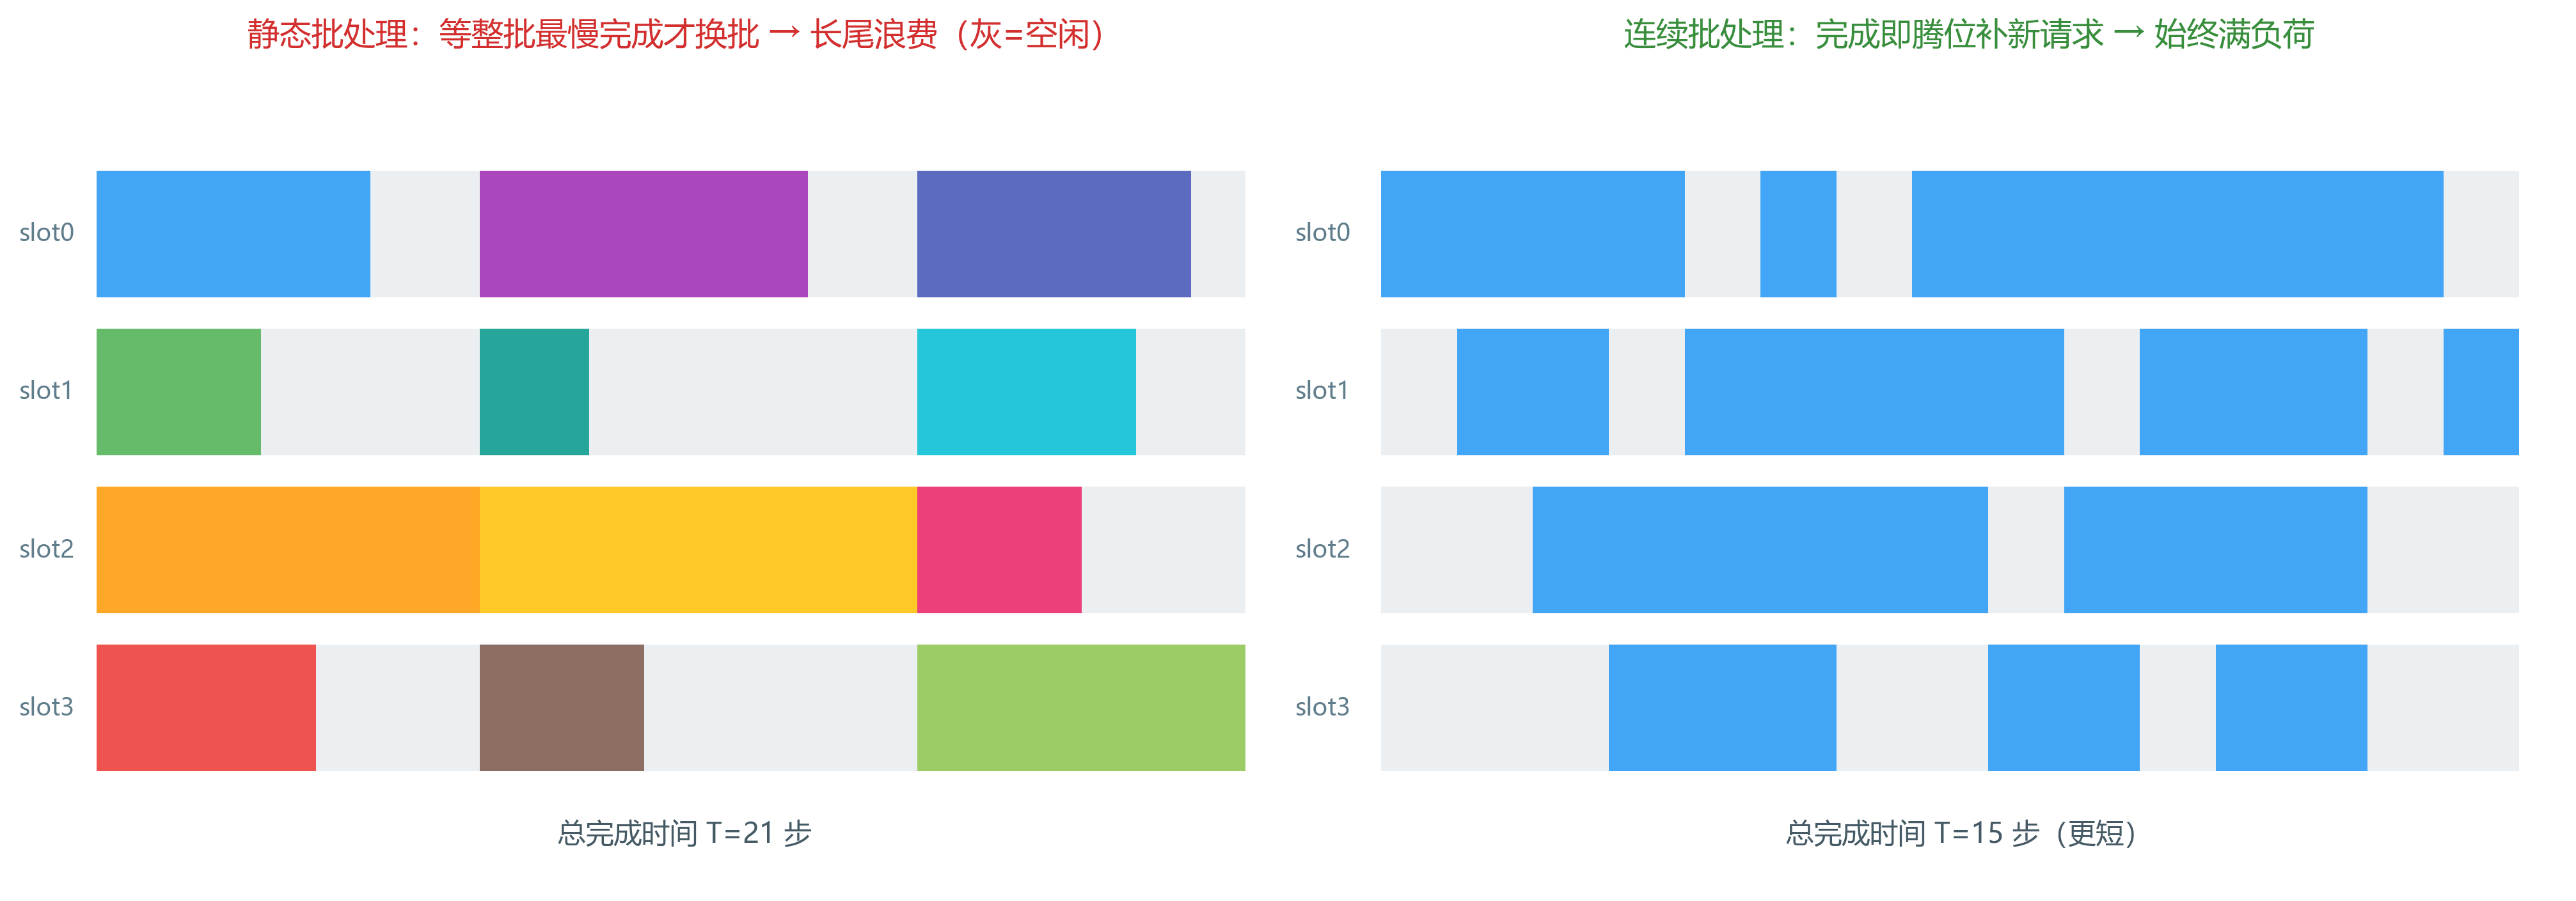
图示:同一批请求,静态批处理等最慢的完成才换批(长尾浪费);连续批处理完成即腾位补新请求,总完成时间显著缩短。
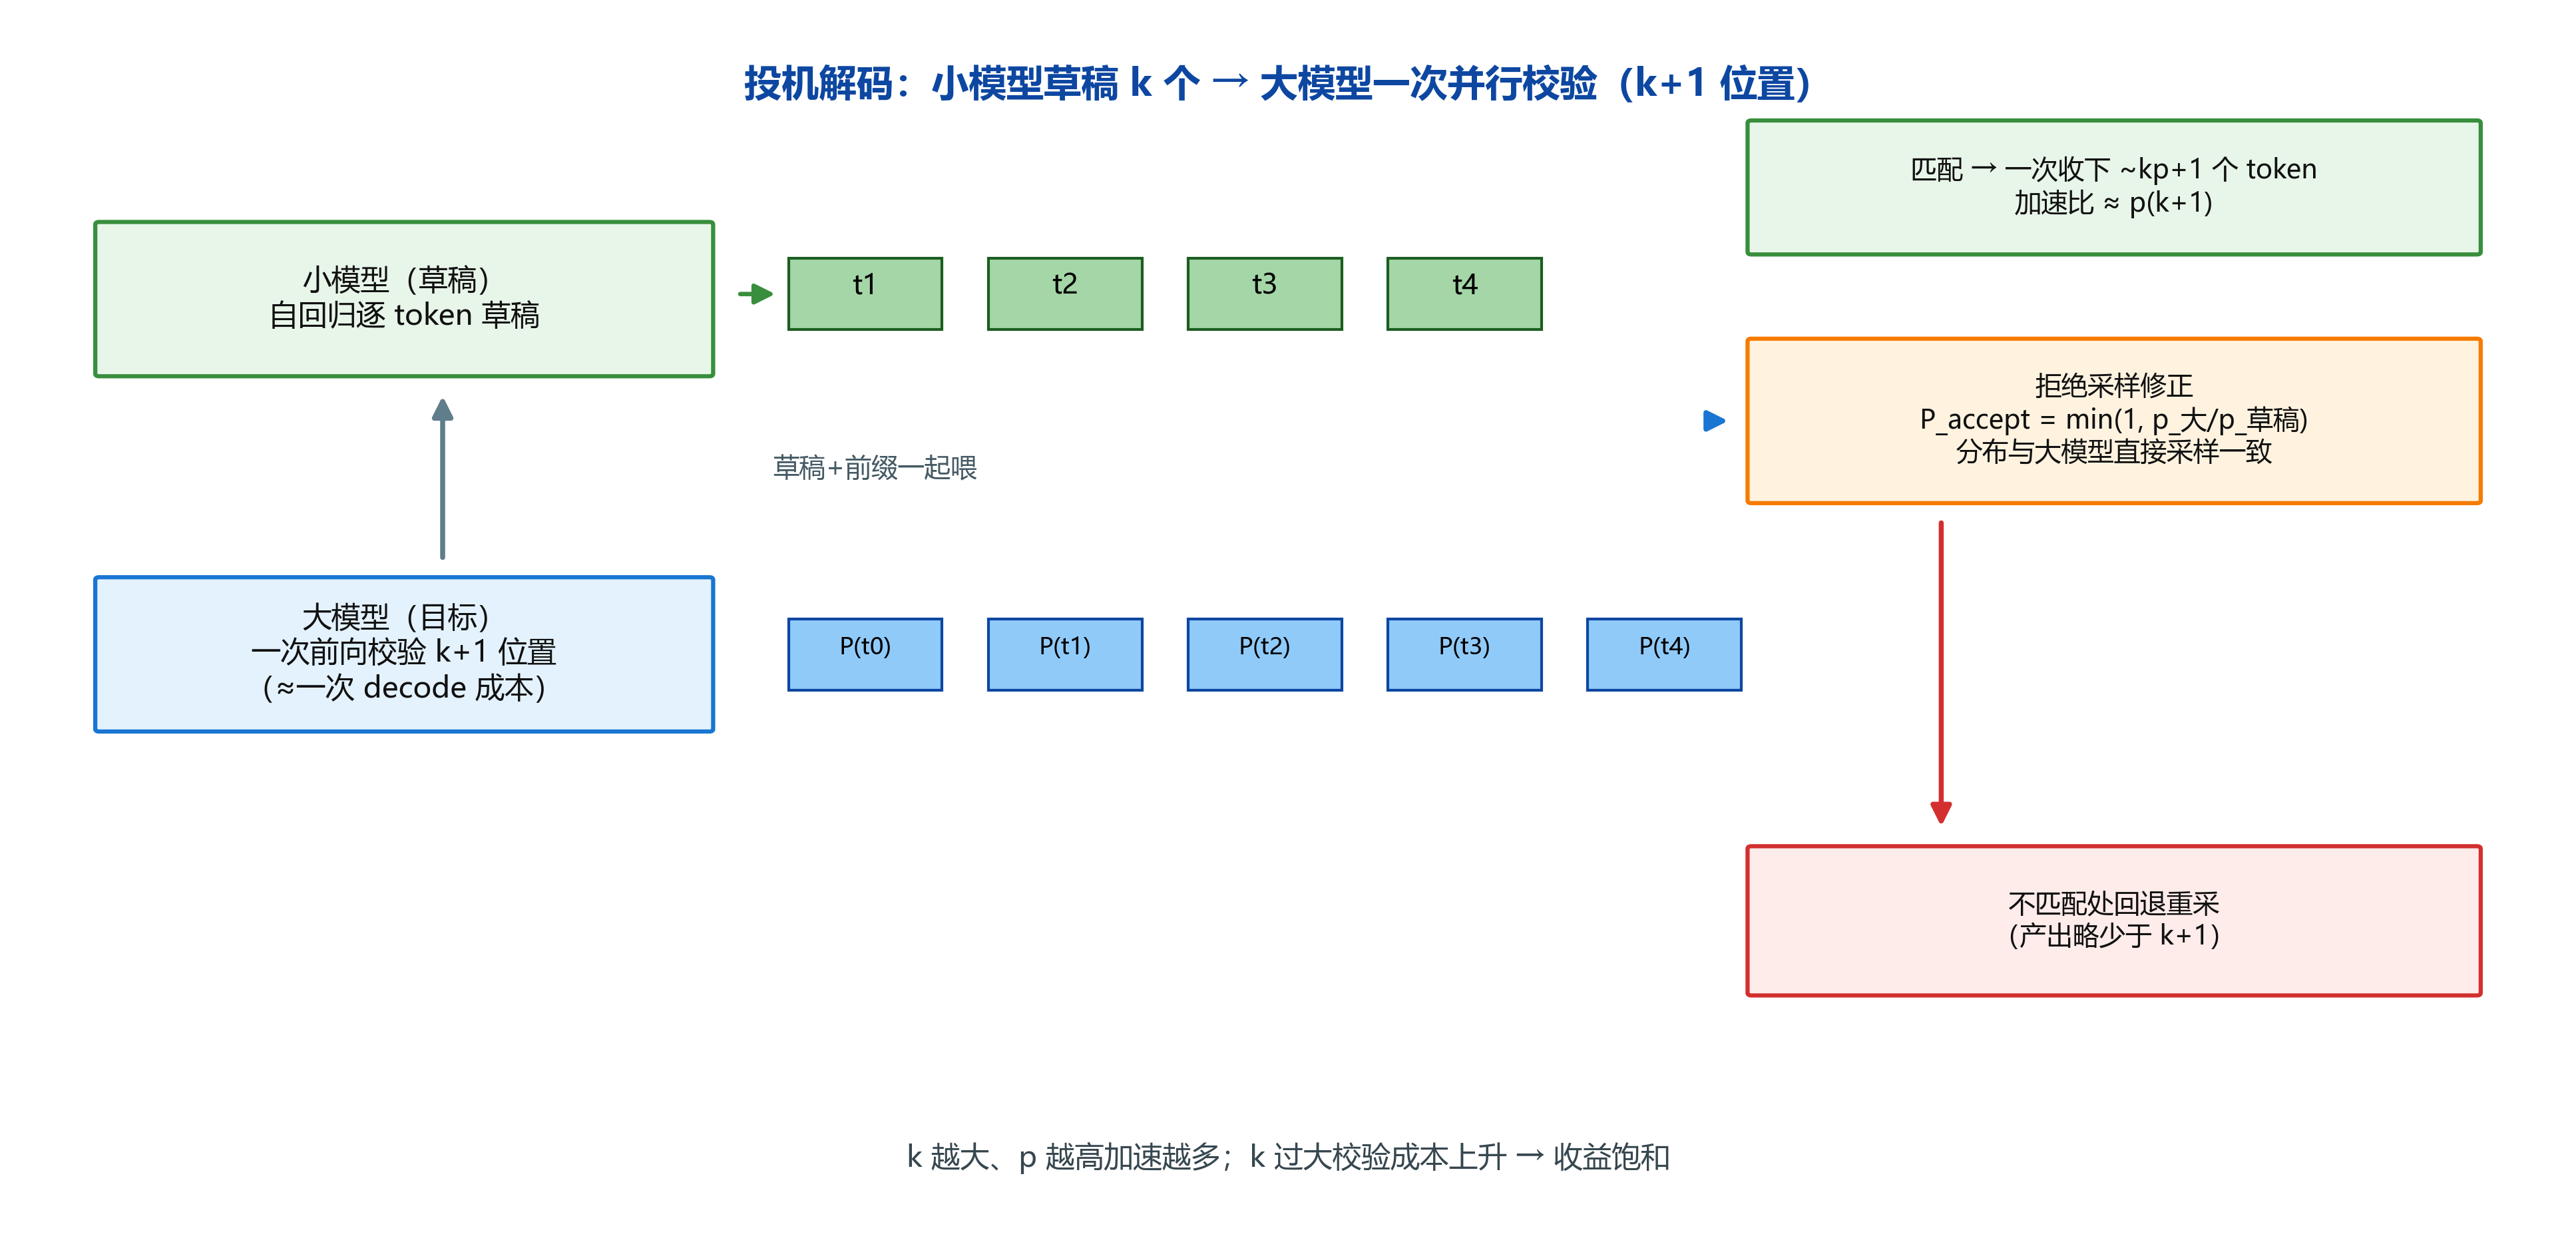
图示:小模型草稿 k 个 token → 大模型一次并行校验 k+1 位置 → 拒绝采样修正(分布严格一致),一次收下约 kp+1 个 token,加速比 ≈ p(k+1)。
深入原理¶
1. 静态批处理的长尾浪费(数学化)¶
设 batch 中请求生成长度 $\ell_i\sim \text{长尾分布}$(如对数正态),批次持续 $\max_i \ell_i$ 步,平均每步活跃请求:
$$ \text{利用率}_{\text{static}} = \frac{1}{B}\cdot\frac{\frac{1}{\max\ell}\sum_i\ell_i}{1}\approx \frac{\bar\ell}{\ell_{\max}}\to\frac{1}{B}\quad(\text{长尾时}) $$
实际日志:长度标准差一大,静态批利用率常掉到 30-50%。
2. 连续批处理的调度模型¶
调度器每个 decode step 做三件事:
- 完成检测:生成完(含 stop 条件)的请求出队、释放 KV 页;
- 准入:显存/KV 池有余量则从队列取新请求(先 prefill,与 decode 交错或用分时);
- 执行:所有未完成请求的 decode 打包成一个大 batch 跑一步。
关键点:prefill 与 decode 的计算特征不同(prefill 算力密集、decode 带宽密集),引擎需要"双模 batch"或分块调度,否则长 prompt 会拖慢 decode。
3. 投机解码的加速比¶
设草稿接受率 $p$(每位置)、草稿长度 $k$:一次校验生成 $\approx kp+1$ 个 token,成本 = 1 次大模型前向($k+1$ 位置)+ $k$ 次小模型前向(快,可忽略):
$$ \text{Speedup} \approx \frac{k+1}{1}\,\cdot\, p \approx p(k+1)\xrightarrow{p\approx0.7,\ k=4}\ 3.5\times $$
接受率越高、草稿越长加速越大;但 $k$ 过大时"大模型校验位置过多"收益饱和(每位置开销不变,接受率却不随 k 涨)。
4. 并行采样与草稿¶
并行采样(parallel sampling):同一 prompt 一次跑 $B$ 条,结果多样(beam/采样)。配合 PagedAttention 的前缀共享,$B$ 条共享同一个前缀 KV,几乎不额外占显存——这也是投机解码/多候选的基础设施。
✍️ §1.1 手算连续批处理收益:3 条请求,静态批浪费多少¶
静态批必须等整批最长请求走完——3 条请求手算,看利用率,再算投机解码加速比。
设定:3 条请求生成长度 $[5,2,8]$(prefill 略,只看 decode 步数)。
第 1 步:静态批
$$\text{总步数}=8\ \text{(最长请求)},\qquad \text{有效产出}=5+2+8=15\ \text{token}$$
$$\text{利用率}=\frac{15}{8\times3}=62.5\%\quad\Rightarrow\quad 37.5\%\ \text{算力在空等}$$
第 2 步:投机解码加速比(公式 $p(k+1)$:草稿 $k$ 个、接受率 $p$)
| p | k | 加速比 |
|---|---|---|
| 0.5 | 4 | 2.5x |
| 0.7 | 4 | 3.5x |
| 0.7 | 6 | 4.9x |
| 0.9 | 8 | 8.1x |
手算收获:
- 静态批利用率 62.5%:等最长请求的空档里 GPU 空闲——连续批处理每步动态调度"有 token 要生成的请求"(本 notebook 代码实战 A 的离散事件模拟)
- 投机解码"一次前向产出 $k+1$ 个 token":草稿模型先猜 $k$ 个,大模型一次校验——接受率 $p$ 高时接近 $k+1$ 倍,$p$ 低时连成本都不划算
- 加速比上界 $p(k{+}1)$:$k$ 越长收益饱和(草稿模型猜不准后面),这就是 $k\approx4\sim8$ 的工程共识
- 面试速答:连续批处理解决"批内长尾"、投机解码解决"单 token 延迟"——两个正交的吞吐/延迟优化
下面 numpy 复算。
# ---- §1.1 验证:numpy 复算连续批处理与投机解码 ----
import numpy as np

L = np.array([5, 2, 8])
static_steps = L.max()
util = L.sum() / (static_steps * len(L))
print(f'静态批步数 = {static_steps},利用率 = {util:.2%}')
assert static_steps == 8 and abs(util - 0.625) < 1e-9

for p, k in [(0.5, 4), (0.7, 4), (0.7, 6), (0.9, 8)]:
    sp = p * (k + 1)
    print(f'p={p}, k={k} → 加速比 = {sp:.1f}x')
assert abs(0.5 * 5 - 2.5) < 1e-9 and abs(0.9 * 9 - 8.1) < 1e-9
print('\n✓ 与手算一致')
代码实战 A:静态 vs 连续批处理调度模拟¶
先运行环境设置单元:
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False
np.random.seed(0)
print("环境就绪")

plt.show()
环境就绪
# 离散事件模拟:40 条请求,生成长度对数正态分布
rng = np.random.default_rng(7)
n_req = 40
lens = np.clip(np.round(rng.lognormal(mean=5.3, sigma=0.8, size=n_req)).astype(int), 8, 300)
cap = 4                      # 并发容量(同时处理请求数)

def simulate_continuous(lens, cap):
    """连续批处理:step 粒度调度。返回(完成步数, 每步活跃数)。"""
    todo = list(lens); done = 0; step = 0
    active = []              # 剩余步数
    util = []
    while done < n_req:
        while len(active) < cap and todo:
            active.append(todo.pop(0))
        active = [l - 1 for l in active if l > 1]
        if not active and todo:
            pass
        util.append(len(active))
        done = n_req - len(todo)
        step += 1
    return step, np.array(util)

def simulate_static(lens, cap):
    """静态批处理:装满 cap 条,全部完成才换批。"""
    todo = list(lens); step = 0; util = []
    while todo:
        batch = todo[:cap]; todo = todo[cap:]
        rem = list(batch)
        while rem:
            rem = [l - 1 for l in rem if l > 1]
            util.append(len(rem))
            step += 1
    return step, np.array(util)

steps_c, util_c = simulate_continuous(lens, cap)
steps_s, util_s = simulate_static(lens, cap)
print("总完成步数:静态 %d vs 连续 %d(少 %.0f%% 时间)" % (steps_s, steps_c, 100 * (1 - steps_c / steps_s)))
print("平均活跃数:静态 %.1f vs 连续 %.1f(容量 %d)" % (util_s.mean(), util_c.mean(), cap))

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4))
ax1.plot(util_s, color="#D32F2F"); ax1.set_title("静态批处理:活跃请求随时间衰减(长尾闲置)")
ax1.set_xlabel("step"); ax1.set_ylabel("活跃请求数")
ax2.plot(util_c, color="#388E3C"); ax2.set_title("连续批处理:始终满负荷(完成即补位)")
ax2.set_xlabel("step"); ax2.set_ylabel("活跃请求数")
for a in (ax1, ax2): a.grid(alpha=0.3)
plt.tight_layout(); plt.show()
assert steps_c < steps_s
print("✅ 连续批处理显著缩短总完成时间(长尾分布下优势更大)")
总完成步数:静态 2584 vs 连续 1521(少 41% 时间)
平均活跃数:静态 2.5 vs 连续 4.0(容量 4)
✅ 连续批处理显著缩短总完成时间(长尾分布下优势更大)
C:\Users\24260\AppData\Local\Temp\ipykernel_31200\565360881.py:46: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
代码实战 B:投机解码加速比(模拟 + 公式)¶
# 理论加速比 vs 模拟
def speedup_formula(p, k):
    return p * (k + 1)  # 每次校验期望产出 ~kp+1 个 token,成本 ≈1 次大模型前向(带宽受限,权重只读一次)→ 上界 ≈ p(k+1)

def simulate_spec(p, k, n_trials=20000, draft_cost=0.05):
    """模拟:每轮草稿 k 个,接受概率 p(独立),产出=接受数+1 个 token。
    成本=1 + k*draft_cost(大模型前向=1 单位)。"""
    rng2 = np.random.default_rng(9)
    tokens = 0; cost = 0.0
    while tokens < n_trials:
        acc = np.sum(rng2.random(k) < p)
        tokens += acc + 1
        cost += 1 + k * draft_cost
    return n_trials / cost  # tokens per 单位成本

base = 1.0  # 无投机:1 token / 1 成本
for p, k in ((0.5, 4), (0.7, 4), (0.7, 6), (0.9, 8)):
    sp_formula = speedup_formula(p, k)
    sp_sim = simulate_spec(p, k) / base
    print("p=%.1f k=%d → 公式 %.2fx | 模拟 %.2fx" % (p, k, sp_formula, sp_sim))

fig, ax = plt.subplots(figsize=(8.5, 4.5))
ps = np.linspace(0.2, 0.95, 50)
for k, c in zip((2, 4, 8), ("#1976D2", "#388E3C", "#D32F2F")):
    ax.plot(ps, [speedup_formula(p, k) for p in ps], label="草稿长度 k=%d" % k, color=c)
ax.set_xlabel("接受率 p"); ax.set_ylabel("加速比")
ax.set_title("投机解码加速比:p 越高、k 越长越快(k 过大收益饱和)")
ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
p=0.5 k=4 → 公式 2.50x | 模拟 2.51x
p=0.7 k=4 → 公式 3.50x | 模拟 3.18x
p=0.7 k=6 → 公式 4.90x | 模拟 4.01x
p=0.9 k=8 → 公式 8.10x | 模拟 5.88x
C:\Users\24260\AppData\Local\Temp\ipykernel_31200\1056716029.py:28: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
代码实战 C:decode 吞吐-延迟曲线(带宽受限)¶
模拟:decode 阶段每步读权重+KV 固定带宽开销;batch 越大,每 token 的"摊销权重读取"越便宜 → 吞吐上升,但单请求 TPOT 随 batch 竞争上升。
# 简化模型:总带宽 Bw=2000GB/s;每步读权重 14GB(7B)+ KV 每请求 0.1GB/步
Bw = 2000.0  # GB/s
w_bytes = 14.0
kv_per_req = 0.1
time_per_step = (w_bytes + kv_per_req) / Bw  # 秒,粗略(含计算重叠因子略)

batch = np.arange(1, 65)
throughput = batch / time_per_step          # tokens/s(每步 1 token/请求)
tpot_ms = time_per_step * 1e3                # 单请求每 token 耗时(无竞争)
tpot_ms_cont = tpot_ms * (1 + 0.03 * (batch - 1))  # 简单竞争模型

fig, ax1 = plt.subplots(figsize=(9, 4.6))
ax1.plot(batch, throughput, "o-", color="#388E3C", label="吞吐 (tokens/s)")
ax1.set_xlabel("并发 batch"); ax1.set_ylabel("吞吐 (tokens/s)", color="#388E3C")
ax2 = ax1.twinx()
ax2.plot(batch, tpot_ms_cont, "s--", color="#D32F2F", label="单请求 TPOT (ms, 竞争)")
ax2.set_ylabel("TPOT (ms)", color="#D32F2F")
ax1.set_title("decode 带宽受限:batch 越大吞吐越高,但单请求延迟上升——调优要定延迟上限")
ax1.grid(alpha=0.3); ax1.legend(loc="upper left"); ax2.legend(loc="center right")
plt.tight_layout(); plt.show()
print("B=1: %.0f tok/s, TPOT %.1f ms | B=32: %.0f tok/s, TPOT %.1f ms" % (throughput[0], tpot_ms_cont[0], throughput[31], tpot_ms_cont[31]))
B=1: 142 tok/s, TPOT 7.0 ms | B=32: 4539 tok/s, TPOT 13.6 ms
C:\Users\24260\AppData\Local\Temp\ipykernel_31200\2287337283.py:20: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
面试考点¶
Q1 连续批处理比静态批处理好在哪?¶
A:静态批必须等整批最长请求结束,长尾浪费 GPU;连续批按 step 调度,完成即腾位补新请求,利用率与吞吐大幅提升(配合 PagedAttention 的内存池)。
Q2 投机解码为什么不会改变输出分布?¶
A:用拒绝采样:草稿 token 以概率 min(1, p_target/p_draft) 接受,否则从修正分布重采——保证最终分布 = 大模型直接采样分布(数学等价)。
Q3 投机解码的加速比受什么影响?¶
A:接受率 p 与草稿长度 k:约 p(k+1) 倍;草稿模型与目标模型越"像"p 越高;k 过大时校验成本上升而接受率不涨,收益饱和。
Q4 为什么 decode 阶段吞吐随 batch 上升但延迟也上升?¶
A:decode 是带宽受限(每步读全部权重);batch 大时权重读取被摊销 → 吞吐升;但共享带宽/算力 → 单请求 TPOT 升。优化要在"延迟 SLA"下取最大吞吐。
Q5 prefill 和 decode 混合 batch 有什么坑?¶
A:prefill 算力密集、decode 带宽密集,混合会让长 prompt 拖慢 decode;引擎需双模调度/分块/异步 prefill(如 chunked prefill)。
Q6 指标怎么报才专业?¶
A:TTFT + TPOT/ITL 分位数(P50/P99)+ 吞吐 + 并发/负载条件,缺一不可;只说"QPS 高"不报延迟分布是外行。
小结与自测清单¶
本讲要点:静态批的长尾浪费 vs 连续批的 step 调度;投机解码 = 草稿 + 并行校验 + 拒绝采样(分布不变);decode 带宽受限下吞吐-延迟权衡;指标 TTFT/TPOT/吞吐配合报。
自测清单:
- 能画出静态 vs 连续批处理的活跃度曲线并解释
- 能默写投机解码加速比公式 p(k+1) 与拒绝采样规则
- 能解释"吞吐升延迟也升"的带宽原因
- 能报出 TTFT/TPOT/吞吐三个指标的测量口径
下一讲预告:07-量化与模型压缩——带宽不够就用"更小的数":INT8/INT4 怎么量化不翻车。