🎤 07 · 大数据面试八股与高频题
最后冲刺:把体系/存储/计算/实时/数仓/管道/平台的考点串成速答体系, 并手写两个高频手撕(TopN、两阶段聚合处理倾斜)。
🎬 背景故事
大数据面试官爱问:'给我 30 秒,讲一条数据从产生到应用'……
大数据岗面试几乎必有这一问:"30 秒,讲一条数据从产生到应用的完整链路。" 本节帮你把这条链路练成肌肉记忆,并覆盖 18 个最高频速答题,最后手撕两道经典题:全局 TopN 分治、数据倾斜两阶段聚合。
🧭 本节逻辑主线:30 秒串讲(采集→存储→计算→数仓→应用)→ 18 个高频速答 → 手撕 TopN → 手撕抗倾斜。
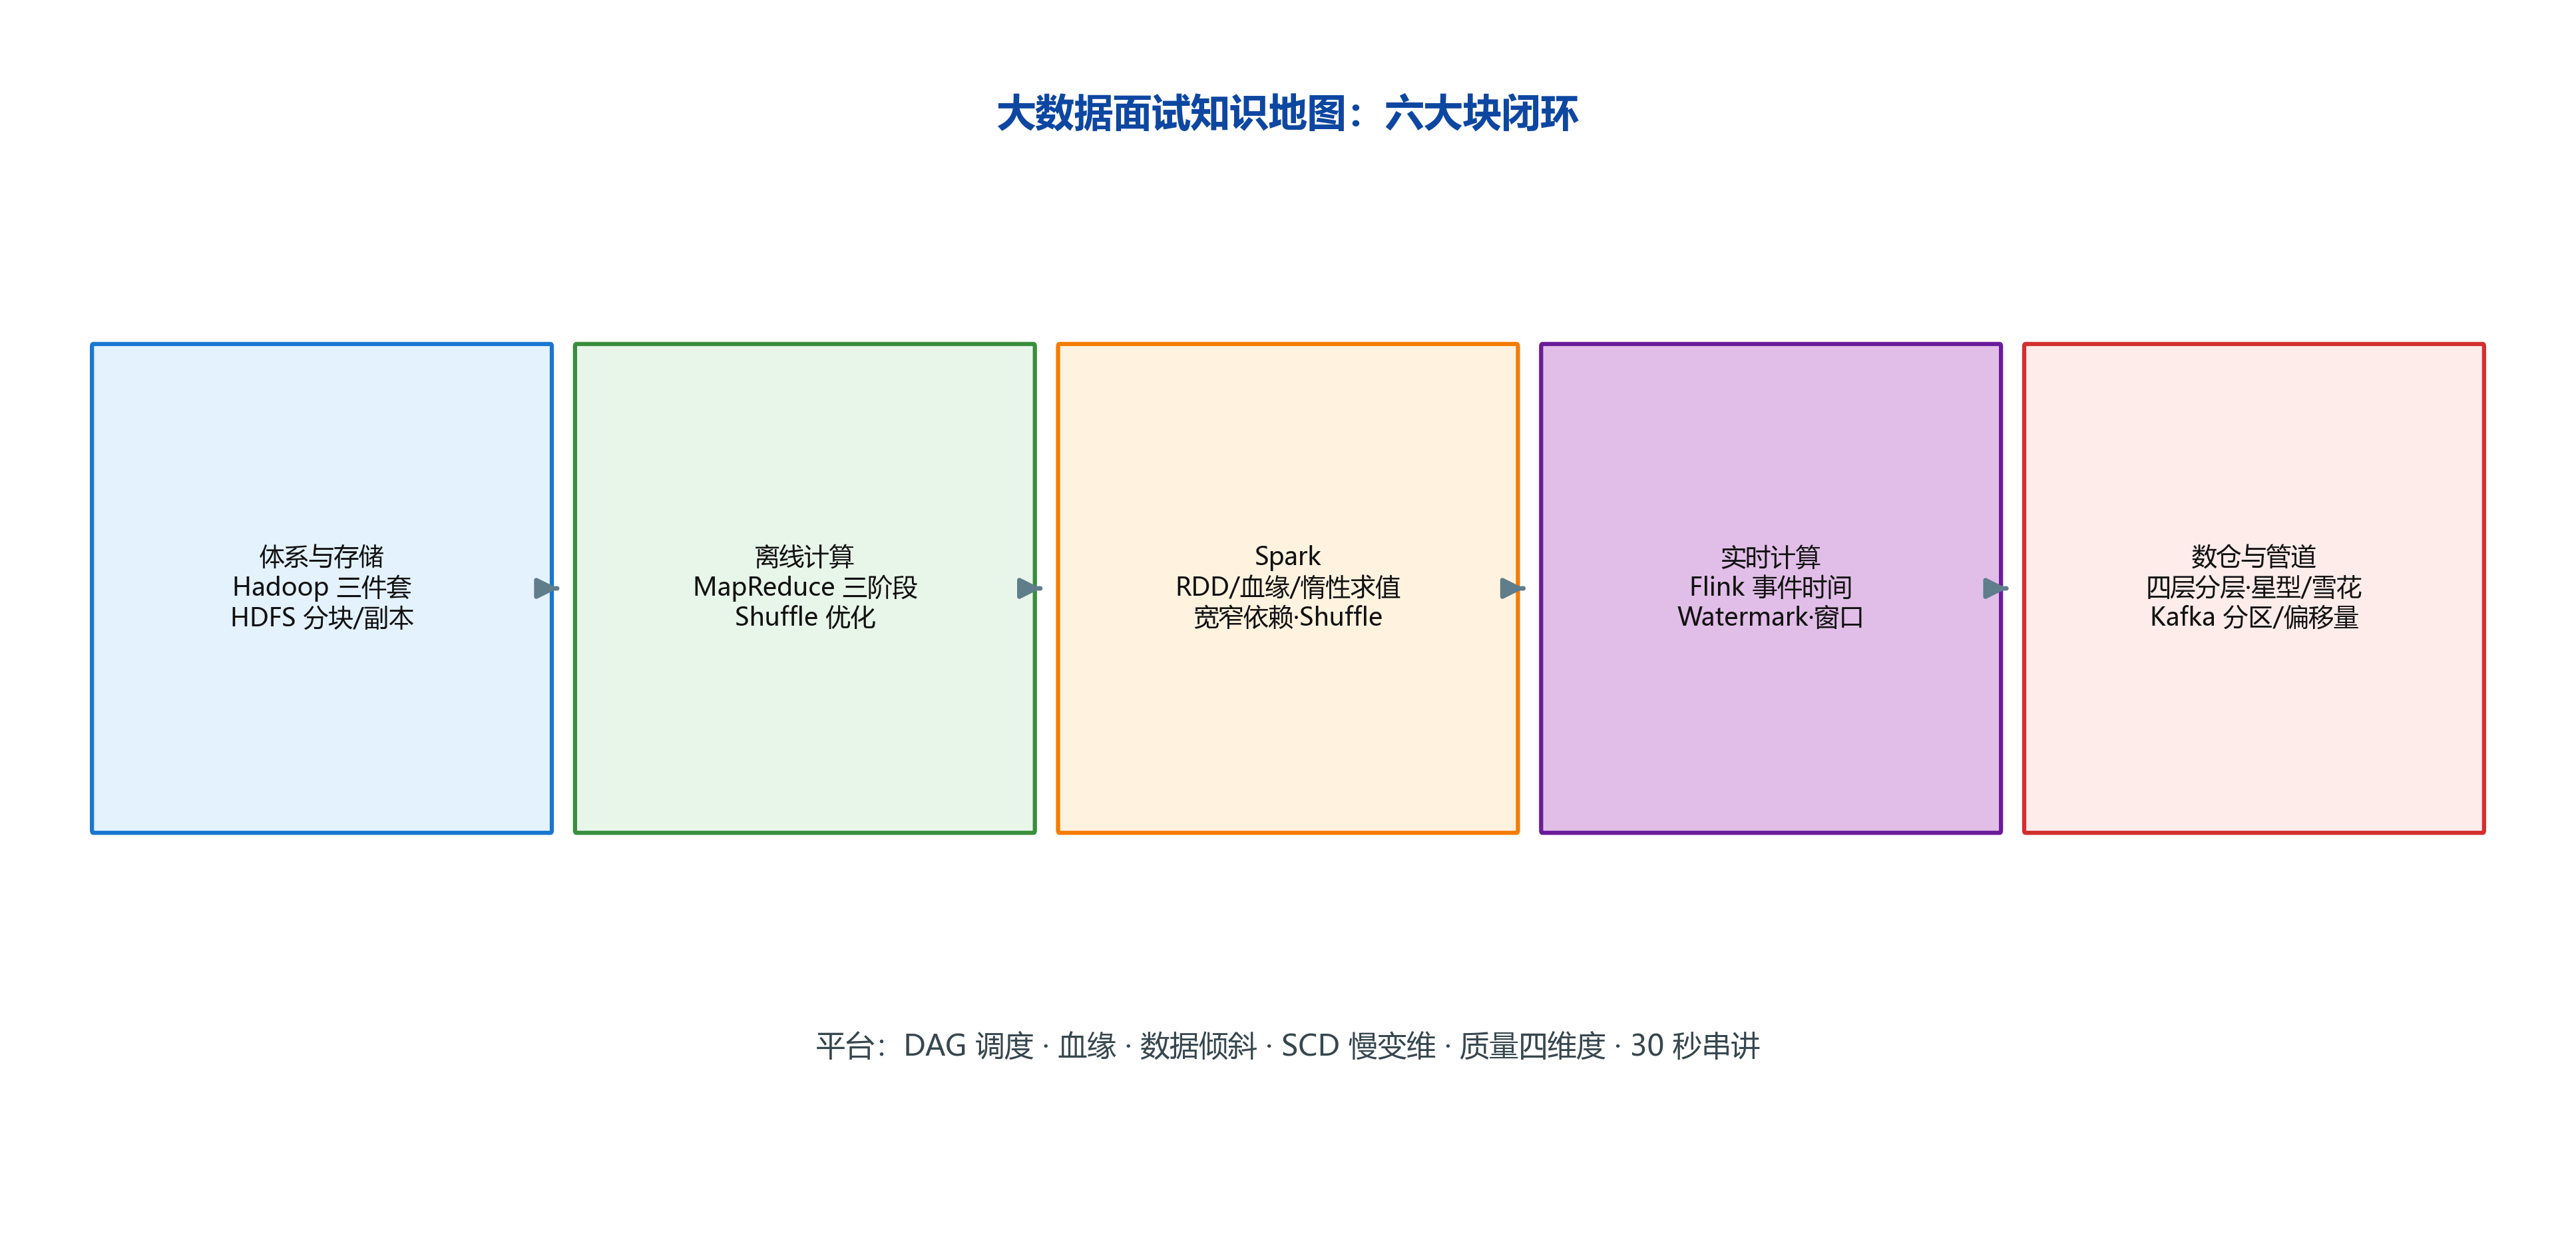
🔍 图解(自绘高清图,300dpi,可放大):大数据面试的六大块知识闭环——
- 存储块:HDFS(块/副本/机架感知)、对象存储、列式存储(Parquet/ORC)——数据落在哪;
- 计算块:MapReduce(三阶段)、Spark(RDD/血缘/Shuffle)、Flink(事件时间/Watermark/状态)——数据怎么算;
- 调度与资源:Yarn(资源管理器/NodeManager)、任务调度——多任务怎么共享集群;
- 数仓块:分层(ODS/DWD/DWS/ADS)、建模(星型/雪花/维度建模理论)、Hive SQL 优化(分区/谓词下推/小文件);
- 管道块:Kafka(分区/Offset/消费者组)、数据同步(CDC/离线拉取)、数据质量与血缘追踪;
- 治理块:权限(Ranger/Sentry)、元数据(Atlas)、成本治理(小文件治理/存储分层);
- 闭环逻辑:数据采集 → 存储 → 计算 → 分析/服务 → 治理,任一块被追问, 都能从"它在前一条链的哪个位置、上下游是谁"答起。
1️⃣ 30 秒框架串讲
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
# 🖼️ 配图:一条数据从产生到应用的全链路(30 秒串讲图)
fig, ax = plt.subplots(figsize=(9, 2.6))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 3)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=8.8)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.8))

box(0.3, 1.2, 1.6, 1.0, '数据源\n(埋点/DB)', '#e2e8f0')
box(2.3, 1.2, 1.5, 1.0, '采集\nKafka', '#bfdbfe')
box(4.2, 1.2, 1.5, 1.0, '存储\nHDFS', '#fef9c3')
box(6.1, 1.2, 1.5, 1.0, '计算\nSpark/Flink', '#bbf7d0')
box(8.0, 1.2, 1.7, 1.0, '应用\n报表/推荐', '#fecaca')
arrow(2.0, 1.7, 2.2, 1.7); arrow(3.9, 1.7, 4.1, 1.7); arrow(5.8, 1.7, 6.0, 1.7); arrow(7.7, 1.7, 7.9, 1.7)
ax.text(5.0, 2.5, '存算分离:HDFS 存 + 计算引擎算(Spark/Flink 读 HDFS)', fontsize=9.5, ha='center', color='#334155')
plt.show()
print('➡️ 串讲顺序:产生(Kafka) → 存储(HDFS) → 计算(Spark/Flink) → 应用')
➡️ 串讲顺序:产生(Kafka) → 存储(HDFS) → 计算(Spark/Flink) → 应用
C:\Users\24260\AppData\Local\Temp\ipykernel_41348\2450897175.py:20: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
print('''一条数据从产生到应用的全链路:
  业务库/日志 -> 采集(Kafka/Flume) -> 存储(HDFS/湖) -> 离线计算(Hive/Spark)
               -> 数仓分层(ODS->DWD->DWS->ADS) -> 报表/算法特征
   另加实时链路:-> Flink 实时计算 -> 实时指标/风控
  调度(Airflow/DolphinScheduler) + 血缘 + 质量 + 权限 贯穿始终
''')
一条数据从产生到应用的全链路:
  业务库/日志 -> 采集(Kafka/Flume) -> 存储(HDFS/湖) -> 离线计算(Hive/Spark)
               -> 数仓分层(ODS->DWD->DWS->ADS) -> 报表/算法特征
   另加实时链路:-> Flink 实时计算 -> 实时指标/风控
  调度(Airflow/DolphinScheduler) + 血缘 + 质量 + 权限 贯穿始终
2️⃣ 高频题速答(一)体系与存储
print('''1) Hadoop 三件套? -> HDFS(存储)+YARN(资源)+MapReduce(计算);
2) HDFS 副本策略?  -> 3 副本:同机架 2/另一机架 1(默认策略描述);
3) 小文件问题?     -> 大量小文件=海量元数据;合并/归档/湖格式;
4) 存算分离?       -> 存储与计算独立扩缩容;云原生趋势;
5) 冷热数据?       -> 冷数据低成本存储(对象存储),热数据快;
6) 数据湖 vs 数仓? -> 湖:原始格式+ACID(Iceberg/Hudi);仓:治理后分层。
''')
1) Hadoop 三件套? -> HDFS(存储)+YARN(资源)+MapReduce(计算);
2) HDFS 副本策略?  -> 3 副本:同机架 2/另一机架 1(默认策略描述);
3) 小文件问题?     -> 大量小文件=海量元数据;合并/归档/湖格式;
4) 存算分离?       -> 存储与计算独立扩缩容;云原生趋势;
5) 冷热数据?       -> 冷数据低成本存储(对象存储),热数据快;
6) 数据湖 vs 数仓? -> 湖:原始格式+ACID(Iceberg/Hudi);仓:治理后分层。
3️⃣ 高频题速答(二)计算与实时
print('''7) Spark vs MapReduce?   -> 内存计算+DAG,快 10-100x;
8) RDD 血缘有什么用?     -> 容错重算/故障恢复;
9) 宽窄依赖?            -> 窄=流水线无 shuffle;宽=shuffle;
10) Flink watermark?     -> 处理乱序;低水位=等迟到数据;
11) 窗口类型?           -> 滚动/滑动/会话;
12) 精确一次语义?       -> 幂等+事务/两阶段提交。
''')
7) Spark vs MapReduce?   -> 内存计算+DAG,快 10-100x;
8) RDD 血缘有什么用?     -> 容错重算/故障恢复;
9) 宽窄依赖?            -> 窄=流水线无 shuffle;宽=shuffle;
10) Flink watermark?     -> 处理乱序;低水位=等迟到数据;
11) 窗口类型?           -> 滚动/滑动/会话;
12) 精确一次语义?       -> 幂等+事务/两阶段提交。
4️⃣ 高频题速答(三)数仓与管道
print('''13) 数仓四层?         -> ODS/DWD/DWS/ADS;
14) 星型 vs 雪花?      -> 冗余/查询快 vs 规范/join 多;
15) 数据倾斜怎么办?    -> 两阶段聚合/打散 key/随机前缀;
16) Kafka 为什么快?    -> 顺序写+零拷贝+批量压缩;
17) 消息积压怎么解?    -> 扩分区扩消费者/批量/降级;
18) 慢变维 SCD?        -> Type1 覆盖/Type2 版本化。
''')
13) 数仓四层?         -> ODS/DWD/DWS/ADS;
14) 星型 vs 雪花?      -> 冗余/查询快 vs 规范/join 多;
15) 数据倾斜怎么办?    -> 两阶段聚合/打散 key/随机前缀;
16) Kafka 为什么快?    -> 顺序写+零拷贝+批量压缩;
17) 消息积压怎么解?    -> 扩分区扩消费者/批量/降级;
18) 慢变维 SCD?        -> Type1 覆盖/Type2 版本化。
5️⃣ 手撕一:全局 TopN(分治思路)
# 每分区先取局部 TopN,再归并取全局 TopN
def topn_partition(nums, n):
    return sorted(nums, reverse=True)[:n]

partitions = [[5, 9, 3], [10, 2, 7], [8, 1, 6]]
k = 3
local = [topn_partition(p, k) for p in partitions]
print('各分区局部 Top3:', local)
global_top = topn_partition([x for p in local for x in p], k)
print('全局 Top3:', global_top)
assert global_top == [10, 9, 8]
print('✅ TopN 分治法正确(局部降量 -> 归并)')
各分区局部 Top3: [[9, 5, 3], [10, 7, 2], [8, 6, 1]]
全局 Top3: [10, 9, 8]
✅ TopN 分治法正确(局部降量 -> 归并)
📐 公式推导:数据倾斜与两阶段聚合(加盐)
问题:groupByKey 后某 key 的 value 数占总量的比例 $p \gg 1/R$,则该 Reduce 任务负载 $T_{\text{hot}} = p \cdot N$,成为长尾(其他任务 $\approx (1-p)N/(R{-}1)$),整体耗时被热任务决定:
$$ T_{\text{total}} \approx \max\big(pN,\; \tfrac{(1-p)N}{R-1}\big) \;\cdot\; t_{\text{unit}} $$
两阶段聚合(加盐):给 hot key 加随机前缀 $r \in \{0,\dots,S{-}1\}$ 先局部聚合,再去前缀二次聚合:
$$ \text{阶段1: } (\text{key}\|r) \xrightarrow{\text{sum}} \text{sum}_r, \qquad \text{阶段2: } \text{key} \xrightarrow{\text{sum}} \sum_{r=0}^{S-1} \text{sum}_r $$
推导要点:加盐把 hot key 的量从 $pN$ 摊到 $S$ 个子 key(每个 $\approx pN/S$),第二阶段只有 $S$ 条小数据,瓶颈消失;代价是多一次 shuffle/遍历。注意:加盐只适用于"可交换"的聚合(sum/count/max/min),不适用需要保序或去重的操作。
6️⃣ 手撕二:数据倾斜两阶段聚合
# 普通 groupBy 会 skew:某 key 集中在 1 个 task
# 两阶段:先加随机前缀局部聚合,再去前缀全局聚合
records = [('hot', 1)] * 100 + [('a', 1)] * 10 + [('b', 1)] * 5   # 'hot' 倾斜

def two_phase_agg(records, n_rand=3):
    phase1 = {}
    for k, v in records:
        p = f'{k}#{rng.integers(0, n_rand)}'
        phase1[p] = phase1.get(p, 0) + v
    phase2 = {}
    for pk, v in phase1.items():
        k = pk.split('#')[0]
        phase2[k] = phase2.get(k, 0) + v
    return phase2

res = two_phase_agg(records)
print('两阶段聚合结果:', res)
assert res['hot'] == 100 and res['a'] == 10 and res['b'] == 5
print('✅ 两阶段聚合:先按加前缀的 key 分散计算,再合并,结果一致且不再倾斜')
两阶段聚合结果: {'hot': 100, 'a': 10, 'b': 5}
✅ 两阶段聚合:先按加前缀的 key 分散计算,再合并,结果一致且不再倾斜
7️⃣ 自测清单
- 能把"一条数据从产生到应用"讲 3 分钟
- 能答 18 个高频速答题
- 能手写 TopN 分治、两阶段聚合
- 能画出数仓四层与 Kafka 架构
- 能说出 Flink watermark/窗口/精确一次
配套刷题:见 ../../21-大数据与数仓/高频面试题.md