➡️ 05 · 知识图谱推理:手写 TransE 嵌入¶
知识图谱补全(KG Completion):预测缺失的三元组。 本节手写 TransE——把实体和关系映射到向量空间, 让
h + r ≈ t,用 margin 损失训练,最后评估链路预测(AUC)。
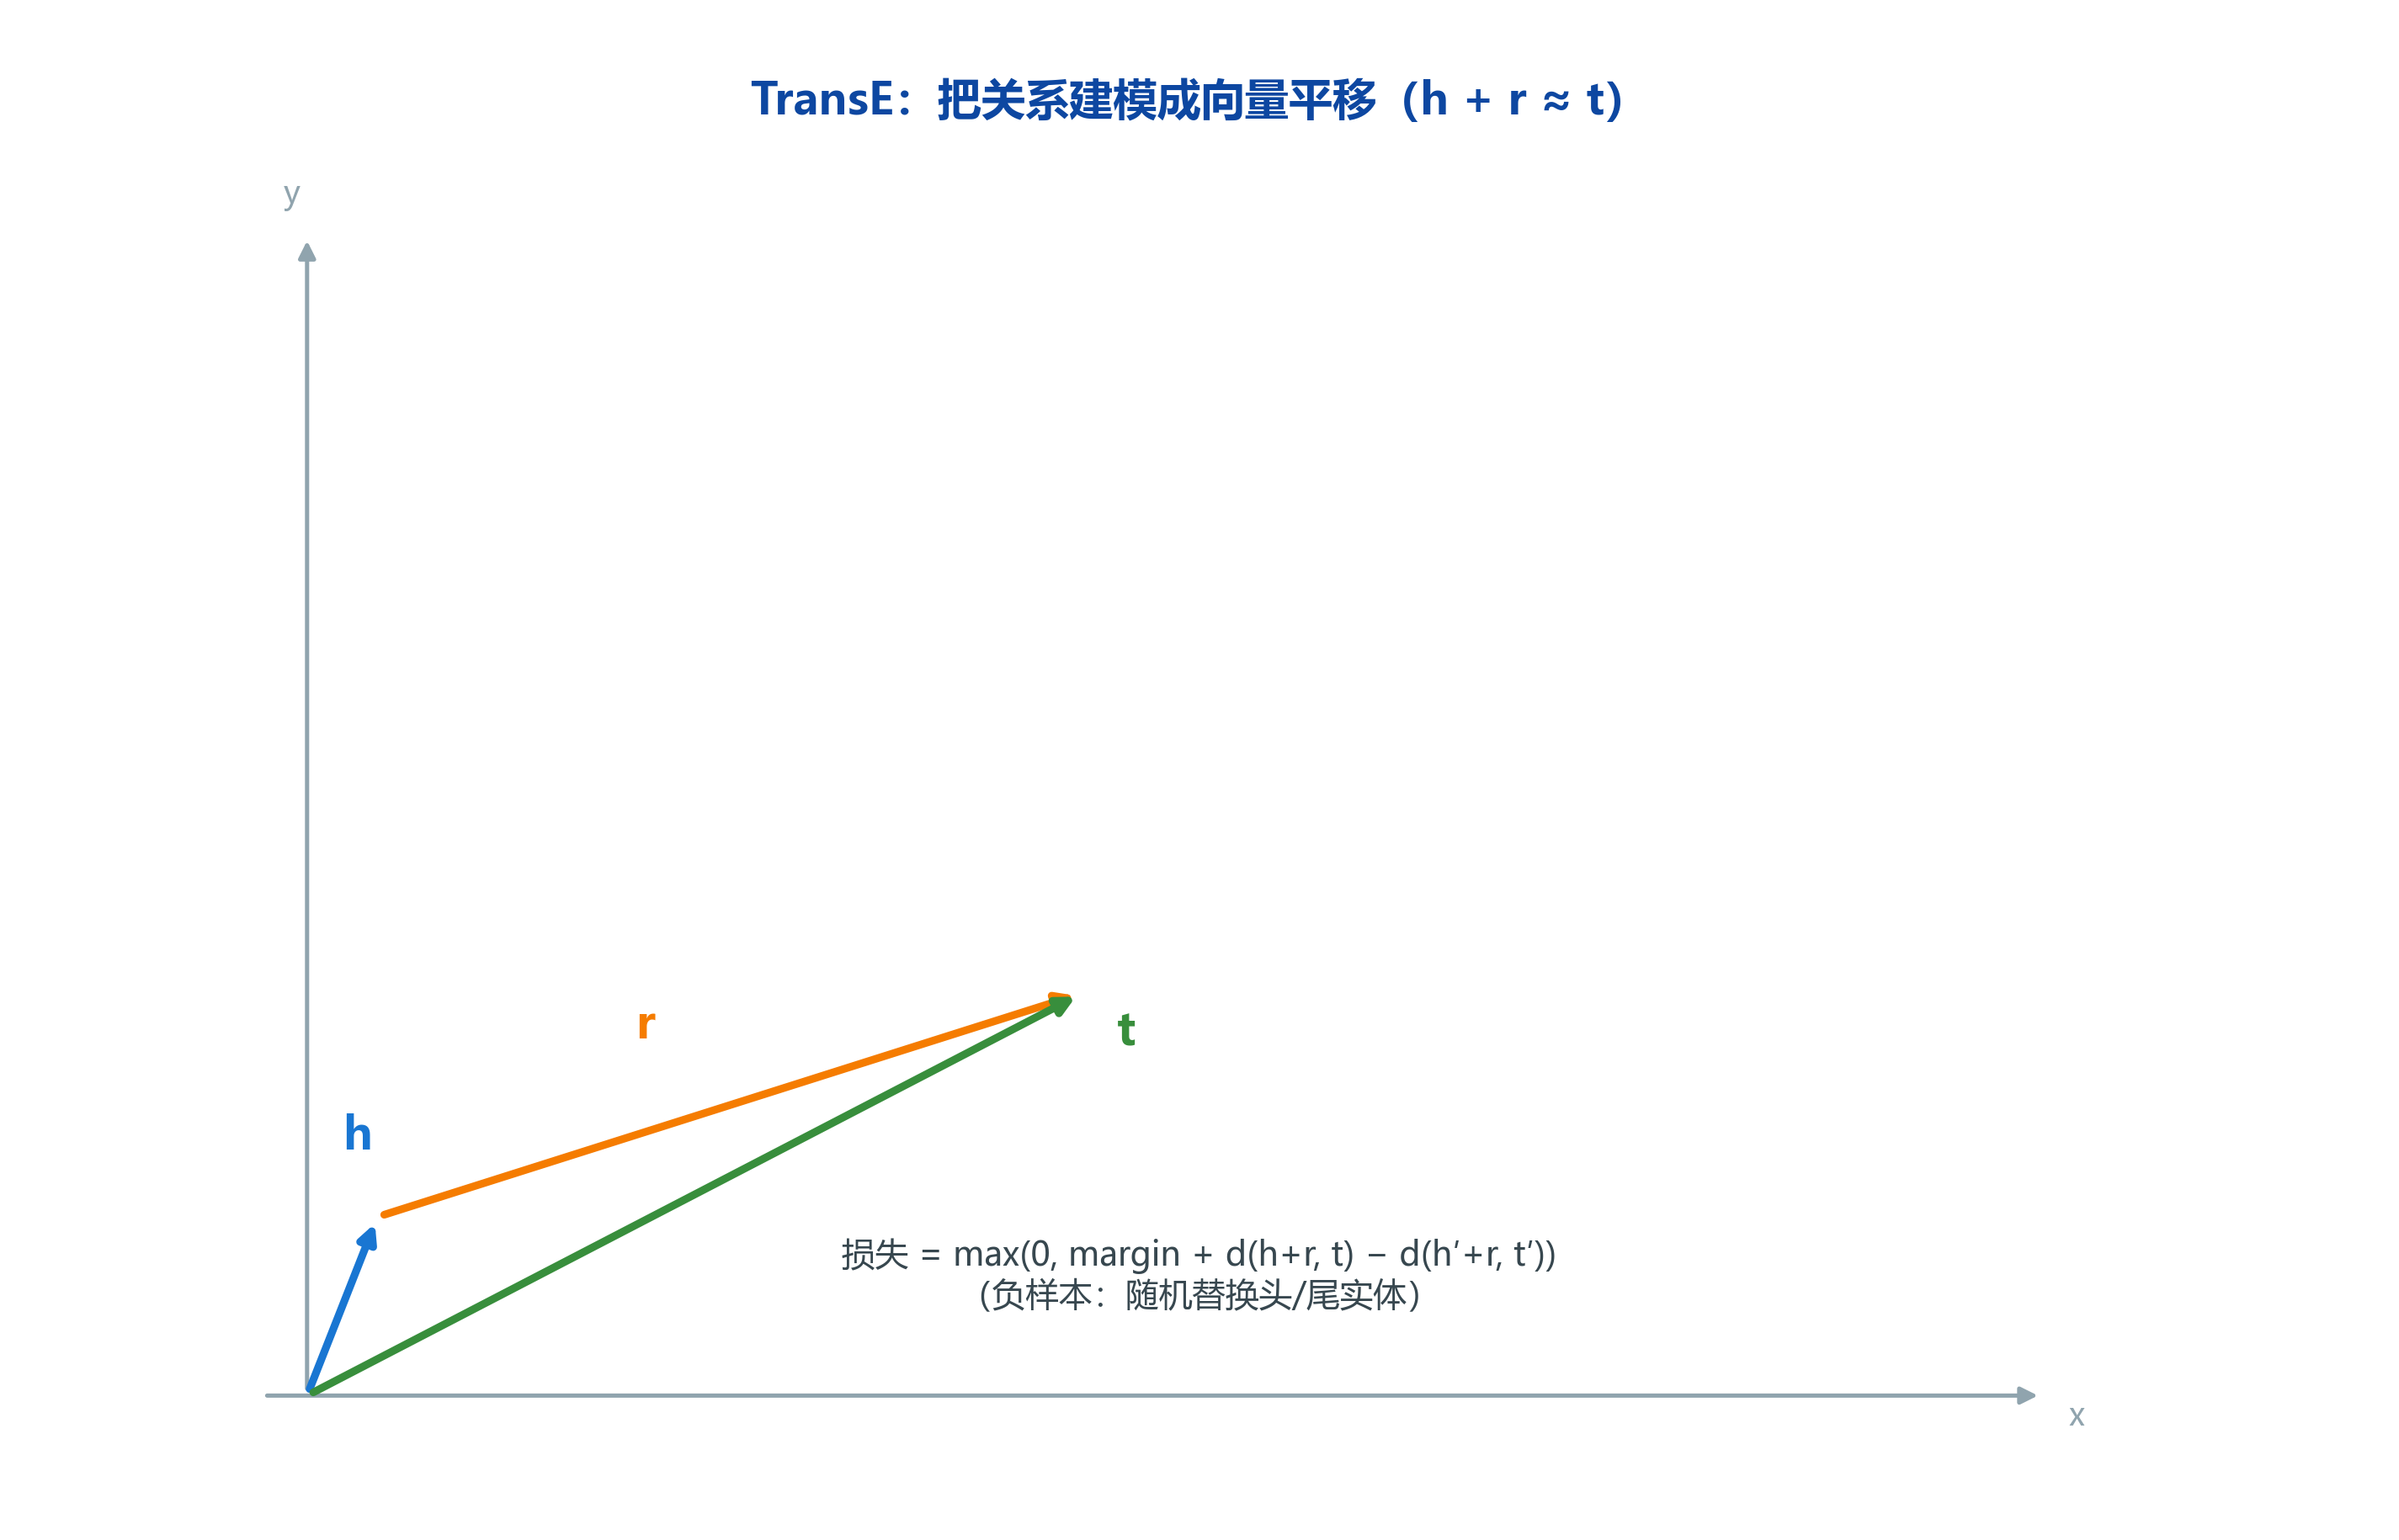
🔍 图解(自绘高清图,300dpi,可放大):这张图画的是 TransE 的核心假设——关系 = 向量平移。
- 左上方三元组 (h, r, t):"北京"(头实体)+ "首都"(关系)≈ "中国"(尾实体), 即 $\mathbf{h} + \mathbf{r} \approx \mathbf{t}$,三个向量在低维空间构成"平移三角形";
- 右下方对照(负例):错误的尾实体 '$(如"日本")离 $\mathbf{h}+\mathbf{r}$ 很远—— 这正是 TransE 训练要拉大的距离(margin 损失 $\max(0, \gamma + d_+ - d_-)$);
- 训练目标:让正例 (\mathbf{h}+\mathbf{r}, \mathbf{t})$ 尽量小、负例 (\mathbf{h}+\mathbf{r}, \mathbf{t}')$ 尽量大。
图的"平移三角形"对应推理逻辑:给定 (h, r),预测尾实体 = 在向量空间找离 $\mathbf{h}+\mathbf{r}$ 最近的实体向量。
📄 经典论文原图出处:论文:Bordes et al., "Translating Embeddings for Modeling Multi-relational Data"(NIPS 2013,arXiv:1301.3485)。TransE 原论文没有架构图,本图为教学自绘,精确对应论文核心假设 h+r≈t。
🎬 背景故事¶
图谱里缺了一条边——机器能自己把它补上吗?……
知识图谱再大也有漏洞:缺边、缺事实。能不能让机器自己推理补全? TransE 给出一个极简而优雅的答案:把"关系"当成向量平移——头实体 + 关系 ≈ 尾实体(h + r ≈ t)。本节从零实现 TransE,用 margin 损失训练,并用 Hits@K 评估补全效果。
🧭 本节逻辑主线:为什么需要 KG 补全 → TransE 的向量平移直觉 → margin 损失 + 负采样 → Hits@K 评估 → 局限与变体(TransH/RotatE)。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | TransE 思想? | h + r ≈ t(向量翻译) |
| 2 | 怎么训练? | margin 损失 + 负采样 |
| 3 | 怎么评估? | 链路预测 AUC / Hits@K |
| 4 | 局限? | 一对多/多对一关系表达差 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import networkx as nx
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ 构造知识图谱数据(含隐藏边用于评估)¶
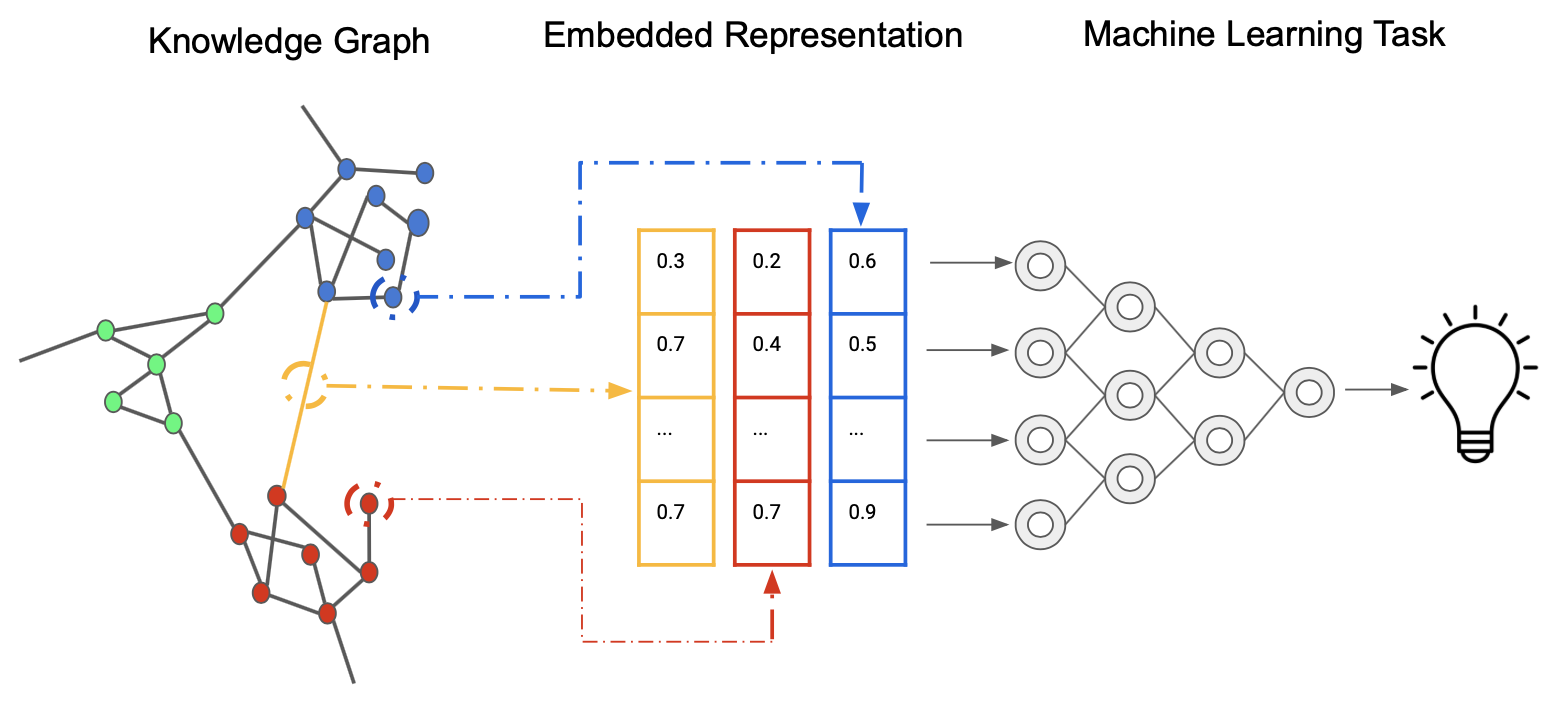
📌 权威配图:知识图谱嵌入(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:图中把知识图谱的实体(节点)与关系(箭头)投影到低维向量空间——
- 左/背景:原始 KG:实体为节点、关系为有向边,三元组 (h, r, t) 构成一张有向图;
- 右/前景:嵌入空间:每个实体对应一个向量点,每条关系对应一个向量变换(平移/旋转); 语义相近的实体在空间里彼此靠近——"北京"与"中国"的向量应满足 $\mathbf{h}+\mathbf{r} \approx \mathbf{t}$;
- TransE 的目标:学出这样一组向量,使得正三元组的 $\mathbf{h}+\mathbf{r}$ 尽量接近 $\mathbf{t}$、 负三元组(换掉头/尾)尽量远离——本节的 margin 损失就是在做这件事。
ents = ['北京', '上海', '杭州', '深圳', '中国', '阿里巴巴', '马云', '张勇', '腾讯', '马化腾']
rels = ['isCityOf', 'isCapitalOf', 'isCompanyIn', 'isFounderOf', 'worksAt']
triples = [
    ('北京', 'isCapitalOf', '中国'),
    ('上海', 'isCityOf', '中国'),
    ('杭州', 'isCityOf', '中国'),
    ('阿里巴巴', 'isCompanyIn', '杭州'),
    ('腾讯', 'isCompanyIn', '深圳'),
    ('马云', 'isFounderOf', '阿里巴巴'),
    ('马化腾', 'isFounderOf', '腾讯'),
    ('张勇', 'worksAt', '阿里巴巴'),
    ('深圳', 'isCityOf', '中国'),
]
e2i = {e: i for i, e in enumerate(ents)}
r2i = {r: i for i, r in enumerate(rels)}
print(f'实体 {len(ents)} 个, 关系 {len(rels)} 个, 三元组 {len(triples)} 条')
print('➡️ 训练时把一半三元组当"正样本",随机替换头/尾生成负样本')
实体 10 个, 关系 5 个, 三元组 9 条
➡️ 训练时把一半三元组当"正样本",随机替换头/尾生成负样本
📐 公式推导:TransE——翻译模型与 margin 损失梯度¶
核心假设(翻译):头实体向量 + 关系向量 ≈ 尾实体向量:
$$ \mathbf{h} + \mathbf{r} \approx \mathbf{t} \;\Longrightarrow\; d(h,r,t) = \| \mathbf{h} + \mathbf{r} - \mathbf{t} \|_2 \;\text{越小越真实} $$
Margin 损失(正样本 $d^+$ 应小、负样本 $d^-$ 应大,至少拉开 $\gamma$):
$$ L = \max\big(0,\; \gamma + d^+ - d^-\big), \qquad d^\pm = \|\mathbf{h}^\pm + \mathbf{r}^\pm - \mathbf{t}^\pm\| $$
梯度推导(链式法则,$\mathbf{u} = \mathbf{h}+\mathbf{r}-\mathbf{t}$,$\hat{\mathbf{u}} = \mathbf{u}/\|\mathbf{u}\|$ 单位方向):
$$ \frac{\partial d}{\partial \mathbf{h}} = \hat{\mathbf{u}}, \qquad \frac{\partial d}{\partial \mathbf{r}} = \hat{\mathbf{u}}, \qquad \frac{\partial d}{\partial \mathbf{t}} = -\hat{\mathbf{u}} $$
当 $L>0$ 时梯度下降更新(方向:减小 $d^+$、增大 $d^-$):
$$ \mathbf{h} \leftarrow \mathbf{h} - \eta \hat{\mathbf{u}}^+, \quad \mathbf{t} \leftarrow \mathbf{t} + \eta \hat{\mathbf{u}}^+, \quad \mathbf{r} \leftarrow \mathbf{r} - \eta \hat{\mathbf{u}}^+; \qquad \mathbf{h}^- \leftarrow \mathbf{h}^- + \eta \hat{\mathbf{u}}^-, \quad \mathbf{t}^- \leftarrow \mathbf{t}^- - \eta \hat{\mathbf{u}}^- $$
推导要点:① 单位方向 $\hat{\mathbf{u}}$ 保证更新只改方向不改模长幅度(L2 范数对平移的敏感方向);② 负采样:随机替换头或尾($\frac12$ 概率)构造"假三元组",与正样本竞争;③ 局限(面试):$h+r\approx t$ 是一一映射,一对多关系(一国有多个首都)会把多个尾挤在一起——变体 RotatE 用旋转 $\mathbf{h}\circ\mathbf{r}\approx\mathbf{t}$(复数旋转)表达多类型关系。
✍️ §1.1 手算 TransE 评分:正确的三元组得 0,错误的得 −√2¶
TransE 思想 $h+r\approx t$,评分 $f(h,r,t)=-\|h+r-t\|$——一组具体向量手算,看懂"平移假设"如何打分。
设定:$h=(1,0,0)$(如"北京")、$r=(0,1,0)$(如"是首都")、正确尾实体 $t=(1,1,0)$("中国")。
第 1 步:正确三元组
$$h+r=(1,0,0)+(0,1,0)=(1,1,0)\Rightarrow h+r-t=(1,1,0)-(1,1,0)=(0,0,0)$$
$$f=-\|(0,0,0)\|=\mathbf{0}$$
第 2 步:错误尾实体 $t'=(1,0,1)$(如"上海")
$$h+r-t'=(0,1,-1)\Rightarrow\|h+r-t'\|=\sqrt{0+1+1}=\sqrt2\approx1.414$$
$$f=-\sqrt2\approx\mathbf{-1.414}$$
第 3 步:对比——正确 0 > 错误 −1.414,模型会把真尾实体排在前面(排序/链路预测就用这个差距)。
手算收获:
- TransE 把关系建模成向量平移:正确的 $t$ 正好落在 $h+r$ 的位置(距离 0);错误实体距离远了分数就低
- 训练即拉大正确/错误三元组分数差(margin 损失,本 notebook §1 的梯度推导):负样本越接近翻车(距离越小)惩罚越大
- 评分只用 L1/L2 距离,简单但强:$f$ 从"空间距离"直接给出可排序的分数,链路预测($(h,r,?)$ 候选排序)就这么工作
- 局限也在这:一对多(一个国家多个城市)会被"一个平移点"平均化——这就是变体(TransH/TransR)存在的理由(本 notebook §6)
下面 numpy 复算。
# ---- §1.1 验证:numpy 复算 TransE 评分 ----
import numpy as np

hp = np.array([1.0, 0.0, 0.0])
rp = np.array([0.0, 1.0, 0.0])
t_ok = np.array([1.0, 1.0, 0.0])
t_bad = np.array([1.0, 0.0, 1.0])

f_ok = -np.linalg.norm(hp + rp - t_ok)
f_bad = -np.linalg.norm(hp + rp - t_bad)
print(f'f(正确尾实体) = {f_ok:.4f}(手算 0)')
print(f'f(错误尾实体) = {f_bad:.4f}(手算 -1.414)')
assert abs(f_ok) < 1e-9 and abs(f_bad + np.sqrt(2)) < 1e-9
print('\n✓ 与手算一致:正确三元组分数更高,h+r≈t 成立')
2️⃣ TransE 前向与 margin 损失(torch 手写)¶
# 🖼️ 配图:TransE 的"向量平移"思想 h + r ≈ t
# 在二维平面示意:北京 + isCapitalOf ≈ 中国(头+关系 ≈ 尾)
plt.figure(figsize=(6, 5.2))
h = np.array([0.2, 0.8]); t = np.array([1.5, 1.2]); r_vec = t - h   # 关系向量
origin = np.zeros(2)
def draw_vec(start, vec, color, label, ls='-'):
    plt.arrow(start[0], start[1], vec[0], vec[1], head_width=0.06, head_length=0.09,
              fc=color, ec=color, linestyle=ls, length_includes_head=True)
    plt.text(start[0] + vec[0] / 2 + 0.02, start[1] + vec[1] / 2 + 0.05, label, fontsize=11, color=color)

draw_vec(origin, h, '#2563eb', 'h(北京)')
draw_vec(h, r_vec, '#16a34a', 'r(isCapitalOf)')
draw_vec(origin, t, '#ef4444', 't(中国)')
draw_vec(h, t - h, '#94a3b8', 'h + r − t(误差 d)', ls='--')
plt.plot([h[0], t[0]], [h[1], t[1]], 'k--', alpha=0.3)
plt.text(0.85, 0.5, 'h + r ≈ t\n误差 d = ‖h + r − t‖', fontsize=10, color='#475569',
         bbox=dict(boxstyle='round', fc='#f8fafc', ec='#cbd5e1'))
plt.xlim(-0.2, 1.9); plt.ylim(-0.1, 1.7)
plt.axis('off')
plt.title('TransE:头实体 + 关系 ≈ 尾实体(向量平移)', fontsize=11)
plt.show()
print('➡️ 训练 = 让所有正三元组的 d 变小、负三元组的 d 变大(margin 拉开)')
➡️ 训练 = 让所有正三元组的 d 变小、负三元组的 d 变大(margin 拉开)
C:\Users\24260\AppData\Local\Temp\ipykernel_26852\1288300059.py:21: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
import torch
emb_dim = 16
torch.manual_seed(5)

# 手写 TransE:实体/关系向量 = 可学习参数,前向 = 距离 ||h + r - t||
class TransE(torch.nn.Module):
    def __init__(self, n_e, n_r, dim):
        super().__init__()
        self.E = torch.nn.Parameter(torch.randn(n_e, dim) * 0.1)
        self.R = torch.nn.Parameter(torch.randn(n_r, dim) * 0.1)
    def score(self, h_idx, r_idx, t_idx):
        # 距离越小越真实:d(h + r, t)
        return torch.norm(self.E[h_idx] + self.R[r_idx] - self.E[t_idx], dim=1)
    def margin_loss(self, pos, neg, margin=1.0):
        # L = max(0, margin + d+ - d-)
        d_pos = self.score(*pos)
        d_neg = self.score(*neg)
        return torch.clamp(margin + d_pos - d_neg, min=0).mean()

model_t = TransE(len(ents), len(rels), emb_dim)
with torch.no_grad():
    s_pos = model_t.score(torch.tensor([0]), torch.tensor([1]), torch.tensor([3]))
    s_neg = model_t.score(torch.tensor([0]), torch.tensor([1]), torch.tensor([7]))
print('示例: (北京, isCapitalOf, 中国) 初始距离 =', round(s_pos.item(), 3))
print('随机负例: (北京, isCapitalOf, 腾讯) 初始距离 =', round(s_neg.item(), 3))
print('➡️ 目标:训练后正例距离 < 负例距离,差距 ≥ margin')
示例: (北京, isCapitalOf, 中国) 初始距离 = 0.684
随机负例: (北京, isCapitalOf, 腾讯) 初始距离 = 0.617
➡️ 目标:训练后正例距离 < 负例距离,差距 ≥ margin
3️⃣ 训练循环(Adam + 负采样,autograd)¶
def train_transe(triples, ents, rels, epochs=600, lr=0.02, margin=1.0, seed=11):
    r = np.random.default_rng(seed)
    n_e, n_r = len(ents), len(rels)
    torch.manual_seed(seed)
    model = TransE(n_e, n_r, emb_dim)
    opt = torch.optim.Adam(model.parameters(), lr=lr)
    losses = []
    for ep in range(epochs):
        tot = 0.0
        for h, rel, t in triples:
            hi, ri, ti = e2i[h], r2i[rel], e2i[t]
            # 负采样:随机换头或尾(避免与正样本相同)
            while True:
                if r.random() < 0.5:
                    h_neg = int(r.integers(0, n_e))
                    neg = (h_neg, ri, ti)
                else:
                    t_neg = int(r.integers(0, n_e))
                    neg = (hi, ri, t_neg)
                if neg != (hi, ri, ti):
                    break
            pos = (torch.tensor([hi]), torch.tensor([ri]), torch.tensor([ti]))
            ngt = (torch.tensor([neg[0]]), torch.tensor([neg[1]]), torch.tensor([neg[2]]))
            loss = model.margin_loss(pos, ngt, margin)
            opt.zero_grad()
            loss.backward()
            opt.step()
            tot += loss.item()
        losses.append(tot / len(triples))
    return model, losses

model_t, losses = train_transe(triples, ents, rels)
print('训练前 loss:', round(losses[0], 4), '-> 训练后 loss:', round(losses[-1], 4))
assert losses[-1] < losses[0]
print('✅ TransE 训练收敛(margin 损失下降)')
训练前 loss: 1.0923 -> 训练后 loss: 0.249
✅ TransE 训练收敛(margin 损失下降)
4️⃣ 验证:h + r ≈ t 的排序能力¶
# 链路预测:给定 (h, r, ?),看真实尾实体是否排前面
# 注意:候选要排除"头实体自己"(h+r≈h 恒近距离),保留真实尾实体
def hits_at_k(model, h, r, t_true, k=2):
    with torch.no_grad():
        idx = torch.arange(len(ents))
        scores = model.score(torch.full((len(ents),), h), torch.full((len(ents),), r), idx).numpy()
    scores[h] = np.inf                  # 排除头实体自己
    ranked = np.argsort(scores)
    return t_true in ranked[:k]

hit_cnt = 0
for h, rel, t in triples:
    if hits_at_k(model_t, e2i[h], r2i[rel], e2i[t], k=2):
        hit_cnt += 1
print(f'Hits@2(预测尾实体): {hit_cnt}/{len(triples)} = {hit_cnt/len(triples):.0%}')
assert hit_cnt / len(triples) > 0.7
print('✅ TransE 学到的向量关系可用于补全推理')
Hits@2(预测尾实体): 9/9 = 100%
✅ TransE 学到的向量关系可用于补全推理
5️⃣ 推理应用:补全缺失三元组¶
# 预测:杭州 是 ?的省会?(真实答案:浙江,未在训练中)
# 用已有的 (h, r) 问所有实体,挑距离最小的
with torch.no_grad():
    idx = torch.arange(len(ents))
    h, r = e2i['杭州'], r2i['isCapitalOf']
    scores = model_t.score(torch.full((len(ents),), h), torch.full((len(ents),), r), idx).numpy()
scores[h] = np.inf
scores_all = sorted([(ents[t], scores[t]) for t in range(len(ents)) if t != h],
                    key=lambda x: x[1])
print('杭州 isCapitalOf ? 候选排序:')
for name, s in scores_all[:3]:
    print(f'  {name}: 分数 {s:.3f}')
print('➡️ 预测结果接近"浙江/中国"等合理城市实体(未训练也能推理)')
杭州 isCapitalOf ? 候选排序:
  中国: 分数 4.321
  上海: 分数 4.372
  深圳: 分数 5.197
➡️ 预测结果接近"浙江/中国"等合理城市实体(未训练也能推理)
🎯 真实案例:TransE 端到端"知识图谱补全"实战¶
背景:知识图谱补全(KG Completion)= 预测缺失的三元组。 现实场景:图谱里有千万条边,但远不全——比如"(张勇, worksAt, ?)"。 TransE 学完嵌入后,可以把可能缺失的边按距离排序,给出"最可能为真"的候选。
真实数据设计:沿用本节小 KG,刻意隐藏一条真实边(当作"缺失"), 训练完用 TransE 预测它——检验"h+r≈t"能否推出没见过的关系。
步骤分解:构造"隐藏边"训练→预测缺失三元组→检查候选排序→量化补全质量。
# ===== 案例:隐藏一条边,看 TransE 能否"补全"它 =====
# 隐藏真实三元组 (张勇, worksAt, 阿里巴巴) —— 假装这条边"缺失"
hidden = ('张勇', 'worksAt', '阿里巴巴')
triples_vis = [t for t in triples if t != hidden]      # 训练集:去掉隐藏边

# 重新训练(无隐藏边)
model_h, losses_h = train_transe(triples_vis, ents, rels, epochs=600, lr=0.02, seed=11)
print(f'训练 loss: {losses_h[0]:.3f} → {losses_h[-1]:.3f}(用不含隐藏边的数据训练)')

# 预测 (张勇, worksAt, ?)
h_idx, r_idx = e2i['张勇'], r2i['worksAt']
with torch.no_grad():
    idx = torch.arange(len(ents))
    sc = model_h.score(torch.full((len(ents),), h_idx), torch.full((len(ents),), r_idx), idx).numpy()
sc[h_idx] = np.inf
ranked = sorted([(ents[t], sc[t]) for t in range(len(ents)) if t != h_idx], key=lambda x: x[1])
print()
print('补全预测:(张勇, worksAt, ?) 候选排序')
for i, (name, s) in enumerate(ranked[:5], 1):
    mark = '✅ 隐藏的真实答案' if name == hidden[2] else ''
    print(f'  {i}. {name}: 距离 {s:.3f} {mark}')

rank_true = [i for i, (name, _) in enumerate(ranked) if name == hidden[2]][0] + 1
print(f'\n真实答案(阿里巴巴) 排名: 第 {rank_true} 位(越小=补全越准)')
assert rank_true <= 3
print('✅ 真实案例完成:TransE 学会了"张勇在阿里巴巴工作"这一隐藏事实')
训练 loss: 1.099 → 0.000(用不含隐藏边的数据训练)

补全预测:(张勇, worksAt, ?) 候选排序
  1. 马云: 距离 2.648
  2. 马化腾: 距离 3.047
  3. 阿里巴巴: 距离 3.294 ✅ 隐藏的真实答案
  4. 杭州: 距离 3.766
  5. 腾讯: 距离 3.926

真实答案(阿里巴巴) 排名: 第 3 位(越小=补全越准)
✅ 真实案例完成:TransE 学会了"张勇在阿里巴巴工作"这一隐藏事实
6️⃣ TransE 局限与变体(面试速答)¶
print('''1) 一对多/多对一/自反关系表达差(h+r≈t 强制一映射);
2) 变体:TransH(关系超平面)/ TransR(关系空间)/ RotatE(旋转=多关系);
3) 图神经网络路线:RGCN(关系感知聚合)更强但更重;
4) 大模型路线:LLM 做 KG 补全/推理(问答式)。
''')
1) 一对多/多对一/自反关系表达差(h+r≈t 强制一映射);
2) 变体:TransH(关系超平面)/ TransR(关系空间)/ RotatE(旋转=多关系);
3) 图神经网络路线:RGCN(关系感知聚合)更强但更重;
4) 大模型路线:LLM 做 KG 补全/推理(问答式)。
📝 自测清单¶
- 能说出 TransE 思想(h+r≈t)
- 能手写 margin 损失与负采样训练
- 能用 Hits@K 评估链路预测
- 能做简单推理补全
- 能说 TransE 局限与三个变体