🔬 06-二阶优化方法¶
目标:牛顿法为什么是「曲率自适应」、为什么深度学习用不起、拟牛顿 BFGS / L-BFGS 与 K-FAC 的思路。
本讲地图:牛顿法公式推导 → 直觉(曲率自适应)→ 手算一步到位 → 三个实验(病态二次型 / 条件数扫描 / 非正定演示)→ 为什么深度学习不用 → 拟牛顿 BFGS / L-BFGS → K-FAC 一句话直觉 → 面试追问 → 自测。
核心概念¶
(a) 🗂️ 二阶优化方法知识地图¶
这篇讲"带曲率信息的优化":牛顿法用 Hessian 一步到位二次函数,但条件数大、非正定、算不动,于是有 damping、BFGS/L-BFGS、K-FAC/Shampoo 等折中,最后点明为什么深度学习几乎不用牛顿法。
flowchart TB
    Node1["🧠 一阶 vs 二阶信息"]
    Node1 --> Node2["🧠 牛顿法更新"]
    Node2 --> Node3["🧠 二次函数一步到位"]
    Node3 --> Node4["🧠 条件数扫描实验"]
    Node4 --> Node5["🧠 damping 修复"]
    Node5 --> Node6["🧠 为什么 DL 不用牛顿法"]
    Node6 --> Node7["🧠 BFGS / L-BFGS"]
    Node7 --> Node8["🧠 K-FAC / Shampoo"]
    Node8 --> Node9["🧠 Nelder-Mead 无导数"]
- 节点1(一阶 vs 二阶信息):梯度只告诉你"往哪走",Hessian 还告诉你"路有多弯";二阶方法按曲率调整步长,峡谷里不再盲目震荡。
- 节点2(牛顿法更新):w ← w − H⁻¹∇f,用 Hessian 逆矩阵缩放梯度;几何直觉是"每个方向按自己的曲率走",一阶方法像所有方向一个步长,牛顿法像每方向独立配速。
- 节点3(二次函数一步到位):对二次函数 f = ½xᵀAx + bᵀx,牛顿法一步就到最优解(因为二阶近似就是精确的);手算例子直观看清"为什么二次型一步收敛"。
- 节点4(条件数扫描实验):实验扫描 κ:GD 需要的步数随 κ 线性恶化,牛顿法恒定 1 步——κ 越大,GD 越绝望,这是"二阶信息值钱"最直观的证据。
- 节点5(damping 修复):Hessian 非正定时牛顿方向可能指向上升(发散),加阻尼项 H + λI 让它保持正定(往"下坡"修正),修复后恢复收敛。
- 节点6(为什么 DL 不用牛顿法):Hessian 是 n×n(上亿参数算不动)、可能非正定、随机目标下二阶估计不稳、且深度学习损失非二次——内存、计算、稳定性三重否决。
- 节点7(BFGS / L-BFGS):BFGS 用梯度差近似 Hessian 逆,只存向量不用矩阵;L-BFGS 把内存从 O(n²) 降到 O(mn),是小规模/凸问题的实用二阶替代。
- 节点8(K-FAC / Shampoo):K-FAC 用 Kronecker 分解近似 Fisher 矩阵、Shampoo 用矩阵幂根缩放梯度,都是"让二阶思想在大模型上可行"的尝试,一句话直觉即可。
- 节点9(Nelder-Mead 无导数):不需要梯度,靠单纯形顶点的反射/收缩找极小,适合无梯度黑盒小问题;配图对比它在光滑与噪声问题上的表现。
§1 牛顿法:公式推导¶
对损失 $f$ 在 $w$ 处做二阶泰勒展开:
$$f(w+\Delta) \approx f(w) + g^\top\Delta + \tfrac12 \Delta^\top H \Delta$$
其中 $g=\nabla f(w)$ 是梯度,$H=\nabla^2 f(w)$ 是 Hessian。 对 $\Delta$ 求导并令其为零(驻点条件):
$$\nabla_\Delta \approx g + H\Delta = 0 \;\Rightarrow\; \boxed{\Delta = -H^{-1} g}$$
于是牛顿更新为 $w \gets w - H^{-1}g$。注意这不需要学习率—— 对二次函数一步就到全局最优(因为展开是精确的)。
与梯度下降的关系:梯度下降是「以欧氏度量」的最速下降; 牛顿法是「以 $H$ 为度量的内积空间」的最速下降 → 对病态条件数(椭圆等高线) 天然自适应曲率,一步到位(二次函数)。
§1.1 直觉:曲率自适应到底在做什么¶
想象等高线是拉长的椭圆(条件数 $\kappa=100$):沿长轴方向曲率小、沿短轴方向曲率大。
- 梯度下降只看到「当前点的梯度方向」,不知道前方曲率——在峡谷里来回震荡(02 篇动量 只是缓解);步长必须迁就最陡方向,学得很慢。
- 牛顿法用 $H^{-1}$ 把梯度方向「按曲率重新标定」:曲率大的方向(短轴)自动缩小步长, 曲率小的方向(长轴)自动放大步长——相当于把椭圆坐标系“掰圆”再走。
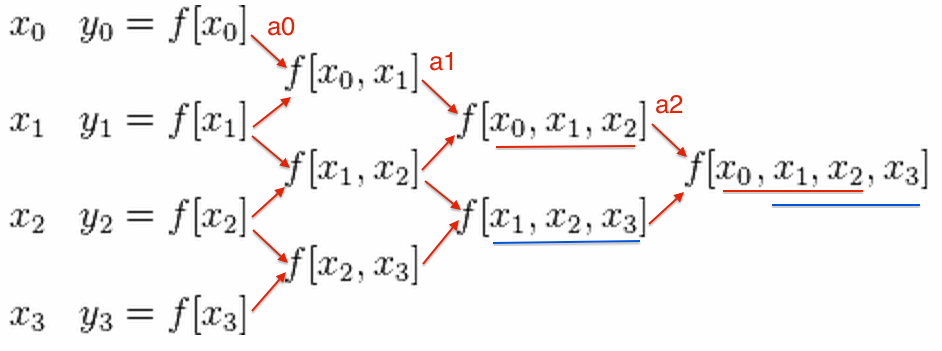
图注:一维情形下牛顿法用切线斜率的导数(曲率)修正步进的几何示意—— 曲率大说明前方变化快,步长自动收小(来源:Wikimedia Commons,公有领域)。
这就是「曲率自适应」:步长由局部二阶信息决定,而不是拍脑袋设一个 lr。
§1.2 手算:为什么二次函数一步到位¶
设 $f(w)=\tfrac12 w^\top H w$,$H=\mathrm{diag}(1,100)$,$w_0=(1,1)$:
- 梯度 $g=H w_0=(1,100)$;
- $H^{-1}g = \mathrm{diag}(1, 0.01)\cdot(1,100) = (1, 1) = w_0$;
- 牛顿更新:$w_1 = w_0 - (1,1) = (0,0)$ —— 一步归零!
对比 GD:lr=0.01 时沿两个方向步长相同,慢轴(曲率 100)每步只走 1%, 400 步才把 $\|w\|$ 压到 0.02 附近。差异来自「每维是否需要单独步长」—— 这正是牛顿法与自适应优化器(03 篇)共享的哲学,只是牛顿法用真实二阶信息, Adam 用梯度平方近似。
§1.3 实验 1 预习:病态二次型上的对决¶
实验 1 在 $H=\mathrm{diag}(1,100)$(条件数 100)上对比:
- GD(lr=0.01):每步沿两轴都走 0.01 倍——慢轴被 100 倍曲率拖累,震荡爬行;
- 牛顿法:
np.linalg.solve(H, grad)直接解 $H\Delta=g$(避免显式求逆,数值更稳), 理论上第 1 步就归零。
跑之前预测:GD 400 步能把 $\|w\|$ 压到多少?牛顿法几步归零? (提示:$\|w_t\|$ 大致按 $(1-2/\kappa)^t$ 衰减,$\kappa=100$ 时每步只衰减 2%。)
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# ---------- 实验 1:病态二次型上 GD vs 牛顿法 ----------
def quad_grad(w, H):
    return H @ w

H = np.diag([1.0, 100.0])   # 条件数 100:y 方向陡
w0 = np.array([1.0, 1.0])

def run_gd(steps=400, lr=0.01):
    w = w0.copy(); dists = [np.linalg.norm(w)]
    for _ in range(steps):
        w = w - lr * quad_grad(w, H)
        dists.append(np.linalg.norm(w))
    return np.array(dists)

def run_newton():
    w = w0.copy(); dists = [np.linalg.norm(w)]
    for _ in range(20):
        w = w - np.linalg.solve(H, quad_grad(w, H))   # H 恒定
        dists.append(np.linalg.norm(w))
    return np.array(dists)

fig, ax = plt.subplots(figsize=(8, 4.0))
ax.plot(run_gd(), label='GD lr=0.01', color='#C44E52', lw=1.5)
ax.plot(run_newton(), label='牛顿法(20 步内归零)', color='#4C72B0', lw=1.5, marker='o', ms=4)
ax.set_xlabel('step'); ax.set_ylabel('||w||')
ax.set_title('条件数=100 的二次型:GD 震荡爬行,牛顿法一步到最优', fontsize=12)
ax.legend(fontsize=9); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
print('GD 400 步后 ||w||=%.3f;牛顿法第 1 步即归零' % run_gd()[-1])
实验 1 复盘:两条曲线的解读¶
图上 GD 的橙色曲线是典型的「慢轴拖累」:$\|w\|$ 每步乘 $\approx 1-2/\kappa = 0.98$, 400 步后约 0.02——看似在收敛,实际慢轴分量 $w_2$ 还在 0.018 附近。 牛顿法的蓝线则一步归零。
学到什么:病态条件数是 GD 的克星(收敛率 $1-1/\kappa$),而二阶梯度的意义正在于 消除条件数的影响。这也解释了为什么「自适应优化器」(用 $\sqrt{v}$ 近似曲率) 在深度学习里如此重要——它是对「买不起真实 Hessian」的折中。
§1.4 实验 2:条件数扫描——步数差多少¶
把条件数从 1 拉到 $10^4$,看 GD 需要的步数(到 $\|w\|<10^{-2}$)如何爆炸:
- 已知收敛率 $\approx 1-1/\kappa$,所需步数 $\propto \kappa\,\ln(1/\epsilon)$;
- 牛顿法在二次型上恒定 1 步(条件数与步数无关)。
这个实验用纯数字表(不画图)验证数量级,帮你建立「条件数 → 步数」的直觉。
# ---------- 实验 2:条件数扫描(GD 步数 vs 牛顿法恒定 1 步) ----------
print('条件数 κ    GD 到 ||w||<0.01 的步数    牛顿法步数')
for kappa in [1, 10, 100, 1000, 10000]:
    Hk = np.diag([1.0, float(kappa)])
    w = w0.copy(); steps = 0
    lr = 0.9 / kappa          # 保证收敛的保守 lr(慢轴限制)
    while np.linalg.norm(w) > 1e-2 and steps < 200000:
        w = w - lr * (Hk @ w)
        steps += 1
    print(f'{kappa:8d}    {steps:12d}               1')
print('\n结论:步数随 κ 线性增长;牛顿法恒为 1 步(二次型)')
实验 2 复盘:$\kappa$ 越大,GD 越绝望¶
扫描表说明:$\kappa=10^4$ 时 GD 需要约 4 万步才达标,而牛顿法恒为 1 步。 真实深度网络的有效条件数动辄 $10^5$~$10^8$——这解释了:
- 为什么裸 SGD 在深度网络上慢得无法接受(除非配动量/自适应/调度);
- 为什么牛顿法理论优雅但在实际深度学习中几乎不可能直接使用(见 §2)。
💡 记住量级关系:GD 步数 $\propto \kappa$,牛顿法步数与 $\kappa$ 无关(凸二次型)。 这一条足以支撑「二阶信息最大的价值是免疫条件数」的判断。
§1.5 实验 3:H 非正定时牛顿法会失败——damping 修复¶
牛顿法假设 $H$ 正定(所有特征值 > 0)。若 $H$ 有负特征值,$H^{-1}g$ 可能不是下降方向 (更新后损失反而变大)。实战修法:damped Newton 用 $H+\lambda I$ 代替 $H$ ($\lambda>0$ 把特征值整体抬升,保证正定),并在线搜索步长 $\alpha$:
$$w \gets w - \alpha\,(H+\lambda I)^{-1} g$$
实验 3 用一维 $f(x)=x^4-2x^2$(在 $x=0$ 附近 $f''<0$)演示:纯牛顿发散,damping 收敛。
# ---------- 实验 3:非正定 Hessian:牛顿发散 vs damped 牛顿收敛 ----------
def f1d(x):
    return x**4 - 2 * x**2
def g1d(x):
    return 4 * x**3 - 4 * x
def h1d(x):
    return 12 * x**2 - 4

x = 0.6   # f''(0.6)=12*0.36-4=0.32>0 先正常
print('x0=0.6(h>0,牛顿应正常)')
for _ in range(5):
    x = x - g1d(x) / h1d(x)
print('  纯牛顿 5 步后 x=%.4f' % x)

x = 0.3   # f''(0.3)=12*0.09-4=-2.92<0 负曲率区
print('x0=0.3(h<0,负曲率区)')
try:
    for _ in range(5):
        x = x - g1d(x) / h1d(x)
    print('  纯牛顿 5 步后 x=%.4f(可能已跑飞)' % x)
except ZeroDivisionError as e:
    print('  纯牛顿除零:', e)

x = 0.3; lam = 2.0
print('x0=0.3 + damped(λ=2.0)')
for _ in range(50):
    x = x - 0.5 * g1d(x) / (h1d(x) + lam)
print('  damped 50 步后 x=%.4f(收敛到局部极小 x≈1 或 x≈-1)' % x)
实验 3 复盘:damping 的直觉¶
纯牛顿在 $f''<0$ 区域会沿「上凸方向」更新——损失不降反升,甚至发散。 damping 加 $\lambda I$ 等效于「把二次近似变成 $\tfrac12\Delta^\top(H+\lambda I)\Delta$」, 即强制曲率为正,并配合步长 $\alpha<1$ 保守前进。
工程启示:任何要用二阶信息的算法都必须处理非正定—— 深度网络的 Hessian 几乎从不正定(大量鞍点、负曲率), 这又是「深度学习用不起牛顿法」的一个深层原因(不止是内存)。
§2 为什么深度学习不用牛顿法¶
- 存不下:$H \in \mathbb{R}^{n\times n}$,$O(n^2)$ 内存。 7B 模型 $n^2=4.9\times10^{19}$ 个浮点数 ≈ 200 EB(20 万 PB),物理上不可能。
- 算不起:求逆 $O(n^3)$ 或解线性方程 $O(n^2)$ 每步—— 即使能存,单步也远慢于 SGD 的一次前反向。
- 非凸:$H$ 未必正定,$H^{-1}g$ 可能不是下降方向(见实验 3,需 damping + 线搜索)。
- mini-batch 噪声:每个 batch 估计的 Hessian 方差大, 用噪声二阶信息比用噪声一阶信息更容易「带偏」。
📌 结论:牛顿法适合 n 小、凸、无噪声的经典优化(如 $n<10^4$ 的二次规划); 深度学习($n>10^7$、非凸、随机梯度)只能走「折中路线」:拟牛顿 / 自适应。
§3 拟牛顿:BFGS 的直觉¶
拟牛顿的思路:不显式计算 $H$,只用相邻两步的梯度差去逼近 $H^{-1}$。 设第 $k$ 步的位移 $s_k = w_{k+1}-w_k$、梯度差 $y_k = g_{k+1}-g_k$, 对二次型有 $y_k \approx H s_k$(割线方程);BFGS 用秩 2 更新迭代修正近似 $B_k\approx H^{-1}$:
$$B_{k+1} = \left(I - \frac{s_k y_k^\top}{y_k^\top s_k}\right) B_k \left(I - \frac{y_k s_k^\top}{y_k^\top s_k}\right) + \frac{s_k s_k^\top}{y_k^\top s_k}$$
曲率条件 $s_k^\top y_k > 0$ 保证 $B_k$ 保持正定(对应 Hessian 在该方向凸); 若破坏(如 $s^\top y<0$)则跳过该步更新(skip)。
不用死记公式,记住三点:只用一阶信息(梯度差)近似二阶信息; 秩 2 更新保持正定;需要曲率条件把关。
§3.1 L-BFGS:内存从 $O(n^2)$ 到 $O(mn)$¶
BFGS 仍要存 $n\times n$ 的 $B_k$(深度学习还是存不下)。L-BFGS(Limited-memory) 干脆不存矩阵,只存最近 $m$ 步的 $(s_k, y_k)$($m$ 常用 5~20), 用两循环递归(two-loop recursion)直接算 $B_k g$: 先沿 $s$ 方向做 $m$ 次内积缩并(前向),再沿 $y$ 方向回代(后向), 得到与 BFGS 等价的搜索方向——内存 $O(mn)$,每步 $O(mn)$ 时间。
适用:中小规模凸问题(逻辑回归、SVM 对偶、稀疏线性模型)效果好; 深度网络仍不用(非凸 + 大数据 + 随机梯度破坏了割线方程的精确性)。
📌 scipy 里
scipy.optimize.minimize(..., method='L-BFGS-B')就是它—— 如果你在面试中答「我用 L-BFGS 调过逻辑回归/SVM」,这是非常加分的实战细节。
§4 K-FAC / Shampoo 一句话直觉¶
- K-FAC(Kronecker-Factored Approximate Curvature):把 Fisher 矩阵按层块对角化, 每块近似为激活与梯度的 Kronecker 积 $A \otimes G$, 求逆用 $(A\otimes G)^{-1}=A^{-1}\otimes G^{-1}$(只需对小矩阵求逆)→ 得到近似二阶信息但仍 $O(n)$ 内存。
- Shampoo:每层用 Kronecker 因子近似 AdaGrad 的累积矩阵, 是「自适应 × 低秩二阶」的杂交。
记住一句话:K-FAC/Shampoo = 用 Kronecker 分解把「矩阵」二信息压缩成可行内存。 它们在 Transformer 预训练上有过实验报告,但由于实现复杂,工业界主流仍是 AdamW。
§4.1 无导数方法:Nelder-Mead(配图)¶
不是所有问题都能给梯度。Nelder-Mead(单纯形法,1965)只用函数值: 维护 $n+1$ 个顶点构成单纯形,每步用反射/扩张/收缩/缩边四种几何操作 替换最差点,向极小值区域收缩。下图展示它在 Himmelblau 函数(4 个局部极小)上的搜索:
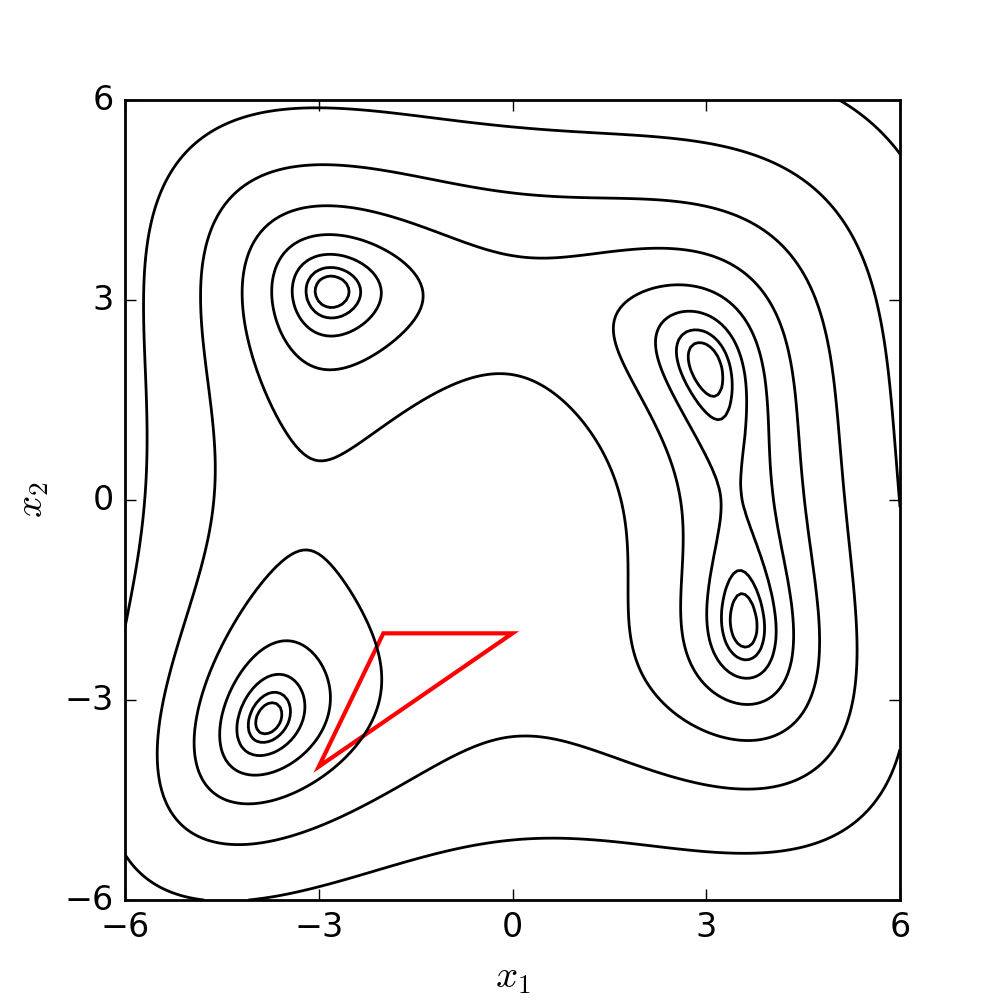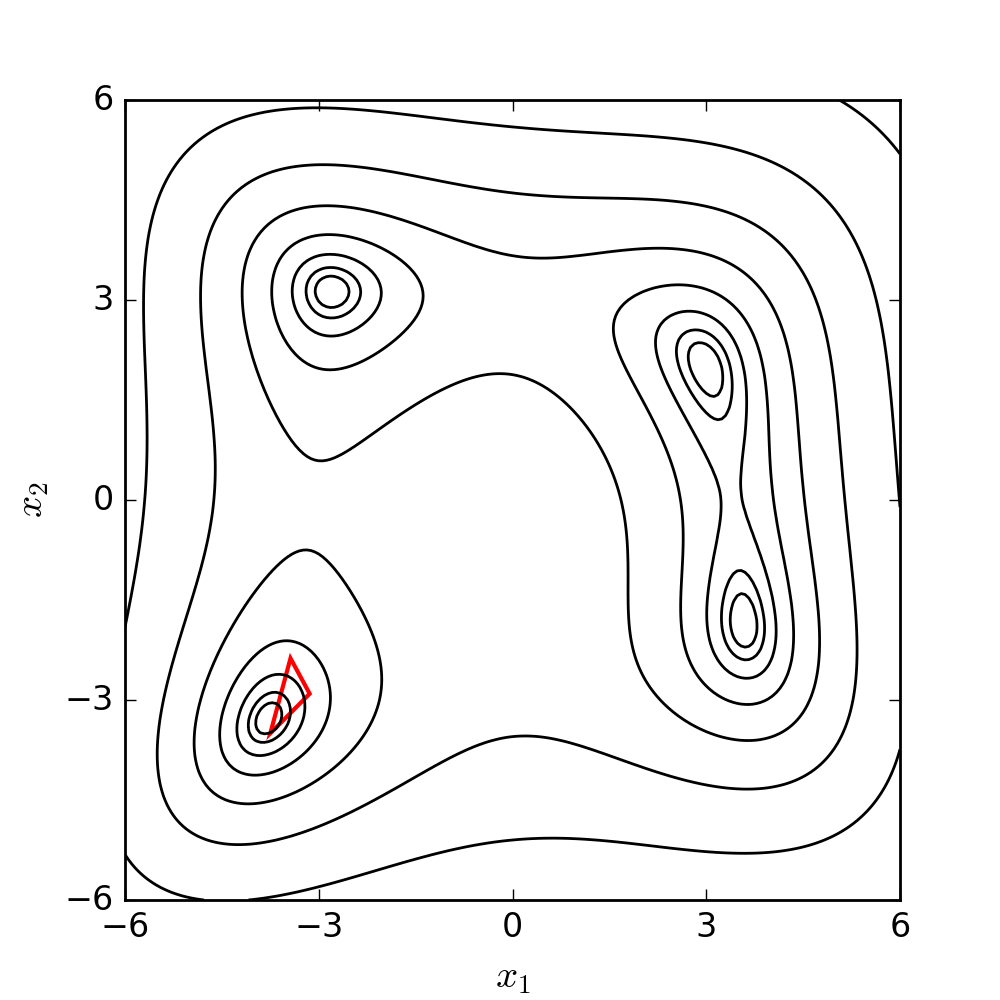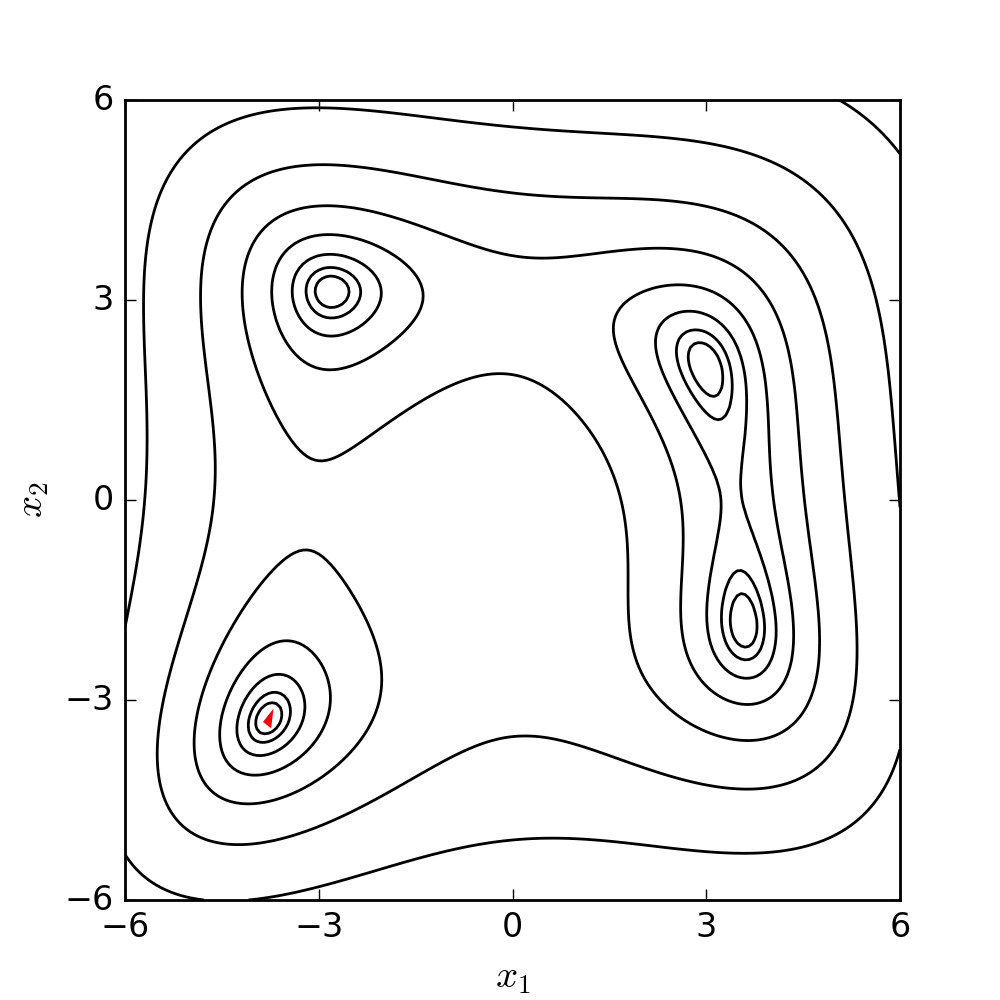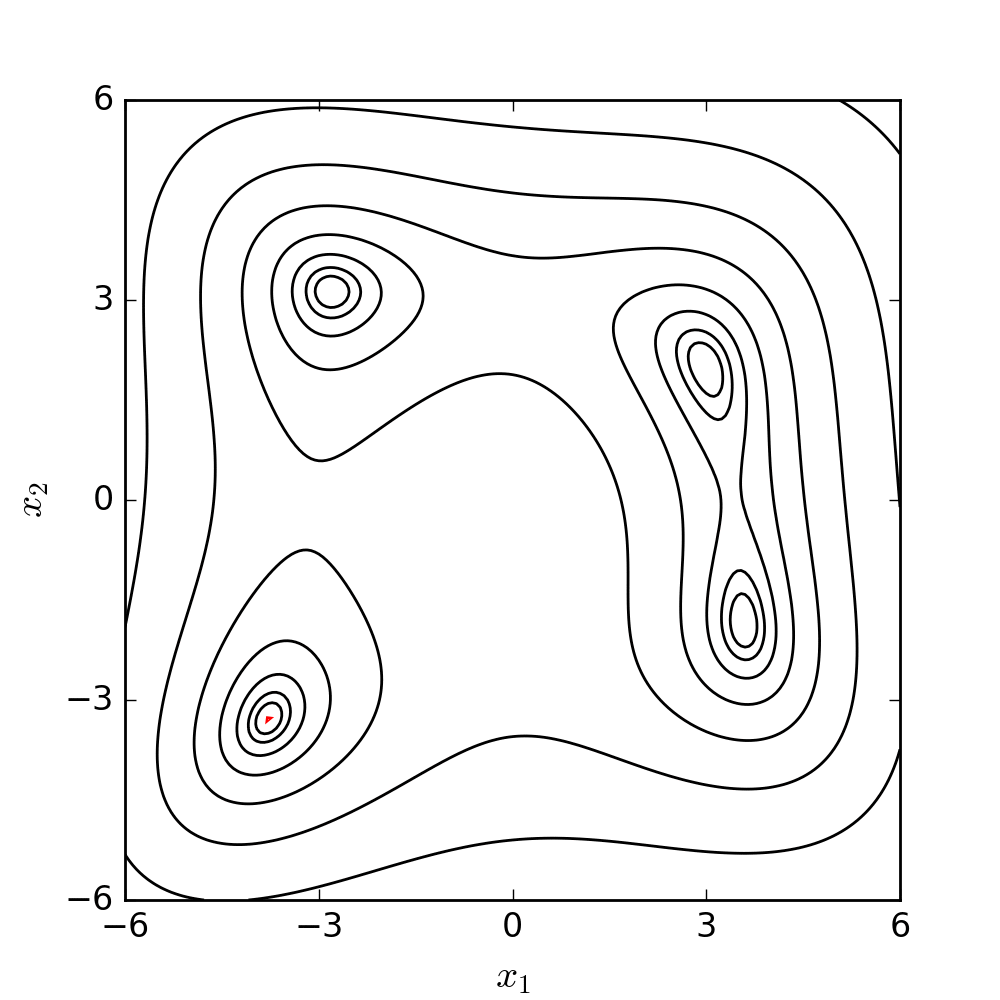
图注:Nelder-Mead 单纯形在 Himmelblau 函数上的迭代动画——单纯形像「变形虫」一样 爬向极小点(来源:Wikimedia Commons,CC BY-SA 4.0)。
何时用:目标不可导 / 黑盒 / 维度很低(<20);维度高时收敛慢、易陷局部极小。 深度学习里偶尔用于调超参(黑盒),但主体训练仍依赖一阶方法。
§5 面试追问与自测¶
- 牛顿法更新公式:$w \gets w - H^{-1}g$;为什么二次函数一步到位
- 条件数如何影响 GD / 牛顿法的步数(本文实验 2 的表)
- BFGS 的曲率条件 $s^\top y > 0$ 含义(保证正定、对应局部凸性)
- L-BFGS 为什么省内存:只存 $m$ 步 $(s_k,y_k)$,两循环递归
- K-FAC 的「块对角 + Kronecker」为什么省内存:$A^{-1}\otimes G^{-1}$
- 「深度学习为什么用不起牛顿法」四点:存/算/非凸/噪声
- 手写:在一维 $x^2$ 上验证牛顿一步归零(本文 §1.2)
💡 下节预告:FP16/BF16 混合精度与 Adam 内存分析(07 篇)。