🎵 24-信号处理 · 08 音频特征提取:MFCC¶
关键词:预加重、分帧、Mel 滤波、DCT MFCC 是语音识别/说话人/唤醒的"标准特征":把 16kHz 波形变成 12 维系数,本章手算每个环节的数值。
本节要解决的问题¶
| # | 问题 | 对应内容 |
|---|---|---|
| 1 | MFCC 全流程有几步? | §1 核心概念 |
| 2 | 预加重系数 0.97 怎么手算? | §2 手算 ✍️ |
| 3 | Mel 刻度公式与 700/1000Hz 的巧合 | §2 手算 ✍️ |
| 4 | 为什么最后要做 DCT? | §3 深入原理 |
故事引入¶
人耳对频率的感知不是线性的:100Hz 和 200Hz 差别很大,9900Hz 和 10000Hz 几乎听不出差别。MFCC 用 Mel 刻度模拟这种感知,再经 DCT 去相关得到紧凑特征——1990 年代以来语音界的"像素"。
MFCC 不是某个人拍脑袋想出来的,它是一套有清晰工程来源的流程。下图是语音处理文献中标准的 MFCC 计算框图:预加重 → 分帧 → 加窗 → FFT → Mel 滤波器组 → 取对数 → DCT,七步和我们本节要手推的流程完全一致。
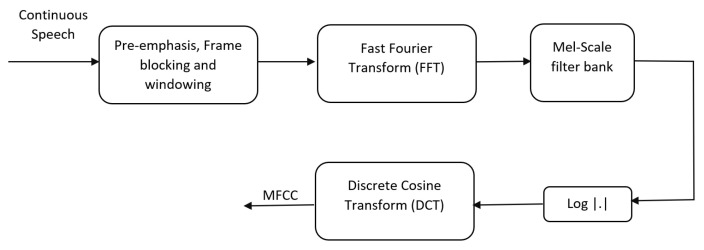
怎么读:顺着框图的箭头走一遍:每一步的输出是下一步的输入。尤其注意中间的 Mel 滤波器组和最后一步 DCT——它们是把"人耳感知"和"去相关"编码进特征的关键,本节 §6 会专门展开。
📚 图源:Herath HMDPM et al. (2022) Automatic Assessment of Aphasic Speech…, Sensors 22(18):6966(开放获取,CC-BY 4.0)图 2。
核心概念:MFCC 七步¶
流程:
$$\text{波形}\xrightarrow{①\text{预加重}}\xrightarrow{②\text{分帧}}\xrightarrow{③\text{加窗}}\xrightarrow{④\text{DFT}}\xrightarrow{⑤\text{Mel 滤波}}\xrightarrow{⑥\log}\xrightarrow{⑦\text{DCT}}$$
预加重:$y[n]=x[n]-\alpha x[n-1]$($\alpha\approx0.97$),提升高频(语音高频能量低)
分帧:25ms 帧、10ms 移(§03)
加窗:Hamming(§05)
DFT:每帧 400 点 → 201 个频点(§01)
Mel 滤波组:三角滤波器按 Mel 刻度铺 22–26 个
取 log:压动态范围、模拟响度感知
DCT:去相关,保留前 12–13 维(Δ、ΔΔ 拼接成 39 维)
✍️ 手算预加重与 Mel 刻度¶
设定 A:预加重(α=0.97)
$x=[1,\ 0.5,\ 0.25]$:
$$y[0]=x[0]=\mathbf{1},\qquad y[1]=0.5-0.97\times1=\mathbf{-0.47},\qquad y[2]=0.25-0.97\times0.5=\mathbf{-0.235}$$
高频(快速变化)被放大、低频平坦段被压——差分器平滑化。
设定 B:Mel 公式
$$\text{mel}(f)=2595\,\log_{10}\left(1+\frac{f}{700}\right)$$
$$\text{mel}(700)=2595\log_{10}2\approx\mathbf{781.2},\qquad \text{mel}(1000)=2595\log_{10}(1+1.4286)\approx\mathbf{1000.0}$$
手算收获:
- mel(700)=781 不是 700:Mel 刻度在 $f=700$Hz 处取"对数值的一半",这就是"感知非线性"的体现
- mel(1000)≈1000 是设计巧合:三组 (2595, 700) 常数恰好让 1kHz 保持不动——面试常考这道送分题
- 预加重系数方向:$y[n]=x[n]-\alpha x[n-1]$ 在 $z$ 域是 $1-\alpha z^{-1}$——一阶高通(§06 零极点:零点 $z=\alpha=0.97$)
- 说话人识别有时不做预加重(保留更多低频身份信息);ASR 一般做——特征工程是任务依赖的
# ---- §2.1 验证:numpy 复算预加重与 Mel ----
import numpy as np
x = np.array([1.0, 0.5, 0.25])
y = np.concatenate([[x[0]], x[1:] - 0.97*x[:-1]])
print('预加重 y =', np.round(y, 4).tolist())
assert np.allclose(y, [1.0, -0.47, -0.235])

def mel(f): return 2595*np.log10(1 + f/700)
print('mel(700) = %.2f, mel(1000) = %.2f' % (mel(700), mel(1000)))
assert abs(mel(700) - 781.2) < 0.5 and abs(mel(1000) - 1000.0) < 0.5
print('\n✓ 与手算一致')
预加重 y = [1.0, -0.47, -0.235]
mel(700) = 781.17, mel(1000) = 999.99

✓ 与手算一致
Mel 滤波器组具体长什么样?下图是 23 个三角滤波器在 0–8kHz 上的幅频响应:每个滤波器是一个三角形(低频处窄、高频处宽),它们互相重叠地覆盖整个频带。FFT 谱线与这些三角形相乘求和,就把线性频率压缩到了 Mel 刻度。
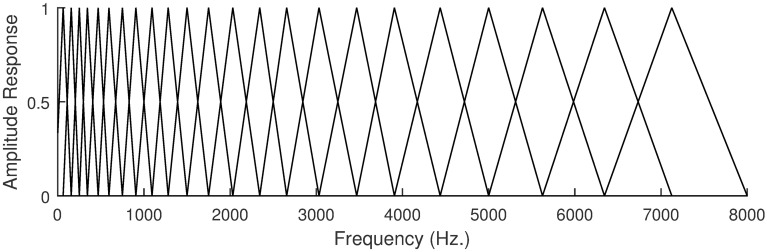
怎么读:看三角形分布:低频滤波器窄而密、高频滤波器宽而疏——这正是 Mel 刻度的体现(人耳对低频更敏感,所以低频分辨率更高)。相邻滤波器大幅重叠,导致 Mel 对数谱相邻维度高度相关,这就是为什么最后要用 DCT 去相关。
📚 图源:Toledano DT et al. (2018) Multi-resolution speech analysis for ASR: Experiments on TIMIT, PLOS ONE 13(8):e0205355(开放获取,CC-BY 4.0)图 3。
深入原理:为什么最后要 DCT¶
Mel 对数谱的相邻维度高度相关(三角滤波器重叠 + 平滑频谱),直接把 26 维喂模型浪费且病态;DCT 相当于"频谱的主成分变换",把能量集中到前几维:
$$C_m=\sum_{k=1}^{K}\log(S_k)\cos\!\left[m\left(k-\tfrac12\right)\frac{\pi}{K}\right]$$
前 12–13 维保留绝大部分能量(与 PCA 同理但无监督、固定基),Δ 系数刻画动态。 与 §20-多模态 的衔接:wav2vec 2.0 等自监督模型输入仍常用 MFCC/Filterbank 特征;Filterbank(不做 DCT)在深度学习时代更常用——CNN 能自己学去相关。
代码实战:MFCC 前 5 步(numpy/matplotlib 无 scipy)¶
生成 400 点帧 → 预加重/加窗/DFT → 3 个 Mel 三角滤波器能量。
# ---- MFCC 前 5 步演示(1 帧) ----
import numpy as np

def mel(f): return 2595*np.log10(1 + f/700)
def imel(m): return 700*(10**(m/2595) - 1)

# 一帧: 300Hz + 3000Hz 双音
fs, N = 16000, 400
n = np.arange(N)
x = 0.5*np.cos(2*np.pi*300/fs*n) + 0.5*np.cos(2*np.pi*3000/fs*n)
# ① 预加重 ② 加窗 ③ DFT ④ Mel 滤波
y = np.concatenate([[x[0]], x[1:] - 0.97*x[:-1]])
w = 0.54 - 0.46*np.cos(2*np.pi*np.arange(N)/(N-1))
X = np.abs(np.fft.rfft(y*w))
freqs = np.fft.rfftfreq(N, 1/fs)
# ⑤ 3 个 Mel 三角滤波器(中心 300/1500/4000 mel 区间等距)
centers_mel = np.linspace(mel(100), mel(6000), 3)
centers_hz = np.array([imel(c) for c in centers_mel])
fb = np.zeros((3, len(freqs)))
for i, fc in enumerate(centers_hz):
    lo = centers_hz[i-1] if i > 0 else 0
    hi = centers_hz[i+1] if i < 2 else centers_hz[i]*2 - centers_hz[i-1]
    mask = (freqs >= lo) & (freqs <= hi)
    fb[i, mask] = np.minimum((freqs[mask]-lo)/(fc-lo), (hi-freqs[mask])/(hi-fc))
S = np.log(fb @ X + 1e-10)
print('Mel 三角滤波中心(Hz):', np.round(centers_hz, 1).tolist())
print('3 个 Mel 滤波器输出能量(log):', np.round(S, 3).tolist())
assert X.shape[0] == 201 and fb.shape == (3, 201)
print('✓ 单帧 400 点 → 201 频点 → 3 个 Mel 能量(完整 MFCC 用 26 个+ DCT)')
Mel 三角滤波中心(Hz): [100.0, 1615.2, 6000.0]
3 个 Mel 滤波器输出能量(log): [2.433, 4.39, 3.682]
✓ 单帧 400 点 → 201 频点 → 3 个 Mel 能量(完整 MFCC 用 26 个+ DCT)
面试考点¶
Q1:MFCC 和 Filterbank 特征的区别?
Filterbank = log Mel 能量;MFCC 再做 DCT 去相关。深度学习时代 Filterbank 更常用(模型能学去相关),传统 GMM-HMM 必须 MFCC(对角协方差假设)。
Q2:为什么用 Mel 刻度?
人耳频率感知近似对数:Mel 滤波把带宽按感知分配——低频滤波器密而窄、高频稀疏而宽。
Q3:Δ 特征是什么?
一阶差分 $\Delta C_m=C_m(t+1)-C_m(t-1)$:刻画轨迹变化;39 维 = 13 + 13Δ + 13ΔΔ。
Q4:预加重会不会丢信息?
会放大高频噪声,但语音高频信噪比本来就差;用 $1-\alpha z^{-1}$ 高通可在后端倒谱归一化中恢复(CMVN 是另一步归一化)。
小结与下一章预告¶
- MFCC = 预加重→分帧→加窗→DFT→Mel→log→DCT
- 手算:预加重 $y=[1,-0.47,-0.235]$;mel(700)=781.2、mel(1000)=1000
- 下一章:特征有了,噪声怎么办?——自适应滤波与语音增强
✅ 自测清单¶
- 能背出 MFCC 七步流程并说出每步目的
- 能手算预加重与 mel(700)/mel(1000)
- 能解释 Mel 刻度的感知动机与 DCT 的去相关
- 知道 MFCC vs Filterbank 的区别与选型