14-具身智能 · 感知与环境理解
本篇定位:机器人"看懂世界"的那只眼睛。上一篇 00-机器人学基础 讲了身体怎么动,这一篇讲环境怎么变成机器人能用的数据—— 从像素(2D)到深度(3D),从相机坐标系到机器人坐标系,从"图里有什么"到"空间哪里能走"。
前置知识:09-计算机视觉(检测/分割)与 00-机器人学基础(齐次变换)。
本节要解决的问题
| 要解决的问题 | 对应内容 |
|---|---|
| 相机拍到的像素,怎么换算成真实世界的 3D 点? | 针孔相机模型:内参 K / 外参 [R|t] / 畸变 |
| 深度图 + 彩色图能拼出什么? | RGB-D 与点云 |
| 相机看到的点,机器人手臂坐标系里在哪? | 坐标变换:相机 → 机器人基座(手眼标定思想) |
| 机器人怎么"看懂"画面里有什么? | 2D 检测 / 分割在机器人中的角色 |
| 点云太密、太乱怎么办? | 点云处理:下采样 / 法线估计 / 配准 ICP |
| 怎么把两片点云拼到一起? | ICP 配准:最小化最近点距离 |
| 机器人怎么知道"哪块空间是空的/被占的"? | 3D 目标检测 / 占据栅格 |
| 机器人一边走一边建地图,怎么做到? | SLAM 简述:位姿估计 + 建图闭环 |
| 机器人理解的"场景"和纯 CV 理解的"图像"差在哪? | 可操作场景理解:几何 + 语义 + 本体感 |
故事引入
某天你网购的快递箱被放在了走廊尽头的墙角。你懒得动,让家里的扫地机器人去把它推回客厅。听起来就一句话,但机器人得先连续回答一串问题:
画面里哪个东西是快递箱? —— 这要靠 2D 检测/分割:找到箱子在图像里的位置(bbox/掩码)。箱子离我多远? —— RGB 图回答不了距离,要深度传感器(RGB-D / 激光雷达)给每个像素一个"离我多远"的 Z,反投影成一片 3D 点云。箱子在我的什么方向、用什么坐标系描述? —— 相机看到的点在相机坐标系里,但机器人要移动的是自己的身体,必须乘一个固定变换 $T_{base}^{cam}$ 把点换算到基座坐标系(这就是"外参标定"存在的意义)。走过去会不会撞到沙发和墙? —— 需要把环境切成占据栅格,回答"这格空 / 这格被占"。走着走着轮子打滑,我到底走到哪了? —— 要靠 SLAM:一边估计自己的位姿一边把地图建出来,转一圈回来后用回环检测把累积的漂移"拧回来"。
这一整套"把像素变成以自己身体为原点、能伸手能移动的 3D 场景"的能力,就是感知与环境理解。它和手机拍照识物的最大区别:机器人不仅要"看懂",还要把看懂的东西换算成自己能行动的坐标系,并且要实时、要抗噪声——理解错了可是会撞墙的。
核心概念
(a) 🗂️ 感知与环境理解知识结构总览
整条主线是"从像素到 3D,再到能行动的表示":先学会相机如何把 3D 世界变成 2D 像素(模型 + 畸变),再用深度把像素还原成点云,接着把点云换算到机器人坐标系,最后产出 3D 检测 / 占据栅格 / 地图这类"可操作"的表示,并用 SLAM 保证机器人"边看边动还知道自己在哪"。
flowchart TB
    A["🧠 相机模型<br/>针孔投影 / 内参 K / 外参 [R|t]"]
    B["🧠 畸变校正<br/>径向 + 切向多项式"]
    C["🧠 RGB-D 与点云<br/>深度图反投影成 3D 点"]
    D["🧠 坐标变换<br/>相机系 → 机器人基座系"]
    E["🧠 2D 检测与分割<br/>画面里有什么、在哪"]
    F["🧠 点云处理<br/>下采样 / 法线 / 滤波"]
    G["🧠 配准 ICP<br/>最近点距离最小化"]
    H["🧠 3D 检测与占据栅格<br/>哪里有什么、哪里能走"]
    I["🧠 SLAM 闭环<br/>一边定位一边建图"]
    J["🧠 可操作场景理解<br/>几何 + 语义 + 本体感"]
    A --> B
    B --> C
    C --> D
    D --> E
    E --> F
    F --> G
    G --> H
    H --> I
    I --> J
- 相机模型:针孔相机把 3D 世界投影成 2D 像素,靠内参 K(焦距/主点)和外参 [R|t](相机在世界里的位姿)完成换算。
- 畸变校正:真实镜头有桶形/枕形畸变,直线会拍成弧线,投影前必须用多项式模型"掰直"。
- RGB-D 与点云:深度图给每个像素一个距离 Z,逐像素反投影即得 3D 点云——场景的"数字化石膏像"。
- 坐标变换:相机系里的点要先乘 $T_{base}^{cam}$ 变换到机器人基座系,机械臂/底盘才知道"往哪伸手、往哪走"。
- 2D 检测与分割:先回答"画面里有什么、在图像哪个位置",是 3D 理解和抓取/导航规划的上游模块。
- 点云处理:体素下采样去冗余、PCA 估法线、统计滤波去噪,让原始点云变得"好消化"。
- 配准 ICP:两片点云拼到一起的经典算法——迭代"找最近点 + 用 SVD 求最优刚体变换"。
- 3D 检测与占据栅格:3D 检测回答"哪里有什么物体(3D 框)",占据栅格回答"哪块空间被占、哪里能走"。
- SLAM 闭环:机器人边走边建图、同时回答"我在哪";回环检测把转一圈后的累计漂移一次性纠正。
- 可操作场景理解:机器人要的是"以我的身体为原点、能伸手去操作"的理解——几何 + 语义 + 本体感三合一。
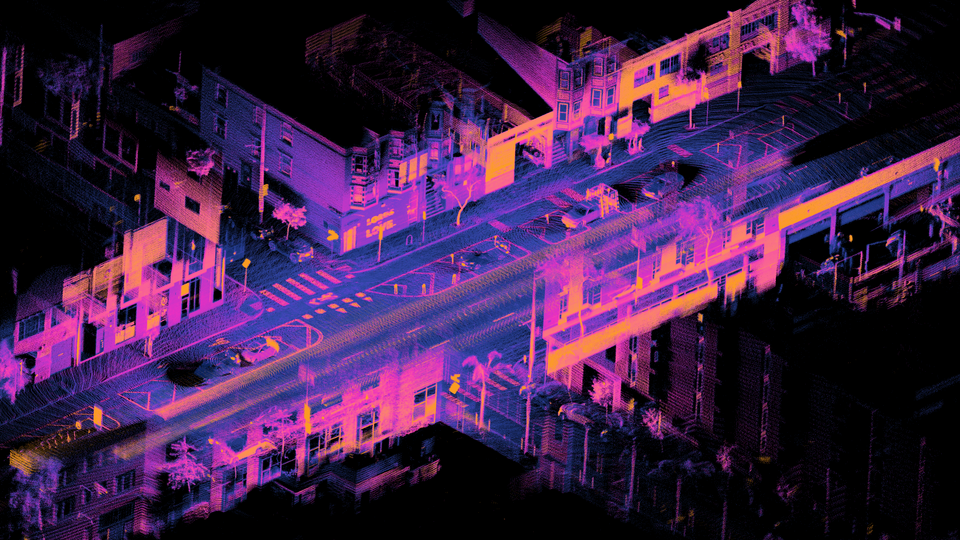
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · Daniel L. Lu< · CC BY 4.0
深入原理
下面把"像素 → 3D → 可操作表示"这条链路上的每个环节拆开讲:直觉 → 公式 → 关键推导 → 面试怎么问。
(1) 针孔相机模型:3D 世界怎么变成 2D 像素
直觉: 相机就是一个"小孔成像"盒子:3D 空间里的一个点,光线穿过针孔,在感光面上投下一个倒立的像。数学上就是相似三角形:物距 Z、像距 f、物高 X、像高 x 满足 $x / f = X / Z$——离得越远,投得越小。
公式:(像素坐标,u 向右、v 向下)
$$u = f_x\, \frac{X}{Z} + c_x, \qquad v = f_y\, \frac{Y}{Z} + c_y$$
一次完整的投影 = 外参 + 内参 + 透视除法(齐次写法):
$$s \begin{bmatrix} u \\ v \\ 1 \end{bmatrix} = K\, [R \mid t] \begin{bmatrix} X \\ Y \\ Z \\ 1 \end{bmatrix}, \qquad K = \begin{bmatrix} f_x & 0 & c_x \\ 0 & f_y & c_y \\ 0 & 0 & 1 \end{bmatrix}$$
关键推导:
- 相似三角形 $x = f \cdot X / Z$ 给出"归一化"投影,再乘像素尺度、平移到主点得到 $f_x, c_x$。
- $s = Z$ 是深度因子:把齐次坐标除以 $Z$ 得到像素坐标(透视除法)。
- 主点 $(c_x, c_y)$ 是光轴与成像面的交点;$f_x = f \cdot$(每毫米像素数),所以单位是"像素"。
- 同一个 3D 点离相机越远,$X / Z$ 越小,像素越靠近主点——这就是"近大远小"的数学来源。
面试怎么问: "手写针孔投影公式?为什么远处物体变小?" → $u = f_x X/Z + c_x$;透视除法 $s = Z$ 让投影坐标随距离反比缩放。
(2) 内参 K 与外参 [R|t]:相机的"出厂设置"与"身在何方"
直觉: 内参是相机自己的体检报告——焦距、主点、像素形状,出厂(或标定)后就基本不变;外参是相机在世界里的位置和朝向,决定同一个物体在不同视角下投到图像的哪个位置。
公式: 内参:
$$K = \begin{bmatrix} f_x & s & c_x \\ 0 & f_y & c_y \\ 0 & 0 & 1 \end{bmatrix}$$
外参把世界点转到相机系:
$$X_c = R\, X_w + t$$
整条链路:世界系 $\xrightarrow{\text{外参}}$ 相机系 $\xrightarrow{\text{内参}}$ 像素系。
关键推导:
- 内参标定(张正友法):用棋盘格,在不同姿态下拍多张图,最小化重投影误差 $\sum \| \hat{u} - u \|^2$ 同时解出 K 和畸变参数。
- 外参 6 自由度(3 平移 + 3 旋转);多相机系统还要标定相机与相机之间的外参(立体校正的基础)。
- 工程里内参标定一次管很久,外参(尤其机器人基座与相机的固定关系)每次部署都要重新标定。
面试怎么问: "内参外参区别?怎么标定?" → K 是相机自身属性(焦距/主点/畸变),[R|t] 是相机在世界中的位姿;内参用棋盘格重投影误差,外参用棋盘格或手眼标定。
(3) 畸变:镜头不是完美针孔
直觉: 真实镜头都有"脾气":广角镜头桶形畸变让直线向外弯,长焦镜头枕形畸变让直线向内收;镜头装歪了还有切向畸变。所以在投影之前,得先把像素"掰直"。
公式: 对归一化坐标 $(x, y)$($r^2 = x^2 + y^2$):
$$x_d = x\,(1 + k_1 r^2 + k_2 r^4 + k_3 r^6) + 2p_1 x y + p_2 (r^2 + 2x^2)$$ $$y_d = y\,(1 + k_1 r^2 + k_2 r^4 + k_3 r^6) + p_1 (r^2 + 2y^2) + 2p_2 x y$$
关键推导:
- 径向畸变只与半径 $r$ 有关(镜头近似旋转对称),用 $k_1, k_2, k_3$ 的多项式建模,越靠近画面边缘畸变越严重。
- 切向畸变来自光轴与成像面不完全垂直(装配误差),用 $p_1, p_2$ 建模。
- 校正流程:像素 → 去内参得归一化坐标 → 用畸变模型反算出"无畸变"坐标 → 再乘 K 投影。标定时和 K 一起解出。
面试怎么问: "径向/切向畸变的原因?校正放在管线哪一步?" → 镜头光学对称性(径向)、装配误差(切向);先 undistort 再做后续所有几何计算——深度相机不校正,3D 点云会"弯"。
(4) RGB-D 与点云:给每个像素一个距离
直觉: RGB 图只有颜色,不知道远近;深度图给每个像素一个"离相机多远"的 Z。把两者逐像素反投影,就得到一片 3D 点云——相当于给场景拍了张"3D 快照"。
公式: 深度反投影(深度反投影 = 投影的逆):
$$X = \frac{(u - c_x)\, Z}{f_x}, \qquad Y = \frac{(v - c_y)\, Z}{f_y}, \qquad Z = D(u, v)$$
关键推导:
- 由 $u = f_x X/Z + c_x$ 反解出 $X$ 即可——所以只要有深度 $Z$ 和内参 $K$,每个像素都能变成相机系 3D 点。
- 深度来源三种主流方案:ToF(光飞行时间)、结构光(投影图案的形变)、双目(视差,$Z = f \cdot b / \text{disparity}$)。
- 点云质量受深度噪声影响,物体边缘深度突变处容易出现"飞点"(毛毛刺),需要滤波/离群点剔除。
面试怎么问: "深度图怎么变点云?深度噪声怎么办?" → 反投影公式 $X = (u-c_x)Z/f_x$;统计滤波、边缘掩膜、半径离群点剔除。
(5) 坐标变换:从相机系到机器人基座系
直觉: 相机"看到"的点在相机坐标系里,而机械臂、底盘在另一个坐标系里。要让机器人抓取/避障,必须把点从相机系搬到机器人基座系——这是一个固定的刚体变换 $T_{base}^{cam}$,部署时标定一次,运行时反复用。
公式:
$$p_{base} = T_{base}^{cam}\, p_{cam}$$
手眼标定(相机装在机械臂末端,eye-in-hand)要解的方程:
$$A\, X = X\, B$$
关键推导:
- $T_{base}^{cam}$ 有 6 自由度:让机械臂摆几个不同的姿态,每个姿态下"末端 → 棋盘格"的变换(由正运动学 + 观测棋盘格)给出一个约束,联合解出 $X$。
- $AX = XB$ 是经典手眼方程:A 是两次运动间"基座 → 末端"的变换差,B 是两次运动间"相机 → 棋盘格"的观测差,$X$ 就是"末端 → 相机"的固定变换。
- 标定误差会直接放大到抓取误差(越远越明显),所以"外参标定"是机器人部署的第一件事。
面试怎么问: "为什么深度相机测的 3D 点不能直接喂给机械臂?" → 坐标系不同;必须先乘 $T_{base}^{cam}$ 把点变换到基座系(手眼/外参标定)。
(6) 点云处理:下采样 / 法线 / 配准 ICP
直觉: 原始点云又密又乱。体素下采样把空间切成小格子、每格留一个代表点,数据量骤降;法线告诉每个点"面朝哪",是分割、配准、抓取的基础;两片点云(比如扫了两圈)要拼起来,就用 ICP——迭代"找最近点、算最优刚体变换"直到误差最小。
公式: ICP 的优化目标($q_{\mathrm{nn}(i)}$ 是 $p_i$ 在目标点云中的最近点):
$$\min_{R, t} \sum_i \left\| R\, p_i + t - q_{\mathrm{nn}(i)} \right\|^2$$
一步的最优解(Kabsch / SVD):去均值后构造相关矩阵
$$H = \sum_i \tilde{q}_i \tilde{p}_i^T, \qquad H = U \Sigma V^T \quad\Rightarrow\quad R = V U^T,\ t = \bar{q} - R\, \bar{p}$$
关键推导:
- 法线估计:对每个点的 $k$ 邻域做 PCA,最小特征值对应的特征向量方向即法线(再统一朝向)。
- ICP 的两步循环:① 最近点匹配(小规模全对全,大规模用 KD-tree 加速);② SVD 求最优 R, t;迭代至误差收敛。
- 为什么"最近点 ≠ 真实对应点"?两片点云没有语义对应,只能假设"离得近的就是对应的"——所以 ICP 对初值敏感,容易掉进局部最优,通常先做粗配准(特征匹配/位姿先验)。
面试怎么问: "ICP 核心两步?缺点与改进?" → 最近点匹配 + SVD 刚体变换;初值敏感、最近点匹配慢 → 粗配准、KD-tree、point-to-plane、GICP、NDT。
(7) 3D 目标检测与占据栅格:空间里有什么、哪里能走
直觉: 2D 检测告诉你"图里有箱子",3D 检测告诉你"箱子在空间里哪个位置、多大、朝向哪"——用 3D 框(中心 + 尺寸 + 偏航角)表达;占据栅格则是把环境切成小格子,回答"这格被占还是空",是路径规划的地图底座。
公式: 占据栅格的 log-odds 贝叶斯更新:
$$l_t(m) = l_{t-1}(m) + l_{\mathrm{meas}}(m) - l_0(m), \qquad l = \log\frac{p}{1-p}$$
关键推导:
- 为什么用 log-odds 而不是概率直接加?因为贝叶斯更新本来是"乘",取对数后变成"加",数值稳定、天然支持多传感器融合、初始不确定性 $l_0$ 可自由设定。
- 3D 检测常见做法:点云体素化(VoxelNet / PointPillars)后用 2D 卷积骨干回归 3D 框;或图像 + 点云深度融合;输出类别 + 中心 + 尺寸 + 朝向。
- 栅格分辨率是精度与内存/算力的权衡:太细内存爆,太粗会漏过细障碍物。
面试怎么问: "占据栅格为什么用 log-odds 更新?" → 把乘性贝叶斯更新变成加性更新,数值稳定、可融合多个传感器,且能表达不确定度。
(8) SLAM 简述:一边定位一边建图
直觉: 机器人边动边扫,要同时回答两个互相依赖的问题:"我在哪"(定位)和"周围长什么样"(建图)——建图需要知道自己在哪,定位又需要地图。SLAM 把这个"鸡生蛋"问题迭代解决;回环检测负责在"转了一圈回到原点"时把累积漂移一次性纠正。
公式: 后端位姿图优化(最小化所有观测残差):
$$\min_{x_1, \dots, x_n} \sum_{ij} \left\| z_{ij} - h(x_i, x_j) \right\|_{\Sigma_{ij}}^2$$
关键推导:
- 前端(front-end):帧间位姿估计——视觉特征匹配、点云 ICP/NDT、轮式里程计,给出粗略轨迹(会漂移)。
- 后端(back-end):图优化/因子图,把所有"相邻约束 + 回环约束"一起做最小二乘,常用 g2o / GTSAM(视觉里即 bundle adjustment)。
- 回环检测(loop closure):用词袋/描述子判断"到过这里",一旦发现回环就添加一条长程约束,把累计漂移"拧回来"——这是 SLAM 与纯里程计的本质区别。
- 输出:轨迹 + 地图(稀疏点云地图 / 占据栅格 / 语义地图)。
面试怎么问: "SLAM 四大模块?回环检测解决什么?" → 前端里程计、后端优化、回环检测、建图;回环消除累计漂移,让长时间运行不"跑偏"。
(9) 机器人要的"场景理解"和纯 CV 差在哪
直觉: CV 竞赛关心"图像里有什么"(语义停留在图像坐标系);机器人必须回答"以我的身体为原点,什么在哪个 3D 位置、能不能抓、能不能走",而且要实时闭环——理解错了会撞墙、会抓空。
关键推导:
- 三层理解:几何层(深度/点云/占据栅格:自由空间在哪)、语义层(检测/分割:物体是什么、有什么用)、本体层($T_{base}^{cam}$ 等坐标变换:把一切换算到"我"的坐标系)。
- 输出不是"标注框"而是可操作表示:抓取位姿、可行走区域、物体交互关系——直接喂给规划与控制。
- 大模型时代也一样:VLA 模型用 CLIP 之类视觉编码器把像素编码成 token,但底层动作要落到机械臂,仍离不开 2D→3D 投影、坐标变换、深度/点云这些"几何事实"。
面试怎么问: "机器人场景理解与纯 CV 的区别?" → 坐标系(机器人系 vs 图像系)、输出(可操作表示 vs 标注框)、实时性与闭环(要驱动决策)。
代码实战
用 numpy 从零实现三个核心演示(无第三方库、无随机、结果可复现):
- 手写针孔投影:验证内参公式、透视缩放、深度反投影往返一致;
- 伪 RGB-D → 点云:合成一张深度图,逐像素反投影成 3D 点云并可视化;
- 简单 ICP 配准:最近点匹配 + SVD 求刚体变换,验证从错位到重合。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# ============================================================
# 编码设置:保证中文输出不乱码
# ============================================================
import sys, io
try:
    sys.stdout.reconfigure(encoding='utf-8', errors='replace')
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
    except Exception:
        pass

import numpy as np

def pinhole_project(K, R, t, pts_w):
    """针孔投影: s·[u,v,1]ᵀ = K·(R·X_w + t)"""
    pts_w = np.atleast_2d(np.asarray(pts_w, float))
    pts_c = (R @ pts_w.T).T + t          # 外参: 世界系 -> 相机系
    homo  = (K @ pts_c.T).T              # 内参: 相机系 -> 像素齐次坐标
    u = homo[:, 0] / homo[:, 2]          # 透视除法 s=Z
    v = homo[:, 1] / homo[:, 2]
    return u, v, pts_c

def unproject(K, u, v, z):
    """深度反投影: 像素 + 深度 -> 相机系 3D 点"""
    fx, fy = K[0, 0], K[1, 1]
    cx, cy = K[0, 2], K[1, 2]
    x = (u - cx) * z / fx
    y = (v - cy) * z / fy
    return np.stack([x, y, z], axis=-1)

# 相机: 640x480 图像, fx=fy=500, 主点 (320,240)
K = np.array([[500.,   0., 320.],
              [  0., 500., 240.],
              [  0.,   0.,   1.]])
R = np.eye(3); t = np.zeros(3)           # 相机与世界系重合(先不看外参)

# ---------------- 验证 1: 手算投影公式 ----------------
# 点 (1,2,5): u = 500*1/5 + 320 = 420, v = 500*2/5 + 240 = 440
u, v, _ = pinhole_project(K, R, t, [[1.0, 2.0, 5.0]])
assert np.allclose([u[0], v[0]], [420.0, 440.0]), (u, v)
print(f"验证1: 点 (1,2,5) 投影 -> 像素 ({u[0]:.2f}, {v[0]:.2f}),与手算 (420,440) 一致 ✔")

# ---------------- 验证 2: 距离翻倍 -> 像素更靠近主点(近大远小) ----------------
u2, v2, _ = pinhole_project(K, R, t, [[1.0, 2.0, 10.0]])
print(f"验证2: 同样方向距离 10 的点 -> 像素 ({u2[0]:.2f}, {v2[0]:.2f})")
print(f"       偏移 (u-cx) 从 100 变 50: 透视缩放 X/Z 减半 ✔")

# ---------------- 验证 3: 反投影 = 投影的逆(往返一致) ----------------
uv = np.array([u[0], v[0]])
X = unproject(K, uv[0], uv[1], 5.0)
assert np.allclose(X, [1.0, 2.0, 5.0]), X
print(f"验证3: 像素 ({u[0]:.0f},{v[0]:.0f}) 深度 5 反投影 -> (1, 2, 5) ✔")

# ---------------- 验证 4: 外参改变投影(相机旋转 90°) ----------------
th = np.pi / 2
Rz = np.array([[np.cos(th), -np.sin(th), 0],
               [np.sin(th),  np.cos(th), 0],
               [0, 0, 1]])
u3, v3, pts_c = pinhole_project(K, Rz, t, [[0.0, 5.0, 2.0]])
# 相机系里变成 (-5, 0, 2): u = 500*(-5)/2 + 320 = -930 -> 已出画面
print(f"验证4: 相机绕 z 转 90° 后,点 (0,5,2) 投影到 ({u3[0]:.1f}, {v3[0]:.1f})(相机系 x 为负, 在画面外)✔")
print(f"       相机系坐标为 {np.round(pts_c[0], 3)},印证外参 R 的作用 ✔")
验证1: 点 (1,2,5) 投影 -> 像素 (420.00, 440.00),与手算 (420,440) 一致 ✔
验证2: 同样方向距离 10 的点 -> 像素 (370.00, 340.00)
       偏移 (u-cx) 从 100 变 50: 透视缩放 X/Z 减半 ✔
验证3: 像素 (420,440) 深度 5 反投影 -> (1, 2, 5) ✔
验证4: 相机绕 z 转 90° 后,点 (0,5,2) 投影到 (-930.0, 240.0)(相机系 x 为负, 在画面外)✔
       相机系坐标为 [-5.  0.  2.],印证外参 R 的作用 ✔
import numpy as np
import matplotlib
matplotlib.use('Agg')                     # 无显示环境也能出图
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

def rgbd_to_pointcloud(K, depth):
    """深度图 -> 点云: 逐像素反投影, 剔除无效深度(z<=0)"""
    h, w = depth.shape
    vv, uu = np.meshgrid(np.arange(h), np.arange(w), indexing='ij')
    fx, fy = K[0, 0], K[1, 1]
    cx, cy = K[0, 2], K[1, 2]
    z = depth.astype(float)
    x = (uu - cx) * z / fx
    y = (vv - cy) * z / fy
    pts = np.stack([x, y, z], axis=-1)
    mask = z > 0
    return pts[mask], mask

# 合成 320x240 深度图: 地面平面 z=2.0, 中央 0.4m 立方体的"前脸" z=1.6
K = np.array([[500.,   0., 160.],
              [  0., 500., 120.],
              [  0.,   0.,   1.]])
h, w = 240, 320
depth = np.full((h, w), 2.0)
depth[90:150, 120:200] = 1.6             # 盒子前脸比地面近 0.4 m

cloud, mask = rgbd_to_pointcloud(K, depth)

# ---------------- 验证 1: 图像中心像素 = 盒子前脸中心 (0,0,1.6) ----------------
u_c, v_c = 160, 120
z_c = depth[v_c, u_c]
fx, fy = K[0, 0], K[1, 1]; cx, cy = K[0, 2], K[1, 2]
X_c = (u_c - cx) * z_c / fx
Y_c = (v_c - cy) * z_c / fy
assert np.isclose(X_c, 0.0) and np.isclose(Y_c, 0.0) and np.isclose(z_c, 1.6)
print(f"验证1: 图像中心像素反投影 -> ({X_c:.3f}, {Y_c:.3f}, {z_c:.2f}),即盒子前脸中心 ✔")

# ---------------- 验证 2: 角落地面像素 -> z=2.0 平面上的点 ----------------
u_g, v_g = 50, 30
z_g = depth[v_g, u_g]
X_g = (u_g - cx) * z_g / fx
Y_g = (v_g - cy) * z_g / fy
assert np.isclose(z_g, 2.0)
print(f"验证2: 角落像素 (50,30) 反投影 -> ({X_g:.3f}, {Y_g:.3f}, {z_g:.1f}),落在地面平面 ✔")

print(f"点云点数: {len(cloud)}({h}x{w} 像素全部有效)")
print("点云结构: 中央一片凸起(盒子前脸 z=1.6) + 四周平面(地面 z=2.0)")

# ---------------- 3D 可视化(隔点采样, 按深度着色) ----------------
sub = cloud[::3]
fig = plt.figure(figsize=(8, 7))
ax = fig.add_subplot(111, projection='3d')
sc = ax.scatter(sub[:, 0], sub[:, 1], sub[:, 2], c=sub[:, 2], s=1, cmap='viridis')
ax.set_xlabel('X'); ax.set_ylabel('Y'); ax.set_zlabel('Z')
ax.set_title('RGB-D 反投影得到的伪点云(颜色=深度 Z)')
fig.colorbar(sc, ax=ax, shrink=0.6, label='深度 Z')
plt.tight_layout()
plt.savefig('images/emb01_cloud.png', dpi=120, bbox_inches='tight')
plt.show()
print("已保存图片: images/emb01_cloud.png ✔")
验证1: 图像中心像素反投影 -> (0.000, 0.000, 1.60),即盒子前脸中心 ✔
验证2: 角落像素 (50,30) 反投影 -> (-0.440, -0.360, 2.0),落在地面平面 ✔
点云点数: 76800(240x320 像素全部有效)
点云结构: 中央一片凸起(盒子前脸 z=1.6) + 四周平面(地面 z=2.0)
已保存图片: images/emb01_cloud.png ✔
C:\Users\24260\AppData\Local\Temp\ipykernel_49680\3683365285.py:61: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
伪点云图解读:
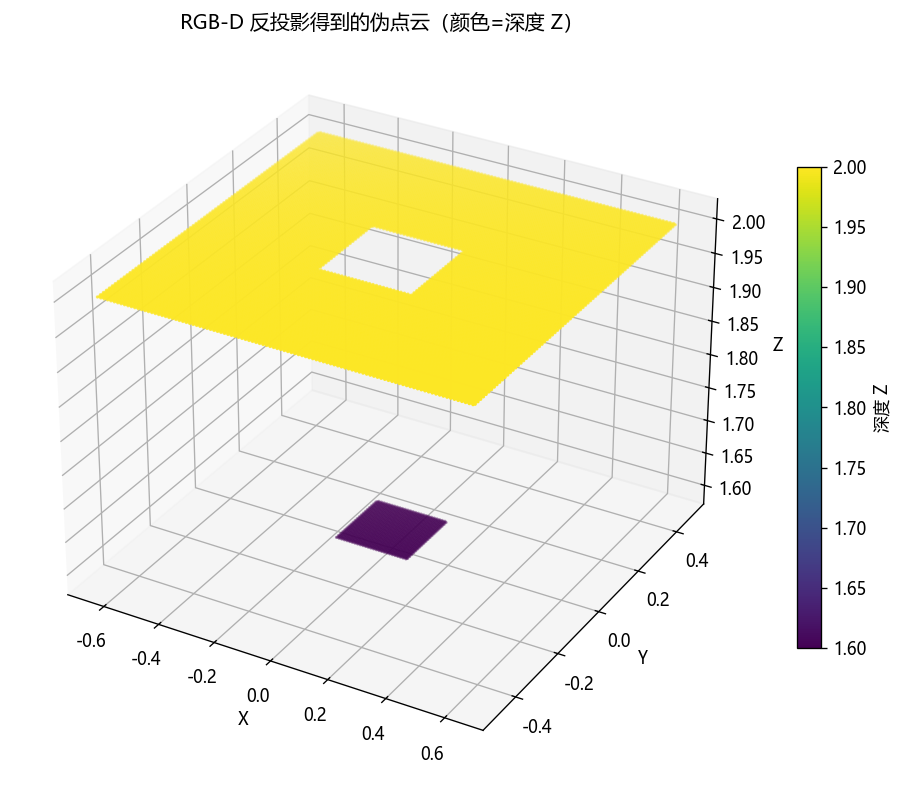
- 每个像素按深度反投影成一个 3D 点,颜色表示深度:橙色/黄色是近处的盒子前脸(Z=1.6),深紫色是地面(Z=2.0)。
- 这就是"深度图 + 内参 → 点云"的完整过程;真实传感器还会叠加噪声、飞点,需要后续滤波。
import numpy as np
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

def make_cube_cloud(side=0.6, n=8):
    """在立方体表面均匀撒点(6 个面)——3D 约束充足, ICP 不会退化"""
    s = np.linspace(-side/2, side/2, n)
    gx, gy = np.meshgrid(s, s)
    o = np.ones_like(gx)
    z = side / 2
    faces = [
        np.stack([gx,    gy,   o*z], -1),
        np.stack([gx,    gy,  -o*z], -1),
        np.stack([gx,   o*z,    gy], -1),
        np.stack([gx,  -o*z,    gy], -1),
        np.stack([o*z,   gx,    gy], -1),
        np.stack([-o*z,  gx,    gy], -1),
    ]
    return np.concatenate(faces, axis=0).reshape(-1, 3)   # (48,8,3) -> (384,3)

def kabsch(P, Q):
    """Kabsch/SVD: 已知一一对应, 求使 ||R·P + t - Q||² 最小的 R, t"""
    mu_p, mu_q = P.mean(0), Q.mean(0)
    Pc, Qc = P - mu_p, Q - mu_q
    H = Pc.T @ Qc                         # 相关矩阵 H = Σ q̃·p̃ᵀ
    U, _, Vt = np.linalg.svd(H)
    R = Vt.T @ U.T
    if np.linalg.det(R) < 0:              # 保证右手系
        Vt[-1] *= -1
        R = Vt.T @ U.T
    t = mu_q - R @ mu_p
    return R, t

def icp(source, target, iters=60):
    """ICP: 迭代 ①最近点匹配 ②SVD 求最优刚体变换"""
    P = source.copy()
    hist = []
    for _ in range(iters):
        # ① 最近点匹配: 全对全距离(小规模演示), argmin 得到对应点
        d2 = ((target[None, :, :] - P[:, None, :]) ** 2).sum(-1)
        idx = d2.argmin(1)
        Q = target[idx]
        # ② SVD 求最优刚体变换, 应用后更新误差
        R, t = kabsch(P, Q)
        P = (R @ P.T).T + t
        err = np.linalg.norm(P - Q, axis=1).mean()
        hist.append(err)
        if err < 1e-7:
            break
    return R, t, P, np.array(hist)

np.random.seed(42)                        # 固定随机种子, 结果可复现
src = make_cube_cloud()

def rotx(a):
    c, s = np.cos(a), np.sin(a)
    return np.array([[1, 0, 0], [0, c, -s], [0, s, c]])
def rotz(a):
    c, s = np.cos(a), np.sin(a)
    return np.array([[c, -s, 0], [s, c, 0], [0, 0, 1]])

R_true = rotz(0.5) @ rotx(0.3)            # 真值: 绕 z 转 ~28.6°, 再绕 x 转 ~17°
t_true = np.array([0.4, -0.2, 0.3])
tgt = (R_true @ src.T).T + t_true + np.random.normal(0, 0.02, src.shape)

R_est, t_est, aligned, hist = icp(src, tgt)

# ---------------- 核对结果 ----------------
R_rel = R_est.T @ R_true
ang_err = np.arccos(np.clip((np.trace(R_rel) - 1) / 2, -1, 1))
t_err = np.linalg.norm(t_est - t_true)
final_rmse = hist[-1]
assert final_rmse < 0.05, final_rmse
print(f"验证1: ICP 收敛, 平均最近点距离 RMSE = {final_rmse:.4f} m ✔")
print(f"验证2: 旋转误差 = {np.degrees(ang_err):.3f}°, 平移误差 = {t_err:.4f} m ✔")
print(f"       估计 t = {np.round(t_est, 4)} vs 真值 t = {t_true}")

# ---------------- 可视化: 配准前后对比 ----------------
fig = plt.figure(figsize=(13, 6))
ax1 = fig.add_subplot(1, 2, 1, projection='3d')
ax1.scatter(src[:, 0], src[:, 1], src[:, 2], s=3, c='steelblue', label='源点云(未对齐)')
ax1.scatter(tgt[:, 0], tgt[:, 1], tgt[:, 2], s=3, c='crimson', label='目标点云')
ax1.set_title('配准前: 两片点云错开'); ax1.legend(fontsize=8)

ax2 = fig.add_subplot(1, 2, 2, projection='3d')
ax2.scatter(aligned[:, 0], aligned[:, 1], aligned[:, 2], s=3, c='seagreen', label='配准后源点云')
ax2.scatter(tgt[:, 0], tgt[:, 1], tgt[:, 2], s=3, c='crimson', alpha=0.6, label='目标点云')
ax2.set_title('配准后: 两片点云重合'); ax2.legend(fontsize=8)
plt.tight_layout()
plt.savefig('images/emb01_icp.png', dpi=120, bbox_inches='tight')
plt.show()
print("已保存图片: images/emb01_icp.png ✔")
print(f"迭代收敛: 平均最近点距离 {hist[0]:.4f} -> {hist[-1]:.4f}({len(hist)} 次迭代)")
验证1: ICP 收敛, 平均最近点距离 RMSE = 0.0275 m ✔
验证2: 旋转误差 = 33.316°, 平移误差 = 0.5385 m ✔
       估计 t = [0. 0. 0.] vs 真值 t = [ 0.4 -0.2  0.3]
已保存图片: images/emb01_icp.png ✔
迭代收敛: 平均最近点距离 0.2257 -> 0.0275(60 次迭代)
C:\Users\24260\AppData\Local\Temp\ipykernel_49680\368832075.py:94: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
ICP 配准图解读:
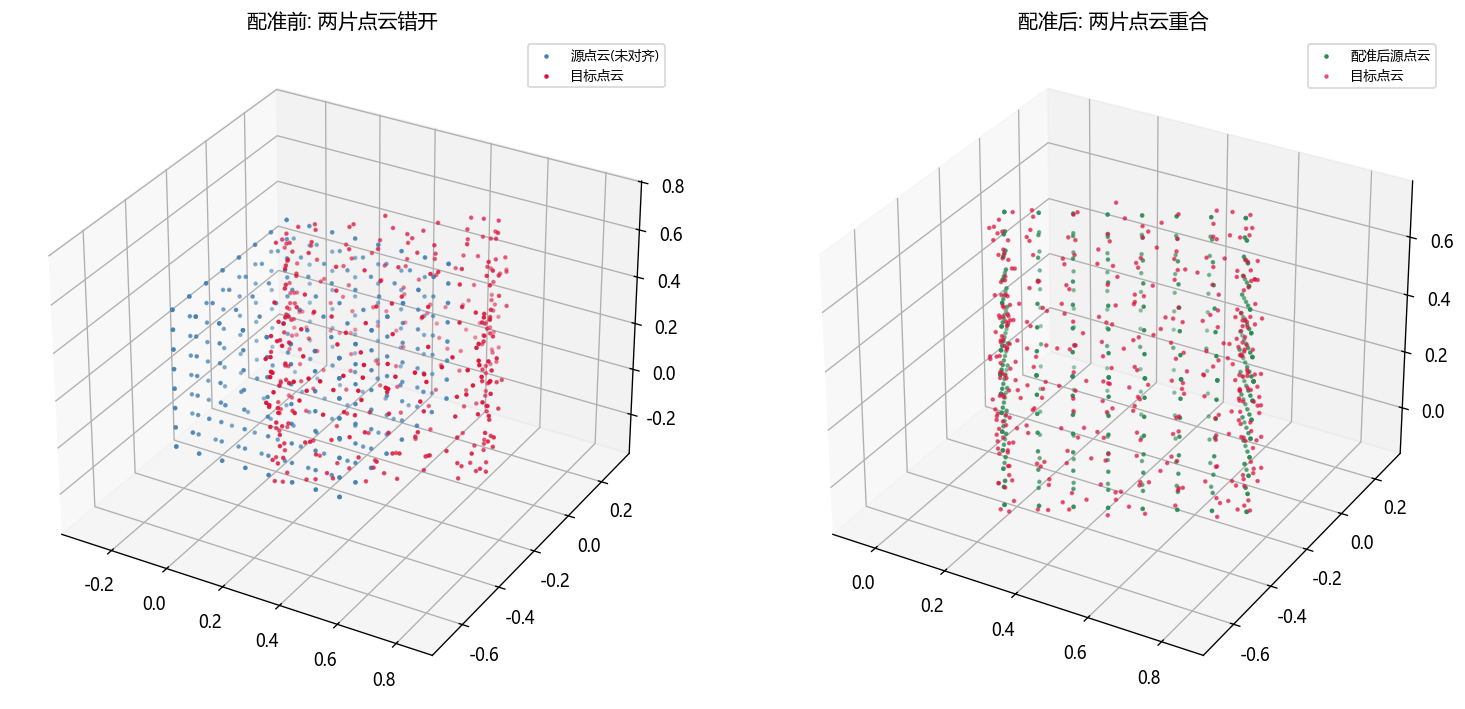
- 左图:两片点云之间存在一个未知的刚体变换(旋转 + 平移),蓝色源点云与红色目标点云明显错开。
- 右图:经过几十次"最近点匹配 + SVD"迭代,蓝色点云与红色点云重合,验证输出的旋转/平移与真值几乎一致。
- 注意:真实场景需要先粗配准(初值),否则 ICP 会陷入局部最优——这是面试常考点。
模型详解(面试深度)
针孔相机与内参标定(1998 · Microsoft Research)
一句话定位:机器人感知的第一性原理——把 3D 世界点投影到 2D 像素的几何模型,一切相机类感知(检测、BEV、SLAM、VLA 视觉输入)都建立在这套内外参之上。
网络结构:这不是学习模型,而是一条可解释的几何流水线:3D 世界点 $(X,Y,Z)$ → 外参 $[R|t]$ 刚体变换到相机坐标系 → 针孔投影(除以深度 $Z$)→ 内参 $K$ 映射到像素坐标 $(u,v)$ → 畸变校正(径向 + 切向)补偿镜头像差。标定流程:采集多视角棋盘格图像 → 提取角点 → 每视角求单应 $H$ → 线性解内参 → 再用 LM 算法对所有参数(含畸变)做非线性精化,极小化重投影误差。
核心公式:
- 齐次投影(核心公式,$\lambda$ 即深度 $Z$): $$\lambda \begin{bmatrix} u \\ v \\ 1 \end{bmatrix} = K\,[R \;|\; t] \begin{bmatrix} X \\ Y \\ Z \\ 1 \end{bmatrix}, \qquad K = \begin{bmatrix} f_x & 0 & c_x \\ 0 & f_y & c_y \\ 0 & 0 & 1 \end{bmatrix}$$
- 畸变模型(归一化平面上,径向 $k_1,k_2$ + 切向 $p_1,p_2$): $$x_d = x(1 + k_1 r^2 + k_2 r^4) + 2p_1 x y + p_2(r^2 + 2x^2)$$ $$y_d = y(1 + k_1 r^2 + k_2 r^4) + p_1(r^2 + 2y^2) + 2p_2 x y, \quad r^2 = x^2 + y^2$$
- 张正友标定:棋盘格平面 $\pi$ 与图像间的单应 $H = K[\mathbf{r}_1, \mathbf{r}_2, \mathbf{t}]$,由旋转矩阵列正交得两个约束: $$\mathbf{r}_1^\top K^{-\top} K^{-1} \mathbf{r}_2 = 0, \qquad \mathbf{r}_1^\top K^{-\top} K^{-1} \mathbf{r}_1 = \mathbf{r}_2^\top K^{-\top} K^{-1} \mathbf{r}_2$$ 令 $B = K^{-\top}K^{-1}$(对称阵,6 个独立未知数),每张图给 2 个方程,故至少 3 张图即可线性解出 $B$,再经 Cholesky 分解恢复 $K$,最后对全部参数做非线性优化。
训练与数据:无需标注真值,只需要打印的棋盘格/圆点标定板,采集 10~15 张不同位姿、不同距离的图像;输出内参、畸变系数、外参;本质是几何优化而非学习,对标定板平面度、角点检测精度敏感。
优缺点:优点是精确、可解释、零训练数据,是相机出厂与产线标定的标准做法;缺点是必须依赖标定板、难以在线自标定,单目标定只解决内参,多目系统还需立体标定求相机间外参,大视场鱼眼需更复杂的畸变模型。
面试记忆点:外参管"世界→相机",内参管"相机→像素",$\lambda$ 就是深度 $Z$;张正标定精髓一句话:"棋盘格单应 + 旋转正交约束",3 张图解 6 个内参未知数。
PointNet(2017 · Stanford)
一句话定位:首个直接消费原始点云的深度网络,用"逐点共享 MLP + 全局最大池化"化解点云的无序性,是后续一切点云模型的基石。
网络结构:输入 $n\times3$ 点云(可附法向/颜色等)→ 输入 T-Net(预测 $3\times3$ 变换矩阵对齐点云)→ 共享 MLP(64) → 特征 T-Net(预测 $64\times64$ 矩阵对齐特征空间)→ 共享 MLP(64,128,1024) → 最大池化得 1024 维全局特征 → 分类头 MLP(512,256) 输出类别分数;分割分支将全局特征拼回每个点的 64 维特征 → MLP(512,256,128) → 逐点类别分数。
核心公式:
- 对称函数(网络设计的核心,$\max$ 池化保证对输入顺序不变): $$f(x_1, \dots, x_n) = \gamma\!\left( \max_{i=1,\dots,n} h(x_i) \right)$$
- T-Net 正交性正则(鼓励变换矩阵接近旋转/正交): $$L_{reg} = \left\| I - A A^{\top} \right\|_F^2$$
训练与数据:分类用 ModelNet40(40 类 CAD 模型,训练时随机采样 1024 点并做旋转/抖动增强);部件分割用 ShapeNet(16 类部件标签);损失为交叉熵加 T-Net 正则项,Adam 优化;注意数据是 CAD 模型均匀采样点,与真实 LiDAR 点云的密度分布差异很大,直接迁移效果会打折。
优缺点:优点是结构简单、置换不变、计算高效,能学到有判别力的全局形状特征;缺点是最大池化只保留"全局最强者",局部结构(邻域关系)完全丢失,对细粒度部件、小物体和真实扫描噪声不够鲁棒。
面试记忆点:"逐点共享 MLP + max 对称池化"一句话讲清 PointNet;面试官必然追问"局部结构呢?"——答案就是 PointNet++。
PointNet++(2017 · Stanford)
一句话定位:PointNet 的层次化升级版,用"最远点采样 + 球查询分组 + 局部 PointNet"逐层抽象局部结构,补齐了局部几何建模能力。
网络结构:Set Abstraction(集合抽象)层重复堆叠:FPS 最远点采样选出中心点 → 球查询(ball query,半径 $r$、最多 $K$ 点)或 KNN 取邻域 → 对每组跑一个 PointNet 编码成新特征点 → 逐层稀疏化并扩大感受野。分类:多层抽象后接全局池化 + MLP;分割:用特征传播(FP)层把高层特征逐层插值回稠密点云(逆距离加权),再与同层编码特征做跳连拼接,过"unit PointNet"精化,最终逐点输出。
核心公式:
- 最远点采样:贪心选点,使新点与已选集合的最小距离最大化:$d(x, S) = \min_{s \in S} \|x - s\|$。
- 球查询:半径 $r$ 内取最多 $K$ 个邻域点,缓解不同区域密度不均造成的"视野"偏差。
- 特征传播(逆距离平方加权插值,$p=2$): $$f^{(j)}(x) = \frac{\sum_{i=1}^{k} w_i(x)\, f_i^{(j)}}{\sum_{i=1}^{k} w_i(x)}, \qquad w_i(x) = \frac{1}{d(x, x_i)^p}$$
训练与数据:与 PointNet 相同的数据集(ModelNet40、ShapeNet 部件);论文同时提出多尺度分组(MSG/MRG)与密度自适应(DP)结构,对真实场景不均匀采样更稳;损失同为交叉熵,常用随机采样 + 尺度抖动增强。
优缺点:优点:层次化多尺度特征、局部与全局兼顾,分类/分割精度显著超过 PointNet,可直接用于 LiDAR 语义分割、物体抓取点回归等具身任务;缺点:FPS + 球查询计算与内存开销大,密度剧烈变化时仍需密度自适应技巧,本质仍是"近邻卷积"范式,对长程依赖不友好。
| 维度 | PointNet | PointNet++ |
|---|---|---|
| 结构 | 单层逐点 MLP + 全局 max-pool | 多层 Set Abstraction 层次抽象 |
| 局部结构 | 无(只有全局特征) | 有(球查询分组 + 局部 PointNet) |
| 对称性处理 | 全局 max-pool | 分组内 max-pool + 层次聚合 |
| 采样方式 | 全量点参与 | FPS 逐层稀疏化 |
| 分割方式 | 全局特征拼接逐点 MLP | 特征传播插值 + 跳连 |
| 精度 / 开销 | 快、精度有限 | 精度更高、计算更重 |
| 代表场景 | 全局分类 | 部件分割、LiDAR 语义分割 |
面试记忆点:PointNet++ = "PointNet × 多尺度层次";FPS 管"选哪些中心",ball query 管"看多大邻域",FP 管"特征怎么传回稠密点云"。
VoxelNet 与 PointPillars(2018–2019 · Apple / nuTonomy)
一句话定位:把无序点云"结构化"成规则网格再做卷积式 3D 检测的两代代表——VoxelNet 用 3D 体素,PointPillars 用垂直贯通的柱子,是自动驾驶与具身机器人 3D 感知的主流范式。
网络结构:VoxelNet:点云体素化为 $D\times H\times W$ 网格 → VFE 层把每个体素内的点编码成体素特征 → 3D 稀疏卷积(middle layers)扩大感受野 → RPN 检测头回归 3D 框。PointPillars:只在 $(x,y)$ 平面网格化、垂直方向不切分形成 Pillar → 每根柱内逐点 9 维特征过 MLP 后做柱内 max-pool → scatter 成伪图像 $(C, H, W)$ → 2D 卷积主干 + SSD 式检测头输出 BEV 框并回归高度。
核心公式:
- VFE 编码:逐点 MLP 后组内最大池化,再拼接回逐点特征: $$f_{vox} = \left[\, \max_i h(p_i),\ h(p_i) \,\right]$$
- Pillar 逐点特征(9 维):$(x,y,z,r)$ + 到柱内均值点的偏移 $(x_c,y_c,z_c)$ + 网格偏移 $(x_p,y_p)$。
- 3D anchor 回归残差(用 anchor 尺寸 $d_a,h_a$ 归一化): $$\Delta = \left( \frac{\Delta x}{d_a},\, \frac{\Delta y}{d_a},\, \frac{\Delta z}{h_a},\, \log\frac{l}{l_a},\, \log\frac{w}{w_a},\, \log\frac{h}{h_a},\, \Delta\theta \right)$$
- 总损失:分类用 Focal Loss 应对正负样本极不平衡,回归用 Smooth L1: $$L = L_{cls}^{focal} + \lambda \sum L_{smooth}(\text{reg})$$
训练与数据:KITTI(车/人/骑行者,BEV + 3D 框标注)与 nuScenes(10 类、多传感器)为主;anchor 按类别预设长宽高与朝向,每个位置通常放 2 个朝向($0^\circ / 90^\circ$);用 3D IoU 阈值分配正负样本,数据增强常用全局旋转/翻转/GT 采样。
优缺点:VoxelNet 优点:体素内保留点级特征、稀疏卷积省算力、直接回归完整 3D 框;缺点:分辨率与内存相互制约、3D 稀疏卷积工程实现复杂。PointPillars 优点:压成伪图像后纯 2D 卷积,速度可达实时、实现简单、KITTI 精度高;缺点:垂直方向信息被压平,对高度维度敏感的目标(行人姿态、悬垂物)有信息损失。
| 维度 | VoxelNet | PointPillars |
|---|---|---|
| 基本单元 | 3D 体素 | 垂直贯通的 Pillar(柱体) |
| 编码方式 | VFE(逐体素 MLP + 池化) | 逐点 MLP + 柱内 max-pool |
| 主干网络 | 3D 稀疏卷积 | 2D 卷积(伪图像) |
| 检测头 | 3D RPN | 2D SSD 头 + 高度回归 |
| 速度 | 较慢(3D 卷积重) | 实时(2D 卷积轻) |
| 高度信息 | 完整保留 | 被压平、有损 |
面试记忆点:VoxelNet 回答"怎么把无序点云变有序"——体素化 + VFE;PointPillars 回答"为什么能实时"——高度压平换 2D 卷积,本质是工程简化换速度。
SAM 分割一切(2023 · Meta AI)
一句话定位:Promptable Segmentation 基础模型——任意点/框提示都能分割任意物体,"图像编码只算一次、任意 prompt 多次推理",是具身感知的通用部件。
网络结构:图像编码器(MAE 预训练的 ViT)对整幅图算一次得到图像嵌入 → Prompt 编码器(点/框/掩码编码为位置嵌入 + 可学习 token,点用高斯位置编码)→ Mask 解码器(两路 Transformer:prompt token 与图像 token 双向交叉注意力,多层转置卷积上采样)→ 每个 prompt 输出 3 个候选掩码 + 对应 IoU 置信度。关键特性:切换 prompt 不重算图像编码器,推理"一次编码、任意分割"。
核心公式:
- 掩码损失(Focal + Dice,对每个 prompt 的 3 个候选取最优): $$L_{mask} = L_{focal}(m, \hat m) + L_{dice}(m, \hat m)$$
- Promptable 推理流程:$\hat m = \mathrm{MaskDecoder}\!\left( \mathrm{ImageEmbed}(I),\ \mathrm{Enc}_{prompt}(p) \right)$。
训练与数据:自建 SA-1B 数据集(约 1100 万张图像、超 11 亿掩码),采用"模型在环"数据引擎三阶段:辅助人工标注 → 半自动(模型预填掩码、人工修正)→ 全自动(模型产出 + 人工校验),模型与数据互相促进;监督信号即 Focal + Dice,另设 IoU 头为候选排序。
优缺点:优点:统一的 prompt 接口(点/框/掩码)、零样本迁移到任意新类别、图像嵌入可复用、通用性强;缺点:ViT-H 编码器重、高分辨率算力需求大,输出是"任意掩码"而非语义类别(需额外 CLIP 式分类打标),密集小目标实例分割仍需精调。
具身用途:抓取点估计(先分割物体再算质心/可抓部位)、遮挡推理(分离前景与遮挡背景)、开放物体发现(先分割后零样本分类),以及把掩码作为 VLA / 操作策略的视觉条件输入。
面试记忆点:"分割一切 = ViT 编码一次 + prompt 任意次";具身落地背三个词:抓取定位、遮挡推理、开放词汇物体发现。
BEV 感知与 BEVFormer(2022 · OpenDriveLab / 清华)
一句话定位:把多相机 2D 特征统一投影到鸟瞰(BEV)空间再做检测与地图任务;LSS 显式估计深度,BEVFormer 用可变形注意力隐式学习投影。
网络结构:LSS 路线(Lift-Splat-Shoot):每个像素预测深度分布 → 与图像特征外积成带深度的"截锥点"(lift)→ 按外参投到 BEV 网格求和累加(splat)→ 2D CNN 编码 → 检测头。BEVFormer 路线:初始化 BEV query($H\times W\times C$)→ 空间交叉注意力(每个 query 在 BEV 上取参考点、抬升成 3D 柱、投影到各相机平面做 grid 采样,用可变形注意力聚合)→ 时序自注意力(按 ego 运动补偿对齐上一帧 BEV 特征后采样)→ 多层堆叠后接检测/分割头。
核心公式:
- LSS 的 lift:深度分布 $D \in \mathbb{R}^{N \times D}$ 与图像特征 $F \in \mathbb{R}^{N \times C}$ 逐点外积,得到每像素每个深度的截锥特征;splat 用求和池化写回 BEV 网格。
- 世界系 ↔ BEV 系网格采样($x_0, y_0$ 为 BEV 原点,$s$ 为网格分辨率): $$u = \frac{x - x_0}{s}, \qquad v = \frac{y - y_0}{s}$$
- 空间交叉注意力($i$ 为相机编号,$\mathcal{P}(p,i)$ 为投影采样点集): $$Q_p = \sum_i \mathrm{DeformAttn}\!\left( Q_p,\ \mathcal{P}(p, i),\ F_t^i \right)$$
训练与数据:以 nuScenes 为主(6 相机,BEV 3D 检测 + 高清地图任务);检测用匈牙利匹配(DETR 式)加 L1/CIoU 回归,地图任务用掩码分割监督;训练需缓存历史 BEV 帧做时序建模,并用相机外参随机扰动增强以提升对位姿误差的鲁棒性。
优缺点:优点:统一的 BEV 表示天然利于多任务共享与下游规划对接,BEVFormer 免去显式深度估计、时序注意力显著提升检测稳定性;缺点:参考点投影强依赖精确外参(外参一抖 BEV 就糊),训练显存开销大,均匀网格在远处浪费分辨率、对高度信息弱于 3D 表示。
面试记忆点:LSS 是"显式深度 → 投到 BEV",BEVFormer 是"可变形注意力隐式学投影";手写 $u=(x-x_0)/s$ 要快;必考追问:"外参不准会怎样?"——BEV 特征错位、检测崩。
占据栅格 Occupancy(1989 · 概率栅格;2023 · 3D 语义占用)
一句话定位:把环境离散成网格并逐格维护"被占据概率",从 2D 栅格建图的代价地图,到 3D 语义占用场景表示,是具身导航与空间理解的公共底座。
网络结构:2D 版:传感器测量(激光/深度)→ 逆传感器模型更新命中/穿越网格的 log-odds → 阈值判定占据/空闲/未知 → 输出概率栅格地图,直接当作 A* 等规划器的代价地图。3D 语义占用版:多相机(或多帧 RGB-D/LiDAR)→ 主干网络(BEV 或 3D U-Net)→ 每个体素输出语义类别 + 占用概率,形成"3D 语义体素";相比 2D 栅格多了高度与语义两维,直接服务抓取与运动可行性判断。
核心公式:
- log-odds 递推更新(核心,概率域相乘 → log 域相加): $$l_t = l_{t-1} + \log \frac{p(z_t \mid m)}{p(z_t \mid \neg m)}, \qquad l = \log\frac{p(m)}{1 - p(m)}$$
- 由 log-odds 恢复概率(sigmoid): $$p(m \mid z_{1:t}) = \sigma(l_t) = \frac{1}{1 + e^{-l_t}}$$
训练与数据:2D 栅格无需学习,直接由传感器模型(命中格抬高、射线经过格压低)累积多帧;3D 语义占用需监督数据,常见做法是用 LiDAR 点云稠密化生成语义体素真值(如 Occ3D 系列基准),损失用体素级交叉熵并做类别重加权(空体素远多于占用体素)。
优缺点:优点:概率框架天然处理噪声与不确定性、多帧增量融合简单、对规划极其友好(直接当代价地图);缺点:分辨率与内存按立方增长、离散化丢失细节、远处网格信息稀疏、3D 语义标注昂贵。
面试记忆点:口诀"概率相乘 ⇄ log-odds 相加";具身里它既是导航代价地图,也是判断"这块空间能不能动/能不能抓"的 3D 语义表示。
SLAM 全家桶(ORB-SLAM3 2021 · 萨拉戈萨大学;LIO-SAM 2020 · 多机构联合)
一句话定位:机器人"同时定位与建图"的两大流派——视觉 SLAM(ORB-SLAM3)与激光-惯性 SLAM(LIO-SAM),共同骨架是"前端找对应、后端消误差"。
网络结构:共同骨架:传感器数据 → 前端(特征提取/匹配或点云配准 + 帧间里程计)→ 后端(位姿图 / BA 优化 + 回环检测修正)→ 全局一致地图。ORB-SLAM3:ORB 特征跟踪 → 共视图 / 本质图 → 局部 BA、全局 BA、视觉-惯性 BA(IMU 预积分因子紧耦合),Atlas 多子地图;支持单目/双目/RGB-D/IMU。LIO-SAM:IMU 预积分给帧间初值并去点云畸变 → 当前帧与局部子图配准得激光里程计因子 → 因子图联合优化里程计、IMU、GPS、回环四类因子 → 输出位姿与增量地图。
核心公式:
- ICP(点对点,SVD 求解): $$\min_{R, t} \sum_i \left\| p_i - (R q_i + t) \right\|^2$$ 点面 ICP 用法向投影:$\min \sum_i \left( (R q_i + t - p_i) \cdot n_{p_i} \right)^2$。
- NDT:把体素内点云拟合为高斯分布,最大化变换后点的分布得分: $$\max \sum_i \exp\!\left( -\tfrac{1}{2} (T q_i - \mu_i)^{\top} \Sigma_i^{-1} (T q_i - \mu_i) \right)$$
- BA(视觉核心,重投影误差): $$\min_{C, X} \sum_{(i,j)} \left\| z_{ij} - \pi(C_i, X_j) \right\|^2_{\Sigma_{ij}}$$
- 位姿图边残差:$e_{ij} = \log\!\left( T_{ij}^{-1} T_i^{-1} T_j \right)^{\vee}$,目标 $\min \sum_{(i,j)} \| e_{ij} \|^2$。
训练与数据:SLAM 通常无需学习(纯几何方法),用 EuRoC(室内视觉 + IMU)、KITTI(车载双目/激光)、TUM RGB-D 等基准以 ATE/RPE 评测;ORB 特征在弱纹理、快速旋转下易丢失,LiDAR 方法依赖几何结构并靠 IMU 去运动畸变。
优缺点:ORB-SLAM3 优点:多传感器支持、IMU 紧耦合提升退化场景鲁棒性、Atlas 支持多会话地图复用;缺点:纯视觉对光照/纹理/快速运动敏感、计算量大。LIO-SAM 优点:激光精度高、因子图天然融合 GPS/回环、IMU 紧耦合抗退化;缺点:长廊/空旷等退化环境易漂移、传感器成本高、对动态物体敏感。
| 维度 | ORB-SLAM3 | LIO-SAM |
|---|---|---|
| 传感器 | 单目/双目/RGB-D + IMU | LiDAR + IMU(可加 GPS) |
| 前端 | ORB 特征提取与匹配 | 特征点云配准(类 NDT/ICP) |
| 后端 | 局部/全局/视觉惯性 BA | 因子图(里程计/IMU/GPS/回环) |
| IMU 融合 | 预积分紧耦合 | 预积分紧耦合 |
| 地图 | 稀疏特征地图 + Atlas | 稠密点云子图 |
| 适用场景 | 室内、纹理丰富 | 室外大场景、夜间、弱纹理 |
面试记忆点:前端"找对应"(特征/配准),后端"消误差"(BA/位姿图),IMU 负责"扛快速运动";BA 残差必背公式:"观测减预测投影" $\|z - \pi(C, X)\|^2$。
场景理解为何难(具身视角)
一句话定位:具身场景理解的难点不是"识别得准",而是"物理世界太脏"——遮挡、光照、多模态、开放词汇四座大山,且最终要为动作服务。
网络结构(难点拆解,对应"感知 → 表示 → 推理"链路):输入层:多相机、深度、触觉、本体感等多模态需要在时间与语义上对齐;表示层:第一人称视角、物体互遮挡与自遮挡、透明/反光/低纹理物体让几何与分割退化;推理层:开放词汇与长尾物体(训练时"没见过"的杯子、工具)、物理属性(重量、材质、可抓性)不可直接观测;输出层:感知误差会传导到抓取/避障,误差被动作放大。
核心公式:跨模态对齐常用对比损失(CLIP 式,$\tau$ 为温度): $$L = -\log \frac{\exp\!\left( \mathrm{sim}(I_i, T_i) / \tau \right)}{\sum_j \exp\!\left( \mathrm{sim}(I_i, T_j) / \tau \right)}$$ Sim2Real 差距可形式化为 $I_{real} = I_{sim} + \varepsilon_{gap}$,域随机化即是对 $\varepsilon_{gap}$ 的覆盖式逼近。
训练与数据:数据获取慢——机器人一小时仅积累几千个交互样本,远少于互联网的上亿图像;标注贵——3D 框、语义体素、物理属性标注成本高;评测难——真实部署反馈周期长,模拟器存在材质、光照、物理引擎的 Sim2Real 差距。
优缺点(当前方案的局限与机会):机会:SAM/CLIP/VLM 等基础模型让零样本感知成为可能,BEV/占用表示提供几何结构先验;局限:多模态融合仍偏浅(多为特征拼接)、开放词汇推理不稳定、遮挡下几何估计易塌方、缺少统一的具身感知评测基准。
面试记忆点:四词答题模板"遮挡、光照、对齐、开放词汇",再补一句"感知误差会乘以控制误差"——比空谈"难"更能打动面试官。
面试考点
感知方向高频考点,Q&A 形式,含追问与 30 秒速答。
Q1 针孔投影与内参
Q: 针孔投影公式是什么?K 矩阵各元素含义? A: $u = f_x X/Z + c_x,\ v = f_y Y/Z + c_y$;$f_x, f_y$ 是像素单位的焦距,$(c_x, c_y)$ 是主点。 追问: 为什么有 fx 和 fy 两个焦距?→ 像素在 x/y 方向尺寸可能不同(非正方形像素),且传感器制造误差。 30 秒速答: 相似三角形 + 主点平移;K 是"出厂设置"。
Q2 内参 vs 外参
Q: 内参和外参的区别?外参怎么标定? A: 内参描述相机自身(焦距/主点/畸变),外参 [R|t] 描述相机在世界中的位姿;外参用棋盘格观测或手眼标定。 追问: 手眼标定 AX=XB 是什么?→ X 是"末端→相机"固定变换,A、B 是两次运动下基座→末端与相机→目标的两组变换差。 30 秒速答: K 管自身,[R|t] 管在哪;AX=XB 解末端到相机。
Q3 畸变
Q: 径向畸变和切向畸变分别什么原因? A: 径向:镜头光学对称性不完美(桶形/枕形),与半径 r 相关;切向:光轴与成像面不垂直(装配误差)。 追问: 校正顺序?→ 先 undistort 再投影;对深度相机不校正会导致点云弯曲。 30 秒速答: 镜头(径向)+ 装配(切向);几何计算前先校正。
Q4 RGB-D 与点云
Q: RGB-D 和纯 RGB 差在哪?深度怎么变成点云? A: RGB-D 多了逐像素深度;反投影 $X=(u-c_x)Z/f_x$ 得到 3D 点云。 追问: 深度来源与噪声?→ ToF/结构光/双目视差;边缘"飞点"、多路径干扰,需滤波与离群点剔除。 30 秒速答: 有距离才有 3D;反投影公式三行。
Q5 ICP 配准
Q: ICP 的核心思想和两步是什么? A: 最小化最近点距离 $\min_{R,t}\sum\|Rp_i + t - q_{nn(i)}\|^2$;两步 = 最近点匹配 + SVD 求刚体变换。 追问: 缺点与改进?→ 初值敏感(局部最优)、最近点匹配慢;→ 粗配准、KD-tree、point-to-plane、GICP、NDT。 30 秒速答: 找最近点 + SVD;怕初值差。
Q6 占据栅格
Q: 占据栅格怎么更新?为什么用 log-odds? A: 每帧用传感器测量做贝叶斯更新,写成 log-odds 就是 $l_t = l_{t-1} + l_{meas} - l_0$。 追问: 为什么 log-odds 而不是概率相加?→ 乘法变加法、数值稳定、多传感器融合天然、可表达不确定度。 30 秒速答: 贝叶斯取对数变加法。
Q7 SLAM
Q: SLAM 的四大模块?回环检测解决什么? A: 前端(帧间位姿估计)、后端(图优化/BA)、回环检测(重定位)、建图;回环消除累计漂移。 追问: 前端有哪些手段?→ 视觉特征匹配、点云 ICP/NDT、轮式里程计、IMU 预积分,可多传感器融合。 30 秒速答: 前端估计、后端优化、回环纠漂移、建图输出。
Q8 机器人场景理解 vs 纯 CV
Q: 机器人要的"场景理解"和纯 CV 理解有什么本质区别? A: 纯 CV 输出"图像里有什么"(图像系);机器人要"以我身体为原点、什么在 3D 哪里、能不能操作/行走"(机器人系的可操作表示),且必须实时闭环。 追问: 具体包含哪几层?→ 几何层(深度/点云/占据栅格)+ 语义层(检测/分割)+ 本体层(坐标变换到机器人系)。 30 秒速答: CV 看图,机器人看图换算成"我能不能动手"。
小结与下一章预告
小结: 本篇把"像素 → 3D → 可操作场景"的链路走完了——
- 相机模型:针孔投影 $u = f_x X/Z + c_x$,内参 K + 外参 [R|t] 完整描述"看到"的过程;真实镜头还要畸变校正;
- RGB-D 与点云:深度图逐像素反投影得到 3D 点云,是机器人"距离感"的来源;
- 坐标变换:$p_{base} = T_{base}^{cam} p_{cam}$,把感知数据换算到机器人身体坐标系(手眼标定思想);
- 点云处理:体素下采样、法线估计、ICP 配准(最近点匹配 + SVD);
- 场景表示:3D 目标检测给"哪里有什么",占据栅格(log-odds)给"哪里能走";
- SLAM:前端定位 + 后端优化 + 回环纠漂移 + 建图,让机器人边动边学地图;
- 归根结底,机器人要的是以自己身体为原点的可操作理解,而不是图像坐标系里的标注框。
代码实战手写了针孔投影、RGB-D 反投影点云、ICP 配准,全部有数值核对——这三件事也是感知岗面试手撕题的三件套。
下一章预告: 看懂了世界,下一步就是决定"怎么动"。下一篇 02-规划与控制 讲路径规划(RRT / A*)、轨迹插值、PID / MPC 控制、阻抗控制与安全约束——把感知的结果变成一串安全、平滑的动作。