📨 05 · Kafka 与数据管道:分区 / 偏移量 / 消费者组¶
Kafka 是大数据管道的传输中枢(削峰填谷、解耦、缓冲)。 本节手写分区与偏移量、生产者/消费者组消费进度、重平衡等核心概念(无 Kafka 依赖)。
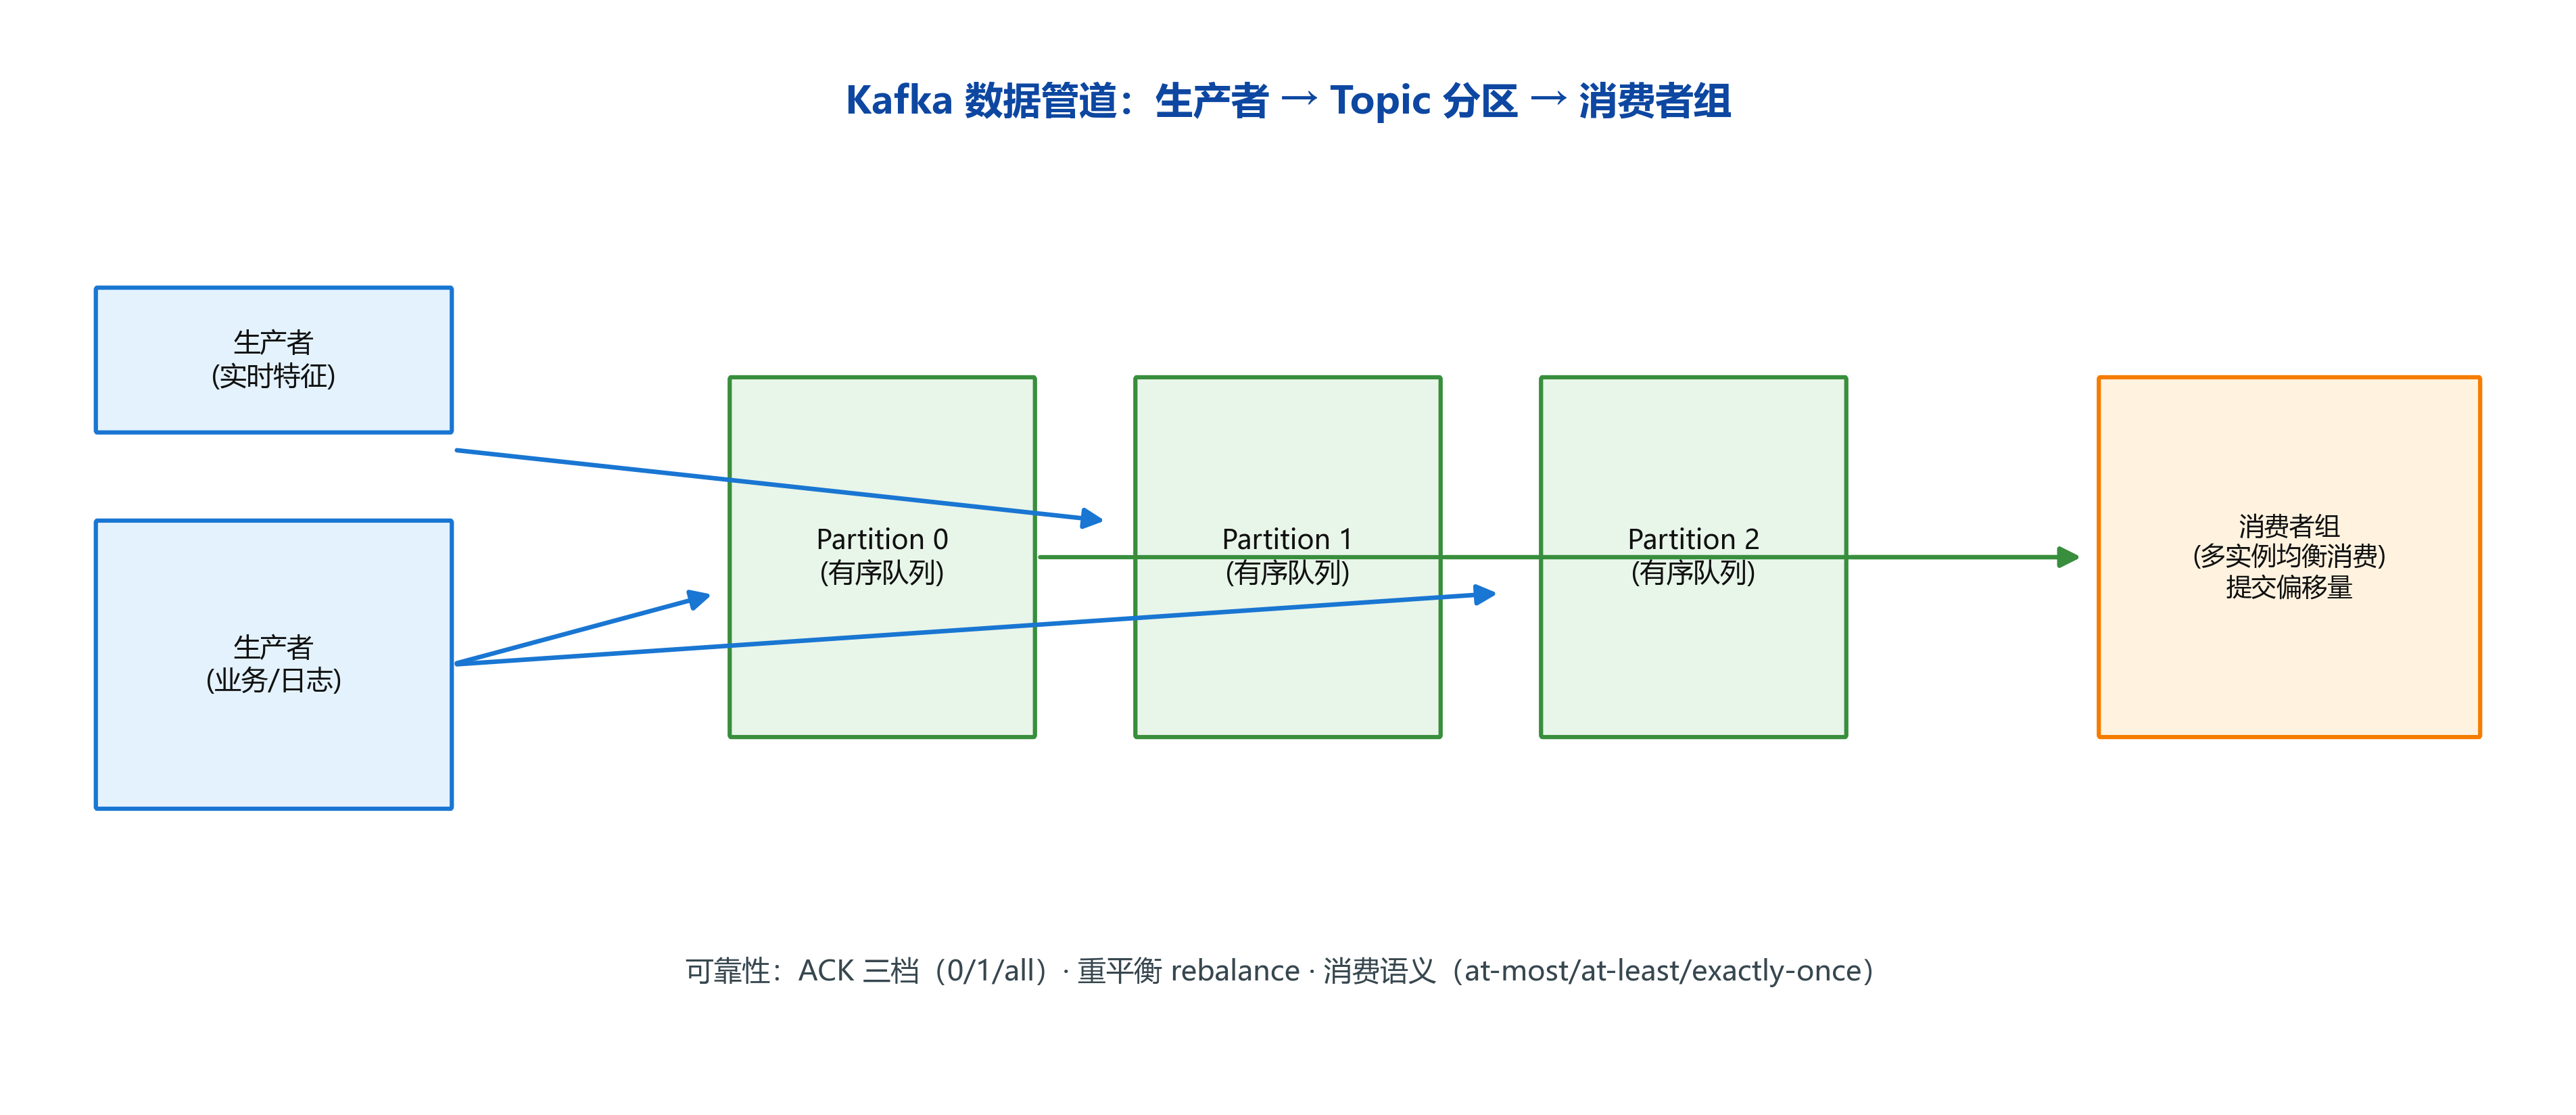
🔍 图解(自绘高清图,300dpi,可放大):Kafka 作为"消息中转站"的核心链路——
- 生产者(左):业务系统(订单/埋点/日志)把消息发给指定 Topic; 每条消息带 key,key 相同 → 进同一分区(保证同一用户的事件有序);
- Topic 分区(中):一个 Topic 切成 N 个分区(Partition),每个分区是有序追加的日志 (顺序写磁盘,所以 Kafka 吞吐极高);分区在集群里多副本冗余(Leader+Follower), 同时分区也是并行度单位——N 个分区最多被 N 个消费者并行消费;
- 消费者组(右):一组消费者共同消费一个 Topic,每个分区同一时刻只被组内一个消费者 持有(分区与消费者一一分配)——组内分摊并行、组间互不干扰(广播/订阅两种模式);
- Offset 与重放:消费者记录自己的消费位点(Offset),挂了可以从上次位点续读; 数据默认保留 7 天,可回放重算——这是"实时管道 + 离线重算"双用同一份数据的基石。
论文出处:Kreps et al., "Kafka: A Distributed Messaging System for Log Processing", NetDB 2011——Topic/Partition/Offset/消费者组机制的原始论文设计。
🎬 背景故事¶
业务系统每秒产生百万条日志,怎么安全地送到下游?……
业务系统每秒产生百万条日志,下游有几十个系统要用。如果每个系统都直接连数据库,数据库早就被压垮。Kafka 就是那个"中转站":生产者把消息发到 Topic,按 key 路由到分区,消费者组从分区拉取并记录偏移量。本节把这条管道的每个环节拆开讲。
🧭 本节逻辑主线:为什么需要消息队列 → Topic/Partition/Offset 是什么 → key 哈希路由 → 消费者组与重平衡 → ACK 与消费语义。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | Kafka 定位? | 分布式消息队列(日志总线) |
| 2 | 分区干什么? | 并行度 + 顺序保证 |
| 3 | 偏移量怎么管理? | 消费者组消费进度 |
| 4 | 怎么保证可靠性? | 副本 + ack 机制 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ Kafka 核心概念(必背)¶
📌 真实配图:Apache Kafka 徽标(Wikimedia Commons,Apache Software Foundation,Apache 2.0 License)
🔍 图解:徽标本身是 Kafka 的流式(Streaming)意象——黑色纵向条纹代表有序追加的 事件流(每个 Topic/分区的日志就是不断追加的记录序列),与 Kafka 的核心设计一一呼应:
- 分布式:Topic 切成多个分区(Partition),分布在不同 Broker 上,并行读写;
- 高吞吐:顺序写磁盘 + 页缓存 + 零拷贝,单机可扛每秒百万条消息;
- 副本容错:每个分区多副本(Leader + Follower),Broker 宕机自动选举续写;
- 可靠语义:ACK 机制(0/1/all)与 Offset 位点,保证"消息不丢、可回放"。
本节要讲的 Topic/Partition/Offset、消费者组、ACK 语义,都是围绕这个"中转站"的核心机制。
论文出处:Kreps et al., "Kafka", NetDB 2011——Apache Kafka 的分布式日志管道设计。
print('''Kafka 组件:
  Topic  :逻辑消息类别(如 user_click);
  Partition:Topic 的物理分片(并行单位,一个分区内有序);
  Offset :分区内消息的序号(从 0 开始);
  Broker :服务器节点(存分区副本);
  Producer / Consumer:生产者 / 消费者;
  Consumer Group:一组消费者协作消费一个 Topic(组内互斥、组间广播)。

为什么用 Kafka:解耦(上游不用管下游)、削峰(缓冲)、
              顺序性(分区内)、持久化(落盘可回放)。
''')
Kafka 组件:
  Topic  :逻辑消息类别(如 user_click);
  Partition:Topic 的物理分片(并行单位,一个分区内有序);
  Offset :分区内消息的序号(从 0 开始);
  Broker :服务器节点(存分区副本);
  Producer / Consumer:生产者 / 消费者;
  Consumer Group:一组消费者协作消费一个 Topic(组内互斥、组间广播)。

为什么用 Kafka:解耦(上游不用管下游)、削峰(缓冲)、
              顺序性(分区内)、持久化(落盘可回放)。
📐 公式推导:Kafka 分区路由与可靠性¶
分区路由(无指定 key 时轮询,指定 key 时哈希取模;$P$ 为分区数):
$$ \mathrm{partition} = \mathrm{hash}(\mathrm{key}) \bmod P $$
同一 key 保证有序:相同 key 永远进同一分区 → 分区内有序(FIFO);跨分区不保证全局有序。
可靠性三档(acks):生产者发送后等待确认的程度,权衡"不丢"与"延迟":
$$ ack \in \{0,\ 1,\ -1\}: \quad \text{0=不等确认(可能丢)}, \quad \text{1=leader 落盘即确认}, \quad \text{-1=ISR 全部落盘才确认} $$
推导要点:① 分区数 = 并行度上限:$\text{吞吐}_{\max} \approx P \times \text{单分区吞吐}$;② 副本因子 $R$ 与可用性:ISR(In-Sync Replica)至少一个存活才可写入,min.insync.replicas 设 2 + acks=-1 是"不丢消息"的工业标配;③ 关键点:分区数定了再加会破坏 key 路由(hash 桶数变了,历史 key 全错位)——这也是面试常见坑。
2️⃣ 分区与消息写入(模拟)¶
# 🖼️ 配图:Kafka 架构——生产者→Broker 分区→消费者组
fig, ax = plt.subplots(figsize=(8.5, 4.2))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 5)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2, color='#64748b'):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color=color, lw=1.6))

box(0.4, 3.6, 1.8, 1.1, '生产者\n(app1/app2)', '#e2e8f0')
box(5.4, 3.6, 2.6, 1.1, 'Broker(主题 topic)\n分区0 | 分区1 | 分区2\n(每分区有序+副本)', '#bfdbfe')
box(7.6, 1.2, 2.1, 1.4, '消费者组\n消费者1\n消费者2', '#bbf7d0')
arrow(2.3, 4.1, 5.3, 4.1)
arrow(7.3, 3.8, 7.6, 2.2); arrow(7.3, 3.4, 8.4, 2.6)
ax.text(3.8, 4.55, '写入:key 哈希 → 分区', fontsize=9, color='#475569')
ax.text(8.0, 0.7, '同一分区内有序;\n消费者组内平分分区', fontsize=8.5, ha='center', color='#475569')
plt.title('Kafka:分区=并行单元,消费者组=消费水平扩展', fontsize=11)
plt.show()
print('➡️ 面试:分区数=并行度上限;加分区会破坏 key 路由(历史数据错位)')
➡️ 面试:分区数=并行度上限;加分区会破坏 key 路由(历史数据错位)
C:\Users\24260\AppData\Local\Temp\ipykernel_48348\4220200079.py:21: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 模拟 3 分区,消息按 key 哈希路由到分区
n_part = 3
msgs = [('u1', 'click'), ('u2', 'view'), ('u1', 'buy'), ('u3', 'click'), ('u2', 'search'), ('u1', 'view')]
partitions = [[] for _ in range(n_part)]
for key, val in msgs:
    p = hash(key) % n_part
    partitions[p].append((key, val, len(partitions[p])))   # (key, val, offset)
for i, p in enumerate(partitions):
    print(f'分区{i}: {p}')
print('\n➡️ 相同 key(同用户)会被路由到同一分区 -> 该用户消息有序');
assert all(len(p) >= 0 for p in partitions)
print('✅ 分区路由演示完成')
分区0: []
分区1: [('u1', 'click', 0), ('u1', 'buy', 1), ('u3', 'click', 2), ('u1', 'view', 3)]
分区2: [('u2', 'view', 0), ('u2', 'search', 1)]

➡️ 相同 key(同用户)会被路由到同一分区 -> 该用户消息有序
✅ 分区路由演示完成
3️⃣ 消费者组与偏移量(模拟)¶
✍️ §3.1 手算 Kafka 消费滞后:lag = 最新位移 − 消费位移¶
消费滞后 $\text{lag}=\text{log-end offset}-\text{consumer offset}$——分区级手算,看懂"消费者追不上生产者"怎么量化。
设定:分区 0 最新位移 100、消费者组已消费 80。
$$\text{lag}=100-80=\mathbf{20}$$
3 个分区总 lag:[20, 0, 35] → 总和 55。
手算收获:
- lag 是"积压的消息条数":>0 说明消费者跟不上,lag 持续增长 = 系统告警信号(实时性恶化)
- 分区内有序(§6 追问 1):lag 只在分区层面有意义——总 lag = 各分区 lag 求和(本例 55)
- 消费者组扩缩容(§4 重平衡):加消费者平分分区 → 各分区 lag 变小,但分区数 ≥ 消费者数才有意义
- 可靠性旁支(§5):acks=1/all 影响的是"不丢消息",与 lag 是两条线——lag 管实时、acks 管可靠
下面 numpy 复算。
# ---- §3.1 验证:numpy 复算 Kafka lag ----
latest, consumed = 100, 80
lag = latest - consumed
lags = [20, 0, 35]
print(f'分区0 lag = {lag},3 分区总 lag = {sum(lags)}')
assert lag == 20 and sum(lags) == 55
print('\n✓ 与手算一致')
# 消费者组:3 个消费者平分 3 个分区(每个消费者一个分区)
consumers = {f'consumer-{i}': [i] for i in range(n_part)}
# 消费进度:记录每个分区已消费的 offset
offsets = {i: 0 for i in range(n_part)}
consumed = {f'consumer-{i}': [] for i in range(n_part)}

# 模拟消费:各消费者从自己分区拉取
while True:
    progressed = False
    for i, p in enumerate(partitions):
        cname = f'consumer-{i}'
        if offsets[i] < len(p):
            key, val, ofs = p[offsets[i]]
            consumed[cname].append(val)
            offsets[i] += 1
            progressed = True
    if not progressed:
        break

for c, v in consumed.items():
    print(f'{c}: 消费 {v} (该分区已消费 offset {offsets[int(c.split("-")[1])]})')
print('\n➡️ 同一用户消息保持顺序;组内消费者各管各的分区,进度记录在 offset')
consumer-0: 消费 [] (该分区已消费 offset 0)
consumer-1: 消费 ['click', 'buy', 'click', 'view'] (该分区已消费 offset 4)
consumer-2: 消费 ['view', 'search'] (该分区已消费 offset 2)

➡️ 同一用户消息保持顺序;组内消费者各管各的分区,进度记录在 offset
4️⃣ 重平衡(Rebalance)演示¶
# 5 个分区、3 个消费者时的分配(简化 round-robin)
n_part5, n_cons3 = 5, 3
assign = {f'c{i}': [] for i in range(n_cons3)}
for p in range(n_part5):
    assign[f'c{p % n_cons3}'].append(p)
print('5 分区 / 3 消费者 分配:')
for c, ps in assign.items():
    print(f'  {c}: 分区 {ps}')
print('''
  消费者加入/退出 -> 触发 Rebalance(分区重新分配);
  代价:rebalance 期间消费暂停、可能重复消费(需幂等/去重)。
''')
5 分区 / 3 消费者 分配:
  c0: 分区 [0, 3]
  c1: 分区 [1, 4]
  c2: 分区 [2]

  消费者加入/退出 -> 触发 Rebalance(分区重新分配);
  代价:rebalance 期间消费暂停、可能重复消费(需幂等/去重)。
5️⃣ 可靠性:ACK 与副本¶
print('''生产者 acks 三档:
  acks=0:不等确认(最快,可能丢);
  acks=1:leader 落盘即确认(默认,丢 leader 时可能丢);
  acks=all:全部 ISR 副本确认(最稳,慢)。

消费者语义:
  At-most-once :可能丢(offset 先提交);
  At-least-once:可能重(offset 后提交 + 重试);
  Exactly-once :幂等写入 + 事务(Kafka 支持)。

可靠性组合拳:3 副本 + acks=all + 消费端幂等去重。
''')
生产者 acks 三档:
  acks=0:不等确认(最快,可能丢);
  acks=1:leader 落盘即确认(默认,丢 leader 时可能丢);
  acks=all:全部 ISR 副本确认(最稳,慢)。

消费者语义:
  At-most-once :可能丢(offset 先提交);
  At-least-once:可能重(offset 后提交 + 重试);
  Exactly-once :幂等写入 + 事务(Kafka 支持)。

可靠性组合拳:3 副本 + acks=all + 消费端幂等去重。
6️⃣ Kafka 面试高频追问¶
print('''1) 分区顺序 vs 全局顺序? -> 只保证分区内有序,要全局有序只能 1 分区(牺牲并行);
2) 消息积压怎么办?       -> 扩分区+扩消费者、批量消费、临时降级;
3) 消费速度跟不上?       -> 增加消费者(≤分区数)、优化反序列化、批量;
4) 数据重复消费?         -> 幂等(唯一键去重)或事务;
5) Kafka vs RocketMQ?    -> 吞吐/顺序/事务侧重不同;
6) 为什么高吞吐?         -> 顺序写磁盘、零拷贝、批量/压缩。
''')
1) 分区顺序 vs 全局顺序? -> 只保证分区内有序,要全局有序只能 1 分区(牺牲并行);
2) 消息积压怎么办?       -> 扩分区+扩消费者、批量消费、临时降级;
3) 消费速度跟不上?       -> 增加消费者(≤分区数)、优化反序列化、批量;
4) 数据重复消费?         -> 幂等(唯一键去重)或事务;
5) Kafka vs RocketMQ?    -> 吞吐/顺序/事务侧重不同;
6) 为什么高吞吐?         -> 顺序写磁盘、零拷贝、批量/压缩。
📝 自测清单¶
- 能画出 Topic/Partition/Offset/Broker 结构
- 能手写 key 哈希分区路由
- 能解释消费者组与重平衡
- 能对比 acks 三档与消费三语义
- 能答 6 个 Kafka 追问