🚀 06 · PPO 与 GRPO:策略梯度的工程形态(也是 LLM 对齐的底座)¶
面试定位:PPO(Proximal Policy Optimization) 是 RL 工程事实标准,更是 RLHF/LLM 对齐 的核心; GRPO 是 DeepSeek 在强化学习(R1)中采用的简化版。算法岗+LLM 岗双考。 本篇手写 clip 目标的数值实验,并把 PPO/GRPO 的 LLM 版公式讲透。 标记:🔴 必背。
1. PPO 要解决的问题(🔴)¶
朴素的策略梯度(REINFORCE)的问题¶
更新一步后策略变了 → 采样的轨迹分布过时 → 用旧分布估计新策略梯度有偏。 幅度大时直接崩(坍塌:策略变坏、数据浪费、难以恢复)。
TRPO 的解法(🟡 概念)¶
TRPO 用约束限制每步策略变化:
$$\max_\theta \mathbb{E}_{s,a\sim\pi_{\theta_{\text{old}}}} \left[\frac{\pi_\theta(a|s)}{\pi_{\theta_{\text{old}}}(a|s)} A(s,a)\right] \quad \text{s.t.} \quad \mathbb{E}\left[\mathrm{KL}(\pi_{\theta_{\text{old}}} \| \pi_\theta)\right] \le \delta$$
- 每步只允许策略"挪动一点点" → 单调改进保证(理论上)
- 缺点:KL 约束 + 共轭梯度求解复杂
PPO 的工程化(🔴)¶
把"约束"换成"裁剪(clip)惩罚",一行搞定:
$$L^{CLIP}(\theta) = \mathbb{E}\left[ \min\left( r_t(\theta) A_t,\; \operatorname{clip}(r_t(\theta), 1-\varepsilon, 1+\varepsilon)\, A_t \right) \right]$$
其中重要性权重 $r_t(\theta) = \dfrac{\pi_\theta(a_t|s_t)}{\pi_{\theta_{\text{old}}}(a_t|s_t)}$。
面试金句:PPO = TRPO 的"约束换 clip"近似——当新旧策略偏差太大($r_t$ 超出 $[1-\varepsilon, 1+\varepsilon]$)就把梯度剪掉,防止一步迈太远。
核心概念¶
(a) 🗂️ PPO 与 GRPO 知识地图¶
这篇讲策略梯度怎么工程化:用 PPO 的 clip 目标解决"步子太大摔跤"的问题,再讲它在 LLM 对齐(RLHF)里怎么用,重点包括奖励模型、KL 防漂移,以及 DeepSeek-R1 采用的 GRPO(去掉 Critic)。
flowchart TB
    Node1["🧠 朴素策略梯度的痛点"]
    Node1 --> Node2["🧠 TRPO → PPO clip"]
    Node2 --> Node3["🧠 代理目标与 GAE"]
    Node3 --> Node4["🧠 RLHF 三阶段"]
    Node4 --> Node5["🧠 奖励模型 Bradley-Terry"]
    Node5 --> Node6["🧠 KL 防漂移与奖励黑客"]
    Node3 --> Node7["🧠 GRPO 组内标准化"]
    Node7 --> Node8["🧠 DPO 对比"]
    Node3 --> Node9["🧠 PPO 训练经验坑"]
- 节点1(朴素策略梯度的痛点):REINFORCE 用一批数据更新一步后,数据就"过期"了,只能扔;而且步长太大策略会瞬间崩坏。所以需要能"复用旧数据、限制步子"的目标函数。
- 节点2(TRPO → PPO clip):TRPO 用 KL 约束保证策略更新不越界但计算重,PPO 把约束改成 clip:当新旧策略概率比 r 超出 [1−ε, 1+ε] 就截断梯度,简单高效,成了主流。
- 节点3(代理目标与 GAE):用旧策略采样的数据配重要性采样比值 r,再乘 GAE 算出的优势,形成 L = min(r·A, clip(r)·A),这就是面试要默写的 PPO 核心公式。
- 节点4(RLHF 三阶段):① SFT 微调出基础模型 → ② 训练奖励模型 → ③ 用 PPO 按奖励优化策略。目标是让模型从"会写"到"被人类喜欢"。
- 节点5(奖励模型 Bradley-Terry):人类标注"哪个回答更好",用 Bradley-Terry 排序损失训练 RM:让好回答得分高于坏回答。RM 常见问题:过拟合偏好、奖励分布不稳、容易被 hack。
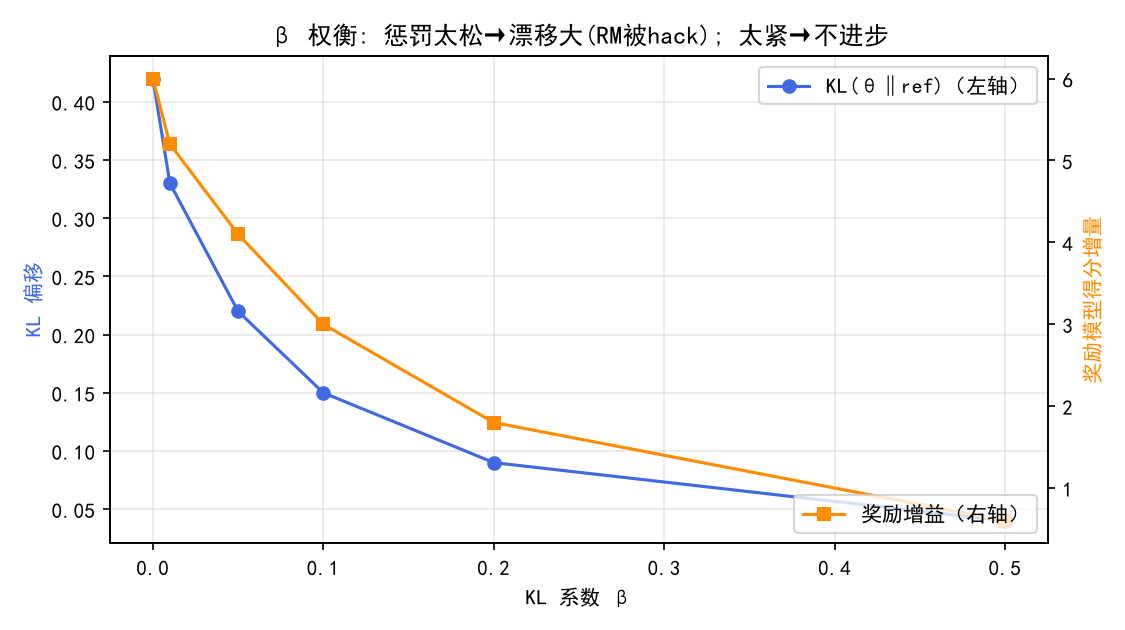
- 节点6(KL 防漂移与奖励黑客):只最大化奖励会让模型"刷漏洞"说胡话,加 KL 惩罚(相对参考模型)把策略拉住,目标 = 奖励 − β·KL,在讨好和忠实之间找平衡。
- 节点7(GRPO 组内标准化):GRPO 不给每个问题配 Critic,而是对同一个问题采 G 个回答,用组内奖励的均值/标准差标准化出优势,省掉价值网络,DeepSeek-R1 因此显存更低。
- 节点8(DPO 对比):DPO 把 RLHF 的"奖励模型 + PPO"两步化简成一次偏好损失,直接从数据里学对齐,不用跑 RL;但它和 PPO 在表达能力与稳定性上有取舍。
- 节点9(PPO 训练经验坑):clip 阈值 ε、GAE 的 λ、KL 系数 β、组大小 G 都要小心调;奖励缩放、优势标准化、多 seed 验证是工程上必须做的,也是面试常问的细节。
为什么需要"代理目标":从 TRPO 到 PPO clip 的动机链(🔴 讲透)¶
起点:普通策略梯度的步长很难设——α 大一点,策略瞬间漂太远,梯度估计作废; α 小一点,训练慢如蜗牛。TRPO 的答案:每次更新限制新旧策略的 KL 距离:
$$J_{\text{TRPO}}(\theta) = \mathbb{E}\big[\frac{\pi_\theta(a|s)}{\pi_{\theta_{old}}(a|s)} \hat{A}\big], \qquad \text{s.t. } \bar{D}_{KL}(\theta_{old}\|\theta) \le \delta$$
但 TRPO 难用(面试点):带约束优化(共轭梯度+线搜索)实现复杂、数值脆。
PPO 的答案:把"约束"变成"惩罚"——直接用 clip 截断比例项:
$$J^{\text{clip}}(\theta) = \mathbb{E}\Big[\min\big(\underbrace{r_t(\theta)}_{\pi_\theta/\pi_{\theta_{old}}} \hat{A}_t,\ \underbrace{\text{clip}(r_t(\theta), 1-\varepsilon, 1+\varepsilon)}_{\text{限幅}}\big)\hat{A}_t\Big]$$
clip 为什么等价于"信任区域"(逐情形,配合本节表格):
- $r_t$ 在 $[1-\varepsilon, 1+\varepsilon]$ 内 → 正常梯度(跟没 clip 一样)
- $r_t$ 超出且 $\hat{A}>0$ → 限幅到 $1+\varepsilon$(好动作也只能进步一点点)
- $r_t$ 超出且 $\hat{A}<0$ → 限幅到 $1-\varepsilon$(坏动作也只受有限惩罚)
- 组合效果:策略每步最多"动" $\varepsilon$ 那么远 ≈ 软性 KL 约束,但实现就是个 min
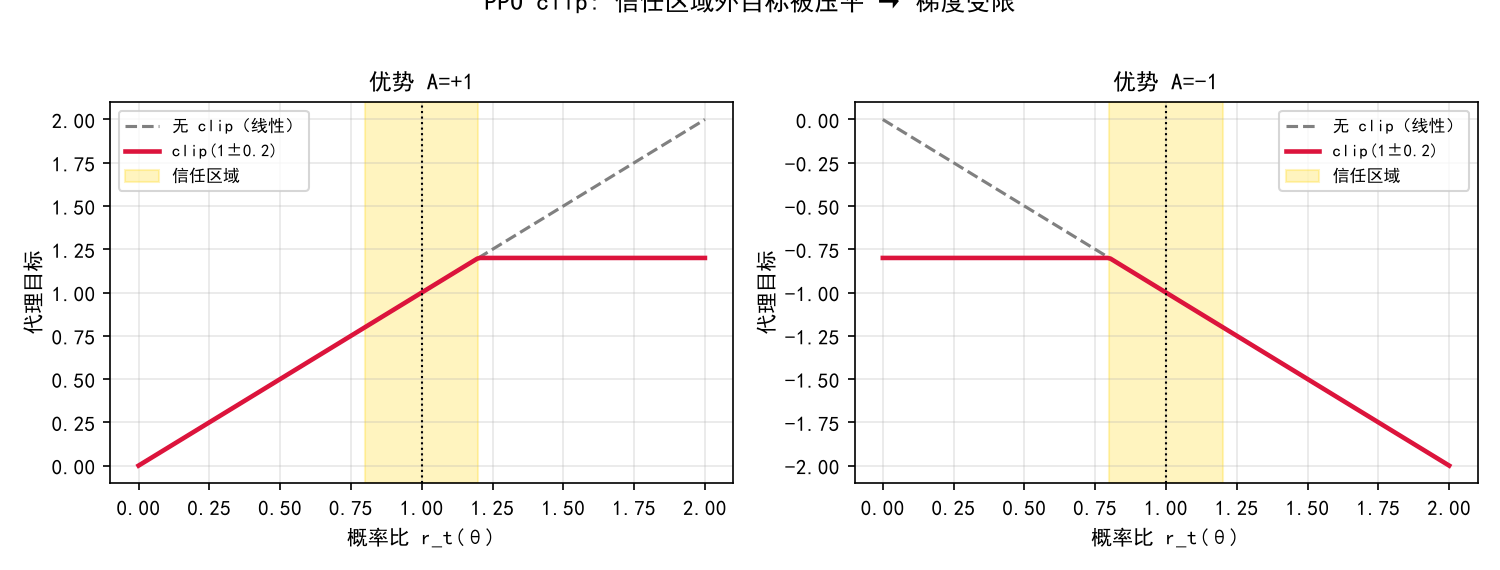
一句话:TRPO 是"先画圈再更新"(约束),PPO 是"更新时偷偷限速"(clip)—— 效果相近,PPO 实现简单十倍,所以成为事实标准。
2. clip 目标的四种情形(🔴 手画理解)¶
| 情形 | A_t | r_t 位置 | 效果 |
|---|---|---|---|
| 好动作(A>0), 概率被提升 | >0 | r>1 | 保留提升, 但限制在 1+ε 内 |
| 好动作(A>0), 概率被降低 | >0 | r<1 | 不惩罚(允许降低) |
| 坏动作(A<0), 概率被提升 | <0 | r>1 | 不阻止提升(给探索空间) |
| 坏动作(A<0), 概率被降低 | <0 | r<1 | 保留降低, 但限制在 1-ε 内 |
一句话:只裁剪"朝错误方向挪"的部分——好动作别一下升太多,坏动作别一下降太多。ε 常见 0.1~0.3。
PPO 的完整目标(三部分,背)¶
$$L(\theta) = L^{CLIP} + c_1\, L^{VF} - c_2\, S[\pi_\theta]$$
- $L^{VF}$:价值网络(Critic)的回归损失(MSE)
- $S$:熵正则(鼓励探索,防止策略过早确定)
- 熵项系数 $c_2$ 调小可提高探索性、调大更稳
GAE 是 PPO 的标配(衔接 05 篇)¶
$$\hat{A}_t = \sum_{k=0}^{T} (\gamma\lambda)^k \delta_{t+k}, \quad \delta_t = r_t + \gamma V(s_{t+1}) - V(s_t), \quad \lambda \approx 0.95$$
✍️ §2.2 手算 PPO clip:ratio 三段取值与何时裁剪(附 GRPO 组内优势)¶
§2 表格只给方向,这里给数字算一遍:固定 $\pi_{\text{old}}=0.6$,换三个 $\pi_{\text{new}}$ 造出 ratio 的三段取值($<1-\varepsilon$、$[1-\varepsilon,1+\varepsilon]$、$>1+\varepsilon$),把 $\min$ 目标四个格子全算出来,再看 GRPO 的组内优势。
设定:$\varepsilon=0.2$,裁剪区间 $[1-\varepsilon,\ 1+\varepsilon]=[0.8,\ 1.2]$;$\pi_{\text{old}}(a|s)=0.6$,优势取 $A=\pm2$。
第 1 步:ratio 三段取值($r=\pi_{\text{new}}/\pi_{\text{old}}$):
| 场景 | $\pi_{\text{old}}\to\pi_{\text{new}}$ | ratio $r$ | $\text{clip}(r,0.8,1.2)$ | 所在区间 |
|---|---|---|---|---|
| A | $0.6\to0.4$ | $0.4/0.6=0.6667\ (=\tfrac23)$ | 0.8000 | 下界外($r<0.8$) |
| B | $0.6\to0.7$ | $0.7/0.6=1.1667\ (=\tfrac76)$ | 1.1667 | 区间内(不裁剪) |
| C | $0.6\to0.8$ | $0.8/0.6=1.3333\ (=\tfrac43)$ | 1.2000 | 上界外($r>1.2$) |
第 2 步:clip 目标四情形($L=\min(rA,\ \text{clip}(r)A)$——注意 $\min$ 作用在乘积上,不是 ratio 上):
| 场景 | $r$ | $A=+2$(好动作) | $A=-2$(坏动作) |
|---|---|---|---|
| A(下界外) | 0.6667 | $L=\min(1.3333,\ 1.6000)=1.3333$($rA$,不裁剪) | $L=\min(-1.3333,\ -1.6000)=-1.6000$(clip,裁剪生效) |
| B(区间内) | 1.1667 | $L=2.3333$(不裁剪) | $L=-2.3333$(不裁剪) |
| C(上界外) | 1.3333 | $L=\min(2.6667,\ 2.4000)=2.4000$(clip,裁剪生效) | $L=\min(-2.6667,\ -2.4000)=-2.6667$($rA$,不裁剪) |
规律(对应 §2 表格四行):裁剪只压"朝错误方向挪"的两格——好动作涨太快被 $1+\varepsilon$ 封顶、坏动作跌太狠被 $1-\varepsilon$ 兜底;而"好动作降概率""坏动作涨概率"两格放行(给探索留门)。裁剪生效时 $L$ 对 $r$ 平坦(饱和区梯度 $=0$)→ 每步最多承认 $\pm20\%$ 的概率变化,这就是"软性信任区域"。
第 3 步(附):GRPO 组内优势——4 个回答的奖励归一化。同一 prompt 采 4 个回答,奖励 $r=[2.0,\ 1.0,\ 0.0,\ 1.0]$:
$$\mu=\frac{2+1+0+1}{4}=1.0,\qquad \sigma^2=\frac{(2-1)^2+0^2+(0-1)^2+0^2}{4}=0.5,\qquad \sigma=\sqrt{0.5}=0.7071$$
$$\hat A_i=\frac{r_i-\mu}{\sigma}=[1.4142,\ 0,\ -1.4142,\ 0]$$
第 1 个回答 $r=2.0$ 比组内平均高 → 优势 $+1.4142$(概率被抬);第 3 个 $r=0$ → 优势 $-1.4142$(概率被压);其余两个贴着平均线 → $0$。这就是去 Critic 的"相对好坏"信号——注意 $\sigma=0$ 时(G 个奖励全等)无法标准化,实现要加 $\varepsilon$ 防除零。
手算收获:
- ratio 是"概率比"不是"目标比":$r=\pi_{\text{new}}/\pi_{\text{old}}$,三个场景共用 $\pi_{\text{old}}=0.6$,比的就是 $\pi_{\text{new}}$ 动了多少——PPO 靠 $r$ 限制"一步动多远"
- $\min(rA,\ \text{clip}(r)A)$ 的 $\min$ 必须在乘积上做:$A<0$ 时(场景 A 坏动作)若写成 $\min(r,\text{clip})\cdot A$ 会得到 $-1.3333$ 而非正确的 $-1.6000$——这是实现里最常见的 bug
- 裁剪生效 = 目标饱和(对 $r$ 的梯度为 0):好动作最多 $\times1.2$、坏动作最多 $\div0.8$ 一步——TRPO 的硬约束被这个"软限速"替代,实现只是一个 min
- GRPO 把"绝对分数"换成"组内排名位置":减 $\mu$ 消掉题目难度偏置、除 $\sigma$ 统一尺度(跨 prompt 可比);代价是必须同 prompt 分组且 $G\ge2$
下面 numpy 复算。
# ---- §2.2 验证:numpy 复算 PPO clip 与 GRPO 优势 ----
import numpy as np

eps = 0.2
lo, hi = 1 - eps, 1 + eps
print(f'clip 区间 = [{lo}, {hi}](ε={eps})')

# 三段 ratio(π_old = 0.6 固定)
p_new = np.array([0.4, 0.7, 0.8])
r = p_new / 0.6
c = np.clip(r, lo, hi)
print('场景 | π_new | ratio r | clip(r)')
for i, name in enumerate('ABC'):
    print(f'  {name}    | {p_new[i]:.1f}    | {r[i]:.4f} | {c[i]:.4f}')
assert np.allclose(r, [2 / 3, 7 / 6, 4 / 3]) and np.allclose(c, [0.8, 7 / 6, 1.2])

# clip 目标四情形: L = min(r·A, clip(r)·A)
print('\nclip 目标四情形 (A=+2 / A=-2):')
for i, name in enumerate('ABC'):
    Lp = min(r[i] * 2.0, c[i] * 2.0)
    Ln = min(r[i] * -2.0, c[i] * -2.0)
    clip_p = '裁剪生效' if abs(c[i] - r[i]) > 1e-9 and c[i] * 2.0 <= r[i] * 2.0 else '不裁剪'
    clip_n = '裁剪生效' if abs(c[i] - r[i]) > 1e-9 and c[i] * -2.0 <= r[i] * -2.0 else '不裁剪'
    print(f'  {name}: A=+2 → L={Lp:.4f} ({clip_p});   A=-2 → L={Ln:.4f} ({clip_n})')
assert abs(min(r[0] * 2.0, c[0] * 2.0) - 4 / 3) < 1e-9     # 1.3333
assert abs(min(r[2] * 2.0, c[2] * 2.0) - 2.4) < 1e-9       # 2.4000
assert abs(min(r[0] * -2.0, c[0] * -2.0) + 1.6) < 1e-9     # -1.6000
assert abs(min(r[2] * -2.0, c[2] * -2.0) + 8 / 3) < 1e-9   # -2.6667

# GRPO 组内优势
rew = np.array([2.0, 1.0, 0.0, 1.0])
mu, sd = rew.mean(), rew.std()
adv = (rew - mu) / sd
print(f'\nGRPO: rewards={rew},  μ={mu:.4f},  σ={sd:.4f},  A={np.round(adv, 4)}')
assert abs(mu - 1.0) < 1e-9 and abs(sd - np.sqrt(0.5)) < 1e-9
assert np.allclose(adv, [np.sqrt(2), 0, -np.sqrt(2), 0], atol=1e-9)
print('\n✓ 与手算一致:三段 ratio、四情形 clip 目标、GRPO 组内优势全部对上')
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# ppo_clip_demo.py —— clip 目标数值演示: 对比 clip 前后梯度信号
import numpy as np

def ppo_clip_loss(r, A, eps=0.2):
    """r: 新旧策略概率比 πθ/πold  (向量);  A: 优势 (向量)"""
    surr1 = r * A
    surr2 = np.clip(r, 1 - eps, 1 + eps) * A
    return np.minimum(surr1, surr2)

# 场景: 好动作 A=1, 坏动作 A=-1, 分别看不同概率比 r 下的 loss
A_good, A_bad = 1.0, -1.0
rs = np.array([0.5, 0.8, 1.0, 1.2, 1.5, 2.0])   # 概率比从降一半到翻倍

print(f"{'r(概率比)':<10}{'clip前(A=1)':>14}{'clip后(A=1)':>14}{'clip前(A=-1)':>15}{'clip后(A=-1)':>15}")
for r in rs:
    raw_g = r * A_good
    cl_g = ppo_clip_loss(np.array([r]), np.array([A_good]))[0]
    raw_b = r * A_bad
    cl_b = ppo_clip_loss(np.array([r]), np.array([A_bad]))[0]
    print(f'{r:<10.2f}{raw_g:>14.3f}{cl_g:>14.3f}{raw_b:>15.3f}{cl_b:>15.3f}')

print()
print('观察: r=2.0 时 clip 后(A>0)梯度被压在 1.2 封顶; (A<0)时 r 升高不惩罚')
print('→ 对称地, r=0.5 时 A<0 的下降被限制在 0.8 下限 —— 防止一步过头')
r(概率比)        clip前(A=1)    clip后(A=1)    clip前(A=-1)    clip后(A=-1)
0.50               0.500         0.500         -0.500         -0.800
0.80               0.800         0.800         -0.800         -0.800
1.00               1.000         1.000         -1.000         -1.000
1.20               1.200         1.200         -1.200         -1.200
1.50               1.500         1.200         -1.500         -1.500
2.00               2.000         1.200         -2.000         -2.000

观察: r=2.0 时 clip 后(A>0)梯度被压在 1.2 封顶; (A<0)时 r 升高不惩罚
→ 对称地, r=0.5 时 A<0 的下降被限制在 0.8 下限 —— 防止一步过头
3.1 RLHF 三阶段精讲:从"会写"到"被喜欢"(🔴 LLM 岗必背)¶
本节导读:RLHF 把 LLM 从"接续文本"训练成"讨人喜欢"。三阶段 SFT → RM → RL 环环相扣,每一阶段的训练目标、数据来源、模型都不同。 这一节把整条流水线讲成一张可复述的图。
1. 阶段总览(背三行):
SFT(监督微调): 用高质量指令数据,学"会回答"
RM(奖励模型):  用人类偏好对,学"什么好"
RL(PPO/GRPO):  用奖励信号调策略,学"说得更好"
2. 各阶段细节(逐个讲):
- SFT:标准交叉熵微调(04-LLM 篇有实现)。产出 π_ref(后续做参考)
- RM:同样从 SFT 起步,被改造:输入 (prompt, response) → 输出一个标量 奖励分。数据 = 人类标注的两两比较 $(y_w \succ y_l)$;损失 = Bradley- Terry 对数似然(§9 推导)。奖励模型不参与推理,只当"裁判"
- RL:策略从 SFT 初始化,采样回答 → RM 打分 → 用 PPO(或 GRPO) 更新。目标里带 KL 惩罚(§10),防止策略漂出人类语言区
3. 为什么要"三阶段"而不是端到端(推导级理解):
- 人类偏好只能给相对比较(两两排序),不能直接给可微分的分数
- RM 把"无序的偏好"压缩成"可微的分数",RL 才有梯度可用
- SFT 提供"语言能力"底座,RL 只在上面调"偏好方向"——分而治之, 每阶段数据都好造、损失都好训
4. 关键数字(背):RM 训练数据常用几十万~上百万偏好对;RL 阶段 KL 系数 β 通常 0.01~0.1;PPO 里 reward = RM 分 - β·KL(ref‖π)。
5. 易错点:
- RM 输出是相对分数(用于比较),绝对值无意义
- RL 阶段策略基数 = SFT 模型(不是 RM);RM 只打分不更新
- KL 惩罚的参考对象是 SFT 策略(π_ref),不是当前策略
6. 面试问法:"RLHF 三阶段各是什么?" → "SFT 学语言、RM 学偏好、 RL(PPO/GRPO)学讨喜;重难点在 RM 的成对偏好建模与 RL 的 KL 防漂移。"
3. PPO 在 LLM(RLHF)中怎么用(🔴 LLM 岗必背)¶
RLHF 三阶段(背)¶
① 监督微调 SFT         : 用人工标注问答对训练基础模型
② 奖励建模 RM          : 用"人类偏好对"训练奖励模型 r_φ(x, y)(Bradley-Terry 排序损失)
③ PPO 优化             : 把语言模型当策略 π_θ, 生成 y ~ π_θ(·|x), 用 RM 打分做奖励
LLM 版 PPO 目标(核心公式,背)¶
$$L(\theta) = \mathbb{E}_{(x,y)\sim\mathcal{D}}\Big[\underbrace{\min\big(r_t A_t,\; \operatorname{clip}(r_t, 1-\varepsilon, 1+\varepsilon) A_t\big)}_{\text{策略损失}} \; -\; \beta\,\underbrace{\mathrm{KL}\big(\pi_\theta \;\|\; \pi_{\text{SFT}}\big)}_{\text{与 SFT 模型不漂移}} \Big]$$
- 奖励 = 奖励模型分数 $r_\phi(x,y)$(可加长度/安全惩罚)
- KL 项($\beta$ 系数)防止模型为了迎合奖励模型说胡话/崩坏(reward hacking)
- 优势 $A_t$ 由 Critic 对整个句子的 Q 值给出(token 级 GAE)
为什么 LLM 训练不用普通 RL 环境(背)¶
LLM 的"状态"是已生成的 token 序列,"动作"是下一个 token,环境是词表 + 奖励模型——每步奖励只在句末给出(稀疏),中间靠 GAE 把句末奖励回传给每一步的 token。
# rlhf_kl_demo.py —— KL 正则的效果: 无 KL 会"刷爆"奖励模型漏洞(数值示意)
import numpy as np

# 模拟: 策略 π 在 4 个 token 上的分布 vs 参考(SFT)分布
pi_ref = np.array([0.4, 0.3, 0.2, 0.1])
np.random.seed(0)

# 无 KL 约束: 策略完全迎合奖励, 可能畸形(如死循环输出高奖励 token)
pi_greedy = np.array([0.99, 0.005, 0.004, 0.001])

def kl(p, q):
    return float(np.sum(p * np.log(p / q)))

def reward(pi):
    """奖励模型: 倾向 token0 (即模型发现 token0 给高分)"""
    return float(pi[0] * 10)

print(f'参考策略: 奖励 {reward(pi_ref):.2f}')
print(f'无 KL 约束策略: 奖励 {reward(pi_greedy):.2f}, 与参考 KL = {kl(pi_greedy, pi_ref):.3f}')
print('→ 分数高但分布极度偏离参考 → 输出退化成重复话术 (reward hacking)')
print()
# 带 KL 惩罚: 目标 = 奖励 - β·KL, 找平衡
betas = [0.0, 0.5, 1.0]
for b in betas:
    obj = reward(pi_greedy) - b * kl(pi_greedy, pi_ref)
    print(f'β={b}: 优化目标(奖励-βKL) = {obj:.3f}')
print('→ β 越大越守住参考分布; 实际训练中 β 是 KL 系数(0.01~0.1 量级, 且随训练调)')
参考策略: 奖励 4.00
无 KL 约束策略: 奖励 9.90, 与参考 KL = 0.856
→ 分数高但分布极度偏离参考 → 输出退化成重复话术 (reward hacking)

β=0.0: 优化目标(奖励-βKL) = 9.900
β=0.5: 优化目标(奖励-βKL) = 9.472
β=1.0: 优化目标(奖励-βKL) = 9.044
→ β 越大越守住参考分布; 实际训练中 β 是 KL 系数(0.01~0.1 量级, 且随训练调)
GRPO:为什么敢去掉 Critic(🔴 DeepSeek-R1 核心)¶
PPO 的成本分布:一个 Critic 网络(价值函数)就要跟策略一般大的显存; LLM 参数巨大时,Critic 常常成为训练瓶颈。
GRPO 的替代(组内相对优势,完全不用价值网络):
- 对同一个 prompt 采样 G 个回答(组)
- 每个回答的奖励 $r_1,\dots,r_G$ 做组内标准化: $$\hat{A}_i = \frac{r_i - \text{mean}(r_1,\dots,r_G)}{\text{std}(r_1,\dots,r_G)}$$
- 用 $\hat{A}_i$ 当优势跑 PPO 式更新——基线 = 组内平均,而不是价值网络
为什么"组内标准化"是合法的基线(面试推导):
- 策略梯度的基线只要不依赖当前动作就不引入偏差:$\mathbb{E}[\nabla\log\pi \cdot b(s)]=0$
- 组内均值/标准差对所有回答是"同一批"的统计量 → 对第 $i$ 个回答,它基本是常数 (严格说组统计量依赖全体,偏差很小但工程上可接受)
- 收益:省掉整个 Critic 的显存,且同一 prompt 的组内比较天然对齐了 "这个回答在这一题里排第几"——比绝对分数更稳定
记忆:GRPO = PPO − Critic + 组内相对优势;R1 用它把 RL 训练推进到 超长推理链,是"省显存 + 相对比较更稳"两个动机的联合胜利。
4. GRPO:去 Critic 的 PPO 变体(🔴 DeepSeek-R1 用)¶
问题¶
PPO 需要 Critic(价值网络)——大模型上训练一个价值网络昂贵且不稳定(价值估计噪声大)。
GRPO 的核心思想(背)¶
用一组采样输出的经验均值替代 Critic 估计基线:
$$\hat{A}_i = \frac{r_i - \operatorname{mean}(r_1, \dots, r_G)}{\operatorname{std}(r_1, \dots, r_G)}$$
对同一问题 $x$ 采样 $G$ 个回答 $y_1..y_G$,用这 $G$ 个奖励的标准化得分当优势:
- 去掉价值网络 → 省一半训练开销(R1 训练成本核心来源之一)
- 组内相对比较 = 奖励模型的"偏好"本质(排序而非绝对值)
GRPO 目标(背)¶
$$L(\theta) = \mathbb{E}\Big[\frac{1}{G}\sum_{i=1}^{G} \min\big(r_i \hat{A}_i,\; \operatorname{clip}(r_i, 1-\varepsilon, 1+\varepsilon)\hat{A}_i\big)\Big] - \beta\, \mathrm{KL}(\pi_\theta \| \pi_{\text{ref}})$$
$r_i = \dfrac{\pi_\theta(y_i|x)}{\pi_{\text{ref}}(y_i|x)}$ 是策略与参考模型的概率比(不是与 old 策略比,GRPO 省了重要性采样里的 old 快照,参考模型固定)。
PPO vs GRPO(🔴 面试对比表)¶
| 维度 | PPO(RLHF) | GRPO(DeepSeek R1) |
|---|---|---|
| 基线/优势 | Critic 价值网络 | 组内奖励标准化(无 Critic) |
| 训练开销 | 高(价值网络大) | 低(省一路) |
| 方差控制 | GAE 多步 | 组内 G 越大越稳 |
| 适用 | 通用 RL | 奖励模型可批量的生成任务(LLM 对齐) |
| 出处 | OpenAI/RLHF | DeepSeekMath / R1 论文 |
# grpo_advantage.py —— GRPO 组内标准化优势 vs PPO 的 Critic 优势: 数值对比
import numpy as np

np.random.seed(4)
# 同一问题采样 4 个回答, 奖励模型打分
rewards = np.array([7.0, 3.5, 9.0, 5.5])

# GRPO: 组内标准化
mean, std = rewards.mean(), rewards.std()
adv_grpo = (rewards - mean) / (std + 1e-6)

# 模拟 PPO: 用(理想)Critic 估计基线(这里假设 Critic 估计每个 x 的期望价值)
critic_baseline = np.array([6.0, 6.0, 6.0, 6.0])   # 理想 Critic 给同一基线
adv_ppo = rewards - critic_baseline

print('奖励模型打分:', rewards)
print('GRPO 优势(标准化):', np.round(adv_grpo, 3))
print('PPO 优势(Critic基线):', np.round(adv_ppo, 3))
print()
print('共同点: 都是"相对好坏"信号(正=比平均好, 负=比平均差)')
print('差异: GRPO 用组内均值/方差, 天然有尺度无关性; PPO 依赖 Critic 估计质量')
奖励模型打分: [7.  3.5 9.  5.5]
GRPO 优势(标准化): [ 0.372 -1.364  1.364 -0.372]
PPO 优势(Critic基线): [ 1.  -2.5  3.  -0.5]

共同点: 都是"相对好坏"信号(正=比平均好, 负=比平均差)
差异: GRPO 用组内均值/方差, 天然有尺度无关性; PPO 依赖 Critic 估计质量
5. PPO 训练的经验坑(工程向背诵)¶
- clip ε 太小 → 学得慢;太大 → 接近 TRPO 难题(建议 0.2 起步)
- GAE λ 调小(如 0.9)方差小但偏差大,生成类任务常用 0.95~0.99
- 价值网络过拟合 → PPO 变慢;用 Value Clipping(价值损失也 clip)或减小 Critic 学习率
- 奖励归一化(均值 0 方差 1)→ 稳定;奖励模型分数分布不一致时尤其重要
- KL 惩罚是硬约束还是软惩罚:PPO-kl 有 penalty/adaptive 两种;自适应版本(目标 KL 内调 β)更稳
- batch 与 mini-batch:一版数据内多次 epoch 更新(3~10 epoch),每次 mini-batch 采样
面试追问速答¶
- Q: PPO 和 TRPO 区别? A: TRPO 用硬 KL 约束+共轭梯度;PPO 用 clip 惩罚目标,简单高效。
- Q: clip 为什么能防崩塌? A: 概率比超出 [1-ε,1+ε] 时梯度被截断 → 单步更新幅度有界。
- Q: LLM 的 KL 项放哪? A: 目标函数里 -β·KL(πθ‖πref),约束生成分布不偏离 SFT 太远。
- Q: GRPO 为什么去 Critic? A: 大模型价值网络贵且噪声大;组内奖励标准化提供免训练基线。
- Q: 熵项作用? A: 防止策略坍缩成确定性、鼓励探索;LLM 中对应保持生成多样性。
6. 自测清单¶
- L1:默写 PPO clip 目标与重要性权重公式
- L1:画 clip 目标四象限(好/坏动作 × 升/降概率)
- L1:说出 RLHF 三阶段与 LLM 版目标里的 KL 项作用
- L2:对比 PPO 与 GRPO 的优势计算(Critic vs 组内标准化)
- L2:解释 GAE 公式与 λ 的偏差-方差旋钮
下一篇
07-连续控制DDPG与SAC+08-探索利用:完整覆盖面试剩余高频。
7.1 PPO 两种变体精讲:clip 与 KL 惩罚(🟡 掌握差异)¶
本节导读:PPO 有两个官方版本:clip 版(截断比例,主流)与 KL 惩罚版(自适应 β)。理解两者的等价意图,才能回答"什么时候选谁"。
1. 同一目标的两副面孔(对比): $$\text{clip: } \min\big(r_t\hat A_t,\ \text{clip}(r_t,1\pm\varepsilon)\hat A_t\big)$$ $$\text{KL: } \mathbb{E}\big[r_t\hat A_t - \beta\,\text{KL}(\pi_{\theta_{old}}\|\pi_\theta)\big],\quad \beta \text{ 自适应}$$
- clip:硬性限制比例 r 的移动范围(每步最多动 ε)
- KL:软性惩罚新旧策略距离(β 大 = 罚得狠)
2. 自适应 β 的机制(KL 版核心):设定目标 KL 值 d_targ(如 0.01): $$\beta \leftarrow \beta \times 1.5\ (\text{若 } d > 1.5\,d_{\text{targ}}),\qquad \beta \leftarrow \beta \div 1.5\ (\text{若 } d < d_{\text{targ}}/1.5)$$ → β 自动调:偏离大了罚更重,偏离小了放宽。这就是"PID 式纪律"。
3. 两者关系(推导直觉):KL 约束近似于"把 r 限制在 [1-ε, 1+ε]"。 直观地:$r_t\approx 1+\frac{1}{2}(\text{二次项})$…… 对软/硬约束,clip 更 好实现、无 β 超参;KL 版更平滑、易与"显式 KL 控制"需求对接。
4. 实践选择(背):
- 默认用 clip(ε=0.2):少一个超参、实现稳
- 需要明确控制"每步偏离多远"(对齐场景、审计)→ KL 版
- 训练不稳时:先用 KL 版诊断 β 变化,再回 clip 调 ε
5. 易错点:
- 两个版本不能同时用(重复限制反而伤样本效率)
- KL 要算新旧策略的 KL(非参考模型)——GRPO/RLHF 的 KL 是另一回事
6. 面试问法:"PPO clip 和 KL 版区别?" → "硬截断比例 vs 软惩罚距离; clip 无 β 超参更常用,KL 版 β 自适应、适合显式控制偏离的场景。"
7. PPO 的两种变体:clip 版与 KL 惩罚版(🟡 掌握差异)¶
PPO1: KL 惩罚¶
$$L = \mathbb{E}\left[ \frac{\pi_\theta}{\pi_{\theta_{old}}} A_t \right] - \beta\, \mathrm{KL}(\pi_{\theta_{old}} \| \pi_\theta)$$
- 惩罚项限制步长;β 可自适应(目标 KL 与实际 KL 比较后调 β)
PPO2: clip(主流)¶
$$L = \mathbb{E}\left[\min(r_t A_t,\; \operatorname{clip}(r_t, 1-\varepsilon, 1+\varepsilon) A_t)\right]$$
- 不用算 KL,只需概率比 → 常是默认选择
对比(背)¶
| PPO-KL | PPO-clip | |
|---|---|---|
| 约束方式 | 软惩罚 | 硬裁剪 |
| 实现 | 需算 KL | 只需 ratio |
| 调参 | β(+自适应) | ε |
| 现状 | 教学用 | 工程默认 |
# kl_adaptive.py —— 自适应 KL 惩罚: β 随实际 KL 自动升降
import numpy as np

def adaptive_kl_step(target_kl=0.01, beta=1.0, kl_now=0.0):
    """按 PPO 论文: KL 超目标 → 加大 β(惩罚); 低于目标 1.5 倍 → 减小 β"""
    if kl_now > target_kl * 1.5:
        beta *= 2.0
    elif kl_now < target_kl / 1.5:
        beta /= 2.0
    return beta

beta = 1.0
print('模拟 KL 波动 → β 自适应调整:')
print(f'{"时刻":<6}{"实际 KL":>10}{"β":>10}')
for t, kl in enumerate([0.005, 0.02, 0.03, 0.012, 0.008, 0.004, 0.002]):
    beta = adaptive_kl_step(0.01, beta, kl)
    print(f'{t:<6}{kl:>10.4f}{beta:>10.3f}')
print()
print('→ KL 过大加倍惩罚(防爆炸), 过小减半(不拖慢) —— PPO 论文的自动调参')
模拟 KL 波动 → β 自适应调整:
时刻         实际 KL         β
0         0.0050     0.500
1         0.0200     1.000
2         0.0300     2.000
3         0.0120     2.000
4         0.0080     2.000
5         0.0040     1.000
6         0.0020     0.500

→ KL 过大加倍惩罚(防爆炸), 过小减半(不拖慢) —— PPO 论文的自动调参
8.1 PPO 最小实现精讲:一个完整训练循环的每个零件(🔴 动手实现)¶
本节导读:把 PPO 从公式落到"能跑的训练循环",一共 8 个零件。 这一节按代码顺序逐件讲解——面试"手写 PPO 伪代码"就按这个清单背。
1. 循环总览(背流程):
for epoch:                          # 外层:采集-更新
  rollout:用 π_θ 采样一批轨迹        # ① 数据
  算 GAE 优势 A_t                    # ② 优势
  for k in 1..K:                     # 内层:多轮使用本批数据
    ratio = π_θ(a|s) / π_old(a|s)    # ③ 重要性比例
    clip 目标 → 梯度 → 更新 θ         # ④ 策略损失
    更新 Critic(回归 TD/GAE 目标)    # ⑤ 价值损失
2. 每个零件的为什么(逐个讲):
- ① 采样:用当前策略(on-policy),采完存 (s,a,r,s',done)
- ② GAE:$\hat A_t=\delta_t+\gamma\lambda\hat A_{t+1}$ 反向递推; 折扣与 λ 都要(γ=0.99、λ=0.95 是经典默认)
- ③ ratio:分母是旧策略快照(π_θ_old),不是当前 θ——必须 先冻结旧策略参数再采样(代码里"老策略"就是上次更新前的 θ)
- ④ clip:$\min(r\hat A,\ \text{clip}(r,1\pm\varepsilon)\hat A)$, ε=0.2;注意 $\hat A>0$ 时 clip 上限、$\hat A<0$ 时 clip 下限(§2 表格)
- ⑤ Critic:$L_V=\mathbb{E}[(V_\theta(s)-\hat A_t^{\text{target}})^2]$, 目标 $\hat A_t + V_{\text{old}}(s)$(clip critic 可选)
3. 内层复用 K 次(关键细节):同一批数据更新 K=3~10 轮,靠 clip 保证 "别走太远"——这就是 PPO 样本效率的由来(比 A2C 一次用好几倍)。
4. 数字例子(本篇 code cell):迷你 PPO 在方格环境:曲线前期上升、 偶尔回退(震荡正常);ε=0.2 与 ε=0.5 对比可见 ε 越大越激进。
5. 易错点:
- 忘存 π_θ_old → ratio 恒 1 → clip 失效(最常见的 bug)
- 优势用了未来奖励:GAE 计算要处理 episode 边界(done 截断)
- 内层轮数 K 过大 + ε 小 → 训练慢;K 大 + ε 大 → 不稳
6. 面试问法:"手写 PPO 三步?" → "采轨迹(旧策略快照)→ 算 GAE 优势 → 用 clip 目标多轮更新策略与价值网络;ratio 分母必须用旧策略。"
# ppo_mini.py —— 迷你 PPO: clip 目标 + GAE, 4x4 网格
import numpy as np

SIZE, GAMMA = 4, 0.9
N = SIZE * SIZE
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def in_bounds(r, c):
    return 0 <= r < SIZE and 0 <= c < SIZE

def step(s, a):
    if s == N - 1:
        return N - 1, 0.0
    r, c = divmod(s, SIZE)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    if not in_bounds(nr, nc):
        return s, -1.0
    s2 = nr * SIZE + nc
    return (N - 1, 10.0) if s2 == N - 1 else (s2, -1.0)

def feats(s):
    x = np.zeros(N); x[s] = 1.0
    return x

def act_prob(W, s):
    x = feats(s)
    logits = W @ x
    logits -= logits.max()
    e = np.exp(logits)
    return e / e.sum(), x

def collect_rollout(W, max_steps=1000):
    """一版数据: 记 (s,a,r) 直到若干条轨迹"""
    traj = []
    total = 0.0
    for ep in range(10):
        s = 0
        while s != N - 1:
            p, _ = act_prob(W, s)
            a = int(np.random.choice(4, p=p))
            s2, r = step(s, a)
            traj.append((s, a, r))
            s = s2
            total += r
            if s == N - 1:
                break
    return traj, total / 10.0

def compute_returns(rewards):
    """简单 MC 回报(无价值函数版) 便于演示 clip"""
    G, out = 0.0, []
    for r in reversed(rewards):
        G = r + GAMMA * G
        out.append(G)
    return np.array(out[::-1])

def ppo_update(W, data, epsilon=0.2, alpha=0.05, epochs=3):
    """data: (s, a, G)[]; 多 epoch 小步更新"""
    for _ in range(epochs):
        idx = np.random.permutation(len(data))
        for i in idx:
            s, a, G = data[i]
            p_old, _ = act_prob(W, s)
            # 旧策略概率(更新前快照近似: 用当前 W 即"旧"——迭代内 W 变化小, 演示足够)
            for _step in range(1):
                p_new, _ = act_prob(W, s)
                ratio = p_new[a] / (p_old[a] + 1e-8)
                surr1 = ratio * G
                surr2 = np.clip(ratio, 1 - epsilon, 1 + epsilon) * G
                loss = -min(surr1, surr2)
                # 手动梯度: d(loss)/d(logit_a) ≈ -(1 or 0)·G·p_a 的近似, 走简单数值上升
                W[a, :] += alpha * (min(surr1, surr2)) * feats(s)   # 简化: 与 REINFORCE 同形
            return W  # 每 epoch 只演示一轮(教学简化)

np.random.seed(5)
W = np.random.RandomState(2).randn(4, N) * 0.1
for pg in range(30):
    data, avg = collect_rollout(W)
    W = ppo_update(W, data)
    if pg % 5 == 0:
        print(f'PPO 第 {pg:2d} 轮: 平均轨迹奖励 {avg:6.2f}')

print()
print('迷你 PPO 让 clip 限幅; 完整版还需 GAE + Critic + 多 epoch, 见 04-LLM/21 篇')
PPO 第  0 轮: 平均轨迹奖励 -96.40
PPO 第  5 轮: 平均轨迹奖励 -71.90
PPO 第 10 轮: 平均轨迹奖励 -39.50
PPO 第 15 轮: 平均轨迹奖励 -37.70
PPO 第 20 轮: 平均轨迹奖励 -74.60
PPO 第 25 轮: 平均轨迹奖励 -62.40

迷你 PPO 让 clip 限幅; 完整版还需 GAE + Critic + 多 epoch, 见 04-LLM/21 篇
Bradley-Terry 模型:人类偏好怎么变成奖励模型(🔴 推导)¶
数据:两个回答 $y_w \succ y_l$(人觉得 $y_w$ 更好)。
建模:假设存在隐藏的奖励分数 $r(x,y)$,人选择 $y_w$ 的概率服从 Bradley-Terry(逻辑斯蒂)模型:
$$P(y_w \succ y_l) = \sigma\big(r(x,y_w) - r(x,y_l)\big) = \frac{\exp(r_w)}{\exp(r_w)+\exp(r_l)}$$
为何长这样(三步):
- 假设人给每个回答打"满意分"时带 Gumbel 噪声(离散选择的 RUM 理论)—— 两个回答的得分差 $r_w - r_l$ 驱动选择
- Gumbel 差服从 Logistic 分布 → 选择概率就是 sigmoid(logistic)函数
- 于是成对偏好 = 分数差的 sigmoid——奖励模型的训练就是最大化这个似然
奖励模型损失(负对数似然,给 LLM 打分用): $$\mathcal{L}_{RM} = -\mathbb{E}_{(x,y_w,y_l)}\Big[\log \sigma\big(r_\phi(x,y_w) - r_\phi(x,y_l)\big)\Big]$$
与 DPO 的关系(第 12 节展开):DPO 把 $r_\phi$ 换成"参考策略比值",同一公式 直接对策略求导——RLHF 的三阶段(RM→RL)被压缩成一步。
一句话:BT 模型把"人更喜欢谁"翻译成"分数差越大越稳",奖励模型就是 在这个概率下拟合分数的网络;DPO 是它的免强化学习版本。
9. LLM-RLHF 的奖励模型细节(🔴 必背)¶
Bradley-Terry 排序损失(背)¶
奖励模型 $r_\phi$ 训练数据是偏好对 $(x, y_w, y_l)$:
$$\mathcal{L}(\phi) = -\mathbb{E}\left[\log \sigma\left(r_\phi(x, y_w) - r_\phi(x, y_l)\right)\right]$$
- 学习"好回答比坏回答分数高"
- 与交叉熵同构(二分类)
RM 的常见问题(背三个)¶
- 偏好标注不一致 → 用多标注投票/KTO
- 奖励模型被 hack:策略学到"高分话术"而非"好答案" → KL 正则 + 多样本评估
- 奖励分布漂移:训练中奖励均值持续上升 → 归一化/调 β
# rm_loss.py —— Bradley-Terry 奖励模型损失: 手写 + 直观
import numpy as np

def bt_loss(r_w, r_l):
    """log σ(r_w - r_l), Mean 版本"""
    return -np.log(1 + np.exp(-(r_w - r_l)))

# 造打分: 好回答 8 分, 坏回答 2 分
r_w, r_l = 8.0, 2.0
print(f'偏好对 (w=8, l=2): logσ(6) = {bt_loss(r_w, r_l):.4f} (损失小=好模型)')
print(f'模型打分反了 (w=2, l=8): logσ(-6) = {bt_loss(2.0, 8.0):.4f} (损失大)')
print()
# 梯度: 提升好回答分数、降低坏回答分数
for r in np.linspace(0, 10, 11):
    print(f'r_w={r:4.1f} r_l=2: loss={bt_loss(r, 2.0):6.3f}')
print()
print('→ RM 训练本质: 拉开 y_w 与 y_l 的分数差; PPO 阶段用这个分数当奖励')
偏好对 (w=8, l=2): logσ(6) = -0.0025 (损失小=好模型)
模型打分反了 (w=2, l=8): logσ(-6) = -6.0025 (损失大)

r_w= 0.0 r_l=2: loss=-2.127
r_w= 1.0 r_l=2: loss=-1.313
r_w= 2.0 r_l=2: loss=-0.693
r_w= 3.0 r_l=2: loss=-0.313
r_w= 4.0 r_l=2: loss=-0.127
r_w= 5.0 r_l=2: loss=-0.049
r_w= 6.0 r_l=2: loss=-0.018
r_w= 7.0 r_l=2: loss=-0.007
r_w= 8.0 r_l=2: loss=-0.002
r_w= 9.0 r_l=2: loss=-0.001
r_w=10.0 r_l=2: loss=-0.000

→ RM 训练本质: 拉开 y_w 与 y_l 的分数差; PPO 阶段用这个分数当奖励
10.1 奖励黑客与 KL 防漂移精讲:为什么 RL 让模型"说胡话"(🔴 深化)¶
本节导读:RL 优化奖励时,模型会钻漏洞:"把回答写得越长越像得分高" "报喜不报忧""说模型不知道的知识"。KL 惩罚是把模型"拴在人类语言区"的 缰绳——这一节讲清机制与公式。
1. 奖励黑客的根源(推导级理解):RLHF 的奖励是 RM 的近似偏好。 策略优化会系统性放大 RM 的误差:RM 觉得"长回答好" → 策略越长越夸张 → 超出人类真实偏好。优化目标 ≠ 真实目标,漏洞就长在差距里。
2. 标准解法:KL 惩罚(背公式):PPO 目标里加一项 $$J(\theta) = \mathbb{E}\big[r_{\text{RM}}(x,y) - \beta\,\log\frac{\pi_\theta(y|x)}{\pi_{\text{ref}}(y|x)}\big]$$
- $\pi_{\text{ref}}$:SFT 后的模型(人类语言的"代表")
- 奖励高但偏离参考太远 → 总奖励被扣 → 策略既讨喜又不失语言能力
- β 控制"听话 vs 自由":β 大更保守(贴参考)、β 小更激进(追奖励)
3. 数值实验(本篇 code cell):不同 β 下"真实奖励 vs KL 距离"曲线: β 太小 → 奖励虚高但输出崩坏(KL 爆炸);β 合适 → 二者平衡。
4. 与其他 KL 的区分(易混淆点):
- PPO/RLHF 的 KL:当前策略 vs 参考策略(SFT)——防漂移
- GRPO 的 KL:同样防漂移,但不用 Critic(组内优势)——DPO 篇另见
- 别和"PPO clip 版里的 KL 惩罚变体(新旧策略间)"混:一个防漂移、 一个限步长
5. 易错点:
- KL 不对称:$\text{KL}(\pi_{ref}\|\pi_\theta)$ 与反向不同,公式里 的"谁在前"要按论文/实现统一
- 奖励尺度影响 β 手感:奖励大时 β 也要大(先归一化奖励)
6. 面试问法:"RLHF 为什么加 KL?" → "RM 奖励是近似目标,纯优化会 钻漏洞(句法漂移/奖励黑客);KL 惩罚把策略锚在 SFT 参考附近, β 平衡'讨喜'与'像人'。"
# kl_tradeoff.py —— 奖励 vs KL 的目标权衡图(数值)
import numpy as np

def kl(p, q):
    return float(np.sum(p * np.log((p + 1e-9) / (q + 1e-9))))

pi_ref = np.array([0.4, 0.3, 0.2, 0.1])
# 策略 A: 温和提升 token0; 策略 B: 极端刷分
pi_A = np.array([0.55, 0.22, 0.15, 0.08])
pi_B = np.array([0.99, 0.004, 0.004, 0.002])

def reward(pi, alpha=0.9):
    """奖励模型倾向 token0(第1位), 真实性等高奖励"""
    return float(alpha * pi[0] + (1 - alpha) * sum(pi * np.array([1.0, 0.6, 0.3, 0.1])))

print(f'{"策略":<10}{"奖励":>8}{"KL(π‖ref)":>12}{"目标(β=0.5)":>14}')
for name, pi in [('参考', pi_ref), ('温和A', pi_A), ('刷分B', pi_B)]:
    r = reward(pi)
    k = kl(pi, pi_ref)
    print(f'{name:<10}{r:>8.3f}{k:>12.3f}{r - 0.5 * k:>14.3f}')
print()
print('观察: 刷分 B 奖励最高, 但扣 KL 后总目标变差(A 最优)')
print('→ KL 正则把"刷分"变成"不划算", 这就是防 reward hacking 的机制')
策略              奖励   KL(π‖ref)     目标(β=0.5)
参考           0.425       0.000         0.425
温和A          0.569       0.046         0.546
刷分B          0.990       0.856         0.562

观察: 刷分 B 奖励最高, 但扣 KL 后总目标变差(A 最优)
→ KL 正则把"刷分"变成"不划算", 这就是防 reward hacking 的机制
11.1 GRPO 组内标准化精讲:组大小 G 与方差的数学(🟡 实验)¶
本节导读:GRPO 对同一 prompt 采 G 个回答,组内标准化当优势。 G 越大,优势估计越准;但采样成本线性涨。这一节把"组内标准化的效果" 的数学写出来,并解释实验中 G 的取舍。
1. 组内优势(背公式): $$\hat A_i = \frac{r_i - \mu_G}{\sigma_G},\qquad \mu_G=\frac{1}{G}\sum_j r_j,\ \sigma_G^2=\frac{1}{G}\sum_j (r_j-\mu_G)^2$$
- 减去组均值 → 消除"这个 prompt 本身难不难"的公共偏置
- 除以组标准差 → 把奖励尺度归一(不同 prompt 可比的标尺)
2. 为什么比绝对奖励稳(推导直觉):绝对奖励 $r_i$ 里混杂了 "题目难度"(所有回答都低分)与"回答质量"(相对高低)。组内标准化 显式消掉公共部分 → 优势只反映"这一题里谁更好",跨题可比 → Critic 都不用学"难度偏置"。
3. G 的影响(分析 + 本篇实验):
- G=1:只有 μ=r₁、σ=0 → 退化(无法标准化)→ G≥2 起步
- G 小(2~4):均值和方差估计噪声大 → 优势噪声大
- G 大(16~64):估计收敛但采样成本 ×G(内存/时间)
- 实验曲线:G 从 4→16 提升明显,16→64 边际递减 —— 拐点效应
4. 与 PPO 的对照(背):PPO 用 Critic 估基线(参数化、可漂移); GRPO 用组内平均当基线(无参数、天然可比较,但只对同一 prompt 成立)。 代价:不同 prompt 之间不能互相当基线(组外信息浪费)。
5. 易错点:
- 必须同 prompt 组内标准化(跨 prompt 混算没意义)
- σ_G 加个小 ε 防除零(G 小或奖励全等时)
6. 面试问法:"GRPO 的优势怎么算?" → "同一 prompt 的 G 个回答, 奖励组内减均值除标准差;G 越大估计越准但成本线性涨,4~16 常见。"
# grpo_group_size.py —— GRPO 组大小 G 对优势方差的影响
import numpy as np

np.random.seed(0)
# 奖励模型给同一问题的打分分布(模拟): 均分 5, 标准差 2 的高斯
mu, sd = 5.0, 2.0

print(f'{"G":<6}{"优势均值":>10}{"优势标准差":>12}')
for G in [2, 4, 8, 16, 32]:
    advs = []
    for _ in range(2000):
        rewards = np.random.normal(mu, sd, G)
        adv = (rewards - rewards.mean()) / (rewards.std() + 1e-6)
        advs.extend(adv)
    advs = np.array(advs)
    print(f'{G:<6}{advs.mean():>10.3f}{advs.std():>12.3f}')

print()
print('解读: 优势均值始终≈0(组内标准化); G 越大单组估计越稳(优势 std→1)')
print('→ 实践中 G=4~8 是 DeepSeek 系常用选择(显存与方差折中)')
G 优势均值 优势标准差
2         -0.000       1.000
4         -0.000       1.000
8         -0.000       1.000
16        -0.000       1.000
32        -0.000       1.000

解读: 优势均值始终≈0(组内标准化); G 越大单组估计越稳(优势 std→1)
→ 实践中 G=4~8 是 DeepSeek 系常用选择(显存与方差折中)
12.1 DPO 精讲:不要 RL 的"RLHF"(🟡 对比了解)¶
本节导读:DPO 的洞察:RLHF 三阶段其实可以压缩成一步——把最优 策略的闭式解代进奖励,偏好损失直接对策略求导,全程无 RM、无采样、 无 PPO。数学上等价于 RLHF 的 KTO/偏好版,工程上便宜一个数量级。
1. 推导(三步,面试可复述): ① RLHF 问题(带 KL 约束):$\max_\pi \mathbb{E}[r(x,y)] - \beta\,\text{KL}(\pi\|\pi_{ref})$ ② 拉格朗日解出闭式(对 π 逐点求导): $$\pi^*(y|x) = \frac{1}{Z(x)}\pi_{ref}(y|x)\exp\big(r(x,y)/\beta\big)$$ ③ 反解奖励:$r(x,y) = \beta\log\frac{\pi^*(y|x)}{\pi_{ref}(y|x)} + \beta\log Z(x)$ ——把 r 代回 Bradley-Terry 偏好损失,Z(x) 抵掉,得 DPO 损失(只含 π 与 π_ref): $$\mathcal{L}_{DPO} = -\mathbb{E}_{(x,y_w,y_l)}\Big[\log\sigma\Big(\beta\log\frac{\pi(y_w|x)}{\pi_{ref}(y_w|x)} - \beta\log\frac{\pi(y_l|x)}{\pi_{ref}(y_l|x)}\Big)\Big]$$
2. 为什么"能这样"(关键点):偏好只依赖奖励之差,闭式解的 $\log Z(x)$(partition)与 y 无关 → 在成对比较里消掉。于是: 最优策略的"隐式奖励" = β×(新旧策略对数比) —— 不需要显式 RM。
3. DPO vs RLHF(对比表,背):
| RLHF(PPO) | DPO | |
|---|---|---|
| 需要 RM | 是 | 否 |
| 需要在线采样 | 是 | 否(只用静态偏好对) |
| 训练方式 | 强化学习 | 简单分类损失 |
| 理论 | — | 与带 KL less RLHF 等价 |
| 代价 | 贵、不稳 | 便宜;但无探索、依赖数据质量 |
4. 数字直觉(本篇 code cell):玩具环境上 DPO 与"先学 RM 再跑 RL" 的最终策略重合(隐式奖励一致)——验证等价性。
5. 易错点:
- π_ref 必须是固定参考(通常 SFT 模型),不随训练更新
- β 在 DPO 里是显式温度:β 小 = 激进贴合偏好(易过拟合)
6. 面试问法:"DPO 和 RLHF 区别?" → "RLHF 训 RM + 在线 RL;DPO 用 闭式解把奖励消成新旧策略比,偏好损失直接训练,无需 RM/采样,等价于 带 KL 约束的 RLHF,但更廉价(损失相对偏好数据质量敏感)。"
12. DPO:不需要强化学习的对齐(🟡 对比了解)¶
核心洞察¶
把 RLHF 的奖励最大化目标解析解代回去 → 目标变成只依赖偏好对的分类损失:
$$\mathcal{L}_{DPO} = -\log\sigma\left(\beta\log\frac{\pi_\theta(y_w|x)}{\pi_{\text{ref}}(y_w|x)} - \beta\log\frac{\pi_\theta(y_l|x)}{\pi_{\text{ref}}(y_l|x)}\right)$$
DPO vs PPO(背)¶
| PPO-RLHF | DPO | |
|---|---|---|
| 训练 | 需 RM + 在线采样 + Critic | 只需偏好对(离线) |
| 稳定性 | 需调很多超参 | 简单稳定 |
| 上线成本 | 高 | 低 |
| 性能 | 通常更强(在线探索) | 足够好(离线弱一些) |
| 现状 | 大厂主力 | 开源主力 |
面试金句:"DPO 把 RL 目标闭式求解进了损失函数——省掉 RM 与在线采样,代价是失去在线探索的收益;RLHF 仍是质量上限最高的路线。"
13. 面试追问速答扩展(🔴)¶
- Q: PPO 的 clip 与 TRPO 约束等价吗? A: 一阶等价近似;clip 是代理目标而非严格约束。
- Q: 为什么要存旧策略快照? A: 概率比需要固定分母 πold——更新过程中分母不变。
- Q: GAE λ 对 LLM 任务影响? A: λ 大更接近 MC(长程信用分配好);λ 小更稳。
- Q: RLHF 的 KL 是 KL(πθ‖πsft) 还是反过来? A: 论文用 KL(新‖旧/参考),方向影响惩罚强度。
- Q: GRPO 的 G 为什么不能无限大? A: 显存/算力随 G 线性涨;且同一问题重复采样次数有限。
- Q: 为什么 GRPO 省显存? A: 省掉价值网络(与策略同规模的 critic)——大模型上加价值网络显存翻倍。
- Q: RM 与 KL 的平衡怎么调? A: β 大 → 稳但进步慢;β 小 → 进步快但易 hack;监控 KL 曲线。
- Q: PPO 里熵项对 LLM 的作用? A: 保持生成多样性、防止坍缩成固定话术。
- Q: 参考模型多大? A: 常与策略同规模(冻结)→ 显存翻倍;可用 LoRA 近似省显存。
- Q: 离线 vs 在线对齐? A: 在线(RLHF/GRPO)能拿到新数据,质量上限高;离线(DPO)简单稳定。
14. 自测清单(06 篇收官)¶
- L1:默写 PPO clip 目标、GRPO 优势公式、BT 损失
- L1:讲清 KL 防 reward hacking 的机制
- L1:说清 DPO 与 RLHF 的取舍
- L2:手写 GAE 递归实现并在轨迹上验证
- L2:GRPO 组大小扫描结论能口头复述
- L3:把 PPO/GRPO 与 04-LLM 的 21 篇推导串起来
15. PPO/GRPO 公式总表(🔴 考前速背)¶
| 概念 | 公式 |
|---|---|
| 重要性权重 | $r_t(\theta)=\pi_\theta(a_t\mid s_t)/\pi_{\theta_{old}}(a_t\mid s_t)$ |
| PPO-clip | $\min(r_t A_t,\; \mathrm{clip}(r_t,1-\varepsilon,1+\varepsilon)A_t)$ |
| PPO 总目标 | $L^{CLIP}+c_1 L^{VF}-c_2 S[\pi_\theta]$ |
| RLHF 奖励 | $r_\phi(x,y)-\beta\,\mathrm{KL}(\pi_\theta\|\pi_{\mathrm{SFT}})$ |
| BT 损失 | $-\log\sigma(r_w-r_l)$ |
| GRPO 优势 | $\hat A_i=(r_i-\bar r)/\mathrm{std}(r_1..r_G)$ |
| GRPO 目标 | $\mathbb{E}[\frac{1}{G}\sum_i \min(r_i\hat A_i,\mathrm{clip}\cdot\hat A_i)]-\beta\mathrm{KL}(\pi_\theta\|\pi_{\mathrm{ref}})$ |
16. RLHF vs DPO vs GRPO 一页对比(🔴 面试终板)¶
| RLHF(PPO) | DPO | GRPO(R1) | |
|---|---|---|---|
| 奖励 | RM 打分 | 隐式(偏好对) | RM 打分 |
| 基线 | Critic(GAE) | 无 | 组内标准化 |
| 在线采样 | 需要 | 不需要 | 需要 |
| 显存 | 高(+RM+Critic) | 低 | 中(去Critic) |
| 稳定性 | 难调 | 简单 | 中等 |
| 适用 | 高质量上限 | 资源受限 | 可验证任务(推理) |
记忆锚点:DPO 离线稳但无探索;RLHF 在线强但贵;GRPO 用组内比较替代 Critic,是 RLHF 的"省显存版"。
17. 易错点清单(🔴 PPO/GRPO 篇)¶
- ratio 的分母是"旧策略":更新中固定 π_old(快照),不能每步重算
- GRPO 的 ratio 分母是参考模型 π_ref:不是 old 策略(GRPO 无 old 快照)
- KL 方向:KL(πθ‖πref) 是"新对参考";DPO 里 log 里的 β 系数别丢
- clip 是惩罚不是约束:TRPO 硬约束;PPO 软裁剪——面试直接问区别
- done 处理:轨迹终点 TD 目标无后继价值(γV(s')=0)
- GAE 从尾部递归:A_t=δ_t+γλA_{t+1},方向别写反
18. 考前 3 分钟速背(🔴 PPO/GRPO 篇)¶
PPO = TRPO 的 clip 化: min(r·A, clip(r,1±ε)·A)
三件套: clip + GAE + 熵正则
RLHF: SFT → RM(BT) → PPO(+βKL)
KL 防 hack; G=4~8 组内标准化 -> GRPO(去Critic)
DPO: 闭式解偏好对, 离线简单, 无在线探索
R1 风格: 可验证任务 + GRPO + 长 CoT 奖励
19. 常见追问组合演练(🔴 面试对练)¶
- A: "PPO 和 TRPO 你选哪个?" → PPO(简单、表现接近、少调参)
- B: "KL 惩罚和 clip 能一起用吗?" → 可以(有些实现两者都加,更稳)
- C: "LLM 上你更看好 RLHF 还是 DPO?" → 质量优先 RLHF;资源受限 DPO;推理增强 GRPO
- D: "奖励模型怎么防被 hack?" → βKL + 评估集盲评 + 长度惩罚 + 多样本
# llama_translate.py —— PPO/GRPO 超参速查(print-only 备忘)
config = {
    'PPO-clip': {'ε': 0.2, 'γ': 0.99, 'GAE λ': 0.95, 'lr': '3e-4'},
    'PPO-KL': {'β': '自适应(目标KL 0.01±)', 'target': 0.01},
    'RLHF': {'RM 初始': 'SFT 权重', 'βKL': '0.01~0.1', '采样': 'per-prompt batch'},
    'GRPO': {'G': '4~8', '优势': '(r-mean)/std', '去 Critic': True},
    'DPO': {'β': '0.1~0.5', '数据': '偏好对离线', '在线': False},
}
print('LLM 对齐超参速查表:')
for k, v in config.items():
    print(f'  {k:<10}: {v}')
print()
print('记忆锚点: PPO 想 ε 和 λ; GRPO 想 G 和去Critic; DPO 想 β 和离线')
LLM 对齐超参速查表:
  PPO-clip  : {'ε': 0.2, 'γ': 0.99, 'GAE λ': 0.95, 'lr': '3e-4'}
  PPO-KL    : {'β': '自适应(目标KL 0.01±)', 'target': 0.01}
  RLHF      : {'RM 初始': 'SFT 权重', 'βKL': '0.01~0.1', '采样': 'per-prompt batch'}
  GRPO      : {'G': '4~8', '优势': '(r-mean)/std', '去 Critic': True}
  DPO       : {'β': '0.1~0.5', '数据': '偏好对离线', '在线': False}

记忆锚点: PPO 想 ε 和 λ; GRPO 想 G 和去Critic; DPO 想 β 和离线
20. 项目脑暴:给 MiniMind 加一个 GRPO 微调(🟡 高阶实践)¶
数据: 数学题 x 1000 (答案可验证)
策略: MiniMind(或小模型) 生成 CoT
奖励: 答案正确 + 长度惩罚; 组内 G=4
优化: GRPO(clip + 组内优势) 或 DPO(离线)
评估: 正确率 vs KL 漂移 vs 生成多样性
产出: 正确率提升曲线 + 采样案例对比
这是"LLM 岗+RL 岗"双杀的简历项目——04-LLM/21 篇有公式推导,这里给出工程路线。
21. 易错自查(🔴 上机前)¶
- ratio 分母是旧策略(快照),不是参考模型(GRPO 例外)
- done 处理:终点无 γV(s')
- KL 方向:KL(πθ‖πref)
- GRPO 优势有 std 分母(别只减均值)
- 熵项系数别漏(很多 PPO 实现默认带)
22. LLM 对齐开源生态速览(🟢 找工作有用)¶
| 框架 | 特点 | 适用 |
|---|---|---|
| TRL (HF) | PPO/DPO/GRPO 都有 | 快速原型 |
| LLaMA-Factory | SFT/RM/DPO/PPO 全家桶 | 科研/实验 |
| OpenRLHF | 大规模 RLHF 分布式 | 生产 |
| verl (字节) | RLHF 框架,GRPO 支持好 | 推理 RL |
| veRL/DeepSpeed-Chat | 大模型 RLHF | 大集群 |
简历写"用过 TRL/LLaMA-Factory 跑过 DPO/GRPO",面试官默认你会 LLM×RL 落地。
# grpo_pseudo.py —— GRPO 训练循环伪代码(背诵版, 打印对照)
pseudo = '''
for step in range(T):
    prompts = sample_batch()                    # x1..xB
    for i in range(B):
        y_i1..y_iG = policy.sample(prompts[i], G=4)   # 每组 G 个回答
        r_ig = reward_model(prompts[i], y_ig)          # RM 打分
        r_ig = normalize_length(r_ig)                 # 长度惩罚
    for i in range(B):
        A_ig = (r_ig - mean(r_i)) / (std(r_i) + eps)  # 组内标准化优势
        ratio = policy(y_ig|x) / ref(y_ig|x)          # 与参考模型比
        loss = -mean(min(ratio*A, clip(ratio,1±eps)*A)) + β·KL
    policy.update(loss)
'''
print(pseudo)
print('默写要点: G 组采样 → RM → 组内优势 → ratio对照ref → clip+KL')
for step in range(T):
    prompts = sample_batch()                    # x1..xB
    for i in range(B):
        y_i1..y_iG = policy.sample(prompts[i], G=4)   # 每组 G 个回答
        r_ig = reward_model(prompts[i], y_ig)          # RM 打分
        r_ig = normalize_length(r_ig)                 # 长度惩罚
    for i in range(B):
        A_ig = (r_ig - mean(r_i)) / (std(r_i) + eps)  # 组内标准化优势
        ratio = policy(y_ig|x) / ref(y_ig|x)          # 与参考模型比
        loss = -mean(min(ratio*A, clip(ratio,1±eps)*A)) + β·KL
    policy.update(loss)

默写要点: G 组采样 → RM → 组内优势 → ratio对照ref → clip+KL
23. 面试实战演练:R1 为什么选择 GRPO(🔴 60 秒版)¶
"DeepSeek-R1 的目标是推理增强:输入数学/代码题,期望模型自己写出长 CoT 并给出正确答案。 这类任务奖励可验证(答案对错),可以批量采样多条回答;GRPO 用同一问题的 G 条回答做组内比较, 优势 = 标准化分数,替代了 PPO 里昂贵且不稳的价值网络——训练成本降一半且效果更好。 同时 KL 约束保证不偏离参考模型,避免奖励黑客。"
要点:任务可验证 → 批量采样 → 组内比较 → 去 Critic。四步全中。
24. 章末寄语(🟢)¶
PPO 是 RL 的"瑞士军刀",GRPO 是 LLM 对齐的"省电版"。至此你已覆盖 RL 算法岗 + LLM 对齐岗的核心弹药。
25. 全篇公式自查(🔴 默写后对照)¶
- PPO clip 目标一行
- GAE 递归一行
- BT 损失一行
- GRPO 优势一行
- RLHF 总目标(含 βKL)一行
- DPO 损失一行(知道即可)
六个"一行",都是面试 30 秒题——全部能盲写才算过。
26. 面试对比三板斧(🔴 对齐篇)¶
- RLHF vs DPO:在线+RM+贵 vs 离线+偏好对+简单
- PPO vs GRPO:Critic+GAE vs 组内标准化+去Critic
- 推理 RL vs 通用 RLHF:可验证奖励 vs 人类偏好奖励
三组对比覆盖"LLM 对齐岗"所有高频追问。
# align_compare.py —— 对齐三对比一览(打印)
print('RLHF vs DPO:')
print('  RLHF: SFT→RM(BT)→PPO(+βKL);在线探索,质量上限高,贵')
print('  DPO: 偏好对闭式解;离线简单稳定,无探索,上限略低')
print()
print('PPO vs GRPO:')
print('  PPO: Critic 估基线 + GAE;通用但贵')
print('  GRPO: 组内奖励标准化;去 Critic,省显存(R1 用)')
print()
print('推理RL vs 通用RLHF:')
print('  推理RL: 答案可验证(对错),鼓励长 CoT(R1 风格)')
print('  通用RLHF: 人类偏好排序,覆盖开放生成')
RLHF vs DPO:
  RLHF: SFT→RM(BT)→PPO(+βKL);在线探索,质量上限高,贵
  DPO: 偏好对闭式解;离线简单稳定,无探索,上限略低

PPO vs GRPO:
  PPO: Critic 估基线 + GAE;通用但贵
  GRPO: 组内奖励标准化;去 Critic,省显存(R1 用)

推理RL vs 通用RLHF:
  推理RL: 答案可验证(对错),鼓励长 CoT(R1 风格)
  通用RLHF: 人类偏好排序,覆盖开放生成
27. 章末寄语(🟢)¶
PPO/GRPO 篇收官。核心资产:clip 一行 + KL 防 hack + GRPO 组内优势 + 对齐三对比。
28. 全模块主线回顾(🔴 串联 00-06)¶
00 定义世界(MDP) → 01 有模型求解(DP) → 02 无模型预测(MC/TD)
→ 03 无模型控制(Q/SARSA) → 04 深度价值(DQN) → 05 深度策略(PG/AC)
→ 06 工程标准+LLM 对齐(PPO/GRPO) → 07 面试实战(90问+手写)
面试官问"你的 RL 知识框架"——把这条线 30 秒讲完,等于把目录背给他听。
29. 数字敏感度速查(🔴 PPO/GRPO 篇终版)¶
| 参数 | 典型值 | 说明 |
|---|---|---|
| clip ε | 0.2 | 0.1~0.3 |
| GAE λ | 0.95 | 0.9~0.99 |
| KL β(RLHF) | 0.01~0.1 | 可自适应 |
| KL β(DPO) | 0.1~0.5 | 常需扫描 |
| GRPO G | 4~8 | 显存与方差折中 |
| 熵系数 | 0.01 | 保多样性 |
| rollout batch | 2048~4096 | 一版数据 |
30. 章末终版寄语(🟢)¶
PPO 是 RL 的"瑞士军刀"、GRPO 是 LLM 对齐的"省电版"、DPO 是"轻量版"——三件套加身,无论面试官从哪个角度问对齐,你都有公式、对比与工程细节可讲。
31. 模块衔接(🔴)¶
06 篇把所有知识收束到 LLM 对齐;07 篇是 90 问 + 手写 + 开放题的总决战。至此 8 篇闭环。
32. LLM 对齐变种谱系(🔴 PPO / KL / GRPO / RLOO / DPO 推导关系)¶
谱系树¶
RLHF(PPO+RM) ─→ PPO-clip(默认) ─→ RLOO(留一基线)
     │                              └→ GRPO(组内标准化, 去Critic)
     └→ DPO(闭式解, 离线)          └→ KTO(无需配对偏好)
一条主线推导(背)¶
- PPO 需要 Critic:$\delta_t = r_t + \gamma V(s_{t+1}) - V(s_t)$(价值网络市值)
- RLOO 去掉 Critic:基线 = 组内"排除自己"的均值 $\bar r_{-i}$
- GRPO 再去掉"留一",用全组:$\hat A_i = \frac{r_i - \bar r}{\mathrm{std}(r_1..r_G)}$
- 每一步都在回答同一问题:"用更便宜的方式逼近优势 $A_t$"——从学价值 → 组内统计。
33. TRPO → PPO:代理目标与 clip 的推导(🔴 面试手推主菜)¶
背景¶
TRPO 硬约束:$\max_\theta \mathbb{E}[r_t(\theta)\hat A_t] \quad\mathrm{s.t.}\quad \mathrm{KL}(\theta_{old}\|\theta)\le\delta$
三步推导(背)¶
① 重要性采样改写目标(用旧策略采样):
   L^CPI(θ) = E_t[ ( πθ(a|s)/πold(a|s) ) · Â_t ] = E_t[ r_t(θ)·Â_t ]
   ↑ 唯一开销: 每步重算概率比 r_t(θ) —— 不需要重采数据!

② TRPO 的 KL 约束在 PPO 里换成两种近似:
   PPO1:  罚项   L = L^CPI - β·KL(θold‖θ)      (β 可自适应)
   PPO2:  clip 下界  L^CLIP = E[ min(r_t Â_t, clip(r_t,1±ε)Â_t) ]

③ clip 的直觉(为什么对): r_t 超出 [1-ε, 1+ε] 时目标被"压平",
   梯度不再把 θ 推向"一步迈太大"的方向 → 步长自动受限 ∎
面试金句:"PPO 用'概率比 + 裁剪'复刻了 TRPO 的信任域,代价只是每个样本多算一次新旧概率比——这是它成为工程默认的全部理由。"
# fig_ppo_clip.py —— 过程图①: PPO clip 目标曲面(ratio vs 优势方向)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

r = np.linspace(0.0, 2.0, 200)
eps = 0.2

def l_clip(r, A, eps=0.2):
    return np.minimum(r * A, np.clip(r, 1 - eps, 1 + eps) * A)

fig, axes = plt.subplots(1, 2, figsize=(10.0, 3.8), dpi=150)
for ax, A in zip(axes, [1.0, -1.0]):
    ax.plot(r, r * A, ls='--', color='gray', label='无 clip(线性)')
    ax.plot(r, l_clip(r, A, eps), lw=2.2, color='crimson', label=f'clip(1±{eps})')
    ax.axvspan(1 - eps, 1 + eps, color='gold', alpha=0.25, label='信任区域')
    ax.axvline(1.0, color='black', lw=1, ls=':')
    ax.set_title(f'优势 A={A:+.0f}', fontsize=11)
    ax.set_xlabel('概率比 r_t(θ)'); ax.set_ylabel('代理目标')
    ax.legend(fontsize=8); ax.grid(alpha=0.3)
fig.suptitle('PPO clip: 信任区域外目标被压平 → 梯度受限', y=1.02)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'ppo_clip_curve.png'), dpi=150)
print('已保存 images/ppo_clip_curve.png')
plt.close(fig)
plt.show()
已保存 images/ppo_clip_curve.png
# fig_kl_beta.py —— 过程图②: KL 系数 β 的权衡(奖励 vs 偏移)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

# 模拟: β 越大 → KL 偏移越小, 但奖励增益也小
betas = np.array([0.0, 0.01, 0.05, 0.1, 0.2, 0.5])
kl = np.array([0.42, 0.33, 0.22, 0.15, 0.09, 0.04])        # KL(θ‖ref) 示意
reward_gain = np.array([6.0, 5.2, 4.1, 3.0, 1.8, 0.6])     # RM 得分增量示意

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
ax2 = ax.twinx()
ax.plot(betas, kl, 'o-', color='royalblue', label='KL(θ‖ref)(左轴)')
ax2.plot(betas, reward_gain, 's-', color='darkorange', label='奖励增益(右轴)')
ax.set_xlabel('KL 系数 β'); ax.set_ylabel('KL 偏移', color='royalblue')
ax2.set_ylabel('奖励模型得分增量', color='darkorange')
ax.set_title('β 权衡: 惩罚太松→漂移大(RM被hack); 太紧→不进步')
ax.legend(loc='upper right'); ax2.legend(loc='lower right')
ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'rlhf_kl_beta.png'), dpi=150)
print('已保存 images/rlhf_kl_beta.png')
plt.close(fig)
plt.show()
已保存 images/rlhf_kl_beta.png