⚙️ 15-AI-Infra · 01 矩阵乘法与算子级优化:GEMM 的工程解剖
关键词:GEMM · FLOPs · 算术强度 · roofline 模型 · 分块(tiling)· 寄存器复用 · 局部性 · 带宽受限
前置知识:00-计算图与自动微分、03-深度学习 02-CNN(卷积→GEMM)。
🧩 本讲定位:卷积、Transformer、全连接在硬件上几乎都归结为矩阵乘法(GEMM)。AI Infra 面试的经典问题:"为什么 naive 三重循环很慢?分块为什么快?roofline 怎么画?"本讲用 numpy 亲手对比 naive / 分块 / 寄存器分块三种实现,画出 roofline,把"算力 vs 带宽"讲透。
本节要解决的问题
| 要解决的问题 | 对应内容 |
|---|---|
| GEMM 到底有多少 FLOPs?怎么手算? | 核心概念 (a) + 代码实战 A |
| naive 三重循环为什么慢?(算力还是带宽?) | 深入原理 1/2 + 代码实战 B |
| 分块 tiling 为什么快?快多少? | 深入原理 3 + 代码实战 B/C |
| 寄存器分块(register blocking)在做什么? | 深入原理 4 + 代码实战 D |
| roofline 模型怎么画、怎么看瓶颈? | 深入原理 5 + 代码实战 E |
故事引入
老张在 CUDA 组实习,Leader 让他把公司的新算子性能从 3 TFLOPS 提到 10 TFLOPS。老张的第一版就是教科书式的三重循环:
for i in range(M):
    for k in range(K):
        for j in range(N):
            C[i][j] += A[i][k] * B[k][j]
他心想:这逻辑不是完全正确吗?为什么这么慢?后来才明白——代码的"逻辑正确"和"硬件友好"是两回事:每一轮内层循环都要去主存读 A[i][k] 和 B[k][j],而 CPU 的寄存器、缓存比主存快几个数量级。真正的 GEMM 优化大师(如 GotoBLAS / cuBLAS / FlashAttention 团队)做的是把数据在缓存/共享内存/寄存器里反复复用,把"从内存读一个数"变成"算很多次"。
老张的第二次迭代:分块(tiling)+ 寄存器分块(register blocking)+ 向量化——性能直接翻了 5 倍。他也由此总结出一条面试金句:"GEMM 优化的本质:用片上(cache/共享内存/寄存器)的大带宽,掩盖片外(主存)的小带宽。"
核心概念
(a) 🧮 FLOPs:矩阵乘法到底做了多少次浮点运算
对 $C_{M\times N} = A_{M\times K}\,B_{K\times N}$:每个输出元素是 $K$ 次乘加(1 次乘 + 1 次加),共 $M\cdot N$ 个元素:
$$ \text{FLOPs} = 2\,M\,N\,K $$
例如 $A(1024\times 1024) \times B(1024\times 1024)$:$2\times 1024^3 = 2.1\times 10^9$ FLOPs(约 2 GFLOPs)。
(b) 📊 算术强度与 roofline
算术强度(arithmetic intensity)= 每搬运 1 字节对应的浮点运算数(FLOPs/Byte),衡量“一次访存能换多少算力”,与时间无关:
$$ I = \frac{\text{FLOPs}}{\text{Bytes}} = \frac{2MNK}{(\underbrace{MK}_{\text{A 读}}+\underbrace{KN}_{\text{B 读}}+\underbrace{MN}_{\text{C 写}})\,s},\quad s=\text{元素字节数} $$
⚠️ C 读改写假设:上式按理想复用计——A、B 各读一遍,C 在寄存器/tile 里累积、最后只写一遍($MN$ 算一次写)。若实现是 $C \mathrel{+}= A\cdot B$ 的原地累加(读 C、改写、写回,read-modify-write),每轮还要多读一次 C,分母变为 $(2MN+MK+KN)\,s$,算术强度略降;优化库(cuBLAS/GotoBLAS)在寄存器中累积、最后只写一次 C,所以按“只写一次”估。方形 $M=N=K=n$ 时 $I \approx \tfrac{2n}{3}\,\text{FLOP/B}$,随 $n$ 线性增长——大 GEMM 天生算力友好。
roofline 给"给定算术强度下能跑多快"的上限:
$$ \text{Performance} \le \min\big(\,\pi_{\text{peak}},\ \beta_{\text{mem}}\, I\,\big) $$
其中 $\pi_{\text{peak}}$ 是峰值算力,$\beta_{\text{mem}}$ 是内存带宽。低于拐点($I < \pi_{\text{peak}}/\beta_{\text{mem}}$)=带宽受限,高于=算力受限。
(c) 💾 局部性:时间局部性 × 空间局部性
- 时间局部性:同一数据短时间内多次使用(寄存器/缓存命中);
- 空间局部性:相邻数据一起搬入缓存(一次取 64B 缓存行)。
naive 三重循环每步都从主存读 A、B——局部性极差;分块把"一块"反复复用——局部性好。
(d) 🔢 分块(tiling)与寄存器分块(register blocking)
- tiling:外层把 A、B 切成 $b\times b$ 块,内层对一块做矩阵乘——块进入 cache 后被 $b$ 次复用;
- register blocking:每个线程/标量单元一次算 $r\times r$ 输出子块,让读入的 A/B 值在寄存器里被复用 $r$ 次——是 GotoBLAS/cuBLAS 的核心技巧之一。
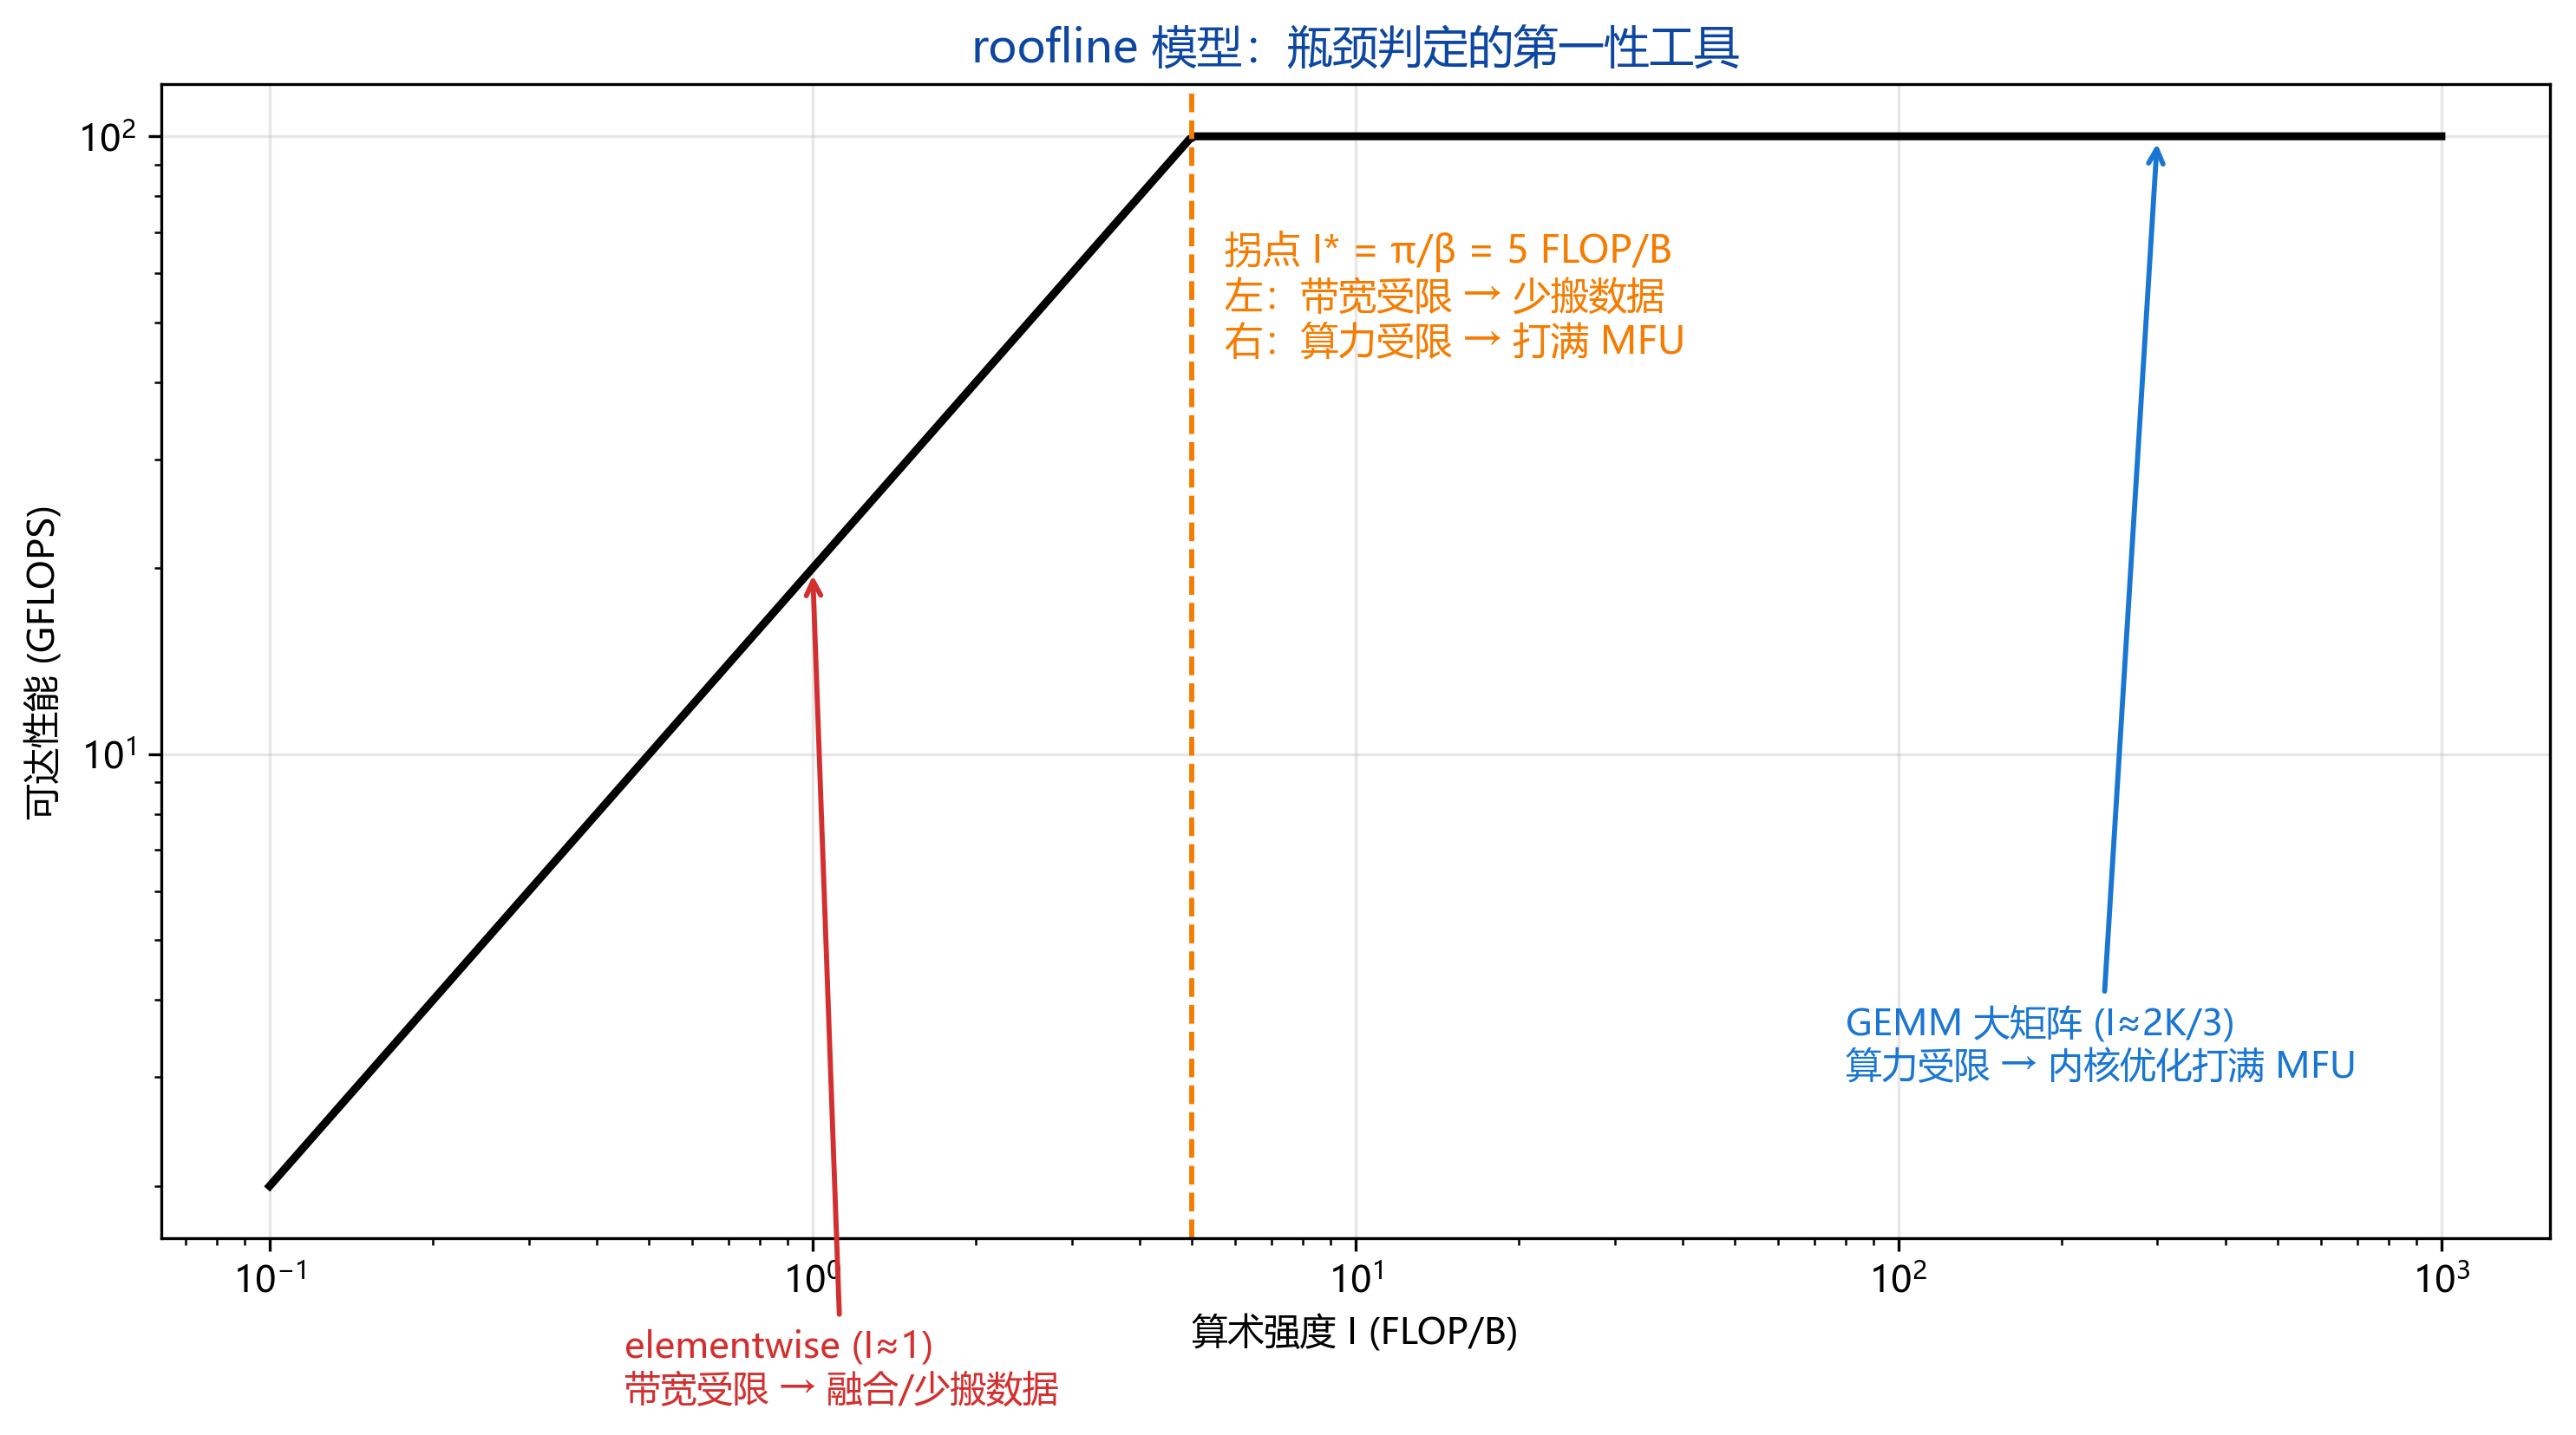
图示:横轴算术强度 I=FLOPs/Bytes,纵轴可达性能;拐点左边带宽受限(少搬数据),右边算力受限(打满 MFU)。elementwise($I\approx 1$)与 GEMM(方形 $n$:$I\approx 2n/(3s)$,$s$=元素字节)分别落在带宽线与算力线上。
ℹ️ 实际 traffic 说明:roofline 里的 Bytes 用的是下限——A、B 各读一遍、C 写一遍、复用取理想值。真实运行还会多搬:C 的读改写、cache 未命中造成的重复搬运、dtype 转换与缓存行对齐等,所以实测点通常落在理论 roofline 下方——它给出的是"给定 $I$ 的性能天花板",不是承诺值。
深入原理
1. naive 三重循环为什么慢:访存主导
以 $M=N=K=n$ 为例:naive 每次内层迭代读 $A[i][k]$、$B[k][j]$(各 8 字节 FP64)做 2 次浮点运算;若 C 未驻留 cache 则每次还要读写 $C[i][j]$(再 16 字节):
$$ \text{运算/字节} = \frac{2}{8+8+16} = \frac{2}{32} = 0.0625\ \text{FLOP/B}\quad(\text{最坏,C 每次从主存取}) $$
若 C 命中 cache(通常内层循环中 $C[i][j]$ 可复用),则近似 $2/(8+8)=0.125$ FLOP/B。无论哪种口径,算术强度都远低于拐点:
假设机器主存带宽 30 GB/s:naive 可达性能上限 ≈ $0.0625\sim0.125\times 30\times10^9 = 1.9\sim3.75$ GFLOPS——无论 CPU 峰值算力多高,都被这个上限卡死。带宽受限。
2. 数学等价性:ijk 顺序不影响结果,影响速度
三重循环的 i/j/k 换序(共 6 种)在数学上等价,但访存模式天差地别:
| 顺序 | 内层访问模式 | 局部性 |
|---|---|---|
| i-k-j(教科书) | B 逐行扫描、A 行内跳跃 | 差 |
| i-j-k | B 列访问(跨步大) | 差 |
| k-i-j / j-i-k(块化后) | A、B 均连续 | 好 |
3. 分块 tiling:把"复用"写进循环
取块大小 $b$,内层一次处理 $A[\cdot\,b] \times B[b,\,\cdot]$。每块数据 $(b^2+b^2)$ 个元素被复用 $b$ 次:
$$ \text{每字节运算} = \frac{2b^3}{(b^2+b^2)\times 8} = \frac{b}{8}\ \text{FLOP/B} $$
$b=32$ 时约 4 FLOP/B,比 naive 高 32 倍——这就是"分块把带宽受限变成算力受限"的数学。块大小受 cache/共享内存容量约束(b 太大放不下)。
4. 寄存器分块:让每次访存多做几次运算
分块后数据在 cache 里;寄存器分块进一步在寄存器里把每个读入值用 $r$ 次:外层循环每读 $r$ 个 A 值和 $r$ 个 B 值,算 $r\times r$ 个输出。操作数复用比提高 $r$ 倍。
5. roofline 实操:怎么画、怎么用
- 定机器的 $\pi_{\text{peak}}$(如单核 AVX2 FP64 FMA 峰值 ≈ $\underbrace{2}_{\text{FMA 单元}}\times\underbrace{4}_{\text{FP64/寄存器}}\times\underbrace{2}_{\text{FMA 融合乘加}} = 16$ FLOP/周期 → $16\times$主频(GHz) GFLOPS)与 $\beta_{\text{mem}}$(如 20 GB/s);
- 画两条线:水平线 $\pi_{\text{peak}}$、斜线 $\beta_{\text{mem}}\,I$(log-log);
- 把你算子的 $(I, \text{实测性能})$ 点画上去:落在斜线上→带宽受限(优化访存);贴近水平线→算力受限(优化计算/向量化)。
GEMM 的 $I$ 随矩阵变大而变大(数据量 $O(n^2)$、运算量 $O(n^3)$),所以大矩阵 GEMM 天生是"算力受限的好算子"。
代码实战 A:FLOPs 手算与实测 GFLOPS
先运行环境设置单元:
# 环境设置:中文字符输出(Jupyter/控制台兼容)+ matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
import time
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False
np.random.seed(0)
print("环境就绪")

plt.show()
环境就绪
def gflops_of(n, dt):
    """n×n×n GEMM 的 GFLOPS:2n^3 FLOPs 除以耗时(秒)。"""
    return 2 * n ** 3 / dt / 1e9

n = 512
A = np.random.rand(n, n); B = np.random.rand(n, n)
t0 = time.perf_counter(); C = A @ B; dt = time.perf_counter() - t0
print("理论 FLOPs = 2×%d³ = %.2e" % (n, 2 * n ** 3))
print("np.matmul 耗时 %.1f ms → 实测 %.1f GFLOPS" % (dt * 1e3, gflops_of(n, dt)))
理论 FLOPs = 2×512³ = 2.68e+08
np.matmul 耗时 3.4 ms → 实测 79.7 GFLOPS
代码实战 B:naive vs 分块(tiled) vs BLAS
三种实现对同一矩阵乘法计时:naive(纯 Python 三重循环,最朴素)、tiled(numpy 分块矩阵乘,模拟 cache 友好)、BLAS(np.matmul,代表高度优化实现)。
🕒 计时规范(warmup / repeat / median):① warmup 先跑几轮,排除冷启动(JIT 编译、页表/缓存未命中、CPU 变频);② 每轮独立用
time.perf_counter()计时;③ 重复多次取 median(中位数)——中位数对偶发的系统抖动不敏感,比“单次计时”或“取最小”更稳。naive 纯 Python 太慢,只跑到 n=64。
# 三种 GEMM 实现
def gemm_naive(A, B):
    """教科书三重循环:逻辑正确但访存极差(每步都碰主存)。"""
    M, K = A.shape; N = B.shape[1]
    C = np.zeros((M, N))
    for i in range(M):
        for k in range(K):
            a_ik = A[i, k]
            for j in range(N):
                C[i, j] += a_ik * B[k, j]
    return C

def gemm_tiled(A, B, tile=16):
    """分块:外层切块,内层 numpy 块乘(块进入 cache 被复用)。"""
    M, K = A.shape; N = B.shape[1]
    C = np.zeros((M, N))
    for i0 in range(0, M, tile):
        for k0 in range(0, K, tile):
            A_blk = A[i0:i0 + tile, k0:k0 + tile]
            for j0 in range(0, N, tile):
                B_blk = B[k0:k0 + tile, j0:j0 + tile]
                C[i0:i0 + tile, j0:j0 + tile] += A_blk @ B_blk
    return C

# 正确性对照(小规模)
Aa = np.random.rand(16, 16); Bb = np.random.rand(16, 16)
ref = Aa @ Bb
assert np.allclose(gemm_naive(Aa, Bb), ref, atol=1e-10)
assert np.allclose(gemm_tiled(Aa, Bb), ref, atol=1e-10)
print("✅ naive / tiled 与 BLAS 结果一致(数值正确)")

# 计时对比(naive 纯 Python 只跑到 64,否则太慢;warmup+repeat+median 口径见上方说明)
sizes = [16, 32, 48, 64]
t_naive, t_tiled, t_blas = [], [], []
def bench(fn, *args, warmup=2, repeat=5):
    """warmup 预热 + repeat 重复 + median 中位数(抗系统抖动)。"""
    for _ in range(warmup):
        fn(*args)
    ts = []
    for _ in range(repeat):
        t0 = time.perf_counter(); fn(*args); ts.append(time.perf_counter() - t0)
    return float(np.median(ts))
for n in sizes:
    A = np.random.rand(n, n); B = np.random.rand(n, n)
    t_naive.append(bench(gemm_naive, A, B))
    t_tiled.append(bench(gemm_tiled, A, B))
    t_blas.append(bench(lambda: A @ B))
    print("n=%3d  naive %6.1f ms | tiled %6.1f ms | BLAS %5.1f ms" % (
        n, t_naive[-1] * 1e3, t_tiled[-1] * 1e3, t_blas[-1] * 1e3))

fig, ax = plt.subplots(figsize=(9, 5))
ax.semilogy(sizes, [t * 1e3 for t in t_naive], "o-", label="naive 三重循环", color="#D32F2F")
ax.semilogy(sizes, [t * 1e3 for t in t_tiled], "s-", label="tiled 分块", color="#388E3C")
ax.semilogy(sizes, [t * 1e3 for t in t_blas], "^-", label="BLAS (np.matmul)", color="#1976D2")
ax.set_xlabel("矩阵维度 n"); ax.set_ylabel("耗时 (ms, 对数)")
ax.set_title("naive vs 分块 vs BLAS:同一逻辑,访存方式不同性能天差地别")
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
✅ naive / tiled 与 BLAS 结果一致(数值正确)
n= 16  naive    1.9 ms | tiled    0.0 ms | BLAS   0.0 ms
n= 32  naive   15.5 ms | tiled    0.0 ms | BLAS   0.0 ms
n= 48 naive 49.7 ms | tiled 0.1 ms | BLAS 0.0 ms
n= 64 naive 131.4 ms | tiled 0.7 ms | BLAS 0.0 ms
C:\Users\24260\AppData\Local\Temp\ipykernel_1620\1107745976.py:58: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
代码实战 C:块大小扫描(cache 友好性的甜点区)
固定矩阵 128×128,扫描 tile ∈ {4, 8, 16, 32, 64},看耗时曲线:块太小(启动开销)、太大(放不进 cache)都差。
n = 128
A = np.random.rand(n, n); B = np.random.rand(n, n)
tiles = [2, 4, 8, 16, 32, 64, 128]
times = []
for t in tiles:
    # 旧口径:best-of-3(已由 bench() 的 warmup+repeat+median 取代)
    # for _ in range(3):  # 旧 best-of-3 循环
    times.append(bench(gemm_tiled, A, B, t) * 1e3)
    # 旧:times.append(best * 1e3)
    print("tile=%3d → %6.2f ms" % (t, times[-1]))

fig, ax = plt.subplots(figsize=(9, 4.5))
ax.plot(tiles, times, "o-", color="#1976D2")
ax.set_xlabel("块大小 tile"); ax.set_ylabel("耗时 (ms)")
ax.set_title("128×128 GEMM:块大小存在最优区间(cache 容量约束)")
ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
tile= 2 → 2435.97 ms
tile= 4 → 319.91 ms
tile=  8 →  46.80 ms
tile= 16 →   8.95 ms
tile= 32 →   1.36 ms
tile= 64 →   0.84 ms
tile=128 →   1.96 ms
C:\Users\24260\AppData\Local\Temp\ipykernel_1620\2729483540.py:16: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
代码实战 D:寄存器分块(register blocking)演示
同样"每读一个 A 值",算 $r$ 次输出 → 数据复用比提高 $r$ 倍。小矩阵上用纯 Python 对比 $r=1,2,4$,并统计"每个读入值被复用几次"。
def gemm_reg(A, B, r=1):
    """寄存器分块:一次算 r×r 输出子块,A/B 值在寄存器复用 r 次。"""
    M, K = A.shape; N = B.shape[1]
    C = np.zeros((M, N))
    for i in range(0, M, r):
        for k in range(K):
            a_blk = A[i:i + r, k]          # 读 r 个 A 值
            for j in range(0, N, r):
                b_blk = B[k, j:j + r]      # 读 r 个 B 值
                for ii in range(r):
                    for jj in range(r):
                        C[i + ii, j + jj] += a_blk[ii] * b_blk[jj]
    return C

n = 24
A = np.random.rand(n, n); B = np.random.rand(n, n)
ref = A @ B
for r in (1, 2, 4):
    t0 = time.perf_counter(); Cr = gemm_reg(A, B, r); dt = time.perf_counter() - t0
    ok = np.allclose(Cr, ref, atol=1e-10)
    print("r=%d: %6.1f ms | 每个读入值复用 %d 次 | 正确=%s" % (r, dt * 1e3, r, ok))
    assert ok
r=1:   23.1 ms | 每个读入值复用 1 次 | 正确=True
r=2:   13.7 ms | 每个读入值复用 2 次 | 正确=True
r=4:   10.0 ms | 每个读入值复用 4 次 | 正确=True
代码实战 E:roofline 模型(画出来)
假设参照机器:峰值算力 $\pi_{\text{peak}}=100$ GFLOPS、主存带宽 $\beta_{\text{mem}}=20$ GB/s(单核数量级)。把三种实现"算术强度 × 实测 GFLOPS"画到 roofline 上。
# roofline 参数(示意参照机)
PI_PEAK = 100.0   # GFLOPS
BETA = 20.0       # GB/s

def intensity(n):
    """GEMM n×n×n:数据 MN+MK+NK = 3n^2 个元素,FP64 8 字节。"""
    return 2 * n ** 3 / (3 * n ** 2 * 8)

n = 64
A = np.random.rand(n, n); B = np.random.rand(n, n)
t0 = time.perf_counter(); gemm_naive(A, B); t_n = time.perf_counter() - t0
t0 = time.perf_counter(); gemm_tiled(A, B); t_t = time.perf_counter() - t0
t0 = time.perf_counter(); A @ B; t_b = time.perf_counter() - t0
I = intensity(n)
pts = [("naive", I, gflops_of(n, t_n)), ("tiled", I, gflops_of(n, t_t)), ("BLAS", I, gflops_of(n, t_b))]

II = np.logspace(0.05, 3, 200)
roof = np.minimum(PI_PEAK, BETA * II)
fig, ax = plt.subplots(figsize=(9.5, 5.5))
ax.loglog(II, roof, "k-", lw=2, label="roofline: min(峰值算力, 带宽×强度)")
for name, ix, g in pts:
    ax.plot(ix, g, "o", ms=9, label="%s: %.2f GFLOPS" % (name, g))
ax.axvline(PI_PEAK / BETA, color="gray", ls="--", lw=1)
ax.text(PI_PEAK / BETA * 1.15, 2, "拐点 I*=%.0f FLOP/B" % (PI_PEAK / BETA), fontsize=10)
ax.set_xlabel("算术强度 (FLOP/Byte, 对数)"); ax.set_ylabel("可达性能 (GFLOPS, 对数)")
ax.set_title("GEMM n=64 的 roofline:naive 卡在带宽线上,BLAS 贴近算力线")
ax.legend(fontsize=9); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
print("naive 每字节运算 = 2/16 = 0.125 FLOP/B(带宽受限);分块后 I = %.1f FLOP/B" % I)
naive 每字节运算 = 2/16 = 0.125 FLOP/B(带宽受限);分块后 I = 5.3 FLOP/B
C:\Users\24260\AppData\Local\Temp\ipykernel_1620\1869040587.py:28: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
面试考点
Q1 GEMM 的 FLOPs 怎么算?
A:$C_{M\times N}=A_{M\times K}B_{K\times N}$,每个输出元素 K 次乘加,共 $2MNK$ FLOPs。
Q2 naive 三重循环为什么慢?
A:内层每次迭代都从主存读 A、B(每字节只 0.125 FLOP),被内存带宽卡死——带宽受限;局部性差,cache 几乎不命中。
Q3 分块(tiling)优化了什么?
A:让一块数据在 cache 中被反复复用(复用 $b$ 次),把每字节运算量从 0.125 提升到 $b/8$,把带宽受限变成算力受限;块大小受 cache 容量约束。
Q4 roofline 模型怎么判断瓶颈?
A:算算术强度 $I$,画 $\min(\pi_{\text{peak}}, \beta I)$;实测点落在斜线上=带宽受限(优化访存/复用),贴近水平线=算力受限(优化计算/向量化/并行)。
Q5 cuBLAS / FlashAttention 为什么快?
A:tiling(共享内存)+ 寄存器分块 + SIMD/双缓冲 + 算子融合;FlashAttention 还用分块把注意力从 $O(T^2)$ 显存降到 $O(T)$,本质都是"少搬数据、多复用"。
Q6 为什么大矩阵 GEMM 天生"算力受限"?
A:数据量 $O(n^2)$、运算量 $O(n^3)$,算术强度随 $n$ 线性增长——越大越划算。
小结与自测清单
本讲要点:
- GEMM FLOPs = 2MNK;算术强度 = FLOPs/字节;
- naive 慢在"每步碰主存"(带宽受限);tiling + 寄存器分块把复用写进循环;
- roofline:斜线(带宽)↔ 水平线(算力),看瓶颈再对症下药。
自测清单:
- 能手算任意 GEMM 的 FLOPs 与算术强度
- 能默写 naive / tiled / register-blocking 三种循环骨架
- 能解释块大小为什么有最优区间(cache 容量 vs 复用)
- 能画并解读一张 roofline 图
下一讲预告:02-混合精度与显存账本(规划中)——从"算子怎么快"到"训练怎么省显存"。