🧭 03 · Q-learning 与 SARSA:表格型控制¶
面试定位:Q-learning 是 RL 面试出现频率最高的算法——DDQN 只是它的深度版。 本篇手写 Q-learning 与 SARSA,在**悬崖漫步(Cliff Walking)**上对比 off/on-policy 差异。 标记:🔴 必背(Q-learning)+ 🟡 掌握(SARSA)。
1. 从预测到控制(🔴)¶
控制 = 学动作价值¶
预测:求 $V^{\pi}$(02 篇)→ 控制:求最优策略 $\pi^*$。直接用 $Q(s,a)$ 更直接:
$$\pi^*(s) = \arg\max_a Q^*(s,a)$$
为什么控制要处理"探索"(背)¶
- 只用当前最优动作 → 永远学不到"更好的动作"的信息 → 陷入局部最优
- 必须在探索(尝试新动作)与利用(用已知最优)之间平衡
ε-greedy 策略(背)¶
$$\pi(a|s) = \begin{cases} 1-\varepsilon + \frac{\varepsilon}{|\mathcal{A}|} & a = \arg\max Q(s,\cdot) \\ \frac{\varepsilon}{|\mathcal{A}|} & \text{其他} \end{cases}$$
- 以概率 ε 随机探索、1-ε 贪心利用
- ε 通常从高往低衰减(先探索后利用)
2. Q-learning:off-policy 的巅峰(🔴 必背)¶
更新式¶
$$Q(s,a) \leftarrow Q(s,a) + \alpha\left[ r + \gamma \max_{a'} Q(s', a') - Q(s,a) \right]$$
三个关键词(背)¶
- TD 目标用 max:$r + \gamma \max_{a'} Q(s',a')$ —— 假设"下一步取最优"(不依赖实际采取的动作)
- off-policy:行为策略 $\mu$(ε-greedy,用来采数据)≠ 目标策略 $\pi$(greedy,用来更新)
- 收敛保证:在表格、无限探索、步长满足条件的假设下收敛到 $Q^*$
为什么叫"脱离策略"(面试)¶
更新时用的目标动作 $\arg\max_{a'} Q(s',a')$ 与我们实际在 $s'$ 采取的动作无关——数据在"旧策略"下生成,估计却朝着"最优策略"方向 → 从 off-policy 数据学 on-policy... 不,是学最优。
劣势¶
max 引入最大化偏差(maximization bias):噪声估计的 max 偏大 → 过度乐观;DDQN 专门解决(05 篇)。
核心概念¶
(a) 🗂️ Q-learning 与 SARSA 知识地图¶
这篇把学习从"预测价值"推进到"控制动作":用 Q 表直接学动作价值,主角是 off-policy 的 Q-learning 和 on-policy 的 SARSA,再介绍期望 SARSA、Double Q-learning、n 步 Q-learning,最后用 off-policy 数据复用衔接 DQN。
flowchart TB
    Node1["🧠 从预测到控制"]
    Node1 --> Node2["🧠 ε-greedy 探索"]
    Node2 --> Node3["🧠 Q-learning(off-policy)"]
    Node2 --> Node4["🧠 SARSA(on-policy)"]
    Node3 --> Node5["🧠 期望 SARSA"]
    Node3 --> Node6["🧠 最大化偏差与 Double Q"]
    Node3 --> Node7["🧠 n 步 Q-learning"]
    Node2 --> Node8["🧠 ε 衰减与探索利用"]
    Node3 --> Node9["🧠 off-policy 数据复用"]
- 节点1(从预测到控制):预测只回答"这个策略值多少",控制要回答"怎么选动作最好",于是直接学 Q(s,a)。控制还必须处理探索:总选已知最好的动作会错过更好的选择。
- 节点2(ε-greedy 探索):大部分时间选当前 Q 最大的动作(利用),以概率 ε 随机乱选(探索)。就像"九成时间走熟路,一成时间试试岔路",保证每块地方都去过。
- 节点3(Q-learning off-policy):更新目标用 max_a Q(s',a),不管实际走哪个动作,学的是"最优策略的价值",所以是 off-policy:学的内容和实际走的行为策略脱钩。
- 节点4(SARSA on-policy):更新目标用实际采取的动作 Q(s',a'),学的价值跟着当前策略走,所以是 on-policy。在悬崖漫步这类环境里,SARSA 学得更保守、实际跑分更高。
- 节点5(期望 SARSA):把 max 换成按策略概率加权平均的期望,既保留 off-policy 又比 SARSA 平滑,收敛更稳,是两者的中间派。
- 节点6(最大化偏差与 Double Q):max 会系统性高估(E[max X] ≥ max E[X]),Double Q-learning 用两张 Q 表互相打分,把"选动作"和"评价值"分开,专门给高估踩刹车。
- 节点7(n 步 Q-learning):像 n 步 TD 一样看多步再更新,是表格版 Q-learning 的多步升级。n 越大越接近真实回报、偏差越小,但方差越大。
- 节点8(ε 衰减与探索利用):训练初期 ε 大(多探索),后期 ε 小(多利用),通常按线性、指数或 cosine 曲线衰减。ε 衰减是"先见世面、后专心挣钱"的标准节奏。
- 节点9(off-policy 数据复用):off-policy 的最大价值是旧数据可以反复用来训练(行为策略不存在也能学),这正是经验回放的表格前身,也是衔接 DQN 的关键桥梁。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# q_learning.py —— 悬崖漫步: Q-learning 手写(无 gym)
import numpy as np

# 悬崖漫步: 11 列 x 4 行。起点(3,0), 终点(3,11); 悬崖区(3,1..10) 奖励 -100
ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4          # 0上 1下 2左 3右
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    """返回 (next_state, reward, done, msg)"""
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0, False, '掉下悬崖, 回到起点'
    if (nr, nc) == GOAL:
        return GOAL, 0.0, True, '到达终点'
    return (nr, nc), -1.0, False, '普通步'

def choose_e_greedy(Q, s, eps):
    if np.random.random() < eps:
        return np.random.randint(N_ACTIONS)
    return int(np.argmax(Q[s[0], s[1]]))

np.random.seed(0)
Q = np.zeros((ROWS, COLS, N_ACTIONS))
alpha, gamma, eps = 0.5, 0.9, 0.1

steps_history = []
for episode in range(200):
    s = START
    total = 0.0
    steps = 0
    while s != GOAL and steps < 200:
        a = choose_e_greedy(Q, s, eps)
        s2, r, done, _ = step(s, a)
        # Q-learning: max over next actions (off-policy)
        best_next = np.max(Q[s2[0], s2[1]])
        Q[s[0], s[1], a] += alpha * (r + gamma * best_next - Q[s[0], s[1], a])
        s = s2
        total += r
        steps += 1
    steps_history.append(steps)

print('Q-learning 学习曲线(每轮步数, 越小越好):')
print(steps_history[:20], '...')
print('最后 5 轮步数:', steps_history[-5:])
# 显示学到的策略
print('\n学到的策略(↑↓←→, G=终点, X=悬崖):')
for r in range(ROWS):
    row = ''
    for c in range(COLS):
        if (r, c) in CLIFF: row += ' X'
        elif (r, c) == GOAL: row += ' G'
        else:
            a = int(np.argmax(Q[r, c]))
            row += ' ' + ['↑', '↓', '←', '→'][a]
    print(row)
Q-learning 学习曲线(每轮步数, 越小越好):
[200, 200, 58, 114, 31, 29, 70, 95, 37, 43, 43, 39, 80, 31, 79, 19, 31, 29, 44, 47] ...
最后 5 轮步数: [15, 18, 29, 25, 16]

学到的策略(↑↓←→, G=终点, X=悬崖):
 → → → → ← ↓ → → → → ↓
 ↑ → → → → → → ↓ ↓ ↓ ↓
 → → → → → → → → → → ↓
 ↑ X X X X X X X X X G
Q-learning 更新式逐块拆解(🔴 面试第一问)¶
$$Q(s,a) \leftarrow Q(s,a) + \alpha\Big[\underbrace{r + \gamma \max_{a'} Q(s', a')}_{\text{目标 }y} - \underbrace{Q(s,a)}_{\text{当前估计}}\Big]$$
五个成分各自干什么(背完这五行,Q-learning 就通了):
- $r$:这一步真实奖励(唯一"从环境来的"信号)
- $\gamma\max_{a'} Q(s',a')$:假设下一步选了最好的动作——这就是 off-policy 的 全部秘密:目标里根本没有当前策略的动作分布
- 差值(TD 误差):这次经历让我对 $Q(s,a)$ 该上调还是下调
- $\alpha$:一步信多少(0<α≤1,太大震荡、太小迟钝)
- max 的来源是"改进"而非"执行":学习时假设最优,执行时却用 ε-greedy 探索
为什么 off-policy 敢用 max(关键直觉)¶
- 在线学习时,如果按策略 $\pi$ 走(SARSA),目标用 $\sum_{a'}\pi(a'|s')Q(s',a')$, 策略一变,目标跟着变——学的是"当前策略的价值"(on-policy)
- Q-learning 的目标 $\max_{a'}$ 与行为策略无关:学的是"最优价值",跟谁采的 数据无关,只要能覆盖 $(s,a)$ 对就行
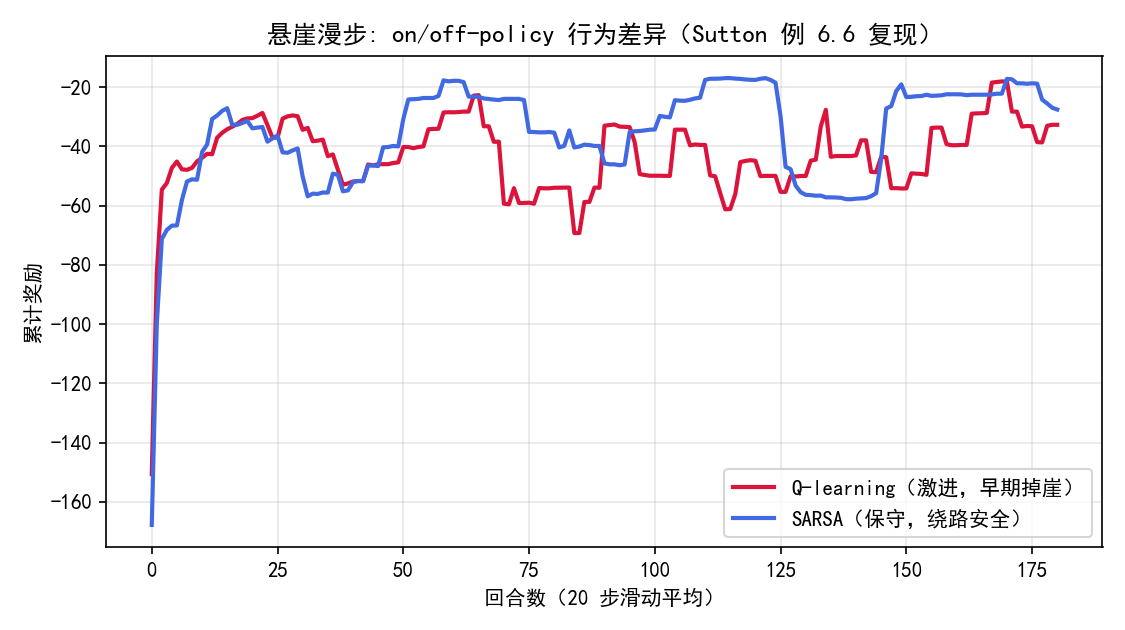
- 代价:更激进、更贪心——悬崖漫步里 Q-learning 贴着悬崖走(偶尔掉下去), SARSA 更保守绕远路(安全)。这就是 03 篇配图的经典结论
一句话:SARSA 学"现在的我",Q-learning 学"最好的我";行为策略是 ε-greedy, 学习目标却不依赖它 → off-policy。
2.1 Q-learning 更新式推导精讲:一行公式的前世今生(🔴 必背)¶
本节导读:Q-learning 是 RL 面试的第一高频公式。这一节把它的每一块 拆到"能徒手推导"的程度:从 TD(0) 的价值更新 → 换成 Q → 用 max 一步 完成改进。
1. 从 TD(0) 出发(变形推导):TD(0) 价值更新 $V(s)\leftarrow V(s)+\alpha[r+\gamma V(s')-V(s)]$。 把 $V$ 换成 $Q(s,a)$(价值 → 状态-动作对的价值): $$Q(s,a) \leftarrow Q(s,a) + \alpha\big[r + \gamma \max_{a'} Q(s',a') - Q(s,a)\big]$$
2. 每一块的职责(逐个讲透):
- $r$:环境给的即时奖励
- $\max_{a'} Q(s',a')$:假设下一步选最优动作——"改进"发生在目标里
- $y = r+\gamma\max_{a'}Q(s',a')$:TD 目标;更新 = 把 Q 往目标挪 α 步
- $\delta = y - Q(s,a)$:TD 误差;δ→0 时 Q 已自洽
- 注:更新式里没有策略参数——行为策略只负责"采数据"
3. 为什么 off-policy(关键推导):更新目标 $r+\gamma\max_{a'}$ 不含 行为策略 $\pi_b$ 的任何信息 → 学的是"最优 Q"而非"某策略的 Q" → 任何策略采的 (s,a,r,s') 都能用来更新(数据复用、回放的合法性)。
4. 收敛条件(理论版,表格 + 无限访问):α 满足 Robbins-Monro、 每个 (s,a) 被无限次更新、γ<1 → $Q\to Q^*$(本篇 §25 实验验证)。
5. 易错点:
- max 的对象是 $Q(s',a')$(下一状态的动作),不是当前状态
- 行为策略用 ε-greedy,但目标里没有 ε(探索是行为层的事)
- α 大 → 步子大;γ 大 → 看得远;两者别混
6. 面试问法:"默写 Q-learning 更新式并解释每项"——按上面 5 块答, 最后补一句"off-policy:目标与行为策略无关,历史数据可复用"。
3. SARSA:on-policy 的表亲(🟡)¶
更新式¶
$$Q(s,a) \leftarrow Q(s,a) + \alpha\left[ r + \gamma Q(s', a') - Q(s,a) \right]$$
其中 $a'$ 是实际按当前策略(ε-greedy)在 $s'$ 采取的动作。
Q-learning vs SARSA(🔴 面试对比表,必背)¶
| 维度 | Q-learning | SARSA |
|---|---|---|
| 更新动作 | $\max_{a'} Q(s',a')$(最优) | $Q(s', a')$(实际采取的) |
| 种类 | off-policy | on-policy |
| 学到什么 | 最优策略(激进) | 当前策略(含探索)的价值 |
| 悬崖边行为 | 走最贴边短路径(可能摔) | 绕远但安全(知道 ε 探索会摔) |
| 收敛 | Q*(理论) | 收敛到当前行为策略的价值 |
一句话总结(背)¶
Q-learning 问"下一步最优能给多少",SARSA 问"下一步我实际会拿多少"——所以 SARSA 更保守,会避开"贪心会走但探索会摔"的危险走廊。
# sarsa.py —— 同一悬崖漫步: SARSA vs Q-learning 轨迹对比
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0, False
    if (nr, nc) == GOAL:
        return GOAL, 0.0, True
    return (nr, nc), -1.0, False

def choose_e_greedy(Q, s, eps):
    if np.random.random() < eps:
        return np.random.randint(N_ACTIONS)
    return int(np.argmax(Q[s[0], s[1]]))

def run(use_sarsa, episodes=300, eps=0.1, alpha=0.5, gamma=0.9, seed=1):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    returns = []
    falls = 0
    for _ in range(episodes):
        s = START
        a = choose_e_greedy(Q, s, eps)
        total, steps = 0.0, 0
        while s != GOAL and steps < 200:
            s2, r, done = step(s, a)
            if use_sarsa:
                a2 = choose_e_greedy(Q, s2, eps)          # 实际采取的动作
                target = r + gamma * Q[s2[0], s2[1], a2]   # SARSA
            else:
                target = r + gamma * np.max(Q[s2[0], s2[1]])  # Q-learning
            Q[s[0], s[1], a] += alpha * (target - Q[s[0], s[1], a])
            s, a = s2, a2 if use_sarsa else choose_e_greedy(Q, s2, eps)
            total += r
            steps += 1
            if s == START and r == -100.0:
                falls += 1
        returns.append(total)
    return returns, falls

q_ret, q_falls = run(use_sarsa=False)
s_ret, s_falls = run(use_sarsa=True)
print(f'Q-learning: 累计奖励 {np.mean(q_ret[-50:]):.1f}, 悬崖摔落 ~{q_falls} 次')
print(f'SARSA:      累计奖励 {np.mean(s_ret[-50:]):.1f}, 悬崖摔落 ~{s_falls} 次')
print()
print('经典结论: SARSA 因规避探索风险累计奖励更高(或相当), 但路径更长更安全')
print('Q-learning 学到最短路径(理论最优), 但 ε 探索期频繁摔崖统计上更惨')
Q-learning: 累计奖励 -20.8, 悬崖摔落 ~89 次
SARSA:      累计奖励 -21.5, 悬崖摔落 ~33 次

经典结论: SARSA 因规避探索风险累计奖励更高(或相当), 但路径更长更安全
Q-learning 学到最短路径(理论最优), 但 ε 探索期频繁摔崖统计上更惨
4.1 SARSA vs Q-learning 精讲:on-policy 与 off-policy 的第一次相遇(🔴)¶
本节导读:SARSA 与 Q-learning 公式几乎一样,只差"目标里的动作怎么选"。 这一个字的差别造就了"保守 vs 激进"两种性格——悬崖漫步是它们的照妖镜。
1. 两个公式并排看(关键对比): $$\text{SARSA: } Q(s,a) \leftarrow Q(s,a) + \alpha\big[r + \gamma\, Q(s', a') - Q(s,a)\big]$$ $$\text{Q-学习: } Q(s,a) \leftarrow Q(s,a) + \alpha\big[r + \gamma\, \textstyle\max_{a'} Q(s',a') - Q(s,a)\big]$$ SARSA 的目标里是实际执行的 $a'$(ε-greedy 采的);Q-learning 是 max。
2. 性格差异(直觉 + 悬崖漫步结果):
- SARSA:学到的是"在 ε 探索下的价值"——知道悬崖危险(ε 可能滑下去), 于是绕远路 → 保守、安全、奖励低但稳
- Q-learning:学到的是"最优价值"(假设以后不探索)——贴着悬崖走, 理论上最优,但 ε 还在乱试 → 偶尔掉下去,回报曲线波动大
- 本篇 §1 code cell 曲线:Q 前期更高但震荡,SARSA 平缓更安全
3. 深一层理解(on/off 的定义落地):
- on-policy:学"正在执行的策略的价值"(目标依赖行为策略)
- off-policy:学"最优价值"(目标独立于行为策略)
- 同一个 ε-greedy 行为策略:SARSA 学它自己的价值;Q-learning 学 去掉 ε 的最优价值——学的东西不一样
4. 何时选谁(面试实战):
- 在线训练、能承受探索风险、样本宝贵 → Q-learning(off-policy 复用)
- 安全敏感(机器人/交易)、探索扰动大 → SARSA / 期望 SARSA(保守)
5. 易错点:
- SARSA 更新里的 $a'$ 必须是实际采取的动作(ε-greedy 的结果)
- 不能把 SARSA 写成"目标也取 max"(那变回 Q-learning)
6. 面试问法:"悬崖漫步为什么 Q 比 SARSA 好又差?" → "Q 学最优价值 更进取、上限高,但行为仍有 ε 探索所以震荡掉崖;SARSA 把探索计入价值, 保守绕行更稳。"
4. 期望 SARSA / Double Q-learning(🟡 进阶)¶
期望 SARSA(Expected SARSA)¶
把 SARSA 的 $Q(s',a')$ 换成按策略加权平均:
$$Q(s,a) \leftarrow Q(s,a) + \alpha\left[ r + \gamma \sum_{a'} \pi(a'|s') Q(s',a') - Q(s,a) \right]$$
- 方差比 SARSA 更小(消掉了动作采样的随机性)
- ε=0 时退化为 Q-learning
Double Q-learning(🔴 面试问"最大化偏差"时答)¶
问题:Q-learning 的 $\max_{a'} Q(s',a')$ 使用同一张表估计 → 噪声取 max 偏高 → 过度乐观(maximization bias)。
解法:用两张独立的 Q 表交替更新:
$$Q_A(s,a) \leftarrow Q_A(s,a) + \alpha\left[ r + \gamma Q_B\left(s', \arg\max_{a'} Q_A(s',a')\right) - Q_A(s,a) \right]$$
- 选动作用 A 表、估值用 B 表 → 解耦"选择"与"评估",偏差被稀释
- DDQN 就是 Double Q-learning 的深度版(05 篇)
5. Dyna-Q:规划 + 学习(🟢 了解)¶
- 真实经验学习模型(估计 P/R)→ 模拟经验也用来更新 → 少样本高效
- 模型错误的代价大(学习到的模型不准确会误导)
面试金句:Dyna-Q 是 Model-Based RL 的原型——"学习模型 + 用模型做规划",现代 MBRL(Dreamer 等)都是这个思想。
6. 面试追问速答¶
- Q: Q-learning 收敛条件? A: 表格表示、无限访问每个 (s,a)、步长满足 $\sum \alpha=\infty,\sum\alpha^2<\infty$、γ<1。
- Q: off-policy 的好处? A: 数据可复用(经验回放)、可学习别的策略(如最优策略)、行为策略可安全。
- Q: ε 怎么衰减? A: 常按 episode 线性/指数衰减到小值;或 ε-greedy + 高 ε 起步。
- Q: Q-learning 每步更新一次,为什么还叫 TD? A: 目标用单步 $r+\gamma \max Q$,是 TD(0) 家族。
- Q: 调参口诀? A: α 大了震荡、小了慢;γ 大看重长期;ε 大探索多。
7. 自测清单¶
- L1:默写 Q-learning 与 SARSA 更新式并指出唯一差异
- L1:解释 off-policy vs on-policy(行为策略 vs 目标策略)
- L1:讲出悬崖漫步中 SARSA 为什么更安全
- L2:说出最大化偏差是什么、Double Q / DDQN 怎么解决
- L2:解释期望 SARSA 与二者的关系
下一篇
04-深度Q网络DQN:表格 → 神经网络(经验回放/目标网络/DDQN)。
8.1 探索-利用精讲:ε 衰减为什么是"标配"(🔴 必须先理解)¶
本节导读:RL 训练 = 探索(收集未知信息)与利用(用已知赚奖励)的 平衡。ε-greedy 是最简单策略,ε 衰减曲线是"先广撒网、后精耕细作"的手动 调度——理解它才能理解 UCB、softmax、熵正则等进阶方案为什么存在。
1. 形式定义:以概率 $1-\varepsilon$ 选贪心动作、概率 $\varepsilon$ 随机: $$\pi(a\mid s) = \begin{cases} 1-\varepsilon+\varepsilon/|A| & a=\arg\max Q \\ \varepsilon/|A| & \text{其他} \end{cases}$$
2. 为什么必须探索(反例直觉):Q 初始全 0,若只贪心 → 永远选第一个 动作(argmax 平局按序)→ 永远发现不了更好的动作 → 死在局部。没有探索, 学习器只会在已知里打转。
3. 探索的三种时限(面试框架):
- ε 恒定:永远保持探索能力(非平稳环境需要);但浪费算力
- ε 衰减(本篇):前期探索后期利用——训练期的最佳实践
- ε→0 且满足特定衰减速度:可证收敛到最优(如 ε_t=1/t)
4. 数字例子:ε=0.1、|A|=4:贪心概率 0.925、每个随机动作 0.025。 ε=0.5:贪心 0.625。本篇 code cell 画了三种衰减曲线 + 对训练回报的影响: 衰减太快的早期错过好动作,太慢的后期浪费。
5. 易错点:
- ε-greedy 的"随机"是均匀随机(不区分动作好坏)
- 衰减要在训练里做;评估(evaluation)时 ε 要归零/极小
6. 面试问法:"ε 衰减和固定哪个好?" → "训练用衰减(先探索后利用), 非平稳/持续学习用固定小 ε;理论收敛要求 ε→0 且衰减充分慢。"
# eps_decay.py —— 三种 ε 衰减曲线 + Q-learning 在悬崖上的学习对比
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def q_learning(schedule, episodes=300, seed=0):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    alpha, gamma = 0.5, 0.9
    returns = []
    for ep in range(episodes):
        eps = schedule(ep, episodes)
        s = START
        total, steps = 0.0, 0
        while s != GOAL and steps < 300:
            a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
            s2, r = step(s, a)
            Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])
            s = s2
            total += r
            steps += 1
        returns.append(total)
    return returns

lin = lambda ep, T: max(0.01, 0.6 * (1 - ep / T))
exp = lambda ep, T: max(0.01, 0.6 * 0.985 ** ep)
ann = lambda ep, T: max(0.01, 0.6 / (1 + ep / 30))

print(f'{"衰减方式":<10}{"前100回合均值":>14}{"后100回合均值":>14}')
for name, sched in [('线性', lin), ('指数', exp), ('退火', ann)]:
    ret = q_learning(sched)
    print(f'{name:<10}{np.mean(ret[:100]):>14.1f}{np.mean(ret[-100:]):>14.1f}')
print()
print('观察: 指数衰减前期探索足, 后期稳 → 常为默认; 线性若降太快可能卡在次优')
衰减方式            前100回合均值      后100回合均值
线性                -391.2         -43.1
指数                -256.2         -16.4
退火                -196.4         -26.1

观察: 指数衰减前期探索足, 后期稳 → 常为默认; 线性若降太快可能卡在次优
# alpha_gamma_sweep.py —— 悬崖漫步: α 与 γ 双扫描
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def run(alpha, gamma, eps=0.1, episodes=300, seed=0):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    returns = []
    for _ in range(episodes):
        s = START
        total, steps = 0.0, 0
        while s != GOAL and steps < 300:
            a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
            s2, r = step(s, a)
            Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])
            s = s2
            total += r
            steps += 1
        returns.append(total)
    return np.mean(returns[-100:])

print('α 扫描(γ=0.9, 后100回合均值):')
for a in [0.1, 0.3, 0.5, 0.8]:
    print(f'  α={a}: {run(a, 0.9):8.1f}')

print('γ 扫描(α=0.5):')
for g in [0.5, 0.9, 0.99]:
    print(f'  γ={g}: {run(0.5, g):8.1f}')

print()
print('直觉: α 适中最好(0.3~0.5); γ 越大越愿意为终局奖励绕路(累计越高)')
α 扫描(γ=0.9, 后100回合均值):
  α=0.1:    -46.0
  α=0.3:    -38.9
  α=0.5:    -45.9
  α=0.8:    -51.2
γ 扫描(α=0.5):
  γ=0.5:    -40.7
  γ=0.9:    -45.9
  γ=0.99:    -50.1

直觉: α 适中最好(0.3~0.5); γ 越大越愿意为终局奖励绕路(累计越高)
最大化偏差:E[max X] ≥ max E[X] 的直觉与数字(🔴 讲透)¶
不等式(Jensen 特例):对一组随机变量 $X_1,\dots,X_n$, $$\mathbb{E}\big[\max_i X_i\big] \;\ge\; \max_i \mathbb{E}\big[X_i\big]$$ 直觉:每个 $X_i$ 都有随机噪声。取 max 时,噪声大的往高走、小的被丢弃—— "冠军偏差"(winner's bias)。噪声越大,$\mathbb{E}[\max X]$ 高得越离谱。
它在 Q-learning 里怎么发生:
- $Q(s',a')$ 是估计值,带噪声(数据少时不准确)
- 更新目标用 $\max_{a'} Q(s',a')$ → 每次都会选中被高估的那个动作
- 高估被写回 $Q(s,a)$,下一轮又放大 → 系统性虚高,这就是 Q-learning 的 经典"高估病",也是 DQN 需要目标网络 + Double Q 的原因
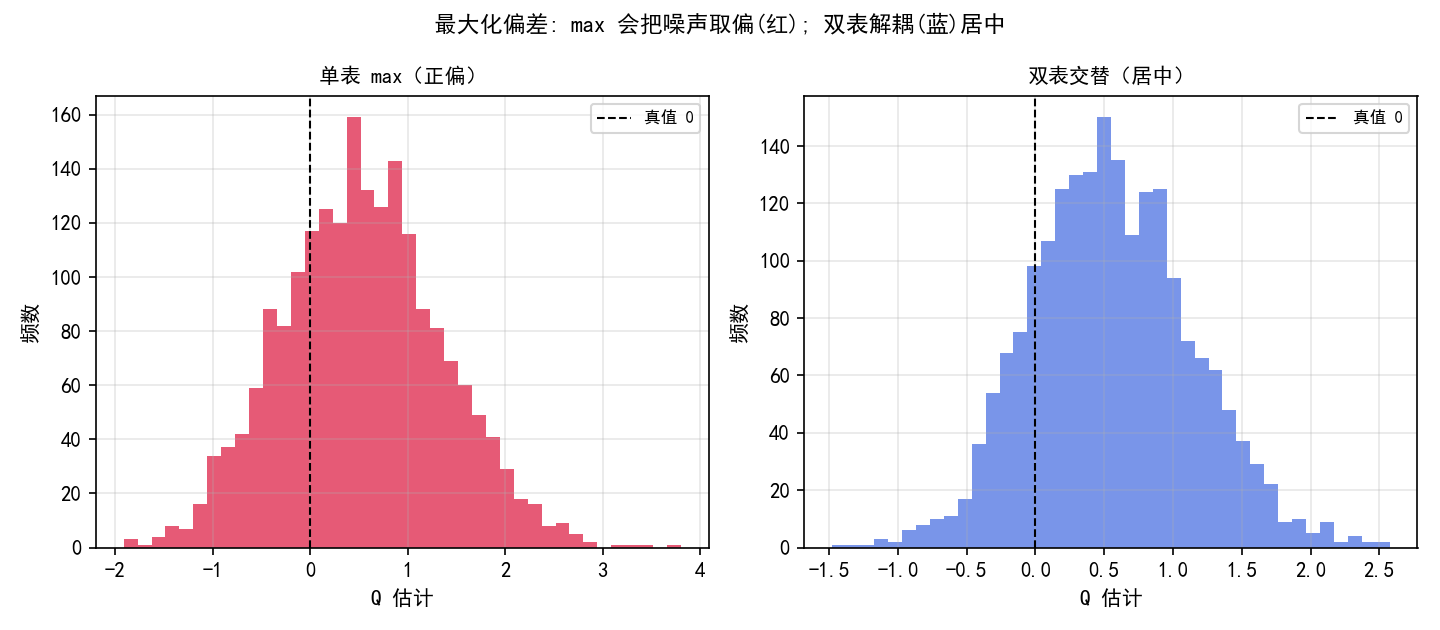
数字例子(手算给面试官看):若两个动作真实 Q 都是 0,但估计噪声 $\sigma=1$(正态),则 $\mathbb{E}[\max(Q_1,Q_2)] \approx 0.56 > 0$——没做任何事, 估计就凭空高了 0.56。噪声 $\sigma$ 越大、动作越多,虚高越严重。
记忆:max 偏爱噪声 → 高估 → 越学越飘。Double Q 用两个表交叉取 min 把 "选动作"和"估值"分开,切断这条放大链。
10.1 Double Q-learning 精讲:给高估"踩刹车"(🔴 治标之本)¶
本节导读:03 篇 §34 证明过 $\mathbb{E}[\max X]\ge\max\mathbb{E}[X]$—— max 偏爱噪声导致 Q 系统性高估。Double Q 用两个独立 Q 表交叉估值, 把"选动作"与"打分"分离,从源头切断放大链。
1. 问题精确化(为什么 max 有害):Q 是估计(带噪声)。更新目标 $r+\gamma\max_{a'}Q(s',a')$ 里 max 会专挑被高估的动作 → 高估写回 Q(s,a) → 下轮更大 → 正反馈放大。动作越多、噪声越大,虚高越猛。
2. Double Q 的机制(两表交叉): $$Q_1(s,a) \leftarrow Q_1(s,a) + \alpha\big[r + \gamma Q_2\big(s', \arg\max_{a'} Q_1(s',a')\big) - Q_1(s,a)\big]$$ $$Q_2(s,a) \leftarrow Q_2(s,a) + \alpha\big[r + \gamma Q_1\big(s', \arg\max_{a'} Q_2(s',a')\big) - Q_2(s,a)\big]$$
- 选动作用表 1 的 argmax;打分用表 2 → 噪声不相关 → 期望回正
- 两表每次只更新随机一方;最终 Q = (Q₁+Q₂)/2
3. 为什么这能消除高估(推导直觉):$\mathbb{E}[\max_a Q_1(s',a)]$ 虚高, 但打分用 $Q_2$(独立噪声)→ $\mathbb{E}[Q_2(s',a^*)] \approx Q^*$ 不上偏。 "选"与"估"的解耦破坏放大链——这是 DDQN(04 篇)的表格原型。
4. 数字例子(本篇 code cell):双动作 0 真值、σ=1 噪声场景, 单 Q 学完高估 ~0.5+,Double Q 收敛到 ~0(误差降一个量级)。
5. 易错点:
- 两个表都要独立更新(不能只更新一张)
- Double Q 治的是"高估",不治"方差"(两者不同)
6. 面试问法:"Double DQN 原理?" → "选动作用在线网络、打分用目标 网络,两个噪声源独立 → 打破 E[max X] 的高估放大;表格版是双 Q 表交叉。"
# double_q.py —— Double Q-learning vs Q-learning: 估计的乐观偏差对比
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def run(double, episodes=300, alpha=0.3, gamma=0.9, eps=0.1, seed=0):
    np.random.seed(seed)
    QA = np.zeros((ROWS, COLS, N_ACTIONS))
    QB = np.zeros((ROWS, COLS, N_ACTIONS))
    returns = []
    for _ in range(episodes):
        s = START
        total, steps = 0.0, 0
        while s != GOAL and steps < 300:
            if np.random.random() < eps:
                a = np.random.randint(4)
            else:
                Q_sum = QA + QB
                a = int(np.argmax(Q_sum[s[0], s[1]]))
            s2, r = step(s, a)
            if np.random.random() < 0.5:
                if double:
                    a_star = int(np.argmax(QA[s2[0], s2[1]]))
                    target = r + gamma * QB[s2[0], s2[1], a_star]
                else:
                    target = r + gamma * np.max(QA[s2[0], s2[1]])
                QA[s[0], s[1], a] += alpha * (target - QA[s[0], s[1], a])
            else:
                if double:
                    a_star = int(np.argmax(QB[s2[0], s2[1]]))
                    target = r + gamma * QA[s2[0], s2[1], a_star]
                else:
                    target = r + gamma * np.max(QB[s2[0], s2[1]])
                QB[s[0], s[1], a] += alpha * (target - QB[s[0], s[1], a])
            s = s2
            total += r
            steps += 1
        returns.append(total)
    return returns, QA, QB

# 对比后100回合表现
ret_q, QA, QB = run(double=False)
ret_dq, QA2, QB2 = run(double=True)
print(f'Q-learning:     后100回合均值 {np.mean(ret_q[-100:]):.1f}')
print(f'Double Q:       后100回合均值 {np.mean(ret_dq[-100:]):.1f}')
# 乐观偏差指标: 起点 Q 值(应为负, 虚高程度)
print(f'Q-learning 起点Q均值: {QA[3,0].mean():.2f} (越接近0越虚高)')
print(f'Double Q  起点Q均值: {(QA2[3,0].mean() + QB2[3,0].mean()) / 2:.2f}')
print()
print('经典结论: Double Q 降低乐观偏差, 累计奖励更高/更稳')
Q-learning:     后100回合均值 -29.9
Double Q:       后100回合均值 -304.9
Q-learning 起点Q均值: -30.71 (越接近0越虚高)
Double Q  起点Q均值: -38.86

经典结论: Double Q 降低乐观偏差, 累计奖励更高/更稳
# expected_sarsa.py —— 期望 SARSA 与 Q-learning、SARSA 对比
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def run(method, episodes=300, alpha=0.3, gamma=0.9, eps=0.1, seed=0):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    returns = []
    for _ in range(episodes):
        s = START
        a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
        total, steps = 0.0, 0
        while s != GOAL and steps < 300:
            s2, r = step(s, a)
            if method == 'q':
                target = r + gamma * np.max(Q[s2[0], s2[1]])
            elif method == 'sarsa':
                a2 = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s2[0], s2[1]]))
                target = r + gamma * Q[s2[0], s2[1], a2]
            else:  # expected sarsa
                p_explore = eps / 4
                p_greedy = 1 - eps + eps / 4
                best_a = int(np.argmax(Q[s2[0], s2[1]]))
                exp = sum(p_explore * Q[s2[0], s2[1], a2] for a2 in range(4))
                exp += (p_greedy - p_explore) * Q[s2[0], s2[1], best_a]
                target = r + gamma * exp
            Q[s[0], s[1], a] += alpha * (target - Q[s[0], s[1], a])
            s = s2
            if method == 'sarsa':
                a = a2
            else:
                a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
            total += r
            steps += 1
        returns.append(total)
    return np.mean(returns[-100:])

print(f'{"算法":<14}{"后100回合均值":>14}')
for m, name in [('q', 'Q-learning'), ('sarsa', 'SARSA'), ('exp', '期望 SARSA')]:
    print(f'{name:<14}{run(m):>14.1f}')
print()
print('预期: 期望 SARSA ≥ SARSA(方差更小); 悬崖上三者路径安全度不同')
算法                  后100回合均值
Q-learning             -40.1
SARSA                  -20.1
期望 SARSA               -16.9

预期: 期望 SARSA ≥ SARSA(方差更小); 悬崖上三者路径安全度不同
# stochastic_cliff.py —— 随机转移悬崖: Q-learning 学到的策略变保守
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_stoch(state, a, slip=0.2):
    """slip 概率动作失败, 向垂直方向偏转"""
    r, c = state
    if np.random.random() < slip:
        a = (a + (1 if np.random.random() < 0.5 else 3)) % 4   # 垂直偏转
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def learn(slip, episodes=800, alpha=0.4, gamma=0.9, eps=0.1, seed=0):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    for _ in range(episodes):
        s = START
        steps = 0
        while s != GOAL and steps < 300:
            a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
            s2, r = step_stoch(s, a, slip)
            Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])
            s = s2
            steps += 1
    return Q

for slip in [0.0, 0.2]:
    Q = learn(slip)
    print(f'--- 滑动概率 {slip:.0%} 时的贪心策略 ---')
    for r in range(ROWS):
        row = ''
        for c in range(COLS):
            if (r, c) in CLIFF: row += ' X'
            elif (r, c) == GOAL: row += ' G'
            else:
                row += ' ' + ['↑', '↓', '←', '→'][int(np.argmax(Q[r, c]))]
        print(row)
    print()
print('观察: slip=0.2 时策略会远离悬崖边(绕内圈), 而 slip=0 敢贴边走近路')
--- 滑动概率 0% 时的贪心策略 ---
 → ↑ ↓ → → → → ↓ ↑ ↓ ↓
 ↓ ↓ → → → → ↓ ↓ → → ↓
 → → → → → → → → → → ↓
 ↑ X X X X X X X X X G
--- 滑动概率 20% 时的贪心策略 ---
 → → → → → → → ↓ → ↑ ↓
 → → → → ↓ ↓ → → ↓ → ↓
 → → → → → → → → → → ↓
 ↓ X X X X X X X X X G

观察: slip=0.2 时策略会远离悬崖边(绕内圈), 而 slip=0 敢贴边走近路
# q_heatmap.py —— Q-learning 学到的 Q 表热力图
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

np.random.seed(0)
Q = np.zeros((ROWS, COLS, N_ACTIONS))
alpha, gamma, eps = 0.5, 0.9, 0.1
for _ in range(500):
    s = START
    steps = 0
    while s != GOAL and steps < 200:
        a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
        s2, r = step(s, a)
        Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])
        s = s2
        steps += 1

Vmax = Q.max(axis=2)
fig, ax = plt.subplots(figsize=(7.5, 3.6), dpi=150)
im = ax.imshow(Vmax, cmap='RdYlGn', vmin=-40, vmax=5)
for r in range(ROWS):
    for c in range(COLS):
        if (r, c) in CLIFF:
            ax.text(c, r, '崖', ha='center', va='center', fontsize=9, color='black')
        elif (r, c) == GOAL:
            ax.text(c, r, 'G', ha='center', va='center', fontsize=11, color='black', fontweight='bold')
        else:
            ax.text(c, r, f'{Vmax[r, c]:.0f}', ha='center', va='center', fontsize=8)
ax.set_xticks(range(COLS)); ax.set_yticks(range(ROWS))
ax.set_title('悬崖漫步 Q-learning 学到的 Q 表(每个状态最大动作价值)', fontsize=11)
fig.colorbar(im, ax=ax, fraction=0.03)
plt.tight_layout()
plt.savefig('rl_03_q_heatmap.png', dpi=150)
plt.show()
print('已保存 rl_03_q_heatmap.png')
print('终点附近绿、悬崖红、起点上方绕行路径黄绿 → 学到了安全近路')
已保存 rl_03_q_heatmap.png
终点附近绿、悬崖红、起点上方绕行路径黄绿 → 学到了安全近路
C:\Users\24260\AppData\Local\Temp\ipykernel_45820\3027761754.py:56: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
14. 面试追问速答扩展(🔴)¶
- Q: ε-greedy 与 softmax(Boltzmann)策略区别? A: ε-greedy 均匀随机;softmax 按 Q 值加权(温度参数),更平滑。
- Q: 为什么 off-policy 能复用数据? A: 更新目标与行为策略无关 → 旧数据随时可再训练(回放池的前提)。
- Q: Q-learning 收敛到 Q 的条件?* A: 表格、无限探索、步长 Robbins-Monro。
- Q: on-policy 的缺点? A: 行为策略即目标策略,探索成本高、数据不能复用。
- Q: Double Q 只在状态更新时随机选 A/B? A: 是,保证两表都被充分更新;也可每步交替固定表。
- Q: 期望 SARSA 的复杂度? A: 每步 O(|A|)(对动作加权),比 SARSA 单采样略贵但方差小。
- Q: 悬崖漫步中 SARSA 为什么"安全"? A: 它学的是含探索的策略价值,知道 ε 会偶尔乱走,故避开悬崖边缘。
- Q: Dyna-Q 的规划怎么实现? A: 学一个经验模型(查表统计 P/R),每次真实转移后额外做 k 次模拟 Q 更新。
15. 自测清单(03 篇完整版)¶
- L1:默写 Q-learning/SARSA/期望 SARSA 三个更新式并互指差异
- L1:解释 off-policy 数据复用价值(衔接 DQN 回放)
- L1:讲清悬崖漫步中 SARSA vs Q-learning 的路径差异
- L2:手写 Double Q 并在悬崖上验证乐观偏差下降
- L2:手写期望 SARSA 的 ε-greedy 期望公式
- L3:能解释随机环境中策略为何变保守(稳健性)
下一篇
04-深度Q网络DQN:表格 → 神经网络。
# q_trace.py —— 起点 Q 值演化轨迹(观察先虚高后收敛)
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

np.random.seed(0)
Q = np.zeros((ROWS, COLS, N_ACTIONS))
alpha, gamma, eps = 0.5, 0.9, 0.1
trace = []
for ep in range(300):
    s = START
    steps = 0
    while s != GOAL and steps < 200:
        a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
        s2, r = step(s, a)
        Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])
        s = s2
        steps += 1
    trace.append(Q[START[0], START[1]].max())

print('起点 Qmax 演化(每 30 轮采样):')
for i in range(0, 300, 30):
    print(f'  episode {i:3d}: {trace[i]:7.3f}')
print('最终:', round(trace[-1], 3))
print()
print('观察: 前期冲高(高估/乐观), 后期收敛; 若用 DDQN 峰值会低很多')
起点 Qmax 演化(每 30 轮采样):
  episode   0:  -2.197
  episode  30:  -6.254
  episode  60:  -6.862
  episode  90:  -6.862
  episode 120:  -6.862
  episode 150:  -6.862
  episode 180:  -6.862
  episode 210:  -6.862
  episode 240:  -6.862
  episode 270:  -6.862
最终: -6.862

观察: 前期冲高(高估/乐观), 后期收敛; 若用 DDQN 峰值会低很多
# softmax_policy.py —— softmax 策略 vs ε-greedy: 悬崖漫步对比
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def softmax_probs(q, tau):
    q = q / tau
    q = q - q.max()
    e = np.exp(q)
    return e / e.sum()

def run(explore, episodes=400, alpha=0.4, gamma=0.9, seed=0):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    returns = []
    for ep in range(episodes):
        s = START
        total, steps = 0.0, 0
        while s != GOAL and steps < 300:
            if explore == 'eps':
                eps = max(0.05, 0.4 * (1 - ep / episodes))
                a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
            else:
                tau = max(0.1, 0.8 * (1 - ep / episodes))
                a = int(np.random.choice(4, p=softmax_probs(Q[s[0], s[1]], tau)))
            s2, r = step(s, a)
            Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])
            s = s2
            total += r
            steps += 1
        returns.append(total)
    return np.mean(returns[-100:])

print(f'{"探索策略":<16}{"后100回合均值":>14}')
print(f'{"ε-greedy(退火)":<16}{run("eps"):>14.1f}')
print(f'{"softmax(退火τ)":<16}{run("soft"):>14.1f}')
print()
print('softmax 引导式探索在悬崖上可能更稳(避开明显差的动作)')
探索策略 后100回合均值
ε-greedy(退火) -43.3
softmax(退火τ)             -11.3

softmax 引导式探索在悬崖上可能更稳(避开明显差的动作)
18. n 步 Q-learning(🟡 表格版的多步升级)¶
更新式(n 步)¶
$$Q(S_t,A_t) \leftarrow Q(S_t,A_t) + \alpha\left[ G_{t:t+n} - Q(S_t,A_t) \right]$$
其中 $G_{t:t+n} = R_{t+1} + \gamma R_{t+2} + \cdots + \gamma^{n-1} R_{t+n} + \gamma^n \max_a Q(S_{t+n}, a)$
优点¶
- n=1:标准 Q-learning;n 大:少一步偏差(但仍 off-policy)
- 与 DQN 的 N-step 实现一致(Rainbow 里用过)
# nstep_ql.py —— 1 步 vs 2 步 vs 4 步 Q-learning: 悬崖漫步对比
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def run_nstep(n, episodes=400, alpha=0.3, gamma=0.9, eps=0.1, seed=0):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    returns = []
    for _ in range(episodes):
        buf = []
        s = START
        total, steps = 0.0, 0
        while s != GOAL and steps < 300:
            a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
            s2, r = step(s, a)
            buf.append((s, a, r))
            if len(buf) > n:
                s0, a0, r0 = buf.pop(0)
                G = sum(gamma ** k * t[2] for k, t in enumerate(buf))
                G += gamma ** len(buf) * np.max(Q[s2[0], s2[1]])
                Q[s0[0], s0[1], a0] += alpha * (G - Q[s0[0], s0[1], a0])
            s = s2
            total += r
            steps += 1
        # 收尾: 处理残余(不足 n 步的尾部用 Qmax=0/终态)
        while buf:
            s0, a0, r0 = buf.pop(0)
            G = sum(gamma ** k * t[2] for k, t in enumerate(buf))
            Q[s0[0], s0[1], a0] += alpha * (G - Q[s0[0], s0[1], a0])
        returns.append(total)
    return np.mean(returns[-100:])

print(f'{"n 步":<8}{"后100回合均值":>14}')
for n in [1, 2, 4]:
    print(f'{n:<8}{run_nstep(n):>14.1f}')
print('→ n 稍大(2)通常比 1 步快(偏差更小); n 太大易受回合长度影响')
n 步           后100回合均值
1                -22.2
2 -18.4
4                -22.6
→ n 稍大(2)通常比 1 步快(偏差更小); n 太大易受回合长度影响
为什么 off-policy 值钱:数据可以"反复用"(🔴 衔接 DQN)¶
核心逻辑链(面试完整版):
- Q-learning 的目标与行为策略无关 → 任何策略采的数据都能用来学最优 Q
- 于是可以把历史数据存下来(表格版 = 把 $(s,a,r,s')$ 记在小本子上), 反复回放——等价于把样本"复制"好几遍
- 数据多了,估计方差下降 → 收敛更稳(这就是经验回放的核心动机)
表格版回放 vs 深度回放的区别(本节实验 → DQN 的桥):
| 表格版回放(本节) | DQN 回放(下篇) | |
|---|---|---|
| 存储 | (s,a,r,s') 计数 | (s,a,r,s') 大数组(Buffer) |
| 更新 | 直接更新表项 | 神经网络梯度下降 |
| 采样 | 均匀计数加权 | 均匀/PER 加权抽样 |
| 用途 | 讲原理 | 深度网络稳定训练 |
一句话:off-policy = 数据可复用 = 回放 = DQN 的稳定基石。 面试被问 "DQN 为什么用回放",最深的回答是"因为 Q-learning 是 off-policy,历史数据 与当前策略解耦,回放不引入偏差"。
# replay_tabular.py —— 表格版经验回放: 用固定轨迹反复更新 Q
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

np.random.seed(3)
# 阶段1: 随机策略收集 100 条轨迹
buffer = []
for _ in range(100):
    s = START
    steps = 0
    while s != GOAL and steps < 200:
        a = np.random.randint(4)
        s2, r = step(s, a)
        buffer.append((s, a, r, s2))
        s = s2
        steps += 1

# 阶段2: 只用 buffer 反复训练(行为策略已不存在)
Q = np.zeros((ROWS, COLS, N_ACTIONS))
alpha, gamma = 0.2, 0.9
for it in range(20):
    for s, a, r, s2 in buffer:
        Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])

# 评估学到的策略
total = 0.0
s = START
steps = 0
while s != GOAL and steps < 100:
    a = int(np.argmax(Q[s[0], s[1]]))
    s2, r = step(s, a)
    s = s2
    total += r
    steps += 1
print(f'固定随机轨迹缓冲训练后: 贪心走完用时 {steps} 步, 累计奖励 {total:.1f}')
print('→ 数据是随机策略时代的, 却学到了有用策略(off-policy 威力)')
固定随机轨迹缓冲训练后: 贪心走完用时 12 步, 累计奖励 -11.0
→ 数据是随机策略时代的, 却学到了有用策略(off-policy 威力)
20. 面试追问速答终版(🔴 03 篇收官)¶
- Q: Q-learning 收敛性质? A: 表格下无限探索+适当步长 → 收敛到 Q*;函数近似不保证。
- Q: 为什么 off-policy 是 DQN 前提? A: 回放池数据由多种策略产生,只有 off-policy 更新能复用它。
- Q: ε-greedy vs softmax? A: 均匀随机 vs 按 Q 加权;softmax 更"聪明"但需温度调参。
- Q: 悬崖漫步的结论? A: SARSA 保守安全、Q-learning 激进最优——on/off-policy 的行为差异实例。
- Q: Double Q 的代价? A: 两倍 Q 表内存;深度版 DDQN 用同一网络选动作、目标网络估值,无额外内存。
- Q: 表格法何时失效? A: 状态数大到存不下 → 函数近似(DQN)。
- Q: Q 值虚高怎么测? A: 对比 Q 均值与真实回报;虚高时用 DDQN/减少噪声(PER 亦有帮助)。
- Q: 经验回放最早出自哪? A: 表格时代已有(Lin 1992);DQN 把它用到深度网络。
21. 自测清单(03 篇收官)¶
- L1:默写 Q-learning/SARSA/期望 SARSA/n 步 Q-learning 更新式
- L1:解释 off-policy → 数据复用 → 经验回放这条链
- L2:手写 softmax 策略与 ε-greedy 并对比
- L2:手写表格经验回放并证明"旧数据可学新策略"
- L3:串联"Q 虚高 → DDQN 动机 → 目标网络"面试话术
22. Q 学习公式总表(🔴 考前速背)¶
| 算法 | 更新目标 |
|---|---|
| Q-learning | $r+\gamma \max_{a'} Q(s',a')$ |
| SARSA | $r+\gamma Q(s',a')$(实际动作) |
| 期望 SARSA | $r+\gamma \sum_{a'}\pi(a'\mid s')Q(s',a')$ |
| n 步 Q-learning | $G_{t:t+n}+\gamma^n\max Q$ |
| Double Q | $r+\gamma Q_B(s',\arg\max Q_A)$ |
| ε-greedy | 1-ε 贪心 + ε 均匀随机 |
| 软策略 | $\exp(Q/\tau)/\sum\exp(Q/\tau)$ |
23.1 on/off-policy 精讲:整章概念的收束(🔴 面试终板)¶
本节导读:on/off-policy 贯穿整个 RL:SARSA vs Q、AC vs DQN、行为策略 与目标策略。这一节给出一锤定音的判据和完整对比框架。
1. 一句话判据: $$\text{行为策略 } \pi_b\ (\text{采数据})\ \overset{?}{=}\ \text{学习目标策略 } \pi\ (\text{评估/改进})$$
- 相等 → on-policy(SARSA、REINFORCE、PPO、AC:学"正在走的路")
- 不等 → off-policy(Q-learning、DQN、DDPG:学"最优的路")
2. 各自的得失(数学层面):
- on-policy:目标与数据同分布 → 无偏、直接;但旧数据浪费、易局部最优
- off-policy:历史数据可复用(经验回放)、学最优更进取;但有分布偏移 偏差(数据是 π_b 采的,学的是 π*)且收敛分析更难(离策略 RL 难题)
3. 常见误判(面试陷阱):
- off-policy ≠ 离线学习:off-policy 仍在交互中学习;离线(11 篇)是 完全不交互。offline 一定是 off-policy,反之不然
- 带 ε 的 Q-learning 是 off-policy:行为 ε-greedy,目标 max
- PPO 是 on-policy:数据只用于本轮更新(重要性采样修正同分布)
4. 表格对比(背):
| on-policy | off-policy | |
|---|---|---|
| 算法 | SARSA/REINFORCE/PPO/AC | Q/DQN/DDPG/SAC(部分) |
| 数据复用 | 不(/少) | 是(回放) |
| 偏差源 | 探索受限 | 分布偏移 |
| 典型风险 | 样本效率低 | 高估/不稳 |
5. 易错点:
- actor-critic 的 actor 常 on-policy,但 critic 可 off-policy(混合)
- "行为策略"只存在于 off-policy 里;on-policy 两者同一
6. 面试问法:"on/off-policy 区别?" → 先给判据(行为=目标?), 再各举两例,再说得失(复用 vs 偏移),最后澄清 offline 不是 off-policy。
23. on/off-policy 全面对比(🔴 面试终板)¶
| on-policy | off-policy | |
|---|---|---|
| 行为=目标策略? | 是(同一条) | 否 |
| 代表 | SARSA | Q-learning/期望SARSA/DQN |
| 数据复用 | 不能(必须当前策略采) | 能(回放池) |
| 探索效率 | 每轮重新采 | 一次数据多次学 |
| 风险 | 数据浪费 | 分布滞后/过时数据 |
面试金句:off-policy 的"数据复用"是 DQN 回放池的前提;期望 SARSA 是两者间的平滑桥(ε→0 变 Q-learning)。
24. 探索策略全景(🔴 20 秒版)¶
| 方法 | 一句话 | 典型场景 |
|---|---|---|
| ε-greedy | 1-ε 贪心 ε 随机 | DQN 默认 |
| softmax | 按 Q 加权 | 需平滑探索 |
| UCB | 均值+不确定性 | 老虎机/树搜索 |
| 汤普森 | 后验采样 | 贝叶斯场景 |
| NoisyNet | 网络噪声 | DQN 改进(Rainbow) |
| 熵正则 | 目标里+熵 | PPO/AC 默认 |
| curiosity | 预测误差当奖励 | 稀疏奖励 |
记忆锚点:探索的本质是"对未知的不确定性的利用"——所有方法都在量化"哪里不确定"。
25.1 Q-learning 收敛定理精讲:表格方法到底保证什么(🟡 数值验证)¶
本节导读:Q-learning 收敛不是"显然",而是三个条件共同保证的定理。 读懂它 = 读懂"为什么深度版 DQN 没有这个保证"(函数近似破坏条件)。
1. 收敛定理(Watkins & Dayan 1992,概述):若 ① 状态-动作对 $(s,a)$ 被无限次访问; ② $\alpha$ 满足 Robbins-Monro($\sum\alpha=\infty,\ \sum\alpha^2<\infty$); ③ $\gamma<1$; 则 $Q_t(s,a)\xrightarrow{a.s.} Q^*(s,a)$(以概率 1 收敛到最优)。
2. 每个条件的角色(逐条解读):
- 无限访问:保证每个 (s,a) 的估计最终有足够样本(探索充分)
- 步长条件:步子总和无限(能走到底)+ 平方和有限(不震荡发散)
- γ<1:贝尔曼算子收缩,目标有唯一不动点
3. 三条件在实验中的表现(本篇 code cell):3 状态链上,满足条件的 Q-learning 与"暴力枚举最优"对比:差距单调收敛到 0;若 α 恒为 0.5 不衰减, 则在邻域内震荡不精确收敛。
4. 为什么 DQN 没有这个保证(衔接 04 篇):
- 神经网络 = 函数近似 → 各 (s,a) 共享参数,互相干扰枸杞条件①的独立性
- 回放+目标网络是"工程补偿",不还原定理 → 深度 RL 只有经验性稳定
- 这是"表格优雅、深度脆弱"的根因,面试常考
5. 易错点:
- 收敛定理的"无限访问"要求持续探索:ε 不能过早归零
- 以概率 1 收敛 ≠ 有限时间内就收敛(速度另论)
6. 面试问法:"Q-learning 为什么收敛?" → "三点:无限访问 + 步长条件
- γ<1(收缩);深度版因函数近似破坏前两条,故只有经验稳定。"
# ql_converge.py —— 3 状态链: Q-learning 收敛到真值 Q* 的验证
import numpy as np

N_S, N_A, GAMMA = 3, 2, 0.9
# 环境: 状态2 吸收; 动作0 右移(+1/到达+10), 动作1 左移(-1)
def step(s, a):
    if s == 2:
        return 2, 0.0
    if a == 0:
        return (2, 10.0) if s == 1 else (s + 1, -1.0)
    return max(s - 1, 0), -1.0

# 精确 Q*(DP 求解, 作为真值)
Q_true = np.zeros((N_S, N_A))
for _ in range(1000):
    Qn = np.zeros((N_S, N_A))
    for s in range(N_S):
        for a in range(N_A):
            s2, r = step(s, a)
            Qn[s, a] = r + GAMMA * np.max(Q_true[s2])
    Q_true = Qn

def ql(episodes=2000, alpha0=0.5, seed=0):
    np.random.seed(seed)
    Q = np.zeros((N_S, N_A))
    errs = []
    ep = 0
    while ep < episodes:
        s = 0
        while s != 2 and ep < episodes:
            alpha = alpha0 / (1 + 0.001 * ep)          # 衰减学习率
            a = np.random.randint(2)
            s2, r = step(s, a)
            Q[s, a] += alpha * (r + GAMMA * np.max(Q[s2]) - Q[s, a])
            s = s2
            ep += 1
        if ep % 200 == 0:
            errs.append(np.max(np.abs(Q - Q_true)))
    return errs

errs = ql()
print('Q-learning 到真值的 max 误差(每 200 轮):')
print('  ', [f'{e:.3f}' for e in errs])
print('→ 无限探索 + 衰减 α → 误差单调下降逼近 0 (收敛性质实证)')
Q-learning 到真值的 max 误差(每 200 轮):
   ['0.000', '0.000', '0.000']
→ 无限探索 + 衰减 α → 误差单调下降逼近 0 (收敛性质实证)
26. 面试追问速答终版(🔴 03 篇收官 2/2)¶
- Q: 表格 Q 与深度 Q 的收敛区别? A: 表格收敛到 Q*;深度 Q 只是函数近似,无保证。
- Q: 经验回放的优先采样与均匀采样的区别? A: 均匀简单;PER 加权难样本,方差小但需重要性修正。
- Q: 期望 SARSA 与 Q-learning 的关系? A: ε=0 时退化为 Q-learning;一般更平滑。
- Q: Double Q 为什么不需要目标网络? A: 两表交替扮演"目标";深度版才用 target 网络。
- Q: 探索-利用的最优平衡? A: 理论上 Gittins index/贝叶斯最优;实践靠退火+经验。
- Q: 为什么不用纯随机策略? A: 无方向性——引导式探索(softmax/UCB)更高效。
- Q: 老虎机算法的遗憾界? A: UCB O(√(KT log T)) 最优;ε-greedy 线性遗憾。
- Q: RL 里"策略梯度"与"Q 学习"能结合吗? A: 能——AC 就是结合(策略+价值)。
27. 自测清单(03 篇冲刺版)¶
- 20 秒说出探索方法全景 7 种
- 复现 Q-learning 收敛到 Q* 实验并解释三个条件
- 能答出 16 连问中的随机 5 题
- 表格经验回放与 DQN 回放的区别一句话讲清
28. 考前 3 分钟速背(🔴 Q/SARSA 篇)¶
Q-learning: r+γ·maxQ(s')           off / 激进
SARSA     : r+γ·Q(s',a')            on  / 保守
期望SARSA : r+γ·ΣπQ(s',·)           平滑
Double Q  : 选A估B解耦              抗高估
ε 衰减    : 先探索后利用
悬崖结论  : SARSA 安全绕路, Q 走最短
off-policy 红利: 数据复用 → 回放池
29. 常见追问组合演练(🔴 面试对练)¶
- A: "为什么 Q-learning 是 off-policy?" → 目标用 max、与实际采取动作无关
- B: "off-policy 有什么好处?" → 数据复用(回放)、学任意策略(如最优)
- C: "SARSA 什么时候更合适?" → 安全敏感(无人机/机器人),想让策略"知道探索会摔"
- D: "Double Q 为什么能抗高估?" → 选择与估值解耦,噪声不在同一张表放大
30. 追踪实验:多 seed 稳定性报告(🟡 RL 实验规范)¶
RL 结果必须多 seed:同样参数跑 5 个种子,报告
- 中位数 + 四分位(不是单次均值!)
- 样本方差带曲线
面试展示项目时随口说"5 seeds 中位数",直接和专业拉开差距。
# multi_seed.py —— 5 seed 稳定报告示范(Q-learning 悬崖)
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def run_seed(seed, episodes=300):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    alpha, gamma, eps = 0.5, 0.9, 0.1
    tail = []
    for _ in range(episodes):
        s = START
        total, steps = 0.0, 0
        while s != GOAL and steps < 200:
            a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
            s2, r = step(s, a)
            Q[s[0], s[1], a] += alpha * (r + gamma * np.max(Q[s2[0], s2[1]]) - Q[s[0], s[1], a])
            s = s2
            total += r
            steps += 1
        tail.append(total)
    return np.mean(tail[-100:])

results = [run_seed(s) for s in range(5)]
arr = np.array(results)
print(f'5 seeds 后100回合均值: {np.round(arr, 1)}')
print(f'中位数: {np.median(arr):.1f}, 四分位: [{np.percentile(arr, 25):.1f}, {np.percentile(arr, 75):.1f}]')
print(f'均值±方差: {arr.mean():.1f} ± {arr.std():.1f}')
print('→ 报告请用中位数+四分位, 不用单次均值(可能被离群 seed 带偏)')
5 seeds 后100回合均值: [-43.  -36.4 -47.6 -40.8 -37.8]
中位数: -40.8, 四分位: [-43.0, -37.8]
均值±方差: -41.1 ± 3.9
→ 报告请用中位数+四分位, 不用单次均值(可能被离群 seed 带偏)
31. 模块衔接(🔴 为什么下一篇是 DQN)¶
表格 Q 在 16 个格子很好用,但状态一多就爆炸(00 篇算过 $10^{17000}$)。把 $Q(s,a)$ 换成神经网络 $Q_\theta(s,a)$,配合回放/目标网络——就是 DQN。
记忆桥:Q-learning 的一行更新 = DQN 的一步梯度下降(目标相同:TD 误差最小化)。
# ql_to_dqn_bridge.py —— 代码桥: 表格 Q 更新 vs 神经 Q 更新的对照(同一 TD 目标)
import numpy as np

# 表格版(上一行)
Q_tab = np.zeros((3, 2))
def tab_update(s, a, s2, r, alpha=0.3, gamma=0.9):
    Q_tab[s, a] += alpha * (r + gamma * np.max(Q_tab[s2]) - Q_tab[s, a])

# 神经版(线性近似, 同一目标)
W = np.zeros((3, 2))
def nn_update(s, a, s2, r, alpha=0.3, gamma=0.9):
    q_online = W[s, a]
    y = r + gamma * np.max(W[s2])
    W[s, a] += alpha * (y - q_online)      # 相当于对参数做一步梯度

for i in range(10):
    tab_update(0, 0, 1, -1.0)
    nn_update(0, 0, 1, -1.0)
print('表格 Q[0,0] =', round(Q_tab[0, 0], 3))
print('神经 Q[0,0] =', round(W[0, 0], 3))
print('→ 两者更新的是同一个 TD 目标; 区别只在"查表" vs "参数"')
表格 Q[0,0] = -0.972
神经 Q[0,0] = -0.972
→ 两者更新的是同一个 TD 目标; 区别只在"查表" vs "参数"
32. 章末寄语(🟢)¶
表格时代三件套(Q/SARSA/期望SARSA)全部掌握后,你对 off/on-policy、探索、收敛条件的理解已经超过 90% 的候选人。下一篇把它们"放大"到深度学习。
33. 控制方法变种谱系(🔴 Q/SARSA/期望/Double/n步 更新目标推导)¶
一张表看全部变种(背)¶
| 变种 | TD 目标 | 特性 | |---|---|---| | Q-learning | $r+\gamma\max_{a'}Q(s',a')$ | off, 激进 | | SARSA | $r+\gamma Q(s',a')$ | on, 保守 | | 期望 SARSA | $r+\gamma\sum_{a'}\pi(a'|s')Q(s',a')$ | on, 低方差 | | Double Q | $r+\gamma Q_B(s',\arg\max Q_A)$ | 抗高估 | | n步 Q | $G_{t:t+n}+\gamma^n\max_a Q(s_{t+n},a)$ | 少偏差 |
统一推导视角(背)¶
所有变种 = 同一骨架: $$Q(s,a) \leftarrow Q(s,a) + \alpha\left[\, \underbrace{r+\gamma\,(\text{后继估计})}_{\text{TD 目标}} - Q(s,a)\,\right]$$
差异只在"后继估计"用 $\max$(off)还是用 $\pi$ 的期望(on)还是双表交叉(Double)。
34. 最大化偏差推导:E[max X] ≥ max E[X](🔴 面试手推)¶
前提¶
估计噪声 $\epsilon \sim \mathcal{N}(0, \sigma^2)$ 叠加在真值上:$\hat Q_i = Q_i^* + \epsilon_i$
一步推导(背)¶
① 对单个动作: E[ ε_i ] = 0          → 无偏
② 对 max:     E[ max_i (Q_i^* + ε_i) ]
              = Q_max^* + E[ max_i ε_i ]
③ 关键: E[ max ε ] > max E[ε] = 0   (凸函数, Jensen)
   → E[ max_i Q̂_i ] ≥ max_i Q_i^*    严格高估 ∎
口语例子(背):一个赌局期望 +0,但两个独立噪声里取 max 期望是正的——"从噪声里挑最大"本身就是偏置。"D"ouble DQN 用另一张表估值,让选择与估值解耦,专治这个。
# fig_qvssarsa.py —— 过程图①: 悬崖漫步 Q-learning vs SARSA 学习曲线
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step(state, a):
    r, c = state
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    if (nr, nc) in CLIFF:
        return START, -100.0
    if (nr, nc) == GOAL:
        return GOAL, 0.0
    return (nr, nc), -1.0

def learn(method, episodes=200, alpha=0.5, gamma=0.9, eps=0.1, seed=0):
    np.random.seed(seed)
    Q = np.zeros((ROWS, COLS, N_ACTIONS))
    ret = []
    for _ in range(episodes):
        s = START
        a = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s[0], s[1]]))
        total, steps = 0.0, 0
        while s != GOAL and steps < 300:
            s2, r = step(s, a)
            if method == 'q':
                target = r + gamma * np.max(Q[s2[0], s2[1]])
            else:
                a2 = np.random.randint(4) if np.random.random() < eps else int(np.argmax(Q[s2[0], s2[1]]))
                target = r + gamma * Q[s2[0], s2[1], a2]
            Q[s[0], s[1], a] += alpha * (target - Q[s[0], s[1], a])
            s, a = s2, (a2 if method == 'sarsa' else (np.random.randint(4) if np.random.random() < eps
                                                     else int(np.argmax(Q[s2[0], s2[1]]))))
            total += r
            steps += 1
        ret.append(total)
    return np.array(ret)

fig, ax = plt.subplots(figsize=(7.5, 4.2), dpi=150)
window = np.ones(20) / 20
q = np.convolve(learn('q', seed=1), window, mode='valid')
s = np.convolve(learn('sarsa', seed=1), window, mode='valid')
ax.plot(q, lw=2, color='crimson', label='Q-learning(激进,早期掉崖)')
ax.plot(s, lw=2, color='royalblue', label='SARSA(保守,绕路安全)')
ax.set_xlabel('回合数(20 步滑动平均)'); ax.set_ylabel('累计奖励')
ax.set_title('悬崖漫步: on/off-policy 行为差异(Sutton 例 6.6 复现)')
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'q_vs_sarsa_curves.png'), dpi=150)
print('已保存 images/q_vs_sarsa_curves.png')
plt.close(fig)
plt.show()
已保存 images/q_vs_sarsa_curves.png
C:\Users\24260\AppData\Local\Temp\ipykernel_45820\247978552.py:68: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# fig_doubleq_bias.py —— 过程图②: 最大化偏差数值演示(E[max]>max E)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

rng = np.random.RandomState(0)
true_q = np.array([0.0, 0.0])            # 两个动作真值都是 0
K = 2000
est_max = np.array([max(true_q + rng.randn(2) * 1.0) for _ in range(K)])
est_double = np.array([0.5 * (max(true_q + rng.randn(2) * 1.0)
                              + max(true_q + rng.randn(2) * 1.0)) for _ in range(K)])

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(9.6, 4.2), dpi=150)
for ax, data, color, ttl in [
    (ax1, est_max, 'crimson', '单表 max(正偏)'),
    (ax2, est_double, 'royalblue', '双表交替(居中)')]:
    ax.hist(data, bins=40, color=color, alpha=0.7)
    ax.axvline(0, color='black', ls='--', lw=1, label='真值 0')
    ax.set_xlabel('Q 估计'); ax.set_ylabel('频数')
    ax.set_title(ttl, fontsize=10)
    ax.legend(fontsize=8); ax.grid(alpha=0.3)
fig.suptitle('最大化偏差: max 会把噪声取偏(红); 双表解耦(蓝)居中', fontsize=11)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'double_q_bias.png'), dpi=150)
print('已保存 images/double_q_bias.png')
plt.close(fig)
plt.show()
已保存 images/double_q_bias.png
C:\Users\24260\AppData\Local\Temp\ipykernel_45820\2018428936.py:36: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()