⚙️ 15-AI-Infra · 03 分布式并行训练:DP / FSDP / TP / PP / ZeRO
关键词:数据并行 DP · FSDP/ZeRO · 张量并行 TP · 流水线并行 PP · 梯度 allreduce · 通信量 · bubble
前置知识:02-混合精度与显存账本(ZeRO 显存模型)、04-集合通信与NCCL(allreduce 原语)。
🧩 本讲定位:单卡放不下、单卡跑不动怎么办?四种并行策略怎么切、各自通信多少、怎么组合?本讲用 numpy 模拟数据并行的梯度同步、张量并行的分片计算、流水线并行的 bubble,把"显存-通信-吞吐"的权衡讲透。
本节要解决的问题
| 要解决的问题 | 对应内容 |
|---|---|
| 四种并行(DP/TP/PP/FSDP)分别切什么? | 核心概念 + 深入原理 1-4 |
| 数据并行梯度同步为什么正确? | 深入原理 1 + 实战 A |
| 张量并行怎么切矩阵?通信在哪? | 深入原理 2 + 实战 B |
| 流水线并行空闲时间(bubble)多大? | 深入原理 3 + 实战 C |
| ZeRO/FSDP 显存省了,通信付出多少? | 深入原理 4/5 + 实战 D |
故事引入
训练 70B 模型那天,小赵对着显存账本沉默了:单卡 80GB,光权重+梯度+优化器就超了。Leader 说"上多卡"。小赵先上了数据并行(DDP)——发现显存每张卡照样不够;又试张量并行——切成 4 张卡才放下,但每步都要通信;最后上了 3D 并行(TP×PP×DP)+ FSDP,70B 在 64 卡上跑起来了,吞吐还翻了倍。
他把经验浓缩成一张表:DP 治"数据太多",TP 治"单层太大",PP 治"层数太多",FSDP 治"状态冗余"。面试被问"你怎么把 70B 放上 64 卡",小赵从这张表讲起,稳了。
核心概念
(a) 四种并行:切法一览
| 并行 | 切什么 | 卡间如何协作 | 典型通信 | 适合场景 |
|---|---|---|---|---|
| 数据并行 DP/DDP | 每个 batch 切 | 每卡全量模型,梯度 allreduce 平均 | 每步全梯度 $O(N)$ | 单卡放得下,想扩吞吐 |
| FSDP/ZeRO | 参数/梯度/优化器状态分片 | 用时 gather,算完丢弃 | 每层 gather/scatter $O(N)$ | 单卡放不下,最通用 |
| 张量并行 TP | 单层权重矩阵切块 | 分片算,合并结果(allreduce) | 每层权重相关 $O(D)$ | 单层超大,机内 NVLink |
| 流水线并行 PP | 网络按层切段 | 相邻段传激活(点对点) | 每 micro-batch 传激活 $O(BDT)$ | 层数多,跨机 |
(b) 两个关键度量
- 通信量:每步卡间传输的字节数——通信与计算的重叠决定效率;
- 流水线 bubble:流水线并行中空闲的占比 $\frac{P-1}{P-1+m}$($P$ 段、$m$ 个 micro-batch)——$m$ 越大空闲越小。
(c) 组合拳:3D 并行
超大模型 = TP(机内) × PP(机间) × DP(扩吞吐),FSDP 可替代或叠加 DP 层。
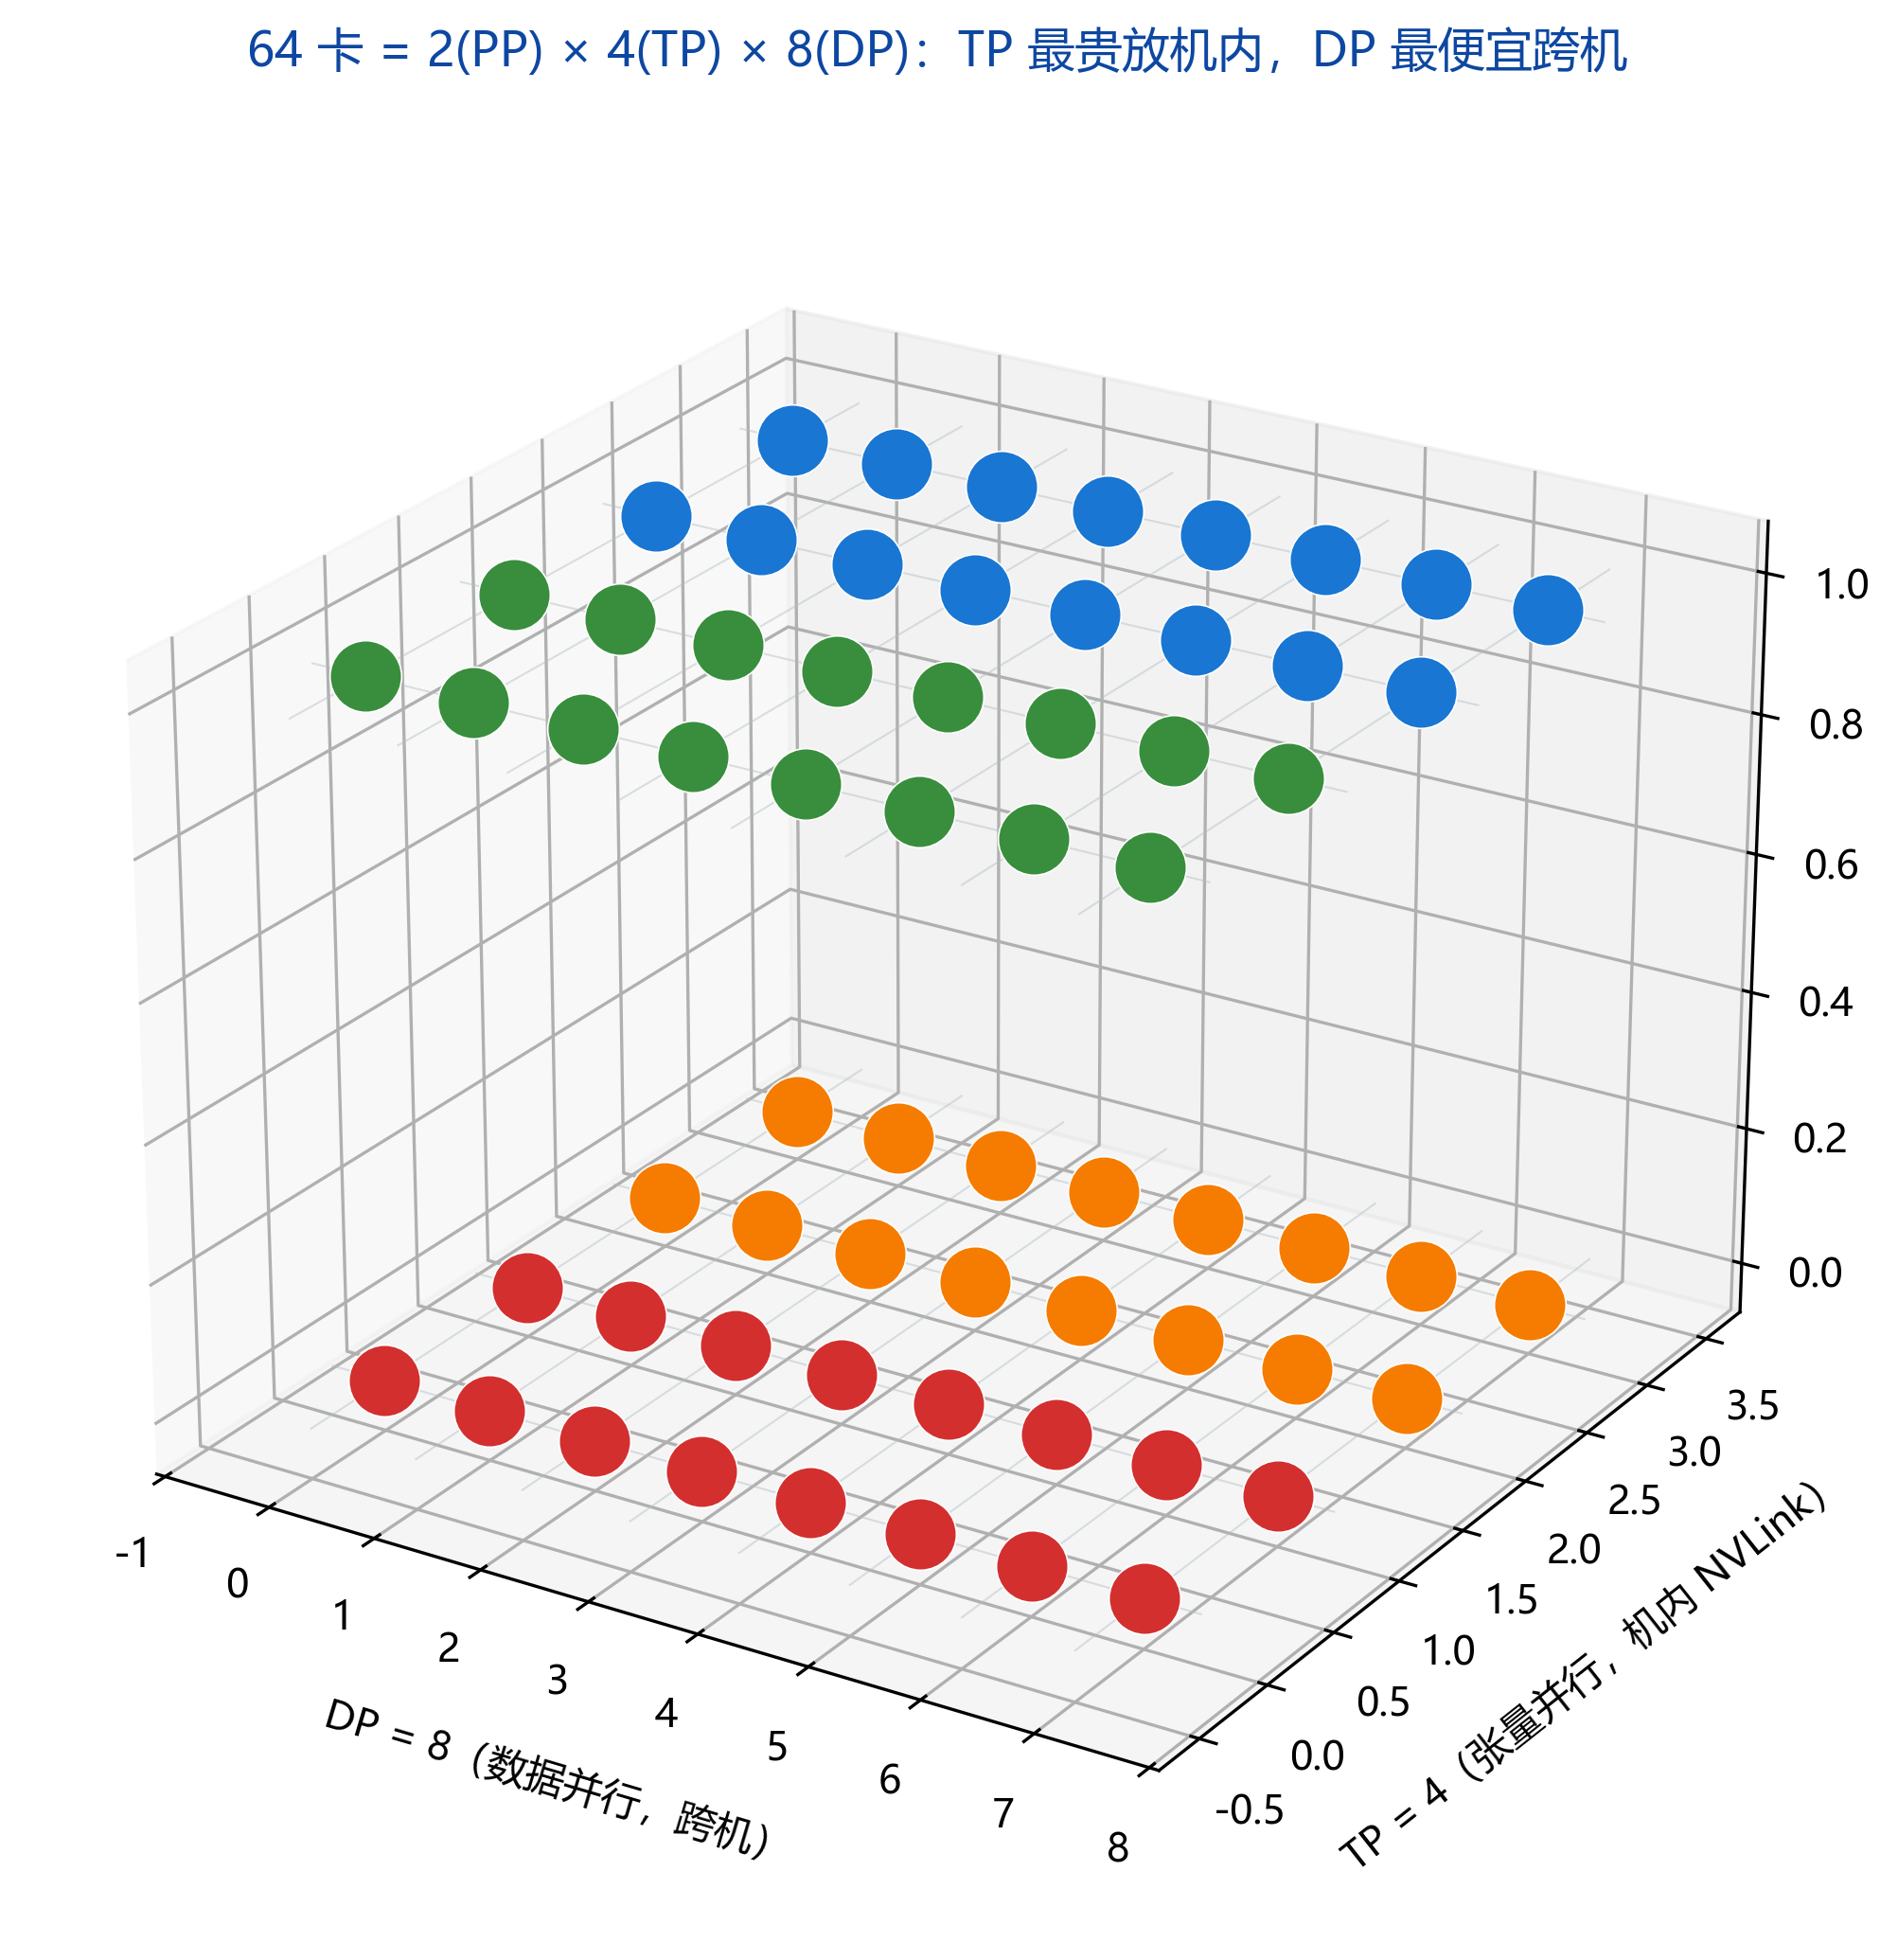
图示:64 卡 = 2(PP) × 4(TP) × 8(DP)。TP 通信最重放机内(NVLink),PP 次之跨机箱,DP 最便宜跨机。
深入原理
1. 数据并行:梯度线性性保证同步与串行等价
损失对 batch 的梯度是线性的:
$$ \nabla_{\theta}\, \tfrac{1}{|\mathcal B|}\sum_{x\in\mathcal B}\ell(x) = \frac{1}{|\mathcal B|}\sum_{x\in\mathcal B} \nabla_\theta \ell(x) $$
所以每卡算自己 batch 的梯度 $g_i$,allreduce 求平均后每卡用相同 $\bar g$ 更新,与串行大 batch 完全一致:
$$ \bar g = \frac{1}{P}\sum_{i=1}^{P} g_i,\qquad \theta \gets \theta - \eta\,\bar g $$
通信量:每步同步 $N$ 个梯度($2\cdot\frac{P-1}{P}N$ 字节,见 04-集合通信)。
2. 张量并行:把一次矩阵乘拆到多卡
按输出切(列并行,column parallel):$W=[W_1;W_2]$,各卡算 $Y_i = X W_i$,拼接即结果——不需要求和通信;
按输入切(行并行,row parallel):$W=[W_1\; W_2]$,各卡算 $Y_i = X_i W_i$,需要 allreduce 求和。
$$ Y = XW = [X_1\ X_2]\begin{bmatrix}W_1\\W_2\end{bmatrix} = X_1W_1 + X_2W_2 $$
Megatron-LM 的 MLP:入口列并行(无需通信合并)→ 激活函数 → 出口行并行(allreduce 一次)。自注意力同理切 QKV/输出。通信量与隐藏维 $D$ 同阶,适合 NVLink 机内。
3. 流水线并行:层切段 + 微批填充
GPipe/PP:把 $L$ 层切成 $P$ 段(每卡一段);朴素版每步只有一段在算(利用率 $1/P$)。改进:拆成 $m$ 个 micro-batch 流水填充:
$$ \text{bubble} = \frac{P-1}{P-1+m} \xrightarrow{m\to\infty} 0 $$
代价:卡间每 micro-batch 传一次激活(点对点),且前后段计算依赖造成"气泡"。1F1B 调度(前向/后向交错)进一步减峰值显存。
图中展示了 $P=4$ 段、$m=3$ 个 micro-batch 的 1F1B 调度时间线:前向(F)与后向(B)交错执行以压低峰值显存,气泡(空白格)占比即 $\frac{P-1}{P-1+m}$;$m$ 越大,气泡越小。
4. FSDP / ZeRO:分片 + 用时 gather
训练中每个参数并非每时刻都需要:
- 前向该层时:gather 该层参数 → 算 → 丢弃;
- 反向该层时:gather 该层梯度 → 更新(分片优化器状态)→ 丢弃。
每层通信 $O(N)$(每层参数量),与 DP 的每步全量 $O(N)$ 同阶但分摊到各层、可与计算重叠,因此 FSDP 在一方放不下时几乎总能替代 DDP。
5. 选型策略(面试必答)
- 单卡放得下 → DP/DDP(或 FSDP 省显存扩容 batch);
- 单层放不下 → TP(机内 NVLink);
- 层太多/跨机 → PP;
- 超大规模 → 3D 并行:DP × TP × PP(+FSDP),并做通信-计算重叠、序列并行、activation checkpointing。
代码实战 A:数据并行梯度同步(模拟 4 卡)
先运行环境设置单元:
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False
np.random.seed(0)
print("环境就绪")

plt.show()
环境就绪
# 模拟:4 卡数据并行训练线性回归(梯度线性性 ⇒ 与串行等价)
rng = np.random.default_rng(1)
N, D = 40, 3
X_all = rng.uniform(-1, 1, (N, D))
w_true = np.array([0.5, -1.2, 0.8])
y_all = X_all @ w_true + 0.1 * rng.standard_normal(N)

P = 4
idx = np.array_split(np.arange(N), P)   # 4 份 batch
lr = 0.2

def grad(X, y, w):
    return 2 * X.T @ (X @ w - y) / len(y)

# 串行基准(大 batch)
w_s = np.zeros(D)
for _ in range(200):
    w_s -= lr * grad(X_all, y_all, w_s)

# 数据并行:每卡自己 batch 的梯度 → allreduce 平均 → 同步更新
w_p = np.zeros((P, D))   # 每卡一份
for step in range(200):
    gs = np.stack([grad(X_all[idx[i]], y_all[idx[i]], w_p[i]) for i in range(P)])
    gbar = gs.mean(axis=0)                 # 手写 allreduce(平均)
    w_p -= lr * gbar

print("串行 w  =", np.round(w_s, 4))
print("并行 w  =", np.round(w_p[0], 4))
print("4 卡一致:", np.allclose(w_p, w_p[0]), "| 与串行一致:", np.allclose(w_p[0], w_s, atol=1e-9))
assert np.allclose(w_p, w_p[0]) and np.allclose(w_p[0], w_s, atol=1e-9)
print("✅ 数据并行梯度平均 = 串行大 batch,更新完全一致")
串行 w  = [ 0.5206 -1.2291  0.7374]
并行 w  = [ 0.5206 -1.2291  0.7374]
4 卡一致: True | 与串行一致: True
✅ 数据并行梯度平均 = 串行大 batch,更新完全一致
代码实战 B:张量并行分片计算(行切 vs 列切)
把单个 Linear 层切到 2 张卡:验证拼接/求和后与整矩阵乘数学等价,并统计通信量。
rng = np.random.default_rng(2)
M, K, N = 6, 4, 6
X = rng.standard_normal((M, K))
W = rng.standard_normal((K, N))
Y_ref = X @ W

# 列并行(column parallel):把 W 的输出维 N 切成两半——各卡算完拼接,无需求和
n1 = N // 2
Wc1, Wc2 = W[:, :n1], W[:, n1:]
Y1 = X @ Wc1          # 卡 1
Y2 = X @ Wc2          # 卡 2
print("列并行拼接 == 整乘:", np.allclose(np.concatenate([Y1, Y2], axis=1), Y_ref))

# 行并行(row parallel):把 W 的输入维 K 切开,X 也要跟着切列——各卡算完必须 allreduce 求和
k1 = K // 2
X1, X2 = X[:, :k1], X[:, k1:]
Wr1, Wr2 = W[:k1], W[k1:]
Y = X1 @ Wr1 + X2 @ Wr2      # 一次 allreduce(求和)
print("行并行求和 == 整乘:", np.allclose(Y, Y_ref))

# 通信量:每步每卡传输 = 输出张量大小(行并行时)
print("\n通信量比较:行并行每步 allreduce 传输 M×N 个元素;列并行无需这一步")
print("=> Megatron MLP 用『入口列并行 + 出口行并行』只做 1 次通信")
assert np.allclose(np.concatenate([Y1, Y2], axis=1), Y_ref) and np.allclose(Y, Y_ref)
print("✅ 两种切法都数学等价")
列并行拼接 == 整乘: True
行并行求和 == 整乘: True

通信量比较:行并行每步 allreduce 传输 M×N 个元素;列并行无需这一步
=> Megatron MLP 用『入口列并行 + 出口行并行』只做 1 次通信
✅ 两种切法都数学等价
代码实战 C:流水线并行 bubble(微批填充)
bubble 占比 $=\frac{P-1}{P-1+m}$:画 $P=4/8$ 时随 micro-batch 数 $m$ 的下降曲线。
def bubble(P, m):
    return (P - 1) / (P - 1 + m)

ms = np.arange(1, 33)
fig, ax = plt.subplots(figsize=(9, 4.5))
for P, c in zip((2, 4, 8), ("#1976D2", "#388E3C", "#D32F2F")):
    ax.plot(ms, [bubble(P, m) for m in ms], "o-", label="P=%d 段" % P, color=c)
print("P=4, m=8 → bubble=%.1f%%\nP=4, m=32 → bubble=%.1f%%" % (100 * bubble(4, 8), 100 * bubble(4, 32)))
ax.set_xlabel("micro-batch 数 m"); ax.set_ylabel("bubble 占比")
ax.set_title("流水线并行:m 越大空闲越小(1F1B 调度的动机)")
ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
P=4, m=8 → bubble=27.3%
P=4, m=32 → bubble=8.6%
C:\Users\24260\AppData\Local\Temp\ipykernel_42632\346956645.py:11: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
代码实战 D:ZeRO/FSDP 显存-通信权衡曲线
BF16 训 70B:横轴卡数 P,画 ZeRO-3 每卡显存(降)与该步通信量(升)双轴对比。
N = 70e9; bytes_per = 2 + 2 + 12  # 权重+梯度+Adam(BF16/FP32 混合)
P_range = np.arange(1, 33)
mem_per_card = N * bytes_per / P_range / 1e9          # ZeRO-3 全分片(激活忽略)
comm = 2 * (P_range - 1) / P_range * N * bytes_per / 1e9  # 每步全量 gather 通信量(GB)

fig, ax1 = plt.subplots(figsize=(9, 4.8))
ax1.plot(P_range, mem_per_card, "o-", color="#1976D2", label="每卡显存 (GB, ZeRO-3)")
ax1.set_xlabel("GPU 数 P"); ax1.set_ylabel("每卡显存 (GB)", color="#1976D2")
ax2 = ax1.twinx()
ax2.plot(P_range, comm, "s--", color="#D32F2F", label="每步通信量 (GB, 近似)")
ax2.set_ylabel("通信量 (GB)", color="#D32F2F")
ax1.set_title("70B 训练:显存随 P 下降,通信随 P 上升——工程上的平衡点")
ax1.grid(alpha=0.3); ax1.legend(loc="upper right"); ax2.legend(loc="center right")
plt.tight_layout(); plt.show()
print("P=8:  每卡 %.0f GB | P=32: 每卡 %.0f GB(接近单卡装得下)" % (mem_per_card[7], mem_per_card[31]))
P=8: 每卡 140 GB | P=32: 每卡 35 GB(接近单卡装得下)
C:\Users\24260\AppData\Local\Temp\ipykernel_42632\2864118369.py:14: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
面试考点
Q1 四种并行分别治什么问题?
A:DP 治数据多(梯度 allreduce 平均,同步与串行等价);TP 治单层大(权重分块 + 拼接/求和);PP 治层数多(层切段 + 微批填气泡);FSDP/ZeRO 治状态冗余(分片 + gather)。
Q2 数据并行梯度同步为什么与串行一致?
A:梯度对样本线性,全 batch 梯度 = 各卡子 batch 梯度的平均;allreduce 平均后每卡用同一梯度更新,等价于串行大 batch。
Q3 张量并行列切和行切有什么差别?
A:列并行输出拼接、无求和通信;行并行需要 allreduce 求和。Megatron 用"入口列 + 出口行"使每层只通信一次。
Q4 流水线并行 bubble 怎么算?
A:$\frac{P-1}{P-1+m}$;micro-batch 越多 bubble 越小,1F1B 调度还能降低峰值显存。
Q5 FSDP 和 DDP 怎么选?
A:单卡放得下用 DDP(通信少);放不下用 FSDP(分片省显存,每层 gather 可与计算重叠,通信量与 DDP 同阶)。
Q6 70B 怎么放上 64 卡?
A:3D 并行——机内 TP(如 8 卡切一层)× 跨机 PP(如 4 段)× DP/FSDP(16 路扩吞吐),配合 activation checkpointing、序列并行、通信-计算重叠。
小结与自测清单
本讲要点:DP 同步梯度(线性性保证等价);TP 分块矩阵(列切省通信);PP 切层 + 微批填气泡;FSDP 分片 + gather;组合成 3D 并行。
自测清单:
- 能默写四种并行的切法/通信/适用场景表
- 能证明数据并行与串行等价的梯度线性性
- 能手算 bubble = (P-1)/(P-1+m)
- 能画出 70B 训练显存-通信权衡曲线并解释平衡点
下一讲预告:04-集合通信与NCCL——并行的"血管":allreduce 到底怎么传才能又快又省带宽。