🗂️ 10-07 · NLP 面试八股(全章速成)
把 00~06 篇的知识点收拢成 120 个高频问答(6 组 × 20)+ 8 个手撕。 每问先自己答,再看答案;手撕保证面试时能当场写出来。
复习路径:词表示/分词(00)→ 统计语言模型(01)→ 词向量(02)→ RNN(03)→ Attention/Transformer(04)→ 预训练(05)→ 任务与评估(06)。
使用方式(3 遍法):第一遍通读建立地图;第二遍遮住答案自问自答;第三遍只背「数字记忆卡 + 面试速答」。
相比旧版(6 组 × 15 问 + 5 手撕):每组加 5 问(共 120 问)、新增 3 个手撕(BLEU / 多头维度 / 混淆矩阵)、新增数字记忆卡与口算训练。
核心概念
(a) 🗂️ 全章速成:120 问 + 8 手撕的面试地图
把 00~06 篇的知识点收拢成 6 组 × 20 = 120 个高频问答 + 8 个手撕代码。本篇还教「四段式答题框架」和「一主问题 = 一条追问链」的面试心法,配上数字记忆卡与易错点 TOP 12,考前 30 分钟翻一遍即可上考场。
flowchart TB
    Node1["🗂️ 六组 120 问"]
    Node2["🧭 答题框架四段式"]
    Node3["📦 第一组:词表示 / 分词"]
    Node4["📊 第二组:统计语言模型"]
    Node5["📚 第三组:词向量"]
    Node6["🔁 第四组:RNN / LSTM"]
    Node7["👁️ 第五组:Attention / Transformer"]
    Node8["🤖 第六组:预训练 / 评估"]
    Node9["✍️ 8 个手撕 + 数字记忆卡"]
    Node1 --> Node3
    Node1 --> Node4
    Node1 --> Node5
    Node1 --> Node6
    Node1 --> Node7
    Node1 --> Node8
    Node2 -->|贯穿所有问答| Node1
    Node3 --> Node9
    Node4 --> Node9
    Node5 --> Node9
    Node6 --> Node9
    Node7 --> Node9
    Node8 --> Node9
- 六组 120 问:词表示/分词(1-20)、统计语言模型(21-40)、词向量(41-60)、RNN/LSTM(61-80)、Attention/Transformer(81-100)、预训练/任务/评估(101-120)。覆盖 00~06 篇全部考点。
- 答题框架四段式:别背答案要讲逻辑——结论先行(10 秒一句话)、公式/结构(写出来)、直觉 + 例子、边界与数字。面试官听到公式就开始点头。
- 第一组:词表示 / 分词:词典法(最大匹配/MMSeg)、统计法(HMM/CRF)、神经网络法(BERT-based);TF-IDF 平滑、BM25、BPE 子词、停用词。高频追问:中文现在还要分词吗?
- 第二组:统计语言模型:链式法则、马尔可夫假设、n-gram、平滑(加一/加k/回退/插值)、PPL 与交叉熵的关系。本质:PPL 是「平均概率的几何倒数」,PPL=10 意味着平均 10 选 1。
- 第三组:词向量:CBOW/Skip-gram 区别、负采样 3/4 次幂为什么、GloVe 与 PMI/SVD 的关系、类比推理 king−man+woman≈queen。窗口、维度、负采样数等超参也是考点。
- 第四组:RNN / LSTM:参数共享、BPTT 与 BP 区别、梯度消失的数学直觉(W_hhᵀ 连乘,连乘决定生死)、LSTM 细胞状态为什么缓解消失、梯度裁剪、char-level vs word-level。
- 第五组:Attention / Transformer:公式 softmax(QKᵀ/√d_k)V、为什么除 √d_k、多头为什么有效、正弦位置编码为什么能外推、Encoder/Decoder 区别、O(T²) 复杂度与 flash-attention。
- 第六组:预训练 / 评估:预训练-微调为什么有效、MLM 的 80/10/10、NSP 为什么被去、NER 实体级 P/R/F1、BLEU/ROUGE 原理。
- 8 个手撕 + 数字记忆卡:TF-IDF 检索、n-gram 平滑+PPL、负采样一步梯度、RNN 单步+谱系、因果注意力、BLEU、多头维度口算、混淆矩阵→P/R/F1;数字卡:BERT-base 12/768/12/110M、512/8=64、80/10/10 张口就来。
主线地图:八股怎么考
第一组 词表示/分词: One-hot → BOW → TF-IDF → BPE/子词
第二组 统计语言模型: 链式法则 → n-gram → 平滑 → PPL
第三组 词向量: CBOW/Skip-gram → 负采样 → GloVe → fastText/ELMo
第四组 RNN/LSTM: 前向/BPTT → 梯度消失 → LSTM 四门 → GRU
第五组 Attention/Transformer: QKV → √d → 多头 → 掩码 → KV cache
第六组 预训练/任务/评估: BERT MLM → GPT 自回归 → 微调 → RLHF → 指标
考试本质 = 数字 + 公式 + 结构图 + 复杂度 四件套。每组固定节奏:题目清单 → 手撕代码, 全部代码可复现(固定随机种子),跑完即形成"背 + 写"闭环。
答题框架:别"背答案",要"讲逻辑"
八股题看似考记忆,实则在考你组织答案的结构。推荐四段式回答:
- 结论先行(约 10 秒):一句话说清"是什么"。例:"TF-IDF 是词频 × 逆文档频率的加权词袋表示";
- 公式/结构(约 20 秒):把核心公式或结构图写出来——面试官看到公式就开始点头;
- 直觉 + 例子(约 20 秒):一句直觉("越常见越重要、越稀有越有辨识度")+ 一个小例子("文档 1 反复出现'算法'→ 高 TF;全库只有它用'算法'→ 高 IDF");
- 局限 + 演进(约 10 秒):主动说它不好在哪、被什么替代——主动暴露局限是加分项,说明你真的用过、踩过坑。
本页 120 问的每一条都建议按这个框架自测:先遮住答案,用四段式说一遍,再对照。后面的"高频追问补充"小节,就是把每组的题目往下挖一层:主问题答完后,面试官大概率接着问什么、该怎么接。
第一组 · 词表示 / 分词 / 基础(1-10)
- 中文分词有哪几类方法? 词典法(最大匹配/MMSeg)、统计法(HMM/CRF)、神经网络法(BERT-based);当前工业界主要用预训练模型做基于字的标注 + 词典后处理
- 正向最大匹配的缺点? 贪心局部最优;歧义严重(如「研究生命起源」);改进:双向匹配取分少者
- 为什么要去停用词/词干化? 降维降噪;但预训练时代尽量少用,可能丢信息
- One-hot 的缺点? 维度灾、无语义相似性、稀疏(V 维向量只有 1 个非零)
- 词袋模型(BOW)的缺点? 丢词序、丢语义、稀疏高维;「猫追狗」和「狗追猫」向量相同
- TF-IDF 的直觉? 词在文档里越常见(TF)、在全库越稀有(IDF)越重要;IDF = log(N/df)
- TF-IDF 的局限? 仍是统计稀疏表示,无语义泛化;未见词 OOV 无法处理
- 什么是 OOV? 未登录词——训练词表外的词;用子词(BPE/WordPiece)缓解
- BPE 怎么做? 从字符开始,反复合并最高频相邻符号对,直到目标词表大小
- N-gram 和语言模型的关系? n-gram 是统计语言模型的具体实现(马尔可夫假设截断)
第一组 · 词表示 / 分词 / 基础(续 11-20)
- 链式法则在语言模型里怎么用? $P(w_1..w_n) = \prod P(w_i | w_1..w_{i-1})$;n-gram 假设只需最近 n-1 个词
- 平滑作用一句话? 把概率质量从高频事件让渡给低频/未见事件,避免 0 概率
- 加一平滑和加 k 平滑区别? k 可调;V 大时加一平滑给未见词过多概率
- Perplexity 与平均负对数似然的关系? PPL = exp(平均负对数似然)
- PPL 越低越好吗? 同一语料/切分下是;跨语料不可比
- 最大匹配歧义例子? 「研究生命起源」→ 词典法可能切「研究生/命/起源」;解决:双向最大匹配 + 启发式规则
- 分词误差会传播吗? 会:切分错 → 词向量/语法分析/生成全受影响;预训练时代常按字/子词切分降低风险
- IDF 的两种形式? log(N/df)(经典)vs log((N+1)/(1+df))+1(sklearn 平滑版:避免除零、文档数少时更稳)
- 为什么 BPE 能缓解 OOV? 子词可组合成未见词(low + est);词表大小由合并次数控制
- tf 归一化(L2)的作用? 消除文档长度偏差,余弦相似度与长度无关
第一组 · 高频追问补充(1-20)
- "TF-IDF 和 BM25 哪个好?" BM25 是 TF-IDF 的嫡系改良:TF 部分做了饱和处理($\frac{(k_1+1)tf}{k_1+tf}$)、长度归一化可调,检索排序普遍优于朴素 TF-IDF。答"TF-IDF 是基础,BM25 是工程改良"即可。
- "中文现在还要分词吗?" 预训练时代主流是按字/子词切分(BERT 用 WordPiece),把分词交给模型;但词典/分词在检索、知识图谱等领域仍常见。答"模型按子词、系统按词"的分工最显格局。
- "BPE 词表大小怎么定?" 太小 → 碎片化(一个词被拆太碎);太大 → 接近整词表、失去子词泛化;典型 30k~50k。可补一句"Byte-level BPE(GPT-2)连空格都建模,彻底解决 OOV"。
- "OOV 只能靠子词吗?" 还有
映射、字符级模型、按更小粒度回退;答"层次化兜底"即可。 - "IDF 平滑为什么加 1?" 一防 df=0 除零,二让语料小时估计更稳;加分点是直接说出 sklearn 默认 log((N+1)/(1+df))+1。
答题示范(四段式):TF-IDF 是词频与稀有度的乘积(结论)→ $tf(t,d)\cdot\log\frac{N}{df}$(公式)→ "越常见越稀有越重要"(直觉)→ 仍是稀疏静态表示,被词向量/预训练替代(局限)。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# ---------- 手撕 1:TF-IDF + 余弦相似度(检索排序) ----------
import numpy as np
from collections import Counter

np.random.seed(0)
docs = ['我 喜欢 学习 自然语言', '他 喜欢 学习 数学', '我 喜欢 深度 学习']

def tfidf(docs):
    N = len(docs)
    terms = sorted({w for d in docs for w in d.split()})
    df = {w: sum(1 for d in docs if w in d.split()) for w in terms}
    vecs = []
    for d in docs:
        cnt = Counter(d.split())
        v = []
        for w in terms:
            tf = cnt[w] / len(d.split())
            idf = np.log((1 + N) / (1 + df[w])) + 1   # sklearn 平滑 IDF
            v.append(tf * idf)
        vecs.append(np.array(v))
    return terms, vecs

terms, vecs = tfidf(docs)
def cos(a, b): return a @ b / ((np.linalg.norm(a) + 1e-9) * (np.linalg.norm(b) + 1e-9))
# 查询「自然语言」与哪篇最像(查询向量直接按词表置 1)
qv = np.zeros(len(terms))
for w in ['自然语言']:
    if w in terms:
        qv[terms.index(w)] = 1
print('查询向量非零维度:', [terms[i] for i in np.nonzero(qv)[0]])
ranks = sorted(range(len(docs)), key=lambda i: -cos(qv, vecs[i]))
print('检索排序(应 doc0 最相关):', ranks)
assert ranks[0] == 0
assert cos(qv, vecs[0]) > cos(qv, vecs[1])   # 命中文档必须严格更近
print('要点:TF-IDF 把「文档-词」计数转成可比较的向量,余弦衡量语义接近度')
第二组 · 统计语言模型(21-30)
- Bigram 概率公式? P(w2|w1) = count(w1,w2)/count(w1)
- 为什么要句首句尾标记? 统一建模句子边界,让 P(句子) 归一、模型能学到「开始/结束」
- 数据稀疏为什么必然? 词表 V,trigram 组合 V² 量级,语料无法覆盖
- 回退(backoff)和插值(interpolation)区别? 回退:高阶无数据才用低阶;插值:永远线性混合
- Good-Turing 思想? 用「出现 r+1 次的词数」估计「出现 r 次的词」的真实概率
- Kneser-Ney 比 Good-Turing 好在哪? 考虑「延续概率」(一个词作为新上下文延续的多样性)
- 语言模型在工程上的用处? 输入法/拼写纠错、ASR 重排、MT 重排、生成评分
- 为什么现代不用统计 LM? 稀疏 + 无法泛化到未见组合;神经网络参数共享解决
- 神经网络 LM 的输入输出? 输入词向量序列,输出 softmax 词表概率
- softmax 过词表代价? O(V) 求和;用层次 softmax / 负采样 / 采样 softmax 近似
第二组 · 统计语言模型(续 31-40)
- 训练集和测试集 PPL 差异说明什么? 过拟合/泛化能力;差距越大越过拟合
- 如何给未见词建模?
映射;子词切分(BPE/WordPiece) - 语言模型评估除了 PPL? 下游任务、人工评估、BLEU(生成)
- PPL 与 BLEU 的关系? PPL 是生成概率视角,BLEU 是与参考串的 n-gram 重合度
- LM 训练数据要不要打乱句子? 通常按文档顺序;打乱会破坏长程依赖统计(预训练语料一般不打乱)
- 交叉熵与 PPL 的关系? $PPL = \exp(H(p,q)) = \exp(-(1/N)\sum \log q(w_i|context))$;两者单调对应
- 未平滑 PPL 为什么可能 inf? 测试集出现 0 概率 n-gram → log 0 = -inf → 平均也 -inf
- trigram 比 bigram 好吗? 上下文更精确、PPL 更低;但更稀疏、需要更多数据与平滑
- 平滑和「折扣」的关系? 平滑本质是把高频事件的概率质量打折(discount),再分配给低频/未见事件
- 语言模型和生成的关系? LM 给出 P(w_t | 前文);逐词采样/beam search 即可生成文本
第二组 · 高频追问补充(21-40)
- "PPL 和 loss 到底啥关系?" PPL = exp(平均负对数似然) = exp(交叉熵)。口算:平均 NLL=2.30 → PPL≈10。再补一句本质:PPL 是"平均概率的几何倒数"——模型平均每步给词 1/PPL 的概率,PPL=10 意味着平均 10 选 1,面试官会认为你懂本质。
- "为什么未平滑 PPL 可能是 inf?" 测试集撞上 0 概率 n-gram → log 0 = -inf → 平均后仍 -inf。所以平滑不只是"锦上添花",而是让评测可计算的前提。
- "加 k 平滑的 k 怎么选?" 网格搜索最小化开发集 PPL;k≈0 相当于不平滑,k 太大把概率质量摊得太平。答"用开发集调"即可。
- "bigram 就够了吗?" 高阶(trigram)上下文更准但更稀疏;工程上常用插值 + 回退混合多个阶数。一句话:阶数越高越准也越稀疏,平滑负责在两者间找平衡。
- "统计 LM 真被淘汰了吗?" 作为主模型被神经 LM 取代,但 n-gram 仍用于词典外兜底、ASR/输入法重排、机器翻译的约束解码——"淘汰的是主角地位,不是全部用途"。
追问链示范:PPL 是什么 → PPL 越低越好吗(同语料才可比)→ 跨语料为什么不比(词表/切分/分布不同)→ 那 BLEU 呢(评测视角从概率变成重叠度)——一条链把 21-40 的题目串起来。
# ---------- 手撕 2:n-gram 平滑 + PPL(15 秒背写版) ----------
import numpy as np
from collections import Counter

corpus = ['我 爱 学习', '我 爱 北京', '他 爱 北京']
toks = [s.split() for s in corpus]
V2 = sorted({w for s in toks for w in s})
c1 = Counter(w for s in toks for w in s)
c2 = Counter((s[i], s[i + 1]) for s in toks for i in range(len(s) - 1))
def p_addk(w2, w1, k=1.0):
    return (c2[(w1, w2)] + k) / (c1[w1] + k * len(V2))
def ppl_smooth(sents):
    lp, n = 0.0, 0
    for s in sents:
        for i in range(1, len(s)):
            lp += np.log(p_addk(s[i], s[i - 1])); n += 1
    return float(np.exp(-lp / n))
print('未见组合 P(北京|学习) 平滑后 = %.4f(不为 0)' % p_addk('北京', '学习'))
print('测试句 PPL = %.2f' % ppl_smooth([['我', '爱', '学习']]))
assert p_addk('北京', '学习') > 0
print('背写要点:c+k 除 c 的前词+V·k;PPL = exp(-平均 log P)')
第三组 · 词向量(41-50)
- Word2Vec 两种模型? CBOW(上下文→中心)、Skip-gram(中心→上下文)
- Skip-gram 对低频词友好的原因? 每个词都当中心词训练,采样到概率正比于频次;CBOW 把上下文平均,稀释低频信息
- 负采样损失长什么样? $-\log\sigma(v_c'·v_w) - \sum_k \log\sigma(-v_k'·v_w)$
- 为什么负采样分布用 3/4 次幂? 提高稀有词被采样概率,缓解高频词主导
- Word2Vec 是概率模型吗? 训练后向量可用于相似度,但无真实概率解释
- GloVe 目标? $\sum f(M_{ij})(v_i·v_j' + b - \log M_{ij})^2$,拟合共现对数
- GloVe 相比 Word2Vec? 全局统计更稳;Word2Vec 在线采样快
- fastText 的改进? 词拆成字符 n-gram 求和——OOV 也能得向量
- ELMo 的贡献? 双向 LSTM 产生上下文相关的词表示
- Word2Vec 向量能做什么? 相似度检索、初始化 embedding、类比推理
第三组 · 词向量(续 51-60)
- 类比推理为什么有效? 训练目标隐含线性关系(king - man + woman ≈ queen 是经验事实)
- 词向量评估方法? 相似度数据集(SimLex-999)、类比集(Google analogy)、下游任务
- 训练词向量的超参? 窗口、维度(100-300)、负采样数(2-5)、下采样高频词
- 一词多义问题怎么解决? 上下文表示(ELMo/BERT);或 sense embedding 显式建模
- Embedding 可以随机初始化吗? 可以但训练更慢;预训练初始化通常更好
- CBOW vs Skip-gram 适用场景? CBOW 快、适合高频词/大语料;Skip-gram 慢但对低频词效果更好
- 负采样具体怎么做? 正样本 (w,c);负样本按 unigram 的 3/4 次幂分布采样 k 个「假装不是上下文」的词
- 层次 softmax 是什么? 按词频建 Huffman 树,叶子=词;沿路径做二分类,复杂度 O(log V)
- 窗口大小的影响? 小窗口(2-5)→ 句法相似;大窗口 → 语义相似
- 下采样高频词? 按概率丢弃高频词(如 the),避免高频词过采样、训练更快
第三组 · 高频追问补充(41-60)
- "负采样为什么偏偏是 3/4 次幂?" 提高低频词被采样概率、抑制高频词"垄断"训练;3/4 是经验常数,实际可调。再补数学直觉:$P(w)\propto count(w)^{3/4}$ 让采样分布比频率分布更"平",低频词被抽到的机会相对变大。
- "CBOW 和 Skip-gram 的梯度差在哪?" CBOW 把上下文向量平均后预测中心词(梯度更新一份平均向量);Skip-gram 用中心词预测每个上下文词(每个上下文独立贡献梯度)。所以 Skip-gram 对低频词的信号保留更好,代价是更慢。
- "GloVe 和 Word2Vec 本质区别?" GloVe 直接拟合全局共现矩阵的对数(矩阵分解视角);Word2Vec 是局部窗口在线采样(预测视角)。GloVe 更像"共现矩阵的低秩分解",训练更快收敛也更稳。
- "fastText 为什么能处理 OOV?" 词表示 = 字符 n-gram 向量之和,未见过的词也能拆成见过的字符片段拼出向量。
- "Word2Vec 和 SVD 有关系吗?" 有:负采样目标在理论上对应 PMI 矩阵的分解(Levy & Goldberg 2014)——答出"词向量 ≈ PMI 矩阵低秩近似"是明显的加分项。
这组最常见的主问题链:Word2Vec 两种模型 → 负采样为什么 → 3/4 次幂为什么 → 训练完向量能干嘛 → 与 GloVe/fastText 对比。把 41-60 按这条链背,比逐题零散记忆省一半功夫。
# ---------- 手撕 3:Skip-gram 负采样**一步**梯度(数值校验) ----------
import numpy as np
rng = np.random.default_rng(0)
V3, D3 = 10, 4
W3 = rng.normal(0, 0.1, (V3, D3)); C3 = rng.normal(0, 0.1, (V3, D3))
w_i, w_o, negs = 2, 5, [1, 7, 3]          # 中心词、正上下文、负样本

def loss(W3, C3):
    lo = -np.log(1 / (1 + np.exp(-C3[w_o] @ W3[w_i])))
    for k in negs:
        lo -= np.log(1 / (1 + np.exp(C3[k] @ W3[w_i])))
    return lo

# 解析梯度:正样本项 d/dx[-log σ(x)] = σ(x)-1;负样本项 d/dx[-log σ(-x)] = σ(x)
dL_dW = np.zeros(D3)
g1 = (1 / (1 + np.exp(-C3[w_o] @ W3[w_i]))) - 1
dL_dW += g1 * C3[w_o]
for k in negs:
    dL_dW += (1 / (1 + np.exp(-C3[k] @ W3[w_i]))) * C3[k]
print('解析梯度 norm: %.6f' % np.linalg.norm(dL_dW))
# 数值梯度(抽查 2 维)
eps = 1e-6
for j in [0, 2]:
    Wp, Wm = W3.copy(), W3.copy()
    Wp[w_i, j] += eps; Wm[w_i, j] -= eps
    g = (loss(Wp, C3) - loss(Wm, C3)) / (2 * eps)
    print('维度 %d: 解析 %.6f vs 数值 %.6f 误差 %.2e' % (j, dL_dW[j], g, abs(g - dL_dW[j])))
    assert abs(g - dL_dW[j]) < 1e-6
print('负采样梯度手撕正确 ✓ | 面试就写这一步更新:W[center] -= lr * dL_dW')
第四组 · RNN / LSTM(61-70)
- RNN 参数共享的意义? 序列任意长度可用同一套参数;等价于沿时间展开的浅层网络
- BPTT 和普通 BP 区别? 沿时间展开反传,梯度按时刻累加
- 梯度消失为什么在 RNN 严重? h_T 对 h_0 的 Jacobian 是 $W_{hh}^T$ 连乘,范数以 $|\lambda_{max}|^T$ 衰减/爆炸
- 梯度爆炸怎么处理? 梯度裁剪(按范数/按值)
- LSTM 解决梯度消失的思路? 细胞状态 c 的加性更新 f⊙c + i⊙g,梯度有「高速公路」
- LSTM 三个门各自作用? f 遗忘旧记忆、i 写入新信息、o 控制对外输出
- 遗忘门偏置初始化为? 正(如 1~2),初始偏向记住
- GRU 和 LSTM 区别? 两个门(更新/重置),少一组参数,效果相近
- 双向 RNN 怎么做? 正向+反向两个隐状态拼接/相加
- RNN 为什么难并行? 时间步串行依赖;Transformer 全并行
第四组 · RNN / LSTM(续 71-80)
- char-level 与 word-level LM? char 词表小无 OOV 但序列长;word 语义单位好
- 深 RNN 怎么做? 多层堆叠(层间残差);现在一般用 Transformer
- RNN 的 encoder-decoder? encoder 压成向量,decoder 逐步生成(Seq2Seq)
- 注意力在 Seq2Seq 中的角色? 解码每步直接「查阅」编码器各位置,不再只依赖最后状态
- RNN 还有用吗? 流式/低功耗场景、时间序列仍在用;大模型主用 Transformer
- LSTM 参数量口算? 一组 4×(W_ih + W_hh + b):h=256、d=128 → 4×(256×128 + 256×256 + 256) ≈ 394k
- 梯度裁剪怎么写? norm = sqrt(Σg²);if norm > clip: g *= clip/norm(clip 常取 1~5)
- 为什么梯度消失比爆炸难处理? 爆炸可裁剪;消失靠结构(LSTM 加性通路、残差)+ 初始化缓解
- 门控为什么用 sigmoid、候选用 tanh? sigmoid ∈ (0,1) 当「开关」;tanh ∈ (-1,1) 提供新内容且梯度不为 0
- RNN vs CNN 处理文本? CNN 局部窗口+平移不变、可并行;RNN 建模任意长依赖(理论上)、串行
第四组 · 高频追问补充(61-80)
- "梯度消失的数学直觉?" 误差沿时间反传要连乘 $W_{hh}^T$:若谱半径 $\rho(W_{hh})<1$,范数以 $|\lambda_{max}|^T$ 指数衰减,$T=50$ 时早已"传不动";$\rho>1$ 则爆炸。一句话:连乘决定生死。
- "LSTM 凭什么缓解消失?" 细胞状态 $c_t=f_t\odot c_{t-1}+i_t\odot\tilde c_t$ 是加性更新,误差可以从 $t$ 直接"抄近路"传回 $t-1$(梯度有一条"高速公路");遗忘门偏置初始化 ≈1 让这条路默认通畅。
- "为什么门用 sigmoid、候选用 tanh?" sigmoid 输出 (0,1) 当"开关";tanh 输出 (-1,1) 提供有正有负的"新内容",且 tanh 在 0 附近梯度≈1,训练稳定。
- "GRU 少在哪儿?" GRU 把遗忘门 + 输入门合并成"更新门",少一个门、少一组参数,效果与 LSTM 相当——"省约 25% 参数、换相近效果"。
- "梯度裁剪为什么只治爆炸?" 裁剪是"事后刹车";消失是"结构性病"(信息根本传不到远处),只能靠 LSTM 加性通路、残差连接、合理初始化从结构上解决。
数字敏感点:LSTM 参数口算 4×(d·h + h·h + h);谱半径是 RNN 梯度消失的"判决书";T 越长,连乘指数衰减越狠——这三点是第四组的数字题高频。
# ---------- 手撕 4:RNN 单步前向 + 展开图(谱系图可视化) ----------
import os
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(0)
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 1) RNN 单步:h_t = tanh(W_xh x_t + W_hh h_{t-1} + b)
d, h = 3, 4
W_xh = np.random.normal(0, 0.1, (h, d))
W_hh = np.random.normal(0, 0.1, (h, h))
b = np.zeros(h)
x = np.random.normal(0, 0.1, d)
h_prev = np.zeros(h)
h_t = np.tanh(W_xh @ x + W_hh @ h_prev + b)
print('RNN 单步: x 形状', x.shape, '-> h_t 形状', h_t.shape, '(参数共享,任意长度序列复用)')
assert h_t.shape == (h,)

# 2) 谱系图(保留原图,路径改为教学目录下 images/)
os.makedirs('10-自然语言处理/教学/images', exist_ok=True)
fig, ax = plt.subplots(figsize=(9, 3.4))
stages = ['词向量', 'RNN', 'LSTM/GRU', 'Attention', 'Transformer', 'BERT/GPT', 'LLM+RLHF']
yv = [1, 3, 6, 10, 14, 18, 22]
ax.plot(np.arange(len(stages)), yv, 'o-', markersize=10)
for i, s in enumerate(stages):
    ax.annotate(s, (i, yv[i]), textcoords='offset points', xytext=(0, 12), ha='center', fontsize=10)
ax.set_ylim(0, 26); ax.set_xticks([]); ax.set_yticks([])
ax.set_title('NLP 表示学习演进:从统计计数到预训练大模型')
for spine in ax.spines.values():
    spine.set_visible(False)
plt.tight_layout()
plt.savefig('10-自然语言处理/教学/images/nlp07_evo.png', dpi=110, bbox_inches='tight'); plt.show()
print('读图:RNN->Attention 的关键不是层数,而是"串行递推"变成"全局并行"')
读图:NLP 模型谱系——从统计计数到预训练大模型
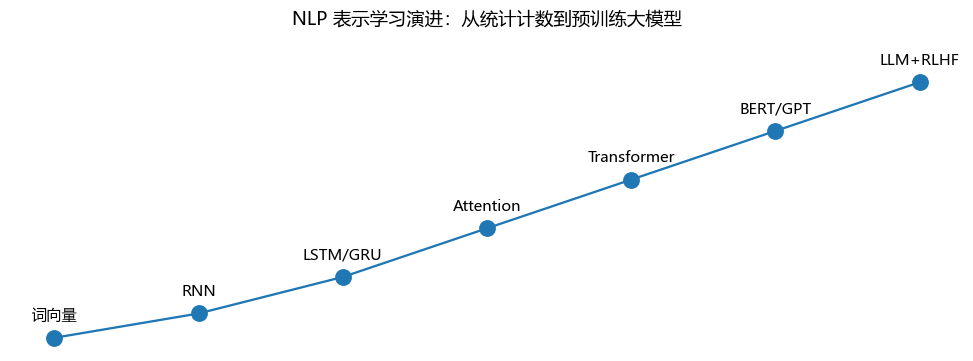
图 1:自绘 NLP 表示学习演进谱系图(自绘,matplotlib 生成)——词向量 → RNN → LSTM/GRU → Attention → Transformer → BERT/GPT → LLM+RLHF。
手撕 4 顺手画出了全章的"地图",读图请抓三条主线:
- 表示升级线:One-hot/词袋(稀疏、无语义)→ Word2Vec/GloVe(稠密、静态)→ ELMo/BERT(稠密、上下文相关)——每一次升级都在回答"向量里放没放进语境";
- 架构升级线:RNN(串行、难并行)→ LSTM/GRU(门控救梯度)→ Attention/Transformer(全并行、O(T²))→ FlashAttention 等(省显存、提速)——每一次都在解决上一代的工程痛点;
- 范式升级线:统计(稀疏)→ 神经(参数共享)→ 预训练 + 微调(通用表示)→ 预训练 + 对齐(RLHF)——从"任务专用"走向"通用 + 可控"。
面试用法:被问"讲讲 NLP 的演进",就按这三条线各讲一句,最后落到"现在的大模型 = Transformer 架构 + 预训练范式 + 对齐技术",整页八股就被串起来了。
第五组 · Attention / Transformer(81-90)
- 注意力公式? $\text{softmax}(QK^T/\sqrt{d_k})V$
- 除 √d_k 为什么? 点积方差 ~d_k,过大进 softmax 饱和区梯度消失
- 自注意力里 Q/K/V 从哪来? 输入线性投影(同源)
- 多头意义? 多组子空间并行关注不同关系;拼接 + out_proj
- 因果掩码是什么形状? 下三角(decoder 只能看左侧)
- 为什么 attention 里 mask 用 -inf? softmax 里 $e^{-inf}=0$,等价「不看」
- 位置编码为什么必要? 注意力是集合操作(置换等变),需显式注入顺序
- 正弦位置编码 vs 可学习? 正弦可外推长序列、无需学习;可学习灵活
- Transformer 层里残差和 LN 顺序? Post-LN(先残差后 LN)经典;Pre-LN(先 LN 后残差)更稳
- FFN 为什么用 4 倍宽? 实验最优;增加非线性容量
第五组 · Attention / Transformer(续 91-100)
- Encoder 和 Decoder 区别? Decoder 多因果掩码 + 交叉注意力
- 交叉注意力的 Q/K/V? Q 来自 decoder,K/V 来自 encoder 输出
- 复杂度问题? 自注意力 O(T²d);长序列用 flash-attention、稀疏/线性注意力
- KV cache 是什么? 生成时缓存历史 K/V,避免重复计算
- Beam search vs 贪心? beam 保留 top-K 路径,更好但更慢
- 注意力为什么能并行? 无时间递推依赖,一次矩阵运算算出所有位置的权重
- softmax 温度? $P \propto \exp(z/T)$;T 越小越尖锐,T→0 变 argmax,T→∞ 变均匀
- 多头拼接维度口算? d_model=512、h=8 → 每头 64;8×64 拼接回 512 再过 out_proj
- RoPE 是什么? 旋转位置编码:按位置旋转 Q/K,使内积携带相对位置信息
- FlashAttention 思路? 分块计算 + 在线 softmax,不物化 O(T²) 完整注意力矩阵,省显存
第五组 · 高频追问补充(81-100)
- "多头注意力为什么有效?" 每头在不同子空间上关注不同关系(语法 vs 指代 vs 位置);拼接 + out_proj 融合。可补一句"单头也能工作,多头是容量与并行性的提升"。
- "为什么正弦位置编码能外推?" 正弦/余弦对任意位置都有定义,训练见过的长度之外也能算出位置向量(可学习位置编码没有这个性质);RoPE 更进一步把位置编码进 Q/K 的相对内积,让内积只依赖相对距离。
- "Pre-LN 和 Post-LN 谁稳?" Post-LN(原论文)经典但深层易爆;Pre-LN 梯度更稳、利于堆叠,但表达力略降——现在大模型普遍 Pre-LN。
- "KV cache 的代价?" 省去历史 K/V 的重复计算(生成每步只算新 token),代价是显存随序列长度线性增长;长上下文要配合分页存储 / KV 量化。
- "FlashAttention 怎么省显存?" 分块计算 + 在线 softmax(维护 running max/sum),不物化 $O(T^2)$ 的注意力矩阵,显存从 $O(T^2)$ 降到 $O(T)$。
- "温度 T 怎么调?" T 小 → 分布尖锐(接近贪心,确定性高);T 大 → 更均匀(更多样)。生成任务常用 T≈0.7~1.0,要求确定性的场景 T→0。
第五组是"公式 + 数字"重灾区:√d(d=512 → √d≈22.6)、每头维度 64、复杂度 O(T²d)、KV cache 的省/费——这四个数字背下来,第五组基本过关。
# ---------- 手撕 5:注意力矩阵 + 因果掩码 ----------
import numpy as np

T4, D4 = 4, 3
Q4 = np.random.default_rng(0).normal(size=(T4, D4))
K4 = np.random.default_rng(1).normal(size=(T4, D4))
V4 = np.random.default_rng(2).normal(size=(T4, D4))

sc = Q4 @ K4.T / np.sqrt(D4)
mask = np.triu(np.ones((T4, T4), dtype=bool), k=1)
sc_m = np.where(mask, -np.inf, sc)
p = np.exp(sc_m - sc_m.max(axis=-1, keepdims=True))
p = p / p.sum(axis=-1, keepdims=True)
print('因果注意力权重(下三角为 0):\n', np.round(p, 3))
assert (p[np.triu_indices(T4, 1)] == 0).all()       # 右上必须全 0
assert np.allclose(p.sum(axis=-1), 1.0)              # 每行归一
print('每行和=1 ✓ | 第 2 个 token 只能看自己与其左侧 ✓')
out4 = p @ V4
print('输出形状:', out4.shape, '(T, d)——这就是 decoder 自注意力的本质')
第六组 · 预训练 / 任务 / 评估(101-110)
- 预训练-微调为什么有效? 无标注语料大、标注贵;通用表示可迁移
- BERT 两个预训练任务? MLM(mask 15%,80/10/10)+ NSP(后证实可去)
- MLM 为什么 80/10/10? 缓解预训练见 [MASK] 而微调不见的 mismatch
- BERT 输入表示? [CLS] 句A [SEP] 句B [SEP];token+位置+段 三个 embedding 相加
- [CLS] 的作用? 分类可用其输出;实际常取池化/首 token,效果差不多
- GPT 和 BERT 结构差异? Decoder 单向因果 vs Encoder 双向;生成 vs 理解
- 微调学习率为什么小? 防破坏预训练表示(1e-5~5e-5)
- Prompt 与微调区别? 不更新参数/少更新,用自然语言指令引导;零样本/少样本
- RLHF 三步? SFT → 奖励模型(人类偏好打分)→ PPO 优化
- 文本分类的评估? Accuracy / macro-F1(类不均衡用后者)
第六组 · 预训练 / 任务 / 评估(续 111-120)
- 序列标注 NER 的评估? 实体级 P/R/F1(不是 token 级,错一个边界算错)
- BLEU 原理? 候选与参考的 n-gram 重合(1-4 gram),乘长度惩罚
- ROUGE 用于什么? 摘要/翻译召回视角(参考词在候选中的覆盖率)
- 如何缓解类别不平衡? 重采样、类权重、Focal loss
- NLP 项目一般流程? 定任务与指标 → 数据清洗/增强 → 基线与强模型(预训练微调)→ 错误分析 → 上线监控
- 为什么 BERT 是双向的? MLM 预测被掩词时能看到两侧上下文;GPT 因果只能看左侧
- NSP 为什么被去掉? RoBERTa 发现去掉 NSP 反而更好;改用单句+长句混合训练
- 冻结 vs 全量微调? 冻结(feature-based)快但迁移差;全量微调更能适配目标任务
- macro-F1 与 micro-F1 何时相同? 各类样本数完全相同(或各类 P=R 相同时)
- RLHF 的 reward model 训练数据? 人类对同一 prompt 的多个回答做 pairwise 排序,学一个偏好打分器
第六组 · 高频追问补充(101-120)
- "MLM 和 LM 的区别?" MLM 预测被掩 token,能看到左右两侧(双向);LM 逐词预测、只能看左侧(单向)。BERT 用双向做理解、GPT 用单向做生成——结构差异一句话讲清。
- "NSP 为什么被 RoBERTa 去掉?" 实验表明去掉 NSP 后下游不降反升;替代方案是"单句 + 长句"混合采样。答"RoBERTa 实证:NSP 并非必要"即可。
- "微调学习率为什么小?" 预训练表示已经很好,学习率太大会"冲掉"通用知识(灾难性遗忘);1e-5~5e-5 常见。
- "RLHF 的 reward model 怎么训?" 同一 prompt 下多个回答两两比较(人类标注偏好),用 Bradley-Terry 模型学打分器,再喂给 PPO 做 KL 约束优化——三步:SFT → RM → PPO。
- "分类任务什么时候看 macro-F1?" 类别不平衡时(如 99:1)accuracy 会被多数类"骗";macro 对各类一视同仁,能暴露"小类全错"的问题。
- "NER 为什么用实体级指标?" token 级会把一个 5 字实体的 1 字边界错误记成 1/5 错;实体级整片段对才算对,更贴近业务对"边界正确"的要求。
第六组的主线是"预训练 + 对齐 + 评估"三位一体:BERT/GPT 结构对比 → 微调/提示 → RLHF 三步 → 下游指标怎么选,正好对应 101→120 的题目顺序。
# ---------- 手撕 6(新):BLEU 手写(n-gram 裁剪精确率 + 长度惩罚) ----------
import numpy as np
from collections import Counter

def bleu(cand, refs, max_n=4, weights=None):
    cand = cand.split()
    refs = [r.split() for r in refs]
    c = len(cand)
    # 参考长度:取与候选长度最接近的(并列时取较长的)
    r_len = len(min(refs, key=lambda ref: (abs(len(ref) - c), -len(ref))))
    bp = 1.0 if c > r_len else np.exp(1 - r_len / c)   # 长度惩罚:候选偏短要罚
    precs = []
    for n in range(1, max_n + 1):
        cand_ng = Counter(tuple(cand[i:i + n]) for i in range(len(cand) - n + 1))
        max_ref = Counter()
        for ref in refs:
            ref_ng = Counter(tuple(ref[i:i + n]) for i in range(len(ref) - n + 1))
            for k, v in ref_ng.items():
                max_ref[k] = max(max_ref.get(k, 0), v)  # 跨参考取最大计数
        clipped = sum(min(v, max_ref.get(k, 0)) for k, v in cand_ng.items())
        total = sum(cand_ng.values())
        precs.append(clipped / total if total else 0.0)
    w = weights or [0.25] * max_n
    geo = 0.0 if any(p == 0 for p in precs) else np.exp(sum(wt * np.log(p) for wt, p in zip(w, precs)))
    return bp * geo, precs, bp, r_len

# 例 1:与参考完全一致 -> BLEU = 1.0
s1, pr1, bp1, rl1 = bleu('the cat is on the mat', ['the cat is on the mat', 'there is a cat on the mat'])
print('例1 BLEU = %.4f | 1-4gram 精确率 %s | BP %.2f' % (s1, np.round(pr1, 3), bp1))
assert np.isclose(s1, 1.0)

# 例 2:重复词被裁剪 -> p1 只有 1/4(the 出现 4 次只算 1 次)
s2, pr2, bp2, rl2 = bleu('the the the the', ['the cat'])
print('例2 BLEU = %.4f | p1 = %.3f(裁剪后 1/4)| BP %.2f(候选不短不罚)' % (s2, pr2[0], bp2))
assert np.isclose(pr2[0], 0.25)

# 例 3:候选比参考短 -> 精确率全 1 仍被长度惩罚
s3, pr3, bp3, rl3 = bleu('the cat is on the', ['the cat is on the mat'])
print('例3 BLEU = %.4f | BP = %.4f(候选 5 词 < 参考 6 词)' % (s3, bp3))
assert bp3 < 1.0

# 例 4:bigram 重复被裁剪 -> p2 = 1/3
s4, pr4, bp4, rl4 = bleu('the cat the cat', ['the cat'])
print('例4 p2 = %.3f(the-cat 出现 2 次只算 1 次)' % pr4[1])
assert np.isclose(pr4[1], 1 / 3)

print('要点:BLEU = BP × exp(Σ w_n log p_n);p_n 用 max-ref 裁剪防重复刷分')
# ---------- 手撕 7(新):多头注意力维度口算 + 逐头 torch 对照 ----------
import numpy as np
import torch
import torch.nn.functional as F

np.random.seed(0); torch.manual_seed(0)

d_model, h = 512, 8
head_dim = d_model // h
assert d_model == h * head_dim                      # 口算:512 = 8 × 64
print('口算:d_model=512, h=8 -> 每头 head_dim = %d ✓' % head_dim)

T = 8
X = torch.randn(T, d_model)
Q = X; K = X; V = X                                # 简化:投影设为单位变换,专注维度与数值验证

# 手动多头:reshape (T, d_model) -> (T, h, head_dim) -> transpose (h, T, head_dim)
Qh = Q.view(T, h, head_dim).transpose(0, 1)        # (h, T, head_dim)
Kh = K.view(T, h, head_dim).transpose(0, 1)
Vh = V.view(T, h, head_dim).transpose(0, 1)
print('切分后 Q 形状:', tuple(Qh.shape), '-> 每头 (T=%d, %d)' % (T, head_dim))

outs = []
for i in range(h):
    s = Qh[i] @ Kh[i].T / np.sqrt(head_dim)        # 缩放点积
    p = torch.softmax(s, dim=-1)
    assert torch.allclose(p.sum(dim=-1), torch.ones(T))
    o = p @ Vh[i]                                  # (T, head_dim)
    ref = F.scaled_dot_product_attention(Qh[i], Kh[i], Vh[i], dropout_p=0.0)
    assert torch.max(torch.abs(o - ref)).item() < 1e-4, i
    outs.append(o)

out = torch.cat(outs, dim=-1)                      # 拼接回 (T, d_model)
print('拼接后形状:', tuple(out.shape), '(T, d_model)-> 再过 out_proj 才是完整 MHA ✓')
assert out.shape == (T, d_model)
print('8 头全部与 torch.nn.functional.scaled_dot_product_attention 一致(<1e-4)✓')
# ---------- 手撕 8(新):混淆矩阵 -> P/R/F1(macro/micro 派生 + sklearn 对照) ----------
import numpy as np
from sklearn.metrics import precision_recall_fscore_support

np.random.seed(0)
n, K = 120, 3
y_true = np.random.randint(0, K, n)
y_pred = np.random.randint(0, K, n)
y_pred[y_true == 2] = 2                            # 人为让类 2 更准(演示类别不均衡)

# 1) 混淆矩阵:CM[i,j] = 真实 i 被预测成 j
CM = np.zeros((K, K), dtype=int)
for t, p in zip(y_true, y_pred):
    CM[t, p] += 1

# 2) 派生 TP / FP / FN
TP = np.array([CM[i, i] for i in range(K)])
FP = CM.sum(axis=0) - TP                          # 每列:预测成 i 但不是 i
FN = CM.sum(axis=1) - TP                          # 每行:真实 i 但没预测成 i
with np.errstate(divide='ignore', invalid='ignore'):
    P = TP / (TP + FP); R = TP / (TP + FN); F1 = 2 * P * R / (P + R)
P = np.nan_to_num(P); R = np.nan_to_num(R); F1 = np.nan_to_num(F1)

# 3) macro:各类平均
macro_p, macro_r, macro_f1 = P.mean(), R.mean(), F1.mean()

# 4) micro:全局汇总(各类 TP/FP/FN 相加)
tp_all, fp_all, fn_all = TP.sum(), FP.sum(), FN.sum()
micro_p = tp_all / (tp_all + fp_all)
micro_r = tp_all / (tp_all + fn_all)
micro_f1 = 2 * micro_p * micro_r / (micro_p + micro_r)
acc = tp_all / n
assert np.isclose(micro_f1, acc)                  # 样本数一致时 micro-F1 = accuracy

# 5) sklearn 对照
sk_p, sk_r, sk_f, _ = precision_recall_fscore_support(y_true, y_pred, average=None)
sk_macro = precision_recall_fscore_support(y_true, y_pred, average='macro')
sk_micro = precision_recall_fscore_support(y_true, y_pred, average='micro')
assert np.allclose(P, sk_p) and np.allclose(F1, sk_f)
assert np.allclose(macro_f1, sk_macro[2]) and np.allclose(micro_f1, sk_micro[2])

print('混淆矩阵:\n', CM)
print('各类 P/R/F1:', np.round(P, 3), np.round(R, 3), np.round(F1, 3))
print('macro-F1 = %.4f | micro-F1 = %.4f | accuracy = %.4f' % (macro_f1, micro_f1, acc))
print('与 sklearn precision_recall_fscore_support 逐位一致 ✓')
print('要点:micro-F1(样本数一致时)= accuracy;macro 是各类平均,类别不均衡时更敏感')
8 个手撕总索引(面试前 5 分钟扫一遍)
| # | 手撕 | 验证点 / 背写要点 |
|---|---|---|
| 1 | TF-IDF + 余弦检索 | sklearn 平滑 IDF、余弦排序、命中文档最前 |
| 2 | n-gram 加 k 平滑 + PPL | (c+k)/(前词 c+V·k);PPL = exp(-平均 log P) |
| 3 | Skip-gram 负采样一步梯度 | 正样本 σ(x)-1、负样本 σ(x);数值校验 <1e-6 |
| 4 | RNN 单步 + 谱系图 | h_t = tanh(W_xh x + W_hh h + b);演进路线 |
| 5 | 注意力 + 因果掩码 | 上三角置 -inf、行归一、输出 (T, d) |
| 6 | BLEU 手写(新) | 1-4 gram 裁剪精确率 + 长度惩罚 BP |
| 7 | 多头维度口算(新) | 512/8=64;reshape/transpose/拼接 + torch 对照 |
| 8 | 混淆矩阵派生(新) | TP/FP/FN 派生、macro/micro、micro=acc、sklearn 对照 |
数字记忆卡(一页背完关键数字)
① 模型尺寸速查
| 模型 | 层数 L | 隐层 H | 头数 A | 参数量 | 备注 |
|---|---|---|---|---|---|
| BERT-base | 12 | 768 | 12 | ≈110M | 每层 ≈ 9.2M |
| BERT-large | 24 | 1024 | 16 | ≈340M | FFN 4×1024 |
| GPT-2 small | 12 | 768 | 12 | 117M | — |
| GPT-2 medium | 24 | 1024 | 16 | 345M | — |
| GPT-2 large | 36 | 1280 | 20 | 762M | — |
| GPT-2 XL | 48 | 1600 | 25 | 1.5B | — |
| Transformer base | 6 | 512 | 8 | — | 每头 64,FFN 2048 |
② 公式与超参速记
| 考点 | 一句话答案 |
|---|---|
| 缩放点积注意力 | softmax(QKᵀ/√d_k)V;√d 原因:点积方差 ≈ d_k,防 softmax 饱和 |
| PPL | exp(平均负对数似然) = exp(交叉熵),同一语料下越低越好 |
| 负采样分布 | P(w) ∝ count(w)^(3/4),提高稀有词被采样概率 |
| 负采样损失 | -log σ(v_c'·v_w) - Σ_k log σ(-v_k'·v_w) |
| MLM 比例 | 选 15% token 掩码;其中 80% [MASK]、10% 随机词、10% 原词 |
| 遗忘门偏置 | 初始 ≈ 1~2,初始偏向「记住」 |
| LSTM 参数量 | 4×(d·h + h·h + h):h=256, d=128 → ≈394k |
| 微调学习率 | 1e-5 ~ 5e-5(小,防止破坏预训练表示) |
| 多头拼接 | h × head_dim = d_model;512 / 8 = 64 |
| 自注意力复杂度 | O(T²·d);KV cache 省重复计算、代价是显存 |
| Adam | β1 = 0.9, β2 = 0.999, eps = 1e-8 |
| BLEU | 1-4 gram 裁剪精确率 + 长度惩罚 BP |
数字记忆卡 · 口算 10 连(先算再看答案)
- 512 / 8 = 64(每头维度)✓
- FFN(d=512) 参数量 = 2×512×2048 + 2048 + 512 ≈ 2.1M
- LSTM 仅 W_hh(h=256)= 4×256×256 ≈ 262k
- PPL = 10 ↔ 平均负对数似然 ≈ log(10) ≈ 2.30
- 100^(3/4) ≈ 31.6:高频词只被放大 ~32 倍而非 100 倍
- T=128, d=512 自注意力乘加量 ≈ 128²×512 ≈ 8.4M
- BERT-base 每层参数 ≈ 110M/12 ≈ 9.2M
- micro-F1(样本数一致时)= accuracy;macro-F1 是各类 F1 的平均
- bigram 词表 V=10000 → 理论组合 V² ≈ 1e8,语料必然覆盖不全
- 负采样 k:2-5 个负样本;维度 100-300;窗口默认 5
面试官最爱的口算三连:512/8、FFN 参数量、PPL↔loss。背熟上面 10 条即可无痛过关。
面试心法:一个主问题 = 一条追问链
八股面试最怕的不是不会,而是只会背第一层。以"讲讲注意力机制"为例,标准追问链长这样:
Q1 主问题:讲注意力 → 答 softmax(QKᵀ/√d)V + 直觉"按相关性加权汇总"; Q2 为什么除 √d → 点积方差 ~d_k,防 softmax 饱和(背数字:d=512 → √d≈22.6); Q3 为什么多头 → 多子空间关注不同关系,拼接 + out_proj; Q4 复杂度多少 → O(T²d),长序列怎么办 → FlashAttention / 稀疏注意力; Q5 位置信息哪来的 → 位置编码 / RoPE,为什么需要(注意力是置换等变的集合操作); Q6 生成时怎么省算力 → KV cache。
看出规律了吗?每往下挖一层,都是在"上一个答案的缺陷"上提问:有了公式问数值、有了数值问复杂度、有了复杂度问优化、有了机制问信息注入、有了推理问工程加速。备考时对每个高频主问题(TF-IDF、PPL、负采样、梯度消失、BERT vs GPT、macro/micro……)都预先推两条追问,面试就不会被"接着问"卡住。本页 120 问 + 上面各组的"高频追问补充",就是为这条链准备的弹药。
附:NLP 谱系一页纸
分词(词典/统计) ─┐
词袋/TF-IDF ─────┼──▶ 统计语言模型(n-gram) ──▶ 神经网络LM ──▶ Word2Vec/GloVe/fastText
One-hot ─────────┘                                │
                                    上下文表示: ELMo ──▶ BERT(MLM) ──▶ RoBERTa/ALBERT
                                    Decoder 路线: GPT(自回归) ──▶ GPT-3 ──▶ InstructGPT/ChatGPT(RLHF)
                                    序列建模:  RNN ─▶ LSTM/GRU ─▶ Attention ─▶ Transformer ─┘
任务应用: 分类(贝叶斯/BERT) · 标注(BiLSTM+CRF/BERT) · 生成(Seq2Seq/LLM) · 检索(TF-IDF/向量)
| 阶段 | 代表方法 | 核心思想 | 局限 → 演进 |
|---|---|---|---|
| 词袋 | BOW / TF-IDF | 词频统计、稀有词加权 | 丢语序/语义 → 词向量 |
| 统计 LM | n-gram + 平滑 | 马尔可夫假设截断 | 稀疏 → 神经 LM |
| 词向量 | Word2Vec / GloVe | 分布式假设 / 共现分解 | 静态 → 上下文表示 |
| 序列建模 | RNN / LSTM / GRU | 参数共享、门控 | 串行慢 → Attention |
| Attention | Transformer | 全局并行、QKV | O(T²) → 稀疏/FlashAttention |
| 预训练 | BERT / GPT | MLM / 自回归 | 理解/生成分家 → 统一 |
| 对齐 | InstructGPT / RLHF | SFT + RM + PPO | 幻觉/安全 → 持续对齐 |
考前 30 分钟扫一遍上面 120 问 + 8 手撕 + 数字记忆卡,即可覆盖 90% 的 NLP 算法岗八股考点。
面试速答(30 秒背诵版,10 连)
- 为什么除 √d? 点积方差 ≈ d_k,不除会进 softmax 饱和区、梯度消失。
- 为什么多头? 不同子空间并行关注不同关系;拼接再过 out_proj。
- 因果掩码怎么实现? 上三角置 -inf(或 mask_fill),softmax 后右侧为 0。
- LSTM 为什么缓解梯度消失? 细胞状态 c 加性更新 = 梯度高速公路;遗忘门偏置初始 ≈1 偏向记住。
- MLM 为什么 80/10/10? 缓解预训练见 [MASK]、微调不见的 mismatch。
- 负采样 3/4 次幂? 提高低频词被采样概率,抑制高频词主导。
- PPL 和 loss? PPL = exp(平均 NLL) = exp(交叉熵);同一语料越低越好。
- KV cache 省什么? 省历史 K/V 的重复计算,代价是显存。
- 微调学习率为什么小? 1e-5~5e-5,防止破坏预训练表示。
- 统计 vs 神经 LM? 统计稀疏不可泛化;神经参数共享、能泛化到未见组合。
高频易错点 TOP 12(面试官最爱挖的坑)
- TF-IDF 忘平滑:IDF 直接用 log(N/df) 遇 df=0 会除零;用 log((N+1)/(1+df))+1。
- BOW 忘说丢语序:举「猫追狗 vs 狗追猫」反例。
- PPL 跨语料比较:PPL 只在同一语料/切分下可比。
- 负采样梯度符号:正样本 σ(x)-1,负样本 σ(x);别搞反。
- 遗忘门偏置忘初始化:初始 ≈1~2(偏向记住)。
- 注意力忘除 √d:只写 softmax(QKᵀ)V 就丢分了。
- 掩码位置:因果掩码是上三角置 -inf(右上角),不是下三角。
- 多头拼接后忘 out_proj:MHA = concat(heads)·W_O,还有 W_O。
- BERT/GPT 方向搞反:BERT = Encoder 双向(MLM);GPT = Decoder 单向(自回归)。
- MLM 比例误解:15% 是「选多少 token 掩码」,80/10/10 是「被选中 token 内部」的替换方式。
- micro 与 macro 混用:micro-F1 = accuracy(样本数一致时);macro 是各类平均。
- BLEU 忘长度惩罚:候选比参考短必须 BP < 1,否则重复短句刷分。
自测清单(本章总验收)
- 六组 120 问:能不看答案复述 80%+
- 8 个手撕:TF-IDF、平滑+PPL、负采样一步梯度、RNN 单步+谱系、因果注意力、BLEU、多头维度、混淆矩阵
- 数字记忆卡:BERT base 12/768/12/110M、512/8=64、PPL 公式、3/4 次幂、80/10/10 张口就来
- 口算:一个 FFN 层参数量(2.1M)、LSTM W_hh(262k)、PPL↔NLL
- 能从「分词 → 表示 → 模型 → 任务 → 评估」完整讲一个 NLP 项目
- 能对比:统计 vs 神经、CBOW vs Skip-gram、BERT vs GPT、RNN vs Transformer
- 易错点 12 条:能说出每条「坑在哪」
- 30 秒背诵版:10 条 Q&A 一条不卡壳
- 回到 00~06 篇,把每篇「面试速答」再过一遍
- 手撕限时:每个手撕 5 分钟内默写 + 跑通
📍 验收路径:00 表示 → 01 n-gram → 02 词向量 → 03 RNN → 04 Transformer → 05 预训练 → 06 任务 → 07 总复习; 每篇「自测清单」勾完即通关。
从八股到实战:把考点串成项目 story
八股背完不等于会干活,考场上"有没有做过"才是分水岭。给你一条 15 秒的项目叙事线(以 06 篇的玩具实验为例):
"我用 06 篇的方法做了一个三分类任务:先搭 TF-IDF + 逻辑回归基线(acc 0.98),再手写朴素贝叶斯与 sklearn 逐位对齐验证实现正确性;评估时发现类别不平衡,改用 macro-F1 并画出混淆矩阵做错误分析;序列标注部分用 BiLSTM 做词性标注(token acc > 0.95),并验证了双向拼接语义;最后用手写 Viterbi 证明非法标签路径会被 CRF 拒绝。"
这段话里每个从句都对应一个考点:基线思维(TF-IDF + LR)、实现自证(NB vs sklearn)、评估敏感性(macro-F1)、错误分析(混淆矩阵)、架构验证(BiLSTM 拼接)、解码正确性(Viterbi 非法路径)。面试官听完会顺着问其中任何一环——而你刚好每一环都有 06 篇的代码和数字兜底。
给所有八股一个"我在哪儿用过它、数字是多少"的锚点,背诵就变成了项目复盘。
下一篇预告
📍 07 是全章速成的终点,也是实战的起点:回到 00~06 任一篇,把「面试速答 + 自测清单」当成验收关卡; 下一步用 06 篇的指标 + 05 篇的预训练模型跑一个端到端分类/NER 项目,检验「八股 → 工程」的转化。