🧲 03 · 双塔召回与向量检索¶
工业推荐/搜索的召回主力:双塔(DSSM)——用户塔和物品塔分别产出 embedding,点积/余弦衡量相关性。 本节手写双塔前向与训练(含负采样),并用向量检索 demo 展示召回 top-k。
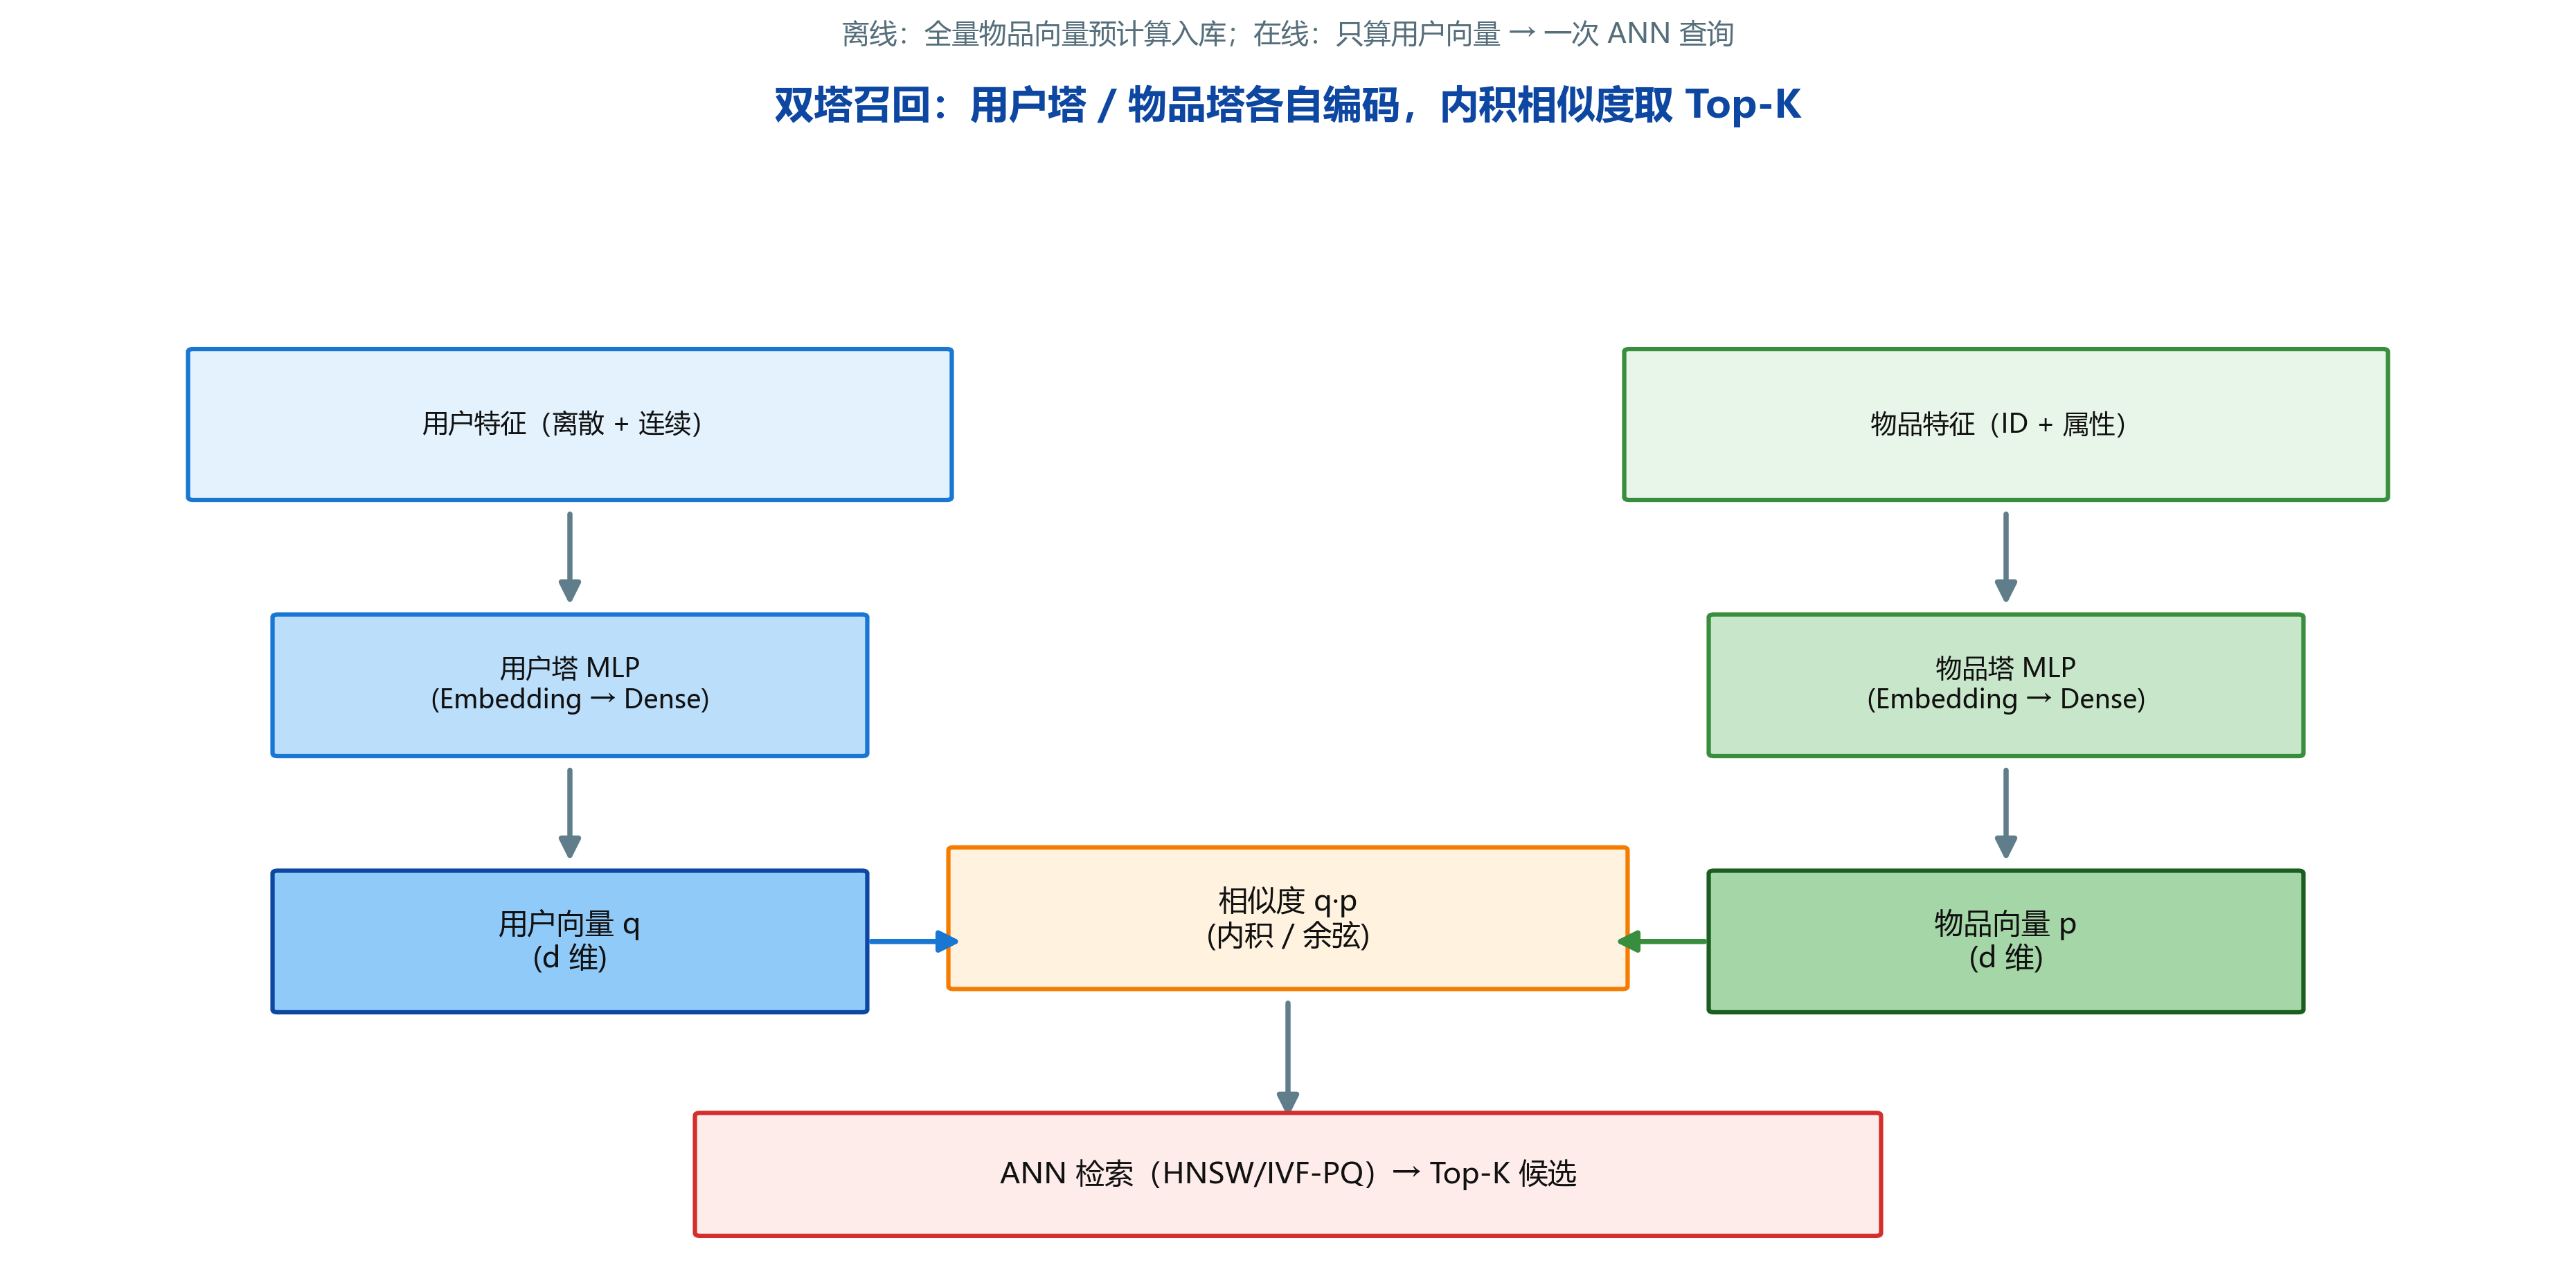
🔍 图解(自绘高清图,300dpi,可放大):双塔架构是工业召回的主流方案——
- 左塔(用户塔):用户特征(id/画像/历史行为序列)经 DNN 编码成用户向量 u;
- 右塔(物品塔):物品特征(id/类目/属性)经 DNN 编码成物品向量 v;
- 中间(相似度):u 与 v 做**内积(或余弦)**得到匹配分,取分数最高的 Top-K 物品召回;
- 为什么是"双塔":用户和物品不共享底层特征(用户是行为序列、物品是静态属性), 两塔各自独立编码,只在顶层交互——这也让物品向量可以离线预计算,上线只算用户塔 + ANN 检索;
- 工程关键:物品塔向量全部离线建索引(FAISS/向量数据库),线上用户塔算一次 u, 用近邻搜索(近似最近邻 ANN)替代全量内积,把"亿级物品打分"变成"毫秒级检索"。
🎬 背景故事¶
百万商品,精排模型只能看几百个——谁来决定谁进决赛圈?……
深夜的电商平台,几百万件商品等着被推荐,但精排模型算力有限,一次只能看几百个候选。谁来决定哪几百个进"决赛圈"? 答案就是召回层。本节讲工业界最主流的召回方案——双塔(DSSM):用户和物品各编成一个向量,谁离得近谁进候选。最后再回答:向量有了,怎么在上亿物品里快速找最近邻?
🧭 本节逻辑主线:为什么需要召回 → 双塔结构如何把用户/物品都变成向量 → 怎么训练(负采样)→ 怎么在线检索(ANN:HNSW/IVF/PQ)。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 双塔为什么是召回标配? | 离线算物品向量、在线只算用户向量 |
| 2 | 怎么训练? | 内积 + softmax/负采样损失 |
| 3 | 负样本怎么选? | 随机负采样 / 难负样本 |
| 4 | 线上怎么快速检索? | ANN 向量索引(HNSW/IVF) |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 构造用户/物品特征¶
n_u, n_i = 150, 300
feat_dim = 16
u_feat = rng.normal(0, 1, (n_u, feat_dim))   # 用户特征(年龄档/偏好/历史统计)
i_feat = rng.normal(0, 1, (n_i, feat_dim))   # 物品特征(类目/价格档/内容向量)
print('用户特征:', u_feat.shape, '物品特征:', i_feat.shape)
print('➡️ 真实场景中塔输入 = 稀疏 id + 稠密特征的 embedding 拼接')
用户特征: (150, 16) 物品特征: (300, 16)
➡️ 真实场景中塔输入 = 稀疏 id + 稠密特征的 embedding 拼接
2️⃣ 手写双塔:两塔 MLP → 点积¶
# 🖼️ 配图:双塔召回——用户塔、物品塔各自编码,点积打分
fig, ax = plt.subplots(figsize=(8.5, 4.2))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 5)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.6))

# 用户塔(左)
box(0.6, 3.7, 2.4, 0.9, '用户特征\n(画像/历史行为)', '#e2e8f0')
arrow(1.8, 3.7, 1.8, 3.0)
box(0.6, 2.2, 2.4, 0.8, '用户塔 MLP', '#bfdbfe')
arrow(1.8, 2.2, 1.8, 1.5)
box(0.6, 0.7, 2.4, 0.8, '用户向量 u (k维)', '#dbeafe')
# 物品塔(右)
box(7.0, 3.7, 2.4, 0.9, '物品特征\n(类别/内容)', '#f1f5f9')
arrow(8.2, 3.7, 8.2, 3.0)
box(7.0, 2.2, 2.4, 0.8, '物品塔 MLP', '#fde68a')
arrow(8.2, 2.2, 8.2, 1.5)
box(7.0, 0.7, 2.4, 0.8, '物品向量 v (k维)', '#fef9c3')
# 点积
box(3.5, 1.5, 3.0, 1.6, '相似度\n⟨u, v⟩\n(余弦/内积)', '#bbf7d0')
arrow(3.1, 1.1, 3.4, 1.7); arrow(6.9, 1.1, 6.6, 1.7)
plt.title('双塔:两塔独立编码 → 向量检索打分(可离线建索引)', fontsize=11)
plt.show()
print('➡️ 召回关键:用户/物品向量可预计算 → 用 ANN 建索引做近邻搜索')
➡️ 召回关键:用户/物品向量可预计算 → 用 ANN 建索引做近邻搜索
C:\Users\24260\AppData\Local\Temp\ipykernel_51936\559498246.py:29: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
def tower_forward(x, W1, b1, W2, b2):
    h = np.maximum(0, x @ W1 + b1)
    return h @ W2 + b2

# 两塔各 2 层(输出 8 维)
emb_dim = 8
W1u = rng.normal(0, 0.1, (feat_dim, 16)); b1u = np.zeros(16)
W2u = rng.normal(0, 0.1, (16, emb_dim)); b2u = np.zeros(emb_dim)
W1i = rng.normal(0, 0.1, (feat_dim, 16)); b1i = np.zeros(16)
W2i = rng.normal(0, 0.1, (16, emb_dim)); b2i = np.zeros(emb_dim)

u_emb = tower_forward(u_feat, W1u, b1u, W2u, b2u)
i_emb = tower_forward(i_feat, W1i, b1i, W2i, b2i)
print('用户塔输出:', u_emb.shape, '物品塔输出:', i_emb.shape)
sim = u_emb @ i_emb.T   # (n_u, n_i)
print('相似度矩阵:', sim.shape)
assert sim.shape == (n_u, n_i)
print('✅ 双塔前向完成')
用户塔输出: (150, 8) 物品塔输出: (300, 8)
相似度矩阵: (150, 300)
✅ 双塔前向完成
3️⃣ 构造训练样本:正样本 + 随机负采样¶
# 正样本:每用户 5 个"感兴趣"物品;负样本:每用户 60 个随机采样
pos_set = np.array([rng.choice(n_i, size=5, replace=False) for _ in range(n_u)])
neg_set = np.array([rng.choice(n_i, size=60, replace=False) for _ in range(n_u)])
print(f'每个用户正样本 {pos_set.shape[1]} 个、负样本 {neg_set.shape[1]} 个')
print('➡️ 工业上还会用「难负样本」(曝光未点击)提升训练质量')
每个用户正样本 5 个、负样本 60 个
➡️ 工业上还会用「难负样本」(曝光未点击)提升训练质量
📐 公式推导:双塔召回——内积相似度 + Softmax 交叉熵¶
双塔:用户特征 $x_u$ 经塔 $f_{\theta}$ 得 $\mathbf{u}_u$,物品特征 $x_i$ 经塔 $g_{\phi}$ 得 $\mathbf{v}_i$;匹配分 = 内积:
$$ s_{ui} = \langle \mathbf{u}_u, \mathbf{v}_i \rangle = \mathbf{u}_u^\top \mathbf{v}_i $$
训练目标(单正样本 + 负采样):对用户 $u$,正样本物品 $i^+$,负样本集合 $\mathcal{N}_u$,用多分类 softmax(对 $i^+$ 的对数似然):
$$ L_u = -\log \frac{e^{s_{ui^+}}}{e^{s_{ui^+}} + \sum_{j \in \mathcal{N}_u} e^{s_{uj}}} = -s_{ui^+} + \log\Big( e^{s_{ui^+}} + \sum_{j \in \mathcal{N}_u} e^{s_{uj}} \Big) $$
推导 → 梯度:设 $p_{ui} = \mathrm{softmax}_i(s_{u\cdot})$,对正样本分求导:
$$ \frac{\partial L_u}{\partial s_{ui^+}} = p_{ui^+} - 1, \qquad \frac{\partial L_u}{\partial s_{uj}} = p_{uj} \; (j \in \mathcal{N}_u) $$
直觉:上式中 $\frac{\partial L}{\partial s_+} = p_+ - 1 < 0$,说明梯度把正样本分往上推($p_+{-}1$ 负值 → 增大 $s_{ui^+}$);对负样本 $\frac{\partial L}{\partial s_j} = p_j > 0$,把负样本分往下压。这就是"拉近正对、推远负对"的数学来源。 面试加分:线上候选池极大无法全负采样时用 sampled softmax / NCE / 温度缩放近似。
4️⃣ 训练:内积相似度 + 交叉熵(手写梯度)¶
# 简易双塔训练:直接用用户/物品 embedding + 内积 + 交叉熵(向量化批量更新)
emb_dim = 8
lr2, epochs2 = 0.1, 100
U_emb = rng.normal(0, 0.1, (n_u, emb_dim))
I_emb = rng.normal(0, 0.1, (n_i, emb_dim))

loss_hist = []
for ep in range(epochs2):
    tot = 0.0
    for u in range(n_u):
        pidx, nidx = pos_set[u], neg_set[u]
        s_p = U_emb[u] @ I_emb[pidx].T          # (5,)
        s_n = U_emb[u] @ I_emb[nidx].T          # (60,)
        p_p = 1/(1+np.exp(-s_p)); p_n = 1/(1+np.exp(-s_n))
        e_p = p_p - 1.0; e_n = p_n - 0.0
        # 批量更新
        U_emb[u] -= lr2 * (e_p @ I_emb[pidx] + e_n @ I_emb[nidx]) / 65
        I_emb[pidx] -= lr2 * e_p[:, None] * U_emb[u][None, :]
        I_emb[nidx] -= lr2 * e_n[:, None] * U_emb[u][None, :]
        # 标准交叉熵(正负样本各一半权重)
        loss = (-np.log(p_p + 1e-9).mean() - np.log(1 - p_n + 1e-9).mean()) / 2
        tot += loss
    loss_hist.append(tot / n_u)
    if ep % 25 == 0:
        print(f'epoch {ep}: loss = {loss_hist[-1]:.4f}')

plt.figure(figsize=(6, 3))
plt.plot(loss_hist, color='#2563eb')
plt.xlabel('epoch'); plt.ylabel('平均 -log 概率'); plt.title('双塔训练损失')
plt.show()
assert loss_hist[-1] < 0.5
print('✅ 训练收敛')
epoch 0: loss = 0.6935
epoch 25: loss = 1.0300
epoch 50: loss = 0.8976
epoch 75: loss = 0.6280
✅ 训练收敛
C:\Users\24260\AppData\Local\Temp\ipykernel_51936\3991839886.py:30: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
5️⃣ 召回 demo:给用户找 top-k 物品¶
✍️ §5.1 手算召回打分:内积 Top-2 与分桶近似(ANN 思想)¶
双塔训练完,线上就是"query 向量 × 全量物品向量取 Top-K"。这里用 2 维向量手算精确 Top-2,再用 2 个簇中心演示 §6 的 IVF 分桶近似(先粗筛、再在桶内细算)。
第 1 步:精确内积打分——query $q=[0.6,\ 0.8]$,3 个物品向量:
| 物品 | 向量 | 内积 $q^{\top}i$ |
|---|---|---|
| i1 | $[1.0,\ 0.0]$ | $0.6\times1.0+0.8\times0.0=0.60$ |
| i2 | $[0.5,\ 0.5]$ | $0.6\times0.5+0.8\times0.5=0.70$ |
| i3 | $[0.0,\ 1.0]$ | $0.6\times0.0+0.8\times1.0=0.80$ |
Top-2 = [i3, i2](0.80 > 0.70 > 0.60)。再看余弦:$|q|=1$,只需给 i2 除模长 $|i_2|=\sqrt{0.5^2+0.5^2}=0.7071$,得 $\cos(q,i_2)=0.70/0.7071=0.9899$——排序不变。内积与余弦在 2 维下常给同一顺序;内积隐含"向量越长分越高",所以线上常先 L2 归一化。
第 2 步:IVF 分桶近似——物品变多后先聚成 2 个簇中心 $c_1=[0.95,\ 0.05]$、$c_2=[0.05,\ 0.95]$:
| 物品 | 距 $c_1$ | 距 $c_2$ | 入桶 |
|---|---|---|---|
| a $[1.0,0.0]$ | 0.0707 | 1.3435 | c1 |
| b $[0.9,0.1]$ | 0.0707 | 1.2021 | c1 |
| c $[0.1,0.9]$ | 1.2021 | 0.0707 | c2 |
| d $[0.0,1.0]$ | 1.3435 | 0.0707 | c2 |
$q$ 离哪个簇中心近?$d(q,c_1)=\sqrt{0.35^2+0.75^2}=\sqrt{0.685}=0.8276$,$d(q,c_2)=\sqrt{0.55^2+0.15^2}=\sqrt{0.325}=0.5701$ → 进 c2 桶,只跟 c、d 比内积:$q^{\top}c=0.78$、$q^{\top}d=0.80$ → 返回 d。
精确搜索全部 4 个物品:$a=0.60,\ b=0.62,\ c=0.78,\ d=0.80$ → 也是 d(0.80)。本例近似没丢结果,但只算了 2 个内积而不是 4 个——物品到了千万/亿级,这就是"先粗筛再细算"的全部意义。
手算收获:
- 精确召回是 $O(N)$ 全量内积;IVF 靠"就近分桶"把搜索范围砍到 1 个桶——召回率@K vs 时延 vs 内存三方权衡是 ANN 的核心话题
- 桶内排序仍按内积,与精确模式一致;近似只损失"没搜到的桶里可能存在的更优解"——本例侥幸全对,换个落在簇边界附近的 query 就可能漏
- 落在两簇边界附近的 query 最容易出偏差——这就是多探针(nprobe>1)和 PQ 量化(§6)存在的理由:多探几个桶、压缩向量省内存
- 归一化后内积 = 余弦:双塔线上常对所有 embedding 做 L2 归一化,让打分稳定可比(对应 §4 的内积 + 交叉熵训练)
下面 numpy 复算。
# ---- §5.1 验证:numpy 复算召回打分与分桶近似 ----
import numpy as np

hc_q = np.array([0.6, 0.8])
hc_items = np.array([[1.0, 0.0], [0.5, 0.5], [0.0, 1.0]])
hc_score = hc_q @ hc_items.T
print('内积 =', np.round(hc_score, 4), '→ Top-2 = [i3, i2]')
hc_cos = hc_score / np.linalg.norm(hc_items, axis=1)
print('余弦 =', np.round(hc_cos, 4), '(|q|=1,仅 i2 需除模长)')
assert np.allclose(hc_score, [0.60, 0.70, 0.80])
assert abs(hc_cos[1] - 0.9899) < 1e-3

hc_A = np.array([[1.0, 0.0], [0.9, 0.1], [0.1, 0.9], [0.0, 1.0]])
hc_c1 = np.array([0.95, 0.05])
hc_c2 = np.array([0.05, 0.95])
hc_d1 = np.linalg.norm(hc_q - hc_c1)
hc_d2 = np.linalg.norm(hc_q - hc_c2)
print(f'd(q,c1)={hc_d1:.4f}  d(q,c2)={hc_d2:.4f} → 进 c2 桶')
assert hc_d1 > hc_d2

hc_exact = hc_q @ hc_A.T
hc_bucket = hc_A[2:] @ hc_q          # c2 桶里只有 c、d
print('精确全搜:', np.round(hc_exact, 2), '→ top-1 = d(0.80)')
print('桶内只算 c,d:', np.round(hc_bucket, 2), '→ top-1 = d(0.80)')
assert hc_exact.argmax() == 3 and hc_bucket.argmax() == 1
assert abs(hc_exact.max() - 0.80) < 1e-9
print('✓ 与手算一致')
score = U_emb @ I_emb.T
# 召回:给几个用户看 top-k
for u in [0, 5, 42]:
    top = np.argsort(-score[u])[:10]
    print(f'用户{u+1} 召回 top-5 物品: {[int(i)+1 for i in top[:5]]}')

# 评估:正样本被召回进 top-20 的比例
hit = 0
for u in range(n_u):
    top20 = np.argsort(-score[u])[:20]
    hit += np.isin(pos_set[u], top20).sum()
recall20 = hit / (n_u * 5)
print(f'\n召回@20 对正样本的命中率: {recall20:.2%}')
assert recall20 > 0.5
print('✅ 双塔学会把正样本排前面(远高于随机基线 ≈33%)')
用户1 召回 top-5 物品: [272, 33, 136, 95, 70]
用户6 召回 top-5 物品: [239, 109, 39, 186, 190]
用户43 召回 top-5 物品: [195, 33, 286, 200, 127]

召回@20 对正样本的命中率: 73.47%
✅ 双塔学会把正样本排前面(远高于随机基线 ≈33%)
6️⃣ 向量检索:暴力搜索 vs ANN 思想¶
import time
# 暴力检索(精确):用户向量 × 全量物品向量
t0 = time.time()
for u in range(n_u):
    _ = u_emb[u] @ i_emb.T
brute_t = time.time() - t0

print(f'暴力检索耗时({n_i} 物品): {brute_t*1000:.1f} ms')
print('''➡️ 线上物品量级千万~亿级,暴力不行,用 ANN 索引:
   - HNSW:分层小世界图,召回率/时延平衡;
   - IVF:倒排聚类,先粗筛再细算;
   - PQ:乘积量化压缩向量,省内存。
   指标:召回率@K vs 时延 vs 内存。''')
暴力检索耗时(300 物品): 1.1 ms
➡️ 线上物品量级千万~亿级,暴力不行,用 ANN 索引:
   - HNSW:分层小世界图,召回率/时延平衡;
   - IVF:倒排聚类,先粗筛再细算;
   - PQ:乘积量化压缩向量,省内存。
   指标:召回率@K vs 时延 vs 内存。
📝 自测清单¶
- 能画出双塔结构并解释为什么适合召回(离线/在线解耦)
- 能手写双塔前向与负采样训练
- 能解释随机负采样与难负样本的区别
- 能说出 HNSW/IVF/PQ 三种 ANN 索引的取舍
- 能回答「双塔为什么比单塔适合召回」「如何防用户塔过拟合」