🔢 09-整数规划与分支定界¶
目标:LP 加上「变量必须为整数」后难度陡增(IP 是 NP-hard),本讲掌握:IP 建模、分支定界 B&B 手撕、 割平面直觉、求解器实践。面试考点:为什么不能对松弛解取整、上界/下界方向、背包 B&B 手撕。
§0 整数规划为什么难¶
整数规划(IP):$\max c^\top x$ s.t. $Ax \le b,\ x \ge 0,\ x \in \mathbb{Z}^n$(部分变量整数 → MILP)。
- LP 松弛:丢掉整数约束 → 连续问题,好解,但只是上界
- 取整不靠谱:松弛解四舍五入可能不可行(违反约束),即使可行也常常非最优
- 整数可行点是离散点集,不再是连续多面体 → 顶点法失效 → 需要分支定界 / 割平面
本节例子(贯穿全程):
$$\max\ 8x_1+5x_2 \quad \text{s.t.}\ x_1+x_2\le 6,\ 9x_1+5x_2\le 45,\ x_1,x_2\ge 0,\ \text{整数}$$
LP 松弛最优 $(3.75, 2.25)$ 目标 $41.25$;但取整 $(4,2)$ 违反 $9x_1+5x_2\le 45$!真正的整数最优是 $(5,0)$,目标 $40$。
核心概念¶
(a) 🗂️ 整数规划与分支定界知识地图¶
这篇讲"加上整数约束为什么变难":取整会失效、解空间离散爆炸,主角是分支定界(用上界/下界剪枝)和割平面(Gomory),并落地到 0-1 背包、指派问题与 Gurobi/OR-Tools/scipy 实践。
flowchart TB
    Node1["🧠 整数规划为什么难"]
    Node1 --> Node2["🧠 取整会失效"]
    Node2 --> Node3["🧠 IP 建模"]
    Node3 --> Node4["🧠 LP 松弛"]
    Node4 --> Node5["🧠 分支定界"]
    Node5 --> Node6["🧠 剪枝三条件"]
    Node6 --> Node7["🧠 0-1 背包"]
    Node7 --> Node8["🧠 Gomory 割平面"]
    Node8 --> Node9["🧠 MILP 求解器"]
- 节点1(整数规划为什么难):整数可行点像散落在平面上的"网格点",数量随维度指数爆炸,不能像 LP 那样沿连续边滑行,理论上还是 NP-hard。
- 节点2(取整会失效):把 LP 松弛最优解 (3.75, 2.25) 四舍五入成 (4, 2) 可能直接落在约束外,甚至离整数最优很远;配图清楚展示"为什么不能无脑取整"。
- 节点3(IP 建模):先会建模再会求解:指派问题用 0-1 变量 + 每行每列和为 1 的约束完整建模,是面试最常考的第一道建模题。
- 节点4(LP 松弛):把"整数约束"放宽成连续,得到松弛问题;松弛最优值 ≥ 整数最优值(max 问题),它就是分支定界的"上界"来源。
- 节点5(分支定界):递归地把一个子问题按某个非整数变量拆成 x ≤ ⌊x⌋ 和 x ≥ ⌈x⌉ 两个分支,每个分支再解 LP 松弛,直到解出整数或证明没希望。
- 节点6(剪枝三条件):① 松弛解是整数 → 更新下界;② 松弛上界 ≤ 当前下界 → 整棵子树剪掉;③ 不可行 → 剪掉。上界越紧剪枝越快,这就是"为什么能剪枝"。
- 节点7(0-1 背包):背包问题用"分数背包贪心"当上界(可拆装的松弛价值 ≥ 整数最优),按性价比排序分支,是分支定界的最经典应用。
- 节点8(Gomory 割平面):从单纯形表推导出 Gomory 割,把非整数解"切"出可行域但不切掉任何整数点,割平面 + 分支定界就是现代 MILP 求解器的内核。
- 节点9(MILP 求解器):手写 B&B 用 scipy.linprog 当 LP oracle,工业上交给 Gurobi/OR-Tools/scipy.optimize.milp;手撕模板保证 10 分钟内解出一道 IP 面试题。
§0.5 配图:为什么「取整」会失效¶
先看一张直观的图——LP 松弛解与整数解的关系:
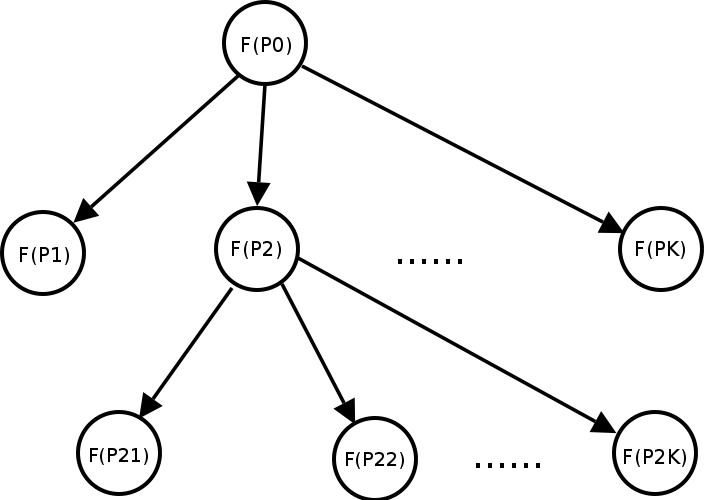
图注:整数规划的搜索树示意——每个节点对应一个带整数界的 LP 松弛子问题, 沿「分数变量」分支(来源:Wikimedia Commons,公有领域)。
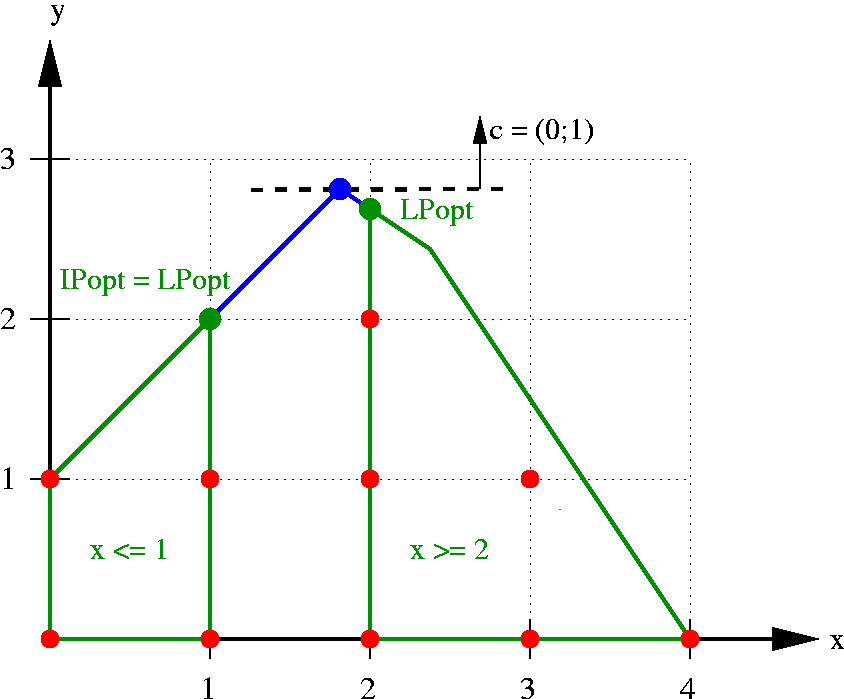
图注:松弛多面体与整数格点的关系——整数解是离散点,最优不一定在松弛解的附近 (来源:Wikimedia Commons,CC BY-SA 4.0)。
取整为什么不可行(本讲例题的教训):松弛最优 $(3.75, 2.25)$ 四舍五入得 $(4,2)$, 代入 $9x_1+5x_2\le 45$ 得 $46>45$——直接违反约束。 即使取整可行,把坐标四舍五入也只是「碰运气」:整数最优 $(5,0)$ 与松弛解相距很远。
🧩 记忆:松弛解是「上界」,不是「答案」;整数最优藏在整个可行整数点集里, 需要系统搜索(分支定界)而不是局部修修补补。
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# ---------- 复用 08 篇的单纯形(本 notebook 自包含;逐行解读见 08-线性规划与对偶.ipynb) ----------
def simplex_max(c, A, b):
    # max c^T x  s.t.  A x <= b,  x >= 0;返回 (status, x*, z*)
    # 单纯形表:行 = m 约束 + 1 目标;列 = n 变量 + m 松弛 + RHS;Bland 规则防循环
    c = np.asarray(c, float); A = np.asarray(A, float); b = np.asarray(b, float)
    m, n = A.shape
    T = np.zeros((m + 1, m + n + 1))    # 增广矩阵:约束行 A|I|b,目标行 -c|0|z
    T[:m, :n] = A                       # 约束系数
    T[:m, n:n + m] = np.eye(m)          # 松弛变量列 = 单位阵(初始基)
    T[:m, -1] = b                       # RHS
    T[-1, :n] = -np.array(c, dtype=float)  # 检验数行(负 = 入基可提高目标)
    basis = list(range(n, n + m))       # 每行的基变量(初始为松弛变量)
    for _ in range(1000):
        neg = np.where(T[-1, :-1] < -1e-9)[0]     # 找负检验数
        if neg.size == 0:
            break                                 # 检验数全 >= 0 → 最优
        j = int(neg[0])                           # 入基:最小下标(Bland)
        col = T[:-1, j]
        if np.all(col <= 1e-9):                   # 整列非正 → 无界
            return 'unbounded', None, None
        pos = np.where(col > 1e-9)[0]
        ratios = T[pos, -1] / col[pos]            # 比值检验:最小正比值行出基
        min_r = ratios.min()
        cand = pos[np.abs(ratios - min_r) <= 1e-9]
        i = int(cand[np.argmin([basis[rr] for rr in cand])])   # Bland 平局
        T[i] = T[i] / T[i, j]                     # 枢轴行归一化
        for r in range(m + 1):
            if r != i and abs(T[r, j]) > 1e-12:
                T[r] = T[r] - T[r, j] * T[i]      # 消去入基列(高斯-约当)
        basis[i] = j
    x = np.zeros(n)
    for i, bv in enumerate(basis):
        if bv < n:
            x[bv] = T[i, -1]                      # 基变量 = 该行 RHS
    return 'optimal', x, T[-1, -1]                # 目标行 RHS = 最优值

# ---------- LP 松弛 + 取整反例 ----------
c9 = [8, 5]; A9 = [[1, 1], [9, 5]]; b9 = [6, 45]
st, xr, zr = simplex_max(c9, A9, b9)
print('LP 松弛最优:', np.round(xr, 2), ' z = %.2f' % zr)
# 常见错误做法:把松弛最优 (3.75, 2.25) 四舍五入成 (4, 2)
print('取整候选 (4,2) 是否可行:', 9 * 4 + 5 * 2 <= 45 and 4 + 2 <= 6)   # 9*4+5*2=46 > 45 → 不可行!
print('取整候选 (4,2) 的目标 =', 8 * 4 + 5 * 2)

# ---------- 穷举所有整数点求真解(小规模对照基准) ----------
best_ip = None
for x1 in range(7):                       # 枚举 x1 = 0..6
    for x2 in range(7):                   # 枚举 x2 = 0..6
        if x1 + x2 <= 6 and 9 * x1 + 5 * x2 <= 45:   # 先检查可行性
            if best_ip is None or 8 * x1 + 5 * x2 > 8 * best_ip[0] + 5 * best_ip[1]:
                best_ip = (x1, x2)        # 保留目标值更大的整数点
print('穷举整数最优:', best_ip, ' z =', 8 * best_ip[0] + 5 * best_ip[1])

plt.show()
# ================= 手写分支定界(B&B) =================
# LP 松弛用 scipy.linprog 作为「线性规划 oracle」——B&B 的核心逻辑(分支/剪枝)是我们手写的,
# 松弛求解是工业级子程序(面试手撕时同样把 LP 松弛当黑盒)。
#
# 关键概念(max 问题):
#   * 上界 UB:当前子问题的 LP 松弛最优值(去掉整数约束只会让解更好或不变 → 松弛值 >= 整数最优)
#   * 下界 LB:已找到的整数可行解的目标值(全局最优至少这么好)
#   * 剪枝   :UB <= LB 时该子问题不可能产出更好的整数解 → 整棵子树直接放弃
from scipy.optimize import linprog

def bb_2d(c, A, b, bds, max_nodes=300):
    # 2 变量整数最大化问题的分支定界。
    # bds: 各变量整数界 [(lo,hi),...]。返回 (最优解, 最优值, 节点记录)。
    c = np.array(c, float); A = np.array(A, float); b = np.array(b, float)
    best_val = -np.inf; best_x = None   # 全局下界(当前最好整数解的值)与对应解
    nodes = []                          # 节点记录:(id, 父id, 松弛解, 松弛值, 状态)
    queue = [(bds, -1)]                 # 待考察子问题:整数界 + 父节点 id(FIFO → BFS)
    nid = 0
    while queue and nid < max_nodes:
        bd, parent = queue.pop(0)
        # 1) 解当前子问题的 LP 松弛(bounds 带上分支得到的整数界)
        res = linprog(-c, A_ub=A, b_ub=b, bounds=bd, method='highs')
        nid += 1
        if not res.success:             # 松弛不可行 → 本分支无可行解,剪枝
            nodes.append((nid, parent, None, None, 'infeasible'))
            continue
        x = res.x; z = -res.fun
        # 2) 判断松弛解是否已经是整数解
        frac = [i for i in range(len(c)) if abs(x[i] - round(x[i])) > 1e-6]
        if not frac:                    # 整数可行:它就是本子问题的可行整数解 → 更新下界
            nodes.append((nid, parent, x, z, 'integer'))
            if z > best_val:
                best_val = z; best_x = x
            continue
        nodes.append((nid, parent, x, z, 'fractional'))
        # 3) 上界剪枝:即使继续分支,最优也不可能超过松弛上界 z <= best_val
        if z <= best_val + 1e-9:
            nodes[-1] = (nid, parent, x, z, 'pruned')
            continue
        # 4) 分支:选一个分数变量 x_i,拆成 x_i <= floor(x_i*) 和 x_i >= ceil(x_i*) 两个子问题
        i = frac[0]
        lo, hi = bd[i]
        child_lo = [bd[k] if k != i else (lo, float(np.floor(x[i]))) for k in range(len(c))]
        child_hi = [bd[k] if k != i else (float(np.ceil(x[i])), hi) for k in range(len(c))]
        queue.append((child_lo, nid))   # 左分支:x_i 取 floor 及以下
        queue.append((child_hi, nid))   # 右分支:x_i 取 ceil 及以上
    return best_x, best_val, nodes

best_x, best_val, nodes = bb_2d(c9, A9, b9, [(0, 6), (0, 6)])
print('分支定界最优:', best_x, ' z =', best_val)
print('B&B 树(id, 父, 松弛解, 松弛值, 状态):')
for nd in nodes:
    print('  ', nd)
assert best_x[0] == 5 and best_x[1] == 0 and abs(best_val - 40) < 1e-9
print('对照通过:B&B == 穷举整数最优 (5,0) z=40')
# ---------- 对照 2:scipy.optimize.milp(工业求解器内核,验证手写 B&B) ----------
from scipy.optimize import milp, LinearConstraint, Bounds
# 目标写最小化:max 8x1+5x2 等价于 min -8x1-5x2 → c = [-8, -5]
# integrality=1 表示对应变量要求整数
res = milp(c=np.array([-8.0, -5.0]),
           constraints=[LinearConstraint(np.array([[1.0, 1.0], [9.0, 5.0]]), -np.inf, [6.0, 45.0])],
           integrality=np.ones(2), bounds=Bounds(0, 6))
print('scipy.milp:', res.x, ' z =', -res.fun)
assert np.allclose(res.x, [5, 0]) and abs(-res.fun - 40) < 1e-9
print('对照通过:手写 B&B == scipy.milp == 穷举,三层验证一致')

# ========== 示意图:松弛解 vs 整数解 ==========
fig, ax = plt.subplots(figsize=(7, 5.4))
xs = np.linspace(-0.2, 7, 300)
ax.plot(xs, 6 - xs, color='#4C72B0', lw=1.3, label='x1+x2=6')
ax.plot(xs, (45 - 9 * xs) / 5, color='#55A868', lw=1.3, label='9x1+5x2=45')
ax.axvline(0, color='k', lw=0.7); ax.axhline(0, color='k', lw=0.7)
# 所有整数可行点(灰色方块)
feas = [(i, j) for i in range(7) for j in range(7) if i + j <= 6 and 9 * i + 5 * j <= 45]
for p in feas:
    ax.plot(*p, 's', ms=4, color='#8E8E93')
# 松弛最优 vs 整数最优:松弛点 (3.75,2.25) 周围根本没有整数可行点,
# 最近的取整候选 (4,2) 还落在约束外(红箭头标注)
ax.plot(3.75, 2.25, 'o', ms=10, color='#C44E52', label='LP 松弛最优 (3.75,2.25)')
ax.plot(5, 0, '*', ms=16, color='#C44E52', label='整数最优 (5,0)')
ax.annotate('取整 (4,2) 不可行!', xy=(4, 2), xytext=(4.4, 2.7),
            arrowprops=dict(arrowstyle='->'), fontsize=9, color='#C44E52')
ax.set_xlim(-0.3, 7); ax.set_ylim(-0.3, 7)
ax.set_xlabel('x1'); ax.set_ylabel('x2')
ax.set_title('LP 松弛 ≠ 整数解:最优整数解不是松弛解的取整', fontsize=12)
ax.legend(fontsize=9); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
§1 整数规划建模(先会建模,再会求解)¶
0-1 背包:$\max \sum_i v_i x_i$ s.t. $\sum_i w_i x_i \le W,\ x_i \in \{0,1\}$ 指派问题:$\min \sum_{i,j} c_{ij} x_{ij}$ s.t. 每行/每列恰好一个 1,$x_{ij}\in\{0,1\}$ TSP 的 MILP:$x_{ij}\in\{0,1\}$ 表示走边 $(i,j)$ + 出入度约束 + 子圈消除(MTZ 大 M 约束 $u_i-u_j+n x_{ij}\le n-1$) 选址/设施:变量 = 是否建 + 是否服务,逻辑关系用大 M 线性化
建模通用技巧:
- 逻辑「若 A 则 B」→ $x_B \ge x_A$(或 $y \le M x$)
- 0-1 乘积 $x_1 x_2$ → 辅助变量 $z$ + 四条线性约束($z \le x_1,\ z \le x_2,\ z \ge x_1+x_2-1,\ z\ge 0$)
- 对称解重复 → 加序约束 $x_1 \le x_2 \le \cdots$ 打破对称
max 问题里,LP 松弛值永远是整数最优的上界——这是分支定界剪枝的依据。
§1.1 建模实战:指派问题完整建模¶
指派问题(assignment problem):$n$ 个任务分给 $n$ 个人,每人恰做一个,成本 $c_{ij}$,求最小总成本。
$$\min \sum_{i=1}^n\sum_{j=1}^n c_{ij}x_{ij} \quad \text{s.t.}\ \sum_j x_{ij}=1\ (\forall i),\ \sum_i x_{ij}=1\ (\forall j),\ x_{ij}\in\{0,1\}$$
有趣的事实:指派问题的 0-1 约束其实不需要显式写整数—— 因为约束矩阵是「全幺模」(totally unimodular),LP 松弛的极点自动是整数。 这也是二部图匹配(匈牙利算法)与 LP 的桥梁。
对比:TSP 为什么难——同样是 0-1 变量,但多了子圈消除约束(MTZ 大 M 法): $$u_i - u_j + n x_{ij} \le n-1 \quad (i,j\ge 2,\ i\ne j)$$ 这条约束保证选中的边构成一条回路而非多个小圈。少了它,松弛解会给出「子圈」这种 无意义解——这是面试常考的「为什么 TSP 不能直接当指派问题解」。
📌 记住三类问题在建模层面的差异:指派(全幺模,松弛即整数)、 背包(一个容量约束,B&B/DP 都好使)、TSP(子圈消除,MILP 表达但实际靠启发式)。
# ================= 0-1 背包:手写分支定界(上界=分数背包贪心) =================
# 模型:max Σ v_i x_i  s.t.  Σ w_i x_i <= W,  x_i ∈ {0,1}
# 上界为什么用【分数背包】:把“装/不装”放松成“可以装一部分”,得最大化问题。
# 可拆的松弛解价值必然 >= 整数背包最优价值 → 天然是上界,且贪心就能算(性价比排序)。
rng = np.random.default_rng(0)
n_items = 12
weights = rng.integers(1, 15, size=n_items)
values = rng.integers(5, 40, size=n_items)
W = 40
print('物品 (w, v):', list(zip(weights, values)))

def knap_ub(pos, cap, cur):
    # 分数背包上界:从第 pos 件起,按“单位重量价值 v/w”从高到低贪心装(允许拆最后一件)
    b = cur
    for k in range(pos, n_items):
        if weights[k] <= cap:           # 整件装得下 → 整件装,扣容量
            b += values[k]; cap -= weights[k]
        else:                           # 装不下 → 按剩余容量比例拆(这就是“可拆”带来的松的上界)
            b += values[k] * cap / weights[k]
            break
    return b

def knap_bb():
    # 按性价比降序排列物品:先分支“单位价值高”的物品,上界收紧更快 → 剪枝更多
    order = sorted(range(n_items), key=lambda i: values[i] / weights[i], reverse=True)
    w = [weights[i] for i in order]
    v = [values[i] for i in order]
    best = 0; best_sel = None; nodes = 0; pruned = 0

    # 深度优先搜索解空间树:每个物品两个分支(装 / 不装)
    def dfs(pos, cap, cur, sel):
        nonlocal best, best_sel, nodes, pruned
        nodes += 1
        if cur > best:                  # 当前装法价值超过已知最优 → 更新下界与最优解
            best = cur; best_sel = sel.copy()
        if pos == n_items:              # 所有物品都决策完 → 回溯
            return
        if knap_ub(pos, cap, cur) <= best:   # 上界剪枝:后续就算全按分数装也超不过 best
            pruned += 1
            return
        if w[pos] <= cap:               # 分支 1:装第 pos 件(容量够才装)
            sel.append(order[pos])
            dfs(pos + 1, cap - w[pos], cur + v[pos], sel)
            sel.pop()
        dfs(pos + 1, cap, cur, sel)     # 分支 2:不装第 pos 件(容量不变)

    dfs(0, W, 0, [])
    return best, sorted(best_sel), nodes, pruned

best_k, sel_k, nk, pk = knap_bb()
print('背包 B&B:最优价值 %d,选中物品 %s,访问节点 %d,剪枝 %d' % (best_k, sel_k, nk, pk))

# ---------- 对照:动态规划(二维 0/1 背包,dp[cap] = 容量 cap 能装的最大价值) ----------
dp = np.zeros(W + 1, int)
for i in range(n_items):
    for cap in range(W, weights[i] - 1, -1):   # 从大到小遍历:保证每件物品只被用一次(01 背包)
        dp[cap] = max(dp[cap], dp[cap - weights[i]] + values[i])
print('DP 最优价值:', dp[W])
assert dp[W] == best_k
print('对照通过:背包 B&B == 背包 DP')
§2 分支定界细节(为什么能剪枝)¶
框架:维护子问题队列(原问题 + 一些整数界):
- 解当前子问题的 LP 松弛,得到上界 $\bar z$
- 剪枝三条件:松弛不可行 / 松弛解已整数可行(更新全局下界 $\underline z$)/ $\bar z \le \underline z$
- 否则选一个小数变量 $x_i$ 分支成两个子问题:$x_i \le \lfloor x_i^* \rfloor$、$x_i \ge \lceil x_i^* \rceil$
工程细节:
- 分支变量选择:最分数化 / 伪代价 / 强分支(节点数可差一个数量级)
- 节点选择:DFS(省内存、快出可行解)vs 最佳上界优先(剪枝更多)
- 初始下界:贪心可行解(背包 = 依次装性价比最高的物品)
- 大规模 → 交给求解器(分支切割 = B&B + 割平面)
复杂度:最坏指数($2^n$ 量级),实际取决于 LP 界松紧与分支策略;10-12 篇的启发式就是「时间不够时的近似替代」。
§2.1 手算:例题的分支定界全过程¶
用本讲例题 $\max\ 8x_1+5x_2$(约束 $x_1+x_2\le 6,\ 9x_1+5x_2\le 45$,整数)手推一次:
- 根节点(无整数界):松弛最优 $(3.75,2.25)$,值 $41.25$ → 上界 $41.25$,有分数 → 分支;
- 分支 1:$x_1\le 3$ → 松弛最优 $(3,3)$ 值 $39$——整数解!更新下界 $39$;
- 分支 2:$x_1\ge 4$ → 松弛最优 $(3.75,2.25)$ 附近受 $x_1\ge4$ 约束 → 解 $(4,1.8)$ 值 $41$,
有分数 → 继续分支 $x_2$;
- $x_2\le 1$:松弛解 $(4.44,1)$?验算:$9\cdot4.44+5=45$,值 $40.56$,分数 → 继续;
- $x_2\ge 2$:解 $(4,2)$?不满足 $9x_1+5x_2\le45$($46>45$)→ 不可行剪枝;
- 继续分裂直到所有节点被剪:最终整数最优 $(5,0)$ 值 $40$,且其它分支上界都 $\le 40$ → 剪枝完成。
手工验证要点(面试手撕就按这个节奏):
- 每轮先求子问题 LP 松弛(可心算 2 变量图解法);
- 松弛解整数 → 更新下界;松弛不可行 → 剪;
- 松弛上界 ≤ 当前下界 → 剪(这是唯一的全局终止判据)。
📌 练习建议:把上面树画成图(根→左/右→孙),标上每个节点的 (解, 上界, 状态), 自己走一遍直到确认最优——比读十遍文字有用。
§2.2 工程细节:分支策略、节点选择、初始解¶
B&B 的实践效果极大依赖策略选择(面试加分点):
1. 分支变量选择(选哪个分数变量分叉):
- 最分数化(most fractional):选离整数最远的 $x_i$(实现简单,效果平庸);
- 伪代价(pseudo-cost):用历史分支的界变化估计每个变量的收益,选「降界最多」的;
- 强分支(strong branching):对候选变量逐个「试分叉」比界,选最好的(每次多解几个 LP,但节点数可少一个数量级)——现代求解器核心技巧。
2. 节点选择(先处理哪个子问题):
- DFS:省内存、能快速找到可行整数解(更新下界)→ 背包手撕常用;
- 最佳上界优先(best-first):永远处理上界最高的节点 → 剪枝最多但可能一直不出可行解;
- 实际混合:先用 DFS 找好下界,再切 best-first。
3. 初始下界(启发式整数解):
- 贪心可行解(本讲背包:性价比降序装);
- 松弛解投影 + 局部搜索;
- 现代求解器的 rounding heuristics / local branching。
📌 记忆链:选好分支变量 → 少节点;先有好下界 → 多剪枝;两者配合 → 大规模可解。
§2.3 为什么有的 IP 好解有的难解:松弛强度的角色¶
B&B 效率的主宰其实是「LP 松弛的紧度」——松弛上界越接近整数最优,剪枝越狠。
对比同一定解的两个建模:
- 弱模型:松弛解严重偏离整数点(上界太松)→ 分支树爆炸;
- 强模型:加冗余约束(如更强的割/更好的大 M)使松弛多面体更贴近整数凸包 → 节点骤减。
经典例子(TSP):
- MTZ 子圈约束($O(n^2)$ 条)——模型小但松弛弱,大实例慢;
- DFJ 子圈消除(指数条,切割生成)——模型大但松弛强,是实际求解器的选择。
🧩 结论:建模质量决定求解难度。面试被问「为什么同一个问题换种建模快 100 倍」, 答案就是松弛强度(或者叫 LP 界强度)。 这也解释了为什么 13 篇的对偶/Lagrangian 松弛在组合优化里如此重要——它们是「找紧上界」的通用武器。
§3 割平面(Gomory)与 MILP 求解器¶
割平面思路:解 LP 松弛得小数顶点 → 加一条切割不等式,它:
- 切掉当前小数顶点(松弛最优不再可行)
- 不切掉任何整数可行点 重复直到松弛最优变整数。
Gomory 割:从最优单纯形表某行推导,对系数取整:$\sum_j \lfloor a_{ij}\rfloor x_j \le \lfloor b_i\rfloor$。 分支切割(branch-and-cut):B&B 每个节点都加割 → 现代 MILP 求解器(Gurobi / CPLEX / SCIP / CBC)标配。
求解器实践:建模语言 PuLP / OR-Tools / Pyomo;小规模可直接 scipy.optimize.milp(本讲对照用)。
常见坑:
- 弱 LP 界(松弛上界太松)→ 分支爆炸
- 大 M 取太大 → 数值病态;取「恰好够大」最好
- 对称解不打破 → 反复搜索等价节点
§3.1 Gomory 割手算(教材型例子)¶
用一维小例理解切割机制。设 LP 松弛最优表中某行是:
$$x_1 + 1.5\,x_2 = 3.5$$
整数化:把非整数系数拆成「整数部分 + 分数部分」($1.5 = 1 + 0.5$,$3.5 = 3 + 0.5$):
$$x_1 + x_2 + \underbrace{(0.5\,x_2 - 0.5)}_{\text{分数部分}} = 3 \ \Rightarrow\ 0.5\,x_2 - 0.5 \le 0 \ \Rightarrow\ x_2 \le 1$$
这条Gomory 割 $x_2\le 1$:当前松弛解($x_2=3.5$)被切掉,而所有整数可行解($x_2$ 为整数且该行成立)都保留。
为什么有效:整数解必须让 $x_1+1.5x_2$ 是整数;从整数解出发,分数部分之和要么是整数要么被取整掉—— Gomory 定理保证这样构造的不等式不切任何整数点,且有限步内收敛。
📌 一句话:割 = 从当前松弛表中「榨」出一条只切小数顶点、不切整数点的线性约束; 现代求解器把它织进每个 B&B 节点(branch-and-cut)。
§3.2 求解器实践:怎么用 Gurobi / OR-Tools / scipy¶
工程上没人手写 B&B。按规模选工具:
| 规模 | 工具 | 说明 |
|---|---|---|
| 教学/小规模 | scipy.optimize.milp |
本讲对照用,内置 HiGHS |
| 中型建模 | PuLP / OR-Tools / Pyomo | 声明式建模语言,接口友好 |
| 工业大规模 | Gurobi / CPLEX | 商用,branch-and-cut + 启发式 + 并行 |
建模-求解闭环(伪代码,任何工具都适用):
model = 建立模型(变量 / 目标 / 约束)
model.setObjective(...)            # 目标
model.addConstr(...)               # 约束(含大 M 线性化)
result = model.optimize()
if result.status == OPTIMAL: 取解;else: 分析不可行/无界
调试技巧:
- 先解 LP 松弛看目标值(上下界差距 = 模型松紧度);
- 不可行时找 IIS(不可约不可行子集)定位矛盾约束;
- 求解太慢 → 加割/加启发式初始解/打破对称。
💡 面试若问「你怎么验证 MILP 模型正确」:穷举小规模对比 + 松弛界合理性 + 与已知特例对齐。
§3.3 整数规划的应用场景(面试谈资)¶
IP/MILP 在工业界无处不在,聊应用能体现你「建模-求解」的全栈能力:
- 物流配送:车辆路径问题(VRP)——每辆车装多少、走哪条线(约束:容量、时间窗);
- 排班/排程:护士排班、车间调度——人/机器×班次的 0-1 指派(加休息、覆盖约束);
- 供应链:工厂选址 + 分配(是否建厂=0-1,产量=连续)→ 经典 MILP;
- 金融:组合优化的整数约束(最小交易手数、持仓上限);套利机会识别的 LP;
- 推荐/广告:广告位分配(预算受限的 0-1 规划)、拍卖中的胜者决定(winner determination)。
共性模式:结构变量(0-1 决策)+ 连续变量(量)+ 大 M 逻辑约束。 记住这个模式,任何新场景都能快速套:先问「有哪些是/否决策?有哪些量?哪些逻辑关系?」。
💡 面试加分表达:「这类问题我先写 MILP 拿上界和最优基准,大规模再换启发式(10-12 篇)或 column generation」——精确与近似两手都亮出来。
§3.4 手撕模板:10 分钟内解一道 IP 面试题¶
给一套「考试流程」,任何小规模 IP 题都能走:
- 建模(3 分钟):变量声明 + 目标 + 约束(含整数/0-1 约束、大 M 线性化);
- 松弛(2 分钟):手解 LP 松弛(2 变量画图/心算),得上界 $\bar z$;
- 找可行整数解(2 分钟):贪心/取整修正/看图,得下界 $\underline z$;
- 分支(3 分钟):选分数变量分两叉,逐节点重复 2-3,直到 $\bar z \le \underline z$;
- 汇报:最优解 + 最优值 + 剪了多少支(展示你对剪枝条件的理解)。
检查清单(交卷前自查):
- 每个子问题都标了(松弛解, 上界, 状态: 最优/整数/剪枝)
- 没有漏掉「松弛上界 ≤ 下界」剪枝
- 整数可行解确实可行(代入所有约束验证)
- 目标方向统一(max 问题用对偶/上界时别搞反符号)
📌 手撕 IP 题 = 建模 + 解 LP + 画树剪枝。练 3 道(背包、指派变体、2 变量整数 LP)即可覆盖所有考点。
§4 面试追问与自测¶
- 为什么不能对 LP 松弛解取整?(反例:本例 (4,2) 不可行)
- 分支定界的上界/下界分别怎么来?(max 问题:松弛 = 上界,可行整数 = 下界)
- 剪枝三条件是什么?背包 B&B 的上界为什么用分数背包贪心(可拆贪心 ≥ 整数最优)?
- 大 M 法怎么线性化「若 A 则 B」?MTZ 子圈消除的作用?
- 什么时候手撕 B&B、什么时候上求解器?(考试小规模手撕;工业直接求解器)
自测清单
- 把 0-1 背包 / 指派 / TSP 写成 IP 模型
- 手撕背包分支定界(上界=分数背包、深度优先、剪枝)
- 说明 LP 松弛界的方向(max:上界)
- 一句话讲清 Gomory 割与分支切割
- 复现本讲 B&B 与 scipy.optimize.milp 结果一致
💡 下节预告:IP 精确但指数级;时间不够用启发式——10 遗传算法。