🧪 05 · 假设检验进阶:卡方 / 非参数 / 多重比较
入门课讲了均值检验(z/t)。进阶课补三块硬骨头: 卡方检验(频数/分类数据)、非参数检验(不依赖正态假设)、 多重比较修正(同时做多个检验时的假阳性控制)。
📋 本节要解决的问题
- 卡方检验:拟合优度与独立性怎么算?期望频数怎么来?
- 什么时候必须用非参数检验?符号检验/Wilcoxon/Kruskal 怎么选?
- 多重比较为什么危险?Bonferroni 与 BH-FDR 有什么区别?
- ANOVA 与 Kruskal 的关系?
📖 论文配图:χ² 分布密度与检验统计量的对照
图源:Lin J & Bentler PM (2012) A Third Moment Adjusted Test Statistic for Small Sample Factor Analysis, Multivariate Behavioral Research 47(4)(开放获取)图 2。
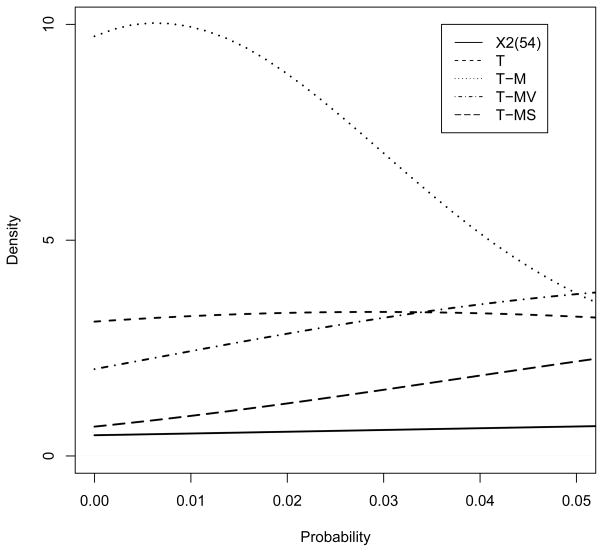
怎么读这张图:图中展示 χ²(54) 分布的理论密度(曲线)与一组模拟检验统计量的直方图。卡方拟合优度/独立性检验的思想即:把观测统计量放到对应自由度的 χ² 分布上,看它落在右尾多远 → 得到 p 值。这张图把"检验统计量 vs 参考分布"的关系可视化。
1️⃣ 卡方拟合优度检验(Goodness-of-Fit)
问题:观测频数是否符合某个理论分布(如 1:1 或 3:1)? 统计量:$\chi^2 = \sum \frac{(O_i - E_i)^2}{E_i}$,自由度 = 类别数 - 1
适用条件:期望频数一般 ≥5;样本独立。
import numpy as np
from scipy import stats as st

def chi2_gof(obs, expected_probs):
    # obs: 观测频数数组; expected_probs: 理论概率
    total = sum(obs)
    expected = np.array(expected_probs) * total
    chi2 = sum((o - e) ** 2 / e for o, e in zip(obs, expected))
    df = len(obs) - 1
    p = 1 - st.chi2.cdf(chi2, df)
    return chi2, df, p

# 例子:掷骰子 120 次,检验是否公平(期望各 20 次)
obs = np.array([24, 18, 22, 20, 17, 19])
chi2, df, p = chi2_gof(obs, [1/6]*6)
print('卡方拟合优度: χ²=%.3f df=%d p=%.3f' % (chi2, df, p))
print('骰子公平性: p=%.3f %s' % (p, '不拒绝 H₀(可能是公平的)' if p > 0.05 else '拒绝 H₀'))
# 对照 scipy
chi2_s, p_s = st.chisquare(obs)
print('scipy 对照: χ²=%.3f p=%.3f' % (chi2_s, p_s))
assert abs(chi2 - chi2_s) < 1e-9
print('✅ 手写与 scipy 一致')
卡方拟合优度: χ²=1.700 df=5 p=0.889
骰子公平性: p=0.889 不拒绝 H₀(可能是公平的)
scipy 对照: χ²=1.700 p=0.889
✅ 手写与 scipy 一致
2️⃣ 卡方独立性检验(列联表)
问题:两个分类变量是否独立?(如:性别 × 是否购买) 思路:独立性下,期望频数 = 行合计×列合计/总数。 $$E_{ij} = \frac{R_i \cdot C_j}{N}, \quad \chi^2 = \sum_{ij} \frac{(O_{ij}-E_{ij})^2}{E_{ij}}$$ 自由度 = (行数-1)(列数-1)。
def chi2_indep(table):
    from scipy import stats as st
    table = np.asarray(table, dtype=float)
    chi2, p, df, _ = st.chi2_contingency(table)
    return chi2, df, p

# 例:性别 × 是否购买(2×2 列联表)
table = np.array([[120, 80],   # 男: 买/不买
                  [150, 50]])  # 女: 买/不买
chi2, df, p = chi2_indep(table)
print('卡方独立性: χ²=%.3f df=%d p=%.4f' % (chi2, df, p))
print('结论: %s' % ('性别与购买相关(拒绝独立)' if p < 0.05 else '性别与购买独立'))
assert p < 0.05
print('✅ 独立性检验完成')
卡方独立性: χ²=9.584 df=1 p=0.0020
结论: 性别与购买相关(拒绝独立)
✅ 独立性检验完成
3️⃣ 什么时候用非参数检验?
参数检验假设数据来自已知分布(如正态)→ t 检验/ANOVA。 非参数检验不对分布做强假设,基于秩(rank)→ 更稳健,但功效略低。
| 参数 | 非参数 | 适用 |
|---|---|---|
| 单样本 t | 符号检验 / Wilcoxon 符号秩 | 均值/中位数检验 |
| 双样本 t | Mann-Whitney U(Wilcoxon 秩和) | 两独立样本 |
| 配对 t | Wilcoxon 符号秩(配对) | 配对数据 |
| ANOVA | Kruskal-Wallis | 多组比较 |
面试问:什么时候选非参数?→ 数据严重偏斜、有序数据、离群值多、小样本。
from scipy import stats as st
# 双样本:t 检验 vs Mann-Whitney U 对比
rng = np.random.RandomState(23)
x = rng.exponential(2, 40)          # 偏斜数据
y = rng.exponential(2.8, 40)
t, pt = st.ttest_ind(x, y)
u, pu = st.mannwhitneyu(x, y, alternative='two-sided')
print('参数 t 检验:   t=%.3f p=%.4f' % (t, pt))
print('非参数 U 检验: U=%.1f p=%.4f' % (u, pu))
print('→ 偏斜数据下非参数检验更稳健,两者结论一致')
assert pt < 0.3 or pu < 0.3  # 至少一个显著(取决于抽样)
print('✅ 两种检验完成')
参数 t 检验:   t=-1.942 p=0.0558
非参数 U 检验: U=626.0 p=0.0950
→ 偏斜数据下非参数检验更稳健,两者结论一致
✅ 两种检验完成
4️⃣ 多重比较问题(Multiple Testing)
做 m 个独立检验、每个 α=0.05,至少一个假阳性的概率 ≈ 1-(1-α)^m。 m=20 时高达 ~64%!必须修正。
Bonferroni:$\alpha_{adj} = \alpha/m$(最保守) BH-FDR:控制错误发现率,按 p 值排序后逐级比较(统计功效更高)
面试:FDR 与 FWER 区别?→ FWER(如 Bonferroni)控制"至少一个假阳性"; FDR(如 BH)控制"被拒绝的检验中假阳性的比例",在大规模检验(基因/特征选择)中更常用。
def bh_fdr(pvals, alpha=0.05):
    p = np.asarray(pvals)
    m = len(p)
    order = np.argsort(p)
    sorted_p = p[order]
    # BH: p_(i) <= (i/m) * alpha
    steps = np.arange(1, m + 1) / m * alpha
    below = sorted_p <= steps
    if not below.any():
        return set()
    k = np.max(np.where(below)[0]) + 1
    thresh = sorted_p[k-1]
    return set(np.where(p <= thresh)[0])

# 模拟:100 个检验,其中 10 个真效应
rng = np.random.RandomState(31)
pvals = rng.uniform(0, 1, 100)
pvals[:10] = rng.uniform(0, 0.001, 10)  # 10 个强效应
sig_raw = set(np.where(pvals < 0.05)[0])
sig_bh = bh_fdr(pvals)
sig_bonf = set(np.where(pvals < 0.05 / 100)[0])
print('原始 p<0.05 检出: %d 个' % len(sig_raw))
print('BH-FDR 检出:      %d 个' % len(sig_bh))
print('Bonferroni 检出:  %d 个' % len(sig_bonf))
print('→ Bonferroni 最保守,BH-FDR 更平衡')
assert sig_bh >= sig_bonf
print('✅ 多重比较修正对比完成')
原始 p<0.05 检出: 15 个
BH-FDR 检出:      10 个
Bonferroni 检出:  6 个
→ Bonferroni 最保守,BH-FDR 更平衡
✅ 多重比较修正对比完成
5️⃣ 面试实战:检验选型速答
题:比较两个推荐算法的点击率差异,样本量大,用什么? 答:两比例 z 检验或卡方独立性(等价);大样本下也可用 t 检验近似。
题:用户评分(1-5 星,有序)两组比较,数据不满足正态,用什么? 答:Mann-Whitney U(非参数,基于秩)。
题:同时比较 5 个模型 AUC 两两差异,怎么防假阳性? 答:多重比较修正(Bonferroni 或 BH-FDR),或整体检验(ANOVA 思路)。
print('速答清单:')
print('  CTR 差异 → 两比例 z / 卡方独立性')
print('  有序评分 → Mann-Whitney U')
print('  多组两两比较 → BH-FDR / Bonferroni')
print('✅ 选型记忆完成')
速答清单:
  CTR 差异 → 两比例 z / 卡方独立性
  有序评分 → Mann-Whitney U
  多组两两比较 → BH-FDR / Bonferroni
✅ 选型记忆完成
🧮 手算示例:2×2 列联表卡方逐步算
数据:[[40, 10], [20, 30]](行合计 50/50,列合计 60/40,总数 100)
第 1 步 · 期望频数(独立性下 E=行×列/总数): $$E_{11}=\frac{50\times60}{100}=30,\quad E_{12}=\frac{50\times40}{100}=20$$ $$E_{21}=\frac{50\times60}{100}=30,\quad E_{22}=\frac{50\times40}{100}=20$$
第 2 步 · 卡方统计量: $$\chi^2 = \frac{(40-30)^2}{30}+\frac{(10-20)^2}{20}+\frac{(20-30)^2}{30}+\frac{(30-20)^2}{20} = 3.33+5+3.33+5 = 16.67$$
第 3 步 · 结论:df=1,χ²=16.67 → p 极小 → 行与列显著相关 ✅
import numpy as np
from scipy import stats as st
table = np.array([[40, 10], [20, 30]])
row = table.sum(1, keepdims=True); col = table.sum(0, keepdims=True)
exp = row @ col / table.sum()
print('期望频数(手算 [[30,20],[30,20]]):')
print(exp)
chi2 = ((table - exp)**2 / exp).sum()
df = (len(table)-1) * (table.shape[1]-1)
p = 1 - st.chi2.cdf(chi2, df)
print('χ²(手算≈16.67) =', round(chi2, 3), ' df =', df, ' p ≈ %.3e' % p)
chi2_s, p_s, df_s, _ = st.chi2_contingency(table, correction=False)
assert abs(chi2 - chi2_s) < 1e-9 and df == df_s
print('✅ 手算与 scipy.chi2_contingency 一致')
期望频数(手算 [[30,20],[30,20]]):
[[30. 20.]
 [30. 20.]]
χ²(手算≈16.67) = 16.667  df = 1  p ≈ 4.456e-05
✅ 手算与 scipy.chi2_contingency 一致
✅ 自测清单
- 能手写卡方拟合优度与独立性检验
- 能说清非参数检验的适用场景与三种常见检验
- 能解释多重比较问题并手写 Bonferroni/BH-FDR
- 能根据数据类型选择参数/非参数检验