🖼️ 20-多模态大模型:CLIP / ViT / VLM / 扩散生成 / 评估
多模态(视觉语言、视频、音视频)是 2024-2025 大模型岗位的第一增量方向。 本模块覆盖多模态总览与 CLIP(InfoNCE)、图像编码(ViT)、视觉语言模型(BLIP/LLaVA)、 视频多模态与音视频、图文生成与扩散模型、跨模态检索与评估、面试八股,全部可执行、含断言与可视化。
面向秋招画像:多模态算法、大模型算法、图像/NLP 交叉方向、AIGC 应用 岗位。 前置衔接:03-深度学习(Transformer/Attention)、04-LLM 大模型(训练范式/评测)、 17-数据科学(评估指标)、19-推荐系统(向量检索/双塔)。
🖼️ 教学 notebook 全部基于 numpy/pandas/matplotlib/scipy/sklearn,自包含可执行, 含断言与数值对照;绘图统一中文字体并显式
plt.show()(无 GPU 依赖、可复现)。
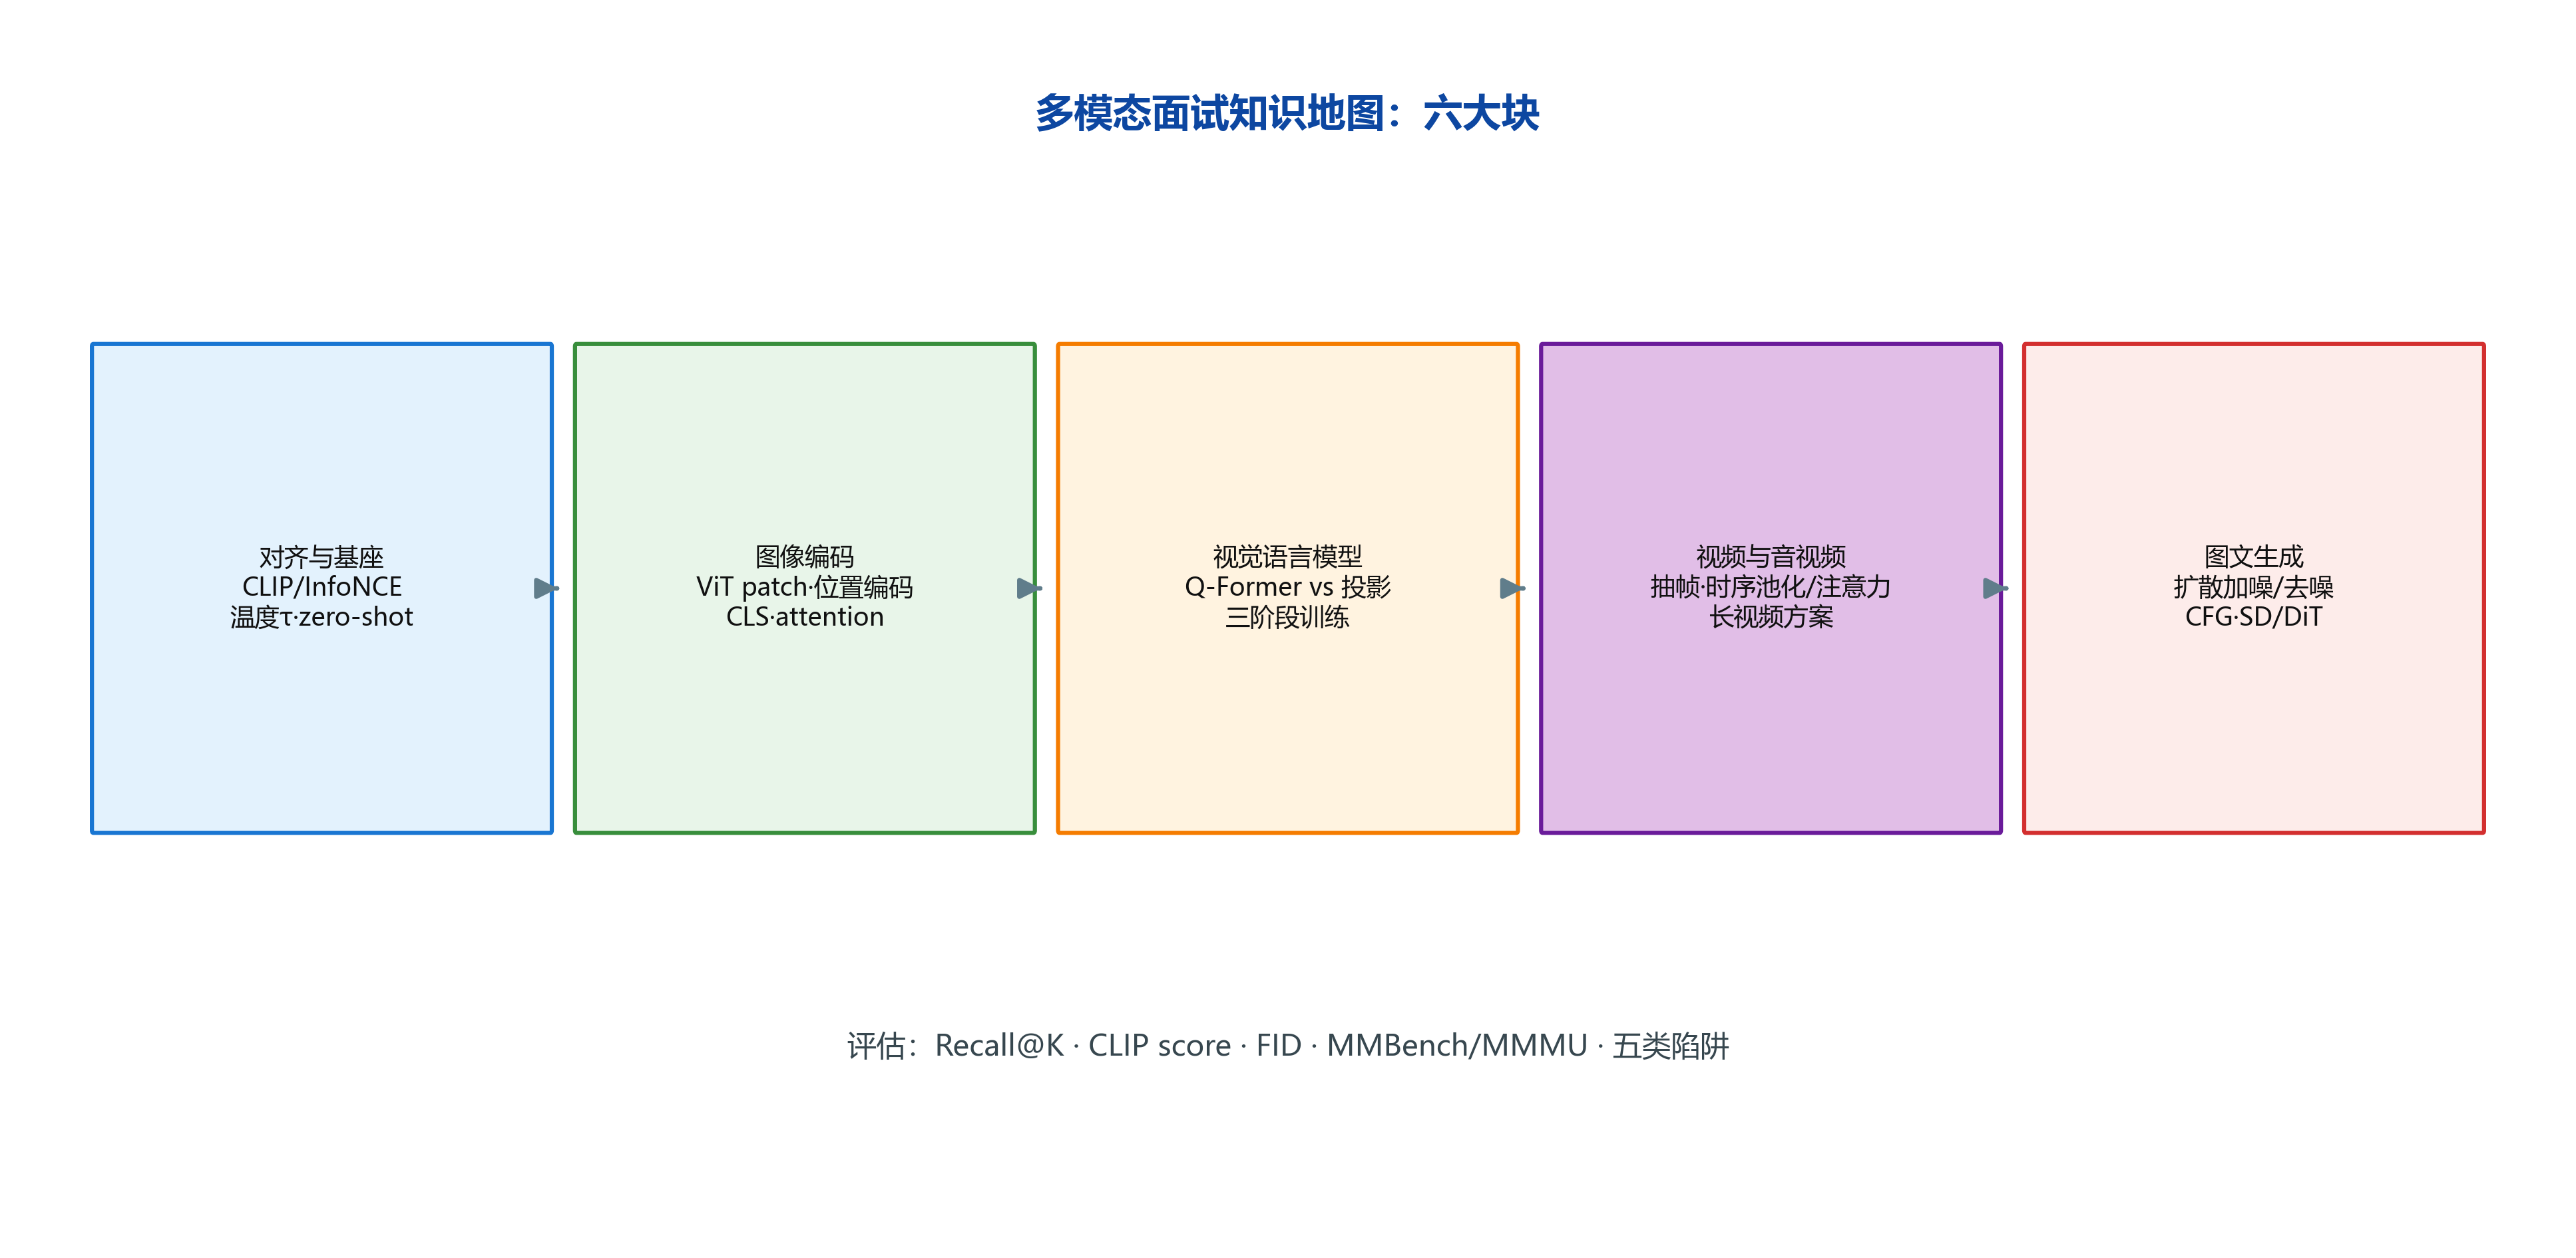
知识地图(面试考察的六大块)
多模态大模型考点
├── 1. 对齐与基座   CLIP/ALIGN · InfoNCE 对比学习 · 温度 τ · zero-shot 分类
├── 2. 图像编码     ViT(patch/位置编码/CLS/attention)· CNN vs ViT
├── 3. 视觉语言模型 对齐层 Q-Former vs 线性投影 · 三阶段训练 · BLIP-2/LLaVA/Qwen-VL
├── 4. 视频与音视频  抽帧/时序池化/时序注意力 · 音视频对齐 · 长视频方案
├── 5. 图文生成     扩散模型(前向/训练/采样 DDPM)· CFG · SD/DiT
└── 6. 评估与八股   图文检索 Recall@K · CLIP score · 评测基准 · 常见坑
学习路线(推荐顺序)
- 搭框架(00):多模态任务地图 + 手写 InfoNCE + zero-shot 分类思路 ✅
- 看懂"眼睛"(01):ViT 核心四步(patch/投影/位置编码/attention)+ CLS token ✅
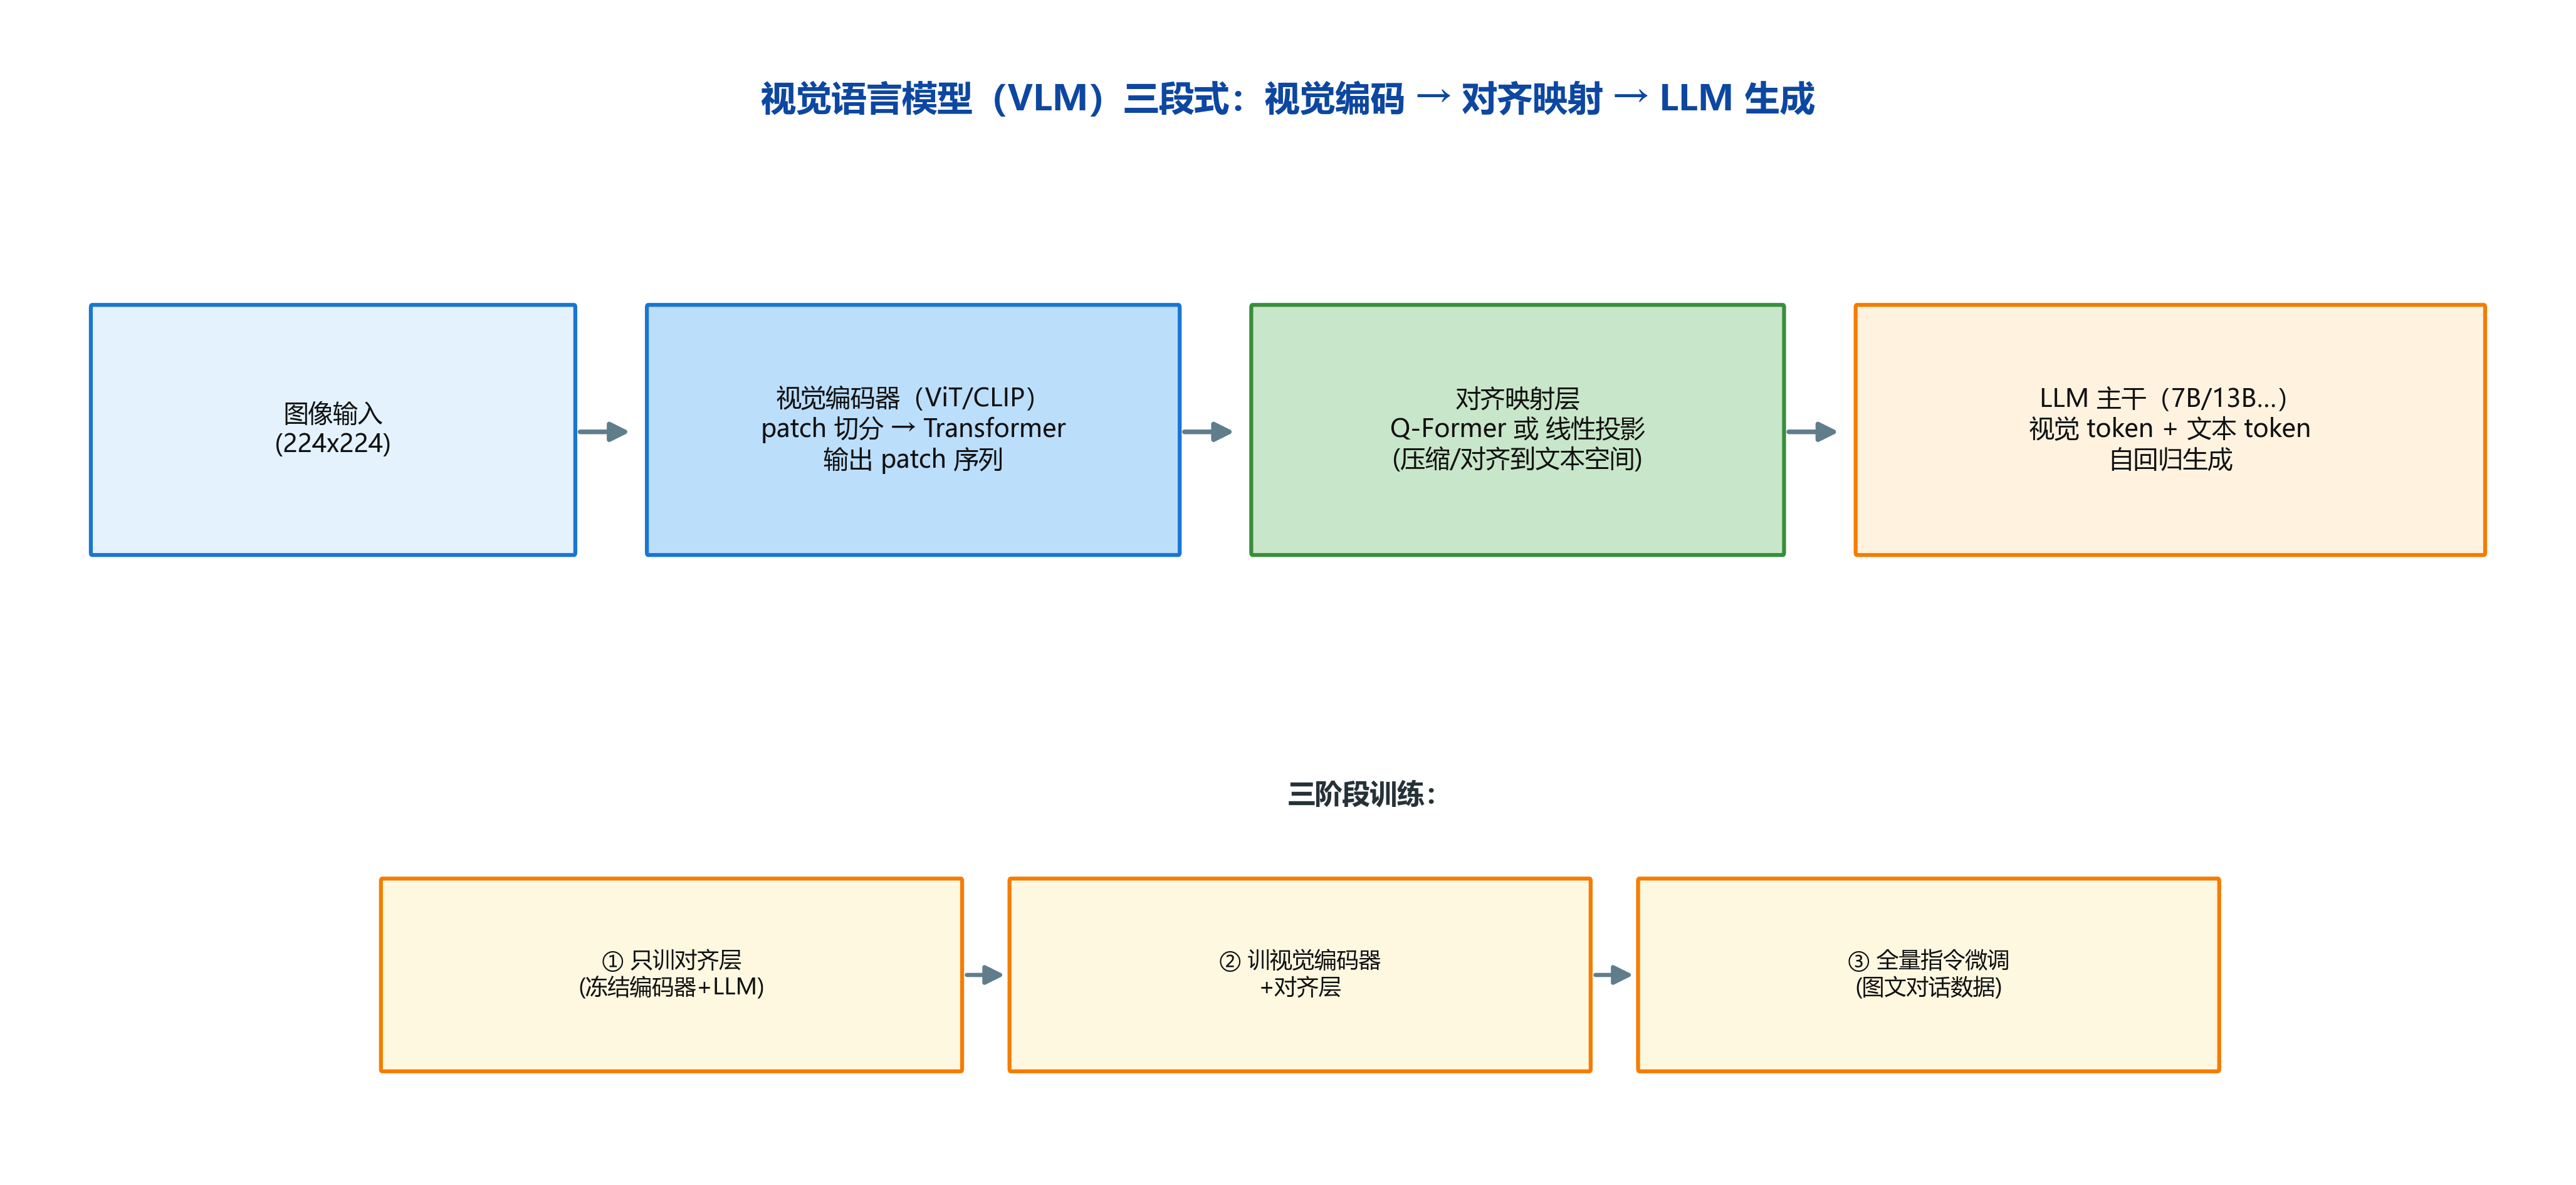
- 理解主战场(02):VLM 架构 → Q-Former vs 投影 → 三阶段训练 ↔ 对比 BLIP/LLaVA ✅
- 扩展能力域(03-04):视频三路线 + 音视频对齐;扩散模型加噪/去噪/CFG ✅
- 学会评估(05):图文检索 Recall@K、zero-shot 准确率、CLIP score、评测陷阱 ✅
- 冲刺(06):架构族谱 + 对齐四问 + 10 个常见坑 + 评测基准速答 ✅
教学 Notebook 索引(7 篇,全部通过 nbclient 执行验证)
| 笔记 | 核心手写/演示 | 状态 |
|---|---|---|
| 00-多模态大模型总览与CLIP | 任务地图、InfoNCE 损失手写、温度 τ 效果、zero-shot 分类、CLIP 五大局限 | ✅ |
| 01-图像编码与ViT | patch 切分 reshape、embedding+位置编码、自注意力手写、注意力热力图、CLS 分类头 | ✅ |
| 02-视觉语言模型BLIP与LLaVA | VLM 架构、Q-Former query 压缩、线性投影、三阶段训练、推理流程、BLIP vs LLaVA | ✅ |
| 03-视频多模态与音视频 | 视频三路线、帧采样与编码、时序池化/注意力对比+热力图、音视频对齐、长视频方案 | ✅ |
| 04-图文生成与扩散模型 | 前向加噪(q_sample)、噪声预测训练目标、DDPM 采样、CFG 公式、生成家族对比 | ✅ |
| 05-跨模态检索与评估 | 图文检索 Recall@K、噪声敏感性、zero-shot 分类准确率、CLIP score、评测五大陷阱 | ✅ |
| 06-多模态面试八股 | 架构族谱、对齐四问、训练数据与配比、10 个常见坑、评测基准速答 | ✅ |
🖼️ 图库:自绘高清流程图(300dpi · 教学/images/)
| 图 | 说明 | 用于 Notebook |
|---|---|---|
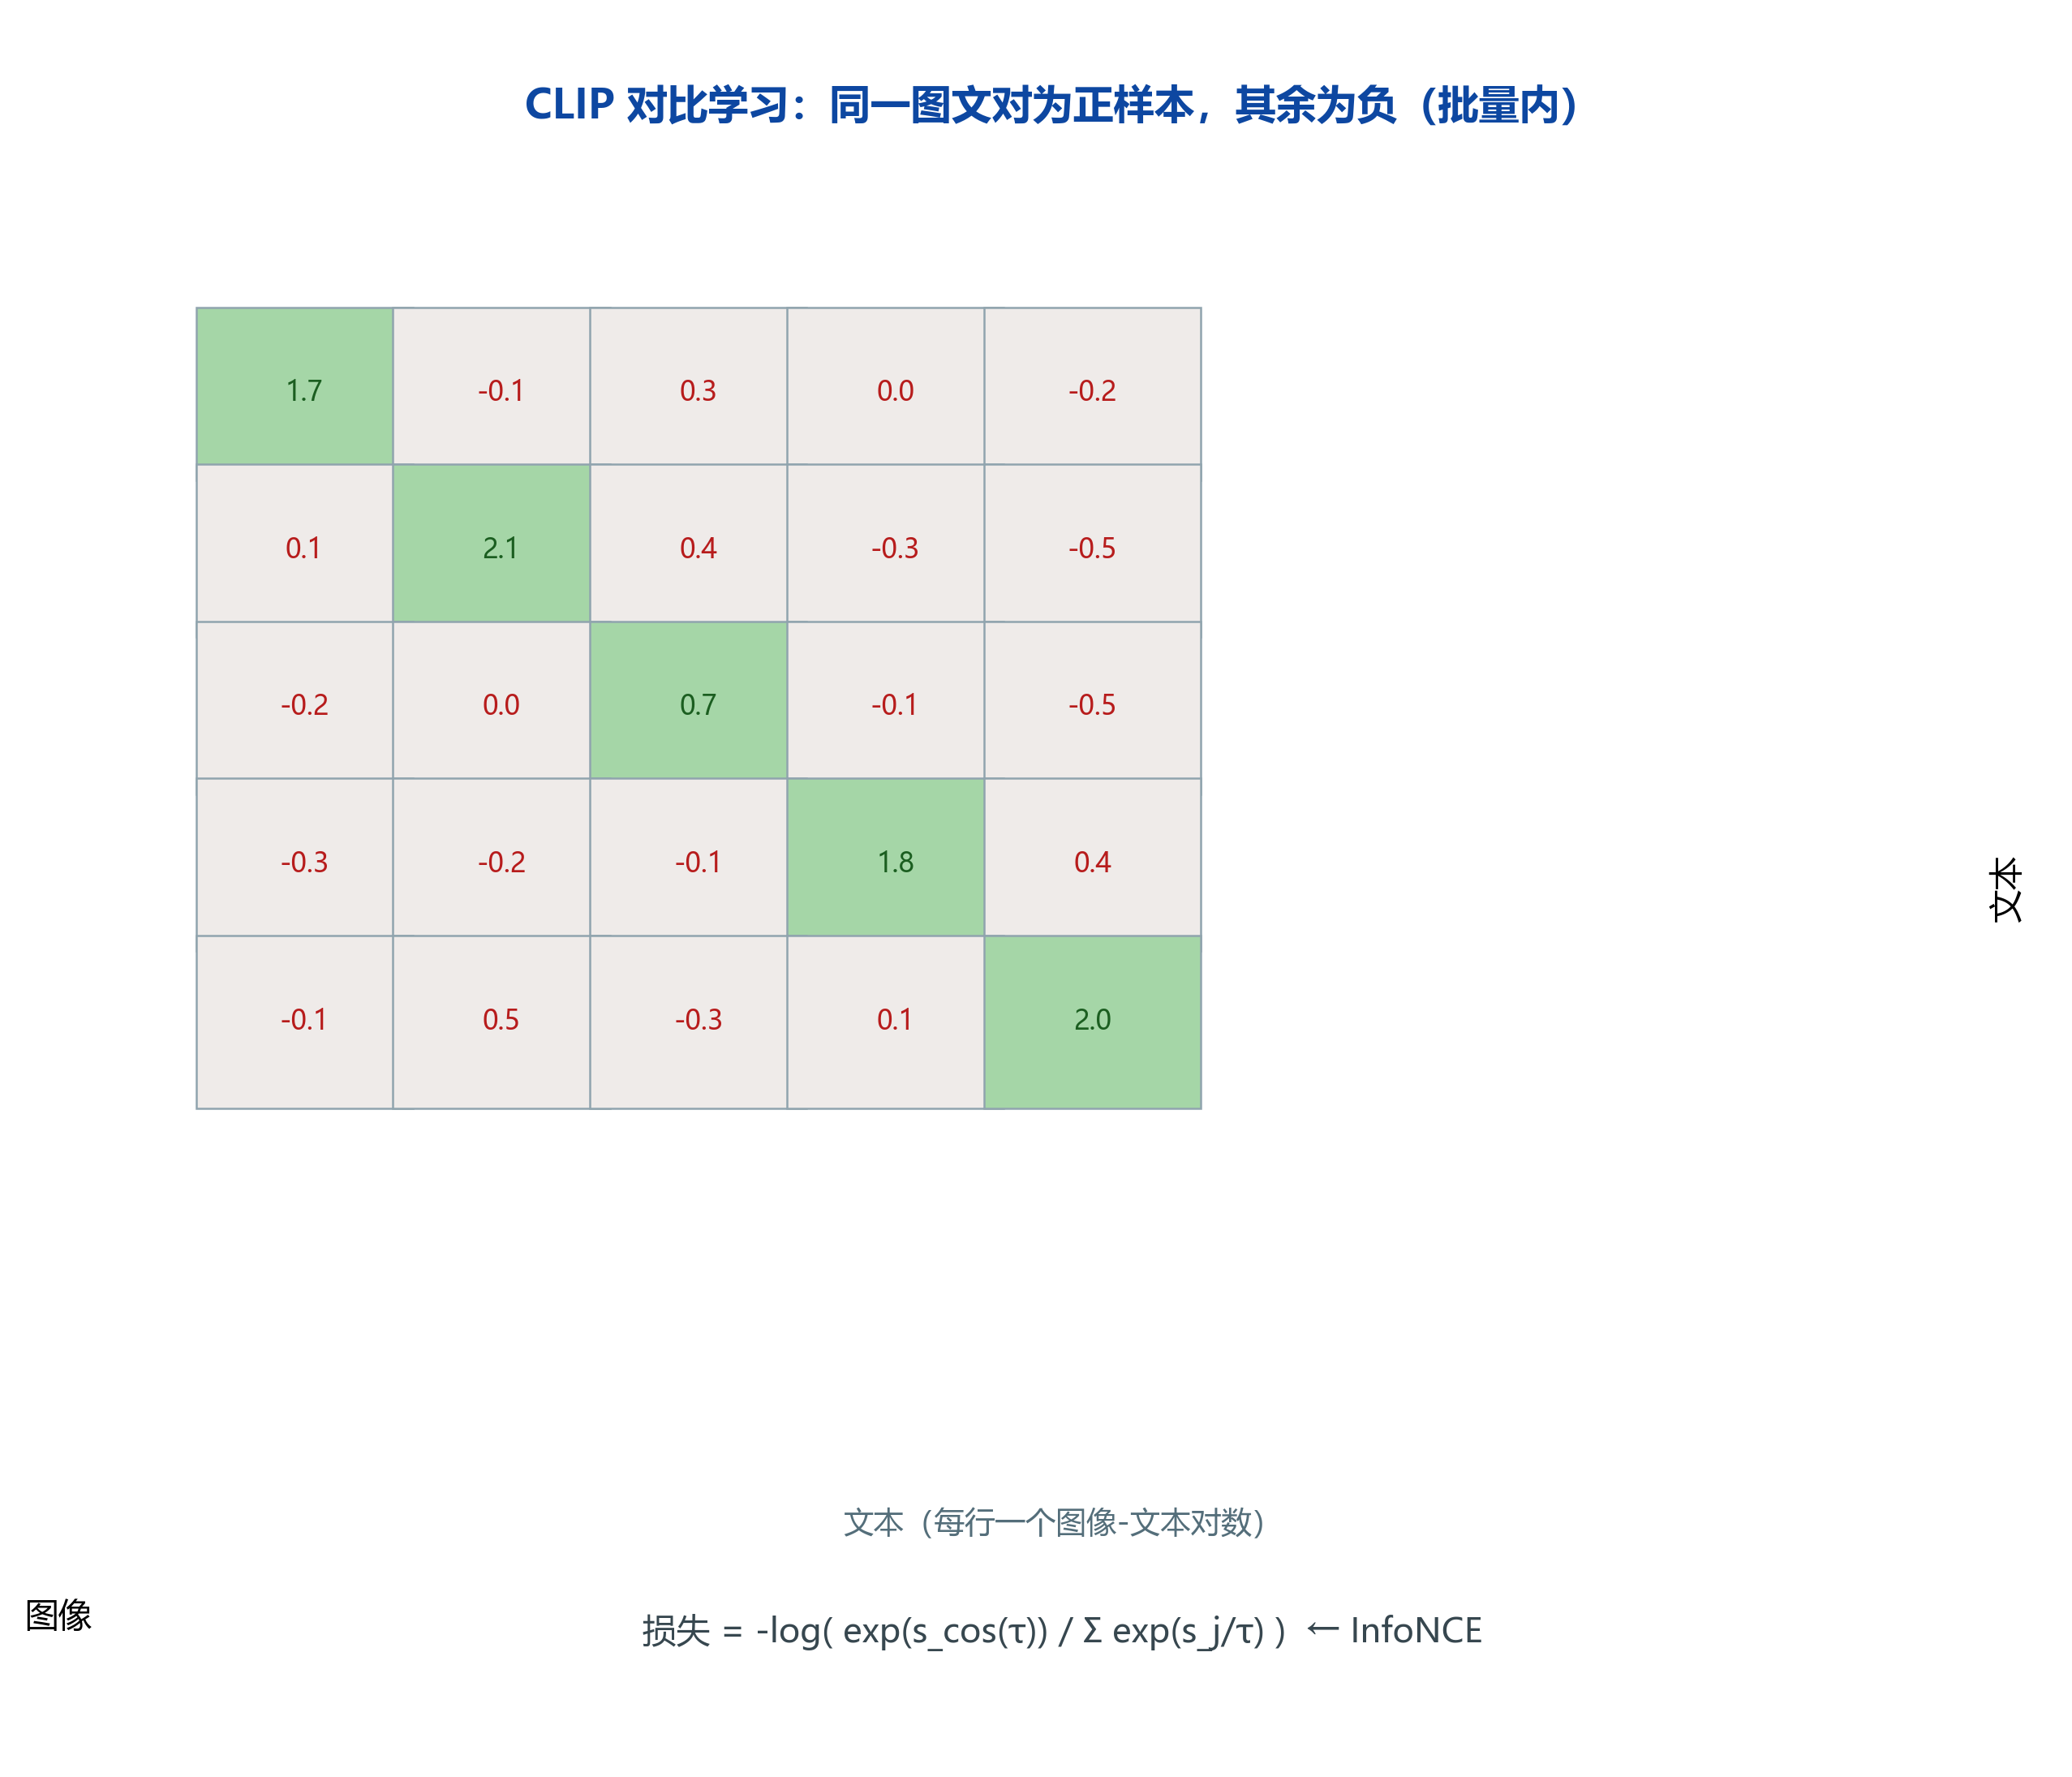
clip_contrastive.png |
CLIP 对比学习矩阵(InfoNCE:对角线正样本) | 00 |
vlm_architecture.png |
VLM 三段式架构(视觉编码→对齐映射→LLM 生成) | 02 |
mm_interview_map.png |
多模态面试知识地图(六大块闭环) | 06 |
📷 真实配图(Wikimedia Commons,已插入对应 notebook)
| 图 | 说明 | 用于 Notebook |
|---|---|---|
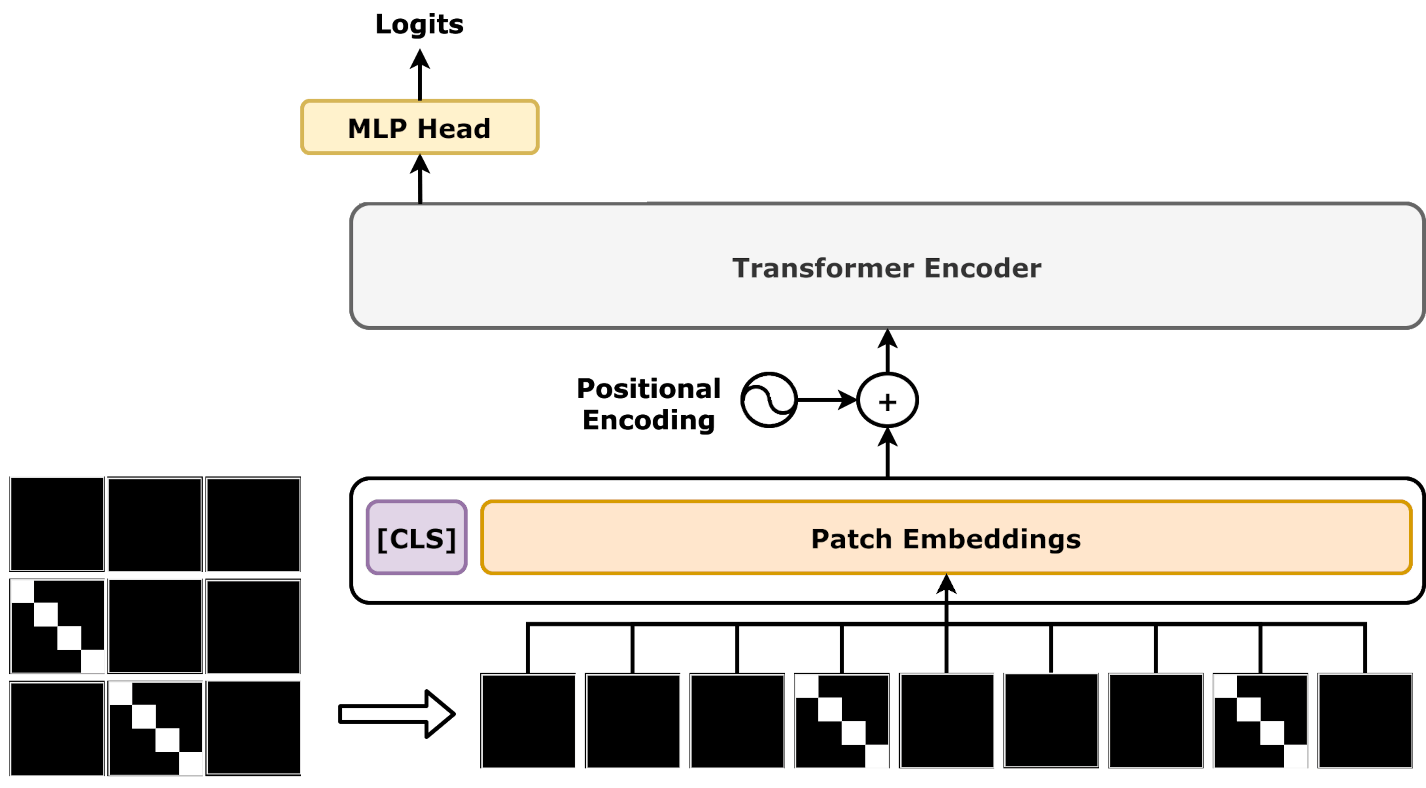
web_vision_transformer.png |
ViT 论文官方架构图(patch→投影→编码器→CLS) | 01 |
web_diffusion_example.png |
DDPM 去噪采样过程示例 | 04 |
web_diffusion_forward.png |
前向加噪过程示例 | 04 |
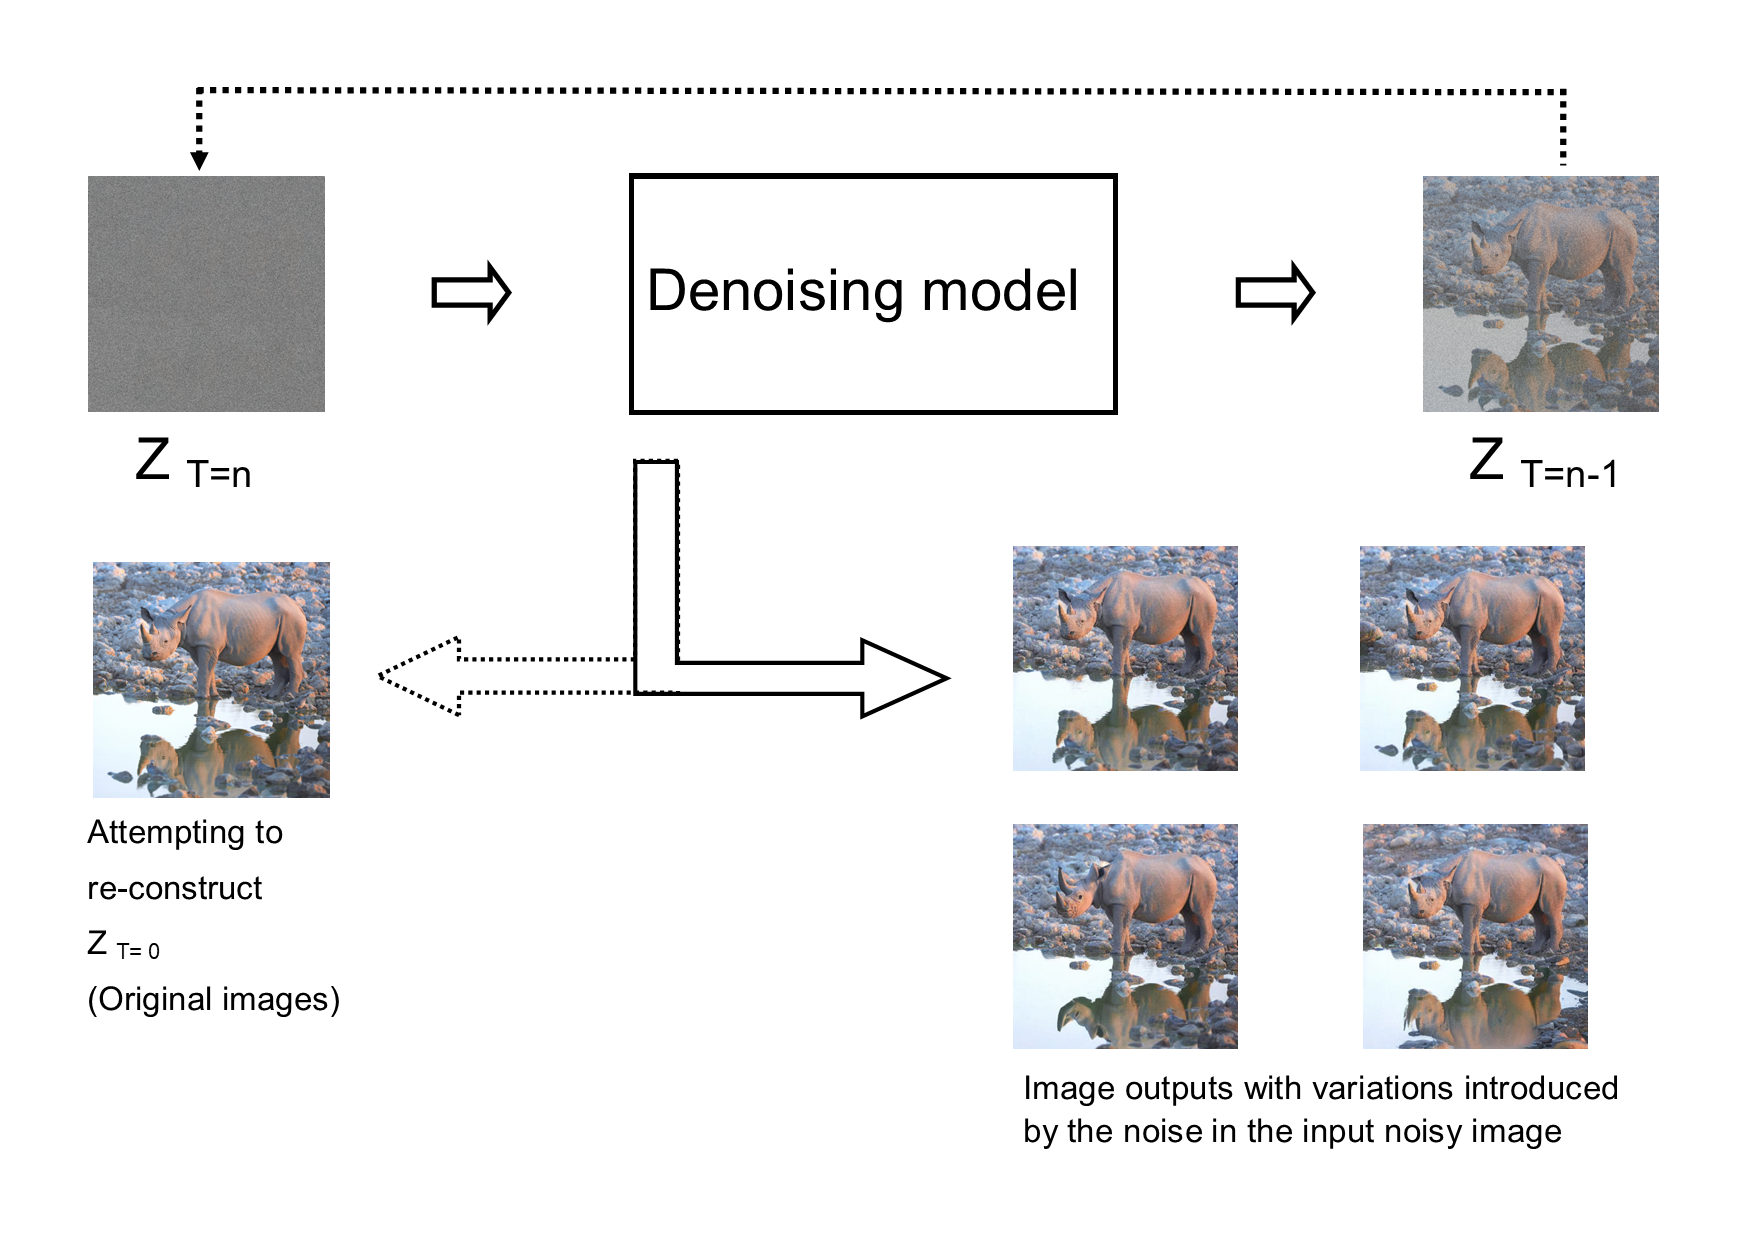
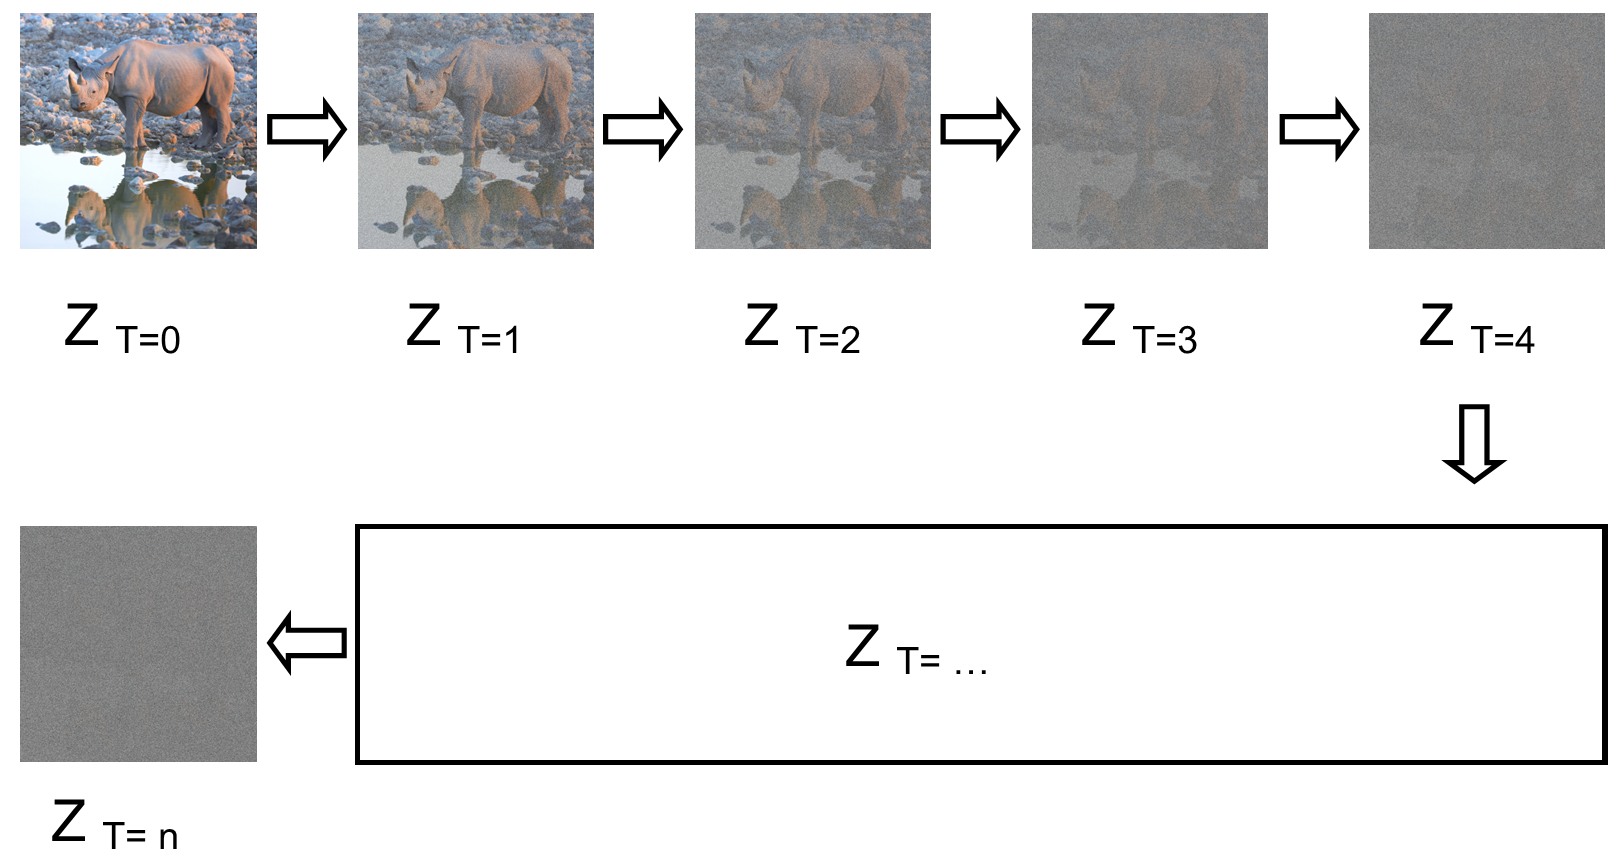
📄 经典论文原图(arXiv 论文原图,已插入对应 notebook 并标注出处)
| 图 | 论文出处 | 用于 Notebook |
|---|---|---|
paper_clip_arch.png |
Radford et al., CLIP, ICML 2021(arXiv:2103.00020)图1:图文对比预训练与零样本迁移 | 00 |
paper_blip2_arch.png |
Li et al., BLIP-2, ICML 2023(arXiv:2301.12597)图2:冻结编码器+冻结LLM+Q-Former 桥接 | 02 |
paper_llava_arch.png |
Liu et al., LLaVA (Visual Instruction Tuning), NeurIPS 2023(arXiv:2304.08485)图2:视觉塔+投影+LLM 两阶段 | 02 |
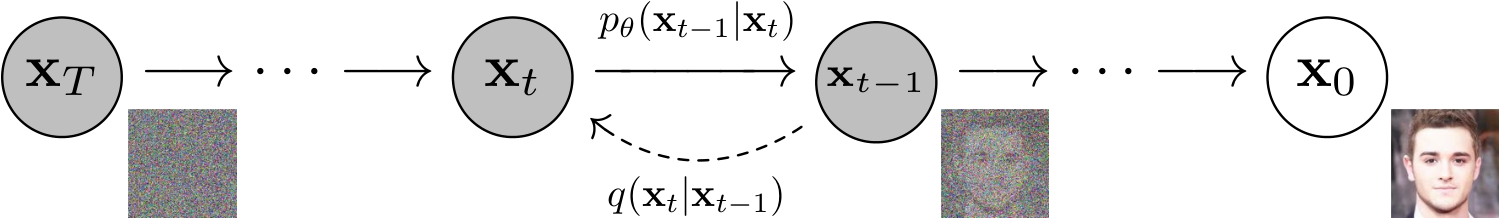
paper_ddpm_pgm.png |
Ho et al., DDPM, NeurIPS 2020(arXiv:2006.11239):前向加噪/反向去噪概率图模型 | 04 |
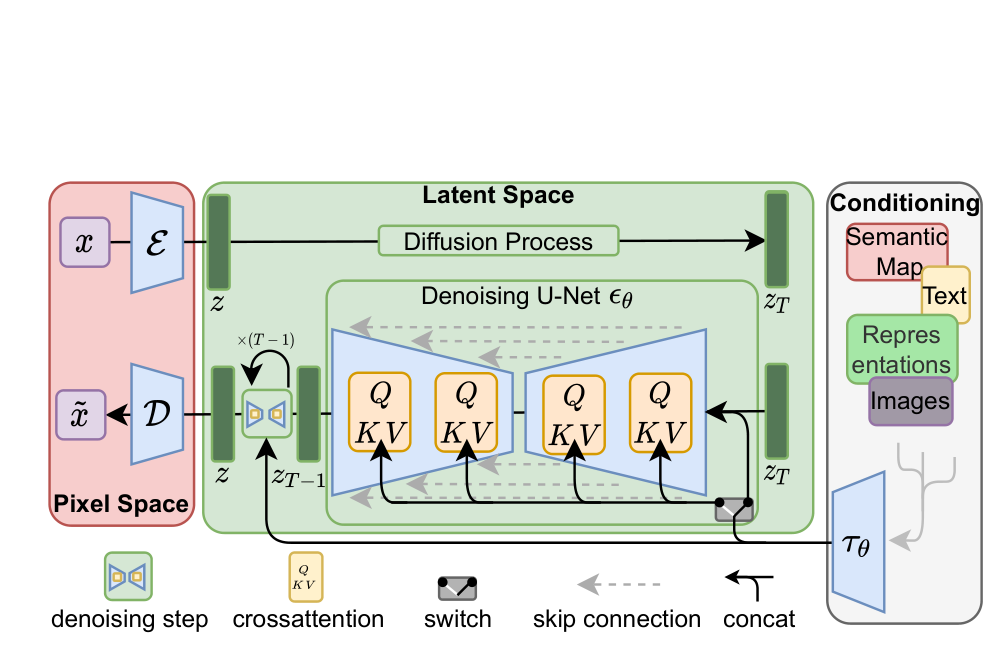
paper_ldm_arch.png |
Rombach et al., LDM, CVPR 2022(arXiv:2112.10752):潜在空间扩散 + 条件注入 | 04 |
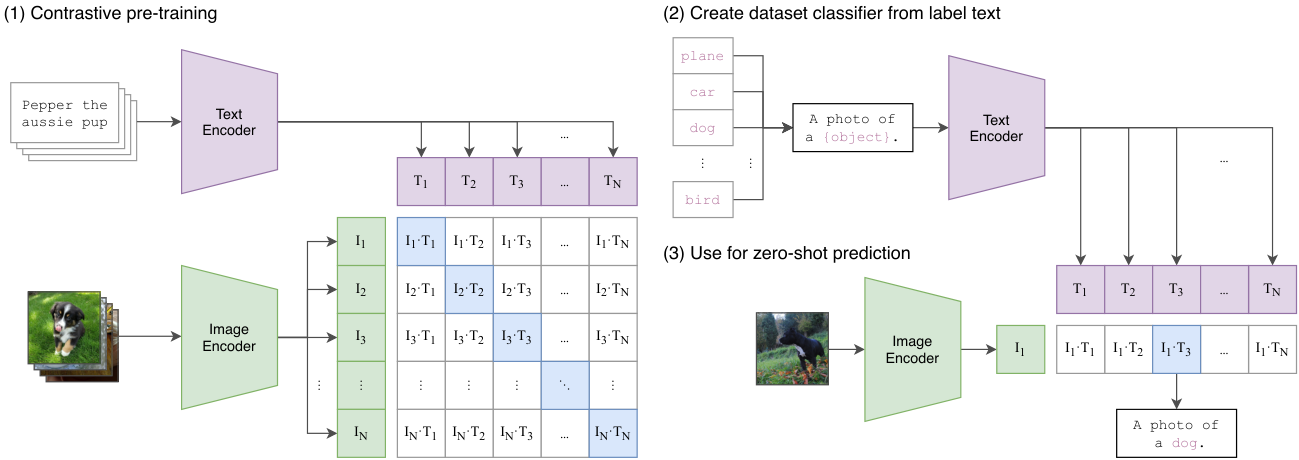
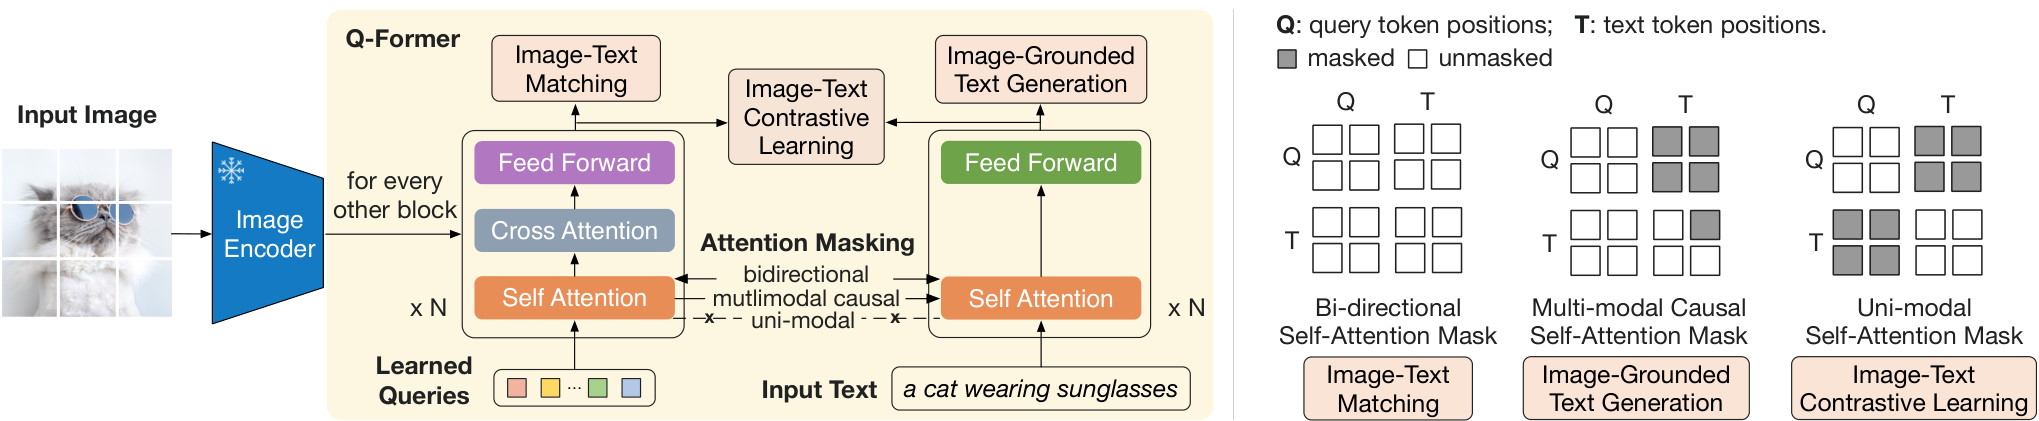
与其他章节衔接
| 本模块主题 | 前置章节 | 衔接说明 |
|---|---|---|
| Transformer / Attention | 03-深度学习 | ViT/VLM 的基础:self-attention、MLP、残差 |
| LLM 训练范式 / 指令微调 | 04-LLM大模型 | VLM 三阶段与 LLM SFT/RLHF 同源 |
| 向量检索 / 双塔 | 19-推荐系统 | CLIP embedding 检索与双塔召回同构 |
| 评估指标 / 实验设计 | 17-数据科学 | 多模态评测的统计与人工评估方法 |
| 图像分类 / CNN 基础 | 02-机器学习 | 卷积/全连接等底层表示基础 |
| RAG 与多模态检索 | 04-LLM大模型 07-RAG | 多模态 RAG:图像检索 + 生成 |
面试高频题型(详见 高频面试题.md)
- 对齐类:InfoNCE 公式与推导、温度 τ 的作用、CLIP 为什么能 zero-shot、对比学习的正负样本
- 架构类:ViT 流程、CNN vs ViT、Q-Former 是什么、LLaVA 投影层、视觉 token 数量权衡
- 训练类:三阶段训练、为什么冻结、视觉编码器选择(CLIP ViT vs 通用 ViT)、数据配比
- 生成类:扩散前向/反向公式、训练目标、CFG 采样、SD 在潜空间扩散、DiT
- 视频类:帧采样、时间池化 vs 时序注意力、长视频 token 爆炸、音视频对齐
- 评估类:检索 Recall@K、CLIP score、FID、MMBench/MMMU、评测五大陷阱
验收标准
- [ ] 能默写 InfoNCE 损失并解释温度 τ 的作用
- [ ] 能手写 ViT 四步(patch/投影/位置编码/attention)并解释 CLS token
- [ ] 能画出 VLM 架构并对比 Q-Former 与线性投影两条路线
- [ ] 能背出三阶段训练范式与"为什么冻结"的答案
- [ ] 能手写扩散前向加噪、讲清训练目标与 DDPM 采样、解释 CFG
- [ ] 能说出视频建模三条路线与长视频处理方案
- [ ] 能手写图文检索 Recall@K 并解释 CLIP score 与 FID
- [ ] 能背出理解/检索/生成/中文四大类评测基准
- [ ] 能答 10 个多模态常见坑(token 多、分辨率、OCR、幻觉、多语言等)