📚 10-04 · Attention 与 Transformer
目标:从「为什么 RNN 不够用」出发,一步步推导出缩放点积注意力与多头注意力,手写实现并逐一与 torch 对照(误差 <1e-5),再理解 Encoder/Decoder 结构、因果掩码、位置编码与 KV cache,最后用 mini-Transformer 学「倒序」 完成一个小训练实验(准确率 >0.95)。
📍 主线位置:03-RNN与LSTM(RNN 的串行瓶颈与梯度问题) → 04-Attention与Transformer(本篇) → 05-预训练模型(把 Transformer 放大成 BERT/GPT,讲清预训练-微调范式)。
🧩 生活化类比:注意力 = 阅读时划重点——每个词都回头问别的词「你跟我有什么关系?」,关系近的(Q·K 点积大)重点吸收。Transformer = 一堆这样的「重点划书人」(多头)同时开工,再配一个前馈网络做深度加工,最后用残差连接保证「老知识不丢失」。
核心概念
(a) 🗂️ 从「串行搬运」到「全体互联」:Attention 与 Transformer
RNN 串行慢、长依赖被压成固定向量,注意力让每个词直接「环顾全句」、按相关性加权汇总。本篇从 Q/K/V 三要素推出缩放点积注意力,再拼装多头、位置编码、Encoder/Decoder(因果掩码、KV cache),最后用 mini-Transformer 学倒序验证「结构即能力」。
flowchart TB
    Node1["🚧 RNN 的两大瓶颈"]
    Node2["🗝️ Q / K / V 三要素"]
    Node3["⚖️ 缩放点积注意力"]
    Node4["👁️ Self-Attention"]
    Node5["👥 多头注意力"]
    Node6["📍 位置编码"]
    Node7["🧱 Encoder 完整结构"]
    Node8["🔒 Decoder:因果掩码 + KV cache"]
    Node9["🧪 mini-Transformer 学倒序"]
    Node1 --> Node2
    Node2 --> Node3
    Node3 --> Node4
    Node4 --> Node5
    Node5 --> Node7
    Node6 --> Node7
    Node7 --> Node8
    Node8 --> Node9
    Node3 -->|复杂度 O(T²)| Node9
- RNN 的两大瓶颈:长距离依赖——信息从位置 i 传到 j 要经过漫长的串行路径,还只能压缩进一个固定向量;串行计算——h_t 必须等 h_{t-1},长序列训练极慢。注意力就是来治这两个病的。
- Q/K/V 三要素:Query 是「你要找什么」,Key 是「候选的标签」,Value 是「候选的内容」。查词典时你带 query 扫每个词条的 key 匹配,取回匹配项的 value——注意力就是这个过程的向量版。
- 缩放点积注意力:打分 = Q·Kᵀ/√d_k,权重 = softmax(打分),输出 = 权重加权求和 V。除以 √d_k 是因为点积方差随维度变大,不缩放会让 softmax 进入饱和区、梯度消失。
- Self-Attention:Q、K、V 全部来自同一个序列的线性投影,每个词「环顾全句」直接计算跟所有词的相关性。对比 RNN/CNN:感受野全场、信息路径最短、可以完全并行。
- 多头注意力:一个打分空间只能学一种「关系」,多头让 h 个专家并行,各学各的(语法、指代、位置关系),最后拼接再过一次输出投影融合——单头也能工作,多头是容量与并行性的提升。
- 位置编码:注意力是集合运算,把 token 打乱重排结果不变,「猫追老鼠」和「老鼠追猫」会看成同一句。正弦/余弦位置编码给每个位置注入坐标,还能外推到训练长度之外。
- Encoder 完整结构:多头自注意力 + 前馈 FFN,每个都带残差连接和 LayerNorm,N 层堆叠。输入经过词嵌入 + 位置编码,输出是每个 token 的上下文表示。
- Decoder:因果掩码 + KV cache:自回归生成不能偷看未来,打分矩阵加下三角掩码把「未来」置 -inf;推理时旧 token 的 K、V 算过就不再变,缓存起来每步只算新 token,计算量大幅下降。
- mini-Transformer 学倒序:输入数字序列要求输出倒序,模型必须学会「位置 p 的输出 = 对侧位置 L-1-p 的输入」——靠的是位置编码与注意力,证明结构决定能力。局限是自注意力 O(T²),引出稀疏注意力、长序列模型的演进线。
0. 主线地图:本篇怎么走
RNN 的串行瓶颈 ──────→ 注意力机制(Q/K/V 三要素)──→ 缩放点积公式与 √d_k
       │                                                    │
       ▼                                                    ▼
Self-Attention(句内交互、O(T²d))             手写 vs torch 对照(实验 1)
       │
       ├──→ 多头注意力(h 个子空间、拼接口算)──→ 手写 vs torch 对照(实验 2)
       │
       ├──→ 位置编码(sin/cos、相对位置性质、与 learned 对比)
       │
       └──→ Encoder(MHA+FFN+残差+LayerNorm)──→ Decoder(因果掩码+cross-attn+KV cache)
                     │
                     └──→ mini-Transformer 学「倒序」(实验 3)──→ 局限与演进(FlashAttention 等)
每个子主题按固定节奏推进:直觉 → 公式推导 → 手写实现 → 库对照 → 数字口算 → 面试题。以「为什么」开头,以「局限」收尾——注意力能解决 RNN 的什么问题、它自己又留下了什么新问题($O(T^2)$),这是本篇的主线。
1. 为什么需要 Attention:RNN 的长距离瓶颈与串行之痛
1.1 RNN 的两个硬伤
上一个专题(03-RNN与LSTM)里我们反复用一个隐藏状态 $h_t$ 逐步「搬运」信息。它有两个天然缺陷,也正是注意力要解决的对象:
① 长距离依赖(long-range dependency):信息要从位置 $i$ 传到位置 $j$,必须经过 $j-i$ 次递推和连乘。回顾 03 篇的梯度分析,$\|W_{hh}^n\|$ 的特征值要么指数爆炸要么指数衰减——远端词对当前词的影响被指数级稀释。举例:
- 句子「我在北京上学,所以我说普通话」中,「普通话」依赖远在第 6 个词位置的「北京」。对 RNN 来说,这段距离要穿过 6 次非线性压缩,几乎不可能学牢;
- 长文档(段落级指代、篇章主题)更是如此——信息「传着传着就丢了」。
② 串行计算(sequential bottleneck):$h_t$ 的计算依赖 $h_{t-1}$,所以 $T$ 个词必须一个接一个地算,无法并行。GPU 上算力再强也只能干等:计算复杂度是 $O(T)$,墙钟时间也是 $O(T)$。序列越长,这个「排队」的问题越致命。
1.2 Attention 的破局思路:一步到位,直接访问
注意力的核心思想只有一句话:我不需要你传话,我直接看。
- 任意两个位置之间建立直接连接:路径长度恒为 1,长距离依赖问题从结构上消失(对应第一个硬伤);
- 所有位置的打分并行计算:注意力在数学上是矩阵乘法($QK^\top$、$\cdot V$),可以一次性批量完成,GPU 的并行能力被完全利用(对应第二个硬伤);
- 看谁、看多少由数据学出来的权重决定:不是固定窗口(n-gram 的局限),也不是「把整句压成一个向量再展开」(seq2seq 第一个版本的局限),而是逐对自动加权。
✅ 为什么需要它(一页纸):Attention 用「全连接 + 可学习权重」换掉 RNN 的「串行递推」,换来长依赖直接可达与完全并行两大优势。
⚠️ 局限与代价:任何两个位置都要两两打分,复杂度从 RNN 的 $O(T)$ 涨到 $O(T^2)$。这笔账不便宜——它是后面稀疏注意力、FlashAttention 等一切演进的原动力(第 10 节展开)。
1.5 前传:注意力机制是怎样被发明的(历史故事)
今天的我们觉得「让模型自由地看全句」天经地义,但这条路走了整整三个台阶:
① 2014 年,Seq2Seq 撞上「固定上下文向量」瓶颈。Sutskever 等人的机器翻译模型把整个源句压成一个定长向量 $c$,Decoder 每一步都只看这同一个 $c$。句子一长,$c$ 就成了「信息漏斗」——开头与结尾的信息互相挤压,长句翻译质量断崖式下跌。这是 RNN 序列建模的「最后一公里」问题:递推丢信息也就算了,连汇总都只能靠一个向量。
② 2015 年,Bahdanau 提出「注意力」这个词。核心改动只有一行:Decoder 第 $t$ 步不再看同一个 $c$,而是每一步重新算一个 $c_t$——对源句所有隐状态 $h_s$ 按相关性加权求和:$c_t=\sum_s \alpha_{ts}h_s$,权重 $\alpha_{ts}$ 由一个小网络算出(加性注意力)。人读长句时目光会移动,模型也学会了「生成第 $t$ 个词时重点看源句的哪几个词」,机器翻译在长句上全面翻盘,也第一次把「对齐(alignment)」思想带进深度学习。
③ 2015 年,Luong 简化打分函数:用点积/双线性打分替代加性打分,更快更省,并区分 global/local attention。2017 年《Attention Is All You Need》把以上元素收编、去掉 RNN、让注意力自己当主角——这是本篇故事的起点。
2. Q / K / V 三要素:从「字典查找」的直觉开始
2.1 你查词典时,脑子里发生了什么
想象在词典里查单词 "query":
- 你脑子里带着一个查询(Query):「我要找一个表达『提问、询问』意思的词」;
- 词典里每一个条目都有一段键(Key)——词头、词性、音标。你快速扫过,把查询与每个键做匹配;
- 匹配度高的条目被「打开细看」,取出它的值(Value)——释义、例句、用法;
- 最后你得到的不是某一个条目,而是若干条目的加权混合(可能「question」的解释占 60%、「inquiry」的占 30%……)。
注意力机制就是把上面这四步写成数学:
$$\text{Attention}(Q,K,V)=\text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)V$$
| 符号 | 角色 | 词典类比 |
|---|---|---|
| $Q$(Query) | 我在找什么 | 你脑子里的查询词 |
| $K$(Key) | 别人是什么 | 词典条目的词头 |
| $V$(Value) | 别人提供什么 | 条目正文(释义例句) |
| $QK^\top$ | 查询与所有键的匹配分 | 扫一眼的匹配程度 |
| $\text{softmax}$ | 匹配分 → 概率式权重 | 决定重点看哪几条 |
| $\sum_i w_i V_i$ | 按权重混合内容 | 综合多条释义取精华 |
🔑 核心直觉(背下来):$QK^\top$ 是打分,$V$ 是取内容。打分决定内容以什么比例混合。打分函数不只点积一种(加性注意力等),但点积 + 缩放是工程上的最优解(快、可并行、好求导)。
2.2 一个 2×2 的手算例子(口算训练)
设只有两个词,$d_k=2$:
$$Q=\begin{bmatrix}1&0\\0&1\end{bmatrix},\quad K=\begin{bmatrix}1&0\\0.5&0.5\end{bmatrix},\quad V=\begin{bmatrix}10&20\\30&40\end{bmatrix}$$
第 1 步,打分矩阵 $S=QK^\top$:
$$S=\begin{bmatrix}1\cdot1+0\cdot0.5 & 1\cdot0+0\cdot0.5\\ 0\cdot1+1\cdot0.5 & 0\cdot0+1\cdot0.5\end{bmatrix}=\begin{bmatrix}1&0.5\\0&0.5\end{bmatrix}$$
第 2 步,除以 $\sqrt{d_k}=\sqrt2\approx1.41$ 并逐行 softmax:
$$\frac{S}{\sqrt2}\approx\begin{bmatrix}0.71&0.35\\0&0.35\end{bmatrix}\ \xrightarrow{\ \text{softmax}\ }\ W\approx\begin{bmatrix}0.59&0.41\\0.41&0.59\end{bmatrix}$$
第 3 步,$O=W\cdot V$(口算第一行):$0.59\times[10,20]+0.41\times[30,40]=[18.25,\,28.25]$。它介于 $V_1=[10,20]$ 与 $V_2=[30,40]$ 之间,且更靠近 $V_1$——因为第 0 个查询和第 0 个键匹配分更高(自己最像自己)。第二行输出 $[21.75,\,31.75]$ 同理。
✔️ 手算要点:先打分、再归一、最后加权——三步缺一不可;softmax 保证权重非负且和为 1(「重点占比」语义)。
2.3 检索直觉再深化:一次「招聘」的完整流程
把 Q/K/V 想成一次招聘,直觉会更立体:
- Query = 岗位需求(「我们需要一个会 Python 的工程师」);
- Key = 候选人的简历标签(「5 年 Python」「3 年前端」「应届生」);
- Value = 候选人的完整能力(简历正文);
- $Q\cdot K$ = 需求与标签的匹配分;softmax 后匹配分的相对差距决定候选人被采信多少;最终输出 = 所有候选人能力的加权混合。
三个容易忽略的细节:
- 价与键分离:同一个候选人可以被「高匹配分选中」却只提供很小一部分内容(Key 与 Value 是两个独立投影,不必绑死)——模型因此获得「关注谁」和「取什么」分别调参的自由;
- 输出维度 = Value 维度:$O=(T\times T)(T\times d_v)\to(T\times d_v)$,输出行的维度是 $d_v$ 而不是别的——口算维度时最容易错的就是这里;
- 为什么点积能当打分函数:除了快,点积还给「方向一致」天然加分;加性注意力(Bahdanau)表达力等价但参数更多、更慢。工程上「点积 + 缩放」胜出,直到今天仍是事实标准。
3. 缩放点积注意力:公式是怎么一步步长出来的
3.1 第一步:为什么用「点积」做相似度打分
回忆线性代数:余弦相似度 $\cos\theta=\dfrac{a\cdot b}{\|a\|\|b\|}$。点积 $a\cdot b=\|a\|\|b\|\cos\theta$——方向越一致、点积越大。忽略向量长度后,点积就是「未归一化的余弦相似度」,而且:
- 它是线性的,能高效并行(矩阵乘法);
- 它是可学习的:$Q,K$ 都是输入经可学习投影得到,相似度定义本身可以被训练调整。
对序列中第 $i$ 个查询 $q_i$ 与所有键 $k_1,\dots,k_T$,打分定义为逐分量内积:
$$s_{ij}=q_i\cdot k_j=\sum_{m=1}^{d_k} q_{i,m}\,k_{j,m}$$
写成矩阵形式,所有位置一次算完:
$$S=QK^\top\in\mathbb{R}^{T\times T}$$
$S$ 的第 $(i,j)$ 个元素 = 「第 $i$ 个词」对「第 $j$ 个词」的原始关注分。$T=6$ 的句子会得到一个 $6\times6$ 的分数表——句内所有词对全部直接连接,这就是第 1 节说的「路径长度 = 1」。
3.2 第二步:softmax 把分数变成「占比权重」
分数是任意实数,可能为负、可能很大。要让它有「占比」的含义(非负、和为 1),用 softmax 逐行归一化:
$$w_{ij}=\frac{e^{s_{ij}}}{\sum_{j'=1}^{T} e^{s_{ij'}}}$$
两个关键性质:
- 竞争性:指数函数把「大分」放大、「小分」压扁,形成 winner-take-most 的稀疏注意力模式;
- 数值稳定性:$\dfrac{e^{s}}{e^{M}}=e^{s-M}$ 是不变式,所以实现时先减掉行最大值再取指数,防止
e^1000溢出为inf——这是实验 1 里stable_softmax的由来,也是面试高频点。
💡 到这里(3.1+3.2)你已经有了一张「注意力权重表」:每行和为 1,告诉模型第 $i$ 个词该把注意力分给谁。下一步是把权重用起来。
3.3 第三步:按权重「取内容」——加权求和
有了权重 $w_{ij}$,第 $i$ 个词的新表示就是全句所有 $V_j$ 的加权混合:
$$o_i=\sum_{j=1}^{T} w_{ij}\,v_j\qquad\Longleftrightarrow\qquad O=\text{softmax}\!\left(QK^\top\right)V$$
矩阵写法里,$V$ 的每一行是一个「值向量」,权重矩阵 $\text{softmax}(QK^\top)$ 告诉模型每一行输出分别从哪些 $V$ 行各取多少。三步连起来:
$$\boxed{\ \text{Attention}(Q,K,V)=\text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}\right)V\ }$$
3.4 第四步:那么 $\sqrt{d_k}$ 到底是哪来的?(必考推导)
问题:假设 $q,k$ 的各分量独立同分布、均值为 0、方差为 1(随机初始化的常见情形)。两个独立随机变量乘积的期望 $E[q_m k_m]=E[q_m]E[k_m]=0$,所以逐个分量求和后,点积的方差为:
$$\text{Var}(q\cdot k)=\sum_{m=1}^{d_k}\text{Var}(q_m k_m)=\sum_{m=1}^{d_k}E[q_m^2]\,E[k_m^2]=d_k$$
(用到 $E[q_m^2]=E[k_m^2]=\text{Var}=1$。)结论:$d_k$ 越大,点积的方差越大,分数分布越「散」。
后果(softmax 饱和):分数动辄几十上百,指数函数 $e^s$ 对这些大数会拉出天文数字级的差距,softmax 输出逼近 one-hot:
$$e^{100}\gg e^{90}\gg e^{10}\quad\Rightarrow\quad w\approx[\,1,\,0,\,0,\,\dots\,]$$
这在热力学上叫「分布坍缩」。对应到梯度:softmax 饱和区的导数趋近 0,学习信号消失;同时注意力退化成「硬对齐」,丧失细粒度混合能力(就像只看词典第一条,不顾其他条目)。
解法:给分数除以 $\sqrt{d_k}$,把方差压回 1:
$$\text{Var}\!\left(\frac{q\cdot k}{\sqrt{d_k}}\right)=\frac{d_k}{d_k}=1$$
分数回到温和的尺度,softmax 留在非饱和区。这就是「缩放(scaled)」两个字的精确来历。面试官追问「为什么除 $\sqrt{d_k}$ 而不是 $d_k$?」——因为我们要把方差归一(方差正比于 $d_k$,标准差才正比于 $\sqrt{d_k}$),实验 1b 会画出未缩放时熵随 $d_k$ 塌缩的曲线。
3.5 论文里的那张图:Scaled Dot-Product Attention 模块
下图展示单个注意力头内部的完整数据流,把公式 $O=\text{softmax}\!\left(QK^\top/\sqrt{d_k}\right)V$ 画成图——实验 1 的代码会照着它一步步实现:MatMul(打分 $QK^\top$)→ Scale(除以 $\sqrt{d_k}$)→ Mask(可选)→ Softmax → 再次 MatMul(加权取 $V$)。
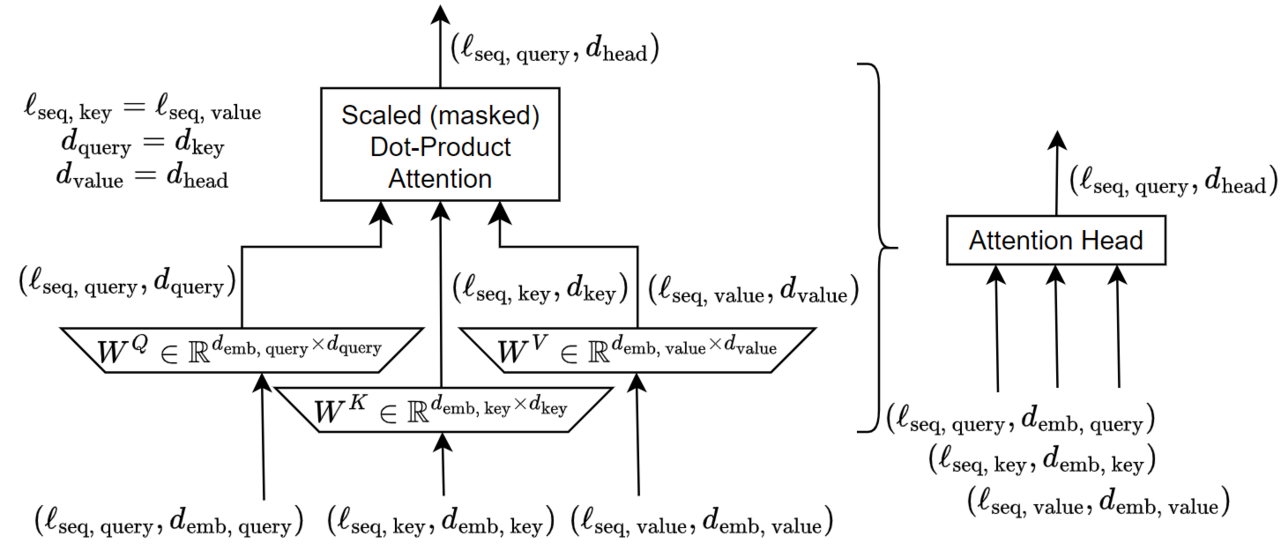
图 1:单个注意力头(Scaled Dot-Product Attention)模块——缩放点积注意力的数据流图(示意图,结构参照 Vaswani et al., 2017)。
读图要点:Mask 这一步可插拔——Encoder 的双向自注意力不遮任何位置;Decoder 的自注意力在这里插入因果掩码(第 8 节);交叉注意力在这里决定 Q 来自哪边、K/V 来自哪边。同一个模块三种用法,全靠这个小小的「开关」。
# ---------- 实验 1:手写缩放点积注意力 vs torch.nn.functional.scaled_dot_product_attention ----------
# 全局设置:固定随机种子 + 中文字体(本 notebook 所有 cell 共用)
import math
import numpy as np
import torch
import torch.nn.functional as F
import matplotlib.pyplot as plt

np.random.seed(0)
torch.manual_seed(0)
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

T, D = 6, 8                        # 6 个 token,特征维 8
Q = torch.randn(1, T, D)           # (B, T, d_k)
K = torch.randn(1, T, D)
V = torch.randn(1, T, D)

def stable_softmax(x, dim=-1):
    """数值稳定 softmax:先减行最大值再取指数(防溢出,易错点 1)"""
    x = x - x.max(dim=dim, keepdim=True).values
    e = torch.exp(x)
    return e / e.sum(dim=dim, keepdim=True)

def scaled_dot_attention(Q, K, V):
    """手写缩放点积注意力:(B,T,d) -> (B,T,d),顺便返回注意力权重"""
    scores = Q @ K.transpose(-1, -2) / math.sqrt(K.shape[-1])   # (B,T,T) 打分
    p = stable_softmax(scores)                                  # 权重:行和为 1
    return p @ V, p                                             # 加权取内容

out_my, attn = scaled_dot_attention(Q, K, V)
with torch.no_grad():
    out_t = F.scaled_dot_product_attention(Q, K, V)             # 官方融合实现
err = (out_my - out_t).abs().max().item()
print('手写 vs torch 最大误差: %.2e' % err)
assert err < 1e-5, '误差应 < 1e-5'

# 自检:权重非负、每行和为 1
print('注意力权重行和(应全为 1):', attn.sum(dim=-1)[0].round(decimals=4).tolist())
print('注意力权重(第 0 个 token 对其它 token):', attn[0, 0].round(decimals=3).tolist())

# 可视化:注意力热力图(行 = 查询,列 = 键),并标出数值
plt.figure(figsize=(5.5, 4.5))
im = plt.imshow(attn[0].detach().numpy(), cmap='Blues', vmin=0, vmax=float(attn[0].max()))
plt.colorbar(im, ax=plt.gca())
plt.title('注意力权重矩阵(行 = 查询, 列 = 键)')
plt.xlabel('Key 位置'); plt.ylabel('Query 位置')
plt.xticks(range(T)); plt.yticks(range(T))
for i in range(T):
    for j in range(T):
        plt.text(j, i, '%.2f' % attn[0, i, j].item(), ha='center', va='center', fontsize=8)
plt.tight_layout(); plt.show()
print('要点:① 手写与官方一致(<1e-5);② 权重非负且行和为 1,模型自动学会「关注谁」;③ QKV 都来自输入时叫自注意力')
# ---------- 实验 1b:演示「为什么除 √d_k」——softmax 饱和与熵塌缩 ----------
# 思路:固定一个查询和 5 个键,看 d_k 增大时 softmax 分布的「熵」如何变化
# 熵越小 = 分布越接近 one-hot = softmax 饱和 = 梯度消失

def softmax_np(x):
    x = x - x.max(-1, keepdims=True)
    e = np.exp(x)
    return e / e.sum(-1, keepdims=True)

def entropy(p, eps=1e-12):
    p = np.clip(p, eps, 1.0)
    return -(p * np.log(p)).sum(-1)

rng = np.random.default_rng(0)
dk_list = [1, 2, 4, 8, 16, 32, 64, 128]
H_raw, H_sc = [], []
for dk in dk_list:
    q = rng.normal(size=dk)            # 一个查询向量(分量方差 1)
    KK = rng.normal(size=(5, dk))      # 5 个键向量
    s_raw = KK @ q                                         # 未缩放分数
    s_sc = s_raw / math.sqrt(dk)                           # 缩放后分数
    H_raw.append(float(entropy(softmax_np(s_raw[None, :])).mean()))
    H_sc.append(float(entropy(softmax_np(s_sc[None, :])).mean()))

plt.figure(figsize=(7, 4))
plt.plot(dk_list, H_raw, 'o-', label='不缩放  QKᵀ(熵快速塌缩)')
plt.plot(dk_list, H_sc, 's--', label='缩放  QKᵀ/√d_k(熵稳定)')
plt.xscale('log')
plt.xlabel('d_k'); plt.ylabel('softmax 输出熵(越高越均匀)')
plt.title('为什么除 √d_k:熵对比(饱和 vs 温和)')
plt.legend(); plt.grid(alpha=0.3); plt.tight_layout(); plt.show()

print(' d_k | 不缩放熵 | 缩放后熵')
for dk, hr, hs in zip(dk_list, H_raw, H_sc):
    print('%4d |   %.3f   |   %.3f' % (dk, hr, hs))
print('结论:d_k=128 时不缩放熵≈%.2f(分布接近 one-hot → 饱和、梯度消失),缩放后熵≈%.2f(保持温和)' % (H_raw[-1], H_sc[-1]))
assert H_raw[-1] < H_sc[-1] * 0.35, '未缩放的熵应显著低于缩放后(饱和演示成立)'
4. Self-Attention:让每个词「环顾全句」
4.1 Q=K=V 的特殊情形
第 2、3 节的 Q/K/V 是泛化定义(比如机器翻译里 Query 来自目标语言、Key/Value 来自源语言)。自注意力(self-attention) 是它的特殊情形:Q、K、V 全部来自同一个序列 $X$,各自经过可学习投影:
$$Q=XW_Q,\qquad K=XW_K,\qquad V=XW_V$$
- $X\in\mathbb{R}^{T\times d}$:整句的表示(通常=词向量+位置信息);
- $W_Q,W_K,W_V\in\mathbb{R}^{d\times d_k}$:可学习投影矩阵;
- 投影的意义:把「原始表示」分别变换到「查询空间 / 键空间 / 值空间」,让「怎么打分」和「取什么内容」可以分开优化——同一份输入,三种用法。
语义效果:第 $i$ 个词更新后的表示 = 全句所有词表示的加权混合,权重由「$i$ 和谁更相关」决定:
- 「银行」→ 对「柜台、存款、贷款」的权重高(一词多义消歧的雏形);
- 「他」→ 权重集中到前文的指代对象(指代消解);
- 动词的注意力常落在它的主语/宾语上(浅层句法先验)。
4.2 矩阵形式:一行公式的由来
$$O=\underbrace{\text{softmax}\!\left(\dfrac{XW_Q\,W_K^\top X^\top}{\sqrt{d_k}}\right)}_{\text{权重矩阵 }T\times T}\ \underbrace{XW_V}_{\text{值 }T\times d_k}$$
注意 $W_Q,W_K,W_V$ 是学习出来的,不是手工设计——「关注谁」的规则由数据驱动(对比 01 篇 n-gram 的固定窗口)。
4.3 复杂度分析(必背)
- 时间:$QK^\top$ 是 $(T\times d_k)\times(d_k\times T)$ 的矩阵乘 → $O(T^2 d_k)$;乘以 $V$ 再 $O(T^2 d_k)$。总共 $O(T^2 d)$($d_k$ 与 $d$ 同量级时);
- 空间:$T\times T$ 的注意力矩阵本身要存下来 → 也是 $O(T^2)$;
- FFN 部分 $O(T d^2)$,两个二次项中 $T^2$ 是长序列的主瓶颈。
📐 口算:$T=32$K 的上下文 → 注意力矩阵有 $32\text{K}^2\approx10^9$ 个元素,光存权重就 4 GB(fp32)——这就是为什么长上下文这么贵,也是第 10 节一切优化的出发点。
⚠️ 局限:单头注意力只有一个打分空间,学到的关系比较单一——这正是第 5 节「多头」要解决的问题。
4.4 Self-Attention vs RNN / CNN:感受野与信息流
把三种结构的「信息流通」并排看,Self-Attention 的优势一目了然:
| 结构 | 感受野 | 信息路径 | 并行度 | 单层复杂度 |
|---|---|---|---|---|
| RNN / LSTM | 全序列(理论上) | 逐 token 串行传递,路径长 | 低 | $O(T)$ |
| CNN(窗口 $k$) | 局部 $k$ | 需堆叠多层才能「看远」 | 高 | $O(kT)$ |
| Self-Attention | 整句任意两词直达 | 任意词对路径 = 1 条 | 高 | $O(T^2)$ |
关键洞察:CNN 的「感受野靠层数换」,RNN 的「信息靠步数传」——两者都要付出深度或时间的代价;Self-Attention 用 $O(T^2)$ 的代价直接买断「一步直达」。这正是第 1 节的结论:注意力把「距离」从结构中消掉了,剩下的问题只有复杂度。
🧠 面试追问:那为什么现在的模型还保留 RNN/CNN 的成分(如 Mamba、RWKV、Hyena)?——因为它们想把 $O(T^2)$ 的代价省回来,用递推或卷积做「便宜的近似注意力」,这是第 10 节的主线。
# ---------- 实验:手写完整 Self-Attention(含 Q=XWq 投影)+ 关注关系可视化 ----------
# 自注意力 = Q、K、V 全部来自同一序列 X 的线性投影(公式 O = softmax(XWq WkᵀXᵀ/√d)XWv)
np.random.seed(0); torch.manual_seed(0)
import time

tokens = ['猫', '追', '老鼠', '在', '花园', '里']        # 6 个词的示例句
T, d = 6, 8
X = torch.randn(T, d)                                     # 词向量矩阵 (T, d)
Wq = torch.randn(d, d) * 0.3
Wk = torch.randn(d, d) * 0.3
Wv = torch.randn(d, d) * 0.3

Q = X @ Wq; K = X @ Wk; V = X @ Wv                       # Q=XWq, K=XWk, V=XWv
scores = Q @ K.T / math.sqrt(d)
p = stable_softmax(scores)                                # 复用实验 1 的稳定 softmax
O = p @ V
print('输出形状:', tuple(O.shape), ' 注意力权重行和:', p.sum(1).round(decimals=6).tolist())

print('\n每个词的 top-2 关注对象:')
for i in range(T):
    top = p[i].argsort(descending=True)[:2].tolist()
    print('  %s 关注 -> %s' % (tokens[i], '、'.join(tokens[j] for j in top)))

plt.figure(figsize=(6, 4.5))
im = plt.imshow(p.detach().numpy(), cmap='YlOrRd')
plt.colorbar(im, ax=plt.gca())
plt.xticks(range(T), tokens); plt.yticks(range(T), tokens)
plt.title('自注意力:句内任意两词直接交互')
plt.xlabel('Key'); plt.ylabel('Query')
plt.tight_layout(); plt.show()

# 复杂度标度:T 翻倍时 Q@Kᵀ 耗时近似翻 4 倍 -> 印证 O(T²)
prng = np.random.default_rng(1)
Ts = [16, 32, 64, 128, 256]
times = []
for Tt in Ts:
    A = prng.normal(size=(Tt, 32)); B = prng.normal(size=(Tt, 32))
    t0 = time.perf_counter()
    for _ in range(3):
        A @ B.T
    times.append((time.perf_counter() - t0) / 3)
print('\n复杂度标度(Q@Kᵀ 单次耗时, 秒):')
for Tt, tt in zip(Ts, times):
    print('  T=%4d -> %.2e s' % (Tt, tt))
ratio = times[-1] / times[-2]
print('T: 256→128 耗时比 = %.1f(O(T²) 预期 ≈ 4)' % ratio)
5. 多头注意力(Multi-Head Attention):一群专家分头把关
5.1 为什么需要多头?
单头注意力的毛病:一个打分空间里只能学一种「关系」。可一句真实句子里并存多种关系——语法从属、指代、语义相似、甚至「隔几格」的位置关系——全都挤在同一个 $QK^\top$ 打分里会互相干扰(学过 A 就顾不上 B)。论文《Attention Is All You Need》给的办法是多头:
$$\text{MultiHead}(X)=\text{Concat}\big(\text{head}_1,\dots,\text{head}_h\big)W_O$$
$$\text{head}_i=\text{Attention}\big(XW_Q^{(i)},\;XW_K^{(i)},\;XW_V^{(i)}\big)$$
即:并排 $h$ 组独立的 QKV 投影(每组维度 $d_k=d_v$),各自跑一遍缩放点积注意力,把 $h$ 个输出拼接起来,再过一层输出投影 $W_O$。直观上就像 8 个「审稿人」:一个盯语法衔接、一个盯指代、一个盯语义相似……互不干扰各打各的分,最后主编($W_O$)把意见融合。已有研究确实观察到 BERT 等模型里不同的 head 各自分工(指代头、位置头等)。
5.2 维度口算(面试必考,动手心算)
论文配置 $d_{model}=512$,$h=8$:
$$d_k=d_v=\frac{d_{model}}{h}=\frac{512}{8}=64$$
- 每个 head 输出 $(T,\,64)$;$h$ 个头拼接 → $(T,\,8\times64)=(T,\,512)$;再过 $W_O\in\mathbb{R}^{512\times512}$ 投影回 $512$ 维;
- 参数量不变!8 个头 × $3\times(512\times64)$ 的 QKV 投影 $=3\times512\times512$,与单头 $512$ 维完全一致——多头是「把容量重新分配」,而不是加参;
- 常见变体口算:$d=768,h=12\to64$;$d=1024,h=16\to64$;$d=256,h=8\to32$。
🎯 口算规则一句话:每头维度 = d_model ÷ h(通常 $d_k=d_v$)。
5.3 局限
头数也不是越多越好:每头维度变小,单头表达能力下降;头数过多时有的头学不到独特模式(冗余)。现代 LLM 多在 8~32 头之间权衡,且出现了分组查询注意力(GQA)/多头查询注意力(MQA)用「K/V 共享」压推理显存——这是 KV cache 时代的工程演进,第 8.3 节见。
5.4 论文里的那张图:Multi-Head Attention 模块
下图是论文 Figure 2 右侧的多头注意力模块:左边是 $h$ 个并排的「Scaled Dot-Product Attention」头,每个头有自己的 QKV 线性投影($W_Q^{(i)},W_K^{(i)},W_V^{(i)}$);右边把 $h$ 个头的输出拼接(Concat),再过一次输出投影 $W_O$:
$$\text{MultiHead}(Q,K,V)=\text{Concat}(\text{head}_1,\dots,\text{head}_h)W_O$$
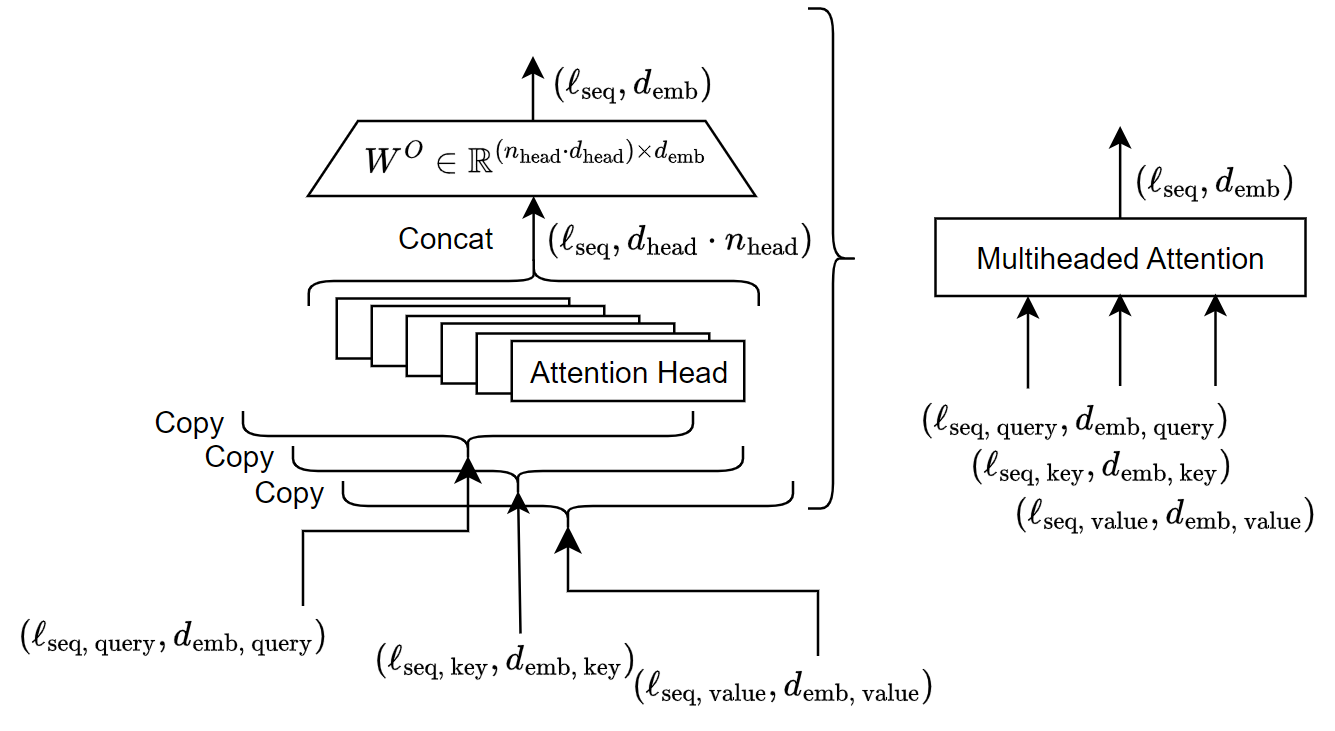
图 2:多头注意力模块(Multi-Head Attention)——$h$ 个头并排分工、拼接后再投影(示意图,结构参照 Vaswani et al., 2017)。
读图要点:三个投影(Q/K/V)逐头独立,输出投影 $W_O$ 跨头共享一次。实验 2 会用 torch 逐行对照;做完实验再回来看这张图,手写代码里的每一个矩阵都能在图上找到。
# ---------- 实验 2:手写多头注意力 vs torch.nn.MultiheadAttention 对照 ----------
# 先做维度口算(d_model / h = 每头维度)
for dm, h in [(512, 8), (768, 12), (16, 4)]:
    print('d_model=%d, h=%d -> 每头维度 d_k = %d' % (dm, h, dm // h))

torch.manual_seed(0)
B_, T_, D_, H_ = 2, 5, 16, 4          # 测试配置:4 头,每头 d_k = 4
mha = torch.nn.MultiheadAttention(D_, H_, batch_first=True, bias=False)

# torch 的 in_proj_weight 形状是 (3D, D),纵向拼接:前 D 行 = Wq,中间 D 行 = Wk,后 D 行 = Wv
wq = mha.in_proj_weight[:D_].detach().numpy().reshape(H_, D_ // H_, D_)
wk = mha.in_proj_weight[D_:2 * D_].detach().numpy().reshape(H_, D_ // H_, D_)
wv = mha.in_proj_weight[2 * D_:].detach().numpy().reshape(H_, D_ // H_, D_)
wo = mha.out_proj.weight.detach().numpy()          # (D, D) 输出投影

def mha_forward(x, wq, wk, wv, wo, H):
    """手写多头:h 组独立 QKV -> 各自缩放点积注意力 -> 拼接 -> out_proj"""
    B, T, D = x.shape
    dk = D // H                                       # 每头维度(口算公式)
    heads = []
    for h in range(H):
        Qh = x @ wq[h].T                              # (B, T, dk)
        Kh = x @ wk[h].T
        Vh = x @ wv[h].T
        sc = Qh @ Kh.transpose(0, 2, 1) / np.sqrt(dk)
        p = np.exp(sc - sc.max(-1, keepdims=True))    # 稳定 softmax(numpy 版)
        p = p / p.sum(-1, keepdims=True)
        heads.append(p @ Vh)
    cat = np.concatenate(heads, axis=-1)              # (B, T, H*dk) = (B, T, D)
    return cat @ wo.T, cat.shape[-1]

x4 = torch.randn(B_, T_, D_)
with torch.no_grad():
    out_t4, _ = mha(x4, x4, x4)                       # 官方(自注意力模式 query=key=value=x)
out_my4, cat_dim = mha_forward(x4.numpy(), wq, wk, wv, wo, H_)
err = np.abs(out_my4 - out_t4.detach().numpy()).max()
print('手写多头 vs torch.MultiheadAttention 最大误差: %.2e' % err)
assert err < 1e-4, '误差应 < 1e-4'
print('拼接后维度 = %d(= d_model)✓ | 4 头 × dk=4 -> 拼成 16 -> W_O 投影回 16' % cat_dim)
print('h 个头 -> 拼接 -> out_proj 投影,与论文 MultiHead 公式逐行一致')
6. 位置编码:给「无序」的注意力补上顺序
6.1 为什么必须注入位置?
注意力机制对输入做的是集合运算:把 $T$ 个 token 任意打乱重排,$QK^\top$ 的每个元素值不变,softmax 结果只是行跟着重排——位置信息被彻底丢弃。「猫追老鼠」和「老鼠追猫」在注意力眼中是同一句话!所以必须事先把「位置」编码后加进输入。这也是为什么 say 03 篇的 RNN 天然有序(它按 $h_0\to h_1\to\cdots$ 递推),而注意力必须「手动」补顺序。
6.2 正弦位置编码公式(论文方案)
对位置 $p$、维度下标 $i$($0\le i<d$):
$$PE_{(p,2i)}=\sin\!\left(\frac{p}{10000^{2i/d}}\right),\qquad PE_{(p,2i+1)}=\cos\!\left(\frac{p}{10000^{2i/d}}\right)$$
要点:
- 偶数维写 $\sin$、奇数维写 $\cos$,成对出现;
- 频率随维度指数下降:$2i/d$ 越大,$10000^{2i/d}$ 越大,$\sin$ 的周期越长。于是低维是「慢变细刻度」(能区分相邻位置),高维是「快变粗刻度」(覆盖长距离)——像钟表的时针分针秒针,短长兼顾;
- 波长:$\lambda_i=2\pi\cdot10000^{2i/d}$,从 $2\pi$ 到 $2\pi\cdot10^4$ 的几何级数;
- $PE$ 与词向量相加(不是拼接):$X=\text{emb}+PE$,维度不变,实现零成本。
6.3 关键性质:相对位置可「线性表示」(推导)
为什么偏偏选 $\sin/\cos$?因为三角恒等式带来一个漂亮性质。先看 $d=2$ 的最简单情形,记 $\omega=\omega_0=1$:
$$PE_p=\big[\sin(p\omega),\; \cos(p\omega)\big]$$
对任意固定偏移 $\Delta$,用和角公式展开:
$$PE_{p+\Delta}=\big[\sin(p\omega+\Delta\omega),\; \cos(p\omega+\Delta\omega)\big] =\underbrace{\begin{bmatrix}\cos(\Delta\omega)&\sin(\Delta\omega)\\ -\sin(\Delta\omega)&\cos(\Delta\omega)\end{bmatrix}}_{M_\Delta}\,PE_p$$
注意 $M_\Delta$ 是一个只与 $\Delta$ 有关、与绝对位置 $p$ 无关的旋转矩阵!$d>2$ 时公式对每一对维度逐块成立,$M_\Delta$ 变成分块旋转矩阵。
推论:任意两个位置编码向量的内积只依赖相对偏移:
$$\langle PE_p,\,PE_q\rangle=\sum_i \cos\big((p-q)\,\omega_i\big)=f(p-q)$$
于是模型在注意力打分里遇到 $PE_p\cdot PE_q$ 这类项时,相对距离 $\Delta=|p-q|$ 自然浮现,很容易学到「相隔几格」的依赖(近强远弱)。这条性质同时带来长度外推:位置编码本身覆盖不到的位置,正弦编码仍能给出合理的值——这是 learned embedding 做不到的。实验 cell 会数值验证这两条性质。
💡 面试加分:现代 LLM(LLaMA 等)用 RoPE(旋转位置编码),本质是把「$M_\Delta$ 旋转」直接作用到 $Q,K$ 上,让注意力分数天然含相对位置——正是本节思想的工程升级版。
6.4 正弦编码 vs 可学习位置编码(对比表)
| 维度 | 正弦 sin/cos(原版 Transformer) | 可学习 learned(BERT/GPT) |
|---|---|---|
| 参数 | 0(固定函数) | $L\times d$ 个可学习参数 |
| 长度外推 | 可外推到训练长度之外($M_\Delta$ 旋转性质) | 通常不行,超出 $L$ 的位置没有参数 |
| 训练稳定性 | 收敛温和 | 依赖初始化与数据 |
| 相对位置 | 内积天然只依赖 $\Delta$ | 靠数据隐式学到 |
| 现代用法 | 启发 RoPE/ALiBi | 仍广泛用于 BERT 系 |
两者的共同点:注入时机都在 embedding 之后、第一层注意力之前(易错点 4)。区别一句话:正弦是「几何先验 + 免费外推」,learned 是「交给数据,更灵活但不外推」。
⚠️ 局限:原版正弦编码是绝对位置函数,虽间接携带相对信息但不精确;且无法编码「词与词之间的语义距离」这类更细的信息。后续工作(RoPE/ALiBi/相对位置矩阵)都在把这个「相对位置注入」做得更直接。
6.5 手算一组位置编码(口算训练)
设 $d=2$(只有一对 sin/cos),记 $\omega_0=1$,则 $PE_p=[\sin p,\ \cos p]$。代入前几个位置:
| 位置 $p$ | $\sin p$ | $\cos p$ | 编码向量 $PE_p$ |
|---|---|---|---|
| 0 | 0.000 | 1.000 | [0.000, 1.000] |
| 1 | 0.841 | 0.540 | [0.841, 0.540] |
| 2 | 0.909 | −0.416 | [0.909, −0.416] |
| 3 | 0.141 | −0.990 | [0.141, −0.990] |
三个观察:
- 每个位置都有唯一编码($p=0,1,2,3$ 两两不同),模型据此区分顺序;
- 相邻位置仍相似、相距越远越不相似:$PE_1\cdot PE_2=\sin1\sin2+\cos1\cos2=\cos(2-1)=\cos1\approx0.54$,即位置差 1 的相似度 ≈ 0.54——「近强远弱」的局部性先验自动出现;
- 任何偏移都是旋转:$PE_{p+\Delta}$ 由 $PE_p$ 左乘一个固定旋转矩阵得到(第 6.3 节),「隔几格」的信息对模型恒等可读。
🎯 口算速记:维度越靠前($i$ 小),$\omega$ 越大、变化越快;真实模型 512 维由 256 个频率瓜分,最慢的频率周期长达 $2\pi\times10^4$ 个位置——这就是「短长兼顾」的刻度尺。
# ---------- 实验:sin/cos 位置编码——生成、可视化、验证相对位置性质 ----------
def sinusoidal_pe(max_len, d_model):
    """按论文公式生成正弦位置编码矩阵 (max_len, d_model)"""
    pe = np.zeros((max_len, d_model), dtype=np.float32)
    pos = np.arange(max_len)[:, None].astype(np.float32)
    omega = 1.0 / np.power(10000.0, 2 * np.arange(d_model // 2) / d_model)  # 每个频率
    pe[:, 0::2] = np.sin(pos * omega)     # 偶数维 sin
    pe[:, 1::2] = np.cos(pos * omega)     # 奇数维 cos
    return pe, omega

max_len, d_model = 100, 16
pe, omega = sinusoidal_pe(max_len, d_model)

# 1) 可视化:低维低频慢变、高维高频快变
plt.figure(figsize=(8, 4))
for i in [0, 3, 6]:
    plt.plot(pe[:, 2 * i], label='dim %d (sin, ω=%.4f)' % (2 * i, omega[i]))
    plt.plot(pe[:, 2 * i + 1], ls='--', label='dim %d (cos)' % (2 * i + 1))
plt.xlabel('位置 p'); plt.ylabel('编码值')
plt.title('正弦位置编码:频率随维度指数下降(低频慢变 → 高频快变)')
plt.legend(fontsize=8); plt.grid(alpha=0.3); plt.tight_layout(); plt.show()

# 2) 相对位置性质:固定偏移 Δ,PE[p+Δ] ≈ PE[p] @ M_Δ(线性变换精确成立)
Delta = 3
A = pe[Delta:]                        # PE[p+Δ]
B = pe[:-Delta]                       # PE[p]
M = np.linalg.lstsq(B, A, rcond=None)[0]      # 找 M 使 A ≈ B @ M(数值线性回归)
resid = np.abs(A - B @ M).max()
print('相对位置验证:Δ=%d 时 PE[p+Δ] ≈ PE[p]@M 的最大残差 = %.2e' % (Delta, resid))
print('残差≈机器精度 → 相对偏移确实由固定线性变换 M_Δ 表示(旋转矩阵)✓')

# 3) 内积只依赖相对偏移:<PE_p, PE_q> 仅由 |p-q| 决定
base = 50
max_dev = 0.0
for p in range(30, 70):
    for q in range(30, 70):
        dev = abs(float(pe[p] @ pe[q] - pe[base] @ pe[base + q - p]))
        max_dev = max(max_dev, dev)
print('内积只依赖 |p-q|?所有 (p,q) 样本的最大偏差 = %.2e' % max_dev)
offs = np.arange(0, 40)
corr = np.array([float(pe[base] @ pe[base + o]) for o in offs])
plt.figure(figsize=(6.5, 3.5))
plt.plot(offs, corr, 'o-')
plt.xlabel('相对偏移 Δ = |p-q|'); plt.ylabel('位置编码内积')
plt.title('位置编码内积仅依赖相对偏移(近强远弱,局部性先验)')
plt.grid(alpha=0.3); plt.tight_layout(); plt.show()
7. Encoder 完整结构:MHA + FFN + 残差 + LayerNorm
7.1 单层 Encoder 的组装(后归一化 Post-LN,论文原版顺序)
拿第 5 节的多头注意力当「核心部件」,再配三样配件做一个完整的 Encoder 层:
$$X'=\text{LayerNorm}\big(X+\text{MultiHead}(X)\big)$$ $$X''=\text{LayerNorm}\big(X'+\text{FFN}(X')\big)$$
① 残差连接(Residual):$+X$ 保证梯度有一条「高速公路」从顶层直通底层,深层也不退化——这和 03 篇里 LSTM 用加性细胞状态防梯度消失是同一思想(加性路径 + 恒等映射)。没有它,几十层的 Transformer 根本训不动。
② LayerNorm(层归一化):对**每个 token 的特征维(最后一维)**做归一化:
$$\hat{x}=\frac{x-\mu}{\sqrt{\sigma^2+\epsilon}}\cdot\gamma+\beta$$
注意归一化轴是「特征维」而不是「序列维」(易错点 5)。相比 BatchNorm 按 batch 统计,LN 与 batch 大小、序列长度都无关,训练/推理行为一致,是 Transformer 的标准选择。
③ FFN(前馈网络):每个位置独立的两层 MLP + ReLU:
$$\text{FFN}(x)=\max(0,\ xW_1+b_1)W_2+b_2$$
中间维度通常取 $4\times d_{model}$(512→2048)。FFN 负责「逐位置深度加工」,是对注意力「跨位置混合」的互补——注意力管词与词的关系,FFN 管每个词表示本身的非线性变换。参数量上 FFN 约占一个 Transformer 层的 2/3。
7.2 Pre-LN vs Post-LN(一句话分清)
| Post-LN(原版 2017) | Pre-LN(现代 LLM:GPT-2/3、LLaMA) | |
|---|---|---|
| 层内顺序 | Attn → Add → LN | LN → Attn → Add |
| 关键差异 | LN 在残差加法之后 | LN 在子层之前,残差直达恒等 |
| 训练 | 深层容易震荡,需 warmup | 稳定,可加大学习率 |
| 精度 | 原版论文精度略好 | 大模型事实标准 |
面试点:为什么 GPT 系用 Pre-LN?因为残差路径完全恒等,梯度最稳,适合堆到几十上百层。这是「为什么现在的大模型好训」的一个具体技术细节。
⚠️ 局限:Encoder 是双向结构——每个位置都能看到整句,这赋予它强大的理解能力,但也决定它不能直接做自回归生成(看不到未来怎么预测未来?)。生成要靠 Decoder 的因果掩码,见下一节。
7.3 拼装完整 Transformer:把架构图挂在墙上
把前面的零件拼起来,就是原论文的整体架构图。左半是 $N$ 层堆叠的 Encoder(每层 = 多头自注意力 + FFN,各带残差与 LayerNorm);右半是 $N$ 层堆叠的 Decoder(每层 = 掩码多头自注意力 + 交叉注意力 + FFN);顶部是输出投影 + softmax;右侧的 "Shifted right" 表示训练时用「右移一位的目标序列」做 teacher forcing(第 8.1 节)。
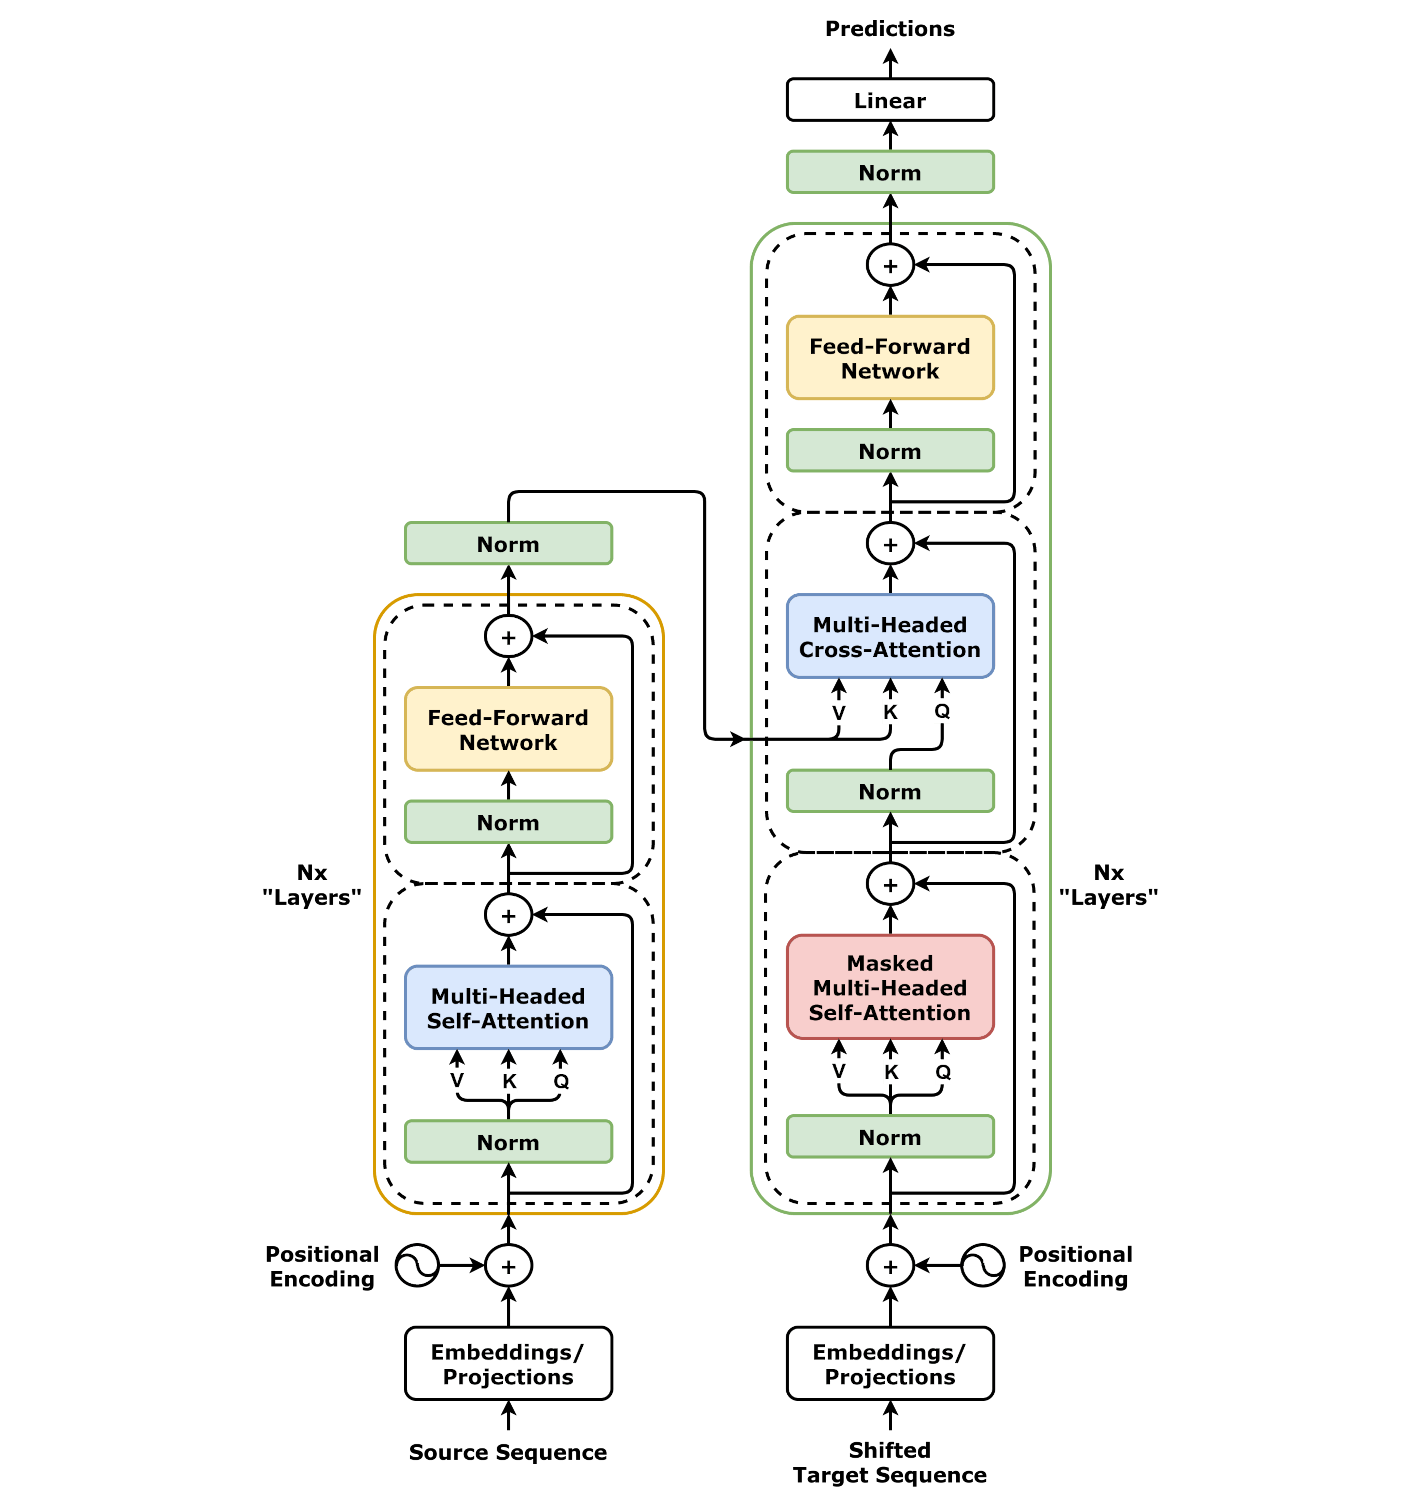
图 3:Transformer 整体架构(Encoder–Decoder)——左:$N\times$ Encoder,右:$N\times$ Decoder,中间的交叉注意力是两半之间的桥(来源:Wikimedia Commons,CC BY 4.0,原图 Vaswani et al., 2017)。
读图要点(对照本篇各节):
- Encoder 每个子层的 ① 多头自注意力 ② FFN ③ 残差加法 ④ LayerNorm——对应第 7 节;
- Decoder 的 ① 掩码多头自注意力 ② 交叉注意力(Key/Value 来自左半 Encoder)③ FFN——对应第 8 节;
- 图里的每个灰色框(Multi-Head Attention 等)都是你已经在实验 1/2 中亲手实现过的模块——读图即复习。
8. Decoder:因果掩码 + 交叉注意力 + KV cache
8.1 因果掩码(causal mask):生成时不能偷看未来
自回归生成(GPT 式)的铁律:预测第 $t$ 个词时,只能用到位置 $\le t$ 的信息,否则就是「作弊」(训练时你直接给了答案,推理时未来还不存在)。实现方式是在打分矩阵上加一个下三角掩码:
$$ O=\text{softmax}\!\left(\frac{QK^\top}{\sqrt{d_k}}+\text{Mask}\right)V,\qquad \text{Mask}_{ij}=\begin{cases}0& i\ge j\ (\text{允许})\\ -\infty & i<j\ (\text{未来,屏蔽})\end{cases} $$
三个必须记住的细节:
- 用 $-\infty$ 而不是 0:$e^{-\infty}=0$,未来位置的权重被精确清零;若填 0,softmax 里会变成「比别的位置多 1 分」,未来信息照样漏进来——这是最经典的面试坑;
- 掩码加在 softmax 之前的分数上,不是之后;
- 对角线(自己)允许看:
torch.triu(..., diagonal=1)屏蔽的是严格上三角。
实现示意(实验 cell 有完整可运行版):
mask = torch.triu(torch.ones(T, T), diagonal=1).bool()      # 未来 = True
scores = scores.masked_fill(mask, float('-inf'))
8.2 交叉注意力(cross-attention):Decoder 怎么「读」Encoder
Decoder 每一层有两个注意力子层:
- 掩码自注意力:Q=K=V 来自 Decoder 自身(因果掩码保护),管「已生成部分」的内部关系;
- 交叉注意力:$Q$ 来自 Decoder,$K,V$ 来自 Encoder 最后一层输出:
$$Q=X_{dec}W_Q,\qquad K=X_{enc}W_K,\qquad V=X_{enc}W_V$$
效果:生成每个词时,用「当前生成语境」(Query)去检索「源句语义」(Key/Value)——这就是「编码器理解语义 → 解码器按语义生成」的桥梁,机器翻译任务的本质动作。
8.3 KV cache:推理时省多少计算?(数学账)
自回归生成是逐 token 进行的:先生成第 1 个词,再把整段送回模型得到第 2 个词……朴素做法每步都拿全部已生成 token 重新过一遍注意力。观察一个事实:生成第 $t$ 个 token 时,前 $t-1$ 个 token 的 $K,V$ 已经算过且不会再变(自回归下旧 token 的表示冻结)。于是把它们缓存下来:
朴素做法(无缓存)——第 $t$ 步要重算全部 $t$ 个 token 的 K/V 投影 + $t\times t$ 注意力矩阵:
$$\text{总开销}=\sum_{t=1}^{T}O(t^2 d)=O(T^3 d)$$
KV cache——每步只算新 token 的 $K_t,V_t$ 和 $1\times t$ 的注意力行:
$$\text{总开销}=\sum_{t=1}^{T}O(t d)=O(T^2 d)$$
加速比 = $O(T)$(约 T/3 倍量级):生成长度 $T=1024$ 的序列,KV cache 让注意力计算量少三个数量级;代价是显存要存下不断增长的 K/V(每 token $2\times d\times h$ 个浮点数,量级很小,但随上下文线性增长——GQA/MQA 就是为压这个显存而生的)。
🎯 面试速记:KV cache 把生成复杂度从 $O(T^3)$ 降到 $O(T^2)$,缓存的是 K 和 V——不缓存 Q(每步的 Q 都是新的)。这是推理引擎(vLLM、TensorRT-LLM)的标配优化。
⚠️ 局限:KV cache 显存随上下文线性增长,长上下文下显存又成瓶颈 → 引出 Mamba 等状态空间模型的动机(第 10 节)。
8.4 训练 vs 推理:同一个 Decoder 的两副面孔(易错点加餐)
| 维度 | 训练(teacher forcing) | 推理(自回归) |
|---|---|---|
| 输入 | 完整目标序列(右移一位) | 只有已生成的 token |
| 掩码 | 一次性固定下三角 | 随长度增长的三角(每次重算) |
| 并行 | 整段并行:一次前向算出所有位置的预测 | 逐 token 串行:每次只预测最后 1 个位置 |
| 监督 | 每个位置都有标签,逐位置算 loss | 没有标签,只能自举(用自己预测的词续写) |
三个必背推论:
- 训练时「未来」被掩码挡住,loss 仍是逐位置算——位置 $t$ 只在其标签处有监督,模型看不到 $>t$ 的输入,teacher forcing 并不泄露答案;
- 推理时掩码随长度增长:长度为 $L$ 时掩码是 $L\times L$ 下三角,每生成一个词就大一圈——KV cache(8.3)正是为了不让这个「重算」拖慢进程;
- 训练/推理的输入形态不一致,是很多训练技巧(05 篇的 80/10/10、dropout 等)要弥合的鸿沟——结构上的不对称最终要靠目标函数的设计来补。
⚠️ 易错点:把「训练时整段并行」误记为「推理也能并行」是新手最常见的口误;推理的并行只发生在 batch 维(多条序列同时生成),序列内部永远串行。
# ---------- 实验:因果掩码实现 + KV cache 计算量对比 ----------
# 1) 因果掩码:下三角 -inf -> softmax 后未来权重精确为 0
T = 6
scores = torch.randn(T, T)
mask = torch.triu(torch.ones(T, T), diagonal=1).bool()        # 严格上三角(未来)= True
scores_masked = scores.masked_fill(mask, float('-inf'))
w = torch.softmax(scores_masked, dim=-1)
upper = w.detach().numpy()[np.triu_indices(T, 1)]
print('因果掩码后注意力权重(行=位置,只能看 列<=行):')
print(w.detach().numpy().round(3))
print('上三角(未来)权重最大值 = %.2e' % upper.max())
assert upper.max() == 0.0, '未来位置的权重必须精确为 0'

# 对比:错误用法——用 0 代替 -inf(经典坑)
w_bad = torch.softmax(scores.masked_fill(mask, 0.0), dim=-1)
print('\n若错误地把 mask 填 0:第 0 行对未来位置的权重 = %s(信息泄露!)' % w_bad[0].round(decimals=3).tolist())

# 2) KV cache:估算逐 token 生成的总注意力计算量(FLOPs,粗略但数量级正确)
def attn_flops(T_now, d):
    """第 T_now 步:投影 2*T_now*d*d + 打分/混合 2*T_now*T_now*d(每步都有的部分)"""
    no_cache = 2 * T_now * d * d + 2 * T_now * T_now * d
    with_cache = 2 * d * d + 2 * T_now * d      # 只投影新 token(2*d*d)+ 1×T 打分混合
    return no_cache, with_cache

T_total, d = 512, 64
sum_no = sum_cache = 0
for t in range(1, T_total + 1):
    a, b = attn_flops(t, d); sum_no += a; sum_cache += b
print('\nKV cache 计算量对比(生成 %d 个 token,注意力部分):' % T_total)
print('  朴素重新计算: %12.1f MFLOPs' % (sum_no / 1e6))
print('  KV cache:     %12.1f MFLOPs' % (sum_cache / 1e6))
print('  加速比 ≈ %.0fx(量级 = T/3,T 越大越明显)' % (sum_no / sum_cache))
# 数量级验证:O(T³) vs O(T²)
import math
ratio_asym = (T_total ** 3) / (T_total ** 2)
print('  渐近对比 O(T³)/O(T²) = T = %d:说明加速随 T 线性增长' % T_total)
9. mini-Transformer 学「倒序」:结构即能力
9.1 任务设计
输入 0~6 的数字序列(长度 2~5,不足部分用填充符 7 补齐前方),要求输出倒序:输入 [2, 5, 1] → 期望 [1, 5, 2]。
为什么选这个任务?
- 倒序要求模型知道「位置 $p$ 的输出 = 对侧位置 $L-1-p$ 的输入」——恰好是「位置重排」能力,只有「位置编码 + 注意力」配合才能学;
- 双向注意力(Encoder 风格)可学:每个输出位置只需从输入里「按位置规则」取一个 token,注意力权重矩阵会学成「反恒等」结构;
- 生成第二个 token 时第一个 token 已经可用,所以双向结构不违反任何约束。
对比:若换成 Decoder(因果掩码,只能看左侧),生成第 1 个 token 时只能看到第 1 个输入 token,倒序永远无法开始——结构即能力:不是「训练不够」,是模型结构在数学上就不允许。这是理解 Encoder/Decoder 分工的绝佳例子(面试可以讲这个故事)。
9.2 教学版模型(故意最简,但机制齐全)
输入 -> Embedding(8→32) + 位置参数(32)
     -> 单头双向自注意力(手写公式 Q=XWq, ...)-> 残差 + LayerNorm
     -> FFN(32→64→32) -> 残差 + LayerNorm
     -> 输出投影 32→8 -> softmax 交叉熵
相比完整 Transformer,去掉了:多头(8→1)、多层堆叠(6 层→1 层)、正弦位置编码(用可学习位置参数代替)。保留的三大核心:位置注入 + 自注意力 + FFN/残差/LN——恰恰是「倒序」能力的最小充分集。
9.3 预期结果与消融设计
- 主线:训练 300 步,loss 降到 ~0.01,token 级准确率 > 0.98;
- 消融:把位置编码去掉重训同样步数——模型只剩「无序集合」,倒序无从谈起,准确率应暴跌到接近随机(0~6 共 7 类 ≈ 0.14)附近;
- 结论:位置编码是注意力唯一的位置线索,去掉它就等于「蒙眼排序」。
想自己动手:把
use_pos=False换成use_pos=True之外,还可以试把双向注意力换成因果掩码(在Q@K.T后加masked_fill),观察准确率起不来——亲手体会「结构即能力」。
# ---------- 实验 3:mini-Transformer 学「倒序」(教学版双向注意力 + FFN + 消融) ----------
np.random.seed(0); torch.manual_seed(0)
import torch.nn as nn

# 任务:输入 0~6 的序列,输出倒序(如 [1,3,2] -> [2,3,1])。
# 主线:双向自注意力 + 位置编码(Encoder 风格)——位置编码提供「从哪取」的空间线索;
# 消融:去掉位置编码重训——模型失去空间线索,准确率崩到随机水平,验证位置编码的必要性。
T_in, V_in = 5, 8                       # 长度 5,词表含 0..6 和填充符 7
rng = np.random.default_rng(0)

class MiniTF(nn.Module):
    def __init__(self, use_pos=True):
        super().__init__()
        self.use_pos = use_pos
        self.emb = nn.Embedding(V_in, 32)
        self.pos = nn.Parameter(torch.randn(1, T_in, 32) * 0.05) if use_pos else None
        self.Wq = nn.Linear(32, 32); self.Wk = nn.Linear(32, 32); self.Wv = nn.Linear(32, 32)
        self.ffn = nn.Sequential(nn.Linear(32, 64), nn.ReLU(), nn.Linear(64, 32))
        self.ln1 = nn.LayerNorm(32); self.ln2 = nn.LayerNorm(32)
        self.head = nn.Linear(32, V_in)
    def forward(self, x):
        e = self.emb(x)
        if self.use_pos:
            e = e + self.pos                          # 位置编码加在 embedding 之后、注意之前
        Q = self.Wq(e); K = self.Wk(e); V = self.Wv(e)
        sc = Q @ K.transpose(-1, -2) / math.sqrt(32)
        p = torch.softmax(sc, dim=-1)                 # 双向:Encoder 风格(无因果掩码)
        a = self.ln1(e + p @ V)                       # 残差 + LayerNorm
        a = self.ln2(a + self.ffn(a))                 # 残差 + LayerNorm
        return self.head(a)

def gen_batch(n=96):
    xs, ys = [], []
    for _ in range(n):
        L = int(rng.integers(2, 6))                       # 随机长度 2..5
        seq = rng.integers(0, 7, size=L).tolist()
        xs.append([7] * (T_in - L) + seq)               # 前补填充符 7
        ys.append(list(reversed(seq)) + [7] * (T_in - L))
    return torch.tensor(xs), torch.tensor(ys)

def train(model, steps, print_every=100):
    opt = torch.optim.Adam(model.parameters(), lr=5e-3)
    losses = []
    for ep in range(steps):
        xb, yb = gen_batch()
        logits = model(xb)
        loss = nn.functional.cross_entropy(logits.permute(0, 2, 1), yb)
        opt.zero_grad(); loss.backward(); opt.step()
        losses.append(loss.item())
        if print_every and ep % print_every == 0:
            print('  ep %3d loss %.3f' % (ep, loss.item()))
    return losses

def evaluate(model, n=300):
    with torch.no_grad():
        xb, yb = gen_batch(n)
        pred = model(xb).argmax(-1)
        # 只看非填充位置(填充位置不参与倒序)
        ok = ((pred == yb) | (yb == 7)).float().mean().item()
    return ok

print('【主线】带位置编码的双向注意力:')
model = MiniTF(use_pos=True)
losses = train(model, 300)
acc = evaluate(model)
print('倒序任务 token 级准确率(填充位置除外): %.3f' % acc)
assert acc > 0.95, '带位置编码时准确率必须 > 0.95'

print('\n【消融】去掉位置编码重训 200 步:')
model_no = MiniTF(use_pos=False)
_ = train(model_no, 200)
acc_no = evaluate(model_no)
print('无位置编码准确率: %.3f(随机猜测 ≈ 1/7 ≈ 0.14)' % acc_no)
assert acc_no < acc - 0.3, '去掉位置编码后准确率应显著下降(消融成立)'

# 演示一例
x0, y0 = gen_batch(1)
with torch.no_grad():
    p0 = model(x0)[0].argmax(-1).tolist()
L0 = (x0[0] != 7).sum().item()
print('示例  输入:', x0[0][-L0:].tolist(), ' 期望:', y0[0][-L0:].tolist(), ' 预测:', p0[-L0:])

# loss 曲线
plt.figure(figsize=(6, 3.5))
plt.plot(losses)
plt.xlabel('训练步'); plt.ylabel('loss'); plt.title('mini-Transformer 倒序任务 loss 曲线(带位置编码)')
plt.grid(alpha=0.3); plt.tight_layout(); plt.show()
10. 局限与演进:$O(T^2)$ 怎么破
10.1 瓶颈回顾
自注意力的时间与显存都是 $O(T^2)$:$T=32$K 的上下文 → 约 10 亿个注意力权重元素;128K 长文档 / 多轮对话直接不可行。这是 Transformer 唯一的「结构性痛点」,也催生了一整条研究线——面试时能把这条线讲清楚非常加分。
10.2 演进路线(名字 + 一句话,够用且准确)
| 方向 | 代表工作 | 核心思想 |
|---|---|---|
| 稀疏注意力 | Sparse Transformer / Longformer | 只算局部窗口 + 少数全局位置,$O(T)$ 或 $O(T\sqrt{T})$ |
| 低秩近似 | Linformer | 把 $T\times T$ 的注意力压成 $T\times k$($k\ll T$),线性复杂度 |
| 核方法 | Performer(FAVOR+) | 用随机特征近似核 $e^{q\cdot k}$,把注意力线性化 |
| 硬件融合 | FlashAttention(当前主流) | 分块(tiling)+ 不落显存,IO 复杂度 $O(T^2d^2/M)$;数学不变但省显存几十倍、提速数倍 |
| 位置改造 | RoPE / ALiBi | 让注意力分数自带相对位置,顺带获得长度外推 |
| 状态空间 | Mamba (SSM) | 用选择性扫描代替注意力,推理 $O(T)$,长程记忆靠隐状态 |
记忆口诀:数学上绕不过 $O(T^2)$,就用稀疏/低秩/线性近似;工程上显存是瓶颈,就用 FlashAttention。为什么 flash-attn 快?——它优化的是「IO 复杂度」(把矩阵分块放在 SRAM 里算,不反复读写显存),而不是改变计算量。大模型时代这道题的答案几乎必考。
10.3 全篇一句话总结
RNN 串行+长依赖弱 → 注意力(全连接 + 可学习权重的加权混合)→ 补上缩放(√d_k 防饱和)、多头(多关系子空间)、位置编码(恢复顺序)、残差+LN(深层可训)→ 组装成 Encoder/Decoder → 生成时靠因果掩码 + KV cache 高效自回归 → 剩下的就是 $O(T^2)$ 这个「甜蜜的烦恼」,交给 FlashAttention 与新一代架构。
10.4 Transformer 家族谱系与延伸阅读(知识地图)
一幅「族谱」把散落的论文串成一条线:
Transformer (2017)
├── 编码器系:BERT (2018) → RoBERTa / ALBERT / ELECTRA / DeBERTa   理解型
├── 解码器系:GPT-1/2/3 (2018-2020) → GPT-4 / LLaMA / Mistral      生成型
├── 编解码系:T5 / BART (2019-2020)                                 文本到文本
├── 效率系:稀疏注意力 / Linformer / Performer / FlashAttention    打 O(T²)
├── 位置系:RoPE / ALiBi / 相对位置矩阵                             打位置编码
└── 替代系:Mamba (SSM) / RWKV                                      打注意力本体
延伸阅读(按这个顺序吃,性价比最高):
- 原论文《Attention Is All You Need》(Vaswani et al., 2017)——必读,公式直接对本篇;
- 《The Illustrated Transformer》(Jay Alammar 博客,中文社区有译文)——把图 3 逐块讲透;
- 《The Annotated Transformer》(Harvard NLP)——PyTorch 逐行实现,可与实验 1/2 对读;
- FlashAttention 论文(Dao et al., 2022)——「IO 复杂度」的原始出处,回答 10.2 的「为什么快」;
- 《Attention? Attention!》(Lilian Weng 博客)——注意力全景综述,覆盖加性/点积/多头的前世今生。
🎯 学习法:每读完一篇就回来对照本笔记本的实验,把「论文公式 ↔ 手写代码 ↔ 可视化输出」三者对齐一遍——这比再读十篇综述都管用。
11. 数字敏感度与易错点(背诵)
必背数字
- 缩放因子 $\sqrt{d_k}$;论文配置 $d_{model}=512$、$h=8$、$d_k=d_v=64$;
- FFN 中间维度 = $4\times d_{model}$(512→2048);
- 复杂度:自注意力时间/空间 $O(T^2 d)$;FFN $O(T d^2)$;KV cache 后逐 token 生成 $O(T^2)$ 而非 $O(T^3)$;
- 正弦编码 $PE_{p,2i}=\sin(p/10000^{2i/d})$,波长 $2\pi\to2\pi\times10^4$ 几何级数;
- 参考系:BERT-base 12 层 / 110M 参数;GPT-3 96 层 / 175B 参数。
易错点(面试官最爱挖的坑)
- 掩码填充用
-inf不是 0——0 会在 softmax 里变成「加分项」,未来信息照样漏进来; - 掩码加在 softmax 之前的分数上,不是之后;
- Decoder 掩码是下三角,对角线(自己)允许看;
- LayerNorm 沿特征维(最后一维)归一化,不是序列维;
- 位置编码加在 embedding 之后、注意力之前;
- softmax 手写要「减 max」防溢出(实验 1 已演示);
- 多头拼接后必须过 $W_O$,否则维度和容量都对不上;
- KV cache 缓存 K 和 V,不缓存 Q(Q 每步都是新的)。
12. 面试速答(30 秒背诵版)
- 注意力公式:$\text{softmax}(QK^\top/\sqrt{d_k})V$;除 $\sqrt{d_k}$ 是因为点积方差 $\propto d_k$,不缩放会让 softmax 饱和、梯度消失。
- Q/K/V 从哪来:自注意力里都是输入线性投影($XW_Q$ 等);交叉注意力里 Q 来自解码器、K/V 来自编码器。
- 复杂度:自注意力 $O(T^2d)$(时间与空间同阶);KV cache 后推理 $O(T^2)$。
- 多头维度口算:$d_{model}=512,h=8\to d_k=64$;拼接 $(T,64)\times8\to(T,512)\to W_O$;参数与单头一致。
- 因果掩码怎么实现:
scores.masked_fill(torch.triu(torch.ones(T,T), diagonal=1).bool(), float('-inf')),再 softmax。 - Encoder vs Decoder:Encoder 双向自注意力;Decoder 掩码自注意力 + 交叉注意力(K/V 来自 Encoder)。
- 为什么需要位置编码:注意力是集合运算、丢顺序;sin/cos 编码让相对位置可用固定线性变换(旋转)表示,且能外推。
- 主流演进:FlashAttention(IO 优化,省显存)、稀疏注意力、Linformer(低秩)、Performer(核方法)、RoPE/ALiBi(相对位置)。
13. 自测清单
手写题
- 不查资料默写 Attention 公式,并解释每一步的矩阵维度
- 手写稳定版 softmax(减 max)与缩放点积注意力,与
F.scaled_dot_product_attention对照 <1e-5 - 手写多头(h 组投影 + 拼接 + out_proj),与
nn.MultiheadAttention对照 - 手写因果掩码(下三角 -inf)并验证 softmax 后上三角全 0
- 生成 sin/cos 位置编码,数值验证「相对位置 = 固定线性变换」
口算题
- $d_{model}=512,h=8$ → 每头维度?(64);$h=16$ 呢?(32)
- 自注意力时间/空间复杂度?($O(T^2d)$);KV cache 后推理?($O(T^2)$)
- FFN 中间维度?($4\times d_{model}=2048$)
- 生成 $T=1024$ 序列,KV cache 相比朴素解码注意力省约多少倍?(量级 $T/3$)
概念题
- 为什么除 $\sqrt{d_k}$ 而不是 $d_k$?(把方差归一回到 1)
- 多头为什么有效?(不同子空间学不同关系,参数量不变)
- 因果掩码为什么用
-inf不用 0? - 自注意力 vs 交叉注意力中 Q/K/V 分别来自哪里?
- 位置编码加在哪一步?去掉位置编码(消融实验)会发生什么?
- 为什么 FlashAttention 快?(IO 复杂度,分块不落显存)
💡 下一篇
05-预训练模型与微调把 Transformer 放大成 BERT/GPT:掩码语言模型(80/10/10 规则)、双向 vs 自回归、预训练-微调范式与 Prompt/RLHF——届时你会频繁用到本篇的掩码与自回归心智模型。