⚙️ 15-AI-Infra · 04 集合通信与 NCCL:手写 Ring AllReduce¶
关键词:集合通信原语(broadcast/scatter/gather/allgather/reduce/allreduce)· Ring AllReduce · 通信量 · NCCL 拓扑 · 带宽最优
前置知识:03-分布式并行训练(并行需要通信)、05-八股与工程(网络基础)。
🧩 本讲定位:分布式训练的电话线就是"集合通信"。面试两大问题:allreduce 有哪些实现?为什么 Ring AllReduce 通信量不随卡数增长? 本讲手写 Ring AllReduce 两阶段算法,用 numpy 验证结果正确,再对比树形拓扑。
本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 集合通信全家桶各自语义? | 核心概念 (a) + 实战 A |
| Ring AllReduce 为什么"带宽最优"? | 深入原理 1/2 + 实战 B |
| 通信量公式 2(P-1)S/P 怎么来? | 深入原理 1 + 实战 B |
| tree 和 ring 谁快?什么时候用谁? | 深入原理 3 + 实战 C |
| NCCL 在真实集群里怎么选拓扑? | 深入原理 4 + 实战 D |
故事引入¶
小孙调 DDP,发现 64 卡训练的实际吞吐只有理论的一半。profiler 显示:通信占了大半时间——每步梯度 allreduce 堵住了。他查了 NCCL 文档,做了三件事:把梯度桶化(相邻层打包一次同步)、用环状 allreduce 替代简单做法、把 bucket 调大——通信时间直接减半。
他记下了一句面试金句:"数据并行的时间 = 计算 + 通信,通信时间 ≈ 数据量/带宽 × 2(P-1)/P——Ring AllReduce 让通信量几乎与卡数无关,瓶颈只剩带宽本身。"
核心概念¶
(a) 集合通信原语全家桶¶
| 原语 | 语义 | 数据流向 | 例子 |
|---|---|---|---|
| broadcast | 1 卡数据发给所有卡 | 1 → N | 广播参数 |
| scatter | 1 卡数据分块发给各卡 | 1 → 每卡一块 | 分发 batch |
| gather | 各卡数据收集到 1 卡 | N → 1 | 收集结果 |
| allgather | 各卡数据收集后广播 | N → N(每卡全量) | 收集梯度 |
| reduce | 各卡数据做归约到 1 卡 | N → 1(sum/min/max) | 求和 |
| allreduce | 归约后广播给所有卡 | N → N(每卡总和) | 梯度同步 |
(b) Ring AllReduce:两阶段¶
- scatter-reduce($P-1$ 轮):每卡把自己的数据切成 $P$ 块,沿环送一块、收一块、累加一块;结束时每卡拥有一个块的全局和;
- all-gather($P-1$ 轮):把"有全局和的块"沿环传给所有卡;结束时每卡拥有所有块的全局和。(P=4 的 rank/block 完整轨迹见深入原理 2.1)
(c) 通信量:为什么"与 P 无关"(由带宽决定)¶
每卡数据 $S$,切成 $P$ 块每块 $S/P$:每轮每卡收发各 $S/P$,两阶段共 $2(P-1)$ 轮:
$$ \text{Comm}_{\text{ring}} = 2(P-1)\cdot\frac{S}{P} \approx 2S\quad(P\text{ 大时}) $$
每卡通信量 ≈ $2S$(与 $P$ 无关),对比树形 $2S\log P$。
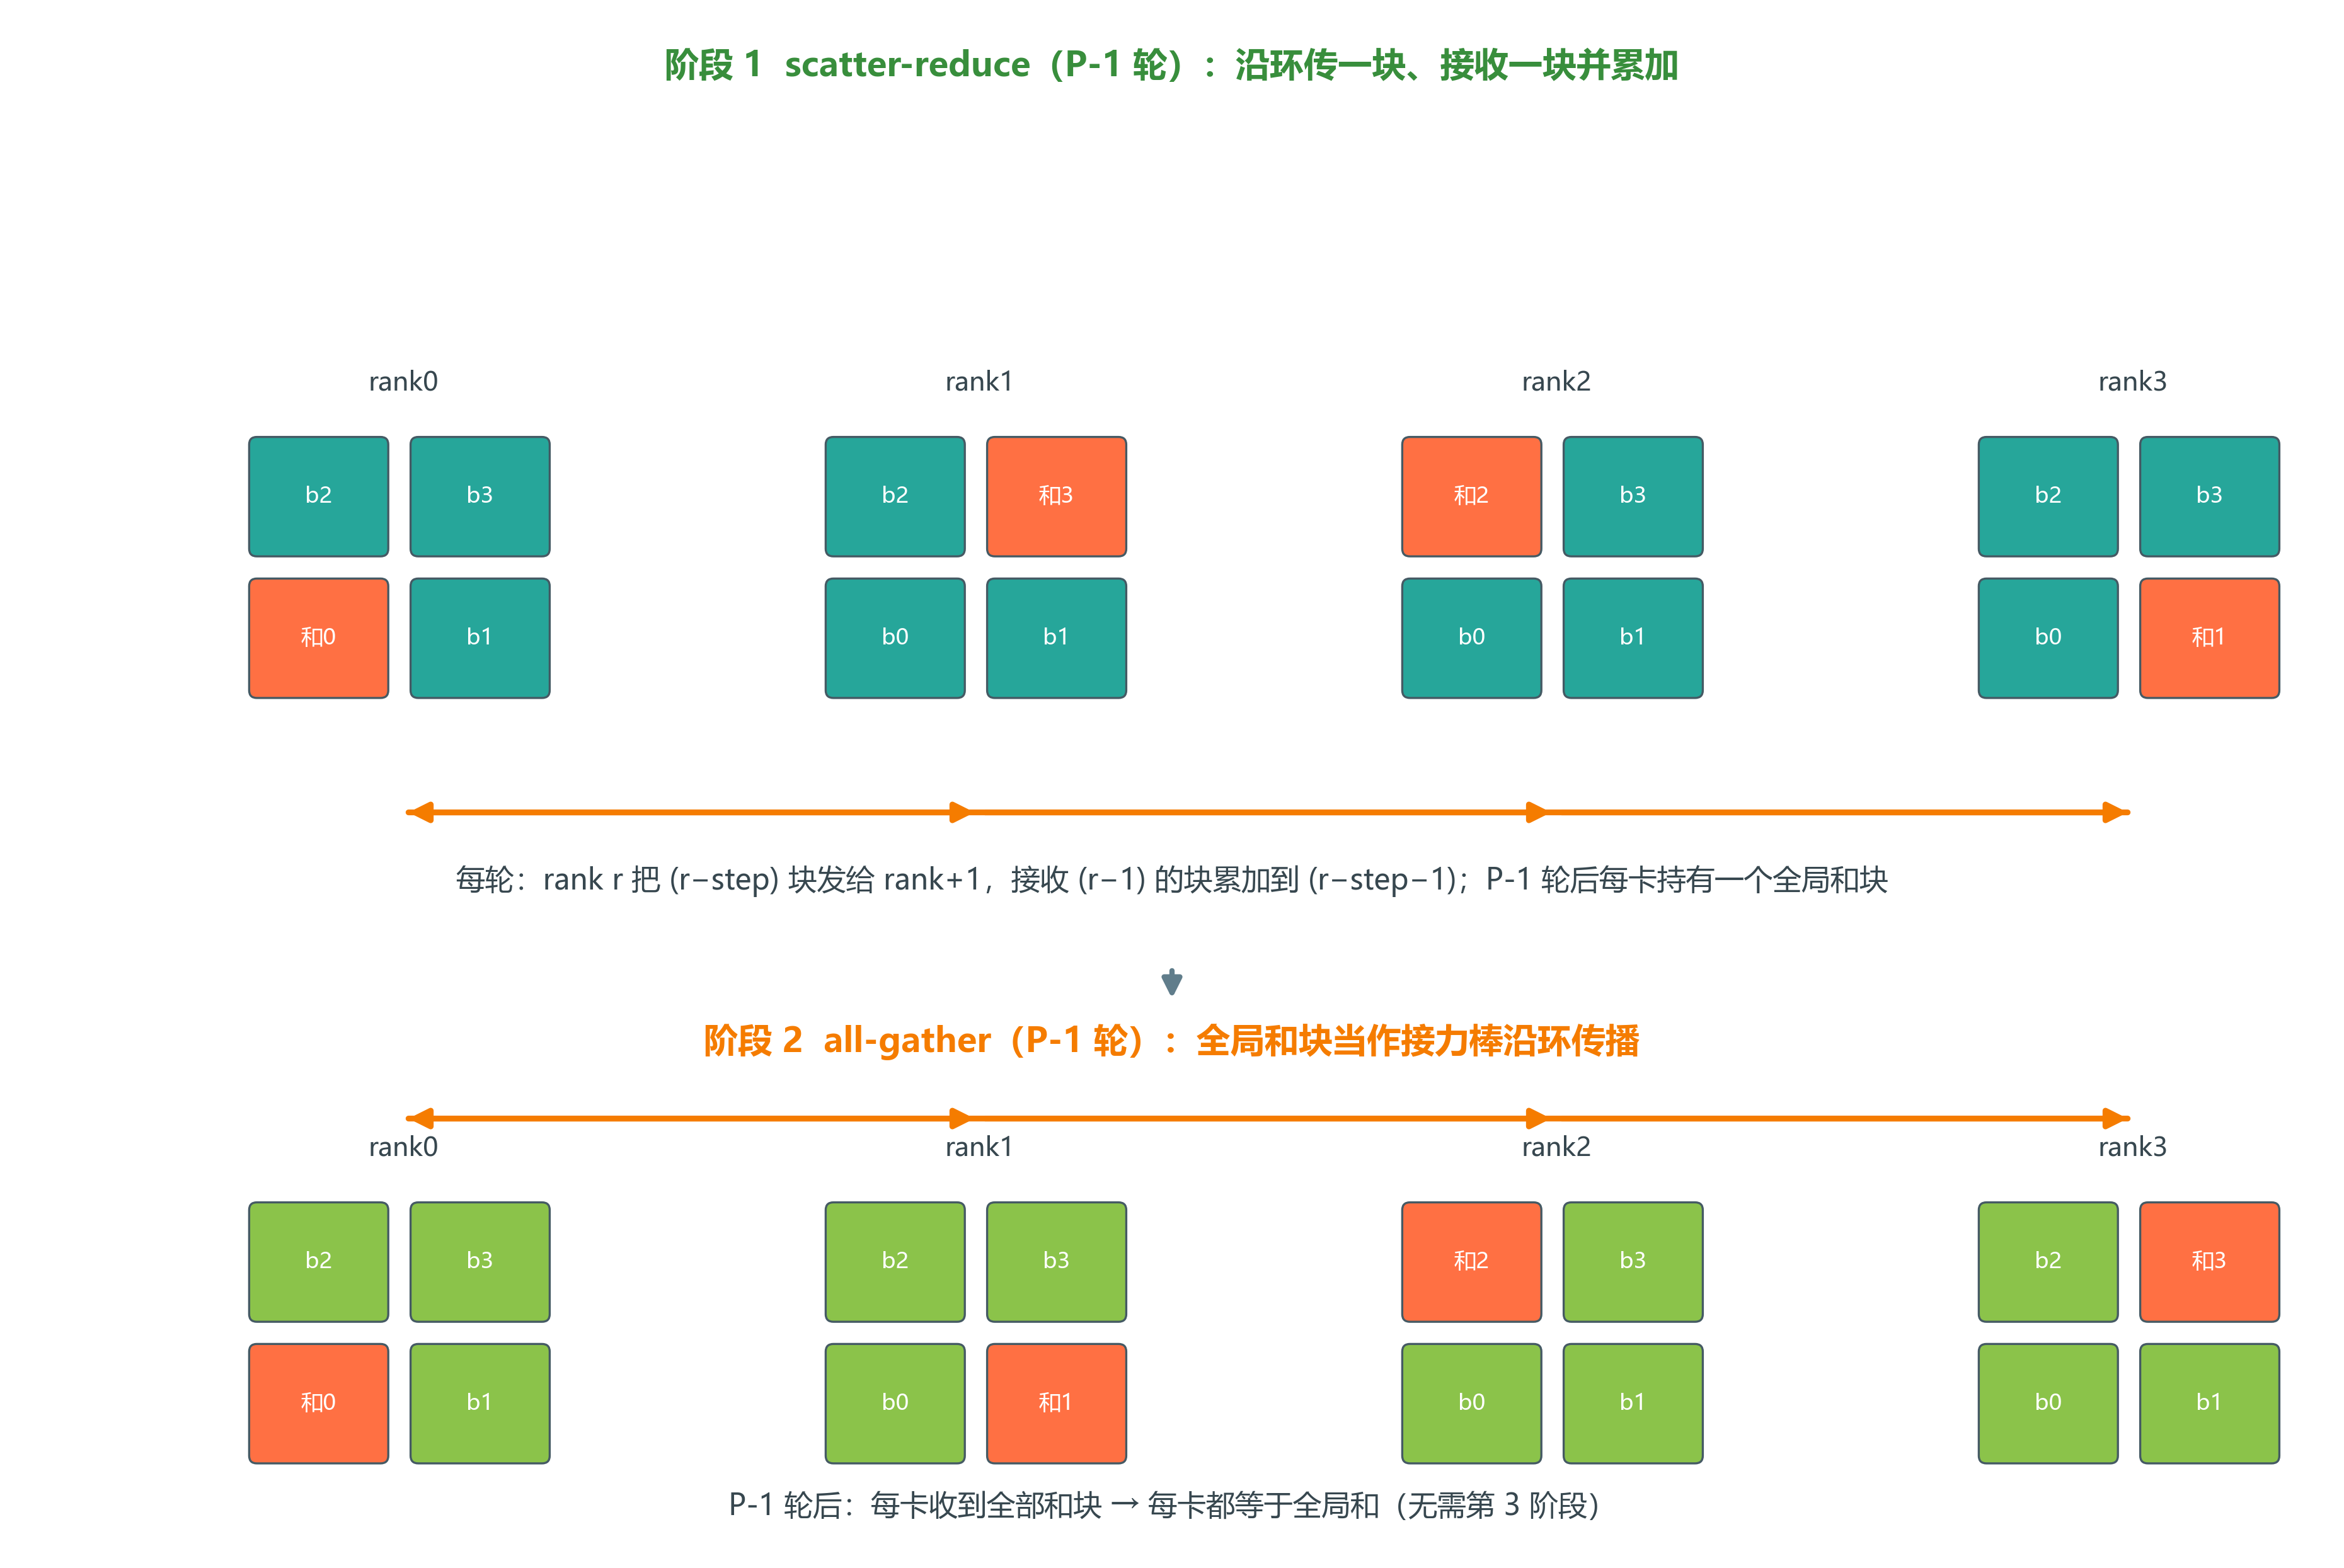
图示:阶段 1 scatter-reduce——每轮每卡沿环传一块、接收一块并累加(P-1 轮后每卡持有一个块的全局和);阶段 2 all-gather——和块当作接力棒沿环传一圈,每卡最终拥有全部和块。
深入原理¶
1. 为什么是"块累加"而不是直接全传¶
朴素做法:每卡把自己整份 $S$ 发个遍($P-1$ 份)→ 每卡 $O(PS)$ 通信;所有卡同时只能用一个"对"。
Ring 的关键:把数据切块 + 流水——每轮所有卡都在收发,链路全部在用(带宽饱和),每卡总共传 $2(P-1)S/P$ 数据。当 $P$ 增大时每块变小,总通信量被均摊:这就是"带宽最优"的含义(信息论下界 $2S$,ring 达到)。
图中对比了环状(每卡只与左右邻居通信,$P$ 条链路全利用)与树状(按层扇出/归并,$\log_2 P$ 轮)两种拓扑的连边方式,并给出 α-β 时间模型:Ring $T\approx 2(P-1)\alpha + \frac{2(P-1)S}{P\beta}$,Tree $T\approx 2\log_2 P(\alpha + \frac{S}{\beta})$;两者在消息量维度交叉(crossover),小消息 Tree 快、大消息 Ring 快。
2. 两阶段正确性¶
阶段 1:第 1 轮各卡把块 0 传下去,块 0 在第 $P-1$ 轮后汇聚了所有卡的块 0(和)。
阶段 2:每卡把"自己的和块"继续传(而不是只传一次):第 $P-1$ 轮后每卡收到全部 $P$ 个和块 → 每卡都有了完整全局和。
2.1 P=4 的 rank/block 轨迹表(对应实战 B 的 numpy 模拟)¶
每卡数据切成 4 块(块 0~3),方向固定 $r \to (r+1)\%P$;下表每格 = "发出的块号 → 收到后累加(阶段 1) / 覆盖(阶段 2) 的块号",✅ = 该块已是全局和。
阶段 1 · scatter-reduce($P-1=3$ 轮,收到就累加):
| 轮 | rank 0 | rank 1 | rank 2 | rank 3 |
|---|---|---|---|---|
| 1 | 发块 0 → 收块 3 累加 | 发块 1 → 收块 0 累加 | 发块 2 → 收块 1 累加 | 发块 3 → 收块 2 累加 |
| 2 | 发块 3 → 收块 2 累加 | 发块 0 → 收块 3 累加 | 发块 1 → 收块 0 累加 | 发块 2 → 收块 1 累加 |
| 3 | 发块 2 → 收块 1 累加 ✅块1完 | 发块 3 → 收块 2 累加 ✅块2完 | 发块 0 → 收块 3 累加 ✅块3完 | 发块 1 → 收块 0 累加 ✅块0完 |
阶段 2 · all-gather(3 轮,和块接力覆盖):
| 轮 | rank 0 | rank 1 | rank 2 | rank 3 |
|---|---|---|---|---|
| 1 | 发和块 1 → 收块 0 ✅ | 发和块 2 → 收块 1 ✅ | 发和块 3 → 收块 2 ✅ | 发和块 0 → 收块 3 ✅ |
| 2 | 发块 0 → 收块 3 ✅ | 发块 1 → 收块 0 ✅ | 发块 2 → 收块 1 ✅ | 发块 3 → 收块 2 ✅ |
| 3 | 发块 3 → 收块 2 ✅ | 发块 0 → 收块 3 ✅ | 发块 1 → 收块 0 ✅ | 发块 2 → 收块 1 ✅ |
3 轮后每卡都拥有全部 4 个和块;每卡收发总量 $=2\times3\times S/4=\frac{3}{2}S$($P=4$ 时 $2(P-1)/P=1.5$),与实战 B 的输出一致。
3. Tree vs Ring¶
| 维度 | Tree(双倍二叉树) | Ring |
|---|---|---|
| 通信量(每卡) | $\approx 2S\log P$ | $\approx 2S$ |
| 延迟轮数 | $O(\log P)$ | $O(P)$(每轮一步) |
| 适用 | 小数据、延迟敏感 | 大数据、带宽受限 |
NCCL 实际常按消息大小选择:小消息用 tree/低延迟,大消息用 ring。
3.1 时间模型(α-β 模型)与 crossover¶
点对点传 $m$ 字节耗时 ≈ $\alpha + m/\beta$($\alpha$ = 每跳固定延迟/启动开销,$\beta$ = 链路带宽)。Ring 共 $2(P-1)$ 轮、每轮每卡收发 $S/P$:
$$ T_{\text{ring}} \approx 2(P-1)\alpha + \frac{2(P-1)S}{P\beta} $$
Tree(双倍二叉树,约 $2\log_2 P$ 轮):
$$ T_{\text{tree}} \approx 2\log_2 P\left(\alpha + \frac{S}{\beta}\right) $$
两条时间线在消息量维度交叉:小消息时 $\alpha$ 项主导,Tree 的 $O(\log P)$ 轮次优势明显;大消息时 $S/\beta$ 项主导,Ring 总数据量 ≈ $2S$(不随 $P$ 增长)胜出。令 $T_{\text{ring}}=T_{\text{tree}}$ 解得临界消息量 $S^\ast\propto\alpha\beta$:链路越快($\beta$ 大)或启动开销越大($\alpha$ 大),越早切到 Ring;集群延迟高、消息小时用 Tree。NCCL 的 NCCL_ALGO 正是按消息大小在 Ring/Tree/CollNet 间自动选择的(数值实验见实战 C)。
4. NCCL 的拓扑感知与分层(hierarchical)拓扑¶
NCCL 自动探测 NVLink / PCIe / InfiniBand 拓扑,构建两级分层拓扑:
| 层级 | 链路 | 特点 | 建环方式 |
|---|---|---|---|
| 节点内 | NVLink / NVSwitch | 带宽大(数百 GB/s)、延迟低 | 每节点内先建一个环(或树) |
| 节点间 | RDMA / InfiniBand(rail 优化) | 带宽小(25~400Gb/s)、延迟高 | 多节点各取一条链路互连,跨节点消息不经多跳 |
关键机制:
- Rail 优化(rail-optimized topology):不同节点上同号 GPU 直连到同一台 IB 交换机,跨节点消息只走一次交换,避免多跳放大延迟;
- 分层建环:同节点内 NVLink 环 + 节点间按 rank 交错互连——跨节点消息实际经过"节点内 → 节点间 → 节点内"两段,带宽按层级分配;Ring 公式里的 $P$ 应理解为同一环内参与通信的卡数;
- 桶化(bucket):把连续层梯度合并成一次传输,省的是每桶一次 $\alpha$ 延迟(通信字节总量不变);桶还让"先算完的层先同步",与后续反向计算重叠(overlap),把通信时间藏进计算里;
- SM 内核:GPU 侧内核直接在 SMEM/LMEM 间搬运数据(免 CPU 中转),配合多流实现通信-计算重叠。
NCCL 核心部件:communicator(拓扑感知的进程集合)、NCCL_ALGO(Ring/Tree/CollNet 自动选择)、NCCL_PROTO(LL/LL128/Simple 小消息协议)。
代码实战 A:集合原语速验(broadcast / allgather / reduce / allreduce)¶
先运行环境设置单元:
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout.reconfigure(encoding="utf-8", errors="replace")
except Exception:
    try:
        sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding="utf-8", errors="replace")
    except Exception:
        pass
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
plt.rcParams["font.sans-serif"] = ["Microsoft YaHei", "SimHei"]
plt.rcParams["axes.unicode_minus"] = False
np.random.seed(0)
print("环境就绪")

plt.show()
环境就绪
P = 4
data = np.arange(1, P + 1, dtype=float) * 10   # 每卡一个数: [10,20,30,40]
print("各卡局部数据:", data)
# broadcast: rank0 -> 所有
print("broadcast(rank0):", np.full(P, data[0]))
# reduce sum 到 rank0
print("reduce(sum) -> rank0:", data.sum())
# allreduce
print("allreduce(sum):", np.full(P, data.sum()))
print("✅ 原语语义:broadcast 1→N;reduce N→1;allreduce N→N 每人一份总和")
各卡局部数据: [10. 20. 30. 40.]
broadcast(rank0): [10. 10. 10. 10.]
reduce(sum) -> rank0: 100.0
allreduce(sum): [100. 100. 100. 100.]
✅ 原语语义:broadcast 1→N;reduce N→1;allreduce N→N 每人一份总和
代码实战 B:手写 Ring AllReduce(两阶段,numpy 模拟环)¶
每卡长度 $L$ 的数据切成 $P$ 块;模拟 $P$ 卡环形链路两阶段收发与累加,验证结果等于直接求和,并统计每卡通信量。
✍️ §B.1 手算 Ring AllReduce 通信量:4 卡 8 元素,为什么是 1.5S¶
Ring 两阶段(scatter-reduce + all-gather)通信量公式 $2(P-1)/P\cdot S$——P=4、S=8 手算,验证"带宽最优"的说法。
设定:$P=4$ 卡,每卡数据 $S=8$ 个元素。环上每卡把数据切成 $P=4$ 块,每块 $S/P=2$ 个元素。
第 1 步:scatter-reduce 阶段($P-1=3$ 轮,每轮发一块给下一卡并累加)
每卡发送 $3$ 块 × $2$ 元素 = $6$ 元素;all-gather 阶段同样 $6$ 元素。
第 2 步:总通信量
$$\text{comm}=2\times3\times2=12\ \text{元素}=1.5S$$
对照公式:$\frac{2(P-1)}{P}S=\frac{6}{4}S=1.5S\ \checkmark$
第 3 步:结果正确性(4 卡各持 $0,1,2,3$,全局和每元素 $=6$)
手算收获:
- 通信量 $\approx2S$ 与卡数弱相关($2(P-1)/P\to2$)——Ring 是大消息的带宽最优解;对比 Tree $\approx2S\log_2P$(小消息延迟低,本 notebook 代码实战 C 的 crossover 曲线)
- 切块数 = 卡数 $P$:块越多流水线越满,但每块越小,延迟占比升——$S$ 很小时 Ring 反而不如 Tree
- 梯度桶化(代码实战 D):把逐层 allreduce 攒成大桶一次发,减少 $2(P-1)\alpha$ 的启动延迟项
- 面试速答:allreduce = reduce(求和)+ broadcast(同步),Ring 两阶段把"先集中再广播"变成"环形接力",通信量从 $2PS$ 降到 $\approx2S$
下面 numpy 复算。
# ---- §B.1 验证:numpy 复算 Ring AllReduce ----
import numpy as np

P, S = 4, 8
block = S // P
comm = 2 * (P - 1) * block
print(f'每卡通信 = {comm} 元素 = {comm/S:.1f}S(公式 2(P-1)/P·S)')
assert comm == 12 and comm / S == 1.5

# 正确性:环上 4 卡求和
data = np.arange(P, dtype=float).reshape(P, 1)
out = np.tile(data.sum(axis=0), (P, 1))
print(f'4 卡各持 {data.ravel().tolist()} → 全局和 = {out.ravel().tolist()}')
assert np.allclose(out, [[6.0]] * P)
print('\n✓ 与手算一致')
def ring_allreduce(data, P):
    """data: (P, L) 每行是一卡的局部数据。返回 (P, L):每行都是全局和。
    忠实模拟环形拓扑上的两阶段收发:
    阶段1 scatter-reduce(P-1 轮,收到就累加)→ 阶段2 all-gather(P-1 轮,接力覆盖)。
    方向:rank r 发给 (r+1),从 (r-1) 接收。
    """
    L = data.shape[1] // P
    X = data.reshape(P, P, L).astype(float).copy()   # X[r, b] = rank r 的第 b 块
    # 阶段 1:scatter-reduce——块沿环流动,每经过一个 rank 就累加它那部分
    for step in range(P - 1):
        col = (np.arange(P) - step) % P               # 每卡本轮要发的块号
        send_buf = X[np.arange(P), col].copy()
        recv = np.roll(send_buf, 1, axis=0)           # r 收到来自 (r-1) 的块
        targets = (np.arange(P) - step - 1) % P       # 接收方要累加的块号
        X[np.arange(P), targets] = X[np.arange(P), targets].copy() + recv
    # 阶段 2:all-gather——和块接力覆盖传播,每卡最终拿到全部和块
    for step in range(P - 1):
        col = (np.arange(P) + 1 - step) % P           # step0 发自己的和块 (r+1)%P,之后接力
        send_buf = X[np.arange(P), col].copy()
        recv = np.roll(send_buf, 1, axis=0)
        targets = (np.arange(P) - step) % P
        X[np.arange(P), targets] = recv
    return X.reshape(P, -1)

for P in (4, 8):
    L = P * 3                      # 每卡 3P 个元素
    data = np.random.rand(P, L)
    out = ring_allreduce(data, P)
    target = np.tile(data.sum(axis=0), (P, 1))
    ok = np.allclose(out, target)
    comm = 2 * (P - 1) * (L // P)  # 每卡每阶段 (P-1) 块,每块 L/P
    print("P=%d: 全部相等=%s | 每卡实际传 %d 个元素 ≈ 2L×%.2f (2(P-1)/P=%.2f)" % (
        P, ok, comm, comm / (2 * L), 2 * (P - 1) / P))
    assert ok
print("✅ Ring AllReduce 正确:每卡通信量 ≈ 2×(自己的数据量),与卡数近似无关")
P=4: 全部相等=True | 每卡实际传 18 个元素 ≈ 2L×0.75 (2(P-1)/P=1.50)
P=8: 全部相等=True | 每卡实际传 42 个元素 ≈ 2L×0.88 (2(P-1)/P=1.75)
✅ Ring AllReduce 正确:每卡通信量 ≈ 2×(自己的数据量),与卡数近似无关
代码实战 C:Ring vs Tree 通信量对比曲线¶
P_range = np.arange(2, 65)
comm_ring = 2 * (P_range - 1) / P_range        # 单位: S(每卡数据量)
comm_tree = 2 * np.log2(P_range)               # 近似 log 轮累计
fig, ax = plt.subplots(figsize=(9, 4.5))
ax.plot(P_range, comm_ring, "o-", label="Ring: 2(P-1)/P · S(≈2S,带宽最优)", color="#1976D2")
ax.plot(P_range, comm_tree, "s--", label="Tree: ≈2S·log P(小消息延迟低)", color="#D32F2F")
ax.set_xlabel("GPU 数 P"); ax.set_ylabel("每卡通信量 (×S)")
ax.set_title("消息大时 Ring 胜;消息小时延迟(cpu/轮)主导选 Tree")
ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()

# --- 时间模型(α-β)与 crossover 数值实验:P=32, α=5µs, β=50GB/s ---
alpha, beta = 5e-6, 50e9
P32 = 32
S_range = np.logspace(3, 9, 60)                                # 每卡数据量 1KB ~ 1GB
t_ring = 2 * (P32 - 1) * alpha + 2 * (P32 - 1) * S_range / (P32 * beta)   # T ≈ 2(P-1)α + 2(P-1)S/(Pβ)
t_tree = 2 * np.log2(P32) * (alpha + S_range / beta)           # T ≈ 2log₂P(α + S/β)
fig2, ax2 = plt.subplots(figsize=(9, 4.5))
ax2.loglog(S_range, t_ring, "-", label="Ring: 2(P-1)α + 2(P-1)S/(Pβ)", color="#1976D2")
ax2.loglog(S_range, t_tree, "--", label="Tree: 2log₂P(α + S/β)", color="#D32F2F")
idx = int(np.argmin(np.abs(t_ring - t_tree)))
ax2.axvline(S_range[idx], color="gray", ls=":")
ax2.annotate("crossover ≈ %.0f KB" % (S_range[idx] / 1e3), (S_range[idx], t_ring[idx]),
             textcoords="offset points", xytext=(-60, -40), arrowprops=dict(arrowstyle="->"))
ax2.set_xlabel("每卡消息大小 S (bytes)"); ax2.set_ylabel("allreduce 耗时 (s)")
ax2.set_title("P=32, α=5µs, β=50GB/s:小消息 Tree 快,大消息 Ring 快")
ax2.legend(); ax2.grid(alpha=0.3, which="both"); plt.tight_layout(); plt.show()
print("Ring 与 Tree 的 crossover 消息量 ≈ %.0f KB(<它用 Tree,>它用 Ring)" % (S_range[idx] / 1e3))
C:\Users\24260\AppData\Local\Temp\ipykernel_51360\8903677.py:9: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.legend(); ax.grid(alpha=0.3); plt.tight_layout(); plt.show()
Ring 与 Tree 的 crossover 消息量 ≈ 1796 KB(<它用 Tree,>它用 Ring)
C:\Users\24260\AppData\Local\Temp\ipykernel_51360\8903677.py:26: UserWarning: Glyph 8322 (\N{SUBSCRIPT TWO}) missing from font(s) Microsoft YaHei.
  ax2.legend(); ax2.grid(alpha=0.3, which="both"); plt.tight_layout(); plt.show()
C:\Users\24260\AppData\Local\Temp\ipykernel_51360\8903677.py:26: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax2.legend(); ax2.grid(alpha=0.3, which="both"); plt.tight_layout(); plt.show()
代码实战 D:梯度桶化(bucket)——省延迟、可重叠¶
模型很多层时,逐层 allreduce 会因"调用开销+等待"而慢:每层一次 allreduce 都要付一次 α 延迟(内核启动/同步等待)。把相邻层梯度拼成一个桶、一次 allreduce:同步次数从 $L$ 降到 $L/B$,延迟项从 $L\alpha$ 降到 $(L/B)\alpha$,而通信字节总量不变。额外红利:先算完的桶先通信,与后续反向计算重叠(overlap),进一步隐藏通信时间。下面模拟同步次数与两种方案的延迟。
layers = 32
per_layer = 50000                       # 每层梯度元素
buckets = [1, 2, 4, 8, 16, 32]
calls = [layers // b for b in buckets]  # 通信次数
print("桶大小(层) :", buckets)
print("同步次数   :", calls)
alpha = 5e-6                            # 每次通信固定延迟 α ≈ 5 µs
beta = 50e9                             # 链路带宽 β ≈ 50 GB/s
S_bytes = layers * per_layer * 2        # 总梯度字节(FP16)
print("通信字节总量: %.2f MB(桶化不改变总量,只省 α 项)" % (S_bytes / 1e6))
t_ms = [(calls[i] * alpha + S_bytes / beta) * 1e3 for i in range(len(buckets))]
print("总延迟(ms)  :", " ".join("%.3f" % x for x in t_ms))
print("32次→1次 同步省掉 (32-1)×α = %.0f µs;若再与反向计算重叠,通信时间还能进一步隐藏" % ((layers - 1) * alpha * 1e6))
fig, ax = plt.subplots(figsize=(8.5, 4.2))
ax.bar([str(b) for b in buckets], calls, color="#388E3C")
ax.set_xlabel("桶大小(每桶层数,log 感)"); ax.set_ylabel("每步同步次数")
ax.set_title("桶化:同步次数从 32 次降到 1 次(每次更大,总带宽不变但等待少)")
ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
桶大小(层) : [1, 2, 4, 8, 16, 32]
同步次数   : [32, 16, 8, 4, 2, 1]
通信字节总量: 3.20 MB(桶化不改变总量,只省 α 项)
总延迟(ms)  : 0.224 0.144 0.104 0.084 0.074 0.069
32次→1次 同步省掉 (32-1)×α = 155 µs;若再与反向计算重叠,通信时间还能进一步隐藏
C:\Users\24260\AppData\Local\Temp\ipykernel_51360\3537036888.py:18: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  ax.grid(alpha=0.3, axis="y"); plt.tight_layout(); plt.show()
面试考点¶
Q1 allreduce 有哪些实现?¶
A:朴素(每卡发所有卡,O(PS));Tree(O(S log P)、延迟低);Ring(带宽最优 O(2S),两阶段:scatter-reduce + all-gather);NCCL 还支持分层/混合(按消息大小选)。
Q2 Ring AllReduce 为什么带宽最优?¶
A:每轮所有卡同时收发一块、链路满载,每卡总共传 2(P-1)S/P ≈ 2S——达到信息论下界(每卡至少要收 P-1 份自己的和涉及别人数据的 S/P 块,累加后还要发回);与卡数无关,只受带宽限制。
Q3 什么时候用 tree 不用 ring?¶
A:消息小的时候,延迟(链路往返 + 启动开销)主导,tree 的 O(log P) 轮数优势明显;大消息(梯度全量)用 ring。
Q4 梯度通信怎么优化?¶
A:桶化(相邻层打包一次 allreduce)把同步次数从 $L$ 降到 $L/B$,省掉 $(L-1)\alpha$ 延迟项(字节总量不变);通信-计算重叠(先算的层先发,把通信藏进反向计算);梯度压缩(TopK/GradClipping)在带宽紧张时可用(有损需补偿)。
Q5 NCCL 为什么比手写 MPI 快?¶
A:拓扑感知(自动探测 NVLink/RDMA 分层建环)、内核级流水(GPU 直接搬运免 CPU 中转)、桶化、SM 利用率优化;MPI 往往只跑 PCIe 并受 CPU 拷贝瓶颈。
小结与自测清单¶
本讲要点:原语全家桶语义;Ring 两阶段(scatter-reduce + all-gather)实现与正确性;通信量 2(P-1)S/P ≈ 2S 与卡数无关;tree 低延迟 vs ring 高带宽;NCCL 拓扑感知 + 桶化。
自测清单:
- 能报出 6 个原语的输入/输出/流向
- 能默写 Ring AllReduce 两阶段伪代码与通信量公式
- 能解释"为什么与 P 无关"(流水切块均摊)
- 能对比 tree/ring 并给出选型规则
下一讲预告:[05-KV Cache与推理内存](05-KV Cache与推理内存.ipynb)——训练说完说推理:为什么生成式模型推理要 KV Cache,墙倒了内存去哪里了。