00-数学基础 · 概率论与统计
不确定性是世界的常态,而概率论就是给「不确定」配的数学语言。机器学习本质上是从数据里学一个概率模型:分类模型输出的是「属于每一类的概率」,语言模型输出的是「下一个词的概率」,强化学习优化的是「长期收益的期望」。这一篇把概率统计的地基一次性打牢——从随机试验讲到贝叶斯公式,从常见分布讲到中心极限定理,从极大似然估计讲到它们在 ML 里的真实用法。
学完你能回答:贝叶斯公式的每一项在朴素贝叶斯里干什么?正态分布为什么无处不在?频率为什么最终会稳定在概率上?MLE 和神经网络的损失函数是什么关系?
本节要解决的问题
| 要解决的问题 | 对应内容 |
|---|---|
| 抛硬币、掷骰子这类随机现象,怎么用数学描述? | 随机试验与事件、概率公理 |
| 看到新的证据之后,概率怎么「更新」? | 条件概率与贝叶斯公式 |
| 一个随机变量的「全貌」怎么刻画? | 随机变量与概率分布(离散:伯努利 / 二项 / 泊松;连续:均匀 / 正态) |
| 平均水平、波动程度怎么量化?两个变量怎么「一起动」? | 期望、方差、协方差与相关系数 |
| 各分布的期望 / 方差长什么样,怎么速查? | 常见分布参数表 |
| 为什么样本量大了「就准了」?样本均值分布长什么样? | 大数定律与中心极限定理 |
| 数据在手,模型参数怎么估计? | 极大似然估计(MLE) |
| 这些知识在机器学习里到底用在哪? | 朴素贝叶斯 / 损失函数 / 采样 |
故事引入
阿秋刚入职一家奶茶连锁,店长把「雨天备多少杯芋泥波波」的难题交给了他。没看数据时,他只能拍脑袋:昨天晴天卖了 120 杯,那明天呢?于是他开始记录——过去 100 个雨天的销量:最低 95、最高 158,大多数挤在 120 杯上下。把 100 天的数字平均,得到 121.6 杯;而他惊讶地发现,记录的天数越多,这个平均数就越稳定,几乎不再摇摆——这就是大数定律:样本多了,平均值就「钉」在真实水平附近。他又把销量画成柱状图,发现形状像一座钟:中间高、两边低、左右对称——这就是正态分布,测量误差、身高、考试分数都长这样。接着他想:凭什么平均数就是「最好的估计」?他写下一条准则——「选一个参数 θ,让当前这批数据出现的概率最大」,这就是极大似然估计:后来他发现,这不就是店里预测销量、也是机器学习里交叉熵损失的同一个原理吗?最后,他翻到店里的联合记录:「下雨且卖爆」的历史数据里藏着一个秘密——已知「卖爆」的情况下,是雨天的概率有多大?算出来他吓一跳:这需要贝叶斯公式——先验、似然、证据、后验四件套。三年后,他把这套逻辑写进推荐系统,发现「给用户推他大概率会点的那一杯」和当年按概率备货,是同一个数学动作。概率统计,就是给「不确定」做决定的科学。
核心概念
(a) 🗂️ 概率论与统计:从「随机试验」到「用数据说话」的知识主干
概率论回答「在已知模型的条件下,事件会以多大可能性发生」;统计回答反过来——「只看数据,模型 / 参数最可能是什么」。机器学习横跨两者:先假定一个分布(建模),再用数据把参数估计出来(统计)。下图是整篇的地图,先看整体,再逐个击破。
flowchart TB
    A["🧠 随机试验与事件<br/>样本空间、概率公理"] --> B["🧠 条件概率与贝叶斯公式<br/>先验 → 证据 → 后验"]
    A --> C["🧠 随机变量<br/>把结果变成数字"]
    C --> D["🧠 离散分布<br/>伯努利 / 二项 / 泊松"]
    C --> E["🧠 连续分布<br/>均匀 / 正态"]
    D --> F["🧠 期望与方差<br/>中心与波动"]
    E --> F
    B --> F
    F --> G["🧠 协方差与相关系数<br/>两个变量一起动"]
    F --> H["🧠 大数定律 & 中心极限定理<br/>样本逼近总体"]
    H --> I["🧠 极大似然估计<br/>用数据反推参数"]
    G --> J["🧠 ML 应用<br/>朴素贝叶斯 / 损失 / 采样"]
    I --> J
- 随机试验与事件:能重复、结果不确定但可枚举的试验(抛硬币、掷骰子),所有结果的集合叫样本空间,我们关心的子集叫事件。这是概率论的「原料」。
- 条件概率与贝叶斯公式:已知某个条件发生后,重新评估事件的概率。贝叶斯公式把它写成「先验 × 似然 ÷ 证据」,是「用数据更新信念」的万能模板,朴素贝叶斯分类器就是它的直译。
- 随机变量:把随机试验的每个结果映射成一个数字(正面 = 1、反面 = 0)。一旦有了数字,就能算均值、方差、画分布图,概率论就从「描述」进入「计算」。
- 离散分布:结果是可数个的分布(硬币、骰子、计数)。伯努利是一次试验的成败,二项是 n 次独立重复试验的成功次数,泊松是「稀有事件计数」模型。
- 连续分布:结果充满某个区间(身高、误差、时间)。均匀分布是区间内等可能,正态分布是自然界与误差的「默认分布」,也是中心极限定理的终点。
- 期望与方差:期望是「长期平均」的中心位置,方差是「离中心多远」的波动程度。它们是一个分布最重要的两个数字,几乎所有公式都围绕它们展开。
- 协方差与相关系数:描述两个变量是否「同涨同跌」以及相关强弱。相关系数把协方差归一化到 [-1, 1],机器学习里常用于特征筛选与相关性分析。
- 大数定律 & 中心极限定理:样本多了,频率收敛到概率(大数定律);大量独立随机变量之和 / 均值近似正态(中心极限定理)。一切统计推断的合法性都靠它们。
- 极大似然估计:在所有候选参数里,选「最可能产生当前这批数据」的那一个。它是大多数模型训练目标(负对数似然 / 交叉熵)的起源。
- ML 应用:朴素贝叶斯用贝叶斯公式做分类;交叉熵损失本质是负对数似然;dropout、采样生成、强化学习都建立在概率与期望之上。
深入原理
这一节逐个拆解核心公式:先给直觉,再给公式与推导,最后给一句「面试怎么问」。建议每看完一小节,拿笔把公式在草稿纸上抄一遍、推一遍。
(1) 条件概率与贝叶斯公式:看见证据后,怎么更新「信念」?
大白话直觉:一件事的概率不是一成不变的。天气预报说「今天 40% 会下雨」是没看任何证据的先验;当你抬头看见乌云密布,心里的概率会立刻上调——这就是「看见证据后更新信念」。条件概率 $P(B|A)$ 回答:「已知 A 已经发生,B 发生的概率是多少」。做法很简单:不再看整个样本空间,只把目光聚焦在 A 这块区域里,看 B 占了多大比例。
公式: $$P(B|A)=\frac{P(A\cap B)}{P(A)},\qquad P(A)>0$$ 贝叶斯公式把「反过来」的条件概率联系起来: $$P(H|E)=\frac{P(E|H)\,P(H)}{P(E)}=\frac{P(E|H)\,P(H)}{\sum_i P(E|H_i)\,P(H_i)}$$ 其中 $P(H)$ 叫先验(看到证据前的信念),$P(E|H)$ 叫似然(假设 H 成立时,看到证据 E 的可能性),$P(H|E)$ 叫后验(看到证据后的信念),$P(E)$ 叫证据 / 归一化常数。
关键推导步骤:
- 由条件概率定义:$P(H|E)=\dfrac{P(H\cap E)}{P(E)}$;
- 同理 $P(E|H)=\dfrac{P(H\cap E)}{P(H)}$,所以 $P(H\cap E)=P(E|H)\,P(H)$(乘法法则);
- 代入得 $P(H|E)=\dfrac{P(E|H)P(H)}{P(E)}$;
- 分母用全概率公式展开:$P(E)=\sum_i P(E|H_i)P(H_i)$(把 E 拆到互斥且完备的假设 $H_i$ 上)。
面试怎么问:「贝叶斯公式里每一项在朴素贝叶斯里是什么角色?先验和似然分别由谁提供?」
(2) 随机变量与常见分布:给随机现象画「画像」
大白话直觉:随机变量就是给每个试验结果贴一个数字标签,然后我们只关心两件事——这个数字能取哪些值(支撑集),每个值的概率是多少。离散分布用概率质量函数(pmf,逐点给概率),连续分布用概率密度函数(pdf,概率落在某区间 = 密度曲线下的面积)。
公式(五个基本分布,前三个离散、后两个连续): $$X\sim \mathrm{Bernoulli}(p):\quad P(X{=}1)=p,\ P(X{=}0)=1-p$$ $$X\sim \mathrm{Binomial}(n,p):\quad P(X{=}k)=\binom{n}{k}p^{k}(1-p)^{\,n-k},\quad \mathbb{E}[X]=np,\ \mathrm{Var}(X)=np(1-p)$$ $$X\sim \mathrm{Poisson}(\lambda):\quad P(X{=}k)=\frac{\lambda^{k}e^{-\lambda}}{k!}\ \xleftarrow[n\to\infty,\ p\to 0,\ \lambda=np\ \text{固定}]{\text{二项分布的极限}}$$ $$X\sim \mathrm{Uniform}(a,b):\quad f(x)=\frac{1}{b-a},\quad a\le x\le b$$ $$X\sim \mathcal{N}(\mu,\sigma^2):\quad f(x)=\frac{1}{\sqrt{2\pi}\,\sigma}e^{-\frac{(x-\mu)^2}{2\sigma^2}}$$
关键推导步骤(二项 → 泊松的极限过程):
- 二项概率 $\binom{n}{k}p^k(1-p)^{n-k}$,令 $p=\lambda/n$,固定 $k$、令 $n\to\infty$;
- 用两个近似:$\binom{n}{k}\approx \dfrac{n^k}{k!}$,以及 $(1-\lambda/n)^n\to e^{-\lambda}$;
- 整理得到 $\dfrac{\lambda^k e^{-\lambda}}{k!}$,即泊松分布——这就是「稀有事件计数」模型(电话呼叫数、机器故障数)的来历。
面试怎么问:「泊松分布和二项分布什么关系?什么场景用泊松建模?泊松分布的期望等于什么?」
(3) 期望、方差、协方差与相关系数:中心、波动与联动
大白话直觉:期望是「重复试验很久很久之后的平均值」——抛硬币正面算 1、反面算 0,期望是 0.5,不是说会抛出一个 0.5,而是长期平均会趋近 0.5。方差度量「围绕均值散得多开」;协方差与相关系数度量两个变量是否同向变动(同涨同跌、还是此消彼长)。
公式: $$\mathbb{E}[X]=\sum_i x_i\,p_i\ (\text{离散}),\qquad \mathbb{E}[X]=\int_{-\infty}^{\infty} x\,f(x)\,dx\ (\text{连续})$$ $$\mathrm{Var}(X)=\mathbb{E}[(X-\mathbb{E}[X])^2]=\mathbb{E}[X^2]-(\mathbb{E}[X])^2$$ $$\mathrm{Cov}(X,Y)=\mathbb{E}[(X-\mu_X)(Y-\mu_Y)],\qquad \rho_{XY}=\frac{\mathrm{Cov}(X,Y)}{\sigma_X\,\sigma_Y}\in[-1,\ 1]$$
关键推导步骤:
- 线性性:$\mathbb{E}[aX+b]=a\mathbb{E}[X]+b$,$\mathbb{E}[X+Y]=\mathbb{E}[X]+\mathbb{E}[Y]$——把期望的定义逐项代入即证,不需要任何独立性假设;
- 方差展开:$\mathrm{Var}(X)=\mathbb{E}[X^2-2X\mathbb{E}[X]+(\mathbb{E}[X])^2]=\mathbb{E}[X^2]-(\mathbb{E}[X])^2$,这是手算方差的常用工具;
- 相关系数边界:把 X、Y 标准化后,$\rho$ 就是两个标准向量的内积,由柯西-施瓦茨不等式立刻得到 $|\rho|\le 1$——$\rho=1$ 完全正相关、$-1$ 完全负相关、$0$ 无线性相关。
- 方差不是线性的:$\mathrm{Var}(aX+b)=a^2\mathrm{Var}(X)$,且 $\mathrm{Var}(X+Y)=\mathrm{Var}(X)+\mathrm{Var}(Y)+2\mathrm{Cov}(X,Y)$。
面试怎么问:「$\mathrm{Var}(aX+b)$ 等于多少?相关系数为 0 能说明 X、Y 独立吗?为什么?」
(4) 常见分布参数速查表:一张表背下所有考点
| 分布 | 记号 | 支撑集 | 期望 | 方差 | 典型场景 |
|---|---|---|---|---|---|
| 伯努利 | $B(1,p)$ | $\{0,1\}$ | $p$ | $p(1-p)$ | 一次试验成败(点击、患病) |
| 二项 | $B(n,p)$ | $\{0,1,\dots,n\}$ | $np$ | $np(1-p)$ | n 次独立重复试验的成功次数 |
| 泊松 | $Pois(\lambda)$ | $\{0,1,2,\dots\}$ | $\lambda$ | $\lambda$ | 稀有事件计数(来电数、故障数) |
| 均匀 | $U(a,b)$ | $[a,b]$ | $\frac{a+b}{2}$ | $\frac{(b-a)^2}{12}$ | 区间内等可能取值(随机数) |
| 正态 | $N(\mu,\sigma^2)$ | $\mathbb{R}$ | $\mu$ | $\sigma^2$ | 误差、身高、样本均值(CLT) |
| 指数 | $Exp(\lambda)$ | $[0,\infty)$ | $\frac{1}{\lambda}$ | $\frac{1}{\lambda^2}$ | 等待事件发生的时间间隔 |
记忆小技巧:
- 离散家族成对背:伯努利是 $(p,\ p(1-p))$;二项 = 伯努利 × n,得 $(np,\ np(1-p))$;泊松期望方差都等于 $\lambda$——这是泊松最著名的「签名特征」,代码实战会亲手验证;
- 正态的两个参数就是期望与方差本身:$\mu$ 管位置、$\sigma^2$ 管胖瘦;
- 3σ 法则:正态分布下 $P(\mu-\sigma<X<\mu+\sigma)\approx 68.3\%$、$2\sigma\approx 95.4\%$、$3\sigma\approx 99.7\%$,工程上常用「3σ」当异常阈值。
关键推导(泊松为何期望 = 方差):$\mathbb{E}[X]=\sum_{k\ge 0}k\dfrac{\lambda^k e^{-\lambda}}{k!}=\lambda e^{-\lambda}\sum_{k\ge 1}\dfrac{\lambda^{k-1}}{(k-1)!}=\lambda$;同理 $\mathbb{E}[X^2]=\lambda^2+\lambda$,故 $\mathrm{Var}(X)=\lambda$。
面试怎么问:「泊松分布期望等于方差,这个性质怎么来的、又有什么用?」
(5) 大数定律与中心极限定理:样本凭什么代表总体?
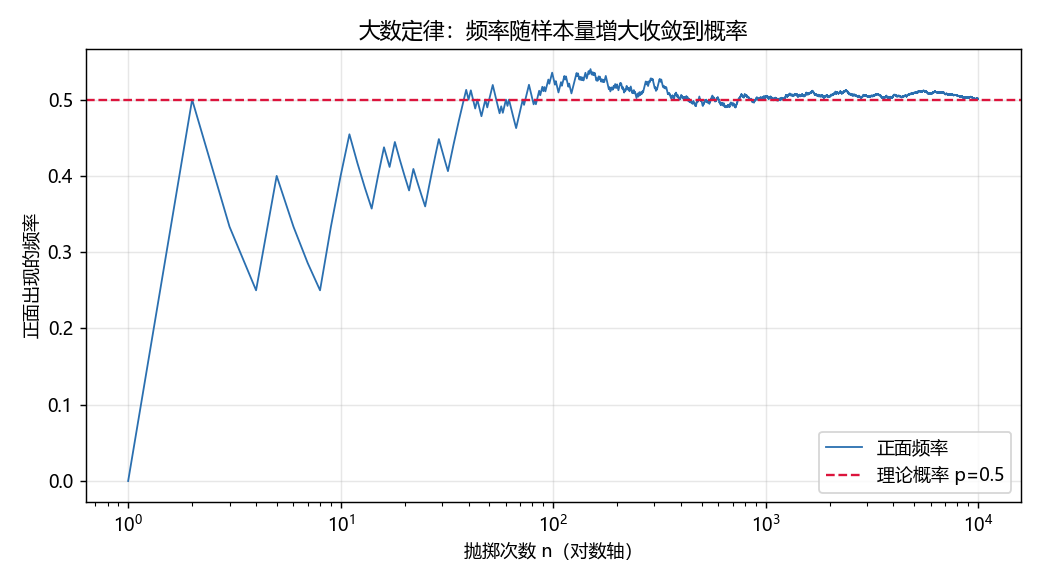
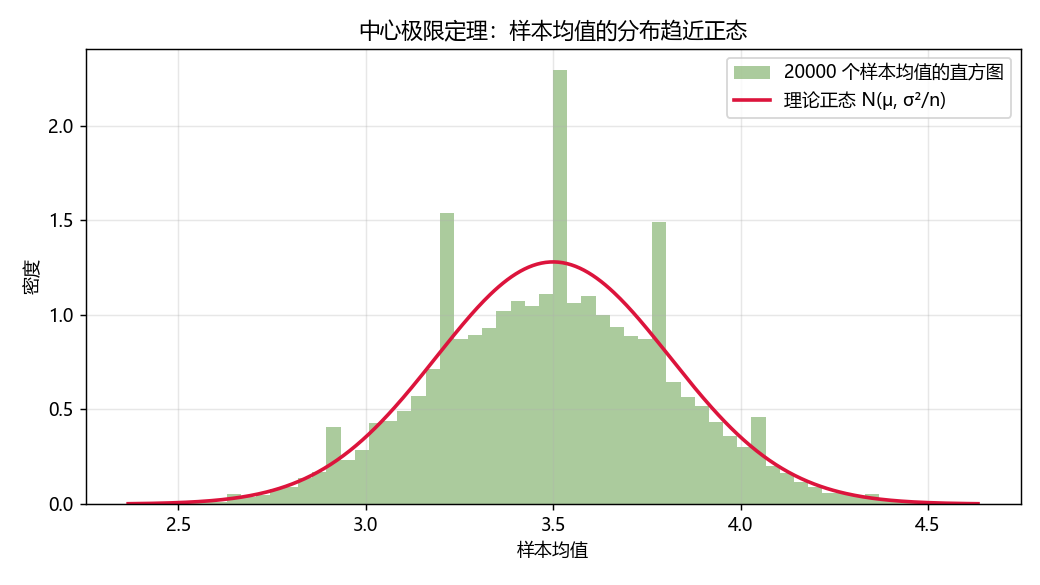
大白话直觉:大数定律说「样本多了就稳了」——抛 10 次硬币可能正 8 反 2(频率 0.8),但抛 10000 次,正面频率几乎必然落在 0.5 附近。中心极限定理更进一步:不管原始数据长什么样(哪怕掷骰子的 1~6 均匀分布),只要样本量够大,样本均值的分布就逼近正态——这就是「正态分布无处不在」的真正原因。
公式(设 $X_1,\dots,X_n$ i.i.d.,均值 $\mu$、方差 $\sigma^2$): $$\frac{1}{n}\sum_{i=1}^{n}X_i\ \xrightarrow{p}\ \mu\qquad(\text{弱大数定律})$$ $$\frac{\bar{X}_n-\mu}{\sigma/\sqrt{n}}\ \xrightarrow{d}\ \mathcal{N}(0,1)\qquad(\text{中心极限定理}),\qquad \bar{X}_n\ \dot{\approx}\ \mathcal{N}\Big(\mu,\ \frac{\sigma^2}{n}\Big)$$
关键推导步骤(CLT 证明的高层思路,用矩母函数):
- 令 $Z_i=X_i-\mu$,其矩母函数在 0 附近展开为 $M_Z(t)=\mathbb{E}[e^{tZ}]=1+\frac{1}{2}\sigma^2 t^2+o(t^2)$;
- 标准化和的矩母函数 $M_{S_n}(t)=\Big[M_Z\big(\frac{t}{\sigma\sqrt{n}}\big)\Big]^{n}\approx\Big(1+\frac{t^2}{2n}\Big)^{n}\to e^{t^2/2}$;
- $e^{t^2/2}$ 正是标准正态的矩母函数,而矩母函数唯一决定分布 ⟹ 收敛到 $\mathcal{N}(0,1)$。
面试怎么问:「大数定律和中心极限定理有什么区别?样本均值的分布是什么、方差多大?」
(6) 极大似然估计(MLE):让数据「最可能」出现的参数
大白话直觉:你手握一组观测数据,却不知道背后的分布参数。MLE 的思想就一句话——「哪个参数最有可能生成出我这手数据,就选哪个」。抛硬币 100 次出了 65 次正面:$p=0.65$ 时出现这种情况的概率最大,$p=0.5$ 时几乎不可能,所以 $\hat p=0.65$。注意 MLE 是「挑最好的参数」,不是「猜真相」;样本越多,估计越准(一致性)。
公式(样本 $x_1,\dots,x_n$ i.i.d.,密度 / 概率函数 $f(x;\theta)$): $$L(\theta)=\prod_{i=1}^{n}f(x_i;\theta),\qquad \ell(\theta)=\sum_{i=1}^{n}\log f(x_i;\theta),\qquad \hat\theta_{MLE}=\arg\max_{\theta}\ \ell(\theta)$$
关键推导步骤(以抛硬币 / 伯努利为例,$k$ 次正面、$n-k$ 次反面):
- 似然函数 $L(p)=p^{k}(1-p)^{n-k}$,取对数 $\ell(p)=k\ln p+(n-k)\ln(1-p)$(连乘变连加;对数单调,不改变最优点);
- 求导并令为零:$\ell'(p)=\dfrac{k}{p}-\dfrac{n-k}{1-p}=0$;
- 解得 $\hat p=\dfrac{k}{n}$——正面频率就是最大似然估计,这就是「频率估计 = MLE」的来历;
- 与损失函数的联系:最小化负对数似然 $-\frac{1}{n}\sum_i \log f(x_i;\theta)$ 与最大化似然等价,而分类问题中的交叉熵损失正是它——下一章信息论会讲透。
面试怎么问:「MLE 里取 log 为什么不影响最优解?MLE 和交叉熵损失是什么关系?」
代码实战:从零验证概率统计的四大支柱
下面的代码只依赖 numpy(画图用 matplotlib),固定随机种子、可复现、可直接运行。四个代码块分别验证: ① 大数定律 + 中心极限定理(图 1、图 2)→ ② 二项 / 泊松的期望方差与泊松近似 → ③ 手写正态 pdf 与 Box-Muller 采样 → ④ 贝叶斯后验公式 + 手写 MLE。 每段末尾都打印「核对结果」:数值与理论公式对得上,才算真正掌握。
代码块 1/4:抛硬币验证大数定律,掷骰子验证中心极限定理(含两张图)
# ═══════════════════════════════════════════════════════════════
# 代码块 1/4:大数定律 + 中心极限定理
# 固定随机种子 → 可复现;只用 numpy + matplotlib
# ═══════════════════════════════════════════════════════════════
import sys, io
if getattr(sys.stdout, 'buffer', None) is not None:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')

import numpy as np
import matplotlib
matplotlib.use('Agg')            # 无界面后端,保证可离线运行
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

def norm_pdf(x, mu=0.0, sigma=1.0):
    """手写正态分布概率密度函数(不依赖 scipy,后面还会复用)"""
    return (1 / (np.sqrt(2 * np.pi) * sigma)) * np.exp(-0.5 * ((x - mu) / sigma) ** 2)

# ---------- A. 大数定律:抛硬币,正面频率 → 0.5 ----------
def simulate_coin(n_total=10000, seed=42):
    rng = np.random.default_rng(seed)
    heads = rng.random(n_total) < 0.5                    # True=正面
    return np.cumsum(heads) / np.arange(1, n_total + 1)  # 前 n 次的正频率

cum_freq = simulate_coin()
n_total = 10000
err_final = abs(cum_freq[-1] - 0.5)
print(f'大数定律:抛 {n_total} 次硬币,最终正面频率 = {cum_freq[-1]:.4f},理论 = 0.5,误差 = {err_final:.5f}')
assert err_final < 0.05, '大数定律核对失败'
print('✅ 核对通过:n 越大,频率越接近概率(大数定律)\n')

# 图 1:频率收敛曲线(横轴取对数,前几百次的变化看得更清楚)
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.plot(np.arange(1, n_total + 1), cum_freq, lw=1.0, color='#2a6fb0', label='正面频率')
ax.axhline(0.5, color='crimson', ls='--', lw=1.3, label='理论概率 p=0.5')
ax.set_xscale('log')
ax.set_xlabel('抛掷次数 n(对数轴)')
ax.set_ylabel('正面出现的频率')
ax.set_title('大数定律:频率随样本量增大收敛到概率')
ax.legend()
ax.grid(alpha=0.3)
fig.tight_layout()
fig.savefig('images/math02_lln.png', dpi=130)
plt.close(fig)
print('已保存图片 images/math02_lln.png')

# ---------- B. 中心极限定理:掷骰子(均匀分布)的样本均值 → 正态 ----------
def dice_mean_hist(n_samples=20000, n_per_sample=30, seed=2024):
    rng = np.random.default_rng(seed)
    samples = rng.integers(1, 7, size=(n_samples, n_per_sample))  # 每行 = 一个样本(30 次掷骰)
    return samples.mean(axis=1)

means = dice_mean_hist()
mu = 3.5                                   # 单次掷骰的理论期望 (1+2+3+4+5+6)/6
sigma_sq = ((1-mu)**2 + (2-mu)**2 + (3-mu)**2 + (4-mu)**2 + (5-mu)**2 + (6-mu)**2) / 6
sigma_mean = np.sqrt(sigma_sq / 30)        # CLT:样本均值标准差 = σ/√n
emp_mean, emp_std = means.mean(), means.std()
print(f'中心极限定理:样本均值 经验均值 = {emp_mean:.4f}(理论 {mu}),经验标准差 = {emp_std:.4f}(理论 {sigma_mean:.4f})')
assert abs(emp_mean - mu) < 0.05 and abs(emp_std - sigma_mean) < 0.05, 'CLT 核对失败'
print('✅ 核对通过:均匀分布的样本均值 ≈ 正态分布(中心极限定理)\n')

# 图 2:样本均值直方图 + 手写正态密度曲线叠加
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.hist(means, bins=60, density=True, alpha=0.65, color='#7fb069', label='20000 个样本均值的直方图')
xs = np.linspace(means.min(), means.max(), 400)
ax.plot(xs, norm_pdf(xs, mu, sigma_mean), color='crimson', lw=2, label='理论正态 N(μ, σ²/n)')
ax.set_xlabel('样本均值')
ax.set_ylabel('密度')
ax.set_title('中心极限定理:样本均值的分布趋近正态')
ax.legend()
ax.grid(alpha=0.3)
fig.tight_layout()
fig.savefig('images/math02_clt.png', dpi=130)
plt.close(fig)
plt.show()
print('已保存图片 images/math02_clt.png')
print('全部核对通过 ✅✅')
大数定律:抛 10000 次硬币,最终正面频率 = 0.5015,理论 = 0.5,误差 = 0.00150
✅ 核对通过:n 越大,频率越接近概率(大数定律)
已保存图片 images/math02_lln.png
中心极限定理:样本均值 经验均值 = 3.4985(理论 3.5),经验标准差 = 0.3133(理论 0.3118)
✅ 核对通过:均匀分布的样本均值 ≈ 正态分布(中心极限定理)
已保存图片 images/math02_clt.png
全部核对通过 ✅✅
读图要点:
- 图 1 的横轴是对数刻度:一开始频率剧烈抖动(前 10 次可能 0.7、0.3),随着 n 增大慢慢「粘」在 0.5 上——这就是大数定律的直观表现;
- 图 2 里红色曲线是理论正态密度 $\mathcal{N}(3.5,\ \sigma^2/30)$,直方图与它几乎重合——注意原始掷骰子分布是均匀的(1~6 等可能),但样本均值却变成钟形,这就是中心极限定理的威力。
代码块 2/4:从零验证二项分布的期望 / 方差,以及「二项 → 泊松」的近似
# ═══════════════════════════════════════════════════════════════
# 代码块 2/4:二项分布的期望/方差 + 泊松近似 + 泊松「期望=方差」签名
# ═══════════════════════════════════════════════════════════════
from math import comb
import numpy as np

def binom_pmf(k, n, p):
    """手写二项分布概率质量函数:C(n,k)·p^k·(1-p)^(n-k)"""
    return comb(n, k) * p**k * (1 - p)**(n - k)

def pois_pmf(k, lam):
    """手写泊松分布概率质量函数:λ^k·e^{-λ}/k!(递推计算,避免阶乘溢出)"""
    if k < 0:
        return 0.0
    term = np.exp(-lam)
    for i in range(1, k + 1):
        term *= lam / i
    return float(term)

# (a) 期望 / 方差:经验值 vs 理论值
n, p = 100, 0.3
rng = np.random.default_rng(2024)
binom_samples = np.sum(rng.random((50000, n)) < p, axis=1)   # 手写二项采样:每行数出正面数
emp_mean, emp_var = binom_samples.mean(), binom_samples.var()
theo_mean, theo_var = n * p, n * p * (1 - p)
print(f'二项分布 B({n},{p}):经验期望 = {emp_mean:.3f}(理论 {theo_mean}),经验方差 = {emp_var:.3f}(理论 {theo_var:.3f})')
assert abs(emp_mean - theo_mean) < 0.25 and abs(emp_var - theo_var) < 0.25, '二项期望/方差核对失败'
print('✅ 核对通过:E[X] = np,Var(X) = np(1-p)\n')

# (b) 二项 → 泊松近似:n 很大、p 很小,λ = np 固定
n2, p2, lam = 1000, 0.005, 5.0
ks = np.arange(0, 16)
binom_probs = np.array([binom_pmf(int(k), n2, p2) for k in ks])
pois_probs = np.array([pois_pmf(int(k), lam) for k in ks])
max_gap = np.abs(binom_probs - pois_probs).max()
print(f'二项 B(1000, 0.005) vs 泊松 Pois(5):逐点概率最大差距 = {max_gap:.2e}')
assert max_gap < 0.01, '泊松近似核对失败'
print(f'✅ 核对通过:n 大 p 小时二项分布 ≈ 泊松分布(λ = np = {lam})\n')

# (c) 泊松分布「期望 = 方差」的数值验证(著名签名特征)
lam2 = 3.0
rng2 = np.random.default_rng(7)
pois_samples = rng2.poisson(lam2, 50000)
emp_mean2, emp_var2 = pois_samples.mean(), pois_samples.var()
print(f'泊松 Pois({lam2}):经验期望 = {emp_mean2:.3f},经验方差 = {emp_var2:.3f}(理论均为 {lam2})')
assert abs(emp_mean2 - lam2) < 0.1 and abs(emp_var2 - lam2) < 0.2, '泊松期望=方差核对失败'
print('✅ 核对通过:泊松分布期望 ≈ 方差 ≈ λ')
print('全部核对通过 ✅✅')
二项分布 B(100,0.3):经验期望 = 29.988(理论 30.0),经验方差 = 21.070(理论 21.000)
✅ 核对通过:E[X] = np,Var(X) = np(1-p)

二项 B(1000, 0.005) vs 泊松 Pois(5):逐点概率最大差距 = 4.40e-04
✅ 核对通过:n 大 p 小时二项分布 ≈ 泊松分布(λ = np = 5.0)

泊松 Pois(3.0):经验期望 = 3.007,经验方差 = 2.990(理论均为 3.0)
✅ 核对通过:泊松分布期望 ≈ 方差 ≈ λ
全部核对通过 ✅✅
代码块 3/4:手写正态 pdf(数值积分验证归一化)+ Box-Muller 采样核对期望 / 方差 / 3σ 法则
# ═══════════════════════════════════════════════════════════════
# 代码块 3/4:手写正态 pdf + Box-Muller 采样验证「期望=μ、标准差=σ、3σ 法则」
# ═══════════════════════════════════════════════════════════════
import numpy as np

def norm_pdf(x, mu=0.0, sigma=1.0):
    """手写正态分布概率密度函数"""
    return (1 / (np.sqrt(2 * np.pi) * sigma)) * np.exp(-0.5 * ((x - mu) / sigma) ** 2)

# (a) 数值积分验证「密度曲线下面积为 1」
xs = np.linspace(-10, 10, 20001)
area = np.trapezoid(norm_pdf(xs, 0.0, 1.0), xs)
print(f'标准正态 pdf 在 [-10, 10] 上数值积分 = {area:.6f}(应为 1)')
assert abs(area - 1.0) < 1e-5, 'pdf 归一化核对失败'
print('✅ 核对通过:∫ f(x)dx = 1,pdf 是合法的密度函数\n')

# (b) 手写 Box-Muller:从标准均匀分布采样出正态样本
def box_muller(n, mu=0.0, sigma=1.0, seed=42):
    """Box-Muller 变换:z = √(-2 ln u1)·cos(2π u2) ~ N(0,1)"""
    rng = np.random.default_rng(seed)
    u1 = rng.random(n)
    u2 = rng.random(n)
    z = np.sqrt(-2.0 * np.log(u1)) * np.cos(2.0 * np.pi * u2)
    return mu + sigma * z

mu_t, sigma_t = 2.0, 3.0
samples = box_muller(100000, mu_t, sigma_t)
emp_mean3 = samples.mean(); emp_std3 = samples.std()
print(f'Box-Muller 采样 N({mu_t}, {sigma_t}²):经验均值 = {emp_mean3:.3f},经验标准差 = {emp_std3:.3f}')
assert abs(emp_mean3 - mu_t) < 0.05 and abs(emp_std3 - sigma_t) < 0.05, '正态采样核对失败'
print('✅ 核对通过:采样得到的期望 ≈ μ、标准差 ≈ σ\n')

# (c) 3σ 法则:区间覆盖率
inside_1 = np.mean(np.abs(samples - mu_t) < 1.0 * sigma_t)
inside_2 = np.mean(np.abs(samples - mu_t) < 2.0 * sigma_t)
inside_3 = np.mean(np.abs(samples - mu_t) < 3.0 * sigma_t)
print(f'3σ 法则实测:1σ 覆盖率 = {inside_1:.4f}(理论 68.3%),2σ = {inside_2:.4f}(理论 95.4%),3σ = {inside_3:.4f}(理论 99.7%)')
assert abs(inside_1 - 0.683) < 0.02 and abs(inside_3 - 0.997) < 0.01, '3σ 法则核对失败'
print('✅ 核对通过:1σ ≈ 68.3%,2σ ≈ 95.4%,3σ ≈ 99.7%')
print('全部核对通过 ✅✅')
标准正态 pdf 在 [-10, 10] 上数值积分 = 1.000000(应为 1)
✅ 核对通过:∫ f(x)dx = 1,pdf 是合法的密度函数

Box-Muller 采样 N(2.0, 3.0²):经验均值 = 2.013,经验标准差 = 3.000
✅ 核对通过:采样得到的期望 ≈ μ、标准差 ≈ σ

3σ 法则实测:1σ 覆盖率 = 0.6828(理论 68.3%),2σ = 0.9544(理论 95.4%),3σ = 0.9971(理论 99.7%)
✅ 核对通过:1σ ≈ 68.3%,2σ ≈ 95.4%,3σ ≈ 99.7%
全部核对通过 ✅✅
代码块 4/4:贝叶斯公式数值演练(检验悖论)+ 手写极大似然估计(MLE)
# ═══════════════════════════════════════════════════════════════
# 代码块 4/4:贝叶斯公式数值演练 + 手写极大似然估计(MLE)
# ═══════════════════════════════════════════════════════════════
import numpy as np

# (a) 经典「检验悖论」:罕见病筛查
# 疾病发病率 1%(先验);检测真阳性率(sensitivity)99%;误报率(假阳性率)5%。
p_disease = 0.01            # 先验 P(患病)
p_pos_given_d = 0.99        # 似然 P(阳性 | 患病)
p_pos_given_nd = 0.05       # P(阳性 | 健康)
p_pos = p_pos_given_d * p_disease + p_pos_given_nd * (1 - p_disease)  # 全概率公式
p_d_given_pos = p_pos_given_d * p_disease / p_pos                     # 贝叶斯公式
print(f'检验呈阳性时,真实患病的概率 = {p_d_given_pos:.4f}(约 {p_d_given_pos*100:.1f}%)')
assert 0.15 < p_d_given_pos < 0.18, '贝叶斯后验核对失败'
print('✅ 核对通过:检测“很准” ≠ 阳性就患病——先验(发病率)决定了后验,这就是贝叶斯思维\n')

# (b) 手写 MLE:抛硬币估计 p,验证「频率估计 = 最大似然估计」
def mle_coin_binomial(n=3000, true_p=0.35, seed=42):
    rng = np.random.default_rng(seed)
    flips = rng.random(n) < true_p          # 模拟真实 p=0.35 的硬币
    k = int(flips.sum())
    p_hat_freq = k / n                      # 频率估计 = k/n
    # 网格搜索「最大化对数似然」,验证 argmax 就是频率估计:
    grid = np.linspace(0.001, 0.999, 5000)
    logL = k * np.log(grid) + (n - k) * np.log(1 - grid)   # 对数似然(省略常数项)
    p_hat_grid = grid[int(np.argmax(logL))]
    print(f'真实 p = {true_p}:频率估计 p̂ = {p_hat_freq:.4f};网格搜索 argmax = {p_hat_grid:.4f}')
    assert abs(p_hat_freq - true_p) < 0.05, 'MLE 一致性核对失败'
    assert abs(p_hat_grid - p_hat_freq) < 1e-3, 'MLE argmax 核对失败'
    print('✅ 核对通过:频率估计 = 最大似然估计 p̂ = k/n,且随 n 增大逼近真实 p(一致性)')
    return k, n

k, n = mle_coin_binomial()
print(f'(本例:{n} 次抛掷中 {k} 次正面 → p̂ = {k/n:.4f})')
print('全部核对通过 ✅✅')
检验呈阳性时,真实患病的概率 = 0.1667(约 16.7%)
✅ 核对通过:检测“很准” ≠ 阳性就患病——先验(发病率)决定了后验,这就是贝叶斯思维

真实 p = 0.35:频率估计 p̂ = 0.3523;网格搜索 argmax = 0.3524
✅ 核对通过:频率估计 = 最大似然估计 p̂ = k/n,且随 n 增大逼近真实 p(一致性)
(本例:3000 次抛掷中 1057 次正面 → p̂ = 0.3523)
全部核对通过 ✅✅
面试考点:概率论与统计高频 Q&A
Q1:大数定律和中心极限定理有什么区别?
- 答:大数定律说「样本均值 / 频率随 n 增大收敛到真实期望 / 概率」——回答的是「准不准」;中心极限定理说「样本均值的分布随 n 增大趋近正态」——回答的是「长什么样」。前者给点估计的合法性,后者是区间估计与假设检验的基础。
- 追问:样本均值的期望和方差是多少?→ $\mathbb{E}[\bar{X}]=\mu$,$\mathrm{Var}(\bar{X})=\sigma^2/n$,标准差 $\sigma/\sqrt{n}$ 又叫标准误。
- 30 秒速答:大数定律管收敛,CLT 管形态;$\bar{X}\ \dot{\approx}\ N(\mu,\sigma^2/n)$。
Q2:贝叶斯公式的每一项在朴素贝叶斯里是什么角色?
- 答:朴素贝叶斯要算 $P(类别|特征)\propto P(特征|类别)\,P(类别)$。$P(类别)$ 是先验(训练集中各类占比);$P(特征|类别)$ 是似然,靠「给定类别下特征条件独立」的朴素假设拆成连乘 $\prod_i P(特征_i|类别)$;分母 $P(特征)$ 对所有类别相同,做分类比较分子时可以直接省掉。
- 追问:为什么叫「朴素」?→ 因为假设特征在给定类别下相互独立,现实中往往不成立;但工程上它简单、快、小样本也稳,所以垃圾邮件过滤等场景依旧是标配。
- 30 秒速答:先验 × 似然 ÷ 证据;分类只比分子,证据可省。
Q3:泊松分布什么时候用?它和二项分布什么关系?
- 答:泊松建模「单位时间 / 空间内稀有事件发生次数」(呼叫中心的来电数、机器故障数),期望 = 方差 = $\lambda$ 是它的签名。二项 $B(n,p)$ 在 n 很大、p 很小、$\lambda=np$ 保持固定时逼近泊松——代码实战里已经数值验证过。
- 追问:泊松为什么期望等于方差?→ 用级数求和可证 $\mathbb{E}[X]=\lambda$、$\mathbb{E}[X^2]=\lambda^2+\lambda$,所以 $\mathrm{Var}(X)=\lambda$。
- 30 秒速答:稀有事件计数用泊松;n 大 p 小,二项 ≈ 泊松。
Q4:期望和方差的性质?$\mathrm{Var}(aX+b)$ 等于多少?
- 答:期望是线性的:$\mathbb{E}[aX+b]=a\mathbb{E}[X]+b$、$\mathbb{E}[X+Y]=\mathbb{E}[X]+\mathbb{E}[Y]$;方差带平方:$\mathrm{Var}(aX+b)=a^2\mathrm{Var}(X)$,且 $\mathrm{Var}(X+Y)=\mathrm{Var}(X)+\mathrm{Var}(Y)+2\mathrm{Cov}(X,Y)$,独立时协方差为 0。
- 追问:相关系数为 0 说明独立吗?→ 不成立。反例:$X\sim N(0,1)$,$Y=X^2$,则 $\mathrm{Cov}(X,Y)=\mathbb{E}[X^3]-\mathbb{E}[X]\mathbb{E}[X^2]=0$,但 Y 完全由 X 决定。独立 ⟹ 不相关,反之不成立。
- 30 秒速答:E 线性、Var 带平方、协方差可加;不相关 ≠ 独立。
Q5:正态分布为什么无处不在?
- 答:三个原因:① 中心极限定理——大量独立小误差叠加后近似正态;② 误差 / 噪声的天然模型(测量误差、传感器噪声);③ 数学性质好——期望方差完全刻画、可解析计算、3σ 法则给出异常阈值,极大似然与最小二乘在正态噪声假设下等价。
- 追问:给一个「不是正态但很重要的分布」?→ 指数分布(等待时间)、幂律分布(社交网络度分布)、长尾分布——现实中并不是一切都正态。
- 30 秒速答:CLT 让小误差之和变正态;正态的数学性质让它成为默认建模分布。
Q6:MLE 是什么?它和损失函数、MAP 有什么关系?
- 答:MLE 选「让数据出现概率最大的参数」;把最大化等价写成最小化负对数似然(NLL),分类任务里的 NLL 正是交叉熵损失——所以训练神经网络本质上就是在做 MLE 近似。MLE 只依赖数据;MAP 额外乘上参数的先验 $P(\theta)$,相当于加了正则项(如 $L_2$ 对应高斯先验)。
- 追问:为什么分类用交叉熵而不是 MSE?→ 交叉熵 = 负对数似然,梯度是 $p-y$ 不含饱和的 $\sigma'$ 项(见下一章),收敛更稳;MSE 配 sigmoid 梯度会消失。
- 30 秒速答:MLE = 最小化 NLL;分类 NLL 就是交叉熵;MAP = MLE + 参数先验。
Q7:概率统计在机器学习里还有哪些「藏起来」的用法?
- 答:三处最典型——① 采样:dropout 是伯努利采样、生成模型从学到的分布采样、策略梯度用蒙特卡洛估计期望梯度;② 置信区间 / 假设检验:评估模型指标时判断「差距是真是假」;③ 贝叶斯流派:贝叶斯优化调超参、在线学习的后验更新。
- 追问:强化学习的策略梯度为什么是「期望」?→ 目标函数是累计回报的期望 $\mathbb{E}[R]$,用采样估计梯度就是蒙特卡洛估计——正是大数定律的日常应用。
- 30 秒速答:采样、置信评估、贝叶斯优化——处处是概率。
小结与下一章预告
- 概率论给「不确定」配数学语言:随机试验 → 事件 → 随机变量 → 分布 → 期望 / 方差;
- 贝叶斯公式是「证据更新信念」的万能模板,朴素贝叶斯分类器就是它的直译;
- 大数定律与中心极限定理是「样本代表总体」的两大支柱,也是假设检验与置信区间的地基;
- 极大似然估计(负对数似然)直接连接到深度学习的损失函数——而「交叉熵为什么是分类标配」这个问题,正好交给下一章的信息论来回答。
下一章预告:03-信息论 —— 熵如何度量「信息量」,交叉熵与 KL 散度为什么是深度学习的损失基石,softmax 与困惑度又是怎么回事,最后落到决策树与 RLHF 的真实用法。
🧪 自测:不看笔记,写出泊松 $(\lambda)$ 与二项 $(n,p)$ 的期望与方差;用一句话讲清大数定律与 CLT 的区别;说出贝叶斯公式「四项」的名字并各给一句人话解释。