🗺️ 01 · MapReduce:从原理到手写词频统计¶
MapReduce 是"分布式计算的启蒙思想":Map(分)→ Shuffle(排序分组)→ Reduce(合)。 本节手写词频统计与平均分计算,并演示 Shuffle 排序如何产生。
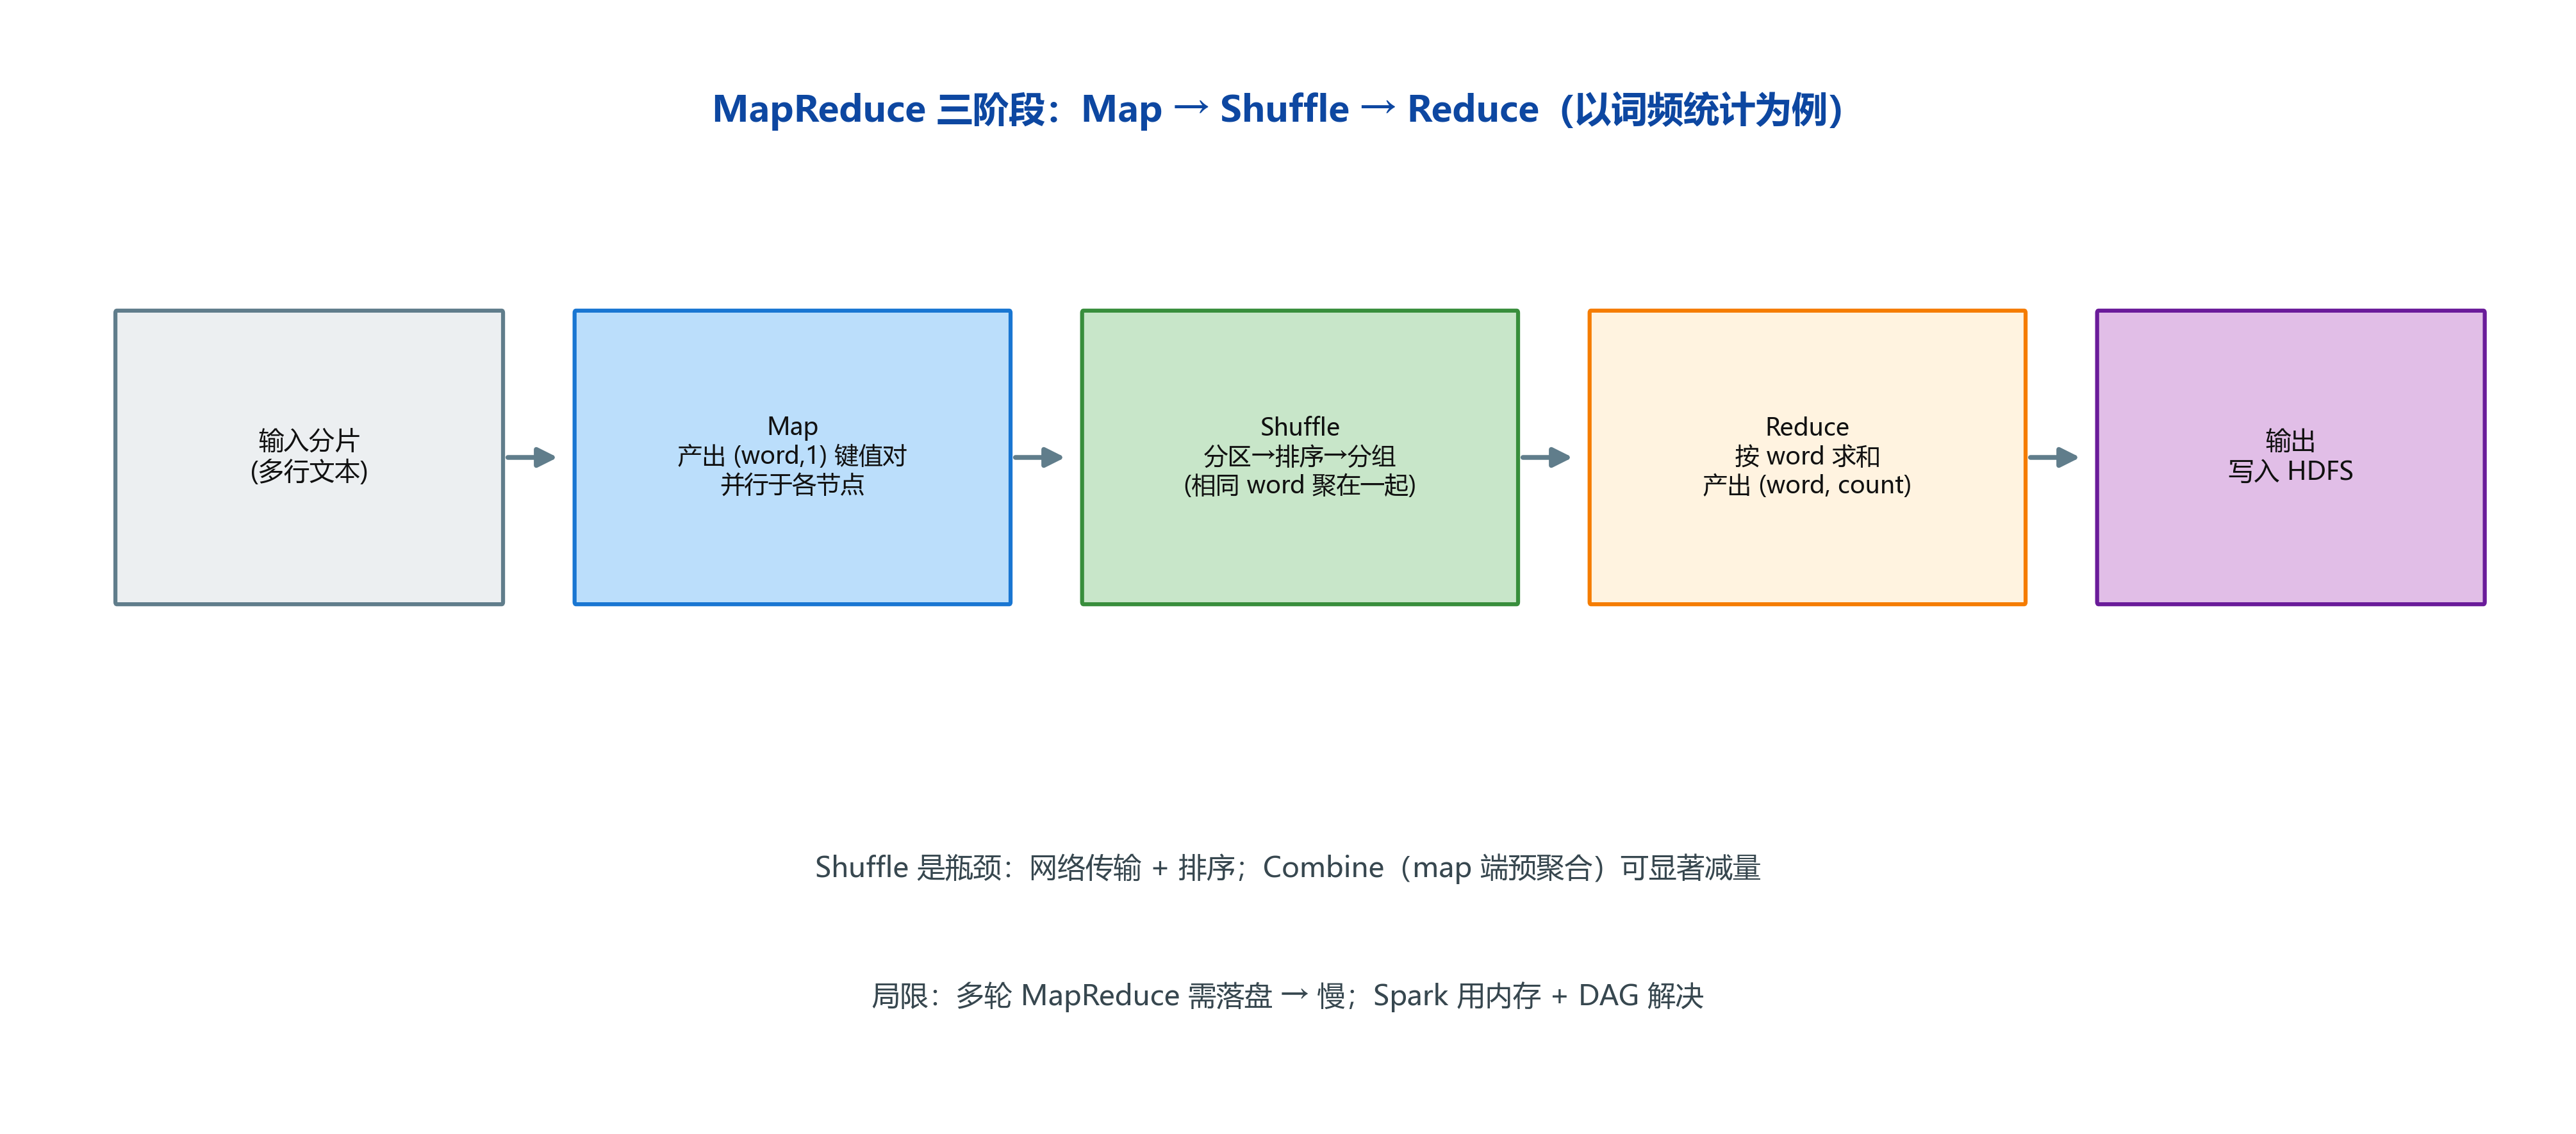
🔍 图解(自绘高清图,300dpi,可放大):MapReduce 把一个计算拆成三个强制阶段——
- Map(左):输入文件按行/块切分,每个分片跑一个 Mapper,产出中间键值对 (k, v); 各 Mapper 互不通信、天然并行(哪个节点算哪个分片都行);
- Shuffle(中):系统把相同 key 的 (k, v) 汇聚到同一个 Reducer—— 分区(Partitioner 按 key hash)+ 排序 + 归并;这是全流程最重的网络传输环节, 也是"数据变成 <key, 值列表>"的关键一步;
- Reduce(右):每个 Reducer 拿到 <key, values> 列表,做聚合(求和/计数/去重)后写出;
- "移动计算而非移动数据":Map 尽量在数据所在节点本地执行(数据本地性), 网络只搬中间结果——这是它能在几千台廉价机器上跑超大数据集的根本原因。
论文出处:Dean & Ghemawat, "MapReduce: Simplified Data Processing on Large Clusters", OSDI 2004——Map/Shuffle/Reduce 三阶段与"移动计算而非移动数据"的原始定义。
🎬 背景故事¶
数据分散在一万台机器上,怎么对它们做一次全量计算?……
数据分散在一万台机器上,但你想统计全网的词频。不可能把数据全搬到一台机器,只能"让计算去找数据"。这就是 MapReduce 的思想:每台机器先算自己那份(Map),再把结果汇总(Reduce),中间由框架负责洗牌(Shuffle)。本节用手写代码重现这经典的三阶段。
🧭 本节逻辑主线:为什么不能集中计算 → MapReduce 三阶段(Map/Shuffle/Reduce)→ 手写词频 vs pandas 对照 → TopN 变体 → 五条局限(为什么被 Spark 取代)。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | MapReduce 三个阶段? | Map / Shuffle / Reduce |
| 2 | 怎么处理大数据? | 分而治之:数据分片并行 |
| 3 | Shuffle 到底是什么? | 排序 + 按键分组 |
| 4 | 典型应用? | 词频、TopN、分组聚合 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ 思想三句话(必背)¶
📌 真实配图:MapReduce 完整流程(Wikimedia Commons)
这张图完整画出 MapReduce 的并行执行流程:输入分片 → 多节点并行 Map → 中间结果分区排序(Shuffle) → 归并 Reduce → 输出写回。图中多个 Map/Reduce 任务并行、数据在节点间洗牌, 正是本节手写三阶段流程的"工业实景图"。图片来源:Wikimedia Commons,CC BY-SA 4.0。
论文出处:Dean & Ghemawat, "MapReduce", OSDI 2004——论文中 MapReduce 并行执行流程的工业实景示意。
print('''1) Map:把每个输入记录变成 (key, value) 中间结果,可并行;
2) Shuffle:系统按 key 排序并分组(相同 key 发给同一 Reduce);
3) Reduce:对一个 key 的所有 value 做聚合,输出最终结果。

核心价值:把"不可并行"的聚合问题拆成"可并行"的 map + 局部聚合。
''')
1) Map:把每个输入记录变成 (key, value) 中间结果,可并行;
2) Shuffle:系统按 key 排序并分组(相同 key 发给同一 Reduce);
3) Reduce:对一个 key 的所有 value 做聚合,输出最终结果。

核心价值:把"不可并行"的聚合问题拆成"可并行"的 map + 局部聚合。
2️⃣ 构造模拟"日志数据"(分片)¶
# 模拟 3 个数据分片,每片若干行单词
splits = [
    ['apple banana apple', 'cherry apple'],
    ['banana banana cherry', 'apple'],
    ['cherry cherry banana apple', 'apple cherry'],
]
for i, s in enumerate(splits):
    print(f'分片{i}: {s}')
print('\n➡️ 真实场景:每个分片在(虚拟)不同机器上并行 Map')
分片0: ['apple banana apple', 'cherry apple']
分片1: ['banana banana cherry', 'apple']
分片2: ['cherry cherry banana apple', 'apple cherry']

➡️ 真实场景:每个分片在(虚拟)不同机器上并行 Map
3️⃣ Map 阶段:每个分片产出 (词, 1)¶
def mapper(line):
    out = []
    for w in line.lower().split():
        out.append((w, 1))
    return out

intermediate = []
for i, split in enumerate(splits):
    partition_out = []
    for line in split:
        partition_out += mapper(line)
    intermediate += partition_out
    print(f'分片{i} Map 输出: {partition_out}')
print(f'\n全部中间结果 {len(intermediate)} 条')
print('➡️ Map 输出也称 intermediate records,key=词,value=1')
分片0 Map 输出: [('apple', 1), ('banana', 1), ('apple', 1), ('cherry', 1), ('apple', 1)]
分片1 Map 输出: [('banana', 1), ('banana', 1), ('cherry', 1), ('apple', 1)]
分片2 Map 输出: [('cherry', 1), ('cherry', 1), ('banana', 1), ('apple', 1), ('apple', 1), ('cherry', 1)]

全部中间结果 15 条
➡️ Map 输出也称 intermediate records,key=词,value=1
📐 公式推导:Shuffle 的数据量与 IO 开销¶
Shuffle:Map 输出的中间数据按 key 分区、排序、落盘、跨节点拉取——是 MapReduce 最重的 IO 环节。
总中间数据量(输入 $n$ 条记录、每条产出 $k$ 个中间键值对、平均键值对大小 $s$ 字节、$M$ 个 Map 任务):
$$ \mathrm{Data}_{\mathrm{shuffle}} = n \times k \times s \;\text{Bytes} \qquad (\text{通常为输入的 2~5 倍}) $$
分区路由($R$ 个 Reduce 任务,默认按 key 哈希到 Reduce):
$$ \mathrm{part}(\mathrm{key}) = \mathrm{hash}(\mathrm{key}) \bmod R $$
推导要点:① 显式比较器(combiner)在 Map 端先局部合并:$\mathrm{Data}' = n k s (1 - \mathrm{combine\,ratio})$,可大幅压减落盘与网络量;② 排序开销 $O(nk \log(nk))$;③ 数据倾斜:若某 key 占比 $p \gg 1/R$,该 Reduce 任务负载为 $nk s \times p$,成为长尾——缓解见 07 篇"两阶段聚合先加盐"。
4️⃣ Shuffle:按 key 排序与分组¶
✍️ §4.1 手算 MapReduce 词频:3 个分片从 (词,1) 到计数¶
Map → Shuffle → Reduce 三阶段——3 分片 6 行文本手算,把"一堆 (word,1)"变成分组计数。
设定(3 个分片):
分片1: "apple banana", "banana cherry"
分片2: "apple cherry", "apple apple"
分片3: "banana cherry", "date"
第 1 步:Map——每个词吐一个 (word, 1):apple:4, banana:3, cherry:3, date:1(共 11 个键值对)
第 2 步:Shuffle——按 key 排序分组:
$$\text{apple}\to[1,1,1,1],\quad \text{banana}\to[1,1,1],\quad \text{cherry}\to[1,1,1],\quad \text{date}\to[1]$$
第 3 步:Reduce——求和:apple=4, banana=3, cherry=3, date=1
手算收获:
- Map 是"无状态逐条",Shuffle 是"全量排序分组"(磁盘 IO 大头),Reduce 是"组内聚合"——Shuffle 是最贵的一环(本 notebook §公式推导数据量)
- 词频看似简单但体现范式:所有"分组统计"(TopN、均值 §6)都是 Map 吐 (key, value) + Reduce 聚合
- 11 个键值对 = 所有单词出现次数总和:Map 输出量可以验证(数词即可),Reduce 输入行数 = 不同词数
- 局限性(§7):中间结果全落盘 → Spark 用内存 + 惰性求值解决,这就是 02 篇的动机
下面 numpy 复算。
# ---- §4.1 验证:numpy 复算 MapReduce 词频 ----
from collections import defaultdict

splits = [
    ['apple banana', 'banana cherry'],
    ['apple cherry', 'apple apple'],
    ['banana cherry', 'date'],
]
pairs = []
for split in splits:
    for line in split:
        for w in line.split():
            pairs.append((w, 1))
grouped = defaultdict(list)
for w, c in pairs:
    grouped[w].append(c)
result = {k: sum(v) for k, v in grouped.items()}
print(f'Map 键值对 = {len(pairs)},Reduce 结果 = {result}')
assert len(pairs) == 11
assert result == {'apple': 4, 'banana': 3, 'cherry': 3, 'date': 1}
print('\n✓ 与手算一致')
# 🖼️ 配图:MapReduce 三阶段数据流(Map → Shuffle → Reduce)
fig, ax = plt.subplots(figsize=(8.5, 4))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4.6)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.6))

# 输入分片
for i, txt in enumerate(['分片1', '分片2', '分片3']):
    box(0.3, 0.8 + i * 0.85, 1.3, 0.7, txt, '#e2e8f0')
# Map 任务
for i in range(3):
    box(2.3, 0.8 + i * 0.85, 1.3, 0.7, f'Map{i+1}\n→(词,1)', '#bfdbfe')
for i in range(3):
    arrow(1.7, 1.15 + i * 0.85, 2.2, 1.15 + i * 0.85)
# Shuffle(排序+分组)
box(4.4, 1.4, 1.7, 1.8, 'Shuffle\n排序+分组\n(落盘/网络)', '#fde68a')
box(6.8, 0.8, 1.6, 1.0, f'Reduce\n聚合计数', '#bbf7d0')
box(6.8, 2.2, 1.6, 1.0, 'Reduce\n聚合计数', '#bbf7d0')
for i in range(3):
    arrow(3.7, 1.15 + i * 0.85, 4.3, 2.1)
arrow(6.2, 2.2, 6.7, 2.6); arrow(6.2, 1.6, 6.7, 1.4)
box(8.8, 1.4, 1.0, 1.8, '结果', '#fecaca')
arrow(8.5, 2.3, 8.7, 2.3)
plt.title('MapReduce:Map(并行)→Shuffle(整序)→Reduce(聚合),中间结果落盘', fontsize=10.5)
plt.show()
print('➡️ 中间 (词,1) 数据要写磁盘再拉取——这就是"磁盘 IO 重"的由来')
➡️ 中间 (词,1) 数据要写磁盘再拉取——这就是"磁盘 IO 重"的由来
C:\Users\24260\AppData\Local\Temp\ipykernel_40056\1569949523.py:31: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# Shuffle = 排序(按 key) + 分组(相同 key 的 value 集合到一起)
intermediate_sorted = sorted(intermediate, key=lambda kv: kv[0])
grouped = {}
for k, v in intermediate_sorted:
    grouped.setdefault(k, []).append(v)
print('排序后(前 8 条):', intermediate_sorted[:8])
print('\n分组结果:', {k: len(v) for k, v in grouped.items()})
print('➡️ 面试点:Shuffle 是 MR 最耗时的环节(排序+网络传输),'
      '优化思路:map 端预聚合(combiner)、压缩中间数据')
排序后(前 8 条): [('apple', 1), ('apple', 1), ('apple', 1), ('apple', 1), ('apple', 1), ('apple', 1), ('banana', 1), ('banana', 1)]

分组结果: {'apple': 6, 'banana': 4, 'cherry': 5}
➡️ 面试点:Shuffle 是 MR 最耗时的环节(排序+网络传输),优化思路:map 端预聚合(combiner)、压缩中间数据
5️⃣ Reduce 阶段:聚合计数¶
result = {k: sum(v) for k, v in grouped.items()}
total = sum(result.values())
print('词频统计结果:', dict(sorted(result.items())))
print('总单词数:', total)

# 对照 pandas 验证
df = pd.DataFrame([w for s in splits for line in s for w in line.lower().split()], columns=['word'])
expected = df['word'].value_counts().sort_index().to_dict()
assert result == expected, 'MR 结果与 pandas 对照不一致'
print('✅ 与 pandas value_counts 对照完全一致')
total_words = sum(len(line.split()) for s in splits for line in s)
print('数据总单词数:', total_words)
assert total_words == 15
print('✅ MapReduce 逻辑正确')
词频统计结果: {'apple': 6, 'banana': 4, 'cherry': 5}
总单词数: 15
✅ 与 pandas value_counts 对照完全一致
数据总单词数: 15
✅ MapReduce 逻辑正确
6️⃣ 进阶:TopN 与均值(Reduce 变体)¶
# 平均分:Map 出 (班级, 分数),Reduce 求和并计数
records = [('一班', 85), ('二班', 92), ('一班', 78), ('三班', 88), ('二班', 95), ('一班', 90), ('三班', 70)]
grouped_scores = {}
for cls, sc in records:
    grouped_scores.setdefault(cls, []).append(sc)
avg = {cls: round(np.mean(vs), 2) for cls, vs in grouped_scores.items()}
print('各班平均分:', avg)

# TopN:全局 top2(跨分片,可用分区+归并)
top2 = sorted((v, k) for k, v in result.items())[-2:]
print('词频 Top2:', [(k, v) for v, k in top2[::-1]])
assert len(avg) == 3
print('✅ 变体任务完成')
各班平均分: {'一班': np.float64(84.33), '二班': np.float64(93.5), '三班': np.float64(79.0)}
词频 Top2: [('apple', 6), ('cherry', 5)]
✅ 变体任务完成
7️⃣ MapReduce 局限(面试必问)¶
print('''1) 磁盘 IO 重:中间结果落盘,迭代计算慢;
   -> 被 Spark(内存计算)替代,仅少数批任务保留;
2) 编程模型受限:复杂 DAG/迭代算法难表达;
3) 实时性差:分钟级延迟起步;
4) 大量 shuffle 排序开销;
5) 适用场景:超大单遍聚合(离线日志统计),如今多由 Hive/Spark SQL 语法糖承接。
''')
1) 磁盘 IO 重:中间结果落盘,迭代计算慢;
   -> 被 Spark(内存计算)替代,仅少数批任务保留;
2) 编程模型受限:复杂 DAG/迭代算法难表达;
3) 实时性差:分钟级延迟起步;
4) 大量 shuffle 排序开销;
5) 适用场景:超大单遍聚合(离线日志统计),如今多由 Hive/Spark SQL 语法糖承接。
📝 自测清单¶
- 能讲清 Map/Shuffle/Reduce 三阶段
- 能手写词频统计(Map 产出 (w,1) → 分组 → 求和)
- 能解释 Shuffle 为什么慢
- 能说出 MR 五点局限与替代方案