本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 机器人在什么「空间」里做规划?构型空间 C-space 到底把什么问题变简单了? | 核心概念 (a) + 深入原理 1 |
| BFS / Dijkstra / A* 都是图搜索,凭什么 A* 又快又「保证最优」? | 核心概念 (b) + 深入原理 2 |
| 高维空间里图搜索爆炸了怎么办?RRT 为什么「概率完备」? | 核心概念 (c) + 深入原理 3 |
| 规划出一条路径后,怎么变成能执行的平滑轨迹? | 核心概念 (d) + 深入原理 4 |
| PID 三个增益 Kp / Ki / Kd 到底在干嘛?离散 PID 怎么写? | 核心概念 (d) + 深入原理 5 |
| MPC 凭什么能「看着未来做决定」还兼顾约束?二次规划形式长什么样? | 核心概念 (e) + 深入原理 6 |
| 碰到人 / 碰到墙怎么办?阻抗控制与安全约束怎么落地? | 核心概念 (f) + 深入原理 7 |
| 算法说了这么多,能不能亲手写一遍跑一遍? | 代码实战 |
故事引入¶
6 轴机械臂「阿机」接到了一个任务:把桌上的杯子从 A 点举到 B 点。第一次,工程师让阿机直接动:6 个关节各自从当前角度「匀速走到」目标角度——结果手臂直接穿过了自己的底座。工程师定睛一看,问题出在「直走」:每个关节直走时,整条手臂在三维空间里的运动轨迹是弯的,中间会撞到自己。
于是工程师告诉阿机一个道理:动之前要先想好一条「不碰任何东西」的路,这叫规划;想好了还得走得准、走得稳,这叫控制。阿机开始学习四件事:
- 换个空间想问题:把「6 个关节角」拼成一个 6 维向量,机器人的每个姿势就是一个点。障碍物和自碰撞在这个「构型空间」里变成一块块不能进的区域——规划就变成「在无障碍区域里找一条从起点到终点的连线」。
- 找路的方法:地图被切成网格后,可以用搜索(BFS 一层层扫、Dijkstra 按已花代价扫、A* 拿指南针扫);地图太大、维数太高时,改用法宝「随机采样+长树」(RRT),采样采得够多就几乎一定能找到路——这叫概率完备。
- 把路变成轨迹:路径只是「往哪走」,轨迹还要回答「每时每刻到哪、速度多大」,于是有了梯形速度、三次多项式这类插值方法。
- 沿着轨迹走稳:实际执行会被惯性和噪声带偏,需要控制器拉回来——PID 三兄弟管「现在差多少、欠多少账、变化多快」,MPC 则直接「预演未来几步」挑最优动作;万一碰到人,还要靠阻抗控制「软」下来,靠约束机制保证安全。
从本章开始,「会思考的 AI」正式长出「会运动的身体」。
核心概念¶
(a) 🗂️ 规划问题的标准抽象:一个「点」代替整个机器人¶
先给一个贯穿全章的工作定义:
运动规划(Motion Planning):在构型空间(Configuration Space,简称 C-space)中,找一条从起始构型到目标构型的连续路径,使得路径上每个构型都不与障碍物碰撞。
「构型(Configuration)」就是能唯一描述机器人姿势的一组数(机械臂通常是各关节角)。把整套姿势压成一个点,是规划问题最重要的一次化简:
flowchart TB
    A["🧠 构型空间 C<br/>一个点 = 一个姿势"] --> B["🟦 自由空间 C_free<br/>不碰障碍的构型区"]
    A --> C["🟥 障碍空间 C_obs<br/>会碰撞的构型区"]
    B --> D["🎯 规划问题<br/>C_free 里找连续路径"]
    D --> E["🗺️ 路径 path<br/>只关心位置序列"]
    E --> F["🎢 轨迹 trajectory<br/>加上时间/速度/加速度"]
    F --> G["🎛️ 控制<br/>让执行跟上轨迹"]
- 构型空间 C:机器人的每个姿势对应一个点,点的坐标就是关节角(或少量的位姿参数)。维度 = 机器人的自由度:6 轴机械臂就是 6 维,双轮小车就是 2 维(x, y)。
- 自由空间 C_free:所有「不会撞到障碍、也不会自碰撞」的构型组成的区域。规划只能在自由空间里进行。
- 障碍空间 C_obs:会碰撞的构型区域。同一个障碍物,从三维工作空间变到 C-space 后形状会被「膨胀」成奇怪的扭曲块——这正是「换个空间想问题」的代价与收益。
- 规划问题:给定起点和终点构型,在自由空间里找一条连续曲线把它们连起来。连续意味着每个中间姿势都合法。
- 路径 path:只描述「经过哪些位置」的几何曲线,不关心速度和加速度。路径是规划的产物。
- 轨迹 trajectory:路径 + 时间信息:每个时刻机器人应该在哪、速度多大、加速度多大。轨迹是「可以执行」的路径,由插值/优化生成。
- 控制:轨迹只是「愿望」,执行机构(电机)有惯性、有误差,控制器负责让实际运动贴着愿望走,形成「规划—执行—反馈」闭环。
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · Simeo · CC BY-SA 3.0
(b) 🗂️ 图搜索三兄弟:BFS、Dijkstra 与 A*¶
最简单的一类规划:把连续空间离散成图(网格就是最常见的图),然后在图上找最短路径。三兄弟的区别只有一句话——「先扩展谁」:
flowchart TB
    A["🧠 图 G=(V,E)<br/>节点 + 边 + 代价"] --> B["🔄 BFS<br/>按「层数」扩展"]
    B --> C["⚖️ Dijkstra<br/>按「已花代价 g」扩展"]
    C --> D["🧭 A*<br/>按 f = g + h 扩展"]
    D --> E["🏁 搜到目标即最优<br/>h 可采纳时"]
    E --> F["⚡ 更快<br/>启发式指引方向"]
- 图 G=(V,E):节点是离散后的位置(网格单元),边是相邻关系,边上有代价(走一步的耗时/能耗)。
- BFS(广度优先):一圈一圈向外扫,谁离起点层数近先扩展谁。在无权图上它保证最短步数;一旦边带权重,它就不再保证最短代价路径(可能绕远)。
- Dijkstra(迪杰斯特拉):永远先扩展「从起点到它累计代价 g 最小」的节点,像水往低处流。它保证找到代价最短的路径,但代价是四面八方都要扫,效率低。
- A*:在 g 之上再加一个启发函数 h(到目标的估计剩余代价),先扩展 f=g+h 最小的节点,相当于给 Dijkstra 装了一个指南针。
- 搜到目标即最优:只要 h 不超估(可采纳,见深入原理 2),A* 第一次弹出目标时,找到的就是最优路径。
- 更快:好的 h 让搜索「直奔目标」,扩展的节点数远小于 Dijkstra;h≡0 时 A* 退化成 Dijkstra。
(c) 🗂️ 高维空间的救星:采样规划 RRT / RRT*¶
网格搜索在每个维度都要撒网格,6 维 C-space 立刻爆炸(维数灾难)。RRT(Rapidly-exploring Random Tree,快速扩展随机树)换个思路:不建完整地图,随机撒点、就近连树,让树像树根一样往目标方向蔓延:
flowchart TB
    A["🧠 随机采样<br/>C-space 里撒一个点"] --> B["🌳 生长树<br/>找最近邻+步长伸展"]
    B --> C["🧱 碰撞检查<br/>新边是否穿障碍"]
    C --> D["🎯 到达目标<br/>靠近即连接"]
    D --> E["📈 概率完备<br/>采样越多越可能成功"]
    E --> F["⭐ RRT*<br/>重选父节点+重布线"]
    F --> G["✨ 渐近最优<br/>代价收敛到最优"]
- 随机采样:在 C-space 里随机撒点(可以带一点「朝目标偏置」让它更积极)。采样天然绕开了「逐维建网格」的爆炸问题。
- 生长树:从已有的树里找离采样点最近的节点,朝采样点方向按固定步长「长」一个新节点,加入树中。
- 碰撞检查:新节点要合法(在自由空间),新边也不能穿过障碍物——用「线段细分采样」逐点检查。
- 到达目标:新节点离目标足够近且与目标连线无碰撞时,把目标连进树,成功找到一条路径。
- 概率完备:采样次数趋于无穷时,只要存在一条可行的通道,找到路径的概率趋于 1。注意这是「概率」意义上的完备——每次运行不一定成功,多试必成。
- RRT*:在 RRT 基础上多了两步「重选父节点(把新节点接给更优的邻居)」和「重布线(邻居改接新的更优节点)」,让树的路径代价随采样数增加不断下降。
- 渐近最优:RRT* 保证当采样数趋于无穷时,路径代价收敛到全局最优;而普通 RRT 只保证「找到一条可行路径」,不保证最优。
(d) 🗂️ 从路径到执行:轨迹插值与 PID 控制¶
路径是「路线图」,真正下发给电机的是轨迹(每时刻的目标位置/速度),而电机实际走的位置要靠控制器一点点拉回轨迹上来:
flowchart TB
    A["🗺️ 路径<br/>位置序列"] --> B["🎢 轨迹插值<br/>梯形速度/三次多项式"]
    B --> C["🎛️ 控制器<br/>PID / MPC"]
    C --> D["⚙️ 执行器<br/>电机/关节"]
    D --> E["📡 反馈<br/>编码器/IMU"]
    E --> C
    C --> F["✅ 执行目标<br/>跟踪误差小、不抖不超调"]
- 路径:规划的输出,一串位置(构型)。
- 轨迹插值:把离散路径点变成「每个时刻该在哪、速度多大」的平滑曲线。梯形速度(加速—匀速—减速)直观但加速度跳变;三次多项式用边界条件给出平滑位置曲线。
- 控制器:算「期望位置 − 实际位置」的误差,生成控制量(力矩/速度指令)。PID 是最经典的控制律。
- 执行器:电机把控制量变成机械运动;它慢半拍、有惯性、有摩擦,这就是误差的来源。
- 反馈:编码器量关节角、IMU 量姿态,把「实际状态」送回控制器,形成闭环——这是「走得稳」的关键。
- 执行目标:跟踪误差小、无超调、无振荡;超调大或抖动的机械臂既伤电机又危险。
(e) 🗂️ MPC:看着未来做决定¶
PID 只看「现在差多少」,MPC(Model Predictive Control,模型预测控制)则用模型预演未来 H 步,把「现在到未来 H 步的总代价」最小化,但只执行第一步,然后滚动重来:
flowchart TB
    A["🔮 预测模型<br/>x_{k+1} = A x_k + B u_k"] --> B["📐 代价函数<br/>跟踪误差 + 控制量惩罚"]
    B --> C["🧱 约束<br/>力矩/速度/避障"]
    C --> D["🔍 解有限时域优化<br/>通常是二次规划 QP"]
    D --> E["⚡ 只执行第一步 u_t"]
    E --> F["🔄 滚动:t+1 重测状态再解"]
    F --> A
- 预测模型:对系统动力学的近似,告诉 MPC「如果你现在给 u,未来状态会怎样变化」。模型越准,预测越可靠。
- 代价函数:把「偏离参考轨迹的程度」和「控制量大小」加权求和,MPC 优化的是这个总和。
- 约束:MPC 的一大卖点——速度上限、力矩上限、避障距离等都能直接写进优化问题。PID 很难优雅地处理约束。
- 解有限时域优化:在每个时刻解一个 H 步的小优化问题;对线性系统+二次代价+线性约束,恰好是二次规划(QP),成熟求解器毫秒级可解。
- 只执行第一步:优化出的是一串控制 u_t, u_{t+1}, ..., u_{t+H-1},但只把第一步 u_t 发给执行器——因为预测有误差,后面的计划不急着兑现。
- 滚动:等到下一个时刻,用最新测量重新预测、重新优化,周而复始。这就是「滚动优化(receding horizon)」,让 MPC 能抵抗模型误差和扰动。
(f) 🗂️ 安全兜底:阻抗控制与约束¶
机器人要和人共处一室,「硬碰硬」不可取。阻抗控制让机器人表现得像「弹簧+阻尼」,遇到外力顺势退让;同时安全机制盯住轨迹跟踪误差,超限就减速/停止/重规划:
flowchart TB
    A["🤝 阻抗控制<br/>期望弹簧-阻尼动力学"] --> B["🪶 柔顺交互<br/>碰撞时退让不硬顶"]
    C["📉 轨迹跟踪误差<br/>e(t) = x_ref(t) - x(t)"] --> D["⚠️ 误差超限<br/>减速/停止/重规划"]
    E["🧱 约束进优化<br/>|u|≤u_max、避障距离"] --> F["✅ 安全执行闭环"]
- 阻抗控制:把机器人的末端动力学「调教」成期望的惯量-阻尼-刚度,外力越大退让越多。人机协作、打磨抛光这类接触任务离不开它。
- 柔顺交互:阻抗参数调软(刚度 K 小)时,碰到人会像碰到弹簧一样弹开,而不是像铁块一样硬顶。
- 轨迹跟踪误差:期望轨迹与实际状态的差,是评估「走没走稳」的核心指标,也是触发安全动作的信号源。
- 误差超限:误差超过阈值说明出了状况(撞了/滑了/模型失灵),此时安全策略:减速 → 停止 → 重新规划,层层递进。
- 约束进优化:把力矩上限、速度上限、与障碍的最小距离写成 MPC 的约束,安全就成了「优化问题的硬性前提」,而不是事后补救。
深入原理¶
1. 构型空间 C-space:把机器人「压扁」成一个点¶
大白话直觉:6 个关节角 (θ₁,…,θ₆) 就是机器人的「身份证」,一个向量唯一确定一个姿势。把「姿势」当作一个点、把「所有可能姿势」当作一个空间,障碍物在这个空间里变成一块块「禁区」。于是「手臂穿过自己」这种问题,就变成了「路径是否穿过禁区」——几何问题,好办多了。
数学刻画:
$$ C = \prod_{i=1}^{n} C_i,\qquad C_{\mathrm{free}} = C \setminus C_{\mathrm{obs}},\qquad n = \text{自由度 DOF} $$
推导 / 展开:
- 每个关节角 θᵢ 的取值范围构成一维空间 Cᵢ(旋转关节通常是 [−π, π)),n 个关节的乘积空间就是 C-space,维度 = DOF。6 轴机械臂 → 6 维。
- 规划问题正式写成:找连续映射 q(s) : [0,1] → C_free,满足 q(0)=q_start、q(1)=q_goal,其中 q(s) 是「构型关于路径参数 s 的函数」。
- 障碍物从工作空间(三维笛卡尔空间)到 C-space 的变换是非线性的:一个长方体箱子在关节空间里会变成奇形怪状的弯曲区域,所以实践中很少显式画出 C_obs,而是用「采样构型 + 正运动学 + 碰撞检测」隐式判断某个点是否在 C_free 里。
- 自碰撞(手臂打到自己)同样可以塞进 C_obs——只要两个连杆的包围盒相交,就判定该构型非法。
- 为什么不在笛卡尔空间直接规划?因为笛卡尔空间的直线轨迹在关节空间可能是弯曲的,中间经过的姿势可能撞障碍甚至奇异;C-space 天然编码了「每个姿势合不合法」。
面试怎么问:
Q:6 轴机械臂在什么空间里做路径规划?C-space 是多少维? A:在构型空间(关节空间)做规划,6 轴就是 6 维,每一维是一个关节角;规划的目标是在自由空间 C_free 里找一条连接起始构型与目标构型的连续路径。
Q:为什么不直接在笛卡尔(工作)空间规划? A:工作空间的直线对应关节空间的非线性曲线,中间姿势可能碰撞或奇异;C-space 把姿态合法性编码进几何,规划问题更干净,但代价是维数高、障碍形状扭曲。
2. 图搜索与 A* 的可采纳启发函数¶
大白话直觉:Dijkstra 是个「闷头扫地」的强迫症,从起点向所有方向均匀扩展;A* 则拿着指南针(启发函数 h),总是优先处理「已经花的 + 估计还要花的」总代价最小的点。只要指南针永不夸大到目标的距离(可采纳),A* 第一次碰到终点时,走过的一定是最短的路。
数学刻画:
$$ f(n) = g(n) + h(n),\qquad \text{可采纳:}\ h(n) \le h^{*}(n),\qquad \text{一致(单调):}\ h(n) \le c(n,n') + h(n') $$
其中 g(n) 是起点到节点 n 的实际最优代价,h(n) 是 n 到目标代价的估计,h*(n) 是 n 到目标的真实最小代价,c(n,n') 是边 (n,n') 的代价。
推导 / 展开:
- 可采纳 ⇒ 最优:设最优路径代价为 C*。在 A* 弹出目标之前,最优路径上必有一个节点 n 尚未扩展(否则目标已被提前弹出)。沿最优路径走到 n 的 g(n) 就是最优前缀代价,于是 f(n)=g(n)+h(n) ≤ C*(因为 g(n) 是最优前缀、h(n) ≤ h*(n) 是剩余最优代价,二者之和 ≤ 整条最优路径代价)。A* 每次都弹出 open 表中 f 最小的节点,所以在弹出目标时必有 f(goal)=g(goal) ≤ C*;而任意路径代价 ≥ C*,故 g(goal)=C*,即找到最优。
- 一致 ⇒ 单调:一致性保证沿任何边扩展时 f 不下降(节点首次被扩展时就是最优的),因此每个节点至多扩展一次,不用反复重开;可采纳只保证最优性,不保证高效。
- h≡0:A* 退化为 Dijkstra;h 超估(不可采纳):可能率先弹出目标却丢掉真正最优的较长路径——「指南针说谎」。
- 网格寻路中的常见选择:4/8 邻域 + 曼哈顿距离(只允许横竖走时,可采纳且一致);8 邻域 + 欧氏距离(每条边代价 ≥ 欧氏增量,也满足一致)。
面试怎么问:
Q:A* 的启发函数为什么要可采纳?如果 h 超估会怎样? A:可采纳保证 A* 第一次弹出目标时路径最优;如果 h 超估,A* 可能贪心地沿一条「看起来近」的错路先到达目标,返回的路径虽然不是最优但通常仍然可行、且更快——工程上叫「weighted A*」的折中。
Q:可采纳和一致有什么区别?哪个更强? A:一致 ⇒ 可采纳,反之不成立。一致保证 f 单调、节点至多扩展一次、效率更高;可采纳只保证最优性。
Q:什么情况下 A* 退化成 Dijkstra? A:h≡0 时。此时 f=g,A* 与 Dijkstra 行为完全一致。
3. 采样规划 RRT / RRT*:随机撒点长出树¶
大白话直觉:网格搜索在 6 维空间里摊开就是天文数字个格子。RRT 不建图,而是「盲人摸象」:随机指一个方向,把树往那个方向长一小步;指多了,树就把整个空旷区域占满了,总会摸到目标。它不保证一次摸到,但摸得越多成功率越接近 100%——这叫概率完备。
数学刻画:
$$ \lim_{N\to\infty} P\big(\text{在 } N \text{ 次采样内找到可行路径}\big) = 1 \quad (\text{概率完备}),\qquad \text{RRT*: } \lim_{N\to\infty} c(\pi_N) = c(\pi^{*}) \quad (\text{渐近最优}) $$
推导 / 展开:
- 概率完备的非正式论证:若存在一条宽度 δ>0 的可行通道,则采样点落入通道内任意球邻域的概率正比于该球体积与 C-space 总体积之比,是个正的常数;N 次独立采样后「一次都没落入」的概率按指数衰减,趋于 0。一旦有采样点落入通道,树以正概率(步长伸展+碰撞检查通过)向它生长,最终以概率 1 把起点和目标连起来。
- 因此 RRT 不保证一次成功(非确定性完备),但保证只要解存在、采样足够多,成功概率趋于 1。
- 普通 RRT 找到的路径很「歪」(随机树不优化代价),且连接条件苛刻;RRT* 增加两步:
- 重选父节点:新节点不只认「最近邻」当爹,而是检查邻域内所有节点,选「经它到新节点代价最小」的做父节点;
- 重布线:再检查邻域内其他节点,如果改认新节点当爹能让它们代价更小,就更新。
- 这两步让树上的路径代价随采样增加单调改善,最终收敛到最优——即「渐近最优」。RRT 系列对高维、非凸、障碍形状任意的问题都适用,是机械臂规划的默认主力之一(工程上常用 RRT-Connect、Informed RRT* 等变体加速)。
面试怎么问:
Q:RRT 为什么概率完备?「完备」和「概率完备」的区别? A:完备 = 只要解存在就一定能找到(如网格搜索);概率完备 = 采样数趋于无穷时找到的概率趋于 1。RRT 每次随机采样是独立同分布的,可行通道总会被「撞上」,树又以正概率向采样点生长,所以成功概率随采样数收敛到 1。
Q:RRT* 相比 RRT 改进了什么?「渐近最优」是什么意思? A:新增「重选父节点 + 重布线」,使路径代价随采样数增加单调下降并收敛到最优,即渐近最优;普通 RRT 只保证找到可行路径。
Q:RRT 的路径为什么通常不是最优的?怎么改进? A:树是随机长出来的,边不是按代价选择的;改进方向包括 RRT*、Informed RRT*(只在最优路径的椭球内采样)以及 RRT 之后再做路径平滑/短截(shortcutting)。
4. 轨迹插值:把路径变成「什么时候到哪」¶
大白话直觉:路径是一串「路标」,但电机要的是「每时每刻的角度和角速度」。梯形速度把一趟运动切成「加速—匀速—减速」三段,像开车一样先猛踩油门再匀速巡航最后刹车;三次多项式则用「起点终点位置 + 起点终点速度」四个条件,直接解出一条平滑曲线。
数学刻画:
$$ q(t)=a_0+a_1 t+a_2 t^2+a_3 t^3,\qquad q(0)=q_0,\ q(T)=q_1,\ \dot q(0)=\dot q(T)=0 $$
推导 / 展开:
- 三次多项式:4 个未知系数 (a₀..a₃) 配 4 个边界条件,恰好唯一确定: $$ a_0=q_0,\quad a_1=0,\quad a_2=\frac{3(q_1-q_0)}{T^2},\quad a_3=-\frac{2(q_1-q_0)}{T^3} $$ 位置连续、速度连续(端点为 0),加速度 ȧ(t)=2a₂+6a₃t 是线性的——没有速度跳变,但加速度在 t=0 和 t=T 处仍会跳变(突变的力)。要更柔顺可换五次多项式(位置/速度/加速度都连续)或 S 型(S-curve)速度曲线。
- 梯形速度:设最大加速度 a_max、巡航速度 v_max。加速段时长 t_a = v_max/a_max,加速段位移 s_a = ½a_max t_a²。
- 若 2s_a < 总位移 q₁−q₀:三段式(加速—匀速—减速),匀速段位移 = (q₁−q₀) − 2s_a;
- 若 2s_a ≥ 总位移:来不及到 v_max 就要减速,退化为「三角形」速度曲线(只有加速—减速)。
- 梯形速度在加减速切换点加速度突变 → 冲击大,适合快速但粗糙的运动;平滑任务用高次多项式或 S 曲线。
- 多段路径:每个路径点两两之间做一段插值,段与段衔接处要保证速度/加速度连续(常用样条)。
面试怎么问:
Q:三次多项式插值为什么是平滑的?它的缺点是什么? A:它保证位置和速度连续(4 边界条件唯一确定 4 系数),但加速度在端点跳变,冲击较大;追求更平滑可用五次多项式或 S 型速度曲线。
Q:梯形速度曲线的轨迹怎么设计?什么情况会退化成三角形? A:按加速—匀速—减速三段设计;当两点距离太短、来不及加速到巡航速度时,匀速段长度为 0,就退化成三角形速度曲线。
5. PID 控制:三个旋钮各管一件事¶
大白话直觉:PID 就是三个「小眼睛」盯住误差 e(t) = 期望 − 实际:P 看「现在差多少」,差多少就推多大力;I 看「历史欠了多少账」,一直有残差就一直加码,直到把稳态误差清零;D 看「误差变化得多快」,看到误差在快速缩小就提前收力,防止冲过头。调 PID 本质就是调这三个旋钮的比例。
数学刻画(连续与离散):
$$ u(t)=K_p\, e(t)+K_i\!\int_0^{t}\! e(\tau)\,d\tau+K_d\,\frac{de(t)}{dt} \qquad\Longrightarrow\qquad u_k=K_p e_k + K_i\,\Delta t\sum_{i=0}^{k} e_i + K_d\,\frac{e_k-e_{k-1}}{\Delta t} $$
推导 / 展开:
- 离散化(控制器在单片机/工控机上都是按固定周期 Δt 采样):积分用矩形累加 Σ eᵢΔt,微分用前向差分 (eₖ−eₖ₋₁)/Δt。这就是面试手写题的标准答案,注意 Δt 的位置别写错。
- P 项:误差的即时放大。Kp 大 → 反应快,但过大导致振荡甚至发散;纯 P 对直流增益为 1 的稳定对象存在稳态误差 1/(Kp+1)(控制力与对象阻力平衡时到不了目标)。
- I 项:把历史误差累加,专门消灭稳态误差。代价是产生滞后,容易引发超调;积分累积过大造成积分饱和(windup)——输出饱和时积分还在涨,一旦误差反向要很久才能「还账」,典型表现是大幅超调。缓解:条件积分(饱和时不计累积)、积分限幅、anti-windup 反馈。
- D 项:误差的导数,起「刹车/阻尼」作用,减小超调、加快收敛。但它放大测量噪声——噪声的差分很大;缓解:测量值低通滤波、D 项只对测量值求导(避免对阶跃参考值产生微分冲击)。
- 调参经验顺序:先 P(让系统动起来、看稳态误差)→ 加 I(消稳态误差)→ 最后加 D(压超调),每次只动一个旋钮。
面试怎么问:
Q:离散 PID 公式写一下?三个增益分别管什么? A:uₖ = Kp·eₖ + Ki·Δt·Σeᵢ + Kd·(eₖ−eₖ₋₁)/Δt。P 管响应速度、I 管稳态误差、D 管阻尼/超调。注意积分要乘 Δt、微分要除 Δt。
Q:Kp 太大会怎样?为什么会有稳态误差? A:Kp 过大导致振荡甚至发散;稳态误差来自系统本身(如摩擦、重力、纯 P 的力平衡),I 项通过累积误差消除它。
Q:什么是积分饱和?怎么处理? A:输出饱和时积分仍在累积,恢复时过冲;用条件积分(饱和时不累加)、积分限幅或 anti-windup 结构解决。
Q:D 项对噪声敏感怎么办? A:对测量值做低通滤波,或 D 项只作用于测量值的差分(测量微分)而不是误差差分。
✍️ §5.1 手算 PID 两步输出:Kp=3, Ki=0.2, Kd=0.5¶
$u = K_p e + K_i\sum e + K_d\frac{de}{dt}$——两步手算,三个旋钮各贡献多少一目了然。
设定:$K_p=3,\ K_i=0.2,\ K_d=0.5,\ dt=1$;误差序列 $e_1=10,\ e_2=6$(初始 $\sum e=0$、上次误差 0)。
第 1 步($e=10$)
$$\Sigma e=10,\quad \frac{de}{dt}=\frac{10-0}{1}=10$$
$$u_1=3\times10+0.2\times10+0.5\times10=30+2+5=\mathbf{37}$$
第 2 步($e=6$)
$$\Sigma e=16,\quad \frac{de}{dt}=\frac{6-10}{1}=-4$$
$$u_2=3\times6+0.2\times16+0.5\times(-4)=18+3.2-2=\mathbf{19.2}$$
手算收获:
- 误差缩小但仍大:P 出力从 30 降到 18(跟随误差);I 项 2→3.2 持续累积(消除稳态残差);D 项从 +5 变 -4——误差在缩小,微分"预见到减速"主动刹车(§5 三个旋钮各管一件事)
- Kp 大:响应快但震荡;Kd 大:抑制超调但放大噪声;Ki 永累加:抗静差但易积分饱和——调参口诀"先 P 后 I 再 D"
- 数字本身验证:$u_2<u_1$ 因为误差在收敛——PID 在误差减小时输出应回落
- 面试速答:PID 是"闭环反馈",与前面的路径规划(开环)串联:规划给目标,PID 追目标(§5 ↔ 演示 3)
下面 numpy 复算。
# ---- §5.1 验证:numpy 复算 PID 两步 ----
Kp, Ki, Kd, dt = 3.0, 0.2, 0.5, 1.0
ie, e_prev = 0.0, 0.0
for e in (10.0, 6.0):
    ie += e
    de = (e - e_prev) / dt
    u = Kp * e + Ki * ie + Kd * de
    print(f'e={e:.0f} Σe={ie} Δe={de} → u = {u}')
    e_prev = e
assert u == 19.2
print('\n✓ 与手算一致')
6. MPC:每个时刻都解一个小优化¶
大白话直觉:PID 是个「近视眼」,只看当下误差;MPC 是个「带水晶球的人」——用动力学模型把未来 H 步的轨迹预演出来,然后挑「未来总代价最小」的控制序列。但水晶球也有误差,所以只执行第一步,下一步重新预演(滚动优化)。它还能把「速度不能超、别撞墙」写成硬约束,这是 PID 给不了的。
数学刻画:
$$ \min_{u_t,\dots,u_{t+H-1}}\ \sum_{k=t}^{t+H-1}\Big[ (x_k-x_k^{\mathrm{ref}})^{\top} Q\,(x_k-x_k^{\mathrm{ref}}) + u_k^{\top} R\,u_k\Big] \ \ \text{s.t.}\ \ x_{k+1}=Ax_k+Bu_k,\quad u_{\min}\le u_k\le u_{\max} $$
推导 / 展开:
- 预测:线性模型 x_{k+1}=Ax_k+Bu_k 反复迭代,未来 H 步的所有状态都可以写成控制序列 u=[u_t,…,u_{t+H-1}] 的仿射函数: $$ \mathbf{x} = M_s\, x_t + M_u\, u, $$ 把 x 代入代价函数,二次项集中到 u 上,就得到标准的**二次规划(QP)**形式: $$ \min_u\ \tfrac12 u^{\top} H u + g^{\top} u \quad \text{s.t.}\quad u_{\min}\le u\le u_{\max}, $$ 其中 H = M_uᵀ Q̄ M_u + R̄(半正定),g = M_uᵀ Q̄ (M_s x_t − x_ref)。线性约束(box、LTI 不等式)都保持 QP 结构,可被凸优化求解器毫秒级求解。
- 滚动优化(receding horizon):t 时刻解出 u*,只执行 u*ₜ;t+1 用新的实测状态重新预测、重新优化。滚动使 MPC 对模型误差和突发扰动有天然鲁棒性。
- 与 LQR 的关系:LQR 是一次性求解无限时域、无约束的二次型最优控制(黎卡提方程),适合离线算好状态反馈增益;MPC = 有限时域 + 约束 + 滚动,在线求解更贵但能处理约束,是自动驾驶、机械臂、无人机的主流。
- 实时性难点:每个控制周期都要在线解 QP,预测时域越长求解越慢;对策:缩短 H、问题线性化/凸化、用专用 QP 求解器、显式 MPC(离线把解分区存成查表)。
- 代码实战 4 里我们用「投影梯度法」手写解这个小 QP,直观感受一下「解优化 + 只执行第一步 + 滚动」的完整循环。
面试怎么问:
Q:MPC 和 PID 的本质区别是什么? A:MPC 有模型、有预测、有滚动优化,还能显式处理约束;PID 是单步反馈,无模型预测、无约束处理能力。MPC 的代价是每步都要在线求解优化问题。
Q:MPC 的约束是怎么写进优化的? A:把状态/控制约束写成决策变量 u 的线性不等式(利用动力学仿射展开),Q P求解器直接处理;非线性约束(如避障的距离不等式)需要线性化或凸化后近似进入 QP。
Q:MPC 的实时性怎么保证? A:缩短预测时域、问题凸化、使用快速 QP 求解器,或显式 MPC 把最优解离线分区在线查表;模型预测控制工期大部分花在这里。
7. 阻抗控制与安全约束¶
大白话直觉:位置控制把机械臂当「铁打的伺服」,命令它到哪就到哪,碰了墙也硬顶——遇到人非常危险。阻抗控制反其道:不给机器人规定「必须到哪」,而是规定「你表现得像一根弹簧加一个阻尼器」,外力推它,它就让;手一松开,它再弹回目标点。交互是否安全,由弹簧软硬(刚度 K)、阻尼大小(D)和惯量(M)决定。
数学刻画:
$$ M\,\ddot{\tilde{x}} + D\,\dot{\tilde{x}} + K\,\tilde{x} = F_{\mathrm{ext}},\qquad \tilde{x}=x-x_d $$
推导 / 展开:
- 目标动力学:期望的偏差 ẋ̃ 运动满足「质量-弹簧-阻尼」方程。没有外力(F_ext=0)时,偏差自然衰减到 0,即跟踪期望轨迹;有外力时,偏差被外力推开,推开多少由 M/D/K 决定。
- 参数直觉:**K(刚度)**大 → 弹簧硬,偏差小、接触力大;**D(阻尼)**大 → 运动更稳、不易振荡;**M(惯量)**大 → 对外力响应迟钝、「抗冲击」。人机协作任务通常把 K 调小、D 调大,让机器人「软」。
- 与导纳控制的关系:二者是同一个硬币的两面——阻抗控制是「给定位置偏差,输出期望力」(从力看位置),导纳控制是「测量外力,修正位置指令」(从位置看力);实际系统一侧有内环位置控制时,通常外层用导纳控制把力变成位置修正量。
- 安全与约束:
- 轨迹跟踪误差 e(t)=x_ref(t)−x(t):实时监控,|e| 超阈值说明系统失控(碰撞、滑移、模型错误),触发安全策略——降速 → 停机 → 重新规划,逐级升级;
- 避障进 MPC:把机器人与障碍的距离约束 d_k(x_k) ≥ d_safe 写成不等式(局部线性化后加入 QP),让「不撞」成为优化问题的硬前提;
- 软保护:再加关节力矩上限、速度上限、奇异规避等,共同构成多层安全网——规划层保证几何无碰撞,控制层保证执行不越界,阻抗层保证接触不发狠力。
面试怎么问:
Q:什么时候用阻抗控制而不是位置控制? A:需要与环境发生受控接触的任务(人机协作、打磨、插孔装配、拖动示教);纯位置控制在接触时会产生巨大的接触力,阻抗控制通过「软」的虚拟动力学把接触力限制在安全范围。
Q:阻抗参数 M / D / K 的物理意义?调大 K 会怎样? A:K 是虚拟刚度,越大越硬、跟随越紧但接触力越大;D 是虚拟阻尼,越大越稳、越不容易振荡;M 是虚拟惯量,越大对外力越迟钝。调大 K 会让机器人在接触时「还手」更狠。
Q:避障约束在 MPC 里怎么建模? A:把「与障碍最短距离 ≥ d_safe」写成关于状态的不等式约束,通常在参考轨迹附近线性化(或凸化)后作为线性约束加入 QP;加上跟踪误差监控、速度/力矩上限,构成多层安全机制。
代码实战¶
四个纯 numpy 手写演示,全部固定输入、固定随机种子,可重复执行(先运行「环境设置」单元):
- A* 网格寻路:同一张地图上对比 BFS / Dijkstra / A* 的扩展节点数与路径代价,验证「可采纳启发式 ⇒ 最优 + 更快」;
- RRT 采样规划:在 2D 构型空间随机撒点建树,看概率完备的树如何绕开障碍摸到目标;
- PID 仿真:对一阶系统做阶跃 / 正弦跟踪,分别调 Kp / Ki / Kd,观察稳态误差、超调与振荡;
- MPC 滚动优化:一维小车(双积分模型),每个时刻重解有限时域二次规划,对比「无控制 / 一次性最优 / 滚动 MPC」。
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except (AttributeError, TypeError):
    pass  # Jupyter 内核的 OutStream 已支持 UTF-8,此处自动降级为 no-op

import os
os.makedirs('images', exist_ok=True)   # 图片统一保存到 images/ 目录

import numpy as np
import matplotlib
matplotlib.use('Agg')                  # 无界面后端,兼容无显示器环境
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']  # 中文字体
plt.rcParams['axes.unicode_minus'] = False                       # 负号正常显示

print('环境就绪:numpy', np.__version__, '| matplotlib', matplotlib.__version__)

plt.show()
环境就绪:numpy 2.4.3 | matplotlib 3.10.8
演示 1:A* 网格寻路(含 BFS / Dijkstra 对比)¶
加权网格:8 邻域、正交边代价 1、对角边代价 √2。BFS 玩的是无权游戏(且只走 4 邻域,不抄斜线捷径),Dijkstra 和 A* 按真实代价搜索;A* 用欧氏距离作启发函数(可采纳且一致)。对比能同时看出「带权图上 BFS 不保证最短」与「启发式让 A* 又快又优」。
# ============ 演示 1:A* 网格寻路 ============
import heapq
from collections import deque

R = 21
MAP = np.zeros((R, R), dtype=np.int8)
# 手工障碍:几堵带缺口的墙(保证存在可行路径,且绕行有辨识度)
MAP[3:14, 6] = 1
MAP[9:18, 14] = 1
MAP[12, 8:18] = 1
MAP[16, 4:12] = 1
MAP[5:9, 10] = 1
START = (2, 2)
GOAL = (18, 18)
assert MAP[START] == 0 and MAP[GOAL] == 0, "起终点必须是空地"

DIRS = [(-1, 0), (1, 0), (0, -1), (0, 1),
        (-1, -1), (1, -1), (-1, 1), (1, 1)]
DIRS4 = DIRS[:4]   # BFS 用 4 邻域(无权搜索,不能抄斜线捷径)

def step_cost(dx, dy):
    return 1.0 if dx == 0 or dy == 0 else np.sqrt(2.0)

def inside(p):
    return 0 <= p[0] < R and 0 <= p[1] < R

def neighbors(p, dirs=DIRS):
    for dx, dy in dirs:
        q = (p[0] + dx, p[1] + dy)
        if inside(q) and MAP[q] == 0:
            yield q, step_cost(dx, dy)

def bfs_path():
    # 无权 BFS:按层数扩展(忽略边权重,且只走 4 邻域)
    prev = {START: None}
    dq = deque([START])
    while dq:
        p = dq.popleft()
        if p == GOAL:
            break
        for q, _ in neighbors(p, DIRS4):
            if q not in prev:
                prev[q] = p
                dq.append(q)
    path = []
    cur = GOAL
    while cur is not None:
        path.append(cur)
        cur = prev[cur]
    path.reverse()
    return path, len(prev)          # 返回路径与访问节点数

def dijkstra_path():
    # Dijkstra:按累计代价 g 扩展(用最小堆)
    dist = {START: 0.0}
    prev = {START: None}
    pq = [(0.0, START)]
    closed = set()
    expanded = 0
    while pq:
        d, p = heapq.heappop(pq)
        if p in closed:
            continue
        closed.add(p)
        expanded += 1
        if p == GOAL:
            break
        for q, cc in neighbors(p):
            nd = d + cc
            if nd < dist.get(q, float('inf')):
                dist[q] = nd
                prev[q] = p
                heapq.heappush(pq, (nd, q))
    path = []
    cur = GOAL
    while cur is not None:
        path.append(cur)
        cur = prev[cur]
    path.reverse()
    return path, expanded

def astar_path():
    # A*:f = g + h,h 用欧氏距离(可采纳且一致)
    def h(p):
        return np.hypot(GOAL[0] - p[0], GOAL[1] - p[1])
    dist = {START: 0.0}
    prev = {START: None}
    pq = [(h(START), 0.0, START)]      # (f, g, node)
    closed = set()
    expanded = 0
    while pq:
        f, g, p = heapq.heappop(pq)
        if p in closed:
            continue
        closed.add(p)
        expanded += 1
        if p == GOAL:
            break
        for q, cc in neighbors(p):
            ng = g + cc
            if ng < dist.get(q, float('inf')):
                dist[q] = ng
                prev[q] = p
                heapq.heappush(pq, (ng + h(q), ng, q))
    path = []
    cur = GOAL
    while cur is not None:
        path.append(cur)
        cur = prev[cur]
    path.reverse()
    return path, expanded

def path_cost(path):
    return sum(step_cost(b[0] - a[0], b[1] - a[1]) for a, b in zip(path, path[1:]))

p_bfs, n_bfs = bfs_path()
p_dij, n_dij = dijkstra_path()
p_ast, n_ast = astar_path()
c_bfs, c_dij, c_ast = path_cost(p_bfs), path_cost(p_dij), path_cost(p_ast)

print('路径存在核对:', GOAL in p_bfs and GOAL in p_dij and GOAL in p_ast)
print('代价对比  BFS={:.3f}  Dijkstra={:.3f}  A*={:.3f}'.format(c_bfs, c_dij, c_ast))
print('扩展/访问节点数  BFS={}  Dijkstra={}  A*={}'.format(n_bfs, n_dij, n_ast))
print('最优性核对:Dijkstra 与 A* 代价一致 →', np.isclose(c_dij, c_ast))
print('教训核对:带权图上 BFS(无视权重、只走 4 邻域)绕远 → 代价 {:.3f} >= 最优 {:.3f}?'.format(c_bfs, c_ast), c_bfs >= c_ast - 1e-9)
print('效率核对:A* 扩展节点数 < Dijkstra →', n_ast < n_dij)

# 画图:左=地图与 A* 路径,右=扩展节点数对比
fig, axes = plt.subplots(1, 2, figsize=(11.5, 4.6))
ax = axes[0]
grid = np.where(MAP == 1, 0.0, 1.0)
ax.imshow(grid, cmap='Greys', origin='lower')
ys, xs = zip(*p_ast)
ax.plot(xs, ys, '-o', color='crimson', lw=2.2, ms=3, label='A* 最短路径')
ax.plot(START[1], START[0], 's', color='tab:green', ms=11, label='起点')
ax.plot(GOAL[1], GOAL[0], '*', color='tab:blue', ms=15, label='终点')
ax.set_xticks([]); ax.set_yticks([])
ax.set_title('地图与 A* 最短路径(8 邻域加权)')
ax.legend(loc='upper left', fontsize=8)
ax2 = axes[1]
labels = ['BFS', 'Dijkstra', 'A*']
vals = [n_bfs, n_dij, n_ast]
bars = ax2.bar(labels, vals, color=['#9ecae1', '#6baed6', '#3182bd'])
for b, v in zip(bars, vals):
    ax2.text(b.get_x() + b.get_width() / 2, v + 2, str(v), ha='center', fontsize=10)
ax2.set_ylabel('扩展(访问)节点数')
ax2.set_title('扩展节点数:越少越快')
ax2.set_ylim(0, max(vals) * 1.2)
fig.tight_layout()
fig.savefig('images/emb02_astar.png', dpi=120)
plt.show()
print('已保存 images/emb02_astar.png')
路径存在核对: True
代价对比  BFS=32.000  Dijkstra=26.142  A*=26.142
扩展/访问节点数  BFS=392  Dijkstra=388  A*=140
最优性核对:Dijkstra 与 A* 代价一致 → True
教训核对:带权图上 BFS(无视权重、只走 4 邻域)绕远 → 代价 32.000 >= 最优 26.142? True
效率核对:A* 扩展节点数 < Dijkstra → True
已保存 images/emb02_astar.png
C:\Users\24260\AppData\Local\Temp\ipykernel_30708\467080302.py:151: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
运行结果示例(可在浏览器中直接查看图片内容):
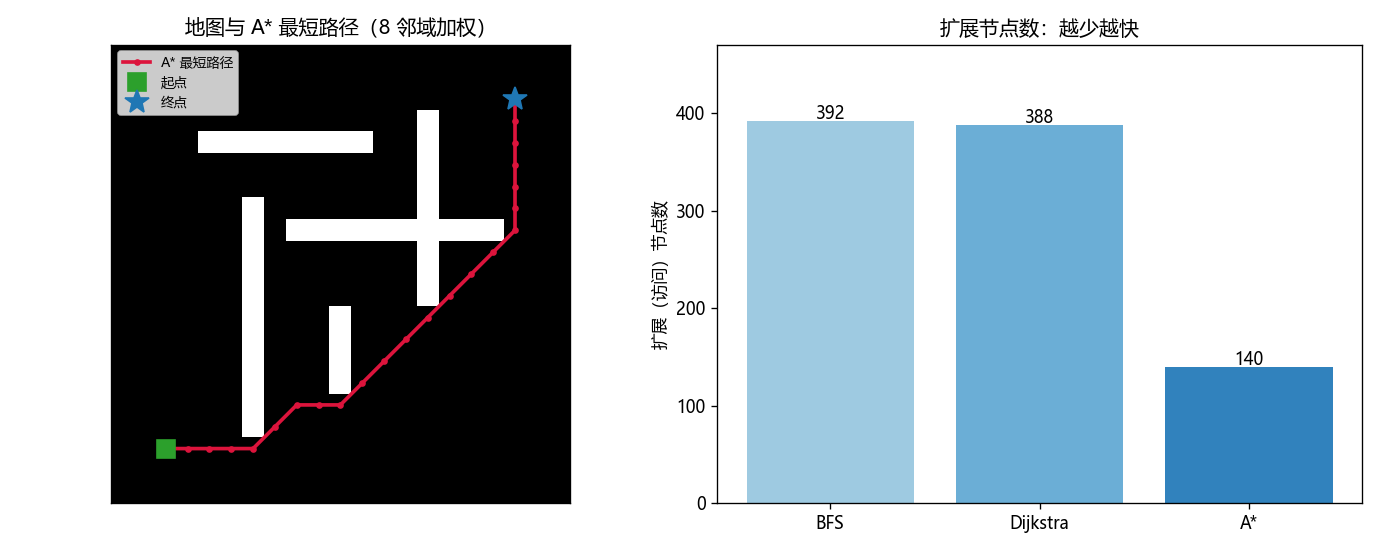
结论:三条路径代价里 Dijkstra 与 A* 完全一致(都保证最优),BFS 因为无视边权重而绕远;扩展节点数 A* 最少,证明「可采纳启发式 = 又快又优」。
演示 2:RRT 采样建树(概率完备的直观体验)¶
C-space 取 2D 平面 [0,10]×[0,10],障碍物是四个圆。固定随机种子(42),每次运行结果一致;把 MAX_ITER 调大可以观察成功率上升——这就是概率完备的滋味。
# ============ 演示 2:RRT 采样建树 ============
rng = np.random.default_rng(42)          # 固定种子,结果可复现
Q_START = np.array([1.0, 1.0])
Q_GOAL = np.array([9.0, 9.0])
OBS = [(5.0, 5.0, 1.7), (2.8, 7.6, 1.2), (7.2, 2.4, 1.3), (7.6, 6.8, 1.0)]  # (cx, cy, r)
STEP = 0.6                               # 每次伸展的步长
GOAL_R = 0.7                             # 判定“到达目标”的半径
MAX_ITER = 4000
GOAL_BIAS = 0.08                         # 一定概率直接采样目标,加快收敛

def point_free(p):
    return all(np.hypot(p[0] - cx, p[1] - cy) > r for cx, cy, r in OBS)

def seg_free(a, b, k=20):
    # 线段细分采样检查:任何一点进障碍都算碰撞
    for s in np.linspace(0.0, 1.0, k + 1):
        if not point_free(a + s * (b - a)):
            return False
    return True

assert point_free(Q_START) and point_free(Q_GOAL)

nodes = [Q_START]                # 树节点
parent = {0: -1}                 # 父指针(根节点为 -1)
goal_idx = None

for it in range(MAX_ITER):
    # 1) 采样:小概率直接采目标,否则均匀随机
    if rng.random() < GOAL_BIAS:
        q_rand = Q_GOAL
    else:
        q_rand = np.array([rng.uniform(0, 10), rng.uniform(0, 10)])
    # 2) 找最近邻
    best = min(range(len(nodes)), key=lambda k: np.linalg.norm(nodes[k] - q_rand))
    nq = nodes[best]
    d = np.linalg.norm(q_rand - nq)
    # 3) 向采样点方向伸展一个步长
    q_new = nq + (q_rand - nq) / d * min(d, STEP)
    # 4) 碰撞检查通过才加入树
    if point_free(q_new) and seg_free(nq, q_new):
        idx = len(nodes)
        nodes.append(q_new)
        parent[idx] = best
        # 5) 靠近目标且连线无碰撞 → 连接目标,大功告成
        if np.linalg.norm(q_new - Q_GOAL) < GOAL_R and seg_free(q_new, Q_GOAL):
            goal_idx = idx
            break

# 沿父指针回溯得到路径
path = []
cur = goal_idx
while cur is not None and cur != -1:
    path.append(nodes[cur])
    cur = parent.get(cur, -1)
path.reverse()

print('找到路径核对:', goal_idx is not None)
print('树节点数:', len(nodes), '(迭代次数:', it + 1, ')')
all_free = all(seg_free(nodes[a], nodes[b])
               for a, b in ((parent[i], i) for i in range(1, len(nodes))))
print('所有树边避障核对:', all_free)
if goal_idx is not None:
    plen = sum(np.linalg.norm(np.array(b) - np.array(a)) for a, b in zip(path, path[1:]))
    straight = np.linalg.norm(Q_GOAL - Q_START)
    print('路径长度={:.3f},直线距离={:.3f},绕行比={:.2f}'.format(plen, straight, plen / straight))
print('提示:采样次数 MAX_ITER 越大,找到路径的概率越接近 1 —— 这就是“概率完备”;')
print('普通 RRT 路径不保证最优,RRT* 通过“重选父节点+重布线”做到渐近最优。')
找到路径核对: True
树节点数: 122 (迭代次数: 187 )
所有树边避障核对: True
路径长度=13.200,直线距离=11.314,绕行比=1.17
提示:采样次数 MAX_ITER 越大,找到路径的概率越接近 1 —— 这就是“概率完备”;
普通 RRT 路径不保证最优,RRT* 通过“重选父节点+重布线”做到渐近最优。
演示 3:PID 仿真 —— 阶跃 / 正弦跟踪¶
被控对象取二阶质量-弹簧-阻尼系统(ω=6、阻尼 ζ=0.35,欠阻尼:纯比例控制会振荡),控制周期 Δt=0.01s,输出限幅 ±3。离散 PID 按标准式 uₖ = Kp·eₖ + Ki·Δt·Σeᵢ + Kd·(eₖ−eₖ₋₁)/Δt 实现,并带条件积分(抗饱和)。
# ============ 演示 3:PID 仿真 ============
dt = 0.01
T = 6.0
N = int(T / dt)
t = np.arange(N) * dt
W, ZETA = 6.0, 0.35    # 二阶对象:固有频率 ω、阻尼比 ζ(欠阻尼,会振荡/超调)

def plant_step(x, v, u):
    # 二阶质量-弹簧-阻尼离散:a = ω²(u - x) - 2ζω v
    a = W**2 * (u - x) - 2 * ZETA * W * v
    return x + dt * v, v + dt * a

def pid_track(Kp, Ki, Kd, ref, u_lim=3.0):
    # 离散 PID + 条件积分(饱和时不计入累积,缓解 windup)
    x, v, e_prev, integ = 0.0, 0.0, 0.0, 0.0
    xs = np.zeros(N)
    us = np.zeros(N)
    for k in range(N):
        e = ref[k] - x
        integ += e * dt
        u = Kp * e + Ki * integ + Kd * (e - e_prev) / dt   # 标准离散 PID
        if u > u_lim:
            u = u_lim
            integ -= e * dt
        elif u < -u_lim:
            u = -u_lim
            integ -= e * dt
        x, v = plant_step(x, v, u)
        xs[k], us[k] = x, u
        e_prev = e
    return xs, us

ref_step = np.ones(N)                                        # 阶跃参考
xs_p1, _ = pid_track(1.0, 0.0, 0.0, ref_step)   # 只 P,Kp=1
xs_p2, _ = pid_track(2.0, 0.0, 0.0, ref_step)   # 只 P,Kp=2
xs_p5, _ = pid_track(5.0, 0.0, 0.0, ref_step)   # 只 P,Kp=5
xs_pi, _ = pid_track(2.0, 2.0, 0.0, ref_step)   # P + I(消稳态误差)
xs_pid, _ = pid_track(2.0, 2.0, 0.5, ref_step)  # P + I + D(压超调)

print('核对1:纯 P 存在稳态误差(Kp=1/2/5 → 约 0.50/0.33/0.17):',
      '{:.3f} / {:.3f} / {:.3f}'.format(abs(1 - xs_p1[-1]), abs(1 - xs_p2[-1]),
                                        abs(1 - xs_p5[-1])))
print('核对2:加入 I(Ki=2)后稳态误差 ≈ 0:', abs(1 - xs_pi[-1]))
print('核对3:加入 D 后超调显著减小:overshoot(PI)={:.4f},overshoot(PID)={:.4f}'.format(
    max(xs_pi) - 1, max(xs_pid) - 1))

ref_sin = 0.5 + 0.4 * np.sin(2 * np.pi * 0.5 * t)            # 正弦参考
xs_sin, _ = pid_track(2.5, 2.0, 0.6, ref_sin)
rmse = np.sqrt(np.mean((xs_sin - ref_sin) ** 2))
print('核对4:正弦跟踪 RMSE = {:.4f}(0.1 量级算跟得不错)'.format(rmse))

# 画图:2x2 展示 P / I / D 各自的作用
fig, axes = plt.subplots(2, 2, figsize=(11, 7.2))
ax = axes[0, 0]
for xs, lab, col in [(xs_p1, 'Kp=1', '#9ecae1'), (xs_p2, 'Kp=2', '#6baed6'), (xs_p5, 'Kp=5', '#3182bd')]:
    ax.plot(t, xs, label=lab, color=col)
ax.plot(t, ref_step, 'k--', lw=1, label='参考')
ax.set_title('纯 P:Kp 越大越快,但稳态误差仍在')
ax.legend(fontsize=8); ax.set_xlabel('t (s)'); ax.set_ylabel('x')

ax = axes[0, 1]
ax.plot(t, xs_pi, label='PI (Kp=2, Ki=2)', color='tab:orange')
ax.plot(t, xs_pid, label='PID (+Kd=0.5)', color='tab:red')
ax.plot(t, ref_step, 'k--', lw=1, label='参考')
ax.set_title('加 I 消除稳态误差,加 D 压超调')
ax.legend(fontsize=8); ax.set_xlabel('t (s)'); ax.set_ylabel('x')

ax = axes[1, 0]
ax.plot(t, ref_sin, 'k--', lw=1.2, label='参考正弦')
ax.plot(t, xs_sin, color='tab:green', lw=1.4, label='PID 跟踪')
ax.set_title('正弦跟踪(Kp=2.5, Ki=2, Kd=0.6)')
ax.legend(fontsize=8); ax.set_xlabel('t (s)'); ax.set_ylabel('x')

ax = axes[1, 1]
ss = [abs(1 - x[-1]) for x in (xs_p1, xs_p2, xs_p5, xs_pi, xs_pid)]
labs = ['P Kp=1', 'P Kp=2', 'P Kp=5', 'PI', 'PID']
bars = ax.bar(labs, ss, color=['#9ecae1', '#6baed6', '#3182bd', '#fdae6b', '#d7301f'])
ax.set_yscale('log')
ax.set_title('阶跃稳态误差:I 项把它压到 ~0')
for b, v in zip(bars, ss):
    ax.text(b.get_x() + b.get_width() / 2, v * 1.2, '{:.1e}'.format(v), ha='center', fontsize=7)
fig.tight_layout()
fig.savefig('images/emb02_pid.png', dpi=120)
plt.show()
print('已保存 images/emb02_pid.png')
核对1:纯 P 存在稳态误差(Kp=1/2/5 → 约 0.50/0.33/0.17): 0.500 / 0.333 / 0.168
核对2:加入 I(Ki=2)后稳态误差 ≈ 0: 0.005605922403689401
核对3:加入 D 后超调显著减小:overshoot(PI)=0.2051,overshoot(PID)=-0.0024
核对4:正弦跟踪 RMSE = 0.1131(0.1 量级算跟得不错)
已保存 images/emb02_pid.png
C:\Users\24260\AppData\Local\Temp\ipykernel_30708\1594282043.py:84: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
运行结果示例:
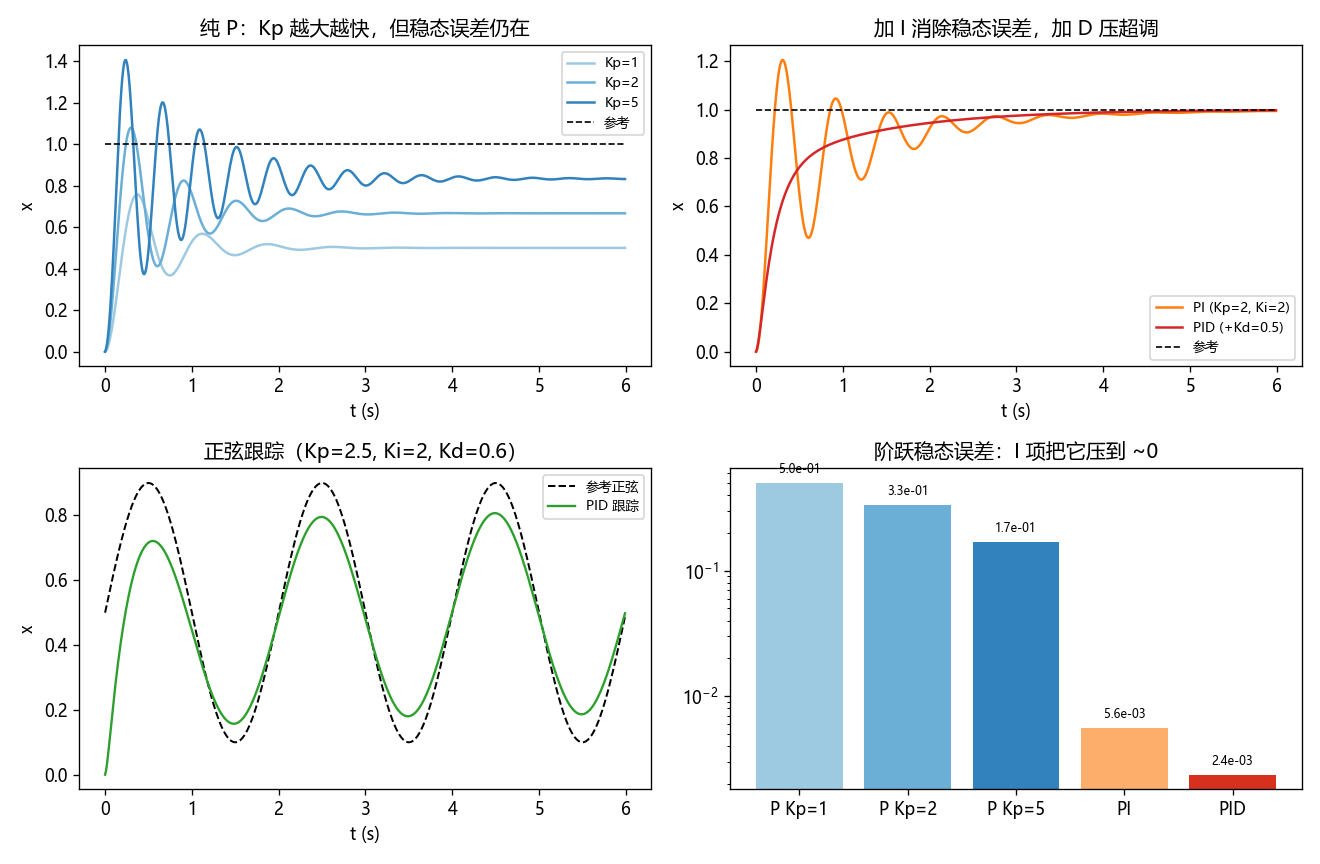
结论:纯 P 追不到目标(稳态误差 = 1/(Kp+1)),加 I 后误差清零但可能出现超调,加 D 提供阻尼把超调压下去;对正弦参考,参数得当的 PID 能把 RMSE 压在 0.1 量级。
演示 4:MPC —— 一维小车的滚动优化¶
小车模型是双积分器:位置 x 由速度 v 更新、速度 v 由控制 u 更新。MPC 每个时刻解一个 H=12 步的二次规划(投影梯度法手写求解),只执行第一步,再滚动;对比「无控制」「一次性最优(只在 t=0 解一次)」「滚动 MPC」,并在第 20/40 步加入确定性扰动考验三者的抗干扰能力。
# ============ 演示 4:MPC 一维小车(滚动优化) ============
dt = 0.1
H = 12                       # 预测时域
N_STEPS = 60
Qx, Qv, R = 0.5, 2.0, 0.05   # 位置/速度误差与控制量权重
U_MAX = 3.0
A = np.array([[1.0, dt], [0.0, 1.0]])
B = np.array([[0.0], [dt]])

def refs_at(t0, x0):
    # 未来 H 步的参考:前 3s 期望速度 1.2,之后 0.4(位置斜坡参考)
    xr, vr = [], []
    x = x0
    for k in range(H):
        vref = 1.2 if (t0 + k) * dt < 3.0 else 0.4
        x += vref * dt
        xr.append(x)
        vr.append(vref)
    return np.array(xr), np.array(vr)

def build_sys():
    # 把未来 H 步状态写成决策 u 的仿射函数:s = Ms@s0 + Mu@u
    Ms = np.zeros((2 * H, 2))
    Mu = np.zeros((2 * H, H))
    for k in range(H):
        Ms[2 * k:2 * k + 2, :] = np.linalg.matrix_power(A, k)
        for j in range(k):
            Mu[2 * k:2 * k + 2, j] = (np.linalg.matrix_power(A, k - 1 - j) @ B)[:, 0]
    return Ms, Mu

MS, MU = build_sys()
QM = np.zeros((2 * H, 2 * H))
QM[0::2, 0::2] = Qx
QM[1::2, 1::2] = Qv

def mpc_solve(x0, v0, t0):
    # 解有限时域 QP:min ½uᵀHu+gᵀu,s.t. -U_MAX <= u <= U_MAX(投影梯度法)
    xr, vr = refs_at(t0, x0)
    ref = np.zeros(2 * H)
    ref[0::2], ref[1::2] = xr, vr
    pred = MS @ np.array([x0, v0]) - ref
    Hmat = MU.T @ QM @ MU + R * np.eye(H)          # 二次项矩阵(半正定)
    gvec = MU.T @ QM @ pred                         # 一次项
    lam = np.linalg.eigvalsh(Hmat).max()
    alpha = 1.0 / (lam + 1e-9)                      # 梯度步长(保证收敛)
    u = np.zeros(H)
    for _ in range(500):
        u = u - alpha * (Hmat @ u + gvec)           # 梯度下降步
        u = np.clip(u, -U_MAX, U_MAX)               # 投影回可行域(box 约束)
    return u

def simulate(mode):
    x, v = 0.0, 0.0
    xs, vs, us = [], [], []
    one_shot = None
    if mode == 'one_shot':
        one_shot = mpc_solve(0.0, 0.0, 0)           # 只在 t=0 解一次
    for t0 in range(N_STEPS):
        if t0 == 20:
            v += 0.5                                # 确定性扰动:外界推了一把
        if t0 == 40:
            v -= 0.3
        if mode == 'mpc':
            u0 = mpc_solve(x, v, t0)[0]             # 滚动:每时刻重解,只取第一步
        elif mode == 'one_shot':
            u0 = one_shot[t0] if t0 < H else 0.0
        else:
            u0 = 0.0
        u0 = np.clip(u0, -U_MAX, U_MAX)
        x, v = A @ np.array([x, v]) + B.ravel() * u0
        xs.append(x); vs.append(v); us.append(u0)
    return np.array(xs), np.array(vs), np.array(us)

xs_m, vs_m, us_m = simulate('mpc')
xs_o, vs_o, us_o = simulate('one_shot')
xs_n, vs_n, us_n = simulate('none')

vref_all = np.array([1.2 if k * dt < 3.0 else 0.4 for k in range(N_STEPS)])
def rmse(v):
    return np.sqrt(np.mean((v - vref_all) ** 2))

print('约束核对:滚动 MPC 全程 |u|<=3 →', np.abs(us_m).max() <= 3.0 + 1e-9)
print('速度跟踪 RMSE:无控制={:.3f}  一次性最优={:.3f}  滚动 MPC={:.3f}'.format(
    rmse(vs_n), rmse(vs_o), rmse(vs_m)))
print('抗扰核对:扰动后 MPC 重新规划 → RMSE 最小(<无控制 且 <一次性最优)→',
      rmse(vs_m) < rmse(vs_n) and rmse(vs_m) < rmse(vs_o))
tail = slice(40, 60)
r_tail_m = np.sqrt(np.mean((vs_m[tail] - vref_all[tail]) ** 2))
r_tail_o = np.sqrt(np.mean((vs_o[tail] - vref_all[tail]) ** 2))
print('恢复核对(扰动后 40~60 步,期望 0.4):滚动 MPC 尾段 RMSE={:.3f} << 一次性最优={:.3f} →'.format(
    r_tail_m, r_tail_o), r_tail_m < r_tail_o)
print('终点:x={:.2f}, v={:.2f}(滚动 MPC 最终速度应回到参考 0.4 附近)'.format(xs_m[-1], vs_m[-1]))
print('原理回顾:只执行 u_t、t+1 重测重解 —— 这就是“滚动优化 (receding horizon)”。')
约束核对:滚动 MPC 全程 |u|<=3 → True
速度跟踪 RMSE:无控制=0.759  一次性最优=1.130  滚动 MPC=0.240
抗扰核对:扰动后 MPC 重新规划 → RMSE 最小(<无控制 且 <一次性最优)→ True
恢复核对(扰动后 40~60 步,期望 0.4):滚动 MPC 尾段 RMSE=0.081 << 一次性最优=1.367 → True
终点:x=5.35, v=0.49(滚动 MPC 最终速度应回到参考 0.4 附近)
原理回顾:只执行 u_t、t+1 重测重解 —— 这就是“滚动优化 (receding horizon)”。
模型详解(面试深度)¶
本篇按"图搜索 → 采样规划 → 轨迹生成 → 闭环控制 → 轨迹优化 → 柔顺控制 → 任务规划"的线索,梳理具身智能最常见的规划与控制方法。面试叙事建议:先讲清"这一步在解决什么问题",再上公式与流程,最后落到记忆点。
1. 图搜索三兄弟:BFS、Dijkstra、A*¶
一句话定位:离散栅格/路图上做节点搜索的三个递进算法——BFS 管无权图的最短路,Dijkstra 管加权图的最短路,A* 用启发式信息加速 Dijkstra。
核心公式与算法流程
- BFS:队列(FIFO)逐层扩展,$dist[v]=dist[u]+1$。流程:起点入队 → 队首出队 $u$ → 未访问邻居标记并入队 → 首次到达目标即最短路(无权图"先到先最优")。
- Dijkstra:优先队列(最小堆)按累计代价扩张,核心是松弛: $$d[v] \leftarrow \min\big(d[v],\; d[u] + w(u,v)\big)$$ 流程:初始化 $d[s]=0$、其余 $+\infty$ → 弹出 $d$ 最小的 $u$ → 松弛 $u$ 的出边并更新堆 → 目标出队即得最短路径。贪心 + 边权非负 ⇒ 节点弹出时 $d[u]$ 已不可能再被更新,可证明最优。
- A*:在 Dijkstra 上加启发代价: $$f(n) = g(n) + h(n)$$ $g(n)$ 是起点到 $n$ 的实际代价,$h(n)$ 是 $n$ 到目标的启发估计,open 集按 $f$ 排序扩展。
h 的选取(高频考点):
- 曼哈顿:$h=|\Delta x|+|\Delta y|$,四方向网格紧确;
- 欧氏:$h=\sqrt{\Delta x^{2}+\Delta y^{2}}$,任意移动下可采纳,但信息弱;
- 八方向(octile/对角距离):$h=\max(|\Delta x|,|\Delta y|)+(\sqrt{2}-1)\min(|\Delta x|,|\Delta y|)$,八方向网格紧确且可采纳。
最优性条件:可采纳 $h(n)\le h^{*}(n)$ ⇒ 树搜索下 A* 最优;一致(consistent)$h(n)\le c(n,n')+h(n')$ ⇒ 图搜索(closed 集)最优且每节点至多扩展一次,同时一致蕴含可采纳;$h\equiv 0$ 时 A* 退化为 Dijkstra。
复杂度:BFS 为 $O(V+E)$、空间 $O(V)$;Dijkstra(二叉堆)$O((V+E)\log V)$;A* 最坏同阶,好启发式显著减少扩展数,空间 $O(V)$(open+closed)。
优缺点:三者完备且(条件满足时)最优、实现成熟;缺点是需要显式离散的状态空间,高维连续构型空间(如 7 自由度机械臂)下状态爆炸,这正是采样规划登场的动机。
面试记忆点:BFS=无权最短路;Dijkstra=累计代价贪心 + 非负权可证最优;A*=g+h,可采纳⇒最优、一致⇒图搜索最优不重复扩展;h 越紧越快,h≡0 就是 Dijkstra。
2. 采样规划:RRT 与 RRT*¶
一句话定位:用随机采样 + 碰撞检测在连续构型空间里逐步"长出"搜索树,全程不显式建模 C-space,专治高维运动规划。
RRT 算法流程(伪代码级):
- 树 $T$ 初始只含起点 $x_{init}$;
- 采样:自由空间随机取点 $x_{rand}$;
- 最近邻:$x_{near}=\arg\min_{x\in T}\|x-x_{rand}\|$;
- steer:朝 $x_{rand}$ 方向迈固定步长 $\rho$, $$x_{new} = x_{near} + \rho\,\frac{x_{rand}-x_{near}}{\|x_{rand}-x_{near}\|}$$
- 碰撞检测:边 $(x_{near},x_{new})$ 全程无碰撞才接受,否则丢弃本轮采样;
- 连接:$x_{new}$ 距目标小于阈值或能直连 $x_{goal}$ 即返回路径,否则回到 2,直至迭代上限。
复杂度:单次迭代最近邻 $O(V)$(朴素)/ $O(\log V)$(kd-tree),$n$ 次迭代总计 $O(n^2)$ 到 $O(n\log n)$。
RRT*:插入 $x_{new}$ 后补两步——
- 邻域选父:半径 $r$ 球内选"到起点代价最小"的节点作父;
- 重接 rewire:对半径内邻居,若经由 $x_{new}$ 代价更小则换父、重建边。
重接半径与样本数、维度挂钩: $$r(n) = \gamma\left(\frac{\log n}{n}\right)^{1/d}$$ 其中 $d$ 是构型空间维度,$\gamma$ 是与环境测度相关的常数。收益是渐进最优:$n\to\infty$ 时路径代价收敛到最优解。
RRT-Connect:从起点和终点各长一棵树,交替扩展并尝试直接连接到对方树上,狭窄通道场景收敛显著加快。
优缺点:RRT 概率完备、无需显式建模障碍、实现简单,但非最优、路径不平滑、窄通道慢、对步长与采样分布敏感;RRT* 用重接开销换渐进最优,维度升高后收敛变慢,工程上常先 RRT 找初值再平滑/优化。
面试记忆点:RRT 三件套"采样→最近邻→steer+碰撞检测",概率完备但不最优;RRT* 加 rewire,半径 $r=\gamma(\log n/n)^{1/d}$,渐进最优;RRT-Connect 双向树专治窄通道。
3. 轨迹插值与生成¶
一句话定位:路径只是几何点串,轨迹要带时间/速度/加速度;多项式插值把点串变成平滑可执行的运动曲线,时间参数化把几何与动态解耦。
三次多项式(位置、速度连续):单段写成 $$p(t) = a_3t^3 + a_2t^2 + a_1t + a_0$$ 由端点位置 $p_0,p_1$ 与端点速度 $v_0,v_1$ 共 4 个边界条件定系数($T$ 为段时长): $$a_0 = p_0,\qquad a_1 = v_0$$ $$a_2 = \frac{3(p_1-p_0)-(2v_0+v_1)T}{T^2},\qquad a_3 = \frac{-2(p_1-p_0)+(v_0+v_1)T}{T^3}$$ 多段拼接时令相邻段端点位置、速度相等即得 $C^1$ 连续;若要加速度也连续($C^2$),需在内部点施加二阶导数连续条件,得到三对角方程组(追赶法求解),即经典三次样条。
五次多项式(加速度可控、轨迹平滑):再指定端点加速度 $\ddot p_0,\ddot p_1$,共 6 个条件: $$p(t)=a_5t^5+a_4t^4+a_3t^3+a_2t^2+a_1t+a_0$$ 闭式解: $$a_0=p_0,\quad a_1=v_0,\quad a_2=\frac{\ddot p_0}{2}$$ $$a_3=\frac{20(p_1-p_0)-(8v_1+12v_0)T-(3\ddot p_0-\ddot p_1)T^2}{2T^3}$$ $$a_4=\frac{-30(p_1-p_0)+(14v_1+16v_0)T+(3\ddot p_0-2\ddot p_1)T^2}{2T^4}$$ $$a_5=\frac{12(p_1-p_0)-(6v_1+6v_0)T-(\ddot p_0-\ddot p_1)T^2}{2T^5}$$ 特点:两端速度、加速度可控,段内 jerk(加加速度)光滑无尖刺;若要求段间 jerk 也严格连续($C^3$),边界条件需加到 8 个,即七次多项式。
时间参数化(梯形速度 / 最小时间):给定位移 $D$、限速 $v_{max}$、限加速度 $a_{max}$:
- 加速/减速段时长与位移:$t_a=v_{max}/a_{max}$,$d_a=v_{max}^2/(2a_{max})$;
- 若 $D\le 2d_a$ 达不到限速:三角 profile,$v_{peak}=\sqrt{a_{max}D}$,总时间 $T=2\sqrt{D/a_{max}}$;
- 否则梯形 profile:$T=2t_a+(D-2d_a)/v_{max}$。
全程贴着加速度边界跑(bang-bang)即最小时间。更一般的做法是把几何路径 $s(\lambda)$ 与单调时间函数 $\lambda(t)$ 复合,保证速度/加速度/加加速度不超限。
复杂度与优缺点:每段系数闭式求解、$O(1)$ 实时性好,适合点到点运动;缺点是多段拼接时光滑性靠约束堆叠,阶数过高数值不稳。时间参数化把"几何"与"动态"解耦,是工程标配。
面试记忆点:三次=位置速度连续(4 条件),五次=再加加速度(6 条件),七次才 jerk 连续(8 条件);梯形速度"加速-匀速-减速"三段式,贴边界即最小时间。
4. PID 控制¶
一句话定位:最经典反馈控制器——用误差的"现在(比例)、过去(积分)、趋势(微分)"三项叠加生成控制量。
核心公式(连续与离散形式): $$u(t) = K_p e(t) + K_i \int_0^t e(\tau)\,d\tau + K_d \frac{de(t)}{dt}$$ $$u_k = K_p e_k + K_i \Delta t \sum_{i=0}^{k} e_i + K_d \frac{e_k - e_{k-1}}{\Delta t}$$
Ziegler-Nichols 整定(临界比例法):只保留比例环,逐步加大 $K_p$ 直至系统等幅振荡,记临界增益 $K_u$ 与临界周期 $T_u$,再取: $$K_p = 0.6K_u,\qquad T_i = 0.5T_u,\qquad T_d = 0.125T_u$$ (PI 型取 $K_p=0.45K_u,\ T_i=0.83T_u$。)注意 Z-N 偏激进,工程上通常再打折扣。
工程细节(高频追问):
- 抗积分饱和(anti-windup):执行器饱和后误差无法继续消除,积分仍累积,退出饱和时引发大超调。解法:饱和时暂停积分(条件积分/积分钳位),或 back-calculation 回算补偿。
- 微分先行(derivative on measurement):微分项只对测量值求导,$u_d=-K_d\,dy/dt$,避免给定值阶跃激起微分冲激(derivative kick)。
三增益速查表:
| 增益 | 管什么 | 调大 | 调小 |
|---|---|---|---|
| $K_p$ 比例 | 对当前偏差的即时响应 | 响应快、稳态误差小;过大→振荡甚至发散 | 响应慢、跟不准 |
| $K_i$ 积分 | 消除稳态误差(累计历史偏差) | 稳态误差消得快;过大→超调、振荡、windup | 稳态误差残留 |
| $K_d$ 微分 | 预测偏差趋势、提供阻尼 | 超调小、更稳;过大→放大测量噪声 | 阻尼弱、易超调 |
复杂度与优缺点:每周期常数次乘加($O(1)$),嵌入式首选;无模型、实现简单、鲁棒。缺点:无预测(相位滞后)、不会显式处理约束、MIMO 强耦合时调参困难。
面试记忆点:P 管现在、I 管过去、D 管未来;$K_i$ 消稳态误差但带来 windup(必答抗饱和),D 项追问"微分先行";Z-N 第一步"纯比例调到等幅振荡"。
5. MPC(模型预测控制)¶
一句话定位:用显式模型预测未来轨迹、在线滚动求解带约束的最优控制,是带约束、多变量控制的"正解",也是机器人轨迹跟踪的主流。
核心公式(线性 MPC): $$\min_{x_{1:N},\,u_{0:N-1}}\ \sum_{k=0}^{N-1}\left(x_k^{\top} Q x_k + u_k^{\top} R u_k\right) + x_N^{\top} P x_N$$ $$\text{s.t.}\quad x_{k+1}=A x_k + B u_k,\qquad u_k\in\mathcal{U},\quad x_0=x(t)$$ $Q,R$ 是状态/控制权重,$P$ 是终端代价,$\mathcal{U}$ 为输入约束(可加状态约束 $\mathcal{X}$)。
滚动时域流程:
- 采样当前状态 $x_0=x(t)$;
- 在线求解 $N$ 步开环最优控制(线性 MPC 即一个 QP,用 OSQP / 内点法 / active-set 求解);
- 只执行第一个控制量 $u_0$;
- 下一采样时刻重解整个问题("滚动")。由于存在模型误差与扰动,必须"只走一步就重算"以闭环修正。
复杂度:每步解一个 QP,内点法约 $O(N^3)$ 量级(与状态/控制维度、约束数相关),实时性取决于求解器与 $N$。
MPC vs PID 对比表:
| 维度 | PID | MPC |
|---|---|---|
| 模型 | 不需要,纯误差反馈 | 必须显式模型 $(A,B)$ 或预测模型 |
| 约束 | 不支持,只能限幅/抗饱和 | 显式处理输入、状态约束 |
| 前瞻 | 无,反应式 | 滚动预测 $N$ 步,提前规避 |
| 计算量 | 每周期常数次运算 | 每步解 QP,毫秒级以上 |
| 适用 | SISO、工况简单、嵌入式 | MIMO、强耦合、带硬约束 |
优缺点:预测 + 约束 + 多变量是三大优势;代价是依赖模型精度(失配影响性能)、在线计算量大、调 $Q/R/N$ 有门槛。非线性 MPC 需 SQP/内点法,计算更重。
面试记忆点:MPC 三要素"预测模型 × 滚动优化 × 反馈校正";每步只执行 $u_0$ 再重算(闭环);约束显式进优化,PID 做不到。
6. 轨迹优化(CHOMP / STOMP / TrajOpt)¶
一句话定位:把"找一条无碰撞又平滑的轨迹"写成代价函数最小化,用优化替代搜索/采样,输出可直接执行的光滑轨迹。
CHOMP(协变梯度优化):在轨迹 $\tau$(离散点列)上定义总代价: $$U(\tau) = U_{obs}(\tau) + \lambda\, U_{smooth}(\tau)$$
- 平滑代价(离散弧长形式):$U_{smooth}=\frac12\sum_t\|x_{t+1}-x_t\|^2=\frac12\tau^{\top} A\tau$,其中 $A$ 是差分度量矩阵,梯度 $\nabla U_{smooth}=A\tau$;
- 障碍代价:$U_{obs}=\int c(\tau(s))\,\|\tau'(s)\|\,ds$,$c(\cdot)$ 由符号距离场(SDF)构造的连续可导障碍惩罚(离障碍越近越大)。
梯度式迭代: $$\tau \leftarrow \tau - \eta\,\nabla U(\tau)$$ CHOMP 的"协变"体现在用轨迹空间的度量 $A$ 做预条件(形式如 $\tau\leftarrow\tau-\eta A^{-1}\nabla U$),使更新与轨迹参数化无关、迭代更稳。 流程:取初值轨迹(如直线/采样结果)→ 在 SDF 上算障碍梯度与平滑梯度 → 沿下降方向迭代 → 障碍与平滑代价收敛后输出。
一句话对比:STOMP 用随机噪声扰动采样估计"期望代价下降方向",无需梯度,能处理不可导/非光滑代价;TrajOpt 用序列凸优化(SQP),把非凸碰撞约束逐步凸化、以安全裕度保证中间解可执行,收敛快、适合机械臂在线重规划。
复杂度与优缺点:单次迭代对轨迹点数 $n$ 与维度 $d$ 约 $O(nd)$,可并行;优点:输出平滑、直接对接执行;缺点:依赖 SDF 计算、对初值敏感(易局部极小)、权重 $\lambda$ 要调。
面试记忆点:CHOMP 是"梯度式"($U=U_{obs}+\lambda U_{smooth}$,$\tau\leftarrow\tau-\eta\nabla U$),STOMP 是"随机式"(免梯度),TrajOpt 是"凸化式"(SQP)。
7. 阻抗控制与导纳控制¶
一句话定位:机器人接触环境(打磨、装配、人机交互)时不能"硬顶",把末端整形为质量-弹簧-阻尼系统,实现力/位置柔顺。
核心公式(末端期望动力学): $$M_d(\ddot x - \ddot x_d) + B_d(\dot x - \dot x_d) + K_d(x - x_d) = F_{ext}$$ $M_d,B_d,K_d$ 是期望惯量、阻尼、刚度,$x_d$ 是期望轨迹,$F_{ext}$ 是环境接触外力。外力推一下,末端按二阶系统"柔顺地"偏离/回正,兼顾跟踪精度与安全性。
两类实现:
- 阻抗控制(impedance):输入是位置/轨迹,内环基于动力学模型输出力矩,使末端呈现上述阻抗关系;模型够准时可不依赖力传感器,响应快、天然带阻尼。
- 导纳控制(admittance):输入是力(力传感器测 $F_{ext}$),解算出位置/速度修正量交给内环位置控制器执行;对外表现为"受力才动"的导纳。
与主动力控的区别:主动力控直接闭环跟踪目标力($F\to F_d$);阻抗/导纳不指定"接触力多大",而是规定"外力与位置偏差之间的动态关系"(即期望机械阻抗),间接获得可控柔顺——本质是力/位置按阻抗折中,而非刚性切换。拖动示教、装配常用导纳(有力传感器 + 现成高精度位置环),人机碰撞防护常用阻抗(力矩级响应快)。
复杂度与优缺点:在线计算为矩阵乘级别、开销小,三参数 $M_d,B_d,K_d$ 直观可调;缺点:阻抗法依赖精确动力学模型、接触刚度变化时环境交互性能受限;导纳法依赖力传感器精度与内环位置控制带宽。
面试记忆点:$M_d\ddot e + B_d\dot e + K_d e = F_{ext}$ 是灵魂;阻抗=位置入、力矩出(力矩环),导纳=力入、位置出(位置环);一个像"弹簧",一个像"受力才动"。
8. 任务级规划:状态机、行为树与 LLM 任务规划¶
一句话定位:运动规划管"怎么走/怎么做",任务规划管"先做什么、失败怎么办";本节覆盖 FSM、行为树这两个经典决策骨架,以及它们与 LLM 语义任务分解的衔接。
行为树(BT)节点类型:
- 控制节点:Sequence(顺序执行,遇失败立即返回失败)、Fallback/Selector(按优先级依次尝试,一个成功即成功,专治备选方案)、Parallel(并发执行并按策略汇总)、Decorator(修饰子节点:Inverter 取反、Retry 重试、Timeout 限时等);
- 叶子节点:Action(执行动作)、Condition(查询条件)。
机制:根节点按周期 tick 整棵树,状态数据放黑板(Blackboard),子树天然可复用。
FSM vs BT 对比表:
| 维度 | 状态机 FSM | 行为树 BT |
|---|---|---|
| 结构 | 状态 + 事件转移表 | 树形嵌套(Sequence/Fallback/Decorator) |
| 模块化/复用 | 差,转移与状态交织 | 好,子树即模块 |
| 并发行为 | 难(需复合状态) | 易(Parallel) |
| 可调试性 | 状态多时转移矩阵难读 | 树结构直观,tick 路径可见 |
| 失败处理 | 每条转移手工设计 | Fallback/Decorator 内建容错重试 |
| 扩展性 | 状态爆炸 | 加子树即可 |
与 LLM 任务规划衔接:LLM 把自然语言指令分解为子任务序列或任务树,例如"把杯子放到桌上"→{导航到杯 → 抓取 → 导航到餐桌 → 放置},输出结构化结果(JSON 任务列表 / 行为树 DSL / 原子技能调用序列);底层由预先验证的 primitives(导航、抓取、放置)执行;执行失败时把反馈(如"抓取失败")回传 LLM 重规划。最终形成"LLM 负责开放语义分解,BT/FSM 负责确定性执行骨架"的分层架构——LLM 保灵活,BT 保安全与可解释。这是当前具身 Agent 的标准范式。
优缺点:FSM 直观、事件驱动实时性好,但状态爆炸、难扩展;BT 模块化、容错好、可复用,但 tick 频率与并发设计需要工程经验;LLM 方案泛化强但不可控,必须用 BT/FSM + 底层技能兜底。
面试记忆点:BT 是"树 + tick + 黑板";Sequence 顺序、Fallback 容错、Decorator 修饰;FSM 状态爆炸就转 BT;LLM 做"语义拆解",BT 做"可靠执行",两层各司其职。
面试考点¶
Q1:什么是构型空间 C-space?6 轴机械臂的规划在几维空间做?¶
答:构型空间是机器人所有合法姿势的集合,一个构型是一个点,坐标就是关节角(或位姿参数);维度等于自由度。规划在 C-space 里找一条从起始构型到目标构型的连续路径,要求路径全程落在自由空间 C_free 中。6 轴机械臂 → 6 维。 追问:为什么不直接在笛卡尔空间规划?障碍物在 C-space 里长什么样? 30 秒速答:工作空间直线对应关节空间的非线性曲线,可能碰撞/奇异;C-space 编码了姿态合法性,但障碍形状被非线性变换扭曲,一般用采样+碰撞检测隐式判断。
Q2:A* 为什么能保证找到最短路径?启发函数要满足什么条件?¶
答:A* 按 f = g + h 扩展节点。只要 h 可采纳(h(n) ≤ 真实剩余代价 h*(n)),最优路径上必有 open 表中的节点满足 f ≤ C*,所以第一次弹出目标时 g(goal) = C*,即最短路径。 追问:可采纳和一致(单调)有什么区别?h≡0 会怎样? 30 秒速答:一致 ⇒ 可采纳且保证节点只扩展一次、效率高;h≡0 时 A* 退化为 Dijkstra;h 超估则可能丢最优但更快(weighted A*)。
Q3:RRT 为什么概率完备?RRT* 改进在哪里?¶
答:RRT 随机采样独立同分布,若存在宽度 δ>0 的可行通道,采样点落入通道球邻域的概率为正,N 次采样后「从未落入」的概率指数衰减到 0;树又正概率向采样点生长,故 N→∞ 时找到路径的概率 → 1。RRT* 增加「重选父节点 + 重布线」,路径代价随采样收敛到最优(渐近最优)。 追问:「完备」与「概率完备」的区别?RRT 路径为什么不优? 30 秒速答:完备=只要解存在必能找到;概率完备=采样无限时成功概率趋于 1。RRT 的边随机生成、不按代价优化,所以不保证最优;RRT*/Informed-RRT* 专门优化这一点。
Q4:离散 PID 公式?三个增益各自管什么?¶
答:uₖ = Kp·eₖ + Ki·Δt·Σᵢeᵢ + Kd·(eₖ−eₖ₋₁)/Δt,注意积分乘 Δt、微分除 Δt。Kp 管响应速度(过大会振荡)、Ki 管稳态误差(消除残差)、Kd 管阻尼(压超调)。 追问:积分饱和怎么处理?D 项对噪声敏感怎么办? 30 秒速答:饱和时条件积分/积分限幅/anti-windup;D 项对测量值滤波或只对测量差分求导,避免放大噪声。
Q5:MPC 的核心思想?为什么能处理约束?¶
答:MPC = 预测 + 优化 + 滚动。每时刻用模型把未来 H 步状态预演成控制序列的仿射函数,求解带约束的二次规划,只执行第一步,下一时刻重解。约束(力矩上限、速度上限、避障距离)直接写进优化问题,这是 PID 做不到的。 追问:二次规划形式怎么写?实时性怎么保证? 30 秒速答:min ½uᵀHu + gᵀu s.t. u_min≤u≤u_max,H=MᵀQ̄M+R̄、g=MᵀQ̄(Ms·x₀−x_ref);实时性靠缩短时域、凸化、专用 QP 求解器或显式 MPC(离线分区在线查表)。
Q6:阻抗控制和位置控制的区别?什么时候用阻抗控制?¶
答:位置控制强制「到哪」,刚性强、接触力不可控;阻抗控制规定期望的弹簧-阻尼动力学 Mẍ̃+Dẋ̃+Kx̃=F_ext,外力推它就退让,适合人机协作、打磨、插孔、拖动示教等接触任务。 追问:M / D / K 的物理意义?调大 K 会怎样? 30 秒速答:K 刚度(越大越硬、接触力越大)、D 阻尼(越大越稳)、M 惯量(越大越抗冲击);调大 K 机器人会「硬顶」环境,接触力增大。
Q7:MPC 里怎么加入「别撞障碍物」这类安全约束?¶
答:把「与障碍最小距离 ≥ d_safe」写成关于状态的不等式约束(通常在参考轨迹附近线性化后进入 QP),配合跟踪误差监控(超限 → 降速/停机/重规划)和力矩/速度上限,形成「规划层几何无碰撞 + 控制层执行不越界」的多层安全网。 追问:跟踪误差为什么也要监控? 30 秒速答:误差超限说明实际已偏离计划(碰撞/滑移/模型错误),此时继续盲目执行危险,必须逐级触发降速、停止、重新规划的应急策略。
小结与下一章预告¶
小结:本章把「动起来」这件事拆成了完整链条——
- 想(规划):在构型空间 C-space 里把机器人压成点;低维用图搜索(BFS/Dijkstra/A*,A* 的可采纳启发式保证又快又优),高维用采样规划(RRT 概率完备、RRT* 渐近最优);
- 排(轨迹):路径插值成带时间的平滑轨迹(梯形速度、三次多项式);
- 控(执行):PID 用三旋钮拉回误差,MPC 用「预测+滚动优化+约束」看着未来决策;
- 保(安全):阻抗控制让人机交互柔顺,跟踪误差监控 + 约束优化兜底。
下一章预告:机器人已经会「想」和「动」了,但上面的每一步都依赖「程序员的设定」。下一章 03-VLA视觉语言动作模型 将给机器人装上「眼睛和大脑」:从 VLM 到 VLA,让机器学习「看一眼场景、听一句指令,自己生成动作」——那时,规划与控制将不再依赖手工规则,而是由大模型直接输出。再之后 04-仿真数据与sim2real 解决「在仿真里学的本领怎么搬到真机」。