🧊 04-Adam 变体与解耦权重衰减¶
目标:把「权重衰减」和「L2 正则」掰开——为什么 Adam 里它们不一样(AdamW 解耦), 以及大模型训练锁死 AdamW 的原因;顺带过 NAdam / AMSGrad / LAMB / Lion。
本讲地图:耦合问题分析 → 手算例子 → 两个实验(逐位对照 / 纯衰减行为)→ 变体总表 → 逐个展开 → 面试追问 → 自测。
核心概念¶
(a) 🗂️ Adam 变体与解耦权重衰减知识地图¶
这篇讲 Adam 的"阿喀琉斯之踵":L2 正则的衰减项会被自适应步长吃掉,AdamW 把权重衰减从梯度里解耦出来,并系统梳理 NAdam、AMSGrad、LAMB、Lion、Adafactor 等变体与大模型实践。
flowchart TB
    Node1["🧠 L2 与 Adam 的耦合"]
    Node1 --> Node2["🧠 衰减被自适应步长吃掉"]
    Node2 --> Node3["🧠 AdamW 解耦衰减"]
    Node3 --> Node4["🧠 贝叶斯先验视角"]
    Node4 --> Node5["🧠 岭回归几何直觉"]
    Node5 --> Node6["🧠 变体 NAdam/AMSGrad/LAMB"]
    Node6 --> Node7["🧠 Lion / Adafactor"]
    Node7 --> Node8["🧠 大模型锁死 AdamW"]
    Node8 --> Node9["🧠 选型与调参"]
- 节点1(L2 与 Adam 的耦合):传统实现把权重衰减加进梯度(w ← w − η·(g + λw)),Adam 再用自适应步长缩放它:λw 被 1/√v 缩放后,衰减力度随参数历史梯度变化,不再是真正的 L2 正则。
- 节点2(衰减被自适应步长吃掉):手算能看出:大梯度参数的衰减被放小、小梯度参数的衰减被放大,L2 的"公平衰减"被破坏,正则效果名存实亡。
- 节点3(AdamW 解耦衰减):AdamW 把衰减移出梯度计算:m、v 只吃真实梯度,更新后单独做 w ← w − η·λ·w,衰减权重与自适应步长彻底无关。一行公式之差,效果天壤之别。
- 节点4(贝叶斯先验视角):权重衰减 = 把参数"拉向 0"的先验(高斯先验取 MAP),衰减系数对应先验方差:拉向 0 不是玄学,而是"没有信息时的合理默认"。
- 节点5(岭回归几何直觉):L2 的几何是"等高圆"约束:权重被压向以 0 为心的圆内,配合手算"同一个 w 两条衰减路径"能直观看到解耦与耦合的差别。
- 节点6(变体 NAdam/AMSGrad/LAMB):NAdam 给 Adam 加 Nesterov 动量,AMSGrad 用历史最大 v 防步长回退,LAMB 做逐层缩放适配大 batch 预训练。
- 节点7(Lion / Adafactor):Lion 用符号梯度(±1)更新,省内存且收敛快;Adafactor 用低秩近似 v 大幅省显存,长序列 Transformer 友好。
- 节点8(大模型锁死 AdamW):大模型训练几乎标配 AdamW:稳定、可控,配 warmup+cosine 和权重衰减 0.01 有大量验证;显存开销(每参数 12B 状态)是它的代价,靠 ZeRO 等解决。
- 节点9(选型与调参):普通任务 AdamW 起步,要省显存用 Adafactor,要冲大 batch 用 LAMB/Lion;衰减系数 1e-2 附近是经验区间,面试要能答"为什么大模型锁死 AdamW"。
§1 L2 正则与 Adam 的耦合问题¶
给优化器加正则的朴素做法(Adam+L2): $$g \gets g + \lambda w, \qquad w \gets w - \eta \frac{\hat m}{\sqrt{\hat v}+\epsilon}$$ 即把 $\lambda w$ 加进梯度,再走 Adam 的自适应缩放。问题出在哪?
权重大 → 梯度项大 → $\sqrt{\hat v}$ 大 → L2 贡献被自适应步长缩小。 也就是说正则化强度被参数幅度反向调制:大权重几乎不衰减,小权重却被大力衰减—— 这与「权重衰减应一视同仁(按固定比例)」的初衷完全矛盾。
🧩 类比:L2 像「交规罚分」——超速越多罚越狠,但交警(自适应步长)会按车速自动调解罚单力度; AdamW 像「按比例注销驾照」——无论车速如何,每次都固定按比例收回。 后者行为可预测,适合大模型这种「开不起玩笑」的场景。
§1.1 手算:L2 贡献为什么被自适应步长「吃掉」¶
用一个极简例子看耦合效果。设某个权重 $w=2$,不含正则的梯度 $g_0=0.1$,$\lambda=0.1$:
- L2 版本:$g_{eff} = 0.1 + 0.1 \cdot 2 = 0.3$,进入 Adam 后 $v$ 累计的是 $g_{eff}^2$。 若 $\hat v$ 已到稳态(如 $\hat v = 1.0$),正则贡献 $0.2$ 与梯度 $0.1$ 一起被 $1/\sqrt{1}=1$ 缩放—— 正则项被「平均」掉了,实际衰减远弱于名义值。
- AdamW 版本:正则不经过 $m,v$,直接执行 $w \gets w - \eta\lambda w$。 无论 $\hat v$ 多大,$w$ 都按固定比例 $\eta\lambda$ 收缩。
关键结论:L2 放进梯度会被 $v$ 调制——权重越大,其梯度项越大,被除以的 $\sqrt{\hat v}$ 也越大, 正则效果反而越弱;AdamW 把它拿出来,让衰减与自适应步长完全解耦, 权重越大衰减的绝对值越大(比例固定)。这正是「解耦权重衰减」名字的由来。
§1.2 AdamW 的更新公式(必背)¶
AdamW(Loshchilov & Hutter 2019):把衰减从梯度里拿出来,直接乘到参数上:
$$\boxed{\;w \gets w - \eta\,\hat m_t/(\sqrt{\hat v_t}+\epsilon) - \eta\lambda w\; }$$
第二项与梯度无关:无论自适应步长如何,权重都按固定比例 $\eta\lambda$ 衰减。 对比 SGD 里的权重衰减:$w \gets (1-\eta\lambda) w - \eta g$——同样按比例, 但 SGD 没有自适应缩放,所以 SGD 下「L2 正则」与「权重衰减」恰好等价。 只有自适应优化器里两者分道扬镳,这是面试必考题。
§1.3 历史背景:AdamW 为什么 2019 才出现¶
2014 年 Adam 论文里其实没有专门的权重衰减讨论,社区惯用「Adam + L2 正则」 (把 $\lambda w$ 加进梯度)。直到 Loshchilov & Hutter(ICLR 2019)严格分析才发现: 在自适应优化器里,L2 正则与权重衰减不等价,并给出解耦版本 AdamW。
随后 BERT、GPT、LLaMA 等 Transformer 系模型全面转向 AdamW,因为 Transformer 对 正则行为敏感,耦合版本会在预训练中引入不稳定。今天 LLM 训练默认就是 AdamW—— 这个「默认」背后是一个明确的数学分析,值得记住这条因果链。
§1.35 权重衰减的贝叶斯视角(为什么「拉向 0」是合理的先验)¶
从贝叶斯看,训练是求后验:$p(w\mid D) \propto p(D\mid w)\,p(w)$。 把参数先验取为零均值高斯 $p(w) \propto \exp(-\lambda \|w\|^2/2)$, 取负对数后恰好多出 $\frac{\lambda}{2}\|w\|^2$ 项——这正是 L2 正则 / 权重衰减。
所以「衰减」的统计含义是:我们相信参数不该太大,先验集中在 0 附近。 对 LLM 这种千万级参数模型,这一先验其实很弱、但很重要: 它把参数约束在合理幅度,防止 embedding / 输出层范数无限膨胀, 对数值稳定与泛化都有帮助。
🧩 记住一句话:L2 正则 = 高斯先验 = 权重衰减(SGD 下三者等价); 但 Adam 的自适应缩放会破坏最后一环的等价性,于是需要 AdamW 把衰减单独拿出来。
§1.4 代码怎么读:decoupled 开关¶
下面代码实现 AdamWithDecay,核心是一个布尔开关 decoupled:
decoupled=False(L2):g_eff = g + wd * w(衰减进梯度,再走 EMA)。decoupled=True(AdamW):g_eff = g(不进梯度),最后w_new -= lr * wd * w(单独衰减一步)。
其余 $m, v$ 递推与 03 篇完全一致。先读代码再跑实验 1(逐位对照)与实验 2(纯衰减行为)。
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# ---------- 手写 Adam(可切换 L2 / 解耦衰减) ----------
class AdamWithDecay:
    def __init__(self, lr=0.01, b1=0.9, b2=0.999, eps=1e-8, wd=0.0, decoupled=False):
        self.lr, self.b1, self.b2, self.eps = lr, b1, b2, eps
        self.wd, self.decoupled = wd, decoupled
        self.m = self.v = None
    def step(self, w, g, t):
        t1 = t + 1
        g_eff = g + self.wd * w if not self.decoupled else g   # L2:进梯度;解耦:不进
        self.m = (1 - self.b1) * g_eff if self.m is None else self.b1 * self.m + (1 - self.b1) * g_eff
        self.v = (1 - self.b2) * g_eff * g_eff if self.v is None else self.b2 * self.v + (1 - self.b2) * g_eff * g_eff
        m_hat = self.m / (1 - self.b1**t1)
        v_hat = self.v / (1 - self.b2**t1)
        w_new = w - self.lr * m_hat / (np.sqrt(v_hat) + self.eps)
        if self.decoupled:
            w_new = w_new - self.lr * self.wd * w
        return w_new

plt.show()
§1.45 耦合版到底「等效」多大的衰减?一个启发式推导¶
把耦合版(L2 进梯度)在稳态下与解耦版做对照,可得到一个著名的启发式结论: 当 $v$ 收敛到稳态 $\hat v \approx E[g^2]$ 时,耦合版每个参数的有效衰减系数约为 $$\lambda_{eff} \approx \frac{\eta\,\lambda}{\sqrt{E[g^2]}} \cdot w$$ 即:梯度幅度大的参数($E[g^2]$ 大)衰减弱,梯度小的参数衰减强。 这意味着耦合版在稀疏参数上反而施加了不成比例的强衰减—— 而稀疏参数恰恰是模型最希望保留的大权重(如词向量)。
⚠️ 这也是「Adam+L2 会让 embedding 稀疏参数被过度正则」这类实践观察的理论来源。 AdamW 用固定比例 $\eta\lambda$ 一刀切,避开了这个陷阱。
怎么记住:耦合版 = 衰减强度随梯度幅度漂移;解耦版 = 衰减强度恒定。 后者的可预测性就是它在 LLM 训练中胜出的核心理由。
§1.5 实验 1 预习:手写 AdamW vs torch 逐位对照¶
实验 1 用相同随机梯度,把**手写 AdamW(decoupled=True)**与 torch.optim.AdamW
并排跑 15 步,比较最大绝对误差(期望 $10^{-12}$ 量级)。
关键对齐点:
- PyTorch 的
optim.AdamW默认weight_decay走解耦路径(不是把 $\lambda w$ 加进梯度)。 - 手写版
wd=0.01, decoupled=True与之对应;衰减实现为w_new = w_new - lr*wd*w。
跑之前预测:会不会因为「torch 内部把衰减放在参数更新前/后」而产生 $>10^{-12}$ 的差异?
(答案:torch 在 step 内先算自适应更新再做衰减,我们的实现顺序一致。)
# ---------- 实验 1:手写 AdamW vs torch.optim.AdamW 逐位对照 ----------
import torch

torch.manual_seed(7)
w_t = torch.randn(4, 4, dtype=torch.float64, requires_grad=True)
w_n = w_t.detach().numpy().copy()

opt_t = torch.optim.AdamW([w_t], lr=0.01, betas=(0.9, 0.999), eps=1e-8, weight_decay=0.01)
mine = AdamWithDecay(lr=0.01, b1=0.9, b2=0.999, eps=1e-8, wd=0.01, decoupled=True)

maxdiff = 0.0
for t in range(15):
    g = torch.randn(4, 4, dtype=torch.float64)
    (w_t * g).sum().backward()
    opt_t.step(); opt_t.zero_grad()
    w_n = mine.step(w_n, g.numpy(), t)
    maxdiff = max(maxdiff, np.abs(w_n - w_t.detach().numpy()).max())
print(f'手写 AdamW vs torch.optim.AdamW 最大误差: {maxdiff:.2e}')
assert maxdiff < 1e-12
print('对照通过')
§1.6 实验 1 复盘¶
误差达 $10^{-12}$ 量级,说明手写实现与 PyTorch 官方数学等价。 这给你一个可迁移的工程习惯:任何新优化器实现,先用小规模逐位对照官方库验证。 实际生产中常见差异来源:
t计数起点(torch 内部从 0 计,校正式里用t+1);- 衰减与自适应更新的先后顺序(AdamW 先自适应后衰减);
- float 精度(fp32 对照误差应 < 1e-6,fp16 另说,见 07 篇)。
💡 若你的手写版误差是 $10^{-8}$ 而非 $10^{-12}$,多半是 $\epsilon$ 位置或 衰减写成 $w \gets w - \eta\lambda \(w-\eta\hat m/\dots)$ 之类的顺序问题。
§2 L2 的几何直觉:岭回归配图¶
为什么「拉向原点」的衰减有用?看岭回归的几何:无惩罚时最优解 $w^*$ 在等值线中心, 加入 L2 惩罚后约束是以原点为中心的椭圆,最优解被拉向原点,方差变小、偏差变大—— 这就是正则的偏差-方差权衡。
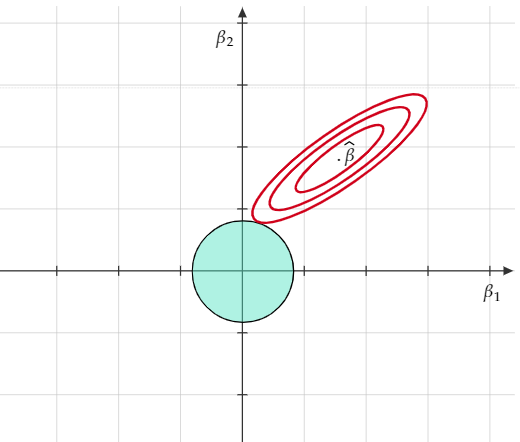
图注:L2 正则等价于在参数空间加一个椭圆约束(ridge),最优解被拉向原点——AdamW 的 解耦衰减实现同样的「拉向原点」,但不再被自适应步长干扰(来源:Wikimedia Commons,CC BY-SA 4.0)。
与 SGD 不同,AdamW 里这个「拉向原点」的力度由 $\eta\lambda$ 固定给出, 不会因为某参数梯度大就被自适应缩放削弱——图上椭圆约束对每个坐标一视同仁。
§2.1 实验 2 预习:零梯度下的纯衰减行为¶
实验 2 故意把梯度设为 0,只看衰减项本身(参数从 $N(0,3^2)$ 采样,范数较大):
- 解耦版(AdamW):$w \gets w - \eta\lambda w$,每步按固定比例缩 → 范数匀速指数下降(对数坐标下是直线)。
- 耦合版(Adam+L2):$g_{eff}=\lambda w$ 进 $m,v$ 后,$v$ 从 0 开始累计, 早期 $\sqrt{\hat v}$ 很小 → 更新被放大(甚至首步几乎不动),后期 $v$ 变大 → 衰减又变弱。 范数曲线呈「先慢后更慢」的非线性。
跑之前预测:哪条曲线更接近「匀速缩水」?哪条更像「雷声大雨点小」?
# ---------- 实验 2:解耦 vs 耦合衰减对大权重的影响 ----------
rng = np.random.default_rng(0)
w = rng.normal(scale=3.0, size=200)   # 大初始权重
g = np.zeros_like(w)                  # 无梯度(看纯衰减行为)

def pure_decay(decoupled, steps=200, lr=0.1, wd=0.05):
    o = AdamWithDecay(lr=lr, wd=wd, decoupled=decoupled)
    ww = w.copy(); norms = []
    for t in range(steps):
        ww = o.step(ww, g, t)
        norms.append(np.linalg.norm(ww))
    return np.array(norms)

fig, ax = plt.subplots(figsize=(7.5, 4.0))
ax.plot(pure_decay(True),  label='AdamW 解耦衰减', color='#4C72B0', lw=1.6)
ax.plot(pure_decay(False), label='Adam+L2(进梯度)', color='#C44E52', lw=1.6)
ax.set_xlabel('step'); ax.set_ylabel('||w||')
ax.set_title('零梯度下纯衰减行为:解耦版匀速衰减,耦合版被统计量压制', fontsize=11)
ax.legend(fontsize=9); ax.grid(alpha=0.3)
plt.tight_layout(); plt.show()
print('解耦衰减按固定比例缩;耦合衰减首步 v=0 时几乎不动')
实验 2 复盘:纯衰减行为说明了什么¶
上图是面试讲 AdamW 的最佳素材:
- 解耦版(蓝):范数匀速指数下降(近似直线),行为完全可预测——每步固定收缩 $1-\eta\lambda$。
- 耦合版(红):早期 $v$ 尚未累计,$\sqrt{\hat v}$ 极小 → 步长被放大、衰减反而更猛; 后期 $v$ 变大 → 衰减又减弱。曲线「先陡后缓」,正则强度随训练推移漂移,不可控。
一图说清:解耦让衰减行为可预测,这正是大模型训练要 AdamW 不要 Adam+L2 的微观原因。
§2.2 手算对照:同一个 w,两种衰减路径¶
设 $w=2.0,\ \eta=0.1,\ \lambda=0.1,\ \beta_2=0.999$,梯度 $g=0$(只看衰减),$t=1$:
- AdamW:$w_1 = 2.0 - 0.1 \cdot 0.1 \cdot 2.0 = 1.98$(一步缩 1%)。
- Adam+L2:$g_{eff} = 0.2$;$v_1 = 0.001 \cdot 0.04 = 4\times10^{-5}$;$\hat v_1 = v_1/(1-0.999) = 0.04$; $m_1 = 0.1 \cdot 0.2 = 0.02$,$\hat m_1 = 0.02/0.1 = 0.2$;更新量 $0.1 \cdot 0.2 / 0.2 = 0.1$ → $w_1 = 1.9$。
同一衰减强度($\lambda=0.1$),耦合版首步反而缩 5%(比解耦版的 1% 狠得多)—— 因为 $v$ 尚未累计到稳态,步长被放大。这正是耦合版行为不可控的微观来源: 首步过冲、后续乏力。
§3 变体总表(面试背诵)¶
| 变体 | 改动 | 解决什么 |
|------|------|----------|
| AdamW | 权重衰减解耦:w -= lr*wd*w | L2 与自适应步长耦合 → LLM 默认 |
| NAdam | 一阶矩带 Nesterov 前瞻 | Adam 收敛再快一点 |
| AMSGrad | $\hat v = \max(\hat v_{t-1}, \hat v_t)$(单调不减) | 防 Adam 在非凸问题上步长反复增大 |
| LAMB | 逐层步长归一:lr * ||w|| / ||m_hat/(sqrt(v_hat)+eps)|| | 大 batch(数千)训练不炸 |
| Lion | w -= lr * sign(b1*m + (1-b1)*g) | 省显存省算力,只用符号 |
| Adafactor | 二阶矩按行/列分解近似 | 省内存(T5 用) |
记忆法:AdamW(正则解耦)→ NAdam(方向前瞻)→ AMSGrad(步长只减)→ LAMB(逐层归一)→ Lion(符号化)→ Adafactor(低秩近似)。
§3.1 为什么大模型锁死 AdamW¶
- 权重衰减解耦 → 正则强度不受幅度调制,训练更稳、可预测
- 配合 warmup + cosine + 梯度裁剪(05 篇)成为 LLM 训练标配(GPT / LLaMA 系)
- AdamW 在 Transformer 上普遍优于 Adam+L2(正则化与自适应解耦)
📌 面试话术:「LLM 微调/预训练默认 AdamW,是因为它把权重衰减从自适应步长中解耦出来, 正则行为可预测,配合 warmup/cosine 调度和梯度裁剪,训练最稳。」
§3.2 变体逐个展开:NAdam / AMSGrad / LAMB¶
NAdam:把 Nesterov 前瞻用在一阶矩上——先用 $\hat m_{t-1}$ 前瞻一步再算动量,
比 Adam 收敛略快(尤其早期);实现成本低,很多库默认就有(如 torch.optim.NAdam)。
AMSGrad:Adam 的 $\hat v_t$ 可能在某步变小(非凸面上 $v$ EMA 波动),导致步长「反复横跳」; AMSGrad 强制 $\hat v_t = \max(\hat v_{t-1}, \hat v_t)$ 单调不减,保证步长只减不增, 牺牲一点灵活性换取稳定收敛(Reddi et al. 2018)。
LAMB(Layer-wise Adaptive Moments):大 batch(数千)训练时,各层参数范数差异巨大, 统一步长会让浅层/深层失衡;LAMB 对每层算「更新范数与参数范数之比」并归一化: $$\text{ratio} = \frac{\|\hat m/(\sqrt{\hat v}+\epsilon)\|}{\|w\|}, \qquad w \gets w - \eta \cdot \text{ratio} \cdot \frac{\hat m}{\sqrt{\hat v}+\epsilon}$$ BERT 大规模预训练(2019,Google)用它实现 64k batch 稳定训练。
§3.3 变体逐个展开:Lion / Adafactor + 选型¶
Lion(Evolved Sign):Google 2023 用程序化搜索进化出的更新——只用符号: $$w \gets w - \eta \cdot \text{sign}(\beta_1 m + (1-\beta_1) g)$$ 不存二阶矩 $v$ → 省一半优化器内存,训练 LLM/视觉模型常比 AdamW 更快收敛; 代价是 lr 通常要调小(约 1/10),且对权重初始化更敏感。
Adafactor:把二阶矩 $v$ 按行/列因子分解近似($v \approx r c^\top$), 内存从 $O(n)$ 降到 $O(\sqrt n)$;T5 用它在超长序列上省显存,代价是收敛略慢。
⚠️ 选型一句话:单卡小模型 → Adam;Transformer/LLM → AdamW;超大 batch → LAMB; 显存吃紧 → Adafactor 或 Lion;追求收敛速度且不介意调参 → Lion。
§4 常见 bug 与边界¶
- PyTorch 默认:
optim.AdamW的weight_decay默认走解耦路径,不要和 L2 混写 - decoupled 衰减不放梯度里:放梯度里就不是 AdamW 了(就退回 Adam+L2)
- Lion 无二阶矩:不存 $v$,省一半优化器内存;但超参(lr 通常更小)要重新调
- 权重衰减 ≠ weight_decay 参数名:不同框架里
weight_decay语义可能不同(有的默认 L2、有的默认解耦),迁移时先查文档 - LAMB 的 ratio 除以零:参数范数极小(如刚初始化的 embedding)时需加 $\epsilon'$ 防除零
§5 面试追问与扩展¶
- LAMB 为什么能大 batch:每层梯度范数差异大,按参数范数归一化步长,避免某层被压死
- Adafactor 省多少:二阶矩从 $O(n)$ 降为 $O(\sqrt n)$(行+列因子)
- AdamW vs SGD+wd:对小模型差异小,对 Transformer 明显
- AdamW 的内存账:每个参数要存 $m$(fp32)+ $v$(fp32)+ 参数量(fp16/bf16), 7B 模型仅优化器状态就约 84GB(7B×2×6B)——这就是 ZeRO 分片要解决的(07 篇)
- 为什么 LLM 用 fp32 的 m/v 而权重可用 bf16:一阶矩累加需要高精度,否则长序列训练误差累积
- AdamW 的 lr 一般比 Adam 大还是小:经验上 AdamW 常用 lr 与 Adam 相当或略大 (如 1e-3~3e-4 量级;LLM 预训练常用 3e-4 配 warmup)
§5.5 LLM 实操:一套被反复验证的 AdamW 配置¶
以 GPT / LLaMA 系预训练为代表,工业界常见的 AdamW 启动配置(记住量级即可):
- lr:$3\times10^{-4}$(7B 级)或 $1.5\times10^{-4}$(70B 级,更大模型更小 lr);
- weight_decay:0.01(解耦路径,
decoupled); - betas:$(0.9, 0.999)$;
eps=1e-8(bf16 下可放宽到 1e-6); - warmup:前 2000 步或总步数 1%-3% 从 0 线性升到目标 lr(05 篇);
- schedule:cosine 衰减到峰值 lr 的 1/10(05 篇);
- 梯度裁剪:全局范数 clip 到 1.0(05 篇)。
为什么都配 warmup+cosine:自适应优化器前期 $m,v$ 统计量不可靠(偏差校正虽在, 但方差仍大),warmup 让统计量「暖机」后再全力前进;后期 cosine 把步长降下来, 既稳定收敛又接近「SGD 收尾」的泛化收益。这套组合拳就是现代 LLM 训练的标配。
§5.6 延伸阅读与知识图谱¶
把 03/04 两讲串起来看:
AdaGrad(2011) ──EMA──> RMSProp(2012) ──+动量+校正──> Adam(2015)
   │                                              │
   │                              ┌───────────────┴────────────────┐
   │                        AdamW(2019)      NAdam / AMSGrad / LAMB / Lion
   │                     (LLM 默认,解耦衰减)
推荐深潜顺序:Kingma & Ba 2015(Adam)→ Loshchilov & Hutter 2019(AdamW)→ Reddi et al. 2018(AMSGrad)→ You et al. 2019(LAMB)→ Chen et al. 2023(Lion)。 每篇只看「改了哪一行更新式 + 为什么改」,就能快速建立家族图谱。
§5.9 权重衰减取多少?直觉与量级¶
weight_decay 的合理量级与模型规模和 lr 强相关,经验锚点:
- 小模型(百万级)/常规任务:0.0001 ~ 0.001 常被报告有效(配合 lr 1e-3 量级);
- 大模型(数十亿级)预训练:0.01 几乎是 LLM 圈共识(GPT/LLaMA 都接近此值);
- 微调阶段:常比预训练更小(0.0 ~ 0.01),因为希望保留预训练知识。
怎么理解「0.01 配 lr 3e-4」:每步参数缩水 $\eta\lambda = 3\times10^{-6}$, 训练 1e5 步累计约 $1-\exp(-0.3)\approx26\%$ 的收缩——既有正则效果又不至于压死学习。 动手建议:先固定 0.01 跑通,若过拟合再按 3 倍递增扫描;若欠拟合则减半。
⚠️ 不同框架语义不同:PyTorch
AdamW的weight_decay走解耦; 某些旧库或自研代码可能走 L2 进梯度——迁移时必须确认,否则衰减强度差一个数量级。
§6 自测清单¶
- 默写 AdamW 更新公式(衰减项写在参数更新里)
- 解释「L2 与自适应步长耦合」的机制
- 手写 AdamW 与 torch 对照(本文已断言)
- 一句话说清 LAMB / Lion / AMSGrad 各改了什么
- 为什么 LLM 训练默认 AdamW
- 口算:7B 模型 AdamW 优化器状态内存 ≈ 多少 GB(84GB)
💡 下节预告:学习率调度(warmup/cosine)与梯度裁剪/累积(05 篇)。