🧠 03-深度学习 · 模型笔记 1:多层感知机与反向传播(手写全流程)¶
BP 是深度学习的发动机:链式法则 + 梯度缓存。把 MLP 的 BP 手推一遍,LeNet/Transformer 都能顺下来。 本 notebook 要求:前向/反向全部手写 numpy,不调 torch;含梯度检查与中间过程输出。
运行环境:Python 3.8+,仅依赖 numpy。
核心概念¶
(a) 🗂️ 多层感知机与反向传播知识结构¶
这篇文章从零手写全连接网络(MLP)的前向与反向传播,是深度学习的"发动机":弄懂它,后面 CNN、Transformer 的梯度推导都能顺下来。
flowchart TB
    Node1["🧠 多层感知机MLP"]
    Node1 --> Node2["📤 前向传播"]
    Node2 --> Node3["📉 损失函数"]
    Node3 --> Node4["🔗 链式法则"]
    Node4 --> Node5["📥 反向传播BP"]
    Node5 --> Node6["🎯 softmax与交叉熵"]
    Node6 --> Node7["✅ 梯度检查"]
    Node7 --> Node8["🧪 XOR问题实验"]
    Node8 --> Node9["⚙️ 自动微分模式"]
    Node9 --> Node10["⚠️ 初始化与常见坑"]
- 多层感知机MLP:由输入层、隐藏层、输出层逐层堆叠的全连接网络,每一层先把输入加权求和、加偏置,再过非线性激活函数。它是深度学习最基础的"乐高积木",后面所有网络几乎都能看成它的变体。
- 前向传播:输入从第一层开始逐层往后传,直到输出层给出预测,就像多米诺骨牌一张接一张倒下。前向只做一件事:把数据算成预测值。
- 损失函数:一把衡量"预测离真相多远"的尺子——回归任务常用 MSE,分类任务常用交叉熵。损失越小,说明模型离正确答案越近。
- 链式法则:反向传播的数学灵魂。复合函数的导数可以拆成一连串局部导数的乘积,所以每一层只需要关心自己环节的导数,不用管整条链。
- 反向传播BP:把总误差当成一张"账单",按每一层贡献大小把梯度分发给每个权重,从输出层一路回传到输入层。本质就是"链式法则 + 梯度缓存",避免重复计算。
- softmax与交叉熵:把网络输出的 logits 变成一组和为 1 的概率,再用交叉熵算损失。妙处在于 softmax 配交叉熵后输出层梯度恰好是 p-y,又稳又简洁。
- 梯度检查:用数值差分(中心差分)算近似梯度,和自己手写的解析梯度比相对误差。这是验证手写反向传播写没写对的黄金标准,深度学习框架自己也靠这招自检。
- XOR问题:单层感知机永远学不会的"线性不可分"问题,加一层隐藏层加非线性激活就能解决。它是证明"多层 + 非线性"表达能力的经典实验。
- 自动微分模式:前向模式要跑 n 趟才能算完 n 个输入的导数,反向模式对标量损失只需一趟,所以训练一律用反向模式——这也是 torch 的 backward 高效的原因。
- 初始化与常见坑:全 0 初始化会让同层神经元永远同步更新、退化成单个神经元;ReLU 的导数在 z≤0 处是 0 不是 1;梯度检查要复用同一个前向状态。随机初始化(Xavier/He)就是为了打破对称性。
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · HRc · Public domain
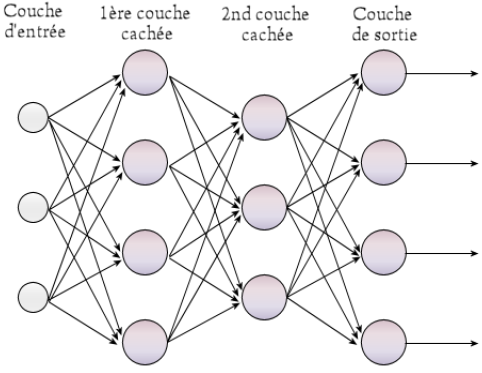
🎯 直觉类比:正向传播像多米诺骨牌——输入依次触发每一层,一张接一张倒下; 反向传播像错误信号分发——把总误差当账单,按「谁贡献大分给谁」逐层回传; 每一层只负责自己环节的导数,最终把 $\partial L/\partial W$ 分到每个权重手上。
§1 网络结构与符号¶
以两层 MLP 为例(输入 $d \to$ 隐藏 $H \to$ 输出 $K$):
$$h = \sigma(W_1 x + b_1), \quad \hat{y} = W_2 h + b_2$$
- $W_1 \in \mathbb{R}^{H \times d}$,$b_1 \in \mathbb{R}^H$(隐藏层)
- $W_2 \in \mathbb{R}^{K \times H}$,$b_2 \in \mathbb{R}^K$(输出层)
- $\sigma$ = 隐藏激活(ReLU / tanh / sigmoid)
矩阵批量形式($n$ 个样本):
$$H = \sigma(X W_1^{\top} + b_1), \quad \hat{Y} = H W_2^{\top} + b_2$$
损失(回归 MSE / 分类交叉熵):
$$L = \frac{1}{n}\|\hat{Y} - Y\|_F^2$$
§2 反向传播推导(链式法则,面试手写重点)¶
目标:求 $\partial L / \partial W_2,\ b_2,\ W_1,\ b_1$。
第一步:输出层误差信号(MSE 下 = 预测差):
$$\delta_2 = \frac{\partial L}{\partial \hat{Y}} = \frac{2}{n}(\hat{Y} - Y)$$
第二步:输出层权重梯度:
$$\frac{\partial L}{\partial W_2} = \delta_2^{\top} H, \quad \frac{\partial L}{\partial b_2} = \delta_2 \text{ 按行求和}$$
第三步:误差往隐藏层回传:
$$\delta_1 = (\delta_2 W_2) \circ \sigma'(Z_1), \quad Z_1 = X W_1^{\top} + b_1$$
$\circ$ 是逐元素乘;$\sigma'$ 是激活导数(ReLU 用掩码):
$$\sigma'_{ReLU}(z) = \begin{cases} 1 & z > 0 \\ 0 & z \le 0 \end{cases}$$
第四步:隐藏层梯度:
$$\frac{\partial L}{\partial W_1} = \delta_1^{\top} X, \quad \frac{\partial L}{\partial b_1} = \delta_1 \text{ 按行求和}$$
核心直觉:$\delta$ 从输出层层回传,每层「矩阵乘 + 激活导数逐元素乘」——这就是反向传播的全貌。
✍️ §2.1 手算 BP 全流程:2→2→1 网络,一步步算出四个梯度¶
公式很抽象,手算一遍立刻落地。用单样本(n=1)、MSE 损失,把前向/反向每个数都算出来。
设定:两层 MLP,隐藏 ReLU,输出线性:
$$W_1=\begin{bmatrix}0.4&-0.3\\0.2&0.4\end{bmatrix},\ b_1=\begin{bmatrix}0.1\\-0.2\end{bmatrix},\quad W_2=\begin{bmatrix}0.7&-0.6\end{bmatrix},\ b_2=0.05$$
输入 $x=[1.0,\;2.0]^{\top}$,目标 $y=1.0$。
前向(正向传播):
$$z_1=W_1x+b_1=\begin{bmatrix}0.4\times1+(-0.3)\times2+0.1\\0.2\times1+0.4\times2+(-0.2)\end{bmatrix}=\begin{bmatrix}-0.1\\0.8\end{bmatrix}$$
$$h=\text{ReLU}(z_1)=\begin{bmatrix}\max(-0.1,0)\\ \max(0.8,0)\end{bmatrix}=\begin{bmatrix}0\\0.8\end{bmatrix}$$
$$\hat{y}=W_2h+b_2=0.7\times0+(-0.6)\times0.8+0.05=-0.43$$
$$L=(\hat{y}-y)^2=(-0.43-1)^2=(-1.43)^2=2.0449$$
反向(BP,链式法则逐步回传):
第一步——输出层误差信号(MSE 导数 $2(\hat{y}-y)$,n=1 不除):
$$\delta_2=\frac{\partial L}{\partial \hat{y}}=2(-0.43-1)=-2.86$$
第二步——输出层权重梯度($gW_2=\delta_2\,h^{\top}$):
$$gW_2=-2.86\times\begin{bmatrix}0&0.8\end{bmatrix}=\begin{bmatrix}0&-2.288\end{bmatrix},\qquad gb_2=\delta_2=-2.86$$
第三步——误差回传隐藏层($dH=\delta_2 W_2$,再乘 ReLU 导数):
$$dH=\delta_2\,W_2=-2.86\times\begin{bmatrix}0.7&-0.6\end{bmatrix}=\begin{bmatrix}-2.002&1.716\end{bmatrix}$$
$$dZ_1=dH\circ\text{ReLU}'(z_1)=\begin{bmatrix}-2.002&1.716\end{bmatrix}\circ\begin{bmatrix}0\\1\end{bmatrix}=\begin{bmatrix}0&1.716\end{bmatrix}$$
第四步——隐藏层权重梯度($gW_1=dZ_1^{\top} x$):
$$gW_1=\begin{bmatrix}0\\1.716\end{bmatrix}\times\begin{bmatrix}1&2\end{bmatrix}=\begin{bmatrix}0&0\\1.716&3.432\end{bmatrix},\qquad gb_1=\begin{bmatrix}0\\1.716\end{bmatrix}$$
核对:梯度检查(中心差分)相对误差 ≈ $1.6\times10^{-11}$——手算完全正确。
关键收获:
- 第 1 个隐藏单元 z=-0.1 被 ReLU 杀死(输出 0),它的整条梯度也为 0——这就是 ReLU 的稀疏性
- 每一步梯度都沿同一个前向值(h=0.8 等)算,绝不重算前向——BP 的「梯度缓存」体现
# ---- §2.1 验证:numpy 复算手算 BP,并做中心差分梯度检查 ----
import numpy as np

W1 = np.array([[0.4, -0.3], [0.2, 0.4]])
b1 = np.array([0.1, -0.2])
W2 = np.array([[0.7, -0.6]])
b2 = np.array([0.05])
x = np.array([1.0, 2.0]); y = np.array([1.0])

# 前向
z1 = W1 @ x + b1
h = np.maximum(z1, 0)
yhat = W2 @ h + b2
loss = (yhat - y) ** 2
print(f'z1={np.round(z1,4)}  h={np.round(h,4)}  yhat={yhat[0]:.4f}  loss={loss[0]:.4f}')
assert np.allclose(z1, [-0.1, 0.8]) and np.allclose(yhat[0], -0.43)

# 反向
dL = 2 * (yhat - y)
gW2 = np.outer(dL, h); gb2 = dL
dH = dL * W2[0]
dZ1 = dH * (z1 > 0)
gW1 = np.outer(dZ1, x); gb1 = dZ1
print(f'delta2={dL[0]:.4f}')
print(f'gW2={np.round(gW2,4)}  gb2={gb2[0]:.4f}')
print(f'dH={np.round(dH,4)}  dZ1={np.round(dZ1,4)}')
print(f'gW1=\n{np.round(gW1,4)}')
print(f'gb1={np.round(gb1,4)}')
assert np.allclose(gW2, [[0, -2.288]]) and np.allclose(gW1, [[0, 0], [1.716, 3.432]])

# 中心差分核对(gold standard)
w = np.concatenate([W1.ravel(), b1, W2.ravel(), b2])
def loss_of(w):
    W1v = w[:4].reshape(2, 2); b1v = w[4:6]; W2v = w[6:8]; b2v = w[8:]
    z1 = W1v @ x + b1v; h = np.maximum(z1, 0)
    return ((W2v @ h + b2v - y) ** 2)[0]
eps = 1e-6
num = np.zeros_like(w)
for i in range(len(w)):
    wp, wm = w.copy(), w.copy()
    wp[i] += eps; wm[i] -= eps
    num[i] = (loss_of(wp) - loss_of(wm)) / (2 * eps)
ana = np.concatenate([gW1.ravel(), gb1, gW2.ravel(), gb2])
rel = np.linalg.norm(num - ana) / (np.linalg.norm(num) + np.linalg.norm(ana))
print(f'\n解析 vs 数值梯度 相对误差 = {rel:.2e}')
assert rel < 1e-5, '梯度不一致!'
print('✓ 手算 BP 与中心差分一致,四个梯度全部正确')
补充:softmax + 交叉熵输出层梯度(多分类)¶
多分类输出层把 logits 归一化为概率: $$p_i = \frac{e^{z_i}}{\sum_j e^{z_j}}$$ 损失取真实类别 $y$ 的负对数概率: $$L = -\log p_y$$ 求 $\partial L / \partial z_k$,分两类情形(softmax 链式 $\partial p_i/\partial z_k = p_i(\mathbb{1}[i{=}k] - p_k)$):
- $k = y$:$L = \log\sum_j e^{z_j} - z_y$,$\dfrac{\partial L}{\partial z_y} = p_y - 1$
- $k \neq y$:$\dfrac{\partial L}{\partial z_k} = p_k - 0$ 合并即灵魂公式: $$\frac{\partial L}{\partial z_i} = p_i - \mathbb{1}[i = y]$$
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
import numpy as np

class MLP:
    """两层 MLP,手写前向/反向/SGD 训练(numpy)"""
    def __init__(self, d, H, K, seed=0):
        rng = np.random.default_rng(seed)
        self.W1 = rng.normal(0, 1 / np.sqrt(d), (H, d))   # Xavier 式初始化
        self.b1 = np.zeros(H)
        self.W2 = rng.normal(0, 1 / np.sqrt(H), (K, H))
        self.b2 = np.zeros(K)
        self.loss_hist = []

    def forward(self, X):
        self.X = X
        self.Z1 = X @ self.W1.T + self.b1
        self.H = np.maximum(self.Z1, 0)              # ReLU
        self.Yhat = self.H @ self.W2.T + self.b2
        return self.Yhat

    def backward(self, Y, lr):
        n = len(Y)
        dL = 2 * (self.Yhat - Y) / n                 # δ2:输出误差
        # 输出层梯度
        gW2 = dL.T @ self.H
        gb2 = dL.sum(axis=0)
        # 回传隐藏层
        dH = dL @ self.W2                             # (n, H)
        dZ1 = dH * (self.Z1 > 0)                      # δ1 = δ2*W2 ∘ ReLU'(Z1)
        gW1 = dZ1.T @ self.X
        gb1 = dZ1.sum(axis=0)
        # SGD 更新
        self.W2 -= lr * gW2; self.b2 -= lr * gb2
        self.W1 -= lr * gW1; self.b1 -= lr * gb1
        return np.linalg.norm(gW1), np.linalg.norm(gW2)   # 梯度范数(中间过程)

    def train(self, X, Y, epochs=500, lr=0.1, verbose=False):
        for e in range(epochs):
            self.forward(X)
            loss = np.mean((self.Yhat - Y) ** 2)
            self.loss_hist.append(loss)
            n1, n2 = self.backward(Y, lr)
            if verbose and (e < 3 or e % 100 == 0 or e == epochs - 1):
                print(f'epoch {e:3d}: loss={loss:.6f}  ||∇W1||={n1:.4f} ||∇W2||={n2:.4f}')

    def predict(self, X):
        return self.forward(X)

# 训练数据:y = x1^2 - 3*x2(非线性回归)
rng = np.random.default_rng(0)
X = rng.uniform(-2, 2, (300, 2))
Y = (X[:, 0] ** 2 - 3 * X[:, 1]).reshape(-1, 1)

mlp = MLP(d=2, H=32, K=1, seed=0)
mlp.train(X, Y, epochs=600, lr=0.05, verbose=True)
print('\n最终训练 MSE =', round(mlp.loss_hist[-1], 5), '(对比线性回归做不到:该目标非线性)')
print('loss 下降倍数 = %.1fx' % (mlp.loss_hist[0] / mlp.loss_hist[-1]))
§3 梯度检查(验证手写 BP 正确性)¶
数值梯度(中心差分):
$$g_{num} = \frac{L(w + \epsilon e_j) - L(w - \epsilon e_j)}{2\epsilon}, \quad \epsilon = 10^{-6}$$
相对误差判据:
$$\frac{\|g_{num} - g_{analytic}\|}{\|g_{num}\| + \|g_{analytic}\|} < 10^{-6} \ \text{(理想)} \quad < 10^{-4} \ \text{(可接受)}$$
这一步是深度学习框架自检的标准流程——你的手写 BP 也应该通过它。
def loss_fn(mlp, X, Y):
    return np.mean((mlp.forward(X) - Y) ** 2)

# 干净实现:把解析梯度暴露出来再检查
class MLPCheck(MLP):
    def grads(self, X, Y):
        self.forward(X)
        n = len(Y)
        dL = 2 * (self.Yhat - Y) / (n * self.Yhat.shape[1])  # loss 是 np.mean 全元素均值
        dH = dL @ self.W2
        dZ1 = dH * (self.Z1 > 0)
        return {'W2': dL.T @ self.H, 'W1': dZ1.T @ self.X,
                'b2': dL.sum(axis=0), 'b1': dZ1.sum(axis=0)}

def grad_check_full(seed=0):
    rng = np.random.default_rng(seed)
    Xs = rng.normal(0, 1, (5, 3))
    Ys = rng.normal(0, 1, (5, 2))
    m = MLPCheck(d=3, H=4, K=2, seed=1)
    ana = m.grads(Xs, Ys)
    print('参数          相对误差     判定')
    ok = True
    for name, g in ana.items():
        P = getattr(m, name)
        num = np.zeros_like(P)
        eps = 1e-6
        it = np.nditer(P, flags=['multi_index'])
        while not it.finished:
            idx = it.multi_index
            orig = P[idx]
            P[idx] = orig + eps
            lp = np.mean((m.forward(Xs) - Ys) ** 2)
            P[idx] = orig - eps
            lm = np.mean((m.forward(Xs) - Ys) ** 2)
            num[idx] = (lp - lm) / (2 * eps)
            P[idx] = orig
            it.iternext()
        denom = np.linalg.norm(num) + np.linalg.norm(g)
        rel = float(np.linalg.norm(num - g) / denom) if denom > 0 else 0.0
        passed = rel < 1e-5
        ok = ok and passed
        print(f'  {name:<6}  {rel:.2e}      {"通过" if passed else "失败"}')
    return ok

all_ok = grad_check_full()
print('\n梯度检查总体结果:', '✅ 全部通过(手写 BP 正确)' if all_ok else '❌ 存在错误,需要排查')
§4 经典案例:XOR 问题(MLP 的能力证明)¶
XOR 线性不可分:感知机(无隐藏层)永远学不会;一层隐藏层 + 非线性激活即可。
$$y = x_1 \oplus x_2 \quad (0\oplus0{=}0,\ 0\oplus1{=}1,\ 1\oplus0{=}1,\ 1\oplus1{=}0)$$
用分类交叉熵 + sigmoid 输出训练,观察 loss 与决策。
def sigmoid(z):
    z = np.asarray(z, dtype=float)
    out = np.empty_like(z)
    pos = z >= 0
    out[pos] = 1.0 / (1.0 + np.exp(-z[pos]))
    out[~pos] = np.exp(z[~pos]) / (1.0 + np.exp(z[~pos]))
    return out

class MLPXor:
    """XOR 专用小 MLP:2->4->1,sigmoid 输出 + 交叉熵/BCE 训练"""
    def __init__(self, seed=0):
        rng = np.random.default_rng(seed)
        self.W1 = rng.normal(0, 1, (4, 2))
        self.b1 = np.zeros(4)
        self.W2 = rng.normal(0, 1, (1, 4))
        self.b2 = np.zeros(1)
        self.loss_hist = []

    def forward(self, X):
        self.Z1 = X @ self.W1.T + self.b1
        self.H = np.tanh(self.Z1)                  # 隐藏用 tanh(对称激活适合 XOR)
        self.logit = self.H @ self.W2.T + self.b2
        self.p = sigmoid(self.logit)
        return self.p

    def train(self, X, Y, epochs=3000, lr=0.1, verbose=False):
        for e in range(epochs):
            self.forward(X)
            ep = 1e-12
            loss = -np.mean(Y * np.log(self.p + ep) + (1 - Y) * np.log(1 - self.p + ep))
            self.loss_hist.append(loss)
            dL = (self.p - Y) / len(Y)             # sigmoid+BCE 梯度 = p - y
            gW2 = dL.T @ self.H
            gb2 = dL.sum(axis=0)
            dH = dL @ self.W2 * (1 - self.H ** 2)  # tanh' = 1 - tanh^2
            gW1 = dH.T @ X
            gb1 = dH.sum(axis=0)
            self.W2 -= lr * gW2; self.b2 -= lr * gb2
            self.W1 -= lr * gW1; self.b1 -= lr * gb1
            if verbose and (e < 4 or e % 500 == 0):
                print(f'epoch {e:4d}: BCE={loss:.6f}')

X = np.array([[0, 0], [0, 1], [1, 0], [1, 1]], dtype=float)
Y = np.array([[0], [1], [1], [0]], dtype=float)
m = MLPXor(seed=0)
m.train(X, Y, epochs=3000, lr=0.3, verbose=True)
print('\nXOR 预测(应接近 [0,1,1,0]):')
print(np.round(m.forward(X).ravel(), 4))
print('以 0.5 为阈值准确率 =', np.mean((m.forward(X).ravel() > 0.5).astype(int) == Y.ravel()))
print('初始 loss =', round(m.loss_hist[0], 4), '→ 最终 loss =', round(m.loss_hist[-1], 6))
§5 常见 bug 与边界(面试踩坑区)¶
- 初始化过大/Random 太散:sigmoid/tanh 初始权重 >1 会饱和 → 梯度消失;用 Xavier($1/\sqrt{d}$)或 He($\sqrt{2/d}$)
- ReLU 导数写错:$z \le 0$ 处为 0(含 0),不是 1
- BCE 微分项:sigmoid+BCE 的 $\delta = p - y$(漂亮抵消),不能直接用 MSE 那套
- 批量均值漏除:损失除以 n,梯度里忘记除 n → 学习率语义错乱
- 梯度检查用同一份数据:数值梯度与解析梯度必须用同一个前向状态(别再 forward 一次)
- tanh 输出范围:tanh 输出 [-1,1],做二分类输出层要用 sigmoid([0,1])
- 过拟合信号:训练 loss 下降但测试不动 → 加正则/早停(模型笔记 7 覆盖)
5.x 为什么「全 0 初始化」不行¶
- 对称破坏缺失:所有神经元初始完全相同 → 前向输出相同 → 同层梯度相同 → 权重永远同步更新
- 后果:隐藏层所有神经元始终是彼此的复制品,网络退化为「单神经元」宽度
- ReLU 全 0 时梯度恒为 0,权重彻底卡死
所以需要随机初始化打破对称(Xavier/He 等)。
§6 面试追问与扩展(加分项)¶
6.1 为什么需要非线性激活¶
无激活时多层线性 = 单层线性(矩阵乘积仍线性),表达能力退化为线性模型——激活是 MLP 表达能力的来源。
6.2 为什么用交叉熵而不是 MSE(呼应推导笔记 2)¶
MSE + sigmoid 饱和区梯度含 $\sigma'$ 趋于 0;交叉熵让输出层梯度 = $p-y$,永不消失。
6.3 BP 的复杂度¶
前向 + 反向各一次矩阵乘链:$O(\text{参数量})$ 级——与前向相同数量级,这正是深度模型可训练的原因。
6.4 与自动微分的关系¶
torch/tf 的 backward() 就是反向模式自动微分(计算图 + 链式法则);手写 BP = 手动展开反向模式。
6.5 前向模式 vs 反向模式自动微分¶
计算图求导有两条路线:
- 前向模式:从输入出发,一次只传播一个方向导数 $\dot{v}_i = \partial v_i / \partial z$——$n$ 个输入要跑 $n$ 趟
- 反向模式:从输出出发,把梯度 $\bar{v}_i = \partial L / \partial v_i$ 沿计算图回传——标量输出只需 1 趟
训练损失 $L$ 是标量,所以用反向模式;这也是 torch 的 backward() 高效的原因。
§7 自测清单(L1 必会 / L2 进阶 / L3 挑战)¶
L1 必会(10 问)¶
- 1. 写出两层 MLP 前向公式
- 2. 写出 BP 四条梯度公式(W2/b2/W1/b1)
- 3. 解释 δ 回传的链式过程
- 4. 手写两层 MLP(numpy)跑通非线性回归
- 5. 手写 ReLU 前向与导数
- 6. 手写 sigmoid+BCE 的前向与梯度
- 7. 梯度检查:中心差分实现
- 8. 解释感知机为何不能解决 XOR
- 9. 手写 MLP 解决 XOR
- 10. 损失曲线中间输出(训练观察)
L2 进阶(10 问)¶
- 11. 推导 tanh 导数并实现 BP
- 12. 手写 softmax 输出层 + 交叉熵梯度(多分类 MLP)
- 13. Xavier/He 初始化推导(方差传播)
- 14. 手写 mini-batch 训练(含 shuffle)
- 15. 梯度消失/爆炸观察实验(深层权重范数输出)
- 16. 手写带 L2 正则的 BP(梯度 += λw)
- 17. 手写动量版 SGD(速度变量)
- 18. 多分类 MLP 跑通鸢尾-like 数据
- 19. Batch 版 vs 单样本版梯度一致性验证
- 20. 手写 LR 衰减(训练中段输出)
L3 挑战(5 问)¶
- 21. 手写任意层数 MLP(循环建层 + 层列表存缓存)
- 22. 反向模式自动微分雏形(计算图)
- 23. 推导矩阵形式 BP 每一步维度
- 24. Dropout + BN 加入手写 MLP(见模型笔记 5/7)
- 25. 手写 K 分类 + 权重共享(Conv 前身)
自测要点¶
- 白板推导:2 层 MLP 的完整 BP(含维度核对)
- 15 分钟内盲写:MLP 类 + XOR 训练
- 讲清「梯度检查为什么是 BP 正确性的金标准」
# 手写 BP vs torch.autograd 对照(同一权重 / 同一输入,2→4→1 ReLU)
import torch

def manual_mlp_forward(X, W1, b1, W2, b2):
    Z1 = X @ W1.T + b1
    H = np.maximum(Z1, 0)                     # ReLU
    Yhat = H @ W2.T + b2
    return Yhat, (Z1, H)

def manual_mlp_backward(X, Y, W1, b1, W2, b2):
    n = len(Y)
    Yhat, (Z1, H) = manual_mlp_forward(X, W1, b1, W2, b2)
    dL = 2 * (Yhat - Y) / n                   # 输出层误差
    gW2 = dL.T @ H
    gb2 = dL.sum(axis=0)
    dH = dL @ W2
    dZ1 = dH * (Z1 > 0)                       # ReLU' 掩码
    gW1 = dZ1.T @ X
    gb1 = dZ1.sum(axis=0)
    return {'W1': gW1, 'b1': gb1, 'W2': gW2, 'b2': gb2}

rng = np.random.default_rng(42)
n = 8
X = rng.normal(0, 1, (n, 2))
Y = rng.normal(0, 1, (n, 1))
W1 = rng.normal(0, np.sqrt(2 / 2), (4, 2))    # He 初始化
b1 = np.zeros(4)
W2 = rng.normal(0, np.sqrt(2 / 4), (1, 4))
b2 = np.zeros(1)

# 手写梯度(float64)
manual = manual_mlp_backward(X, Y, W1, b1, W2, b2)

# torch.autograd 对照(同样 float64,消除精度差异)
X_t = torch.tensor(X, dtype=torch.float64)
Y_t = torch.tensor(Y, dtype=torch.float64)
W1_t = torch.nn.Parameter(torch.tensor(W1, dtype=torch.float64))
b1_t = torch.nn.Parameter(torch.tensor(b1, dtype=torch.float64))
W2_t = torch.nn.Parameter(torch.tensor(W2, dtype=torch.float64))
b2_t = torch.nn.Parameter(torch.tensor(b2, dtype=torch.float64))

Z1_t = X_t @ W1_t.T + b1_t
H_t = torch.relu(Z1_t)
Yhat_t = H_t @ W2_t.T + b2_t
loss_t = torch.mean((Yhat_t - Y_t) ** 2)
loss_t.backward()

auto = {'W1': W1_t.grad.numpy(), 'b1': b1_t.grad.numpy(),
        'W2': W2_t.grad.numpy(), 'b2': b2_t.grad.numpy()}

max_err = 0.0
for name in manual:
    err = float(np.max(np.abs(manual[name] - auto[name])))
    max_err = max(max_err, err)
    print(f'{name}: 最大误差 = {err:.3e}  allclose: {np.allclose(manual[name], auto[name], rtol=1e-4, atol=1e-6)}')

print(f'\n总最大绝对误差 = {max_err:.3e}')
assert max_err < 1e-5, '手写 BP 与 torch.autograd 梯度不一致!'
print('✅ 手写 BP 与 torch.autograd 梯度一致(< 1e-5)')