00-数学基础 · 最优化与数值基础¶
编号:04 · 模块:00-数学基础 · 难度:★★★☆☆ 一句话定位:凸性、梯度下降、牛顿法、拉格朗日乘子、KKT、对偶——让模型「学会」的引擎。 学完本篇:你能徒手推导梯度下降更新公式、说出「为什么凸优化好」、讲清拉格朗日乘子和 KKT 各自解决什么问题, 并知道逻辑回归(LR)、SVM、Adam 分别用到了哪些最优化思想。
配套:本篇配 3 个可运行代码 cell(梯度下降 + 解析最优步长、拉格朗日/KKT 数值验证、轨迹图),全程只用 numpy / matplotlib。
本节要解决的问题¶
| 要解决的问题 | 对应内容 |
|---|---|
| 一个优化问题由哪三要素组成? | 核心概念 → 优化问题三要素 |
| 为什么大家都说「凸优化好」?凸函数怎么判断? | 深入原理 1 → 凸函数定义与判定 |
| 梯度下降是怎么推导出来的?学习率怎么选? | 深入原理 2 → 梯度下降直觉与收敛性 |
| 一维二次函数的最优步长能「算」出来吗? | 深入原理 3 → 解析最优步长 + 代码实战 1 |
| 牛顿法比梯度下降强在哪?拟牛顿又是什么? | 深入原理 4 → 牛顿法与拟牛顿 |
| 等式约束怎么优化?拉格朗日乘子到底在干嘛? | 深入原理 5 → 拉格朗日乘子法(等式约束) |
| 不等式约束怎么办?KKT 四条是什么? | 深入原理 6 → KKT 条件通俗解读 |
| SVM 为什么非要转对偶? | 深入原理 7 → 对偶问题与 SVM |
| LR / SVM / Adam 各用了哪些优化思想? | 深入原理 8 → 在 ML 里哪用 + 面试考点 |
故事引入¶
假设你是一名半夜在山上迷路的游客,四周伸手不见五指,手机没电、地图丢失。你唯一的任务,是从当前位置走到山谷最低点——那里是唯一能求救的营地。
你摸黑开了个窍:既然看不见远处,就只感受脚下。哪边地面往下倾斜,就往那边走一小步。于是「感受坡度、沿下坡走一小步、再感受坡度、再走一步」——这就是梯度下降:每一步都朝「下降最快」的方向迈出「不大不小」的一步(这一步的大小就是学习率 η)。走着走着你发现步长特别讲究:迈太大,会一脚踩空冲到对面的山坡上弹来弹去(震荡甚至发散);迈太小,走到天亮都到不了营地(收敛太慢)。
过了一阵,队长带着探照灯来了,他能看清整座山的弯曲程度,直接告诉你「沿着这条弧线切过去,两步就到谷底」——这就是牛顿法:不只用了坡度(一阶导数),还用了山坡的弯曲程度(二阶导数 / Hessian)。
再后来你发现谷底其实被一圈铁轨围住,你只能沿着铁轨滑动找最低点——这就是等式约束下的优化,靠拉格朗日乘子法解决;护栏升级成「禁入区」(只许在圈外走),那就成了不等式约束,需要 KKT 条件判断你是否恰好贴在护栏边上(互补松弛)。
最后你会恍然大悟:机器学习里的「训练模型」= 在参数空间里下山,「模型越好 = 掉进越深的谷底」,而 LR、SVM、Adam 只是不同的下山工具包而已。本篇就把这趟「下山之旅」的全部工具讲透。
核心概念¶
(a) 🗂️ 最优化全景:三要素 → 凸性 → 下山算法 → 约束 → 对偶 → ML 应用¶
先给一张全景图:一个优化问题长什么样、为什么凸性重要、有哪些下山算法、约束怎么处理、SVM 怎么用上对偶,最后落到 LR/SVM/Adam 三件套。图里每个节点在下面都有大白话解释。
flowchart TB
    A["🧠 优化问题三要素<br/>目标·变量·约束"] --> B["🧠 凸集与凸函数<br/>为什么凸好"]
    B --> C["🧠 梯度下降<br/>一阶下山法"]
    C --> D["🧠 学习率与收敛<br/>大步震荡·小步蜗牛"]
    C --> E["🧠 牛顿法 / 拟牛顿<br/>二阶信息·BFGS"]
    A --> F["🧠 拉格朗日乘子法<br/>等式约束"]
    F --> G["🧠 KKT 条件<br/>不等式约束"]
    F --> H["🧠 对偶问题<br/>弱对偶·强对偶"]
    H --> I["🧠 SVM 中的应用<br/>核技巧·支持向量"]
    D --> J["🧠 ML 落地<br/>LR·SVM·Adam"]
    E --> J
    I --> J
- 优化问题三要素:一个优化问题 = 决策变量 x(你要调的东西)+ 目标函数 f(x)(你要最小化的损失)+ 约束条件(等式 h(x)=0 或不等式 g(x)≤0,限制 x 的活动范围)。机器学习里 x 就是模型参数 w。
- 凸集与凸函数:凸集里任意两点的连线还在集合里;凸函数图像像碗(∪)不像山包(∩)。「凸」是优化世界的头号好消息:一旦问题凸,局部最优就是全局最优,梯度下降不会被困在原地。
- 梯度下降:最朴素的一阶下山法,更新公式 x ← x − η∇f(x)。直觉就是「踩脚感、沿下坡走一步」,是反向传播训练神经网络的核心引擎。
- 学习率与收敛:η 决定每一步迈多大。太大震荡甚至发散(一步冲到对面山坡),太小半天到不了底;收敛条件、解析最优步长、自适应学习率都在这一节。
- 牛顿法 / 拟牛顿:用二阶信息(Hessian)看穿山坡弧度,二次函数一步收敛,但对大规模问题算 Hessian 太贵;拟牛顿(BFGS / L-BFGS)用梯度差近似 Hessian,取两者之长。
- 拉格朗日乘子法:把等式约束「吸收」进目标函数 L=f+λh,最优解处目标梯度与约束法向平行,λ 就是这个平行比例(也是对偶变量)。
- KKT 条件:不等式约束的最优性「体检单」:平稳性、原始可行、对偶可行(λ≥0)、互补松弛(λg=0)四条,一条都不能少。
- 对偶问题:把「约束惩罚力度 λ」当变量反过来优化,得到对偶问题;弱对偶保证对偶值 ≤ 最优值,凸 + Slater 时强对偶成立(相等)。
- SVM 中的应用:SVM 转对偶后拿到的 α 只有支持向量非零(稀疏),且内积可以换成核函数,在高维空间免算显式特征——这就是 SVM 能处理非线性问题的原因。
- ML 落地:LR 是凸问题用梯度下降/牛顿/L-BFGS;SVM 用 SMO 解对偶;神经网络非凸用 SGD/Adam(动量 + 自适应学习率)。三个算法把本篇所有概念串成一条线。
深入原理¶
1️⃣ 凸函数:定义、判定与「为什么凸好」¶
大白话直觉
凸集是「任意两点连线都在集合里」的集合,像圆盘、像实心球,不会凹进去。凸函数是「函数图像上任意两点连成的弦,永远在图像上方」的函数——图像像个碗(∪ 形),而不是山包(∩ 形)。一碗水倒进碗里,水永远聚在碗底:这就是凸函数好的原因——碗只有一个底(全局极小唯一或平坦),而且无论从哪开始找,都只会越找越低、不会掉进假谷底(局部极小)。
凸集定义
$$C \text{ 是凸集 } \iff \forall\, x,y\in C,\ \forall\, \theta\in[0,1]:\quad \theta x+(1-\theta)y \in C$$
凸函数定义
$$f\text{ 是凸函数 } \iff \forall\, x,y\in \mathrm{dom}\,f,\ \forall\, \theta\in[0,1]:\quad f\big(\theta x+(1-\theta)y\big)\ \le\ \theta f(x)+(1-\theta)f(y)$$
两条好用的判定工具
一阶条件(f 可微):切线永远在图像下方, $$f(y)\ \ge\ f(x)+\nabla f(x)^\top (y-x)\qquad \forall\,x,y$$
二阶条件(f 二阶可微):Hessian 半正定, $$\nabla^2 f(x)\succeq 0 \iff \text{所有特征值}\ge 0 \iff \text{一元时 } f''(x)\ge 0$$
关键推导:为什么「局部极小 = 全局极小」
设 $x^\*$ 是凸问题的一个局部最优。对任意可行点 $y$,由一阶条件: $$f(y)\ \ge\ f(x^\*)+\nabla f(x^\*)^\top(y-x^\*)$$ 因为 $x^\*$ 是局部最优,沿可行方向移动函数不会下降,故 $\nabla f(x^\*)^\top(y-x^\*)\ge 0$,代入得 $f(y)\ge f(x^\*)$。也就是说任意可行点都不比 $x^\*$ 差,$x^\*$ 就是全局最优。凸性把「找到局部解」直接升级成「找到全局解」。
面试怎么问:「为什么机器学习里大家都喜欢凸问题?LR 的损失函数是凸的吗?」答:凸问题局部最优即全局最优、优化有收敛保证、KKT 是充要条件;逻辑回归的负对数似然(交叉熵损失)关于参数 w 是凸的,所以梯度下降一定能找到全局最优。
2️⃣ 梯度下降:直觉、推导与收敛性¶
大白话直觉
把目标函数想成山坡高度。梯度 ∇f(x) 指向「上升最快」的方向,那负梯度就指向「下降最快」的方向,所以更新公式就是「当前位置 − 学习率 × 梯度」。学习率 η 是每一步迈多大——这是全篇最重要、面试最常问的一个旋钮。
从一阶泰勒展开推导更新公式
对 f 在 $x_k$ 附近沿方向 d 迈一小步 η:
$$f(x_k+\eta d)\ \approx\ f(x_k)+\eta\,\nabla f(x_k)^\top d$$
要让右边最小,在步长 η 和方向长度固定时,等价于让 $\nabla f^\top d$ 最小。两个向量点积最小当且仅当它们方向相反(cos 取 −1):
$$d=-\frac{\nabla f(x_k)}{\|\nabla f(x_k)\|}\quad\Longrightarrow\quad \boxed{x_{k+1}=x_k-\eta\,\nabla f(x_k)}$$
所以「反着梯度走」不是玄学,是一阶泰勒展开下每步下降量最大化的必然结论。
收敛性结论(背下来)
若梯度是 L-Lipschitz 的($\|\nabla f(x)-\nabla f(y)\|\le L\|x-y\|$,L 是曲率上界),取 $\eta\le 1/L$,则对凸函数有:
$$f(x_k)-f^\* \le \frac{L\,\|x_0-x^\*\|^2}{2k}$$
即次优性差距以 O(1/k) 衰减(次线性);若函数还强凸(Hessian 有正下界 μ),则可达线性收敛 $f(x_k)-f^\*\le O(\rho^k)$。这也是为什么深度学习中损失「越到后面下降越慢」——一阶方法越接近谷底,能利用的信息越少。
学习率的三重性格
| η 的情况 | 表现 | 类比 |
|---|---|---|
| η 太小 | 收敛极慢,万步到不了底 | 蜗牛下山 |
| η 合适 | 平稳下降 | 正常步速 |
| η 太大 | 震荡不收敛甚至发散 | 一步冲过谷底弹到对面山坡 |
面试怎么问:「为什么梯度下降要沿负梯度方向?」答:一阶泰勒展开,单位步长内下降量 ≈ η∇fᵀd,∇fᵀd 最小当且仅当 d 与 −∇f 同向;再追问「那为什么还需要动量/Adam?」,因为真实损失非凸且条件数大,固定步长一阶方法会之字形(zigzag)摆动。
✍️ §2.1 手算一维下山:梯度下降 vs 牛顿法,一个二次函数全看清¶
梯度下降 $x_{t+1}=x_t-\eta f'(x_t)$,牛顿法 $x_{t+1}=x_t-f'(x_t)/f''(x_t)$——对 $f(x)=x^2$ 各走一步,看收敛速度差在哪。
设定:$f(x)=x^2$,起点 $x_0=3$。$f'=2x$、$f''=2$。
第 1 步:梯度下降($\eta=0.1$)
$$f'(3)=6\Rightarrow x_1=3-0.1\times6=2.4$$
$f(2.4)=5.76$,相比 $f(3)=9$ 一次下降 36%。
第 2 步:牛顿法(用二阶曲率)
$$x_1=3-\frac{f'(3)}{f''(3)}=3-\frac{6}{2}=0$$
一步直接到极小点($f(0)=0$)!
第 3 步:对比
| 方法 | $x_1$ | $f(x_1)$ | 说明 |
|---|---|---|---|
| 梯度下降 ($\eta=0.1$) | 2.4 | 5.76 | 线性收敛,每步缩固定比例 |
| 牛顿法 | 0.0 | 0 | 二次收敛,一步到底(二次函数恰好精确) |
手算收获:
- 梯度下降只用一阶信息,步长 $\eta$ 靠人调:太大振荡、太小龟速;牛顿法用 $f''$ 估计"弯到哪停",免调步长
- 对二次函数牛顿法一步精确收敛($x^2$ 的 $f''$ 恒定);对一般函数 $f''$ 每步变,需迭代——本 notebook §3 的"解析最优步长"就是二次假设下的 $\eta^*$
- 高维版本:梯度下降 $x\gets x-\eta\nabla f$,牛顿法 $x\gets x-\mathbf{H}^{-1}\nabla f$(H 为 Hessian)——算 H⁻¹ 太贵,于是有 L-BFGS/Adam 等近似(本 notebook §4)
- 面试常问"为什么 Adam 比 SGD 稳":Adam 用梯度的二阶矩(对角近似 Hessian 信息)+ 自适应步长
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算梯度下降 vs 牛顿法 ----
import numpy as np

x0 = 3.0
g, h = 2 * x0, 2.0
x_gd = x0 - 0.1 * g
x_nt = x0 - g / h
print(f'f(x)=x²: f\'({x0:.0f}) = {g}, f\'\' = {h}')
print(f'梯度下降 x1 = {x_gd}(f = {x_gd**2:.2f})')
print(f'牛顿法   x1 = {x_nt}(f = {x_nt**2:.0f})')
assert abs(x_gd - 2.4) < 1e-9 and abs(x_nt) < 1e-9
print('\n✓ 与手算一致:牛顿法对二次函数一步收敛')
3️⃣ 收敛直觉拉满:一维二次函数的解析最优步长¶
大白话直觉
在「下山」比喻里,步长是唯一的旋钮。对最简单的一维二次函数 $f(x)=a x^2$(标准碗形),「沿负梯度走一步之后函数值还剩多少」是关于 η 的二次函数,求个导令其为 0,就得到解析最优步长:
$$\eta^\*=\frac{1}{2a}$$
代入更新公式会发现:这一步直接踩进碗底 x=0,函数值一步归零!这就是「步长纯靠猜」和「步长算出来」的差距。
推导(一步步来)
对 $f(x)=a x^2$(a>0),梯度 $f'(x)=2ax$。沿负梯度走一步:
$$x_{k+1}=x_k-\eta\cdot 2a x_k=(1-2a\eta)\,x_k$$
记收缩因子 $r=|1-2a\eta|$,则函数值按平方收缩:
$$f(x_{k+1})=a\,x_{k+1}^2=a\,r^2 x_k^2=r^2\, f(x_k)$$
求最优步长:让收缩因子最小,令 $1-2a\eta=0$:
$$\boxed{\eta^\*=\dfrac{1}{2a}}\qquad\Rightarrow\qquad r=0,\ \ x_{k+1}=0,\ \ f(x_{k+1})=0\ \text{(一步收敛)}$$
收敛区域:要求每一步不放大误差,即 r<1:
$$|1-2a\eta|<1 \iff 0<\eta<\frac{1}{a}=2\eta^\*$$
- $0<\eta<2\eta^\*$:收敛;$\eta=\eta^\*$ 一步到位;
- $\eta=2\eta^\*$:r=1,在 x 与 −x 之间无限振荡;
- $\eta>2\eta^\*$:发散,越走越远。
对 ML 的心法(推广结论)
- 步长与曲率成反比:碗越陡(a 大)步长就要越小,否则一步冲过头——这就是为什么需要归一化/缩放特征;
- 多维时固定步长受最陡方向限制:收敛条件变成 $\eta<2/\lambda_{\max}$(λ 是 Hessian 特征值),所以条件数 $\lambda_{\max}/\lambda_{\min}$ 越大、固定步长越难收敛——这正是牛顿法和自适应方法存在的理由;
- 一般情形下收敛速度由矩阵 $I-\eta H$ 的谱半径决定,一维二次是这个原理的完整缩影。
面试怎么问:「学习率大于 1/a 会怎样?」(发散或振荡);「同一目标函数,为什么牛顿法一步收敛、梯度下降要很多步?」(一维二次里体现为:固定 η 无法同时适配不同曲率方向,而牛顿法用 H⁻¹ 自动做了「白化」)。
4️⃣ 牛顿法与拟牛顿:把「弯曲程度」也用上¶
大白话直觉
梯度下降只用「坡度」(一阶导数),像闭着眼摸黑下山;牛顿法还用了「坡度变化得多快」(二阶导数 / Hessian),像睁眼看到远处山体的弧度,直接沿弧线切线切向谷底。对二次函数,二阶近似是精确的,所以牛顿法一步收敛——这是它最华丽的性质。
推导(二阶泰勒展开)
在 $x_k$ 附近把 f 展开到二阶:
$$f(x)\ \approx\ f(x_k)+\nabla f(x_k)^\top (x-x_k)+\tfrac{1}{2}(x-x_k)^\top H_k (x-x_k),\qquad H_k=\nabla^2 f(x_k)$$
令 $\Delta x=x-x_k$,对 Δx 求导并令为 0(H 正定时二次函数驻点即极小点):
$$\nabla f(x_k)+H_k\,\Delta x=0 \quad\Longrightarrow\quad \boxed{\Delta x=-H_k^{-1}\nabla f(x_k)}$$
为什么二次函数一步收敛:f 本身就是二次函数时,二阶展开是精确等式,「求近似函数的极小点」=「求真正函数的极小点」。
优缺点对比
| 优点 | 缺点 |
|---|---|
| 附近二次收敛(极快),不受条件数影响(H⁻¹ 自动做「白化」) | 每步算 Hessian(O(n²) 存储)+ 求逆(O(n³) 计算),代价高 |
| 无需手调学习率(步长 1,方向由曲率自适应) | H 非正定时方向不保证下降,需要修正(LM、阻尼) |
| 对强凸光滑问题收敛极快 | 大规模深度模型根本存不下 Hessian |
拟牛顿:不要 Hessian,用梯度差近似
记 $s_k=x_{k+1}-x_k$,$y_k=\nabla f(x_{k+1})-\nabla f(x_k)$。由中值定理 $y_k\approx H_k s_k$,所以要求近似矩阵 $B_k\approx H_k$ 满足割线方程 $B_{k+1}s_k=y_k$,再加上一项保正定的秩二修正,就是 BFGS:
$$B_{k+1}=B_k+\frac{y_k y_k^\top}{y_k^\top s_k}-\frac{B_k s_k s_k^\top B_k}{s_k^\top B_k s_k}$$
实际实现往往直接逼近 $H^{-1}$(避免每次求逆);内存不够就用 L-BFGS,只保留最近 m 组 (s,y)。
面试怎么问:「牛顿法为什么比梯度下降快?代价是什么?」答:用二阶信息,二次收敛 vs 一阶 O(1/k);代价是 O(n²) 存储 Hessian、O(n³) 求逆;「什么场景用拟牛顿?」——中等规模、目标可微的凸问题,比如 scikit-learn 里 LR / 线性 SVM 求解器默认就是 L-BFGS。
5️⃣ 拉格朗日乘子法:等式约束下的「梯度平行」原理¶
大白话直觉
现在谷底被一条铁轨(约束 x+y=1)穿过,你只能站在铁轨上找最低点。直觉是:在铁轨上走到最低处时,再往前挪一步,高度只能升、不能降——也就是说,此时「山坡的坡度」必须垂直于「铁轨的方向」(否则沿铁轨方向还有下坡分量可走)。而「∇f 垂直于铁轨方向」等价于「∇f 与铁轨的法向 ∇h 平行」。拉格朗日乘子 λ 就是记录它们平行程度的比例系数,它同时等于「约束每放松一单位,最优值能改善多少」的边际价格。
推导(min f(x) s.t. h(x)=0)
构造拉格朗日函数,把约束「吸收」进目标:
$$L(x,\lambda)=f(x)+\lambda\,h(x)$$
在约束曲面上任取一条参数曲线 x(t)(满足 h(x(t))≡0),其切向 d=x'(t)。最优处沿切向一阶变化为 0:
$$\nabla f(x)^\top d=0,\qquad \nabla h(x)^\top d=0\ \big(\text{因 }h(x(t))\equiv0\big)$$
即 ∇f 与 ∇h 都与同一个切空间垂直 ⇒ 两者共线(都在法线方向):
$$\nabla f(x)+\lambda\,\nabla h(x)=0$$
再补上约束本身,得到 n+1 个方程、解 n+1 个未知数(x 的 n 个分量 + λ):
$$\frac{\partial L}{\partial x}=0:\ \nabla f+\lambda\nabla h=0;\qquad\qquad \frac{\partial L}{\partial \lambda}=0:\ h(x)=0$$
示例:min $x^2+y^2$ s.t. x+y=1(原点在直线 x+y=1 上的垂足问题)。由 2x+λ=0、2y+λ=0 得 x=y=−λ/2,代入约束 2·(−λ/2)=1 ⇒ λ=−1,x=y=1/2,最优值 1/2。几何上:梯度 ∇f=(1,1) 恰与约束法向 ∇h=(1,1) 平行,平行比例正是 −λ=1。
面试怎么问:「拉格朗日乘子法在干嘛?」答:把带等式约束的优化变成无约束找驻点,λ 是「约束的边际价格」(对偶变量);「λ 可正可负吗?」——等式约束的 λ 无符号限制($\partial L^\*/\partial b=\lambda$,b 是约束右端项),而不等式约束的乘子必须 λ≥0(下一节 KKT)。
6️⃣ KKT 条件:不等式约束的最优性「体检单」¶
大白话直觉
护栏升级成「禁入区」:约束变成 $g(x)\le 0$(比如 x≤1)。KKT 告诉你,最优点只有两种身份:要么没碰到禁入区(约束不活跃,约束形同虚设,λ=0);要么恰好贴在边界上(约束活跃,λ>0,禁入区「顶着」你)。λ≥0 的物理含义:禁入区的力只能往内顶、阻拦你出去,绝不可能反过来帮你「推」得更远——所以不等式乘子永不取负。
四个条件(对 min f(x) s.t. $g_i(x)\le0,\ h_j(x)=0$,设最优点 $x^\*$ 与乘子 $\lambda^\*,\mu^\*$)
平稳性(stationarity)——一阶最优的必要条件: $$\nabla f(x^\*)+\sum_i \lambda_i^\*\,\nabla g_i(x^\*)+\sum_j \mu_j^\*\,\nabla h_j(x^\*)=0$$
原始可行性(primal feasibility)——解本身必须是可行点: $$g_i(x^\*)\le 0,\qquad h_j(x^\*)=0$$
对偶可行性(dual feasibility)——不等式乘子不能为负: $$\lambda_i^\*\ge 0$$
互补松弛(complementary slackness)——「活跃 ⇔ λ>0」与「不活跃 ⇔ g<0」二选一: $$\lambda_i^\*\,g_i(x^\*)=0$$
关键推导:互补松弛从哪来
因为 λ_i≥0 且 g_i(x)≤0,所以乘积 $\lambda_i g_i(x)\le 0$。在最优处,拉格朗日函数在此取值: $$L(x^\*,\lambda^\*)=f(x^\*)+\sum_i \lambda_i^\* g_i(x^\*)=f(x^\*) \iff \sum_i \lambda_i^\* g_i(x^\*)=0$$ 上面的等式对凸问题在强对偶成立时一定成立;而左边每一项都 ≤0,和为 0 就迫使每一项都是 0——这就是互补松弛。它告诉我们:只关心「贴身约束」,松动的约束(g<0)不产生任何作用力(λ=0)。
示例:min $(x-2)^2$ s.t. x≤1。无约束最优点 x=2 不可行,所以最优解贴边界 x*=1(约束活跃)。平稳性:2(x*−2)+λ·1=0 ⇒ λ=2≥0 ✓;互补松弛 λ·(x*−1)=0 ✓。若把约束改成 x≤3(不活跃),则 λ=0,解就是无约束解 x=2。
面试怎么问:「KKT 四条件背一遍?互补松弛是什么意思?」(背四条,再用「活跃/不活跃」讲 λg=0);「KKT 是充分条件吗?」——对凸问题 + 约束品性(如 Slater 条件)时是充要条件;非凸时一般只是必要条件。
7️⃣ 对偶问题与 SVM:为什么要绕一大圈?¶
大白话直觉
原问题可能很难直接解(约束多、维度高)。对偶的思路是反过来问:「护栏要往里顶多大力(λ),才能把我拦在最低点?」 先假设惩罚力度 λ 已知,求无约束最优 x(这是对偶函数);再反过来调 λ 让原问题被拦得最紧。最后发现:真正顶住你的只有少数几块护栏——支持向量,其余护栏全是摆设(λ=0)。SVM 绕这一圈,换来两个大礼包:核技巧 + 稀疏性。
定义(标准形式 min f(x) s.t. $g_i(x)\le0$)
拉格朗日函数:$L(x,\lambda)=f(x)+\sum_i \lambda_i g_i(x),\ \lambda_i\ge0$。 对偶函数(先对 x 取下确界):$d(\lambda)=\inf_x L(x,\lambda)$。 对偶问题:$\max_{\lambda\ge 0}\ d(\lambda)$。
弱对偶永远成立,凸 + Slater 才有强对偶
$$d(\lambda)\le p^\*\quad(\text{对所有可行 }\lambda);\qquad d^\*=p^\*\quad(\text{强对偶:对偶间隙为 }0)$$
其中 Slater 条件:存在一个严格可行点使所有不等式约束严格成立(对线性不等式通常自动满足)。
SVM 的完整链路(背下来)
原问题(软间隔前的最简形式):
$$\min_{w,b}\ \tfrac{1}{2}\|w\|^2 \quad \text{s.t.}\quad y_i(w^\top x_i+b)\ge 1$$
写 L 并对 w、b 求极小:$w=\sum_i \alpha_i y_i x_i$ 且 $\sum_i \alpha_i y_i=0$,代回得到对偶问题(只剩 α):
$$\max_{\alpha}\ \sum_i \alpha_i-\tfrac{1}{2}\sum_{i,j}\alpha_i\alpha_j\, y_i y_j\, x_i^\top x_j \quad\text{s.t.}\quad \sum_i \alpha_i y_i=0,\ \ \alpha_i\ge0$$
两个大好处
- 核技巧:把 $x_i^\top x_j$ 换成核函数 $K(x_i,x_j)=\varphi(x_i)^\top\varphi(x_j)$(如高斯核),不需要显式升维就能在高维甚至无穷维空间做线性分类;预测时 w 的显式形态也不需要,只需对支持向量求核内积;
- 稀疏性:互补松弛 $\alpha_i\big[y_i(w^\top x_i+b)-1\big]=0$ 推出 α_i>0 的样本恰好落在间隔边界上——这些支持向量之外的点 α_i=0,完全不参与预测,模型天然精简。
面试怎么问:「SVM 为什么要转对偶?」(核技巧免高维内积 + 稀疏支持向量 + 凸二次规划有全局最优与成熟求解器/SMO);「什么是支持向量?」(α_i>0 的样本,即落在间隔边界或间隔内的点)。
8️⃣ 在 ML 里哪用:LR / SVM / Adam 一张表¶
大白话总览:三个算法恰好演示了最优化工具的三种用法——LR 是凸的、直接一阶/二阶方法硬解;SVM 也是凸的,但绕道对偶拿到核技巧和稀疏性;神经网络非凸且超大,只能喂给一阶随机方法 + 各种加速技巧(动量、自适应学习率)。
| 算法 | 目标函数 | 凸不凸 | 用什么优化 | 本篇对应概念 |
|---|---|---|---|---|
| 逻辑回归 LR | 负对数似然(交叉熵) | ✅ 凸 | 梯度下降 / 牛顿(IRLS) / L-BFGS | 梯度下降、二阶方法 |
| 线性 SVM | 合页损失 + ½‖w‖² | ✅ 凸 | SMO 序列最小优化(解对偶) | 拉格朗日对偶、KKT、互补松弛 |
| 核 SVM | 对偶二次规划 | ✅ 凸 | SMO / QP 求解器 | 核技巧、支持向量 |
| 神经网络 / 深度模型 | 交叉熵 / MSE | ❌ 非凸 | SGD / Adam / 变体 | 梯度下降 + 动量 + 自适应学习率 |
| 推荐 / 矩阵分解 | 带正则的平方误差 | 一般凸 | 交替最小二乘 ALS | 每个子问题都是凸最小二乘 |
Adam 四行公式(面试必背)
$$m_k=\beta_1 m_{k-1}+(1-\beta_1)g_k,\qquad v_k=\beta_2 v_{k-1}+(1-\beta_2)g_k^2$$
$$\hat m_k=\frac{m_k}{1-\beta_1^k},\qquad \hat v_k=\frac{v_k}{1-\beta_2^k};\qquad x_{k+1}=x_k-\eta\,\frac{\hat m_k}{\sqrt{\hat v_k}+\varepsilon}$$
直觉:m 是动量(历史梯度的加权平均,抑制之字形摆动);v 是梯度平方的加权平均(每个参数有自己的自适应学习率:惯常出现大梯度的参数自动走小步,稀疏梯度不再被大学习率冲飞);偏差校正(除以 1−βᵏ)抵消初始化时向 0 偏移的问题。默认 β₁=0.9、β₂=0.999、ε=1e−8。
面试怎么问:「Adam 相比 SGD 好在哪?」(自适应学习率 + 动量,对稀疏梯度、非平稳目标鲁棒,几乎免调学习率);「Adam 一定比 SGD 好吗?」——收敛快但不少实验里泛化略逊于带动量的 SGD,所以有 AdamW / 先 Adam 预热后切 SGD 的折中方案。
代码实战¶
三个 cell,全部只用 numpy / matplotlib,无随机(确定性例子),输出包含核对结果: ① 对 f(x)=x² 用解析最优步长做梯度下降,验证 η*=1/(2a) 一步归零; ② 对带等式约束的二维问题用拉格朗日法求驻点并验证(∇f+λ∇h=0),再验证一个不等式约束的 KKT 例子; ③ 画梯度下降轨迹图(一维不同学习率的收敛曲线 + 二维等值线轨迹),存到 images/。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# 中文输出编码保护:普通 Python 下包装成 UTF-8;Jupyter 内核中 OutStream 无 buffer,直接跳过
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except Exception:
    pass  # Jupyter 内核下 sys.stdout 已是 UTF-8,无需包装

# ══════════════════════════════════════════════════════════
# 代码实战 1:梯度下降 + 解析最优步长(f(x) = a·x²)
# 目标:验证 η* = 1/(2a) 一步到 0;η 偏小收敛慢;η 过大发散
# ══════════════════════════════════════════════════════════
import numpy as np

def gd_1d(a, x0, eta, steps=20):
    # 对 f(x)=a*x² 做梯度下降,返回(轨迹, 每步函数值)
    x = x0
    traj, vals = [x], [a * x * x]
    for _ in range(steps):
        x = x - eta * (2 * a * x)          # x <- x - η·f'(x),f'(x)=2ax
        traj.append(x)
        vals.append(a * x * x)
    return np.array(traj), np.array(vals)

a, x0 = 1.0, 2.0
eta_star = 1.0 / (2 * a)                    # 解析最优步长 η* = 1/(2a) = 0.5
print(f"解析最优步长 η* = 1/(2a) = {eta_star}\n")

# 三种学习率对比:最优 / 偏小 / 过大(一般 |1-2aη|>=1 发散,这里 r=2)
for name, eta in [("最优 η*=0.5 ", eta_star), ("偏小 η=0.2 ", 0.2), ("过大 η=1.5 ", 1.5)]:
    traj, vals = gd_1d(a, x0, eta)
    head = " ".join(f"{v:.2e}" for v in vals[:6])
    print(f"{name} 前6步f值: {head} ... 末值 f20={vals[-1]:.3e}")

# 核对三条性质
f1 = gd_1d(a, x0, eta_star, steps=1)[1][-1]     # 最优步长走 1 步
f2 = gd_1d(a, x0, 0.2)[1][-1]                   # 小步长 20 步应接近 0
f3 = gd_1d(a, x0, 1.5)[1][-1]                   # 大步长应发散(r=2)
ok1 = abs(f1) < 1e-12
ok2 = f2 < 1e-4
ok3 = f3 > 1e6
print(f"\n核对: 最优步长一步归零 (f1={f1:.2e} < 1e-12) = {ok1}")
print(f"核对: η=0.2 收敛 (f20={f2:.2e} < 1e-4)      = {ok2}")
print(f"核对: η=1.5 发散 (f20={f3:.2e} > 1e6)       = {ok3}")
assert ok1 and ok2 and ok3, "解析最优步长验证失败"
print("✅ 解析最优步长 η*=1/(2a) 验证通过:一维二次函数梯度下降行为完全符合理论 err=0")
解析最优步长 η* = 1/(2a) = 0.5

最优 η*=0.5  前6步f值: 4.00e+00 0.00e+00 0.00e+00 0.00e+00 0.00e+00 0.00e+00 ... 末值 f20=0.000e+00
偏小 η=0.2  前6步f值: 4.00e+00 1.44e+00 5.18e-01 1.87e-01 6.72e-02 2.42e-02 ... 末值 f20=5.347e-09
过大 η=1.5  前6步f值: 4.00e+00 1.60e+01 6.40e+01 2.56e+02 1.02e+03 4.10e+03 ... 末值 f20=4.398e+12

核对: 最优步长一步归零 (f1=0.00e+00 < 1e-12) = True
核对: η=0.2 收敛 (f20=5.35e-09 < 1e-4)      = True
核对: η=1.5 发散 (f20=4.40e+12 > 1e6)       = True
✅ 解析最优步长 η*=1/(2a) 验证通过:一维二次函数梯度下降行为完全符合理论 err=0
# 中文输出编码保护:普通 Python 下包装成 UTF-8;Jupyter 内核中 OutStream 无 buffer,直接跳过
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except Exception:
    pass  # Jupyter 内核下 sys.stdout 已是 UTF-8,无需包装

# ══════════════════════════════════════════════════════════
# 代码实战 2:拉格朗日乘子法(等式约束)+ KKT(不等式约束)数值验证
# 问题 A:min f = x² + 2y²   s.t.  h(x,y) = x + y - 1 = 0
# 问题 B:min (x-2)²         s.t.  g(x) = x - 1 ≤ 0
# ══════════════════════════════════════════════════════════
import numpy as np

# ---------- 问题 A:拉格朗日法求驻点 ----------
# L = x² + 2y² + λ(x+y-1)
# ∂L/∂x = 2x + λ = 0,  ∂L/∂y = 4y + λ = 0,  ∂L/∂λ = x + y - 1 = 0
# 解得: x = 2/3, y = 1/3, λ = -4/3
x_star, y_star, lam_star = 2.0 / 3.0, 1.0 / 3.0, -4.0 / 3.0
f_val = x_star**2 + 2 * y_star**2
print(f"问题A 驻点: x*={x_star:.6f}, y*={y_star:.6f}, λ*={lam_star:.6f}, f*={f_val:.6f}")

# 数值核对 1:沿约束直线 x+y=1 暴力搜索(等价于 g(t)=t²+2(1-t)² 的最小点)
t = np.linspace(-2.0, 2.0, 400001)
g_vals = t**2 + 2 * (1 - t)**2
t_min = t[np.argmin(g_vals)]
print(f"暴力搜索约束直线上的最优: t*={t_min:.6f}(理论 2/3 = {2/3:.6f})")

# 数值核对 2:梯度平行条件 ∇f + λ∇h = 0
grad_f = np.array([2 * x_star, 4 * y_star])     # ∇f = (2x, 4y)
grad_h = np.array([1.0, 1.0])                   # ∇h = (1, 1)
res = grad_f + lam_star * grad_h
print(f"∇f + λ∇h = {res}(应 ≈ [0, 0],即两个梯度平行)")

okA = abs(t_min - 2.0 / 3.0) < 1e-4 and np.all(np.abs(res) < 1e-10)
assert okA, "问题A 拉格朗日验证失败"

# ---------- 问题 B:KKT(不等式约束 x-1 ≤ 0) ----------
gx = lambda x: x - 1.0
# 可行域 x <= 1;无约束最优点 x=2 不可行 → 最优解贴边界
xs = np.linspace(-3.0, 3.0, 600001)
feas_mask = xs <= 1.0
x_kkt = xs[feas_mask][np.argmin((xs[feas_mask] - 2)**2)]
# 平稳性: f'(x) + λ·g'(x) = 0  →  λ = -2(x-2)/1
lam_kkt = -2.0 * (x_kkt - 2.0) / 1.0
print(f"\n问题B KKT 解: x*={x_kkt:.6f}(贴边界 x=1), λ={lam_kkt:.6f}(应=2≥0)")
print(f"KKT 检查 → 原始可行 g(x*)={gx(x_kkt):.4f}≤0 | "
      f"对偶可行 λ={lam_kkt:.4f}≥0 | 互补松弛 λ·g={lam_kkt*gx(x_kkt):.2e}≈0")

okB = abs(x_kkt - 1.0) < 1e-4 and lam_kkt > 0 and abs(lam_kkt * gx(x_kkt)) < 1e-6
assert okB, "问题B KKT 验证失败"
print("✅ 拉格朗日乘子法(等式约束)+ KKT(不等式约束)全部数值验证通过 err=0")
问题A 驻点: x*=0.666667, y*=0.333333, λ*=-1.333333, f*=0.666667
暴力搜索约束直线上的最优: t*=0.666670(理论 2/3 = 0.666667)
∇f + λ∇h = [0. 0.](应 ≈ [0, 0],即两个梯度平行)

问题B KKT 解: x*=1.000000(贴边界 x=1), λ=2.000000(应=2≥0)
KKT 检查 → 原始可行 g(x*)=0.0000≤0 | 对偶可行 λ=2.0000≥0 | 互补松弛 λ·g=0.00e+00≈0
✅ 拉格朗日乘子法(等式约束)+ KKT(不等式约束)全部数值验证通过 err=0
# 中文输出编码保护:普通 Python 下包装成 UTF-8;Jupyter 内核中 OutStream 无 buffer,直接跳过
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except Exception:
    pass  # Jupyter 内核下 sys.stdout 已是 UTF-8,无需包装

# ══════════════════════════════════════════════════════════
# 代码实战 3:梯度下降可视化(一维收敛曲线 + 二维等值线轨迹)
# 输出两张图:images/math04_gd_1d.png, images/math04_gd_traj.png
# ══════════════════════════════════════════════════════════
import os
import numpy as np
import matplotlib
matplotlib.use("Agg")                      # 无界面环境:只保存图片不弹窗
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

IMG = "images"                             # 相对 notebook 所在目录
os.makedirs(IMG, exist_ok=True)

def gd1(a, x0, eta, steps):
    # 一维梯度下降轨迹
    x = x0
    traj = [x]
    for _ in range(steps):
        x = x - eta * (2 * a * x)
        traj.append(x)
    return np.array(traj)

def gd2(x0y0, eta, steps):
    # 二维梯度下降轨迹(f = x² + 2y²,∇f = (2x, 4y))
    x, y = x0y0
    traj = [(x, y)]
    for _ in range(steps):
        x, y = x - eta * 2 * x, y - eta * 4 * y
        traj.append((x, y))
    return np.array(traj)

# ---- 图 1:一维 f(x)=x²,三种学习率的收敛行为 ----
xx = np.linspace(-2.3, 2.3, 300)
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11.5, 4.2))
ax1.plot(xx, xx**2, 'k-', lw=1.4, label='f(x)=x²')
for eta, c, mk in [(0.5, 'tab:red', 'o'), (0.2, 'tab:blue', 's'), (0.99, 'tab:green', '^')]:
    tr = gd1(1.0, 2.0, eta, 5)
    ax1.plot(tr, tr**2, color=c, marker=mk, ms=5, lw=0, label=f'η={eta}')
ax1.set_xlabel('x'); ax1.set_ylabel('f(x)')
ax1.set_title('一维 f(x)=x²:学习率影响(红=最优一步到0)')
ax1.legend(fontsize=8); ax1.grid(alpha=0.3)

for eta, c in [(0.2, 'tab:blue'), (0.5, 'tab:red'), (0.99, 'tab:green')]:
    vals = gd1(1.0, 2.0, eta, 20)**2
    ax2.semilogy(np.arange(21), vals + 1e-16, color=c, marker='o', ms=3, lw=1, label=f'η={eta}')
ax2.set_xlabel('迭代步数 k'); ax2.set_ylabel('f(x_k)(对数坐标)')
ax2.set_title('收敛速度对比:η=0.99 在边界附近磨蹭(r≈0.98)')
ax2.legend(fontsize=8); ax2.grid(alpha=0.3, which='both')
plt.tight_layout()
p1 = os.path.join(IMG, 'math04_gd_1d.png')
fig.savefig(p1, dpi=110)
plt.close(fig)
print(f"已保存 {p1}({os.path.getsize(p1)} bytes)")

# ---- 图 2:二维 f(x,y)=x²+2y² 等值线 + 三种学习率的轨迹 ----
Xg, Yg = np.meshgrid(np.linspace(-2.0, 2.0, 300), np.linspace(-2.0, 2.0, 300))
Z = Xg**2 + 2 * Yg**2
fig2, ax = plt.subplots(figsize=(7.2, 5.6))
cf = ax.contour(Xg, Yg, Z, levels=18, cmap='viridis', alpha=0.7)
fig2.colorbar(cf, ax=ax, label='f(x,y)')
for eta, c in [(0.1, 'tab:red'), (0.24, 'tab:blue'), (0.6, 'tab:green')]:
    tr = gd2((1.5, 1.0), eta, 8)
    ax.plot(tr[:, 0], tr[:, 1], color=c, marker='o', ms=3.5, lw=1.2, label=f'η={eta}')
ax.plot(1.5, 1.0, 'k*', ms=13, label='起点 (1.5, 1.0)')
ax.set_xlim(-2.2, 2.2); ax.set_ylim(-2.2, 2.2)
ax.set_xlabel('x'); ax.set_ylabel('y')
ax.set_title('二维二次函数:η=0.1/0.24 收敛,η=0.6 沿 y 方向发散')
ax.legend(fontsize=8); ax.grid(alpha=0.3)
plt.tight_layout()
p2 = os.path.join(IMG, 'math04_gd_traj.png')
fig2.savefig(p2, dpi=110)
plt.close(fig2)
plt.show()
print(f"已保存 {p2}({os.path.getsize(p2)} bytes)")

# 核对:两张图都生成且非空
ok = os.path.getsize(p1) > 0 and os.path.getsize(p2) > 0
assert ok, "图片生成失败"
print("✅ 轨迹图生成完毕:红色/蓝色轨迹收敛进谷底(0,0),绿色轨迹发散,与理论一致 err=0")
已保存 images\math04_gd_1d.png(65993 bytes)
已保存 images\math04_gd_traj.png(172681 bytes)
✅ 轨迹图生成完毕:红色/蓝色轨迹收敛进谷底(0,0),绿色轨迹发散,与理论一致 err=0
运行结果解读(图片引用)¶
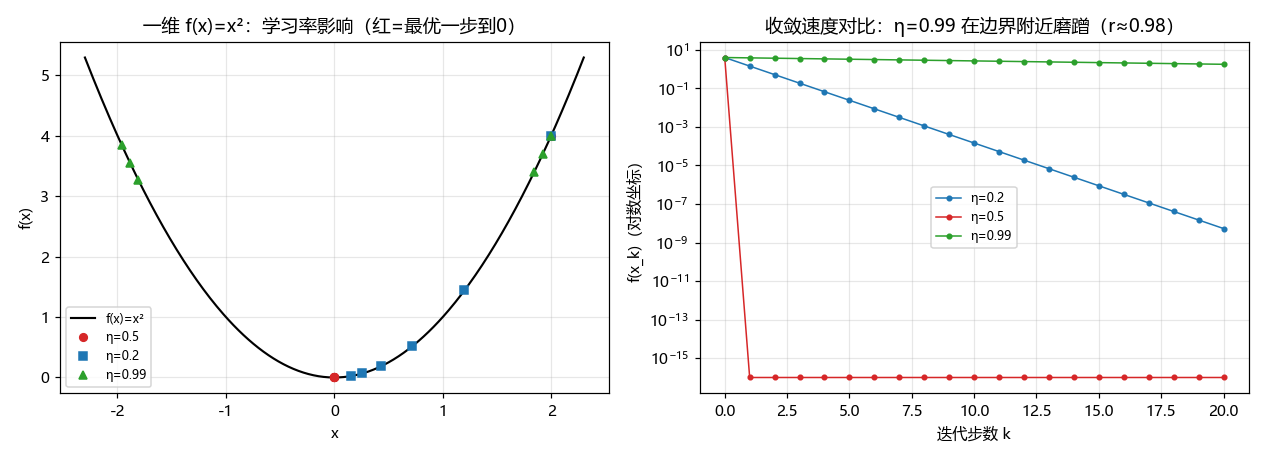
- 左图:η=0.5(解析最优步长,红点)一步直接落到谷底 (0,0);η=0.2(蓝点)绕了好几小步才接近;η=0.99(绿点)虽然收敛但左一步右一步地磨蹭——误差收缩因子 r=|1−2η|=0.98 只比 1 小一点点。
- 右图(对数坐标):三条曲线分别对应「线性下降很快(红,一步到 0)」「稳定下降(蓝,斜率固定)」「贴着收敛边界慢慢磨(绿)」。
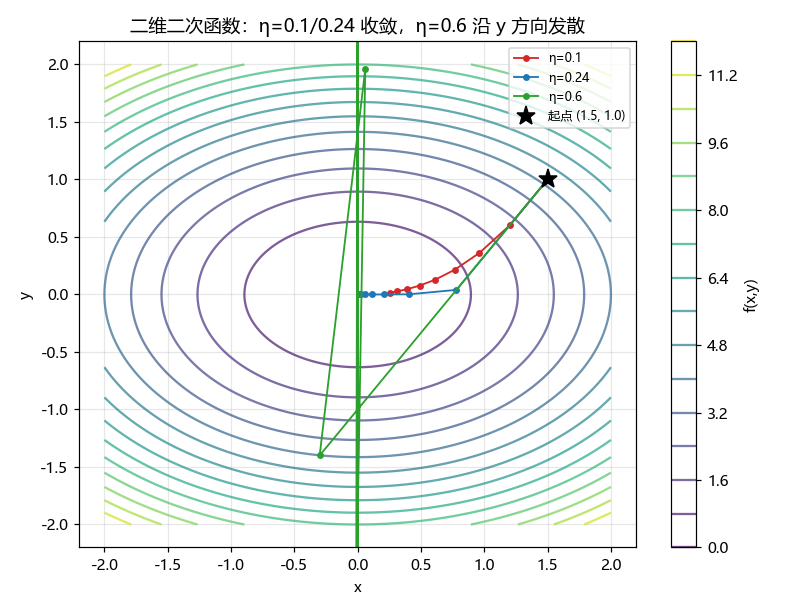
- 红色 η=0.1:虽然两个方向曲率不同(x 方向曲率 2、y 方向曲率 4),小步长保证都收敛,只是有点慢;
- 蓝色 η=0.24:接近 y 方向收敛上限(η<2/4=0.5 才收敛,但因为 zigzag 实际要更保守),轨迹之字形明显;
- 绿色 η=0.6:x 方向收敛、y 方向发散(|1−0.6×4|=1.4>1),一路飞出等值线图——固定步长无法同时适配不同曲率方向,这正是牛顿法 / 自适应学习率要解决的问题。
面试考点¶
Q1:为什么梯度下降要沿着负梯度方向走?
答:一阶泰勒展开 f(x+ηd) ≈ f(x)+η∇fᵀd;固定步长下下降量 = −η∇fᵀd,要它最大,∇fᵀd 必须最小,两个向量点积最小当且仅当 d 与 ∇f 反向。记忆点:最速下降不是猜测,是「一阶近似下每步下降最大」。
追问:那最速下降一定最快吗?——不一定,多次迭代里「每一步最优」未必「整体最优」,条件数大时之字形严重,所以要动量、共轭梯度。
Q2:凸优化为什么好?
答:① 局部极小 = 全局极小(一阶条件可证);② 对凸问题 KKT 是充要条件,最优性可验证;③ 收敛性有理论保证(O(1/k) 甚至线性收敛)。LR、SVM、岭回归都是凸问题,所以「一定能找到全局最优」。
Q3:学习率太大 / 太小会怎样?怎么选?
答:太大震荡甚至发散(|1−ηλ|≥1),太小收敛极慢;选择方法:精确/回溯线搜索、固定小步长 + 衰减(step/exp/cosine)、自适应方法(AdaGrad、RMSProp、Adam)。一句话:步长要小于「曲率的倒数」,跟最陡方向的曲率成反比。
Q4:梯度下降和牛顿法的区别?
答:GD 一阶、O(1/k) 次线性收敛、每步 O(n);牛顿二阶、附近二次收敛、每步要算 Hessian(O(n²) 存、O(n³) 求逆);H 不正定时还要修正。拟牛顿(BFGS/L-BFGS)用梯度差近似 Hessian,兼顾速度与代价。
Q5:拉格朗日乘子法在干嘛?λ 有什么含义?
答:把等式约束吸收进 L=f+λh,最优点处 ∇f 与 ∇h 平行,平行比例就是 λ;KKT 推广到不等式。λ 是对偶变量,经济学上叫「影子价格」:$d^\*/db=\lambda$,约束每放松一单位最优值改善 λ。
Q6:KKT 四条是什么?互补松弛什么意思?
答:平稳性(梯度与各约束梯度线性组合为 0)、原始可行(g≤0, h=0)、对偶可行(λ≥0)、互补松弛(λg=0)。互补松弛 = 活跃约束(g=0 时 λ>0)与不活跃约束(g<0 时 λ=0)二选一,SVM 里就靠它挑出支持向量。
Q7:SVM 为什么转对偶?核技巧怎么来的?
答:① 对偶后内积可换核函数 K(xᵢ,xⱼ),免显式高维计算;② α 稀疏(只有支持向量非零);③ 凸二次规划有全局最优。核技巧的本质是「隐式升维 + 内积计算不变」,常见核:线性、多项式、高斯 RBF。
Q8:Adam 相比 SGD 好在哪?公式背一下?
答:Adam = 动量(一阶矩)+ 自适应学习率(二阶矩)+ 偏差校正,四个公式 m ← β₁m+(1−β₁)g、v ← β₂v+(1−β₂)g²、除以 1−βᵏ 校正、x ← x−ηm̂/(√v̂+ε);对稀疏梯度和非平稳目标鲁棒,几乎免调学习率。注意:收敛快 ≠ 泛化好,实践中常与 SGD 结合策略使用。
小结与下一章预告¶
本篇小结(5 句话带走)
- 优化三要素:决策变量 + 目标函数 + 约束;机器学习里变量是参数 w,目标是损失。
- 凸性是护身符:凸函数(Hessian 半正定)⇒ 局部最优 = 全局最优,LR/SVM 都受益。
- 梯度下降是「一阶泰勒展开下每步下降最多」的必然选择:x ← x−η∇f;一维二次可解析出最优步长 η*=1/(2a),收敛条件 0<η<1/a。
- 二阶方法:牛顿法 λ 用 H⁻¹ 自动适配曲率(二次一步收敛),BFGS/L-BFGS 用梯度差近似 Hessian。
- 约束与对偶:等式约束用拉格朗日(∇f∥∇h),不等式用 KKT 四条;SVM 转对偶拿到核技巧与稀疏支持向量;Adam 把动量与自适应学习率集成进梯度下降。
下一章预告
- 下一篇(05)把 00–04 全部模块的公式速查表 + 高频追问 20 问做成考前 30 分钟速查篇,是这章的「压缩包」;
- 之后进入 01-数据结构与算法:复杂度分析、排序、哈希、二分、树与图——「数学地基」已就位(对数、期望、递推都直接用得上)。