⏱️ 03 · Flink 与实时计算:窗口 / Watermark / 状态¶
实时计算岗位必考 Flink。本节手写核心概念:事件时间、水位线(Watermark)、 滚动/滑动窗口、迟到数据处理,用 numpy 模拟流式处理(无 Flink 依赖)。
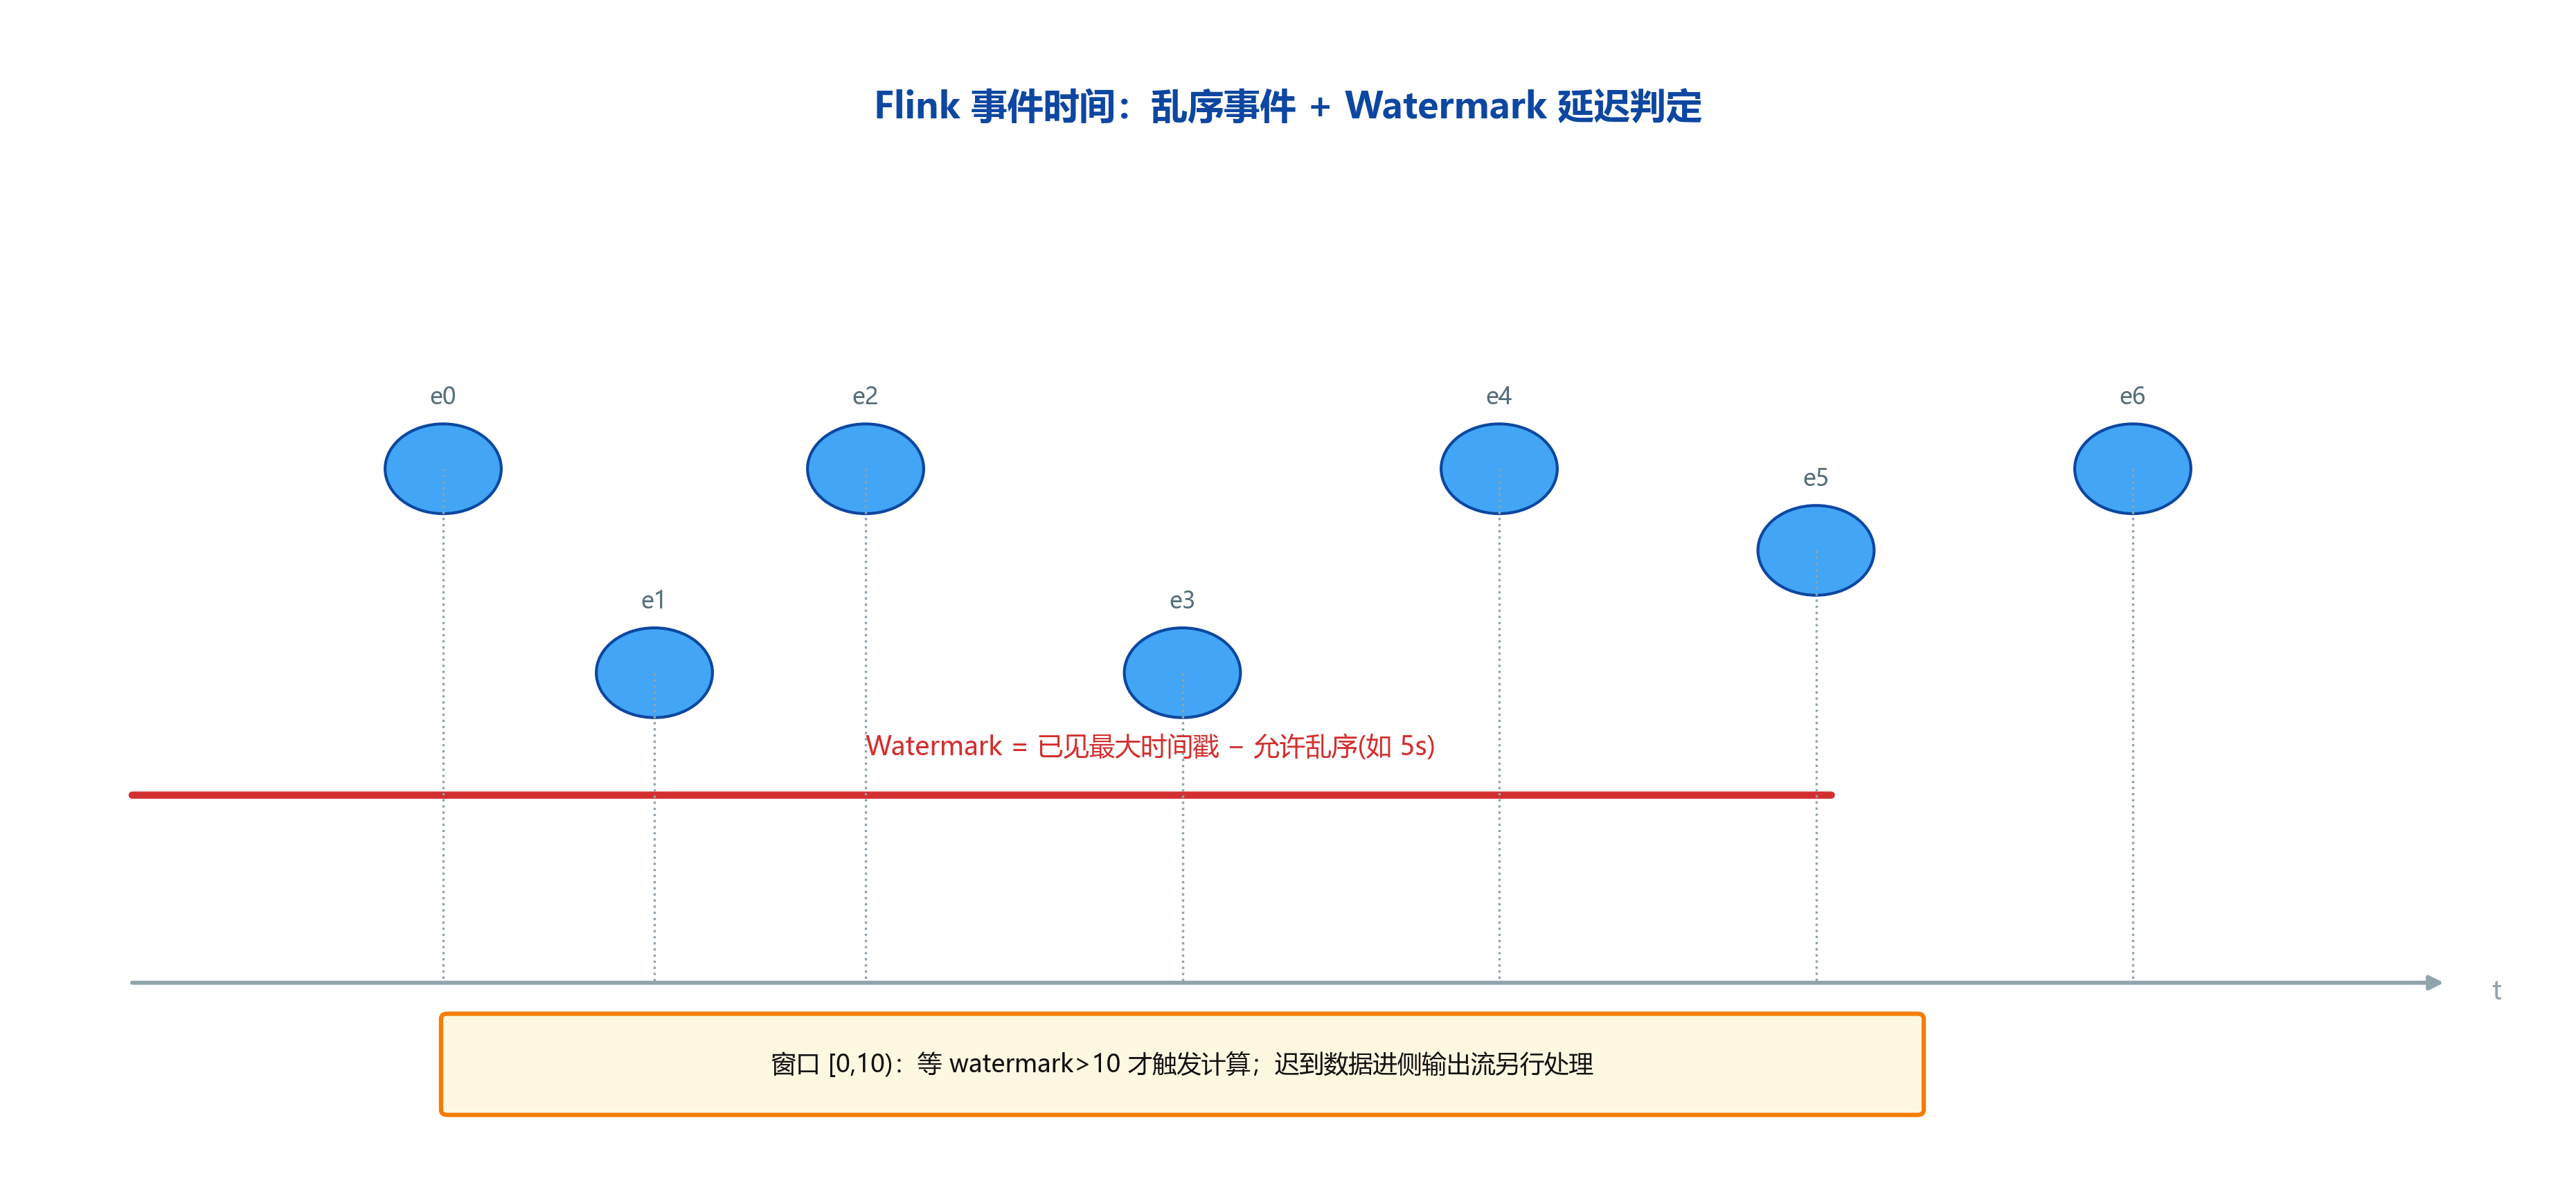
🔍 图解(自绘高清图,300dpi,可放大):实时流处理最难的"乱序 + 迟到"问题,Watermark 是解法——
- 事件时间轴(横轴):每个事件带自己的发生时间戳,而不是到达处理的时间—— 但网络/队列会导致事件乱序到达(先到的事件时间戳可能更晚);
- Watermark(红色阶梯线):水位线 = 当前已到事件中保证不会再来的时间点—— 假设 watermark = T,表示"事件时间 ≤ T 的数据都已经到齐了";
- 窗口如何触发:滚动/滑动窗口在 watermark 越过窗口结束时间时才计算—— 图中 t=3 的窗口在 watermark 到达 3.5 时才触发,把先来的 t=2.8 事件正确算进窗口;
- 迟到处理:watermark 之后才到的"迟到事件",用允许迟到(allowed lateness)+ 侧输出 双保险——窗口还能再等一会儿,真正太晚的进旁路流单独处理;
- 参数权衡:watermark 推进慢 → 窗口延迟出结果(低吞吐);推进快 → 丢更多迟到数据—— 实际生产中靠 watermark 延迟(如 max 乱序 5s)+ 迟到容忍窗口平衡。
论文出处:Apache Flink 官方文档与 Carbone et al., "Apache Flink: Stream and Batch Processing in a Single Engine", IEEE Data Engineering Bulletin 2015——事件时间与 Watermark 机制。
🎬 背景故事¶
离线算完已经是昨天——可风控要的是秒级响应……
离线计算再快,跑完也已经是昨天;但风控要拦截一笔可疑交易、推荐要实时捕捉用户兴趣,要的是秒级响应。这就轮到流式计算出场。本节讲 Flink 的三大灵魂:事件时间、Watermark、窗口,并用代码演示乱序数据下怎么保证计算正确。
🧭 本节逻辑主线:离线 vs 实时的本质差异 → 事件时间 vs 处理时间 → 乱序怎么办(Watermark)→ 滚动/滑动窗口手写 → 迟到数据三策略。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 批与流区别? | 有界 vs 无界数据 |
| 2 | 事件时间 vs 处理时间? | 乱序怎么处理 |
| 3 | 水位线(watermark)? | 允许延迟的边界 |
| 4 | 窗口类型? | 滚动/滑动/会话 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import sqlite3
import os
rng = np.random.default_rng(42)
1️⃣ 批处理 vs 流处理(必背)¶
print('''批处理(离线):数据有界、一次性处理、延迟高(小时级)、准确;
流处理(实时):数据无界、持续到达、延迟低(秒级)、对乱序敏感;
Lambda 架构:批+流两套并行再合并(历史准确+实时快但对账难);
Kappa 架构:只用流处理(重放历史=批),Flink 主流。
''')
批处理(离线):数据有界、一次性处理、延迟高(小时级)、准确;
流处理(实时):数据无界、持续到达、延迟低(秒级)、对乱序敏感;
Lambda 架构:批+流两套并行再合并(历史准确+实时快但对账难);
Kappa 架构:只用流处理(重放历史=批),Flink 主流。
2️⃣ 三种时间与乱序问题¶
# 事件时间(事件发生时刻)vs 处理时间(数据到达处理系统时刻)
events = [
    ('A', '2024-01-01 10:00:01'),
    ('B', '2024-01-01 10:00:02'),
    ('D', '2024-01-01 10:00:04'),
    ('C', '2024-01-01 10:00:03'),   # 乱序:C 在 D 之后才到
]
print('到达顺序:', [e[0] for e in events])
print('事件时间顺序:', sorted(events, key=lambda e: e[1]))
print('''
  如果按"处理时间"聚合,会得到错误顺序(C 与 D 顺序反了);
  所以流计算默认用"事件时间 + 水位线"处理乱序。
''')
到达顺序: ['A', 'B', 'D', 'C']
事件时间顺序: [('A', '2024-01-01 10:00:01'), ('B', '2024-01-01 10:00:02'), ('C', '2024-01-01 10:00:03'), ('D', '2024-01-01 10:00:04')]

  如果按"处理时间"聚合,会得到错误顺序(C 与 D 顺序反了);
  所以流计算默认用"事件时间 + 水位线"处理乱序。
3️⃣ 滚动窗口(Tumbling Window)手写¶
✍️ §3.1 手算滚动窗口归属:6 个事件时间戳怎么分窗¶
滚动窗口:$\text{窗口} = \lfloor t/\text{size}\rfloor\times\text{size}$——窗口长 5 手算 6 个事件,把归属规则变成数字。
设定:事件时间戳 [1, 3, 8, 11, 14, 20],窗口大小 5(左闭右开)。
$$1,3\in[0,5);\qquad 8\in[5,10);\qquad 11,14\in[10,15);\qquad 20\in[20,25)$$
| 事件时间 | 所属窗口 | 计数 |
|---|---|---|
| 1, 3 | [0, 5) | 2 |
| 8 | [5, 10) | 1 |
| 11, 14 | [10, 15) | 2 |
| 20 | [20, 25) | 1 |
手算收获:
- 滚动窗口划分只依赖事件时间,与数据到达顺序无关——这就是"事件时间"的意义(§2)
- $\lfloor t/\text{size}\rfloor$ 是整数除法:每条数据恰好属于一个窗口(不重叠、不留缝)
- 乱序(§5 Watermark):事件 9 在事件 7 之后才到,只要 watermark 未越过 [5,10) 边界就能补进窗口——所以 watermark = "最晚能等的边界"
- 对比滑动窗口(§4):滑动窗口有步长,一条数据可属多个窗口(本 notebook §4 手写代码)
下面 numpy 复算。
# ---- §3.1 验证:numpy 复算滚动窗口归属 ----
events = [1, 3, 8, 11, 14, 20]
win = 5
belong = {}
for t in events:
    belong.setdefault(t // win * win, []).append(t)
print({w: v for w, v in belong.items()})
cnt = {w: len(v) for w, v in belong.items()}
print(f'各窗口计数 = {cnt}')
assert belong[0] == [1, 3] and belong[5] == [8] and belong[10] == [11, 14] and belong[20] == [20]
print('\n✓ 与手算一致')
# 滚动窗口:固定长度、不重叠、每条数据只属于一个窗口
def tumbling_window(events_with_ts, win_len):
    # events_with_ts: [(id, ts_seconds)]
    buckets = {}
    for eid, ts in events_with_ts:
        w = (ts // win_len) * win_len          # 窗口起点
        buckets.setdefault(w, []).append((eid, ts))
    return [sorted(v) for k, v in sorted(buckets.items())]

stream = [('a', 3), ('b', 5), ('c', 8), ('d', 12), ('e', 17)]
wins = tumbling_window(stream, 10)
for w in wins:
    print(f'窗口 [{w[0][1]}s, {w[0][1]+10}s): {[e[0] for e in w]}')
assert sum(len(w) for w in wins) == len(stream), '滚动窗口每条数据只属于一个窗口'
print('✅ 滚动窗口:每条数据属于唯一窗口')
窗口 [3s, 13s): ['a', 'b', 'c']
窗口 [12s, 22s): ['d', 'e']
✅ 滚动窗口:每条数据属于唯一窗口
4️⃣ 滑动窗口(Sliding Window)手写¶
# 滑动窗口:长度+滑动步长,数据可属于多个窗口
def sliding_window(events_with_ts, win_len, slide):
    buckets = {}
    for eid, ts in events_with_ts:
        start = 0
        while start <= ts:                       # 窗口起点不能晚于事件时间
            if start <= ts < start + win_len:    # 事件落在窗口内
                buckets.setdefault(start, []).append((eid, ts))
            start += slide
    return buckets

stream2 = [('a', 2), ('b', 5), ('c', 7), ('d', 11)]
buckets = sliding_window(stream2, 6, 3)
for start in sorted(buckets):
    print(f'窗口 [{start},{start+6}): {[e[0] for e in buckets[start]]}')
assert sum(len(v) for v in buckets.values()) >= len(stream2), '滑动窗口数据可属于多个窗口'
print('✅ 滑动窗口:同一数据属于多个窗口(重叠)')
窗口 [0,6): ['a', 'b']
窗口 [3,9): ['b', 'c']
窗口 [6,12): ['c', 'd']
窗口 [9,15): ['d']
✅ 滑动窗口:同一数据属于多个窗口(重叠)
📐 公式推导:窗口归属与 Watermark¶
滚动窗口归属(事件时间戳 $ts$、窗口长度 $L$):窗口起点是 $ts$ 向下取整到 $L$ 的倍数:
$$ w_{start} = \left\lfloor \frac{ts}{L} \right\rfloor \times L, \qquad ts \in [w_{start},\; w_{start}+L) $$
滑动窗口(窗口长 $L$、滑动步长 $S$):同一事件落在多个窗口,$ts$ 属于所有满足下式的窗口:
$$ \forall\, w_{start}=mS\;(m\in\mathbb{Z}): \quad w_{start} \le ts < w_{start}+L $$
Watermark = 乱序安全线($\tau_{\max}$ 为已见最大事件时间、$\delta$ 为允许迟到时长):
$$ \mathrm{WM} = \tau_{\max} - \delta $$
推导要点:① 窗口关闭条件:事件时间 $< \mathrm{WM}$ 的事件视为"不会再来了",窗口可触发计算并关闭——这是代码 wm = max(wm, ts - allow_late) 的含义;② 迟到事件($ts < \mathrm{WM}$)进侧输出/延迟重算;③ $\delta$ 的取舍:太大 → 吞吐延迟高;太小 → 丢数据,工业上按业务 P99 延迟估算。
5️⃣ Watermark:允许乱序的边界¶
# 🖼️ 配图:乱序事件流 + Watermark——何时"安全"关窗
fig, ax = plt.subplots(figsize=(8, 3.6))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4)
ax.annotate('', xy=(9.6, 1.0), xytext=(0.3, 1.0), arrowprops=dict(arrowstyle='-|>', color='#334155', lw=1.5))
ax.text(9.7, 1.05, '事件时间 t →', fontsize=9, color='#334155')
# 事件点(带乱序:时间戳 1..9,3 号迟到)
events = {1: 1.0, 5: 2.0, 3: 3.5, 7: 4.0, 6: 5.5, 8: 6.2, 9: 7.8}
for t, x in events.items():
    ax.plot(x, 1.0, 'o', color='#2563eb', ms=9)
    ax.text(x, 1.35, f't={t}', fontsize=8.5, ha='center', color='#1e40af')
ax.text(3.5, 1.85, 't=3 迟到(在 t=5/6 之后才到)', fontsize=9, color='#dc2626')
# Watermark 线
ax.plot([4.8, 4.8], [0.3, 1.8], '--', color='#16a34a', lw=2)
ax.text(4.95, 1.7, 'Watermark = 已见最大ts − δ', fontsize=9, color='#16a34a')
# 关窗时刻
ax.plot([6.4, 6.4], [0.3, 1.8], '--', color='#9333ea', lw=2)
ax.text(6.55, 1.7, '窗口触发/关闭', fontsize=9, color='#7e22ce')
ax.text(4.6, 0.3, 'δ 以内:等迟到事件;δ 以外:进侧输出', fontsize=8.5, ha='center', color='#475569')
plt.title('Watermark:容忍乱序的“安全线”——过了线窗口才关闭', fontsize=11)
plt.show()
print('➡️ Watermark 决定"等多久":δ 大=更准但更慢,δ 小=更快但丢尾部乱序')
➡️ Watermark 决定"等多久":δ 大=更准但更慢,δ 小=更快但丢尾部乱序
C:\Users\24260\AppData\Local\Temp\ipykernel_30108\3015385840.py:20: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# Watermark = 当前"已安全"的事件时间下限
# 含义:watermark = max(已见事件时间) - 允许乱序延迟
def watermark_update(seen_max_ts, max_lateness):
    return seen_max_ts - max_lateness

events_ts = [10, 12, 11, 15, 14, 20, 19]   # 乱序到达
allow_late = 3
wm = 0
print('到达时间 | 当前 watermark')
for ts in events_ts:
    wm = max(wm, watermark_update(ts, allow_late))
    print(f'  {ts:>4}    | {wm:>4}(=最新事件时间-{allow_late},窗口关闭判断依据)')
print('''
  判断:事件时间 >= watermark 的事件才允许进入窗口计算;
  小于 watermark 的事件视为迟到 -> 侧输出/丢弃/重算。
''')
到达时间 | 当前 watermark
    10    |    7(=最新事件时间-3,窗口关闭判断依据)
    12    |    9(=最新事件时间-3,窗口关闭判断依据)
    11    |    9(=最新事件时间-3,窗口关闭判断依据)
    15    |   12(=最新事件时间-3,窗口关闭判断依据)
    14    |   12(=最新事件时间-3,窗口关闭判断依据)
    20    |   17(=最新事件时间-3,窗口关闭判断依据)
    19    |   17(=最新事件时间-3,窗口关闭判断依据)

  判断:事件时间 >= watermark 的事件才允许进入窗口计算;
  小于 watermark 的事件视为迟到 -> 侧输出/丢弃/重算。
6️⃣ 迟到数据处理策略(面试速答)¶
print('''1) 允许迟到(allowedLateness):窗口关闭后再等一段时间;
2) 侧输出流(sideOutput):迟到数据单独输出,离线补偿;
3) 直接丢弃:最简粗暴,准确性差;
4) 水印合并(多并行度):取最小 watermark(最保守);
5) 面试要点:watermark 决定"窗口何时关",allowedLateness 决定"关了还能不能补"。
''')
1) 允许迟到(allowedLateness):窗口关闭后再等一段时间;
2) 侧输出流(sideOutput):迟到数据单独输出,离线补偿;
3) 直接丢弃:最简粗暴,准确性差;
4) 水印合并(多并行度):取最小 watermark(最保守);
5) 面试要点:watermark 决定"窗口何时关",allowedLateness 决定"关了还能不能补"。
7️⃣ Flink 与 Spark Streaming 对比¶
print('''| 维度 | Flink | Spark Streaming |
|---|---|---|
| 模型 | 真正的流(每条处理) | 微批次(秒级攒批) |
| 延迟 | 毫秒-秒 | 秒级(批延迟) |
| 状态 | 原生状态管理(checkpoint) | 有状态但较粗 |
| 精确一次 | Exactly-once(两阶段提交) | 有(2.0+ 结构化流) |
| 适用 | 实时风控/实时大屏 | 近实时批处理 |

结论:新增实时项目普遍选 Flink;Spark 流适合"批+流一体"需求。
''')
| 维度 | Flink | Spark Streaming |
|---|---|---|
| 模型 | 真正的流(每条处理) | 微批次(秒级攒批) |
| 延迟 | 毫秒-秒 | 秒级(批延迟) |
| 状态 | 原生状态管理(checkpoint) | 有状态但较粗 |
| 精确一次 | Exactly-once(两阶段提交) | 有(2.0+ 结构化流) |
| 适用 | 实时风控/实时大屏 | 近实时批处理 |

结论:新增实时项目普遍选 Flink;Spark 流适合"批+流一体"需求。
📝 自测清单¶
- 能对比批/流、Lambda/Kappa
- 能解释事件时间 vs 处理时间与乱序
- 能手写滚动/滑动窗口
- 能解释 watermark 的作用与计算
- 能说出迟到数据三种处理策略