🧮 02 · 矩阵分解与隐语义模型¶
协同过滤的进阶:把 user-item 评分矩阵分解成用户隐向量 × 物品隐向量,用隐向量点积预测评分。 本节手写 Funk-SVD(SGD 矩阵分解) 并对比 SVD 截断,最后可视化 embedding 语义。
🎬 背景故事¶
协同过滤有个致命伤:数据稀疏……
协同过滤有个致命伤:当用户和物品都很多、但每个用户只看了寥寥几部片子时,相似度矩阵几乎全是空的。这时我们换个思路——不直接算相似度,而是问:能不能把"喜欢"拆成几个隐藏因子?比如动作片、爱情片、文艺片……每个用户对各因子的偏好、每部片子在各因子上的得分,相乘就能预测喜欢程度。这就是隐语义模型(LFM),而矩阵分解是它的数学外壳。
🧭 本节逻辑主线:相似度在稀疏数据下失效 → 引入"隐因子"假设 → 用矩阵分解(Funk-SVD)把评分矩阵拆成 用户×因子 · 因子×物品 → 用 SGD 求解 → 与截断 SVD 对照。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 隐语义模型的思想? | 矩阵分解 = 发现潜在因子 |
| 2 | 怎么求解? | SGD / 交替最小二乘 ALS |
| 3 | 和 SVD 有什么关系? | 截断 SVD 是闭式解 |
| 4 | 隐向量有什么意义? | embedding 可视化 |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 构造数据(含隐性反馈的评分)¶
📌 真实配图:矩阵分解示意(Wikimedia Commons)
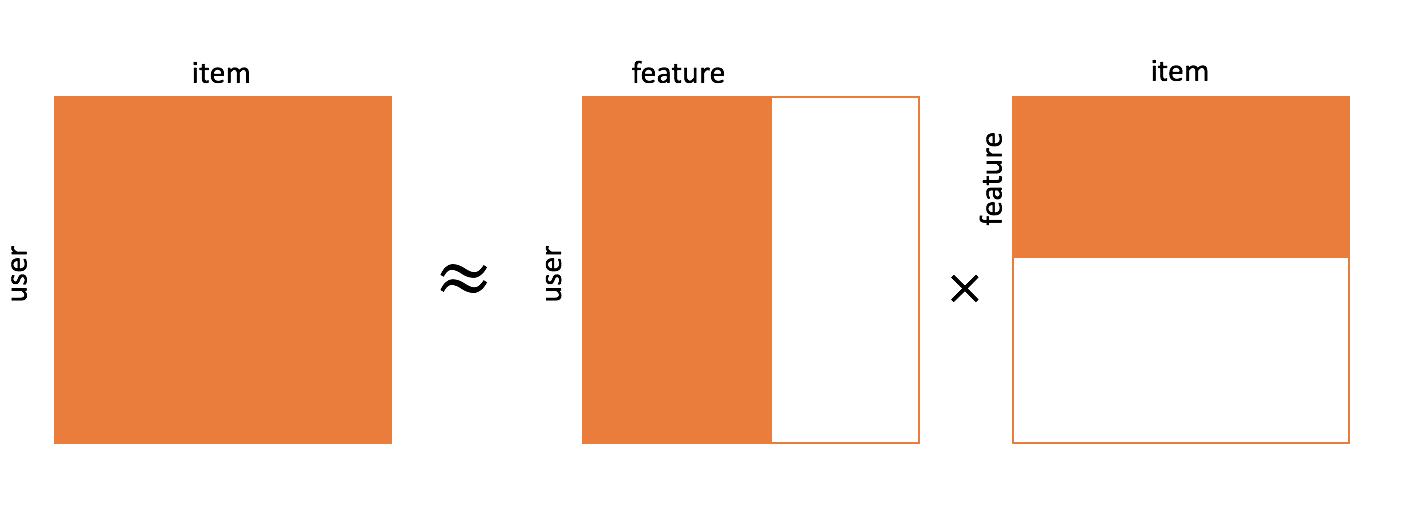
矩阵分解的核心就是把稀疏的用户-物品评分矩阵 R 拆成两个低秩矩阵的乘积: 用户隐含因子矩阵 P × 物品隐含因子矩阵 Q(R ≈ P·Qᵀ)。图中左上是原始矩阵, 右下是分解后重建的稠密矩阵——空白评分被"猜"了出来。 这正是 Funk-SVD 的几何直觉:把"喜欢"拆成几个隐藏因子再相乘。 图片来源:Wikimedia Commons,CC BY-SA 4.0。
n_u, n_i = 40, 30
true_u = rng.normal(0, 1, (n_u, 4))
true_v = rng.normal(0, 1, (n_i, 4))
R = 3.0 + true_u @ true_v.T + rng.normal(0, 0.3, (n_u, n_i))  # 评分尺度 1~5 左右
# 随机遮盖 30% 作为缺失
mask = rng.uniform(0, 1, R.shape) > 0.3
R = np.where(mask, R, 0.0)
print('评分矩阵形状:', R.shape, '| 观测比例:', (R > 0).mean().round(3))
assert 0.6 < (R > 0).mean() < 0.8
print('✅ 数据就绪(含缺失)')
评分矩阵形状: (40, 30) | 观测比例: 0.67
✅ 数据就绪(含缺失)
📐 公式推导:Funk-SVD 目标函数与 SGD 梯度¶
目标:用低秩分解 $R \approx \mu + b_u + b_i + U V^\top$ 拟合已观测评分,加 L2 正则防过拟合:
$$ \min_{U, V, b_u, b_i} \; \sum_{(u,i) \in \Omega} \big( r_{ui} - \mu - b_u - b_i - \mathbf{u}_u^\top \mathbf{v}_i \big)^2 + \lambda \big( \|U\|_F^2 + \|V\|_F^2 + \|b_u\|^2 + \|b_i\|^2 \big) $$
推导 → SGD 更新:对单个样本定义残差 $e_{ui} = r_{ui} - \hat{r}_{ui}$,对目标求偏导(链式法则:平方项求导出 $2e$,并入学习率):
$$ \frac{\partial L}{\partial \mathbf{u}_u} = -e_{ui} \mathbf{v}_i + \lambda \mathbf{u}_u, \quad \frac{\partial L}{\partial \mathbf{v}_i} = -e_{ui} \mathbf{u}_u + \lambda \mathbf{v}_i, \quad \frac{\partial L}{\partial b_u} = -e_{ui} + \lambda b_u, \quad \frac{\partial L}{\partial b_i} = -e_{ui} + \lambda b_i $$
梯度下降更新式($\eta$ 为学习率):
$$ \mathbf{u}_u \leftarrow \mathbf{u}_u + \eta \big( e_{ui}\mathbf{v}_i - \lambda \mathbf{u}_u \big), \qquad \mathbf{v}_i \leftarrow \mathbf{v}_i + \eta \big( e_{ui}\mathbf{u}_u - \lambda \mathbf{v}_i \big) $$
推导要点:① 只对 $\Omega$(观测集)求和——缺失值不参与,抗稀疏;② 隐因子维数 $k$ 远小于 min(用户数,物品数),起到压缩与泛化作用;③ 正则项来自"分解参数无约束会过拟合"的贝叶斯先验(参数 ~ N(0, 1/λ))。
2️⃣ Funk-SVD:手写 SGD 分解¶
✍️ §2.1 手算 Funk-SVD:4 个预测、MSE 与一步 SGD 更新¶
把"低秩分解 + 只拟合已观测评分"落到 2 用户 × 3 物品的最小例子上,手算一次完整前向 + 一步回传更新,直接对接 §2 的 SGD 公式。
设定:观测矩阵 $R$(0 = 缺失,不参与训练)、隐因子 $k=2$、初始因子 $P,Q$、学习率 $\eta=0.02$(先忽略正则与偏差,聚焦因子更新):
$$R=\begin{bmatrix}5&3&0\\4&0&1\end{bmatrix},\qquad P=\begin{bmatrix}0.5&1.0\\1.0&0.5\end{bmatrix},\qquad Q=\begin{bmatrix}0.8&0.6\\0.9&0.7\\1.0&0.4\end{bmatrix}$$
第 1 步:4 个观测项的预测与误差($\hat r_{ui}=\mathbf{p}_u^{\top}\mathbf{q}_i$)
| (u,i) | $r_{ui}$ | $\hat r_{ui}$ | $e_{ui}=r_{ui}-\hat r_{ui}$ |
|---|---|---|---|
| (0,0) | 5 | $0.5\times0.8+1.0\times0.6=1.0$ | $4.0$ |
| (0,1) | 3 | $0.5\times0.9+1.0\times0.7=1.15$ | $1.85$ |
| (1,0) | 4 | $1.0\times0.8+0.5\times0.6=1.1$ | $2.9$ |
| (1,2) | 1 | $1.0\times1.0+0.5\times0.4=1.2$ | $-0.2$ |
$$\text{MSE}=\frac{4.0^2+1.85^2+2.9^2+(-0.2)^2}{4}=\frac{16+3.4225+8.41+0.04}{4}=\frac{27.8725}{4}=6.9681,\qquad \text{RMSE}=\sqrt{6.9681}=2.6397$$
第 2 步:一步 SGD(同步更新:$\mathbf{p}_u\leftarrow\mathbf{p}_u+\eta\,e\,\mathbf{q}_i$,$\mathbf{q}_i\leftarrow\mathbf{q}_i+\eta\,e\,\mathbf{p}_u$)
先看误差最大的 (0,0)($e=4.0$):
$$\mathbf{p}_0=[0.5,\ 1.0]+0.02\times4.0\times[0.8,\ 0.6]=[0.5+0.064,\ 1.0+0.048]=[0.564,\ 1.048]$$ $$\mathbf{q}_0=[0.8,\ 0.6]+0.02\times4.0\times[0.5,\ 1.0]=[0.8+0.04,\ 0.6+0.08]=[0.84,\ 0.68]$$
重新预测:$\hat r'_{00}=0.564\times0.84+1.048\times0.68=0.4738+0.7126=1.1864$,误差从 4.0 降到 3.8136。
再看误差为负的 (1,2)($e=-0.2$,预测偏高要往下修):
$$\mathbf{p}_1=[1.0,\ 0.5]+0.02\times(-0.2)\times[1.0,\ 0.4]=[0.996,\ 0.4984],\qquad \mathbf{q}_2=[1.0,\ 0.4]+0.02\times(-0.2)\times[1.0,\ 0.5]=[0.996,\ 0.398]$$
手算收获:
- 只算观测点:矩阵里的 0(缺失)不进 MSE——这是 Funk-SVD 与"补 0 后做截断 SVD"(§4)的本质区别
- 更新幅度正比于误差:$e=4.0$ 时第一维被推 $+0.064$,$e=-0.2$ 时只动 $0.004$——误差越大学得越猛,SGD 的"咬住大误差"就在这
- 负误差 = 预测高了 → 参数被减小($0.996<1.0$):方向由 $e$ 的符号自动决定,无需人工干预
- 一步就把 $\hat r_{00}$ 从 1.0 提到 1.1864(离目标 5 更近):这就是 notebook
funk_svd中U[u] += lr*(err*V[i] - reg*U[u])去掉正则项 $-\text{reg}\cdot U[u]$ 后的样子——加入正则后参数还会额外向 0 收缩
下面 numpy 复算。
# ---- §2.1 验证:numpy 复算 Funk-SVD 一步更新 ----
import numpy as np

hc_R = np.array([[5, 3, 0], [4, 0, 1]])
hc_P = np.array([[0.5, 1.0], [1.0, 0.5]])
hc_Q = np.array([[0.8, 0.6], [0.9, 0.7], [1.0, 0.4]])
hc_eta = 0.02

hc_obs = [(0, 0), (0, 1), (1, 0), (1, 2)]
hc_errs = {}
for u, i in hc_obs:
    p = hc_P[u] @ hc_Q[i]
    hc_errs[(u, i)] = hc_R[u, i] - p
    print(f'ŕ({u},{i})={p:.4f}  误差={hc_errs[(u, i)]:+.4f}')

hc_mse = np.mean([hc_errs[k] ** 2 for k in hc_obs])
print(f'MSE={hc_mse:.4f}, RMSE={np.sqrt(hc_mse):.4f}')
assert abs(hc_mse - 6.9681) < 1e-3

# 一步 SGD(同步:都基于旧值)
hc_Pn = hc_P.copy(); hc_Qn = hc_Q.copy()
e = hc_errs[(0, 0)]
hc_Pn[0] = hc_P[0] + hc_eta * e * hc_Q[0]
hc_Qn[0] = hc_Q[0] + hc_eta * e * hc_P[0]
print(f'更新后 P[0]={np.round(hc_Pn[0], 4)}, Q[0]={np.round(hc_Qn[0], 4)}, '
      f'新预测={hc_Pn[0] @ hc_Qn[0]:.4f}')
assert np.allclose(hc_Pn[0], [0.564, 1.048], atol=1e-3)
assert np.allclose(hc_Qn[0], [0.84, 0.68], atol=1e-3)

e2 = hc_errs[(1, 2)]
hc_Pn[1] = hc_P[1] + hc_eta * e2 * hc_Q[2]
hc_Qn[2] = hc_Q[2] + hc_eta * e2 * hc_P[1]
print(f'更新后 P[1]={np.round(hc_Pn[1], 4)}, Q[2]={np.round(hc_Qn[2], 4)}')
assert np.allclose(hc_Pn[1], [0.996, 0.4984], atol=1e-4)
assert np.allclose(hc_Qn[2], [0.996, 0.398], atol=1e-4)
print('✓ 与手算一致')
# 🖼️ 配图:矩阵分解——R ≈ U·Vᵀ 低秩近似(隐因子)
fig, ax = plt.subplots(figsize=(8.5, 3.6))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

# R = U @ V^T
box(0.6, 1.6, 2.4, 1.4, 'R (n_u×n_i)\n稀疏评分矩阵', '#fecaca')
ax.text(3.4, 2.3, '≈', fontsize=18, ha='center', color='#334155')
box(4.0, 1.6, 2.2, 1.4, 'U (n_u×k)\n用户隐因子', '#bfdbfe')
ax.text(6.6, 2.3, '×', fontsize=18, ha='center', color='#334155')
box(7.2, 1.6, 2.2, 1.4, 'Vᵀ (k×n_i)\n物品隐因子', '#bbf7d0')
ax.text(5.0, 0.35, 'k 个小因子(如"动作/爱情/剧情")压缩成低秩近似', fontsize=9.5, ha='center', color='#475569')
ax.text(5.0, 3.5, 'r̂_ui = μ + b_u + b_i + ⟨u_u, v_i⟩', fontsize=11, ha='center', color='#dc2626')
plt.show()
print('➡️ 未观测位置也被"补齐":隐向量泛化,缓解稀疏')
➡️ 未观测位置也被"补齐":隐向量泛化,缓解稀疏
C:\Users\24260\AppData\Local\Temp\ipykernel_39984\2857203423.py:17: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
def funk_svd(R, k=4, lr=0.02, reg=0.05, epochs=150, seed=7):
    rng2 = np.random.default_rng(seed)
    n_u, n_i = R.shape
    U = rng2.normal(0, 0.1, (n_u, k))
    V = rng2.normal(0, 0.1, (n_i, k))
    bu = np.zeros(n_u)   # 用户偏差
    bi = np.zeros(n_i)   # 物品偏差
    mu = R[R > 0].mean()
    observed = np.argwhere(R > 0)
    history = []
    for ep in range(epochs):
        rng2.shuffle(observed)
        for u, i in observed:
            pred = mu + bu[u] + bi[i] + U[u] @ V[i]
            err = R[u, i] - pred
            bu[u] += lr * (err - reg * bu[u])
            bi[i] += lr * (err - reg * bi[i])
            U[u] += lr * (err * V[i] - reg * U[u])
            V[i] += lr * (err * U[u] - reg * V[i])
        # 每 30 轮记录 RMSE
        if ep % 30 == 0:
            preds = mu + bu[:, None] + bi[None, :] + U @ V.T
            rmse = np.sqrt(((preds - R)[R > 0] ** 2).mean())
            history.append((ep, rmse))
    return U, V, bu, bi, mu, history

U, V, bu, bi, mu, hist = funk_svd(R)
for ep, rmse in hist:
    print(f'epoch {ep}: RMSE = {rmse:.4f}')
final_rmse = hist[-1][1]
assert final_rmse < 0.5
print('✅ 训练收敛,RMSE 下降')
epoch 0: RMSE = 1.4934
epoch 30: RMSE = 0.5154
epoch 60: RMSE = 0.2643
epoch 90: RMSE = 0.2609
epoch 120: RMSE = 0.2614
✅ 训练收敛,RMSE 下降
3️⃣ 预测与评估¶
pred_full = mu + bu[:, None] + bi[None, :] + U @ V.T

# 训练集内评估
train_mask = R > 0
rmse_train = np.sqrt(((pred_full - R)[train_mask] ** 2).mean())
# 模拟留出 10% 观测做验证(这里简化:随机抽 10% 观测点算误差)
test_mask = (rng.uniform(0, 1, R.shape) < 0.1) & train_mask
rmse_test = np.sqrt(((pred_full - R)[test_mask] ** 2).mean()) if test_mask.sum() > 0 else 0
print(f'训练 RMSE = {rmse_train:.4f}')
print(f'抽样验证 RMSE = {rmse_test:.4f}')
assert rmse_test < 0.6
print('✅ 预测误差可控')
训练 RMSE = 0.2610
抽样验证 RMSE = 0.2521
✅ 预测误差可控
4️⃣ 与截断 SVD 对比(闭式解)¶
# 用已观测值补 0 后做 SVD(真实工业会用加权/填充均值,这里演示思路)
R_fill = np.where(R > 0, R, R[R > 0].mean())
U_svd, S_svd, Vt_svd = np.linalg.svd(R_fill, full_matrices=False)
k = 4
U_hat = U_svd[:, :k] @ np.diag(np.sqrt(S_svd[:k]))
V_hat = Vt_svd[:k, :].T @ np.diag(np.sqrt(S_svd[:k]))
pred_svd = U_hat @ V_hat.T
rmse_svd = np.sqrt(((pred_svd - R)[R > 0] ** 2).mean())
print(f'截断 SVD(k=4) 观测点 RMSE = {rmse_svd:.4f}')
print('➡️ SVD 是全局最优闭式解;Funk-SVD 只优化观测点,适合稀疏数据且可加偏差/时间项')
截断 SVD(k=4) 观测点 RMSE = 0.7953
➡️ SVD 是全局最优闭式解;Funk-SVD 只优化观测点,适合稀疏数据且可加偏差/时间项
5️⃣ Embedding 可视化:隐向量里有什么语义¶
# 物品隐向量投影到 2D(PCA)
from sklearn.decomposition import PCA
pca = PCA(n_components=2)
item_2d = pca.fit_transform(V)

plt.figure(figsize=(7, 5))
plt.scatter(item_2d[:, 0], item_2d[:, 1], s=60, c=np.arange(n_i), cmap='viridis')
for j in range(n_i):
    plt.annotate(f'I{j+1}', (item_2d[j, 0], item_2d[j, 1]), fontsize=9)
plt.title('物品隐向量 2D 投影(语义相近的物品距离近)')
plt.xlabel('PC1'); plt.ylabel('PC2')
plt.show()
print('➡️ 隐向量本质是低维嵌入:相似物品在隐空间相邻,可做向量召回、聚类、解释')
➡️ 隐向量本质是低维嵌入:相似物品在隐空间相邻,可做向量召回、聚类、解释
C:\Users\24260\AppData\Local\Temp\ipykernel_39984\1903069265.py:12: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
6️⃣ 面试高频追问(速答)¶
print('''1) 为什么用低秩分解?  → 隐因子压缩信息、泛化、抗稀疏;
2) SGD vs ALS 怎么选?   → 稀疏/可扩展 ALS 更快(交替最小二乘闭式更新),
   SGD 灵活可加正则/偏差/时间衰减;
3) 隐向量维度 k 怎么定? → 交叉验证;一般几十~几百;
4) 和 DeepFM 关系?     → DeepFM 的 FM 项 = 特征 embedding 的点积,
   矩阵分解是「只有 id 特征」的特例;
5) 冷启动怎么办?       → 内容特征/热启动模型(DNN 用内容 embedding 替代 id)。
''')
1) 为什么用低秩分解?  → 隐因子压缩信息、泛化、抗稀疏;
2) SGD vs ALS 怎么选?   → 稀疏/可扩展 ALS 更快(交替最小二乘闭式更新),
   SGD 灵活可加正则/偏差/时间衰减;
3) 隐向量维度 k 怎么定? → 交叉验证;一般几十~几百;
4) 和 DeepFM 关系?     → DeepFM 的 FM 项 = 特征 embedding 的点积,
   矩阵分解是「只有 id 特征」的特例;
5) 冷启动怎么办?       → 内容特征/热启动模型(DNN 用内容 embedding 替代 id)。
📝 自测清单¶
- 能手写 Funk-SVD(偏差+正则+SGD)并解释每步
- 能解释截断 SVD 与 Funk-SVD 的差异
- 能讲清隐向量/embedding 的语义与用途
- 能回答 k 怎么选、SGD vs ALS 怎么选
- 能说明矩阵分解与 FM/DeepFM 的关系