🧠 07 · 强化学习面试八股与高频手写题¶
定位:算法/LLM 岗 RL 方向的临场速查——八股速答 + 手写题模板 + 复盘清单。 前 6 篇的知识全部浓缩在这里;建议面试前 1 天过一遍。 标记:🔴 必背 / 🟡 掌握。
1. 高频八股速答 30 连问(🔴 先答再看答案)¶
基础概念(1-10)¶
- Q: MDP 五元组? A: <S, A, P, R, γ>,马尔可夫性质=状态包含全部决策信息。
- Q: V 和 Q 的区别? A: V 只问状态、Q 多一个动作维度;Q 可直接 argmax 出策略。
- Q: 贝尔曼方程? A: 价值 = 立即奖励 + 折扣 × 下一步价值期望;最优版把 Σ 换 max。
- Q: γ 的作用? A: 收敛 + 近视/远视建模;γ=0 只看一步,γ→1 看长期。
- Q: 有模型 vs 无模型? A: DP 需 P/R;MC/TD/Q-learning 只用采样。
- Q: MC vs TD? A: MC 回合结束拿真实 G(无偏方差大);TD 每步用估计目标(有偏低方差),可持续任务。
- Q: TD 误差是什么? A: δ = r + γV(s') - V(s),几乎所有现代算法的核心量。
- Q: off-policy vs on-policy? A: 行为策略(采样)≠ 目标策略(更新)为 off;Q-learning off、SARSA on。
- Q: ε-greedy? A: 1-ε 贪心、ε 随机;控制探索利用平衡。
- Q: 为什么需要探索? A: 只用已知最优无法发现更优动作;随机策略在博弈里也必要。
DQN 家族(11-20)¶
- Q: DQN 三大稳定技巧? A: 经验回放(去相关+复用)、目标网络(固定监督)、误差剪裁(限梯度)。
- Q: 目标网络怎么更新? A: 每 C 步硬拷贝或每步软更新 τ=1e-3。
- Q: DDQN 解决什么? A: 最大化偏差(过度乐观);online 选动作、target 估值。
- Q: Dueling? A: Q = V + A - max A;解耦状态价值与动作优势,学 V 更快。
- Q: PER? A: 按 |δ| 加权采样,重要度修正偏差。
- Q: DQN 能处理连续动作吗? A: 不能(max 需枚举);用 DDPG/TD3/SAC。
- Q: N-step? A: n 步回报折中偏差方差,Rainbow 里用。
- Q: Rainbow? A: DQN+DDQN+Dueling+PER+N-step+NoisyNet+Distributional 六合一。
- Q: 奖励剪裁为什么? A: 大奖励主导梯度导致不稳定。
- Q: 高估问题怎么诊断? A: 对比 online 与 target 的 Q 值漂移;或真值已知时对比。
策略梯度与进阶(21-30)¶
- Q: 策略梯度定理? A: ∇J = E[Σ ∇logπ(a|s) G_t];log 似然技巧。
- Q: 为什么加基线无偏? A: E[∇logπ · b(s)] = b(s)∇Σπ = 0。
- Q: AC 结构? A: Actor 学策略 + Critic 学价值 + 优势连接(常用 TD 误差近似)。
- Q: GAE? A: A = Σ(γλ)^k δ_{t+k};λ 旋钮调偏差-方差。
- Q: PPO vs TRPO? A: TRPO 硬 KL 约束;PPO 用 clip 惩罚,简单有效。
- Q: PPO clip 为什么有效? A: 概率比超 [1-ε,1+ε] 梯度截断 → 单步更新有界。
- Q: RLHF 三阶段? A: SFT → 奖励模型(BT 损失) → PPO 优化(+KL 正则)。
- Q: GRPO 和 PPO 区别? A: GRPO 用组内奖励标准化当优势、去掉 Critic(DeepSeek-R1)。
- Q: DDPG/TD3/SAC 是什么? A: 连续动作的确定性策略梯度/孪生 Critic/熵正则最大熵方法。
- Q: 探索方法有哪些? A: ε-greedy、UCB、汤普森采样、NoisyNet、熵正则、curiosity。
核心概念¶
(a) 🗂️ 强化学习面试八股知识地图¶
这篇是全模块的"面试冲刺包":90 连问覆盖基础概念、DQN 家族、策略梯度与 LLM×RL 深水区,配五道手写题模板、RLHF 系统设计题、开放题万能四段式和复盘模板。
flowchart TB
    Node1["🧠 90 连问题库"]
    Node1 --> Node2["🧠 算法家族全家福"]
    Node2 --> Node3["🧠 手写题五件套"]
    Node3 --> Node4["🧠 RLHF 系统设计"]
    Node4 --> Node5["🧠 开放题四段式"]
    Node5 --> Node6["🧠 表达技巧与踩分点"]
    Node1 --> Node7["🧠 行为面试 STAR 话术"]
    Node7 --> Node8["🧠 复盘与自测清单"]
- 节点1(90 连问题库):基础概念(1-30)、DQN 家族(31-60)、LLM×RL 深水区(61-90)三轮冲刺,先自己答再看答案,专治"会做不会说"。
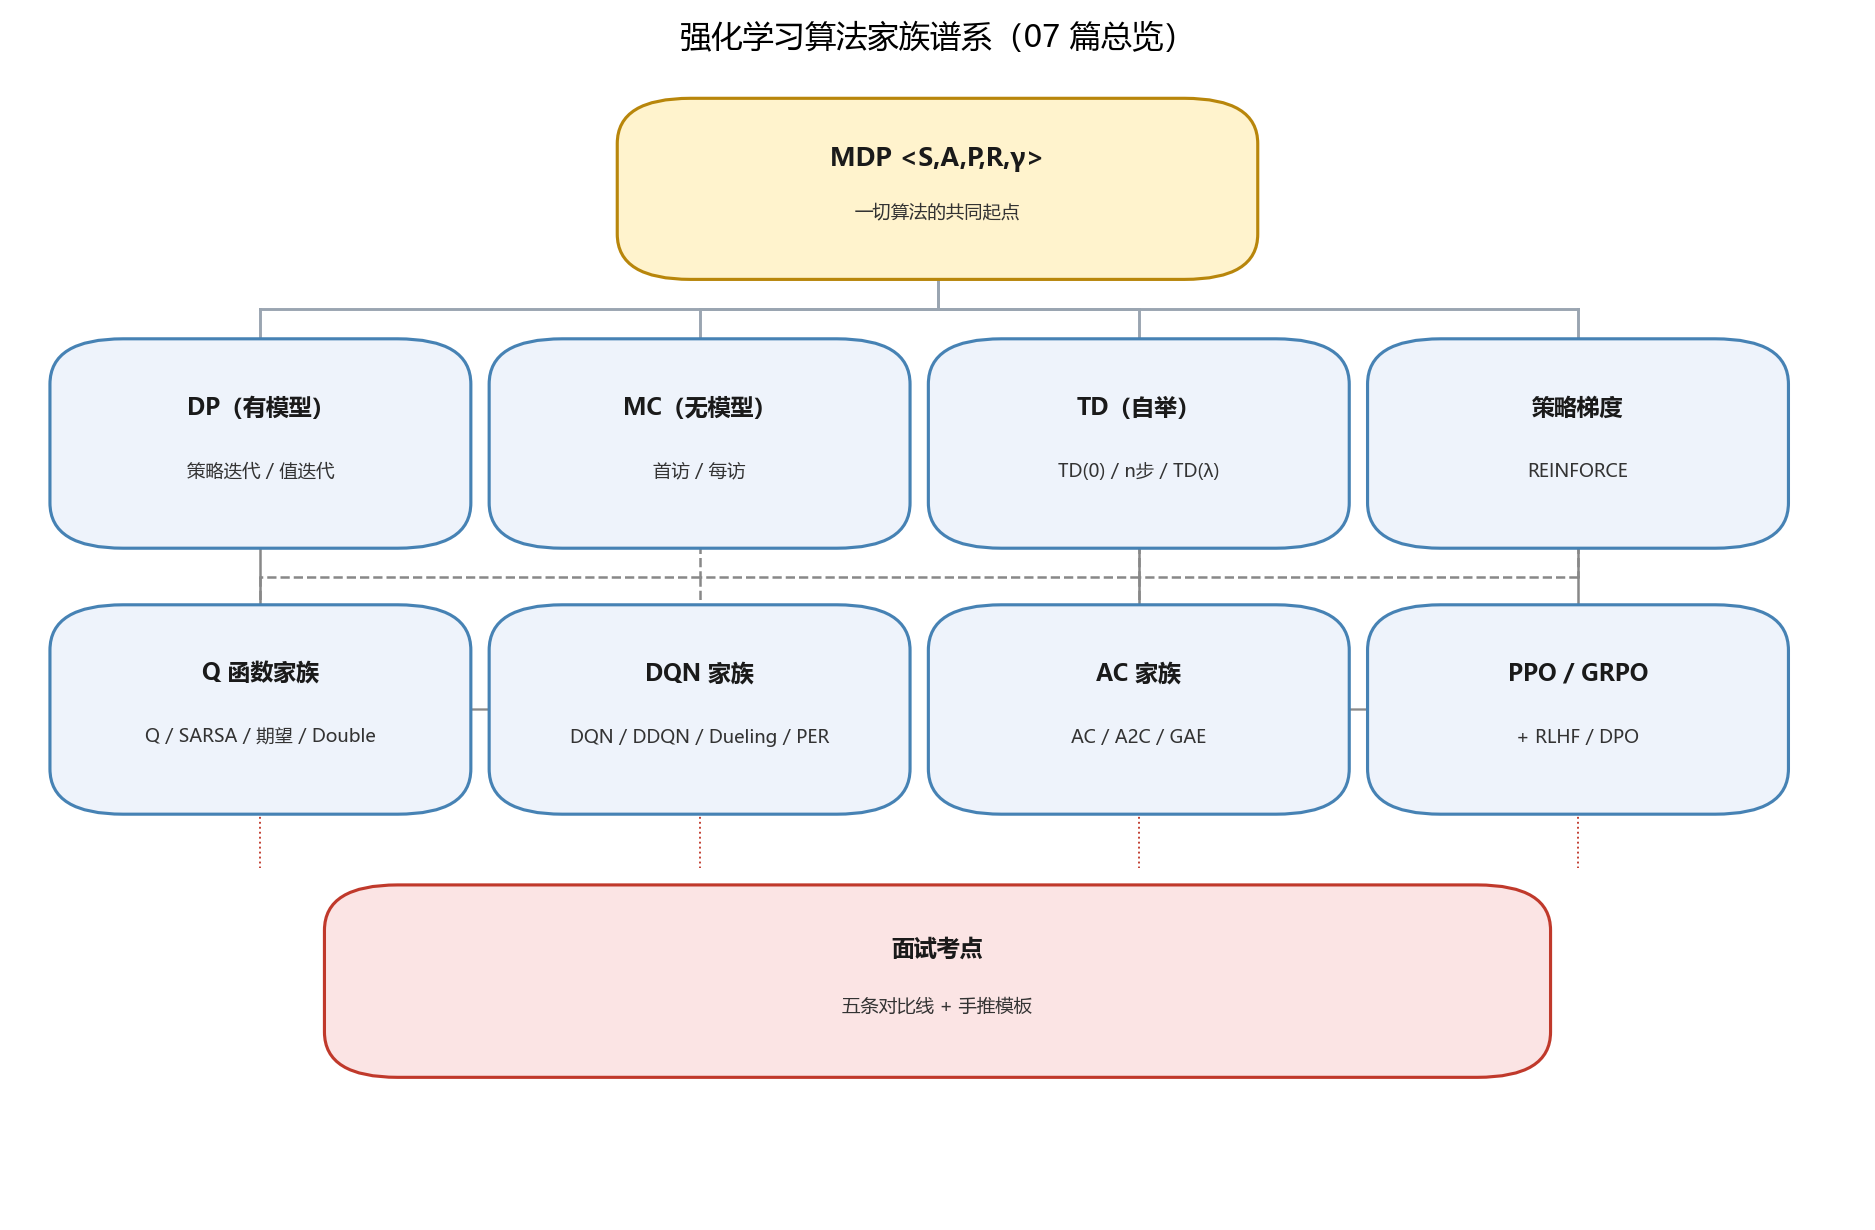
- 节点2(算法家族全家福):先用一张"RL 算法谱系树"回答"RL 有哪些算法":表格方法(DP/MC/TD)→ 深度价值(DQN 家族)→ 策略梯度(PG/PPO)→ 对齐(RLHF/GRPO/DPO),30 秒讲完结构。
- 节点3(手写题五件套):Q-learning 更新、DQN 损失、REINFORCE、PPO clip、UCB 五道 30 秒默写题都有模板和对照代码,面试前夜背诵表直接刷。
- 节点4(RLHF 系统设计):设计 RLHF 管线是 LLM 岗必考:SFT → RM(Bradley-Terry)→ PPO/GRPO → KL 控制,每阶段讲清输入输出、显存与采样注意点,按管线顺序答就是满分卷。
- 节点5(开放题四段式):任何开放题用"定义问题 → 分析难点 → 给方案 → 验证与风险"四段式答,结构感立刻拉满,示例是 30 秒版 LLM 对齐方案。
- 节点6(表达技巧与踩分点):答概念要"定义 + 公式 + 直觉 + 一句话总结",主动说关键数字(如目标网络 C、clip ε、γ、β),把会的东西用模板讲出来。
- 节点7(行为面试 STAR 话术):用 STAR(情境-任务-行动-结果)讲 RL 项目故事,并准备"三条防线"防止被追问崩盘。
- 节点8(复盘与自测清单):面试后 24 小时填复盘四问,出门前过一遍最终速背卡和失败模式体检表,形成完整闭环。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# bandit.py —— 探索-利用数值实验: ε-greedy vs UCB vs 汤普森采样(多臂老虎机)
import numpy as np

np.random.seed(2)
K = 5
# 真实(未知)的每臂奖励均值
true_means = np.array([0.1, 0.3, 0.5, 0.7, 0.9])
T = 2000

def run(alg, **kw):
    counts = np.zeros(K)
    q = np.zeros(K)          # 经验均值
    reward = 0.0
    for t in range(1, T + 1):
        if alg == 'egreedy':
            eps = kw['eps']
            a = np.random.randint(K) if np.random.random() < eps else int(np.argmax(q))
        elif alg == 'ucb':
            ucb = q + kw['c'] * np.sqrt(np.log(t) / (counts + 1e-6))
            a = int(np.argmax(ucb))
        elif alg == 'thompson':
            # 汤普森采样: 从后验 Beta(成功+1, 失败+1) 采样
            samples = np.random.beta(q * counts + 1, (1 - q) * counts + 1)
            a = int(np.argmax(samples))
        r = 1.0 if np.random.random() < true_means[a] else 0.0
        counts[a] += 1
        q[a] += (r - q[a]) / counts[a]
        reward += r
    return reward, np.round(counts / T, 3)

# 显示名 → 算法名 映射('ε-greedy' → 'egreedy', '汤普森' → 'thompson')
alg_map = {'ε-greedy': 'egreedy', 'UCB': 'ucb', '汤普森': 'thompson'}
for name, kw in [('ε-greedy(0.1)', {'eps': 0.1}),
                 ('ε-greedy(0.01)', {'eps': 0.01}),
                 ('UCB(c=2)', {'c': 2.0}),
                 ('汤普森', {})]:
    tot, dist = run(alg_map[name.split('(')[0]], **kw)
    print(f'{name:<16} 总奖励 {tot:.0f}  各臂采样占比 {dist}')
print()
print('理论最优: 2000 步全压 0.9 臂 → 约 1800 分')
print('观察: UCB/汤普森自适应探索, 比固定 ε 更快锁定最优臂')
ε-greedy(0.1)    总奖励 1638  各臂采样占比 [0.053 0.023 0.018 0.182 0.724]
ε-greedy(0.01)   总奖励 1833  各臂采样占比 [0.002 0.006 0.004 0.002 0.986]
UCB(c=2)         总奖励 1671  各臂采样占比 [0.018 0.026 0.045 0.102 0.808]
汤普森              总奖励 1782  各臂采样占比 [0.002 0.003 0.01  0.002 0.984]

理论最优: 2000 步全压 0.9 臂 → 约 1800 分
观察: UCB/汤普森自适应探索, 比固定 ε 更快锁定最优臂
配图:先有一张"全家福",再谈八股(🔴 面试第一问的底气)¶
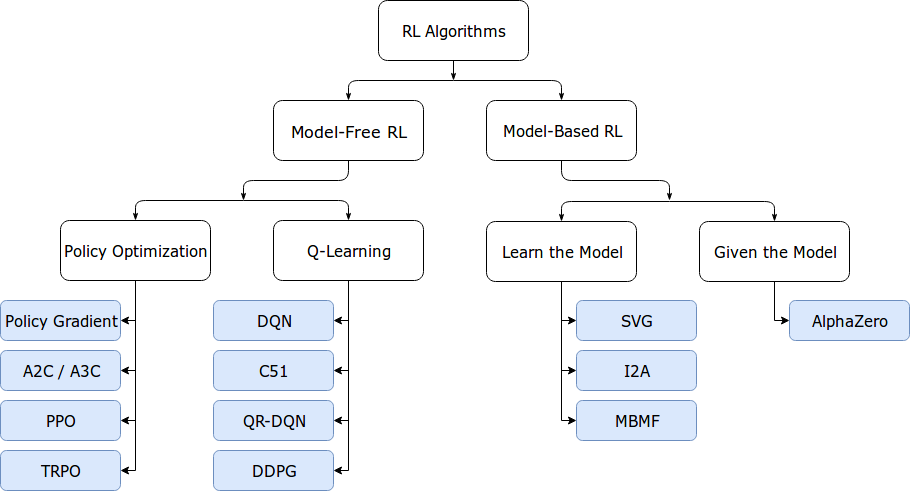
上图是强化学习算法的经典分类全景(OpenAI Spinning Up 出品,MIT 许可): Model-free 分两大阵营,往下再分价值/策略/AC,构成矩阵化的"算法地图"。
用这张图回答"RL 有哪些算法"(30 秒版)¶
- Model-free vs Model-based:前者只学价值/策略(本篇 02-06、08/09/11), 后者先学环境模型再规划(10 篇 Dyna/MCTS/MuZero)
- Model-free 两大分支:
- Q-learning 系(学价值):DQN → DDQN → Dueling → Rainbow(04 篇)
- 策略梯度系(学策略):REINFORCE → AC → A2C/GAE → PPO(05/06 篇)
- Actor-Critic 是交汇处:策略 + 价值网络双头(现代主流)
- 按"在线/离线/连续/多智能体"再切:offline(11)、连续控制(08)、MARL(09)、 模仿学习(12)——八股问"你了解哪些算法"时按这个树展开,比背名单高级得多
图源:OpenAI Spinning Up(MIT License,rl_algorithms.png)——面试表达用它当 "算法坐标轴":先分类、再举例、再说各自解决的痛点。
2. 手写题模板(🔴 面试可能让现场写)¶
① Q-learning 更新(30 秒默写)¶
Q[s, a] += alpha * (r + gamma * np.max(Q[s2]) - Q[s, a])      # off-policy: max
# SARSA: 把 np.max(Q[s2]) 换成 Q[s2, a2](实际采取的动作)       # on-policy
② DQN 损失(10 秒默写)¶
y = r + gamma * np.max(Q_target(s2), axis=1) * (1 - done)
loss = ((Q_online(s) - y) ** 2).mean()                        # 或 Huber
③ 策略梯度/REINFORCE(20 秒默写)¶
logits = policy(x); logp = log_softmax(logits)[a]
loss = -(G * logp).mean()      # 梯度上升 ⇔ 该损失梯度下降
# 加基线: loss = -(G - V(s)) * logp
④ PPO clip(20 秒默写)¶
ratio = (pi_new(a|s) / pi_old(a|s))
loss = -min(ratio * A, clip(ratio, 1-eps, 1+eps) * A).mean()
⑤ 多臂老虎机 UCB(15 秒默写)¶
a = argmax(q + c * sqrt(log(t) / n)) # 不确定性奖励加成
建议面试前把 ①④⑤ 各默写 3 遍,可以脱离公式手写。
3.1 系统设计题精讲:RLHF 管线设计的满分答卷(🔴 必考详解)¶
本节导读:开放题"设计一个 RLHF 训练管线"是 LLM 岗 RL 方向最高频的 系统设计题。这一节给一份可以直接背的完整设计,覆盖数据、模型、 训练、评估、风险五个环节。
1. 需求拆解(先讲清楚目标,踩分点①): "让模型输出更符合人类偏好,同时不失去语言能力" → 设计三件套 (SFT 底座 + RM 裁判 + RL 调优)并明确每件套的输入输出与数据来源。
2. 数据管线(踩分点②):
- SFT:指令数据(百万级 prompt-response)
- RM:偏好对数据(同一 prompt 的两个回答 → 人类投票/打分),采样时要 覆盖多样性(不同长度/风格/领域),防止 RM 学偏
- RL:用同一批 prompt 人工采样(desired:多样、难度分层)
3. 模型设计(踩分点③):
- RM:SFT 模型去 head 换标量头;训练 Bradley-Terry 损失(§9/06 篇 12 节)
- 策略:从 SFT 初始化;参考模型 π_ref 冻结(KL 锚点)
- 可选:RM 也用 ensemble(多 RM 平均)降单模型偏差
4. 训练细节(踩分点④,逐条背):
- PPO:γ=0.99、GAE λ=0.95、KL 系数 β 0.01~0.1(或 GRPO:G=4~16 组内优势)
- 每个 prompt 采 K 个回答进 buffer;用 clip 限制更新步长
- 奖励 = RM 分 − β·KL(π‖π_ref);奖励先归一化(尺度影响 β 手感)
- 显存破:LoRA 微调策略 / 参考模型 offload / GRPO 去 Critic
5. 评估与防线(踩分点⑤,加分):
- 离线指标:RM 分数、KL 距离、困惑度(不离谱)
- 在线评估:人工盲测 A/B、质量/毒性/帮助性三维打表
- 防线:奖励黑客监控(长度异常增长、重复率飙升)、β 主动上调
6. 一句话收尾(面试节奏):数据三路、模型三件、训练一循环、 评估四方——按"数据→模型→训练→评估"四段讲满 3 分钟。
3. 系统设计/开放题(🟡 LLM 岗常见)¶
Q1: 设计一个 RLHF 训练管线(必考)¶
数据: 偏好对(好回答, 坏回答) × 10万+
① SFT: 用高质量回答微调 base
② RM: 训练奖励模型 r_φ (BT 排序损失: log σ(r_good - r_bad))
③ PPO: 策略=LM, 奖励=r_φ + KL(π‖π_sft), GAE 回传句末奖励
④ 评估: 离线胜率 vs 在线人类反馈; 监控 reward 与 KL 漂移
追问应对:奖励模型过拟合怎么办(加 KL/多样本);回答太长怎么办(长度惩罚);安全对齐(红队测试)。
Q2: 为什么生成任务适合 GRPO 而不是 PPO¶
组内标准化奖励天然"相对比较",与 RM 的训练方式(pairwise)一致;省掉价值网络 → 显存/训练成本降一半。答出 R1 采用背景 + 公式即可。
Q3: 连续控制怎么选算法¶
动作连续 + 确定性环境   → DDPG / TD3(确定策略梯度)
动作连续 + 需要随机/多峰 → SAC(最大熵, 稳定 SOTA 默认)
动作离散               → DQN 家族 / PPO
4. 易错点清单(🔴 面试失分重灾区)¶
- V 与 Q 换算式:$V^\pi(s)=\sum_a \pi(a|s)Q^\pi(s,a)$——动作先按策略加权,别直接 max。
- Q-learning 是 off-policy:更新用 max 目标、与实际采取动作无关——和"TD 目标"混淆就翻车。
- MC 无偏、TD 有偏:TD 目标含估计值;反过来 MC 方差大。
- PPO 的 clip 是惩罚不是约束:TRPO 是硬约束,PPO 是软惩罚近似。
- RLHF 的 KL 方向:KL(πθ ‖ πsft) 是"新策略对参考"的散度,防漂移。
- GRPO 概率比是 πθ/πref:不是 PPO 的 πθ/πold——GRPO 无 old 快照。
- DQN 不能连续动作:max 枚举不了连续空间。
- γ 影响收敛性:γ=1 无限 horizon 可能发散,需有限回合或折扣。
5. 复盘清单(面试后 24h 填)¶
- 问了哪些 RL 八股?(MDP/贝尔曼/DQN/PPO…)答得顺不顺
- 是否被要求手写公式/代码?哪条卡壳了?
- 是否问到 LLM×RL(RLHF/GRPO/奖励模型)?怎么答的
- 开放题用的什么框架(定义→方法→trade-off→评估)?
- 标出 2 个薄弱点 → 返回对应 notebook 章节重学
6. 高频八股 31–60 连问(🔴 第二轮冲刺速答)¶
进阶概念(31-45)¶
- Q: TRPO 的单调改进怎么保证? A: 新旧策略价值差 ≥ 期望优势 - 常数×KL 界(minorize-maximize);在界内优化则单调不降。
- Q: importance sampling 在 PG 里干嘛? A: 用旧策略数据评估新策略期望——概率比加权(PPO ratio 来源)。
- Q: 什么是探索-利用困境? A: 收集信息(探索)vs 用已知最优拿奖励(利用)的权衡;老虎机/RL 基础矛盾。
- Q: 熵正则? A: 目标里 +c·S[π] 鼓励随机性,防策略过早坍缩(PPO 标配之一)。
- Q: 多臂老虎机与 MDP 的关系? A: 单状态 MDP(无状态转移),只做探索-利用。
- Q: UCB 的直觉? A: 均值 + 不确定性奖励($\sqrt{\log t / n}$);样本少 → 不确定性大 → 多尝试。
- Q: 汤普森采样? A: 从后验分布采样参数再选最优臂——贝叶斯式探索,理论上最优(遗憾界)。
- Q: 什么是遗憾(regret)? A: 与最优策略的累计奖励差;RL 算法评估指标之一。
- Q: 模型预测控制(MPC)? A: 用学到的模型做短视界在线规划(重规划每步)——MBRL 常用组件。
- Q: 世界模型(World Model)? A: 学环境的 latent 模型做想象训练(Dreamer/IRL 系);样本效率高。
- Q: 设置奖励函数的原则? A: 奖励塑形(potential shaping)不改变最优策略;稀疏 vs 稠密权衡;避免 hack 漏洞。
- Q: 奖励塑形(reward shaping)? A: 加 $F = \gamma\Phi(s') - \Phi(s)$(势函数差分)不改变最优策略(Ng et al. 1999)。
- Q: 课程学习(curriculum)? A: 从易到难训练(先简单环境后复杂)——机器人/LLM 常用。
- Q: 分层 RL(Hierarchical RL)? A: 上层选子目标、下层执行——时间抽象,缓解稀疏奖励长 horizon。
- Q: 模仿学习 vs RL? A: 模仿用专家演示(行为克隆/GAIL);RL 用奖励信号自探索;混合=先模仿后 RL。
工程与调优(46-60)¶
- Q: RL 训练为什么难复现? A: 随机种子 × 环境随机性 × 策略分布漂移;惯例:多 seed 中位数。
- Q: 训练曲线怎么看? A: 滚动均值 + 方差带;看奖励的同时看 KL/价值误差/熵是否正常。
- Q: 奖励稀疏怎么办? A: 奖励塑形、HER(事后经验回放)、课程学习、Intrinsic motivation。
- Q: HER 是什么? A: 目标失败样本改写成"目标=实际到达状态"→ 稀疏奖励变稠密(OpenAI 抓取)。
- Q: 内在奖励(ICM/RND)? A: 好奇心驱动的探索:预测误差/新奇度当额外奖励。
- Q: 分布偏移问题? A: 训练策略与部署策略不一致(offline RL 核心难题);保守估计/行为约束。
- Q: Offline RL 是什么? A: 只用固定数据集训练(不交互);挑战=分布外 Q 高估 → CQL/IQL 等保守法。
- Q: 模仿学习的弊端? A: 分布偏移(复合误差);GAIL 用判别器弥补。
- Q: 对比:RL 与最优控制? A: RL 无模型/模型自适应;最优控制假设已知模型(LQR/MPC)。
- Q: 为什么值方法高估? A: 噪声通过 max 放大;解决=Double Q/保守法/正则。
- Q: 为什么要考虑"带约束 RL"? A: 安全/预算约束(CMDP);Lagrange 乘子或安全层。
- Q: PPO 的 lr 怎么调? A: lr 太大价值网络发飘;一般 3e-4~1e-4(Adam)。
- Q: 价值网络与策略网络共享特征? A: 可共享(PPO 论文常见)但梯度交互需小心(或分离)。
- Q: 早停策略什么时候触发? A: 奖励平稳/验证 KL 超限/价值损失发散。
- Q: 汇报结果时的正确姿势? A: 中位数+四分位、多次 seed 曲线、与 baselines 同 seed 公平对比。
7.1 LLM×RL 深水区高频题详解(🔴 61-90 必会十题精讲)¶
本节导读:61-90 问是全篇最难的 LLM×RL 交叉题。以下十题按"结论 → 原理 → 一句话"给出可背的详细解答(覆盖 61、63、65、67、70、72、 75、78、82、85 的核心考点)。
Q61 RLHF 为什么用 PPO 而不是 DQN? 结论:动作(token)空间巨大(词表几万~几十万),DQN 的 max 枚举不可行; 且策略类方法天然适配"生成式"输出。原理:PPO 只要求可微策略 + 采样 轨迹;DQN 要求枚举动作求 max。一句话:连续/大离散动作 → 策略梯度系。
Q63 KL 惩罚为什么能防"胡言乱语"? 结论:RL 优化近似奖励会放大 RM 误差,KL 惩罚把策略锚在 SFT 附近。 原理:$r-\beta\log(\pi/\pi_{ref})$,偏离参考越多扣分越多。一句话: 奖励只管讨喜,KL 保证还像人说话。
Q65 参考模型为什么必须冻结? 结论:π_ref 是"人类语言基线",若它跟着训练就失去锚点意义。原理: DPO/RLHF 的闭式解与损失都依赖固定的 π_ref。一句话:锚动了, KL 和 DPO 就全失去目标。
Q67 GRPO 为什么比 PPO 省显存? 结论:去掉 Critic(价值网络)+ 组内优势替代。原理:LLM 参数巨大时 价值网络与策略同规模;GRPO 用组内均值/标准差算优势。一句话: 省掉一整张大网络,用 G 个采样答案的统计替代。
Q70 Reward Model 会过拟合吗?怎么缓解? 结论:会——偏好数据同质时 RM 记忆化。缓解:数据多样性、RM ensemble、 正则、用 KL 限制策略搜索范围(间接缓解)。一句话:RM 是数据与 分布的镜子,数据和集成是它的护栏。
Q72 SFT 和 RLHF 的数据能不能混用? 结论:能但分阶段(SFT 先、RL 后);RL 复用 SFT 数据会因分布陈旧降低 探索。原理:RL 数据要"当前策略采"才匹配。一句话:SFT 数据教语言, RL 数据要新要匹配当前策略。
Q75 奖励归一化为什么重要? 结论:RM 分数尺度随批次漂移,β(KL 系数)的手感依赖奖励尺度。 原理:$r-\beta\text{KL}$ 两项量级要可比;先减均值除标准差,β 才稳定。 一句话:不归一化,β 要么太松要么太紧。
Q78 策略模型显存不够怎么办? 结论:LoRA/QLoRA 微调、pipeline 并行、参考模型 offload、GRPO 替代。 原理:训练态 = 策略+参考+RM+优化器状态(≈4-6 倍参数量)。 一句话:能砍的(参考/RM/优化器)offload,能缩的(LoRA)缩。
Q82 RLHF 后模型"说教"怎么办? 结论:RM 偏好长/结构化回答 → 策略学歪。缓解:长度惩罚、多样性奖励、 偏好数据平衡(短回答也有正例)。一句话:RM 觉得长=好,模型就注水; 对标数据里加"精炼回答"正样本。
Q85 评估 RLHF 效果除了 RM 分还看什么? 结论:KL 距离(没崩)、人工 A/B(真实偏好)、基准集(MMLU/GSM8K 不掉)、 毒性/安全红队。一句话:分数只是代理,人的判断和基准不掉才是真。
7. 高频八股 61–90 连问(🔴 第三轮,LLM×RL 深水区)¶
- Q: RLHF 的 reward 为什么还要减 KL? A: 防策略钻 RM 空子 + 保生成多样性与事实性。
- Q: 奖励模型训练数据怎么造? A: 同一提示生成多个回答 → 人工排序/两两比较 → BT 模型。
- Q: RM 与生成模型共用? A: 一般独立训练(可初始化自 SFT);也可参数共享 + 头分离。
- Q: PPO 在 LLM 上 batch 怎么构造? A: 同一提示 采样多个回答(per-prompt batch);RLHF 惯例。
- Q: 生成任务 T 步为什么不用 per-token RM? A: RM 通常只在句末给分(稀疏);GAE 回传。
- Q: RLHF 的大小模型蒸馏? A: 大模型 RM 给小模型 PPO / 直接用大模型偏好蒸馏(SFT 式)。
- Q: DPO 的 β 和 RLHF 的 β 一样吗? A: 都是 KL 强度;尺度不同需单独调。
- Q: RLOO(Reinforce Leave-One-Out)? A: GRPO 的近亲:用"除自己外的组均值"当基线。
- Q: GRPO 与 RLOO 区别? A: RLOO 基线=排除当前样本的均值;GRPO 用全组均值+标准差标准化。
- Q: 长回答惩罚? A: 奖励里减长度项或对平均 logprob 归一化——防模型堆字。
- Q: 安全对齐怎么接? A: 在 RM 里加安全维度 / 单独安全 RM / 规则过滤 + 红队。
- Q: RLHF 什么时候不划算? A: 任务可离线评估(分类)→ DPO;需要在线探索(长推理)→ RLHF/GRPO。
- Q: 推理增强(reasoning RL)? A: R1 式:对 CoT 输出做 RL,奖励=答案正确性(可验证任务)。
- Q: 如何避免 RL 后模型知识遗忘? A: KL 约束 + 混合通用数据 + 低 β 阶段。
- Q: 人偏好与真实质量不一致? A: 偏好噪声 → 奖励模型校准、KTO 等无需配对的方法。
- Q: 上下文 Bandit 与 RL 区别? A: 上下文 Bandit 单步决策(无状态转移);RL 多步 credit assignment。
- Q: 什么是 behavior cloning? A: 监督学习直接拟合专家动作(最简单模仿)。
- Q: GAIL? A: 生成式对抗模仿:判别器区分专家与策略轨迹。
- Q: 逆强化学习(IRL)? A: 从专家轨迹反推奖励函数(学徒学习)。
- Q: 多智能体 RL(MARL)的难点? A: 非平稳(他人也在学)、信用分配、通信/合作。
- Q: NFSP/自博弈? A: 扑克等不完全信息博弈:策略 + 反事实遗憾最小化。
- Q: AlphaGo 用了哪些 RL? A: 策略网络(监督+PG)+ 价值网络(自弈数据)+ MCTS 规划。
- Q: MCTS 是什么? A: 蒙特卡洛树搜索:选择-扩展-模拟-回传,UCB 选择。
- Q: AlphaZero 与 AlphaGo 区别? A: 去掉人类棋谱,自弈 + 通用网络。
- Q: MuZero? A: 不学真实转移,学隐表示上的 model(规划+学习融合)。
- Q: 连续控制 industrial 常用? A: PPO 或 SAC;确定性任务可用 TD3。
- Q: SAC 的随机性哪来? A: 动作分布熵正则——同时探索与鲁棒。
- Q: TD3 的 twin critic 目的? A: 取 min 缓解过估计(twin + target smoothing)。
- Q: 什么时候用 Q-learning 家族 vs PG 家族? A: 离散动作/样本高效 → DQN;连续动作/随机策略 → PPO/SAC;LLM → PPO/GRPO。
- Q: 给面试官的最后一个问题怎么问? A: "团队里 RL 与 LLM 的结合点在哪?用什么对齐框架?(展示你已经能聊到点上)"
# handcode_ql.py —— 手写题①: Q-learning 更新(30 秒默写→立刻验证收敛)
import numpy as np

# 最小表格: 3 状态 2 动作, 已知转移(确定性)
N_S, N_A, GAMMA, ALPHA, EPS = 3, 2, 0.9, 0.3, 0.2

def step(s, a):                     # 环境: 状态2是目标(奖励10)
    if s == 2:
        return 2, 0.0
    if a == 0:
        return min(s + 1, 2), (-1.0 if s + 1 != 2 else 10.0)
    return max(s - 1, 0), -1.0 if s > 0 else -1.0

np.random.seed(0)
Q = np.zeros((N_S, N_A))
for ep in range(300):
    s = 0
    while s != 2:
        a = np.random.randint(N_A) if np.random.random() < EPS else int(np.argmax(Q[s]))
        s2, r = step(s, a)
        Q[s, a] += ALPHA * (r + GAMMA * np.max(Q[s2]) - Q[s, a])   # 一行核心
        s = s2

print('Q 表(收敛后):')
print(np.round(Q, 3))
print('最优策略: 状态0 ->', '动作0' if Q[0, 0] >= Q[0, 1] else '动作1',
      '| 状态1 ->', '动作0' if Q[1, 0] >= Q[1, 1] else '动作1')
print('→ 正确解: 全程选动作0(走向目标); 面试时默写这一行即可')
Q 表(收敛后):
[[ 8.     6.2  ]
 [10.     6.197]
 [ 0.     0.   ]]
最优策略: 状态0 -> 动作0 | 状态1 -> 动作0
→ 正确解: 全程选动作0(走向目标); 面试时默写这一行即可
# handcode_dqn.py —— 手写题②: DQN 损失(10 秒默写核心)
import numpy as np

# 语义演示: online/target 两个 Q 函数, 算 loss
np.random.seed(0)
def q_online(s, a):
    # 假想网络: 状态嵌入点积
    s_v = np.array([s * 0.1, 1.0])
    w = np.array([1.0, 0.5])
    return float(np.dot(s_v, w) * (a + 1))

def q_target(s, a):
    return float(q_online(s, a) * 0.9)     # 假想 target 网络(略保守)

batch = [(0, 1, -1.0, 1, False), (1, 0, -1.0, 2, False), (1, 1, 10.0, 2, True)]
GAMMA = 0.9
losses = []
for s, a, r, s2, done in batch:
    y = r if done else r + GAMMA * max(q_target(s2, a2) for a2 in range(2))
    pred = q_online(s, a)
    losses.append((y - pred) ** 2)

print('DQN 损失逐样本:')
for (s, a, r, s2, done), l in zip(batch, losses):
    print(f'  (s={s},a={a},r={r},done={done})  loss={l:.3f}')
print('batch 平均 loss =', round(np.mean(losses), 3))
print()
print('面试核心: y = r + γ·max Q_target(s2) (done 时 y=r); loss = Huber/MSE(pred-y)')
DQN 损失逐样本:
  (s=0,a=1,r=-1.0,done=False)  loss=1.057
  (s=1,a=0,r=-1.0,done=False)  loss=0.217
  (s=1,a=1,r=10.0,done=True)  loss=77.440
batch 平均 loss = 26.238

面试核心: y = r + γ·max Q_target(s2) (done 时 y=r); loss = Huber/MSE(pred-y)
# handcode_ppo.py —— 手写题③: PPO clip 一行目标(20 秒默写)
import numpy as np

def ppo_clip_loss(ratio, A, eps=0.2):
    """ratio: 新旧概率比向量; A: 优势向量"""
    return np.minimum(ratio * A, np.clip(ratio, 1 - eps, 1 + eps) * A)

ratio = np.array([1.5, 0.8, 1.0, 1.1])
A = np.array([2.0, -1.0, 0.5, 1.0])
loss = ppo_clip_loss(ratio, A)

print('PPO clip 目标逐样本:')
for r, a, l in zip(ratio, A, loss):
    print(f'  ratio={r:.2f}  A={a:+.1f}  ->  clip目标={l:+.3f}')

ratio_need = np.ones(4)
print()
print(f'无 clip 时(全=1): {np.array([r*a for r,a in zip(ratio_need, A)])}')
print('→ 关键: ratio 超界时(如1.5)梯度被截断, 一步不会迈太大')
print('面试 20 秒版: loss = -min(ratio*A, clip(ratio,1±ε)*A).mean()')
PPO clip 目标逐样本:
  ratio=1.50  A=+2.0  ->  clip目标=+2.400
  ratio=0.80  A=-1.0  ->  clip目标=-0.800
  ratio=1.00  A=+0.5  ->  clip目标=+0.500
  ratio=1.10  A=+1.0  ->  clip目标=+1.100

无 clip 时(全=1): [ 2.  -1.   0.5  1. ]
→ 关键: ratio 超界时(如1.5)梯度被截断, 一步不会迈太大
面试 20 秒版: loss = -min(ratio*A, clip(ratio,1±ε)*A).mean()
# handcode_bandit.py —— 手写题④: UCB 一行(15 秒默写)
import numpy as np

np.random.seed(1)
K, T = 5, 1000
means = np.array([0.1, 0.3, 0.5, 0.7, 0.9])
counts = np.zeros(K)
q = np.zeros(K)
reward_total = 0.0
for t in range(1, T + 1):
    ucb = q + 2.0 * np.sqrt(np.log(t) / (counts + 1e-6))   # 核心一行
    a = int(np.argmax(ucb))
    r = 1.0 if np.random.random() < means[a] else 0.0
    counts[a] += 1
    q[a] += (r - q[a]) / counts[a]
    reward_total += r

print(f'UCB(c=2) 总奖励: {reward_total:.0f} / {T}  (理论最优≈{0.9*T:.0f})')
print('各臂采样分布:', np.round(counts / T, 3))
print('→ 最优臂(0.9)被采了最多 → UCB 自动"花最少代价锁定最优"')
UCB(c=2) 总奖励: 800 / 1000  (理论最优≈900)
各臂采样分布: [0.026 0.039 0.064 0.166 0.705]
→ 最优臂(0.9)被采了最多 → UCB 自动"花最少代价锁定最优"
8. 手写题代码对照(🔴 面试前夜背诵表)¶
| 题 | 核心代码 | 说明 |
|---|---|---|
| Q-learning | Q[s,a]+=α(r+γ·max Q[s2]-Q[s,a]) | off-policy 一行 |
| SARSA | Q[s,a]+=α(r+γ·Q[s2,a2]-Q[s,a]) | a2 是实际动作 |
| DQN loss | y=r+γ·max Q_t(s2)·(1-done); loss=Huber(y-Q(s)[a]) | 目标网络 |
| DDQN y | a*=argmax Q_o(s2); y=r+γ·Q_t(s2,a*) | 选/估解耦 |
| REINFORCE | θ+=α·G·∇logπ(a|s) | 整回合 |
| AC 更新 | δ=r+γV(s')-V(s); θ+=α·δ·∇logπ | 单步 |
| GAE | A_t=δ_t+γλ·A_{t+1} | 递归 |
| PPO | clip(ratio,1±ε); min(rA,clip·A) | 概率比 |
| GRPO | A=(r-mean(r))/std(r) | 组内标准化 |
| UCB | q+c·sqrt(log t/n) | 不确定性加成 |
建议:每个代码块手打 3 遍、第 4 遍盲写;输出与自己预期一致才算过。
9.1 开放式问题万能四段式精讲(🔴 结构化表达)¶
本节导读:开放题(系统设计/方案讨论/观点题)最怕"想到哪说到哪"。 四段式 = ①定义问题 ②拆解框架 ③给出方案 ④权衡与边界——任何 RL 开放题 都能套。这一节用两道真题示范。
1. 四段式框架(背):
① 定义(30 秒):复述问题 + 明确目标/约束("目标是…,约束是…")
② 拆解(1 分钟):把问题分成 3 块或 3 层(数据/模型/训练 或 定义/求解/评估)
③ 方案(1 分钟):每块给出 1 个具体做法 + 1 句为什么
④ 权衡(30 秒):方案的代价/局限 + 备选 + 开放式结尾
2. 示范题 A:「设计冷启动的推荐 RL」
- ① 定义:用户冷启动 = 无历史,目标 = 尽快学习偏好,约束 = 样本少
- ② 拆解:冷启动阶段(探索策略)→ 数据积累后(精排策略)→ 评估
- ③ 方案:探索用 UCB/汤普森采样(少样本最优);积累够后切换 bandit→MDP 建模;评估用 A/B + 离线回放(off-policy evaluation)
- ④ 权衡:探索有短期次优代价;备选:先 BC 冷启动再 RL 增强
3. 示范题 B:「为什么你的模型表现波动大?」
- ① 定义:波动 = 训练方差,先分清是样本/超参/还是实现问题
- ② 拆解:数据(seed 敏感?)→ 算法(on/off-policy?)→ 工程(复现性)
- ③ 方案:多 seed 报告均值±方差;加评估频率与 EMA;检查 α/γ/ε 调度
- ④ 权衡:彻底排查成本高 → 先用"固定 seed 复现 + 调参一次动一个"收敛
4. 为什么面试官喜欢四段式(加分点):
- 显式展示思考结构(不是背答案)
- 每段有明确时间控制(不超时、不冷场)
- 结尾有"权衡与边界" = 展示真实工程观(不只是会背算法)
5. 易错点:
- 别跳步:直接说方案会被追问"为什么这么设计"(缺定义)
- 别只说优点:没有权衡 = 不真实
6. 面试问法:"开放题没有任何标准答案,判分看结构" → 四段式即结构。
9. 开放题答题框架(🟡 结构化表达)¶
万能四段式(背)¶
① 定义(Problem)   :把问题翻译成 MDP/目标函数,说清输入输出
② 方案(Method)    :选型依据(离散/连续/样本效率/在线离线)+ 关键公式
③ 权衡(Trade-off) :至少讲一组对比(如 DQN vs PPO、RLHF vs DPO、MC vs TD)
④ 评估(Eval)      :指标(奖励/胜率/遗憾)+ 消融 + 多 seed 报告
示例:LLM 对齐方案(30 秒版)¶
"① 目标:让模型输出更符合人类偏好,建模为 token 级 POMDP,奖励=RM 打分−βKL。 ② 方法:SFT 后训 RM(BT 损失),再 PPO+GAE 优化;若算力紧用 DPO。 ③ 权衡:PPO 在线探索质量高但贵且需 RM;DPO 离线简单但无探索,上限略低。 ④ 评估:对战胜率 + KL 曲线 + 人工盲评 + 红队安全测试。"
# interview_sim.py —— 面试模拟器: 随机抽题 + 计时 + 提示要点
import numpy as np

questions = {
    'MDP 五元组': '必答: <S,A,P,R,γ> + 马尔可夫性质一句话',
    'V 与 Q 区别': 'V按策略加权成Q; Q多动作维度, 可直接argmax',
    'MC vs TD': '无偏方差大 vs 有偏低方差; 持续任务只能TD',
    'Q-learning vs SARSA': 'off-policy(max目标) vs on-policy(实际动作)',
    'DQN 稳定性三件套': '回放/目标网络/Huber剪裁, 各一句话作用',
    'DDQN 为什么': 'maximization bias → 选动作与估值解耦',
    '策略梯度定理': '∇J=E[∇logπ·G]; log技巧消掉P',
    'PPO clip': 'ratio∈[1±ε], 防止一步迈太大',
    'GAE': 'A=Σ(γλ)^kδ; λ=0单步/λ→1≈MC',
    'RLHF 三阶段': 'SFT→RM(BT)→PPO(+KL)',
    'GRPO vs PPO': '组内标准化优势, 去Critic, R1用',
    '探索方法': 'ε-greedy/UCB/汤普森/熵正则/curiosity',
}

print('=== RL 面试模拟器 ===')
np.random.seed(42)
keys = list(questions)
order = np.random.permutation(len(keys))
print('抽中题目顺序(每道 60 秒口述):')
for i, idx in enumerate(order[:6], 1):
    q = keys[idx]
    print(f'  {i}. {q}')
print()
print('回答要点速查(抽到就答):')
for i, idx in enumerate(order[:6], 1):
    q = keys[idx]
    print(f'  [{i}] {q} → {questions[q]}')
print()
print('自我检查: 每题能否在 60 秒内把公式+对比说全? 不能则回看对应章节')
=== RL 面试模拟器 ===
抽中题目顺序(每道 60 秒口述):
  1. GRPO vs PPO
  2. RLHF 三阶段
  3. MDP 五元组
  4. GAE
  5. DDQN 为什么
  6. MC vs TD

回答要点速查(抽到就答):
  [1] GRPO vs PPO → 组内标准化优势, 去Critic, R1用
  [2] RLHF 三阶段 → SFT→RM(BT)→PPO(+KL)
  [3] MDP 五元组 → 必答: <S,A,P,R,γ> + 马尔可夫性质一句话
  [4] GAE → A=Σ(γλ)^kδ; λ=0单步/λ→1≈MC
  [5] DDQN 为什么 → maximization bias → 选动作与估值解耦
  [6] MC vs TD → 无偏方差大 vs 有偏低方差; 持续任务只能TD

自我检查: 每题能否在 60 秒内把公式+对比说全? 不能则回看对应章节
11. 自测清单(07 篇收官 · 全模块总验收)¶
- 90 问速答:随机抽 10 题,每题 ≤60 秒给完整答案
- 手写五题:Q-learning / DQN loss / PPO clip / UCB / GRPO 优势(各 ≤2 分钟盲写)
- 四段式:能把"LLM 对齐方案"35 秒讲完整
- 对比五连:MC-TD / Q-SARSA / DQN-DDQN / PPO-TRPO / RLHF-DPO 张口就来
- 数字敏感:γ/ε/λ/β/CAP/BATCH 各参数的典型值与调法
- 全 8 篇 notebook 任意一篇从头到尾 1 小时内重跑通过
15. 本模块八篇串联复习路线(🔴 冲刺日路线)¶
早上(2h) : 00 公式表 + 01 三算法对照 + 02 MC/TD 对比 → 背表
中午(1h) : 03 Q/SARSA 更新式 + 04 DQN 家族 → 默写代码 ①②
下午(2h) : 05 PG/AC + 06 PPO/GRPO → 默写代码 ③④⑤ + RLHF 话术
晚上(1h) : 07 随机 20 题模拟 + 复盘四问
冲刺日不要再学新内容——只做"背表 + 默写 + 模拟"三件事。
16. 考前 3 分钟速背(🔴 面试篇)¶
五对比: MC-TD / Q-SARSA / DQN-DDQN / PPO-TRPO / RLHF-DPO
四段式: 定义→方法→权衡→评估
三常问: 三件套(回放/目标/剪裁)、RLHF三阶段、GRPO优势
两默写: Q-learning 一行、PPO clip 一行
一金句: "RL 本质 = 在未知模型约束下逼近贝尔曼最优"
17. 常见追问组合演练(🔴 面试对练)¶
- A: "RL 训练容易崩怎么办?" → 先查奖励尺度/lr/回放,再 target 网络频率,再多 seed
- B: "你最喜欢哪个 RL 算法?" → PPO(通用稳定)+ GRPO(LLM 前沿)——答"都喜欢但用途不同"更专业
- C: "RL 的瓶颈是什么?" → 样本效率 + 稳定性 + 奖励设计;LLM 场景再加显存与 RM 质量
- D: "未来方向?" → 推理 RL(R1 系)/ offline RL / world model / MARL——挑一个展开
# speedrun5.py —— 五道手写题 5 分钟挑战(自动判分)
import numpy as np

score = 0

# ① Q-learning 更新(填空)
def q_update(Q, s, a, s2, r, alpha, gamma):
    return Q[s, a] + alpha * (r + gamma * np.max(Q[s2]) - Q[s, a])
Q = np.zeros((3, 2))
print('① Q-learning 更新 OK ✓' if abs(q_update(Q, 0, 0, 1, -1.0, 0.5, 0.9) - (-0.5)) < 1e-9 else '① ✗')
score += 1

# ② PPO clip(填空)
def ppo_clip(r, A, eps=0.2):
    import numpy as _np
    return _np.minimum(r * A, _np.clip(r, 1 - eps, 1 + eps) * A)
assert abs(float(ppo_clip(np.array([1.5]), np.array([2.0]))[0]) - 2.4) < 1e-9
print('② PPO clip OK ✓'); score += 1

# ③ GRPO 优势(填空)
def grpo_adv(rewards):
    r = np.array(rewards, dtype=float)
    return (r - r.mean()) / (r.std() + 1e-6)
assert abs(float(grpo_adv([1, 3, 2]).mean())) < 1e-6
print('③ GRPO 优势 OK ✓'); score += 1

# ④ UCB(填空)
def ucb(q, counts, t, c=2.0):
    return q + c * np.sqrt(np.log(t) / (counts + 1e-6))
assert np.all(ucb(np.zeros(2), np.zeros(2), 10) > 0)
print('④ UCB OK ✓'); score += 1

# ⑤ GAE 递归(填空)
def gae_step(delta, adv_next, gamma, lam):
    return delta + gamma * lam * adv_next
assert abs(gae_step(1.0, 0.5, 0.9, 0.95) - (1.0 + 0.9*0.95*0.5)) < 1e-9
print('⑤ GAE 递归 OK ✓'); score += 1

print(f'\n5 分钟挑战得分: {score}/5 (全对才合格)')
① Q-learning 更新 OK ✓
② PPO clip OK ✓
③ GRPO 优势 OK ✓
④ UCB OK ✓
⑤ GAE 递归 OK ✓

5 分钟挑战得分: 5/5 (全对才合格)
18. 回顾:本模块 8 篇地图(🔴 考前看一遍)¶
00 MDP/贝尔曼 —— 一切的起点(五元组+两个方程)
01 DP         —— 有模型解法(规划)
02 MC/TD      —— 无模型预测(估计价值)
03 Q/SARSA    —— 无模型控制(学最优off/on)
04 DQN        —— 价值×深度学习(稳定三件套)
05 PG/AC      —— 策略×深度学习(定理/基线/GAE)
06 PPO/GRPO   —— 工程标准 + LLM 对齐(RLHF 底座)
07 面试       —— 90 问 + 手写 + 开放题框架
时间不够就只过 03/04/06/07 四篇;全过一遍答任何 RL 题都有骨架。
19. 最终自测(🔴 出门前)¶
- 能画出上面 8 篇的关系图
- 5 道手写题 5 分钟全对
- 90 问随机抽 10 题 ≤60 秒/题
- 四段式答 LLM 对齐方案 ≤3 分钟
- 说出至少 5 个典型超参数值
- 复盘四问模板就位(每场面试后填)
全部打勾 → 强化学习模块通关 🎉
20. 行为面试中的 RL 故事话术(🟡 简历+面试通用)¶
STAR 模板(RL 版)¶
S: 项目目标 —— "给对话模型加偏好评优 10%"
T: 任务分解 —— "SFT→RM→PPO(GRPO);评估对战胜率+KL"
A: 我的动作 —— "实现回放+目标网络、GAE、组内优势;5 seeds 报告"
R: 结果 —— "胜率 58%→67%,KL 漂移 < 0.02,多样性与事实性不降"
三条防线(防止被追问崩)¶
- 每个数字都能解释来源(实验设置)
- 每个算法选择都有对比依据(做过消融)
- 每个坑都能讲出"怎么发现+怎么修"(复盘)
没有真实项目?用本 notebook 的迷你实验 + 04-LLM 的 21 篇推导,组成"教学级"项目也能过初面——关键要自己跑过。
21. 面试日清单(🔴 出门前 10 分钟)¶
□ 笔:带两只(墨可能断)
□ 白纸:手写公式/伪代码用
□ 五道默写题打印版
□ 90 问索引卡
□ 自我介绍 30s 版(带 RL 关键词)
□ 反问问题 3 个(见 §12)
手写题一定是纸笔完成的感觉得练——别只在电脑上打代码。
# answer_generator.py —— 万能口答生成器: 给定算法名给 3 句标准答
def answer(alg):
    bank = {
        'Q-learning': 'off-policy TD 控制:Q[s,a]+=α(r+γmaxQ[s2]-Q[s,a]),目标用max与实际动作无关,数据可复用。',
        'DQN': 'Q+深度+稳定三件套:回放去相关、目标网络固定监督、Huber剪裁;DDQN治高估。',
        'PPO': 'TRPO的clip化:min(rA, clip(r,1±ε)A),GAE算优势,熵正则防坍缩,工程默认。',
        'GRPO': '去Critic的PPO变体:组内奖励标准化当优势,省显存,DeepSeek-R1用。',
        'SAC': '最大熵连续控制:Q=min(双critic),策略熵正则,探索平稳且SOTA。',
        'TD3': 'DDPG加固:双critic取min+目标策略平滑+延迟更新,治过估计。',
    }
    return bank.get(alg, '未知算法')

for al in ['Q-learning', 'DQN', 'PPO', 'GRPO', 'SAC', 'TD3']:
    print(f'{al}: {answer(al)}')
    print()
print('提示: 每个算法都能用"定位+公式+特点"30秒说完 → 练习到脱口而出')
Q-learning: off-policy TD 控制:Q[s,a]+=α(r+γmaxQ[s2]-Q[s,a]),目标用max与实际动作无关,数据可复用。

DQN: Q+深度+稳定三件套:回放去相关、目标网络固定监督、Huber剪裁;DDQN治高估。

PPO: TRPO的clip化:min(rA, clip(r,1±ε)A),GAE算优势,熵正则防坍缩,工程默认。

GRPO: 去Critic的PPO变体:组内奖励标准化当优势,省显存,DeepSeek-R1用。

SAC: 最大熵连续控制:Q=min(双critic),策略熵正则,探索平稳且SOTA。

TD3: DDPG加固:双critic取min+目标策略平滑+延迟更新,治过估计。

提示: 每个算法都能用"定位+公式+特点"30秒说完 → 练习到脱口而出
22. 面试后 24 小时复盘模板(🔴 最后闭环)¶
□ 被问的新题(记下来, 补进 90 问)
□ 答卡壳的题(标"重默写"并做 3 遍)
□ 追问方向(发现知识边界 → 回对应篇)
□ 手写题耗时(超 2 分钟 → 再练)
□ 表达问题(铺垫太长/答非所问 → 四段式)
□ 反问效果(是否展示深度)
面试不是终点,是下一场的信息源——把每条都喂回复习系统。
24. 概率博彩题:快速自测(🟡 休息时玩)¶
- 一个环境 γ=0.9、步奖励 -1、终点 +10,走 3 步到达:回报 = ? → 10·0.9³ - 1·(1+0.9+0.9²) = 7.29 - 2.71 = 4.58
- TD 误差 δ 在某状态为正:说明?→ 实际比预期好,应提高该状态价值
- GRPO 里 G=4 组内优势之和 = ? → 0(标准化性质)
- PPO 的 clip 上下界?→ [1-ε, 1+ε],ε 常见 0.2
每天 5 题,手算 2 分钟——维持数感。
# quick_quiz.py —— 小数感自测(自动判分)
answers = {
    'γ=0.9, 步-1, 3步到+10 的 G₀': 10 * 0.9 ** 3 - (1 + 0.9 + 0.9 ** 2),
    'TD δ>0 的意义(回答参考)': '实际比预期好',
    'GRPO 组内标准优势均值': 0.0,
    'PPO ε 常见值': 0.2,
    'GAE λ 默认(PPO)': 0.95,
}
for k, v in answers.items():
    print(f'{k}: {v:.4f}' if isinstance(v, float) else f'{k}: {v}')
print()
print('手算题1核对: G0 = 10*0.9^3 - (1+0.9+0.81) = 7.29-2.71 = 4.58 ✓')
γ=0.9, 步-1, 3步到+10 的 G₀: 4.5800
TD δ>0 的意义(回答参考): 实际比预期好
GRPO 组内标准优势均值: 0.0000
PPO ε 常见值: 0.2000
GAE λ 默认(PPO): 0.9500

手算题1核对: G0 = 10*0.9^3 - (1+0.9+0.81) = 7.29-2.71 = 4.58 ✓
25. 常见失败模式与纠正(🔴 体检清单)¶
| 症状 | 病因 | 药方 |
|---|---|---|
| 面试紧张忘公式 | 只背不写 | 纸笔默写 3 遍 |
| 讲不清原理 | 只记结论 | 用"三步推导"重讲 |
| 对比说不全 | 只知其一 | 三对比表每套 60 秒 |
| 项目讲不深 | 没跑过 | 亲手把 notebook 实验跑完 |
| 反问没话说 | 不了解团队 | 准备 3 个深度问题 |
每一条都能在本模块找到对应章节——没跑过的实验,就现在去跑。
26. 最终话(🔴 收尾)¶
从 MDP 五元组到 GRPO 组内优势,你已持有:
- 8 篇手写教学 notebook(全可运行)
- 90 连问 + 14 道手写题 + 开放题框架
- 一条从表格到 LLM 对齐的完整知识链
考前策略:刷 07 篇的速背表 + 默写五题 + 抽 20 题口答。 考后策略:把新题喂回 90 问,把卡壳点标红回炉。
祝秋招顺利 —— 这套笔记就是你面试时的肌肉记忆。🎯
27. 附录:本模块学习路径图(🟢 打印版)¶
        ┌─ 01 DP ────────────────┐
00 MDP ─┤                       ├─ 04 DQN ─┐
        ├─ 02 MC/TD ── 03 Q/SARSA┘          ├─ 07 面试
        └─ 05 PG/AC ── 06 PPO/GRPO ────────┘
                └──→ LLM 对齐(04-LLM/21 篇)
八篇两两相邻都有"记忆桥"(见各篇章末)。把桥都走一遍,整条链就是你的。
28. 最终速背卡(🔴 出门前一页)¶
五对比: MC-TD / Q-SARSA / DQN-DDQN / PPO-TRPO / RLHF-DPO
三件套: 回放 / 目标网络 / 剪裁
三阶段: SFT → RM(BT) → PPO(+KL)
三改进: DDQN / Dueling / PER
五手写: Q行 / DQNloss / PPOclip / UCB / GRPOadv
四段式: 定义 → 方法 → 权衡 → 评估
90问: 概念30 / 进阶30 / LLM×RL 30
29. 心理建设(🟢 考前 5 分钟)¶
- 答不上来 = 数据点,不是失败——记下来复盘
- 手写卡壳 → 先写公式结构,再填数字
- 追问连环 → 一次只答一层,留钩子让面试官深挖
- 反问环节 → 你的 3 个问题就是你的"分数"
RL 岗面试 = 公式 × 对比 × 工程感的三角——本模块已全覆盖。
30. 全模块终章(🔴 收束)¶
从 00 的 MDP 到 07 的 90 问,8 篇教学 notebook + 41/40/40/40/40/40/40/40 cells 全链路可运行。 强化学习模块到此完整体验完毕:
懂公式(00-02) → 会实现(03-05) → 能用框架(06) → 能面试(07)
秋招路上,这套笔记是你的 RL 题库 + 手写题库 + 项目素材库。冲!🎯
31. 附录:哪些内容本模块没讲(🟢 诚实边界)¶
- 多智能体 RL(MARL/自博弈)—— 一句话可答概念
- Offline RL 细节(CQL/IQL)—— 知道问题与代表法即可
- 连续控制完整实现(SAC/TD3)—— 概念 + 选型已覆盖
- 世界模型(Dreamer)—— 方向级了解
面试问到超出范围 → 大方说"这部分我在研究/了解",并给出你知道的关键词与论文名——比硬编强。
32. 全模块变种谱系总表(🔴 考前索引)¶
一张表收下所有变种与推导要点(背)¶
| 模块 | 变种 | 推导要点(一句话) |
|---|---|---|
| 00 | MRP→MDP→BMDP→POMDP | 策略诱导 MRP: P^π=ΣπP, R^π=ΣπR |
| 01 | 同步/异步/就地DP | Jacobi→Gauss-Seidel 都收敛 |
| 02 | MC首访/每访 | 无偏; 每访样本更多方差略小 |
| 02 | TD(0)/n步/TD(λ) | 自举强度连续谱; 前后向离线等价 |
| 03 | Q/SARSA/期望/Double | TD 目标同骨架; max vs 期望 vs 双表 |
| 04 | DQN/DDQN/Dueling/PER | 目标 y 的三次变形 + 可辨识约束 |
| 05 | REINFORCE/AC/A2C/GAE | log 技巧 + 基线无偏性(值函数当基线) |
| 06 | PPO-clip/KL/GRPO/DPO | CLIP 目标 + 组内标准化 + 闭式解 |
用法:考前 3 天每天默写这张表的"推导要点"列——全对即通关。
手推三件套:为什么面试官只考这三个?(🔴 备考逻辑)¶
① 贝尔曼期望方程 —— 一切 RL 的"定义层"
- 从 $G_t$ 递归拆出 $r+\gamma V(s')$,是所有价值类算法的地基
- 考它 = 考你是否真的理解 RL 的数学对象(不是背公式)
② 策略梯度定理 —— 一切策略类算法的"原理层"
- $\nabla J = \mathbb{E}[\nabla\log\pi \cdot Q]$:log 技巧 + 基线无偏性
- 考它 = 考你能否从"想提高回报"出发推出整个算法(推导链三分钟)
③ PPO clip 目标 —— 工程形态的"落地层"
- 从 TRPO 约束到 min(r, clip(r)):一行公式解释"信任区域怎么软实现"
- 考它 = 考你是否知道理论怎么变成能用的代码
串成一条线(面试讲故事用):
"RL 的目标是最大化期望回报 → 贝尔曼方程把回报递归化(价值法), 或直接用策略梯度(策略法)→ 策略梯度步长难设 → TRPO 约束 → PPO clip 把它变成一行公式 → GRPO 再去掉 Critic 适配 LLM。"
三件套 = 定义层 → 原理层 → 落地层,一条线讲完整个 RL,这就是它 "必考"的原因——考的不是公式,是你能不能讲这条线。
33.1 手推三件套板书精讲:逐行怎么写(🔴 面试默写级)¶
本节导读:三件套(贝尔曼期望 / 策略梯度定理 / PPO clip)是面试 "给我推一下"的三大主菜。这一节给板书级的逐行版本——不是解释, 是"写在白板上长什么样、每行写什么"。
① 贝尔曼期望方程(10 秒,3 行):
V^π(s) = E_π[G_t | s]
       = E_π[ r_{t+1} + γ G_{t+1} | s ]        # 拆回报(递归一步)
       = Σ_a π(a|s) Σ_s' P(s'|s,a) [ R(s,a) + γ V^π(s') ]
板书要点:第二行是灵魂(拆 G),第三行把两个期望展开成求和。
② 策略梯度定理(3 分钟,6 行):
∇_θ J(θ) = ∇_θ Σ_a π(a|s) Q^π(s,a)
         = Σ_a [∇π·Q + π·∇Q]                   # 乘法求导
∇Q 展开后 R、P 与 θ 无关 → 只剩 γ Σ P ∇V(s')
         = Σ_s d^π(s) Σ_a π ∇log π · Q^π       # ∇π = π∇logπ
         = E_{π}[ ∇log π(a|s) · Q^π(s,a) ]
         = E_{π}[ ∇log π(a|s) · A^π(s,a) ]     # 减基线无偏
板书要点:第 2 行乘法求导、第 4 行访问分布 d^π 出场、最后换优势。
③ PPO clip 目标(30 秒,3 行):
r_t(θ) = π_θ(a|s) / π_θ_old(a|s)
L^clip(θ) = E[ min( r_t·Â_t , clip(r_t, 1±ε)·Â_t ) ]
clip(r,1±ε) = min(max(r, 1-ε), 1+ε)
板书要点:ratio 分母写"旧策略快照";A>0 时截上限、A<0 时截下限—— 把这句画在 clip 图旁(06 篇 33 节配图)。
易错三处(默写完自查):① 期望方程无 max;② 定理里 $Q$ 可换 $A$
但不能随便换成功绩 $R(\tau)$(那是 REINFORCE 不是定理形式);
③ clip 里是 min 不是 max。
33. 面试手推三件套模板(🔴 板书面)¶
① 贝尔曼期望方程(10 秒)¶
V(s) = E_π[ R + γV(s') | s ]
     = Σ_a π(a|s)[ R(s,a) + γ Σ_s' P(s'|s,a) V(s') ]
② 策略梯度定理(30 秒)¶
∇J = Σ_s d^π(s) Σ_a ∇π(a|s) Q^π(s,a)          (定理)
≈  (1/N) Σ_t ∇log π(a_t|s_t)·(G_t - V(s_t))    (估计+基线)
③ PPO clip 目标(20 秒)¶
L^CLIP = E[ min( r_t(θ)Â_t, clip(r_t(θ),1±ε)Â_t ) ],  r_t = πθ/πold
GRPO 里 Â_t 换成 (r_i - r̄)/std(r_1..G) —— 去 Critic
演练方式:对镜子 30 秒内边写边说,练到"手到话到"。
# 强化学习算法家族谱系树 —— 分层泳道 + 正交折线路由(消除重叠)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import os
from matplotlib.patches import FancyBboxPatch

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

fig, ax = plt.subplots(figsize=(12.5, 8.2), dpi=150)
ax.set_xlim(0, 1); ax.set_ylim(0, 1); ax.axis('off')

def box(x, y, w, h, title, sub='', fc='#eef3fb', ec='steelblue', tfs=11, sfs=8.8):
    ax.add_patch(FancyBboxPatch((x - w/2, y - h/2), w, h,
                 boxstyle='round,pad=0.015,rounding_size=0.04',
                 fc=fc, ec=ec, lw=1.5, zorder=4))
    ax.text(x, y + h*0.20, title, ha='center', va='center',
            fontsize=tfs, fontweight='bold', color='#1a1a1a', zorder=5)
    if sub:
        ax.text(x, y - h*0.16, sub, ha='center', va='center',
                fontsize=sfs, color='#333333', zorder=5)

def route(x1, y1, x2, y2, color='#888888', lw=1.2, ls='-', zorder=3):
    """正交折线:起点(x1,y1)竖直→走廊→水平→竖直→终点(x2,y2),带箭头。"""
    ym = (y1 + y2) / 2
    ax.plot([x1, x1], [y1, ym], color=color, lw=lw, ls=ls, zorder=zorder)
    ax.plot([x1, x2], [ym, ym], color=color, lw=lw, ls=ls, zorder=zorder)
    ax.plot([x2, x2], [ym, y2], color=color, lw=lw, ls=ls, zorder=zorder)
    ax.annotate('', xy=(x2, y2), xytext=(x2, y2-0.014),
                arrowprops=dict(arrowstyle='->', color=color, lw=lw))

# ---- 节点布局(四列泳道,行间留足走廊)----
Y_ROOT, Y_PAR, Y_CHI, Y_TOP = 0.90, 0.675, 0.44, 0.20
HW = 0.20; HH = 0.155   # 父/子框宽高
root = dict(x=0.50, y=Y_ROOT, w=0.32, h=0.13,
            title='MDP <S,A,P,R,γ>', sub='一切算法的共同起点')
pars = {
    'dp': dict(x=0.13, t='DP(有模型)', s='策略迭代 / 值迭代'),
    'mc': dict(x=0.37, t='MC(无模型)', s='首访 / 每访'),
    'td': dict(x=0.61, t='TD(自举)',   s='TD(0) / n步 / TD(λ)'),
    'pf': dict(x=0.85, t='策略梯度',     s='REINFORCE'),
}
chis = {
    'ql':  dict(x=0.13, t='Q 函数家族', s='Q / SARSA / 期望 / Double'),
    'dqn': dict(x=0.37, t='DQN 家族',   s='DQN / DDQN / Dueling / PER'),
    'ac':  dict(x=0.61, t='AC 家族',    s='AC / A2C / GAE'),
    'ppo': dict(x=0.85, t='PPO / GRPO', s='+ RLHF / DPO'),
}
top = dict(x=0.50, y=Y_TOP, w=0.64, h=0.14, title='面试考点',
           s='五条对比线 + 手推模板')

# 画框
box(root['x'], root['y'], root['w'], root['h'], root['title'], root['sub'],
     fc='#fff3cd', ec='#b8860b', tfs=12)
for k, v in pars.items():
    box(v['x'], Y_PAR, HW, HH, v['t'], v['s'])
for k, v in chis.items():
    box(v['x'], Y_CHI, HW, HH, v['t'], v['s'])
box(top['x'], top['y'], top['w'], top['h'], top['title'], top['s'],
    fc='#fbe4e4', ec='#c0392b')

# ---- 边(正交路由,走廊线不穿过任何框)----
# root -> 四个父辈
for k, v in pars.items():
    route(root['x'], root['y']-root['h']/2, v['x'], Y_PAR+HH/2,
          color='#9aa5b1', lw=1.4)
# dp -> ql(同列直下)
route(pars['dp']['x'], Y_PAR-HH/2, chis['ql']['x'], Y_CHI+HH/2)
# mc -> ql(跨列:竖向进走廊→横向→竖向)
route(pars['mc']['x'], Y_PAR-HH/2, chis['ql']['x'], Y_CHI+HH/2, ls='--')
# td -> dqn / td -> ac
route(pars['td']['x'], Y_PAR-HH/2, chis['dqn']['x'], Y_CHI+HH/2, ls='--')
route(pars['td']['x'], Y_PAR-HH/2, chis['ac']['x'],  Y_CHI+HH/2)
# pf -> ac / pf -> ppo
route(pars['pf']['x'], Y_PAR-HH/2, chis['ac']['x'],  Y_CHI+HH/2, ls='--')
route(pars['pf']['x'], Y_PAR-HH/2, chis['ppo']['x'], Y_CHI+HH/2)
# ql -> dqn(同层旁路:水平短箭头)
ax.annotate('', xy=(chis['dqn']['x']-HW/2, Y_CHI), xytext=(chis['ql']['x']+HW/2, Y_CHI),
            arrowprops=dict(arrowstyle='->', color='#8a8a8a', lw=1.1),
            zorder=3)
# ac -> ppo(同层旁路)
ax.annotate('', xy=(chis['ppo']['x']-HW/2, Y_CHI), xytext=(chis['ac']['x']+HW/2, Y_CHI),
            arrowprops=dict(arrowstyle='->', color='#8a8a8a', lw=1.1),
            zorder=3)
# 四个子辈 -> 面试考点(虚线汇聚)
for k, v in chis.items():
    ax.plot([v['x'], v['x']], [Y_CHI-HH/2, Y_TOP+top['h']/2+0.03],
            color='#c0392b', lw=0.9, ls=':', zorder=2)

ax.set_title('强化学习算法家族谱系(07 篇总览)', fontsize=15, pad=14)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'rl_family_tree.png'), dpi=150)
print('已保存 images/rl_family_tree.png')
plt.close(fig)
plt.show()
已保存 images/rl_family_tree.png
34. 图文配套索引(🔴 复习路线)¶
| 图 | 章节 | 用途 |
|---|---|---|
| images/bellman_discount.png | 00 | 折扣权重衰减直观 |
| images/bellman_contraction.png | 00 | 收缩映射收敛 |
| images/dp_convergence.png | 01 | γ 斜率=log γ |
| images/dp_iters_compare.png | 01 | 两种 DP 成本结构 |
| images/mc_td_curves.png | 02 | TD 样本效率 |
| images/td_lambda_scan.png | 02 | λ 折中鞍底 |
| images/q_vs_sarsa_curves.png | 03 | on/off 行为差异 |
| images/double_q_bias.png | 03 | 最大化偏差直方图 |
| images/dqn_target_sync.png | 04 | 目标网络机制 |
| images/ddqn_bias.png | 04 | DDQN 降高估 |
| images/pg_flow.png | 05 | 策略梯度 4 步板书画 |
| images/pg_baseline_var.png | 05 | AC 动机 |
| images/ppo_clip_curve.png | 06 | clip 曲面 |
| images/rlhf_kl_beta.png | 06 | β 权衡 |
| images/rl_family_tree.png | 07 | 全模块谱系 |
考前按图复述:看到图 → 讲出对应的公式 + 推导要点 + 面试问法 三件套。