⚖️ 13-拉格朗日对偶与KKT¶
目标:把约束优化从「会解例子」提升到「懂原理」:拉格朗日乘子、KKT 四条件、对偶构造与互补松弛—— 这是 SVM、Lasso、正则化、强化学习(约束策略)背后共同的数学。面试考点:KKT 四条件默写、互补松弛的含义、slack。
§0 等式约束:拉格朗日乘子法¶
问题:$\min f(x)\ \text{s.t.}\ h(x)=0$。 引入乘子 $\lambda$:$L(x,\lambda) = f(x) + \lambda h(x)$。
核心几何:最优解处,目标等高线与约束曲线相切 → 两者法向平行 → $\nabla f(x^*) + \lambda \nabla h(x^*) = 0$。 (若不平行,沿约束移动一点还能继续降低 $f$。)
为什么是“乘子”:$\nabla f$ 与 $\nabla h$ 平行意味着存在 $\lambda$ 使二者线性相关——$\lambda$ 度量 f 对约束松紧的敏感度(= 影子价格,见 08 篇)。
核心概念¶
(a) 🗂️ 拉格朗日对偶与 KKT 知识地图¶
这篇是约束优化的收尾:用拉格朗日乘子法处理等式约束、KKT 四条件处理不等式约束,再回到对偶理论与对偶间隙,最后用坐标下降解 Lasso,点出 L1 稀疏性的几何与软阈值。
flowchart TB
    Node1["🧠 拉格朗日乘子法"]
    Node1 --> Node2["🧠 相切条件"]
    Node2 --> Node3["🧠 KKT 四条件"]
    Node3 --> Node4["🧠 互补松弛"]
    Node4 --> Node5["🧠 对偶问题构造"]
    Node5 --> Node6["🧠 对偶间隙"]
    Node6 --> Node7["🧠 坐标下降"]
    Node7 --> Node8["🧠 软阈值"]
    Node8 --> Node9["🧠 L1 vs L2 稀疏"]
- 节点1(拉格朗日乘子法):等式约束 min f s.t. h=0 转成无约束 L = f + λh,把"约束"变成"代价"加进目标;例子 min x₁²+x₂² s.t. x₁+x₂=1 的最优解就是圆与直线的相切点。
- 节点2(相切条件):最优解处目标等高线与约束线相切,梯度共线:∇f + λ∇h = 0;几何图 + 手算验证,λ 的符号和大小就是"约束的拉动力"。
- 节点3(KKT 四条件):不等式约束的最优解要满足:① 平稳性(梯度组合为 0)② 原始可行性(约束成立)③ 对偶可行性(乘子 μ ≥ 0)④ 互补松弛(μ·g = 0)。
- 节点4(互补松弛):约束拉紧(g=0)时乘子 μ > 0,约束空闲(g<0)时 μ 必须 = 0;"没被用满的约束不值钱",两个对照例子把它讲透。
- 节点5(对偶问题构造):把约束乘子变成对偶变量,构造对偶问题(min 对偶函数),回到 08 篇的对偶理论,形成"原问题-对偶问题"的统一视角。
- 节点6(对偶间隙):对偶最优值 ≤ 原问题最优值,差就是对偶间隙;凸问题(Slater 条件)间隙为 0(强对偶),机器学习里常用"弱对偶当下界、强对偶求最优"。
- 节点7(坐标下降):固定其它坐标只优化一个 w_j,循环往复;Lasso 的每一维子问题都有闭式解,所以坐标下降是解 Lasso 的标准算法。
- 节点8(软阈值):一维子问题 min ½(z−w)² + λ|w| 的闭式解是软阈值 w* = sign(z)·max(|z|−λ, 0):把 z 向 0 压 λ,|z| ≤ λ 直接置 0——"平底"正是稀疏性的来源。
- 节点9(L1 vs L2 稀疏):几何上 L1 约束是"菱形"、交点落在坐标轴上 → 稀疏;L2 约束是"圆"、交点一般不在轴上 → 不稀疏;KKT 视角再次确认"L1 在零点有角点"的本质。
§0.1 配图:拉格朗日乘子的几何¶
配一张经典示意图,把「相切」条件画出来:
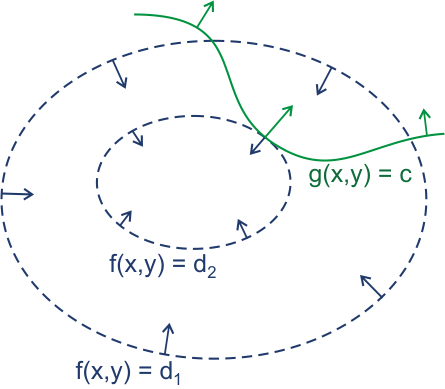
图注:拉格朗日乘子法的几何——目标等高线与约束曲线在最优解处相切, 两者的梯度方向平行(来源:Wikimedia Commons,公有领域)。
读图要点:
- 约束曲线(红色)限制了可行点只能在其上移动;
- 目标等高线(蓝色椭圆)沿曲线滑动时,$f$ 单调变化——只有相切处才是极值 (切点处沿约束方向移动 $f$ 不再一阶变化);
- 相切 ⟺ $\nabla f \parallel \nabla h$ ⟺ 存在 $\lambda$ 使 $\nabla f + \lambda\nabla h=0$。
🧩 一维直观:在约束线上走,$f$ 的「沿约束方向导数」= 0 的点就是候选极值, 代数上等价于梯度平行——这就是拉格朗日乘子法的全部几何。
§0.2 手算:min f=x₁²+x₂² s.t. x₁+x₂=1¶
目标:圆上离原点最近、且落在直线 $x_1+x_2=1$ 上的点。
拉格朗日函数:$L = x_1^2+x_2^2 + \lambda(x_1+x_2-1)$。
平稳性(对 x 求导置零): $$\partial_{x_1}: 2x_1+\lambda=0,\qquad \partial_{x_2}: 2x_2+\lambda=0 \ \Rightarrow\ x_1=x_2$$
约束:$x_1+x_2=1 \Rightarrow x_1=x_2=0.5$,代回 $\lambda=-2\times 0.5=-1$。
验证:$\nabla f=(1,1)$,$\nabla h=(1,1)$——平行 ✓;$f^*=0.5$。
📌 手撕要点:三步走——写 $L$ → 对每个 $x_i$ 求导置零 + 保留约束 → 联立解方程组。 乘子 $\lambda$ 的符号由「记号约定」决定(上式用 $+\lambda h$,代码用同一约定), 解出来是 -1 很正常;SVM 里常写 $\tfrac12\|w\|^2 - \sum \alpha_i y_i(w^\top x_i+b-1)$ 得到 $\alpha\ge 0$——对偶可行条件约定不同而已。
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False
from scipy.optimize import minimize

# ================= 拉格朗日乘子法:min f(x) s.t. h(x)=0 =================
# 例子:min f = x1² + x2²   s.t.  x1 + x2 = 1
#   几何:目标等高线是圆(越靠近原点越小),约束是直线 x1+x2=1
#   最优 = 圆与直线相切处 → 切点 (0.5, 0.5),f* = 0.5(投影最短距离问题)
f = lambda x: x[0] ** 2 + x[1] ** 2
h = lambda x: x[0] + x[1] - 1

# ---- 在最优解 (0.5, 0.5) 处验证相切条件 ∇f + λ∇h = 0 ----
x_star = np.array([0.5, 0.5])       # 圆与直线的切点(解析解)
gx = 2 * x_star                     # ∇f = 2x → (1, 1)
gh = np.array([1.0, 1.0])           # ∇h = (1,1)(约束系数)
lam_star = -gx[0] / gh[0]           # 由 2x1 + λ·1 = 0 解出 λ = -2x1 = -1
print('∇f + λ∇h =', gx + lam_star * gh, '(应为 0:梯度平行)')
assert np.allclose(gx + lam_star * gh, 0)

# ---- 对照:scipy SLSQP(工业级约束优化求解器) ----
res = minimize(f, [0.2, 0.5], constraints={'type': 'eq', 'fun': lambda x: x[0] + x[1] - 1}, method='SLSQP')
print('解析最优: [0.5 0.5]  f = 0.5')
print('SLSQP 数值解:', res.x, ' f = %.4f' % res.fun)
assert np.allclose(res.x, [0.5, 0.5], atol=1e-3)
print('对照通过:拉格朗日解析解 == SLSQP 数值解')

# ========== 图:等高线相切约束线 ==========
xs = np.linspace(-0.6, 1.4, 300)
Xs, Ys = np.meshgrid(xs, xs)
Fv = Xs ** 2 + Ys ** 2
fig, ax = plt.subplots(figsize=(6.8, 6.0))
cf = ax.contourf(Xs, Ys, Fv, levels=16, cmap='viridis_r')
fig.colorbar(cf, ax=ax, shrink=0.85)
ax.plot(xs, 1 - xs, color='white', lw=2, label='约束 x1+x2=1')
ax.plot(0.5, 0.5, '*', ms=17, color='#C44E52')
ax.annotate('最优 (0.5,0.5),等高线相切', xy=(0.5, 0.5), xytext=(0.72, 0.62),
            arrowprops=dict(arrowstyle='->', color='#C44E52'), fontsize=10, color='#C44E52')
ax.set_xlabel('x1'); ax.set_ylabel('x2')
ax.set_title('等式约束:最优处梯度与约束法向量平行', fontsize=12)
ax.legend(fontsize=9); ax.set_xlim(-0.6, 1.4); ax.set_ylim(-0.6, 1.4)
plt.tight_layout(); plt.show()
§1 不等式约束与 KKT 四条件¶
问题:$\min f(x)\ \text{s.t.}\ g_i(x)\le 0,\ i=1..m$(等式约束可并入)。
KKT 条件(约束规范成立时,$\bar x$ 最优 ⟺ 存在乘子 $\mu_i$ 满足):
| # | 条件 | 含义 |
|---|---|---|
| 1 | $\nabla f + \sum_i \mu_i \nabla g_i = 0$ | 平稳性:梯度被约束梯度线性表出 |
| 2 | $g_i(x) \le 0$ | 原始可行:解本身在可行域内 |
| 3 | $\mu_i \ge 0$ | 对偶可行:乘子不取负 |
| 4 | $\mu_i g_i(x) = 0$ | 互补松弛:约束拉紧($g_i=0$)才可能有 $\mu_i>0$;没拉紧 → $\mu_i=0$ |
互补松弛的直觉:只有「起作用」(active,$g_i=0$)的约束才产生“拉力”,不起作用的约束乘子必须为 0。 (对应到 SVM:只有支持向量($g=0$)的 $\alpha_i>0$,其余样本 $\alpha_i=0$。)
Slater 条件:凸问题里存在严格可行点($g_i(x)<0$)→ 强对偶成立 → KKT 是充要条件。非凸问题 KKT 只是必要条件。
§1.1 手算 KKT:一个约束被拉紧 vs 一个约束空闲¶
例 A:$\min (x_1-1)^2+(x_2-1)^2$ s.t. $x_1+x_2\ge 4$(写成 $g=4-x_1-x_2\le 0$)。
无约束最优 $(1,1)$ 处 $x_1+x_2=2<4$ → 不满足约束 → 最优被「顶」到边界 $x_1+x_2=4$。 对称性 → $x_1=x_2=2$,$g=0$(拉紧),平稳性 $2(x_1-1)+\mu(-1)=0 \Rightarrow \mu=2>0$ ✓。
例 B:$\min (x_1-0.5)^2+x_2^2$ s.t. $x_1\ge 0$($g=-x_1\le 0$)。
无约束最优 $(0.5,0)$ 已经满足 $x_1>0$ → 约束空闲 → 互补松弛要求 $\mu=0$。 平稳性 $2(0.5-0.5)+\mu(-1)=0 \Rightarrow \mu=0$ ✓,解就是 $(0.5,0)$。
对照:例 A 是「约束有效 → 乘子 > 0,解在边界」;例 B 是「约束无效 → 乘子 = 0,解在内部」—— 互补松弛条件 $g\mu=0$ 精确区分这两种情况。
📌 面试手撕套路:先求无约束解 → 看它是否满足约束 → 满足就直接是答案($\mu=0$);不满足就把约束当等式代入 KKT 求边界解。
# ================= KKT 四条件:两个对照例子 =================
# 例1:min f = (x1-1)² + (x2-1)²   s.t.  x1 + x2 >= 4(写成 g = 4-x1-x2 <= 0)
#   无约束最优 (1,1) 处 x1+x2=2 < 4 → 不满足约束 → 最优解被顶到边界 x1+x2=4 上
#   ⇒ 约束拉紧(g1=0),乘子 μ>0
f1 = lambda x: (x[0] - 1) ** 2 + (x[1] - 1) ** 2
g1 = lambda x: 4 - x[0] - x[1]      # 约束写成 g <= 0 的标准形式
# scipy 的 'ineq' 表示 fun(x) >= 0,所以传 -g1 = x1+x2-4 >= 0
res1 = minimize(f1, [0.0, 0.0], constraints={'type': 'ineq', 'fun': lambda x: -g1(x)}, method='SLSQP')
x1 = res1.x
# KKT 平稳性:∇f + μ∇g = 0 ⇒ 2(x1-1) + μ(-1) = 0 ⇒ μ = 2(x1-1)(x1=2 时 μ=2)
mu1 = 2 * (x1[0] - 1)
print('例1 解: [%.3f %.3f]  f = %.3f  g = %.2e' % (x1[0], x1[1], f1(x1), g1(x1)))
print('例1 KKT: ∇f = [%.2f %.2f] ,∇f + %.2f·∇g =' % (2*(x1[0]-1), 2*(x1[1]-1), mu1),
      2 * (x1 - 1) + mu1 * np.array([-1.0, -1.0]), '(μ=2 使之为 0)')
assert np.allclose(x1, [2, 2], atol=1e-3) and abs(mu1 - 2) < 1e-2   # 解在边界上、乘子>0

# 例2:min f = (x1-0.5)² + x2²   s.t.  x1 >= 0(写成 g = -x1 <= 0)
#   无约束最优 (0.5, 0) 已经有 x1=0.5 >= 0 → 约束根本没起作用(inactive)
#   ⇒ 互补松弛:g2 < 0 时 μ2 必须 = 0
f2 = lambda x: (x[0] - 0.5) ** 2 + x[1] ** 2
g2 = lambda x: -x[0]                # -x1 <= 0 ⟺ x1 >= 0
res2 = minimize(f2, [0.0, 0.0], constraints={'type': 'ineq', 'fun': lambda x: -g2(x)}, method='SLSQP')
x2 = res2.x
mu2 = 2 * (x2[0] - 0.5)             # 平稳性:2(x1-0.5) + μ(-1) = 0 ⇒ μ = 2(x1-0.5)
print('例2 解: [%.3f %.3f]  f = %.2e (无约束解 (0.5,0) 已满足约束 → μ=0)' % (x2[0], x2[1], f2(x2)))
assert np.allclose(x2, [0.5, 0], atol=1e-3) and abs(mu2) < 1e-2    # 约束不拉紧、乘子=0
print('对照通过:两个 KKT 例子的数值解与解析一致')
§2 对偶问题的更一般构造(回到 08 篇)¶
对原问题(拉格朗日函数对 x 取 inf):$g(\mu) = \inf_x L(x,\mu)$ → 对偶问题 $\max_{\mu\ge 0} g(\mu)$。
弱对偶永远成立(对偶值 ≤ 原值);强对偶(相等)在凸 + Slater 下成立。 KKT 的 1+3 正是“$x^*$ 与 $\mu^*$ 互为对偶最优”的显式写法;条件 4(互补松弛)让两面完全锁死。
在 ML 里:
- SVM:KKT → 只有支持向量的 α>0;对偶把约束写进目标,引出核技巧
- Lasso:软阈值解 = 一维子问题的 KKT(见下节)
- RL 约束策略优化(CPO):用拉格朗日对偶把「期望回报约束」写进目标函数,与 SVM 的处理同构
§2.1 对偶间隙与机器学习的关系¶
对偶间隙(duality gap)= 原问题最优值 − 对偶问题最优值。
- 凸 + Slater:间隙 = 0(强对偶),KKT 充要;
- 非凸:间隙 > 0,对偶只能给下界——这就是为什么深度学习的「对偶视角」只是分析工具而非求解器;
- 在 ML 中求解对偶问题的好处:约束写进目标(无约束化),变量维度常大幅降低 (SVM:原问题维度 = 特征数,对偶变量数 = 样本数 m),还能引出核技巧。
SVM 的完整 KKT 故事(面试必答):
- 原问题:$\min \tfrac12\|w\|^2$ s.t. $y_i(w^\top x_i+b)\ge 1$;
- 拉格朗日:$L=\tfrac12\|w\|^2 - \sum_i \alpha_i [y_i(w^\top x_i+b)-1]$;
- KKT 平稳性 → $w=\sum_i \alpha_i y_i x_i$(解只由 α>0 的样本组成!);
- 互补松弛 → $\alpha_i[y_i(w^\top x_i+b)-1]=0$:只有支持向量(恰好在间隔边界上)α>0;
- 对偶问题 $\max \sum_i\alpha_i - \tfrac12\sum_{i,j}\alpha_i\alpha_j y_i y_j x_i^\top x_j$ → 核技巧登场。
📌 把上面 5 步讲顺,等于把「KKT → SVM → 核」一条线串通了——这是 ML 面试的黄金考点。
§3 坐标下降与 Lasso(一维闭式解 = 软阈值)¶
Lasso:$\min_w \tfrac{1}{2}\|y - Xw\|^2 + \lambda \|w\|_1$
坐标下降:每次固定其他坐标只优化一个 $w_j$ —— 一维子问题有闭式解:
一维问题 $\min_w \tfrac{1}{2}(z - w)^2 + \lambda |w|$ 的最优解是软阈值算子: $$w^* = \operatorname{soft}(z, \lambda) = \operatorname{sign}(z)\cdot\max(|z|-\lambda, 0)$$
含义:把 $z$ 向 0 收缩 $\lambda$;缩不动了就置 0 —— 这就是 L1 产生稀疏解的机制(L2 里没有“置零”)。
为什么划算:每轮每个坐标一个 $O(m)$ 投影(可增量维护残差变 $O(1)$ 级联),几百轮就收敛 —— Lasso 大数据的标配。
# ================= 坐标下降求解 Lasso(手写 + sklearn 对照) =================
# 问题:min ½||y - Xw||² + λ||w||₁
# 坐标下降循环:固定其它坐标只优化 w_j。推导一句话:
#   记 r' = y - Σ_{k≠j} X_k w_k(残差暂时不含第 j 列),则一维子问题为
#   min_a ½||X_j||²·(a - z)² + λ|a|,其中 z = X_jᵀr'/||X_j||²
#   → 闭式解 a* = soft(z, λ/||X_j||²)(软阈值:把 z 向 0 收缩 λ/||X_j||²)
import numpy as np
from sklearn.linear_model import Lasso

def soft(z, lam):
    # 软阈值算子:min ½(z-w)² + λ|w| 的闭式解 w* = sign(z)·max(|z|-λ, 0)
    # 几何:把 z 向 0 压 λ;|z| ≤ λ 时直接置 0(左上图的“平底”= L1 稀疏性的来源)
    return np.sign(z) * np.maximum(np.abs(z) - lam, 0.0)

def coord_lasso(X, y, lam, iters=2000, tol=1e-9):
    m, p = X.shape
    w = np.zeros(p)
    r = y.copy()                            # 残差向量 r = y - X w,全程增量维护(O(m) 而非重算)
    for _ in range(iters):
        w_old = w.copy()
        for j in range(p):
            r = r + X[:, j] * w[j]          # ① 把 w_j 的贡献拿回 → r 暂时不含第 j 列(r')
            mj = X[:, j] @ X[:, j]          # ② 列平方范数 ||X_j||²
            z = (X[:, j] @ r) / mj          # ③ 一维最小二乘解(投影系数)
            w[j] = soft(z, lam / mj)        # ④ 软阈值闭式解(收缩量 = λ/||X_j||²,可能置零)
            r = r - X[:, j] * w[j]          # ⑤ 用新 w_j 更新残差,恢复不变量 r = y - X w
        if np.max(np.abs(w - w_old)) < tol: # 所有权重几乎不再变 → 已收敛,提前退出
            break
    return w

# ---- 数据:8 特征但只有 3 个真正有用 → 检验 Lasso 的稀疏性 ----
rng = np.random.default_rng(1)
m, p = 150, 8
X = rng.standard_normal((m, p))
w_true = np.array([1.5, 0, 0, -2.0, 0, 0.8, 0, 0])     # 支持集 {0,3,5}
y = X @ w_true + 0.1 * rng.standard_normal(m)
lam = 0.1

w_cd = coord_lasso(X, y, lam)
print('坐标下降 w:', np.round(w_cd, 4))
assert abs(w_cd[0] - 1.5) < 0.05 and abs(w_cd[3] + 2.0) < 0.05   # 非零坐标逼近真值

# ---- 对照:sklearn(同一问题的工业实现) ----
# sklearn 优化目标为 1/(2m)·||y-Xw||² + alpha·||w||₁,与我们写的 ½||·||² + λ||w||₁
# 差一个 1/m 尺度因子 → 令 alpha = λ / m 即可对齐(两边同乘 m)
# fit_intercept=False:sklearn 默认会拟合截距(内部把 X/y 中心化),那是另一个问题;
# 我们手写版不设截距,所以关掉它才能让两边目标完全一致地对比。
# tol=1e-8:收紧 sklearn 默认 1e-4 的收敛容差,保证两边都算到足够精确再比。
sk = Lasso(alpha=lam / m, max_iter=10000, tol=1e-8, fit_intercept=False).fit(X, y)
print('sklearn   w:', np.round(sk.coef_, 4))
dev = np.max(np.abs(w_cd - sk.coef_))
print('最大偏差: %.6f' % dev)
assert dev < 1e-3
print('对照通过:手写坐标下降 Lasso == sklearn Lasso(稀疏解保留 w0/w3/w5)')
§3.1 L1 vs L2:为什么 L1 出稀疏解(几何视角)¶
正则化问题 $\min \tfrac12\|y-Xw\|^2 + \lambda\,\|w\|_p$ 的几何(2 维示意):
- L2(岭回归):$\|w\|_2\le t$ 的可行域是圆,等高线与圆相切点几乎不可能恰好落在坐标轴上 → 权重被缩小但不置零;
- L1(Lasso):$\|w\|_1\le t$ 的可行域是菱形,顶点在坐标轴上——等高线与菱形相切 常常就切在顶点 → 对应坐标直接为 0 → 稀疏。
软阈值就是「一维 L1 投影」:$w^*=\operatorname{soft}(z,\lambda)$ 的几何是 把 $z$ 沿坐标轴方向压扁 $\lambda$——压过原点就停在 0(平底区间 $|z|\le\lambda$)。
📌 记忆:L2 圆滑、L1 尖角;尖角顶点在坐标轴上 → 稀疏。 面试画张 2D 图秒懂,比背公式强百倍。
§3.2 KKT 视角再看 Lasso¶
Lasso 等价于约束版 $\min \tfrac12\|y-Xw\|^2$ s.t. $\|w\|_1\le t$。 在最优解处常有约束拉紧($t$ 有效)→ 存在乘子 $\lambda\ge 0$,且 KKT 平稳性 对不可导点($w_j=0$)要换成次梯度条件:
$$0 \in X_j^\top (Xw-y) + \lambda\,\partial|w_j|,\qquad \partial|w_j| = \begin{cases}\{1\}& w_j>0\\ [-1,1]& w_j=0 \\ \{-1\}& w_j<0\end{cases}$$
这正是软阈值公式的来源:$w_j=0$ 要求 $|X_j^\top r|\le \lambda$—— 内积残差小于 $\lambda$ 的坐标被「钉」在 0。
🧩 一层比一层深:几何(菱形尖角)→ 一维闭式解(软阈值)→ 次梯度 KKT(钉零条件)。 面试从任一角度切入都能答,三者互相印证。
§4 面试追问与自测¶
- 默写 KKT 四条件;互补松弛怎么直观理解?(只有拉紧的约束才有乘子)
- 等式约束 ∇f∥∇h 与 KKT 平稳性的关系?(不等式是「线性表出」,等式是特例)
- 强对偶什么时候成立?(凸 + Slater)非凸为什么 KKT 只是必要条件?
- 软阈值算子从哪来?为什么 L1 会置零、L2 不会?(|w| 在 0 处不可导 → 角点解)
- Lasso 坐标下降每一轮为什么要拿回再投影?(增量残差)
自测清单
- 默写并解释 KKT 四条件(一字不差)
- 手写软阈值算子并讲出几何
- 手写坐标下降 Lasso 并与 sklearn 对齐(本讲断言 dev<1e-3)
- 说出 KKT 在 SVM / Lasso / 强化学习约束优化中的落点
至此经典优化算法线(08-13)完结:精确方法(LP/IP)→ 启发式(GA/SA/TS/PSO/ACO)→ 理论工具(KKT/对偶)。