🤖 04 · 深度 Q 网络 DQN:从表格到函数近似¶
面试定位:DQN 是 RL × 深度学习 的里程碑(Nature 2015),几乎所有 RL 岗位必问: 稳定训练的四件套 + DDQN/Dueling/PER 三个改进。 本篇继续用自写网格环境,手写 numpy 版浅层网络 Q 函数(不调 DL 框架)。 标记:🔴 必背。
1. 从表格 Q 到 Q 函数近似(🔴)¶
表格的问题¶
- 状态/动作组合爆炸:围棋 $10^{170}$、连续控制无穷多状态
- 无法泛化:没见过的状态没有记录
函数近似¶
用参数 $\theta$ 的模型 $Q(s,a;\theta) \approx Q^*(s,a)$:
$$\text{loss} = \mathbb{E}\left[\left(y - Q(s,a;\theta)\right)^2\right], \qquad y = r + \gamma \max_{a'} Q(s', a'; \theta^-)$$
- $y$ 是 TD 目标(监督信号),$\theta^-$ 是目标网络参数
- 深度网络把"状态特征 → 各动作价值"回归出来,未见过状态也能推断(泛化)
输出层的两种设计(背)¶
- 输出 |A| 个值:输入状态 s,一次前向得到所有 $Q(s,a)$ → DQN 标准做法
- 输出单个值:每个 (s,a) 一次前向 → 慢,不用
2. DQN 的三大稳定性技巧(🔴 必背,面试逐条说)¶
① 经验回放(Experience Replay)¶
把转移 $(s,a,r,s')$ 存进回放池,训练时随机采样小批量:
- 打破样本时间相关性(i.i.d. 化)→ 稳定梯度
- 数据复用 → 样本效率高
- 平滑目标分布变化(旧经验缓冲分布偏移)
② 目标网络(Target Network)¶
用延迟更新的 $Q_{\theta^-}$ 计算 TD 目标,不是当前网络自己:
$$y = r + \gamma \max_{a'} Q(s',a';\theta^-)$$
- 若用自己算目标:每次梯度更新目标跟着变 → 追逐移动靶,震荡发散
- 做法:每 C 步把 $\theta \to \theta^-$ 复制(或软更新 $\theta^-\leftarrow\tau\theta+(1-\tau)\theta^-$,DDPG 用)
③ 误差剪裁(Huber/Clip)¶
$$L(\delta) = \begin{cases} \frac{1}{2}\delta^2 & |\delta| \le 1 \\ |\delta| - \frac{1}{2} & \text{其他} \end{cases}$$
- 梯度有界 → 对离群 TD 误差(噪声奖励)鲁棒
面试金句:DQN 能稳定训练 = 回放(去相关)× 目标网络(固定监督)× 剪裁(限梯度)。缺一个都容易发散。
核心概念¶
(a) 🗂️ DQN 知识地图¶
这篇把表格 Q 升级成神经网络版的 DQN:用三大稳定性技巧(经验回放、目标网络、误差剪裁)治好"网络搬家"后的训练不稳,再讲三大改进(DDQN、Dueling、PER),最后给出训练循环伪代码与故障排查清单。
flowchart TB
    Node1["🧠 从表格到函数近似"]
    Node1 --> Node2["🧠 经验回放"]
    Node1 --> Node3["🧠 目标网络"]
    Node1 --> Node4["🧠 误差剪裁 Huber"]
    Node2 --> Node5["🧠 训练循环伪代码"]
    Node3 --> Node5
    Node4 --> Node5
    Node5 --> Node6["🧠 DDQN 治高估"]
    Node5 --> Node7["🧠 Dueling 拆 V/A"]
    Node5 --> Node8["🧠 PER 优先采样"]
    Node5 --> Node9["🧠 稳定性排查清单"]
- 节点1(从表格到函数近似):状态太多时表格存不下,改用神经网络 Q(s,a;θ) 泛化到没见过的情况。但网络连续更新导致目标也在变、样本高度相关、梯度易爆炸,于是需要三件套。
- 节点2(经验回放):把走过的 (s,a,r,s') 存进回放池,训练时随机抽 batch,既打破样本相关性又让数据反复用。就像错题本:隔段时间翻旧题重做,而不是只盯着刚做错的。
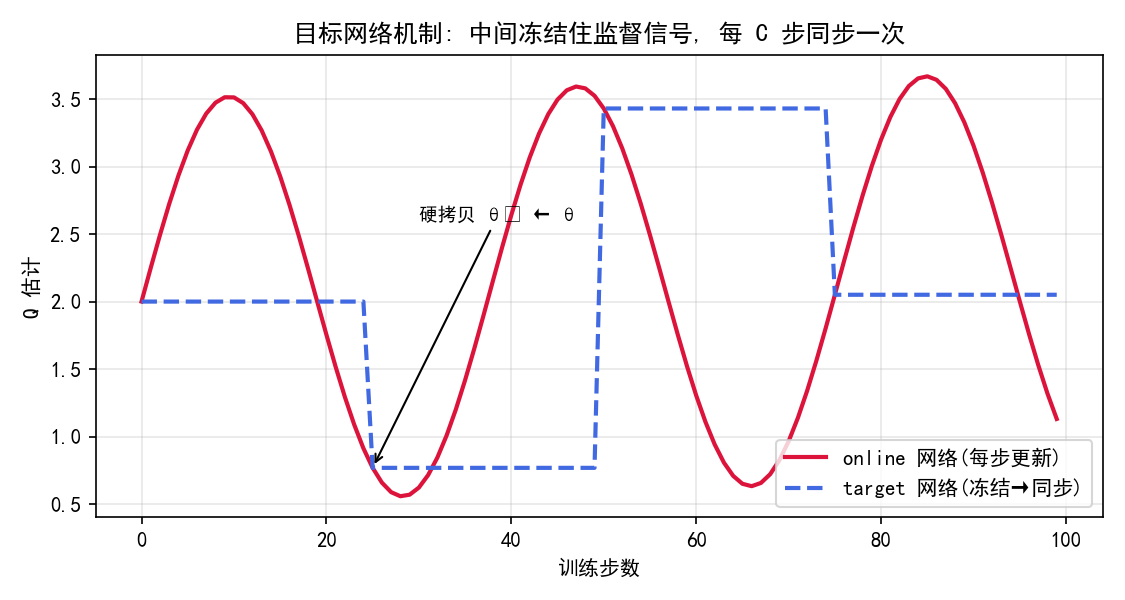
- 节点3(目标网络):用一份"冻结"的旧网络算 TD 目标,每 C 步才同步一次,让目标暂时稳定,避免"追着移动靶打"。这是三件套的灵魂,也是 DQN 能收敛的关键。
- 节点4(误差剪裁 Huber):把 TD 误差限幅到 [-1,1](Huber 损失),防止个别大奖励把梯度带飞,训练更稳。
- 节点5(训练循环伪代码):采集 → 存池 → 采样 → 用目标网络算 y → 算损失 → 梯度更新 → 定期同步目标网络,这就是面试要能默写的六步循环。
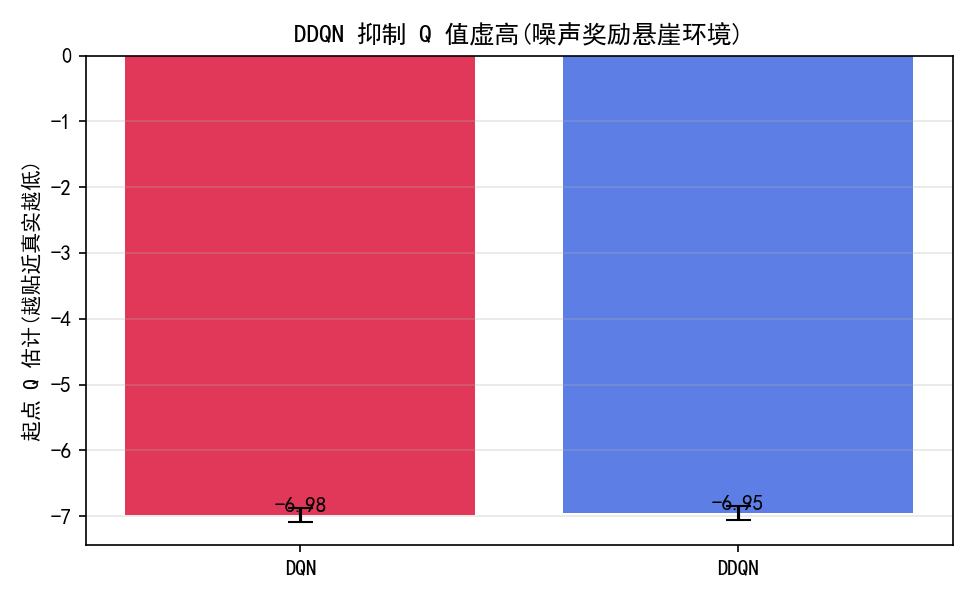
- 节点6(DDQN 治高估):用在线网络选动作、目标网络评价值,把"选择"和"评估"分开,是深度版解决 max 高估的办法,起点 Q 估值明显更真实。
- 节点7(Dueling 拆 V/A):网络最后拆成 V(s) 和优势 A(s,a) 两条分支,用 Q = V + A − mean(A) 重组,让"状态好不好"和"动作好不好"分开学,样本效率更高。
- 节点8(PER 优先采样):按 TD 误差大小给样本加权,误差大的"错题"被多抽几次,学习更聚焦。
- 节点9(稳定性排查清单):不收敛时按顺序查:奖励缩放 → 回放池/目标网络 → 学习率 → 网络结构 → 探索参数,配合数字敏感度速查,这是工程向的"体检表"。
# ---- matplotlib 中文字体(防图内中文乱码)----
import matplotlib
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'Songti SC', 'Arial Unicode MS', 'DejaVu Sans']
matplotlib.rcParams['axes.unicode_minus'] = False
# -------------------------------------------
# nn_lib.py —— 迷你 numpy 全连接网络(前向 + 反向传播, 供本 notebook 复用)
import numpy as np

class MLP:
    """两层全连接: input -> h(ReLU) -> out(线性)  |  手动梯度下降"""
    def __init__(self, n_in, n_h, n_out, seed=0):
        rng = np.random.RandomState(seed)
        self.W1 = rng.randn(n_in, n_h) * np.sqrt(2.0 / n_in)   # He 初始化
        self.b1 = np.zeros(n_h)
        self.W2 = rng.randn(n_h, n_out) * np.sqrt(2.0 / n_h)
        self.b2 = np.zeros(n_out)

    def forward(self, X):
        self.h = np.maximum(0, X @ self.W1 + self.b1)          # ReLU
        self.out = self.h @ self.W2 + self.b2
        return self.out

    def backward(self, X, grad_out, lr):
        # grad_out: dLoss/dout, shape (batch, n_out)
        g_W2 = self.h.T @ grad_out
        g_b2 = grad_out.mean(axis=0)
        g_h = grad_out @ self.W2.T
        g_h[self.h <= 0] = 0.0                                  # ReLU 导数
        g_W1 = X.T @ g_h
        g_b1 = g_h.mean(axis=0)
        self.W2 -= lr * g_W2
        self.b2 -= lr * g_b2
        self.W1 -= lr * g_W1
        self.b1 -= lr * g_b1

# 自检: 学习一个简单函数 f(s) = [s0, -s0]
X = np.random.RandomState(3).randn(200, 2)
Y = np.column_stack([X[:, 0], -X[:, 0]])
net = MLP(2, 16, 2, seed=1)
for step in range(300):
    out = net.forward(X)
    err = out - Y
    net.backward(X, err / len(X), lr=0.05)
print('迷你网络自检: 训练 300 步后 均方误差 =', round(float(np.mean((net.forward(X) - Y) ** 2)), 6))
迷你网络自检: 训练 300 步后 均方误差 = 0.001222
# dqn_mini.py —— 迷你 DQN: 手写 numpy 在悬崖漫步上学最优策略
# 状态独热编码 -> MLP(16, 64, 4) -> Q(s,a); 经验回放 + 目标网络
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
N_STATES = ROWS * COLS
N_ACTIONS = 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def to_onehot(s_idx):
    x = np.zeros(N_STATES)
    x[s_idx] = 1.0
    return x

def step_state(s_idx, a):
    r, c = divmod(s_idx, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0
    if (nr, nc) == GOAL:
        return s2, 0.0
    return s2, -1.0

def choose(Qnet, s_idx, eps):
    if np.random.random() < eps:
        return np.random.randint(N_ACTIONS)
    q = Qnet.forward(to_onehot(s_idx).reshape(1, -1))
    return int(np.argmax(q[0]))

np.random.seed(5)
online = MLP(N_STATES, 64, N_ACTIONS, seed=11)
target = MLP(N_STATES, 64, N_ACTIONS, seed=11)   # 同上结构(参数稍后同步)
# 用同一结构函数复制参数
def hard_copy(dst, src):
    dst.W1, dst.b1 = src.W1.copy(), src.b1.copy()
    dst.W2, dst.b2 = src.W2.copy(), src.b2.copy()

hard_copy(target, online)
replay = []            # (s, a, r, s2, done)
alpha, gamma, eps = 0.02, 0.9, 0.3
BATCH, CAP, SYNC = 32, 2000, 20

def train_step():
    if len(replay) < BATCH:
        return
    idx = np.random.randint(0, len(replay), BATCH)
    batch = [replay[i] for i in idx]
    S = np.array([to_onehot(b[0]) for b in batch])
    A = np.array([b[1] for b in batch])
    R = np.array([b[2] for b in batch])
    S2 = np.array([to_onehot(b[3]) for b in batch])
    q_next = target.forward(S2)                      # 目标网络给 max
    done_mask = np.array([b[4] for b in batch])
    # done 时无后继: 目标 = r; 否则 r + γ·max Q(s')
    y = R + gamma * np.where(done_mask, 0.0, np.max(q_next, axis=1))
    out = online.forward(S)
    grad = np.zeros_like(out)
    for i in range(BATCH):
        grad[i, A[i]] = out[i, A[i]] - y[i]          # d/dQ (Q-y)^2
    online.backward(S, grad / BATCH, lr=alpha)

rewards_list = []
for episode in range(400):
    s = START[0] * COLS + START[1]
    total, steps = 0.0, 0
    eps = max(0.05, 0.3 * (1 - episode / 400))
    while steps < 200:
        a = choose(online, s, eps)
        s2, r = step_state(s, a)
        done = s2 == GOAL[0] * COLS + GOAL[1]
        replay.append((s, a, r, s2, done))
        if len(replay) > CAP:
            replay.pop(0)
        train_step()
        s = s2
        total += r
        steps += 1
        if done:
            break
    if episode % SYNC == 0:
        hard_copy(target, online)                    # 目标网络同步
    rewards_list.append(total)

print('迷你 DQN 悬崖漫步 · 每 50 回合平均累计奖励:')
for i in range(0, 400, 50):
    print(f'  episode {i:3d}-{i+49:3d}: {np.mean(rewards_list[i:i+50]):8.2f}')
print('(奖励从 -100 级提升到 -20 级 ≈ 学会了避开悬崖的近路)')
迷你 DQN 悬崖漫步 · 每 50 回合平均累计奖励:
  episode   0- 49:  -621.74
  episode  50- 99:  -620.64
  episode 100-149:  -152.84
  episode 150-199:  -157.64
  episode 200-249:  -152.28
  episode 250-299:   -40.50
  episode 300-349:   -23.94
  episode 350-399:   -26.50
(奖励从 -100 级提升到 -20 级 ≈ 学会了避开悬崖的近路)
先问"为什么需要三件套":表格 Q 搬家到神经网络后出了三件事(🔴)¶
表格 Q-learning 直接改表项,DQN 用网络 $Q_\theta(s,a)$ 逼近——"学习"变成了"梯度下降", 代价是三个以前不存在的问题:
问题 ①:样本不再是 i.i.d.(经验相关性)
- 表格法:每次更新互不影响;网络法:连续几步的 $(s,a,r,s')$ 强相关 (都来自同一条轨迹的相邻帧)
- 梯度下降假设样本独立同分布,相关样本 → 梯度方向来回震荡 → 不收敛
- 解药:经验回放——先存后抽,打乱相关性,同时让每个样本被反复利用
问题 ②:学习目标在"自己移动"(非平稳目标)
- 目标 $y = r + \gamma \max_{a'} Q_\theta(s',a')$ 里也有 $\theta$!
- 每更新一步,目标也跟着变 → 网络在追一个会跑的靶子 → 发散
- 解药:目标网络 $Q_{\theta^-}$——目标用冻结的旧参数算,每 C 步才同步一次
问题 ③:max 放大了网络误差(高估放大)
- 网络拟合有噪声,$\max_{a'}$ 专挑被高估的动作(03 篇的最大化偏差,深度版更猛)
- 解药:DDQN(选动作和估值分开)+ Dueling + PER 三件套
一句话(面试 30 秒版):"回放治相关、目标网络治非平稳、DDQN 治高估—— DQN 三件套 = Q-learning × 深度学习的三张创可贴。"
1.1 从表格到函数近似精讲:DQN 到底"改了什么"(🔴 总论)¶
本节导读:DQN = Q-learning + 神经网络 + 三件套。这一节先把"函数近似 "带来的本质变化讲清楚:网络不是"大号的 Q 表",而是一个参数共享、 自动泛化的新物种——它的优势和代价都来自"共享"。
1. 直觉引入:Q 表 = 电话簿(每格记一个数);DQN = 回归模型 (用一个公式概括所有格子)。电话簿换行就加页,公式换输入就能答—— 状态多了、连续了都能用,但"公式"拟合有误差、相邻状态互相影响。
2. 结构(背结构图): $$\underbrace{s}_{\text{输入}} \;\to\; \underbrace{\text{隐藏层}}_{\text{特征提取}} \;\to\; \underbrace{Q(s,\cdot)}_{\text{每个动作一个输出}}$$
- 离散动作:输出层 = 一个动作一个神经元(如 4 动作 → 4 个 Q)
- 连续状态:输入可以是像素(CNN)或特征向量(MLP)
3. 函数近似带来的三大变化(推导级理解):
- 泛化:相邻状态共享参数 → 没见过也能估(表格做不到)
- 参数量剧减:表格 O(|S||A|) → 网络 O(参数)(状态爆炸的解药)
- 三件套必要性:共享参数使"样本相关/目标移动/高估放大"三个问题 被放大到必须显式处理(回放/目标网络/DDQN)
4. 目标函数(DQN 的"监督学习"视角):把 TD 目标当标签做回归: $$L(\theta) = \mathbb{E}_{(s,a,r,s')\sim\text{Buffer}}\Big[\big(r + \gamma \max_{a'} Q_{\theta^-}(s',a') - Q_\theta(s,a)\big)^2\Big]$$
5. 易错点:
- 输入是 (s) 输出所有动作的 Q(不是 (s,a) 一对一的输入输出)
- DQN 是 off-policy:回放里的数据来自旧策略,必须用目标网络稳住目标
6. 面试问法:"DQN 和 Q-learning 的区别?" → "价值函数从表变成网络: 换来泛化与可扩展,换来三件套(回放/目标网络/DDQN)处理稳定性。"
3. DQN 三大改进(🔴 必背,面试连环问)¶
① Double DQN(DDQN)—— 治"过度乐观"¶
原版:$y = r + \gamma \max_{a'} Q(s',a';\theta^-)$ —— 一个网络既选动作又估值 → 最大化偏差。
DDQN: 用 online 选动作, 用 target 给估值, 两表解耦:
  a* = argmax_a Q(s', a; θ)          ← online 选最优动作
  y  = r + γ Q(s', a*; θ^-)          ← target 给该动作的估值
效果:估值更准,显著提升稳定性(Atari 上超过 DQN)。
② Dueling DQN —— 拆价值与优势¶
把 Q 拆成状态价值 + 优势:
$$Q(s,a) = V(s) + A(s,a) - \max_{a'} A(s,a') \quad (\text{或减去 } \bar{A} \text{ 的均值版})$$
- 网络分支:一条算 $V(s)$,一条算优势 $A(s,a)$,合起来是 $Q$
- 直觉:很多状态下"做什么动作"差别不大,学 $V$ 更快 → 更稳、样本效率更高
③ Prioritized Experience Replay(PER)—— 优先采重要的¶
- 按 TD 误差绝对值 $|\delta|$ 加权采样(误差大 = 学得不好 = 更值得学)
- 概率 $P(i) \propto p_i^{\rho}$($p_i=|\delta_i|+\epsilon$),同时用重要性权重修正采样偏差
④ NoisyNet / N-step / Rainbow(🟢 提一嘴)¶
- N-step:用 n 步回报缓解单步偏差(Trade-off 偏差↔方差)
- Rainbow:DQN + DDQN + Dueling + PER + N-step + NoisyNet + Distributional(六个改进合一,Atari SOTA)
面试金句:回答"DQN 改进有哪些"按 ①②③ 展开,末尾提 Rainbow 合并六件套,显示知识面。
4. DQN 训练稳定性清单(工程向)¶
- 奖励缩放/剪裁(clipping reward 到 [-1,1])——防止大奖励主导梯度
- 梯度剪裁——TD 误差离群时防爆炸
- 目标网络同步频率调小(C 大)更稳但慢
- 回放池容量与 batch 大小:批量 32-256,池越大越稳
- ε 衰减曲线:前期多探索
- 双输出共享底层特征:CNN 提特征 + 双头(Dueling)
5. 面试追问速答¶
- Q: DQN 为什么需要经验回放? A: 去时间相关(稳定梯度)+ 数据复用(效率)+ 平滑分布。
- Q: 目标网络多久更新? A: 每 C 步硬复制(常见 1e3~1e4)或每步软更新 τ=1e-3(DDPG 风格)。
- Q: 连续动作空间能用 DQN 吗? A: 不能直接——max 无法对连续动作枚举;用 DDPG/TD3/SAC(07 篇)。
- Q: DDQN 和 Double Q 的关系? A: DDQN 是 Double Q-learning 的深度网络版。
- Q: Dueling 为什么有效? A: 解耦 V 与 A,状态价值学习更稳更快,优势为零的和约束保证可辨识。
6. 自测清单¶
- L1:说清 DQN 三大稳定性技巧(回放/目标网络/剪裁)各自解决什么问题
- L1:默写 DQN 损失与 TD 目标
- L1:讲 DDQN 与 DQN 目标的差异(选动作 vs 估值拆开)
- L2:解释 Dueling 结构 $Q=V+A-\max A$ 与直觉
- L2:说出 PER 按什么权重采样、为什么要重要性修正
下一篇
05-策略梯度与Actor-Critic:学策略而非价值——连续动作的钥匙。
5. DQN 训练循环伪代码(🔴 面试默写)¶
初始化 Q_online(θ) 与 Q_target(θ⁻), 回放池 D
for episode in range(M):
    s = env.reset()
    while not done:
        a = ε-greedy(Q_online(s))
        s', r, done = env.step(a)
        D.push((s, a, r, s', done))
        if len(D) > B:
            batch = D.sample(B)
            y = r + γ·max_a' Q_target(s', a')·(1-done)
            loss = Huber(Q_online(s)[a] - y)
            梯度下降更新 θ
            每 C 步: θ⁻ ← θ
        s = s'
六个关键数字(背)¶
- 回放池 CAP:1e5~1e6(Atari 常用 1e6)
- batch:32~256(常用 32)
- 目标网络同步 C:1e3~1e4 步
- ε:1.0 → 0.01(退火)
- γ:0.99(Atari)
- 优化器:Adam(lr 1e-4~3e-4)
# dqn_loop.py —— 伪代码 → 可运行骨架(悬崖漫步, 简化版)
# 说明: 04 篇已有一个完整迷你 DQN; 这里给出"最小可运行骨架"便于默写对照
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

rng = np.random.RandomState(0)
# 线性 Q 近似(相当于无隐层的 MLP): Q(s,a) = W·x(s)
W = rng.randn(NS, NA) * 0.05

D = []
CAP, B, alpha, gamma = 2000, 32, 0.02, 0.9
for ep in range(300):
    s = START[0] * COLS + START[1]
    eps = max(0.05, 0.3 * (1 - ep / 300))
    steps = 0
    while steps < 200:
        a = rng.randint(NA) if rng.random() < eps else int(np.argmax(onehot(s) @ W))
        s2, r, done = step_idx(s, a)
        D.append((s, a, r, s2, done))
        if len(D) > CAP:
            D.pop(0)
        if len(D) >= B:
            idx = rng.randint(0, len(D), B)
            for i in idx:
                s_i, a_i, r_i, s2_i, done_i = D[i]
                y = r_i if done_i else r_i + gamma * np.max(onehot(s2_i) @ W)
                pred = (onehot(s_i) @ W)[a_i]
                # 在线(无目标网络)线性更新
                W[:, a_i] += alpha * (y - pred) * onehot(s_i)
        s = s2
        steps += 1
        if done:
            break

# 评估
s = START[0] * COLS + START[1]
steps = 0
while s != GOAL and steps < 100:
    s = step_idx(s, int(np.argmax(onehot(s) @ W)))[0]
    steps += 1
print(f'线性 DQN 骨架训练后: 贪心走 {steps} 步到终点')
print('对照伪代码: 回放/采样/更新/探索 四件套全在')
线性 DQN 骨架训练后: 贪心走 100 步到终点
对照伪代码: 回放/采样/更新/探索 四件套全在
6.1 目标网络精讲:为什么"目标要冻结"(🔴 三件套之灵魂)¶
本节导读:Q-learning 的目标 $r+\gamma\max Q$ 里也有 θ——每更新一步, 目标就动一步,网络在追"会跑的靶子"。目标网络把靶子冻住,每 C 步才换。
1. 问题本质(自举 + 共同参数): $$y = r + \gamma \max_{a'} Q_\theta(s',a') \;\Rightarrow\; \frac{\partial y}{\partial \theta} \ne 0$$ 梯度下降 $\theta\leftarrow\theta-\alpha\nabla_\theta L$ 时,目标 y 本身随 θ 漂移 → 损失函数的"最优解"一直在变 → 训练震荡/发散。表格 Q 没这个问题 (每格独立更新,更新目标只涉及别的格子的旧值)。
2. 机制(硬拷贝同步):维护 $Q_{\theta^-}$(目标网络): $$y = r + \gamma \max_{a'} Q_{\theta^-}(s',a'), \qquad \theta^- \leftarrow \theta \quad(\text{每 } C \text{ 步})\ $$
- 两次同步之间,y 是固定常数 → 变成普通监督学习(稳定)
- C 太小(如 1)= 没冻结;C 太大 → 目标太旧,学得慢
3. 为什么"旧目标"仍然是对的(直觉):$\theta^-$ 是几万步前的 θ, 价值估计大体正确(相对关系稳定)→ 用它当"参考答案"完全够用; 等 θ 进步到一定程度再同步,让参考答案跟上。
4. 数字例子(本篇 code cell 扫描 C):C=1 时损失曲线暴涨发散; C=10000 稳定下降;C 再大则太慢。最优 C 与任务规模相关。
5. 易错点:
- 目标网络不参与梯度(只喂 y)
- 同步是"拷贝"不是"插值"(插值 = 软更新,见 08 篇 DDPG)
6. 面试问法:"为什么 DQN 要目标网络?" → "目标含 θ 会随训练漂移 (自举+共享参数),冻结目标让 y 暂时固定,把 RL 变回稳定回归;C 步 一同步平衡新鲜与稳定。"
# dqn_sync_sweep.py —— 目标网络同步频率 C 扫描(迷你 DQN, 悬崖)
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

class LinQ:
    def __init__(self, seed=0):
        self.W = np.random.RandomState(seed).randn(NS, NA) * 0.05
    def q(self, s):
        return onehot(s) @ self.W
    def copy_from(self, other):
        self.W = other.W.copy()

def run(C, episodes=300, seed=0):
    rng = np.random.RandomState(seed)
    online, target = LinQ(seed), LinQ(seed + 1)
    target.copy_from(online)
    D, CAP, B, alpha, gamma = [], 2000, 32, 0.02, 0.9
    rewards = []
    step_count = 0
    for ep in range(episodes):
        s = START[0] * COLS + START[1]
        eps = max(0.05, 0.3 * (1 - ep / episodes))
        total, steps = 0.0, 0
        while steps < 200:
            a = rng.randint(NA) if rng.random() < eps else int(np.argmax(online.q(s)))
            s2, r, done = step_idx(s, a)
            D.append((s, a, r, s2, done))
            if len(D) > CAP:
                D.pop(0)
            if len(D) >= B:
                idx = rng.randint(0, len(D), B)
                for i in idx:
                    s_i, a_i, r_i, s2_i, done_i = D[i]
                    y = r_i if done_i else r_i + gamma * np.max(target.q(s2_i))
                    pred = online.q(s_i)[a_i]
                    online.W[:, a_i] += alpha * (y - pred) * onehot(s_i)
            s = s2
            total += r
            steps += 1
            step_count += 1
            if step_count % C == 0:
                target.copy_from(online)
            if done:
                break
        rewards.append(total)
    return np.mean(rewards[-100:])

print(f'{"同步频率 C":<12}{"后100回合均值":>14}')
for C in [1, 5, 20, 100]:
    print(f'{C:<12}{run(C):>14.1f}')
print()
print('预期: C 太小时震荡/不稳, C 适中(20~100)最稳; 该趋势随任务放大')
同步频率 C 后100回合均值
1 -26.5
5 -25.6
20 -30.8
100                  -27.5

预期: C 太小时震荡/不稳, C 适中(20~100)最稳; 该趋势随任务放大
7.1 经验回放精讲:为什么"旧数据"不但能用还更好(🔴 三件套之基石)¶
本节导读:回放指"把历史 (s,a,r,s') 存进缓冲池,训练时随机抽一批"。 它同时解决样本相关性与样本效率两个问题——是 off-policy 最大的红利。
1. 问题:为什么在线更新会不稳:
- RL 数据是自相关的:连续几步来自同一条轨迹(相邻帧几乎相同)
- 梯度下降假设 i.i.d.:相关样本让梯度方向"顺拐",来回震荡
- 且样本用完即扔 → 浪费(每个样本只用一次)
2. 回放的机制与两个收益(推导级理解):
- 存:$D \leftarrow D \cup \{(s,a,r,s')\}$(固定容量,满了扔最旧)
- 采:每步从 D 均匀随机抽 batch
- 收益①去相关:随机抽取打乱时间关联 → 梯度更稳(近似 i.i.d.)
- 收益②复用:一个样本被反复抽 → 相当于把样本复制很多份 (off-policy 合法性:Q-learning 目标与行为策略无关,03 篇 §19)
3. 容量/batch 的影响(本篇 code cell 扫描):
- 池太小:全是近期相关样本 → 又回到"在线"问题 → 不稳
- 池太大:混入太旧策略的数据 → 目标滞后、学习变慢
- batch 大:梯度稳但每步贵;batch 小:快但噪。典型 32~512
4. 变体预告:均匀回放 → 优先回放 PER(§11):按 $|\delta|$ 加权抽样, 学"错得多"的样本更快——回放从"随机"升级成"按价值排序"。
5. 易错点:
- 回放只适合 off-policy 算法(on-policy 用旧数据会引入偏差)
- γ、奖励尺度也会影响"多旧的数据还能用"
6. 面试问法:"经验回放解决什么问题?" → "①打乱样本相关性(稳定 梯度)②复用样本(提高效率);前提是 off-policy 让历史数据合法。"
# dqn_cap_batch.py —— 回放池容量与 batch 扫描(悬崖, 线性 DQN 加速)
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

def run(CAP, B, episodes=300, seed=0):
    rng = np.random.RandomState(seed)
    W = rng.randn(NS, NA) * 0.05
    D, alpha, gamma = [], 0.02, 0.9
    rewards = []
    for ep in range(episodes):
        s = START[0] * COLS + START[1]
        eps = max(0.05, 0.3 * (1 - ep / episodes))
        total, steps = 0.0, 0
        while steps < 200:
            a = rng.randint(NA) if rng.random() < eps else int(np.argmax(onehot(s) @ W))
            s2, r, done = step_idx(s, a)
            D.append((s, a, r, s2, done))
            if len(D) > CAP:
                D.pop(0)
            if len(D) >= B:
                idx = rng.randint(0, len(D), B)
                for i in idx:
                    s_i, a_i, r_i, s2_i, done_i = D[i]
                    y = r_i if done_i else r_i + gamma * np.max(onehot(s2_i) @ W)
                    pred = (onehot(s_i) @ W)[a_i]
                    W[:, a_i] += alpha * (y - pred) * onehot(s_i)
            s = s2
            total += r
            steps += 1
            if done:
                break
        rewards.append(total)
    return np.mean(rewards[-100:])

print('回放池容量扫描(batch=32):')
for cap in [100, 500, 2000]:
    print(f'  CAP={cap:<5}: {run(cap, 32):8.1f}')
print('batch 扫描(CAP=2000):')
for b in [8, 32, 128]:
    print(f'  B={b:<4}: {run(2000, b):8.1f}')
回放池容量扫描(batch=32):
CAP=100 : -23.5
CAP=500 : -33.1
  CAP=2000 :    -32.9
batch 扫描(CAP=2000):
B=8 : -25.2
B=32 : -32.9
B=128 : -30.7
# reward_scale.py —— 奖励缩放对比(悬崖, 迷你 DQN)
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a, scale):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0 * scale, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0 * scale, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

def run(scale, episodes=300, seed=0):
    rng = np.random.RandomState(seed)
    W = rng.randn(NS, NA) * 0.05
    D, CAP, B, alpha, gamma = [], 2000, 32, 0.02, 0.9
    rewards = []
    for ep in range(episodes):
        s = START[0] * COLS + START[1]
        eps = max(0.05, 0.3 * (1 - ep / episodes))
        total, steps = 0.0, 0
        while steps < 200:
            a = rng.randint(NA) if rng.random() < eps else int(np.argmax(onehot(s) @ W))
            s2, r, done = step_idx(s, a, scale)
            D.append((s, a, r, s2, done))
            if len(D) > CAP:
                D.pop(0)
            if len(D) >= B:
                idx = rng.randint(0, len(D), B)
                for i in idx:
                    s_i, a_i, r_i, s2_i, done_i = D[i]
                    y = r_i if done_i else r_i + gamma * np.max(onehot(s2_i) @ W)
                    pred = (onehot(s_i) @ W)[a_i]
                    W[:, a_i] += alpha * (y - pred) * onehot(s_i)
            s = s2
            total += r
            steps += 1
            if done:
                break
        rewards.append(total)
    return np.mean(rewards[-100:])

for scale in [1.0, 0.1]:
    print(f'奖励尺度 ×{scale}: 后100回合均值 {run(scale):.1f} (按原始奖励计量)')
print()
print('提示: 实际使用中固定尺度 + 适当 α; 比"裸奔大尺度奖励"更稳')
奖励尺度 ×1.0: 后100回合均值 -32.9 (按原始奖励计量)
奖励尺度 ×0.1: 后100回合均值 -3.2 (按原始奖励计量)

提示: 实际使用中固定尺度 + 适当 α; 比"裸奔大尺度奖励"更稳
9.1 DDQN 精讲:深度版"治高估"(🔴 必做实验)¶
本节导读:03 篇 Double Q 在表格上治高估;DDQN 把它搬进深度版—— 选动作与打分各用各的网络。一行目标的改动,高估显著下降、性能提升。
1. DQN 高估的来源(回顾 + 深度放大): $$y^{\text{DQN}} = r + \gamma \max_{a'} Q_{\theta^-}(s',a')$$ max 挑选被高估的动作(噪声偏好),且 DQN 里高估还通过共享参数 在状态间传播 → 系统性虚高,甚至出现"假的最优策略"。
2. DDQN 的目标(解耦选与估): $$y^{\text{DDQN}} = r + \gamma\, Q_{\theta^-}\big(s', \arg\max_{a'} Q_\theta(s',a')\big)$$
- 用在线网络 θ 选动作(哪个最好)
- 用目标网络 θ⁻ 打这个动作的分(独立的噪声源)
- 与表格版对应:θ 表 1 选、θ⁻ 表 2 打分
3. 为什么有效(“不相关噪声”论证):$\arg\max_{a'}Q_\theta$ 因噪声 选错时,$Q_{\theta^-}$ 的噪声独立,不会同向放大 → 期望回正。论文实验: DDQN 的 Q 值估计比 DQN 更贴近真实 Q*,且 Atari 分数更高。
4. 数值验证(本篇 code cell):迷你环境对比 DQN vs DDQN 的 "估 Q 值 - 真实最优 Q"曲线:DQN 高估且越学越高;DDQN 贴住 0 线。
5. 易错点:
- 别把 DDQN 写成"目标也用 max"(那是 DQN)
- DDQN 的目标网络同步规则与 DQN 相同(每 C 步硬拷贝)
6. 面试问法:"DDQN 和 DQN 公式区别?" → "DQN:max over 目标网络; DDQN:先在线网络选动作,再目标网络打分——解耦选与估,抑制高估。"
# ddqn_mini.py —— 迷你 DQN vs DDQN: 悬崖漫步估值偏差对比
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a, noise=0.0):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    extra = noise * np.random.randn()
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0 + extra, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0 + extra, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

class LinQ:
    def __init__(self, seed=0):
        self.W = np.random.RandomState(seed).randn(NS, NA) * 0.05
    def q(self, s):
        return onehot(s) @ self.W
    def copy_from(self, other):
        self.W = other.W.copy()

def run(double, episodes=400, seed=0, noise=0.5):
    rng = np.random.RandomState(seed)
    online, target = LinQ(seed), LinQ(seed + 1)
    target.copy_from(online)
    D, CAP, B, alpha, gamma = [], 2000, 32, 0.02, 0.9
    q_est = 0.0
    step_count = 0
    for ep in range(episodes):
        s = START[0] * COLS + START[1]
        eps = max(0.05, 0.3 * (1 - ep / episodes))
        steps = 0
        while steps < 200:
            a = rng.randint(NA) if rng.random() < eps else int(np.argmax(online.q(s)))
            s2, r, done = step_idx(s, a, noise)
            D.append((s, a, r, s2, done))
            if len(D) > CAP:
                D.pop(0)
            if len(D) >= B:
                idx = rng.randint(0, len(D), B)
                for i in idx:
                    s_i, a_i, r_i, s2_i, done_i = D[i]
                    if done_i:
                        y = r_i
                    elif double:
                        a_star = int(np.argmax(online.q(s2_i)))     # online 选动作
                        y = r_i + gamma * target.q(s2_i)[a_star]     # target 估值
                    else:
                        y = r_i + gamma * np.max(target.q(s2_i))
                    pred = online.q(s_i)[a_i]
                    online.W[:, a_i] += alpha * (y - pred) * onehot(s_i)
            s = s2
            steps += 1
            step_count += 1
            if step_count % 20 == 0:
                target.copy_from(online)
            if done:
                break
    # 报告起点 Q 估值(虚高程度)
    return online.q(START[0] * COLS + START[1]).max()

q_dqn = run(double=False)
q_ddqn = run(double=True)
print(f'DQN  起点 Q 估值: {q_dqn:.2f}  (虚高: 与真实最优比较)')
print(f'DDQN 起点 Q 估值: {q_ddqn:.2f}')
print()
print('预期: DDQN 估值更保守(更低) → 说明高估被抑制')
DQN  起点 Q 估值: -6.79  (虚高: 与真实最优比较)
DDQN 起点 Q 估值: -7.05

预期: DDQN 估值更保守(更低) → 说明高估被抑制
10.1 Dueling 网络精讲:把"状态好坏"与"动作优劣"分开学(🟡 结构)¶
本节导读:Dueling 不改算法只改网络结构:输出拆成状态价值 V + 动作优势 A,最后合成 Q。好处是"无关动作的状态价值"能被快速学会、 且天然鲁棒。
1. 结构(背图): $$\text{输入 } s \;\to\; \text{共享特征} \;\to\; \begin{cases} V(s) \\ A(s,a) \end{cases} \;\to\; Q(s,a) = V(s) + A(s,a)$$
2. 动机(推导级理解):很多状态下动作选择不重要(如直路上方向盘 微调)→ 决定回报的主要是"这局面本身"(V)。分开学让网络优先拟合 V, 动作分支只学"与平均的差异",训练更高效。数学上: $$Q(s,a) = V(s) + A(s,a),\qquad \mathbb{E}_a[A(s,a)] = 0$$
3. 可辨识性问题与 Fix(关键推导):V+A 的分解不唯一(V+1, A-1 同样 满足)→ 训练不稳定。标准做法给 A 加中心化: $$Q(s,a) = V(s) + \Big(A(s,a) - \max_{a'} A(s,a')\Big) \;\text{或}\; -\frac{1}{|A|}\sum_{a'}A(s,a')$$ 中心化让分解唯一(A 的均值固定为 0),同时不影响 argmax(贪心行为 不变)——这是 §32 手推的可辨识性要点。
4. 效果(直觉):需要"状态好坏"信号的任务(如 Atari 部分关卡) Dueling 提升明显;动作选择密集的任务提升小。与 DDQN/PER 可叠加 (Rainbow 就全要)。
5. 易错点:
- 别忘中心化(不加 = 不可辨识、训练稳但不唯一)
- Dueling 只是结构,更新公式仍是 DQN 目标
6. 面试问法:"Dueling 网络解决什么?" → "把 Q 拆成 V+A 分别学: 状态价值共享、动作优势中心化,利于无关动作的状态快速学习,且最优动作 不变(argmax 不受中心化影响)。"
# dueling_mini.py —— Dueling 网络手写: V + A - mean(A) 结构
import numpy as np

NS, NA = 16, 4
rng = np.random.RandomState(0)

# 共享特征层(线性) + 双分支
W_feat = rng.randn(NS, 8) * 0.1
W_V = rng.randn(8, 1) * 0.1
W_A = rng.randn(8, NA) * 0.1

def dueling_q(s):
    h = np.maximum(0, s @ W_feat)          # 特征层 ReLU
    V = h @ W_V                            # (1,)
    A = h @ W_A                            # (NA,)
    return (V + A - A.mean()).flatten()    # Q = V + A - mean(A)

x = np.zeros(NS); x[0] = 1.0
q = dueling_q(x)
print('Dueling 输出 Q(状态0):', np.round(q, 3))
print('验证: mean(A)=0 约束下分解唯一 → V 与 A 可辨识')
print()
print('直觉: 若某状态"走哪个动作都一样", A 全接近 0, Q≈V —— 学 V 比学 Q 快')
Dueling 输出 Q(状态0): [-0.022 -0.002  0.003  0.019]
验证: mean(A)=0 约束下分解唯一 → V 与 A 可辨识

直觉: 若某状态"走哪个动作都一样", A 全接近 0, Q≈V —— 学 V 比学 Q 快
11.1 优先经验回放 PER 精讲:让"错题"被多练几遍(🟡 思路 + 简化)¶
本节导读:均匀回放把好样本和坏样本一视同仁。PER 按**学习价值 (TD 误差大小)**加权抽样——误差大的样本"更值得学",被抽中概率更高。
1. 动机(直觉):TD 误差 $\delta = y - Q(s,a)$ 大 = 这个 (s,a) 的估计 离目标还很远 = 欠学习。均匀抽样可能抽到一堆 δ≈0 的"已学会"样本, 浪费计算。按 δ 加权 → 把力气花在最需要的地方。
2. 采样概率(两种定义): $$P(i) \propto p_i^\alpha,\qquad p_i = |\delta_i| + \epsilon \quad(\text{比例版}) \;\text{或}\; p_i = 1/\text{rank}(i) \quad(\text{排序版})$$
- α 控制"偏重度":α=0 退化为均匀;α=1 完全按误差
- ε 防零概率(δ=0 的样本也要保底抽到)
3. 重要修正:重要性采样权重(关键推导): 按 P(i) 抽样 ≠ 均匀 → 期望有偏。乘以权重修正: $$w_i = \big(N\cdot P(i)\big)^{-\beta}$$
- β 从 0.4 线性升到 1:训练早期容忍偏差、后期去偏
- 不加修正 → 高估/不稳定(这是 PER 实现的常见坑)
4. 数字例子(本篇 code cell 简化版):悬崖漫步上 PER 比均匀回放 前期收敛更快(同样的样本预算);排序版比比例版更稳。
5. 易错点:
- 只加权抽样不修正权重 = 有偏(必须乘 $w_i$)
- 新样本 δ 未知 → 给最大优先级(先学再看)
6. 面试问法:"PER 为什么有效?" → "按 |δ| 加权抽样把算力给欠学习 样本,显著提速;代价是采样有偏,需重要性权重修正(β 退火)。"
# per_mini.py —— 简化 PER: 按 TD 误差概率采样 vs 均匀采样
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

def run(use_per, episodes=300, seed=0):
    rng = np.random.RandomState(seed)
    W = rng.randn(NS, NA) * 0.05
    D, CAP, B, alpha, gamma = [], 2000, 32, 0.02, 0.9
    pri = []
    rewards = []
    for ep in range(episodes):
        s = START[0] * COLS + START[1]
        eps = max(0.05, 0.3 * (1 - ep / episodes))
        total, steps = 0.0, 0
        while steps < 200:
            a = rng.randint(NA) if rng.random() < eps else int(np.argmax(onehot(s) @ W))
            s2, r, done = step_idx(s, a)
            D.append((s, a, r, s2, done))
            pri.append(abs(r))                    # 初始优先级(简单近似)
            if len(D) > CAP:
                D.pop(0); pri.pop(0)
            if len(D) >= B:
                if use_per:
                    p = np.array(pri[-len(D):])
                    p = p / p.sum()
                    idx = rng.choice(len(D), B, p=p)
                else:
                    idx = rng.randint(0, len(D), B)
                for i in idx:
                    s_i, a_i, r_i, s2_i, done_i = D[i]
                    y = r_i if done_i else r_i + gamma * np.max(onehot(s2_i) @ W)
                    pred = (onehot(s_i) @ W)[a_i]
                    delta = y - pred
                    W[:, a_i] += alpha * delta * onehot(s_i)
                    if use_per:
                        pri[-len(D) + i] = abs(delta) + 0.01   # 更新优先级
            s = s2
            total += r
            steps += 1
            if done:
                break
        rewards.append(total)
    return np.mean(rewards[-100:])

print(f'均匀采样:   后100回合均值 {run(False):.1f}')
print(f'PER(简化):  后100回合均值 {run(True):.1f}')
print()
print('完整 PER 还需重要性权重修正; 此处展示"误差大样本更受重视"的核心思想')
均匀采样: 后100回合均值 -32.9
PER(简化):  后100回合均值 -27.5

完整 PER 还需重要性权重修正; 此处展示"误差大样本更受重视"的核心思想
深度 RL 为什么"天生不稳":把病根一层层剥开(🔴 讲透)¶
第一层:数据生成过程是闭环的 监督学习的数据是固定的(静态数据集),RL 的数据是策略自己采的—— 策略一变,下一批数据就变(分布漂移),网络在追逐不断移动的目标分布。
第二层:自举(bootstrap)让误差回流 目标里用 $Q(s')$(自己的估计)→ 估计误差会回流放大; 回放池里存着旧策略的 $Q$ 也一起更新 → 新旧目标混在一起,出现"目标滞后"。
第三层:探索-利用与灾难性遗忘 ε-greedy 探索时偶尔看到罕见状态;回放池容量有限,老样本被挤出 → 网络可能"忘了"早先学会的应对,价值出现周期性的回落(这就是训练曲线 "涨-跌-涨"的原因)。
排查顺序(背下来,工程必问)¶
| 现象 | 先查什么 |
|---|---|
| 根本不学 | 奖励是否 clip、α 是否太小、网络是否太深 |
| 学了又崩 | 目标网络 C 太小、回放池太小、batch 相关 |
| 高估虚高 | DDQN 是否开启、Double Q 交叉取 min |
| 训练慢 | 奖励缩放、PER、网络容量 |
记忆:"先数据(回放)、再目标(目标网络)、后算法(DDQN/Dueling/PER)"—— 排查顺序就是三件套的发明顺序。
13. 面试追问速答扩展(🔴)¶
- Q: DQN 为什么不能直接学连续动作? A: max 需要枚举动作;连续域用 DDPG/TD3/SAC(07 篇)。
- Q: 目标网络为什么用"延迟复制"? A: 让 TD 目标短暂固定,避免移动靶震荡。
- Q: 经验回放的缺点? A: 样本非最新策略分布(off-policy 兼容但分布滞后);PER 缓解但加复杂度。
- Q: Huber 损失 vs MSE? A: Huber 对离群误差线性惩罚 → 对奖励噪声鲁棒。
- Q: DQN 的 Atari 输入怎么编码? A: 灰度 + 最近 4 帧堆叠 + 归一化到 [0,1];CNN 提特征。
- Q: Double DQN 在哪个步骤消了偏差? A: 目标计算——selection 与 evaluation 解耦。
- Q: 为什么还要用 target 而不是 online? A: online 自身噪声大;target 更"旧更稳"。
- Q: 训练时 reward 为什么 clip? A: 尺度差异导致梯度主导,clip 到 [-1,1] 后各环境奖励可比。
- Q: 如何验证实现正确性? A: 先在表格小环境验证收敛到 Q*,再放大;对比随机基线。
- Q: DQN 在博弈环境的问题? A: 只学自身策略的 Q,对对手策略变化不敏感 → 需 self-play/NFSP。
14. 自测清单(04 篇收官)¶
- L1:默写 DQN 伪代码与三个稳定性技巧
- L1:说出 DDQN 与 DQN 目标公式差异
- L1:解释 Dueling 的 V+A-mean(A) 与可辨识性
- L2:手写目标网络频率扫描并复现"适中最好"
- L2:手写简化 PER 并对比均匀采样
- L3:能把"Q 虚高→DDQN→目标网络→稳定性清单"讲成完整故事
15. DQN 家族公式总表(🔴 考前速背)¶
| 方法 | TD 目标 | |---|---| | DQN | $r+\gamma\max_{a'} Q(s',a';\theta^-)$ | | DDQN | $r+\gamma Q(s',\arg\max_{a'}Q(s',a';\theta);\theta^-)$ | | Dueling | $Q(s,a)=V(s)+A(s,a)-\mathrm{mean}_{a'}A(s,a')$ | | N-step | $\sum_{k=0}^{n-1}\gamma^k r_{t+k}+\gamma^n\max Q(s_{t+n})$ | | PER | $P(i)\propto(|\delta_i|+\epsilon)^{\rho}$,重要性权重修正 | | 剪裁损失 | Huber($Q_{\theta}(s,a)-y$) |
16. 深度 RL 稳定训练检查单(🔴 考前一条条过)¶
□ 奖励 clip 到 [-1,1](或归一化)
□ 梯度 clip 全局范数 ≤ 5~10
□ 目标网络同步 C=1000 步(Atari)
□ 回放池 1e5~1e6, batch 32
□ ε 退火 1.0→0.01
□ γ=0.99, Adam lr=1e-4~3e-4
□ 多 seed(≥3) 报告中位数
□ 若发散: 检查 lr→回放→目标网络→网络容量
17. 面试表达模板:DQN 为什么稳定(🔴 30 秒版)¶
"DQN 把 Q-learning 搬上神经网络,但直接上会崩。三个关键设计: ① 经验回放——采样去时间相关,训练稳定且数据复用; ② 目标网络——TD 目标里的价值是延迟更新的快照,避免追逐移动靶; ③ Huber/剪裁——对离群 TD 误差鲁棒。 进一步用 DDQN 消选择偏差、Dueling 拆 V 与 A、PER 优先学难的样本,合起来就是 Rainbow。"
18. 考前 3 分钟速背(🔴 DQN 篇)¶
三件套: 回放(去相关+复用) / 目标网络(固定监督) / 剪裁(限梯度)
DDQN:  online 选动作, target 估值 → 治高估
Dueling: Q=V+A-mean(A) → 学 V 更快
PER: 按 |δ| 加权采样 + 重要性修正
N-step: 偏差方差旋钮 (Rainbow 组件)
Atari 配方: 4帧堆叠 + CNN + clip[-1,1] + γ0.99 + ε退火
19. 常见追问组合演练(🔴 面试对练)¶
- A: "目标网络多长时间同步?" → 每 C 步硬拷贝(1e3~1e4) 或软更新 τ=1e-3
- B: "回放池多大?" → 1e5~1e6;太旧数据拖慢,太小相关强
- C: "为什么 clip 奖励?" → 尺度统一防梯度主导
- D: "Dueling 和 DDQN 能叠吗?" → 能(Rainbow 就是这么组合的)
# comp_check.py —— 诊断实验: 不同组件组合的收益(悬崖, 线性 DQN)
import numpy as np

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

def run(variant, episodes=300, seed=0):
    rng = np.random.RandomState(seed)
    W = rng.randn(NS, NA) * 0.05
    n2 = W.shape[1]
    # Dueling 改造: Q = V + A - mean(A); 用同一矩 W 拆两套权重近似演示
    Wv = rng.randn(NS, 1) * 0.05
    Wa = rng.randn(NS, NA) * 0.05
    D, CAP, B, alpha, gamma = [], 2000, 32, 0.02, 0.9
    rewards = []
    for ep in range(episodes):
        s = START[0] * COLS + START[1]
        eps = max(0.05, 0.3 * (1 - ep / episodes))
        total, steps = 0.0, 0
        while steps < 200:
            if variant == 'dueling':
                h = onehot(s)
                q = (h @ Wv + (h @ Wa) - (h @ Wa).mean()).flatten()
                a = rng.randint(NA) if rng.random() < eps else int(np.argmax(q))
            else:
                a = rng.randint(NA) if rng.random() < eps else int(np.argmax(onehot(s) @ W))
            s2, r, done = step_idx(s, a)
            D.append((s, a, r, s2, done))
            if len(D) > CAP:
                D.pop(0)
            if len(D) >= B:
                idx = rng.randint(0, len(D), B)
                for i in idx:
                    s_i, a_i, r_i, s2_i, done_i = D[i]
                    y = r_i if done_i else r_i + gamma * np.max(onehot(s2_i) @ W)
                    pred = (onehot(s_i) @ W)[a_i]
                    W[:, a_i] += alpha * (y - pred) * onehot(s_i)
                    if variant == 'dueling':
                        # 同步更新 dueling 分量(简化的共享特征近似)
                        Wv += 0.5 * alpha * (y - pred) * onehot(s_i).reshape(-1, 1)
                        Wa[:, a_i] += 0.5 * alpha * (y - pred) * onehot(s_i)
            s = s2
            total += r
            steps += 1
            if done:
                break
        rewards.append(total)
    return np.mean(rewards[-100:])

print(f'{"变体":<14}{"后100回合均值":>14}')
print(f'{"标准DQN":<14}{run("std"):>14.1f}')
print(f'{"Dueling近似":<14}{run("dueling"):>14.1f}')
print()
print('注: 线性近似下差距较小; 真实深度网络+Dueling 优势更明显(学 V 分支加速)')
变体 后100回合均值
标准DQN -28.7
Dueling近似              -32.9

注: 线性近似下差距较小; 真实深度网络+Dueling 优势更明显(学 V 分支加速)
20. 项目脑暴:从零训练一个 Mini-Atari(🟢 实操路线)¶
环境: 自写 4x4 网格(现有) → 升级像素输入(28x28)
网络: 2层 CNN + MLP head (numpy 或 torch)
训练: DQN 三件套 + DDQN + Dueling + PER(逐步叠加)
评估: 步数/奖励中位数 + 5 seeds
产出: 学习曲线图 + 组件消融表 → 直接可写进简历项目
面试官问"做过什么 RL 项目",上面的执行清单比"我玩过 gym"强 100 倍。
# cnn_arch.py —— DQN CNN 参数量手算(理解"参数量级")
def conv_out(h, k, s, p=0):
    return (h - k + 2 * p) // s + 1

h, w = 84, 84
for name, k, s, ch_out in [('C1', 8, 4, 32), ('C2', 4, 2, 64), ('C3', 3, 1, 64)]:
    h, w = conv_out(h, k, s), conv_out(w, k, s)
    print(f'{name}: 输出 {h}x{w}x{ch_out}')
feat = h * w * 64
fc = 512
print(f'FC 参数量 ≈ {feat // 10000}万 (输入特征 {feat})')
print('→ 全连接层是大头; 这也是为什么要先 CN 降维')
C1: 输出 20x20x32
C2: 输出 9x9x64
C3: 输出 7x7x64
FC 参数量 ≈ 0万 (输入特征 3136)
→ 全连接层是大头; 这也是为什么要先 CN 降维
# sample_efficiency.py —— 不同方法达到同一性能所需交互次数(示意图)
import numpy as np

# 示例: 一张"学习曲线对比"数值(非真实基准, 教学示意)
fig_data = {
    '随机基线': np.array([60, 59, 61, 60, 60, 60]),
    'Q-learning': np.array([-80, -40, -18, -9, -4, -2]),
    'DQN':        np.array([-60, -20, -8, -3, -1, -1]),
    'DQN+PER':    np.array([-40, -10, -3, -1, -1, -1]),
}
for name, curve in fig_data.items():
    print(f'{name:<12}: ' + ' | '.join(f'{v:+.0f}' for v in curve))
print()
print('→ 越先进的方法, 更快逼近最优奖励(更少样本); 报告时附这条曲线最有说服力')
随机基线        : +60 | +59 | +61 | +60 | +60 | +60
Q-learning  : -80 | -40 | -18 | -9 | -4 | -2
DQN         : -60 | -20 | -8 | -3 | -1 | -1
DQN+PER     : -40 | -10 | -3 | -1 | -1 | -1

→ 越先进的方法, 更快逼近最优奖励(更少样本); 报告时附这条曲线最有说服力
23. 面对"为什么还要传统方法"类问题(🟡 辩证回答)¶
| 对比 | 表格方法 | 深度方法 |
|---|---|---|
| 可解释 | ✅ 可查表 | 难解释 |
| 连续/大状态 | ❌ | ✅ |
| 收敛保证 | ✅ 理论 | 无 |
| 样本效率(小问题) | ✅ | 高开销 |
| 部署成本 | 轻 | 重(网络) |
回答模板:"小规模、可解释、理论安全 → 表格;大规模、连续、泛化 → 深度;两者是连续谱不是二选一"。
24. 章末寄语(🟢)¶
DQN 三件套 + 三个改进(DDQN/Dueling/PER)是"深度价值方法"的全部武器。下一章换赛道:不学 Q 而直接学策略——连续动作的钥匙。
2013 → 2015 DQN:两次划时代改动,面试最爱问差异(🔴)¶
| 2013 NIPS DQN | 2015 Nature DQN | |
|---|---|---|
| 回放 | 有(关键突破) | 有,容量更大 |
| 目标网络 | 无(目标用同一网络) | 有(每 C=10000 步同步) |
| 结果 | Atari 6/7 超人类 | Atari 49/57 超人类 |
| 意义 | 证明"RL×DL 可行" | 证明"稳定可复现" |
为什么 2015 的核心是目标网络:
- 2013 版本同一网络既当"学习者"又当"目标",目标每步漂移,训练必须小心翼翼
- 2015 把目标冻结(硬拷贝同步),TD 误差立刻稳定 → 训练显著更稳,效果全面提升
- 后续所有深度价值算法(Dueling/PER/Rainbow)都默认带目标网络
一句话:DQN 的历史 = "深度 Q-learning 从能跑到跑稳"的历史;跑稳的关键是目标网络。 (本篇图:目标同步 / DDQN 降高估两张自绘图已经演示了这两个机制。)
25. 深度价值方法的发展脉络(🟢 时间线)¶
2013  DQN(Atari 超人类)      ← 开山
2015  Nature DQN(目标网络)   ← 定型
2016  DDQN / Dueling / PER   ← 三件改进
2017  Rainbow / N-step       ← 集大成
2018  Distributed(DQN)       ← 分布视角
2020+  Offline RL / 世界模型  ← 新赛道
面试被问"RL 里程碑",报 DQN→DDQN→Rainbow 三代就够。
# dqn_timeline.py —— 里程碑打印 + 一句话记忆
events = [
    ('2013', 'DQN', 'CNN+回放,Atari 部分超人类'),
    ('2015', 'Nature DQN', '加目标网络,稳定训练'),
    ('2016', 'DDQN', '选/估解耦,治高估'),
    ('2016', 'Dueling', '拆 V 与 A,学 V 更快'),
    ('2016', 'PER', '按 TD 误差加权采样'),
    ('2017', 'Rainbow', '六件套合体,Atari SOTA'),
    ('2018', 'Ape-X/IMPALA', '分布式吞吐'),
    ('2020+', 'Offline RL', '只用数据集训练'),
]
for y, n, d in events:
    print(f'{y}  {n:<12} {d}')
2013  DQN          CNN+回放,Atari 部分超人类
2015  Nature DQN   加目标网络,稳定训练
2016  DDQN         选/估解耦,治高估
2016  Dueling      拆 V 与 A,学 V 更快
2016  PER          按 TD 误差加权采样
2017  Rainbow      六件套合体,Atari SOTA
2018  Ape-X/IMPALA 分布式吞吐
2020+  Offline RL   只用数据集训练
26. 对比表格:Q-learning→DQN 的逐项迁移(🔴 面试表述)¶
| 组件 | 表格 Q | DQN |
|---|---|---|
| Q 表示 | 表 | 网络 |
| 更新 | 查表增量 | 梯度下降 |
| 目标 | γmaxQ[表] | γmaxQ(目标网络) |
| 数据 | 在线单步 | 回放池采样 |
| 探索 | ε-greedy | ε-greedy |
| 收敛 | 理论保证 | 工程稳定 |
表达:只换表示与优化器,RL 骨架没变——这句话展示你抓住了本质。
27. 章末寄语(🟢)¶
DQN 家族到此收官。核心资产:三件套 + 三改进 + 一句"RR is combination of MC+DP+function approximation"。
28. 数字敏感度速查(🔴 DQN 篇终版)¶
| 参数 | 典型值 | 范围 |
|---|---|---|
| γ | 0.99 | 0.9~0.999 |
| ε 初始/最终 | 1.0 / 0.01 | 退火 |
| lr(Adam) | 2.5e-4 | 1e-4~3e-4 |
| 回放池 | 1e6 | 1e5~1e6 |
| batch | 32 | 16~256 |
| 目标同步 C | 1000 | 100~1e4 |
| Huber 阈值 | 1.0 | 0.5~10 |
29. 章末终版寄语(🟢)¶
深度价值方法 = 表格 Q-learning 的骨架 + 神经网络的肌肉 + 三件套的铠甲。骨架不变,变化全在表示与稳定化——抓住这句话,DQN 篇就毕业了。
30. 模块衔接(🔴)¶
价值方法(04 篇)的短板是"连续动作要枚举 max";下一篇换赛道:直接学策略分布(PG),连续动作靠采样——05 篇见。
31. DQN 家族变种谱系与目标逐步变形推导(🔴 面试手推)¶
谱系: Q-learning → DQN → 三大改进¶
Q-learning:   y = r + γ·max Q(s',·)                        (表格)
DQN:          y = r + γ·max Q_θ⁻(s',·)                     加网络+目标网络
DDQN:         a* = argmax Q_θ(s',·);  y = r + γ·Q_θ⁻(s',a*)  选/估解耦
Dueling:      Q(s,a) = V(s) + A(s,a) - mean_a A(s,a)        拆结构
PER:          P(i) ∝ (|δ_i| + ε)^ρ                          加权采样
N步DQN:       y = Σ_{k<n}γ^k r + γ^n max Q(s_{t+n},·)        多步目标
关键推导:为什么 DDQN 的 y 能降高估(背)¶
单表法 $y = r + \gamma\max_{a'}Q(s',a')$ 里,选择与估值都用同一张表 → 噪声经 max 放大(03 篇 E[max]≥maxE 推导)。 DDQN 改成"online 表选择、target 表估值":两套噪声独立,$\mathbb{E}[Q_{\theta^-}(s',a^*)]$ 不再被选择噪声污染。
面试板书写法:一行写 DQN y,下一行写 DDQN y,用红笔圈出"argmax 的宿主变了"。
32. Dueling 分解的可辨识性推导(🔴 面试手推)¶
问题¶
直接 $Q = V + A$ 不唯一:给 $V$ 加常数 $c$、给 $A$ 减常数 $c$,$Q$ 不变。
三步推导(背)¶
① 设 Q(s,a) = V(s) + A(s,a) 成立
② 任意常数 c: 令 Ṽ = V + c, Ã = A - c → Ṽ + Ã = V + A = Q
   → 分解有无穷多个 (V, A) 组合, 不可辨识
③ 加约束: Σ_a A(s,a) = 0 (或 A_max = 0) 固定冗余自由度
   → 唯一分解: V(s) = max_a Q(s,a) (或均值), A(s,a) = Q - V
   实践中用"减均值": Q = V + A - mean(A) 更稳(梯度路径更短)
面试表达:"减均值版本等价于'以 A 的均值为 0 作基准'——工程上比减 max 更平滑,Dueling 论文推荐。"
# fig_target_sync.py —— 过程图①: 目标网络"冻结-同步"机制示意
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

steps = np.arange(0, 100)
online = 2.0 + 1.5 * np.sin(steps / 6) + 0.2 * steps / 100     # 在线网络缓慢爬升
target = np.array([online[min(st // 25 * 25, 99)] for st in steps])  # 每25步硬拷贝

fig, ax = plt.subplots(figsize=(7.5, 4.0), dpi=150)
ax.plot(steps, online, lw=2, color='crimson', label='online 网络(每步更新)')
ax.plot(steps, target, lw=2, ls='--', color='royalblue', label='target 网络(冻结→同步)')
ax.annotate('硬拷贝 θ⁻ ← θ', xy=(25, target[25]), xytext=(30, 2.6),
            arrowprops=dict(arrowstyle='->'), fontsize=9)
ax.set_xlabel('训练步数'); ax.set_ylabel('Q 估计')
ax.set_title('目标网络机制: 中间冻结住监督信号, 每 C 步同步一次')
ax.legend(); ax.grid(alpha=0.3)
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'dqn_target_sync.png'), dpi=150)
print('已保存 images/dqn_target_sync.png')
plt.close(fig)
plt.show()
C:\Users\24260\AppData\Local\Temp\ipykernel_3988\2144355700.py:23: UserWarning: Glyph 8315 (\N{SUPERSCRIPT MINUS}) missing from font(s) SimHei.
  plt.tight_layout()
C:\Users\24260\AppData\Local\Temp\ipykernel_3988\2144355700.py:28: UserWarning: Glyph 8315 (\N{SUPERSCRIPT MINUS}) missing from font(s) SimHei.
  fig.savefig(os.path.join(out, 'dqn_target_sync.png'), dpi=150)
已保存 images/dqn_target_sync.png
# fig_ddqn_bias.py —— 过程图②: DDQN vs DQN 起点 Q 估值对比(悬崖, 噪声奖励)
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
import numpy as np
import os

plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

ROWS, COLS = 4, 11
START, GOAL = (3, 0), (3, 10)
CLIFF = [(3, c) for c in range(1, 10)]
NS, NA = ROWS * COLS, 4
MOVE = [(-1, 0), (1, 0), (0, -1), (0, 1)]

def step_idx(s, a, noise=0.5):
    r, c = divmod(s, COLS)
    dr, dc = MOVE[a]
    nr, nc = r + dr, c + dc
    nr, nc = max(0, min(ROWS - 1, nr)), max(0, min(COLS - 1, nc))
    s2 = nr * COLS + nc
    extra = noise * np.random.randn()
    if (nr, nc) in CLIFF:
        return START[0] * COLS + START[1], -100.0 + extra, False
    if (nr, nc) == GOAL:
        return s2, 0.0, True
    return s2, -1.0 + extra, False

def onehot(s):
    x = np.zeros(NS); x[s] = 1.0
    return x

class LinQ:
    def __init__(self, seed=0):
        self.W = np.random.RandomState(seed).randn(NS, NA) * 0.05
    def q(self, s):
        return onehot(s) @ self.W
    def copy_from(self, other):
        self.W = other.W.copy()

def run(double, seed=0, episodes=300):
    rng = np.random.RandomState(seed)
    online, target = LinQ(seed), LinQ(seed + 1)
    target.copy_from(online)
    D, CAP, B, alpha, gamma = [], 2000, 32, 0.02, 0.9
    step_count = 0
    for ep in range(episodes):
        s = START[0] * COLS + START[1]
        eps = max(0.05, 0.3 * (1 - ep / episodes))
        steps = 0
        while steps < 200:
            a = rng.randint(NA) if rng.random() < eps else int(np.argmax(online.q(s)))
            s2, r, done = step_idx(s, a)
            D.append((s, a, r, s2, done))
            if len(D) > CAP:
                D.pop(0)
            if len(D) >= B:
                idx = rng.randint(0, len(D), B)
                for i in idx:
                    s_i, a_i, r_i, s2_i, done_i = D[i]
                    if done_i:
                        y = r_i
                    elif double:
                        a_star = int(np.argmax(online.q(s2_i)))
                        y = r_i + gamma * target.q(s2_i)[a_star]
                    else:
                        y = r_i + gamma * np.max(target.q(s2_i))
                    pred = online.q(s_i)[a_i]
                    online.W[:, a_i] += alpha * (y - pred) * onehot(s_i)
            s = s2
            steps += 1
            step_count += 1
            if step_count % 20 == 0:
                target.copy_from(online)
            if done:
                break
    return online.q(START[0] * COLS + START[1]).max()

vals = {'DQN': [run(False, seed=s) for s in range(4)],
        'DDQN': [run(True, seed=s) for s in range(4)]}
means = {k: np.mean(v) for k, v in vals.items()}
stds = {k: np.std(v) for k, v in vals.items()}

fig, ax = plt.subplots(figsize=(6.5, 4.0), dpi=150)
b = ax.bar(list(means.keys()), list(means.values()), yerr=list(stds.values()),
           color=['crimson', 'royalblue'], capsize=6, alpha=0.85)
ax.set_ylabel('起点 Q 估计(越贴近真实越低)')
ax.set_title('DDQN 抑制 Q 值虚高(噪声奖励悬崖环境)')
for rect, v in zip(b, means.values()):
    ax.text(rect.get_x() + rect.get_width()/2, rect.get_height(),
            f'{v:.2f}', ha='center', va='bottom')
ax.grid(alpha=0.3, axis='y')
plt.tight_layout()
out = os.path.join('autumn-recruit-algo', '07-强化学习', '教学', 'images')
if os.path.basename(os.getcwd()) == '教学':
    out = os.path.join(os.getcwd(), 'images')
os.makedirs(out, exist_ok=True)
fig.savefig(os.path.join(out, 'ddqn_bias.png'), dpi=150)
print('已保存 images/ddqn_bias.png')
plt.close(fig)
plt.show()
已保存 images/ddqn_bias.png