本节要解决的问题
| 要解决的问题 | 对应内容 |
|---|---|
| VLM 和 VLA 到底差在哪一步?「动作」是怎么长出来的? | 核心概念 (a) + 深入原理 1 |
| 动作有哪些表示方法?离散 token、连续扩散、轨迹级各有何利弊? | 核心概念 (b) + 深入原理 1/4 |
| RT-1 / RT-2 / PaLM-E / OpenVLA / π0 / GR00T 各自的关键思想是什么? | 核心概念 (c) + 深入原理 2/3/4 |
| VLA 是怎么训出来的?「预训练 → 微调」管线怎么走? | 核心概念 (d) + 深入原理 5 |
| 换一台机器人还能用吗?RT-X / Open X-Embodiment 解决什么? | 深入原理 6 |
| 世界模型和视频预测在 VLA 里干什么?VLA 和 LLM Agent 有何异同? | 深入原理 7 |
| 能不能用 numpy 亲手写写 token 化、next-token 推理与扩散/流采样? | 代码实战 |
故事引入
多模态大模型「阿眼」一直是个优秀的「看图说话」选手:给它一张桌面照片,它能说出「桌上有一个红色杯子,旁边放着蓝色方块」——但仅此而已。工程师把它装进机器人后说:「光会说是没用的,你得伸手把杯子拿起来!」阿眼愣住了:它所有输出都是「文字」,而机器人需要的是「六个关节各自转多少度、夹爪张多大」。
这套「文字 » 动作」的翻译难题,催生了一整个研究家族:VLA(Vision-Language-Action model,视觉-语言-动作模型)。故事按时间线展开:
- RT-1 的发明(2022):工程师先把连续动作「量化」成有限个格子(比如每维 256 个),于是动作变成了「token」——和大模型里的文字其实是同一种东西!再用 Transformer 做 next-token 预测:「看图 + 听指令 → 预测下一个动作 token」。发明很简单:让机器人的手也学会说一种「动作语言」。
- RT-2 的跃进(2023):RT-1 里的视觉-语言部分还是自己从零训的小网络;RT-2 直接把动作 token 塞进预训练好的巨型 VLM 的词表里,让几十亿参数的「语言大脑」顺便学会输出动作——「动作也是词」。
- PaLM-E 的并行探索(2023):把视觉、机器人状态都变成 token 喂给语言模型,让 LLM 直接做具身推理。
- OpenVLA 的平民化(2024):7B 参数的开源 VLA,用 VQ-VAE 自动学习「动作字母表」,让动作表示不再靠手工分箱。
- π0 / GR00T 的「连续派」(2024 起):token 再细也有粒度损失;π0 用流匹配(flow matching)直接生成连续动作轨迹,GR00T 面向人形机器人输出全身动作。
阿眼的经历告诉我们一个道理:让大模型动手,关键不在模型多大,而在「把动作变成模型会处理的形式」——这一章我们就沿着这条线把每个环节讲透。
核心概念
(a) 🗂️ 从 VLM 到 VLA:多了一步「动作输出」
先给一个贯穿全章的工作定义:
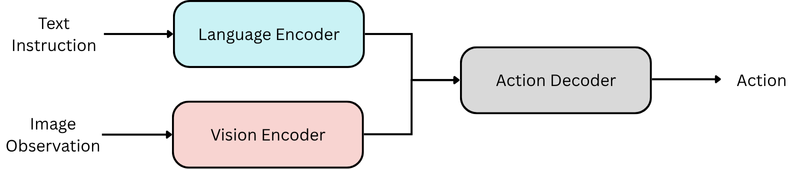
VLA(Vision-Language-Action model):以视觉-语言大模型(VLM)为骨干,输入「图像 + 语言指令」,输出「机器人动作」的多模态模型。它把感知和理解与动作生成统一进同一个网络的 next-token 预测(或连续生成)过程。
VLM 本来只会输出文字;VLA = VLM + 一条「动作车道」:
flowchart TB
    A["🧠 VLM<br/>看图 + 说话"] --> B["➕ 动作车道<br/>输出关节/末端动作"]
    B --> C["🎯 VLA<br/>视觉 + 语言 + 动作"]
    C --> D["🏭 预训练<br/>互联网图文/视频对齐"]
    D --> E["🤖 具身微调<br/>演示数据教动作"]
    E --> F["⚡ 推理<br/>看一眼 → 动起来"]
- VLM:现有的大模型能读图、能对话,但输出空间是「文本词表」,动作对它来说是外星球语言。
- 动作车道:给模型加一条输出通道,把机器人的连续动作表示成模型能生成的形态(离散 token、连续的扩散/流、或整条轨迹)。
- VLA:同一个网络同时做感知(图像)、理解(语言)、决策(动作),三者共享特征表示,这是 VLA 相对「感知系统 + 独立规划器」流水线的核心优势。
- 预训练:先在互联网图文/视频数据上把「视觉-语言对齐」学扎实——这是 VLA 泛化能力的来源(见过世界,才懂场景)。
- 具身微调:再用机器人演示数据(观察 → 动作)精调,教会模型输出与场景匹配的动作。
- 推理:部署时输入实时图像和指令,模型直接输出动作指令交给执行器;高频策略还会把「当前动作」作为下一时刻的上下文,形成闭环。
🕸️ 网络配图(Wikimedia Commons)
📷 来源:Wikimedia Commons · N · CC0
(b) 🗂️ 动作表示三流派:离散 token / 连续生成 / 轨迹级
「动作怎么表示」是 VLA 设计的第一个岔路口。三种流派各有拥趸,面试最爱问它们的取舍:
flowchart TB
    A["🎲 离散 token 派<br/>RT-1 / RT-2 / OpenVLA"] --> B["🅰️ 量化 + 动作词表<br/>均匀分箱 或 VQ-VAE"]
    B --> C["🧮 next-token 预测<br/>复用 LLM 架构"]
    D["🌊 连续生成派<br/>π0 / GR00T"] --> E["🛤️ 扩散 / 流匹配<br/>从噪声长出动作用轨迹"]
    E --> F["🖐️ 细腻连续动作<br/>高频、多自由度"]
    G["📼 轨迹级派<br/>先预测未来轨迹"] --> H["🎬 视频/关键帧预测<br/>再解码成动作"]
- 离散 token 派:把连续动作量化成有限个「动作字」,组成动作词表;模型在词表上做 next-token 预测。优点:完全复用 LLM 的成熟架构(softmax + 交叉熵);缺点:量化粒度损失(动作被「掐」成格子),高频细腻动作吃亏。
- 量化方式:RT-1/RT-2 用均匀分箱(每维 256 格),OpenVLA 用 VQ-VAE 学出码本(codebook)——让网络自己决定「动作字母表」长什么样,比手工分箱更贴合数据分布。
- 连续生成派:不量化,直接用扩散模型或流匹配生成连续动作轨迹。优点:无量化误差、能输出高频高维(人形几十个自由度)动作;缺点:生成式采样比自回归慢、训练更复杂。
- π0 / GR00T:π0 在预训练 VLM 上挂了「流匹配动作专家」,GR00T 面向人形机器人做全身动作生成,都属于连续派。
- 轨迹级派:先把「未来会发生什么」预测出来(未来视频/关键帧/轨迹),再从预测结果里解出动作——把「世界模型」请进来当中间层,可解释性强、能利用海量无动作标签的视频数据。
- 怎么选:机器人关节少(7 自由度夹爪)且设备简单 → token 派够用;人形(几十自由度)、需要高频精细控制 → 连续派;要利用互联网视频、强调「脑补未来」→ 轨迹级 + 世界模型。
(c) 🗂️ VLA 族谱:RT-1 → RT-2 → PaLM-E → OpenVLA → π0 / GR00T
按时间线和思想传承,主流 VLA 可以画成一张家谱:
flowchart TB
    A["🔬 RT-1 (2022)<br/>动作 token + Transformer"] --> B["🧠 RT-2 (2023)<br/>动作进词表,VLM 直接训"]
    C["🗣️ PaLM-E (2023)<br/>具身 VLM:世界皆 token"] --> B
    B --> D["📖 OpenVLA (2024)<br/>7B 开源 + VQ-VAE"]
    D --> E["🌊 π0 (2024)<br/>流匹配连续动作"]
    F["🦿 GR00T (2024)<br/>人形全身动作基础模型"] --> E
- RT-1:第一个把「动作 token + Transformer」串起来的机器人策略:8 维动作(手臂+夹爪)逐维量化成 token,用 FiLM 条件化注入语言/图像特征,做自回归动作预测。
- RT-2:把动作 token 直接加进 VLM 词表,用 PaLI-X / PaLM-E 级别的 VLM 在机器人数据 + 互联网数据上联合微调——模型一边补全「下一段文字」,一边学会补全「下一个动作」。
- PaLM-E:走「万物皆 token」路线:把图像、机器人状态向量都转成 token 塞进语言模型,让 LLM 做具身场景的推理与规划;它更像「会规划的具身 VLM」,动作最终由底层控制器执行。
- OpenVLA:7B 参数的开源 VLA(LLM 用 Llama-2-7B,视觉编码器用 SigLIP / DINOv2),动作用 VQ-VAE 离散化;因为开源,成为学术界复现、微调 VLA 的事实标准。
- π0:Physical Intelligence 的 VLA:预训练 VLM 主干 + 流匹配(flow matching)动作专家,直接生成连续动作轨迹,主打「高频、细腻、可泛化」,并支持 π0.5 这类更小的变体。
- GR00T:NVIDIA 的人形机器人基础模型:输入视频/语言/传感器,输出全身动作(Diffusion/Transformer 系架构),面向「一个模型驱动多种人形机器人」。
(d) 🗂️ VLA 训练管线与数据:先学说话,再学动手
VLA 的训练哲学和大模型如出一辙:先在互联网上当「通才」(预训练),再在机器人数据上当「专才」(微调):
flowchart TB
    A["📚 阶段 1:预训练<br/>互联网图文/视频"] --> B["🎯 阶段 2:具身微调<br/>演示数据 + 动作监督"]
    B --> C["🧪 阶段 3(可选)<br/>真实交互 / RL 微调"]
    C --> D["📦 数据规模化<br/>RT-X / Open X-Embodiment"]
    D --> E["🔁 跨具身泛化<br/>更多机器人 → 更好用"]
- 阶段 1 预训练:在互联网图文对、视频上训练 VLM——学「杯子长什么样、'拿'是什么意思」。动作数据昂贵稀缺,预训练让模型带着「世界知识」进入机器人领域,样本效率大幅提升。
- 阶段 2 具身微调:在机器人演示数据(观察图像 + 指令 + 动作)上进行监督微调:模型输出动作 token(或连续动作),与真值动作算损失。通常把机器人的互联网数据按比例混合,防止「灾难性遗忘」。
- 阶段 3(可选):微调后的策略放到仿真/真机上做强化学习(奖励来自任务成功与否)或人类反馈优化,进一步打磨成功率。
- 数据规模化:单手单机采集的演示数据太少;Open X-Embodiment(RT-X 背后的数据集)汇总了多种型号机器人的演示数据,让一个 VLA 见到「千万种手」。
- 跨具身泛化:数据里机器人长相各异、动作空间不同,需要把动作归一化/相对化(如用末端位姿差代替绝对关节角),模型才能学到「拿杯子」这个抽象技能而不是某台机器的肌肉记忆。
深入原理
1. 动作表示与 token 化:把「连续的手」翻译成「离散的词」
大白话直觉:机器人动作是一个连续向量(比如 8 维:手臂 6 个自由度 + 夹爪 + 手腕),连续值没法直接扔进词表做 softmax。办法是「打格子」:把每维 [-1,1] 的连续值切成 B 个格子,每个格子的编号就是一个 token——于是「动作」被翻译成了一串「词」,后面的一切就跟语言模型一模一样了。代价是量化误差:动作只能落在格子中心附近,B 越大越细腻。
数学刻画:
$$ a_i \in [-1,1]\ \longmapsto\ b_i = \Big\lfloor \frac{a_i+1}{2}\,B \Big\rfloor \in \{0,1,\dots,B-1\}, \qquad \mathbf{e}_j = \mathbf{E}[\,t_j\,] \in \mathbb{R}^{d} $$
其中 B 是每维格子数(RT-1/RT-2 取 256),t_j 是动作 token,E 是嵌入矩阵(把 token 变成向量),d 是嵌入维度。
推导 / 展开:
- 均匀量化(RT-1/RT-2):每维独立分箱,8 维动作 → 8 个 token;逆变换用格子中心重建:â = −1 + (b+0.5)·(2/B),重建误差上界为格子宽度的一半 1/B。RT-1 把离散化的 8 维动作作为序列输入 Transformer 做自回归预测。
- 学习式量化(VQ-VAE)(OpenVLA):不要手工分箱,让网络自己学码本 Z={e₁,…,e_K}:编码器把动作压成连续表征 z_e,取「离它最近的码本向量」z_q = argmin‖z_e−e_k‖,码本的索引就是 token。优劣:码本按数据分布自动生长,同样 token 数下重建精度更高;代价是要训练额外的编码器/解码器。
- 为什么都要转 token:VLA 的任务最终落到「词表上的分类问题」,LLM 的整套利器(softmax、交叉熵、KV-Cache、采样)全部可以直接复用,工程上极其顺滑。
- 代价:量化噪声对高频精细动作不友好;连续派(π0)正是冲着这一点来的。
面试怎么问:
Q:RT-1 是怎么把动作变成 token 的? A:把 8 维连续动作逐维均匀量化成 256 个 bin,每个 bin 的编号是一个 token,8 维动作变成 8 个 token,再用 Transformer 做自回归 next-token 预测。
Q:手动分箱和 VQ-VAE 学码本有什么区别? A:手动分箱均匀、简单但有量化误差且不贴合数据分布;VQ-VAE 的码本从数据中学习,同样的 token 数下重建精度更高,代价是多训练一套编码器/解码器和码本。
2. RT-1 与 RT-2:动作 token 与「动作即文本」
大白话直觉:RT-1 说「动作是一串特殊的词」,于是自研一个小 Transformer 来预测它们;RT-2 更狠——「动作就是词,直接加进语言模型的词表」,让几十亿参数的 VLM 在生成「下一段话」的同时学会生成「下一个动作」。模型仍然只会做一件事:看完上文预测下一个 token;只不过上文里多了图像,下文里混进了动作。
数学刻画:
$$ p(a_1^a,\dots,a_L^a \mid v,\,T)=\prod_{j=1}^{L} p\big(a_j^{\,a}\mid v,\,T,\,a_{<j}^{\,a}\big), \qquad \mathcal{L}_{\mathrm{act}} = -\sum_{j} \log p\big(a_j^{\,a}\mid \cdot\big) $$
其中 v 是图像(patch token 序列),T 是语言指令 token 序列,a^a_j 是第 j 个动作 token。
推导 / 展开:
- 序列构造:一次推理的输入序列 = 图像 patch token(视觉编码器输出) + 语言指令 token + 已生成的动作 token;输出是下一个 token 的分布。训练时把真值动作 token 放在序列末尾做监督。
- RT-1:视觉用 EfficientNet、动作预测用 Transformer,语言/图像特征通过 FiLM(特征级仿射调制)注入解码器——动作 token 由模型单独「翻译」,视觉-语言部分不算大模型。
- RT-2:把动作 token 扩充进 VLM 的词表(vocabulary),模型对「文字 token 和动作 token 一视同仁」做 next-token 预测;loss 是「语言任务 + 动作任务」的联合交叉熵。RT-2 建立在 PaLI-X / PaLM-E 这类巨型 VLM 之上,参数规模带来跨任务的迁移:用互联网数据让模型更懂「红色杯子」是什么,机器人任务表现也随之变好。
- 为什么「动作即文本」可行:机器人操作与语言共享高层语义(「拿」和 "pick up" 是同一个意图),把动作塞进词表等于强迫模型在「语言的世界模型」里找动作的对应物——这是 RT-2 泛化能力的关键假设。
- 推理差异:动作按 GPT 式自回归逐个 token 生成,可配合贪心/束搜索;生成完再做逆量化得到连续动作指令。
面试怎么问:
Q:RT-2 和 RT-1 的本质区别? A:RT-1 的动作 token 由专门训练的小 Transformer 预测,视觉-语言部分不是大模型;RT-2 把动作 token 直接扩进预训练 VLM 的词表,用几十亿参数模型做统一 next-token 预测,动作与语言共享同一套表示与知识。
Q:为什么说 RT-2 是「把动作当文本 token 在 VLM 上训练」? A:动词表扩充动作 token,训练目标是「文本 token 与动作 token 混合序列的交叉熵」——模型不会区分自己在写文字还是在写动作,动作与语言在一个 loss 里联合学习。
3. PaLM-E 与 OpenVLA:具身 VLM 与 VQ-VAE 动作量化
大白话直觉:PaLM-E 信奉「万物皆 token」——图像、机器人状态统统翻译成 token 塞进语言模型,让 LLM 直接做「看到什么、该干什么」的推理;OpenVLA 则把「动作字母表」升级成学出来的:用 VQ-VAE 让网络自己定义动作码本,LLM 负责在码本上「写动作作文」。
数学刻画(VQ-VAE 的量化与训练目标):
$$ z_q(x) = \arg\min_{e_k\in\mathcal{Z}} \big\| z_e(x) - e_k \big\|_2, \qquad \mathcal{L} = \underbrace{\big\| x-\mathrm{Dec}(z_q) \big\|^2}_{\text{重建}} + \underbrace{\big\| z_e - \mathrm{sg}(z_q) \big\|^2}_{\text{码本收敛}} + \beta \underbrace{\big\| z_q - \mathrm{sg}(z_e) \big\|^2}_{\text{commitment}} $$
其中 sg 表示停止梯度(stop-gradient),β 是 commitment loss 的权重。
推导 / 展开:
- PaLM-E:把多张图像的大 patch 化 token、机器人的关节角/末端位姿状态向量(甚至句子描述)一起映射成 token 序列喂给 PaLM 式 LLM;输出可以是自然语言规划、也可以是高级动作指令,由底层控制器执行。意义是证明「LLM 可以直接当具身大脑」,但与低层控制之间有间隙。
- OpenVLA:7B 开源 VLA——视觉编码器(SigLIP/DINOv2 类 ViT)输出图像 patch token,LLM 主干(Llama-2-7B 类)做自回归;关键改动是动作分支:演示数据里的连续动作轨迹先经过 VQ-VAE(编码→查码本→解码重建),训练好之后,动作状态变成一串码本索引 token,LLM 的任务就是预测这些索引。
- VQ-VAE 损失三件套:① 重建损失逼解码器把码本向量还原成动作;② 码本损失逼码本向量去贴近编码器输出(ema 更新更常用);③ commitment 损失逼编码器输出贴近码本、防止「码本空转」。训练稳定后,码本索引就是高质量的动作 token。
- 为什么开源重要:OpenVLA 让 VLA 从「巨头实验室黑盒」变成「可下载、可微调、可复现」的研究基座,社区在其上做了大量 LoRA 微调、少样本适应的工作。
面试怎么问:
Q:OpenVLA 的动作是怎么离散化的? A:用 VQ-VAE:先把连续动作经编码器压成表征,就近量化到学好的码本向量,码本索引作为动作 token 参与 LLM 自回归;VQ-VAE 用「重建 + 码本 + commitment」三部分损失联合训练。
Q:VQ-VAE 的码本是怎么学出来的?码本太大/太小会怎样? A:码本向量在训练中逐步靠近编码器输出(或用指数移动平均更新);太小 → 重建误差大、动作粗糙;太大 → 码本利用率低、模型学不动,通常取几百量级并结合 commitment loss 控制。
Q:PaLM-E 和 RT-2 有什么不同定位? A:PaLM-E 是「具身 VLM」,让 LLM 做场景理解与高级规划(输出语言/高层指令);RT-2 直接输出动作 token。业界后来的共识是两者思想融合进同一个框架(如闭源 Gemini Robotics、开源 π0 体系)。
4. π0 / GR00T:扩散与流匹配的连续动作
大白话直觉:token 是「把动作掰成格子」,再细也有锯齿。π0 换了一条路:不量化,直接生成连续动作轨迹。它用流匹配(flow matching)定义一个「从噪声/起点流向动作」的速度场,让网络学会这个速度场,推理时顺着场从 t=1 走回 t=0,就得到一条平滑连续的动作轨迹——像顺着水流把船从噪声开回目标。
数学刻画(流匹配):
$$ x_t = (1-t)\,x_0 + t\,x_1, \qquad \frac{dx_t}{dt} = v_\theta(x_t, t), \qquad \mathcal{L}_{\mathrm{FM}} = \Big\| v_\theta(x_t,t) - (x_1 - x_0) \Big\|^2 $$
其中 x₀ 是真实动作轨迹,x₁ 是噪声(或另一条轨迹),x_t 是二者的线性插值,vθ 是要学的速度场网络。
推导 / 展开:
- 流匹配的思想:把「生成」看成「把分布从噪声搬到数据」的确定性运输过程。对任意一对 (x₀, x₁),线性插值 x_t 的「正确速度」就是 x₁−x₀;网络只需回归这个速度场,极小化上式。推理时从 x₁~N(0,I) 出发,用欧拉法(或 RK4)积分 dx/dt=vθ 到 t=0,得到生成的动作轨迹。
- 与扩散模型(DDPM)的对比:扩散的前向过程是随机逐步加噪,逆过程是「逐步去噪」的马尔可夫链,通常需要几十到上千步;流匹配的前向是确定性线性插值,步数可大幅减少(几十步甚至更少),且对 ODE 求解器友好、训练目标更简单(直接回归速度而不是噪声)。
- 为什么 π0 选连续生成:人形/仿生动作多自由度(几十维)、高频(几千赫兹量级控制周期),量化成 token 会丢掉细腻度;连续流直接输出高频动作轨迹,还可融入「动作=头部姿态+手部+语言」的多模态条件。
- GR00T 与后续:GR00T 面向人形机器人,输入视频/语言/传感器、输出全身动作,同样采用生成式(扩散/Transformer)路线;2024 后的趋势是「VLM 主干 + 动作解码专家」的分工:VLM 负责理解世界,动作专家负责细腻输出。
面试怎么问:
Q:π0 为什么用 flow matching 而不是 token 化?两者利弊? A:token 化有量化误差且每个 token 是离散分类,高频高维连续动作会「发毛」;流匹配直接回归速度场生成连续轨迹,无量化损失、采样步数少。代价是生成式采样比自回归慢、训练管线更复杂。
Q:flow matching 和扩散模型的区别? A:扩散:前向逐步加噪(随机马尔可夫链),逆过程去噪,步数多;流匹配:前向是 (1−t)x₀+tx₁ 的确定性线性插值,训练只回归速度 x₁−x₀,推理用 ODE 积分,步数少、可并行求解。二者同属「生成模型」,流匹配常被视为扩散的推广/简化。
Q:π0 的整体结构? A:预训练 VLM 主干(视觉+语言理解)+ 流匹配动作专家(生成连续动作);VLM 提供世界理解,动作专家负责高频细腻的输出,二者联合训练。
5. VLA 训练管线:预训练 → 具身微调
大白话直觉:机器人演示数据又贵又少(一个灵巧手动作要采集几十上百次),而互联网图文书多到用不完。VLA 的策略是「先大后小」:先在互联网上把模型喂成「什么都见过的通才」,再拿少量机器人数据把它调成「会干活的专才」——就像先读万卷书,再练一门手艺。
数学刻画:
$$ \mathcal{L}_{\mathrm{VLA}} = \underbrace{\mathbb{E}_{D_{\mathrm{web}}}\big[\mathcal{L}_{\mathrm{VLM}}\big]}_{\text{互联网:语言/视觉对齐}} + \lambda\ \underbrace{\mathbb{E}_{D_{\mathrm{robot}}}\big[\mathcal{L}_{\mathrm{act}}\big]}_{\text{机器人:动作监督}}, \qquad \lambda \text{ 是动作任务的权重} $$
推导 / 展开:
- 预训练:用互联网图文对/视频做标准 VLM 训练(对比学习、captioning、next-token),模型学到「红色杯子 vs 蓝色方块」的视觉概念与「拿、放、推」的语义。没有这段,VLA 只是「一台只会背动作的机器」。
- 具身微调:在两个流上联合训练或顺序训练:
- 机器人演示数据(真实遥操作或仿真)监督动作输出——对每个时刻,输入历史图像与指令,输出真值动作(token 或连续),算动作损失;
- 同时保留一部分互联网文本/图文数据混训,防止灾难性遗忘(模型「忘掉」世界知识只记得动作)。
- 动作损失细节:token 派在动作 token 位置算交叉熵;连续派在动作轨迹上算流匹配/扩散损失;通常只在动作 token/段上算梯度,语言部分继续维持原有损失。
- 后续阶段:可选 RL(仿真或真机,奖励=任务成功率)、人类偏好优化(让动作更自然)、蒸馏(大 VLA 蒸馏成可在机载设备实时推理的小模型)。
- 数据配比与课程:实践中常「先互联网后机器人」或按 9:1~1:1 混合;数据质量(动作对齐、视角配置)比数量更重要——遥操作数据质量高但采集贵,仿真数据便宜但 sim2real 有鸿沟。
面试怎么问:
Q:VLA 的训练管线是怎样的? A:阶段一互联网图文/视频预训练 VLM,学视觉-语言对齐;阶段二用机器人演示数据微调,让模型输出动作(交叉熵或流匹配损失),并混入互联网数据防遗忘;可选阶段三用 RL/人类反馈进一步优化。
Q:动作监督的 loss 是怎么加的? A:token 派在动作 token 位置算交叉熵;连续派在生成轨迹上算流匹配(回归速度场)或扩散(预测噪声)损失。语言与动作通常共享主干、联合优化。
Q:为什么预训练对 VLA 这么重要? A:动作数据稀缺且只在机器人域,预训练提供「世界知识」和视觉-语言对齐,让小幅度的具身微调就能泛化到新场景新物体;没有预训练,模型对没见过的物体毫无概念。
6. 跨具身泛化:RT-X 与数据归一化
大白话直觉:一台机器人学会「拿杯子」,另一台(不同品牌、不同关节数)能不能直接用?如果模型记住的是「这台机器第 3 个关节转 45°」,那换台机器就废了;如果记住的是「末端往杯子方向移 5cm」,那全世界机器人都能用。跨具身(cross-embodiment)就是要把动作表示从「某台机器的肌肉记忆」提升到「抽象技能」。
数学刻画(动作空间归一化示意):
$$ a^{\mathrm{norm}} = \frac{a - a_{\mathrm{min}}}{a_{\mathrm{max}} - a_{\mathrm{min}}} \in [0,1], \qquad \text{或改用末端位姿差 } \Delta \mathbf{x} = \mathbf{x}^{EE}_{t+1} - \mathbf{x}^{EE}_t $$
推导 / 展开:
- RT-X / Open X-Embodiment:汇集多种型号机器人的演示数据(真实 + 仿真,数百种技能、上百万条轨迹),统一成共同格式;在此数据上训练一个 VLA,涉及「一个模型服务多台机器人」的设想(RT-X 论文报道零样本/少样本跨机器人迁移的显著提升)。
- 动作空间怎么归一化:不同机器人的关节范围、自由度数量都不同,常用手段:
- 每台机器人动作按各自的 min/max 归一化到同一区间([0,1] 或 [−1,1]);
- 改用任务空间动作:用末端执行器的位姿变化(Δx, Δrot)代替关节角——末端动作对机器人型号更「免疫」;
- 对异构动作空间,也可以把动作表示成「相对当前状态的增量」,让模型学「相对动作」而非「绝对动作」。
- 为什么跨具身有用:数据从「一种机器人、一个任务」变成「多种机器人、多种任务」,模型被迫学任务本身的规律(抓取=接近+合拢+提起),泛化对象从「场景」扩展到「本体」。
- 局限:完全异构的机械结构(关节数不同、有腿有臂)仍难统一,业界在探索「用语言/视觉描述动作意图 + 各本体自己的运动学适配层」的混合方案。
面试怎么问:
Q:RT-X 是什么?为什么跨具身数据能提升泛化? A:RT-X 基于 Open X-Embodiment 跨具身数据集训练 VLA:多种机器人、数百技能、超百万条轨迹。模型被迫学「抽象的任务规律」而不是单台机器的肌肉记忆,因此能迁移到新机器人、新场景。
Q:不同机器人动作空间不一样,怎么统一? A:按各自 min/max 归一化;或改用末端执行器的位姿增量(任务空间动作);或用相对当前状态的增量表示。核心思想:让动作表示「对本体免疫」,只保留任务语义。
7. 世界模型、视频预测,以及与 LLM Agent 的异同
大白话直觉:如果模型能「脑补」出「我伸手推这个杯子,它会往右滑、再撞到碗停下来」,那么规划就变成了「在脑补出的未来里挑一个最好的」。**世界模型(World Model)**就是干这个的:学环境的动态规律,预测未来(视频/状态)。它让 VLA 少依赖真机试错,还能拿海量无动作标签的视频「白拿」学世界规律。
数学刻画:
$$ \hat{x}_{t+1},\ \hat{o}_{t+1} = f_\theta(o_t,\, a_t,\, h_t), \qquad \mathcal{L}_{\mathrm{WM}} = \mathbb{E}\Big[\big\| \hat{o}_{t+1} - o_{t+1} \big\|^2 + \big\| \hat{x}_{t+1}-x_{t+1}\big\|^2\Big] $$
其中 o 是观测(图像/视频帧),a 是动作,h 是隐状态,fθ 是世界模型。
推导 / 展开:
- 世界模型做什么:输入 (观测, 动作),输出下一帧预测。训练目标就是「观测/状态预测误差」。有了它,VLA 可以:① 用预测误差做模型自监督(不需要动作标签,视频就能训);② 在「脑内推演」多种动作路线,选预期结果最好的(想象规划,MBRL 一体);③ 提供更长的时序上下文(不仅看当前帧,还「知道」接下来会怎样)。
- 视频预测的难点:像素空间预测模糊、计算量大、长时程不稳定;实用化常压缩到隐空间(latent space)预测,或只预测「关键事件」(如碰撞、抓取成功与否)而非整段视频。2024 后的 VLA 把世界模型作为辅助任务与动作预测联合训练(如动作条件视频预测),而不是完全替代策略。
- VLA 与 LLM Agent 的异同:
- 相同:都是「感知输入 + 大模型决策 + 迭代闭环」;VLA 的「看一眼→给动作」和 Agent 的「看上下文→调用工具」结构上同构;都可以 RL/微调持续进化。
- 不同:Agent 的动作空间是离散的工具调用/文本,反馈是文字/API 结果,环境是数字世界;VLA 的动作空间是连续的物理动作,反馈是传感器/图像,环境是物理世界——要求高频(毫秒~百毫秒级)闭环、满足动力学与安全性约束。
- 趋势:两者正在融合——具身 Agent = VLA(低层动作)+ LLM(高层任务规划与反思)的分层架构(如把「拿杯子」拆成「走过去→伸手→抓→搬运」再交给 VLA 执行)。
面试怎么问:
Q:世界模型在 VLA 里有什么用? A:预测未来(视频/状态),用于自监督学习、脑内规划(想象推演选最优动作)、提供时序上下文;实用上多在隐空间或关键事件层面预测,作为辅助任务与动作预测联合训练。
Q:VLA 和 LLM Agent 的区别? A:动作空间不同(连续物理动作 vs 离散工具/文本)、反馈不同(传感器/图像 vs 文字/API 结果)、实时性要求不同;结构上都遵循「感知→决策→执行→观察」闭环,趋势是分层融合:LLM 规划高层任务,VLA 执行低层动作。
代码实战
三个纯 numpy 手写演示,全部固定输入、固定随机种子,可重复执行(先运行「环境设置」单元):
- 动作 token 化:把连续动作均匀量化成 token、查 embedding、再逆量化重建,核对量化误差;
- VLA 推理示意:文本 + 图像 + 动作拼接成一条序列,用「最小二乘拟合的线性头」演示 next-token 预测结构;
- 扩散去噪 & 流匹配:在 2D 混合高斯「动作簇」上手写最优去噪器 / 速度场,从纯噪声采样落回动作簇,再用两条原型轨迹演示 flow 的插值性质——真实系统中这两者换成神经网络即可。
# 环境设置:中文字符输出 + matplotlib 中文(本单元必须先运行)
import sys, io
try:
    sys.stdout = io.TextIOWrapper(sys.stdout.buffer, encoding='utf-8', errors='replace')
except (AttributeError, TypeError):
    pass  # Jupyter 内核的 OutStream 已支持 UTF-8,此处自动降级为 no-op

import os
os.makedirs('images', exist_ok=True)   # 图片统一保存到 images/ 目录

import numpy as np
import matplotlib
matplotlib.use('Agg')                  # 无界面后端,兼容无显示器环境
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']  # 中文字体
plt.rcParams['axes.unicode_minus'] = False                       # 负号正常显示

print('环境就绪:numpy', np.__version__, '| matplotlib', matplotlib.__version__)

plt.show()
环境就绪:numpy 2.4.3 | matplotlib 3.10.8
演示 1:动作 token 化 —— 连续动作 → 量化 → embedding → 逆量化
动作取 6 个 2 维连续向量的示意集合(真实场景是 7~8 维末端/关节动作)。B=16 个格子/维,token 序列就是「动作的字母表」。
# ============ 演示 1:动作 token 化 ============
BINS = 16                                  # 每维 16 个格子(RT-1/RT-2 用 256,这里缩小便于查看)
actions = np.array([
    [0.0, 0.9],      # 动作 A:垂直拿起
    [0.9, 0.0],      # 动作 B:向右移动
    [-0.9, 0.0],     # 动作 C:向左移动
    [0.6, 0.6],      # 动作 D:斜向推进
    [-0.6, 0.6],     # 动作 E:斜向拿起
    [0.0, -0.9],     # 动作 F:放下
])

def quantize(a):
    # 连续值 [-1,1] -> token 索引 {0..BINS-1}
    b = np.floor((a + 1.0) / 2.0 * BINS).astype(int)
    return np.clip(b, 0, BINS - 1)

def dequantize(tok):
    # token 索引 -> 格子中心(逆量化)
    return -1.0 + (tok + 0.5) * (2.0 / BINS)

tokens = np.array([quantize(a) for a in actions])     # (6, 2) 动作 token
rng = np.random.default_rng(0)
emb_dim = 8
E = rng.normal(0, 1.0, (BINS, emb_dim))               # 词表 embedding(真实模型中学出)
emb_seq = E[tokens]                                   # 查表得到嵌入向量
a_recon = np.array([dequantize(t) for t in tokens])   # 逆量化重建
err = np.abs(actions - a_recon).max()

name = ['A 拿起', 'B 右移', 'C 左移', 'D 斜推', 'E 斜拿', 'F 放下']
print('动作名      连续动作     ->  token 序列')
for i in range(len(actions)):
    print('{}  {}  ->  {}'.format(name[i], actions[i].round(2), tokens[i]))
print('embedding 形状(动作数, 每维 token 数, 嵌入维度):', emb_seq.shape)
print('量化误差核对:max|a - a_hat| = {:.5f} <= 半格宽 {:.5f} ?'.format(err, 1.0 / BINS),
      err <= 1.0 / BINS + 1e-9)
print('含义:token 序列就是“动作的字母表” —— 之后交给 Transformer 预测下一个动作 token。')

# 图:左=动作点与码本网格,右=每个动作的重建误差
fig, axes = plt.subplots(1, 2, figsize=(11, 4.6))
ax = axes[0]
centers = -1.0 + (np.arange(BINS) + 0.5) * (2.0 / BINS)
ax.scatter(centers, np.zeros(BINS), s=8, color='gray', alpha=0.6, label='码本格子中心')
for i in range(len(actions)):
    ax.annotate(name[i], (actions[i, 0], actions[i, 1]), fontsize=8,
                xytext=(6, 6), textcoords='offset points')
ax.scatter(actions[:, 0], actions[:, 1], s=60, color='crimson', label='原始连续动作')
ax.scatter(a_recon[:, 0], a_recon[:, 1], s=40, marker='x', color='tab:blue', label='逆量化重建')
ax.axhline(0, color='gray', lw=0.5)
ax.set_xlim(-1.15, 1.15); ax.set_ylim(-1.15, 1.15)
ax.set_aspect('equal')
ax.set_title('动作量化:原始点 vs 重建点(都在格子上)')
ax.legend(fontsize=8)
ax2 = axes[1]
errs = np.abs(actions - a_recon).max(axis=1)
bars = ax2.bar(name, errs, color='#9ecae1')
ax2.axhline(1.0 / BINS, color='red', ls='--', lw=1, label='理论误差上界 1/B')
ax2.legend(fontsize=8)
ax2.set_title('每动作重建误差(max 范数)')
ax2.set_ylim(0, 1.0 / BINS * 1.5)
fig.tight_layout()
fig.savefig('images/emb03_tokens.png', dpi=120)
plt.show()
print('已保存 images/emb03_tokens.png')
动作名      连续动作     ->  token 序列
A 拿起  [0.  0.9]  ->  [ 8 15]
B 右移  [0.9 0. ]  ->  [15  8]
C 左移  [-0.9  0. ]  ->  [0 8]
D 斜推  [0.6 0.6]  ->  [12 12]
E 斜拿  [-0.6  0.6]  ->  [ 3 12]
F 放下  [ 0.  -0.9]  ->  [8 0]
embedding 形状(动作数, 每维 token 数, 嵌入维度): (6, 2, 8)
量化误差核对:max|a - a_hat| = 0.06250 <= 半格宽 0.06250 ? True
含义:token 序列就是“动作的字母表” —— 之后交给 Transformer 预测下一个动作 token。
已保存 images/emb03_tokens.png
C:\Users\24260\AppData\Local\Temp\ipykernel_46112\195834201.py:62: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
运行结果示例:
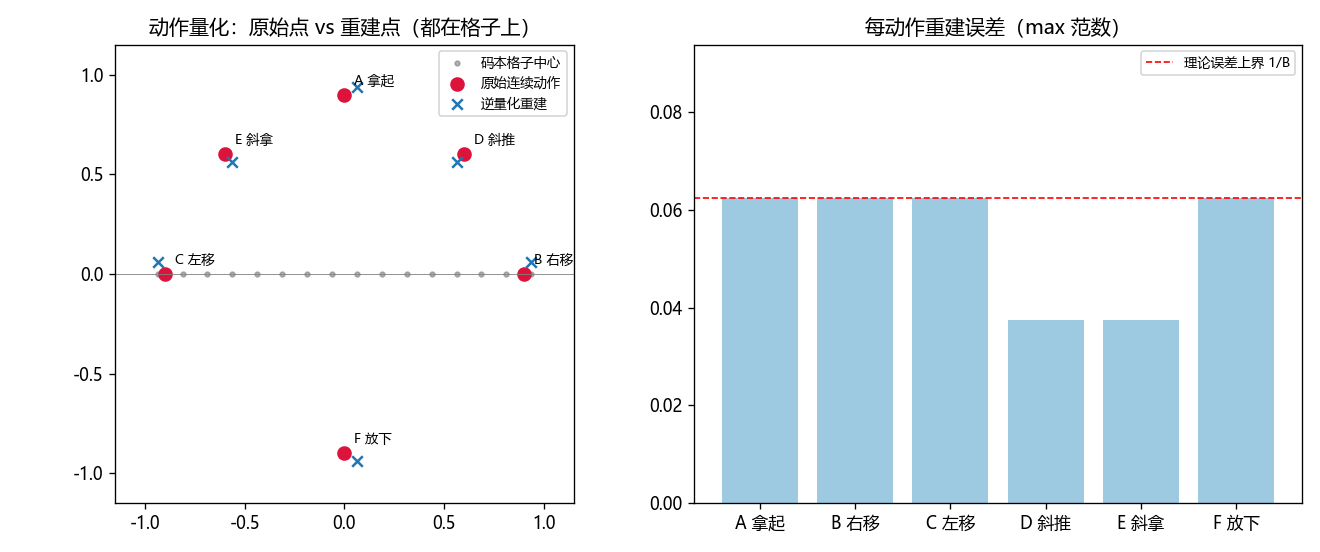
结论:token 化把连续动作「钉」到格子中心,误差不超过半格宽;格子越多(B 越大)动作越细腻,token 数也越多——这就是「粒度 vs 词表大小」的权衡。
演示 2:VLA 推理示意 —— 拼接序列 + next-token 预测
真实 VLA 用 Transformer 对「图像 patch token + 文本 token + 动作 token」做自回归;这里用最小二乘拟合一个线性「softmax 头」演示同样的结构:输入拼接好的上下文向量,输出下一个动作 token 的分布。虽然玩具,但结构是真的。
# ============ 演示 2:VLA 推理示意(线性 softmax 头) ============
rng = np.random.default_rng(1)
VOCAB = 24                                  # 词表:0~9 文本词,10~15 图像 patch,16~23 动作 token
TEXT_IDS = {'拿': 0, '放': 1, '推': 2, '红': 3, '蓝': 4, '杯子': 5, '方块': 6}
IMG_PATCHES = 3                             # 每张图切成 3 个 patch token
ACT_IDS = {'抓取': 16, '右移': 17, '左移': 18, '前推': 19, '放下': 20}
INV_ACT = {v: k for k, v in ACT_IDS.items()}

# 玩具数据集:(指令词表, 图像特征) -> 真值动作
dataset = [
    (['拿', '红', '杯子'], np.array([0.9, 0.1, 0.3]), '抓取'),
    (['拿', '蓝', '杯子'], np.array([0.1, 0.9, 0.3]), '抓取'),
    (['推', '蓝', '方块'], np.array([0.1, 0.9, 0.9]), '前推'),
    (['放', '红', '杯子'], np.array([0.9, 0.1, 0.1]), '放下'),
    (['推', '红', '方块'], np.array([0.9, 0.1, 0.9]), '右移'),
]

d_emb = 8
W_emb = rng.normal(0, 0.5, (VOCAB, d_emb))            # token -> 向量(含动作 token 行)
W_img = rng.normal(0, 0.5, (IMG_PATCHES, 3, d_emb))   # 图像特征 -> 3 个 patch 向量
b_img = rng.normal(0, 0.1, (IMG_PATCHES, d_emb))

def encode(ctx):
    # 返回 (拼接后的上下文向量, 拼接后的 token id 序列)
    text_ids = [TEXT_IDS[w] for w in ctx[0]]
    img_ids = [10 + i for i in range(IMG_PATCHES)]          # 图像 patch 的 token id
    e_text = W_emb[text_ids].reshape(-1)                    # 文本嵌入拼接
    e_img = np.stack([ctx[1] @ W_img[i] + b_img[i] for i in range(IMG_PATCHES)]).reshape(-1)  # 图像嵌入拼接
    ctx_vec = np.concatenate([e_text, e_img])
    seq_ids = text_ids + img_ids                            # 序列 = 文本 + 图像
    return ctx_vec, seq_ids

# 训练“模型”:线性头 W_head 把上下文向量映射到词表 logits(最小二乘拟合真值动作)
X = np.stack([encode(c)[0] for c in dataset])
Y = np.zeros((len(dataset), VOCAB))
for i, (_, _, act) in enumerate(dataset):
    Y[i, ACT_IDS[act]] = 1.0
lam = 1e-3
W_head = np.linalg.solve(X.T @ X + lam * np.eye(X.shape[1]), X.T @ Y).T   # (VOCAB, d)

logits = X @ W_head.T
probs = np.exp(logits - logits.max(axis=1, keepdims=True))
probs /= probs.sum(axis=1, keepdims=True)
pred = logits.argmax(axis=1)
acc = (pred == Y.argmax(axis=1)).mean()

print('拼接序列结构(文本 token + 图像 patch token)→ 模型预测下一个动作 token:')
for i, c in enumerate(dataset):
    seq = encode(c)[1]
    print('  样例{}: 序列 {} -> 预测动作 token {} ({}),真值 {}'.format(
        i + 1, seq, pred[i], INV_ACT[pred[i]], dataset[i][2]))
print('预测正确率核对:{:.0f}% == 100% ?'.format(acc * 100), acc == 1.0)
print('说明:真实 VLA 用 Transformer 对整条序列做自回归(动作 token 追加在末尾);')
print('这里用最小二乘线性头演示同一个“看上文 → 预测下一动作”的结构。')
拼接序列结构(文本 token + 图像 patch token)→ 模型预测下一个动作 token:
  样例1: 序列 [0, 3, 5, 10, 11, 12] -> 预测动作 token 16 (抓取),真值 抓取
  样例2: 序列 [0, 4, 5, 10, 11, 12] -> 预测动作 token 16 (抓取),真值 抓取
  样例3: 序列 [2, 4, 6, 10, 11, 12] -> 预测动作 token 19 (前推),真值 前推
  样例4: 序列 [1, 3, 5, 10, 11, 12] -> 预测动作 token 20 (放下),真值 放下
  样例5: 序列 [2, 3, 6, 10, 11, 12] -> 预测动作 token 17 (右移),真值 右移
预测正确率核对:100% == 100% ? True
说明:真实 VLA 用 Transformer 对整条序列做自回归(动作 token 追加在末尾);
这里用最小二乘线性头演示同一个“看上文 → 预测下一动作”的结构。
演示 3:扩散去噪 & 流匹配 —— 从噪声里「长」出动作
数据取 4 个 2 维「动作簇」(混合高斯;真实 VLA 的动作是高维向量,这里降到 2D 便于画图)。对混合高斯先验,最优去噪器 / 最优条件速度场都有闭式解(贝叶斯后验),我们直接手写它们,完整跑一遍「扩散逆过程采样」与「流匹配 ODE 采样」,再用两条原型动作轨迹演示 flow 的插值性质。真实系统里,去噪器 / 速度场是神经网络(用深入原理 4 的损失训练得到)。
# ============ 演示 3:扩散去噪 & 流匹配 ============
rng = np.random.default_rng(3)

# ---- 数据:4 个 2 维「动作簇」(混合高斯先验;真实 VLA 的动作是高维的,降到 2D 便于可视化)----
MU = np.array([[1.6, 1.6], [-1.6, 1.6], [1.6, -1.6], [-1.6, -1.6]])   # 簇心 = 动作原型
SIGMA0 = 0.25                                    # 每个簇的先验噪声标准差

# ---- 扩散(DDPM/DDIM 族):前向 x_t = sqrt(ā_t)·x_0 + sqrt(1-ā_t)·ε ----
T_D = 200
betas = np.linspace(1e-4, 0.02, T_D)
alpha_bar = np.cumprod(1 - betas)

def post_w(x_t, t_idx):
    # 混合高斯后验权重 w_i ∝ p(x_t | 簇 i) —— 最优去噪器的原料
    ab = alpha_bar[t_idx]
    var = ab * SIGMA0**2 + (1 - ab)
    w = np.exp(-0.5 * np.sum((x_t[None, :] - np.sqrt(ab) * MU)**2, axis=1) / var)
    return w / (w.sum() + 1e-12)

def mmse(x_t, t_idx):
    # MMSE 去噪:E[x_0 | x_t] = Σ w_i μ_i
    return post_w(x_t, t_idx) @ MU

# 逆过程采样(DDIM 确定性形式 σ=0,数值稳定):从纯噪声 t=T 走回 t=0
xd = rng.normal(0, 1, 2)
path_d = [xd.copy()]
for t_idx in range(T_D - 1, 0, -1):
    ab = alpha_bar[t_idx]
    ab_prev = alpha_bar[t_idx - 1]
    x0_hat = mmse(xd, t_idx)
    eps_hat = (xd - np.sqrt(ab) * x0_hat) / np.sqrt(max(1 - ab, 1e-12))
    xd = np.sqrt(ab_prev) * x0_hat + np.sqrt(max(1 - ab_prev, 0.0)) * eps_hat
    path_d.append(xd.copy())
d_ddpm = np.min(np.linalg.norm(MU - xd, axis=1))

# ---- 流匹配:x_t = (1-t)·x_0 + t·x_1,条件速度场 v = E[x_1-x_0 | x_t],从 t=1 积分回 t=0 ----
def flow_post_w(x_t, t):
    var = (1 - t)**2 * SIGMA0**2 + t**2
    w = np.exp(-0.5 * np.sum((x_t[None, :] - (1 - t) * MU)**2, axis=1) / var)
    return w / (w.sum() + 1e-12)

def flow_velocity(x_t, t):
    w = flow_post_w(x_t, t)
    s2 = (1 - t)**2 * SIGMA0**2 + t**2
    mean = (1 - t) * MU
    v = np.zeros_like(x_t)
    for i in range(len(MU)):
        v_i = (t - (1 - t) * SIGMA0**2) / s2 * (x_t - mean[i]) - MU[i]
        v += w[i] * v_i
    return v

xf = rng.normal(0, 1, 2)                       # x_1 ~ N(0, I)
path_f = [xf.copy()]
steps = 400
for k in range(steps):                         # 欧拉积分 t: 1 -> 0
    t = 1.0 - k / steps
    xf = xf - (1.0 / steps) * flow_velocity(xf, t)
    path_f.append(xf.copy())
d_flow = np.min(np.linalg.norm(MU - xf, axis=1))

# ---- flow 插值轨迹:x_t = (1-t)·x₀ + t·x₁(两条原型动作轨迹之间)----
T_PTS = 40
tt = np.linspace(0, 1, T_PTS)
z_sin = np.stack([np.sin(tt * 3 * np.pi), tt * 2 - 1], axis=1)            # 原型 A:正弦轨迹
z_cir = np.stack([np.cos(tt * np.pi) * 1.2, np.sin(tt * np.pi) * 1.2], axis=1)  # 原型 B:圆弧轨迹
interp = {s: (1 - s) * z_sin + s * z_cir for s in (0.25, 0.5, 0.75)}

print('核对1(扩散去噪):从纯噪声逆过程采样,终点 ({:.2f},{:.2f}) 距最近簇心 {:.4f} < 0.3 ?'.format(
    xd[0], xd[1], d_ddpm), d_ddpm < 0.3)
print('核对2(流匹配):从 x_1~N(0,I) 积分速度场,终点 ({:.2f},{:.2f}) 距最近簇心 {:.4f} < 0.3 ?'.format(
    xf[0], xf[1], d_flow), d_flow < 0.3)
d_mid_sin = np.abs(interp[0.5] - z_sin).max()
d_mid_cir = np.abs(interp[0.5] - z_cir).max()
full = np.abs(z_cir - z_sin).max()
print('核对3(flow 插值轨迹):中点(t=0.5)距正弦端 {:.3f}、距圆弧端 {:.3f},两端总差 {:.3f}(中点≈两端差一半)'.format(
    d_mid_sin, d_mid_cir, full))
print('说明:真实 VLA 中 mmse 去噪器 / 速度场是神经网络(用深入原理 4 的损失训练),这里用混合高斯闭式解演示同一机制。')

# 画图 2x2:扩散路径 / 流路径 / 轨迹插值 / 恢复误差
fig, axes = plt.subplots(2, 2, figsize=(11, 9))
ax = axes[0, 0]
pd = np.array(path_d)[::10]
ax.plot(pd[:, 0], pd[:, 1], '-o', color='tab:red', ms=3, lw=1.0, label='扩散逆过程路径')
ax.scatter(MU[:, 0], MU[:, 1], s=140, marker='*', color='tab:blue', label='簇心(动作原型)')
ax.scatter(*xd, color='black', s=45, marker='x', label='终点')
ax.set_title('扩散去噪:从纯噪声逐步落回动作簇')
ax.legend(fontsize=8); ax.set_aspect('equal')

ax = axes[0, 1]
pf = np.array(path_f)[::20]
ax.plot(pf[:, 0], pf[:, 1], '-o', color='tab:green', ms=3, lw=1.0, label='流匹配采样路径')
ax.scatter(MU[:, 0], MU[:, 1], s=140, marker='*', color='tab:blue', label='簇心(动作原型)')
ax.scatter(*xf, color='black', s=45, marker='x', label='终点')
ax.set_title('流匹配:沿速度场积分 t=1→0')
ax.legend(fontsize=8); ax.set_aspect('equal')

ax = axes[1, 0]
ax.plot(z_sin[:, 0], z_sin[:, 1], 'k-', lw=2, label='原型 A:正弦轨迹 (t=0)')
ax.plot(z_cir[:, 0], z_cir[:, 1], 'k--', lw=2, label='原型 B:圆弧轨迹 (t=1)')
for s, col in [(0.25, '#9ecae1'), (0.5, '#3182bd'), (0.75, '#d7301f')]:
    ax.plot(interp[s][:, 0], interp[s][:, 1], color=col, lw=1.3, label='插值 t={}'.format(s))
ax.set_title('flow 插值轨迹:x_t = (1-t) x0 + t x1')
ax.legend(fontsize=8); ax.set_aspect('equal')

ax = axes[1, 1]
bars = ax.bar(['扩散去噪', '流匹配'], [d_ddpm, d_flow], color=['#fc8d59', '#91bfdb'])
ax.axhline(0.3, color='red', ls='--', lw=1, label='阈值 0.3')
for b, v in zip(bars, [d_ddpm, d_flow]):
    ax.text(b.get_x() + b.get_width() / 2, v + 0.01, '{:.3f}'.format(v), ha='center')
ax.set_ylim(0, 0.45)
ax.set_title('生成结果与最近簇心的距离(越小越好)')
ax.legend(fontsize=8)

fig.tight_layout()
fig.savefig('images/emb03_diffusion.png', dpi=120)
plt.show()
print('已保存 images/emb03_diffusion.png')
核对1(扩散去噪):从纯噪声逆过程采样,终点 (1.62,-1.62) 距最近簇心 0.0260 < 0.3 ? True
核对2(流匹配):从 x_1~N(0,I) 积分速度场,终点 (1.48,-1.55) 距最近簇心 0.1237 < 0.3 ? True
核对3(flow 插值轨迹):中点(t=0.5)距正弦端 1.028、距圆弧端 1.028,两端总差 2.055(中点≈两端差一半)
说明:真实 VLA 中 mmse 去噪器 / 速度场是神经网络(用深入原理 4 的损失训练),这里用混合高斯闭式解演示同一机制。
已保存 images/emb03_diffusion.png
C:\Users\24260\AppData\Local\Temp\ipykernel_46112\2881803314.py:116: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
运行结果示例:
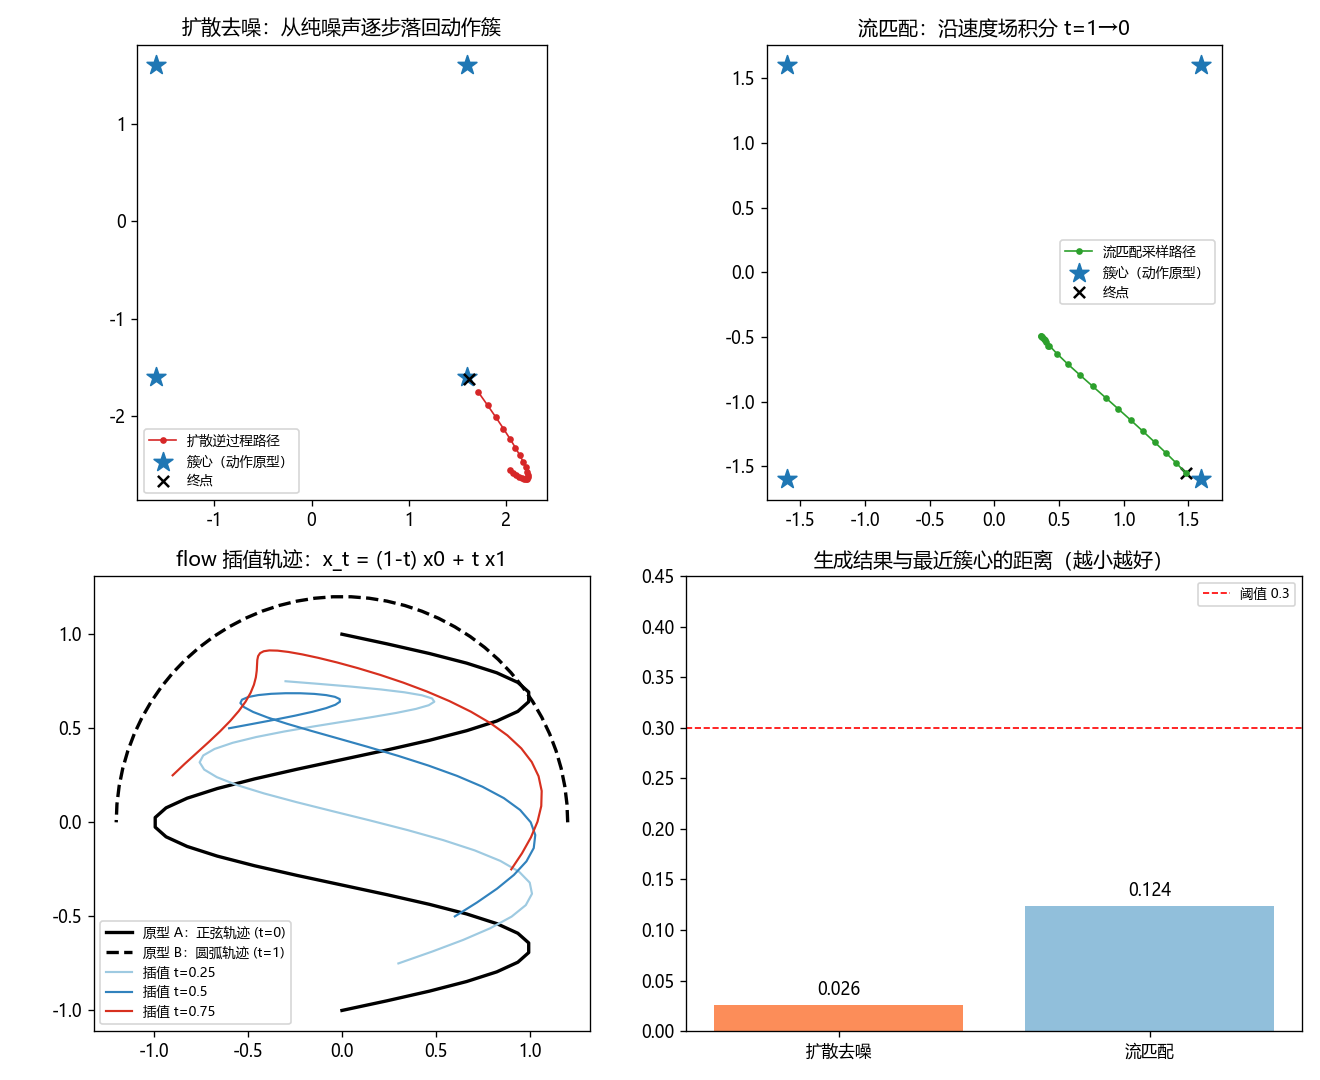
结论:扩散靠「逐步去噪」、流匹配靠「沿速度场积分」,都能从纯噪声回到动作所在的簇(距离远小于 0.3 阈值);flow 插值则展示两条轨迹之间的线性过渡。真实 VLA 把这里的闭式解换成神经网络(εθ / vθ),机制完全一致。
模型详解(面试深度)
本篇与 notebook「深入原理」四段式分工不同:那边按「动作表示 → RT 家族 → 具身 VLM → 连续生成」讲思路,这里给每个模型立一份事实档案卡——年份、机构、论文、参数量、骨干、动作表示、损失、数据一张表看清,公式只留最核心的。面试叙事建议:先报档案(30 秒),再讲公式(30 秒),最后背记忆点(10 秒)。
0. 前置数学:VQ-VAE 动作码本 vs 均匀分箱
背景:把连续动作变成离散 token 有两条路——手工均匀分箱(RT-1/RT-2)与学出来的 VQ-VAE 码本(OpenVLA/VQ-BET)。吃透后者必须先吃透 VQ-VAE 的三件套损失。
均匀分箱(Uniform Binning):把每维连续值 $a_i \in [-1,1]$ 切成 $B$ 个格子,格子编号即 token,逆量化用格子中心重建: $$b_i = \Big\lfloor \frac{a_i+1}{2}\,B \Big\rfloor \in \{0,\dots,B-1\},\qquad \hat{a}_i = -1 + \Big(b_i + \tfrac12\Big)\cdot\frac{2}{B}$$ 误差上界是半格宽 $1/B$:$|\hat{a}_i - a_i| \le 1/B$。优点:零训练成本、实现即用;缺点:格子等分,不贴合动作真实分布(密集区间浪费),$B$ 越大越细腻但词表也越大。
VQ-VAE 动作码本:让网络自己学「动作字母表」,流程四步:
- 编码:$z_e = E_{\mathrm{enc}}(a)$,把连续动作压成低维连续表征;
- 量化(查码本):$z_q = e_k$,其中 $k = \arg\min_{e_j\in\mathcal{Z}}\|z_e - e_j\|_2$,码本索引 $k$ 就是动作 token;
- 解码:$\hat{a} = D_{\mathrm{dec}}(z_q)$ 重建动作;
- token 化:$k$ 进入语言模型做自回归预测。
完整损失(三件套 + 重建): $$\mathcal{L} = \underbrace{\|a - D_{\mathrm{dec}}(z_q)\|_2^2}_{\text{重建损失}} + \underbrace{\|\mathrm{sg}[z_e] - e_k\|_2^2}_{\text{码本损失}} + \beta \underbrace{\|z_e - \mathrm{sg}[e_k]\|_2^2}_{\text{commit loss}},\qquad \mathrm{sg} = \text{stop-gradient}$$
- 重建损失:逼解码器把码本向量还原成动作;
- 码本损失:把码本向量 $e_k$ 拉向编码器输出(常改用 EMA 指数移动平均更新码本,训练更稳);
- commit loss:反向约束编码器输出贴近已选码本(防止码本「空转」),权重 $\beta$ 常取 0.25 量级;
- 量化取 $\arg\min$ 不可导,靠 sg 技巧让梯度只沿「最近邻」路径回传;
- 工程实现常用 EMA 更新码本(不反向传播码本梯度):$\hat{n}_k \leftarrow \gamma\hat{n}_k + (1-\gamma)\,n_k$ 滚动统计每个码字的平均向量,$\gamma\in[0,1]$ 为衰减系数,此时损失只剩「重建 + commit」两项。
对比表:
| 维度 | 均匀分箱 | VQ-VAE 码本 |
|---|---|---|
| 格子怎么来 | 手工等分 | 从动作数据中学出 |
| 重建精度 | 上限半格宽 $1/B$ | 码本贴合分布,同容量更准 |
| 训练成本 | 无 | 多训一整套编解码器 + 码本 |
| 代表模型 | RT-1、RT-2 | OpenVLA、VQ-BET |
| 一句话 | 简单粗暴有锯齿 | 让数据定义「动作字母表」 |
面试记忆点:VQ-VAE 损失背成「重建 + 码本(sg 在编码器侧)+ commit(sg 在码本侧)」,sg 只切一边,β 控 commit 强度;均匀分箱就是 VQ 的「零训练版」。
1. RT-1(2022 · Google Robotics)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | RT-1: Robotics Transformer for Real-World Control at Scale(arXiv:2212.06817) |
| 参数量 | 约 35M(论文称轻量模型) |
| 骨干网络 | EfficientNet-B3 图像编码 + FiLM 条件化 + Transformer 决策器 |
| 动作表示 | 8 维 × 256 bin 均匀分箱 → 每步 8 个动作 token |
| 损失函数 | 8 个动作 token 的交叉熵 |
| 训练数据 | 约 13 万条真实演示(13 台机器人,办公室/厨房,EVER 系列) |
核心公式: $$a \in \mathbb{R}^{8}:\,[\Delta x,\Delta y,\Delta z,\Delta \text{roll},\Delta\text{pitch},\Delta\text{yaw},\ \text{gripper},\ \text{terminate}],\qquad b_i = \Big\lfloor\tfrac{a_i+1}{2}\cdot 256\Big\rfloor$$ $$\mathcal{L}_{\mathrm{act}} = -\sum_{i=1}^{8}\log p\big(t_i \mid \text{图像 patch},\ \text{指令},\ t_{<i}\big)$$
结构流程:图像 → EfficientNet-B3 → 图像 token(token learner 压缩)→ 语言指令嵌入经 FiLM(特征级仿射调制) 注入图像 token → Transformer 决策器自回归吐 8 个动作 token → 逆量化执行。
评测口径(常考):成功率 = 真机按指令重复试运行、统计任务完成比例;RT-1 论文报告训练过的任务/环境约 97%(700+ 次试运行)、未见物体/背景组合约 82%——成功率的定义本身就是考点:试运行次数、指令集、成败判据都要问清。
亮点:第一个把「动作 token + Transformer」规模化跑通的真机策略;轻量、可实机部署。局限:均匀分箱有量化锯齿;视觉-语言部分是识别器而非大模型,语义泛化弱。
面试记忆点:RT-1 = 8 维 × 256 bin 动作 token + FiLM 条件化 + Transformer;「动作也是词」的起点,但大脑还很小。
2. RT-2(2023 · Google DeepMind)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control(arXiv:2307.15818) |
| 参数量 | 5B / 12B / 55B 三档(旗舰 RT-2-PaLI-X-55B,另有 PaLM-E-12B 变体) |
| 骨干网络 | PaLI-X / PaLM-E 巨型 VLM,词表扩充动作 token |
| 动作表示 | 与 RT-1 同款 8 维 × 256 bin token,但塞进 VLM 词表 |
| 损失函数 | 文本 + 动作 token 的联合交叉熵(统一 next-token 预测) |
| 训练数据 | 机器人演示 + 互联网图文/视频 Co-Fine-Tuning 混合 |
核心公式(动作即文本): $$\mathcal{L} = -\sum_{j}\log p\big(y_j \mid y_{<j}\big),\qquad y_j \in \{\text{文本 token},\ \text{动作 token}\}$$
Co-Fine-Tuning:微调时把机器人数据与互联网数据按比例混进同一条数据流(论文主配置机器人数据占比约 5%,随模型规模调整),既防灾难性遗忘,又把「红色杯子、餐巾纸、按形状归类」等世界知识灌进动作决策。
泛化案例(论文定性展示):把从未见过的物品放到指定区域(如放到图片所示的餐巾纸上)、换背景/换桌面照常执行、跨任务语义推理(按颜色/大小/数字符号选目标)——这些能力来自互联网预训练而非机器人数据,是「动作即文本」路线最大的卖点。论文把效果分为两层:泛化(训练任务遇到新物体/新背景仍能完成)与涌现(互联网知识带来全新技能,如按语义指认目标),答泛化案例时先分清这两层再举例。
亮点:55B 旗舰把互联网知识迁移到操作,涌现语义泛化。局限:巨型 VLM 推理慢、真机高频闭环难;未开源;量化粒度损失依旧。
面试记忆点:RT-2 一句话——「动作也是词」:动作 token 扩进 VLM 词表,55B 旗舰 + 约 5% 机器人数据 Co-Fine-Tuning,联合交叉熵一把梭;泛化靠互联网预训练白拿世界知识。
3. PaLM-E(2023 · Google)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | PaLM-E: An Embodied Multimodal Language Model(arXiv:2303.03378,ICML 2023) |
| 参数量 | 12B / 84B / 562B(最大 = 540B PaLM + 22B ViT) |
| 骨干网络 | PaLM 语言模型 + ViT 视觉编码器 |
| 动作表示 | 不直接输出动作;输出语言/高层规划,低层控制器执行 |
| 损失函数 | 语言建模交叉熵(token 序列含图像 patch 与状态向量) |
| 训练数据 | 文本 + 图文 + 多机器人(真实/仿真)演示 |
核心公式(万物皆 token): $$\text{序列} = [\ \underbrace{v_1,\dots,v_P}_{\text{图像 patch token}},\ \underbrace{s_1,\dots,s_Q}_{\text{状态向量线性投影 token}},\ \underbrace{w_1,\dots,w_R}_{\text{语言 token}}\ ],\qquad \mathcal{L} = -\sum_{j}\log p(w_j \mid \cdot)$$
与 RT-2 路线差异:PaLM-E 走「LLM 当具身大脑」——图像 patch、机器人关节角/末端位姿状态向量全部投影成 token 喂给 LLM,LLM 做场景理解与任务推理,输出自然语言计划交给低层控制器执行;RT-2 则让 VLM 直接输出动作 token、跳过语言接口。一句话:PaLM-E 把动作放在「语言之后」,RT-2 把动作放在「词表之内」。
亮点:验证 LLM 可直接做具身推理,还能顺带干 VQA 等非机器人任务。局限:LLM 推理慢,与低层控制隔一层「语言鸿沟」,难以高频闭环。
面试记忆点:PaLM-E = 「万物皆 token、LLM 规划、控制器执行」;与 RT-2 的区别就是「语言接口 vs 动作进词表」。
4. OpenVLA(2024 · Stanford 等 · 开源)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | OpenVLA: An Open-Source Vision-Language-Action Model(arXiv:2406.09246) |
| 参数量 | 7B(Llama-2-7B 骨干) |
| 骨干网络 | Llama-2-7B + SigLIP 视觉编码 + 冻结 DINOv2(定位特征) |
| 动作表示 | 7 维动作(末端平移 3 + 旋转 3 + 夹爪 1)× VQ-VAE 码本 8192 → token |
| 损失函数 | 动作 token 交叉熵为主,借鉴动作分块加 KL 正则项 |
| 训练数据 | 两阶段:LIDA 互联网图文指令预训练(约百万级)→ RLDS 格式 Open X-Embodiment 微调(约 97 万条机器人轨迹) |
训练两阶段(面试重点):
- 互联网预训练:用图文指令数据把 SigLIP 视觉特征与 Llama-2 语言空间对齐(先学会「看图说话」);
- 具身微调:在 RLDS 格式的 Open X-Embodiment 数据上监督微调,动作经 VQ-VAE 离散成码本索引,LLM 自回归预测 token 序列。RLDS(Robot Learning DataSet)是 Google 的统一轨迹格式,把不同机器人的观测/动作/奖励字段标准化,OpenVLA 借此直接吃整个 OXe 数据集。
损失组成:$\mathcal{L} = \mathcal{L}_{\mathrm{CE}}(\text{动作 token}) + \lambda\,\mathrm{KL}$(VQ-VAE 编解码器单独训练,主损失是动作 token 交叉熵)。
亮点:完全开源、权重可下载,单张 A100 即可完成下游微调(论文展示约十小时量级),是社区 LoRA/少样本适配的事实标准。局限:7B 推理仍偏慢;VQ 量化有粒度损失;预训练数据规模远小于闭源巨头。
面试记忆点:OpenVLA = 「Llama-2-7B + SigLIP/DINOv2 + VQ-VAE 8192 码本」,两阶段「先图文对齐、再 OXe 微调」,单卡可微调——VLA 界的开源旗舰。
5. ACT(2023 · Stanford)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(RSS 2023,arXiv:2304.13705) |
| 参数量 | 论文未强调(双 ResNet18 编码器 + 前馈 Transformer 解码器) |
| 骨干网络 | ResNet18 图像编码 + CVAE 隐变量 + 基于动作块的前馈 Transformer |
| 动作表示 | 连续动作块(一次预测未来 $k$ 步动作) |
| 损失函数 | 动作块重建损失(L1)+ CVAE 的 KL 项 |
| 训练数据 | 自采真机演示(ALOHA 低成本双臂遥操作系统) |
核心公式(动作分块 + CVAE): $$\hat{a}_{t:t+k} = F_{\theta}\big(z,\,h_t\big)\ \ \text{(一次预测 }k\text{ 步)},\qquad z \sim q(z\mid h_t,\,a_{t:t+k})\ \text{训练};\ \ z\sim\mathcal{N}(0,I)\ \text{推理}$$ $$\mathcal{L}_{\mathrm{ELBO}} = \mathbb{E}_{q(z\mid\cdot)}\big[\|a_{t:t+k} - \hat{a}_{t:t+k}\|_1\big] + \beta\,\mathrm{KL}\big[q(z\mid h_t,a_{t:t+k})\ \|\ \mathcal{N}(0,I)\big]$$
与普通 VAE 不同,CVAE 训练时隐变量 $z$ 以「观测历史 + 真值动作块」为条件,编码的是「这段动作打算怎么走」的意图;推理时只剩观测条件,$z$ 从先验 $\mathcal{N}(0,I)$ 采样——既让解码器见过完整动作模式,又不把未来动作当输入泄漏给推理。
为什么分块能提高一致性:逐单步贪婪预测会「一步错、步步错」,误差随步数累积成抖动;一次联合预测未来 $k$ 步,网络被迫输出一条内部一致的轨迹(像写一整段话而非挤牙膏),执行前 $a$ 步再滚动重规划,既平滑又保留闭环修正。
亮点:极低硬件成本(ALOHA)实现双臂精细操作;动作分块成为后续 VLA 标配。局限:CVAE 的 $z$ 只编码本块,长程任务靠重规划;对动态干扰鲁棒性一般。
面试记忆点:ACT = 「一次预测 k 步 + CVAE 隐变量 + Transformer 解码」;分块治「误差累积、轨迹抖动」,执行前 $a$ 步再滚动重规划。
6. Diffusion Policy(2023 · MIT / CMU)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | Diffusion Policy: Visuomotor Policy Learning via Action Diffusion(arXiv:2303.04137) |
| 参数量 | 骨干可换(CNN/Transformer 扩散头),论文未强调单一数值 |
| 骨干网络 | 视觉编码(ResNet 等)+ 条件 DDPM 扩散头 |
| 动作表示 | 连续动作块(扩散生成,不量化) |
| 损失函数 | DDPM 去噪损失(预测噪声) |
| 训练数据 | 自采演示 + 公开机器人数据集(仿真/真机均可) |
核心公式(DDPM 训练目标与推理): $$\mathcal{L} = \mathbb{E}_{t,\,x_0,\,\varepsilon}\Big[\big\|\varepsilon - \varepsilon_\theta\big(x_t,\,t,\,\mathrm{obs}\big)\big\|^2\Big],\qquad x_t = \sqrt{\bar\alpha_t}\,x_0 + \sqrt{1-\bar\alpha_t}\,\varepsilon$$ 训练:对动作块 $x_0$ 加噪到任意 $t$,网络在观测条件下预测噪声;推理:从高斯噪声出发用 DDIM 少步采样(十几步内)逐步去噪得到动作块,执行前若干步后滚动重规划。
与 VQ 派对比:
| 维度 | VQ token 派(RT/OpenVLA) | 扩散派(DP/π0) |
|---|---|---|
| 动作输出 | 词表分类 | 连续轨迹 |
| 量化误差 | 有(格子宽度) | 无 |
| 多模态动作 | 靠码本多 token 拟合 | 天然支持(同一观测多种合理动作) |
| 推理速度 | 快(自回归) | 慢(多步采样,DDIM 缓解) |
亮点:无量化损失、天然多模态、精度高;训练稳定(回归噪声)。局限:采样开销大,高频闭环需少步技巧或蒸馏。
面试记忆点:Diffusion Policy = 「观测条件下对动作块去噪」,训 $L=\|\varepsilon-\varepsilon_\theta\|^2$、推理 DDIM 少步 + 滚动执行;与 VQ 派的根本分歧是「量化 vs 连续」。
7. VQ-BET(2022)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | What Matters in Language Conditioned Robotic Imitation Policies(arXiv:2204.06252,IROS 2022) |
| 参数量 | 论文未强调(Transformer 规模中等) |
| 骨干网络 | 行为 Transformer(语言条件 FiLM 注入) |
| 动作表示 | VQ-VAE 码本 token 化的连续动作 |
| 损失函数 | VQ-VAE 三件套(重建/码本/commit)+ 动作 token 交叉熵 |
| 训练数据 | 语言条件演示数据(如 CALVIN 系列) |
核心公式: $$\mathcal{L} = \mathcal{L}_{\text{VQ-VAE}}(a) - \sum\nolimits_t \log p\big(t^{\text{act}}_t \mid t^{\text{act}}_{<t},\ \text{图像},\ \text{指令}\big)$$
VQ-BET 把 BET(Behavior Transformer)里手工 k-means 聚类换成 VQ-VAE 学出的码本:连续动作先变成码本索引 token,Transformer 再像语言模型一样自回归生成整条动作 token 序列。码本天然多模态——同一指令下几种合理动作各占一个码字,正好治「行为克隆把多模态平均成怪动作」的病。
亮点:确立「VQ-VAE 动作 token + 自回归 Transformer」的动作序列生成范式,是 OpenVLA 的思想前辈;语言条件化让单模型服务多指令。局限:码本容量受限、序列长了不划算;模型规模小,泛化有限。
面试记忆点:VQ-BET = 「VQ-VAE 动作 token + 行为 Transformer 自回归」;把 BET 的 k-means 升级成学出来的码本,多模态动作不平均。
8. π0(2024 · Physical Intelligence)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | π0: A Vision-Language-Action Flow Model(arXiv:2410.24164) |
| 参数量 | PaliGemma VLM 主干约 3B + 动作专家约 300M(合计约 3.5B 量级) |
| 骨干网络 | 预训练 VLM(PaliGemma)+ 流匹配动作专家(PALM 架构) |
| 动作表示 | 连续(流匹配直接生成动作轨迹,不量化) |
| 损失函数 | 条件流匹配损失(回归速度场) |
| 训练数据 | 自采真机 + 跨平台具身数据,叠加 VLM 预训练权重 |
核心公式(条件流匹配,OT 路径): $$x_t = (1-t)\,x_0 + t\,x_1,\qquad u_t = x_1 - x_0,\qquad \mathcal{L}_{\mathrm{FM}} = \Big\| v_\theta\big(x_t,\,t,\,c\big) - u_t \Big\|^2$$ 训练:对(真实动作 $x_0$,噪声 $x_1$)线性插值,网络回归「正确速度」$u_t=x_1-x_0$;推理:从噪声出发沿学到的速度场做 ODE 积分(欧拉/RK4)得到动作轨迹。条件 $c$ 含图像、语言指令与状态;动作空间可含机械臂末端、夹爪与头部姿态等多通道——机器人侧的多模态输出。
为什么选流匹配:动作不量化(无锯齿)、采样步数比扩散少;50Hz 高频控制靠缓存 VLM 特征实现——世界理解慢、动作专家快,分工闭环。π0.5 变体:参数约减半的轻量版,面向小算力部署。
亮点:预训练 VLM 的世界知识 + 连续动作的高频细腻;PALM 动作专家开「VLM 主干 + 动作专家」架构先河。局限:模型权重未开源;流匹配仍需数步采样;数据仍以遥操作为主。
面试记忆点:π0 = 「PaliGemma(约 3B)+ 流匹配动作专家(约 300M)」;OT 插值 $x_t=(1-t)x_0+tx_1$、回归速度 $u_t=x_1-x_0$,缓存 VLM 特征上 50Hz;π0.5 是轻量变体。
9. GR00T(2024 · NVIDIA)
事实档案:
| 项 | 内容 |
|---|---|
| 论文 | Isaac GR00T(2024,仿真合成数据与基础模型计划);GR00T N1: An Open Foundation Model for Generalist Humanoid Robots(arXiv:2503.14734,2025) |
| 参数量 | GR00T N1 约 2.6B(扩散 Transformer 动作头约 0.5B,论文口径,写约) |
| 骨干网络 | 视觉-语言主干 + 扩散 Transformer(DiT)动作解码 |
| 动作表示 | 连续全身动作(关节位置),扩散/流式生成 |
| 损失函数 | 扩散/流匹配去噪损失(预测噪声或速度场) |
| 训练数据 | 真实人形演示 + Isaac Lab / Isaac Sim 仿真合成数据(GR00T-Gen/Mimic 生成) |
输入 = 视频/图像 + 语言指令 + 传感器/本体状态;输出 = 全身动作(多关节位置序列)。架构为 Diffusion/Transformer 混合:VLM 理解场景语义,DiT 动作头生成连续动作。与单臂 VLA 不同,人形输出的是腿、躯干、臂、手一起的全身轨迹,需同时满足平衡与运动学约束——这正是生成式动作头的用武之地。仿真配合是关键闭环:人形数据贵到买不起,先用 Isaac 仿真大规模合成演示再真机验证。
亮点:面向「一个模型驱动多种人形机器人」的全身动作基础模型;仿真合成数据管线(GR00T-Gen/GR00T-Mimic)成体系。局限:人形本体异构严重、真机数据稀缺,Sim2Real 仍有鸿沟;2024 版细节未完全公开,架构细节以 2025 N1 论文为准。
面试记忆点:GR00T = NVIDIA 人形全家桶——「VLM 理解 + DiT 生成全身动作 + Isaac 仿真造数据」,GR00T N1(2025)是开源实现。
10. 大对比表
| 模型 | 年份 | 参数量 | 动作表示 | 骨干 | 损失 | 数据来源 | 开源 |
|---|---|---|---|---|---|---|---|
| RT-1 | 2022 | 约 35M | 8 维×256 bin token | EfficientNet + Transformer | 动作 token 交叉熵 | 自采真机约 13 万条 | 否 |
| RT-2 | 2023 | 5B / 12B / 55B | 动作进 VLM 词表 | PaLI-X / PaLM-E VLM | 文本+动作联合交叉熵 | 机器人+互联网 Co-FT | 否 |
| PaLM-E | 2023 | 12B / 84B / 562B | 语言/规划输出 | PaLM + ViT | 语言建模交叉熵 | 文本+图文+机器人 | 否 |
| OpenVLA | 2024 | 7B | VQ-VAE 8192 token | Llama-2-7B + SigLIP/DINOv2 | token 交叉熵(+KL) | LIDA + OXE 约 97 万条 | 是 |
| ACT | 2023 | 论文未强调 | 连续动作块 k 步 | ResNet18 + CVAE + Transformer | L1 重建 + KL | ALOHA 自采真机 | 是(代码) |
| Diffusion Policy | 2023 | 骨干可换 | 连续动作块(扩散) | 视觉编码 + DDPM 头 | 去噪噪声 MSE | 演示 + 公开数据集 | 是 |
| VQ-BET | 2022 | 论文未强调 | VQ-VAE 码本 token | 行为 Transformer | VQ 损失 + token 交叉熵 | CALVIN 等语言条件演示 | 是 |
| π0 | 2024 | 约 3B + 约 300M | 连续(流匹配) | PaliGemma + PALM 专家 | 条件流匹配 | 自采 + 多平台具身数据 | 否 |
| GR00T | 2024/25 | N1 约 2.6B | 连续全身动作 | VLM + DiT | 扩散/流去噪 | 真实 + Isaac 仿真 | N1 是 |
读表三条主线(面试收尾):① 动作表示三流派——token 化(RT-1/RT-2/OpenVLA/VQ-BET)→ 连续块(ACT/DP)→ 流匹配(π0/GR00T);② 骨干进化——专用小 Transformer → 巨型 VLM → VLM 主干 + 动作专家;③ 数据与开源——闭源巨头靠自采 + 互联网数据,开源系(OpenVLA)把 VLA 变成可单卡微调的事实标准。再补一个读法提示:动作表示决定推理方式(分类快但糙、采样慢但细),参数量决定部署难度(7B 以下单卡可微调,55B/562B 是闭源旗舰)。
面试考点
Q1:VLA 和 VLM 的区别是什么?
答:VLM 输入图像+文本、输出文本;VLA 在其基础上增加了一条「动作通道」,输出机器人的动作(离散 token 或连续轨迹),把感知、理解、决策统一进同一个网络。VLA = VLM 预训练 + 具身动作微调。 追问:「动作通道」有哪几种实现? 30 秒速答:三种:离散 token(RT-1/RT-2 均匀分箱、OpenVLA 用 VQ-VAE 学码本,做 next-token 预测);连续生成(π0/GR00T 用扩散或流匹配直接从噪声生成动作轨迹);轨迹级(先预测未来视频/关键帧再解码动作,配合世界模型)。
Q2:RT-1 是怎么工作的?动作怎么变成 token?
答:RT-1 把 8 维连续动作(手臂+夹爪)逐维均匀量化成 256 个 bin,转成 8 个动作 token;图像特征(EfficientNet)与语言指令通过 FiLM 注入,Transformer 自回归预测动作 token。 追问:RT-1 和 RT-2 的本质区别? 30 秒速答:RT-1 的动作预测器是自研小 Transformer、VLM 部分不是大模型;RT-2 把动作 token 扩进预训练巨型 VLM 的词表,动作与语言在同一 next-token 预测里联合学习——「动作即文本」。
Q3:OpenVLA 为什么用 VQ-VAE 量化动作?VQ-VAE 怎么工作?
答:手工分箱不贴合动作分布;VQ-VAE 让网络自己学「动作字母表」(码本)。编码器把动作压成表征 z_e,就近量化到码本向量 z_q=argmin‖z_e−e_k‖,码本索引即为动作 token;损失 = 重建 + 码本 + commitment 三部分。 追问:码本太大/太小会怎样?commitment loss 干什么? 30 秒速答:太小重建粗糙、太大利用率低学不动(通常几百量级);commitment loss 逼编码器输出贴近码本,防止码本「空转」不被使用。
Q4:π0 为什么用 flow matching 生成连续动作?和扩散模型什么关系?
答:token 化有量化误差、自回归步数多,人形高频高维连续动作不友好;流匹配定义确定性插值 x_t=(1−t)x₀+tx₁,网络回归速度场 vθ(损失‖vθ−(x₁−x₀)‖²),推理用 ODE 积分从噪声走回动作,无量化损失、步数少。流匹配是扩散的推广/简化:扩散前向是随机马尔可夫加噪,流匹配前向是确定性线性插值。 追问:π0 的整体结构? 30 秒速答:预训练 VLM 主干(视觉+语言理解)+ 流匹配动作专家(连续动作生成),联合训练;GR00T 类似但面向人形全身动作。
Q5:VLA 的训练管线是什么样的?
答:阶段一互联网图文/视频预训练 VLM(学视觉-语言对齐与世界知识);阶段二机器人演示数据微调(token 派算交叉熵、连续派算流匹配/扩散损失),混入互联网数据防灾难性遗忘;可选阶段三仿真/真机 RL 或人类反馈优化。 追问:动作 loss 怎么加?为什么预训练重要? 30 秒速答:只在动作 token/轨迹段上算动作损失,语言任务继续维持;动作数据稀缺,预训练提供世界知识,让小幅具身微调即可泛化到新场景新物体。
Q6:RT-X / Open X-Embodiment 是什么?跨具身怎么归一化?
答:跨多种机器人的大规模演示数据集(数百技能、超百万条轨迹)及在其上训练的 VLA。跨具身的关键是动作表示归一化:按各机器人 min/max 归一化、改用末端执行器位姿增量(任务空间动作)、或用相对当前状态的增量——让模型学「抽象技能」而非单台机器的肌肉记忆,从而迁移到新本体。 追问:归一化到任务空间动作有什么好处? 30 秒速答:末端位姿差对机器人型号「免疫」,不同关节构型的机器人都能用同一套动作语义,跨具身泛化能力显著提升。
Q7:世界模型在 VLA 里干什么?VLA 和 LLM Agent 有什么异同?
答:世界模型学习环境动态、预测未来(视频/状态),用途:①自监督(无动作标签的视频也能训练);②脑内推演规划(选预期最好的动作);③提供时序上下文。VLA 与 LLM Agent 同构(感知→决策→执行→观察闭环、都能 RL 微调),但动作空间不同:VLA 是连续物理动作、反馈是传感器、要求高频闭环;Agent 是离散工具/文本、反馈是 API 结果。 追问:两者会怎么融合? 30 秒速答:分层架构——LLM 做高层任务规划与反思(拆步骤),VLA 执行低层动作(拿、放、推),构成「大脑 + 小脑」的具身 Agent。
小结与下一章预告
小结:本章把「大模型如何指挥机器人的手」讲透了——
- 表示:动作可以离散化成 token(RT-1/RT-2 均匀分箱、OpenVLA 用 VQ-VAE 学码本),也可以用 flow matching 生成连续轨迹(π0/GR00T);
- 架构:VLA = VLM 主干 + 动作通道,统一做序列建模;RT-2 把动作塞进词表,PaLM-E 让 LLM 直接做具身推理;
- 训练:互联网预训练学世界 → 机器人演示数据微调学动作 → 可选 RL 打磨;损失只在动作段上算;
- 泛化:RT-X / Open X-Embodiment 用跨具身数据 + 动作归一化,让模型学「抽象技能」;
- 进阶:世界模型通过视频预测让 VLA「脑补未来」,与 LLM Agent 的分层融合是当前趋势。
下一章预告:VLA 再强,也离不开「数据从哪里来」——真机遥操作贵、仿真数据便宜但有「次元壁」。下一章 04-仿真数据与sim2real 讲 Isaac 仿真、域随机化与 Sim2Real 迁移,解决「在虚拟世界里学的本领怎么安全地搬到真机」;之后 05-具身智能面试八股与高频题 做全模块速查。