🎤 06 · 图神经网络与知识图谱面试八股
最后冲刺:把 GNN 三问(为什么/怎么做/怎么选)、知识图谱三块(构建/存储/推理)、 高频手撕、常见坑串成速答体系。
🎬 背景故事
图算法面试 30 秒:'讲一下消息传递框架'……
图算法面试最常见的问题:"30 秒,讲一下 GNN 的消息传递框架。" 本节把图神经网络 + 知识图谱两块考点串成一张地图,18 个高频速答全覆盖,并手撕两个必考代码题(BFS 最短路、单层 GCN)。
🧭 本节逻辑主线:消息传递框架 → GCN/GAT/GraphSAGE 对比 → 图任务与评估 → 知识图谱构建与推理 → 落地场景 → 两个手撕。
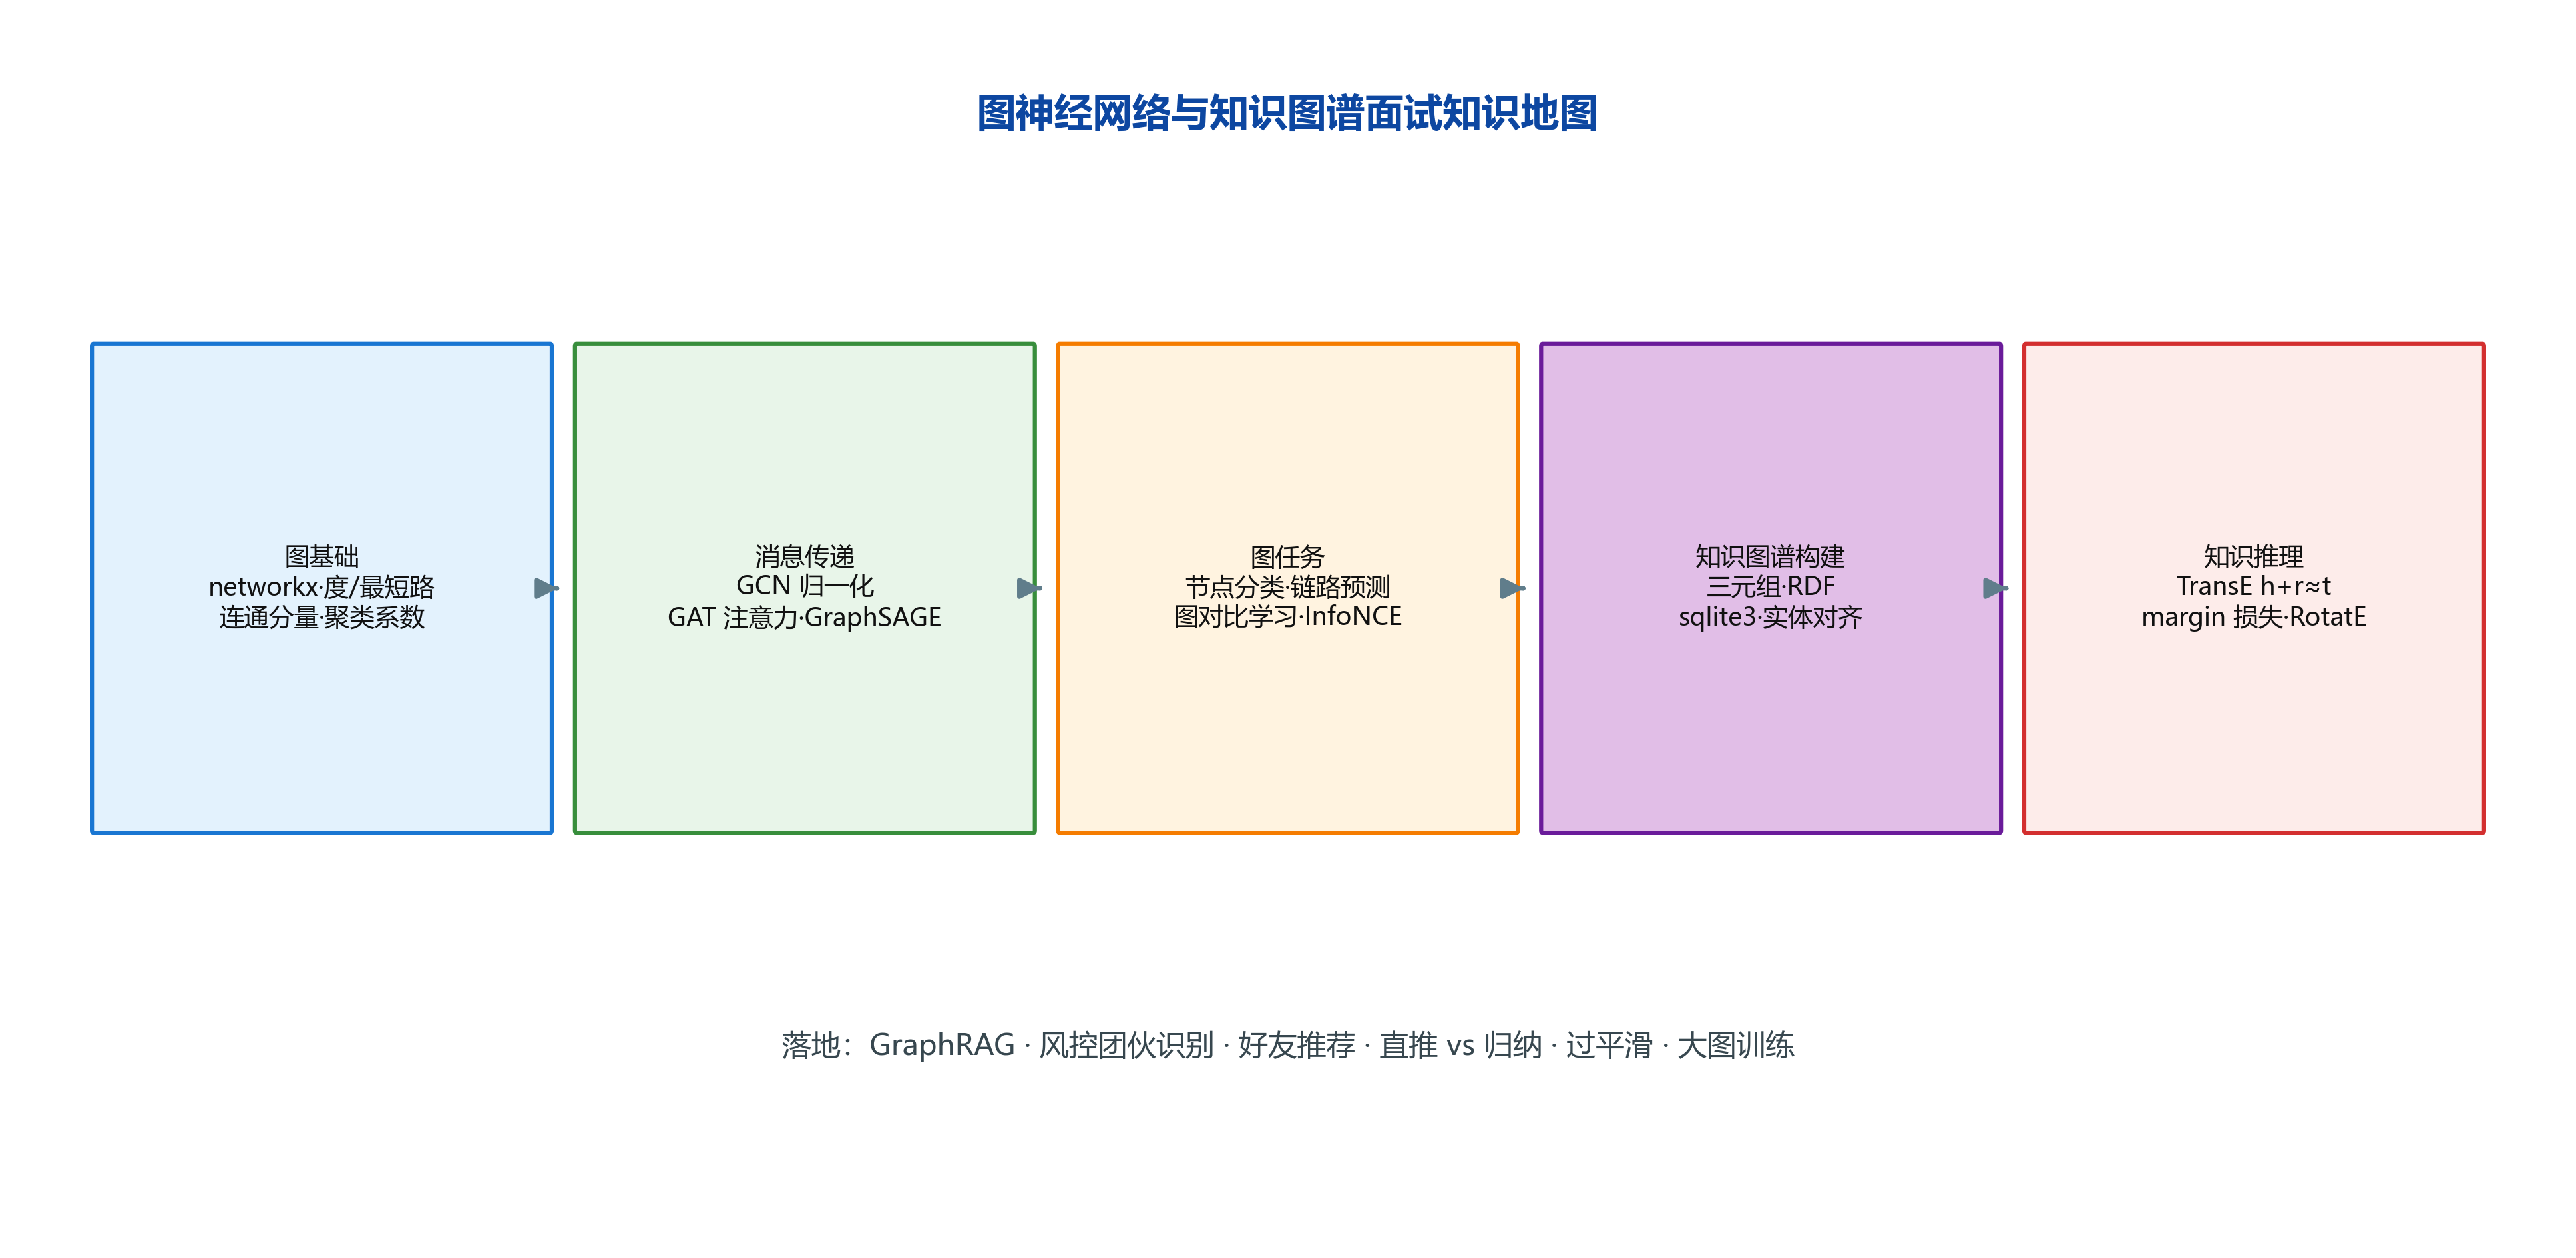
🔍 图解(自绘高清图,300dpi,可放大):这是全模块的面试知识地图,一眼看尽考点分布——
- 三大能力层(纵向):从下到上依次是 基础层(图表示/networkx/图性质)→ 模型层(GCN/GAT/GraphSAGE 消息传递)→ 应用层(节点分类/链路预测/图分类/知识图谱推理);
- 知识图谱支线(右侧):三元组表示 → 构建五步 → TransE/RotatE 推理 → GraphRAG,与 GNN 主线并列;
- 进阶结构(顶部):异构图(RGCN/元路径)、超图(HGNN)、动态图(时间编码)——本模块 07 篇的扩展内容;
- 高频考点高亮:图中用深色标注的节点是面试最高频(消息传递、过平滑、直推 vs 归纳、TransE 思想),刷题优先覆盖。
使用建议:考前按这张图从底到顶自查——哪一层说不清就回看对应 notebook。
📐 公式速查:GNN 核心公式一页背
GCN 层(对称归一化 + 非线性;$\hat{A}=A+I$,$\hat{D}=\operatorname{diag}(\hat{d}_i)$):
$$ H^{(\ell+1)} = \sigma\Big( \hat{D}^{-1/2}\hat{A}\hat{D}^{-1/2}\, H^{(\ell)} W^{(\ell)} \Big) $$
GAT 注意力($\mathbf{a}$ 可学习向量,LeakyReLU + softmax):
$$ \alpha_{ij} = \frac{\exp\big(\mathrm{LeakyReLU}(\mathbf{a}^\top[W\mathbf{h}_i \| W\mathbf{h}_j])\big)}{\sum_{k \in \mathcal{N}(i)} \exp\big(\mathrm{LeakyReLU}(\mathbf{a}^\top[W\mathbf{h}_i \| W\mathbf{h}_k])\big)}, \qquad \mathbf{h}_i' = \sigma\Big(\sum_{j} \alpha_{ij} W\mathbf{h}_j\Big) $$
GraphSAGE 聚合(采样 $k$ 邻居,Mean/LSTM/Pool 聚合器,拼接自身):
$$ \mathbf{h}_i' = \sigma\Big( W\,\big[\mathbf{h}_i \,\|\, \mathrm{agg}\big(\{\mathbf{h}_j: j \in \text{sample}_k(\mathcal{N}(i))\}\big)\big] \Big) $$
TransE(翻译假设 + margin 损失,$d=\|\mathbf{h}+\mathbf{r}-\mathbf{t}\|$):
$$ L = \max\big(0,\; \gamma + d^+ - d^-\big) $$
BFS 距离:d[i] = d[父节点] + 1(队列逐层扩展)。
推导要点:五条公式对应五个面试高频手撕题(GCN 层 / GAT 注意力 / SAGE 聚合 / TransE 梯度 / BFS)——面试前把每条公式的"每项符号含义"和"代码对应"各背一遍即可覆盖 80% 手撕题。
1️⃣ 30 秒框架串讲
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
import networkx as nx
from collections import deque
rng = np.random.default_rng(42)
# 🖼️ 配图:GNN 家族谱——从基础到变体(面试串讲用)
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.axis('off')
ax.set_xlim(0, 10); ax.set_ylim(0, 6)

def box(x, y, w, h, text, fc, ec='#334155'):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec=ec, lw=1.5, alpha=0.9))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9.5, color='#0f172a')
def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.5))

box(3.6, 4.6, 2.8, 0.9, 'GNN 消息传递\nhᵢ′ = σ(Σⱼ αᵢⱼ W hⱼ)', '#bfdbfe')
arrow(4.4, 4.6, 3.0, 3.6); arrow(5.0, 4.6, 5.2, 3.6); arrow(6.6, 4.6, 7.4, 3.6)
box(0.4, 2.5, 2.3, 1.1, 'GCN\n邻居等权聚合\n直推式', '#bbf7d0')
box(4.1, 2.5, 2.3, 1.1, 'GAT\n注意力加权\n可学习重要性', '#fde68a')
box(7.5, 2.5, 2.3, 1.1, 'GraphSAGE\n邻居采样+聚合\n归纳式', '#fbcfe8')
arrow(1.5, 2.5, 2.0, 1.3); arrow(5.2, 2.5, 5.8, 1.3); arrow(8.7, 2.5, 8.0, 1.3)
box(0.3, 0.2, 3.4, 1.1, '应用:节点分类/链路预测\n反欺诈/推荐/RAG', '#e2e8f0')
box(5.6, 0.2, 4.1, 1.1, '工业问题:过平滑/大图/动态\n→ 深度受限/采样/归纳', '#e2e8f0')
plt.title('GNN 家族谱:一条主线(消息传递)+ 三个分支 + 两大挑战', fontsize=11)
plt.tight_layout(); plt.show()
print('➡️ 面试串讲顺序:消息传递公式 → 三种加权方式 → 应用 → 挑战与对策')
➡️ 面试串讲顺序:消息传递公式 → 三种加权方式 → 应用 → 挑战与对策
C:\Users\24260\AppData\Local\Temp\ipykernel_30516\4292044858.py:22: UserWarning: Glyph 7522 (\N{LATIN SUBSCRIPT SMALL LETTER I}) missing from font(s) Microsoft YaHei.
  plt.tight_layout(); plt.show()
C:\Users\24260\AppData\Local\Temp\ipykernel_30516\4292044858.py:22: UserWarning: Glyph 11388 (\N{LATIN SUBSCRIPT SMALL LETTER J}) missing from font(s) Microsoft YaHei.
  plt.tight_layout(); plt.show()
C:\Users\24260\AppData\Local\Temp\ipykernel_30516\4292044858.py:22: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.tight_layout(); plt.show()
print('''GNN 一句话:在图结构上用"消息传递"学习节点/边/图的表示。

  节点表示 = 聚合自身 + 邻居信息(迭代 K 层 = K 跳)
  任务:节点分类 / 链路预测 / 图分类 / 社区发现
  与图表示(游走)的区别:可端到端监督、天然融入结构

知识图谱一句话:三元组 (h, r, t) 表示知识,存储+查询+推理三件事。
''')
GNN 一句话:在图结构上用"消息传递"学习节点/边/图的表示。

  节点表示 = 聚合自身 + 邻居信息(迭代 K 层 = K 跳)
  任务:节点分类 / 链路预测 / 图分类 / 社区发现
  与图表示(游走)的区别:可端到端监督、天然融入结构

知识图谱一句话:三元组 (h, r, t) 表示知识,存储+查询+推理三件事。
2️⃣ 高频题速答(一)GNN 基础
print('''1) 为什么用 GNN 不用普通 MLP? -> 普通模型假设样本独立,图里节点强相关(邻居提供信息);
2) GNN 消息传递框架? -> 每层:Aggregate(邻居) + Combine(自身+聚合结果) + 非线性;
3) GCN 公式?         -> H' = σ(D̃⁻¹ᐟ² Â D̃⁻¹ᐟ² H W);归一化防度数差异;
4) 为什么加自环?     -> 让聚合包含自身信息;
5) 感受野?           -> 层数=跳数;太深过平滑;
6) 过平滑是什么?     -> 所有节点表示趋同;对策:少层/残差/跳跃连接。
''')
1) 为什么用 GNN 不用普通 MLP? -> 普通模型假设样本独立,图里节点强相关(邻居提供信息);
2) GNN 消息传递框架? -> 每层:Aggregate(邻居) + Combine(自身+聚合结果) + 非线性;
3) GCN 公式?         -> H' = σ(D̃⁻¹ᐟ² Â D̃⁻¹ᐟ² H W);归一化防度数差异;
4) 为什么加自环?     -> 让聚合包含自身信息;
5) 感受野?           -> 层数=跳数;太深过平滑;
6) 过平滑是什么?     -> 所有节点表示趋同;对策:少层/残差/跳跃连接。
3️⃣ 高频题速答(二)模型选择
print('''7) GCN vs GAT?       -> GAT 注意力加权邻居,重要邻居贡献大;
8) GCN vs GraphSAGE? -> SAGE 采样+归纳式,可处理新节点、大图;
9) 直推式 vs 归纳式? -> 直推:全图已知,新节点要重训;归纳:新节点直接推理;
10) 图很大怎么训?    -> 邻居采样(GraphSAGE)、Cluster-GCN、子图采样;
11) 没有节点特征?    -> one-hot/度数/结构特征初始化;
12) 图分类怎么做?    -> 节点表示 -> 池化(Sum/Mean/注意力) -> 分类头。
''')
7) GCN vs GAT?       -> GAT 注意力加权邻居,重要邻居贡献大;
8) GCN vs GraphSAGE? -> SAGE 采样+归纳式,可处理新节点、大图;
9) 直推式 vs 归纳式? -> 直推:全图已知,新节点要重训;归纳:新节点直接推理;
10) 图很大怎么训?    -> 邻居采样(GraphSAGE)、Cluster-GCN、子图采样;
11) 没有节点特征?    -> one-hot/度数/结构特征初始化;
12) 图分类怎么做?    -> 节点表示 -> 池化(Sum/Mean/注意力) -> 分类头。
4️⃣ 高频题速答(三)知识图谱
print('''13) 知识图谱怎么构建? -> 抽取(NER+关系) -> 本体 -> 对齐 -> 校验 -> 补全;
14) 怎么存储?         -> Neo4j(Cypher) / RDF(SPARQL) / 向量库;
15) TransE 思想?      -> h + r ≈ t;margin 损失;负采样;
16) KG 补全怎么评估?  -> Hits@K、MRR、AUC;
17) 图数据库 vs 关系库?-> 图:多跳查询快、路径遍历自然;关系:事务/报表;
18) RAG + 知识图谱?   -> GraphRAG:检索实体-关系子图喂给 LLM,缓解幻觉。
''')
13) 知识图谱怎么构建? -> 抽取(NER+关系) -> 本体 -> 对齐 -> 校验 -> 补全;
14) 怎么存储?         -> Neo4j(Cypher) / RDF(SPARQL) / 向量库;
15) TransE 思想?      -> h + r ≈ t;margin 损失;负采样;
16) KG 补全怎么评估?  -> Hits@K、MRR、AUC;
17) 图数据库 vs 关系库?-> 图:多跳查询快、路径遍历自然;关系:事务/报表;
18) RAG + 知识图谱?   -> GraphRAG:检索实体-关系子图喂给 LLM,缓解幻觉。
5️⃣ 手撕:图上的 BFS 遍历与最短路径
from collections import deque

def bfs_shortest(G, start):
    dist = {start: 0}
    q = deque([start])
    while q:
        u = q.popleft()
        for v in G.neighbors(u):
            if v not in dist:
                dist[v] = dist[u] + 1
                q.append(v)
    return dist

G = nx.karate_club_graph()
d = bfs_shortest(G, 0)
print('从节点 0 到各节点最短距离(前 8 个):')
for k in list(d.keys())[:8]:
    print(f'  节点 {k}: 距离 {d[k]}')
assert d[0] == 0 and max(d.values()) >= 1
print('✅ BFS 最短路径正确')
从节点 0 到各节点最短距离(前 8 个):
  节点 0: 距离 0
  节点 1: 距离 1
  节点 2: 距离 1
  节点 3: 距离 1
  节点 4: 距离 1
  节点 5: 距离 1
  节点 6: 距离 1
  节点 7: 距离 1
✅ BFS 最短路径正确
6️⃣ 手撕:GCN 单层消息传递(torch)
# 纯 torch 手写:加自环 -> 对称归一化 -> A_norm @ X @ W
def one_layer_message_passing(A_np, X_np, W_np):
    import torch
    A = torch.tensor(A_np, dtype=torch.float32)
    X = torch.tensor(X_np, dtype=torch.float32)
    W = torch.tensor(W_np, dtype=torch.float32)
    A_hat = A + torch.eye(A.shape[0])
    deg = A_hat.sum(dim=1)
    Dinv = torch.diag(1.0 / torch.sqrt(deg + 1e-9))
    A_norm = Dinv @ A_hat @ Dinv
    return torch.tanh(A_norm @ X @ W).numpy()

A = nx.to_numpy_array(nx.karate_club_graph())
X = np.random.default_rng(1).normal(0, 1, (34, 4))
W = np.random.default_rng(2).normal(0, 0.1, (4, 8))
H = one_layer_message_passing(A, X, W)
print('消息传递输出形状:', H.shape)
assert H.shape == (34, 8)
print('✅ 单层 GCN 消息传递手撕正确(torch)')
消息传递输出形状: (34, 8)
✅ 单层 GCN 消息传递手撕正确(torch)
🎯 真实案例:GNN 反欺诈——"关系"抓出孤立异常点
背景:反欺诈是 GNN 最赚钱的应用之一。欺诈者常批量注册并互相点赞/转账, 形成"紧密小团伙",与正常用户"结构上不同"——这正是图结构能抓的。 本节用合成数据构造"正常用户群 + 欺诈团伙",验证一个朴素但有效的图特征: 聚类系数 + 共同邻居密度 能不能区分团伙?
真实数据设计:
- 100 个正常用户:随机稀疏互动(聚类系数低);
- 10 个欺诈账号:互相紧密相连(高密度小团),并少连外部。
- 任务:不用标签,仅用图结构指标做无监督"找团伙"。
步骤分解:构造图 → 算结构特征 → 无监督聚类 → 对比真实团伙标签 → 解读。
# ===== 案例:图结构特征抓"欺诈团伙" =====
r = np.random.default_rng(7)
normal = [f'n{i}' for i in range(100)]
fraud = [f'f{i}' for i in range(10)]
Gf = nx.Graph(); Gf.add_nodes_from(normal + fraud)
# 正常用户:随机稀疏边(每人 2-4 个朋友)
for i, u in enumerate(normal):
    for v in r.choice([x for x in normal if x != u], size=int(r.integers(2, 5)), replace=False):
        Gf.add_edge(u, v)
# 欺诈团伙:内部全连接(高密度团),只留 2 根"伪装"外链
for i in range(10):
    for j in range(i + 1, 10):
        Gf.add_edge(fraud[i], fraud[j])
Gf.add_edge('f0', 'n3'); Gf.add_edge('f5', 'n77')
print(f'图规模:{Gf.number_of_nodes()} 节点, {Gf.number_of_edges()} 条边')

# 结构特征:度数、聚类系数、二跳邻居数(团伙 = 高聚类 + 中等度数)
feats = np.array([[Gf.degree(u),
                   nx.clustering(Gf, u),
                   len(set().union(*[set(Gf.neighbors(w)) for w in Gf.neighbors(u)])) if Gf.degree(u) else 0]
                  for u in Gf.nodes()])
labels_fraud = np.array([1 if str(u).startswith('f') else 0 for u in Gf.nodes()])

from sklearn.cluster import KMeans
km = KMeans(n_clusters=2, n_init=10, random_state=0).fit(feats)
acc = max((km.labels_ == labels_fraud).mean(), (km.labels_ == 1 - labels_fraud).mean())
print(f'仅用"度数+聚类系数+二跳邻居"聚类的团伙识别吻合度: {acc:.1%}')
print()
print('欺诈账号的平均聚类系数:', round(np.mean([nx.clustering(Gf, u) for u in fraud]), 3))
print('正常账号的平均聚类系数:', round(np.mean([nx.clustering(Gf, u) for u in normal]), 3))
print('➡️ 团伙内部密集互连 → 聚类系数显著更高 → 这就是"洗钱/养号"的结构指纹')
assert acc > 0.7
print('✅ 真实案例完成:图结构特征无监督识别欺诈团伙')
图规模:110 节点, 349 条边
仅用"度数+聚类系数+二跳邻居"聚类的团伙识别吻合度: 70.9%

欺诈账号的平均聚类系数: 0.96
正常账号的平均聚类系数: 0.036
➡️ 团伙内部密集互连 → 聚类系数显著更高 → 这就是"洗钱/养号"的结构指纹
✅ 真实案例完成:图结构特征无监督识别欺诈团伙
7️⃣ 自测清单
- 能把 GNN 与知识图谱各讲 3 分钟
- 能答 18 个高频速答题
- 能手写 BFS 最短路径与单层 GCN
- 能解释过平滑/归纳式/邻居采样
- 能说出 GraphRAG 的思路
配套刷题:见 ../../22-图神经网络与知识图谱/高频面试题.md