🧊 06 · 冷启动与多目标优化¶
新用户/新物品没有行为怎么办(冷启动)?点击好但成交差怎么权衡(多目标)? 这两块是推荐岗高阶面试题。本节给五类冷启动方案 + ESMM/MMoE 思想与简例。
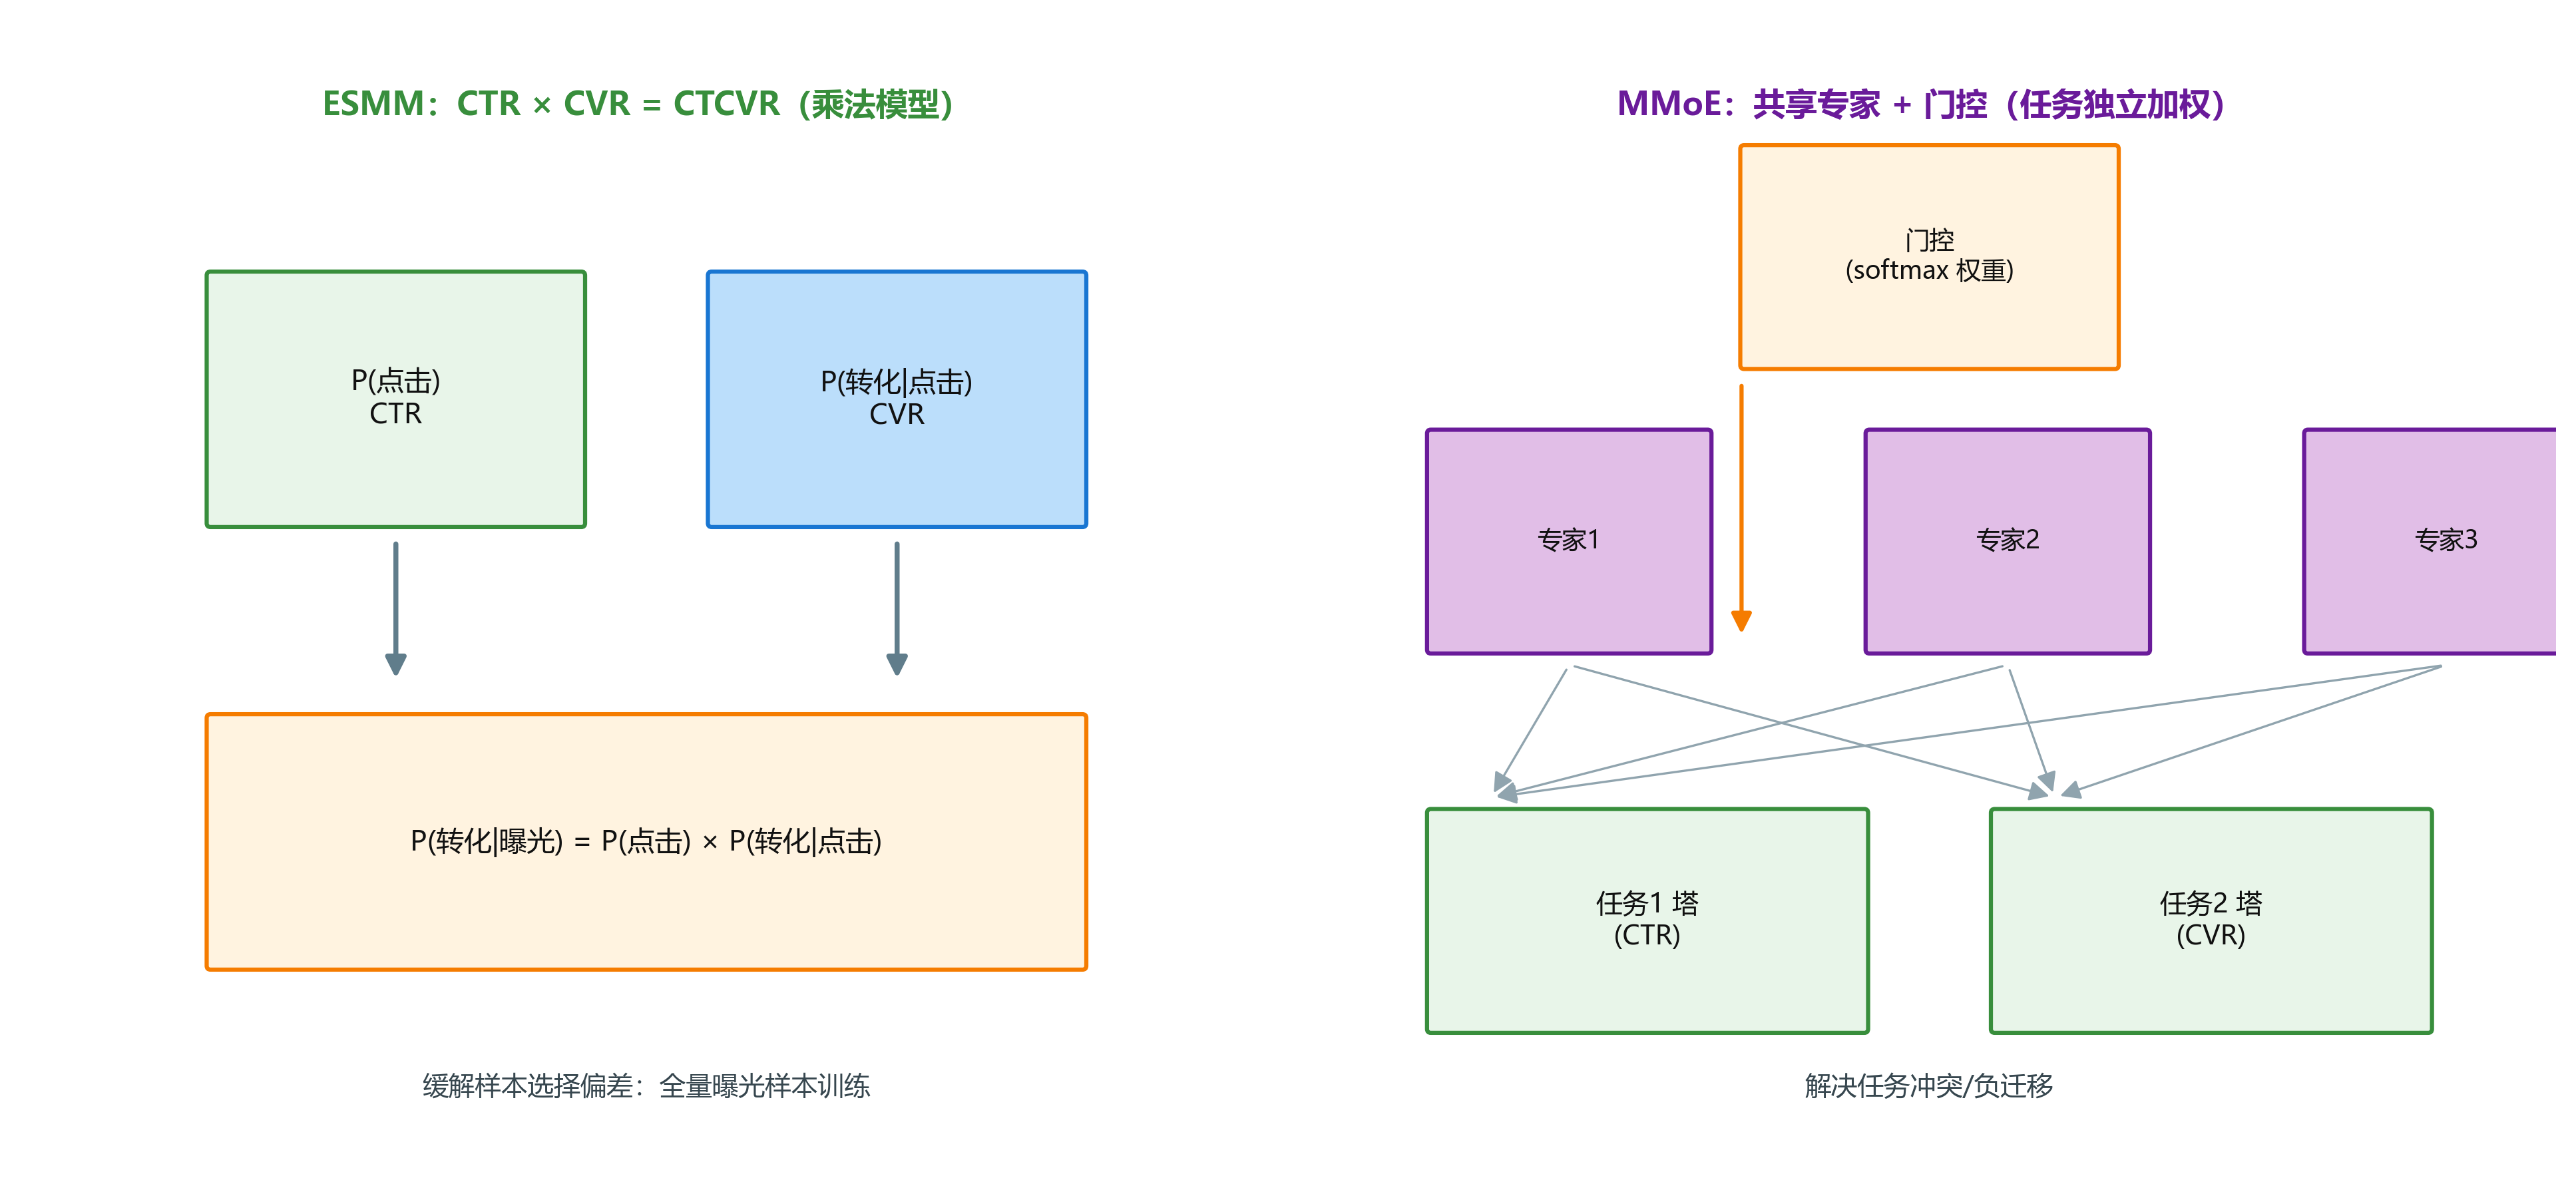
🔍 图解(自绘高清图,300dpi,可放大):推荐系统常要同时优化多个目标(点击/转化/时长), 这张图对照两种主流多目标方案——
- 上(ESMM:乘法关系):点击率 p(CTR) 与"点击后转化率" p(CVR) 是漏斗关系—— 先看是否点击、点击后才可能转化,于是建模 pCTCVR = pCTR × pCVR(乘法路径): 用全量曝光数据训练 CTR,用"点击子集"训练 CVR,两个塔共享底层特征,避免 CVR 样本稀疏偏差;
- 下(MMoE:门控专家):多个任务共享一组专家网络(Expert),每个任务有自己的 门控(Gate)——门控学习"这个任务更信任哪些专家"的权重,按任务加权组合专家输出; 任务间共享底层信息(同一位用户的行为模式)又各取所需(CTR 更重兴趣、时长更重沉浸);
- 选型:目标间是"先后漏斗"关系用 ESMM(点击→转化),是"并行多面"关系用 MMoE(时长+完播+点赞)。
🎬 背景故事¶
新用户第一次进来,系统对他一无所知……
一个新用户注册进来,系统对他的偏好一无所知——推什么? 这就是冷启动。更麻烦的是,推荐的目标从来不止一个:既要点击率高,又要转化率高,还要时长久。本节把两件"高阶难题"一次讲透:冷启动五大方案、多目标优化(ESMM 乘法 + MMoE 门控)。
🧭 本节逻辑主线:冷启动困境 → 五大方案(热度/画像/迁移/试探/EE)→ 为什么不能只优化点击 → ESMM 如何用乘法解选择偏差 → MMoE 如何用门控解任务冲突。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 用户冷启动怎么解? | 试探/热度/内容画像/迁移 |
| 2 | 物品冷启动怎么解? | 内容特征/类目热度/探索 |
| 3 | 点击和转化怎么一起优化? | ESMM(多任务) |
| 4 | 多个目标怎么平衡? | MMoE(门控专家) |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 冷启动方案地图(必背)¶
print('''用户冷启动:
  1) 试探法:随机/热门榜兜底,看行为再个性化;
  2) 热度法:给全局热门(覆盖广,体验稳);
  3) 画像法:用注册信息/授权(性别/城市/兴趣)匹配类目;
  4) 迁移法:跨平台/跨场景行为迁移(同集团账号打通);
  5) 主动问:冷启动问卷/引导选兴趣(成本高)。

物品冷启动:
  1) 内容特征:用文本/视觉 embedding 找相似老物品;
  2) 类目热度:新物品给所在类目的平均 CTR 先验;
  3) 探索:给新物品一定曝光配额(EE 探索-利用);
  4) 提权:新品加权/打标,扶持期观察。
''')
用户冷启动:
  1) 试探法:随机/热门榜兜底,看行为再个性化;
  2) 热度法:给全局热门(覆盖广,体验稳);
  3) 画像法:用注册信息/授权(性别/城市/兴趣)匹配类目;
  4) 迁移法:跨平台/跨场景行为迁移(同集团账号打通);
  5) 主动问:冷启动问卷/引导选兴趣(成本高)。

物品冷启动:
  1) 内容特征:用文本/视觉 embedding 找相似老物品;
  2) 类目热度:新物品给所在类目的平均 CTR 先验;
  3) 探索:给新物品一定曝光配额(EE 探索-利用);
  4) 提权:新品加权/打标,扶持期观察。
2️⃣ 冷启动 demo:热度兜底 vs 画像匹配¶
n_item = 100
item_hot = rng.uniform(0, 1, n_item)                     # 全局热度
item_cat = rng.integers(0, 5, n_item)                    # 物品类目
user_pref = rng.integers(0, 5)                            # 新用户兴趣类目

# 热度兜底:直接按热度排
rec_hot = np.argsort(-item_hot)[:10]

# 画像匹配:先按用户兴趣类目过滤,再按热度排
cand = np.where(item_cat == user_pref)[0]
if len(cand) < 10:
    cand = np.concatenate([cand, np.where(item_cat != user_pref)[0]])
rec_img = cand[np.argsort(-item_hot[cand])][:10]

print(f'新用户兴趣类目: {user_pref}')
print('热度兜底 top5 类目:', item_cat[rec_hot[:5]])
print('画像匹配 top5 类目:', item_cat[rec_img[:5]])
assert len(rec_img) == 10
print('\n✅ 画像匹配显著提高"类目相关"(热度兜底只看全局)')
新用户兴趣类目: 1
热度兜底 top5 类目: [1 3 4 0 3]
画像匹配 top5 类目: [1 1 1 1 1]

✅ 画像匹配显著提高"类目相关"(热度兜底只看全局)
📐 公式推导:ESMM——用"点击→转化"漏斗解耦 CVR¶
核心等式(曝光 $\to$ 点击 $\to$ 转化两级漏斗,$P$ 表示概率、$\odot$ 为逐元素乘):
$$ P(\text{转化} \mid \text{曝光}) = P(\text{点击} \mid \text{曝光}) \cdot P(\text{转化} \mid \text{点击}) $$
符号:$z_i \in \{0,1\}$ 曝光、$c_i \in \{0,1\}$ 点击、$b_i \in \{0,1\}$ 转化;由于"转化必然先点击",$b_i \le c_i$。 用全空间样本(曝光域)建模 CTR 与 CTCVR,隐式得到 CVR 目标:
$$ \hat{y}^{CTR}_i = P(c_i{=}1 \mid z_i{=}1), \qquad \hat{y}^{CTCVR}_i = P(b_i{=}1 \mid z_i{=}1) = \hat{y}^{CTR}_i \cdot \hat{y}^{CVR}_i $$
联合损失(两个塔共享底层 embedding,误差同时回传):
$$ L = L^{CTR} + L^{CTCVR} = -\sum_{i} \big[ c_i \log \hat{y}^{CTR}_i + (1-c_i)\log(1-\hat{y}^{CTR}_i) \big] - \sum_{i} \big[ b_i \log \hat{y}^{CTCVR}_i + (1-b_i)\log(1-\hat{y}^{CTCVR}_i) \big] $$
推导要点(为什么比直接学 CVR 好):直接学 $P(\text{转化}|\text{点击})$ 只用点击样本,存在选择偏差(点击样本不代表曝光全集)和样本稀疏;ESMM 用全空间曝光样本 + 等式约束,天然消除偏差。
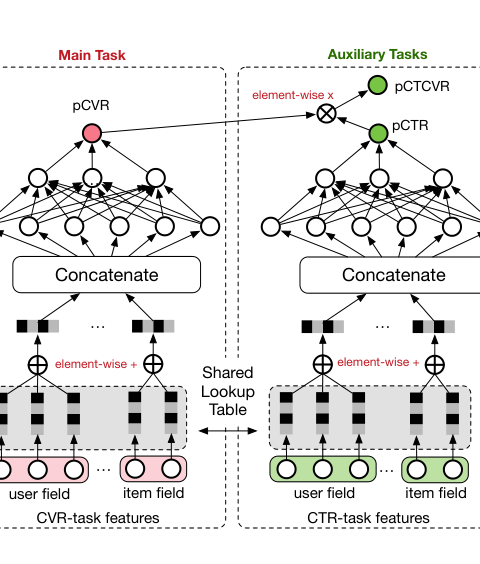
📄 经典论文原图:ESMM 架构
🔍 图解与逻辑衔接:图中共享底部 embedding 后分出三个预测量:点击率 pCTR、点击后转化率 pCVR、全空间点击转化率 pCTCVR。ESMM 用概率链式关系约束三者:pCTCVR = pCTR × pCVR。这样 CVR 不再只在“已经点击”的狭窄样本空间训练,而是借助全部曝光样本学习,缓解样本选择偏差与 CVR 正例稀疏问题。阅读顺序:先看图中的共享表示与三条输出路径,再回到下面的公式推导,最后对照代码中的乘法关系。它与本节自绘的 ESMM+MMoE 总图互补:论文图解释 ESMM 的概率约束,自绘图解释 ESMM 与 MMoE 的选型差异。
论文出处:Ma et al., “Entire Space Multi-Task Model: An Effective Approach for Estimating Post-Click Conversion Rate”, SIGIR 2018(arXiv:1804.07931),Figure 2。
3️⃣ 多目标问题:CTR 与 CVR 的关联¶
✍️ §3.1 手算多目标加权:α 组合损失与梯度¶
多目标(CTR / 时长 / 互动)不是"分开训",而是加权合并损失 + 加权合并梯度。用两个具体 loss 和一个 2 维梯度向量,把加权机制算清楚。
第 1 步:加权组合损失——当前 batch 两个任务的损失,权重 $(\alpha,\beta)=(0.6,0.4)$:
$$L_{\text{ctr}}=0.3,\quad L_{\text{dur}}=0.5,\qquad L=\alpha L_{\text{ctr}}+\beta L_{\text{dur}}=0.6\times0.3+0.4\times0.5=0.18+0.20=0.38$$
第 2 步:换个权重看敏感性——$\alpha=0.8$(更重视 CTR):
$$L=0.8\times0.3+0.2\times0.5=0.24+0.10=0.34$$
同样的两个任务损失,组合损失从 0.38 变成 0.34——权重 $\alpha$ 就是产品对两个目标的"主观汇率":改权重不改变任务本身,只改变优化天平。
第 3 步:梯度也按权重合并——两个任务各自的梯度(2 维示例):
$$\mathbf{g}_{\text{ctr}}=[0.2,\ -0.1],\qquad \mathbf{g}_{\text{dur}}=[0.05,\ 0.15]$$
$$\mathbf{g}=0.6\,\mathbf{g}_{\text{ctr}}+0.4\,\mathbf{g}_{\text{dur}}=[0.12+0.02,\ -0.06+0.06]=[0.14,\ 0.00]$$
手算收获:
- 组合损失是线性合并时,梯度就是各任务梯度的加权和——实现上"各任务各自回传 → 按权重相加"即可;MMoE 门控输出的任务权重 $g_k$ 对专家输出做同样的事(§4)
- 例子的第 2 维 $0.6\times(-0.1)+0.4\times0.15=0.0$:两个任务在该维度梯度方向相反、恰好相消——这是多目标训练"跷跷板"现象的数学来源(共享参数被任务打架拉不动)
- 权重本质是"评估指标的换算":$\alpha$ 调大 → 模型偏向 CTR,时长/互动指标下滑——调参看的是整条 trade-off 曲线(帕累托前沿),不是单个 loss 的绝对大小
- ESMM 是另一种"合并":不设权重,用结构建模"曝光→点击→转化"漏斗($p\text{CTCVR}=p\text{CTR}\times p\text{CVR}$,§2),从结构上避免 CTR 与 CVR 的样本偏差——记住了"加权"与"结构解耦"是两条路线
下面 numpy 复算。
# ---- §3.1 验证:numpy 复算多目标加权 ----
import numpy as np

hc_l_ctr, hc_l_dur = 0.3, 0.5
hc_alpha = 0.6
hc_L = hc_alpha * hc_l_ctr + (1 - hc_alpha) * hc_l_dur
print(f'L = {hc_alpha}*0.3 + {1 - hc_alpha}*0.5 = {hc_L:.4f}')
assert abs(hc_L - 0.38) < 1e-9

hc_L2 = 0.8 * hc_l_ctr + 0.2 * hc_l_dur
print(f'α=0.8 → L = {hc_L2:.4f}')
assert abs(hc_L2 - 0.34) < 1e-9

hc_g_ctr = np.array([0.2, -0.1])
hc_g_dur = np.array([0.05, 0.15])
hc_g = hc_alpha * hc_g_ctr + (1 - hc_alpha) * hc_g_dur
print('合并梯度 = 0.6*[0.2,-0.1] + 0.4*[0.05,0.15] =', np.round(hc_g, 4))
assert np.allclose(hc_g, [0.14, 0.0], atol=1e-9)
print('✓ 与手算一致')
# 🖼️ 配图:ESMM——用"曝光→点击→转化"全链路解耦 CVR
fig, ax = plt.subplots(figsize=(8.5, 3.6))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 4.4)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=9)

def arrow(x1, y1, x2, y2, color='#64748b'):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color=color, lw=1.6))

box(0.5, 3.0, 2.2, 1.0, '曝光\n(全部样本)', '#e2e8f0')
box(4.1, 3.0, 2.2, 1.0, '点击\n(样本子集)', '#bfdbfe')
box(7.7, 3.0, 2.2, 1.0, '转化\n(更小子集)', '#fecaca')
arrow(2.8, 3.5, 4.0, 3.5, '#16a34a'); arrow(6.4, 3.5, 7.6, 3.5, '#16a34a')
ax.text(3.4, 3.9, 'P(ctr)', fontsize=9, color='#16a34a', ha='center')
ax.text(7.0, 3.9, 'P(cvr|click)', fontsize=9, color='#16a34a', ha='center')
box(2.3, 0.8, 5.6, 1.1, '联合建模:L = L_CTR + L_CTCVR\nP(ctcvr) = P(ctr) × P(cvr|click)', '#fef9c3')
arrow(1.6, 3.0, 3.9, 1.9); arrow(4.4, 3.0, 4.6, 1.9); arrow(8.1, 3.0, 6.2, 1.9)
plt.title('ESMM:转化 = 曝光→点击→转化 的漏斗(解耦选择偏差)', fontsize=11)
plt.show()
print('➡️ 面试:直接学 CVR 只用"点击后"样本有选择偏差;ESMM 全链路联合学')
➡️ 面试:直接学 CVR 只用"点击后"样本有选择偏差;ESMM 全链路联合学
C:\Users\24260\AppData\Local\Temp\ipykernel_48968\606271975.py:22: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 常见痛点:点击样本多、转化样本少;直接学 CVR 受选择偏差影响
# ESMM 思路:P(转化|曝光) = P(点击|曝光) × P(转化|点击)
# 用全样本学点击率,用点击样本学"点击后转化率",两者乘起来做整体目标
n = 100000
p_ctr = 0.10
p_cvr_given_click = 0.08
click = rng.uniform(0, 1, n) < p_ctr
convert = click & (rng.uniform(0, 1, n) < p_cvr_given_click)
print(f'点击率: {click.mean():.3f}(≈10%)')
print(f'整体转化率: {convert.mean():.3f}(≈{p_ctr*p_cvr_given_click:.1%})')
print(f'点击后转化率: {convert[click].mean():.3f}(≈8%)')
assert abs(convert.mean() - p_ctr * p_cvr_given_click) < 0.02
print('✅ ESMM 的乘法关系演示:整体转化 = 点击 × 点击后转化')
点击率: 0.099(≈10%)
整体转化率: 0.008(≈0.8%)
点击后转化率: 0.078(≈8%)
✅ ESMM 的乘法关系演示:整体转化 = 点击 × 点击后转化
📐 公式推导:MMoE——多专家 + 门控¶
专家:$K$ 个共享专家网络 $f_k(\mathbf{x})$(通常为浅 MLP),输出 $\mathbb{R}^d$。 任务 $t$ 的门控:softmax 归一化的权重向量 $\mathbf{g}^t \in \mathbb{R}^K$(输入同样为 $\mathbf{x}$,由小网络产生):
$$ \mathbf{g}^t(\mathbf{x}) = \mathrm{softmax}\big( \mathbf{W}_g^t \mathbf{x} + \mathbf{b}_g^t \big), \qquad g_k^t = \frac{e^{z_k^t}}{\sum_{k'} e^{z_{k'}^t}} $$
任务塔输出:门控对专家输出做凸组合,再过各任务专属塔 $h_t$:
$$ y_t(\mathbf{x}) = h_t\Big( \sum_{k=1}^{K} g_k^t(\mathbf{x}) \, f_k(\mathbf{x}) \Big) $$
与硬参数共享的对比:共享底层把所有任务捆死→任务冲突时互相拖累(如 CTR 与停留时长方向可能相反);MMoE 允许各任务按需取用专家,门控凸组合保证数值稳定(权重非负且和为 1)。 面试推导:问"为什么用 softmax 权重而不是直接拼接"——凸组合是可微的软选择,梯度能传到门控网络,自动学习任务-专家匹配;直接拼接(Shared-Bottom 变体)每个任务看到同样的表示,退化回共享模型。
4️⃣ MMoE:多专家 + 门控¶
# MMoE:多个专家网络,门控为每个任务分配专家权重
# 演示:两个任务(点击/时长),两个专家
n_exp, n_tasks = 2, 2
gate = rng.uniform(0.1, 1, (n_tasks, n_exp))   # 门控权重(任务 x 专家)
gate = gate / gate.sum(axis=1, keepdims=True)
expert_out = rng.normal(0, 1, (n_exp, 1000))   # 每个专家的输出(1000 个样本)

# 每个任务 = 门控加权专家输出的组合
task_out = gate @ expert_out
print('门控权重矩阵(任务×专家):')
print(pd.DataFrame(gate.round(3), index=['任务1:点击', '任务2:时长'], columns=['专家A', '专家B']).to_string())
print('\n任务1 输出维度:', task_out[0].shape)
print('➡️ MMoE 让不同任务"按需使用"共享专家,缓解任务冲突与负迁移')
门控权重矩阵(任务×专家):
          专家A    专家B
任务1:点击  0.456  0.544
任务2:时长  0.465  0.535

任务1 输出维度: (1000,)
➡️ MMoE 让不同任务"按需使用"共享专家,缓解任务冲突与负迁移
5️⃣ 多目标面试追问(速答)¶
print('''1) 为什么不能只优化 CTR? → 点击好但转化差,平台和商家目标不一致;
2) 多任务常见问题?       → 任务冲突、样本稀疏不均、梯度冲突(负迁移);
3) 解决方案?            → 共享底部(硬共享)、ESMM(全样本乘法)、MMoE(门控)、PLE(多级专家);
4) 怎么调权重?          → 业务目标换算(如 1 次成交=多少次点击)或离线搜索权重;
5) 指标怎么定义?        → 加权业务指标(GMV + 时长 + 留存 的复合目标)。
''')
1) 为什么不能只优化 CTR? → 点击好但转化差,平台和商家目标不一致;
2) 多任务常见问题?       → 任务冲突、样本稀疏不均、梯度冲突(负迁移);
3) 解决方案?            → 共享底部(硬共享)、ESMM(全样本乘法)、MMoE(门控)、PLE(多级专家);
4) 怎么调权重?          → 业务目标换算(如 1 次成交=多少次点击)或离线搜索权重;
5) 指标怎么定义?        → 加权业务指标(GMV + 时长 + 留存 的复合目标)。
📝 自测清单¶
- 能背出用户冷启动五方案与物品冷启动四方案
- 能实现"热度兜底 vs 画像匹配"并说明差异
- 能解释 ESMM 乘法关系与解决的选择偏差
- 能画出 MMoE 结构(门控+专家)并说明作用
- 能回答多目标任务冲突的几种解法