🏗️ 21-大数据与数仓:Hadoop / Spark / Flink / Hive 数仓 / Kafka / 调度
大数据岗位(离线/实时/数仓)面试覆盖 HDFS、MapReduce、Spark、Flink、Hive 分层建模、 Kafka 管道、调度与治理。本模块用 Python 模拟实现讲透每个核心机制: 分块副本、Map/Shuffle/Reduce、RDD 惰性求值与血缘、窗口与水位线、 ODS→DWD→DWS→ADS 四层数仓(sqlite3 实战)、分区与偏移量、DAG 调度。
面向秋招画像:大数据开发、数据仓库、实时计算、数据平台、数据工程 岗位。 前置衔接:17-数据科学(SQL/数据分析)、18-数据分析(业务指标)、 02-机器学习(特征工程,算法特征产出依赖数仓)。
🖼️ 教学 notebook 全部基于 numpy/pandas/matplotlib/sqlite3,无需集群即可运行, 含断言与数值对照(含与 pandas/SQL 的交叉验证);绘图统一中文字体并显式
plt.show()。
知识地图(面试考察的七大块)
大数据与数仓考点
├── 1. 体系与存储  Hadoop 三件套 · HDFS 分块/副本/读写 · 存算分离 · 小文件
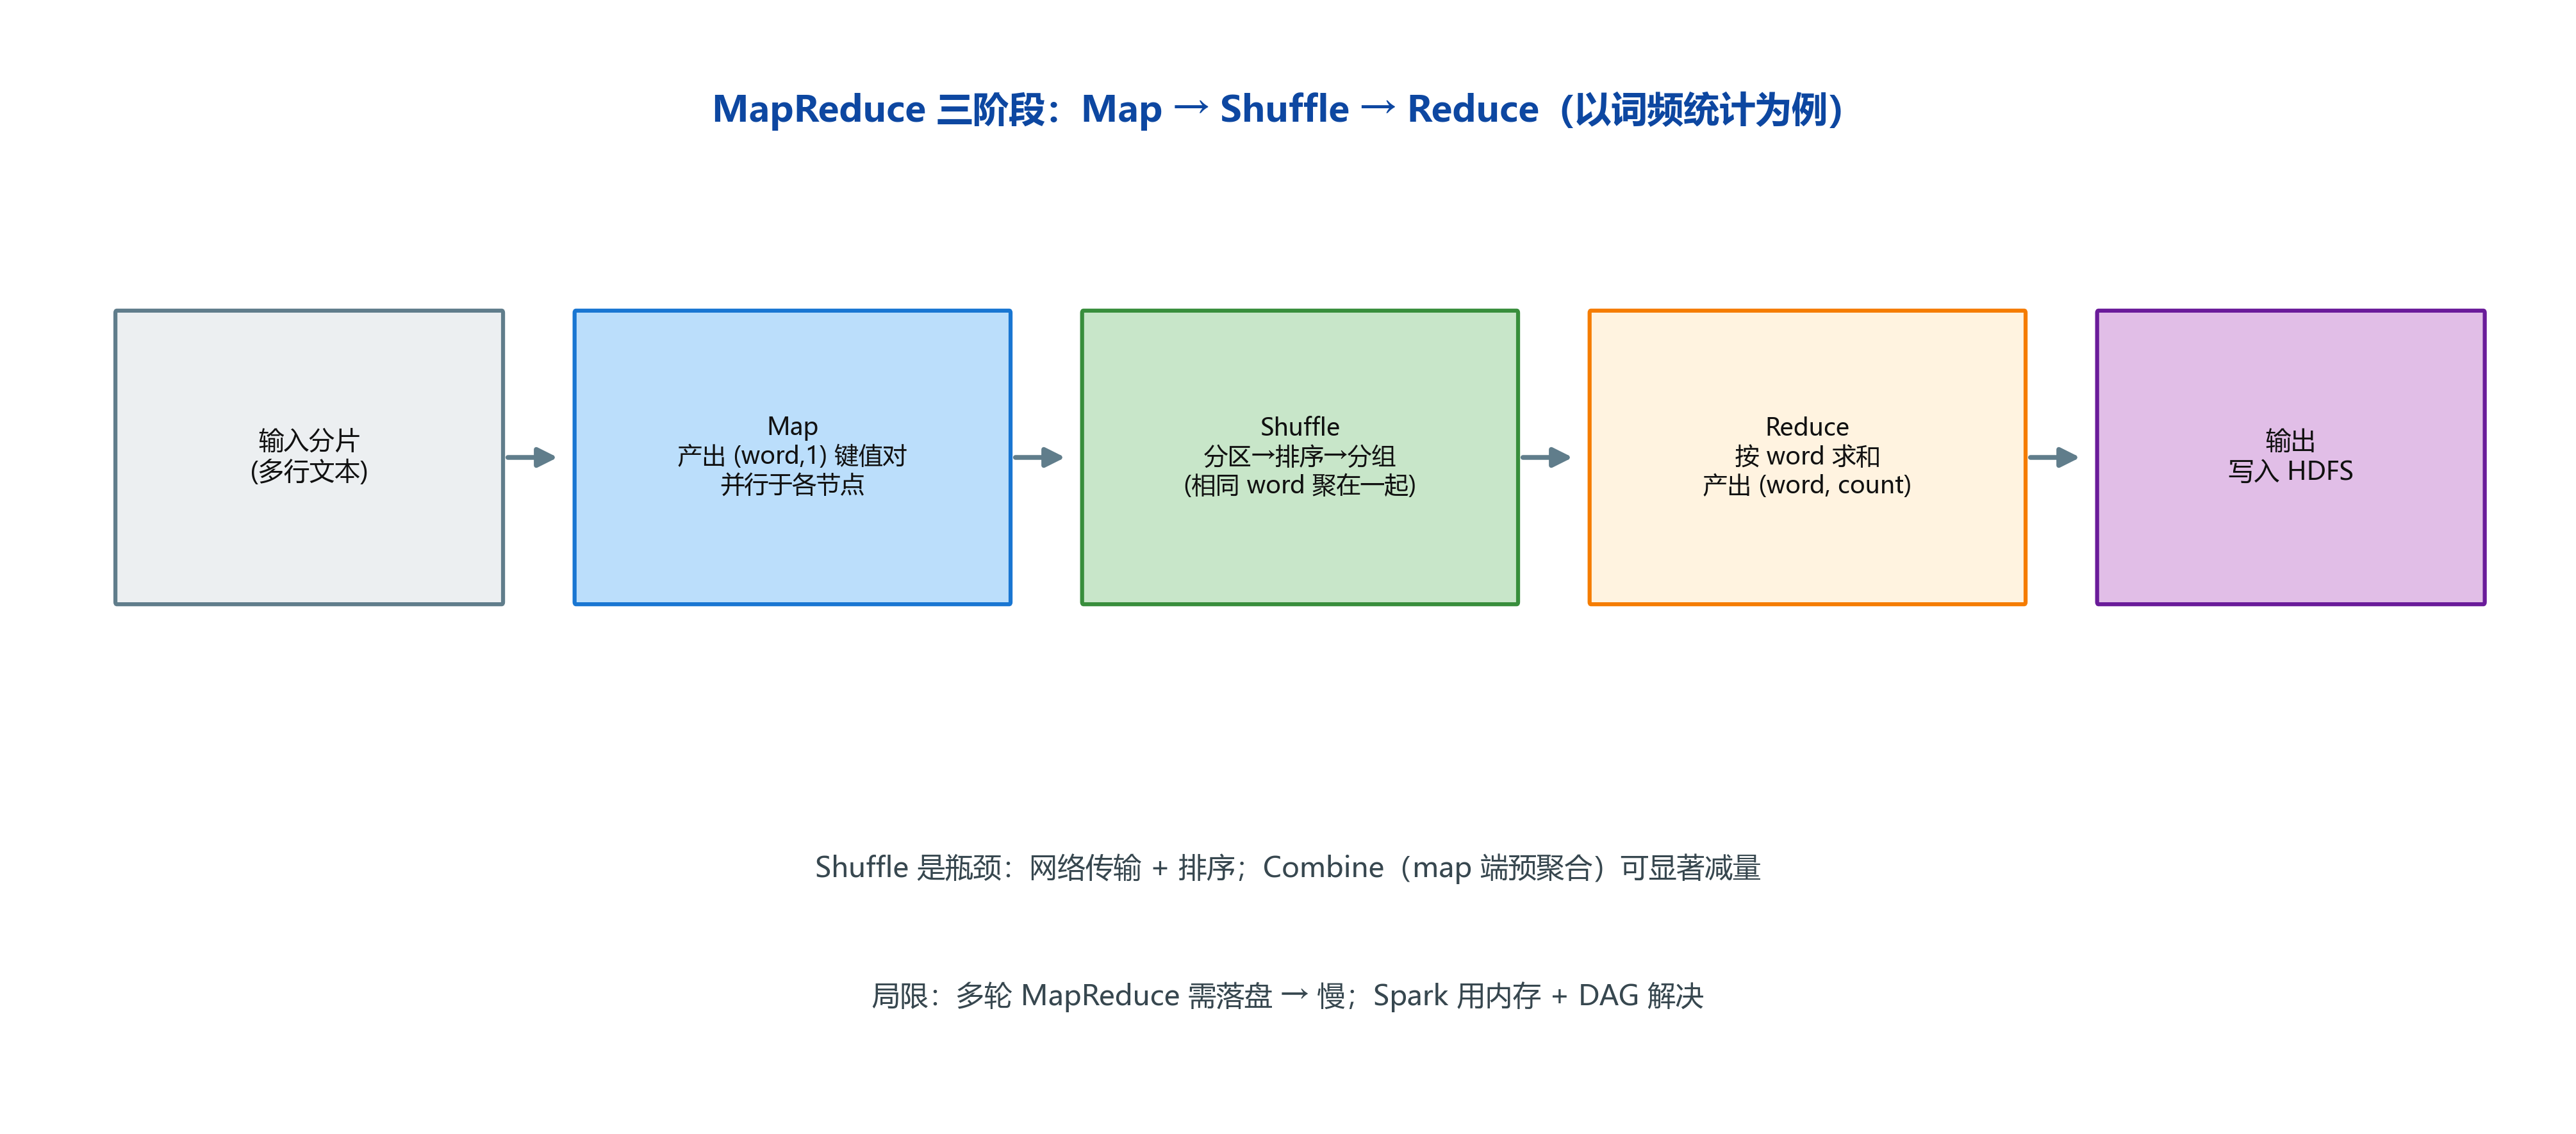
├── 2. 离线计算    MapReduce(Map/Shuffle/Reduce)· 词频手写在先 · 局限
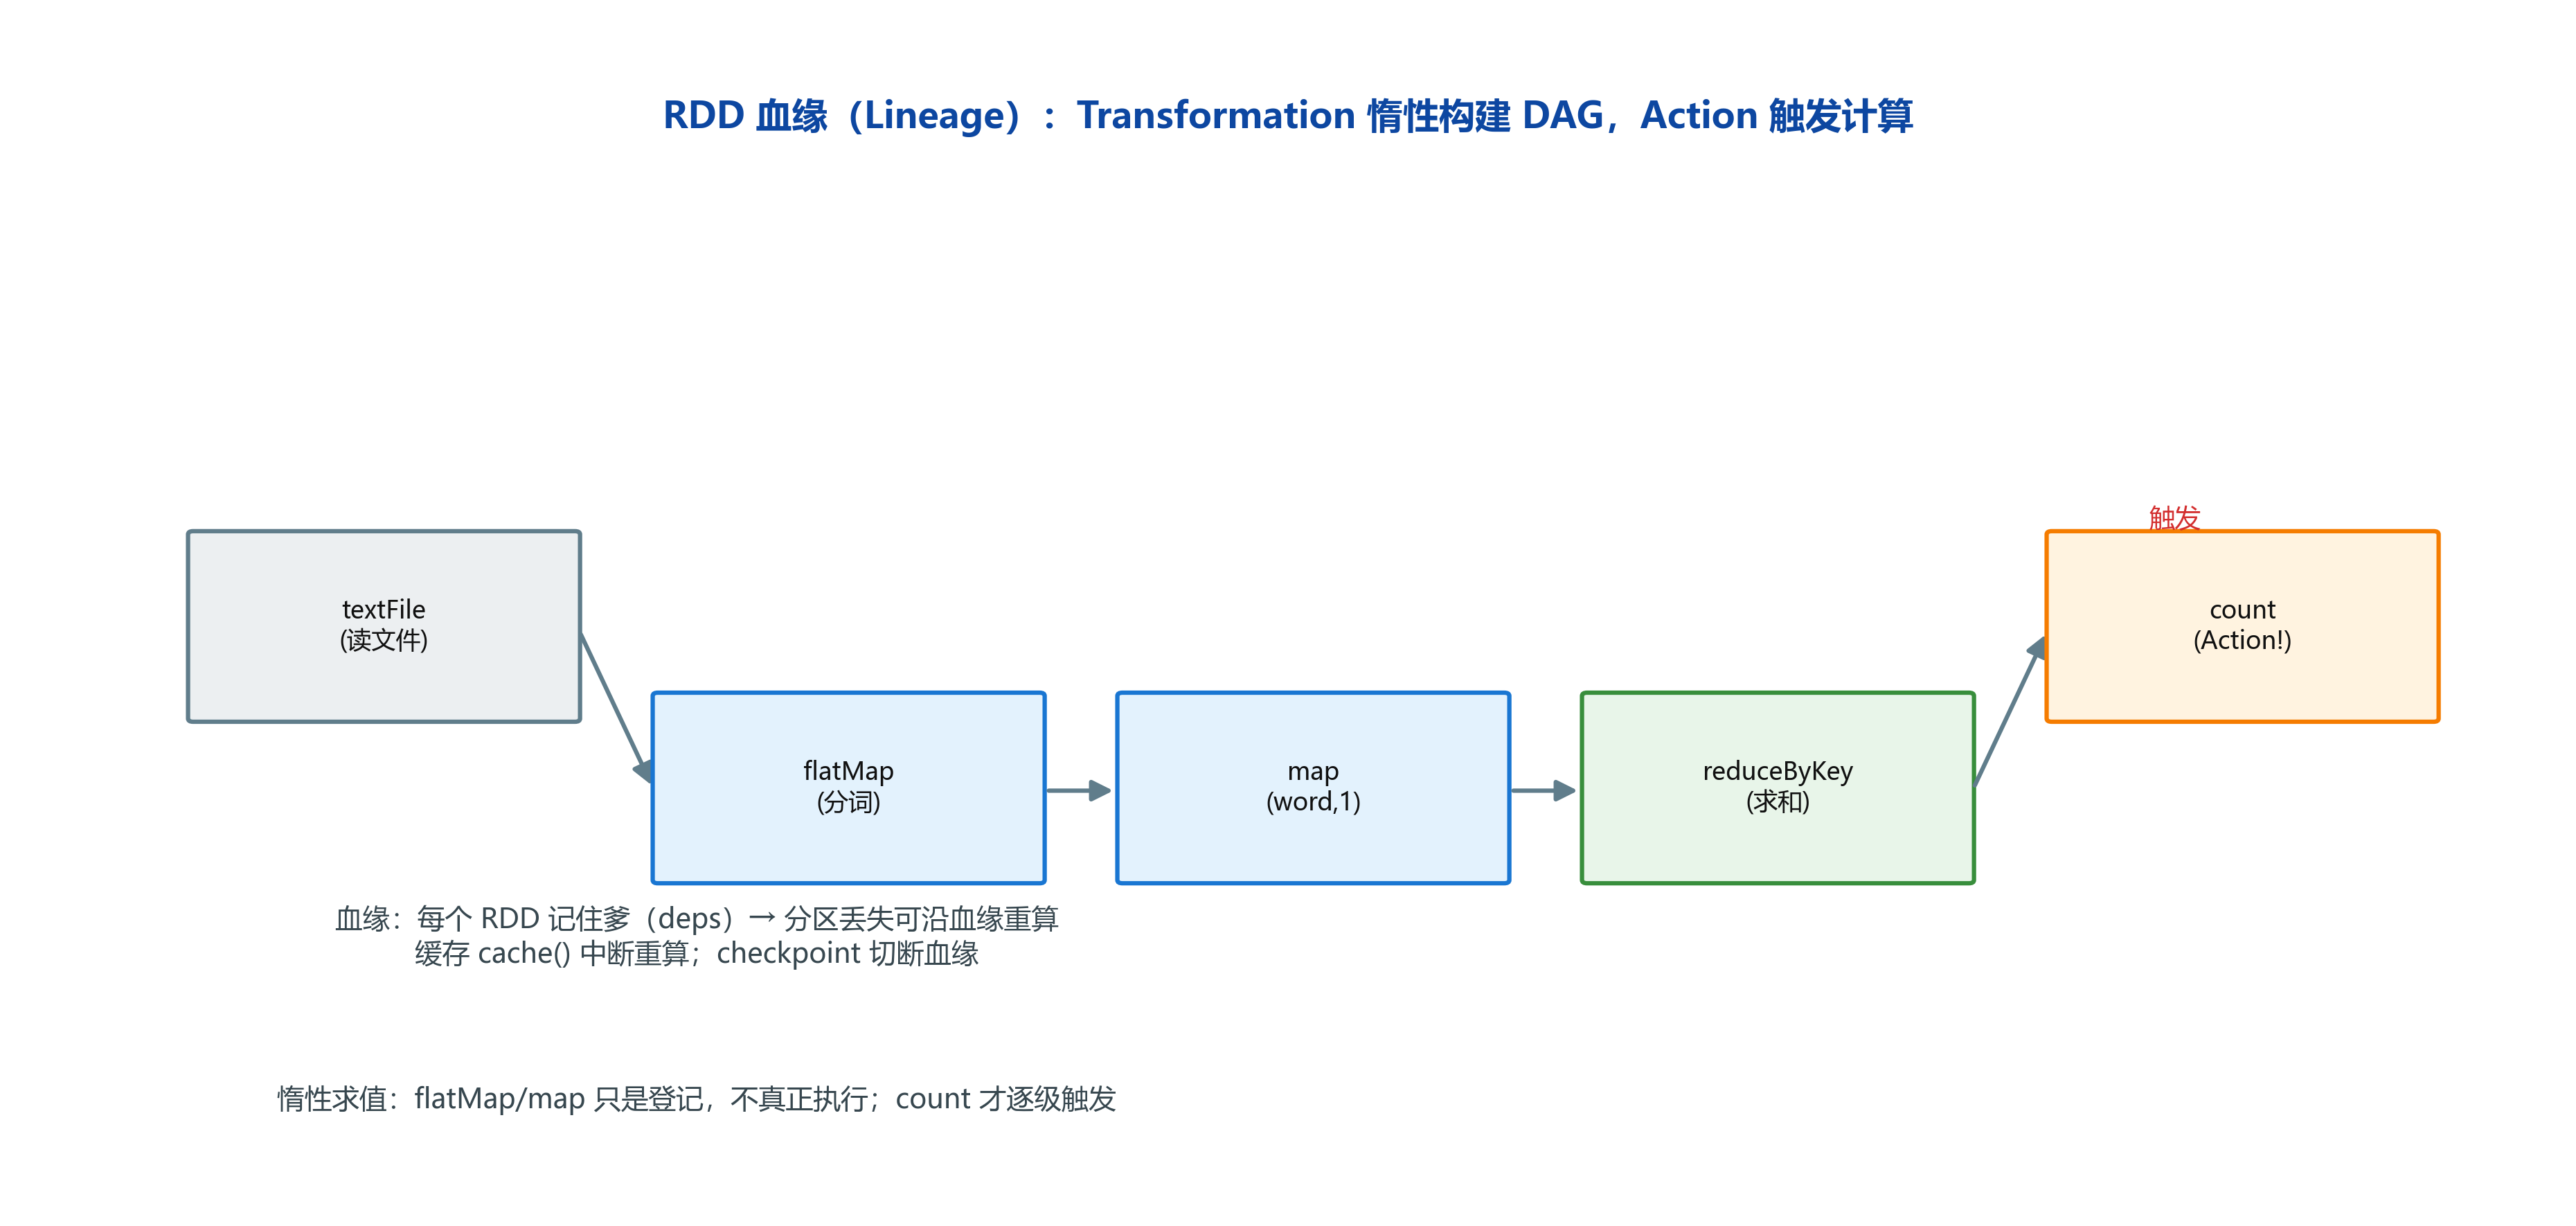
├── 3. Spark      RDD/惰性求值/血缘/宽窄依赖/Shuffle · DataFrame vs RDD · Cache
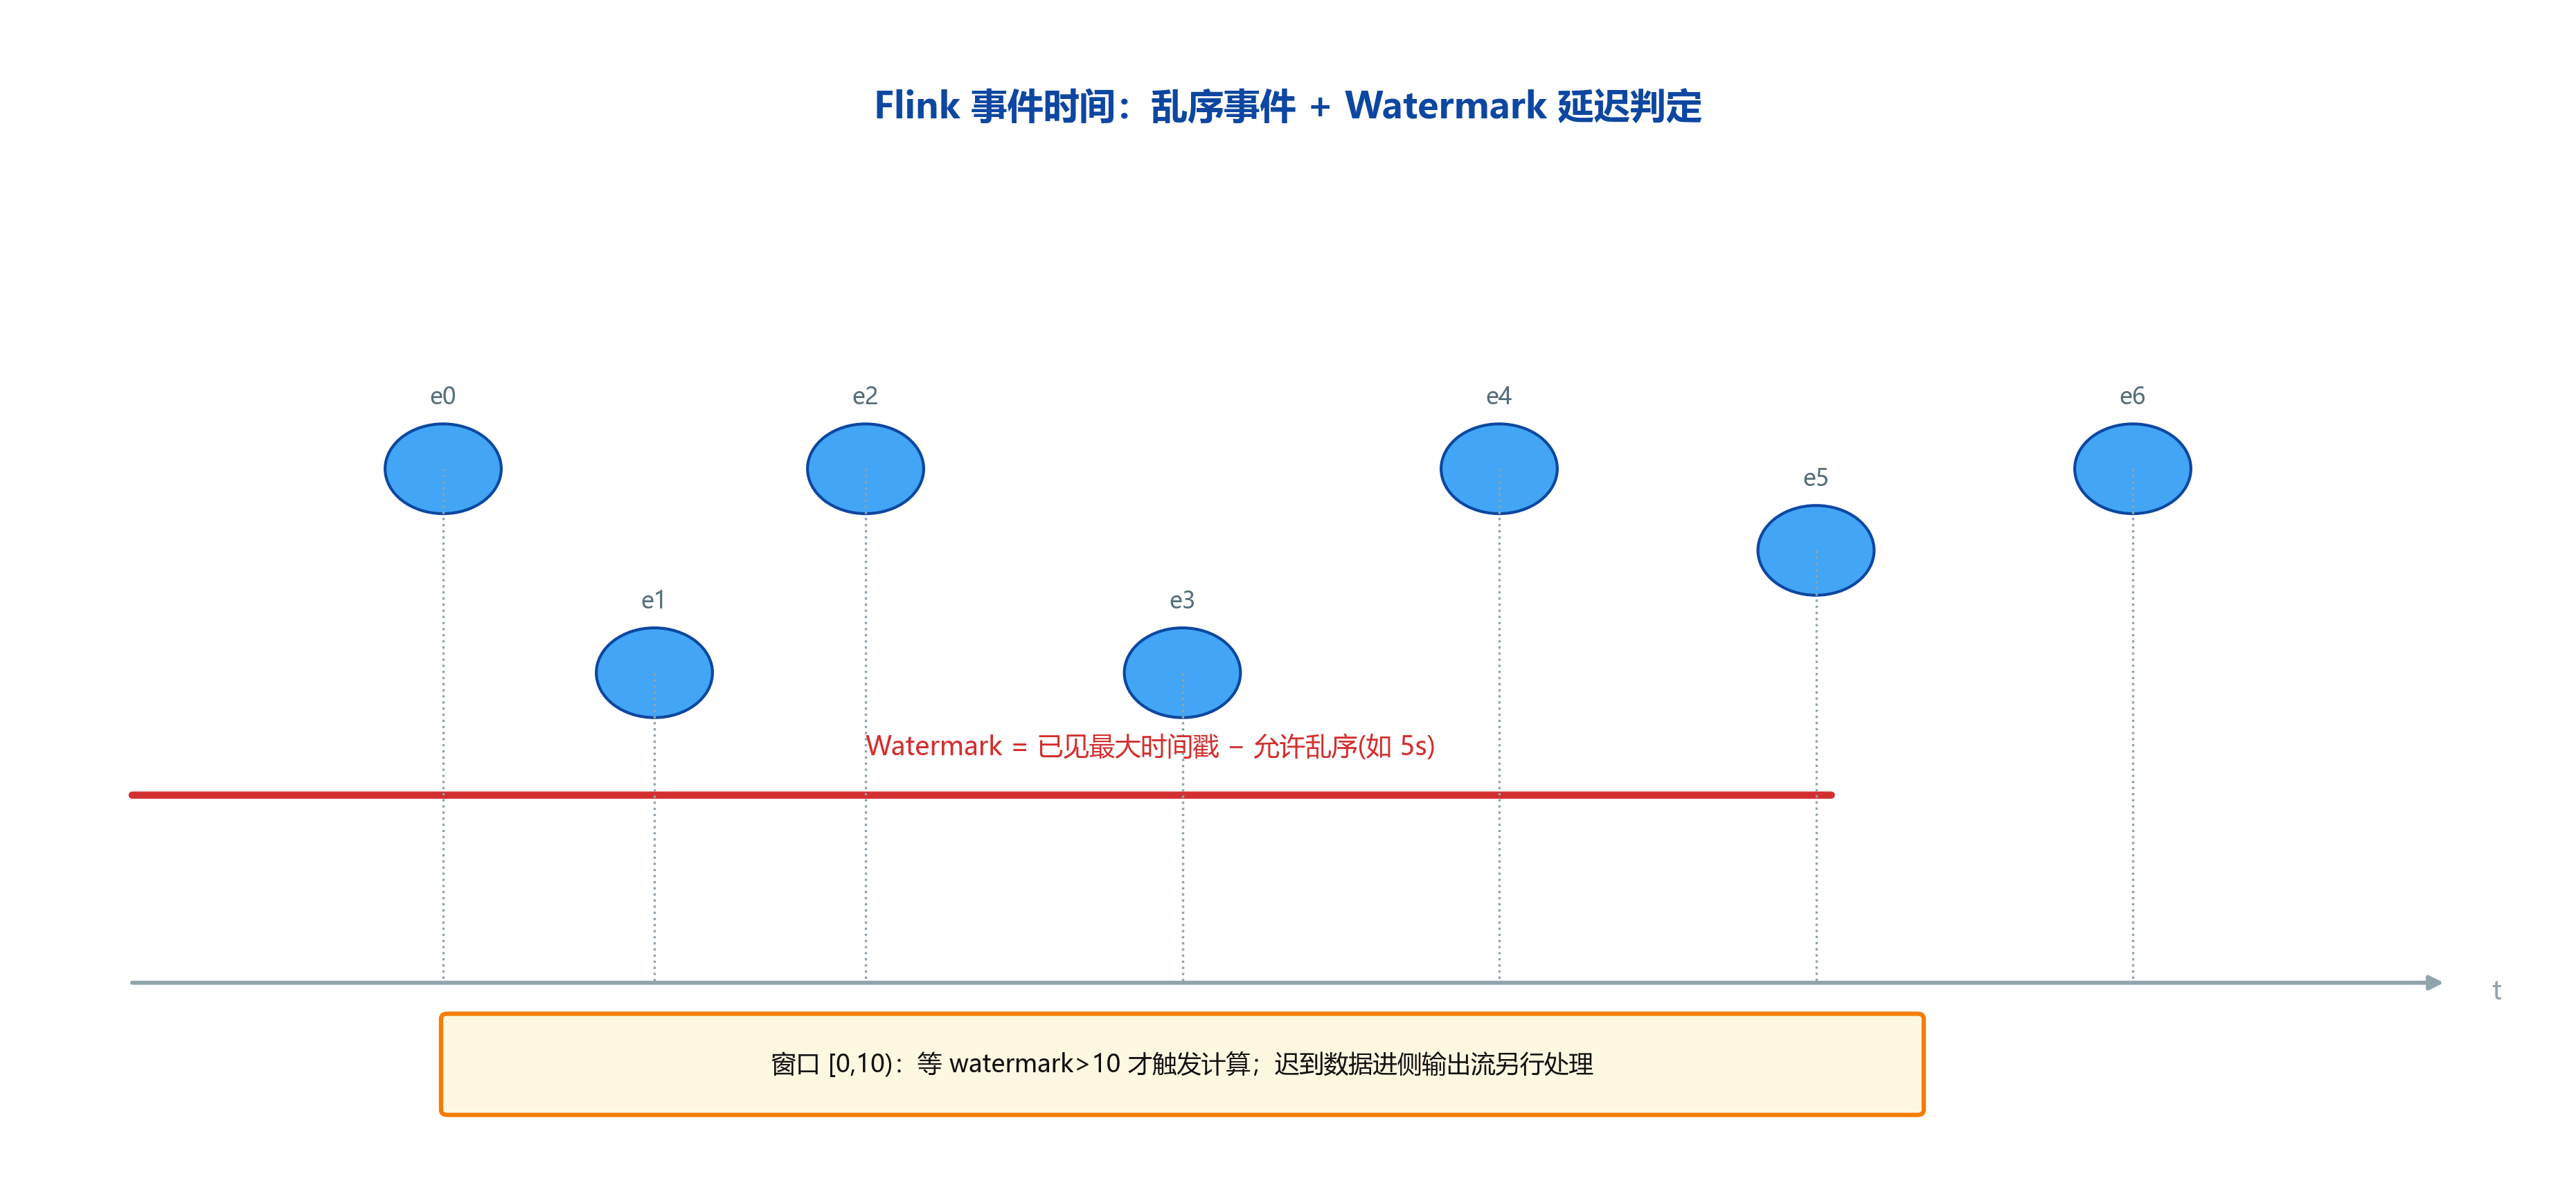
├── 4. 实时计算    Flink 事件时间/Watermark/滚动滑动窗口/迟到处理 · 批 vs 流
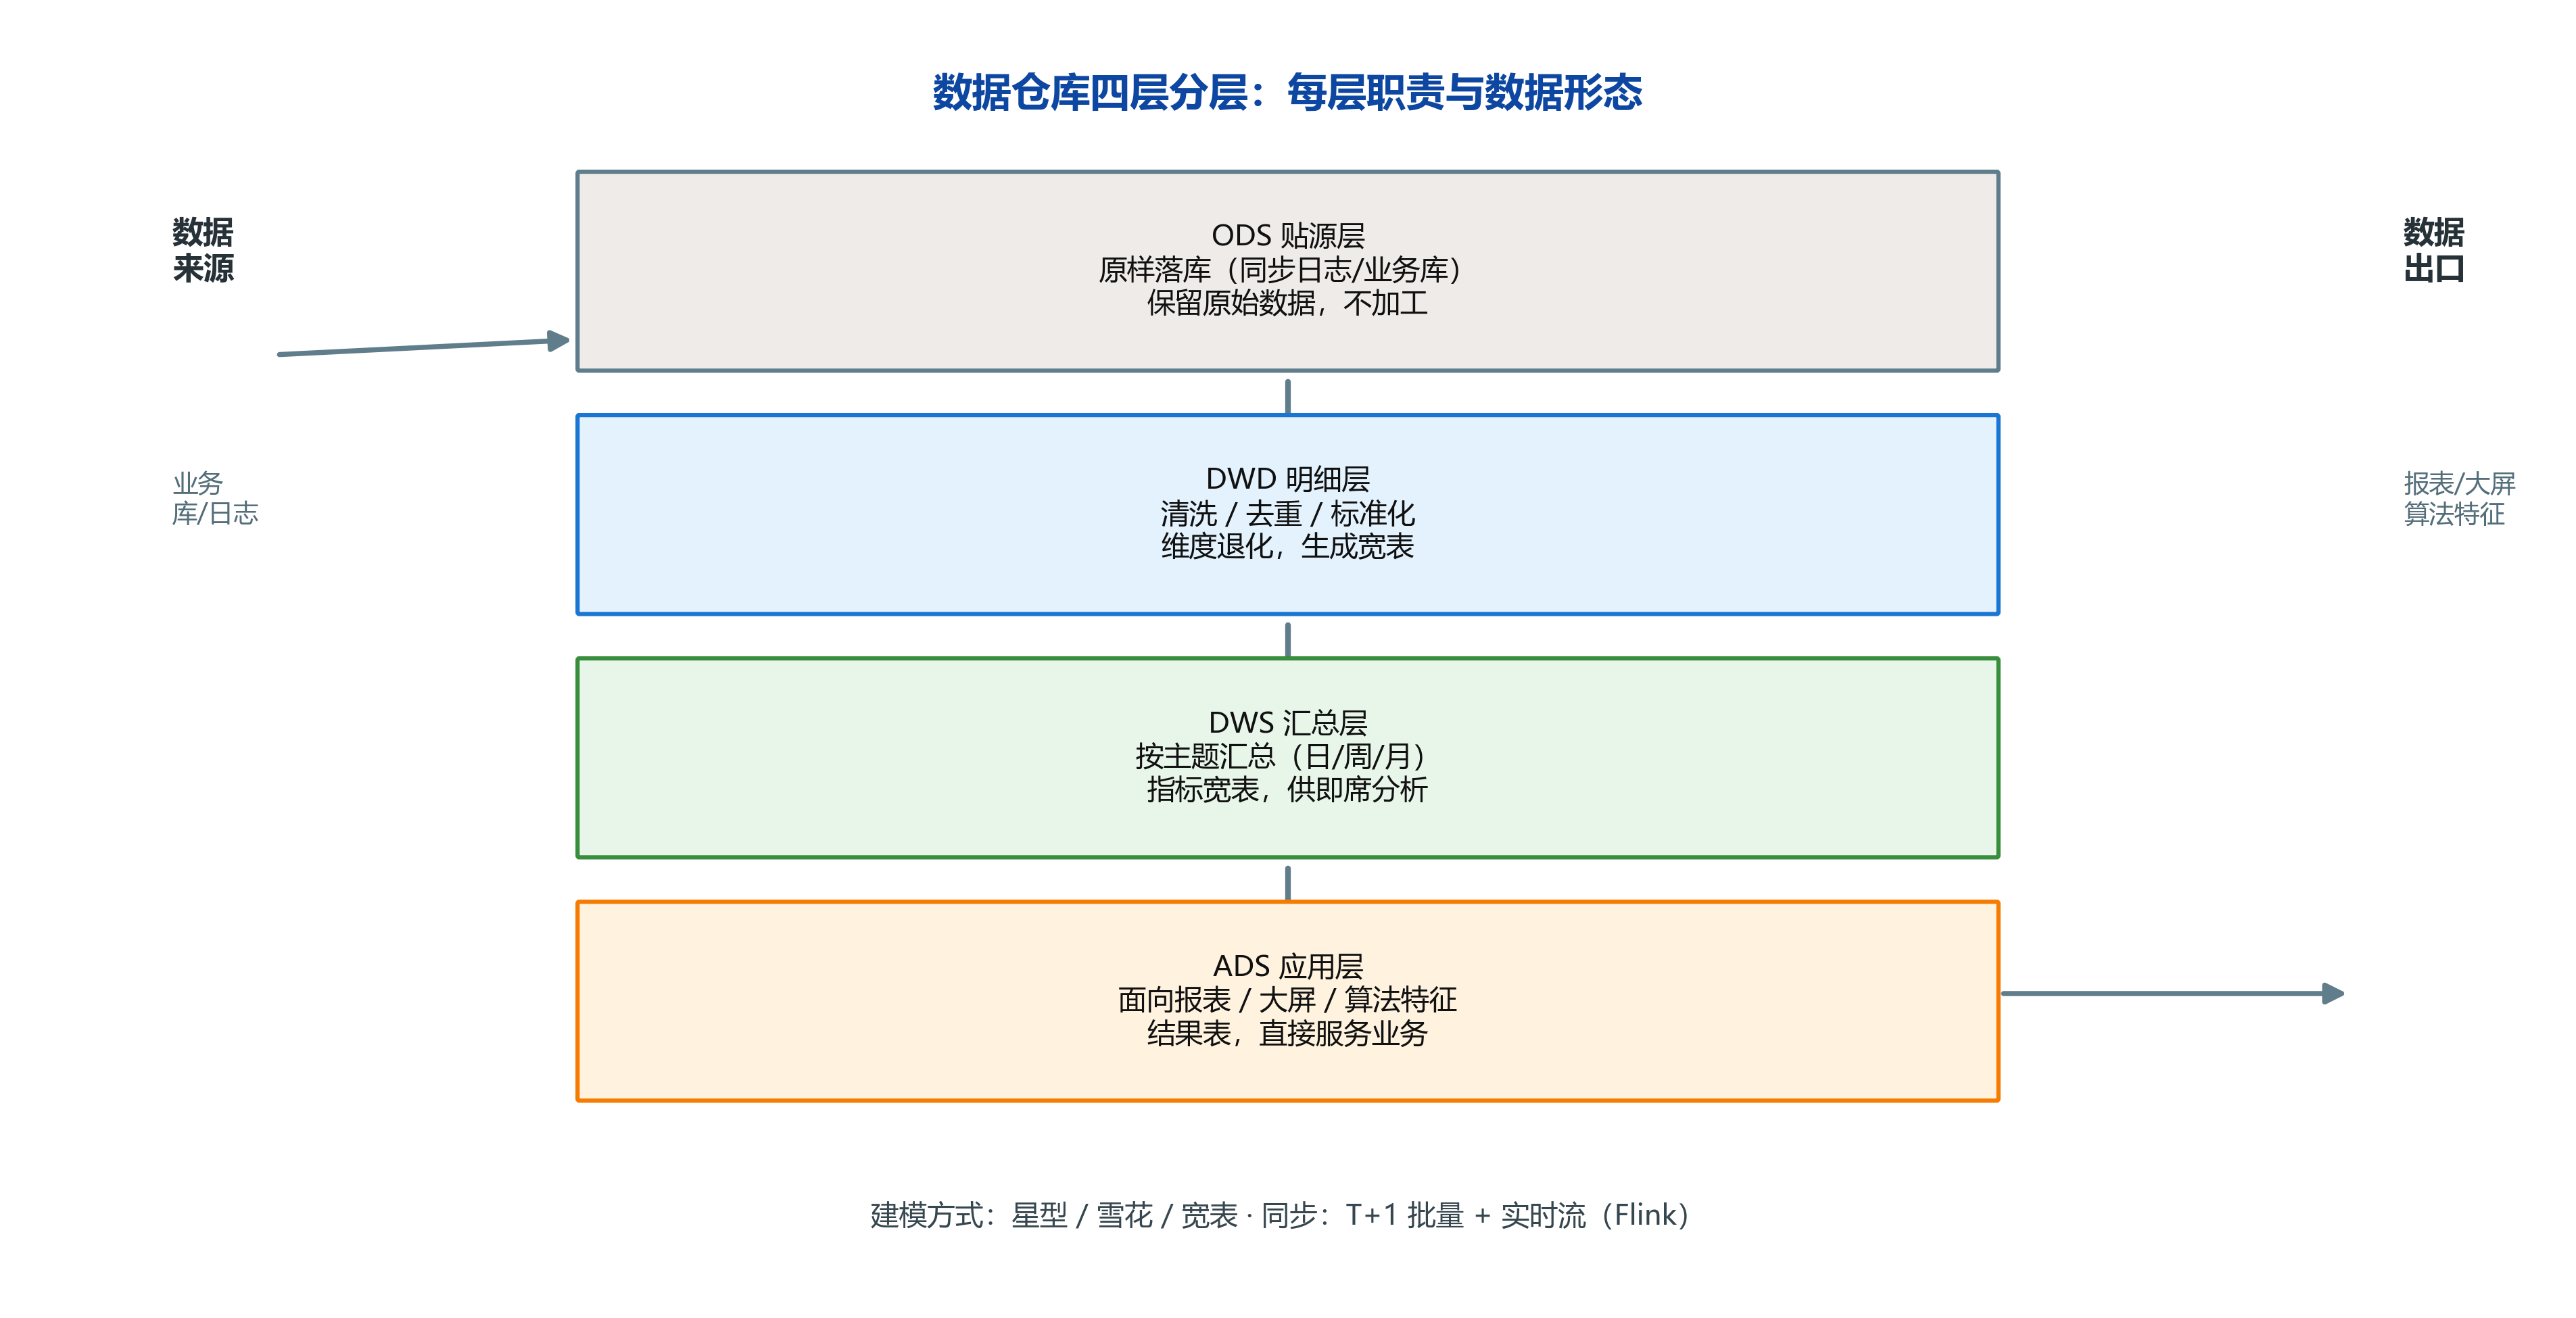
├── 5. 数仓建模    ODS/DWD/DWS/ADS 四层 · 星型/雪花/宽表 · 数仓治理
├── 6. 数据管道    Kafka 分区/偏移量/消费者组/重平衡/ACK · 积压排查
└── 7. 平台调度    DAG 编排/依赖/拓扑排序/重试/血缘 · 30 秒全链路串讲
学习路线(推荐顺序)
- 搭框架(00):技术栈六层全景 + HDFS 分块/副本/读写流程 ✅
- 理解离线计算(01-02):MR 词频手写 → Spark RDD 惰性求值/血缘/Shuffle ✅
- 掌握实时计算(03):Flink 事件时间/窗口/Watermark/迟到处理 ✅
- 数仓核心(04):sqlite3 实战四层分层 + 星型/雪花建模 + 治理 ✅
- 数据管道(05):Kafka 分区/偏移量/消费者组/可靠性 ✅
- 平台与冲刺(06-07):DAG 调度 + 血缘 → 30 秒串讲 + 手撕 TopN/两阶段聚合 ✅
教学 Notebook 索引(8 篇,全部通过 nbclient 执行验证)
| 笔记 | 核心手写/演示 | 状态 |
|---|---|---|
| 00-大数据体系与HDFS | 六层技术栈、存算分离、文件分块计算、3 副本容错、NameNode/DataNode 读写、5 个高频点 | ✅ |
| 01-MapReduce | Map 产出 (词,1)、Shuffle 排序分组、Reduce 聚合(pandas 对照)、TopN/均值变体、五点局限 | ✅ |
| 02-Spark核心与RDD | 迷你 MiniRDD、惰性求值证明(action 触发)、Spark 风格词频、宽窄依赖与 map 端预聚合、Cache/Checkpoint | ✅ |
| 03-Flink与实时计算 | 批 vs 流、事件时间与乱序、滚动/滑动窗口手写、Watermark 更新、迟到数据三策略、与 Spark Streaming 对比 | ✅ |
| 04-Hive与数仓建模 | sqlite3 四层实战(ODS→DWD 清洗→DWS 汇总→ADS 指标)、星型/雪花/宽表、6 个数仓治理点 | ✅ |
| 05-Kafka与数据管道 | Topic/Partition/Offset、key 哈希路由、消费者组消费进度、重平衡、ACK 三档与消费三语义 | ✅ |
| 06-数据平台与调度 | DAG 依赖、拓扑排序、失败重试与依赖阻断、表级血缘三大用途、调度速答 | ✅ |
| 07-大数据面试八股与高频题 | 30 秒全链路串讲、18 个高频速答、手撕全局 TopN 分治、两阶段聚合抗倾斜 | ✅ |
🖼️ 图库:自绘高清流程图(300dpi · 教学/images/)
| 图 | 说明 | 用于 Notebook |
|---|---|---|
dw_layers.png |
数仓四层分层(ODS→DWD→DWS→ADS) | 00 |
mapreduce_flow.png |
MapReduce 三阶段流程(Map→Shuffle→Reduce) | 01 |
rdd_lineage.png |
RDD 血缘与惰性求值(Transformation→Action) | 02 |
flink_watermark.png |
Flink 事件时间与 Watermark(乱序延迟判定) | 03 |
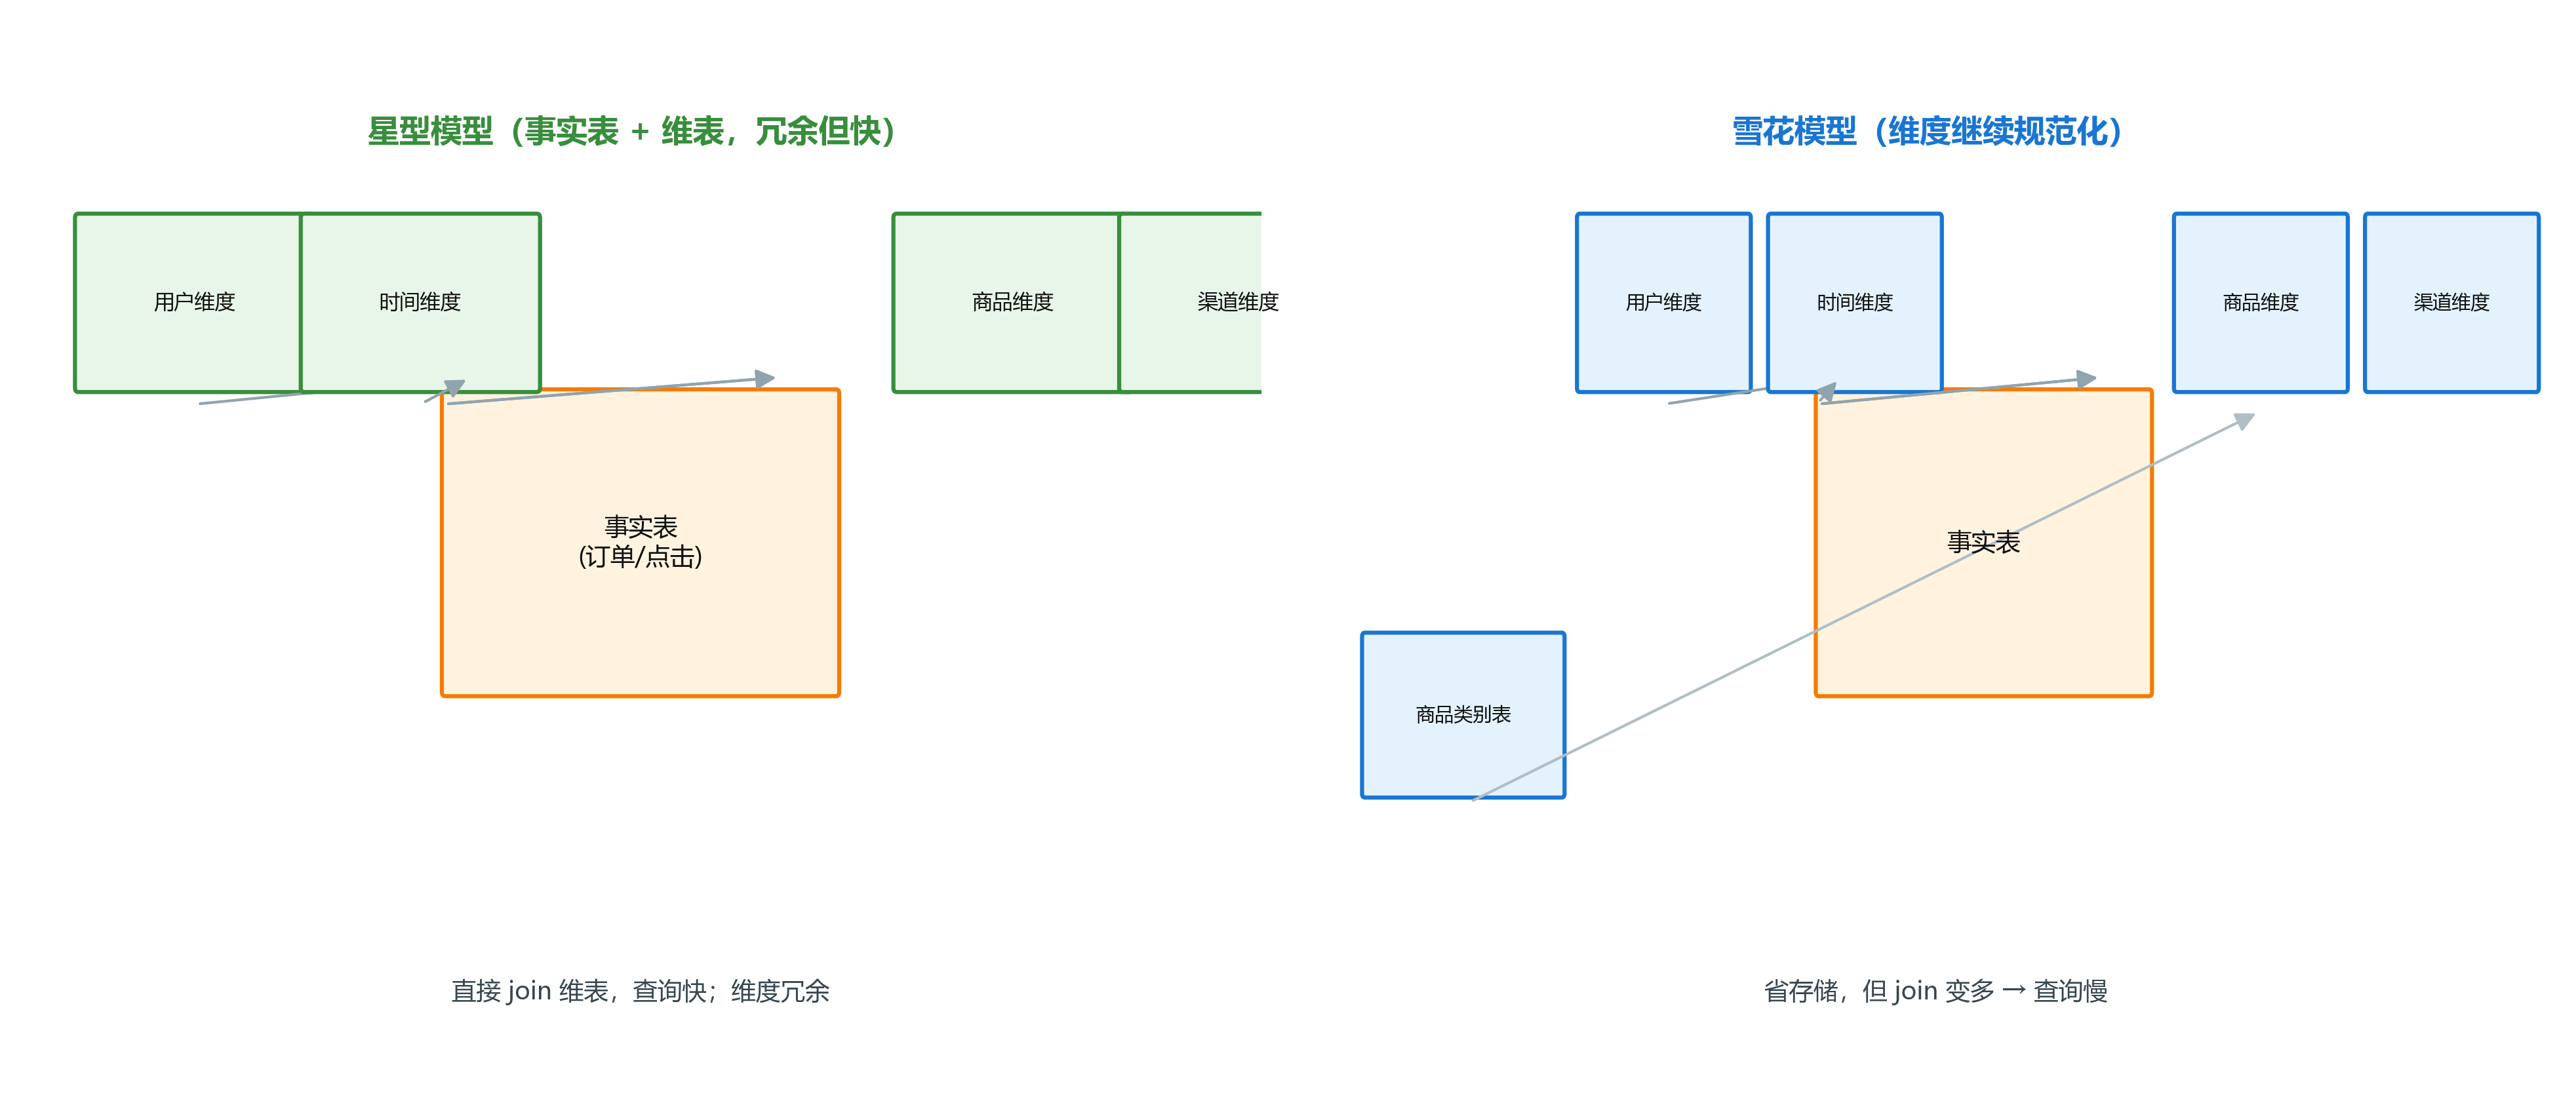
star_schema.png |
星型 vs 雪花模型对比 | 04 |
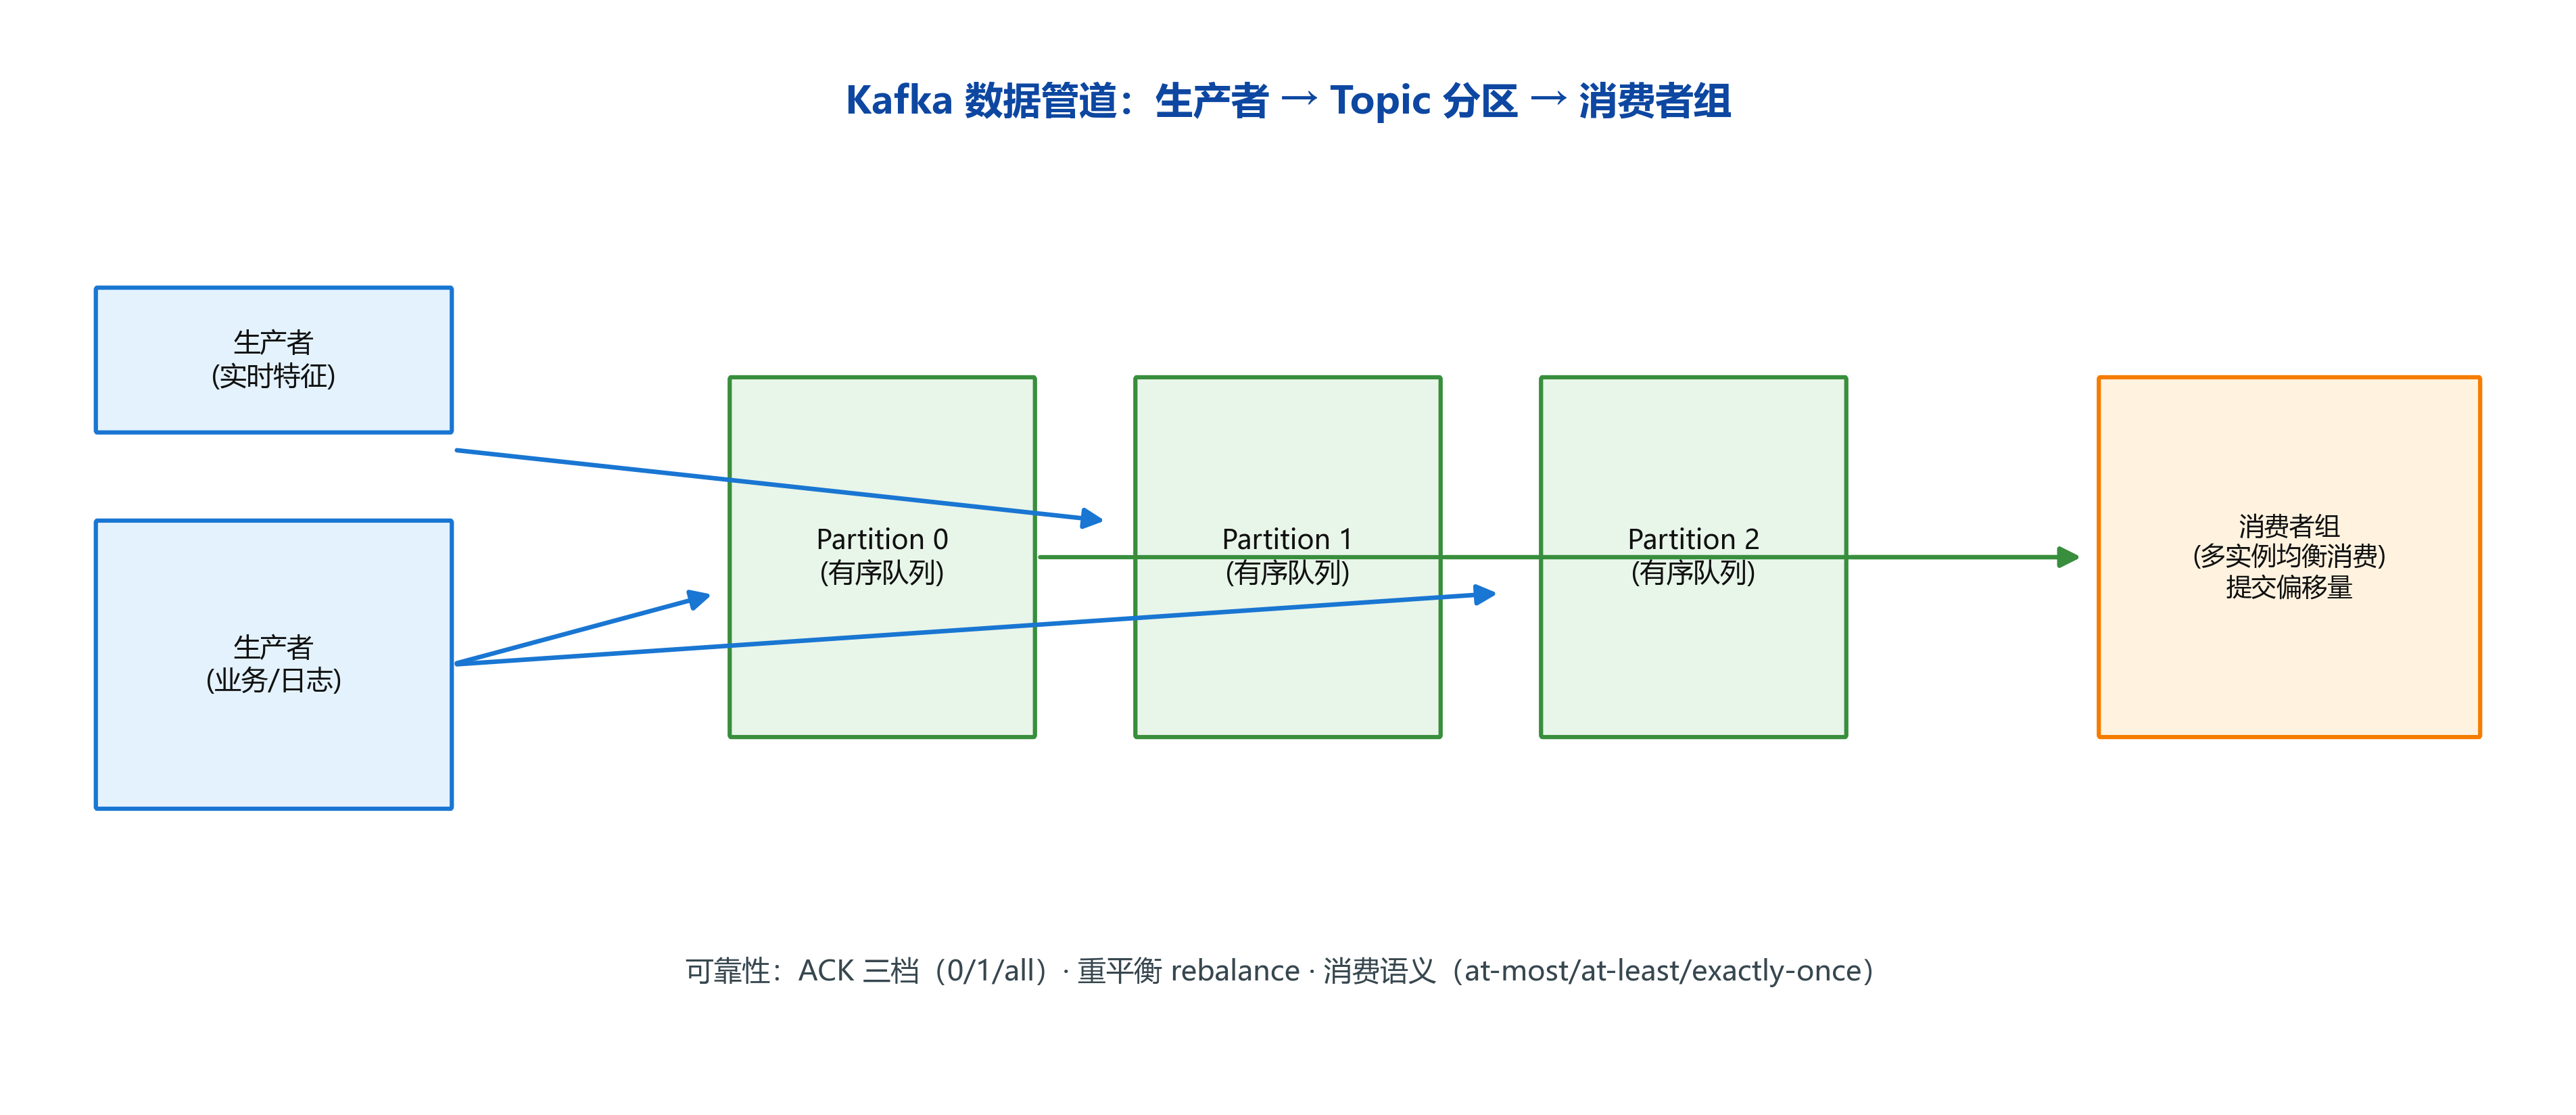
kafka_pipeline.png |
Kafka 数据管道(生产者→分区→消费者组) | 05 |
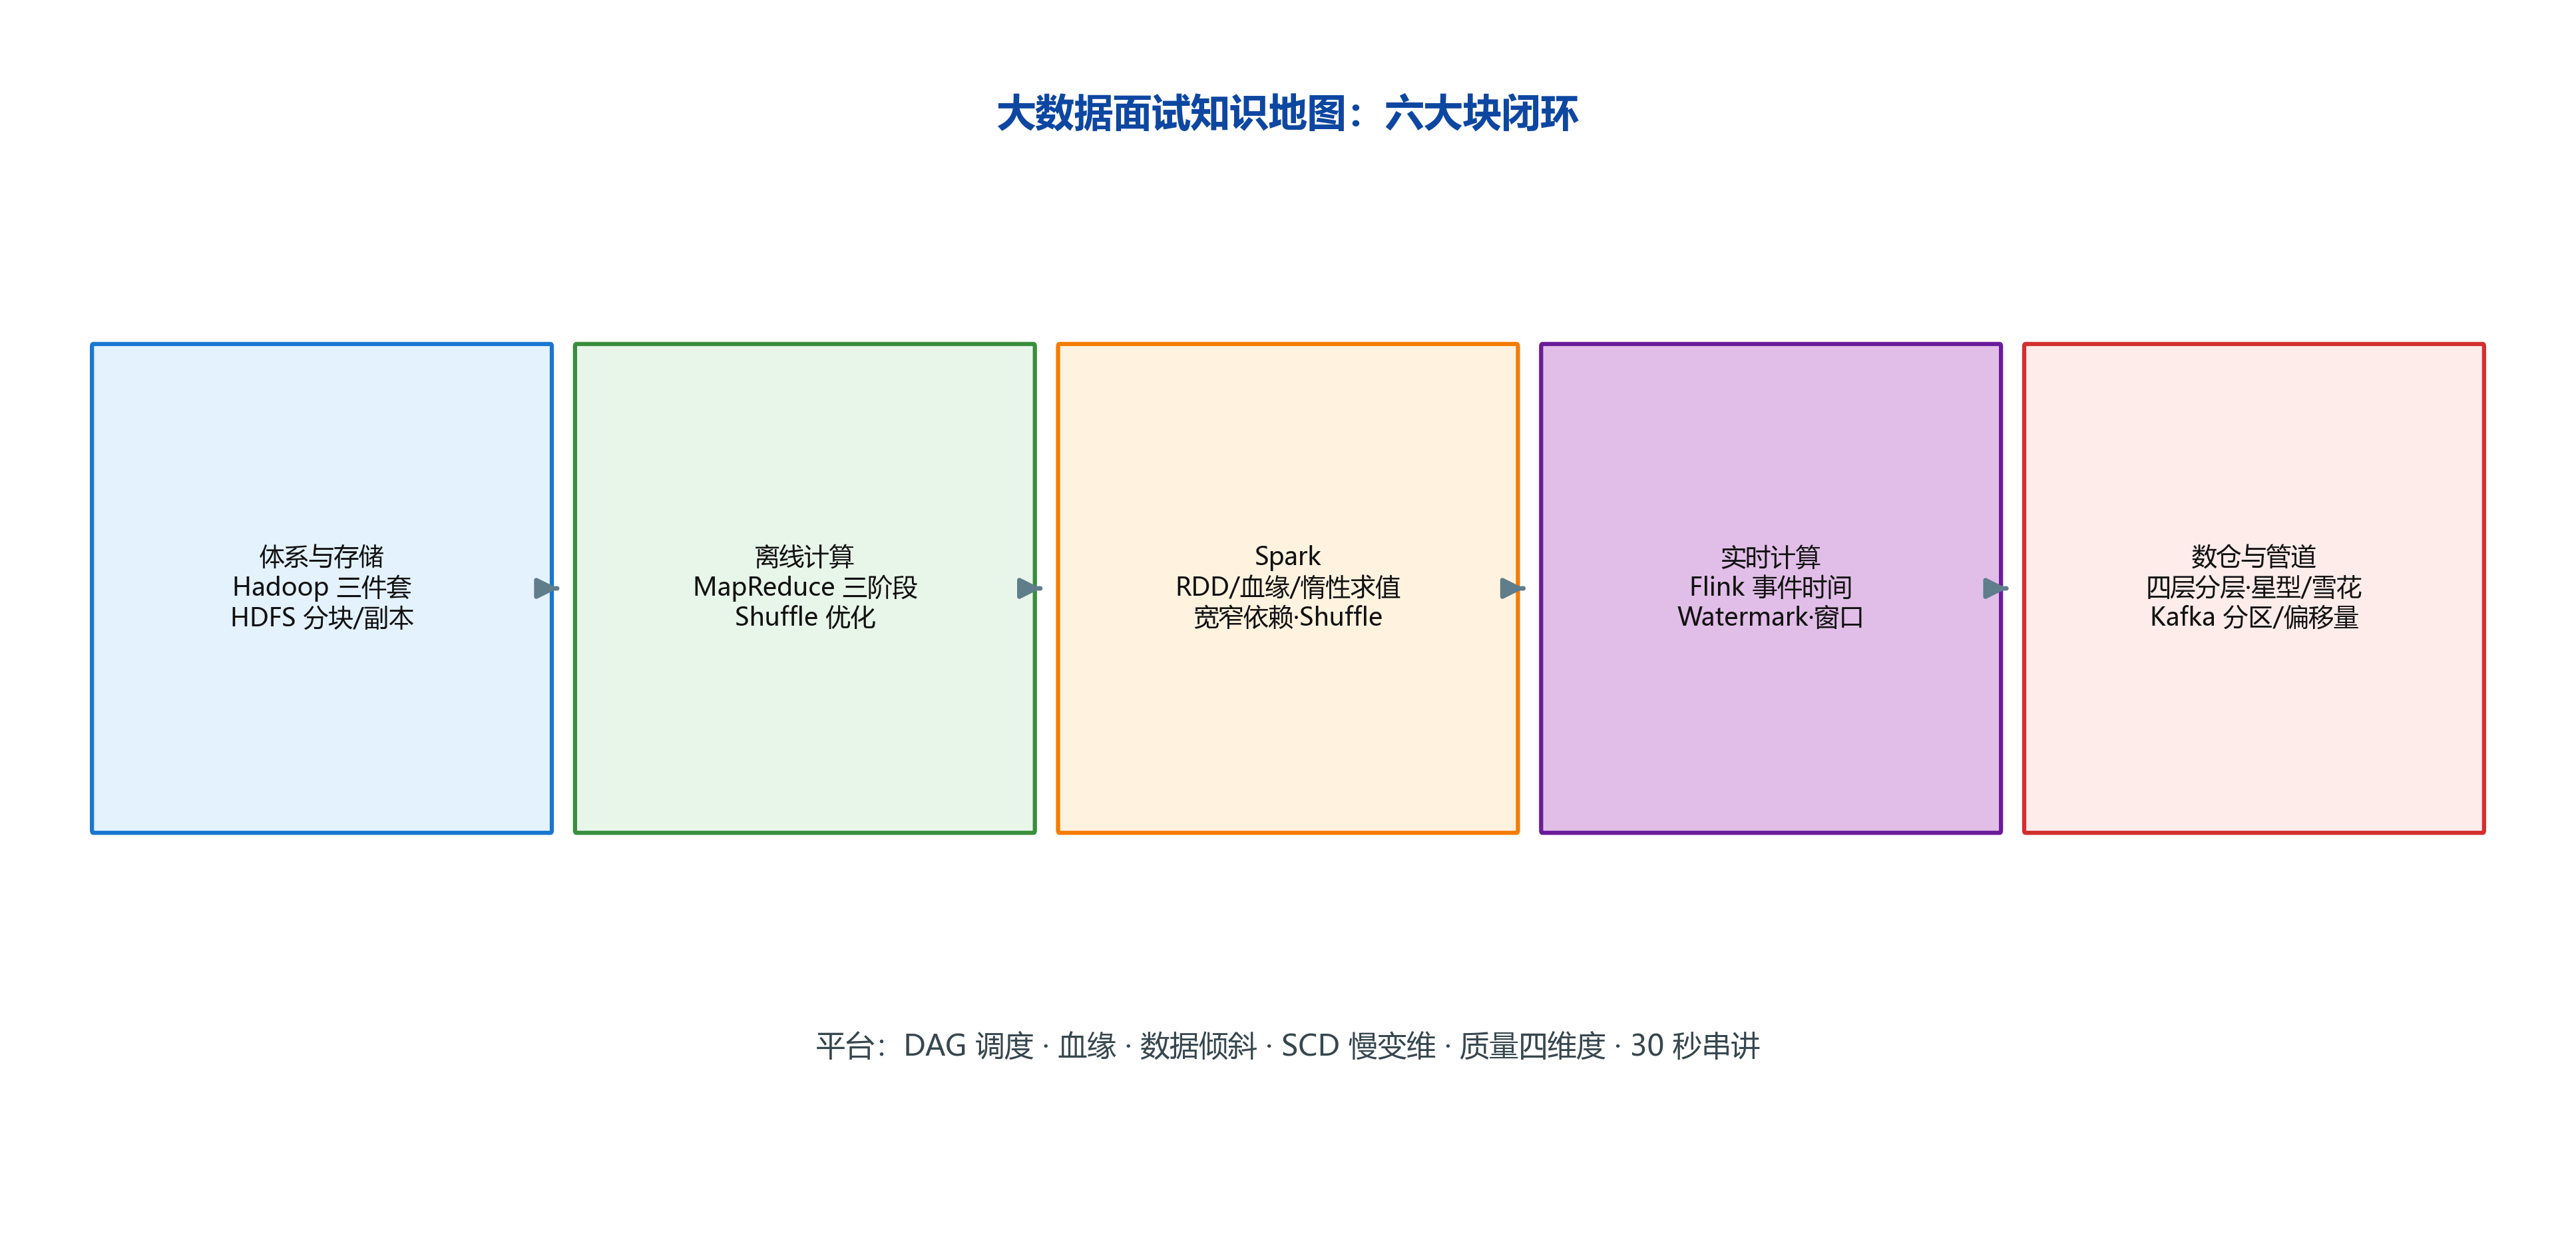
bigdata_interview_map.png |
大数据面试知识地图(六大块闭环) | 07 |
📌 自绘图的经典论文出处(已写入对应 notebook):
dw_layers.png← Inmon, Building the Data Warehouse, 1992;mapreduce_flow.png/web_mapreduce.png← Dean & Ghemawat, MapReduce, OSDI 2004;rdd_lineage.png← Zaharia et al., RDD, NSDI 2012;kafka_pipeline.png/web_kafka_logo.svg← Kreps et al., Kafka, NetDB 2011;flink_watermark.png← Carbone et al., Apache Flink, IEEE DEBull 2015;star_schema.png← Kimball, The Data Warehouse Toolkit, 1996。
📷 真实配图(Wikimedia Commons,已插入对应 notebook)
| 图 | 说明 | 用于 Notebook |
|---|---|---|
web_mapreduce.png |
MapReduce 完整并行执行流程 | 01 |
web_kafka_logo.svg |
Apache Kafka 官方徽标 | 05 |
与其他章节衔接
| 本模块主题 | 前置章节 | 衔接说明 |
|---|---|---|
| SQL / 数据分析基础 | 17-数据科学 | 数仓 SQL 与业务查询的基础 |
| 业务指标 / 指标体系 | 18-数据分析 | 数仓指标与业务口径的落地 |
| 特征工程 / 训练数据 | 02-机器学习 | 算法特征依赖数仓产出 |
| 实时推荐特征 | 19-推荐系统 | 实时特征管道(Flink+Kafka)支撑推荐 |
| 数据清洗 / EDA | 17-数据科学 03-数据清洗 | DWD 层清洗方法与单机 EDA 同源 |
面试高频题型(详见 高频面试题.md)
- 存储类:HDFS 分块与副本、NameNode 单点、小文件问题、存算分离
- 离线计算类:MR 三阶段、Shuffle 为什么慢、Spark vs MR、RDD 血缘、宽窄依赖
- 实时计算类:事件时间 vs 处理时间、Watermark、窗口类型、迟到数据处理、精确一次
- 数仓类:四层职责、星型 vs 雪花、指标口径统一、数据倾斜、SCD 慢变维
- 管道类:Kafka 分区与有序性、消费者组与重平衡、消息积压、ACK 三档
- 平台类:DAG 调度与依赖、失败重试、血缘用途、数据质量四维度
验收标准
- [ ] 能画出大数据技术栈六层全景图并串讲一条数据全链路
- [ ] 能讲清 HDFS 分块/副本/读写流程并答 5 个高频点
- [ ] 能手写 MR 词频统计并与 pandas 对照
- [ ] 能解释 RDD 惰性求值、血缘、宽窄依赖与 Shuffle
- [ ] 能手写滚动/滑动窗口,讲清 Watermark 与迟到处理
- [ ] 能用 sqlite3 构建 ODS/DWD/DWS/ADS 四层并写出各层 SQL
- [ ] 能讲清 Kafka 分区/偏移量/消费者组/重平衡与可靠性
- [ ] 能实现拓扑排序、失败重试与两阶段聚合抗倾斜
- [ ] 能答 18 个高频速答题并完成 TopN 分治手撕