🎯 00 · 推荐系统总览与评估指标¶
推荐系统(搜广推)是算法岗最大的方向之一。本节先搭全局框架(召回→粗排→精排→重排→AB), 再手写 AUC / GAUC / NDCG@K / HR@K / Recall@K 并与 sklearn 对照——评估指标是推荐岗面试第一关。
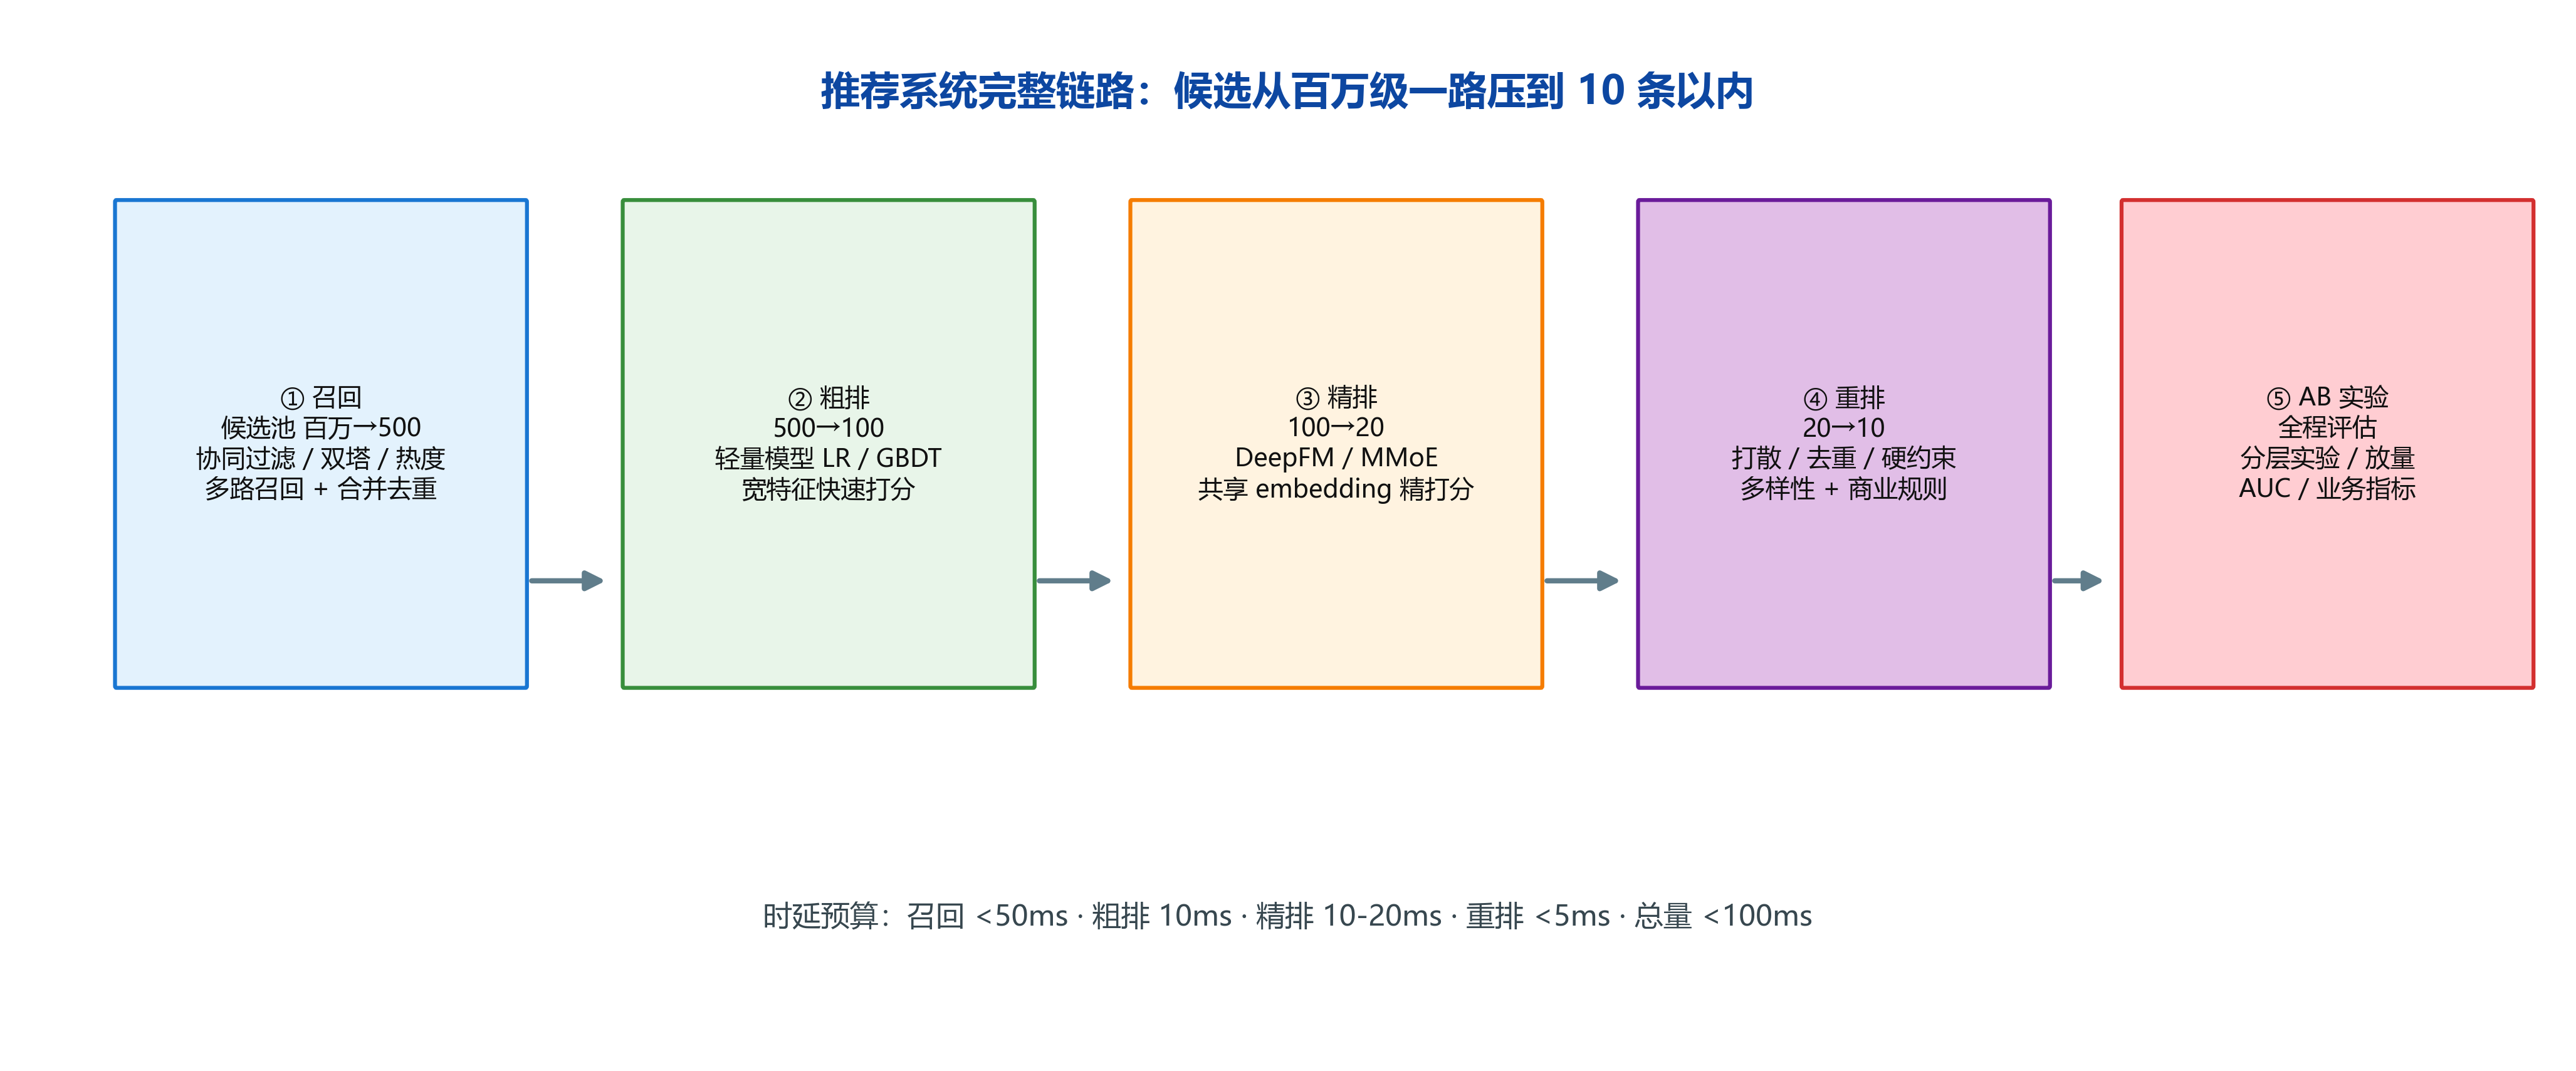
🔍 图解(自绘高清图,300dpi,可放大):这张图是推荐系统的五段漏斗链路——
- 召回(百万 → 千):全量候选(百万级物品)被多路召回(协同过滤/双塔向量/热门兜底)快速筛到千级; 召回追求快:宁可漏,不可慢,为精排提供候选池;
- 粗排(千 → 百):轻量模型对候选粗略打分(双塔内积/轻量 DNN),再砍到百级,减少精排压力;
- 精排(百 → 十):重模型(CTR 模型/Transformer 排序)精算点击/转化概率,选 Top-N; 这一步追求准:每个候选都过完整特征;
- 重排/混排(十 → 10 条以内):业务规则介入——去重、打散(类目/作者多样性)、强插广告位, 保证最终列表"好看又不重复";
- 核心思想:每一层只保留上一层的子集,漏斗宽度越收越窄、模型越来越重——用算力换精度。
🎬 背景故事¶
晚上十一点,你打开购物 App,首页已经为你排好了"猜你喜欢"……
晚上十一点,你打开购物 App,首页第一屏已经悄悄换成了你可能想买的东西——你三天前搜过的相机、上次犹豫的背包,整整齐齐排在前面。这背后没有一个"魔法师",而是一条从百万商品里层层筛选到 10 条的流水线。本节就是带你走进这条流水线的第一站:先看懂全链路,再学会用 AUC / GAUC / NDCG 这些"尺子"去衡量它到底推得好不好。
🧭 本节逻辑主线:先建立全链路框架(这 10 条怎么来的)→ 再问"怎么量化效果"(一把尺子)→ 最后问"不同用户/不同位置要不要区别对待"(三把更细的尺子)。
📋 本节要解决的问题¶
| # | 问题 | 方法 |
|---|---|---|
| 1 | 推荐系统完整链路是什么? | 召回→粗排→精排→重排→AB |
| 2 | 排序效果怎么量化? | AUC(手写 vs sklearn) |
| 3 | 用户级排序怎么评估? | GAUC |
| 4 | 推荐列表质量怎么评估? | HR@K / Recall@K / NDCG@K |
import matplotlib
import matplotlib.pyplot as plt
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei', 'PingFang SC', 'Noto Sans CJK SC', 'Arial Unicode MS']
matplotlib.rcParams['axes.unicode_minus'] = False
import numpy as np
import pandas as pd
rng = np.random.default_rng(42)
1️⃣ 推荐链路总览(必背框架)¶
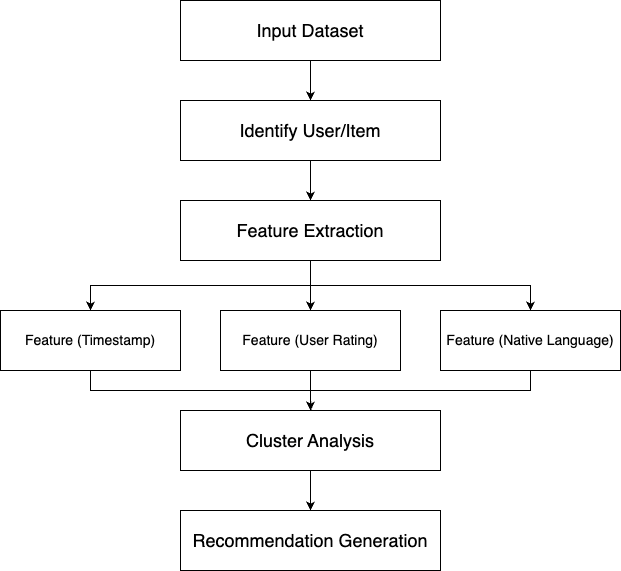
📌 真实配图①:推荐系统流程图(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:这是 Wikimedia 上经典的推荐系统端到端流程图——
- 最左(数据采集):用户行为日志(浏览/点击/购买)、物品属性、画像特征源源不断进入系统;
- 中左(候选生成/召回):从全量物品池筛出千级候选——多路召回(协同过滤/双塔向量/热门兜底);
- 中右(打分排序/精排):CTR/转化模型对候选逐个打分,按预估分排序取 Top-N;
- 最右(Top-N 列表):重排(打散/去重/业务强插)后把最终列表呈现给用户;
- 对照本节的五段链路:这正是"多路召回 + 逐层过滤"的真实世界版本—— 每一步都在减小候选规模、提升精度。图片来源:Wikimedia Commons,CC BY-SA 4.0。
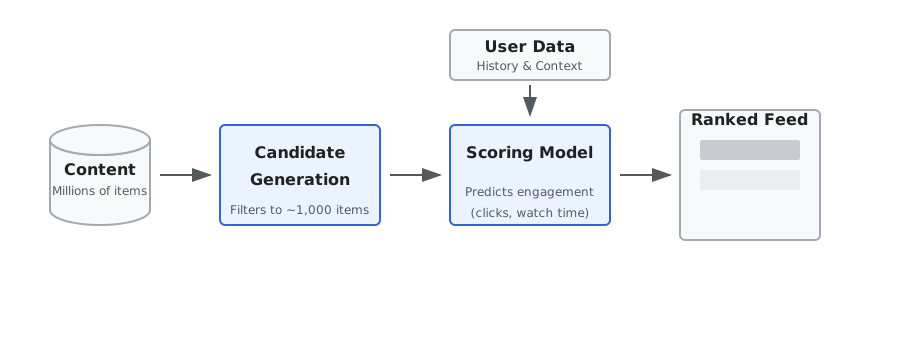
📌 真实配图②:推荐架构总览(Wikimedia Commons,CC BY-SA 4.0)
🔍 图解:这张推荐架构图画出推荐系统在真实业务中的分层位置——
- 底层(数据层):日志采集、特征平台、离线/实时特征——喂给模型的"食材";
- 中层(算法层):召回(候选生成)→ 排序(CTR/CVR 预估)→ 重排(多样性与业务约束)—— 本模块 00-06 篇讲的每一环都在这一层;
- 顶层(业务层):AB 实验系统(验证策略好坏)、运营策略、效果监控——决定"模型改不改、怎么上";
- 对照:链路图讲"数据怎么流动",架构图讲"系统怎么分层"——两图互补,面试各答一半。
stages = [
    ('召回', '从百万级物品粗筛几百~上千候选:协同过滤/双塔/向量检索,快而粗'),
    ('粗排', '轻量模型把候选压到百级:双塔/简单 LR,控制时延'),
    ('精排', '复杂模型逐点精估 CTR/CVR:DeepFM/MMoE,最重的一层'),
    ('重排', '多样性/新鲜度/打散/业务约束,重排最终列表'),
    ('AB 评估', '小流量实验验证线上收益,评估指标驱动迭代'),
]
print('推荐系统五段链路:')
for i, (s, d) in enumerate(stages, 1):
    print(f'  {i}. {s} —— {d}')
print('\n➡️ 面试串讲:从「候选池规模」到「时延预算」讲每层职责与模型选择')
推荐系统五段链路:
  1. 召回 —— 从百万级物品粗筛几百~上千候选:协同过滤/双塔/向量检索,快而粗
  2. 粗排 —— 轻量模型把候选压到百级:双塔/简单 LR,控制时延
  3. 精排 —— 复杂模型逐点精估 CTR/CVR:DeepFM/MMoE,最重的一层
  4. 重排 —— 多样性/新鲜度/打散/业务约束,重排最终列表
  5. AB 评估 —— 小流量实验验证线上收益,评估指标驱动迭代

➡️ 面试串讲:从「候选池规模」到「时延预算」讲每层职责与模型选择
2️⃣ 构造点击/打分数据¶
# 🖼️ 配图:推荐系统全链路——召回 → 精排 → 重排 → 策略
fig, ax = plt.subplots(figsize=(9, 2.8))
ax.axis('off'); ax.set_xlim(0, 10); ax.set_ylim(0, 3.4)

def box(x, y, w, h, text, fc):
    ax.add_patch(plt.Rectangle((x, y), w, h, fc=fc, ec='#334155', lw=1.5))
    ax.text(x + w / 2, y + h / 2, text, ha='center', va='center', fontsize=8.8)

def arrow(x1, y1, x2, y2):
    ax.annotate('', xy=(x2, y2), xytext=(x1, y1),
                arrowprops=dict(arrowstyle='-|>', color='#64748b', lw=1.8))

box(0.3, 1.4, 1.8, 1.0, '召回\n(亿→千)\n双塔/CF/热度', '#bfdbfe')
box(2.6, 1.4, 1.8, 1.0, '粗排\n(千→百)\n轻量模型', '#e2e8f0')
box(4.9, 1.4, 1.8, 1.0, '精排\n(百→几十)\nLR/FM/DeepFM', '#fde68a')
box(7.2, 1.4, 1.8, 1.0, '重排\n打散/多样性\n/业务规则', '#bbf7d0')
box(0.3, 0.25, 4.2, 0.8, '用户特征 + 物品特征 + 上下文', '#fef9c3')
arrow(2.1, 1.9, 2.5, 1.9); arrow(4.4, 1.9, 4.8, 1.9); arrow(6.7, 1.9, 7.1, 1.9)
arrow(1.2, 1.4, 2.4, 1.05); arrow(3.5, 1.4, 4.2, 1.05); arrow(5.8, 1.4, 6.6, 1.05)
box(9.05, 1.4, 0.7, 1.0, '曝光\n反馈', '#fecaca')
arrow(9.0, 1.9, 9.0, 1.9)
plt.title('工业推荐链路:漏斗逐层缩小,反馈回流优化', fontsize=11)
plt.show()
print('➡️ 面试开场白:从"亿级候选"到"几十个曝光"的漏斗,每层模型不同')
➡️ 面试开场白:从"亿级候选"到"几十个曝光"的漏斗,每层模型不同
C:\Users\24260\AppData\Local\Temp\ipykernel_41444\672830156.py:23: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
# 模拟 100 用户 × 50 物品的评分/点击
n_users, n_items = 100, 50
true_scores = rng.normal(0, 1, (n_users, n_items))
# 取前 30% 作为"正样本"
labels = (true_scores > np.quantile(true_scores, 0.7)).astype(int)
scores_pred = true_scores + rng.normal(0, 0.3, (n_users, n_items))  # 预测分=真值+噪声
print('标签矩阵形状:', labels.shape, '正样本占比:', labels.mean().round(3))
assert 0.25 < labels.mean() < 0.35
print('✅ 数据就绪(含少量噪声的预测分)')
标签矩阵形状: (100, 50) 正样本占比: 0.3
✅ 数据就绪(含少量噪声的预测分)
📐 公式推导:AUC 的概率定义与秩和法¶
AUC = 随机抽取一个正样本、一个负样本,正样本得分更高的概率:
$$ AUC = P(s_{正} > s_{负}) = \frac{1}{n_+ n_-} \sum_{i \in \mathcal{P}} \sum_{j \in \mathcal{N}} \mathbb{1}[s_i > s_j] $$
推导 → 秩和等价式:把全体样本按得分升序编号(并列取平均秩 $r_i$),正样本秩和为 $R_+ = \sum_{i \in \mathcal{P}} r_i$。 在不考虑并列时,$R_+$ 拆成"正样本内部秩和" + "正样本赢过的负样本数":
$$ R_+ = \frac{n_+(n_+{+}1)}{2} + \sum_{i \in \mathcal{P}} \sum_{j \in \mathcal{N}} \mathbb{1}[s_i > s_j] $$
所以(Mann–Whitney U 统计量的归一化):
$$ AUC = \frac{R_+ - \frac{n_+(n_+{+}1)}{2}}{n_+ n_-} $$
- $n_+, n_-$:正/负样本数;$\mathbb{1}[\cdot]$ 为指示函数。
- 代码中
rank[y==1].sum()即 $R_+$;(rank_sum_pos - n_pos*(n_pos+1)/2) / (n_pos*n_neg)即上式。 - 直觉:AUC=0.5 等于随机;=1.0 完全排序正确。它只依赖相对顺序,对得分绝对值不敏感。
3️⃣ AUC 手写 vs sklearn¶
from sklearn.metrics import roc_auc_score

y_true = labels.ravel()
y_score = scores_pred.ravel()

# 手写 AUC:随机正样本得分 > 随机负样本得分的概率(秩和法)
def auc_manual(y, s):
    order = np.argsort(s)
    rank = np.empty_like(order)
    rank[order] = np.arange(len(s)) + 1
    n_pos = y.sum()
    n_neg = len(y) - n_pos
    rank_sum_pos = rank[y == 1].sum()
    return (rank_sum_pos - n_pos * (n_pos + 1) / 2) / (n_pos * n_neg)

auc_m = auc_manual(y_true, y_score)
auc_s = roc_auc_score(y_true, y_score)
print(f'手写 AUC = {auc_m:.4f}')
print(f'sklearn AUC = {auc_s:.4f}')
assert abs(auc_m - auc_s) < 1e-9
print('✅ 手写与 sklearn 完全一致')

# 可视化 ROC 曲线
from sklearn.metrics import roc_curve
fpr, tpr, _ = roc_curve(y_true, y_score)
plt.figure(figsize=(6, 4))
plt.plot(fpr, tpr, color='#2563eb', lw=2, label=f'AUC={auc_s:.3f}')
plt.plot([0, 1], [0, 1], 'k--', lw=1, label='随机')
plt.xlabel('FPR'); plt.ylabel('TPR'); plt.title('ROC 曲线')
plt.legend(); plt.grid(alpha=0.3)
plt.show()
手写 AUC = 0.9728
sklearn AUC = 0.9728
✅ 手写与 sklearn 完全一致
C:\Users\24260\AppData\Local\Temp\ipykernel_41444\4099093705.py:31: UserWarning: FigureCanvasAgg is non-interactive, and thus cannot be shown
  plt.show()
4️⃣ GAUC:用户级 AUC(加权平均)¶
# GAUC = 按用户分别算 AUC,再按各用户样本数加权
gauc_vals = []
for u in range(n_users):
    y_u = labels[u]
    s_u = scores_pred[u]
    if y_u.sum() == 0 or y_u.sum() == len(y_u):
        continue  # 纯正/纯负用户无 AUC
    gauc_vals.append((y_u.sum(), auc_manual(y_u, s_u)))
w = np.array([n for n, _ in gauc_vals])
a = np.array([v for _, v in gauc_vals])
gauc = (a * w).sum() / w.sum()
print(f'GAUC = {gauc:.4f}(按用户样本量加权)')
print(f'说明:GAUC 更贴近推荐场景(每个用户一个排序列表),比全局 AUC 对"用户间差异"更敏感')
assert 0.5 < gauc < 1.0
print('✅ GAUC 计算完成')
GAUC = 0.9730(按用户样本量加权)
说明:GAUC 更贴近推荐场景(每个用户一个排序列表),比全局 AUC 对"用户间差异"更敏感
✅ GAUC 计算完成
📐 公式推导:HR@K / Recall@K / NDCG@K¶
设用户 $u$ 的相关物品集合为 $\mathcal{R}_u$,模型返回得分最高的前 $K$ 个物品 $\hat{L}_u^{(K)}$,命中数 $\text{hit}_u = |\hat{L}_u^{(K)} \cap \mathcal{R}_u|$。
Hit Ratio(至少命中一个相关物品的用户占比,$\mathbb{1}$ 为指示函数):
$$ \mathrm{HR@K} = \frac{1}{|U|} \sum_{u \in U} \mathbb{1}[\mathrm{hit}_u > 0] $$
Recall@K(相关物品被召回的比率,分子分母都用 $|\mathcal{R}_u|$ 归一):
$$ \mathrm{Recall@K} = \frac{1}{|U|} \sum_{u \in U} \frac{\mathrm{hit}_u}{|\mathcal{R}_u|} $$
NDCG@K(Discounted Cumulative Gain 的归一化):位置 $i$(从 1 计数)打折系数 $\frac{1}{\log_2(i+1)}$:
$$ \mathrm{DCG@K} = \sum_{i=1}^{K} \frac{2^{rel_i} - 1}{\log_2(i+1)}, \qquad \mathrm{NDCG@K} = \frac{\mathrm{DCG@K}}{\mathrm{IDCG@K}} $$
其中 $rel_i \in \{0,1\}$ 是第 $i$ 位物品的相关性;$\mathrm{IDCG@K}$ 是把 $\min(K, |\mathcal{R}_u|)$ 个相关物品全部排最前时的理想 DCG。 推导要点:$\log_2(i+1)$ 使越靠前的命中贡献越大——这是"排序位置"信息进入指标的通道,也是面试常问"NDCG 为什么位置加权"的答案。
5️⃣ HR@K / Recall@K / NDCG@K¶
✍️ §5.1 手算评估指标:Precision@2 / Recall@2 / NDCG@2¶
上文公式容易背混,这里用 1 条推荐列表 把 Precision / Recall / HR / DCG / NDCG 逐一算出数字,每个结果都能对着公式核一遍。
设定:推荐列表 $\text{Rec}=[A,\ B,\ C]$(按位次排列),真实相关集合 $\text{Rel}=\{A,\ C\}$,先取 $K=2$。相关性向量 $\text{rel}=[1,0,1]$。
第 1 步:命中情况(只看前 2 位 $\text{Rec}_{@2}=[A,\ B]$)
| 位次 | 物品 | rel | 命中? |
|---|---|---|---|
| 1 | A | 1 | ✓ |
| 2 | B | 0 | ✗ |
命中数 $h=1$,相关总数 $|\text{Rel}|=2$。
第 2 步:Precision / Recall / HR
$$\text{Precision}@2=\frac{h}{K}=\frac{1}{2}=0.5,\qquad \text{Recall}@2=\frac{h}{|\text{Rel}|}=\frac{1}{2}=0.5,\qquad \text{HR}@2=\mathbb{1}[h>0]=1$$
第 3 步:NDCG@2(位次折扣 $1/\log_2(\text{pos}+1)$,其中 $\log_2 3=1.5850$,$1/\log_2 3=0.6309$)
$$\text{DCG}@2=\frac{1}{\log_2 2}+\frac{0}{\log_2 3}=1+0=1.0000$$
$$\text{IDCG}@2=\frac{1}{\log_2 2}+\frac{1}{\log_2 3}=1+0.6309=1.6309\ \Rightarrow\ \text{NDCG}@2=\frac{1.0000}{1.6309}=0.6131$$
第 4 步(对照 $K=3$):$\text{rel}=[1,0,1]$ 全部进入——$\text{P}@3=\frac{2}{3}=0.6667$,$\text{R}@3=\frac{2}{2}=1.0$;$\text{DCG}@3=1+0+\frac{1}{\log_2 4}=1.5$,而相关只有 2 个物品,$\text{IDCG}@3$ 仍为 $1.6309$,所以 $\text{NDCG}@3=\frac{1.5}{1.6309}=0.9197$。
手算收获:
- Precision 与 Recall 的分子都是 $h$,分母分别是"返回数 $K$"与"相关总数"——$K$ 放大时 Recall 只增不减、Precision 通常下降,这就是"召回-精度权衡"
- HR@K 是 0/1 的"有没有命中",最宽松;NDCG 的 $\log_2$ 折扣专门惩罚"相关物品排太靠后"——同样的 $h=1$,若 A、C 换位,NDCG@2 会变
- $\text{IDCG}@K$ 永远只按 $\min(K,\ |\text{Rel}|)$ 个位次加总:相关只有 2 个时 $\text{IDCG}@3=\text{IDCG}@2$,分母代表"理想排序"的天花板
- 单用户指标掩盖马太效应:评估全系统还要多用户的覆盖率/多样性(对应 §4 GAUC"用户级加权"的思想)
下面 numpy 复算。
# ---- §5.1 验证:numpy 复算评估指标 ----
import numpy as np

hc_rel = np.array([1, 0, 1])        # A 相关, B 不相关, C 相关
hc_K = 2
hc_h = hc_rel[:hc_K].sum()
hc_n_rel = hc_rel.sum()
print(f'命中 h={hc_h}, 相关总数={hc_n_rel}')
print(f'Precision@{hc_K} = {hc_h}/{hc_K} = {hc_h / hc_K:.4f}')
print(f'Recall@{hc_K} = {hc_h}/{hc_n_rel} = {hc_h / hc_n_rel:.4f}')

hc_dcg = sum(hc_rel[i] / np.log2(i + 2) for i in range(hc_K))
hc_idcg = sum(1.0 / np.log2(i + 2) for i in range(min(hc_n_rel, hc_K)))
hc_ndcg = hc_dcg / hc_idcg
print(f'DCG@2={hc_dcg:.4f}, IDCG@2={hc_idcg:.4f}, NDCG@2={hc_ndcg:.4f}')

hc_k3 = 3
hc_dcg3 = sum(hc_rel[i] / np.log2(i + 2) for i in range(hc_k3))
hc_idcg3 = sum(1.0 / np.log2(i + 2) for i in range(min(hc_n_rel, hc_k3)))
print(f'K=3: P={hc_rel[:hc_k3].sum() / hc_k3:.4f}, R={hc_rel[:hc_k3].sum() / hc_n_rel:.4f}, '
      f'NDCG={hc_dcg3 / hc_idcg3:.4f}')

assert abs(hc_h / hc_K - 0.5) < 1e-9 and abs(hc_h / hc_n_rel - 0.5) < 1e-9
assert abs(hc_ndcg - 0.6131) < 1e-3 and abs(hc_dcg3 / hc_idcg3 - 0.9197) < 1e-3
print('✓ 与手算一致')
def hr_recall_ndcg(rel_matrix, K):
    # rel_matrix: (users, items) 0/1 相关性;对每用户取预测分最高的 K 个
    hr_list, rec_list, ndcg_list = [], [], []
    for u in range(rel_matrix.shape[0]):
        rel = rel_matrix[u]
        n_rel = rel.sum()
        if n_rel == 0:
            continue
        top_k_idx = np.argsort(-scores_pred[u])[:K]
        hit = rel[top_k_idx].sum()
        hr_list.append(1.0 if hit > 0 else 0.0)
        rec_list.append(hit / n_rel)
        # NDCG@K
        dcg = sum((2**rel[top_k_idx[i]] - 1) / np.log2(i + 2) for i in range(K))
        idcg = sum(1.0 / np.log2(i + 2) for i in range(min(n_rel, K)))
        ndcg_list.append(dcg / idcg if idcg > 0 else 0.0)
    return np.mean(hr_list), np.mean(rec_list), np.mean(ndcg_list)

K = 10
hr, rec, ndcg = hr_recall_ndcg(labels, K)
print(f'HR@{K}  = {hr:.4f}(至少命中 1 个相关物品的用户比例)')
print(f'Recall@{K} = {rec:.4f}(相关物品被召回的比例均值)')
print(f'NDCG@{K} = {ndcg:.4f}(位置加权:排得越靠前越加分)')
assert 0 < hr <= 1 and 0 < ndcg <= 1
print('✅ 推荐列表三指标计算完成')
HR@10  = 1.0000(至少命中 1 个相关物品的用户比例)
Recall@10 = 0.6455(相关物品被召回的比例均值)
NDCG@10 = 0.9615(位置加权:排得越靠前越加分)
✅ 推荐列表三指标计算完成
6️⃣ 离线评估 vs 在线评估(必背)¶
print('''离线评估:在历史数据上回放(GAUC/NDCG/Recall@K),快但存在偏差:
  1) 曝光偏差:只有被曝光的物品才有反馈;
  2) 位置偏差:排在前面的天然有点击优势;
  3) 数据分布随策略变化:训练分布≠线上分布(反事实偏差)。

在线评估:小流量 AB 实验,看线上指标(CTR/CVR/停留/时长/GMV/留存),
  最可信但慢、贵、有风险(打错伤体验)。

工业做法:离线筛选 → 在线小流量 AB → 逐步放量 → 全量。
''')
离线评估:在历史数据上回放(GAUC/NDCG/Recall@K),快但存在偏差:
  1) 曝光偏差:只有被曝光的物品才有反馈;
  2) 位置偏差:排在前面的天然有点击优势;
  3) 数据分布随策略变化:训练分布≠线上分布(反事实偏差)。

在线评估:小流量 AB 实验,看线上指标(CTR/CVR/停留/时长/GMV/留存),
  最可信但慢、贵、有风险(打错伤体验)。

工业做法:离线筛选 → 在线小流量 AB → 逐步放量 → 全量。
📝 自测清单¶
- 能画出推荐五段链路并讲每层职责与时延预算
- 能手写 AUC(秩和法)并解释其物理意义
- 能解释 GAUC 与全局 AUC 的区别与适用场景
- 能手写 HR@K / Recall@K / NDCG@K
- 能说出离线评估三大偏差与在线 AB 的取舍